

Jira Service Management tiene una página de estado nativa, pero Atlassian la incluye solo en el plan Enterprise, tanto para páginas públicas como privadas. En Premium o por debajo, usas el producto independiente Statuspage y lo conectas a JSM mediante una app o una integración de alertas. Lo que vale la pena saber antes de comprar: la página nativa toma sus componentes de tu registro de servicios y sus actualizaciones del incidente, así que no hay una segunda herramienta que mantener sincronizada. Un compañero de IA como eesel cubre lo que la página no puede: responde los tickets de "¿está caído?" en tu cola a partir de la actualización que publicaste.
Construyo los agentes de eesel, así que leo esta función preguntando de dónde viene cada dato y quién puede cambiarlo. Revisé la documentación de páginas de estado y las páginas de precios de Atlassian para esta guía, y la documentación se contradice en algunos puntos, que señalo más abajo. Con el CLI de eesel, un agente de código con IA puede subir macros de interrupción aprobadas y la política de incidentes, luego hacerle preguntas de prueba y revisar las respuestas antes de que algo salga en vivo. Conectar el propio sitio de Jira todavía necesita que un administrador de Jira lo apruebe.
¿Qué son las páginas de estado de Jira Service Management?
Son páginas de marca que dicen a tus clientes o a tu equipo qué servicios funcionan y qué estás haciendo cuando uno no funciona. Atlassian las describe como integradas en JSM para que usen "tu registro de servicios y tus incidentes" en vez de una segunda app que tienes que configurar otra vez. Creas una en Operations y luego Status pages, y los agentes publican actualizaciones desde la vista del incidente.
En realidad hay tres formas en que Jira Service Management y una página de estado se conectan, y la documentación de Atlassian cubre las tres. Confundirlas es la fuente de confusión más común que veo.
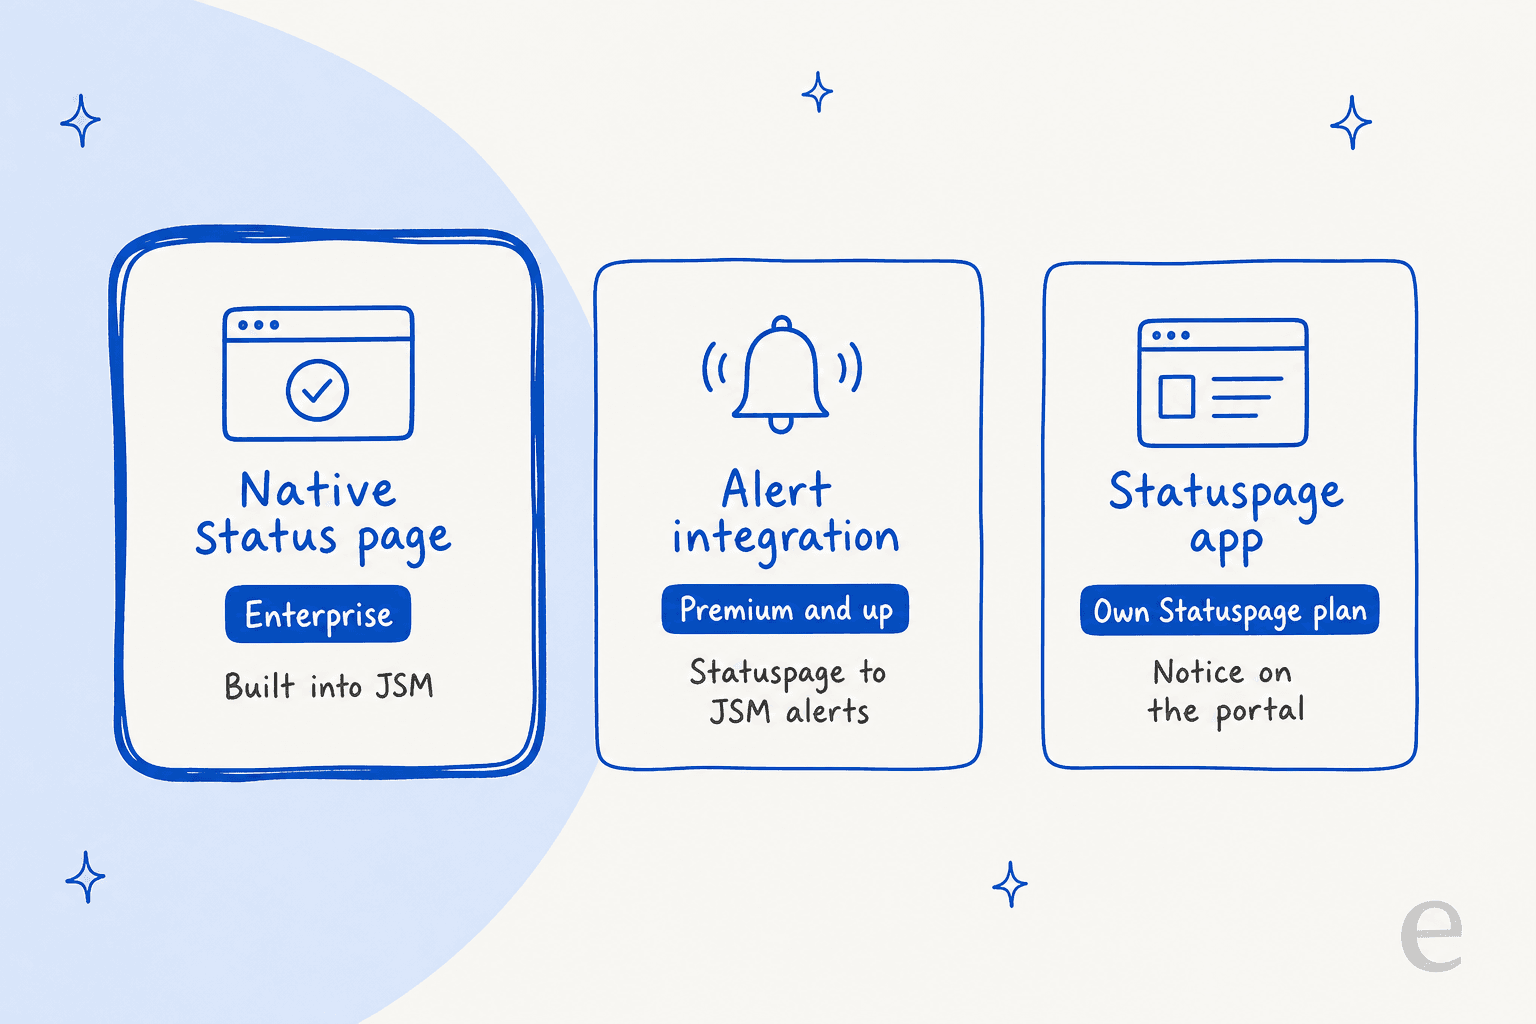
La página nativa es la nueva. El anuncio en la comunidad de Atlassian del 17 de febrero de 2026, publicado por un miembro del equipo de Atlassian, dijo que el lanzamiento empezó el 16 de febrero de 2026. Las otras dos vías conectan JSM con el producto más antiguo Statuspage, que ya existía antes.
¿Qué plan incluye las páginas de estado de Jira Service Management?
Enterprise, para la función nativa. La página de precios de Atlassian lista "Status pages" con una marca solo bajo Enterprise, y la doc de página de estado repite que la función es "exclusive to Enterprise plans". Así se reparten las piezas por plan, según las mismas páginas:
| Función | Free | Standard | Premium | Enterprise |
|---|---|---|---|---|
| Páginas de estado nativas (públicas y privadas) | No | No | No | Sí |
| Integración de alertas de Statuspage (bidireccional) | No | No | Sí | Sí |
| Comunicación con partes interesadas del incidente | No | No | Sí | Sí |
| Escalado de incidentes mayores | No | No | Sí | Sí |
| Retención de datos de alertas | 1 mes | 1 año | 3 años | 5 años |
Sobre el coste, Premium mostraba 55,28 $ por agente al mes en la página de precios cuando lo comprobé el 12 de noviembre de 2026. Enterprise no tiene precio público, se factura anualmente y pasa por ventas. Atlassian dice que el precio mensual es progresivo, así que esa cifra es una mezcla para un tamaño de equipo preestablecido, no una tarifa de lista. Mi desglose de precios recorre los tramos.
Si estás por debajo de Enterprise, el producto independiente tiene sus propios precios públicos:
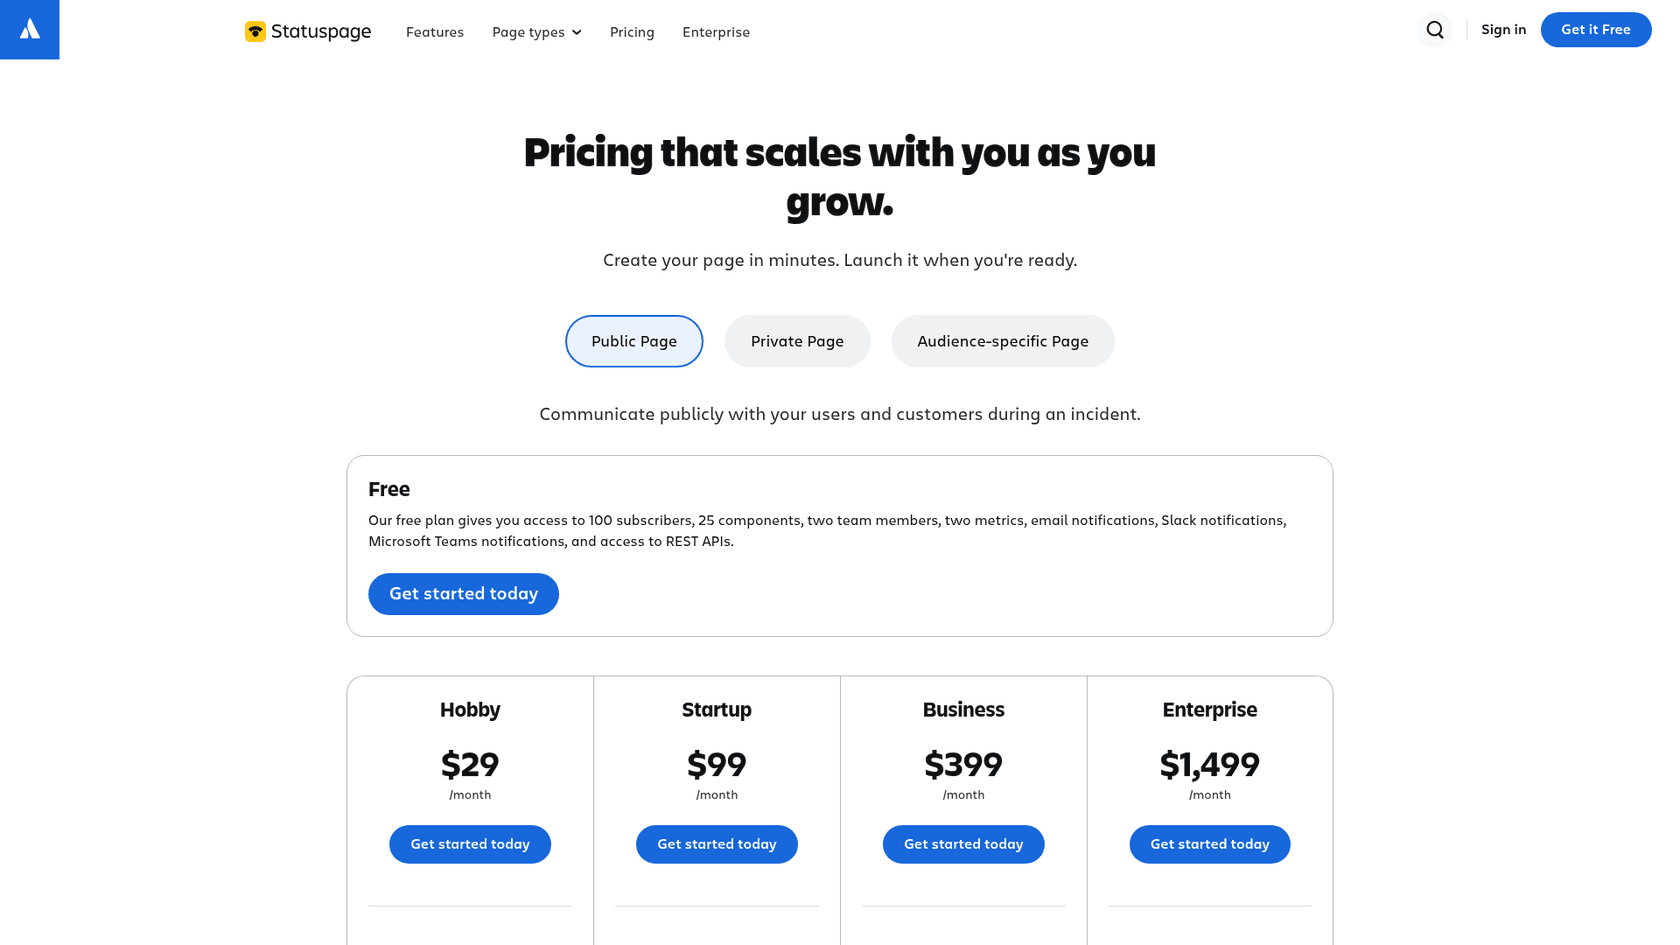
| Plan público de Statuspage | Precio al mes | Suscriptores | Miembros del equipo | Suscripciones a componentes |
|---|---|---|---|---|
| Free | $0 | 100 | 2 | No |
| Hobby | $29 | 250 | 5 | No |
| Startup | $99 | 1.000 | 10 | No |
| Business | $399 | 5.000 | 25 | Sí |
| Enterprise | $1.499 | 25.000 | 50 | Sí |
Las páginas privadas empiezan en 79 $ al mes en la misma página de precios. La vía independiente cuesta más en facturas separadas, pero funciona con un plan de JSM más bajo.
¿Cómo configuras una página de estado en Jira Service Management?
Tienes que ser administrador del producto, y la primera decisión no se puede deshacer. La página de crear y personalizar de Atlassian dice que eliges Public o Private al crearla y que "can't change it afterwards". Para cambiar, creas una página nueva.
- Ve a Operations y luego Status pages y elige el tipo de página.
- En Details, define el nombre de la página, la descripción interna, la URL y la zona horaria. La dirección por defecto es
<name>.status.atlassian.com. - En Components, añade servicios desde tu registro de servicios y agrúpalos.
- En Appearance, añade colores, una imagen de portada y un favicon. Se permiten CSS y HTML para un estilo más profundo.
- En Advanced settings, añade plantillas de incidentes y un dominio propio.
- Revisa la vista de escritorio y móvil, y luego elige Publish page, según la documentación de publicación.
Los límites de componentes son generosos pero reales: hasta 1.000 componentes en total, 50 por grupo y 20 grupos por página. El dominio propio necesita dos registros CNAME, y el SSL se emite automáticamente, como explica la página de dominio propio.
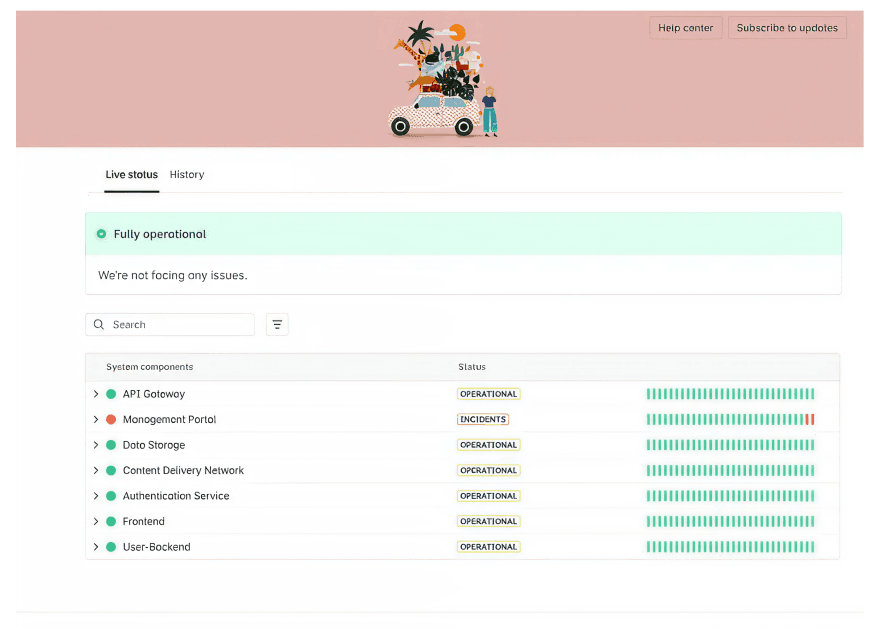
Lo que ven los visitantes es un banner, una lista de componentes con un buscador, y las pestañas Live status y History. Si tus administradores son nuevos con el registro de servicios que alimenta la lista de componentes, mi guía sobre el sistema de tickets de ITSM cubre lo básico.
¿Cómo llegan las actualizaciones de incidentes a la página de estado?
Desde el propio incidente. La doc de actualizaciones de Atlassian hace que los agentes vinculen una página publicada en la sección Status pages del incidente, y luego elijan Send update. Solo puedes vincular una página de estado por incidente.
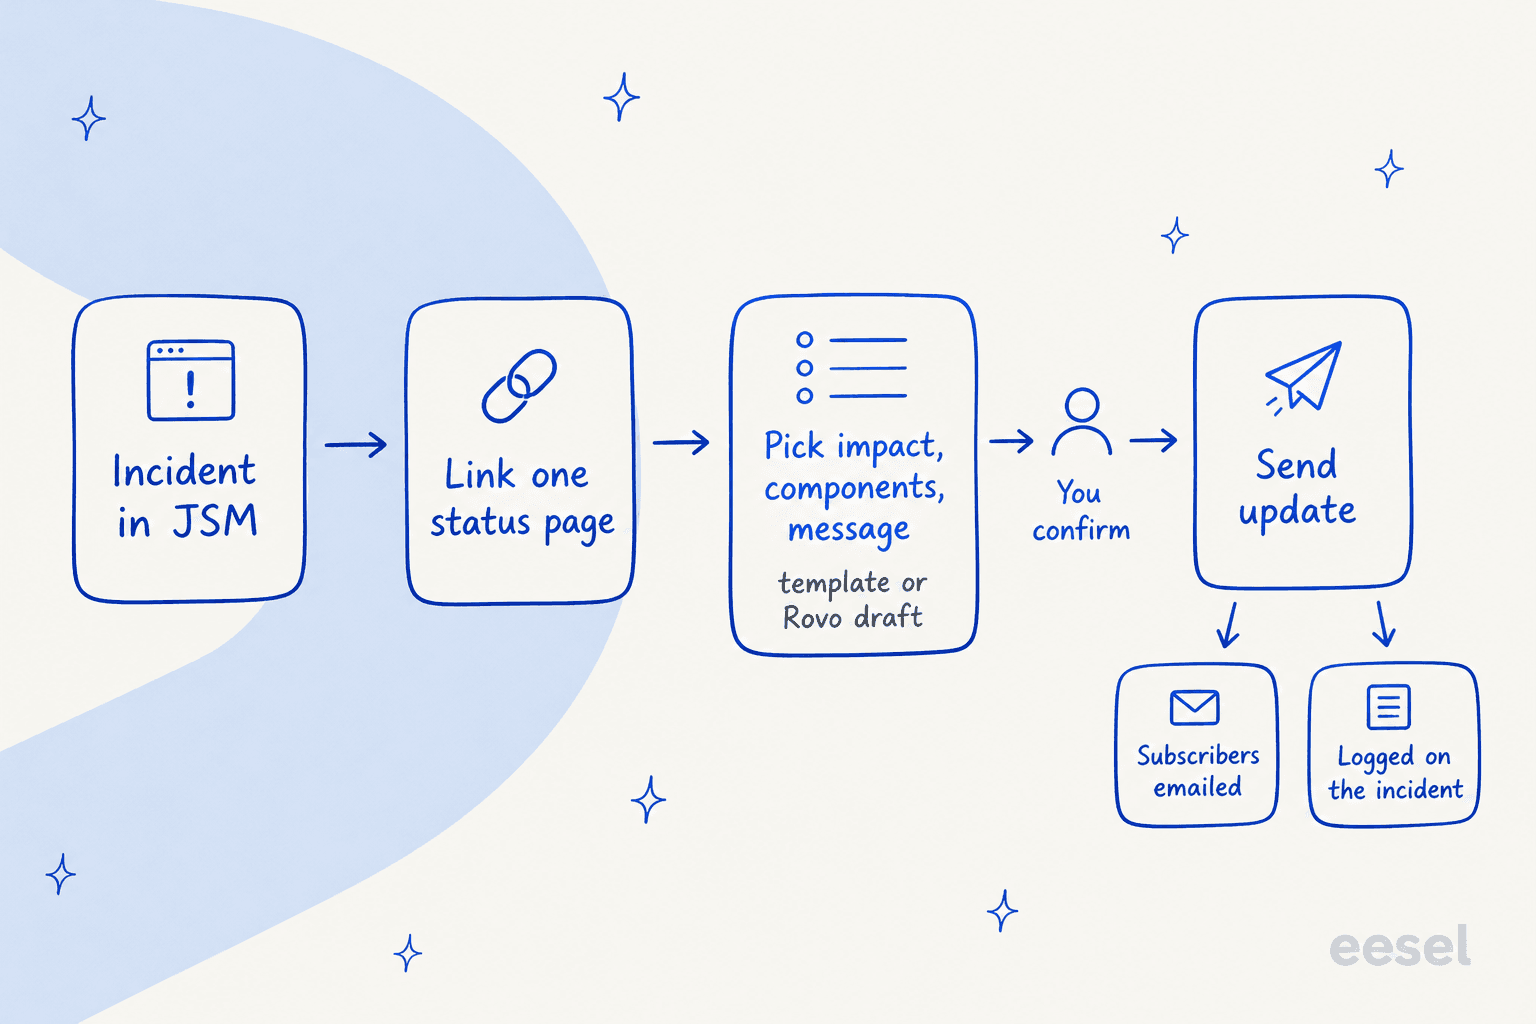
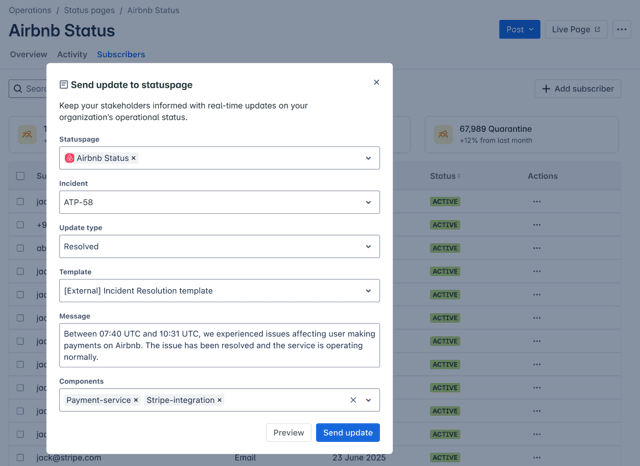
El cuadro de actualización pide el impacto, el estado, el título y el mensaje del incidente. Puedes escribirlo a mano, partir de una plantilla de incidente por defecto, o revisar un título y un mensaje sugeridos por Rovo en incidentes elegibles. Atlassian es explícito en que las sugerencias "are applied only after you confirm them". Las actualizaciones también se registran en el incidente, así que la línea de tiempo muestra qué se le dijo a los clientes. Los grupos de partes interesadas funcionan junto a esto: Rovo sugiere personas según incidentes similares pasados, pero las partes interesadas se añaden solo tras confirmar.
La parte de redacción con Rovo es su propio tema. Mis notas sobre Atlassian Intelligence e incidentes y revisiones post-incidente cubren las funciones de IA vecinas, y agentes de Rovo explica el modelo de agentes más amplio.
¿Cómo obtiene su estado un componente?
Por el incidente abierto más grave, lo cual me sorprendió. La doc de página de estado de Atlassian dice que cuando varios incidentes afectan a un componente, la página muestra el peor estado, y solo cambia cuando se envía una actualización desde JSM.
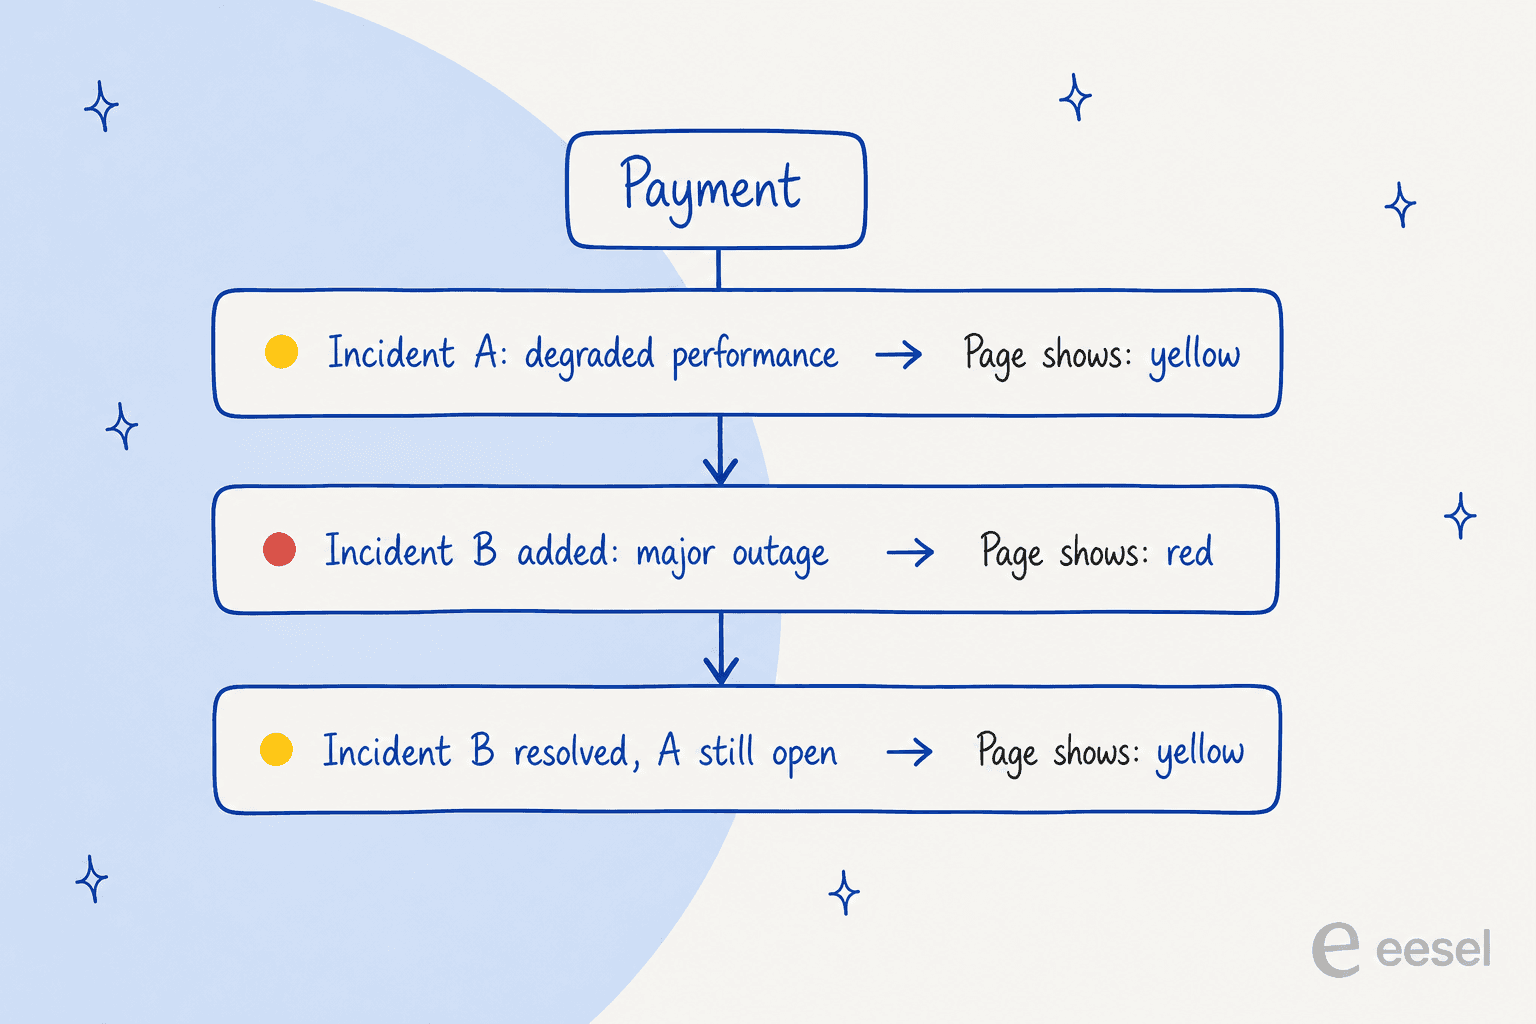
De esto se siguen dos consecuencias. Primero, la página está tan actualizada como tu último Send update, así que un canal de incidentes silencioso significa una página obsoleta. Segundo, bajar de categoría un componente dentro de un solo incidente no lo reduce, porque la documentación dice que el estado de uptime "will still reflect the most significant impact". El uptime es (Total Time - Downtime) / Total Time, así que el ejemplo de Atlassian de 90 minutos de caída en una ventana de 30 días da 99,791 %.
¿Quién puede suscribirse, y cuáles son los límites?
Cualquiera, en una página pública, y los límites son por sitio, no por página. Estas son las cifras de la documentación de suscriptores y la documentación de edición de Atlassian:
| Límite | Valor |
|---|---|
| Suscriptores por sitio (todas las páginas juntas) | 10.000, cuenta activos, pendientes e inactivos |
| Componentes por página | 1.000 |
| Componentes por grupo | 50 |
| Grupos por página | 20 |
| Altas manuales de suscriptores a la vez | 10 direcciones de correo, sin listas de distribución |
| Canales de suscripción | Correo electrónico, y webhooks |
Solo los suscriptores Active reciben actualizaciones, y alguien que no ha verificado su correo aparece como Pending. En páginas privadas, quitar a una persona del grupo de Atlassian vinculado elimina su acceso, pero no cancela su suscripción por correo, así que tienes que borrarla tú mismo.
¿Deberías usar la página nativa o Statuspage?
Depende sobre todo de tu plan, y luego de cuánto quieras tener en un solo lugar. Atlassian mismo dice que la app independiente "works as a separate product, so its scope for integration and customization is limited". Prueba el selector de abajo, que sigue la documentación.
¿Qué camino de página de estado te conviene?
Elige tu plan de JSM y para quién es la página.
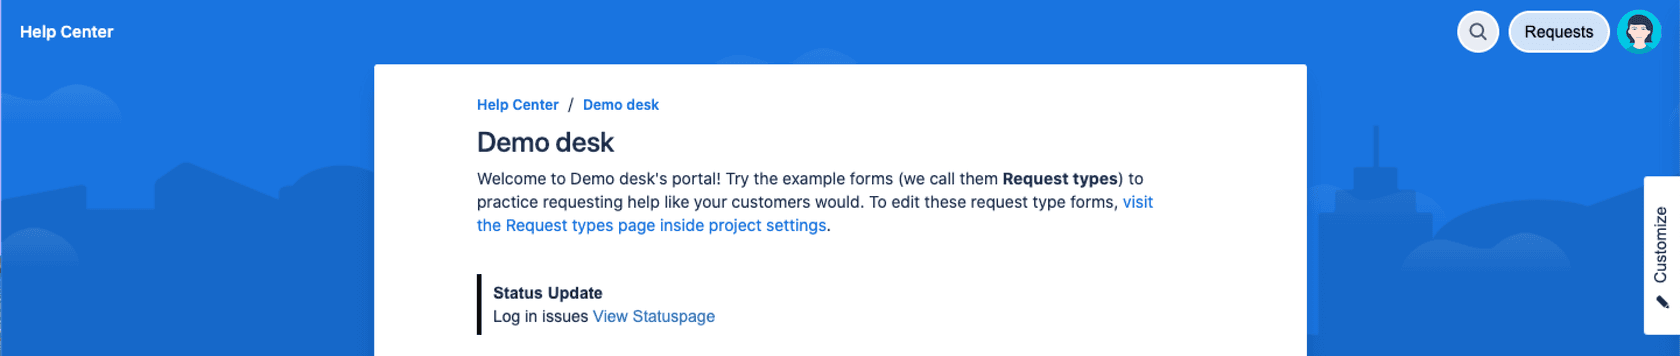
Si ya usas Statuspage, Atlassian dice que puedes seguir ahí, según la página de configuración de Statuspage. Esa página también añade el aviso de portal que se muestra abajo, así que los clientes ven el incidente antes de abrir un ticket.
Las páginas de estado están junto a la gestión de cambios, que tiene su propia barrera de plan, y las funciones de IA de JSM más amplias también merecen un vistazo. Si estás valorando otras herramientas primero, mi comparación con Freshservice, comparación con Zendesk y mi lista de alternativas cubren la decisión más amplia.
¿Cómo se relaciona esto con el sucesor de las alertas de Opsgenie?
A través del incidente. Opsgenie se está retirando: Atlassian detuvo las nuevas ventas el 4 de junio de 2025 y termina el soporte el 5 de abril de 2027, y sus funciones de alertas y on-call están integradas en Jira Service Management y Compass. En JSM, las alertas se enrutan según el calendario on-call y pueden abrir un incidente, y el incidente es donde publicas la actualización de estado.
La integración con Statuspage también funciona al revés. La documentación de integración con Statuspage dice que un nuevo incidente en Statuspage crea una alerta en JSM, y cada actualización se añade como nota en esa alerta. JSM puede entonces crear, actualizar y resolver incidentes en Statuspage mediante acciones de alerta asignadas. Atlassian lista las integraciones bidireccionales como función de Premium y Enterprise.
Para el lado de las alertas de la historia, lee mis notas sobre agrupación de alertas, monitorización y alertas con IA e ITIL con IA. Para complementos de IA, mira los resúmenes de mejor IA para JSM e IA para ITSM. Si estás mapeando todo el proceso, help desk vs. service desk es una buena introducción.
¿Dónde no coincide la documentación de Atlassian?
Cinco puntos, y comprobaría cada uno en tu propio sitio antes de planear un lanzamiento:
- Páginas privadas. El post de la comunidad de febrero de 2026 decía que las páginas privadas estaban "coming soon", y abrió un programa de acceso anticipado. La documentación actual describe una configuración completa con grupos de Atlassian, y la página de precios dice "public & private". Yo trataría las páginas privadas como disponibles, pero lo confirmaría en tu entorno.
- Enviar actualizaciones. La página de enviar actualizaciones dice que la función de publicar "will be released soon", mientras que la documentación de incidentes y su propia captura de pantalla la describen como funcionando.
- Partes interesadas en Standard. La tabla de precios lista la comunicación con partes interesadas del incidente como no incluida en Standard. La documentación de partes interesadas dice que los usuarios con licencia de agente en Standard pueden añadirse como partes interesadas.
- Suscriptores por webhook. El post de lanzamiento lista correo y webhooks, y la documentación de ver menciona solo correo. Los webhooks tienen su propia documentación.
- Redacción con IA. El post de lanzamiento llama al auto-redactado una beta abierta para Enterprise, mientras que la documentación dice que las sugerencias de Rovo aparecen en "eligible incidents", sin nombrar un plan.
¿Qué debería hacer tu cola de soporte durante un incidente?
Responde desde la actualización publicada, y no envíes nada que no esté ahí. Una página de estado le dice a la gente qué está mal, pero la mayoría igual escribe. Mis guías sobre actualizaciones de página de estado, comunicación en incidentes mayores y soporte durante caídas de SaaS cubren ese bucle en detalle, y software de comunicación con clientes cubre las herramientas.
Yo mantendría una línea dura. Una IA puede citar la actualización, pero una persona decide qué cuenta como caída. Qontro, un proveedor de ERP que usa eesel en Freshdesk, lo configuró así: las caídas, la pérdida de datos y la facturación van directo a una persona, y eesel no intenta solucionarlas. Redactó respuestas en 190 tickets en el mes del 8 de agosto al 8 de septiembre de 2026, y el equipo envía o reescribe cada una.
El agente virtual y una buena base de conocimiento hacen parte de este trabajo de forma nativa. La deflección es la cifra a vigilar. Deflección de tickets, deflección de nivel 1 y tasa de deflección explican cómo medirla, y gestión de SLA cubre los relojes que siguen corriendo. Para enrutar el resto, mira gestión de escalado con IA.
Prueba eesel para Jira Service Management
Si tu página de estado está bien pero tu cola se desborda cada vez que se pone roja, eesel se conecta a tu mesa de Jira Service Management como una nueva incorporación. Lee cada solicitud de "¿está caído?", responde a partir de la actualización que publicaste y tu base de conocimiento, y deja una nota interna para una persona en todo lo que parezca una nueva caída. Gratis para probar. Para una visión más amplia, mira mis guías IA para Jira Service Management y cómo añadir IA a JSM, más la evaluación de IA de JSM.
