

La IA para la gestión de cambios en ITSM se gana su sueldo en el papeleo, no en la aprobación. Deja que revise cada solicitud de cambio en busca de un plan de reversión o de evidencia de pruebas que falte antes de que nadie se reúna, que explique la puntuación de riesgo con palabras claras y, lo más útil, que vincule la oleada de tickets del service desk tras un mal cambio con el cambio que la causó. Una persona concreta sigue aprobando y ejecutando cada cambio normal o de emergencia. Eso es también lo que construyen hoy ServiceNow, Jira Service Management y Freshservice: su IA redacta y sugiere, y ninguna aprueba cambios automáticamente.
La razón para apuntar la IA al papeleo está en la investigación. El equipo de SRE de Google dice que aproximadamente el 70% de las caídas proviene de cambios en un sistema en producción, y DORA descubrió que los equipos con aprobación pesada por comité tenían 2,6 veces más probabilidades de ser de bajo rendimiento, sin una reducción de las tasas de fallo que lo compensara. Un guardián más listo no arregla eso. Lo arreglan solicitudes mejores a la entrada y un vínculo más rápido cuando algo sale mal.
Si tu service desk funciona con Jira Service Management o Zendesk, eesel puede ser el compañero del lado de los tickets: lee las solicitudes nuevas, busca cambios recientes, deja una nota interna con el cambio probable y retiene cualquier cosa arriesgada para que la revise una persona. El responsable de TI de InDebted lo usa como primer respondedor en un desk interno de JSM.
¿Puede la IA ayudar con la gestión de cambios en ITSM?
Sí, siempre que la apuntes a la mitad correcta del trabajo. La gestión de cambios, que ITIL 4 llama habilitación de cambios, tiene dos mitades: decidir si un cambio debe hacerse y lidiar con lo que ocurre después. La IA es buena en la lectura, el cruce de datos y el resumen que rodean a ambas. No es lo que quieres que decida.
Yo construyo las integraciones de helpdesk de eesel, incluida la de Jira Service Management, así que paso mucho tiempo dentro de las colas ITSM de otras personas. El patrón que veo en los desks internos de TI es constante. El proceso de cambios en sí suele funcionar sobre el papel. Lo que se come la semana es el ir y venir con solicitudes de cambio a medio rellenar, y el lunes por la mañana en que 30 tickets dicen "la VPN no funciona" y nadie en el service desk sabe que el sábado cambió una regla del firewall.
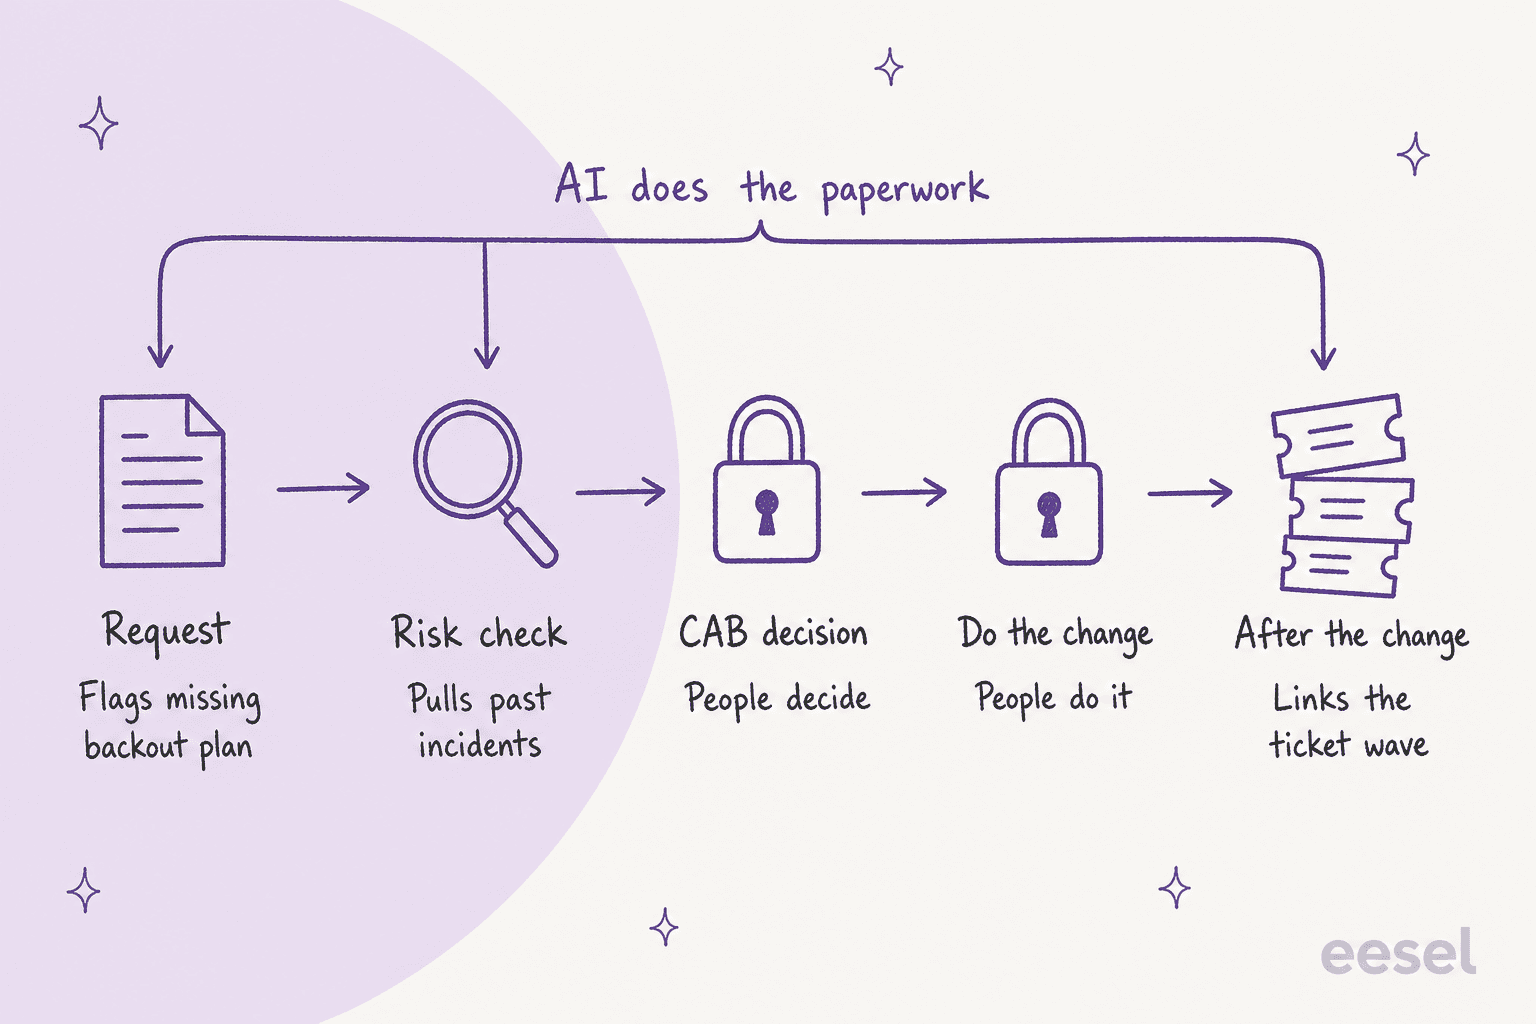
Esa imagen es todo el argumento. Las tres etapas donde la IA ayuda son las que tienen más documentos y cruces de datos. Las dos del medio son criterio y manos en el teclado, y se quedan con las personas.
Los números respaldan por qué los extremos importan más que el centro:
| Hallazgo | Cifra | Fuente |
|---|---|---|
| Caídas causadas por cambios en un sistema en producción | ~70% | Google SRE book |
| Tasa de fallo de cambios, élite frente a bajo rendimiento | 5% vs 40% | DORA 2024 report |
| Equipos de bajo rendimiento cuando la aprobación va a un comité o a un directivo | 2.6x más probable | DORA 2019 report |
| Caídas graves por error humano causadas por procedimientos no seguidos o defectuosos | 85% | Uptime Institute 2025 |
La línea de DORA es la que debería cambiar tu forma de pensar. DORA buscó evidencia de que la aprobación formal reduce las tasas de fallo de los cambios y "no encontró evidencia que respalde esta hipótesis". Así que añadir una puntuación de riesgo de IA a la misma reunión del comité te da una versión más rápida de un paso que no hacía los cambios más seguros. La mejor apuesta es la IA en las entradas (¿está completa esta solicitud?) y en las salidas (¿qué tickets causó este cambio?).
¿Dónde encaja la IA en cada etapa de un cambio?
La IA encaja en la recepción, la explicación del riesgo, la preparación del CAB y la oleada de tickets posterior al cambio. La aprobación y la implementación siguen siendo humanas. Esta es la división que usaría, con lo que ofrecen las principales herramientas ITSM para cada etapa:
| Etapa | Qué hace la IA | Qué hace una persona | Disponible hoy |
|---|---|---|---|
| Solicitud | Revisa si faltan plan de reversión, evidencia de pruebas o servicios afectados | Rellena los huecos | Evaluador de calidad de cambios de ServiceNow |
| Revisión de riesgo | Recupera cambios pasados similares y sus incidentes, explica la puntuación | Responde o confirma las preguntas de riesgo | Explicación de riesgo de ServiceNow, evaluación de riesgo con IA de JSM, cambios similares de Freshservice |
| Decisión del CAB | Resume cada cambio, señala conflictos | Aprueba o rechaza | Resumen de cambios y evaluador de conflictos de ServiceNow, Prevention Center de JSM (acceso anticipado) |
| Hacer el cambio | Sugiere un hueco en el calendario | Ejecuta el cambio | Agente de programación de ServiceNow |
| Después del cambio | Vincula los incidentes nuevos con el cambio probable, redacta la respuesta de estado | Confirma la causa, decide si hacer rollback | Sugeridor de cambio iniciador de Freshservice (acceso anticipado), IA de helpdesk como eesel |
Dos cosas destacan en esa tabla. Primero, todos los proveedores se detienen en la misma línea: la IA sugiere, una persona envía. Segundo, la fila "después del cambio" es la más escasa. Es donde vive el service desk, y es de donde sale la mayor parte del dolor en los hilos de comunidad que leo.
¿Puede la IA revisar una solicitud de cambio antes de que la vea el CAB?
Sí, y por aquí empezaría, porque es de bajo riesgo y ahorra más idas y venidas. Una revisión de completitud lee la solicitud y señala lo que falta antes de que una persona dedique tiempo a ella.
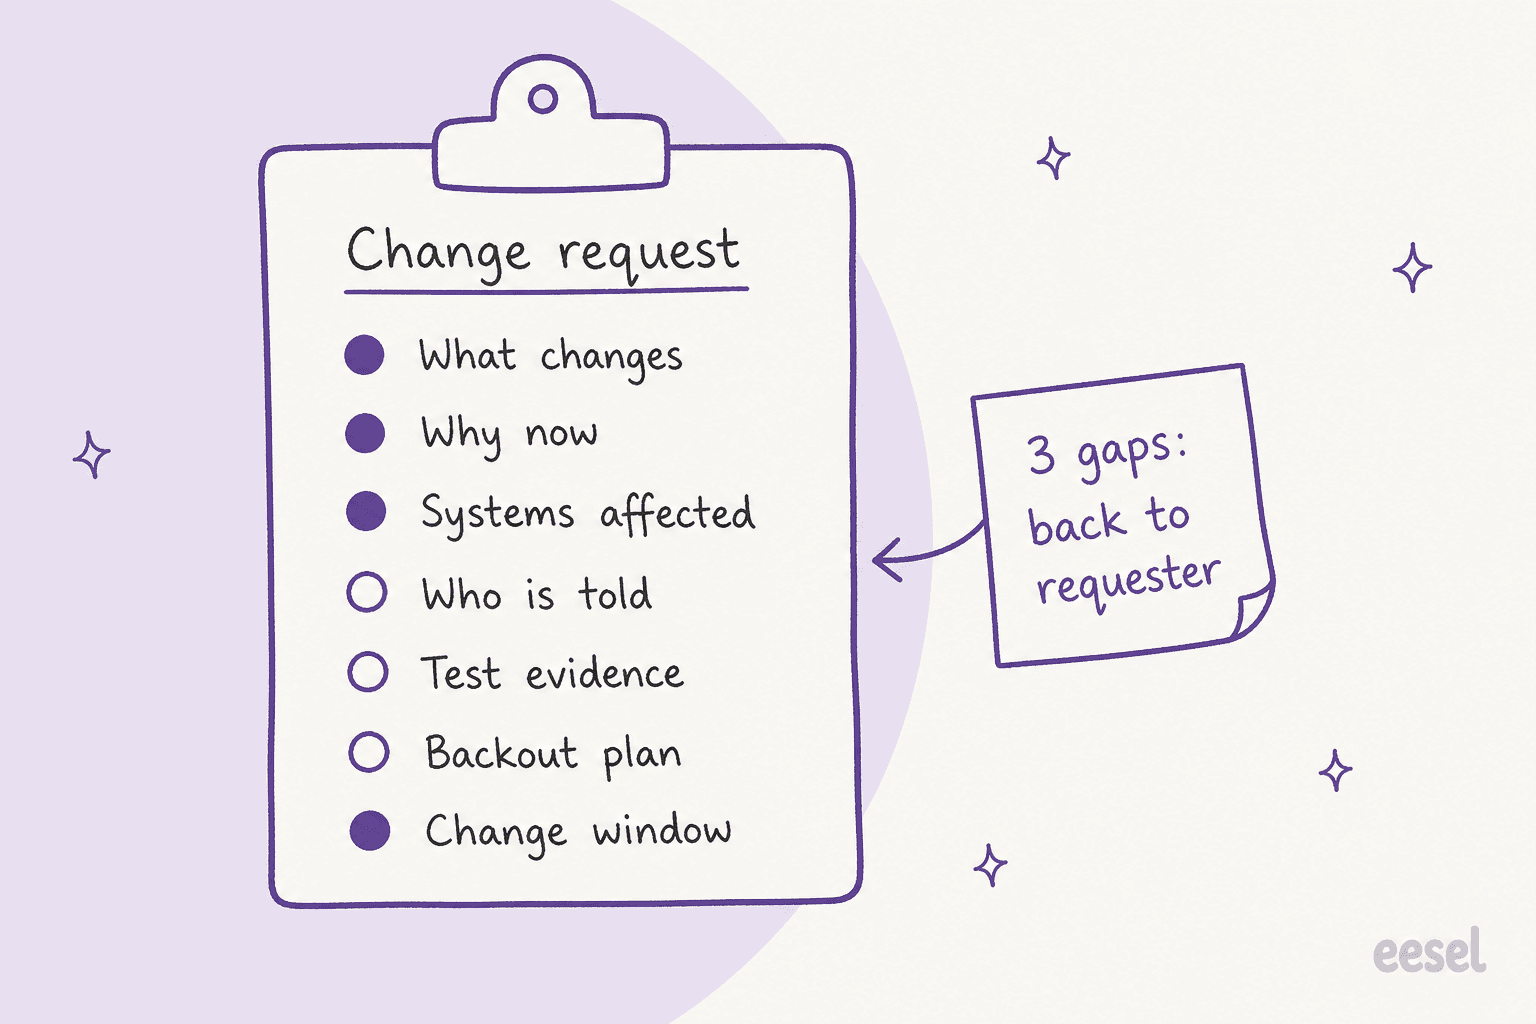
ServiceNow ofrece la versión más completa. Su evaluador de calidad de cambios puntúa cinco partes de un cambio (plan de implementación, plan de reversión, plan de pruebas, análisis de riesgo e impacto, justificación) en una escala de "Excelente" a "Incompleto". Primero consulta el documento de política de cambios de tu empresa y solo recurre a cambios similares ya cerrados si no tienes uno. Ese orden importa: escribe la política y la IA puntúa según tu estándar, no según el aspecto que hayan tenido tus cambios pasados.
¿Por qué molestarse? Porque la pregunta del rollback es en la que los CAB gastan su tiempo, y la gente lo sabe:
"O sea, no hacen ningún trabajo real. Es solo una persona a la que pagan por sentarse en una reunión de una hora y preguntar al final: «Oh, ¿hay plan de reversión?»."

Si la IA hace esa pregunta en el momento en que se envía la solicitud, la reunión no tiene que hacerla. Los equipos pequeños sin ServiceNow obtienen una versión de esto gratis: un sysadmin de una empresa pequeña sugirió que la IA produzca el propio documento de cambio ("Qué vas a hacer, plan de reversión, riesgo, etc."), según un hilo de r/sysadmin. Una lista de verificación que rellena la IA sigue siendo una lista que alguien lee.
Una nota práctica: en un desk con una IA de helpdesk al frente, la misma revisión puede ocurrir en la conversación. Cuando alguien pregunta en Slack "¿cómo registro un cambio para la migración del DNS?", el agente puede responder desde tu política de cambios en Confluence y pedir el plan de reversión desde el principio, de modo que la solicitud llegue completa. Esa es la mitad de autoservicio de un help desk de TI con IA, aplicada a los cambios.
¿Puede la IA puntuar el riesgo de un cambio?
En parte. La versión útil explica una puntuación de riesgo y trae el historial que la respalda. La versión con la que hay que tener cuidado es la que te da un número y espera que confíes en él.
Fíjate bien en lo que hace cada herramienta:
- ServiceNow: la puntuación de riesgo en sí sale de una encuesta con umbrales basados en reglas (0 a 25 Bajo, 26 a 50 Moderado, 51 o más Alto). La capa de IA va encima: explica la puntuación usando solicitudes de cambio similares y los incidentes que causaron, y puede rellenar previamente las respuestas de riesgo para que una persona las revise antes de enviar.
- Jira Service Management: la evaluación de riesgo con IA escribe un resumen narrativo con una puntuación de confianza y una calificación Baja, Media o Alta. Comprueba los incidentes abiertos en el servicio afectado, los despliegues fallidos, los cambios rechazados en el mismo servicio en los últimos 90 días y si existen planes de pruebas y de reversión.
- Freshservice: las políticas de riesgo de cambios se basan en reglas y puntúan cada factor de 0 a 10 con ponderaciones opcionales. La parte de IA de Freddy consiste en encontrar cambios pasados similares, no en producir la puntuación.
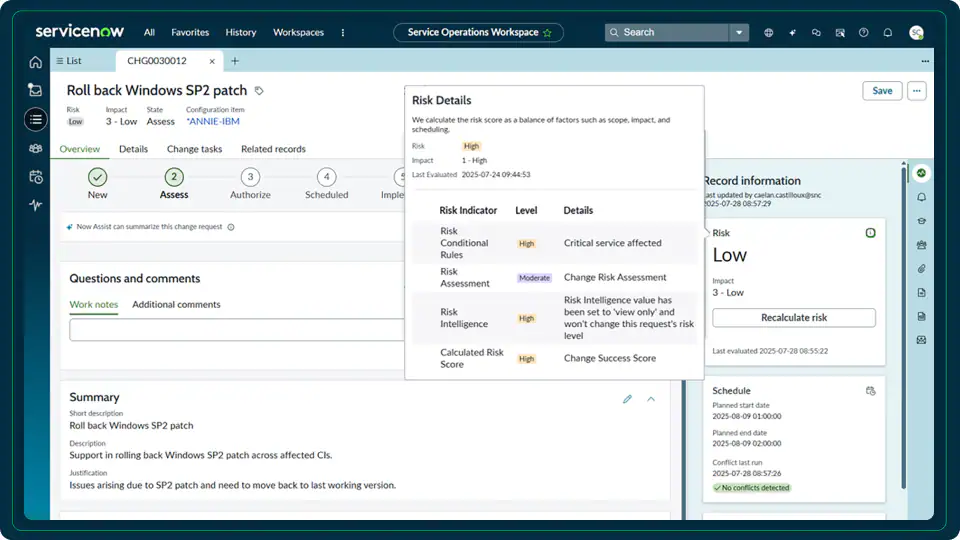
Mi opinión: trata el resultado de riesgo de la IA como un informe, no como un veredicto. La documentación de Jira es inusualmente directa en esto. La función no "aprueba ni rechaza cambios automáticamente" y no "ofrece predicciones garantizadas ni deterministas". Además hay una particularidad que conviene conocer antes de que tu CAB se apoye en ella: la evaluación se genera por usuario, según lo que cada persona tiene permiso para ver, así que dos aprobadores pueden recibir resúmenes distintos del mismo cambio.
Y entra con expectativas realistas sobre la precisión. La IA de ServiceNow solo conoce tu historial si tu historial está en ServiceNow, bien vinculado. Un profesional explicó por qué las demos se ven mejor que la producción:
"Las instancias de demo que usan los de ventas son difíciles de hacer bien. No tienen datos «históricos» reales, así que no hay nada que enseñe al modelo de aprendizaje automático dónde debería asignarse algo."
Lo contrario también es cierto. Si tus cambios no están vinculados a servicios ni a elementos de configuración, la parte de "cambios similares y sus incidentes" no tiene nada con qué cruzarse. Jira dice sin rodeos que la detección de conflictos solo funciona "cuando los cambios relacionados están correctamente vinculados a servicios o activos e incluyen fechas planificadas de inicio y fin".
¿Debería la IA reemplazar al comité asesor de cambios?
No, pero debería reducir lo que mira el CAB. El problema real de la mayoría de los CAB no es que la gente decida mal. Es que deciden sobre todo, así que lo hojean todo:
"Así funcionaba en teoría en las grandes empresas en las que trabajé como contratista. Sin embargo, en la práctica era una sala llena de técnicos esperando a que dijeran su nombre, seguida de un sello de goma. No creo haber visto nunca un cambio cuestionado por sus compañeros."
También hay un coste de segundo orden. Agrupar los cambios en torno a una reunión semanal hace que todos aterricen a la vez:
"Lo que más me gusta de pasar por el CAB cosas que no deberían pasar por el CAB es que eso agrupa cambios que ocurren todos al mismo tiempo... después de la reunión del CAB. Ahora, si algo se rompe, puede ser cualquiera de las decenas de cosas que se acaban de desplegar en los 15 minutos posteriores a la reunión."

La guía actual de DORA sobre agilizar la aprobación de cambios apunta en la misma dirección: dejar de "tratar todos los cambios por igual" y hacer un "análisis continuo para detectar y señalar pronto los cambios de alto riesgo para someterlos a un escrutinio adicional". Eso es un trabajo de clasificación, y clasificar es lo que la IA hace bien. Un paquete útil para el CAB se ve así:
- Cambios estándar preaprobados por plantilla, listados solo para conocimiento. Jira Service Management ya aprueba automáticamente los cambios estándar con una regla de automatización, y ServiceNow los trata como preautorizados.
- Solicitudes incompletas devueltas antes de la reunión, con los huecos señalados.
- Conflictos marcados: dos cambios en el mismo servicio en la misma ventana, o un cambio dentro de un periodo de congelación.
- Los pocos arriesgados, cada uno con un resumen de un párrafo y los cambios pasados similares que salieron mal.
El resumen de cambios de ServiceNow lee 17 campos de un cambio (incluidos los planes de implementación, pruebas y reversión) y los convierte en un breve informe, y su evaluador de conflictos comprueba los CI afectados frente a ventanas de bloqueo y mantenimiento. El Prevention Center de Atlassian agrupa un resumen de cambios, un mapa de dependencias y una comprobación de choques de calendario, pero sigue en un programa abierto de acceso anticipado, así que revisa tu plan antes de contar con él.
Entonces el comité dedica su hora al punto 4. Esa es la versión de un CAB que DORA llama "arquitecto de procesos y faro de información" en lugar de guardián.
¿Qué pasa en el service desk después de que un cambio sale mal?
Los tickets llegan antes de que nadie los haya conectado con el cambio. Esta es la etapa que, a mi juicio, más importa para un equipo de TI, y la que menos cubren los proveedores de ITSM.
La escala puede ser enorme. Cuando CrowdStrike lanzó una actualización de contenido defectuosa el 19 de julio de 2024, estuvo activa unos 78 minutos antes de revertirse, según su propia revisión, y Microsoft estimó que afectó a 8,5 millones de dispositivos Windows. La mayoría de los cambios internos son mucho más pequeños, pero la forma en el service desk es la misma: una causa, decenas de tickets que describen cada uno un síntoma distinto.
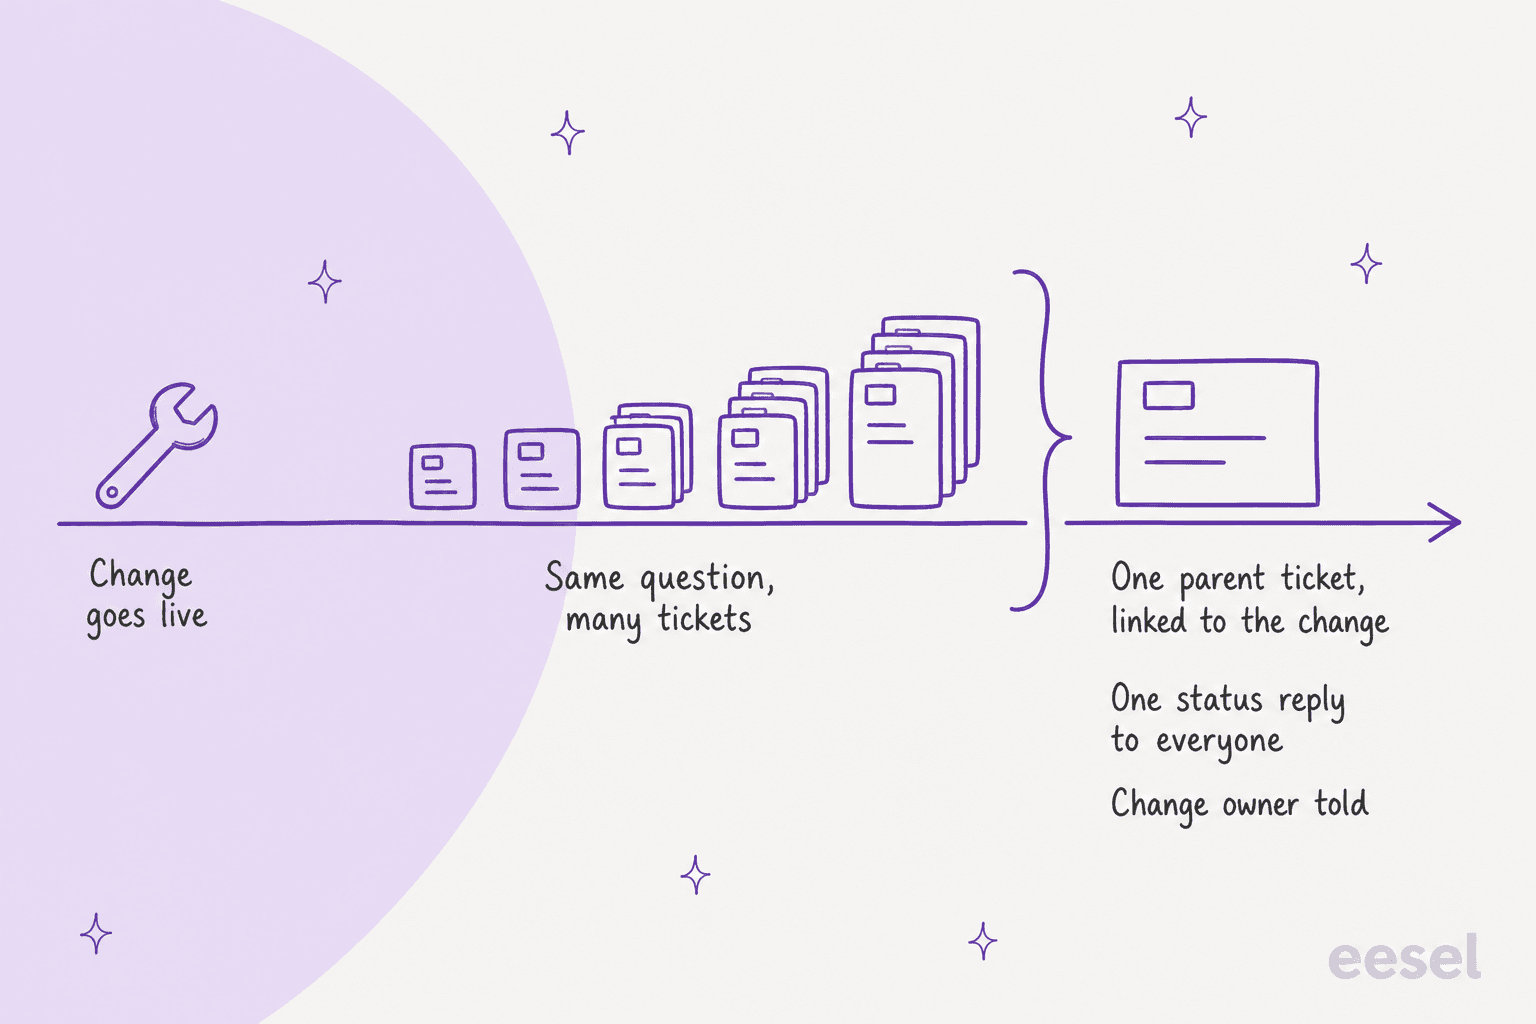
Quienes atienden ese desk lo describen igual:
"No sé si te servirá porque estoy en el Service Desk, pero aquí se siente igual. Cada vez que lanzamos o actualizamos algo, a pesar de dedicar tiempo a probar, etc., tenemos que ponernos a apagar fuegos casi de inmediato. Es agotador."
Y la peor versión es el cambio del que nadie avisó. En un hilo de r/sysadmin, un cambio aprobado siguió adelante un sábado en que la planta debía estar cerrada; al gerente de producción no se le había dicho que era un día de doble producción, y el usuario calculó el coste en $1.5mil por una caída de 3 horas.
Esto es lo que la IA puede hacer en esa primera hora:
- Detectar el patrón. Varios tickets nuevos sobre el mismo servicio en una ventana corta son una señal, la misma idea que la deduplicación de tickets.
- Buscar cambios recientes en ese servicio. En Jira Service Management los cambios son issues, así que una búsqueda JQL de cambios en el servicio afectado en los últimos días responde "¿cambió algo?" en segundos.
- Dejar una nota interna en cada ticket con la clave del cambio probable, para que el agente que lo recoja empiece por la causa y no desde cero.
- Enviar una sola respuesta de estado a todos los afectados, redactada una vez y aprobada una vez. Es el mismo trabajo que las actualizaciones de la página de estado y la comunicación de incidentes graves, solo que activado por un cambio.
- Avisar al responsable del cambio con el número de tickets, para que la decisión de rollback se tome con evidencia.
Freshservice tiene la función nativa más cercana. Su sugeridor de cambio iniciador clasifica los cambios cerrados en los últimos 14 días que pueden haber causado un incidente, y un agente vincula a mano el correcto. Está en acceso anticipado y requiere el complemento Copilot.
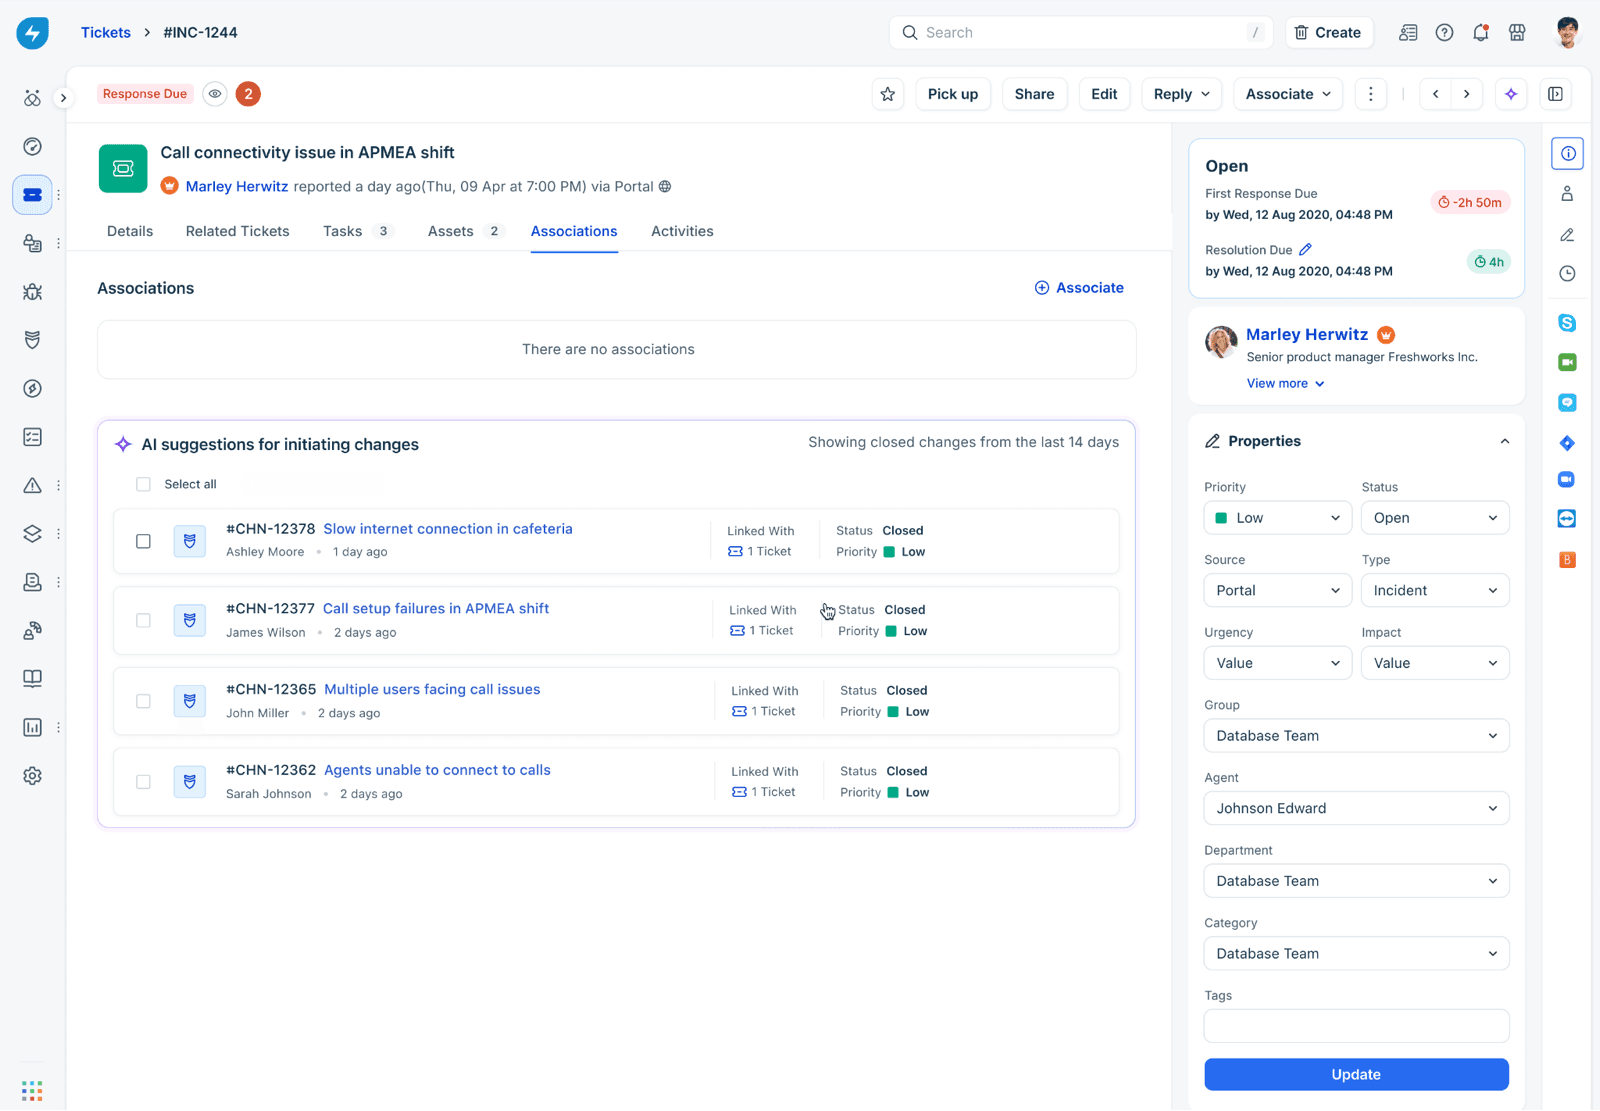
La ventana de 14 días es una barrera razonable. Un cambio del mes pasado rara vez es la causa de los tickets de esta mañana, y una IA que lo sugiere de todos modos solo añade ruido.
¿Qué herramientas ITSM tienen IA para la gestión de cambios?
ServiceNow tiene el conjunto más profundo, Jira Service Management tiene la evaluación de riesgo mejor documentada y Freshservice tiene el vínculo más fuerte del incidente de vuelta al cambio. Una IA del lado del helpdesk como eesel cubre la oleada de tickets y las conversaciones con los solicitantes, sea cual sea el ITSM que guarde el registro del cambio. Así se comparan en los detalles que un comprador realmente revisa:
| ServiceNow | Jira Service Management | Freshservice | eesel (capa de helpdesk) | |
|---|---|---|---|---|
| Gestión de cambios en el plan | ITSM Advanced y superiores | Premium y Enterprise | Pro y Enterprise | Funciona junto a tu ITSM |
| Precio publicado | Solo bajo presupuesto | Premium $55.28/agente/mes | Pro $99/agente/mes (anual) | Desde $299/mes por 500 créditos |
| Coste de la IA | AI Agents for ITSM listado en Prime | Créditos de Rovo incluidos por usuario | Complemento Copilot $29/agente/mes | Incluido, 1 crédito por ticket |
| Revisión de calidad de la solicitud | Sí, evaluador de 5 áreas | Parcial (comprueba planes de pruebas y reversión) | No | En la conversación, desde tu documento de política |
| Puntuación de riesgo | Puntuación basada en reglas, la IA la explica | Calificación de IA Baja/Media/Alta | Política basada en reglas | No |
| Ayuda con conflictos y programación | Evaluador de conflictos, agente de programación | Conflictos de calendario (acceso anticipado) | Calendario de cambios (sin IA) | No |
| Vínculo incidente-cambio | La explicación de riesgo cita incidentes pasados | Comprueba incidentes abiertos en el servicio | Sugeridor de cambio iniciador (acceso anticipado) | Búsqueda JQL y nota interna en los tickets nuevos |
| Aprueba cambios | No, decide el responsable del CAB | No, deciden los aprobadores | No, votación del CAB | No, las acciones de escritura pueden requerir aprobación |
| Respuesta de estado a los usuarios afectados | No cubierto aquí | No cubierto aquí | No cubierto aquí | Redacta y envía, o retiene para aprobación |
Fuentes: paquetes ITSM de ServiceNow, precios de Atlassian y precios de Freshservice. La página de Atlassian tiene un selector de tamaño de equipo y facturación, así que consulta la cifra actual para tu número de puestos.
ServiceNow Otto (Now Assist) para ITSM
La documentación de ServiceNow ahora llama a su app de IA generativa "ServiceNow Otto for IT Service Management", mientras que la página de precios sigue diciendo Now Assist. Lista ocho flujos de trabajo agénticos de cambios, incluidos evaluación de conflictos, evaluación de calidad, programación, sugerencias de CI y creación conversacional de cambios.
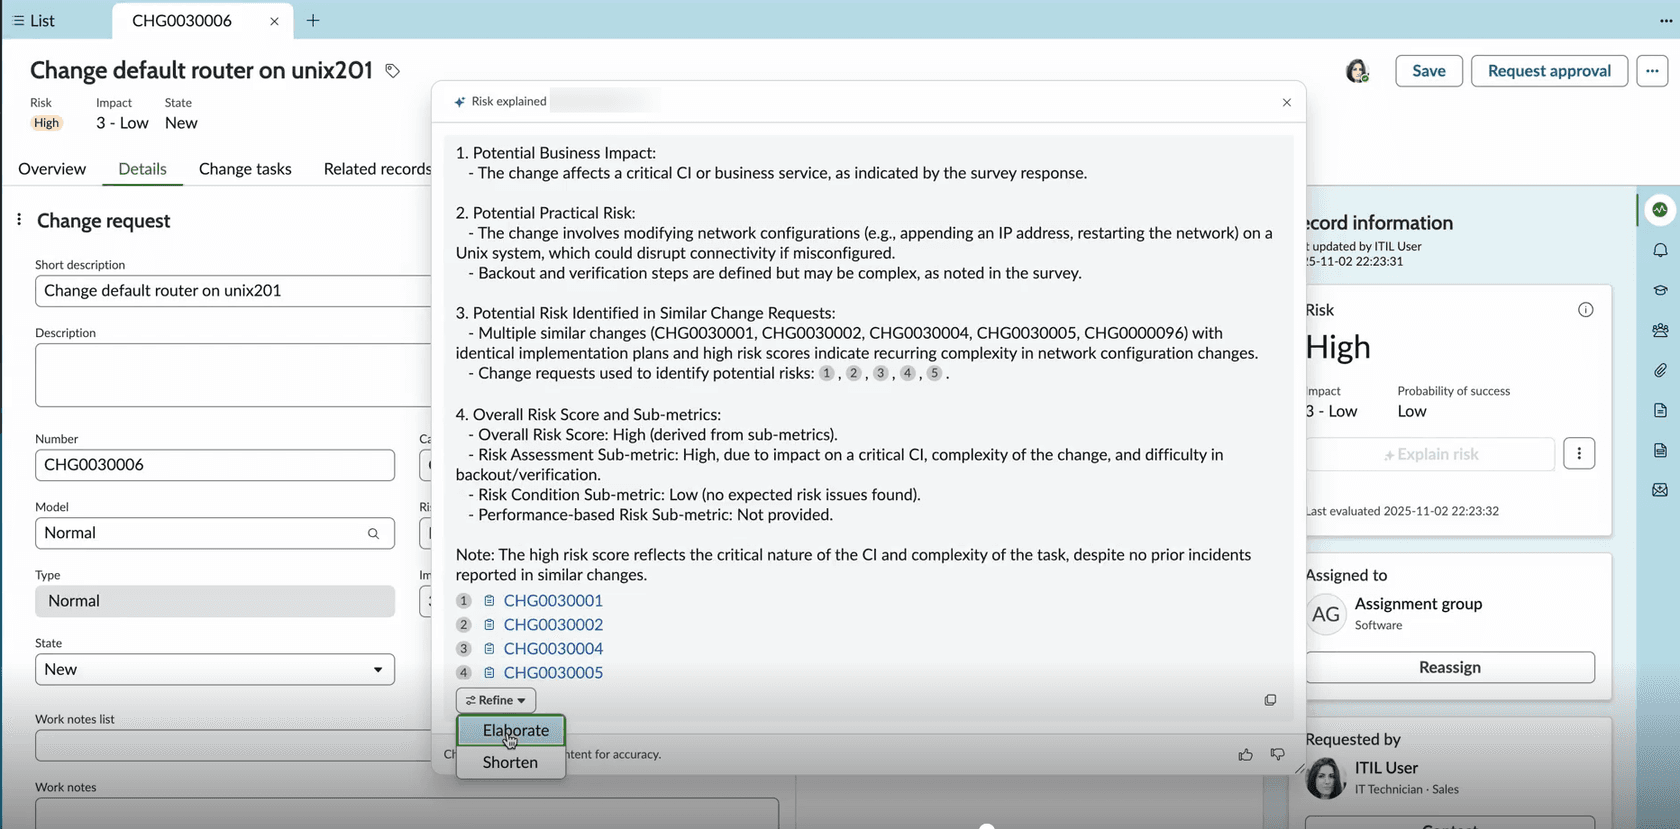
Lo que me gusta: las salvaguardas son explícitas. Por defecto, todos los registros de flujos de trabajo de agentes son de solo lectura, y ejecutar uno por su cuenta implica duplicarlo, activarlo y darle un disparador. Los agentes de conflictos, calidad y programación se invocan a mano. Lo que hay que prever: Change Management no está en el paquete Foundation y la línea "AI Agents for ITSM" aparece solo en Prime, así que cuenta con una conversación para pedir presupuesto. La opinión de los profesionales es mixta: una respuesta en r/servicenow calificó la IA de "más discurso comercial que realidad" y otra espera que sea decente dentro de un año. Los detalles de costes están en nuestro desglose de precios de ServiceNow.
Nuestra opinión: elígelo si ya estás en ServiceNow ITSM Advanced o Prime y tu CMDB está en buen estado. Solo el evaluador de calidad ya vale la pena activarlo.
Jira Service Management con Rovo
La evaluación de riesgo con IA de Atlassian, impulsada por Rovo (el agente detrás ahora se llama Ops Expert), lee artículos vinculados de la base de conocimiento, URLs en la descripción del cambio y pipelines de despliegue conectados. Divide el riesgo en dimensiones técnicas y operativas y sugiere mitigaciones; al aceptar una se crea una tarea de seguimiento vinculada al cambio.
Lo que me gusta: puede ejecutar un análisis estático básico de código en los pull requests vinculados, lo cual es una ventaja real para equipos donde los cambios son despliegues. El control de despliegues puede pausar un pipeline de Bitbucket o Jenkins hasta que se apruebe el cambio. Lo que hay que prever: todas las funciones de cambios están en Premium o Enterprise desde el 16 de octubre de 2024, no cumple con HIPAA y el resultado varía por usuario según los permisos. Consulta la IA de Jira Service Management y Rovo para ver el panorama completo.
Nuestra opinión: el mejor encaje para equipos donde la mayoría de los cambios vienen de CI/CD. Si estás en Standard, la evaluación de riesgo con IA es una razón para cotizar Premium, no para cambiar de herramienta.
Freshservice con Freddy AI
La IA de cambios de Freshservice trata del historial más que de la predicción. El sugeridor de cambios similares muestra cambios coincidentes de hasta 6 meses atrás, con el nivel de riesgo de cada uno y a cuántos incidentes se vinculó.
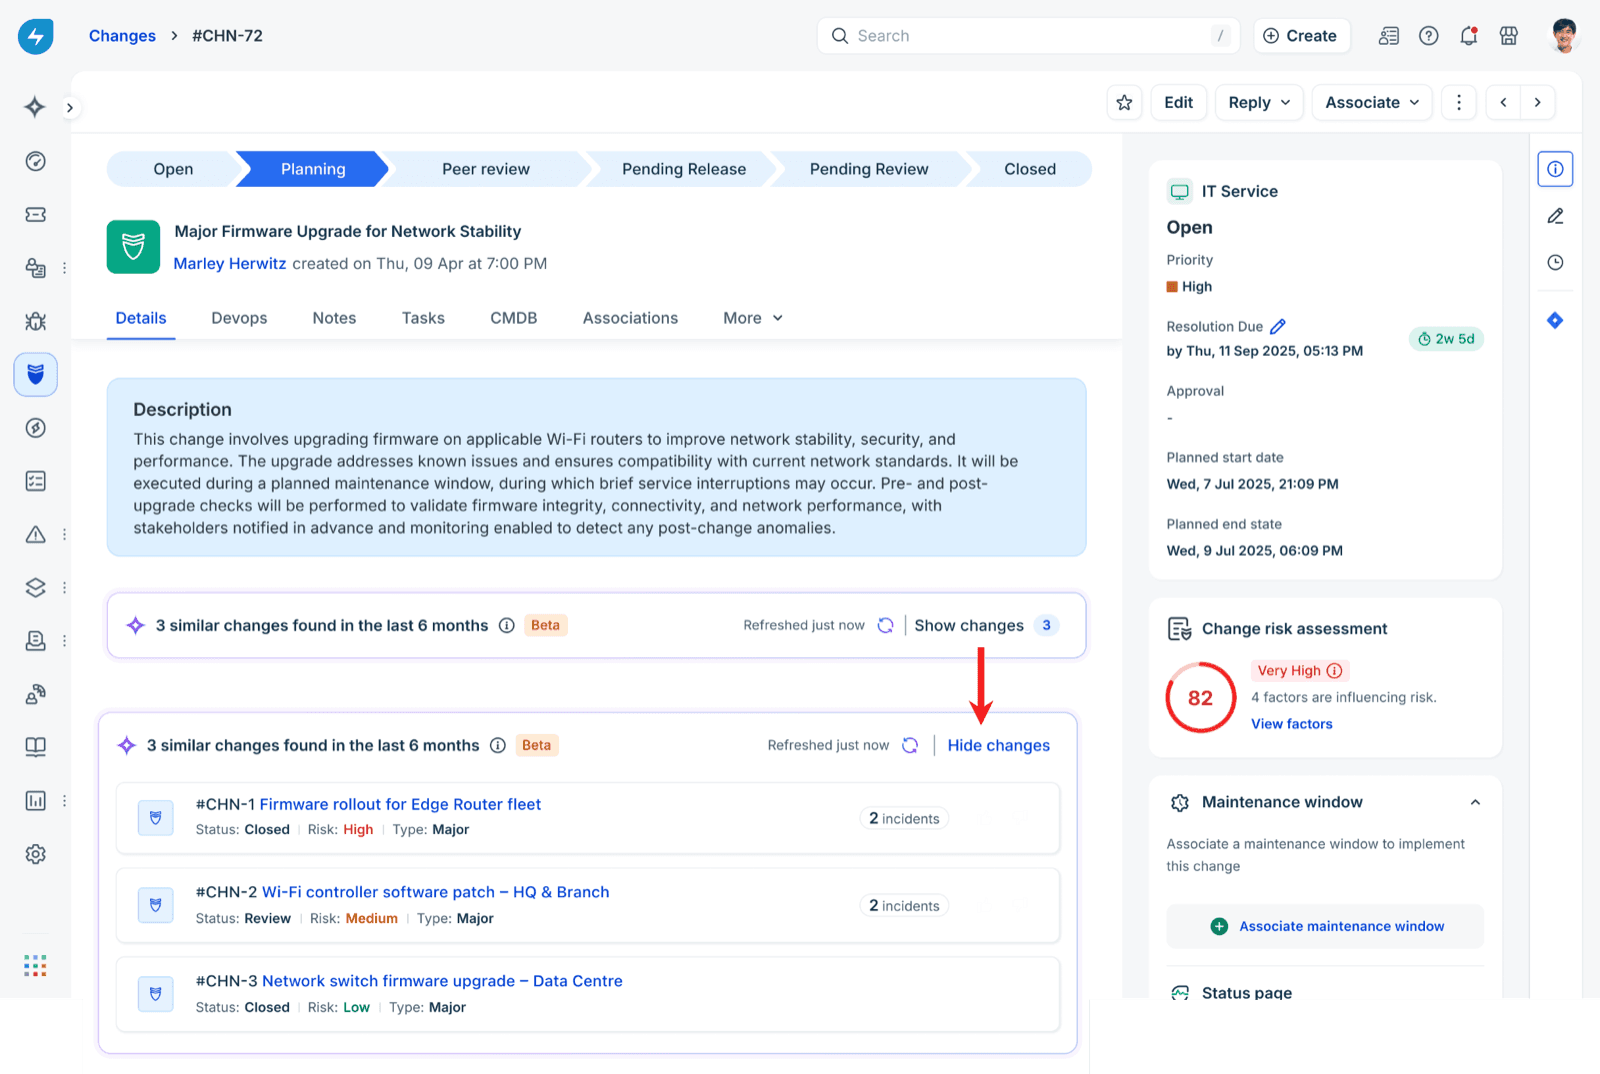
Lo que me gusta: "este mismo cambio causó 2 incidentes la última vez" es lo más persuasivo que puedes poner delante de un aprobador, y está en el propio registro del cambio. Lo que hay que prever: la puntuación de riesgo se basa en reglas, un generador de encuestas de riesgo con IA figura para una versión futura y no está disponible, y ambas funciones de IA para cambios necesitan el complemento Copilot. ¿Comparando plataformas? Mira Freshservice vs ServiceNow y Freshservice vs Jira Service Management.
Nuestra opinión: sólido para equipos de TI medianos que ya pagan por Pro. Activa el sugeridor de cambio iniciador en cuanto tu CSM pueda habilitarlo.
eesel en el lado del service desk
eesel no es un ITSM y no guarda tu registro de cambios. Es un compañero de IA que se une a la cola de tu helpdesk, así que su trabajo en la gestión de cambios está del lado de los tickets: responder a quienes preguntan cómo registrar un cambio, atender la oleada de tickets posterior a uno y mantener informado al responsable del cambio. Se conecta de forma nativa con Jira Service Management y Zendesk. En JSM recoge solicitudes y comentarios nuevos, responde o deja una nota interna, y puede buscar issues con JQL, etiquetarlos, asignarlos y moverlos por el flujo de trabajo. Lee los issues en vivo en lugar de aprender de tu historial de Jira, y su conocimiento proviene de fuentes como Confluence.
Para ServiceNow o Freshservice no hay conector integrado. La vía es la API de la herramienta a través de Network Access, o un servidor MCP si tienes uno, así que prepárate para configurarlo tú mismo. Más sobre esto en IA para herramientas ITSM.
Nuestra opinión: añádelo cuando el dolor esté en el service desk, no en el CAB. Se cobra por ticket atendido, no por puesto de agente.
¿Cómo configuro la IA para la gestión de cambios?
Empieza por el paso más barato y seguro y avanza hacia fuera. Este es el orden que seguiría en un equipo de TI interno típico, y corresponde al orden en que debería crecer tu confianza en la IA:
- Escribe tu política de cambios. Un solo documento: qué necesita cada tipo de cambio, cómo es un buen plan de reversión, quién aprueba qué, cuándo son las ventanas de congelación. El evaluador de calidad de ServiceNow lee primero un documento de política, y cualquier otra IA también funciona mejor con uno. Ponlo donde tu IA pueda leerlo, como Confluence o Google Drive.
- Activa la revisión de completitud, en modo sugerencia. Deja que la IA señale huecos en las solicitudes nuevas durante unas semanas sin bloquear nada. Cuenta con qué frecuencia una persona coincide con ella.
- Vincula los cambios con servicios y fechas. La detección de conflictos, el cruce de cambios similares y el vínculo de tickets posteriores al cambio dependen de ello. Es el paso poco glamuroso que hace funcionar el resto.
- Conecta el service desk con el registro de cambios. Sea el sugeridor de Freshservice, una búsqueda JQL en JSM o un agente de helpdesk, el objetivo es el mismo: que un incidente nuevo se compare con los cambios recientes en ese servicio. Pruébalo primero con tickets antiguos; yo ejecutaría una simulación con tickets pasados de tu último mal cambio antes de confiar en él en vivo.
- Mantén las acciones de escritura tras una aprobación. Cualquier cosa que envíe un mensaje a todos, cambie el estado de un ticket o toque el registro del cambio debería pedir permiso a una persona hasta que hayas visto que acierta durante un tiempo. En eesel cada acción se ejecuta por sí sola, pregunta antes o queda desactivada, y las aprobaciones pueden llegar como una tarjeta en Slack.
- Trata las instrucciones de la IA también como un cambio. Si las reglas del agente cambian cómo se gestionan los tickets, versiónalas y despliégalas como cualquier otro cambio. Swiftreg mantiene sus instrucciones de eesel como versiones numeradas desplegadas mediante su propio procedimiento en lugar de editarlas en vivo, que es justo el hábito que quieres de un equipo de TI.
- Mide tres números. Solicitudes incompletas devueltas, tasa de fallo de cambios (definición de DORA: despliegues que necesitan un hotfix o un rollback) y tickets por cambio fallido. Si baja el tercer número y nadie persigue planes de reversión en el CAB, funciona. Una configuración de informes de soporte hace fácil sacar el tercero.

¿Qué no debería hacer nunca la IA en la gestión de cambios?
Mantén esta lista corta y aplícala en los permisos de la herramienta, no solo en un prompt:
- Aprobar o rechazar un cambio normal o de emergencia. Ninguno de los tres grandes ITSM lo permite, y no deberías construir un atajo.
- Ejecutar el cambio. Las sugerencias de programación están bien; tocar producción, no.
- Declarar la causa de un incidente. Puede nombrar el cambio probable. Una persona lo confirma.
- Cerrar tickets como resueltos porque se hizo un rollback. Compruébalo con el solicitante; un rollback puede arreglar el servicio y dejar roto el estado de un usuario.
- Editar por su cuenta los planes del registro del cambio. El agente autónomo de calidad de ServiceNow es un buen modelo aquí: guarda su puntuación y sus notas "sin establecer valores en los campos de la solicitud de cambio".
El hilo común es la responsabilidad. Si algo sale mal, la revisión posterior al incidente necesita una persona concreta que decidió, y "lo aprobó la IA" no es una respuesta que tus auditores vayan a aceptar. Para profundizar en los niveles de acceso, consulta la guía de revisión de seguridad de la IA.
Prueba eesel en tu service desk de TI
Si los cambios llegan a tu service desk como una pila de tickets confusos, eesel puede sentarse en esa cola como un compañero. En Jira Service Management busca cambios recientes en el servicio afectado, deja una nota interna con la clave del cambio probable en cada ticket nuevo y redacta una respuesta de estado para que la apruebe una persona. También responde "¿cómo registro un cambio?" en Slack desde tu propia política. InDebted lo ejecuta como primer respondedor en un desk interno de JSM y logra que resuelva el 15% de los tickets por sí solo, con un 55% como meta. En Zendesk, Cactus Club Cafe lo usa en soporte técnico interno, donde redactó 790 respuestas en un mes siguiendo paso a paso los runbooks del equipo.
Hay un plan gratuito con 100 créditos, y los planes de pago empiezan en $299 al mes por 500 créditos, sin tarifa por puesto. Prueba eesel con los tickets de cambios del mes pasado y mira qué habría señalado.