Die 6 besten GLM-5.3-Flash-Alternativen 2026

Rama Adi

Katelin Teen
Zuletzt bearbeitet August 29, 2026
GLM-5.3-Flash ist das günstige, nativ multimodale Open-Weight-Modell von Z.ai und ein wirklich starker Standard: etwa $0.075/$0.25 pro 1M Token in der Einführungsaktion, ein Kontextfenster von 1M Token und ein Artificial Analysis Intelligence Index von 57 bei rund $0.045 pro Aufgabe. Die meisten Teams, die sich nach Alternativen umsehen, wollen eines von drei Dingen: schnellere Antworten, vollständig offene Gewichte zum Selbsthosten oder ein größeres Anbieter-Ökosystem.
Hier die Kurzfassung, zu wem du greifen solltest:
- Schnellstes geschlossenes Modell: Gemini 3.7 Flash, etwa 340 Token/Sek., aber sein Listenpreis verdoppelt sich im Januar 2027.
- Günstigste offene Gewichte: DeepSeek V4 Flash, MIT-lizenziert und fast kostenlos selbst zu hosten, aber nur Text.
- Absolute Geschwindigkeits- und Preisuntergrenze: Gemini 3.5 Flash-Lite für $0.30/$2.50.
- Ökosystem einer großen Marke: GPT-5.6 Luna für $0.20/$1.20, mit dem breitesten Tooling.
- Am günstigsten bei kleinen Prompts: Qwen 3.7 Flash, wenn deine Aufrufe unter 32K Token bleiben.
- Offene Gewichte plus natives Bildverständnis: Kimi K3, bei den Fähigkeiten der nächste Treffer zu GLM, aber mit Flaggschiff-Preis von $3/$15.
Eines vorab, aus Jahren mit KI in Live-Support-Warteschlangen: Das Modell ist die günstigste und einfachste Schicht zum Austauschen. Wenn du eines wählst, um echte Kundentickets zu lösen, zählt die Qualität des Schlussfolgerns weit weniger als das Retrieval, die Leitplanken und die Tests, die du darum herum baust. Das entscheidet, ob der Bot hilfreich oder selbstsicher falsch ist.
Warum überhaupt über GLM-5.3-Flash hinausschauen?
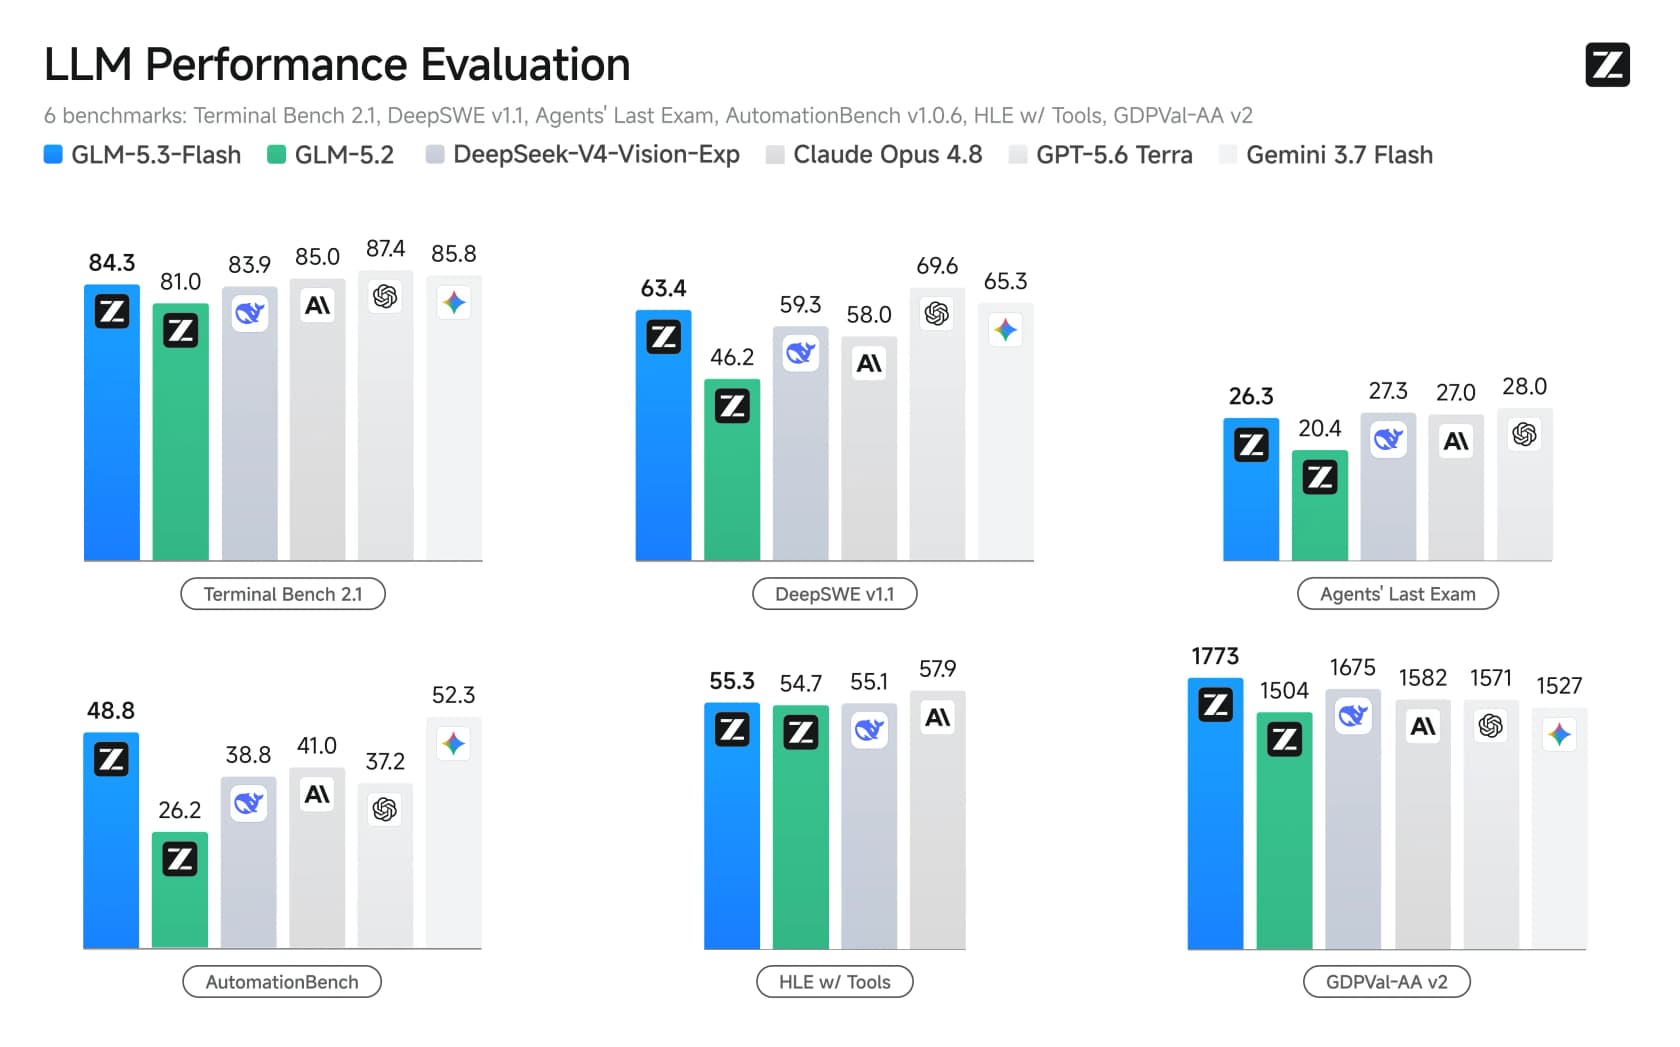
Zuerst fair zum Platzhirsch, denn er hat sich den Benchmark verdient. GLM-5.3-Flash ist ein Mixture-of-Experts-Modell mit 320B Parametern gesamt / 18B aktiv, das erste nativ multimodale Modell der GLM-5-Serie, mit einem Kontextfenster von 1M Token und offenen Gewichten. Cloudflare formuliert es so: Es schlägt GLM-5.2 in allen Benchmarks "at one-tenth the price, while approaching Claude Opus 4.8 on coding and agentic benchmarks." In sechs Coding- und Agenten-Benchmarks lässt es seinen Vorgänger deutlich hinter sich.
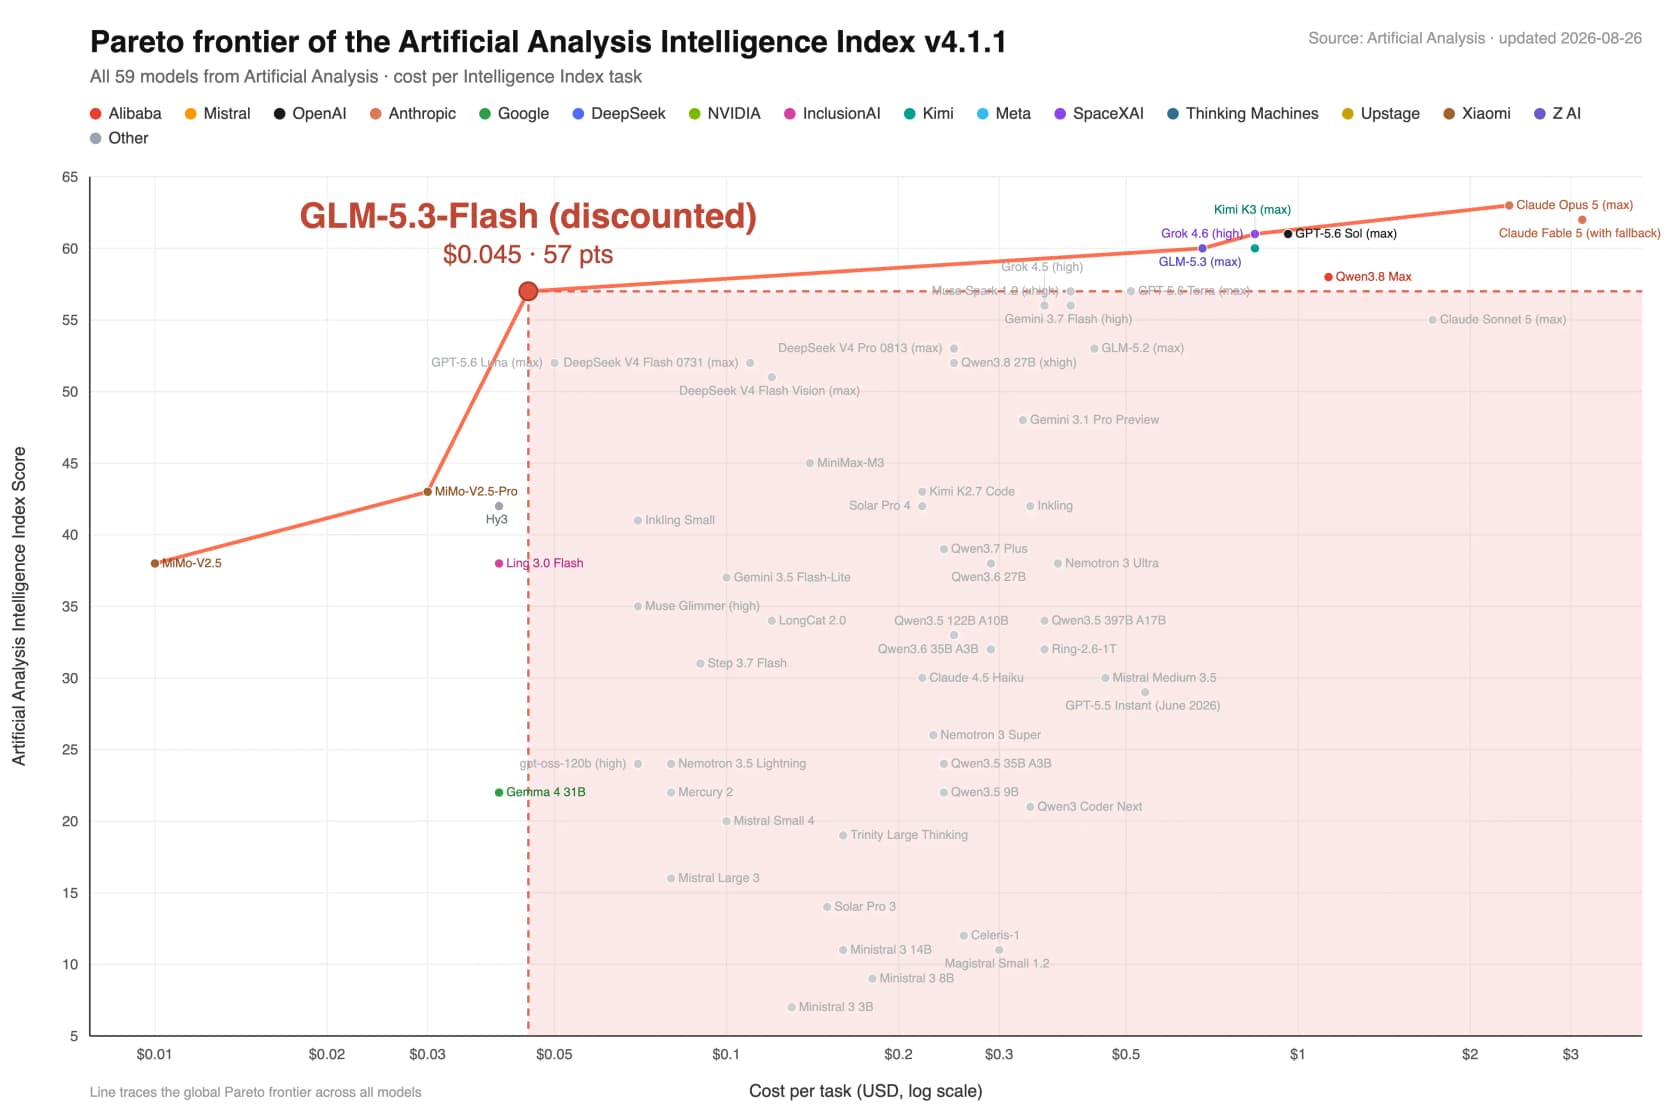
Dass es die ganze Debatte um Preis und Intelligenz angestoßen hat, liegt an diesem Pareto-Diagramm. GLM-5.3-Flash liegt mit etwa $0.045 pro Aufgabe und 57 Punkten auf der Grenze, ein Platz, den kaum etwas anderes besetzt.
Warum schauen sich Leute trotzdem um? Ein paar echte Gründe tauchen immer wieder auf:
- Geschwindigkeit am First-Party-Endpunkt. Auf der eigenen API von Z.ai läuft GLM-5.3-Flash langsam, etwa 49 Token/Sek., und ein r/opencode-Thread nannte es "one of the slowest models AA has ever" gesehen. Drittanbieter-Hosts beheben das (Databricks misst 272,9 t/s), aber dann bindest du dich an einen Reseller.
- Die Datenlage ist dünn. Z.ai veröffentlicht weder einen Auftragsverarbeitungsvertrag noch eine Zero-Retention-Option, und die Daten unterliegen chinesischem Recht. Für regulierte oder kundendatenlastige Workloads ist das ein echtes Hindernis, außer du hostest selbst.
- Die Aktionsuhr. Der Preis von $0.075/$0.25 ist ein Einführungsrabatt, der am 9. September 2026 endet; der Listenpreis ist doppelt so hoch.
- Reine Text-Teams. Wenn du nie mit Bildern arbeitest, sind manche günstigeren oder schnelleren Text-Spezialisten sinnvoller, als für eine multimodale Architektur zu zahlen, die du nicht nutzt.
Nichts davon macht GLM-5.3-Flash zu einem schlechten Modell. Es heißt nur, dass es nicht automatisch für jede Aufgabe das richtige ist. Wenn du die ausführliche Analyse des Modells selbst willst, haben wir sie im GLM-5.3-Flash-Review behandelt.
Wie ich diese Alternativen ausgewählt habe
Ich habe mich an Modelle gehalten, die ein GLM-5.3-Flash-Interessent tatsächlich vergleichen würde: von günstig bis mittelpreisig, schnell und möglichst multimodal oder Open-Weight. Jedes ist nach den Kriterien bewertet, die einen echten Wechsel entscheiden, nicht nur nach einem Schlagzeilen-Benchmark:
- Preis und die echte Rechnung. Listenpreis pro 1M Token, plus die Aufschläge, die ihn aufblähen.
- Geschwindigkeit (Token/Sek. und Zeit bis zum ersten Token).
- Bildverständnis / Multimodalität, denn das ist das Markenzeichen von GLM-5.3-Flash.
- Offene vs. geschlossene Gewichte, für alle, die selbst hosten müssen.
- Kontextfenster und maximale Ausgabe.
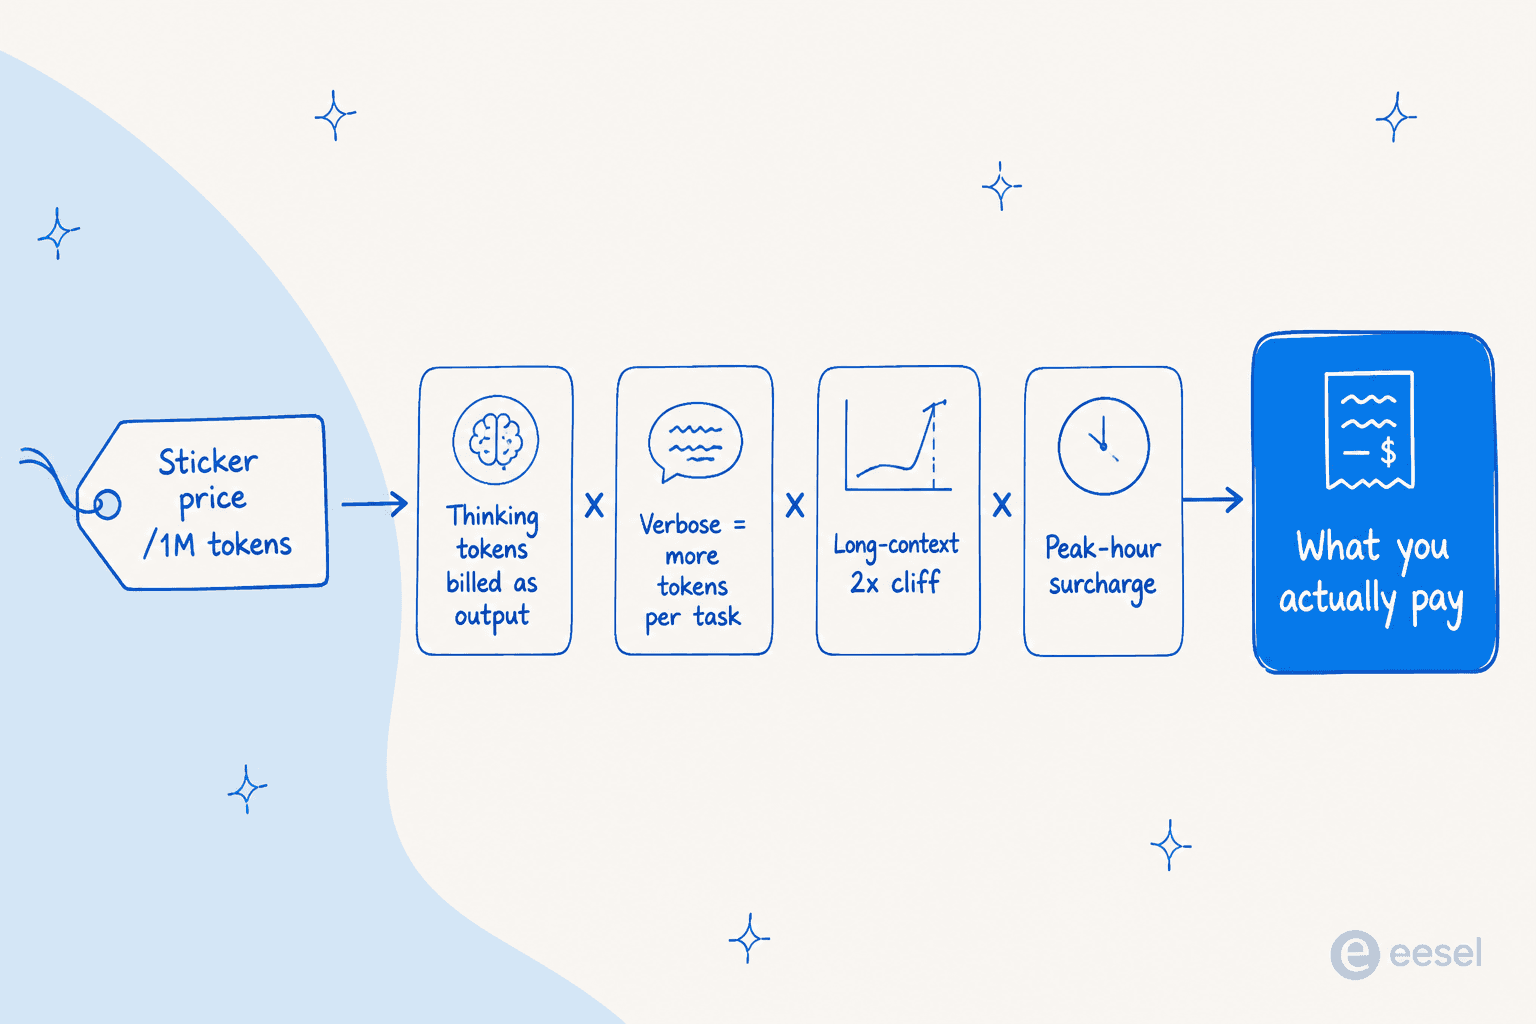
Ein Thema zieht sich durch alles: Der Listenpreis ist nicht die Rechnung. Thinking-Token werden zum Output-Satz abgerechnet, wortreiche Modelle verbrennen mehr Token pro Aufgabe, manche Anbieter berechnen einen Langkontext-Aufschlag, und DeepSeek hat sogar einen Spitzenzeit-Multiplikator. Behalte das bei jeder Zeile der Tabelle unten im Hinterkopf.
So ordnen sich die Optionen auf den beiden Achsen ein, die den meisten wirklich wichtig sind: Preis und ob die Gewichte offen sind.
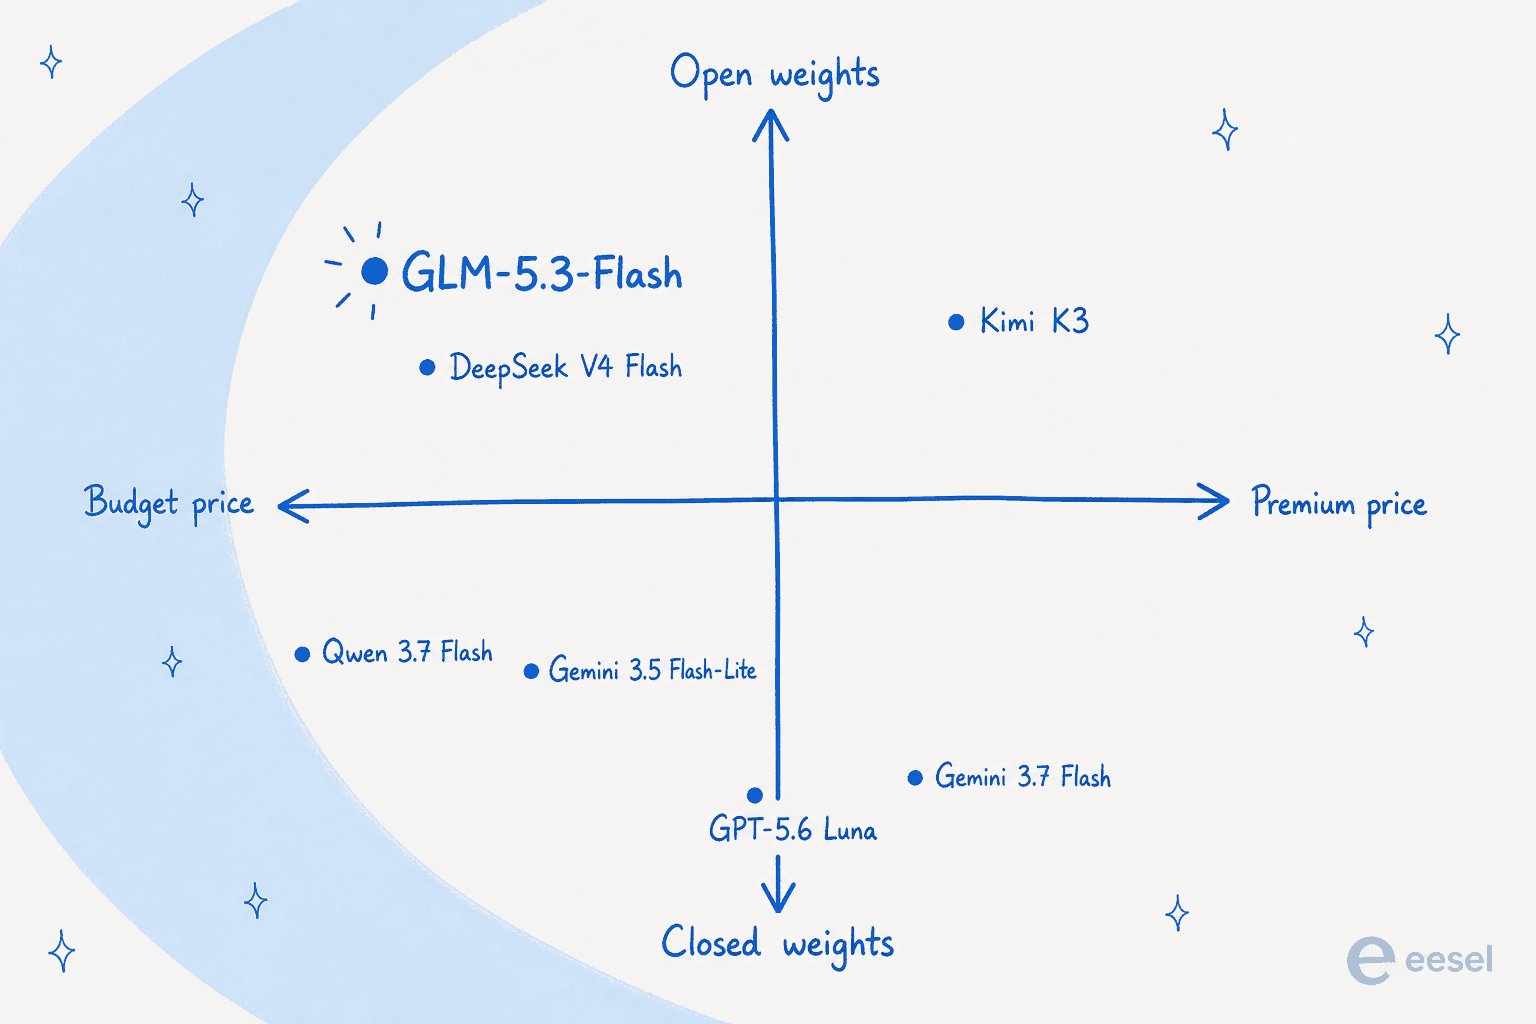
GLM-5.3-Flash-Alternativen auf einen Blick
| Modell | Am besten für | Input / Output (pro 1M) | Kontext | Gewichte | Bildverständnis | Hinweis |
|---|---|---|---|---|---|---|
| GLM-5.3-Flash (Platzhirsch) | Günstig, offen, multimodal | $0.075 / $0.25 (Aktion) | 1M | Offen | Ja | AA-Index 57; Aktion endet am 9. Sep |
| DeepSeek V4 Flash | Günstigste offene Gewichte | $0.22 / $0.66 (außerhalb der Spitzenzeit) | 1M | Offen (MIT) | Nein (Text) | Spitzenzeit-Preise 2x; wortreich |
| Gemini 3.7 Flash | Schnellstes geschlossenes Modell | $0.75 / $3.75 (Aktion) | ~1M | Geschlossen | Ja | ~340 t/s; verdoppelt sich Jan 2027 |
| Gemini 3.5 Flash-Lite | Geschwindigkeits-/Preisuntergrenze | $0.30 / $2.50 | ~1M | Geschlossen | Ja | Schnellste, günstigste Gemini-Stufe |
| GPT-5.6 Luna | Ökosystem einer großen Marke | $0.20 / $1.20 | 1.05M | Geschlossen | Ja (Bildeingabe) | 2x Input über 272K Token |
| Qwen 3.7 Flash | Günstigste kleine Prompts | $0.03-$0.20 / $0.13-$0.80 | 1M | Geschlossen | Ja | Preis gestaffelt nach Prompt-Größe |
| Kimi K3 | Offene Gewichte + natives Bildverständnis | $3.00 / $15.00 | 1M | Offen | Ja (nativ) | Flaggschiff-Klasse, kein Budget |
Nun die Details zu jedem, in der Reihenfolge, in der ich sie in Betracht ziehen würde.
1. DeepSeek V4 Flash
Am besten für: Teams, die offene Gewichte wollen, die sie tatsächlich selbst hosten können, und die niedrigstmögliche Rechnung bei Text-Workloads.
Wenn GLM-5.3-Flash einen echten Rivalen auf der Achse "günstig und offen" hat, dann DeepSeek V4 Flash. Es ist ein MoE mit 284B gesamt / 13B aktiv, veröffentlicht unter einer echten MIT-Lizenz, mit 1M Token Kontext und offenen Gewichten, die auf SGLang oder vLLM laufen. Selbst die Community-Reaktion auf GLM nimmt DeepSeek als Referenzpunkt, etwa mit einer r/opencode-Notiz, dass GLMs "visible context grows half as fast as Deepseek Flash."
Stärken. Die MIT-Lizenz ist der eigentliche Reiz: Du kannst die rund 167GB Gewichte selbst hosten, was deine Grenzkosten Richtung Preis der eigenen GPUs drückt und Kundendaten auf deiner eigenen Infrastruktur hält. Genau hier schmerzt GLMs dünne Datenlage. Bei maximalem Aufwand ist es ein fähiger Reasoner (Artificial Analysis bewertet es mit 50), und auch über die gehostete API ist es wirklich günstig.
Zu beachten. Zwei Dinge. Erstens kann es nur Text, ohne dokumentierte Bildeingabe, es ist also kein Eins-zu-eins-Ersatz, wenn du GLMs Bildverständnis nutzt. Zweitens hat die gehostete Preisgestaltung einen Spitzenzeit-Aufschlag: Cache-Miss-Input kostet $0.22/M außerhalb der Spitzenzeit, aber $0.44/M in den Spitzenzeiten (01:00-04:00 und 06:00-10:00 UTC), mit Output von $0.66, der auf $1.32 steigt. Eine US- oder EU-Support-Warteschlange wird meist außerhalb der Spitzenzeit abgerechnet, was ein Vorteil für dich ist, aber ein fragiler. Außerdem ist es wortreich und verbraucht mehr Output-Token pro Aufgabe als der Klassenmedian.
Preise. Außerhalb der Spitzenzeit $0.22 Input / $0.66 Output pro 1M; in der Spitzenzeit genau das Doppelte. Cache-Treffer sind mit $0.007/M außerhalb der Spitzenzeit fast kostenlos. Alle Zahlen in unserem Beitrag zu den DeepSeek-V4-Flash-Preisen. Es gibt auch ein Text-plus-Bild-Experiment, DeepSeek V4 Flash Vision, falls du die multimodale Lücke schließen willst.
Fazit. Die Wahl, wenn offene Gewichte und Selbsthosting wichtiger sind als Bildverständnis. Wenn du nie Bilder sendest und eigene Inferenz betreiben kannst, schlägt es GLM bei Datenkontrolle und Grenzkosten, und unser DeepSeek-V4-Flash-Review geht auf die Falle der günstigen Konfiguration ein. Wenn du Bildverständnis brauchst oder keine GPUs betreiben willst, lies weiter.
2. Gemini 3.7 Flash
Am besten für: Teams, die das schnellste geschlossene Modell und eine ausgereifte, gut dokumentierte Plattform wollen und einen Preis eines großen Anbieters in Kauf nehmen.
Gemini 3.7 Flash wurde am 13. August 2026 allgemein verfügbar als Googles "most intelligent workhorse model yet for coding and agents." Es ist die naheliegende Wahl, wenn GLMs First-Party-Geschwindigkeit dein Ausschlusskriterium ist.
Stärken. Geschwindigkeit ist die Schlagzeile: Artificial Analysis misst 340,1 Token/Sek., Rang #1 von 188 Modellen. Es ist multimodal, hat etwa 1M Token Kontext und kommt mit Googles Tooling, Grounding und Dokumentation. Pro Aufwandsstufe erreicht low 50,9 im Intelligence Index bei $0.16/Aufgabe und einer Zeit bis zum ersten Token unter einer Sekunde, das liegt innerhalb eines Punkts des älteren 3.6 Flash bei vollem Aufwand. Wenn du den Aufwand herunterregelst, ist es gleichzeitig schnell und günstig.
Zu beachten. Der Preis ist ein Einführungspreis. Er beträgt $0.75/$3.75 pro 1M bis zum 31. Dezember 2026, dann $1.50/$7.50 ab dem 1. Januar 2027 laut Googles Preisseite, eine exakte Verdopplung. Auch die API hat sich stark verändert: temperature, top_p und thinking_budget sind weg, und die günstigste Denkstufe minimal wurde entfernt, die Untergrenze für günstige OCR-/Klassifikationsaufgaben liegt also höher als bei 3.6 Flash. Und die Halluzinationsrate hat sich auf 64,5 % verschlechtert, gegenüber 55,6 % bei 3.6 Flash, was viel ausmacht, wenn du es ungeschützt auf Kunden loslässt.
Preise. $0.75 Input / $3.75 Output pro 1M bis Ende 2026, dann das Doppelte. Batch und Flex sind 50 % günstiger.
Fazit. Die beste Rohgeschwindigkeit hier, auf einer seriösen Plattform. Wähle es, wenn Latenz und Anbieterreife schwerer wiegen als der Preis, und plane die Erhöhung im Januar 2027 jetzt ein, statt davon überrascht zu werden.
3. Gemini 3.5 Flash-Lite
Am besten für: Jobs mit hohem Durchsatz und hohem Volumen, bei denen du das günstigste, schnellste Google-Modell willst und eine niedrigere Obergrenze akzeptierst.
Wenn Gemini 3.7 Flash das Arbeitspferd ist, ist Flash-Lite der Sprinter. Google beschreibt es als "our fastest, most cost-effective 3.5 model for high-throughput execution," und genau diese Nische kann GLM-5.3-Flash mit seinem langsamen First-Party-Endpunkt allein schwer füllen.
Stärken. Es ist die Preis- und Geschwindigkeitsuntergrenze der geschlossenen Optionen mit $0.30/$2.50 pro 1M, läuft mit rund 350+ Token/Sek. und behält dennoch multimodale Eingabe, Computer Use und einen großen Kontext. Für Klassifikation, Routing, Tagging und andere "günstige und schnelle" Massenarbeit ist es schwer zu schlagen, ohne zu Open Source zu wechseln.
Zu beachten. Du tauschst Intelligenz gegen Durchsatz. Im Pareto-Diagramm liegt es im Intelligence Index deutlich unter GLM-5.3-Flash, es ist also nicht das Modell für schwieriges Schlussfolgern oder anspruchsvolle mehrstufige Agentenaufgaben. Es ist ein Spezialist, kein Flaggschiff-Ersatz.
Preise. $0.30 Input / $2.50 Output pro 1M, Batch zum halben Preis.
Fazit. Die richtige Wahl für Pipelines mit hohem Volumen und geringer Komplexität, in denen Geschwindigkeit und Kosten dominieren. Für alles, was GLM-Niveau beim Schlussfolgern braucht, geh wieder auf ein volles Flash-Modell hoch.
4. GPT-5.6 Luna
Am besten für: Teams, die bereits im OpenAI-Ökosystem leben und eine günstige Stufe wollen, ohne es zu verlassen.
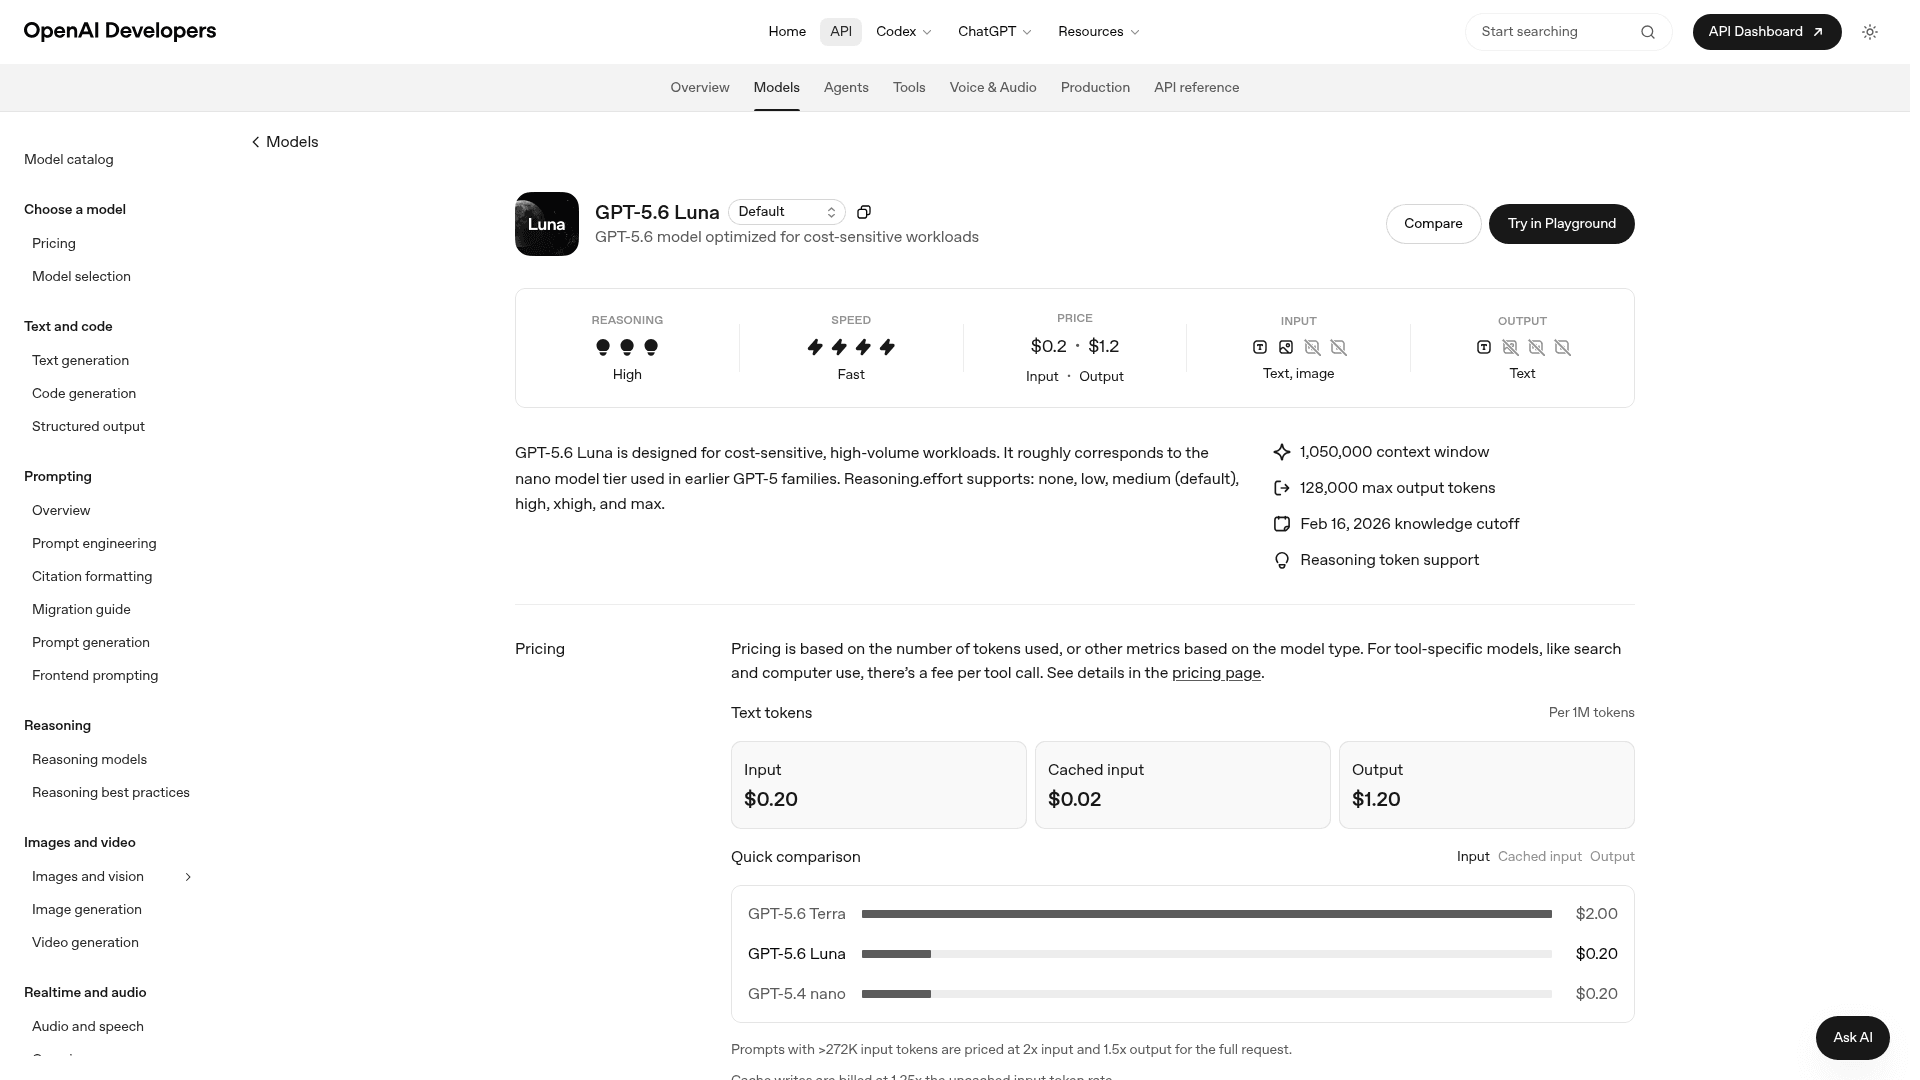
GPT-5.6 Luna ist OpenAIs kostensensible Stufe, "designed for cost-sensitive, high-volume workloads," in etwa der Nano-Platz in früheren GPT-5-Familien. Es ist die Alternative für Teams, denen Ökosystem, Tooling und Support des größten Anbieters wichtiger sind, als den letzten Cent herauszuholen.
Stärken. Mit $0.20/$1.20 pro 1M ist es für ein Modell einer Frontier-Marke günstig, mit einem Kontext von 1.050.000 Token, Bildeingabe und dem vollen reasoning.effort-Bereich von none bis max. Wenn dein Team bereits das OpenAI-SDK, Agents und Tooling nutzt, entfällt durch das Bleiben darin viel Integrationsreibung. Es wirkt wie die sichere, langweilige Wahl, und manchmal ist das genau die richtige.
Zu beachten. Es gibt eine Langkontext-Klippe: Prompts über 272K Input-Token werden für die gesamte Anfrage mit 2x Input und 1,5x Output abgerechnet. "1M Kontext" und "$0.20" können also bei einem sehr langen Prompt nicht beide wahr sein. Außerdem ist es geschlossen, nur Text und Bild (keine offenen Gewichte, kein Selbsthosting), und Luna liegt bei der Rohintelligenz unter GLM-5.3-Flash, da es die Budgetstufe der Familie ist und nicht das Arbeitspferd.
Preise. $0.20 Input / $1.20 Output pro 1M, gecachter Input $0.02, mit dem oben genannten 272K-Aufschlag. Mehr OpenAI-Kontext in unserem GPT-5.6-Review.
Fazit. Am besten, wenn die Anziehungskraft des Ökosystems den Preis pro Token schlägt. Wenn du bereits voll auf OpenAI setzt, ist Luna der reibungsärmste Weg zu einer günstigen Stufe; wenn du rein nach Kosten suchst oder offene Gewichte willst, gewinnen GLM oder DeepSeek.
5. Qwen 3.7 Flash
Am besten für: Vision- oder Textarbeit mit kurzen Prompts und hohem Volumen, bei der deine Aufrufe klein bleiben.
Qwen 3.7 Flash von Alibaba ist das andere günstige chinesische Modell im Feld, und sein Preismodell unterscheidet sich wirklich von allen anderen hier.
Stärken. Bei kleinen Prompts ist es in dieser Übersicht die günstigste Option: $0.03/M Input und $0.13/M Output für Aufrufe unter 32K Token. Es ist ein Vision-Modell mit 1M Token Kontext und deckt GLMs multimodales Terrain auf dem Papier mit niedrigerem Einstiegspreis ab.
Zu beachten. Der Preis ist nach Prompt-Größe gestaffelt, und die beiden Schlagzeilenzahlen schließen sich gegenseitig aus. Über 32K Token springt er auf $0.10/$0.40, und im Bereich 256K-1M liegt er bei $0.20/$0.80, ein Sprung um das 6,7-Fache beim Input. OpenRouters gleitender Mischwert dessen, was Kunden tatsächlich zahlen, liegt bei $0.044/$0.149, über dem Einstiegssatz, was zeigt, dass echter Traffic in die oberen Staffeln fällt. Außerdem hat es geschlossene Gewichte und ist dünn evaluiert: keine veröffentlichten Benchmarks oder Architektur, und die eine unabhängige Auswertung (Roboflow) platziert es insgesamt auf #22 von 23, aber bei den Kosten auf #1. "Flash" heißt hier günstig, nicht schnell, mit rund 59 Token/Sek.
Preise. Gestaffelt: $0.03-$0.20 Input / $0.13-$0.80 Output pro 1M je nach Prompt-Größe. Vollständige Aufschlüsselung in unserem Beitrag zu den Qwen-3.7-Flash-Preisen, und mit Qwen3.8-Max gibt es ein größeres Geschwister, falls du mehr Spielraum brauchst.
Fazit. Ein echtes Schnäppchen, wenn und nur wenn deine Prompts klein bleiben. Modelliere deine tatsächliche Token-Verteilung, bevor du wechselst, denn ein Support-Workload mit langem Kontext kann dich unbemerkt in die teure Staffel bringen. Unser Qwen-3.7-Flash-Review hat mehr dazu.
6. Kimi K3
Am besten für: Teams, die offene Gewichte und natives Bildverständnis wie bei GLM wollen und bereit sind, für eine höhere Obergrenze Flaggschiff-Preise zu zahlen.
Kimi K3 ist das Flaggschiff von Moonshot AI und der nächste Treffer zu GLM-5.3-Flash bei der Kombination "offene Gewichte plus nativ multimodal". Es ist ein MoE mit 2,8T gesamt / 104B aktiv, mit 1M Token Kontext und nativem Bild- und Videoverständnis, und seine Gewichte erschienen planmäßig auf Hugging Face.
Stärken. Die Fähigkeit ist die Geschichte. Es erreicht einen Artificial Analysis Intelligence Index von 57, gleichauf mit GLM-5.3-Flash und auf Platz #4 insgesamt, und es schlägt Opus 4.8 und GPT-5.5 in den meisten Benchmarks. Natives Bildverständnis (Bild und Video) plus offene Gewichte heißt, du kannst selbst hosten und die multimodalen Funktionen behalten, was genau das ist, was GLM bietet, aber mit einer größeren Zahl aktiver Parameter dahinter.
Zu beachten. Der Preis. Mit $3/$15 pro 1M liegt es im Claude-Sonnet-Band, etwa das 50-Fache von GLM-5.3-Flashs Output-Preis. Das Reasoning lässt sich auf keiner Stufe abschalten, und bei low erreicht es einen Index von 47 bei $0.24/Aufgabe, was sowohl schlechter als auch etwa 8x teurer ist als DeepSeek V4 Flash. Außerdem akzeptiert es keine öffentlichen Bild-URLs, nur base64 oder Datei-IDs. Das ist kein Budget-Tausch.
Preise. $3 Input / $15 Output pro 1M, Cache-Treffer $0.30. Siehe unsere Beiträge zu den Kimi-K3-Preisen und den Kimi-K3-Alternativen für das ganze Bild.
Fazit. Das Fähigkeits-Upgrade, nicht die Kostenersparnis. Wähle Kimi K3, wenn du GLMs Form aus offen plus multimodal mit mehr Rohintelligenz willst und Flaggschiff-Preise verkraften kannst. Wenn Kosten der Grund sind, warum du hier bist, ist das die falsche Richtung.
Welche Alternative passt wirklich zu dir?
Tabelle und Quadrant leisten den Großteil der Arbeit, aber die ehrliche Antwort hängt von deiner größten Einschränkung ab. Wähle die wichtigste und sieh, wohin sie zeigt:
Was ist für deinen Workload am wichtigsten?
Was die Modellwahl nicht löst
Das würde ich jedem sagen, der sich mit dieser Tabelle quält, und es kommt aus Jahren mit KI in Live-Support-Warteschlangen: Das Modell auszutauschen sind die einfachen 5 %. Wenn dein Ziel ist, Kundentickets zu beantworten, ist das Modell die unterste Schicht des Stacks, und es ist die Schicht, die sich beim Anbieterwechsel am wenigsten ändert.
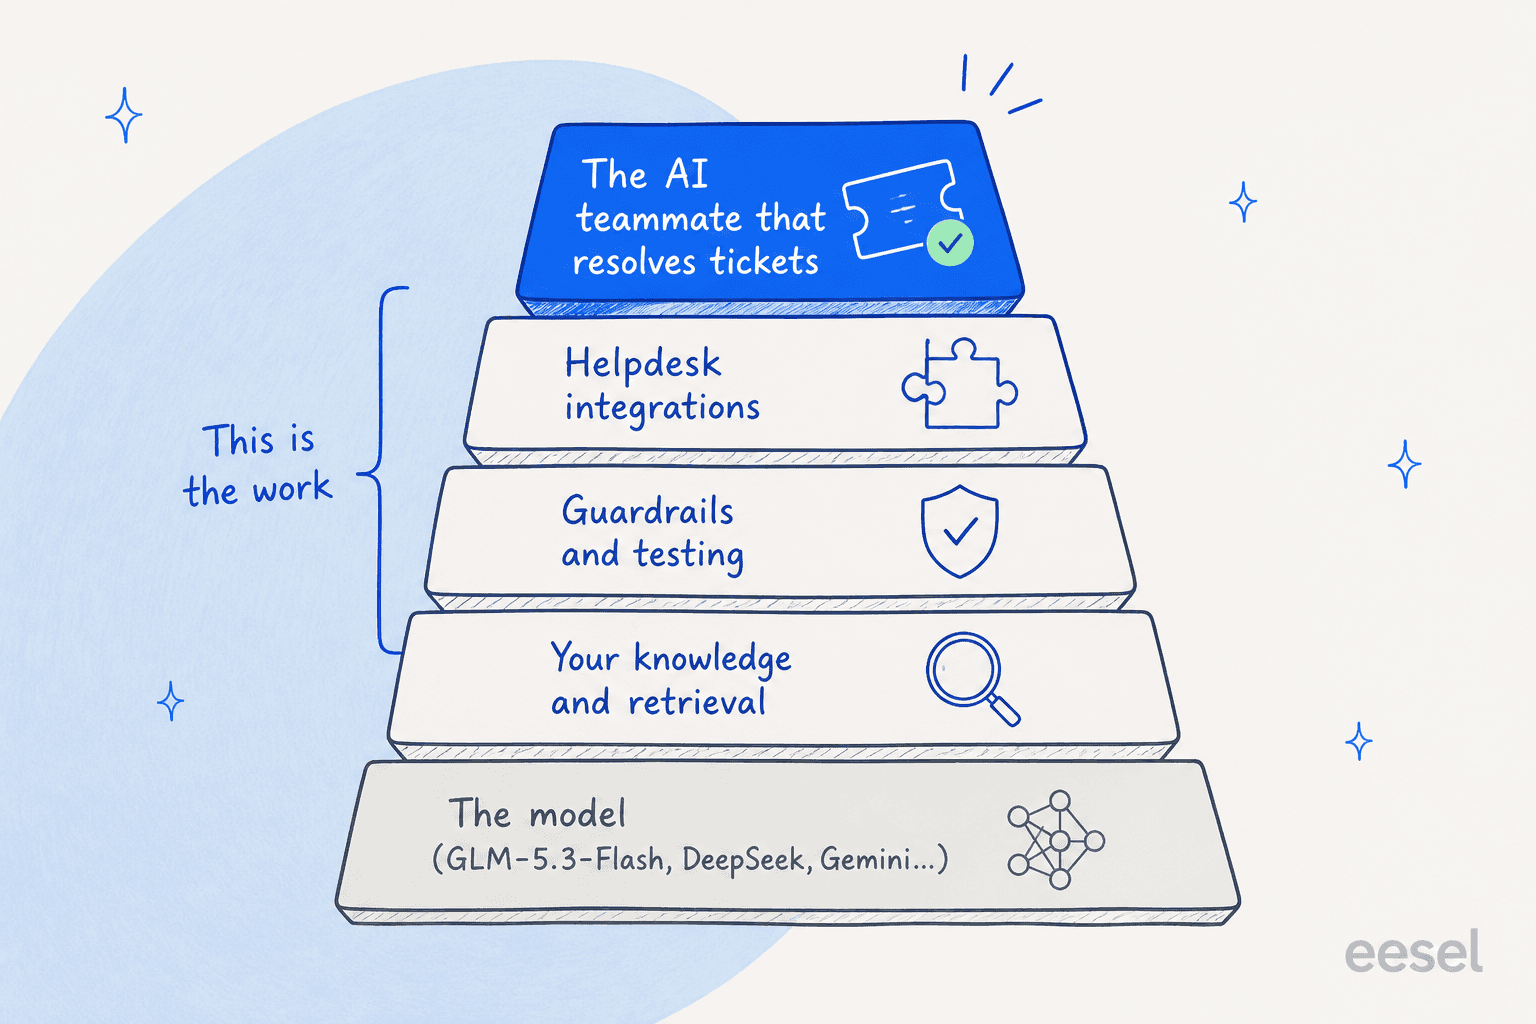
Das ist dieselbe Logik, warum man einen KI-Mitarbeiter einstellt, statt eine rohe API zu mieten, und warum die besten KI-Teammitglieder an Ergebnissen gemessen werden, nicht an Token pro Sekunde. Alles oberhalb des Modells ist die eigentliche Arbeit: deine Wissensdatenbank anbinden, damit Antworten fundiert sind, Leitplanken, damit es weiß, was es nicht sagen darf, Tests, damit du erfährst, wie es sich verhält, bevor es Kunden tun, und Integrationen in deinen Helpdesk, damit es tatsächlich handeln kann. Der Grund, warum ein günstigeres Modell deine Lösungsquote selten bewegt, ist, dass die Lösungsquote in den oberen Schichten liegt, nicht in den Token pro Sekunde.
Hier werden die Halluzinationszahlen von oben auch mehr als eine Randnotiz. Die Halluzinationsrate von 64,5 % bei Gemini 3.7 Flash, oder jedes dieser Modelle, das selbstsicher antwortet, wo es nicht sollte, ist nur dann gefährlich, wenn es ungetestet bei einem Kunden ankommt. Wir haben gesehen, wie selbstsicher klingende Bots leise falsche Antworten gaben, und genau deshalb simulieren wir inzwischen jeden Rollout an den echten historischen Tickets eines Unternehmens, bevor er live geht. Keine noch so gute Wahl des "richtigen" günstigen Modells ersetzt das. Wenn du die Modellsicht speziell für den Support willst, haben wir sie separat im Beitrag zum besten KI-Modell für Support-Tickets aufgeschrieben.
eesel ausprobieren
Wenn du GLM-5.3-Flash-Alternativen vergleichst, um Support-Automatisierung aufzubauen, ist eesel die Schicht, die auf dem Modell deiner Wahl sitzt. Stell dir das Modell als den Motor vor und eesel als das KI-Teammitglied, das du einstellst: Es kommt bereits darauf vorbereitet, sich in Zendesk, Freshdesk oder Gorgias einzuklinken, lernt aus deinen vergangenen Tickets und deinem Help Center und hält sich an die Leitplanken, die du setzt.
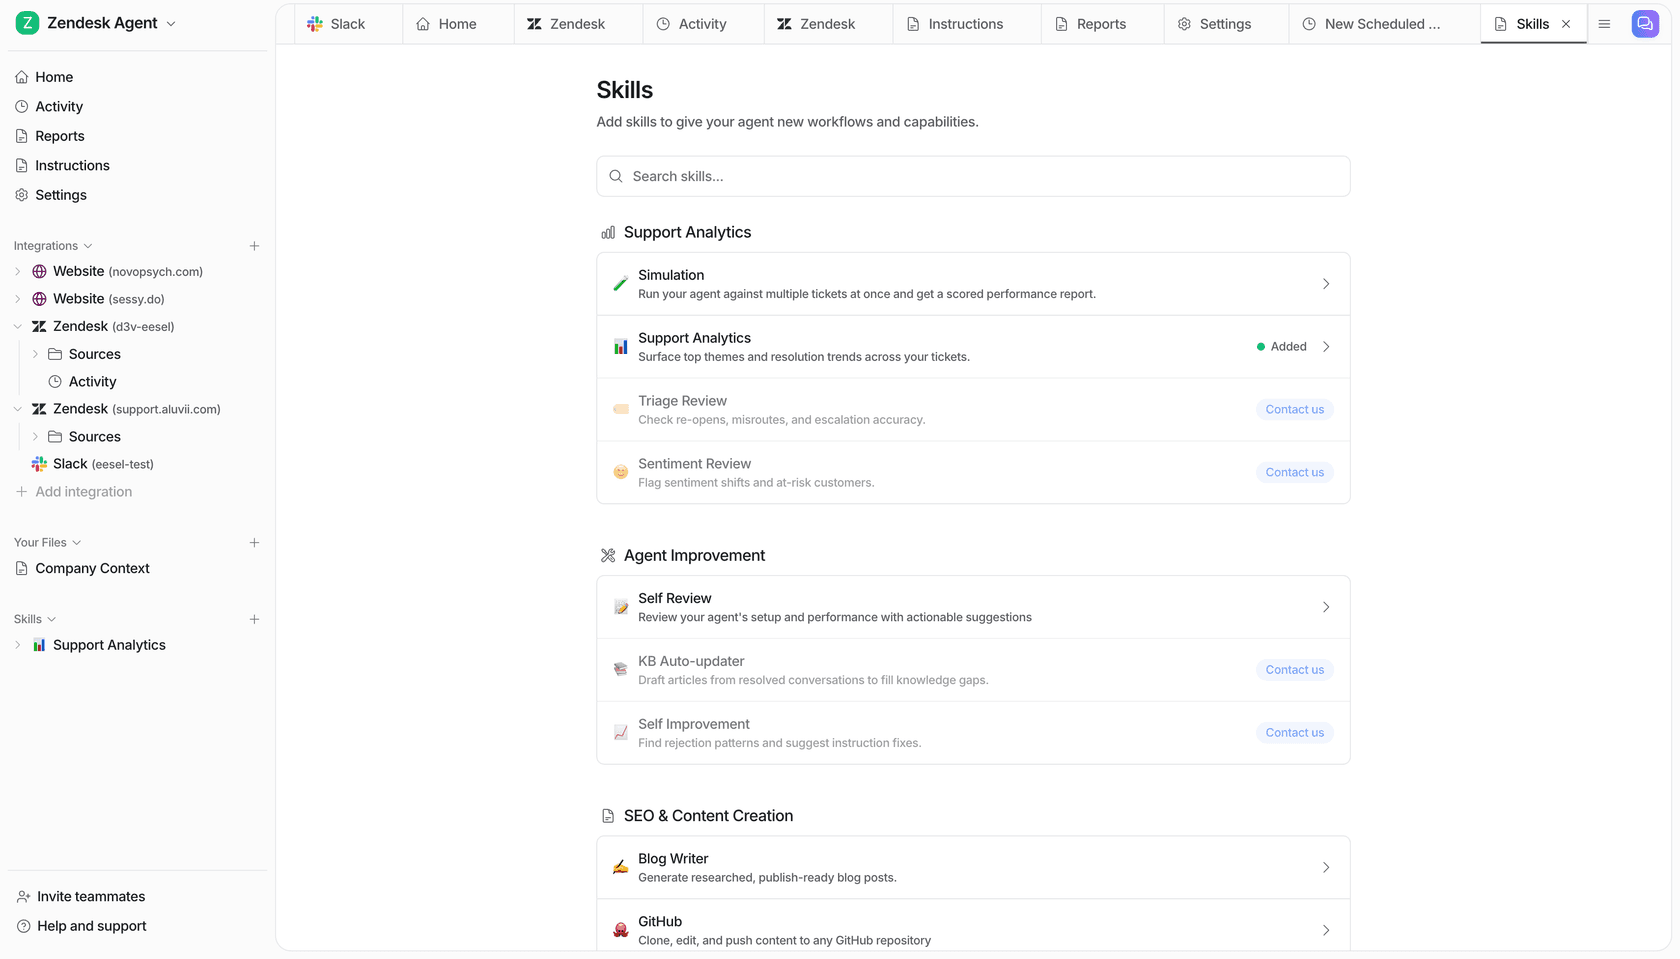
Der Unterschied ist die Simulation: Bevor dein KI-Teammitglied ein einziges Live-Ticket beantwortet, spielt eesel es an Tausenden deiner echten vergangenen Konversationen durch, sodass du die Lösungsquote und die genauen Antworten siehst, die es gesendet hätte, und sie korrigieren kannst, solange das Risiko noch null ist. Das ist die Absicherung, die ein günstiges, fähiges Modell zu einem Support-Agenten macht, dem du wirklich vertrauen kannst. Es ist kostenlos testbar, und du kannst es in wenigen Minuten auf deinen eigenen Helpdesk richten.