As 6 melhores alternativas ao GLM-5.3-Flash em 2026

Rama Adi

Katelin Teen
Última edição August 29, 2026
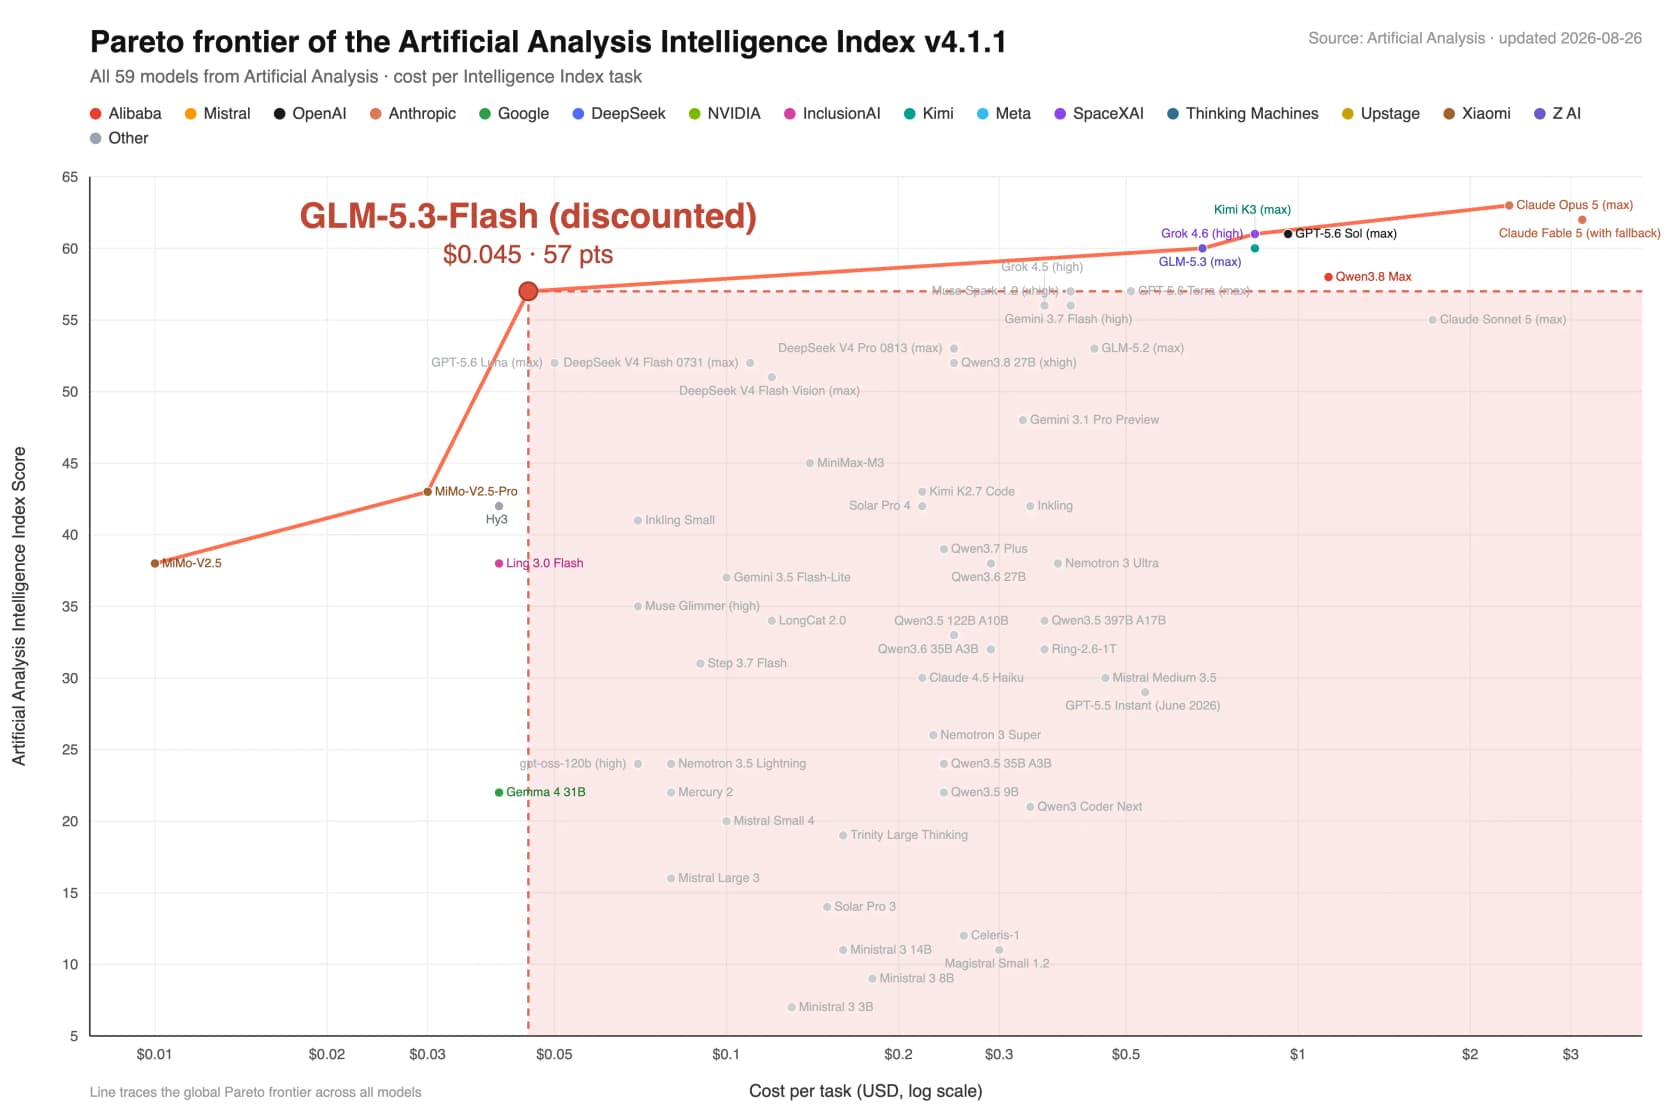
O GLM-5.3-Flash é o modelo barato, nativamente multimodal e de pesos abertos da Z.ai, e é um padrão realmente forte: cerca de $0.075/$0.25 por 1M de tokens na promoção de lançamento, uma janela de contexto de 1M de tokens e um Intelligence Index da Artificial Analysis de 57 a aproximadamente $0.045 por tarefa. A maioria das equipes que olha além dele busca uma de três coisas: respostas mais rápidas, pesos totalmente abertos que possam hospedar ou um ecossistema de fornecedor maior.
Aqui vai a versão curta de quem escolher:
- Modelo fechado mais rápido: Gemini 3.7 Flash, cerca de 340 tokens/seg, mas seu preço de tabela dobra em janeiro de 2027.
- Pesos abertos mais baratos: DeepSeek V4 Flash, com licença MIT e quase de graça para hospedar, embora só trabalhe com texto.
- Piso absoluto de velocidade e preço: Gemini 3.5 Flash-Lite a $0.30/$2.50.
- Ecossistema de uma grande marca: GPT-5.6 Luna a $0.20/$1.20, com as ferramentas mais amplas.
- Mais barato em prompts pequenos: Qwen 3.7 Flash, se suas chamadas ficarem abaixo de 32K tokens.
- Pesos abertos mais visão nativa: Kimi K3, o mais próximo do GLM em capacidade, mas com preço de modelo topo de linha a $3/$15.
Uma coisa que vale dizer logo de início, depois de anos operando IA em filas de suporte reais: o modelo é a camada mais barata e mais fácil de trocar. Se você está escolhendo um para realmente resolver tickets de clientes, a qualidade do raciocínio importa muito menos do que a recuperação, as barreiras de proteção e os testes que você constrói em volta. É isso que decide se o bot é útil ou se está confiantemente errado.
Por que olhar além do GLM-5.3-Flash?
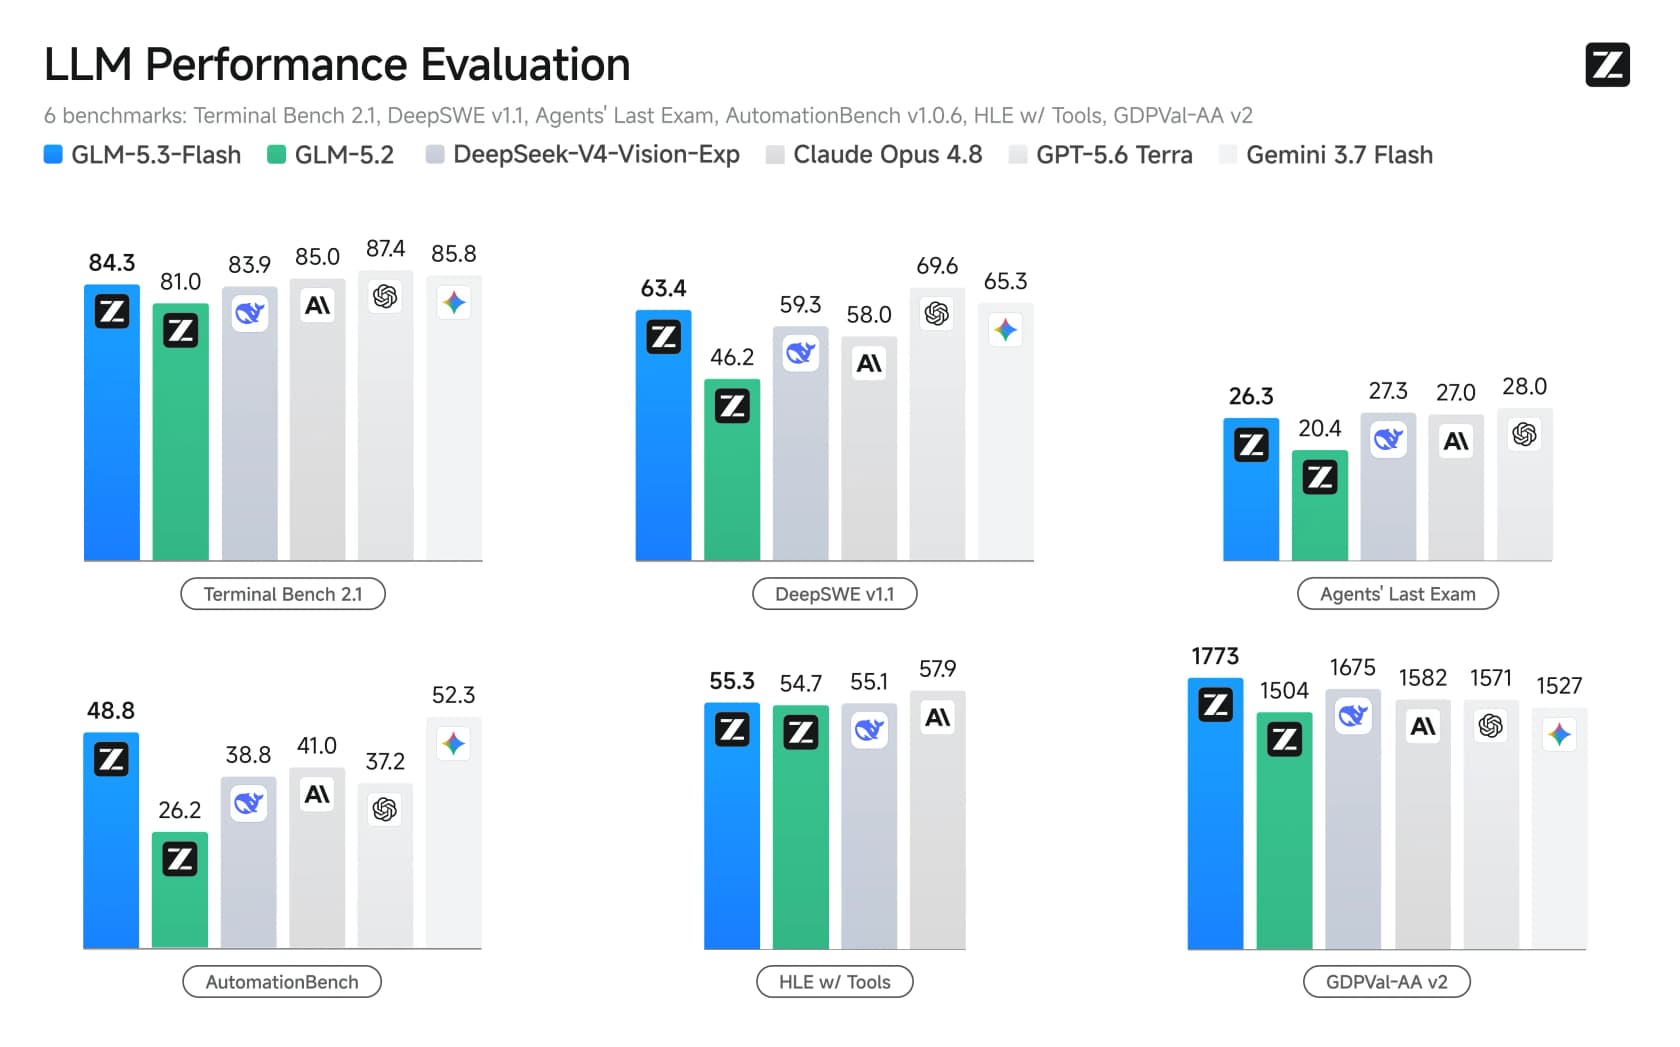
Vamos ser justos primeiro com o favorito, porque ele merece o benchmark. O GLM-5.3-Flash é um modelo de mistura de especialistas com 320B totais / 18B ativos, o primeiro modelo nativamente multimodal da série GLM-5, com janela de contexto de 1M de tokens e pesos abertos. O enquadramento da Cloudflare é que ele supera o GLM-5.2 em todos os benchmarks "at one-tenth the price, while approaching Claude Opus 4.8 on coding and agentic benchmarks." Em seis benchmarks de programação e agentes, ele supera com folga o antecessor.
A razão pela qual ele moveu toda a conversa sobre preço e inteligência é este gráfico de Pareto. O GLM-5.3-Flash fica na fronteira com cerca de $0.045 por tarefa e 57 pontos, um lugar que quase nada mais ocupa.
Então por que as pessoas ainda pesquisam? Algumas razões reais aparecem repetidamente:
- Velocidade, no endpoint do próprio fornecedor. Na API da própria Z.ai, o GLM-5.3-Flash roda lento, cerca de 49 tokens/seg, e um tópico no r/opencode o chamou de "one of the slowest models AA has ever" visto. Hosts de terceiros resolvem isso (a Databricks mede 272.9 t/s), mas isso significa se comprometer com um revendedor.
- A história dos dados é fraca. A Z.ai não publica DPA nem opção de retenção zero, e os dados ficam sob a lei da RPC. Para cargas regulamentadas ou com dados de clientes, isso é um bloqueio real, a menos que você hospede por conta própria.
- O relógio da promoção. A tarifa de $0.075/$0.25 é um desconto de lançamento que termina em 9 de setembro de 2026; o preço de tabela é o dobro.
- Equipes só de texto. Se você nunca trabalha com imagens, alguns especialistas em texto mais baratos ou rápidos fazem mais sentido do que pagar por uma arquitetura multimodal que você não vai usar.
Nada disso faz do GLM-5.3-Flash um modelo ruim. Significa apenas que ele não é automaticamente o certo para todo trabalho. Se você quer a análise detalhada do modelo em si, cobrimos isso na análise do GLM-5.3-Flash.
Como escolhi essas alternativas
Fiquei com modelos que alguém interessado no GLM-5.3-Flash realmente compararia: de baratos a intermediários, rápidos e, de preferência, multimodais ou de pesos abertos. Cada um é pontuado nas dimensões que decidem uma troca real, não só em um benchmark de manchete:
- Preço e a conta real. Preço de tabela por 1M de tokens, mais os acréscimos que o inflam.
- Velocidade (tokens/seg e tempo até o primeiro token).
- Visão / suporte multimodal, já que essa é a marca registrada do GLM-5.3-Flash.
- Pesos abertos vs. fechados, para quem precisa hospedar por conta própria.
- Janela de contexto e saída máxima.
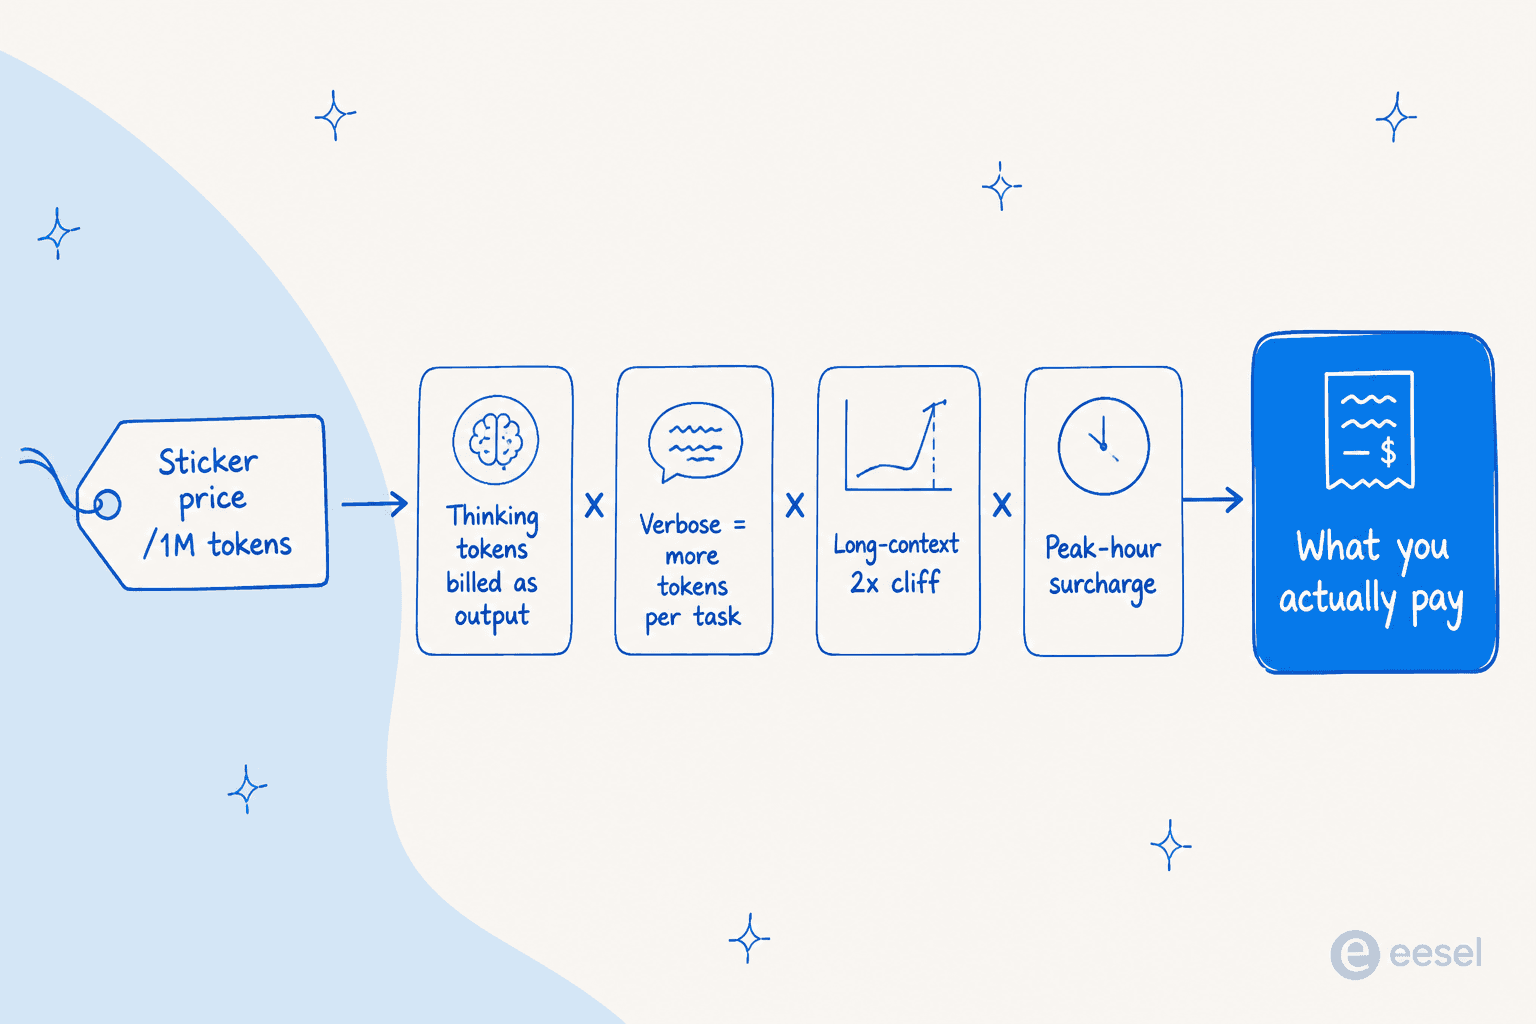
Um tema atravessa tudo: o preço de tabela não é a conta. Tokens de raciocínio são cobrados na tarifa de saída, modelos prolixos queimam mais tokens por tarefa, alguns fornecedores cobram um acréscimo por contexto longo, e a DeepSeek tem até um multiplicador de horário de pico. Tenha isso em mente em cada linha da tabela abaixo.
Veja onde cada opção se situa nos dois eixos que mais importam para a maioria: preço e se os pesos são abertos.
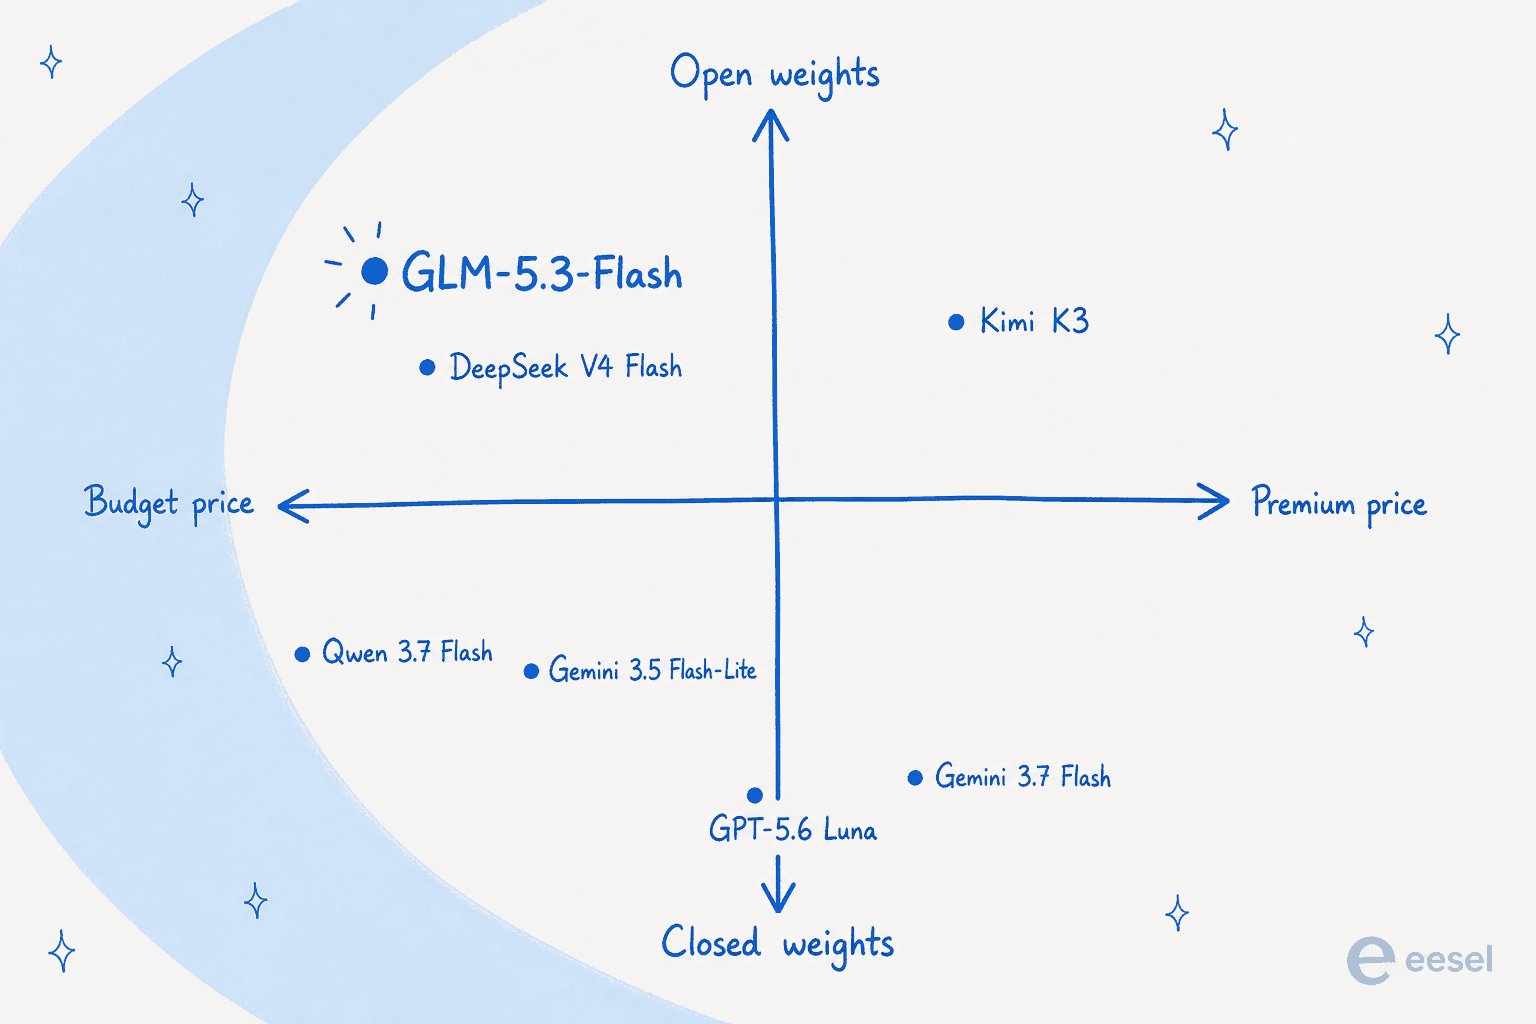
Alternativas ao GLM-5.3-Flash em resumo
| Modelo | Ideal para | Entrada / Saída (por 1M) | Contexto | Pesos | Visão | Observação |
|---|---|---|---|---|---|---|
| GLM-5.3-Flash (o de referência) | Multimodal aberto e barato | $0.075 / $0.25 (promo) | 1M | Abertos | Sim | Índice AA 57; promo termina em 9 set |
| DeepSeek V4 Flash | Pesos abertos mais baratos | $0.22 / $0.66 (fora do pico) | 1M | Abertos (MIT) | Não (texto) | Tarifas 2x no pico; prolixo |
| Gemini 3.7 Flash | Modelo fechado mais rápido | $0.75 / $3.75 (promo) | ~1M | Fechados | Sim | ~340 t/s; dobra em jan 2027 |
| Gemini 3.5 Flash-Lite | Piso de velocidade / preço | $0.30 / $2.50 | ~1M | Fechados | Sim | Faixa Gemini mais rápida e barata |
| GPT-5.6 Luna | Ecossistema de uma grande marca | $0.20 / $1.20 | 1.05M | Fechados | Sim (entrada de imagem) | 2x na entrada acima de 272K tokens |
| Qwen 3.7 Flash | Mais barato em prompts pequenos | $0.03-$0.20 / $0.13-$0.80 | 1M | Fechados | Sim | Preço em faixas pelo tamanho do prompt |
| Kimi K3 | Pesos abertos + visão nativa | $3.00 / $15.00 | 1M | Abertos | Sim (nativa) | Nível topo de linha, não econômico |
Agora o detalhe de cada um, na ordem em que eu os consideraria.
1. DeepSeek V4 Flash
Ideal para: equipes que querem pesos abertos que possam realmente hospedar e a menor conta possível em cargas de texto.
Se o GLM-5.3-Flash tem um verdadeiro rival no eixo "barato e aberto", é o DeepSeek V4 Flash. É um MoE de 284B totais / 13B ativos lançado sob uma licença MIT genuína, com 1M de tokens de contexto e pesos abertos que rodam em SGLang ou vLLM. Até a reação da comunidade ao GLM usa o DeepSeek como ponto de referência, com uma nota no r/opencode de que o "visible context grows half as fast as Deepseek Flash" do GLM.
Pontos fortes. A licença MIT é o verdadeiro atrativo: você pode hospedar por conta própria os cerca de 167GB de pesos, o que aproxima seu custo marginal do preço das suas próprias GPUs e mantém os dados dos clientes na sua infraestrutura. Esse último ponto é exatamente onde a fraca história de dados do GLM pesa. Em esforço máximo, é um raciocinador capaz (a Artificial Analysis dá 50) e é realmente barato também na API hospedada.
Pontos de atenção. Duas coisas. Primeiro, só trabalha com texto, sem entrada de imagem documentada, então não é uma troca equivalente se você usa a visão do GLM. Segundo, o preço hospedado tem um acréscimo de horário de pico: a entrada com cache miss custa $0.22/M fora do pico, mas $0.44/M durante o horário de pico (01:00-04:00 e 06:00-10:00 UTC), com saída de $0.66 subindo para $1.32. Uma fila de suporte dos EUA ou da UE é cobrada sobretudo fora do pico, uma peculiaridade a seu favor, mas frágil. Também é prolixo, gastando mais tokens de saída por tarefa do que a mediana da classe.
Preços. Fora do pico $0.22 entrada / $0.66 saída por 1M; no pico, exatamente o dobro. Acertos de cache são quase de graça, a $0.007/M fora do pico. Números completos em nosso post de preços do DeepSeek V4 Flash. Há também um experimento de texto mais visão, o DeepSeek V4 Flash Vision, se você quiser fechar a lacuna multimodal.
Veredicto. A escolha quando pesos abertos e hospedagem própria importam mais que visão. Se você nunca envia imagens e pode rodar sua própria inferência, ele supera o GLM em controle de dados e custo marginal, e nossa análise do DeepSeek V4 Flash mergulha na armadilha da configuração barata. Se você precisa de visão ou não quer operar GPUs, continue lendo.
2. Gemini 3.7 Flash
Ideal para: equipes que querem o modelo fechado mais rápido e uma plataforma madura e bem documentada, e não se importam com um preço de grande fornecedor.
O Gemini 3.7 Flash chegou à disponibilidade geral em 13 de agosto de 2026 como o "most intelligent workhorse model yet for coding and agents" do Google. É a escolha natural se a velocidade do endpoint do próprio GLM for o seu impeditivo.
Pontos fortes. A velocidade é a manchete: a Artificial Analysis mede 340.1 tokens/seg, posição #1 de 188 modelos. É multimodal, tem cerca de 1M de tokens de contexto e vem com as ferramentas, o grounding e a documentação do Google. Por nível de esforço, low marca 50.9 no Intelligence Index a $0.16/tarefa e com tempo até o primeiro token abaixo de um segundo, a um ponto do antigo 3.6 Flash em esforço total. Se você reduz o esforço, ele é rápido e barato ao mesmo tempo.
Pontos de atenção. O preço é introdutório. É $0.75/$3.75 por 1M até 31 de dezembro de 2026, depois $1.50/$7.50 a partir de 1º de janeiro de 2027 conforme a página de preços do Google, uma duplicação exata. A API também mudou bastante: temperature, top_p e thinking_budget sumiram, e o nível de raciocínio minimal, o mais barato, foi removido, então o piso para trabalho barato de OCR/classificação é mais alto do que no 3.6 Flash. E sua taxa de alucinação piorou para 64.5% dos 55.6% do 3.6 Flash, o que pesa muito se você o apontar para clientes sem proteção.
Preços. $0.75 entrada / $3.75 saída por 1M até o fim de 2026, depois o dobro. Batch e Flex têm 50% de desconto.
Veredicto. A melhor velocidade bruta daqui, em uma plataforma séria. Escolha-o se latência e maturidade do fornecedor pesarem mais que o preço, e orce já o aumento de janeiro de 2027 em vez de ser pego de surpresa.
3. Gemini 3.5 Flash-Lite
Ideal para: trabalhos de alto throughput e alto volume em que você quer o modelo Google mais barato e rápido e aceita um teto mais baixo.
Se o Gemini 3.7 Flash é o cavalo de batalha, o Flash-Lite é o velocista. O Google o descreve como "our fastest, most cost-effective 3.5 model for high-throughput execution," e é exatamente o espaço que o GLM-5.3-Flash tem dificuldade em ocupar sozinho com seu lento endpoint próprio.
Pontos fortes. É o piso de preço e velocidade das opções fechadas, a $0.30/$2.50 por 1M, rodando a cerca de 350+ tokens/seg, e ainda mantém entrada multimodal, uso de computador e um contexto grande. Para classificação, roteamento, etiquetagem e outro trabalho "barato e rápido" de alto volume, é difícil de bater sem partir para o código aberto.
Pontos de atenção. Você troca inteligência por throughput. No gráfico de Pareto ele fica bem abaixo do GLM-5.3-Flash no Intelligence Index, então não é o modelo para raciocínio difícil nem para tarefas agênticas sutis de vários passos. É um especialista, não um substituto de modelo topo de linha.
Preços. $0.30 entrada / $2.50 saída por 1M, com batch pela metade.
Veredicto. A escolha certa para pipelines de alto volume e baixa complexidade em que velocidade e custo dominam. Para qualquer coisa que precise de raciocínio no nível do GLM, volte a um modelo Flash completo.
4. GPT-5.6 Luna
Ideal para: equipes que já vivem no ecossistema da OpenAI e querem uma faixa barata sem sair dele.
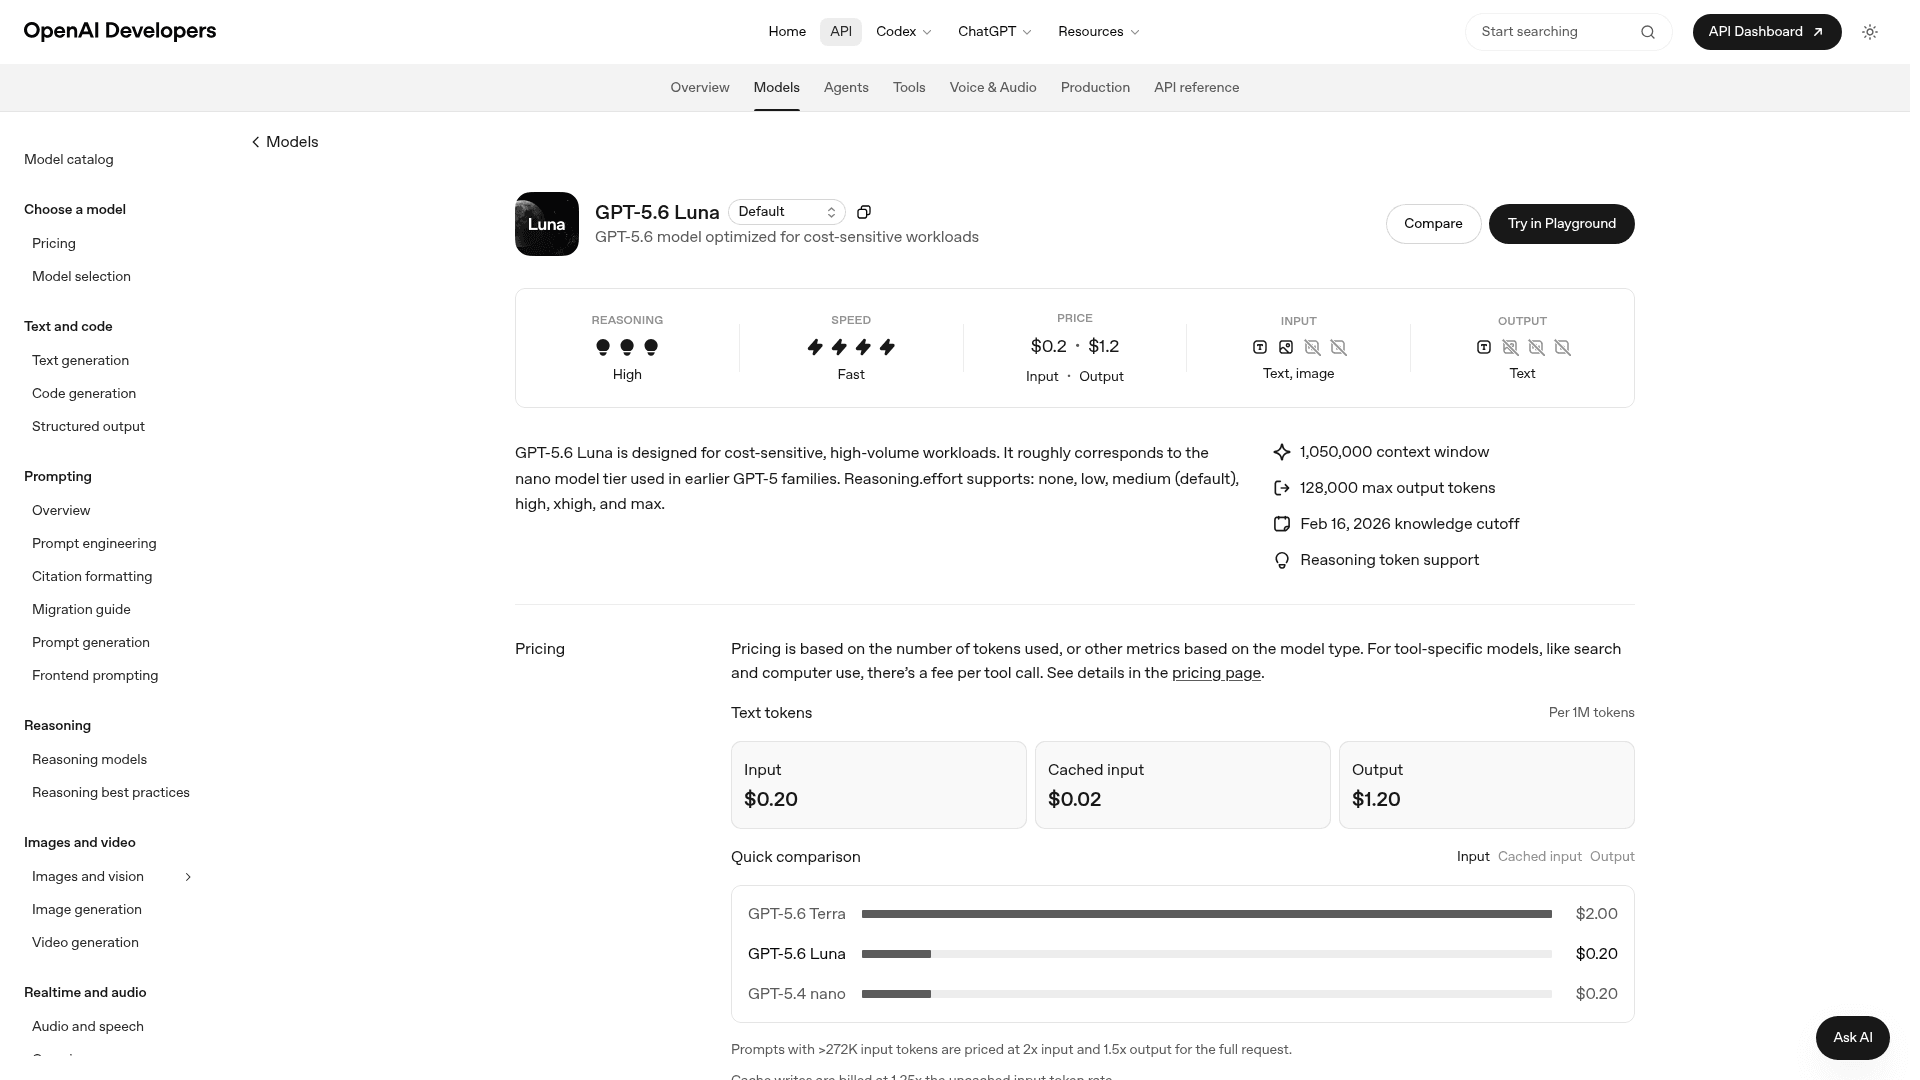
O GPT-5.6 Luna é a faixa sensível a custo da OpenAI, "designed for cost-sensitive, high-volume workloads," aproximadamente o espaço do nano nas famílias GPT-5 anteriores. É a alternativa para quem valoriza o ecossistema, as ferramentas e o suporte do maior fornecedor mais do que espremer o último centavo.
Pontos fortes. A $0.20/$1.20 por 1M é barato para um modelo de marca de fronteira, com contexto de 1,050,000 tokens, entrada de imagem e toda a faixa de reasoning.effort de none a max. Se sua equipe já usa o SDK da OpenAI, Agents e as ferramentas, ficar dentro dele elimina muito atrito de integração. Parece a escolha segura e entediante, e às vezes é a certa.
Pontos de atenção. Há um salto por contexto longo: prompts acima de 272K tokens de entrada são cobrados a 2x na entrada e 1.5x na saída para a requisição inteira. Então o "contexto de 1M" e os "$0.20" não podem ser ambos verdadeiros em um prompt muito longo. Também é fechado, só texto e imagem (sem pesos abertos, sem hospedagem própria), e o Luna fica abaixo do GLM-5.3-Flash em inteligência bruta, por ser a faixa econômica da família e não o cavalo de batalha.
Preços. $0.20 entrada / $1.20 saída por 1M, entrada em cache $0.02, com o acréscimo de 272K mencionado acima. Mais contexto da OpenAI em nossa análise do GPT-5.6.
Veredicto. Melhor quando a gravidade do ecossistema vence o preço por token. Se você já está todo na OpenAI, o Luna é o caminho de menor atrito para uma faixa barata; se você procura puramente custo ou quer pesos abertos, GLM ou DeepSeek ganham.
5. Qwen 3.7 Flash
Ideal para: trabalho de visão ou texto de alto volume com prompts curtos, em que suas chamadas permanecem pequenas.
O Qwen 3.7 Flash, da Alibaba, é o outro modelo chinês econômico da mistura, e seu modelo de preços é genuinamente diferente do de todos os outros aqui.
Pontos fortes. Em prompts pequenos é a opção mais barata deste comparativo: $0.03/M de entrada e $0.13/M de saída para chamadas abaixo de 32K tokens. É um modelo de visão com 1M de tokens de contexto, então, no papel, cobre o terreno multimodal do GLM com um preço de entrada menor.
Pontos de atenção. O preço é dividido em faixas pelo tamanho do prompt, e os dois números de manchete são mutuamente exclusivos. Acima de 32K tokens salta para $0.10/$0.40, e na faixa de 256K-1M é $0.20/$0.80, uma variação de 6.7x na entrada. A mistura móvel da OpenRouter do que os clientes realmente pagam é $0.044/$0.149, acima da tarifa de entrada, o que indica que o tráfego real cai nas faixas superiores. Também é de pesos fechados e pouco avaliado: sem benchmarks ou arquitetura publicados, e a única avaliação independente (Roboflow) o coloca em #22 de 23 no geral, mas #1 em custo. "Flash" aqui significa barato, não rápido, a cerca de 59 tokens/seg.
Preços. Em faixas: $0.03-$0.20 entrada / $0.13-$0.80 saída por 1M conforme o tamanho do prompt. Detalhamento completo em nosso post de preços do Qwen 3.7 Flash, e há um irmão maior no Qwen3.8-Max se você precisar de mais fôlego.
Veredicto. Uma verdadeira pechincha se, e somente se, seus prompts permanecerem pequenos. Modele sua distribuição real de tokens antes de trocar, porque uma carga de suporte com contexto longo pode jogá-lo silenciosamente na faixa cara. Nossa análise do Qwen 3.7 Flash tem mais.
6. Kimi K3
Ideal para: equipes que querem pesos abertos e visão nativa como o GLM oferece, e estão dispostas a pagar preços de modelo topo de linha por um teto mais alto.
O Kimi K3 é o modelo topo de linha da Moonshot AI e o mais próximo do GLM-5.3-Flash na combinação "pesos abertos mais multimodal nativo". É um MoE de 2.8T totais / 104B ativos com 1M de tokens de contexto e compreensão nativa de imagem e vídeo, e seus pesos foram lançados no Hugging Face no prazo.
Pontos fortes. A capacidade é a história. Ele marca um Intelligence Index da Artificial Analysis de 57, igualando o GLM-5.3-Flash e ficando em #4 no geral, e supera o Opus 4.8 e o GPT-5.5 na maioria dos benchmarks. Visão nativa (imagem e vídeo) mais pesos abertos significa que você pode hospedar por conta própria e manter os recursos multimodais, que é exatamente o que o GLM oferece, mas com uma contagem maior de parâmetros ativos por trás.
Pontos de atenção. O preço. A $3/$15 por 1M, está na faixa do Claude Sonnet, cerca de 50 vezes o preço de saída do GLM-5.3-Flash. O raciocínio não pode ser desligado em nenhum nível, e em esforço low marca um Index de 47 a $0.24/tarefa, o que é pior e cerca de 8x mais caro que o DeepSeek V4 Flash. Também não aceita URLs públicas de imagem, apenas base64 ou IDs de arquivo. Não é uma troca econômica.
Preços. $3 entrada / $15 saída por 1M, cache hit $0.30. Veja nossos posts de preços do Kimi K3 e alternativas ao Kimi K3 para o quadro completo.
Veredicto. O upgrade de capacidade, não a economia de custo. Escolha o Kimi K3 quando quiser o formato do GLM de aberto mais multimodal com mais inteligência bruta e puder absorver preços de modelo topo de linha. Se o custo é o motivo de você estar aqui, esta é a direção errada.
Qual alternativa realmente combina com você?
A tabela e o quadrante fazem a maior parte do trabalho, mas a resposta honesta depende da sua maior restrição. Escolha a que mais importa e veja para onde ela aponta:
O que mais importa para a sua carga de trabalho?
O que a escolha do modelo não resolve
Isto é o que eu diria a qualquer um que esteja se angustiando com esta tabela, e vem de anos colocando IA em filas de suporte reais: trocar o modelo é a parte fácil de 5%. Se o seu objetivo é responder tickets de clientes, o modelo é a camada inferior da pilha, e é a camada que menos muda quando você troca de fornecedor.
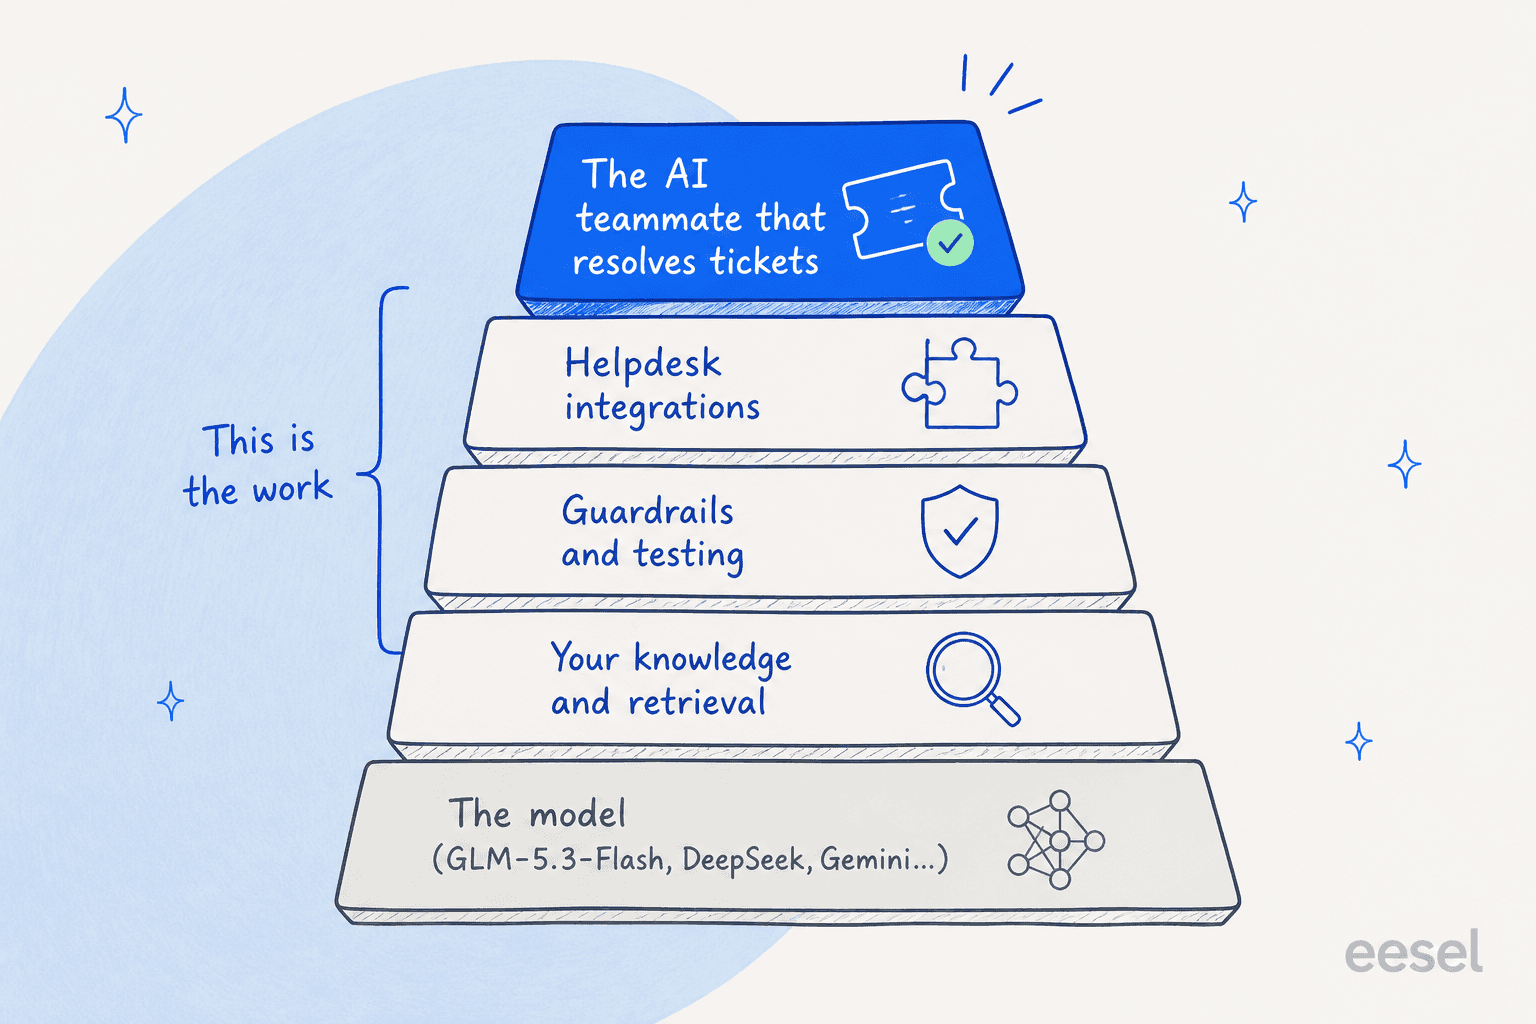
É a mesma lógica de contratar um funcionário de IA em vez de alugar uma API bruta, e é por isso que os melhores colegas de IA são julgados por resultados, não por tokens por segundo. Tudo acima do modelo é o trabalho: conectar sua base de conhecimento para que as respostas tenham fundamento, barreiras de proteção para que ele saiba o que não dizer, testes para descobrir como ele se comporta antes dos seus clientes, e integrações ao seu helpdesk para que possa de fato agir. A razão pela qual um modelo mais barato raramente move sua taxa de resolução é que a taxa de resolução vive nessas camadas superiores, não nos tokens por segundo.
É também aqui que os números de alucinação acima deixam de ser curiosidade. A taxa de alucinação de 64.5% do Gemini 3.7 Flash, ou qualquer um desses modelos respondendo com confiança quando não deveria, só é perigosa se chegar a um cliente sem teste. Vimos bots de aparência confiante darem respostas erradas sem ninguém notar, e é exatamente por isso que hoje simulamos cada implantação com os tickets históricos reais de uma empresa antes de entrar no ar. Nenhuma escolha do modelo barato "certo" substitui isso. Se você quer a visão em nível de modelo especificamente para suporte, escrevemos separadamente sobre o melhor modelo de IA para tickets de suporte.
Experimente a eesel
Se o motivo de você comparar alternativas ao GLM-5.3-Flash é construir automação de atendimento ao cliente, a eesel é a camada que fica por cima de qualquer modelo que você escolher. Pense no modelo como o motor e na eesel como o colega de IA que você contrata: ele chega já sabendo se conectar ao Zendesk, Freshdesk ou Gorgias, aprende com seus tickets passados e sua central de ajuda e segue as barreiras de proteção que você define.
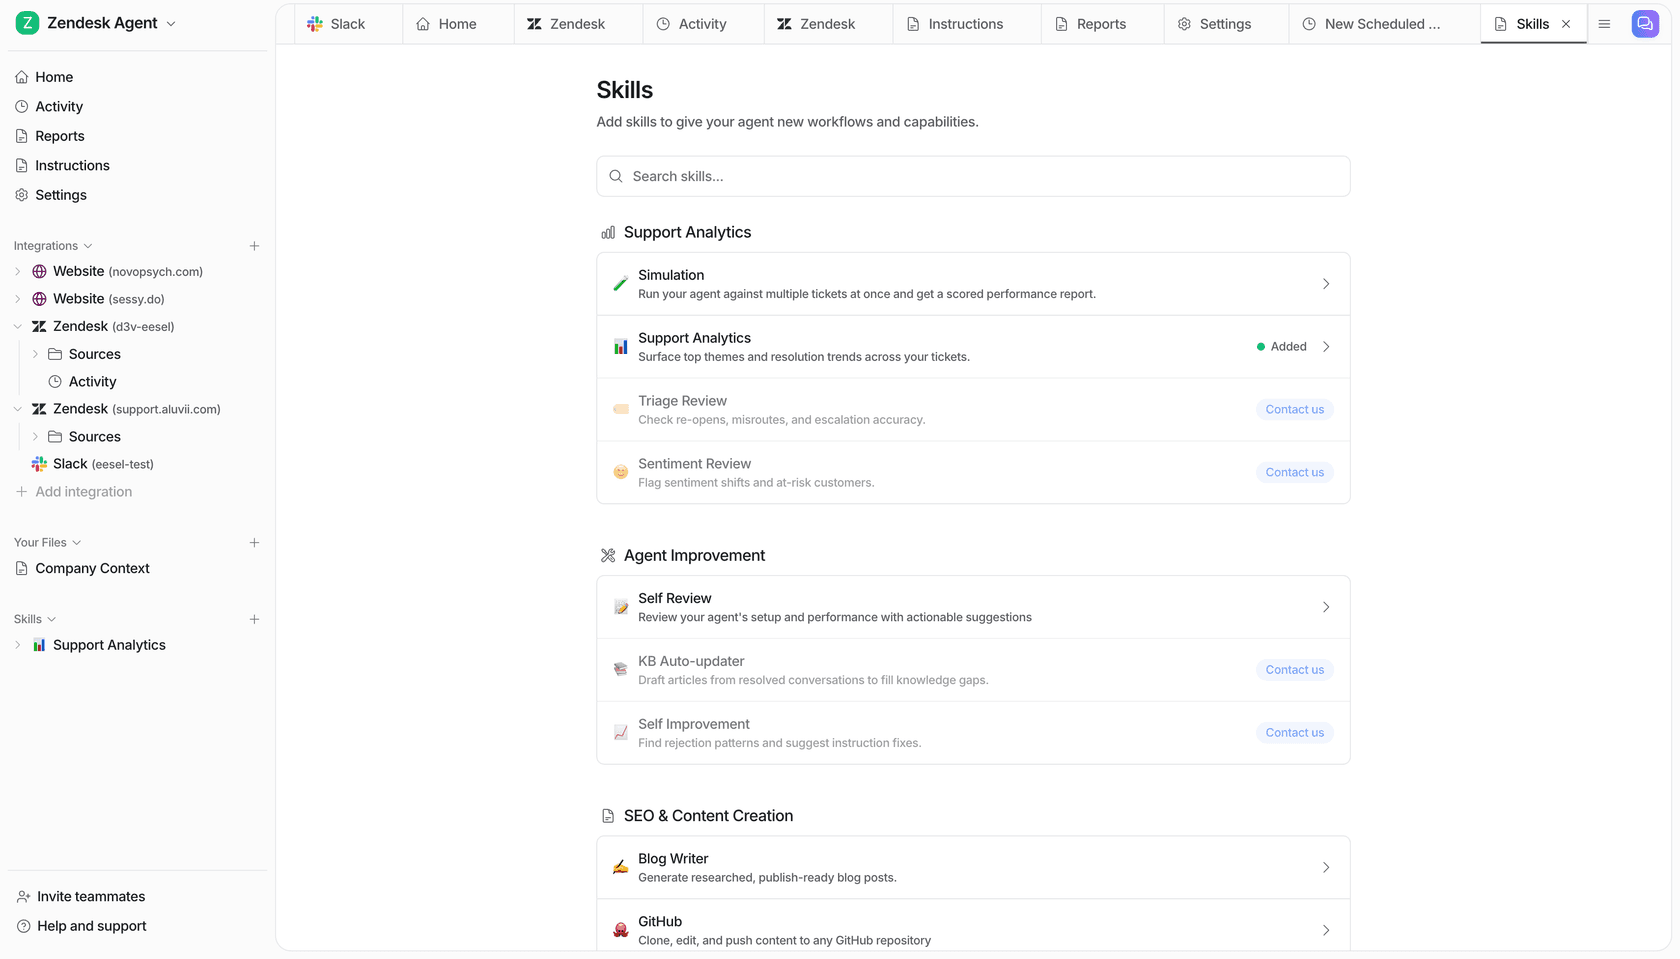
O diferencial é a simulação: antes que seu colega de IA responda um único ticket ao vivo, a eesel o reproduz em milhares das suas conversas passadas reais, para que você veja a taxa de resolução e as respostas exatas que ele teria enviado, e possa corrigi-las enquanto o risco ainda é zero. Essa é a salvaguarda que transforma um modelo barato e capaz em um agente de suporte em quem você pode realmente confiar. É grátis para testar, e você pode apontá-lo para o seu próprio helpdesk em poucos minutos.