Help ScoutのAI品質保証: 何を測り、残りをどう評価するか

Rama Adi

Katelin Teen
最終更新 2026年11月21日
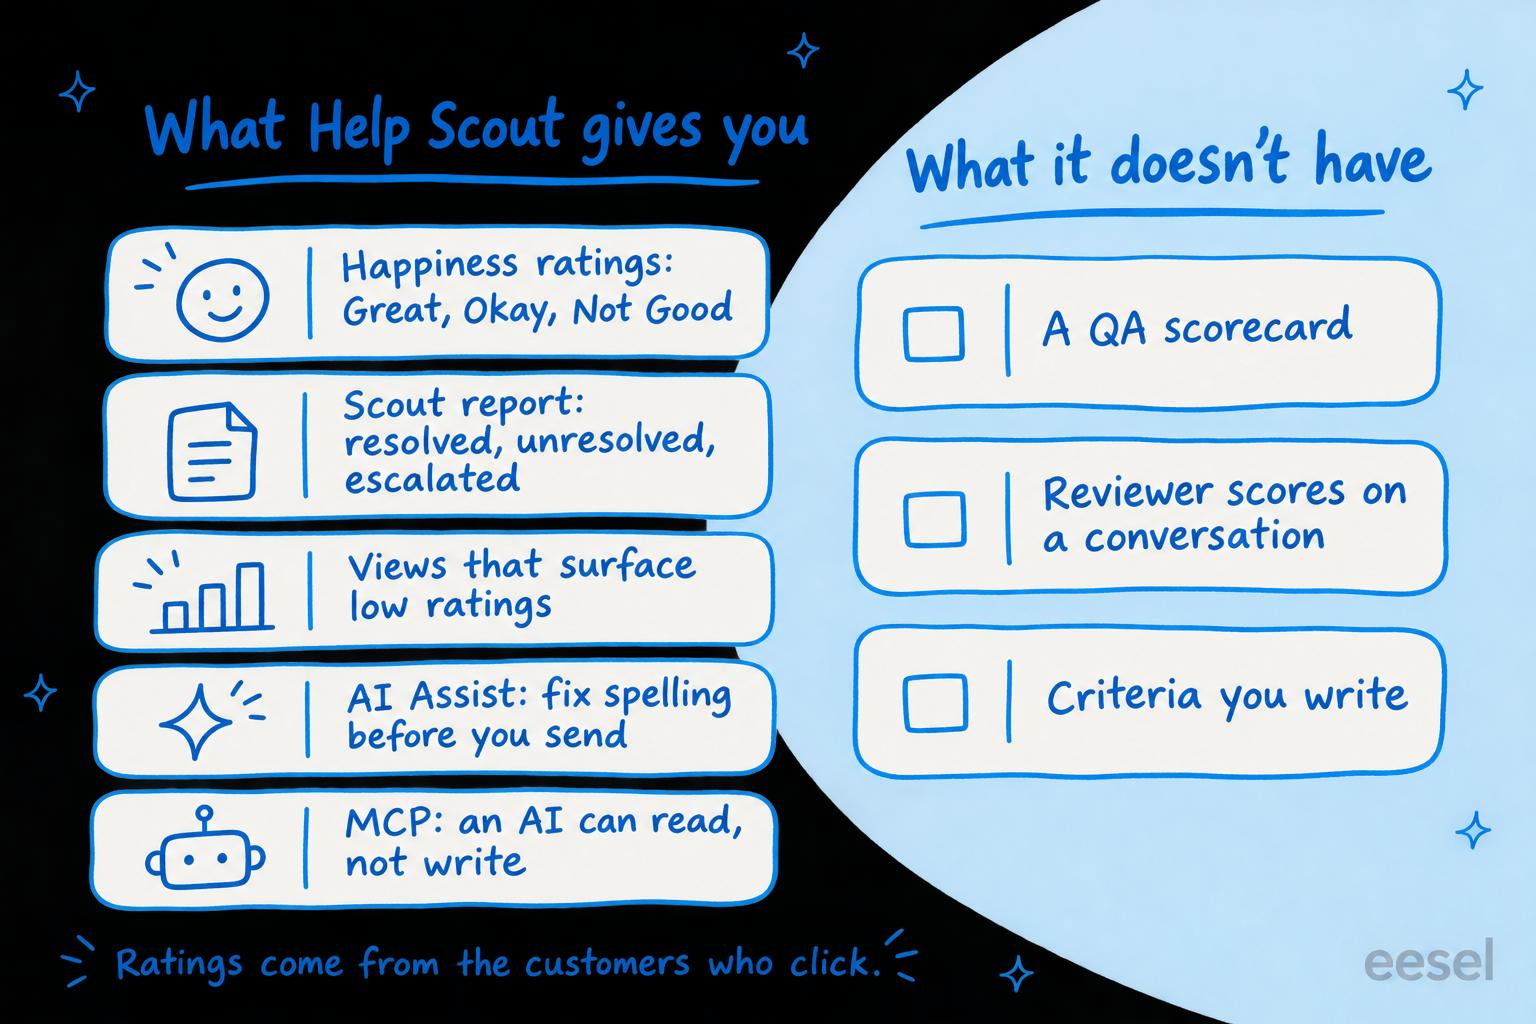
Help ScoutにはAI QAスコアカードがありません。チームの会話を正確さ、トーン、プロセスの観点で評価する機能はなく、あるのは顧客評価と、AIエージェントが各チャットを解決できたかどうかのレポートです。QAリーダーが得られるのは、各返信への顧客自身の評価(Great、Okay、Not Goodで、Happinessスコアに集計される)、各AI会話をResolved、Unresolved、またはエスカレーションとマークするScoutレポート、そしてHelp ScoutのMCPサーバー経由でのClaudeやChatGPTの読み取り専用アクセスです。つまりHelp Scoutは、評価をクリックした顧客がどう感じたかを教えてくれますが、「ポリシー通りの回答だったか」はあなた次第です。これは、毎週手作業でサンプルを評価すること、MCP経由で会話を読むAIアシスタント、あるいはeeselのようなAIチームメイトでカバーできます。eeselは、あなたが書いたルーブリックに沿ってクローズした会話をすべて評価し、その理由を社内メモに残します。Claude Codeのようなコーディングエージェントなら、そのルーブリックをeeselに書き込み、eesel CLIでスケジュールを設定できますが、接続の承認はHelp Scout管理者が行う必要があります。
Help ScoutにAI品質保証はありますか?
スコアカードとしてはありません。私はeeselの連携機能を作っているので、マーケティング文の裏で各機能が実際に何をするのかをヘルプデスクのドキュメントで確認します。Help ScoutのAI機能ページには、Scout(AIエージェント)、AI Drafts、AI Summarize、AI Assist、Topics、MCPサーバーが載っています。どれも、チームが対応した会話を品質保証の基準に沿って評価するものではありません。
これは、Help Scoutが自社のAIを「can be used to improve support」という形で説明していること、つまりチケットの削減を軸にしていないことと一致します。これはまた、返信が正確だったかを知りたいサポートリーダーは、自分でその材料を組み合わせる必要があるということでもあります。各要素が測るものは次の通りです。
| Help Scoutの機能 | プラン | QAリーダーに分かること | 分からないこと |
|---|---|---|---|
| Happiness評価 | Standardはレポートを2年保持、PlusとProはアカウントの存続期間中 | 評価をクリックした顧客がどう感じたか | 誰も評価しなかった返信については何も分からない |
| Scoutレポート | ScoutはStandard、Plus、Proで利用可能、resolution単位で課金 | どのAI会話が解決・未解決・人への引き渡しになったか | 解決した回答が正しかったかどうかは分からない |
| AI Assist | Standard、Plus、Pro | 返信を送信する前にスペルと文法を修正し、トーンを調整する | 送信後に何かを評価することはない |
| Topics | PlusとPro | 顧客がどんなテーマで問い合わせているか | チームの対応がどれほど良かったかは分からない |
| MCPサーバー | Standard、Plus、Pro(レポートツールにはPlusかProが必要) | 自分のAIアシスタントが会話やレポートを読めるようにする | メモやタグを書き戻すことはできない |
Help ScoutのHappiness評価は何を教えてくれますか?
顧客がある返信をどう感じたかを、顧客自身の言葉で教えてくれます。Settings、Inboxes、Satisfaction Ratingsの順に進み、受信箱ごとに満足度評価をオンにすると、それ以降、各メール返信に評価リンクが付くようになります。顧客はGreat、Okay、Not Goodのいずれかを選び、コメントを追加できます。
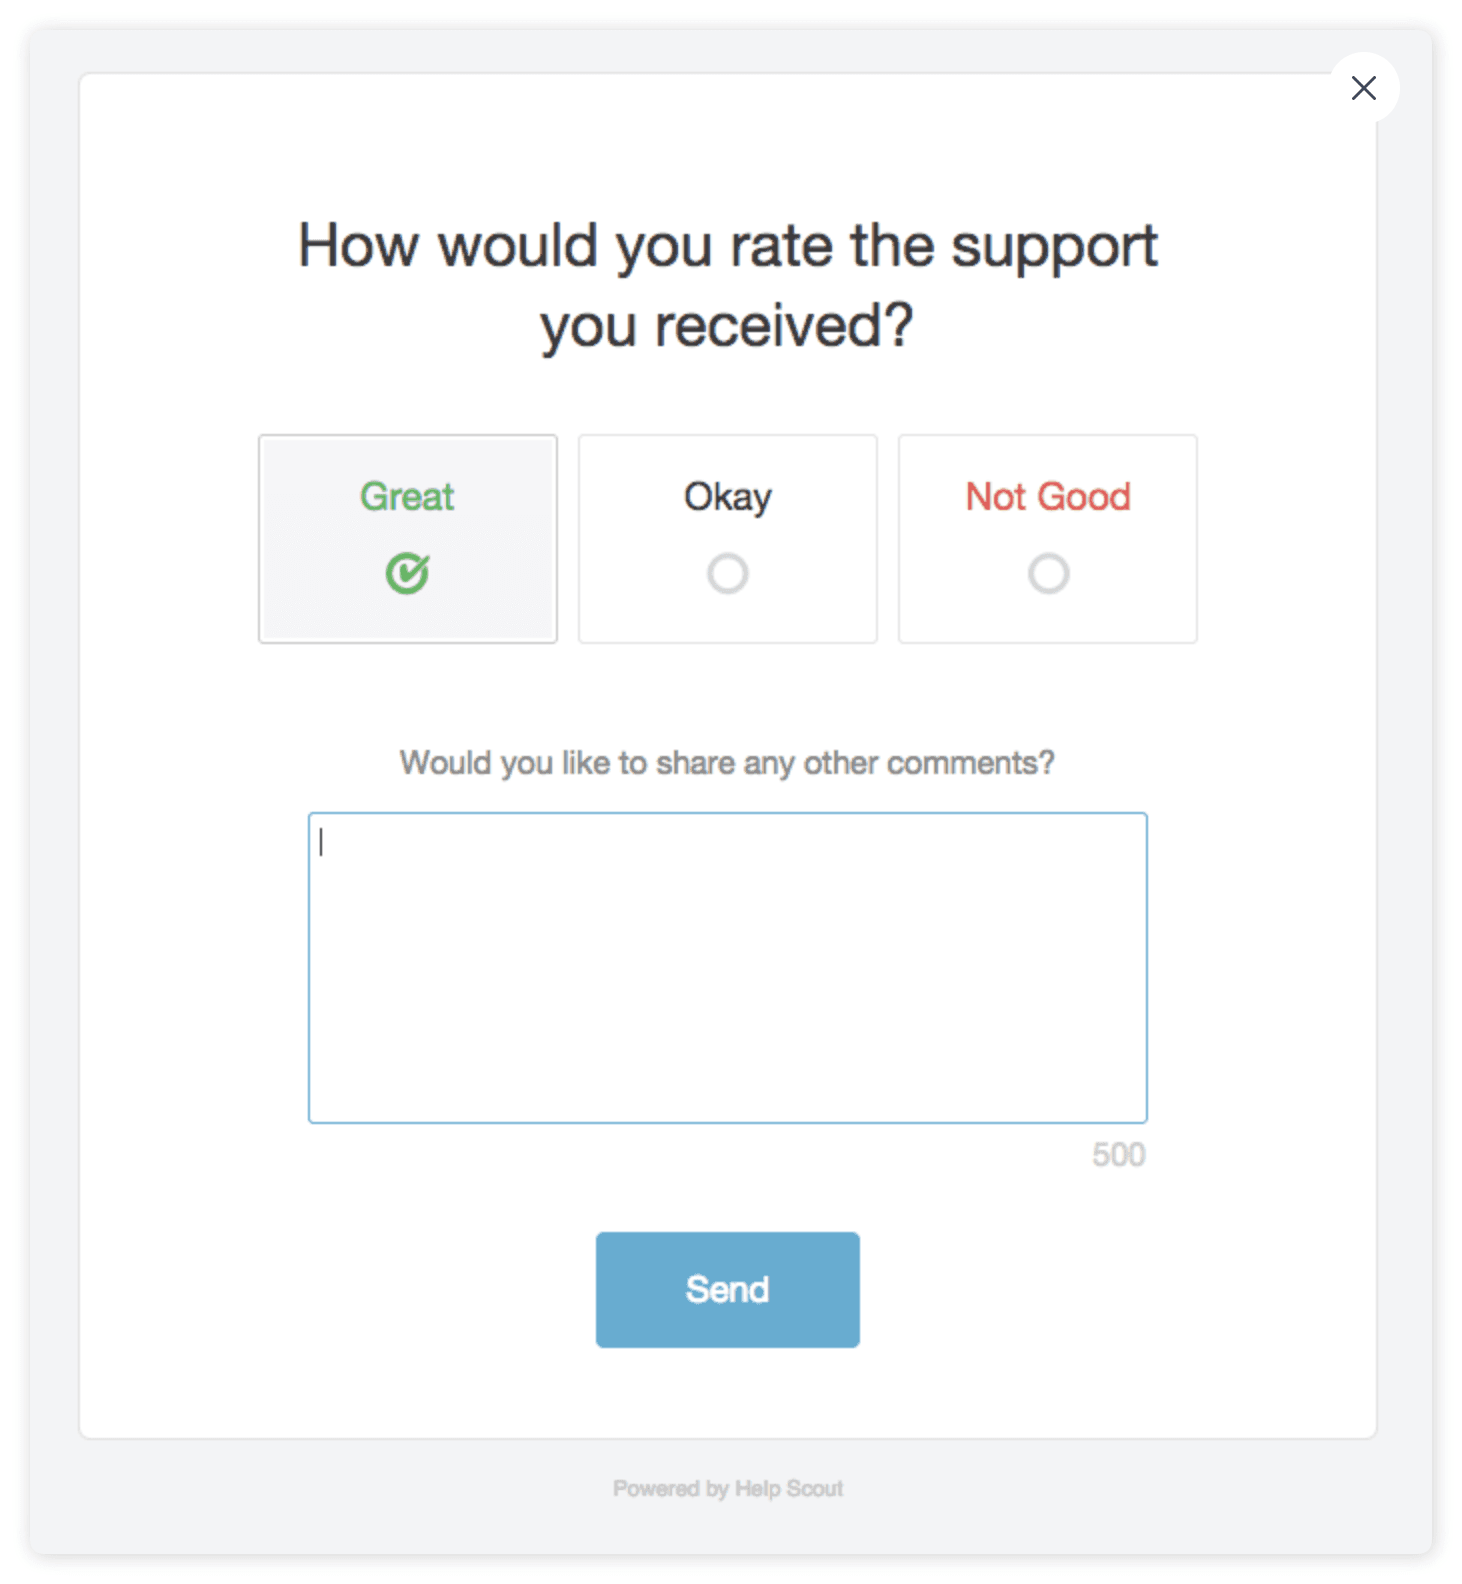
これを品質の指標として読むつもりなら、次のルールが重要です。
- すべての返信が評価対象になります。 エージェントが5件の返信を送れば、顧客は5件すべてを、それぞれ1回評価できます。
- 期間は10日間です。 顧客は返信後10日間、評価したり評価を変更したりできます。評価は削除できません。
- スコアはネットの数字です。 HappinessレポートはGreat、Okay、Not Goodの割合を示し、HappinessスコアはGreatの割合からNot Goodの割合を引いたもので、NPSとよく似た方法で計算されます。
- 評価は返信の日付でカウントされ、 顧客がクリックした日付ではないため、先週の数字が今も動くことがあります。Happinessレポートの日付についての私の記事で、週次レビューへの影響を扱っています。
- 各エージェントは自分専用のタブを持ちます。 Companyレポートを開き、次にUserレポートを開くと、一人分の評価が見られます。
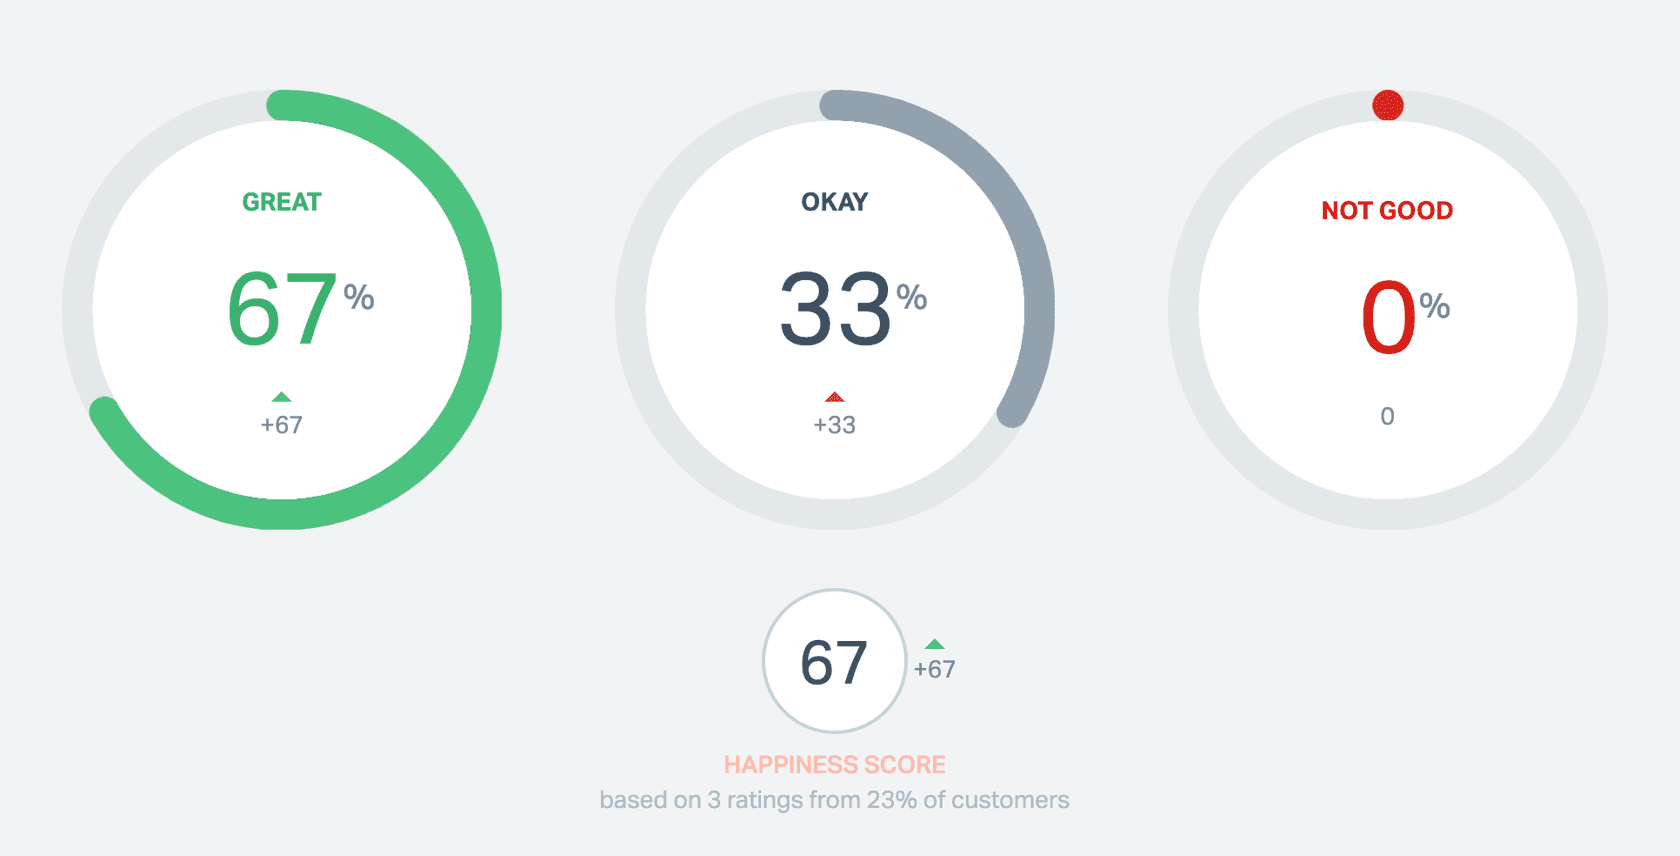
そのスクリーンショットの小さな注記を見てください。顧客の23%からの3件の評価です。これが評価をQAとして使う限界です。CSATアンケート全般と同じで、クリックする手間をかけた顧客の声しか聞けません。自信満々だが間違った返金回答を受け取った顧客は、返金が届かないまでGreatと評価してしまうこともあります。評価は返信がどう感じられたかを示しますが、その返信があなたのポリシーに従っていたかどうかは示しません。そのギャップを埋めようとしているのがAI CSAT系のツールです。
それでも評価はレビューの出発点として悪くありません。2026年5月以降、Help Scoutのviewsは会話内で起きたことでフィルタできるようになったので、"spot low-rated interactions that need follow-up"ができ、評価が来るとワークフローでリーダーにメール通知することもできます。顧客がどう感じているかをもっと知りたいなら、Help Scoutのセンチメント分析についての記事でさらに踏み込んでいます。
Help ScoutでScoutのAI回答をどうチェックしますか?
ReportsからScoutに進み、Scoutレポートを使います。Scoutはいわば Help ScoutのAIエージェント(実際に費用が発生する製品名はEnvoyで、1 resolutionあたり0.75ドル)で、レポートはScoutが関わった各会話を次の3グループに分けます。
- Resolved: Scoutが回答し、顧客はそれ以上の助けが必要だと言わなかった。
- Unresolved: 顧客がそれ以上の助けが必要だと言った、またはScoutが対象外のためエスカレーションしたが、顧客から連絡はなかった。
- Human Escalation: 会話がチームに引き渡された。
各Beacon(Help Scoutのチャットウィジェット)には独自のレポートがあり、顧客の最初の質問、resolution、セッションの終わり方、評価、Topicを示すセッション一覧があります。Help ScoutのScoutのベストプラクティスでは、resolutionで並び替え、顧客が助けを得られなかった会話を読み、Scoutがもっと良く答えるべきだった箇所にImprovementを追加するよう勧めています。Account OwnerとAdministratorは、Scoutが失敗した時に確認したソースも見ることができます。
これはAIの見落としに対する妥当なレビューのループです。ただ、"Resolved"の意味に注意してください。顧客が最後の回答のあとに追加の助けを求めなかった、というだけです。これは同時に、Help Scoutが1件のresolutionとして課金するタイミングでもあります。顧客が信じてしまった誤った回答もResolvedとしてカウントされるため、失敗例だけでなく解決済みセッションのサンプルも読む価値があります。AIのcontainmentとエスカレーションの測定で、この落とし穴をさらに詳しく扱っています。
Help ScoutでQAを行うコストはどれくらいですか?
プラン料金に追加費用はありません。評価、Happinessレポート、Scoutレポートに追加料金はかかりません。プランによって変わるのは、レポートがどこまで遡れるか、どのAIツールが使えるかです。2026年11月21日に確認したHelp Scoutの料金ページによると:
| プラン | 1ユーザーあたり、年払い | 月払い | QAにとって重要な点 |
|---|---|---|---|
| Free | 0ドル | 0ドル | 最大5ユーザー、"No AI tools included" |
| Standard | 25ドル | 30ドル | 過去2年分のHappinessレポート、AI Assist、レポートツールなしのMCPアクセス |
| Plus | 45ドル | 54ドル | 存続期間中のレポート、Topics、AI Drafts、MCPレポートツール |
| Pro | 75ドル | 90ドル | Plusの全機能、最低10ユーザー |
| Envoy(アドオン) | 1 resolutionあたり0.75ドル | 翌月後払いで課金 | ScoutとそのScoutレポート |
8人のチームがPlusを使う場合、年払いで月360ドルになり、Envoyのresolution分も支払っていればScoutレポートが含まれます。Help Scoutの料金についての私の記事で、各プランの残りの詳細を扱っています。
QAスコアカードに必要で、Help Scoutが任せてくるものは何ですか?
多くのQAスコアカード(参考としてスコアカードの基準の例)は、Help Scoutが決して評価しない3つを確認します。回答がポリシー通りに正しかったか、エージェントがプロセス(タグ、保存済み返信、エスカレーション)に従ったか、そしてあなたらしい口調だったかです。それには、あなたのルールを読んだ誰か、または何かが必要です。
何を確認したいかを選んで、何がそれをカバーするかを見てみましょう。
確認したい項目を選ぶと、Help Scoutでそれをカバーするものと、何もカバーしない場合に何が必要かが分かります。
このギャップを埋める方法は3つあります。
サンプルを手作業で評価する
最も安い方法は何も新しく用意する必要がなく、AIでのサポートQAに関するガイドの多くもここから始まります。毎週、リーダーが先週クローズした会話のビュー(低評価のものを先に)を開き、10件か20件を読み、短いルーブリックに沿ってスプレッドシートで各会話を評価します。まず各スコアの意味を決めておけば、2人のレビュアーが同じ会話に同じ点数をつけられます。サポートQAのキャリブレーションがそれに役立ち、QAフィードバック例も参考になります。
限界は明らかです。人がサンプルを読むだけで全会話ではなく、スコアもHelp Scoutの外に存在します。
MCP経由でAIアシスタントに頼む
Help ScoutのMCPサーバーは、Claude、ChatGPT、Cursorが会話(スレッド、タグ、カスタムフィールドを含む)を一覧表示、検索、要約でき、PlusとProではHappinessなどのレポートも取得できます。各ユーザーが自分のHelp Scoutログインで接続するので、アシスタントはそのユーザーが見られる範囲しか見られません。
これで週次のQAセッションが手軽に行えます。ルーブリックを貼り付け、アシスタントにSupport受信箱で先週クローズした会話を読ませ、理由付きで各会話を評価させます。知っておくべき制限が2つあります。新しい接続は読み取り専用なので、アシスタントは評価した会話にメモを追加したりタグを変更したりできませんし、結果はチャット内に残るだけです。また、誰かが頼むことを思い出した時にしか動かず、毎朝自動で動くわけではありません。Claude TeamとEnterpriseプランでは、Claude Ownerだけがコネクタを追加できます。Help Scout用のClaudeについての私の記事で設定方法を扱っています。
AIチームメイトにルーブリックで評価させる
3つ目の方法は、AIエージェントが自分でレビューを行い、あなたのルールに沿って、結果をHelp Scoutに書き戻すというものです。私がeeselでやるならこうします。eeselのHelp Scout連携は、ステータス、タグ、最終更新日で会話を一覧表示し、各会話をすべての返信、メモ、タグとともに読み込み、社内メモを残し、タグを追加できます。
これをスケジュールに乗せれば、毎朝次のことをします。
- 前日クローズした会話を一覧表示する。
- あなたが平易な言葉で書いた基準(「返金提案は返品ポリシーの30日ルールと一致していなければならない」「配送に関する質問には
shippingタグを付ける」「署名はエージェントの名前で行う」など)に沿って各会話を読む。 - スコアと理由を社内メモとして残し、見落としには
qa-reviewタグを付けて、リーダーがHelp Scoutのビューを作れるようにする。 - Slackやメールをつなげていれば、その日のまとめをリーダーに送る。
ルーブリックはあなたが書くので、ポリシーの正確さや口調もそこに行を追加するだけで済み、ポリシーが変わればいつでも変更できます。Scoutの会話もチームの会話と同じルーブリックで評価でき、同じeeselエージェントが返信を作成したり、新しい会話にタグ付け・振り分けしたりすることもできます。始める前に知っておくべきことが2つあります。eeselのメモには、接続に使っているHelp Scoutユーザーの名前が表示されるので、専用のユーザーを与えてください。また、カスタムフィールドは設定できないので、スコアはメモやタグ、eeselが書くレポートの中に残り、Help ScoutのHappinessレポートには残りません。
こうしたスケジュール済みのチェックは、すでにeeselの顧客向けに動いています。Cactus Club Cafeは、Zendeskヘルプデスクでもうひとつのeeselエージェントを動かし、毎朝、日次の財務抽出を監査しています。各店舗をチェックし、バランスが取れていればチケットを解決済みにし、そうでなければ差額を明記したまま未解決にします。2026年8月8日から9月8日の間に、約60回実行されました。QAレビューも同じ形です。毎朝のジョブが、書かれたルールに沿って動き、結果がチケットに残ります。
Help Scoutの品質への取り組みは十分ですか?
Help Scoutを評価すべき点はあります。見せかけをしていません。(比較として、GorgiasはAuto QAを提供し、3つの基準をAIで評価し、残りは人に任せています。)評価は誠実な顧客フィードバックで、Happinessスコアは読みやすく、Scoutレポートは AIがどこで足りなかったかを明確に示し、AI Assistは誰かに届く前に誤字を捕まえます。小さなチームなら、評価と、低評価の会話を毎週読むことを組み合わせれば、十分なQAプログラムになります。
私の見解としては、Happiness評価とScoutレポートはQAのスコアではなく、トリアージリストとして扱うべきです。どこを見るべきかは示してくれますが、クリックする顧客からしか話を聞けませんし、「resolved」は顧客が聞き返すのをやめたという意味にすぎません。すべての会話で回答がポリシーに従っていたかを知る必要が出てきたら、そのポリシーを読んだレビュアーが必要です。人の時間、週1回のMCP経由のアシスタント、あるいは毎朝それを行いHelp Scoutに書き戻すAIチームメイトのいずれかです。
Help Scoutと並べてeeselを試す
Happiness評価とScoutレポートは、それが得意なことのために残しておきましょう。eeselが何をできるかは、誰が頼むかによって変わります。どのアクションを自動で動かすか、どれを先に確認を求めるか、どれをオフにするかはあなたが選べます。クローズしたHelp Scoutの会話を、ルーブリックの残りの部分、つまり返金ルール、タグ、あなたの口調に沿って読ませましょう。これらは平易な言葉で書かれ、ポリシーが変わるたびに変更できます。eeselは各会話に理由を社内メモとして残し、リーダーが読むべき会話にタグを付け、何を確認するか変えたいときは平易な言葉で答えてくれます。

eeselを試すなら、あなたのHelp Scout受信箱で、まずは前日クローズした会話から始めてみてください。