

ヘルプセンターをAIエージェントが読めるようにするには、ファイルより先に記事を直します。1記事に1つの質問を置き、最初の2文で平文で答え、単独で読んでも意味が通る見出しにし、変わるものすべてに日付を付けます。次にrobots.txtで通したいAI検索ボットを許可し、ログインの壁は本当に必要な場所にだけ残します。llms.txtとMCPは最後です。2026年11月17日時点で、ZendeskとHelp Scout自身のヘルプセンターも/llms.txtに対してまだ404を返していました。
最も重要な読者は自社のサポートAIです。eeselのAIヘルプデスクチームメイトはヘルプセンターと過去のチケットをもとに回答し、チームが直すたびにその下書きは直すべき記事を指し示します。eesel CLIを使えば、コーディングエージェントがヘルプセンターの同期内容を実際に確認し、公開前にテスト質問を実行できます。ヘルプデスク連携自体の承認は、管理者が行う必要があります。
今、誰がヘルプセンターを読んでいるのか?
私はeeselのソフトウェアエンジニアで、SEOの仕事を2年経験してきましたが、サポートやドキュメント担当者から受ける質問が変わってきました。以前は「なぜこの記事はランクしないのか」でした。今は「返金期間は30日なのに、なぜChatGPTは顧客に14日と伝えたのか」です。短く言えば、ヘルプセンターには3種類の新しい読者がいて、それぞれ読み方が違うということです。
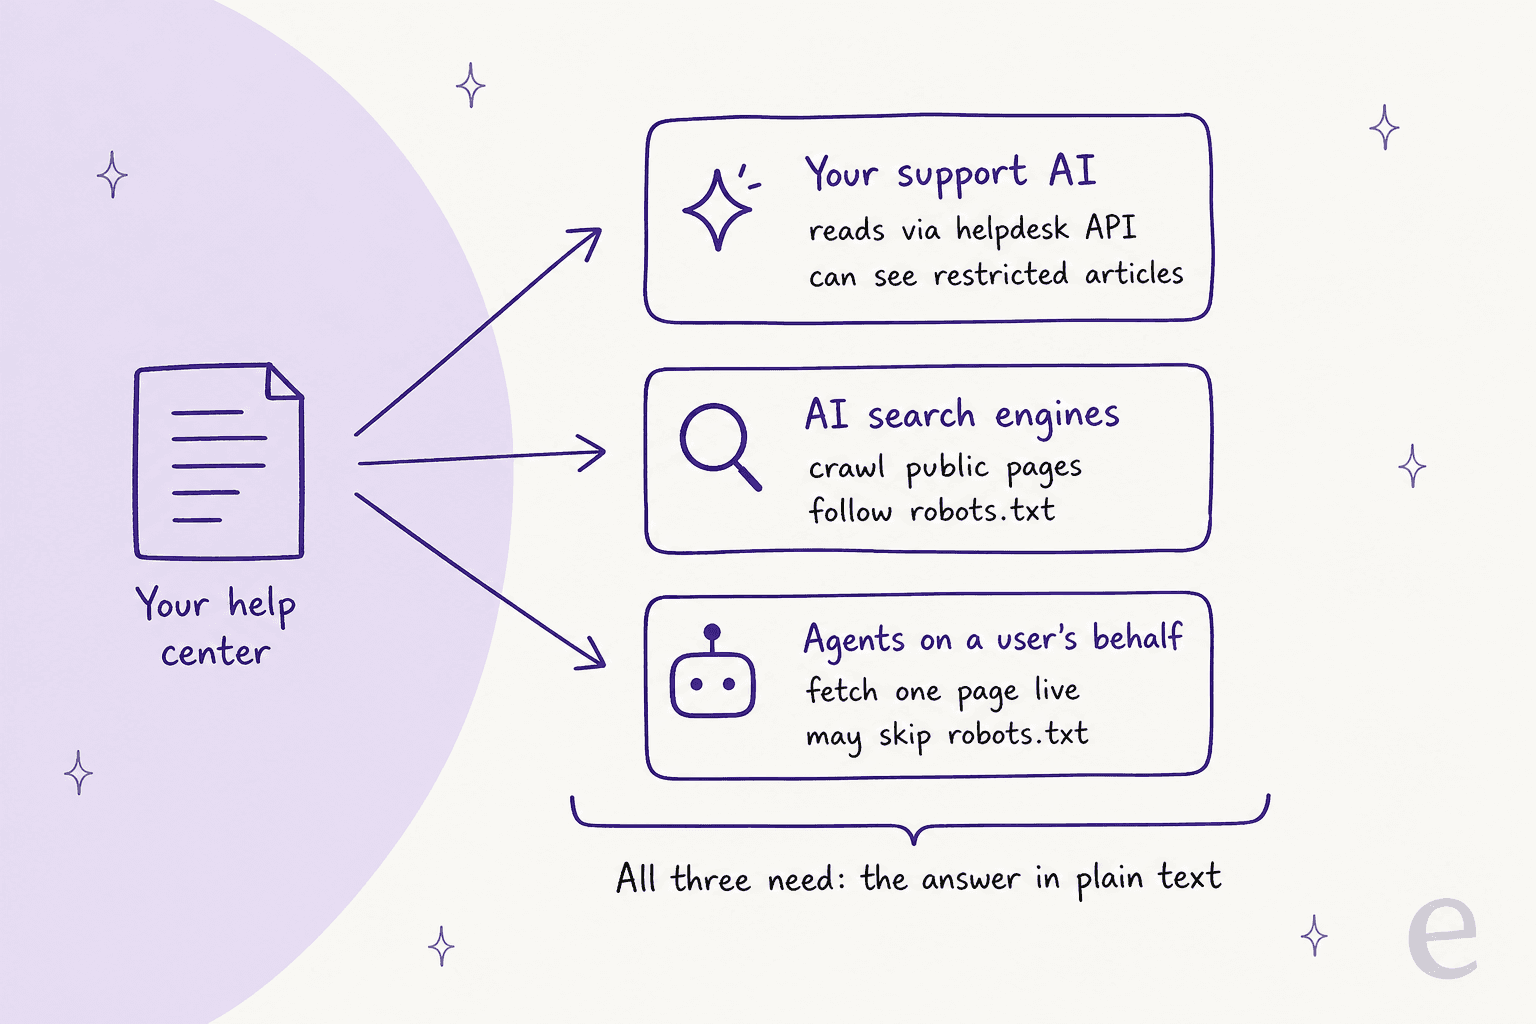
- 自社のサポートAI。 ナレッジベースで学習させたボットやコパイロットは、通常スケジュールに沿ってヘルプデスクAPI経由で記事を同期します。robots.txtは関係なく、許可すれば制限付き記事も読めます。
- AI検索エンジン。 ChatGPT検索、Claude、Perplexity、GoogleのAI Overviewsは、AI検索エンジンがどんな索引を作る場合とも同じように、事前に公開ページをクロールします。ボットごとに1つのルールでrobots.txtに従います。
- ユーザーの代わりに動くエージェント。 誰かがChatGPTに製品について尋ねると、
ChatGPT-Userとしてその場でページを取得することがあります。コーディングエージェントはドキュメントをmarkdownとして取得し、MCPクライアントはツールとして問い合わせることもあります。
あなたがコントロールできる点でどう違うかは次の通りです。
| 読者 | 入ってくる方法 | robots.txtに従う? | ログイン限定記事を見られる? | JavaScriptを実行する? |
|---|---|---|---|---|
| 自社のサポートAI | ヘルプデスクAPIの同期またはコネクタ | いいえ、自社のAPIアクセスを使う | 接続に権限があれば見られる | 不要、記事本文を直接読む |
| AI検索クローラー(OAI-SearchBot、Claude-SearchBot、PerplexityBot) | 公開URLをクロール | はい | いいえ | ChatGPTとClaudeのクローラーはVercelのテストで実行していなかった。Geminiは実行する |
| ユーザー起点のフェッチャー(ChatGPT-User、Claude-User、Perplexity-User) | チャット中に1つのURLを取得 | 常にではない(ステップ4参照) | いいえ | 実行しないものとして扱う |
| コーディングエージェントとMCPクライアント | llms.txt、markdownページ、MCPツール | クライアントによる | 認証情報がある場合のみ | 不要 |
心配すべきなのは最後の列です。VercelのAIクローラートラフィック分析によると、ChatGPTとClaudeのクローラーはJavaScriptファイルを取得はしても実行しないため、クライアント側でレンダリングされるものはすべて見えません。この表のどの読者も、ページやAPIレスポンスにある平文は読めます。だからこそ、以下の最初の3つのステップは記事そのものに関するもので、4種類の読者すべてに同時に効果があります。その後サポートAIがどの断片を選ぶかは検索(リトリーバル)の問題ですが、読めたものの中からしか選べません。
今、ヘルプセンターはどれくらいAIに読みやすいか?
ステップに入る前に監査をしましょう。ブラウザのタブで記事を1つ開き、もう1つのタブでヘルプデスクの管理画面を開けば、10分で終わります。
すでに当てはまる項目にチェックしてください。スコアはその場で上がっていきます。チェックできない項目は、以下のステップに対応しています。
ステップ1:1記事に1つの質問を置き、最初の数行で答える
AIの読者が記事全体を使うことはほとんどありません。検索エンジンやサポートボットはページを断片に分割し、質問に最も近そうな2つか3つを取り出して、そこから回答を作ります。つまり、あなたが書く対象の単位はページではなく断片です。
GitBookはLLM対応ドキュメントガイドでこれを明確に述べています。「GitBookは配信レイヤーを担います。AIの回答の質を決めるのはあなたの文章です」。そのチェックリストは短く、各ページに明確な目的を持たせる、見出しと短いセクションで説明する、制約・デフォルト値・要件を直接書く、正確な数値を含める、製品が変わったらコンテンツを更新する、というものです。
実務上は、ほとんどのヘルプセンターで次の3つの修正が必要になります。
- タイトルは顧客が尋ねる質問にする。 「請求用メールアドレスはどう変更しますか?」は「請求設定の概要」より優れています。これはナレッジベース記事の書き方でも伝えているのと同じ助言で、人々が検索に入力する言葉とも一致しやすくなります。
- 答えを最初に置く。 質問を解決する1、2文を先に置き、次に手順、そして例外事項を続けます。断片だけが取り出された場合、生き残らなければならないのは最初の文です。
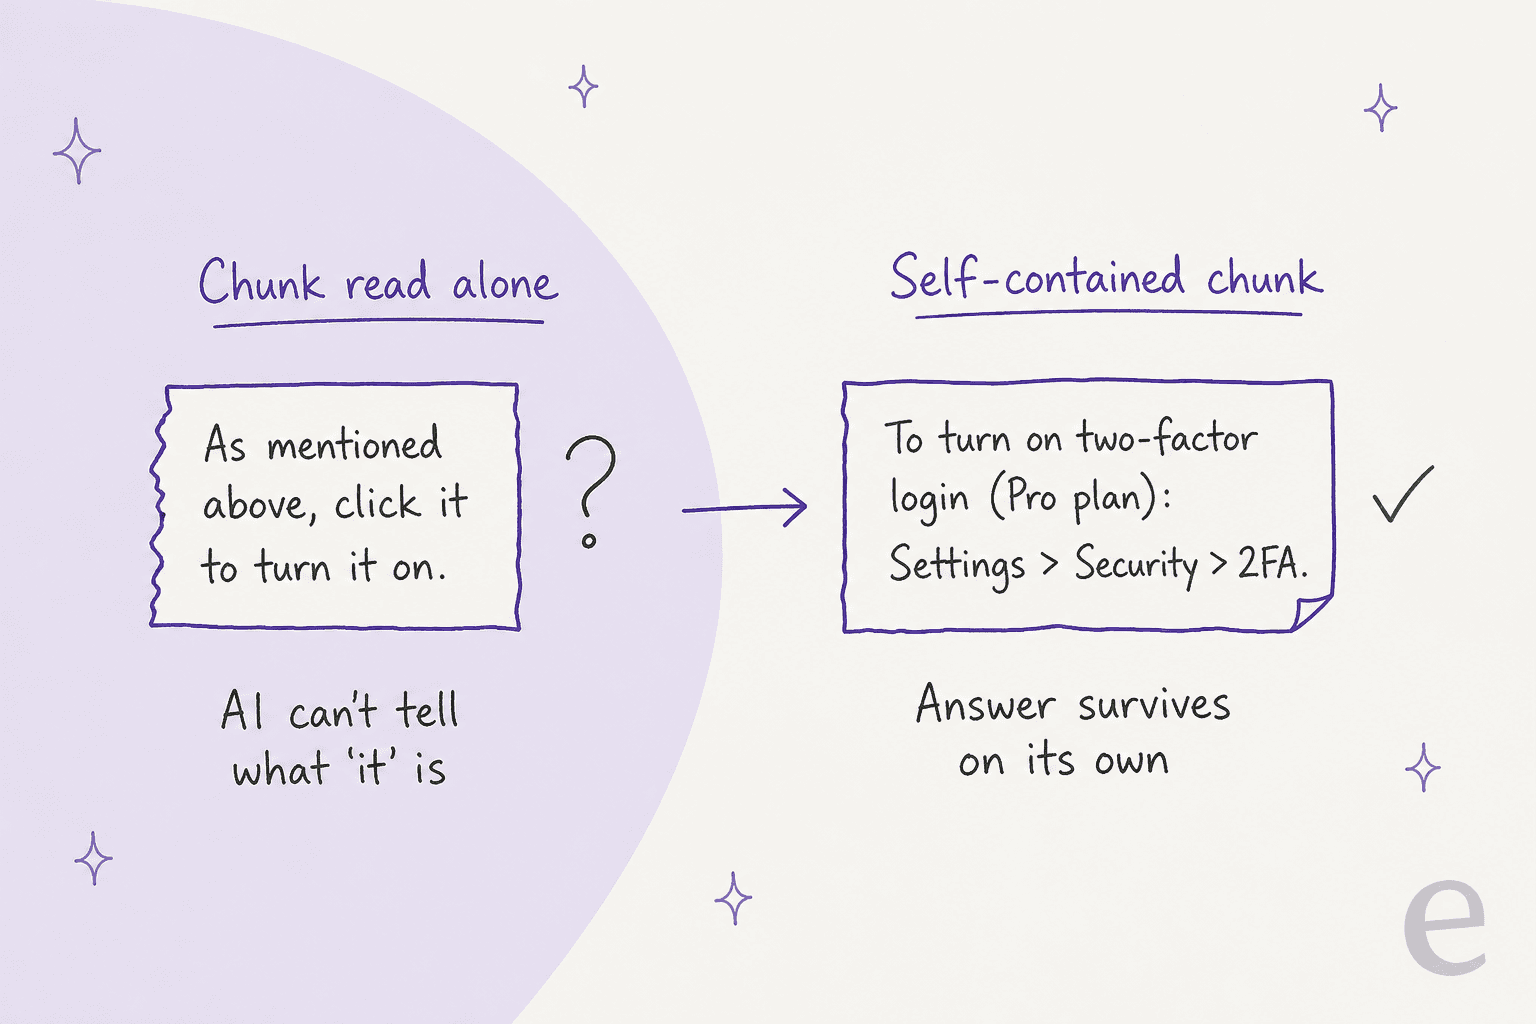
- 各セクションは単独で成立させる。 名詞を繰り返しましょう。「それをオンにする」は、見出しを失った断片の中では何も意味しません。
記事を1質問1つにすることは、静かな失敗も防ぎます。1ページに25件の回答が載った長い「アカウントFAQ」は、すべて同じタイトルを共有する断片に分割されてしまい、AIはどの回答がどの質問に属するか判別できません。大きなFAQページを先に分割するのは、AIでFAQを減らすために私が知っている中で最も早く効く対策です。
Document360を使っているなら、良い要約を書くべき理由がもう1つあります。生成されるllms.txtは各記事の「AI&検索向け説明」を使い、Document360のllms.txtドキュメントによると、その説明がないコンテンツは「タイトルのみでllms.txtに含まれる」とされています。
ステップ2:画像・動画・PDF・クリックで開くウィジェットから回答を取り出す
これは私が見てきた中で、最もAIの回答を壊しているステップです。ヘルプ記事に「下に表示されている設定に移動してください」と書かれていて、その手順が載っている唯一の場所がスクリーンショットだったりします。読んでいる人には見えますが、ほとんどのAI読者には見えません。
Google自身のAI機能に関するガイダンスでも、AI OverviewsやAI Modeに表示されるための基本の1つとして「重要なコンテンツがテキスト形式で利用できるようにする」ことを挙げています。これは自社のサポートAIにも当てはまります。記事本文を取り込む同期処理は、テキストと画像のURLは得られますが、画像の中に描かれている内容は得られません。
回答がよく隠れている場所と、その対処法です。
| 回答が隠れている場所 | AI読者が得るもの | 対処法 |
|---|---|---|
| 設定ページのスクリーンショット | 画像のURLと、あればalt属性 | メニューの経路をテキストで書く:設定 > セキュリティ > 2FA。スクリーンショットは補助として残す(フォーマットのコツ) |
| 埋め込みの解説動画 | プレーヤーの埋め込みのみ、手順なし | 動画の下に手順か文字起こしを追加する(動画の埋め込み) |
| PDFやスライドの添付ファイル | 多くの場合スキップされる、または構造なしで読まれる | 内容を記事本文に移す(添付ファイル) |
| スクリプトで読み込むタブやアコーディオン | JavaScriptの実行後にしかテキストが現れない場合は何も得られない | テキストをHTMLの中に残す。シンプルな<details>ブロックならテキストが最初から存在するので問題ない |
| 埋め込みウィジェット内の料金や上限 | 何も得られない | 数値を日付付きの文として本文に書く |
これは自社のボットにも関わる話で、公開検索だけの問題ではありません。SE Rankingでは、eeselが約14,100件のヘルプセンターページをもとに3製品分のライブチャットに答えており、その指示では、知識の中に見つからないメニューやボタンは絶対に説明しないとされています。これはサポートエージェントにとって正しいルールです。同時に、スクリーンショットの中にしか存在しないメニューの経路は、エージェントが示すことのできない経路だということでもあり、結果として顧客はヘルプセンターがすでに扱っている内容のために人へ引き渡されてしまいます。
どの記事でもできる簡単なテストがあります。ページのソース(またはAPIレスポンス)を見て、肝心な手順を検索してください。テキストに含まれていなければ、どのAI読者もそれを持っていないと考えましょう。
ステップ3:事実に日付を付け、古い記事を正しく廃止する
AIの読者はデフォルトで自信満々です。古い記事が返金期間は14日だと言い、新しい記事が30日だと言う場合、モデルはどちらでも引用しうるし、「ただし日付を確認してください」とは付け加えません。古いコンテンツは、ページ上よりAIの回答の中でより大きな被害を生みます。顧客は「最終更新2023年」というフッターを決して見ないからです。
ほとんどはこの3つの習慣で解決します。
- 事実のすぐ隣に日付を置く。 「購入後30日間返金可能(2026年10月時点のポリシー)」なら、断片として抜き出されても生き残ります。フッターは生き残りません。
- 重複を削除または統合する。 同じ質問に異なる数字で答える記事が2つあることが、私が見る中でAIの回答が間違う最も多い原因です。まずは古くなったヘルプセンターのコンテンツの洗い出しから始めましょう。
- リダイレクトする。404を返さない。 Vercelのクローラーデータでは、ChatGPTはフェッチの34.82%を404ページに、さらに14.36%をリダイレクト追跡に使っていました。記事を移動するときはリダイレクトを設定して、AI検索エンジンが最新版に到達できるようにしましょう。
自社のサポートAIにも、矛盾が起きたときのルールが必要です。OroSoftはeeselをFreshdeskのコパイロットとして運用し、ヘルプセンターをポリシーの正とみなしつつ、ヘルプセンターと過去のチケットが矛盾する場合はより新しい方に従わせています。そのヘルプセンターは毎週月曜に再同期されます。これは、どのツールを使うチームにも必要なループです。
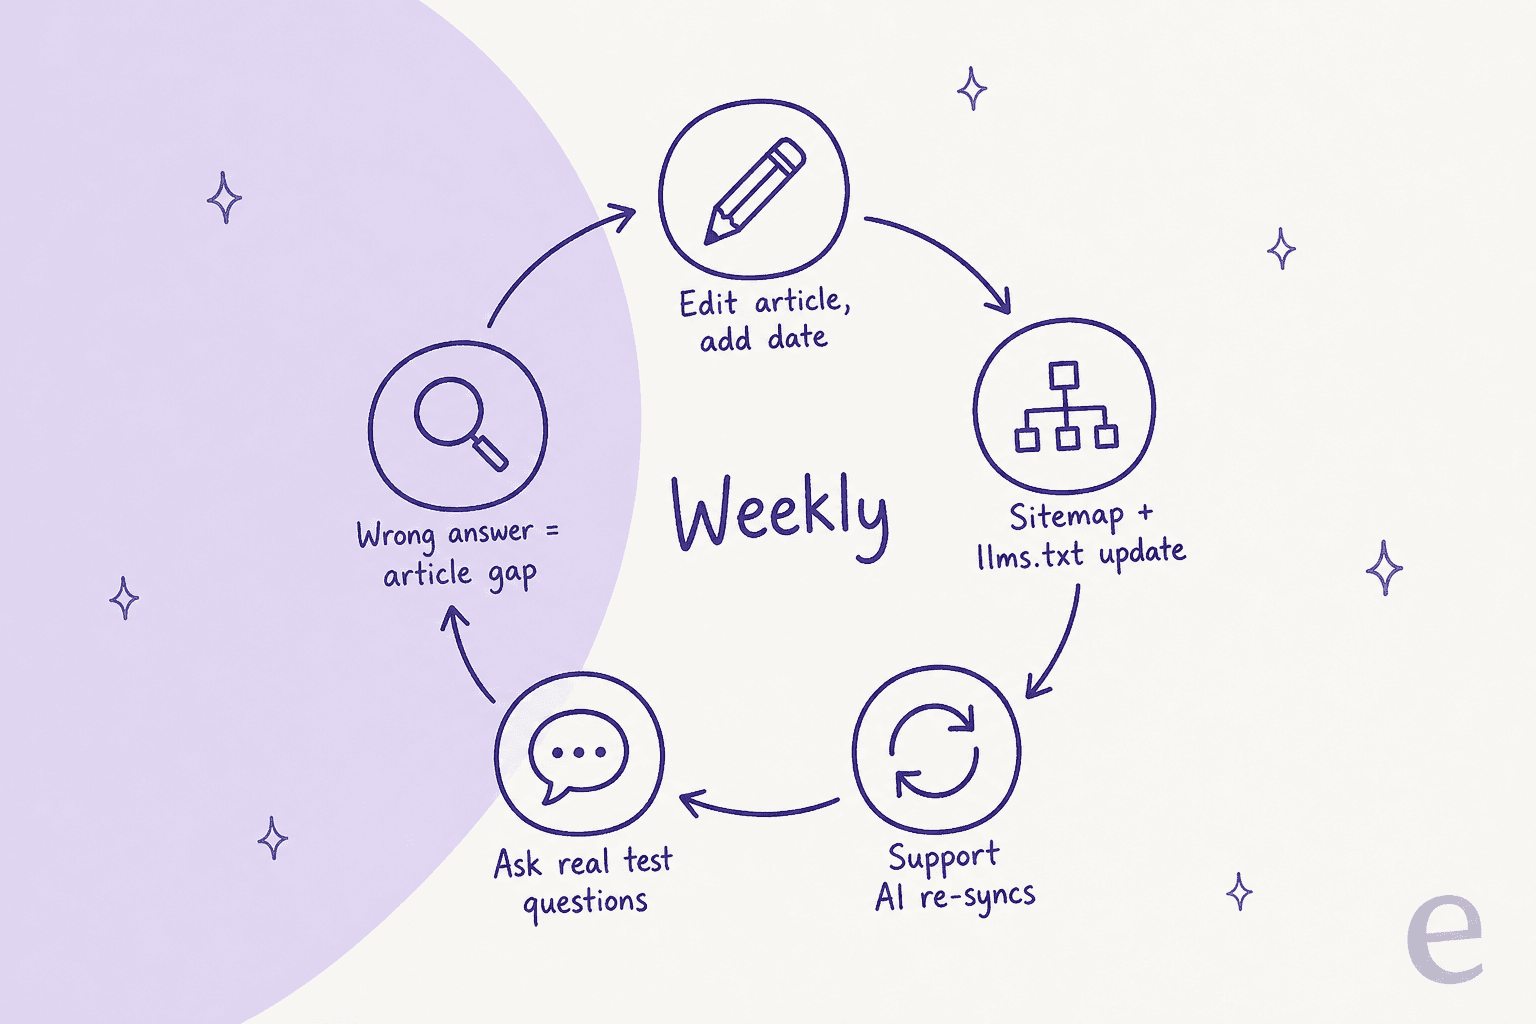
ZendeskはヘルプセンターのSEOに関する記事によると、ヘルプセンターのサイトマップを2時間ごとに再生成しており、公開側はほぼ自動的に対応されます。確認すべきなのはボットの同期スケジュールです。月1回の同期なら、ポリシー変更がAIの回答の中で最大1か月間誤ったままになります。自動更新されるナレッジベースは逆方向で役立ち、記事に反映されなかった回答を捕まえてくれます。
ステップ4:どのAIボットに読ませるかを決める
多くのAI企業は今、ボットを役割別に分けています。モデル学習用、検索用、ユーザーが求めるその場の取得用です。一方を許可し、もう一方をブロックすることもできます。サポートチームが誤ってヘルプセンターを隠してしまうのは大抵ここで、多くは「AIボットを全部ブロック」というrobots.txtの一節をどこかから貼り付けた後です。
| 企業 | 学習用クローラー | 検索用クローラー | ユーザー起点のフェッチャー |
|---|---|---|---|
| OpenAI | GPTBot | OAI-SearchBot | ChatGPT-User(「robots.txtのルールが適用されない場合がある」) |
| Anthropic | ClaudeBot | Claude-SearchBot | Claude-User(ブロックするとユーザー指示による取得が止まる) |
| Perplexity | 記載なし | PerplexityBot | Perplexity-User(「robots.txtのルールを基本的に無視する」) |
| Google-Extended(個別のボットではなく制御用トークン) | Googlebot | ここでは扱わない |
各企業名は、その企業自身のクローラー向けドキュメントにリンクしています。
公開ヘルプセンターのルールは単純です。検索クローラーは許可する。OpenAIは、OAI-SearchBotをオプトアウトしたサイトは「ChatGPT検索の回答には表示されない」としており、Anthropicは、Claude-SearchBotをブロックすると「ユーザー検索結果でのサイトの可視性と精度が下がる可能性がある」としています。学習用クローラーを入れるかどうかは、法務・マーケティング側で別途判断すべきことです。
AI検索アクセスを保ちつつ学習からはオプトアウトするヘルプセンター用robots.txtは、次のようになります。
# AI検索:これらにはヘルプセンターの索引作成を許可する
User-agent: OAI-SearchBot
Allow: /

User-agent: Claude-SearchBot
Allow: /

User-agent: PerplexityBot
Allow: /

# モデル学習:回答の問題ではなく方針の問題
User-agent: GPTBot
Disallow: /

User-agent: ClaudeBot
Disallow: /
つまずきやすい3つの点です。
- Google-Extendedは学習だけではない。 Googleは、Gemini AppsやVertex AIのグラウンディングもこれが制御しているとしており、ブロックするとGeminiの回答から記事が外れる可能性がある一方で、「Google検索へのサイトの掲載には影響しない」としています。
- 変更は即時には反映されない。 OpenAIは、robots.txtの変更後、検索システムが調整されるまで約24時間かかる場合があるとしています。
- robots.txtはそれが置かれているドメインしかカバーしない。 Anthropicの案内では、サブドメインごとにルールを繰り返すよう求めており、ヘルプセンターが
help.やsupport.上にある場合は注意が必要です。
この対応後にAIエンジンから実際どれくらい引用されるようになったかを見たいなら、それはアンサーエンジン最適化の話で、そうしたツールが追跡の側面をカバーしています。
ステップ5:ログインの壁を本当に必要な場所に置く
公開のAI読者はすべてログインページで止まります。Zendeskはこの点について明確で、ヘルプセンターがログインを要求する場合「サイトマップは自動生成されません。Webクローラーは非公開や制限付きのヘルプセンターにアクセスできません」としています。Mintlifyのllms.txtドキュメントも、生成されるファイルについて同様で、完全に認証が必要なサイトでは「認証できないAIツールはアクセスできません」としています。
これは正しい動作です。間違いは、公開すべき回答を誤って壁の内側に置いてしまうことで、よくある原因は、1つの機密記事のためにカテゴリー全体をユーザーセグメントに制限してしまうことです。制限は記事単位で見直し、セグメントによる制限は本当に非公開であるべきものだけにかけましょう。
そして2つの経路を計画します。
- 公開経路: 見込み客や顧客がログイン前に尋ねうるすべてのこと。これがAI検索エンジンやChatGPT系フェッチャーが引用する対象になります。
- 非公開経路: アカウント固有、パートナー限定、または社内向けの記事。これらを読むべきなのは自社のサポートAIだけで、権限付きのAPI接続、たとえばZendesk Guide APIやFreshdeskナレッジベースAPI経由であるべきです。
これは思っているより細かい話になります。あるeeselの商談では、1つのZendeskから2体のエージェントが必要なエンタープライズの物流チームがありました。1体は匿名ユーザー向けで公開記事のみから回答し、もう1体は登録ユーザー向けで制限付き記事の一部も読みます。これが正しい直感です。各AI読者がどの対象に応えるのかを決め、ちょうどその内容だけを与えましょう。
ステップ6:llms.txtとmarkdown版を追加する
ここでようやく、多くのガイドが冒頭で扱う部分に入ります。llms.txtは提案中の標準で、/llms.txtに置かれ主要ページを1行の説明付きで列挙するmarkdownファイルと、各ページの同一URLに.mdを付けた、整えられたmarkdown版から成ります。狙いは、エージェントがナビゲーション・スクリプト・クッキーバナーを解析して答えを探す手間を省くことです。
2026年11月時点の状況です。
- コーディングエージェントやAIクライアントは使っている。 仕様書によれば、llms.txtファイルは「コーディングエージェントがAPIリファレンスやチュートリアルを探すためにたどる、ソフトウェアドキュメントで最も重く使われている」とされます。Zendeskは2026年11月4日、開発者向けドキュメントにllms.txtとmarkdownページを追加し、発表では開発者に対し、自分のエージェントへ検索インデックスとして
developer.zendesk.com/llms.txtを与えるよう伝えています。 - 検索エンジンには不要。 Googleは、AI OverviewsとAI Modeには通常の検索適格性以上の「追加の技術要件はない」としています。ChromeのLighthouse llms.txt監査は、ファイルがないことを「現時点ではファイルの提供は任意であるため」該当なしと判定します。
- 顧客のヘルプセンターはまだ大半が持っていない。 2026年11月17日、support.zendesk.com、docs.helpscout.com、support.freshdesk.comで
/llms.txtをリクエストしたところ、3件すべてが404を返しました。これらと同じ企業のヘルプセンター自体は問題なくランクし引用されており、llms.txtが優先順位リストのどこに位置するかがうかがえます。
開発者コミュニティはこれがどれほど重要かについて意見が分かれており、どちらの側にも一理あります。
"LLMs are not reading llms.txt nor AGENTS.md files from servers. We analyzed this on different websites/platforms, and except for random crawlers, no one from the big LLM companies actually requests them, so it's useless."

"llms.txt files have nothing to do with crawlers or big LLM companies. They are for individual client agents to use. I have my clients set up to always use them when they're available, and since I did that they've been way faster and more token efficient when using sites that have llms.txt files."
2つ目のコメントは、llms.txtの提案を書いたJeremy Howard本人のアカウントによるもので、仕様書の内容とも一致しています。llms.txtは索引を作るクローラーのためではなく、探しに来るエージェントのためのものです。ヘルプセンターを開発者のコーディングエージェント(APIプロダクト、開発者向けツール、SDKを持つもの全般)が読むなら、やる価値があります。消費者向けのヘルプセンターなら、安価な保険のようなもので、ランキングを動かすレバーではありません。
プラットフォームが代わりにやってくれるなら、有効にしてそのまま次へ進みましょう。
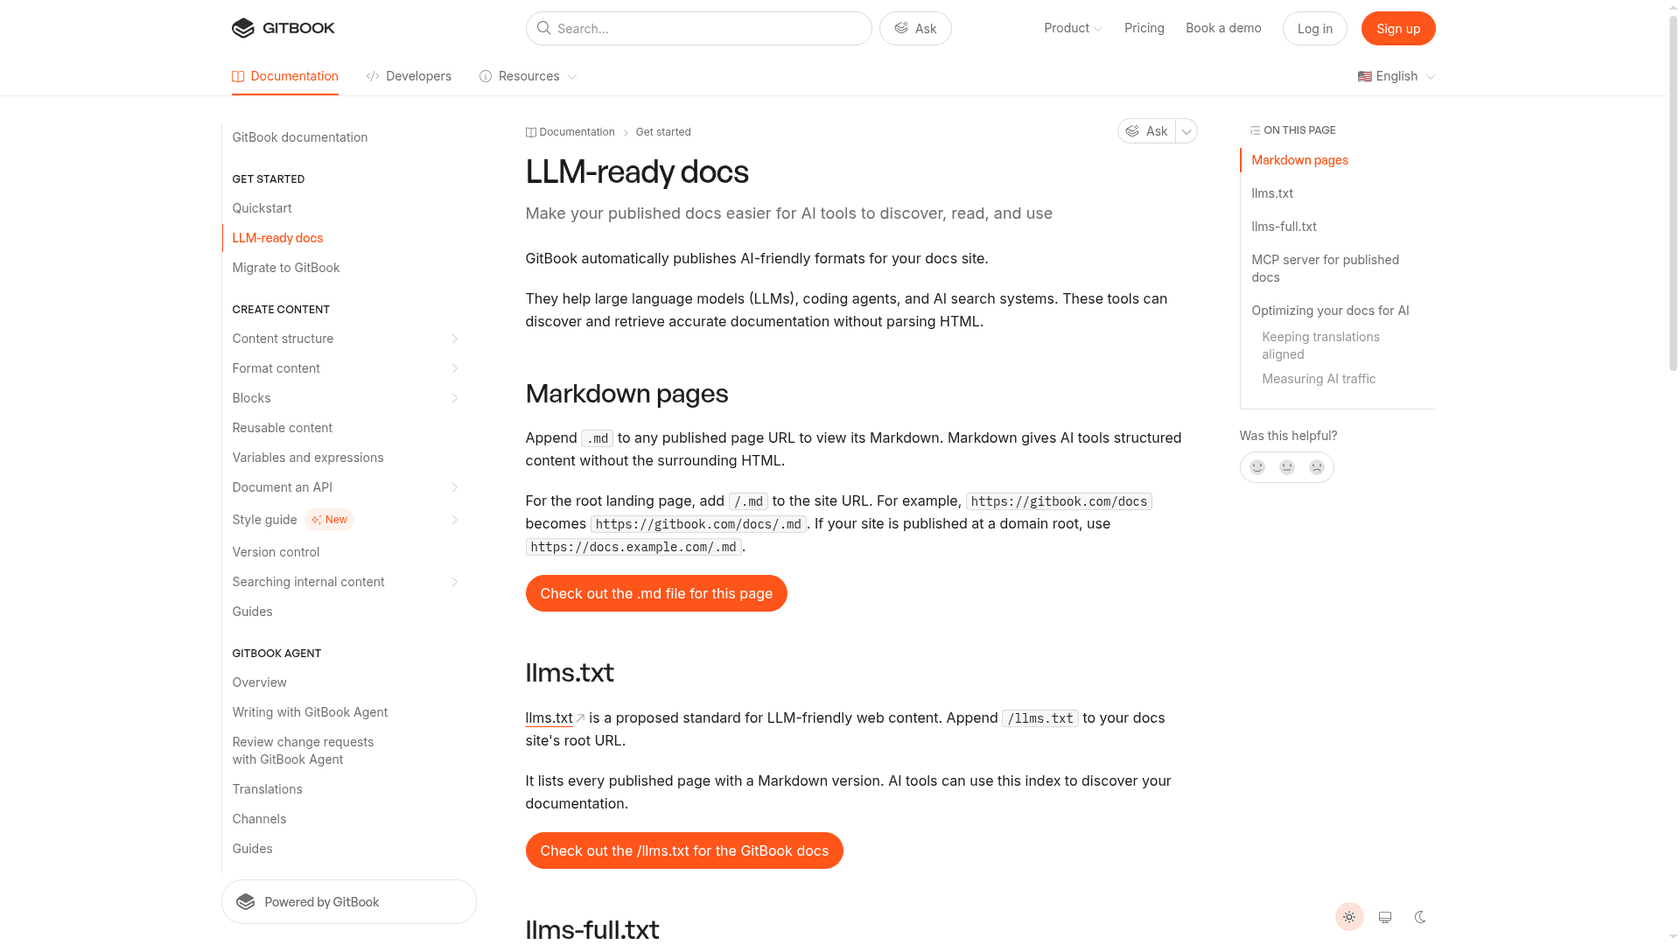
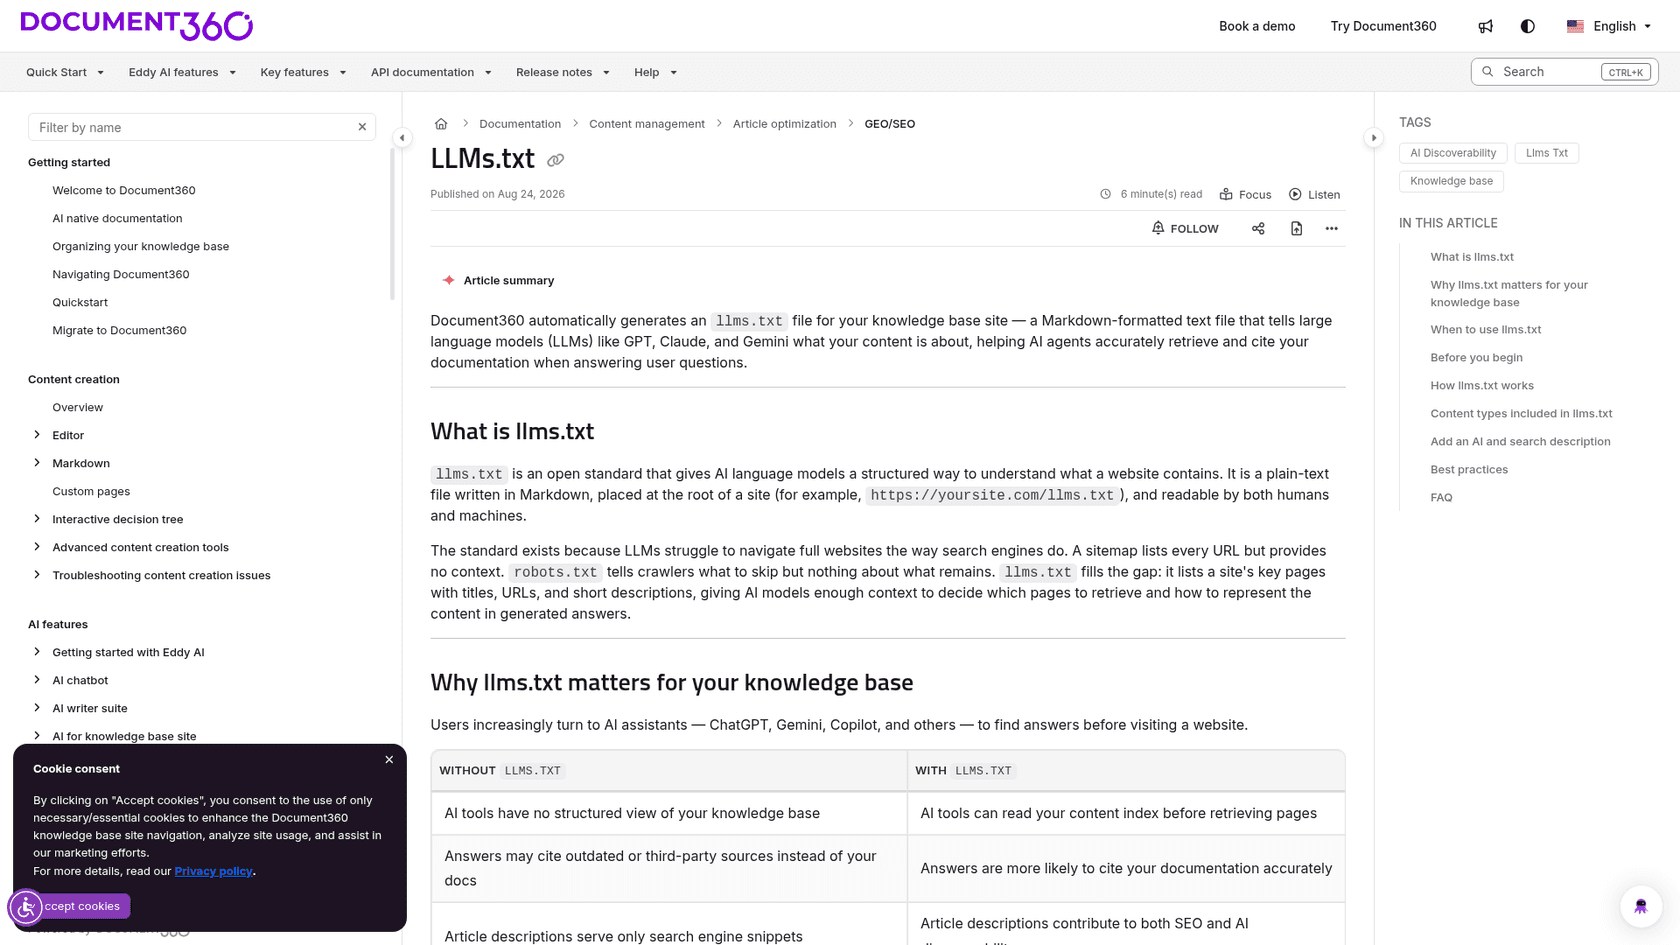
| プラットフォーム | llms.txt | markdownページ | 注意点 |
|---|---|---|---|
| GitBook | 自動、さらにllms-full.txtも | 任意のページに.mdを付ける | 非表示ページもllms-full.txtとMCPサーバーには含まれ続ける |
| Mintlify | 自動、/.well-known/llms.txtにも | .mdを付ける。HTMLページからmarkdown版へリンクされる | 「Don't index project」設定はllms.txtには404を返すがllms-full.txtには返さない |
| Document360 | 自動、公開ごとに更新 | ページに「View as Markdown」がある | 公開コンテンツのみ含まれる。説明文のない記事はタイトルのみで表示される |
| Zendeskのヘルプセンター | 見つけられる標準機能はない。MarketplaceのKnowledgeBridgeアプリが両ファイルを生成 | アプリ経由、または自前のヘルプセンター書き出し | 結果のホスティングと更新は自分で行う |
GitBookの行は、もう一度見る価値があります。GitBook自身のドキュメントによると、「ページを非表示にしても、公開済みの目次から外れるだけ」です。古くなった記事や社内向けの記事を非公開化ではなく非表示にしていた場合、エージェントは依然として読むことができます。
ステップ7:MCPサーバーを提供する。どの種類かを理解しておく
MCP(Model Context Protocol)は、AIアプリがHTMLをスクレイピングする代わりに、ヘルプセンターをツールとして呼び出し、検索したりページを読んでmarkdownを受け取ったりできるようにします。これには大きく異なる2種類があり、サポートチームはよく混同します。
公開ドキュメント向けMCPサーバーは誰のAIでも使えます。GitBookは/~gitbook/mcpで「公開済みのドキュメントサイトごとにModel Context Protocol(MCP)サーバーを公開している」としています。Mintlifyの検索MCPサーバーはエージェントに3つのツールを提供します。検索、読み取り専用のドキュメントファイルシステム、そして「エージェントが間違っている、古い、分かりにくい、または不完全なページを見つけたときにドキュメントの問題をチームへ報告する」フィードバック送信ツールです。この最後のツールこそ、私が最初に真似したいアイデアです。あなたのドキュメントを読むエージェント自身が、そこで不具合報告を提出するというものです。
アカウント向けMCPサーバーは、チーム自身のAIツール向けで、あなたの権限で動きます。
- Help ScoutのMCPは、Claude、ChatGPT、CursorをConversations、Customers、Docsのコンテンツに接続します。APIアクセス(Standard、Plus、Proプラン)とナレッジベースツール用のDocs APIキーが必要で、AIエージェントは「その特定のユーザーアカウントが見ることを許可されたデータにしかアクセスしない」とされています。これは顧客向けのHelp Scoutのセルフサービスツールとは別の役割です。
- Zendesk Bridgeは早期アクセス段階で、Claude、ChatGPT、Copilot、Geminiなどの外部エージェントが、統制されたMCP接続経由でヘルプセンターを検索しチケットを処理できるようにします。詳細はZendeskのEAP記事にあります。これは、逆方向に動きZendeskから他のツールを呼び出せるようにするZendesk自身のMCPクライアントとは別物です。
- Document360のMCPは、ChatGPTとClaudeをナレッジベースに接続し、記事の検索や管理を行います。
どちらの種類も、ステップ1から3の代わりにはなりません。MCPサーバーは記事をより速く、より綺麗に返しますが、古くなった記事を正しくすることはできません。エージェントがこれらのサーバーをどう使うかの背景については、AIエージェント向けMCPサーバーに関する記事でカバーしています。ZendeskのChatGPTチャネルの早期アクセスプログラムも方向性を示しており、ChatGPT内で「アカウントのヘルプセンターのコンテンツから直接」生成される回答が、その会話型ヘルプセンターと並んで提供されるようになります。
AIエージェントが正しく読んでいるかはどうテストする?
聞いてみることです。当たり前に聞こえますが、それを定期的に行っている人はほとんどいません。先月のチケットから、回答に数字が入る具体的な質問を10件選び、3つの場所でテストします。
- 検索をオンにしたChatGPT、Claude、Perplexity。 ヘルプセンターを引用しているか、その数字が最新かどうかを確認します。
- 生のフェッチ。
curl -A "OAI-SearchBot" https://help.yoursite.com/your-articleを実行し、出力の中に肝心な一文があるか検索します。欠けていれば、JavaScriptを実行しないクローラーにはそれが見えません。 - 顧客に見せる前の、自社のサポートAI。 eeselでは、すべてのロールアウトを事前に過去のチケットに対してテストします。自信ありげに聞こえて間違っているボットは、ボットがいない場合より信頼を失わせるからです。
開発者向けドキュメントについては、ChromeのLighthouseのエージェンティックブラウジングカテゴリ(Chrome 150以降、まだ実験的)が、llms.txt、レイアウトの安定性、アクセシビリティツリーが健全かどうかをチェックし、これをページの「機械の目から見た視点」と呼んでいます。
私が見た中で最も良いテストループは、すべてのチケットで実行されるものです。ERP企業のQontroはFreshdeskをeeselに接続し、ヘルプセンター、サポートフォーラム、そして約9,800件の過去チケットを読み込ませました。新しいチケットごとに、関連するヘルプ記事をリンクした内部メモとして下書き回答が付きます。チームは各下書きと実際に人が送った返信を比較し、下書きが間違っていた場合は「それは通常、記事が欠けているか不完全であること、あるいはルールを絞る必要があることを示している」としています。そのヘルプセンターは毎週金曜に再同期されます。現在、約10件中1件の下書きはほとんど、あるいは一切編集せずに送られており、これまでの大きな収穫は、下書きがどこに欠落があるかを示してくれることです。
これは、別のプロジェクトを立てずにできるナレッジギャップ分析です。Innrは逆方向から同じ誠実さのルールを使っています。ヘルプセンターがその質問を扱っていなければ、eeselはそう伝えて推測せずに引き渡します。引き渡しの1件1件が欠けている記事であり、検索クエリをヘルプセンターの欠落に対応付けることでも見つけられます。
どんな間違いがヘルプセンターをAIに読みにくくするのか?
私がよく見る順に、おおよそ被害の大きい順です。
- 記事を直す前にllms.txtを出す。 ページの一覧は速くなりますが、内容が正しくなるわけではありません。
- 「AIボットを全部ブロック」をコピーしたrobots.txt。 学習用クローラーと一緒にOAI-SearchBotやClaude-SearchBotまでブロックしてしまい、AI検索の回答からヘルプセンターが外れます。
- 非公開化ではなく非表示にする。 GitBookでは、非表示ページも
llms-full.txtとMCPサーバーには残り続けます。 - スクリーンショットの中にある回答。 すでに文書化していることについてAIが「見つけられませんでした」と言う最も多い理由です。
- 1つの質問に2つの現行回答がある。 AIは新しい方ではなく、より近そうに見える断片を引用します。
- 月1回のボット同期。 公開検索は数時間で追いつきますが、同期が遅いと自社のボットがヘルプセンターより後れを取ります。
eesel:ヘルプセンターでサポートチームメイトを育てる
ヘルプセンターを読む主なAIが自社のサポートボットなら、それを読みやすくする最も早い方法は、実際に読む様子を見ることです。eeselのAIヘルプデスクチームメイトはヘルプデスクに参加し、ヘルプセンター・マクロ・過去のチケットから学び、元記事をリンクした下書きや送信を行います。チームが編集する下書きの一つ一つが、より明確な回答・日付・統合が必要な記事を示してくれます。Qontroで起きたのと同じことです。
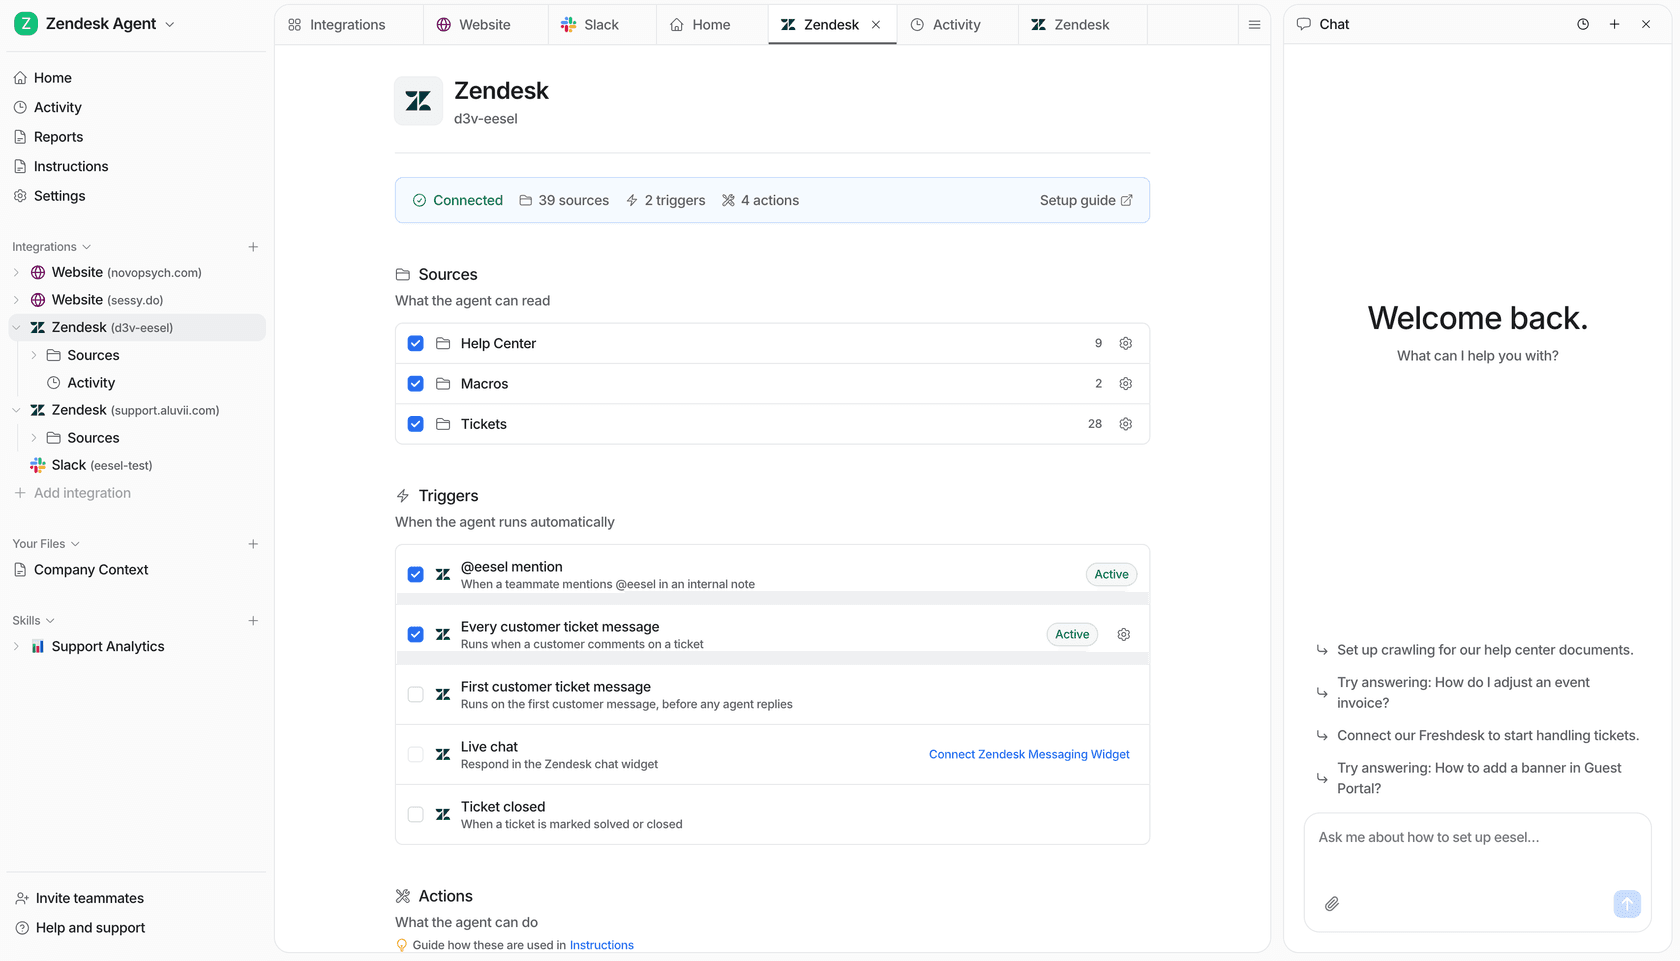
端末から、コーディングエージェントはeesel integrations sources zendeskを実行して、ヘルプセンターの同期が実際に何を保持しているかを確認し、承認済みのポリシーファイルをアップロードし、何かが顧客に届く前にeesel chatでテスト質問を実行できます。ヘルプデスク連携そのものの承認には、管理者権限を持つ人が今も必要です。eeselを試すのは無料で、直近10件のチケットを実際に通してみてください。