

Un modèle de communication de panne est un texte approuvé à l'avance pour chaque étape d'incident (investigation, identifié, surveillance, résolu, post-mortem) sur chaque canal, avec des blancs pour ce qui est cassé, qui est concerné et quand viendra la prochaine mise à jour. Copie l'ensemble ci-dessous, mais deux règles comptent plus que le texte : chaque mise à jour nomme l'heure de la prochaine mise à jour, et chaque canal copie depuis une seule note d'incident approuvée par ton responsable d'incident. Atlassian dit de ne jamais laisser passer plus d'une heure entre deux mises à jour.
Pour le flot de tickets, le coéquipier IA pour le support d'eesel répond aux tickets de problèmes connus à partir de cette même note directement dans ton support, et transmet les cas limites à une personne. Avec la CLI eesel, un agent de code peut charger la note approuvée et tester les réponses d'abord ; un administrateur reste nécessaire pour connecter le support.
Clique sur une étape pour changer le texte de la page de statut, de la bannière et du support pour ce moment de la panne.
Que doit dire toute mise à jour de panne ?
Je travaille chaque jour dans la file de support d'eesel, et dans une mauvaise journée, le premier signe qu'un problème est survenu est la même question qui revient sans cesse dans la file. Le modèle, c'est ce qui arrête cela. Une bonne mise à jour de panne répond à quatre questions avant que le client n'ait à les poser : ce qui est cassé, qui est concerné, ce que tu fais, et quand tu en diras plus.
Cette structure n'est pas mon invention. Le guide d'incident.io découpe une mise à jour client dans les mêmes parties : donner du contexte pour que les gens ne supposent pas le pire, dire ce que tu fais, fixer des attentes, dire aux gens quoi faire, et dire quand viendra la prochaine mise à jour. La bibliothèque de modèles d'Atlassian est construite de la même façon, et la moitié de ses modèles d'investigation se terminent par "We will send an additional update in NEXT_UPDATE minutes."
Les quatre étapes viennent directement des outils de pages de statut. La documentation de publication d'incident.io les définit en une ligne chacune : Investigation signifie que tu n'es pas encore sûr du problème, Identifié signifie que tu travailles sur une solution, Surveillance signifie que les clients doivent s'attendre à un retour à la normale mais que ta réponse n'est pas encore terminée, et Résolu signifie que tout est revenu à la normale. Chaque étape demande un détail différent, ce qui explique pourquoi un message générique "nous sommes conscients d'un problème" étiré sur quatre heures ressemble à du silence.
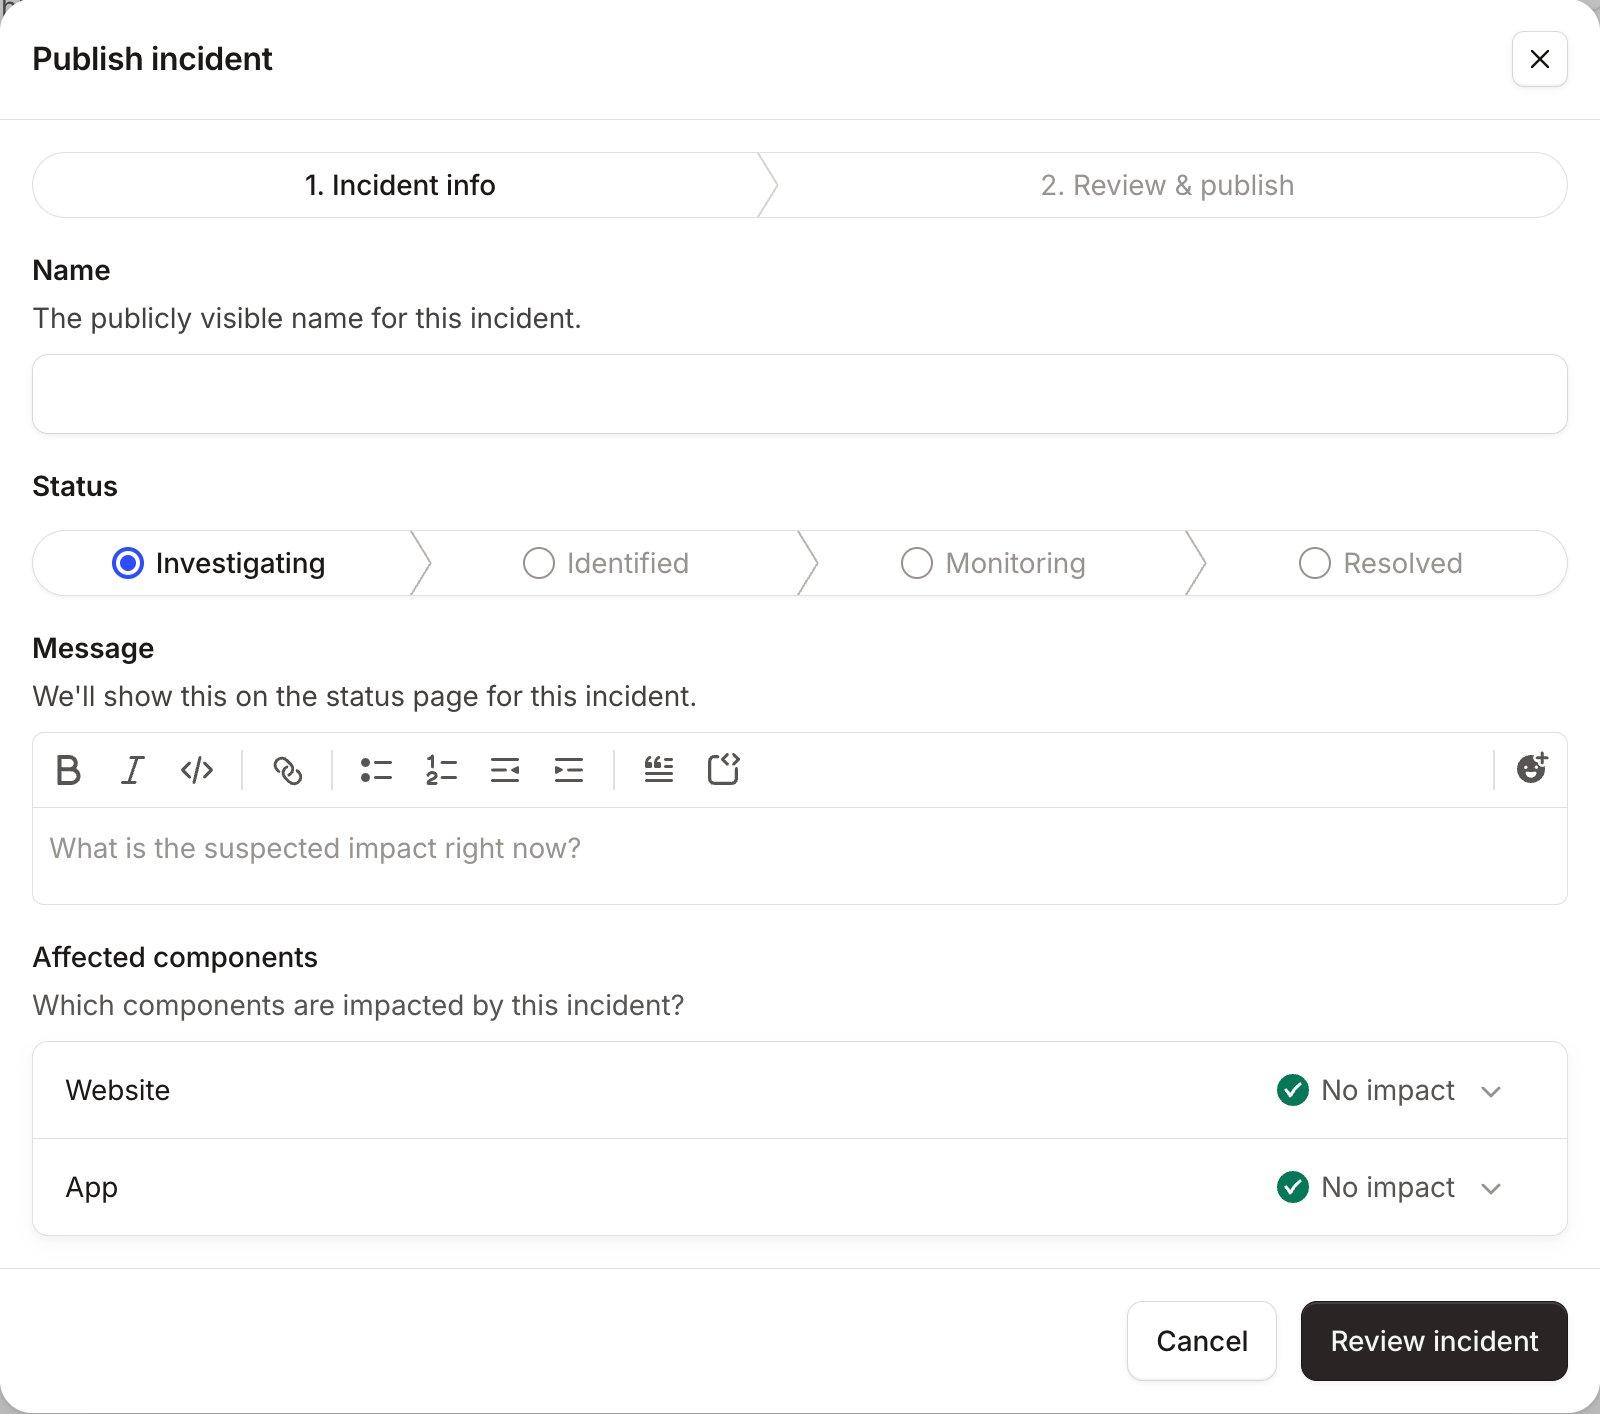
Remarque ce que demande le formulaire : un nom, un statut, un message et les composants affectés. Le nom devient l'objet de l'e-mail pour les abonnés, selon la même documentation, donc écris le titre pour quelqu'un qui ne lit que l'objet. "Les tableaux de bord ne chargent pas pour certains utilisateurs de l'UE" vaut mieux que "Perturbation du service".
À quelle fréquence faut-il publier des mises à jour de panne ?
Au moins toutes les heures tant que les clients sont affectés, et toutes les 30 minutes si tu peux le gérer. Le guide de communication d'incidents d'Atlassian recommande "never going more than one hour without sending an update" pour tout ce qui affecte encore les clients, et dit d'indiquer toujours quand viendra la prochaine mise à jour.
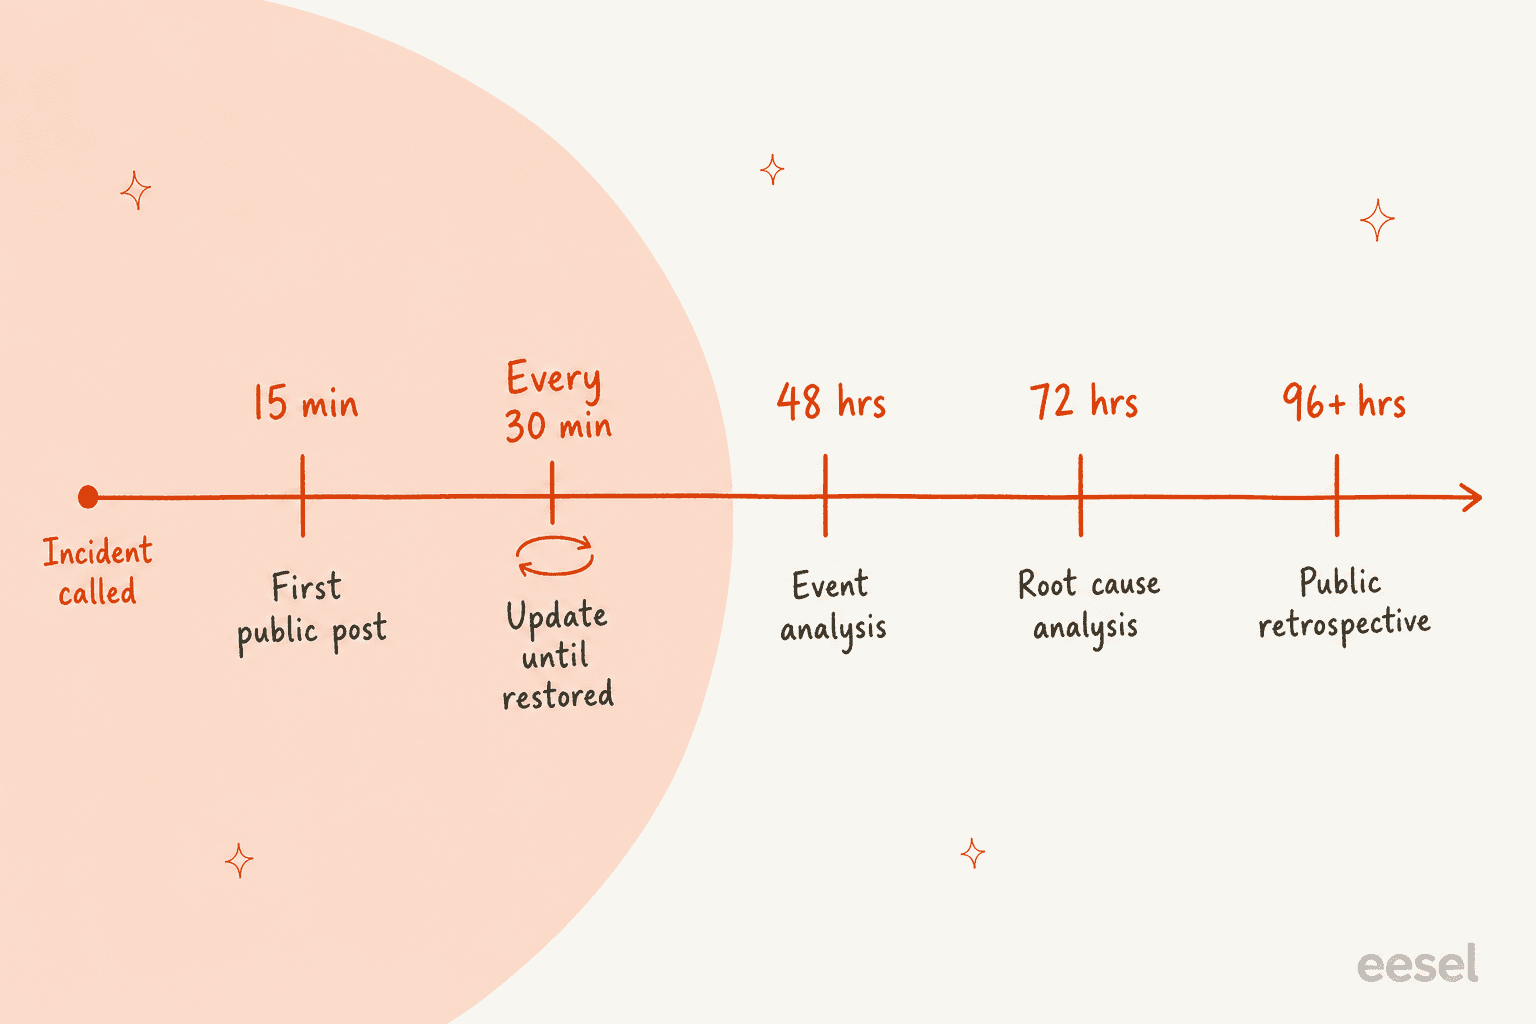
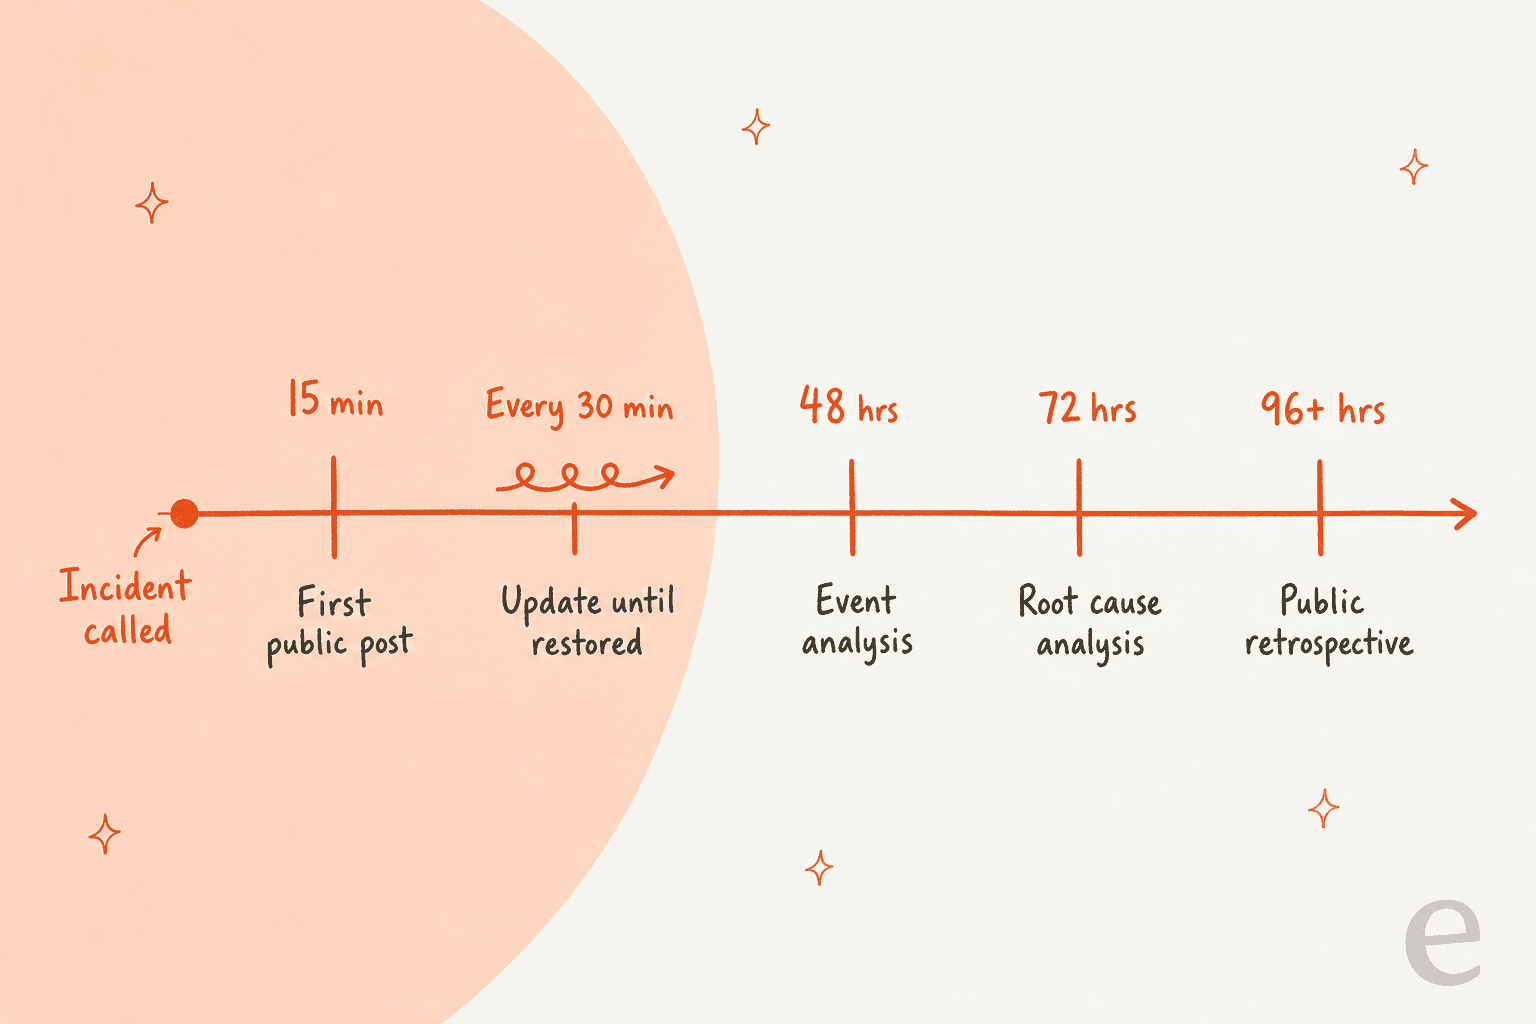
Zendesk publie son propre calendrier, l'exemple public le plus concret que j'ai trouvé. Son article sur la gestion des incidents liste les délais internes qu'il respecte :
| Étape | Objectif de Zendesk |
|---|---|
| Annonce publique | Dans les 15 minutes après la déclaration de l'incident |
| Mises à jour de l'incident | Toutes les 30 minutes jusqu'au rétablissement du service, ou dès qu'une nouvelle information arrive |
| Analyse de l'événement (gravité 0 et 1) | Dans les 48 heures après la résolution |
| Analyse de la cause racine | Dans les 72 heures après la résolution |
| Rétrospective publique de l'incident | Dans les 96 heures ou plus après la résolution |
Le chiffre compte moins que le respect de la promesse. Si tu dis "prochaine mise à jour à 14h30" et que tu publies à 14h50, les 20 minutes suivantes de tickets porteront sur la mise à jour manquée, pas sur la panne. Les clients remarquent aussi quand tu la respectes :
"They also updated the status page every hour (or when they had new information), which is what they said they would do in their status updates."

Encore un piège de rythme : se répéter, ce n'est pas grave, devenir obsolète, ça l'est. incident.io souligne qu'il existe "a zillion different ways" de dire que tu enquêtes encore, et un horodatage frais avec "pas de changement, on y travaille encore" vaut mieux qu'un message intact datant de trois heures. Si ton équipe de support fonctionne avec des minuteurs de SLA, décide à l'avance si les tickets de panne les mettent en pause ; ce guide de gestion des SLA couvre les options.
Qui est responsable de quel canal de panne ?
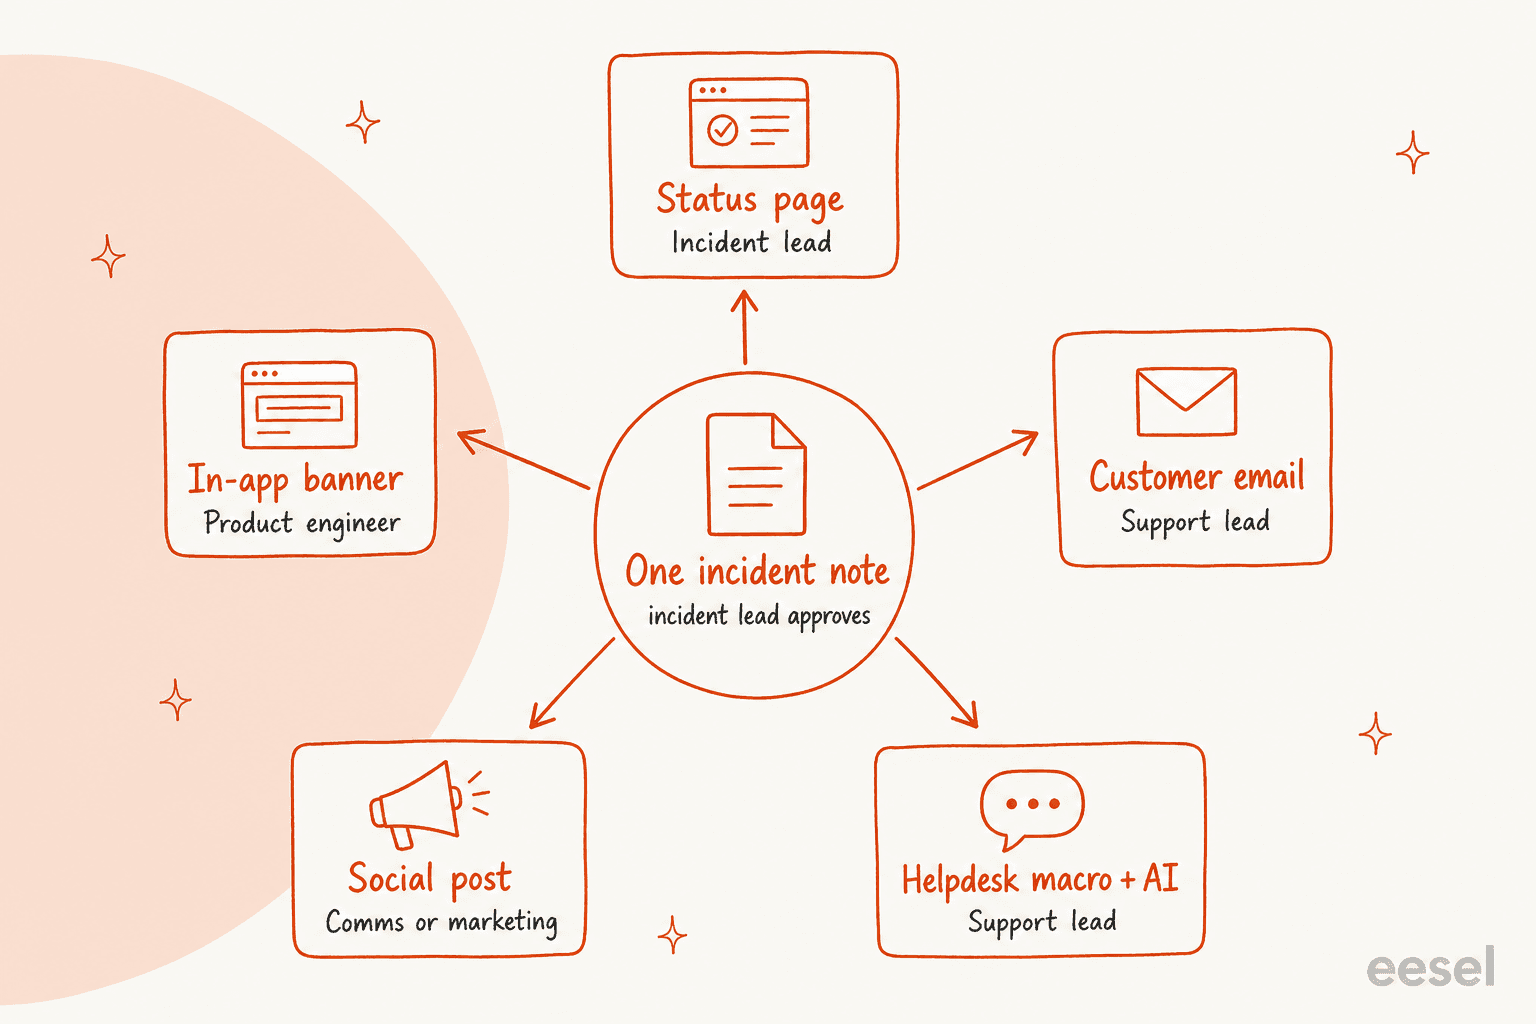
Une personne approuve la note d'incident, et chaque canal a exactement un responsable nommé qui s'en inspire. Sans cela, la page de statut dit "certains utilisateurs", la bannière dit "tous les utilisateurs" et la réponse d'un agent dit "devrait être résolu dans 10 minutes", et tu te retrouves avec trois versions différentes.
Voici la répartition par laquelle je commencerais dans une entreprise SaaS de 20 à 200 personnes :
| Canal | Responsable | Copie depuis la note | Quand l'utiliser |
|---|---|---|---|
| Page de statut | Responsable de l'incident (ou communication d'astreinte) | Mise à jour complète | Tout incident visible par les clients |
| Bannière dans l'app | Ingénieur produit sur l'incident | Une ligne + lien de statut | Quand les utilisateurs sont dans le produit en panne |
| E-mail client | Responsable support | Résumé + quoi faire | Pannes longues, impact sur les données, ou comptes clés |
| Post sur les réseaux sociaux | Communication ou marketing | Une ligne + lien de statut | Quand les clients en parlent déjà publiquement |
| Réponse automatique, macros et IA du support | Responsable support | Texte de l'étape en cours | Toujours, dès le premier ticket en double |
Atlassian fait le même constat sur la stratification : l'entreprise publie les incidents sur sa page de statut, pousse les mises à jour vers les réseaux sociaux, et affiche une annonce dans son portail de service, chaque message renvoyant vers la page de statut. Son guide liste aussi l'équipe de support de première ligne comme son propre public, les personnes qui "directly answering questions and giving customers updates", ce qui est la partie que la plupart des playbooks d'incident oublient. Si ton équipe de support n'apprend la cause que via la page de statut publique, tu as déjà perdu 15 minutes. Une solution simple est d'acheminer les mises à jour d'incident vers le canal de support, de la même façon que tu connecterais Zendesk à Slack pour les alertes de tickets.
Que doivent dire la page de statut et la bannière dans l'app ?
Le widget ci-dessus contient le texte de la page de statut et de la bannière pour chaque étape. Trois règles se cachent derrière.
Commence par le symptôme du client, pas par ton système. "Les paiements échouent au moment de payer" est quelque chose qu'un client peut relier à ce qu'il voit. "Taux d'erreur élevé sur payments-api" ne l'est pas. La bibliothèque d'Atlassian conserve bien certains titres au niveau système ("Elevated API Errors", "Webhook failures"), qui fonctionnent pour un public de développeurs. Adapte les mots à qui lit ta page.
Nomme l'ampleur honnêtement. "Certains utilisateurs" et "tous les utilisateurs" signifient des choses différentes pour un client qui décide d'attendre ou d'escalader. Si tu ne sais pas encore, dis "certains utilisateurs" et précise dans la mise à jour suivante, jamais l'inverse.
Donne au canal de support une solution de repli. La bibliothèque d'Atlassian a un modèle pour le cas où le portail de support lui-même est en panne, renvoyant les clients vers un e-mail ou un compte de réseau social secondaire. Ce n'est pas paranoïaque. Pendant la panne de Cloudflare du 18 novembre 2025, sa page de statut est également tombée, même si elle est hébergée entièrement hors de l'infrastructure de Cloudflare. C'était une coïncidence, mais cela a brièvement convaincu une partie de l'équipe qu'elle subissait une attaque.
Pour la bannière, vérifie si ton outil la retire pour toi. La documentation sur les annonces de statut de Better Stack dit clairement que l'annonce ne se met pas à jour automatiquement selon le statut du service ; tu la retires en effaçant le texte et en enregistrant.
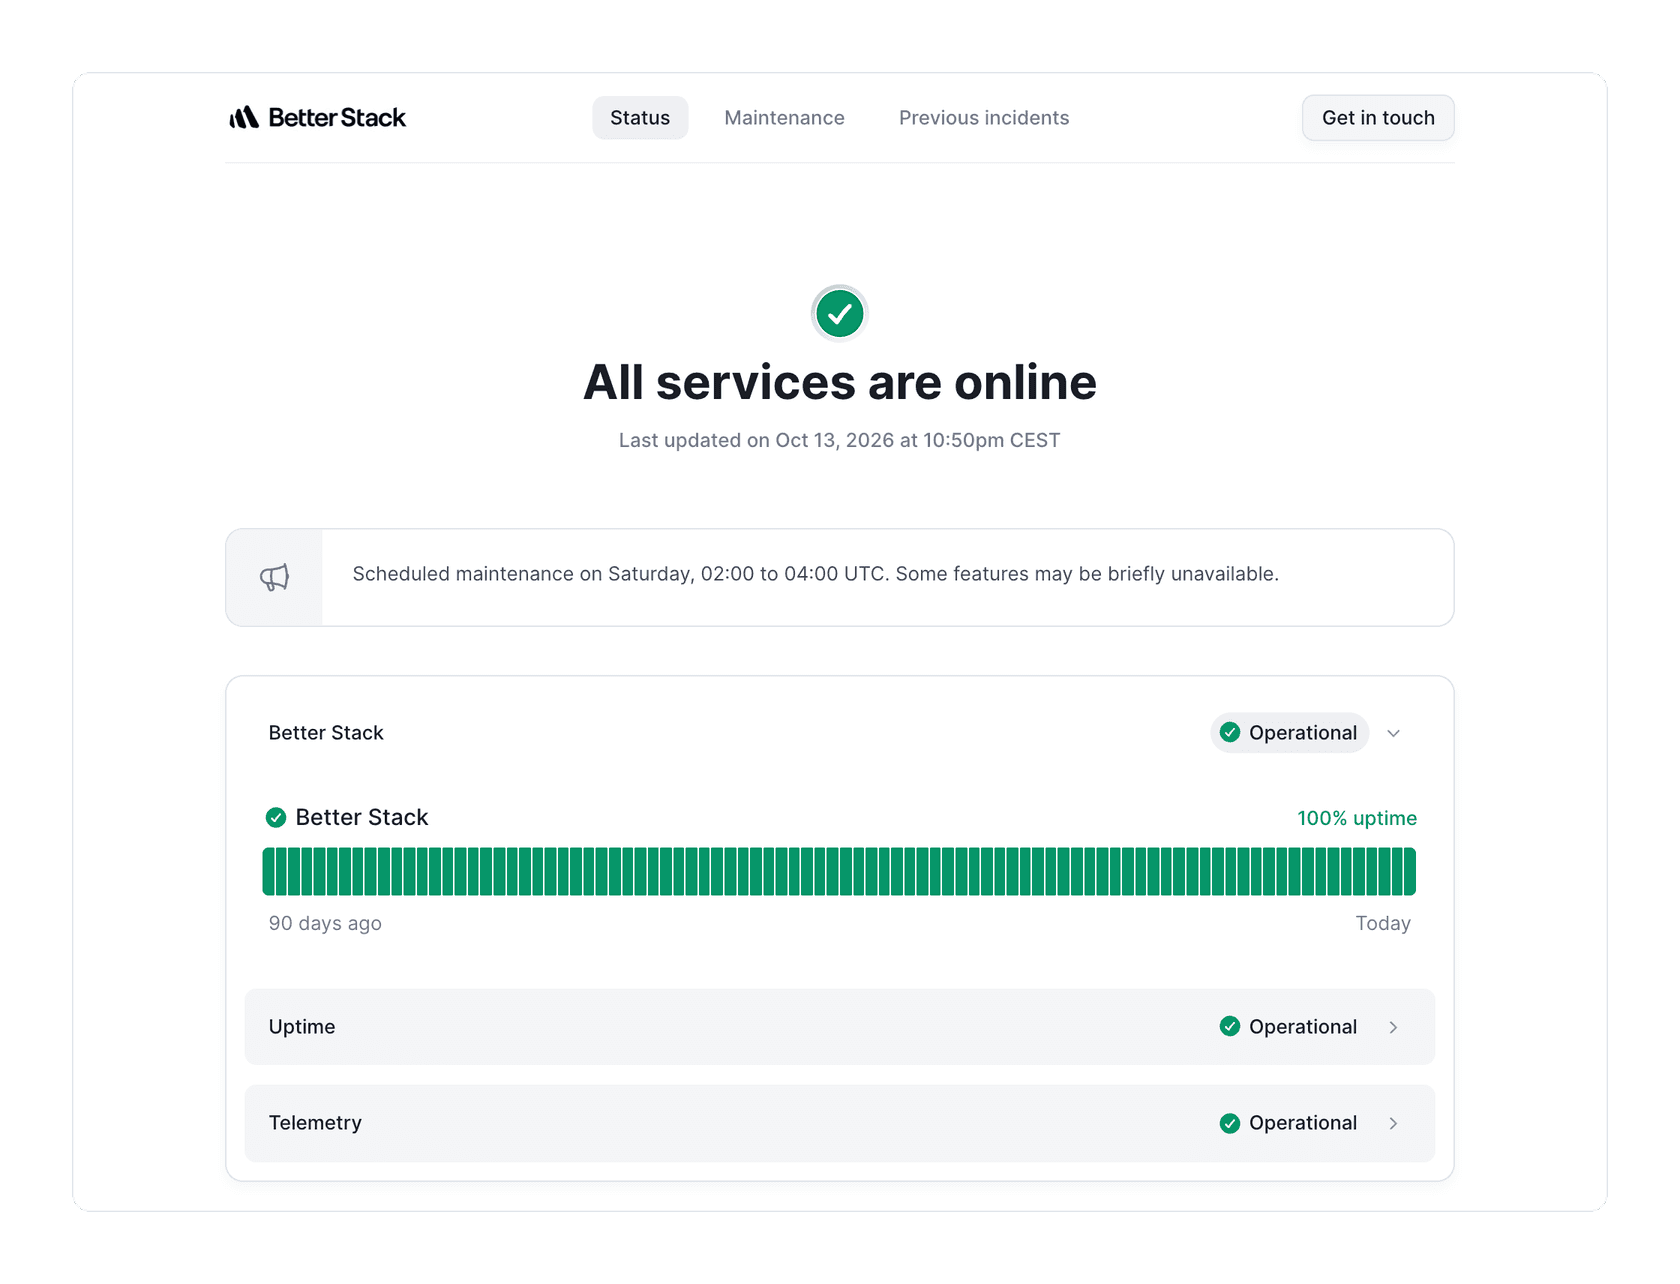
Mets "retirer la bannière" sur la check-list de résolution, sinon les clients verront un avis de panne pour un problème que tu as corrigé hier. Les mises à jour de statut automatiques ont leur propre piège : la documentation sur les mises à jour de page de statut de Better Stack note que modifier une mise à jour automatique la transforme en mise à jour manuelle, et tu dois alors ajouter toi-même la mise à jour Résolu. Si tu utilises Atlassian, mon guide sur les pages de statut de Jira Service Management couvre le côté configuration.
Que doit dire l'e-mail de panne envoyé aux clients ?
L'e-mail est pour les pannes qui durent assez longtemps, ou frappent assez fort, pour que les clients aient besoin de quelque chose dans leur boîte de réception : retards de données, paiements échoués, panne de plusieurs heures, ou comptes avec SLA. Pour un incident de 15 minutes, la page de statut et les notifications aux abonnés suffisent. Voici les deux e-mails que je ferais approuver à l'avance.
E-mail 1 : avis de panne (envoyé une fois, tôt, aux comptes concernés)
Objet : [Fonctionnalité] est indisponible pour certains comptes en ce moment

Bonjour [prénom],

Depuis [heure de début, fuseau horaire], [fonctionnalité] est
[ce qu'ils voient, par ex. ne charge pas / envoie des notifications
retardées] pour certains comptes, dont le tien.

Ce que nous savons : [une phrase, ou "nous enquêtons encore sur la
cause"].
Ce que tu peux faire : [solution de contournement, ou "rien, tes
données sont en sécurité et en file d'attente"].
Ce que nous faisons : [les ingénieurs travaillent sur un correctif /
nous annulons un changement].

Les mises à jour en direct sont sur [lien de la page de statut], et
nous t'écrirons à nouveau quand ce sera corrigé. Si cela bloque
quelque chose d'urgent, réponds à cet e-mail et il arrivera
directement à notre équipe de support.

[Nom], support de [Entreprise]
E-mail 2 : résolution (envoyé à tous ceux qui ont reçu l'e-mail 1)
Objet : Résolu : [fonctionnalité] fonctionne à nouveau

Bonjour [prénom],

[Fonctionnalité] fonctionne à nouveau normalement. Le problème a
duré de [début] à [fin] [fuseau horaire].

Ce qui s'est passé : [une phrase simple, sans noms de systèmes
internes].
Tes données : [aucune donnée n'a été perdue / X a été retardé et a
maintenant rattrapé le retard / ce qui a été touché et ce que nous
avons fait].
La suite : nous partagerons un compte-rendu complet avant le [date]
sur [lien].

Je suis désolé que cela ait perturbé ta journée. Si quelque chose ne
va toujours pas, réponds ici et nous regarderons ton compte
directement.

[Nom], support de [Entreprise]
Deux remarques sur ces e-mails. Envoie l'e-mail 2 exactement à la liste qui a reçu l'e-mail 1, pour que personne ne reste dans le doute. Et limite les excuses à une ligne qui nomme l'impact ; mes exemples de messages d'excuses et mes modèles d'e-mails de service client approfondissent le ton.
Que faut-il publier sur les réseaux sociaux pendant une panne ?
Les réseaux sociaux sont un panneau indicateur, pas une seconde page de statut. Le guide d'Atlassian dit de les utiliser comme partie du plan mais pas comme ton seul canal. Publie quand les clients parlent déjà publiquement de la panne, reste bref, et mets toujours un lien vers la page de statut pour que les mises à jour vivent au même endroit.
Investigation : certains clients ne peuvent pas [action] dans
[produit] en ce moment. On s'en occupe. Mises à jour en direct :
[lien de la page de statut]

Identifié : nous avons trouvé la cause du problème de [fonctionnalité]
d'aujourd'hui et nous le corrigeons. Mises à jour toutes les
30 minutes ici : [lien de la page de statut]

Résolu : [fonctionnalité] fonctionne à nouveau normalement. Désolé
pour la perturbation d'aujourd'hui. Ce qui s'est passé et ce que
nous changeons : [lien]
Réponds aux plaintes individuelles avec le lien de statut et une invitation à ouvrir un ticket, pas par un dépannage en public. Si quelqu'un partage des détails de compte dans une réponse, déplace-le vers le support.
Comment gérer le flot de tickets de panne dans le support ?
C'est là que les responsables support perdent le plus de leur journée, et c'est le canal que la plupart des plans de panne oublient. Trois modèles font le gros du travail : une réponse automatique, une macro avec des tags, et une note interne pour que les agents n'improvisent pas.
Réponse automatique pendant que l'incident est ouvert
Objet : Re : {%subject%}

Merci de nous avoir contactés. Nous savons que [fonctionnalité] ne
fonctionne pas pour certains clients en ce moment et nos ingénieurs
le corrigent. Mises à jour en direct : [lien de la page de statut].

Tu n'as rien à faire, et tu n'as pas besoin d'envoyer un autre
message. Nous mettrons à jour cette conversation une fois résolu.
Si ta question ne porte pas sur ce problème, réponds et une personne
s'en occupera.
Vérifie comment ton support envoie les réponses automatiques avant de compter sur l'une d'elles. La réponse automatique de Help Scout ne part que vers le premier e-mail d'une conversation, et vers chaque adresse une fois par 24 heures par défaut, donc un client qui a déjà reçu ta réponse automatique normale ce matin ne verra pas celle de la panne. Si tu es sur Zendesk ou Gorgias, mes guides sur les réponses automatiques Zendesk et les réponses automatiques Gorgias couvrent la configuration des déclencheurs, et les bonnes pratiques de réponse automatique couvrent le texte.
Macro pour les agents (ajoute un tag et la réponse de l'étape en cours)
Nom de la macro : Panne - [ID de l'incident] - [étape]
Actions :
  Ajouter le tag : outage_[incident_id]
  Définir le type : Incident (relié au ticket de problème)
  Commentaire (public) : [coller la réponse support pour l'étape
    en cours]
Dans Zendesk, seuls les administrateurs peuvent créer des macros partagées pour toute l'équipe, donc construis le jeu de panne avant d'en avoir besoin, et les macros s'appliquent à un ou plusieurs tickets à la fois. Le levier le plus puissant est le ticket de problème : quand tu le résous, la documentation sur les tickets de problème et d'incident de Zendesk dit que chaque ticket d'incident relié est résolu et reçoit le même commentaire. Cela fait de ton modèle résolu le seul message qui ferme toute la pile. Mon tour d'horizon des types de tickets Zendesk montre la liaison, et tu peux aussi automatiser le type de ticket. Sur Freshdesk, les équivalents sont les réponses prédéfinies et les tickets reliés. Si construire cela est nouveau pour toi, commence par comment créer une macro et mes modèles de macros.
Note interne pour les agents (épingle-la là où ils travaillent)
PANNE [ID de l'incident] - étape en cours : [Investigation]
Dernière mise à jour : [heure] par [responsable de l'incident]
À dire : [résumé sûr pour le client en deux lignes]
À ne pas dire : une ETA, la cause avant qu'elle soit confirmée,
  "tous les utilisateurs", quoi que ce soit sur des crédits.
Escalader vers [nom/canal] : signalements de perte de données,
  questions de sécurité, comptes entreprise, toute personne demandant
  un remboursement ou un crédit.
Prochaine mise à jour prévue : [heure]
La liste "à ne pas dire" est la ligne qui te sauve. Les agents sous pression remplissent le silence de suppositions, et une ETA inventée dans un ticket devient une capture d'écran dans une plainte une heure plus tard.
Que ne faut-il jamais promettre dans un message de panne ?
Ne promets jamais ce que la note d'incident ne dit pas. En pratique, ce sont quatre choses :
- Une ETA qu'on ne t'a pas donnée. Le guide d'incident.io dit "It's absolutely fine to say 'we don't know how long it'll take'", et qu'après quelques heures les clients peuvent raisonnablement attendre une estimation en heures, jours ou semaines. Avant cela, l'heure de la prochaine mise à jour fait le travail.
- Une cause racine avant qu'elle soit confirmée. Le propre compte-rendu de Cloudflare dit que l'équipe a d'abord "wrongly suspected" une attaque DDoS à grande échelle. Imagine cette supposition dans une mise à jour publique.
- Une ampleur que tu n'as pas vérifiée. Dire "aucune donnée n'a été perdue" avant que l'ingénierie ne le confirme est la promesse qui revient te mordre.
- Des crédits ou des remboursements sans politique définie. Transmets toujours cela à une personne.
L'honnêteté sur l'état des choses compte plus que le poli. Ce commentaire, dans un fil sur la panne de l'API d'Instagram alors que sa page de statut restait verte, résume comment les clients lisent une page en décalage avec la réalité :
"There is nothing more frustrating than a status page that lies about the state of an API. Feels like insult + injury. I'd rather they not even have a status page!"
Et l'échec inverse, le silence, est perçu tout aussi mal :
"A status page is not something you update only when things are calm. It is part of the response itself. It is how you keep users informed and maintain trust when everything else is going wrong."
La même règle s'applique à toute IA qui répond aux tickets pour toi. SE Ranking, qui utilise eesel sur le chat Zendesk pour trois produits, a configuré son agent pour qu'il ne promette jamais ce que l'équipe ne peut pas livrer : pas de "un agent humain arrive maintenant", pas de remises, pas de remboursements. Quand un client a besoin d'une personne, l'agent dit de s'attendre à une réponse en un ou deux jours ouvrés et transmet avec le nom et l'e-mail du client.
Que doit dire le post-mortem destiné aux clients ?
Des faits simples avec des heures, des excuses sans réserve, et ce que tu changes. Les meilleurs exemples publics suivent une forme similaire. L'historique de statut de GitHub le montre en deux couches : la mise à jour de résolution est courte ("This incident has been resolved... A detailed root cause analysis will be shared as soon as it is available."), et le résumé de l'incident qui suit commence par des heures exactes : "Between 19:05 and 21:27 UTC on November 13, 2026, GitHub Copilot experienced degradation...", puis nomme la cause et ce qui a été fait.
Le compte-rendu de Cloudflare commence par l'heure de début en UTC, dit sans détour que la panne "was not caused, directly or indirectly, by a cyber attack", et s'excuse sans réserve : "We know we let you down today." Voici un modèle destiné aux clients construit sur cette forme :
Titre : panne de [fonctionnalité] le [date] : ce qui s'est passé et ce que nous changeons

Résumé
Le [date], entre [début] et [fin] [fuseau horaire], [nombre ou part
de] clients [ce qu'ils ont vécu]. [Le problème n'a pas été causé par
un incident de sécurité / quel impact de sécurité il y a eu.]

Ce que tu as vécu
- [Symptôme 1, par ex. les tableaux de bord ne chargeaient pas]
- [Symptôme 2, par ex. les notifications ont été retardées de
  jusqu'à X minutes]
- [Impact sur les données, indiqué avec précision]

Ce qui s'est passé
[Deux à quatre phrases simples : le changement ou la défaillance,
pourquoi cela s'est propagé, comment nous l'avons trouvé, comment
nous l'avons corrigé.]

Chronologie ([fuseau horaire])
[HH:MM] [Premier impact client]
[HH:MM] [Incident déclaré, première mise à jour publique]
[HH:MM] [Cause identifiée]
[HH:MM] [Correctif déployé, surveillance]
[HH:MM] [Résolu]

Ce que nous changeons
- [Changement 1, avec équipe responsable et date cible]
- [Changement 2]

Nous sommes désolés. [Une phrase nommant l'impact sur les clients.]
Si tu as des questions sur ton compte, réponds à [adresse de
support].
Écris-le tant que c'est frais. Le guide de post-mortem d'Atlassian suggère de documenter dans les 24 à 48 heures après la résolution, et Zendesk vise sa rétrospective publique 96 heures ou plus après. Si tu veux de l'aide pour rédiger la version interne, l'article sur les comptes-rendus post-incident rédigés par IA couvre ce que fait l'outil d'Atlassian.
Où l'IA s'intègre-t-elle dans la communication de panne ?
Surtout dans le support, là où se trouve le volume. La page de statut, c'est un post toutes les 30 minutes ; le support peut recevoir des centaines de tickets presque identiques dans la même fenêtre. Mes collègues ont écrit les articles plus longs sur le support par IA pendant les pannes SaaS, l'IA pour les mises à jour de pages de statut et l'IA pour la communication des incidents majeurs, donc ici je me limite à comment les modèles ci-dessus s'intègrent.
La mise en place est simple à décrire : la note d'incident actuelle devient le savoir à partir duquel l'IA répond, et les lignes "à ne pas dire" et "escalader" deviennent ses règles. Le coéquipier IA pour le support d'eesel (voir la comparaison dans ce tour d'horizon du support par IA) fonctionne dans ton Zendesk ou Freshdesk existant, donc les tickets de panne reçoivent la réponse de l'étape en cours dans le même fil que tes agents utilisent, et tout ce qui sort du script, comme une demande de remboursement ou un signalement de perte de données, part vers une personne avec le contexte joint. Cela aide aussi ton taux de déviation les jours de panne, sans toucher aux tickets qui demandent du jugement.

Changer les instructions de l'agent se fait par un message de chat, comme dans la capture ci-dessus, ce qui compte quand l'incident passe d'Identifié à Surveillance et que le texte doit changer avec lui. SamCart est un bon exemple de ce que cela donne à grand volume : l'entreprise fait tourner un agent eesel sur les tickets Freshdesk et un autre sur le chat de son site, répondant à partir d'environ 280 articles du centre d'aide, sur un forfait de 8 000 interactions par mois, qu'un mois chargé a déjà dépassé.
Trois choses que je ferais avant la prochaine panne :
- Charge les modèles comme savoir dès maintenant. Télécharge à l'avance les réponses par étape, la réponse automatique et la liste "à ne pas dire". Avec la CLI eesel, un agent de code IA peut exécuter
eesel files uploadsur la note d'incident approuvée en plein incident, puis poser des questions de test à l'agent aveceesel chatet vérifier les réponses avant qu'il ne réponde aux clients. Connecter le support lui-même demande toujours quelqu'un avec un accès administrateur pour l'approuver dans cet outil. - Teste le transfert, pas seulement les réponses. J'ai vu ce qui se passe quand ce n'est pas testé : un de nos clients d'hébergement web néerlandais sur Zendesk avait un bot qui disait aux clients qu'il les transférait à une personne alors que le transfert n'avait jamais lieu. Un jour de panne, c'est le pire échec possible, donc fais une escalade simulée de bout en bout. Mes guides sur le transfert humain dans le chat et l'escalade IA couvrent ce qu'un transfert propre doit comporter.
- Mesure-le après. Tague chaque ticket de panne touché par l'IA et vérifie la qualité de la contention et de l'escalade dans le post-mortem, avec la chronologie de la page de statut. SE Ranking a demandé exactement cela, un tag
ai_handledsur chaque ticket que touche eesel, pour que la contention soit comptée dans Zendesk plutôt que devinée.
Essaie eesel pour ta prochaine panne
Si ta page de statut est couverte mais que ton support se noie chaque fois que quelque chose casse, eesel est l'élément que j'ajouterais. Il rejoint ton support existant comme une nouvelle recrue support, répond aux tickets de problèmes connus à partir de la note d'incident que tu as approuvée, utilise ton texte de l'étape en cours à mesure que l'incident avance, et transmet à ton équipe les remboursements, les questions sur les données et tout ce qui n'est pas clair. Tu peux voir comment il gère tes propres tickets passés avant même qu'il ne parle à un client.

Essaie eesel sur ton support, ou regarde d'abord les tarifs.
Comment fermer des centaines de tickets de panne d'un coup ?