

L'IA pour les mises à jour de la page de statut fonctionne mieux orientée dans l'autre sens : que la page de statut alimente l'IA, et non l'IA la page de statut. La page de statut est le seul endroit où l'ingénierie s'est mise d'accord sur ce qui est vrai. Un agent IA qui la lit peut associer chaque ticket « est-ce en panne ? » à l'incident déclaré, répondre avec le texte publié mot pour mot et relancer chaque ticket quand la page indique Resolved.
Rédiger la mise à jour de statut elle-même reste une décision humaine. L'IA peut la préparer à partir du canal de l'incident, mais un ingénieur l'approuve avant sa publication, car ce message touche tous les clients en même temps.
La plomberie existe déjà : Statuspage envoie un webhook à chaque mise à jour d'incident dès l'offre Startup à 99 $, et Zendesk comme Freshdesk regroupent les tickets de panne, mais ni l'un ni l'autre n'écrit les réponses pendant la panne. Ce vide est le travail d'un coéquipier IA comme eesel, que SE Ranking fait tourner sur 4,650 conversations par mois, avec des agents configurés pour ne jamais promettre ce que l'équipe ne peut pas tenir.
Pourquoi la page de statut est-elle en retard sur la boîte de réception du support ?
Je construis des intégrations chez eesel, ce qui veut dire que je passe beaucoup de temps à lire ce que les API et les webhooks envoient réellement, par opposition à ce que dit la page marketing. Les pages de statut en sont un bon exemple. Tous les grands outils de page de statut annoncent déjà chaque mise à jour d'incident à tout ce qui s'abonne. La plupart des helpdesks ne s'abonnent jamais.
Pendant une panne, deux horloges tournent donc en même temps. L'ingénierie répare et, quand quelqu'un a une minute, publie une mise à jour. Le support voit arriver des tickets avec la même question formulée de cinquante façons, et chaque agent consulte Slack, la page de statut et ses collègues pour savoir ce qu'il a le droit de dire. Un commentateur de Hacker News a résumé simplement le point de vue du client :
"If I'm having issues but you show all green, I'm submitting a case."

Et le retard est réel. Un autre commentateur, à propos de la panne d'un hébergeur :
"they only updated the status page to indicate that there's an issue ~20 minutes into the outage."
Vingt minutes, c'est long dans une file de support, et votre délai de première réponse en pâtit. La solution à laquelle la plupart des équipes pensent est « faire écrire les mises à jour de statut plus vite par l'IA ». Je pense que cela règle le petit problème. Le plus gros, c'est que la page de statut et le helpdesk ne se parlent pas, si bien que chaque agent devient un relais humain entre les deux. Si vous avez lu mon guide du support pendant les pannes, cet article en est la tuyauterie : comment la page de statut devient la source de vérité de l'IA.
Comment l'IA et la page de statut doivent-elles travailler ensemble ?
Le schéma que je mettrais en place comporte cinq étapes, et une seule fait écrire quelque chose de nouveau à l'IA.
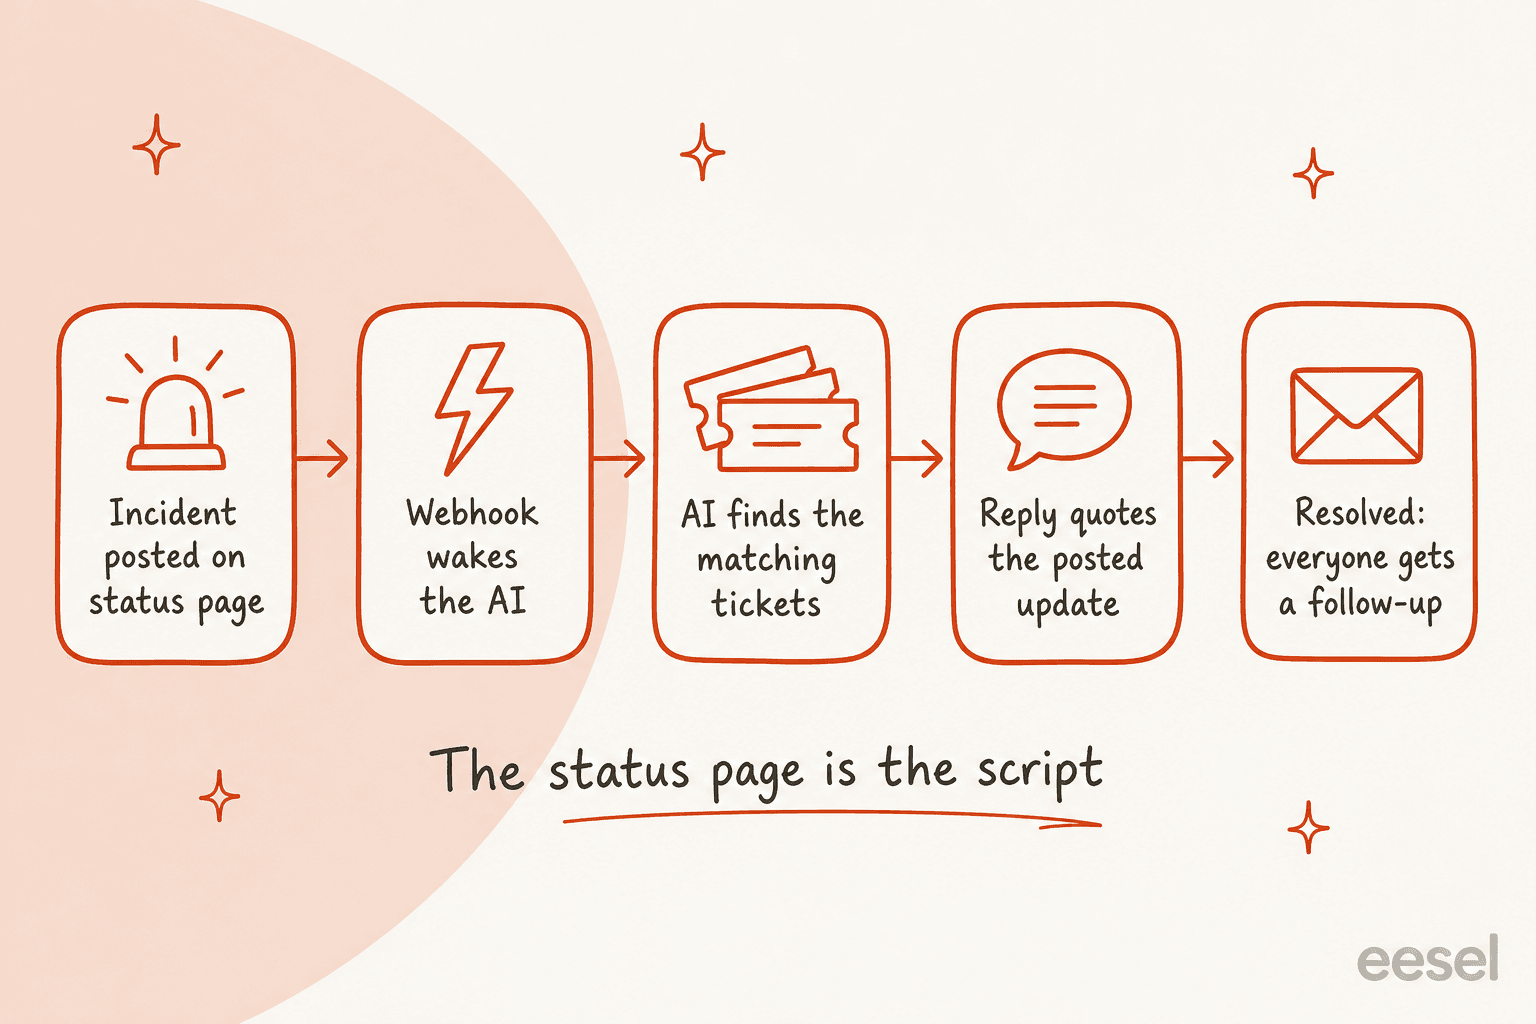
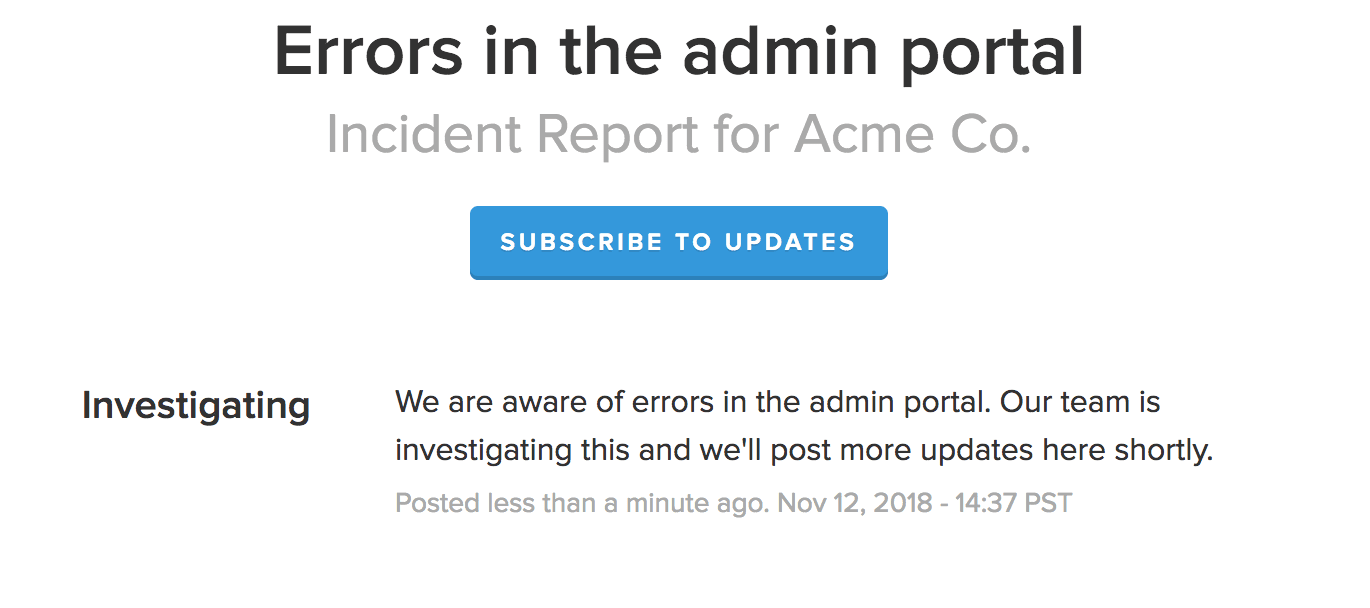
- Un ingénieur publie l'incident. Sur Atlassian Statuspage, cela représente un nom, l'un des quatre statuts (Investigating, Identified, Monitoring, Resolved), un message et les composants touchés.
- La page de statut prévient l'IA. Un webhook se déclenche à chaque création ou mise à jour, et l'IA lit le nom de l'incident, le statut, le message et les composants.
- L'IA trouve les tickets correspondants. Les tickets nouveaux et ouverts qui décrivent le composant touché sont étiquetés avec l'incident, un peu comme la déduplication de tickets regroupe les questions répétées.
- La réponse cite la page de statut. Le client reçoit le message publié et un lien, rien que les ingénieurs n'aient écrit.
- Resolved boucle la boucle. Quand le statut passe à Resolved, chaque ticket étiqueté reçoit une relance, y compris ceux qui étaient restés silencieux.
Cet ordre compte parce que l'IA ne décide jamais de ce qui est vrai au sujet de la panne. Elle décide quels tickets concernent la panne, un travail de tri où l'IA est bonne. Les faits viennent de la page.
Qu'envoient réellement les webhooks et les API des pages de statut ?
C'est la partie qui m'importe le plus, car elle détermine ce que vous pouvez construire sans code sur mesure.
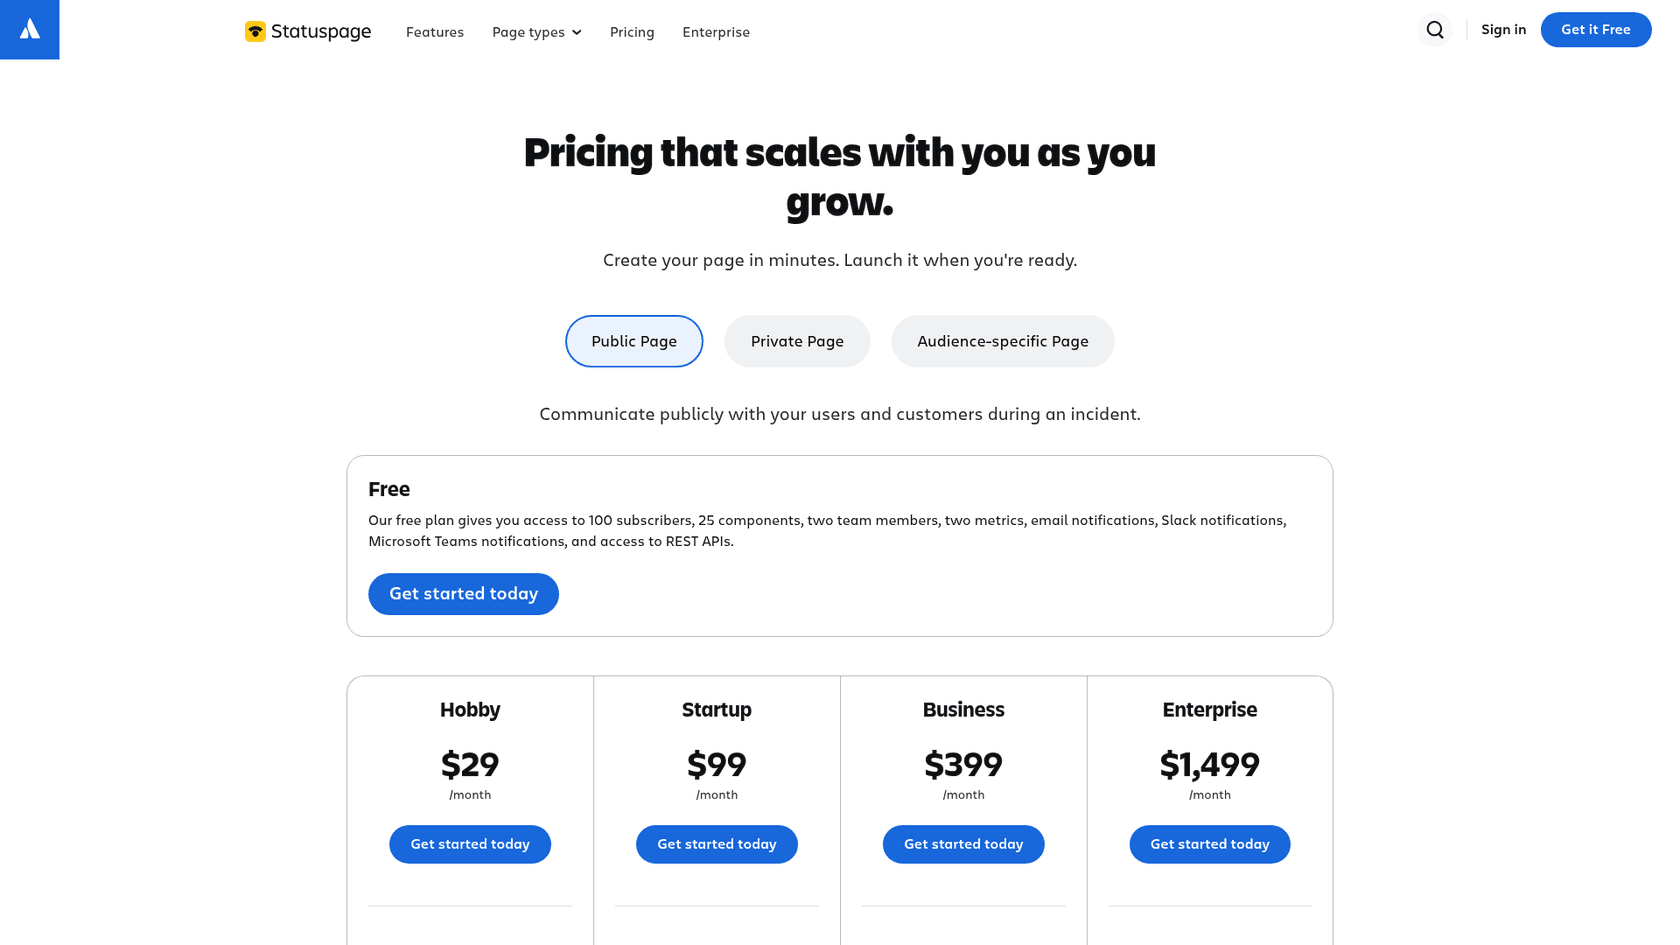
Atlassian Statuspage peut envoyer un webhook "when you create or update an incident, or update a component status", d'après son guide des notifications par webhook. La charge utile contient le statut global de la page, le composant modifié avec son ancien et son nouveau statut, ou l'incident et sa dernière mise à jour. Votre point de terminaison doit répondre par un code 2xx en moins de 30 secondes. Les notifications par webhook commencent avec l'offre Startup à 99 $ par mois ; Free et Hobby ne listent que l'e-mail, Slack et Teams.
Il existe aussi un côté lecture. Chaque page Statuspage publique expose un point de terminaison de synthèse avec l'indicateur de statut, les statuts des composants et les incidents non résolus, sans clé. L'API REST de Statuspage authentifiée permet de créer et de mettre à jour des incidents, limitée à 1 requête par seconde et par jeton. Cette limite convient pour publier des mises à jour et ne convient pas pour de l'interrogation régulière depuis un helpdesk très sollicité.
incident.io intègre la page de statut à son flux de gestion des incidents, de sorte que "you're prompted to post when it matters most", et vous pouvez "automate updates entirely or use templates with pre-approved messaging", selon sa page sur les status pages. Les clients s'abonnent par e-mail, Slack et RSS.
PagerDuty indique que ses pages de statut externes permettent aux visiteurs de s'abonner "via email, Slack or webhook", ce qui donne le même déclencheur par push que Statuspage.
Pour une configuration eesel, un push devient une automatisation par webhook : vous demandez une URL à l'agent, vous la collez dans la page de statut comme abonné webhook, et chaque mise à jour d'incident réveille l'agent avec la charge utile complète. Un en-tête de livraison comme X-Eesel-Reference, fixé à l'identifiant de l'incident, regroupe toutes les mises à jour d'un incident sur la page Activity. Pour une page qui ne peut pas envoyer de push, Network Access permet à l'agent d'appeler directement l'API de la page de statut, la clé étant stockée dans les paramètres et jamais montrée à l'IA.
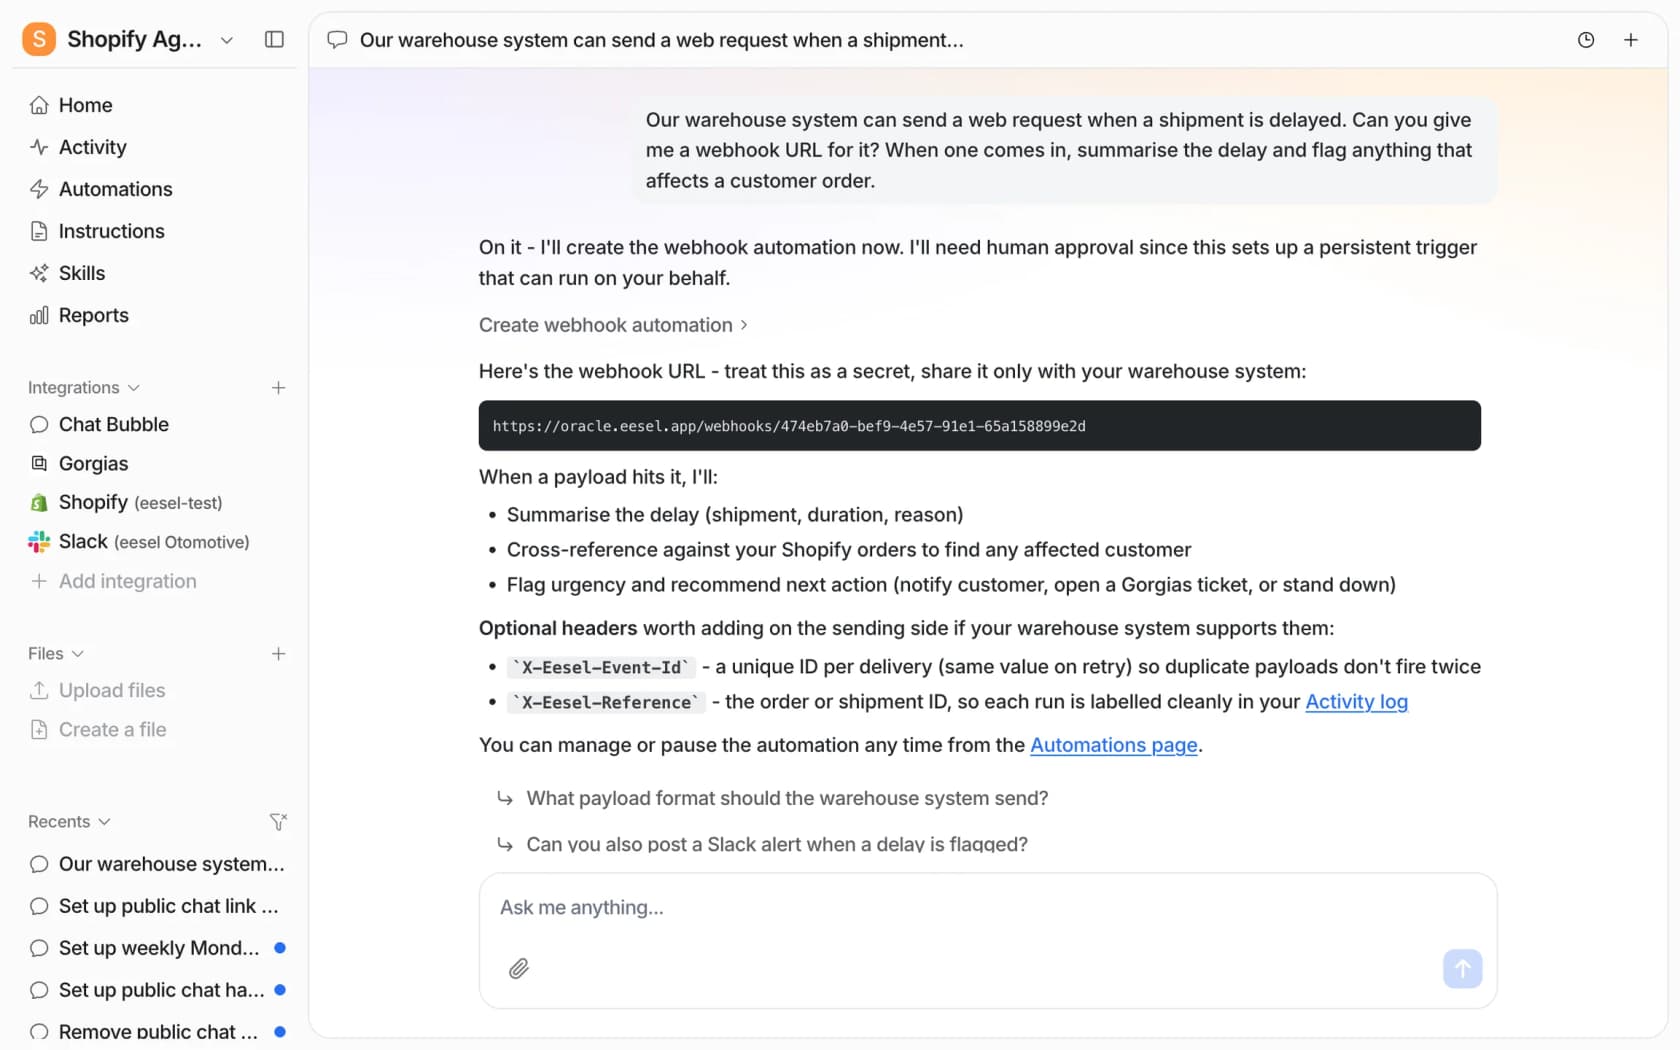
Deux limites à connaître avant un incident, pas pendant. L'URL de webhook d'eesel accepte 60 livraisons par minute et par espace de travail et en traite huit à la fois. Une page de statut envoie une poignée de mises à jour par incident, c'est donc largement suffisant, mais c'est la raison pour laquelle je ne brancherais jamais le flux brut d'alertes d'un outil de supervision dessus. Alimentez-la avec l'incident confirmé par un humain, pas avec chaque à-coup.
Comment l'IA doit-elle trier les tickets de panne ?
Une fois que l'IA sait quel incident est en cours, chaque ticket entrant va dans l'une de quatre voies. C'est là que se trouve l'essentiel de la valeur, et là que la plupart des configurations sont trop grossières.
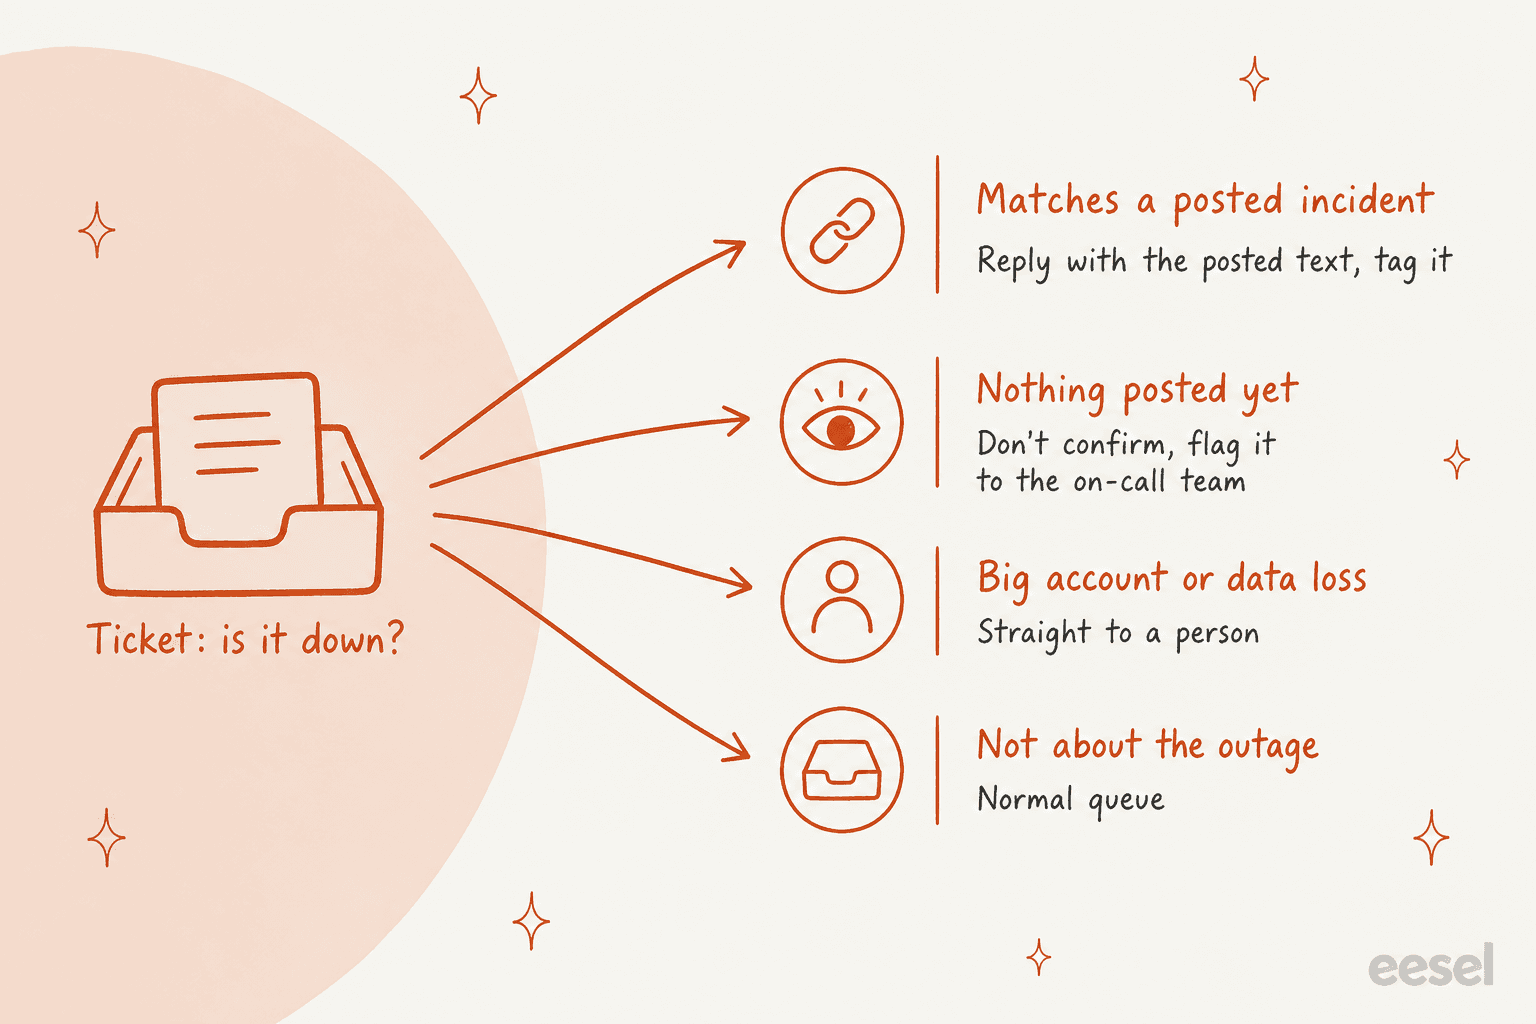
Correspond à un incident publié. Le ticket mentionne le composant touché, ou le symptôme que décrit l'incident. L'IA répond avec le dernier message publié, renvoie vers la page de statut, dit que le ticket sera mis à jour à la résolution et ajoute une étiquette d'incident. C'est la voie au plus gros volume et celle à automatiser en premier, selon la même logique que toute automatisation de la première réponse.
Rien de publié pour l'instant. Les clients remarquent souvent avant la page. Ici, l'IA ne doit pas confirmer une panne, car elle n'a rien pour la confirmer. Elle peut dire que l'équipe vérifie, étiqueter le ticket et poster une alerte dans le canal d'astreinte. Cinq tickets sur le paiement en dix minutes sans incident publié, c'est un signal d'alerte précoce, et le support le voit généralement en premier. Quand l'incident est publié, l'IA revient sur ces tickets et y répond aussi.
Gros compte ou perte de données. Certains tickets ne devraient pas recevoir une réponse type, aussi exacte soit-elle. Les comptes entreprise nommés, quiconque signale des données perdues, quiconque cite un SLA, quiconque demande des crédits. Ils vont à une personne via vos règles habituelles d'escalade IA. Qontro, un éditeur de logiciels ERP qui utilise eesel sur Freshdesk, envoie les pannes, les pertes de données et les questions de facturation directement à une personne plutôt que de laisser l'IA les diagnostiquer.
Sans rapport avec la panne. Une question de facturation qui arrive en plein incident reste une question de facturation. Elle va dans la file normale, et l'IA ne devrait pas y coller le texte de l'incident simplement parce que le moment coïncide. Surveillez ce cas lors des tests, car c'est la fausse correspondance la plus fréquente, le même défaut que je traite dans réduire les faux positifs.
Que doit dire l'IA en pleine panne, et que ne doit-elle jamais dire ?
Les règles sont courtes, et elles font la différence entre une IA qui calme les clients et une IA qui crée un deuxième incident.
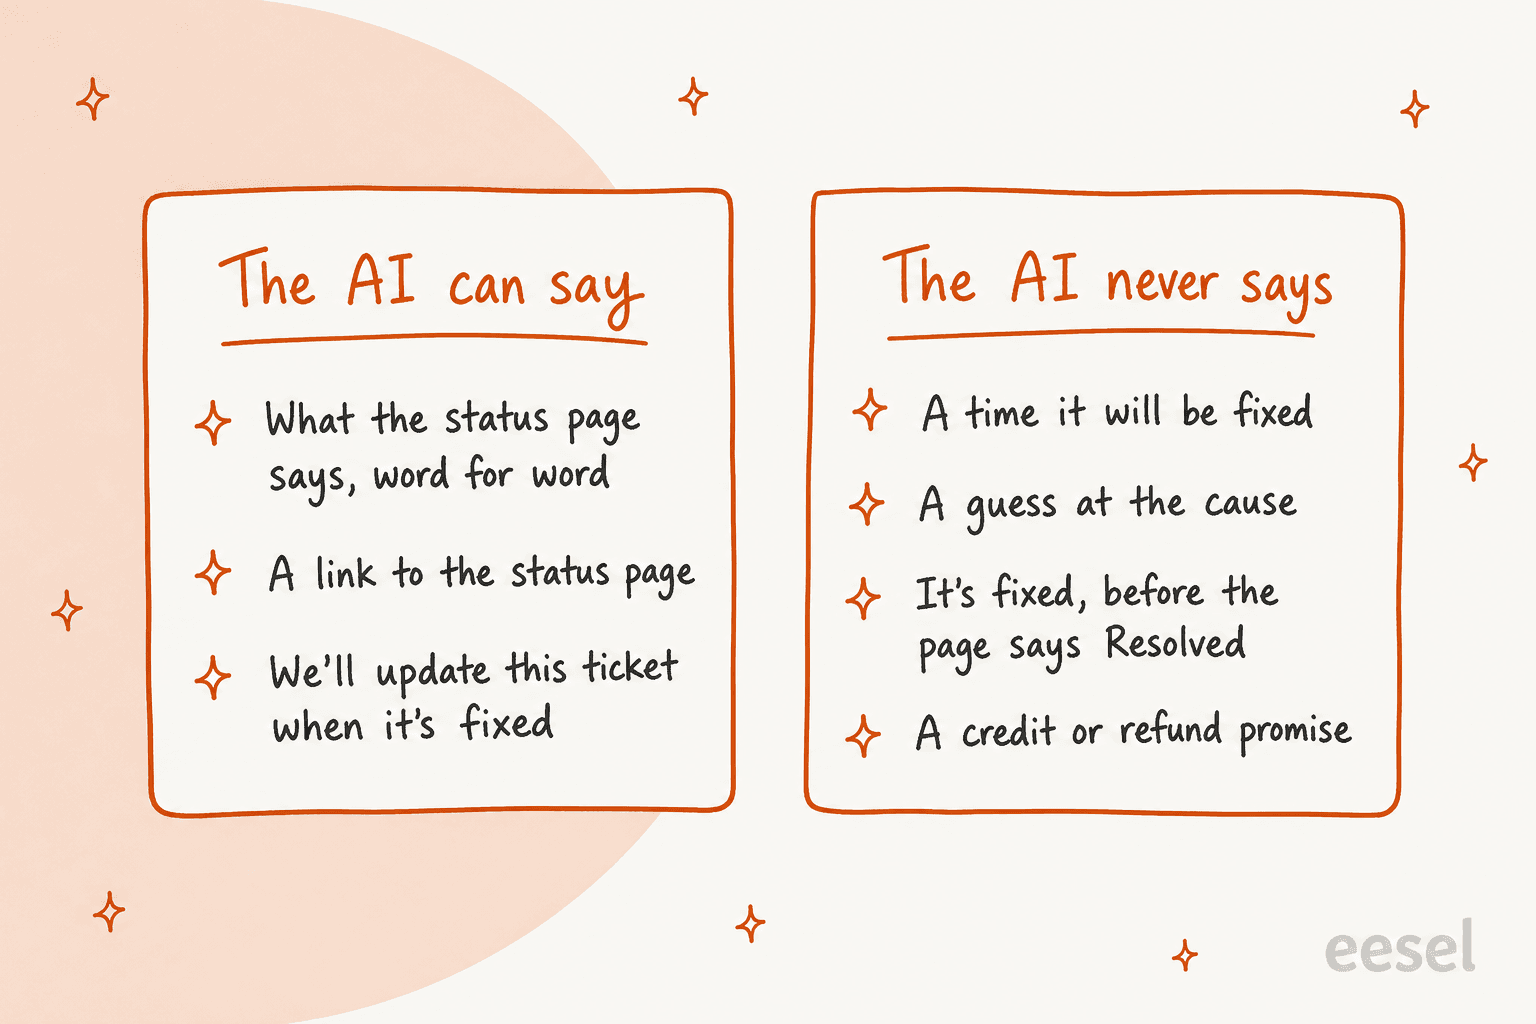
La liste des « jamais » tient à une seule chose : l'IA ne peut répéter que des engagements pris par l'ingénierie. Un modèle à qui l'on demande « quand est-ce que ça revient ? » produira volontiers une heure plausible, et c'est une hallucination d'IA horodatée. Même chose pour la cause racine. Même « Identified » sur Statuspage signifie que l'équipe a trouvé la cause, pas qu'elle l'a partagée.
C'est là que je m'inspirerais de la façon dont SE Ranking a configuré ses agents. L'équipe voulait que le chat en direct reçoive une réponse immédiate "without the bot promising things the team could not deliver." Ses agents eesel disent donc aux clients d'attendre une réponse sous un à deux jours ouvrés, jamais que quelqu'un les rejoint maintenant. C'est le bon réflexe aussi pour les pannes : une réponse plus lente mais vraie vaut mieux qu'une réponse rapide mais inventée.
Il aide aussi d'écrire la réponse sous forme de modèle fixe que l'IA remplit, plutôt que de la laisser composer librement :
| Statut sur la page | Ce que contient la réponse de l'IA |
|---|---|
| Investigating | Le message publié, le lien vers la page de statut, « nous mettrons ce ticket à jour dès la résolution » |
| Identified | Le nouveau message publié, le lien, la même promesse de relance |
| Monitoring | Le message publié, une note indiquant qu'un correctif est en place et surveillé, pas encore de « réparé » |
| Resolved | Le message de résolution, une demande de répondre si le problème persiste, puis le ticket est résolu |
Comment Zendesk et Freshdesk gèrent-ils aujourd'hui les tickets de panne ?
Les helpdesks ont des fonctions pour les pannes depuis des années. Ils regroupent bien les tickets. Ce qu'ils ne font pas, c'est écrire la réponse au client, et c'est dans les détails que l'IA trouve sa place.
Zendesk propose des tickets de problème et d'incident : vous liez chaque signalement à un ticket de problème, et résoudre le problème résout les incidents et copie le commentaire de clôture sur chaque ticket non résolu. C'est disponible à partir de Suite Team. Deux limites tirées de l'article de Zendesk lui-même comptent ici. "AI agent tickets can't be linked to problem and incident tickets", et quand le problème est résolu, "Customers are not notified using the messaging channel." Les tickets traités par l'agent IA de Zendesk, et les clients qui ont écrit par messagerie, peuvent donc rater la mise à jour de clôture. Mon guide des types de ticket Zendesk couvre la configuration, et vous pouvez définir le type automatiquement avec une automatisation.
Freshdesk propose des tickets liés, qui regroupent les signalements sous un ticket « tracker ». L'exemple de Freshdesk lui-même est "your product is facing some unexpected downtime." Un commentaire sur le tracker est diffusé à tous les tickets liés, mais "the internal broadcast message will be visible only to agents", donc un agent écrit toujours chaque réponse au client. Et résoudre le tracker "would not resolve the linked tickets by default", selon une FAQ de Freshdesk.
Au total, les helpdesks vous donnent le regroupement. Le travail de l'IA est ce qu'il y a entre les deux : décider quel ticket appartient à quel incident et écrire la réponse destinée au client à partir du texte de la page de statut. Sur Zendesk, une IA qui écrit dans les tickets d'incident eux-mêmes contourne aussi la limite « AI agent tickets can't be linked », car les tickets restent des tickets ordinaires.
Combien coûtent les outils de page de statut ?
Voici ce que facture chaque outil, d'après sa propre page de tarifs au 30/10/2026. La page de statut est généralement la partie bon marché ; le coût qui surprend les équipes se trouve côté helpdesk, que je traite ensuite.
| Outil et offre | Prix | Abonnés | Webhook sortant | Fonctions IA |
|---|---|---|---|---|
| Statuspage Free | 0 $ | 100 | Non (e-mail, Slack, Teams) | Aucune listée |
| Statuspage Hobby | 29 $/mois | 250 | Non | Aucune listée |
| Statuspage Startup | 99 $/mois | 1 000 | Oui | Aucune listée |
| Statuspage Business | 399 $/mois | 5 000 | Oui, plus abonnements par composant | Aucune listée |
| Statuspage Enterprise | 1 499 $/mois | 25 000 | Oui | Aucune listée |
| incident.io Basic | Gratuit | Illimité, 1 page publique | E-mail, Slack, RSS | Éditeur de post-mortem de base |
| incident.io Team | 15 $/utilisateur/mois en annuel, 19 $ en mensuel | Illimité | E-mail, Slack, RSS | Éditeur de post-mortem de base, workflows |
| incident.io Pro | 25 $/utilisateur/mois | Illimité, plus 1 page interne | E-mail, Slack, RSS | Post-mortems natifs IA |
| PagerDuty Free | 0 $ | Pas de page de statut | n/a | n/a |
| PagerDuty Professional | 21 $/utilisateur/mois en annuel, 25 $ en mensuel | 250 sur la page externe, plus avec le module Status Pages | Oui (e-mail, Slack, webhook) | Revues post-incident par IA avec PagerDuty Advance |
| PagerDuty Reliability Platform Starter | 2 800 $/an | Inclus | Oui | Inclus |
Mon avis : si vous utilisez déjà incident.io ou PagerDuty pour l'astreinte, servez-vous de la page de statut que vous avez. Si vous n'avez besoin que d'une page publique et que vous voulez le webhook, Statuspage Startup à 99 $ est le seuil à franchir. Aucun de ces outils ne répond à vos tickets, cependant ; cela reste le travail du côté support.
Combien coûte une panne côté support ?
C'est là que les modèles de tarification commencent à compter. Une panne est un pic de support fait de questions quasi identiques, et certains tarifs d'IA transforment ce pic en facture.
Zendesk facture son agent IA à la résolution automatisée : 1,50 $ pièce avec un volume engagé ou 2,00 $ à l'usage, après les 5 à 10 incluses par agent et par mois. Freshdesk vend les sessions de Freddy AI Agent 49 $ les 100 après 500 gratuites une seule fois. La tarification d'eesel est un lot mensuel fixe de crédits, où un ticket ou un chat vaut un crédit : 299 $ pour 500, jusqu'à 1 749 $ pour 5 000. Saisissez ci-dessous votre propre panne.
Le but n'est pas de dire qu'un modèle est toujours moins cher. C'est que la tarification à la résolution transforme une panne, le jour où votre équipe est déjà la plus sous pression, en un événement à coût variable. Un lot mensuel fixe est plus facile à budgéter si votre produit a de temps en temps une mauvaise journée.
L'IA devrait-elle écrire elle-même la mise à jour de la page de statut ?
Elle peut la rédiger. Je ne la laisserais pas la publier. Le message de la page de statut est le seul élément de communication de panne qui atteint tous les clients en même temps, et chaque réponse du support en aval le cite. S'il est faux, tout ce qui repose dessus l'est aussi.
Un commentateur de Hacker News, répondant à la question de savoir si les pages de statut sont mises à jour automatiquement, a bien résumé l'arbitrage :
"Typically no because there's an art to crafting the actual message around impact… but sometimes yes it is automated"
Le bon compromis est un brouillon avec une étape d'approbation. L'API REST de Statuspage accepte un nouvel incident ou une mise à jour par un simple POST, de sorte qu'un agent IA avec Network Access vers api.statuspage.io peut préparer la mise à jour à partir du canal de l'incident, et un ingénieur l'approuve avant publication. Dans eesel, c'est une action réglée sur Needs approval : l'agent s'arrête, montre le texte exact et attend Approve ou Deny. Côté incident, l'offre Pro d'incident.io liste un éditeur de post-mortem natif IA et PagerDuty propose des revues post-incident générées par IA via son module Advance, donc le compte rendu après coup y est couvert.
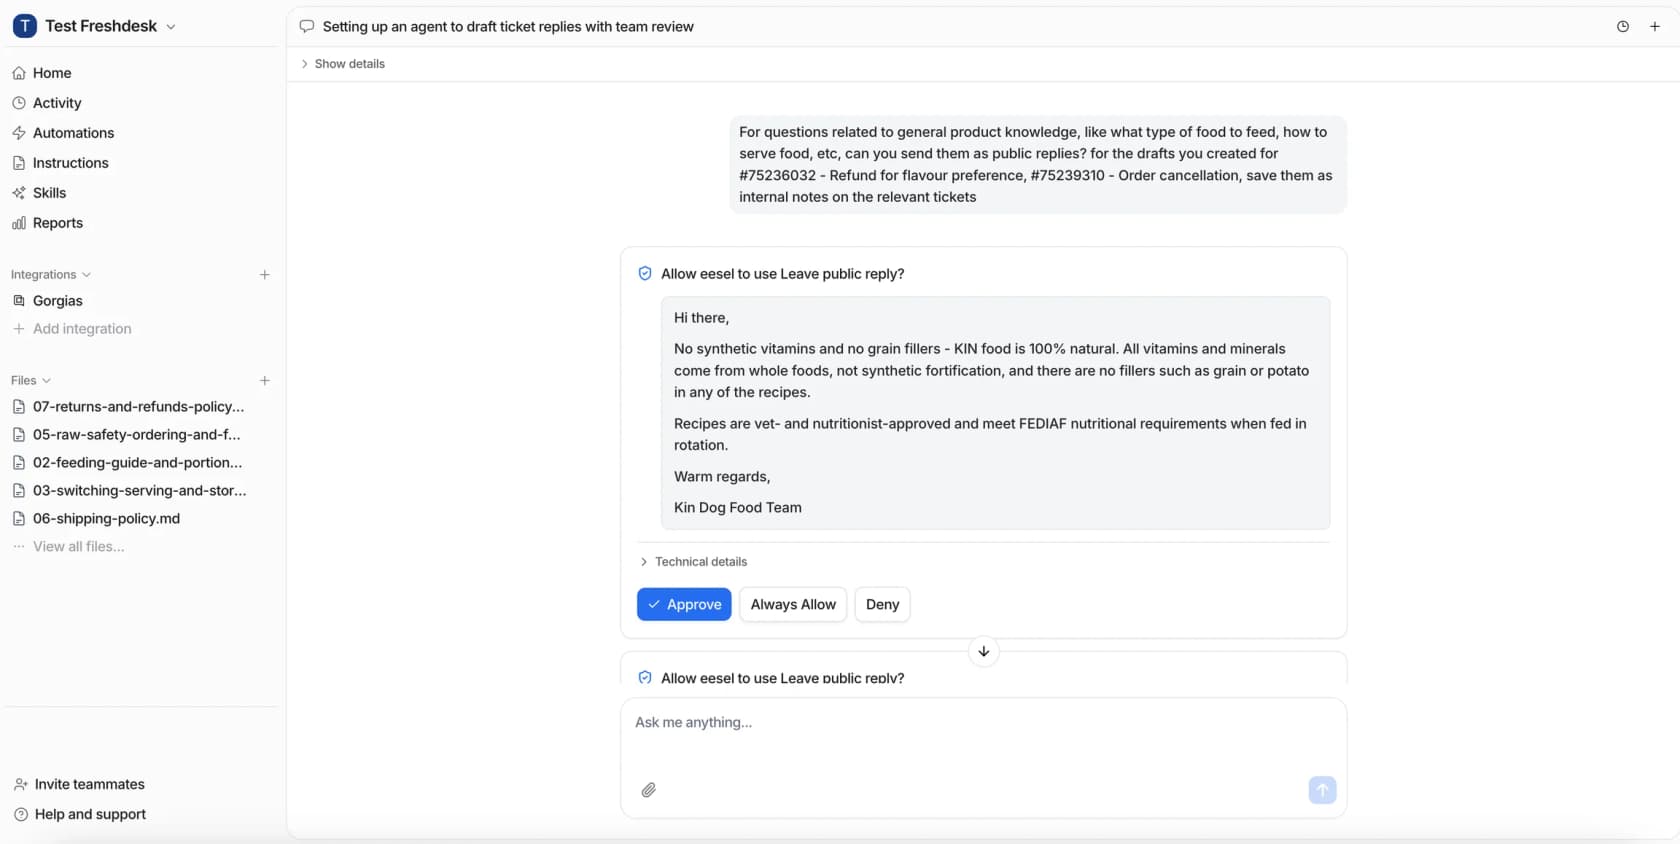
C'est aussi ainsi que je commencerais pour les réponses côté support. Lesson Pro fait tourner eesel sur deux comptes Zendesk, où il a laissé 1,700 notes internes et rédigé 560 réponses en un mois, l'équipe approuvant avant que quoi que ce soit n'atteigne un client. Commencer sous supervision sur les réponses de panne vous coûte quelques minutes au premier incident et vous montre exactement ce que l'IA aurait envoyé.
Comment le mettre en place avant la prochaine panne ?
La mise en place prend un après-midi. La faire en plein incident prend bien plus longtemps, voici donc l'ordre que je suivrais.
- Choisissez la source de vérité. Une page de statut, un jeu de noms de composants. Si l'ingénierie et le support appellent le service de paiement de deux façons différentes, corrigez cela d'abord, puisque l'IA associe les tickets par composant.
- Abonnez l'IA à la page. Sur Statuspage Startup ou supérieur, ou sur PagerDuty, ajoutez l'URL de webhook de l'agent comme abonné. Sinon, utilisez le point de terminaison de synthèse public ou l'API de l'éditeur via Network Access.
- Écrivez les voies dans les instructions. Les quatre voies ci-dessus, le modèle de réponse par statut et la liste des « jamais dire ». Nommez les comptes entreprise et les mots-clés exclus de la réponse automatique.
- Choisissez votre étiquette et votre règle de relance. Une étiquette d'incident par panne, et une règle selon laquelle Resolved déclenche une relance sur chaque ticket étiqueté. Sur Zendesk, vous pouvez aussi lier les tickets à un ticket de problème et mettre à jour le statut en masse si vous préférez les fermer à la main.
- Testez sur une panne passée. Rejouez les tickets de votre dernier vrai incident et vérifiez chaque voie, selon l'approche de mon guide des tests par simulation. Surveillez de près la voie « Sans rapport avec la panne ».
- Commencez par des brouillons, puis passez en production. Mettez les réponses publiques en Needs approval pour le premier incident, puis basculez la voie correspondante sur Auto quand les brouillons sont justes. Gardez les crédits et les remboursements sous approbation en permanence.
- Comptez. Étiquetez chaque ticket de panne traité par l'IA pour pouvoir en rendre compte, comme SE Ranking a demandé une étiquette
ai_handledsur chaque ticket qu'eesel touche, "so containment is counted in Zendesk, not guessed." Mon guide du reporting de support couvre le reste.
Si vous préférez le configurer depuis un terminal, ou le faire faire par un agent de code, la CLI eesel exécute le même agent que le tableau de bord. eesel automations liste l'automatisation par webhook et l'active ou la désactive, eesel activity montre ce que l'agent a fait de chaque mise à jour d'incident, et eesel approvals liste les réponses qui attendent une personne. Chaque commande affiche du JSON avec une option --dry-run pour les écritures, ce qui permet à Claude Code, Cursor ou Codex de piloter toute la configuration et de relire leurs propres résultats.
Essayer eesel pour les tickets de panne
eesel est un coéquipier IA pour votre helpdesk, et les tickets de panne sont un premier travail idéal pour lui. Il lit chaque mise à jour de votre page de statut, associe les tickets « est-ce en panne ? » de Zendesk, Freshdesk ou Gorgias à l'incident, répond avec le texte publié et relance chacun quand la page indique Resolved. Les gros comptes et les pertes de données vont directement à votre équipe, comme Qontro oriente ses tickets de panne.
Commencez par des brouillons avec les approbations activées, rejouez votre dernière panne et basculez la voie correspondante sur Auto quand vous lui faites confiance. Les offres démarrent à 299 $ par mois pour 500 tickets, avec 100 crédits gratuits pour essayer d'abord. Essayer eesel.
Comment l'IA répond-elle aux tickets « est-ce en panne ? » pendant une panne ?