

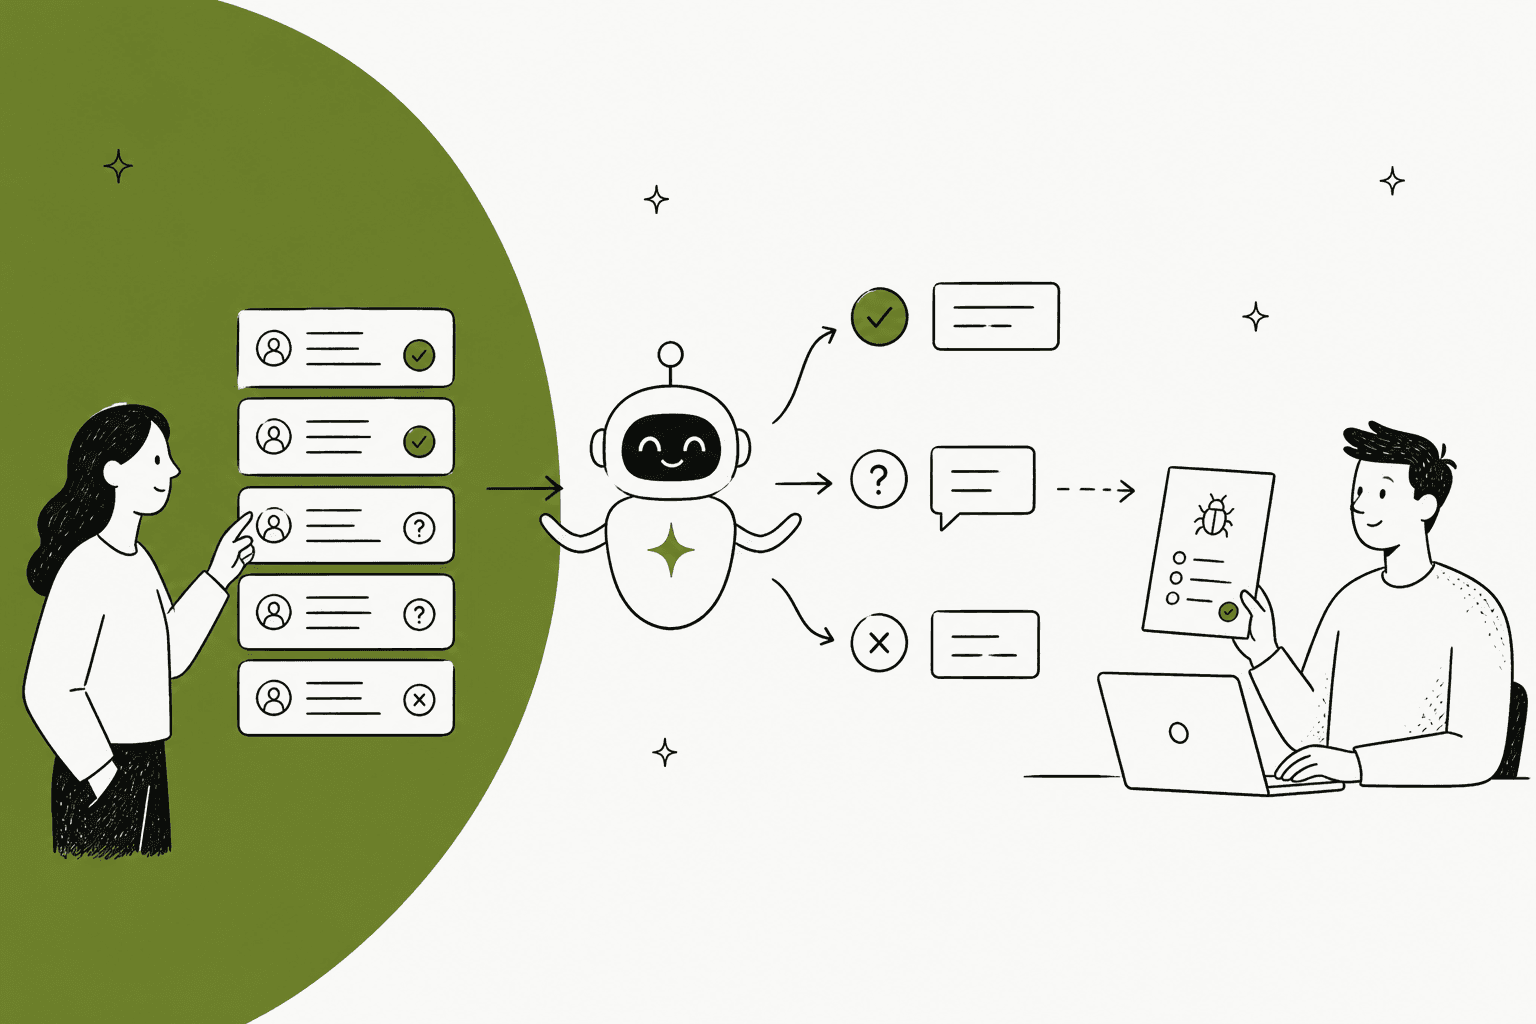
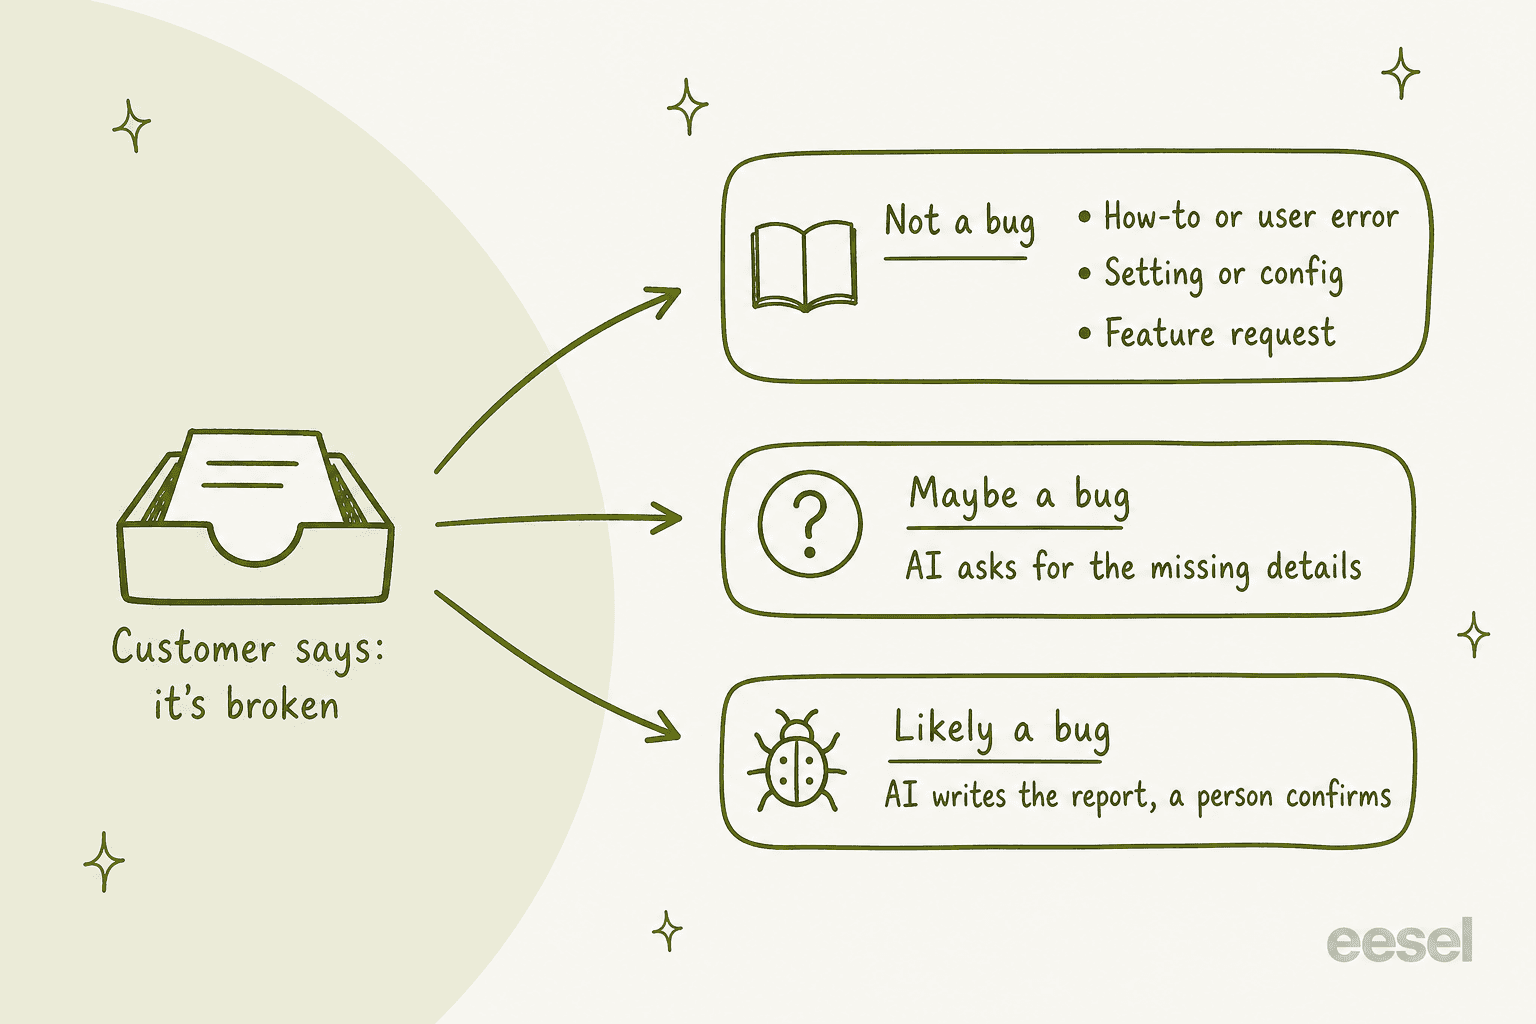
L'IA pour le triage des bugs fonctionne mieux dans la file du support, pas dans le backlog de l'ingénierie. Triez chaque ticket « c'est cassé » en trois voies : pas un bug (question d'usage, réglage, demande de fonctionnalité), peut-être un bug (l'IA demande les détails manquants) et probablement un bug (l'IA rédige le rapport et une personne le confirme). L'essentiel du temps gagné vient des deux premières voies, car la plupart des « bugs » signalés par les clients n'atteignent jamais l'ingénierie.
La règle qui garde la confiance des ingénieurs : l'IA ne dit jamais à un client que quelque chose est un bug confirmé, et elle ne crée jamais de rapport sans étapes de reproduction, le compte et une vérification des doublons. Quand la correction est livrée, elle prévient chaque client qui l'avait signalé.
eesel fait cela dans le helpdesk que vous utilisez déjà. SE Ranking s'en sert pour transformer les questions sur des données erronées et sur l'API en tickets de niveau 2, avec le domaine, le lien d'audit ou la capture d'écran collectés d'abord, sur environ 4 650 conversations par mois.
Pourquoi les signalements de bugs engorgent-ils une file de support ?
Je travaille dans la file du support chez eesel, et une bonne part de ce qui y arrive commence par une version de « je crois que quelque chose est cassé ». Certains sont des bugs. La plupart non. C'est un réglage que quelqu'un a modifié, un bouton qui a bougé, une extension de navigateur qui gêne, ou une fonctionnalité qui n'a jamais existé. Le problème, c'est que dans la boîte de réception ils se ressemblent tous, et que les vrais sont mélangés aux autres.
Ce mélange crée deux sortes de gaspillage : le support passe du temps sur des tickets qui ont besoin de l'ingénierie et l'ingénierie passe du temps sur des tickets qui n'ont jamais été des bugs. Quelqu'un sur Hacker News, parlant des fournisseurs réseau, a poussé le second problème à l'extrême :
"Especially with network vendors where 99%+ of their support workload is dealing with client or reseller misconfiguration."

Votre proportion ne sera pas aussi déséquilibrée, mais la forme est familière. Et quand un vrai bug part vers l'ingénierie, il part souvent avec trop peu de détails. Un ingénieur qui travaille avec des équipes de support a décrit l'écart sur Hacker News :
"they're not developers and every now and then they cut the corner and need to be reminded that "I cannot press this button" is not good enough"
C'est le travail pour lequel l'IA est bonne ici. Pas décider ce qui est un bug, mais faire le tri et les questions de suivi qu'une équipe de support débordée saute. Si vous voulez le point de vue côté ingénierie (Sentry, Linear et GitHub qui trient les tickets une fois qu'ils existent), je l'ai détaillé dans l'IA pour le triage des rapports de bugs. Cet article traite de l'étape d'avant : passer du ticket d'un client à un ticket d'incident qui mérite d'être créé.
Comment l'IA doit-elle trier le signalement d'un client ?
Quand j'ai demandé à ChatGPT comment une équipe de support devrait faire le triage des rapports de bugs, il a décrit le même enchaînement auquel arrivent la plupart des équipes : classer, puis investiguer, puis transmettre. Je rendrais l'étape de classement plus concrète, et ce qu'il faut retenir ici, ce sont trois voies, avec un travail différent pour l'IA dans chacune.
| Voie | Signalement typique | Ce que fait l'IA | Qui décide |
|---|---|---|---|
| Pas un bug : question d'usage ou erreur de l'utilisateur | "I can't find the export button anymore" | Répond depuis le centre d'aide et le journal des modifications, lie l'article | L'IA, une fois testée |
| Pas un bug : réglage ou configuration | "The report totals are wrong" | Vérifie d'abord les réglages habituels (plage de dates, filtres, fuseau horaire) | L'IA, avec une personne sur les brouillons au début |
| Pas un bug : demande de fonctionnalité | "Can you add dark mode?" | Remercie, consigne la demande, ne promet jamais rien | L'IA |
| Peut-être un bug | "Nothing works since this morning" | Demande les étapes, le compte, la version du navigateur ou de l'application, une capture d'écran | L'IA demande, puis reclasse |
| Probablement un bug | "Export freezes at 99% since Tuesday's update, worked last week" | Vérifie les problèmes connus et le statut, rédige le rapport, dit au client que c'est entre les mains de l'équipe | Une personne confirme |
| Panne | "Login shows a 500 for everyone in our org" | Vérifie la page de statut, alerte tout de suite une personne | Une personne, maintenant |
Le détail « worked last week » compte plus qu'il n'y paraît. La réponse de ChatGPT l'a qualifié d'indicateur de régression et je suis d'accord : un signalement qui nomme quelque chose qui fonctionnait avant, plus un changement récent, est le signal le plus fort qu'un client puisse donner. L'IA devrait traiter ces cas comme des bugs probables même quand la description du client est vague.
Essayez de trier quelques signalements vous-même :
Dans quelle voie se trouve ce signalement de bug ?
Choisissez un signalement de client pour voir où il va et ce que l'IA doit faire ensuite.
Rien de choisi pour l'instant. Commencez par n'importe quel signalement ci-dessus.
L'IA vérifie d'abord le journal des modifications. Si le bouton a changé de place dans une version récente, elle répond où il se trouve maintenant et lie la note de version. Si rien n'a changé, elle demande une capture d'écran avant de le classer autrement.
Nécessite : centre d'aide, journal des modifications, anciens tickets.
La plupart des tickets « les chiffres sont faux » viennent d'une plage de dates, d'un filtre, d'un fuseau horaire ou d'un document en brouillon. L'IA passe ces vérifications en une seule réponse. Si tout semble correct, le ticket passe en peut-être un bug et l'IA demande un exemple d'enregistrement.
Nécessite : une règle écrite pour les signalements de chiffres erronés, anciens tickets.
L'IA remercie, dit clairement que ce n'est pas disponible aujourd'hui, étiquette le ticket comme demande de fonctionnalité pour que l'équipe produit puisse la comptabiliser, et n'évoque jamais de date de sortie.
Nécessite : une étiquette de demande de fonctionnalité, une règle interdisant de promettre des éléments de la feuille de route.
Trop vague pour trier. L'IA vérifie la page de statut, puis demande ce qu'elle ne peut pas retrouver : ce que le client essayait de faire, ce qu'il a vu, la version du navigateur ou de l'application et une capture d'écran. Elle retrie ensuite avec la réponse.
Nécessite : page de statut, une courte liste de questions par domaine produit.
« Worked last week » plus une mise à jour récente est un signal de régression. L'IA cherche un ticket ou un ticket d'incident existant avec le même symptôme, le lie s'il existe, et sinon rédige le rapport pour l'ingénierie. Elle dit au client que l'équipe se penche dessus et ne le déclare jamais confirmé.
Nécessite : problèmes connus, recherche de tickets, un moyen de créer dans votre gestionnaire.
Beaucoup d'utilisateurs, un symptôme, tous en même temps. L'IA vérifie la page de statut, lie le ticket à l'incident s'il y en a un d'ouvert, et sinon alerte la personne d'astreinte. Pas d'étapes de dépannage pour une panne.
Nécessite : page de statut, une voie urgente vers une personne.
Une remarque sur la façon dont l'IA doit trier : laissez-la lire vos anciens tickets, pas une liste de mots-clés. « It's broken » veut dire des choses très différentes selon les produits, et c'est pourquoi les mots que vos clients emploient pour un vrai bug se trouvent déjà dans vos tickets résolus. Si vous mettez en place le routage plus large autour de cela, le routage de tickets par IA pour le SaaS et comment automatiser le triage de tickets couvrent le reste de la file.
Que doit demander l'IA au client avant d'appeler cela un bug ?
La voie « peut-être » est celle où l'IA gagne sa place, parce que c'est l'étape que les équipes de support sautent sous la pression. Une personne avec quarante tickets ouverts transmet « nothing works » à l'ingénierie et passe à autre chose. Une IA peut poser les questions de suivi à chaque fois, tant que le client est encore dans la conversation et se souvient encore de ce sur quoi il a cliqué.
Ce que je lui ferais demander, à peu près dans cet ordre :
- Que tentiez-vous de faire ? L'objectif, pas l'erreur. La moitié du temps, cela révèle une question d'usage.
- Que s'est-il passé à la place, et qu'attendiez-vous ? Le texte exact de l'erreur s'il y en a un.
- Depuis quand, et est-ce que cela fonctionnait avant ? C'est la question de la régression.
- Quel compte, espace de travail ou projet ? Pour que personne n'ait à redemander plus tard.
- Quel navigateur, application ou version ? À sauter si vos systèmes l'enregistrent déjà.
- Pouvez-vous envoyer une capture d'écran ou un court enregistrement ? Une image épargne trois réponses.
Deux règles font que cela paraît utile et non comme un formulaire. D'abord, l'IA doit chercher avant de demander. L'agent de SE Ranking est réglé pour ne jamais poser de question de précision avant d'avoir vérifié les centres d'aide, les macros et les anciens tickets. Ensuite, demandez une ou deux choses à la fois, et ne demandez rien que l'IA puisse retrouver elle-même.
La configuration de SE Ranking montre ce que cela donne quand c'est bien fait. Des données erronées dans leurs outils de recherche, la configuration en marque blanche, les questions d'audit, l'API et Looker Studio deviennent tous un ticket pour leur groupe de niveau 2, avec le domaine, le lien d'audit ou la capture d'écran du connecteur collectés d'abord. Si un client dit que son écran ne correspond pas à ce que l'IA a décrit, elle arrête le dépannage et transmet avec une note sur ce qu'elle lui a déjà dit. Sur un mois, cela a représenté environ 400 tickets créés pour le niveau 2 et les cas du week-end, sur environ 4 650 conversations réparties sur trois produits.
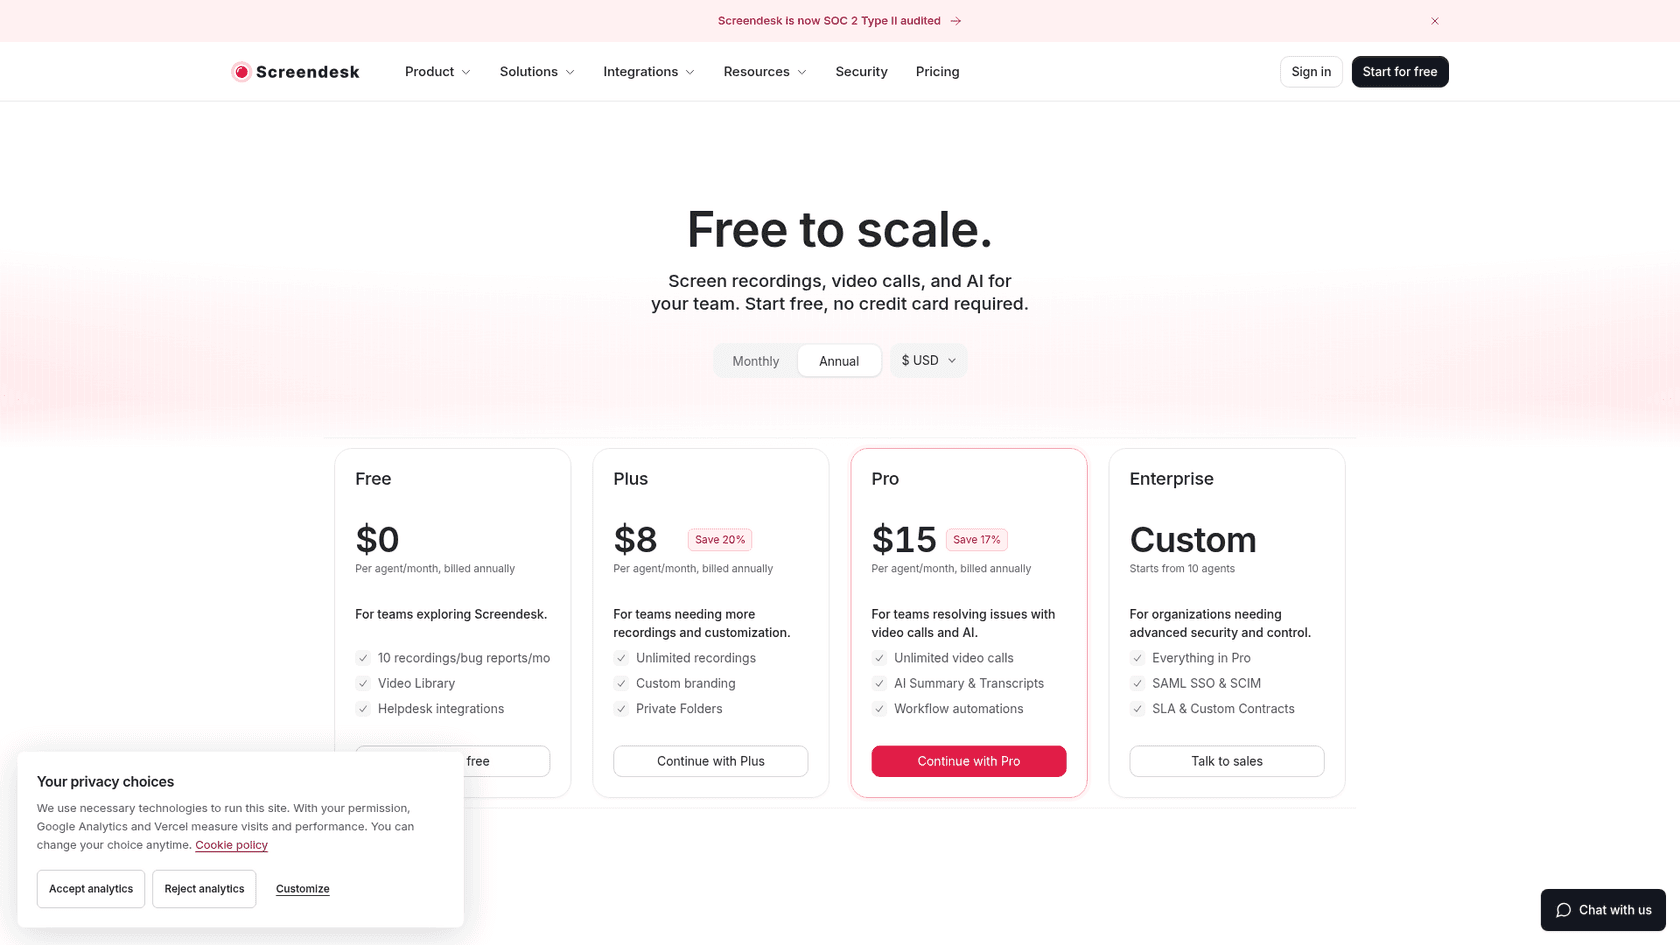
Les enregistrements d'écran aident aussi ici. Screendesk ajoute des liens d'enregistrement et de rapport de bug à des helpdesks comme Zendesk, Freshdesk, Help Scout et Jira Service Management, et son forfait Pro préremplit le titre et les étapes de reproduction avec l'IA. Cela s'associe bien à un agent IA : l'agent demande l'enregistrement, puis l'enregistrement remplit les étapes.
Comment l'IA vérifie-t-elle si l'ingénierie est déjà au courant ?
Avant que quoi que ce soit n'aille à l'ingénierie, l'IA doit répondre à une question : est-ce déjà connu ? Il y a trois endroits où regarder :
- Les tickets ouverts dans votre helpdesk. Si six clients ont signalé ce matin le même blocage de l'export, le septième est un lien, pas un nouveau rapport.
- Les problèmes connus et la page de statut. Pour que l'IA dise « nous le savons et nous y travaillons » au lieu de guider un client à travers une solution pour une panne.
- Le gestionnaire de tickets d'incident lui-même. Un ticket ouvert avec le même symptôme signifie que le ticket y est lié et que le client est prévenu à sa clôture.
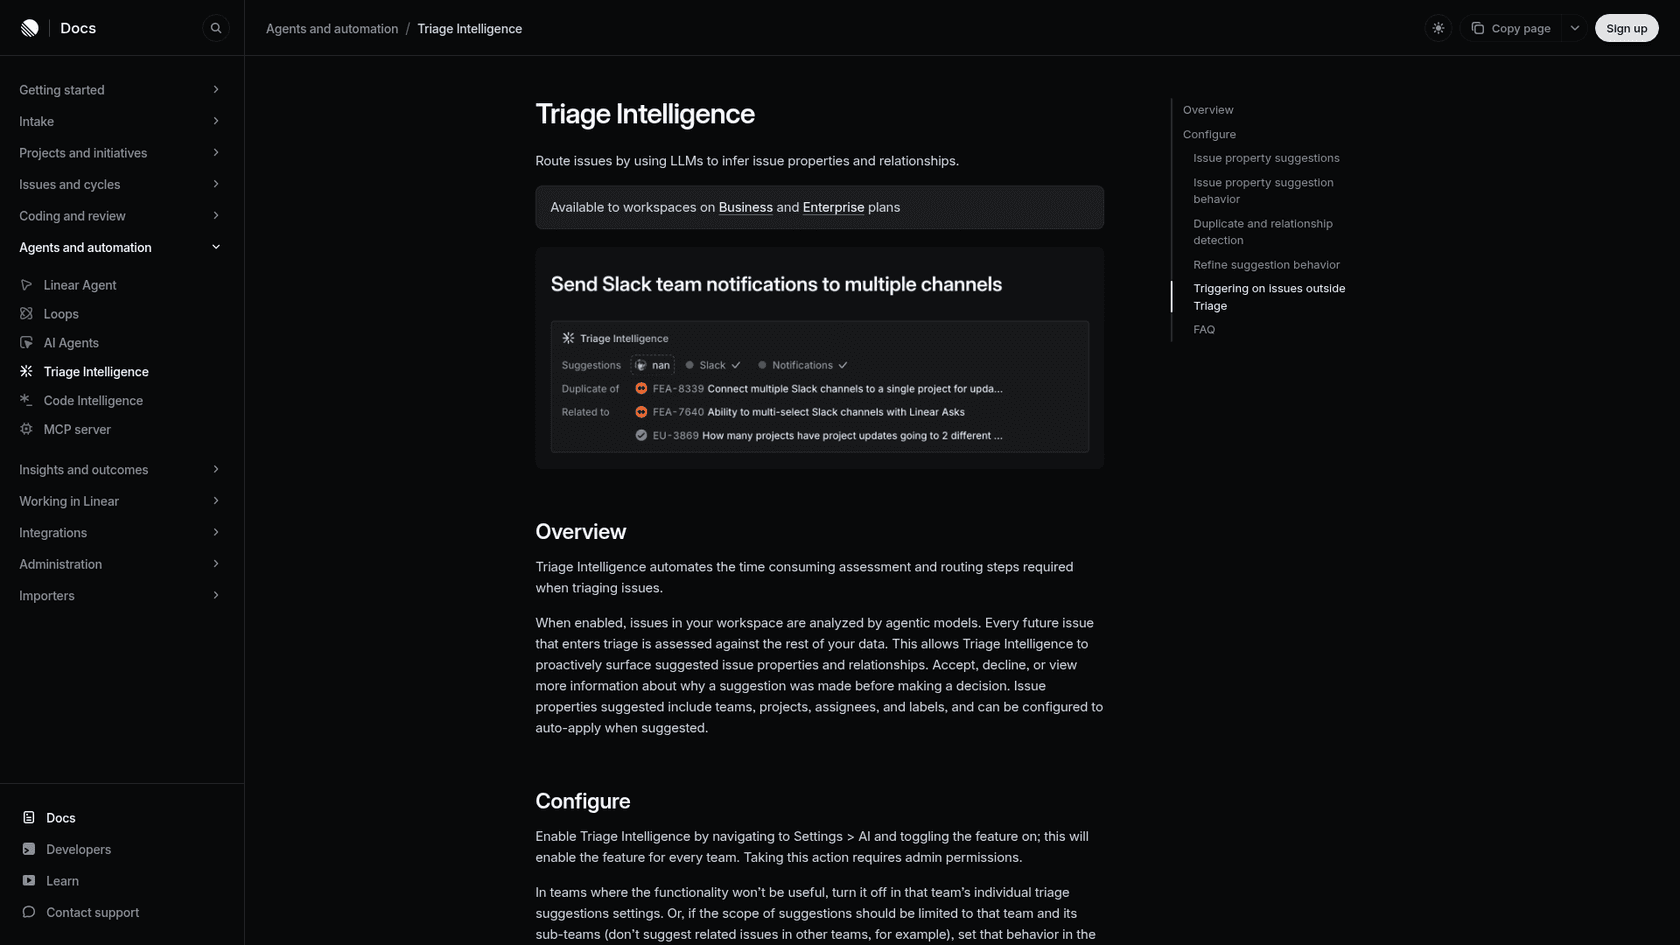
Les helpdesks comme les gestionnaires ont ajouté de l'IA pour cela. Zendesk liste des suggestions de fusion et des tickets similaires parmi ses fonctions Copilot. Côté ingénierie, Triage Intelligence de Linear signale un doublon probable quand un ticket en triage présente "a strong semantic similarity" avec un ticket existant, et montre son raisonnement avant que vous l'acceptiez.
Faire la vérification côté support vaut quand même la peine, parce qu'elle change ce que vous dites au client. Un ticket lié signifie que le client entend « nous savons, c'est en cours » aujourd'hui plutôt que dans trois jours, et cela donne à l'ingénierie un vrai chiffre. « Quatorze clients du forfait Pro, depuis mardi » est un argument de priorité ; « un client dit que l'export est cassé » n'en est pas un. Mon article sur la déduplication de tickets explique quand fusionner et quand lier.
À quoi ressemble un rapport de bug prêt pour l'ingénierie ?
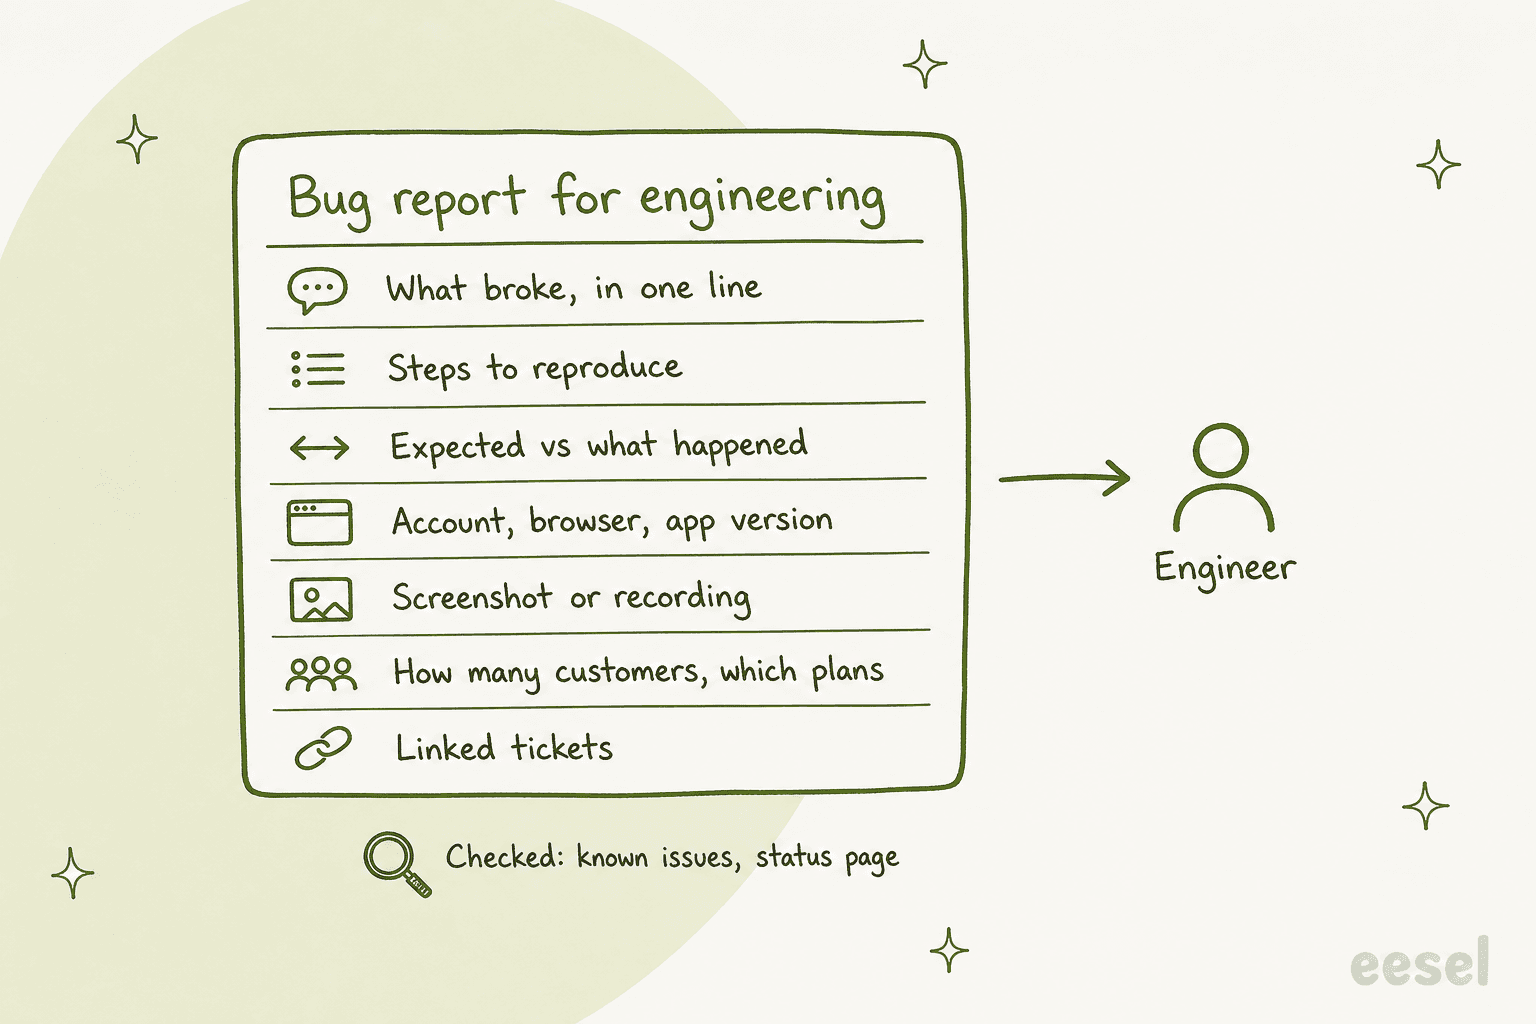
Le pire transfert qu'un ingénieur puisse recevoir est un ticket transféré avec « customer says export is broken » en haut. Le meilleur est un rapport sur lequel il peut agir en cinq minutes. C'est là qu'une IA qui a déjà posé les questions et cherché les doublons est payante : elle peut écrire le second type à chaque fois.
Un bon rapport contient :
- Ce qui est cassé, en une ligne. "Monthly CSV export stops at 99% for large workspaces."
- Les étapes pour reproduire, autant que le client a pu en donner.
- L'attendu par rapport à ce qui s'est passé, avec le texte exact de l'erreur.
- Le compte, le navigateur et la version de l'application, et le début du problème.
- Une capture d'écran ou un enregistrement.
- L'impact : combien de clients, quels forfaits, tickets liés.
- Ce qui a déjà été vérifié : problèmes connus, page de statut, réglages habituels.
- Un lien vers chaque ticket, pour que l'ingénierie voie qui attend.
Et une règle au-dessus de toutes les autres : l'IA peut dire « cela ressemble à un bug et je l'ai transmis à l'équipe », mais elle ne doit jamais dire à un client que quelque chose est un bug confirmé ni promettre de date de correction. Confirmer un défaut est une décision pour quelqu'un capable de le reproduire ou de lire le code. La réponse de ChatGPT lui-même disait la même chose autrement : ne laissez pas la seule assurance de l'IA décider si quelque chose est un vrai bug.
Voici une mise en garde tirée d'un appel commercial. Une entreprise de médias numériques qui gère environ 4 000 tickets Zendesk par mois décrivait le flux qu'elle voulait ainsi : "User contacts → AI troubleshooting → escalate to Jira if unresolved." Pendant son pilote, une escalade est partie sous forme d'e-mail, qui a ensuite été fermé automatiquement, si bien que personne dans l'équipe ne l'a jamais vu. Un transfert que personne ne lit est pire que pas de transfert, parce qu'on a dit au client que quelqu'un s'en occupait. Quelle que soit la voie choisie, vérifiez que le rapport arrive à l'endroit où une personne ou une équipe désignée travaille réellement.
Comment le rapport arrive-t-il dans Jira, Linear ou GitHub ?
Cela dépend de l'endroit où travaillent vos ingénieurs, et c'est là que les outils diffèrent le plus. La carte honnête est ci-dessous :
| Voie | Fonctionnement | Points d'attention |
|---|---|---|
| Jira Service Management, avec eesel | L'intégration JSM d'eesel répond, laisse des notes internes, et déplace, assigne, étiquette et crée des tickets | Expiration du jeton : Atlassian en fixe une et vous reconnectez quand elle arrive à échéance |
| Plain avec Linear, GitHub, Jira ou Shortcut | Créer ou lier un ticket depuis le fil de support ; le statut Linear se resynchronise | Plain est un helpdesk, donc cela implique de quitter le vôtre |
| Linear Asks | Chaque e-mail ou message Slack entrant devient un ticket dans le Triage de l'équipe | Forfait Business ou Enterprise ; conçu pour les demandes internes |
| Automatisations Screendesk | Un nouvel enregistrement ou rapport de bug peut créer un ticket Jira ou GitHub et publier dans Slack | Forfait Pro ; le déclencheur est l'enregistrement, pas le texte du ticket |
| eesel vers Linear ou GitHub | Pas d'intégration native ; eesel appelle leur API via Network Access | Vous configurez vous-même le domaine, l'en-tête d'authentification et les instructions |
Le guide de Plain fait une remarque avec laquelle je suis d'accord : un envoi à sens unique vers le gestionnaire ne suffit pas. Dans Plain, quand un ticket Linear lié est terminé ou annulé, le fil passe à un état « Close the Loop » comme invite à prévenir le client, d'après son guide Linear et GitHub. Il signale aussi un piège de configuration : si l'intégration Linear est limitée à certaines équipes, les mises à jour de statut ne se synchronisent pas.
Linear Asks est l'option la plus légère si vous êtes déjà sur le forfait Business de Linear. Sa documentation cite "engineering teams receiving bug reports from non-technical teammates" comme usage principal, et un Ask par e-mail utilise l'objet comme titre du ticket et le corps comme description. Cela signifie qu'un rapport propre de votre côté support devient un ticket Linear propre, sans plomberie supplémentaire.
Pour eesel avec un gestionnaire avec lequel il ne s'intègre pas, la voie est Network Access. Vous autorisez le domaine du gestionnaire, vous ajoutez l'en-tête d'authentification, et vous dites à l'agent en mots simples à quoi sert la connexion. Les identifiants restent dans vos paramètres et eesel les joint à chaque requête, donc l'IA ne voit jamais la clé. Il prend en charge GET, POST, PATCH et DELETE, ce qui couvre la création d'un ticket et l'ajout d'un commentaire. Je mettrais cette action derrière une approbation au début, pour qu'une personne valide chaque nouveau ticket jusqu'à ce que vous fassiez confiance aux rapports. Les actions et approbations d'eesel vous permettent de régler chaque action sur Auto, Approbation requise ou Désactivée.
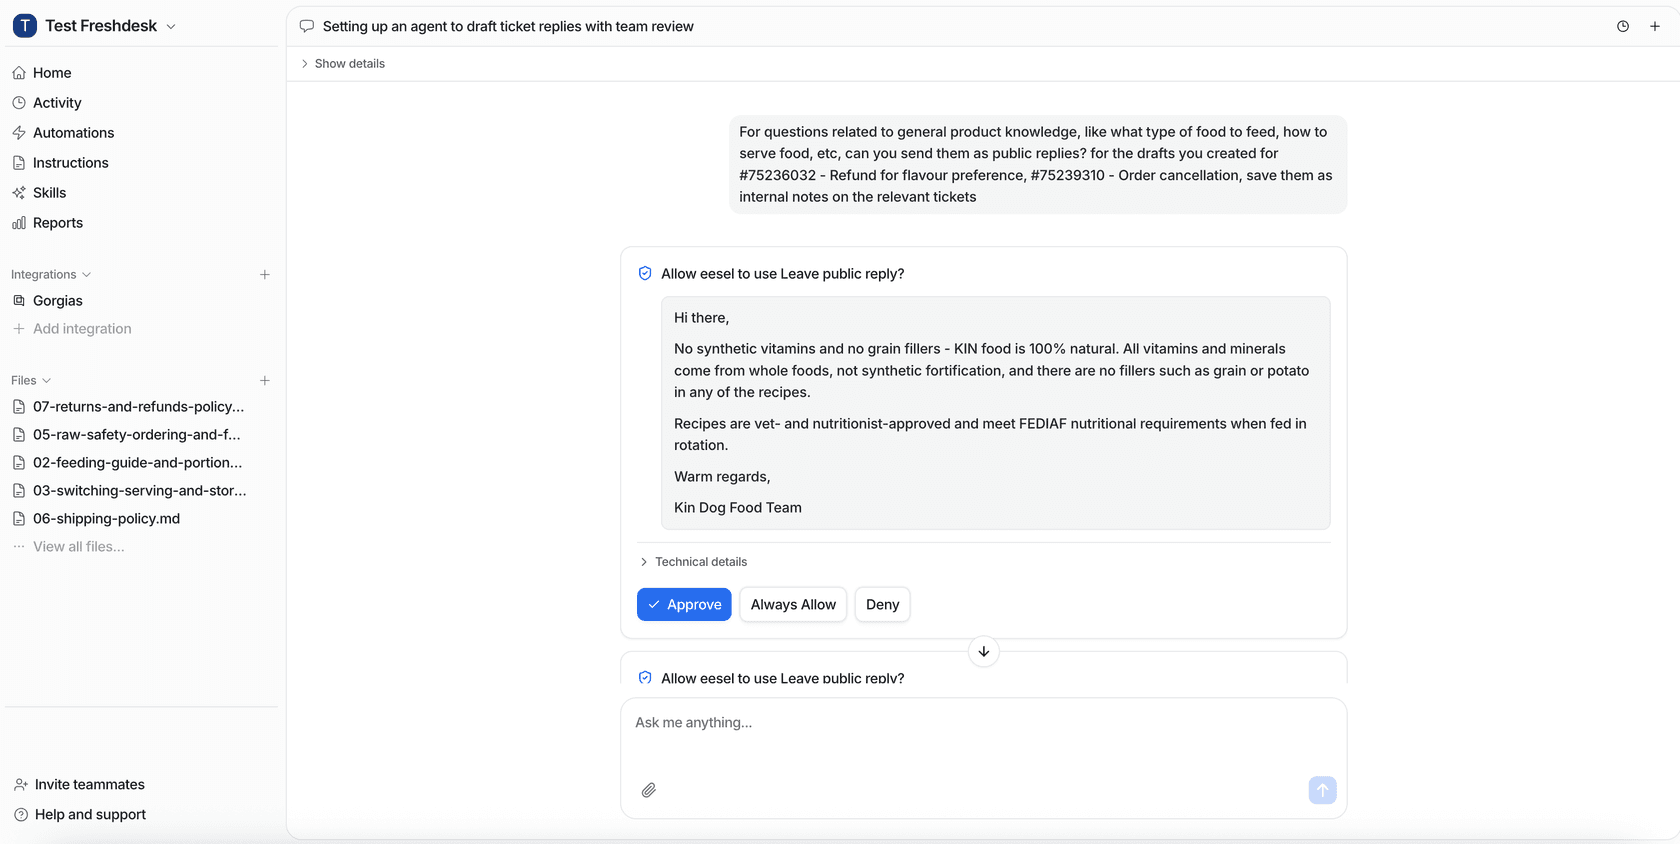
Si vos ingénieurs vivent déjà dans Jira, mes guides sur l'escalade de Zendesk vers Jira et l'intégration Zendesk Jira vont plus loin.
Pour Linear, voir Linear AI et Linear vs Jira.
Comment les clients apprennent-ils qu'un bug est corrigé ?
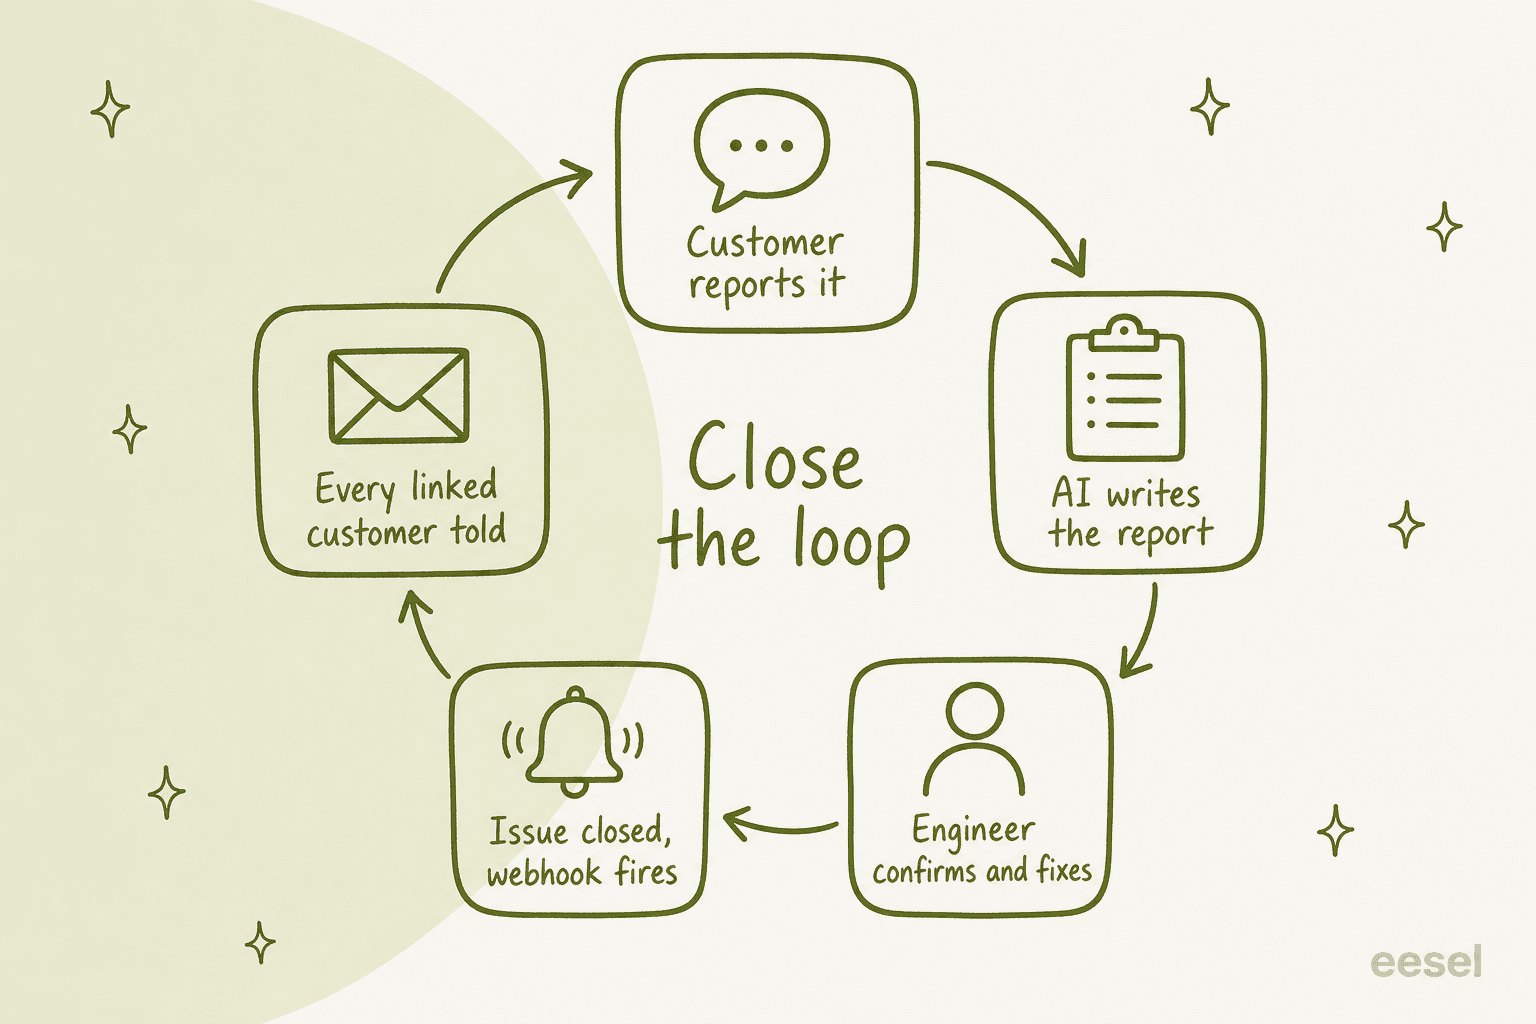
C'est l'étape que presque tout le monde oublie. La correction est livrée, le ticket d'ingénierie se ferme, puis le client qui l'avait signalé n'en est jamais informé. La page d'accueil de Modem décrit exactement cela : "The fix ships. Whoever heard the complaint never finds out." Un commentateur de Hacker News a exposé la boucle complète du support vers l'ingénierie et l'a terminée de la même façon, avec le support qui recontacte le client pour retester :
"as soon as you have multiple people involved in a communication chain, details get lost, and feedback loops become really extensive because of all the latency involved"
L'IA rend la dernière étape peu coûteuse, à condition que deux choses soient vraies : chaque ticket client est lié au ticket d'incident, et quelque chose prévient l'IA quand ce ticket se ferme. Dans Plain, c'est la synchronisation des statuts qui s'en charge. Avec eesel, c'est une automatisation par webhook : eesel vous donne une URL, et tout service capable d'envoyer une requête web (Zapier, Make, votre propre backend, le webhook d'un gestionnaire de tickets) peut réveiller l'agent avec le ticket fermé et des instructions. L'agent cherche alors les tickets étiquetés avec ce ticket d'incident, écrit à chaque client une courte note disant que la correction est sortie, et lui demande de la vérifier de son côté.
Dire à quatorze clients « le bug que vous avez signalé est corrigé » est l'une des victoires de bonne volonté les moins chères du support, et cela n'arrive presque jamais à la main. Cela détecte aussi les cas où la correction n'a rien corrigé, ce qui vaut la peine d'être su avant le prochain sprint.
Quels outils font du triage de bugs par IA, et combien coûtent-ils ?
La liste restreinte de ChatGPT pour cette question était Modem, Plain, et un helpdesk existant plus IA et Zapier. Voici comment se comparent les options que j'ai examinées, avec les prix tirés de la page de tarifs de chaque éditeur, relevés le 30 octobre 2026. Elles ne font pas toutes le même travail, donc pour choisir, la colonne « où il se place » compte autant que le prix.
| Outil | Où il se place | Ce qu'il fait pour le triage des bugs | Prix |
|---|---|---|---|
| Zendesk intelligent triage | Dans Zendesk | Classe les tickets par sujet, sentiment et langue, chacun avec un champ de confiance | Suite Professional 115 $/agent/mois plus Copilot 50 $/agent/mois, facturé annuellement |
| Linear Triage Intelligence | Gestionnaire d'ingénierie | Suggère équipe, responsable, étiquettes et doublons pour les tickets en triage | Business 16 $/utilisateur/mois facturé annuellement, inclut Asks |
| Jira Service Management | Service desk | Réception des demandes avec agents Rovo et IA sur les forfaits payants | Gratuit pour 3 agents, Standard 21,50 $/agent/mois |
| Plain | Helpdesk pour équipes techniques B2B | Liens natifs Linear, GitHub, Jira avec synchronisation des statuts | Foundation 45 $/utilisateur/mois facturé annuellement, 100 crédits par résolution IA |
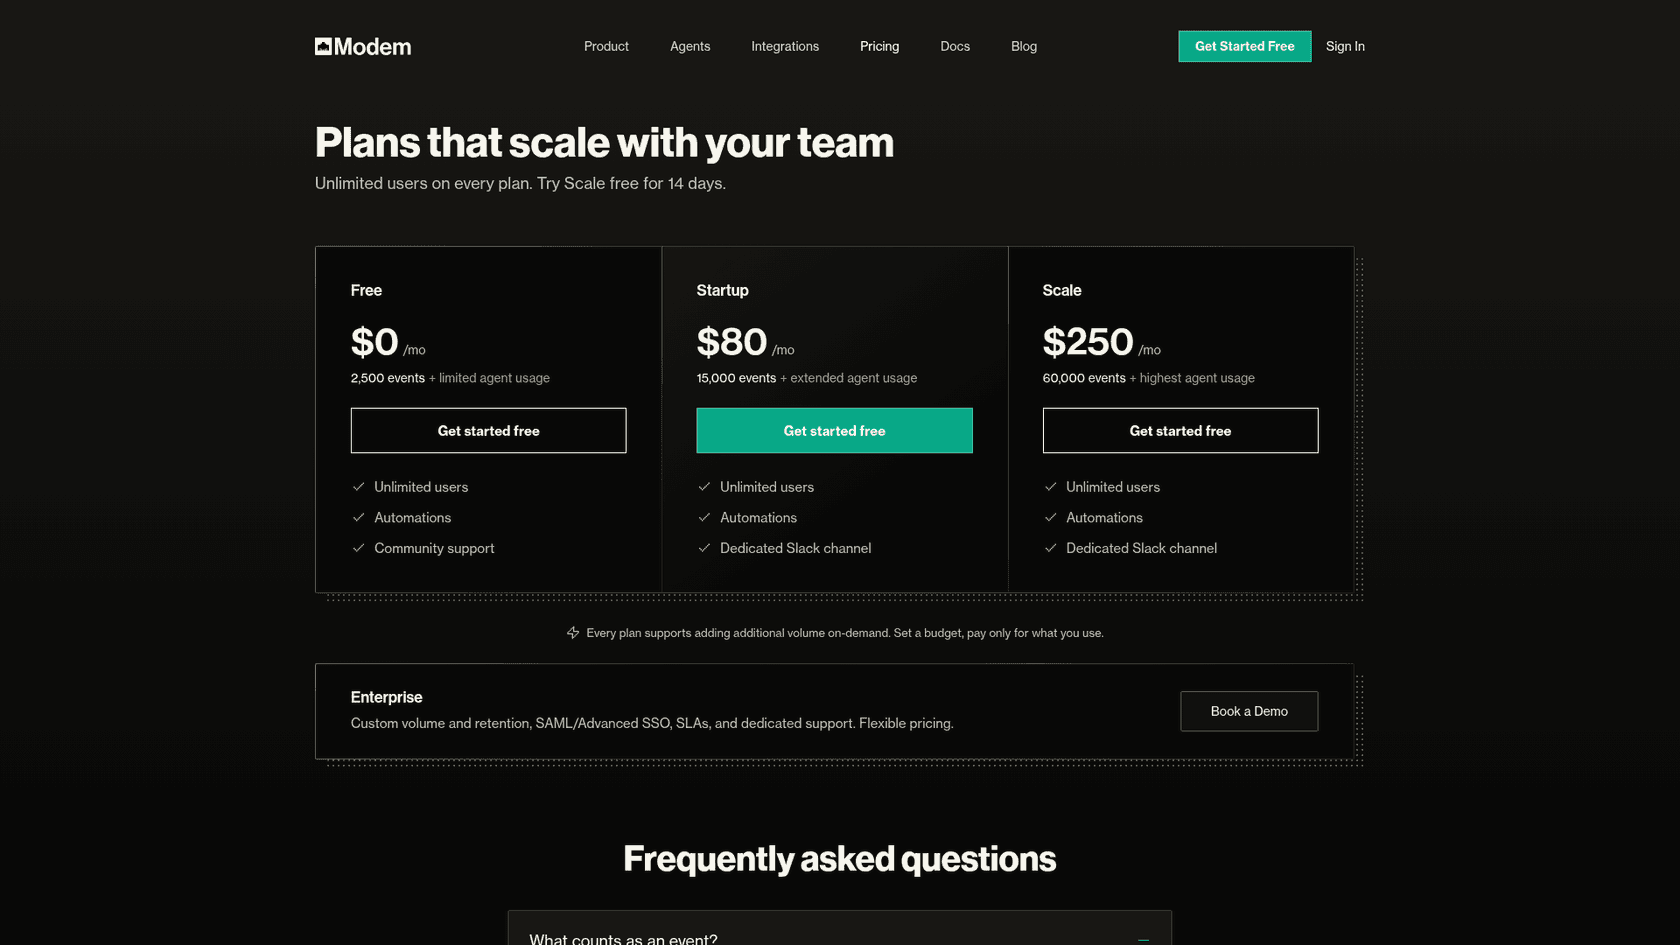
| Modem | À travers Slack, Discord, GitHub et le support | Repère les préoccupations répétées des clients et les suit jusqu'à la correction | Gratuit, Startup 80 $/mois (15 000 événements), Scale 250 $/mois |
| Screendesk | Module complémentaire de votre helpdesk | Enregistrements d'écran, étapes de reproduction par IA, automatisations Jira et GitHub | Gratuit, Plus 8 $, Pro 15 $ par agent/mois facturé annuellement |
| eesel | Collègue IA dans votre helpdesk | Trie, demande des détails, rédige et crée le rapport, prévient les clients à la correction | 299 $/mois pour 500 tickets, sièges illimités |
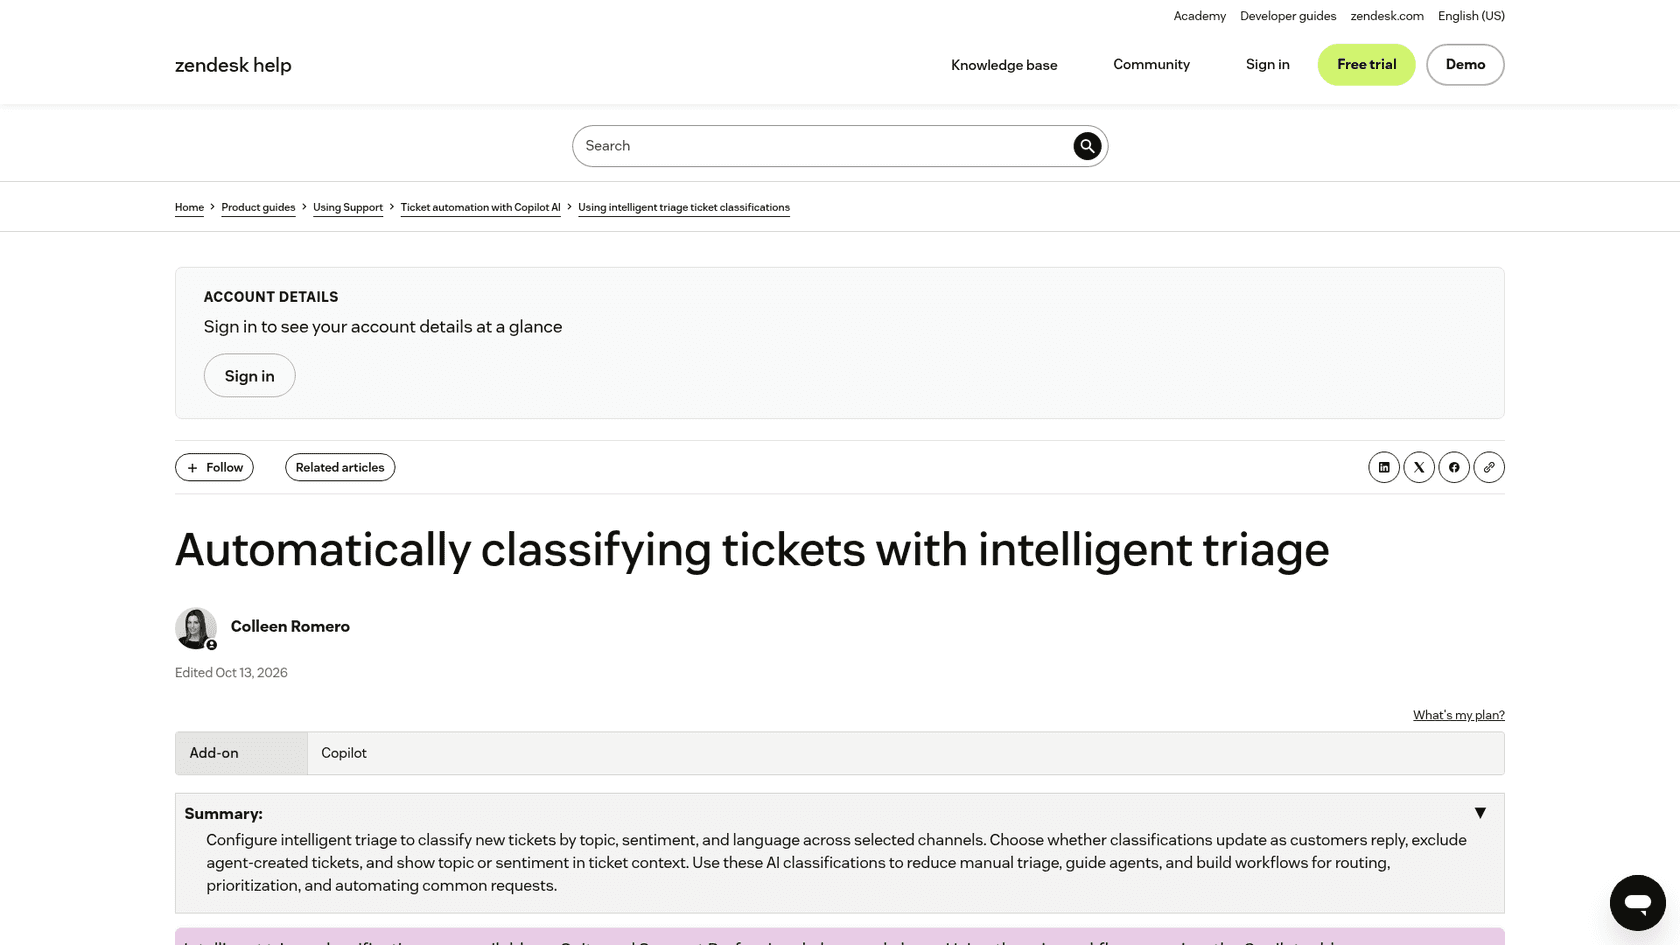
Quelques remarques sur ce tableau. Le triage intelligent de Zendesk classe d'après l'objet et le premier commentaire public, et vous pouvez voir les classements sur Suite Professional, mais les utiliser dans des déclencheurs et le routage demande Copilot. Linear indique que Triage Intelligence prend 1 à 4 minutes par ticket, ce qui convient puisqu'il s'exécute sur des tickets d'incident, après qu'un ticket est déjà devenu l'un d'eux. Modem compte comme « événement » toute entrée sur laquelle il exécute l'IA, comme un message Slack ou un ticket GitHub.
Combien cela coûte-t-il pour une équipe de support ?
Les prix par agent, par utilisateur, par événement et par ticket ne sont pas comparables tant qu'on ne les chiffre pas pour une même équipe. Prenons donc l'entreprise SaaS avec six agents de support, 3 000 tickets par mois et dix ingénieurs, déjà équipée d'un helpdesk.
| Configuration | Le calcul | Coût mensuel |
|---|---|---|
| Zendesk avec Copilot (Suite Professional, annuel) | 6 x (115 $ + 50 $) | 990 $, helpdesk inclus |
| eesel lisant chaque nouveau ticket | 3 000 crédits, sièges illimités | 1 149 $, et les mêmes crédits rédigent des réponses sur les tickets qui ne sont pas des bugs |
| eesel sur les tickets qui ressemblent à des bugs seulement | Réveillé par un formulaire « problème » ou une étiquette, environ 500 par mois | 299 $ |
| Screendesk Pro ajouté à votre helpdesk | 6 x 15 $ | 90 $ |
| Linear Business pour l'ingénierie | 10 x 16 $ | 160 $ |
| Plain Foundation (changement de helpdesk) | 6 x 45 $, plus 100 crédits par résolution IA après 1 000 inclus | 270 $ plus crédits |
| Modem Startup | Forfait fixe, jusqu'à 15 000 événements | 80 $ |
Mon avis : ces outils s'empilent plus qu'ils ne se concurrencent. Si vos ingénieurs sont sur Linear Business, activez Triage Intelligence, il est déjà payé. Si votre support vit dans Zendesk et que vous voulez surtout des tickets classés et routés, Copilot le fait dans Zendesk. Si vous voulez les questions de suivi, le rapport rédigé et le client prévenu à la sortie de la correction, c'est le travail côté support que fait un collègue IA, et c'est là que je dépenserais d'abord. Pour un panorama plus large, j'ai aussi écrit des comparatifs sur les meilleurs outils d'IA pour le triage de tickets et sur la meilleure IA pour le support SaaS.
Comment déployer le triage des bugs par IA sans agacer l'ingénierie ?
Les ingénieurs pardonnent un « ceci pourrait être un bug, voici ce que j'ai rassemblé ». Ils ne pardonnent pas un flot de rapports assurés qui se révèlent être des réglages, alors déployez dans cet ordre :
- Brouillons et notes seulement. L'IA trie chaque ticket et laisse sa voie, ses questions et tout brouillon de rapport comme note interne, puis une personne envoie. C'est ainsi que Timengo gère le support technique de son produit de messagerie sécurisée sur Freshdesk : chaque nouveau ticket reçoit un brouillon en danois et une note interne pour l'ingénieur, et eesel n'envoie jamais de lui-même.
- Écrivez les règles du « pas un bug ». Les fausses alertes courantes de votre produit, en mots simples, sous forme de courte liste. Qontro, un ERP cloud sur Freshdesk, a écrit une règle sur la façon de traiter un signalement disant que les chiffres semblent faux, et envoie les erreurs système et les pertes de données directement à une personne.
- Comparez ses voies avec ce que votre équipe a décidé. Là où l'IA a qualifié de bug quelque chose qui n'en était pas un, resserrez la règle ou corrigez l'article d'aide. Qontro utilise ses brouillons ainsi : un brouillon erroné pointe souvent vers un article manquant ou une règle à resserrer.
- Laissez la voie « pas un bug » passer en automatique. Réponses d'usage et de réglages sur des sujets précis, une fois qu'elles tiennent sur d'anciens tickets.
- Activez la création de tickets, derrière une approbation. L'IA crée le rapport dans Jira, Linear ou GitHub, et une personne approuve chacun jusqu'à ce que les rapports soient régulièrement bons.
- Fermez la boucle. Reliez l'événement « ticket fermé » du gestionnaire à l'IA pour que les clients liés apprennent la correction.
Avant l'étape quatre, testez. Les tests de simulation du support par IA expliquent comment faire tourner l'agent sur les tickets du mois dernier, et mon calendrier de mise en œuvre donne les chiffres réalistes pour chaque étape.
Quelques autres lectures qui aident en chemin. Les bonnes pratiques de passage de relais à un humain couvrent ce que le client doit entendre quand l'IA transmet un ticket, et l'IA pour le support de niveau 2 couvre le travail d'investigation une fois qu'un rapport existe. Et si les mauvaises réponses reviennent toujours à une documentation insuffisante, l'analyse des lacunes de connaissances du support les transforme en backlog.
Les ingénieurs peuvent-ils le configurer depuis le terminal ?
Pour une équipe logicielle, c'est pratique. La CLI eesel exécute depuis un terminal le même agent que vous voyez dans le tableau de bord, et chaque commande affiche du JSON, donc un agent de codage comme Claude Code, Cursor ou Codex peut aussi la piloter. Un ingénieur peut ajouter le document des problèmes connus avec eesel files upload, tester comment l'agent trie un signalement d'exemple avec eesel chat "export freezes at 99% since the update", et débloquer une action de création de ticket retenue avec eesel approvals approve <id>, le tout sans ouvrir le tableau de bord. eesel automations liste l'automatisation par webhook qui ferme la boucle. Le contexte de l'idée se trouve dans mon article sur les serveurs MCP d'agents IA.
Essayez eesel pour le triage des bugs
Si vos signalements de bugs arrivent dans Zendesk, Freshdesk ou Jira Service Management, eesel rejoint cette file comme un collègue de support qui a lu votre centre d'aide, votre journal des modifications et chaque ticket que vous avez résolu. Il répond aux tickets d'usage et de réglages, demande aux clients les étapes et les captures d'écran dont l'ingénierie aura besoin, rattache les doublons au rapport déjà ouvert, puis rédige le rapport qu'une personne confirme avant sa création. Quand la correction est livrée, il prévient tous ceux qui l'avaient signalée.
SE Ranking l'exploite ainsi sur trois produits dans Zendesk, en envoyant au niveau 2 les questions sur des données erronées et sur l'API avec les preuves déjà jointes.
Les forfaits démarrent à 299 $ par mois pour 500 tickets ou chats, avec des sièges illimités, et il y a un essai gratuit avec 100 crédits. Essayez eesel sur les signalements de bugs du mois dernier et voyez lesquels il aurait triés comme votre équipe.
Comment le triage des bugs par IA gère-t-il les signalements en double ?