

L'IA pour le support aux développeurs fonctionne quand vous répartissez la file en quatre types de tickets : les questions de documentation auxquelles l'IA répond avec un lien, les problèmes de configuration qu'elle diagnostique à partir du code du développeur, les questions de compte auxquelles elle répond en consultant son ID de requête, et les bugs possibles qu'elle rédige pour un ingénieur. Le bot de documentation est la partie facile. Les deux qui font vraiment gagner du temps aux ingénieurs sont la consultation en lecture seule et le rapport de bug.
Ce que la plupart des équipes ratent : une part croissante des tickets de développeurs vient désormais de leurs propres outils de programmation à base d'IA, qui inventent des morceaux de votre API. Chaque mauvaise réponse, la leur ou la vôtre, pointe une lacune dans votre documentation, donc corrigez la page, pas seulement la réponse.
Si votre file vit dans Freshdesk, Zendesk ou Jira Service Management, eesel le fait à l'intérieur. Timengo l'utilise pour rédiger en danois des réponses à des administrateurs informatiques sur les certificats, les compléments Outlook et le flux de messagerie, à partir d'environ 5 300 tickets et articles passés, avec un ingénieur qui envoie chacune d'elles.
À quoi ressemble le support aux développeurs en 2026 ?
Je construis les intégrations d'eesel, ce qui veut dire que je passe une bonne partie de ma semaine de l'autre côté de votre file : à lire la référence d'API de quelqu'un d'autre, à tomber sur un 401 que je ne comprends pas et à me demander si c'est moi ou eux. Les tickets de développeurs ne se lisent pas comme le support grand public. Ils arrivent avec des traces de pile, la moitié d'une commande curl et une version de SDK, et la personne qui écrit en sait souvent plus sur son propre code que votre équipe de support.
Ils tombent en général dans quelques catégories :
- Questions pratiques et de référence. Quelle est la limite de débit de cet endpoint, de quel scope ai-je besoin, existe-t-il un SDK Go.
- Problèmes de configuration et d'authentification. Clé de test en production, jeton OAuth expiré, mauvaise URL de base, une signature de webhook qui ne se vérifie pas.
- « Qu'est-il arrivé à ma requête ? » Une livraison de webhook échouée, un paiement jamais enregistré, un 500 sur un ID de requête précis.
- Bugs possibles. Un comportement qui ne correspond pas à la documentation, une régression après une version du SDK, une erreur que seule une région renvoie.
La quatrième catégorie est celle où l'on fait appel aux ingénieurs, et aussi celle où le support est le plus faible, parce qu'un ticket vague du type « votre webhook est cassé » oblige l'ingénieur à commencer l'enquête de zéro. C'est le même problème que dans mon article sur l'IA pour le support de niveau 2 : à ce niveau, le travail n'est pas de répondre, c'est d'enquêter.
L'IA du développeur écrit-elle maintenant vos tickets ?
Il existe un nouveau type de ticket qui n'existait pas il y a quelques années. Un développeur demande à son assistant de programmation d'écrire un client pour votre API, l'assistant devine des champs qu'il n'a jamais vus, et votre équipe de support reçoit le résultat. Un développeur sur Hacker News a décrit exactement cette file chez l'un de ses clients :
"What I'm seeing is a little eternal September of support tickets about programs that fail to interface the JSON API of a customer of mine. The API is always allucinated. In the best case there are out of place attributes. Often they don't exist at all."

Sa solution a été de répondre avec des commentaires ligne par ligne sur le JSON inventé. C'est un travail parfait pour l'IA de votre côté, à condition qu'elle compare la charge utile à votre vraie spécification plutôt qu'à sa propre supposition. Cela dit aussi où concentrer l'effort : si l'IA des autres se trompe sans cesse sur votre API, la documentation que ces outils lisent fait désormais partie de votre surface de support. Les plateformes de documentation l'ont remarqué. Mintlify fournit un serveur MCP dans son offre gratuite Starter, et kapa.ai propose un serveur MCP hébergé pour que les agents de programmation interrogent directement votre documentation.
Quelles questions de développeurs l'IA peut-elle traiter seule ?
ChatGPT, interrogé par une équipe qui vend une API et des SDK, a réparti la file par type de question et rangé les bugs possibles sous « supervision humaine ». Je suis d'accord avec ce découpage, et j'ajouterais une ligne de plus entre les voies : ce que l'IA doit avoir de connecté pour faire chacune.
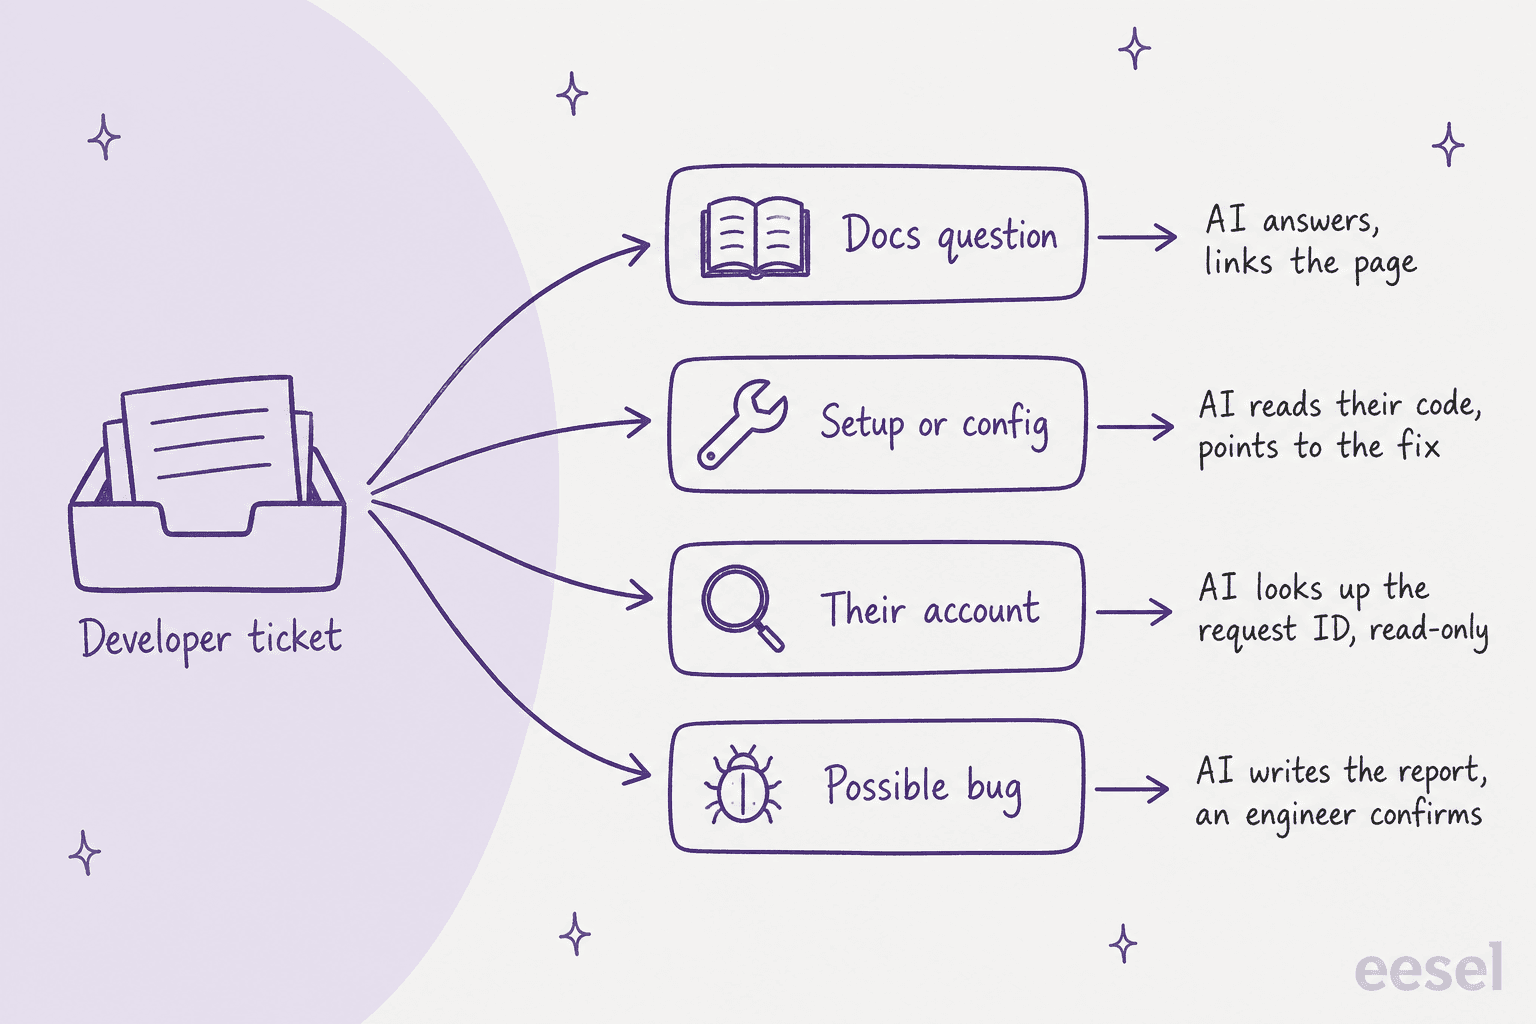
| Type de ticket | Exemple | Ce que l'IA doit faire | Ce qu'il faut connecter |
|---|---|---|---|
| Question de documentation | « Quelle est la limite de débit sur /search ? » | Répondre et lier la page | Référence d'API, documentation des SDK, changelog |
| Configuration | « 401 après rotation des clés sur Node SDK 2.4 » | Demander la version du SDK et l'ID de requête, jamais la clé, puis indiquer la correction probable | Documentation, changelog, tickets passés |
| Leur compte | « Le webhook invoice.paid n'est jamais arrivé » | Consulter le journal de livraison, en lecture seule, et expliquer ce qui s'est passé | Une consultation de votre propre API ou de vos outils d'administration |
| Bug possible | « /search renvoie 500 seulement dans la région UE depuis 9 h » | Vérifier les problèmes connus et le statut, rédiger le rapport, le transmettre à un ingénieur | Problèmes connus, page de statut, suivi des tickets d'ingénierie |
| Changement de compte | « Pouvez-vous relever notre limite de débit ? » | Recueillir les détails, attendre l'approbation d'une personne | Une étape d'approbation |
Les deux premières voies sont celles où les bots de documentation réussissent déjà bien. La troisième est celle où la plupart des configurations s'arrêtent, parce qu'elle exige une connexion en direct à vos propres systèmes. La quatrième est celle où se trouvent les heures.
Essayez de trier vous-même quelques tickets d'apparence réelle :
Où va ce ticket de développeur ?
Choisissez un ticket pour voir à quelle voie il appartient et ce dont l'IA a besoin pour le traiter.
Rien de choisi pour l'instant. Commencez par n'importe quel ticket ci-dessus.
La réponse se trouve dans votre référence d'API. L'IA répond avec le nom du scope et lie la page utilisée, pour que le développeur puisse vérifier.
Besoin : référence d'API et documentation des SDK, explorées de façon planifiée.
Elle demande la version du SDK et un ID de requête, jamais la clé elle-même, puis vérifie le changelog de cette version et les tickets passés avec la même erreur. Une clé de test en production est le coupable habituel.
Besoin : documentation, changelog, tickets passés.
Un assistant de programmation a probablement inventé ces champs. L'IA compare la charge utile à votre vrai schéma champ par champ et lie le bon. Consignez aussi cela comme un signal pour la documentation : si leur outil a mal deviné, votre documentation est peut-être difficile à lire pour les outils.
Besoin : spécification OpenAPI ou référence d'API.
Elle appelle votre journal de livraison interne pour cette requête, en lecture seule et limité à ce client, et explique ce qu'elle a trouvé : les nouvelles tentatives, le code de réponse renvoyé par leur endpoint, le moment où elle a renoncé.
Besoin : une consultation de votre propre API, avec des identifiants que l'IA ne voit jamais.
Elle vérifie les problèmes connus et la page de statut, rassemble la région, l'endpoint, les ID de requête et les horodatages, et dépose un rapport pour l'ingénierie. Elle dit au développeur que c'est à l'examen et ne parle jamais de bug confirmé.
Besoin : problèmes connus, page de statut, votre outil de suivi des tickets d'ingénierie.
L'IA recueille l'offre, l'usage actuel et le motif, puis retient le changement pour une personne. Tout ce qui modifie un compte ou de l'argent attend une approbation.
Besoin : une étape d'approbation sur chaque action d'écriture.
Pourquoi un bot de documentation ne vous mène-t-il qu'à mi-chemin ?
Un bot de documentation est le premier pas évident, et c'est un bon. kapa.ai, par exemple, relie la documentation, des dépôts GitHub, une spécification OpenAPI, des fils Slack et des tickets Zendesk, et compte parmi ses clients OpenAI, Grafana et Netlify. Un développeur dont l'équipe l'a acheté a résumé simplement la valeur :
"It's not right all the time, but it is most of the time and, crucially, it shares not just an answer but a link to the docs that led it to that answer. That makes it easier to fact check the LLM."
Ce lien est l'essentiel. Un développeur fera confiance à une réponse qu'il peut vérifier, et pas à une réponse qu'il ne peut pas vérifier. Mais trois choses empêchent un bot de documentation de couvrir toute la file.
La recherche est plus difficile qu'il n'y paraît. Le fondateur de kapa.ai lui-même, Emil Sorensen, a écrit que les bots de documentation sont "deceptively hard to get right in production", que la recherche dépend beaucoup de la façon dont votre documentation est découpée et structurée, et que la seule façon de l'affiner est l'évaluation, "lots of them", d'après son commentaire sur Hacker News. Si un éditeur dont tout le produit est cela le dit, croyez-le avant de monter le vôtre en un week-end.
Les versions dérivent. Un développeur sur le SDK 2.4 a besoin de la réponse de la 2.4, pas de celle de la 3.0. Votre IA a besoin du changelog comme source, et votre documentation a besoin d'étiquettes de version qu'elle peut lire. Sans les deux, elle donne la réponse la plus récente à tout le monde.
La documentation ne connaît pas leur compte. « Pourquoi mon webhook a-t-il échoué ? » n'a de réponse dans aucune page de documentation. La réponse est dans vos journaux de livraison, auxquels un bot de documentation n'accède pas. Ce sont les voies trois et quatre, et c'est pourquoi les outils de support pour équipes de développeurs (Plain, Pylon, eesel) placent l'IA dans la file de tickets avec accès à vos systèmes, et pas seulement sur le site de documentation.
Que doit lire l'IA avant de répondre ?
Les sources comptent plus que le modèle. Voici ce que je connecterais, à peu près par ordre d'utilité :
- Référence d'API et spécification OpenAPI. La vérité de référence sur les endpoints, les paramètres et les codes d'erreur. C'est la spécification qui permet à l'IA de repérer un champ inventé.
- Documentation des SDK par langage. Étapes d'installation, configuration et particularités de chaque bibliothèque cliente.
- Changelog et notes de version. C'est ainsi que l'IA sait qu'un paramètre a été renommé en 2.4 ou qu'une valeur par défaut a changé en 3.0.
- Tickets résolus. Les cas limites que personne n'a documentés. C'est la source qui fait sonner les réponses comme votre ingénieur senior. Orosoft pointe son agent vers environ 6 100 tickets Freshdesk résolus et lui demande de préférer les résolus, de pondérer les récents et d'indiquer sur quel ticket ou article chaque brouillon s'appuie.
- Problèmes connus et statut. Pour que l'IA dise « nous avons connaissance de ce problème » au lieu de guider un développeur dans une correction face à une panne.
- Procédures internes. Pour l'équipe de support, pas pour les réponses publiques.
Deux règles que je fixerais dès le premier jour. D'abord, les tickets passés regorgent de données clients, donc masquez-les avant l'indexation. La suppression des données personnelles d'eesel fait passer chaque ticket synchronisé dans un détecteur de quinze catégories, dont les numéros de carte et les noms, avant que quoi que ce soit soit stocké, de sorte que l'agent ne voit jamais les originaux. Ensuite, gardez les sources à jour de façon planifiée. Timengo réexplore son site de documentation chaque lundi, resynchronise son centre d'aide chaque dimanche soir et récupère l'historique complet des tickets chaque mois, ce qui compte dans un produit où les certificats expirent sur un cycle de trois ans et où une vague de renouvellements arrive d'un coup.
Si vous partez d'un centre d'aide maigre, mon audit de base de connaissances par IA est le bon point de départ, et la base de connaissances IA pour le SaaS couvre la structure.
Comment l'IA consulte-t-elle un ID de requête sans voir vos clés d'API ?
C'est la voie qui fait passer une IA d'une recherche dans la documentation à quelque chose qui fait gagner du temps aux ingénieurs. Le développeur donne un ID de requête, l'IA le cherche dans votre système et explique ce qui s'est passé. Bien faite, elle ne demande ni ne voit jamais de secret.
Les règles que je tiendrais :
- Ne demandez jamais sa clé d'API au développeur. Demandez l'ID de requête, la version du SDK et l'endpoint. Cela suffit pour chercher.
- Lecture seule d'abord. L'IA peut consulter les journaux de livraison et les enregistrements de requêtes. Elle ne peut rien modifier tant que vous ne l'avez pas décidé.
- Limitez à son compte. Une consultation pour un client ne doit renvoyer que les enregistrements de ce client.
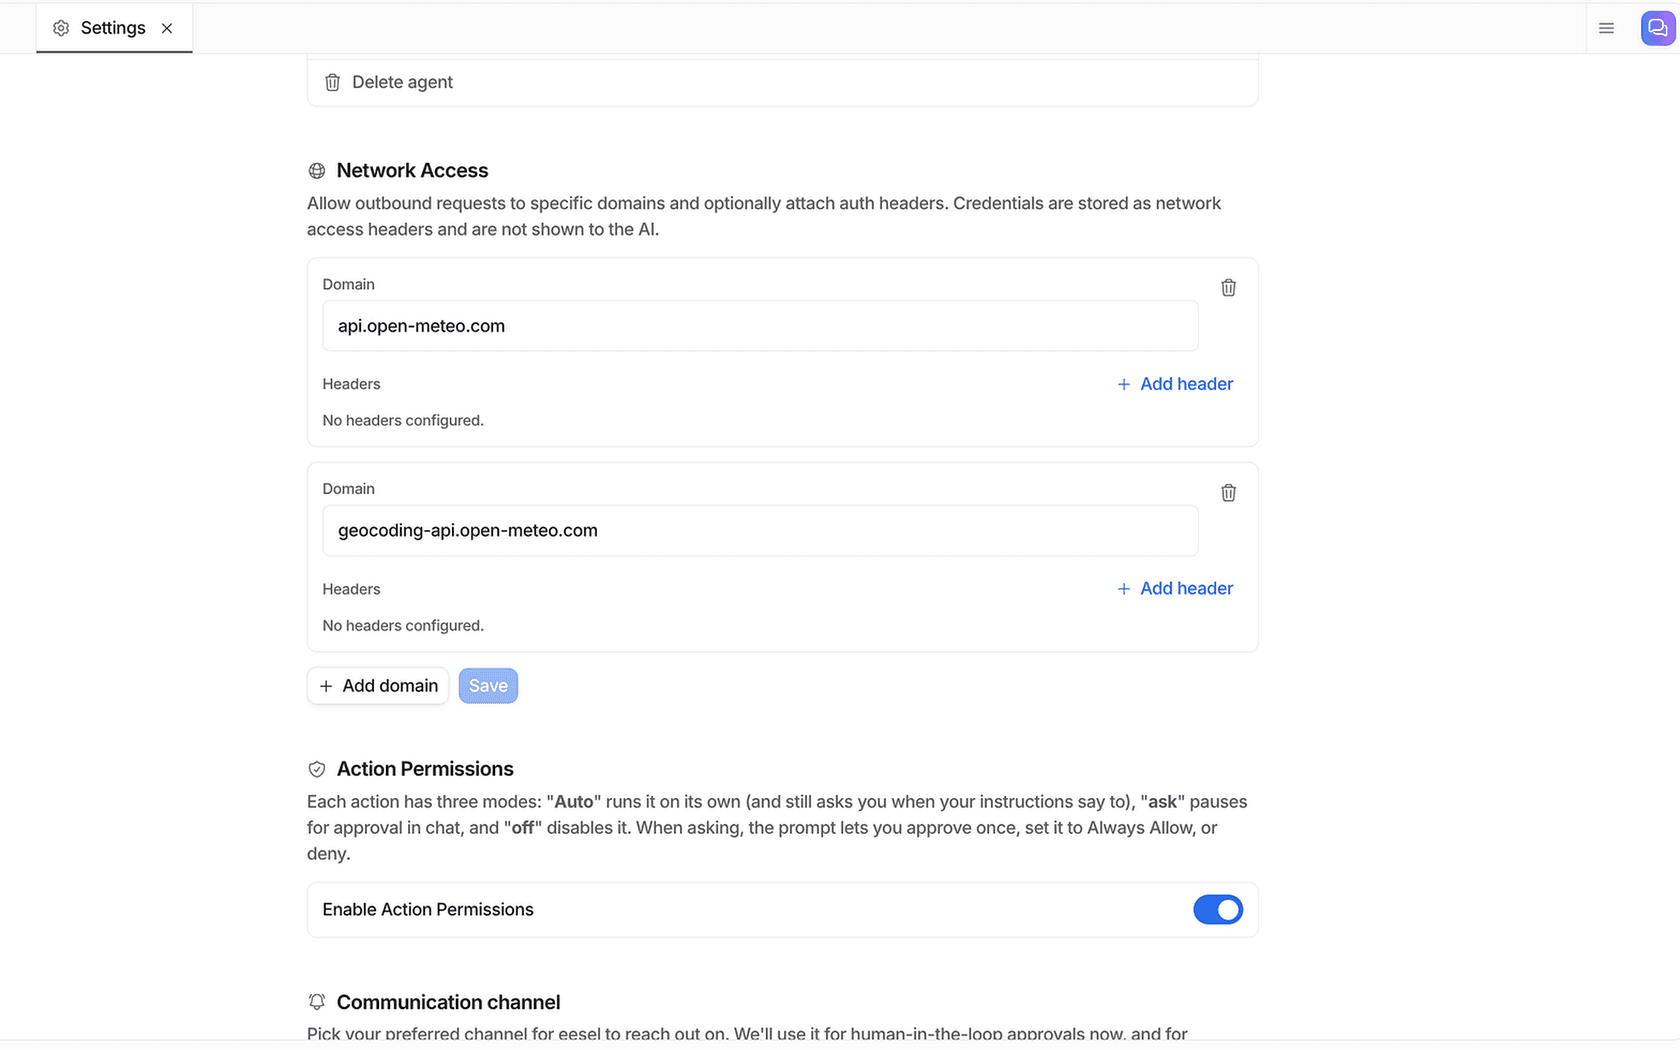
- Les identifiants restent hors de portée de l'IA. La clé qui autorise la consultation se trouve dans les paramètres, pas dans le prompt.
Dans eesel, c'est Network Access. Vous autorisez un domaine, ajoutez l'en-tête d'authentification attendu et dites à l'agent en termes simples à quoi sert la connexion, par exemple « quand un développeur donne un ID de requête, cherche-le et explique son statut ». Selon la documentation, les identifiants "stay in your settings and are attached to each request by eesel, so the AI never sees them". Il prend en charge GET, POST, PATCH et DELETE, si bien que le même mécanisme peut atteindre une API d'administration interne ou une API publique comme celle de votre outil de suivi, si vous l'autorisez.
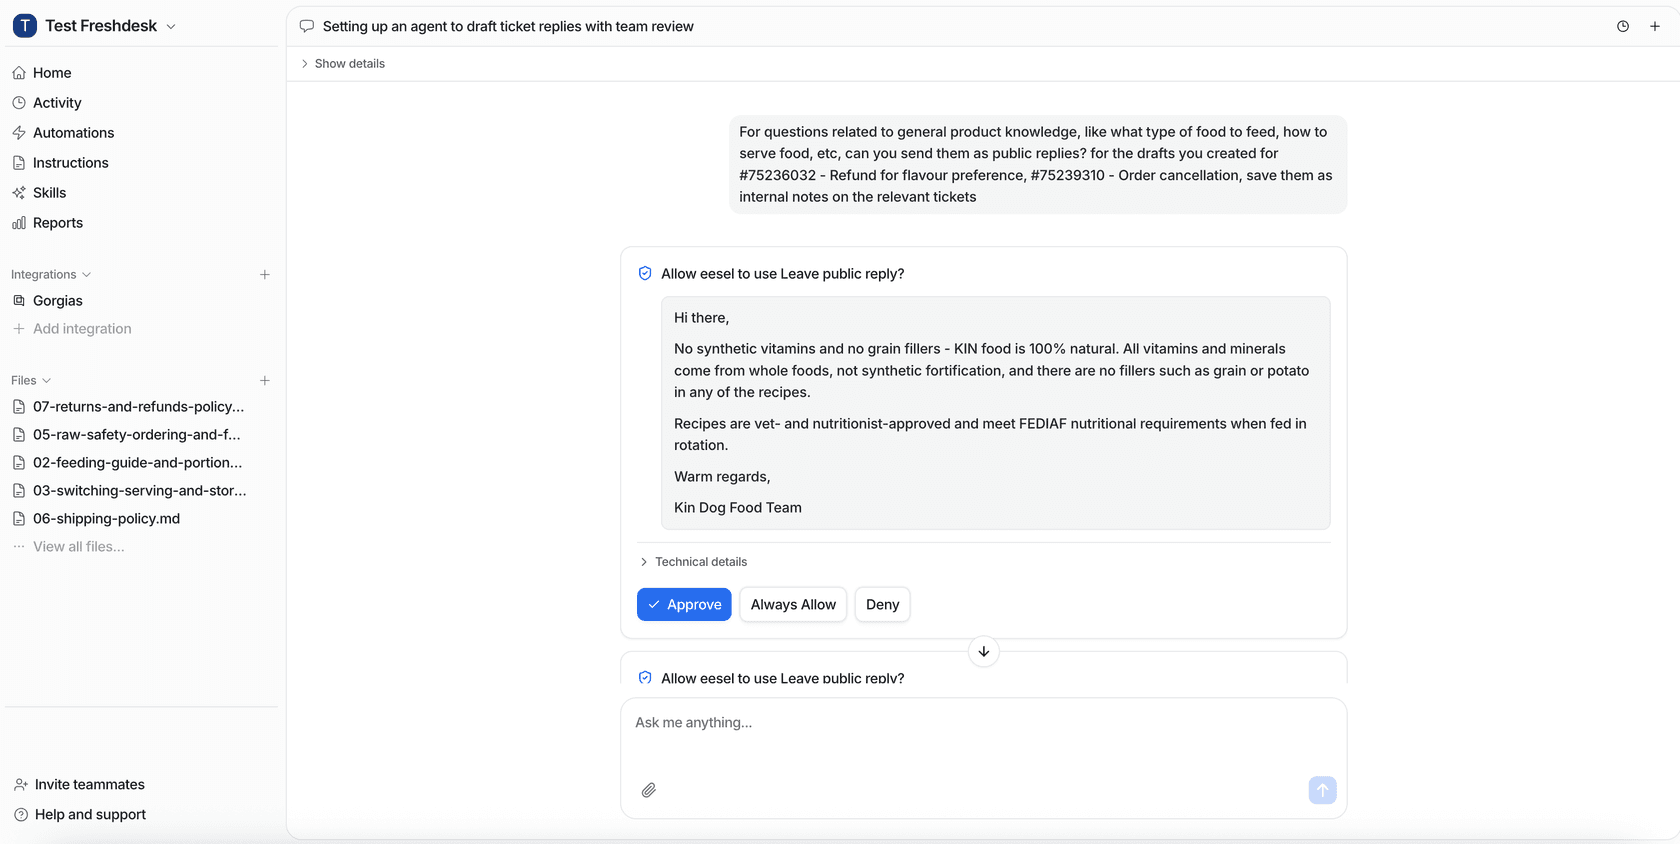
Tout ce qui modifie un état passe derrière une approbation. Les actions et approbations d'eesel vous permettent de régler chaque action sur Auto, Needs approval ou Disabled. Le conseil de la documentation elle-même est de démarrer les nouveaux agents sous supervision et de garder derrière une approbation tout ce qui coûte de l'argent, ce qui, pour une entreprise d'API, signifie changements de limite de débit, crédits et passages à une offre supérieure. Les approbations apparaissent dans le tableau de bord, dans Slack ou dans le terminal.
Comment un bug possible doit-il arriver à l'ingénierie ?
Le pire ticket de développeur qu'un ingénieur puisse recevoir est un ticket transféré avec « le client dit que les webhooks sont cassés » en tête. Le meilleur est un rapport sur lequel il peut agir en cinq minutes. L'IA est douée pour écrire le second, parce qu'elle peut tout recueillir pendant que le développeur est encore dans la conversation.
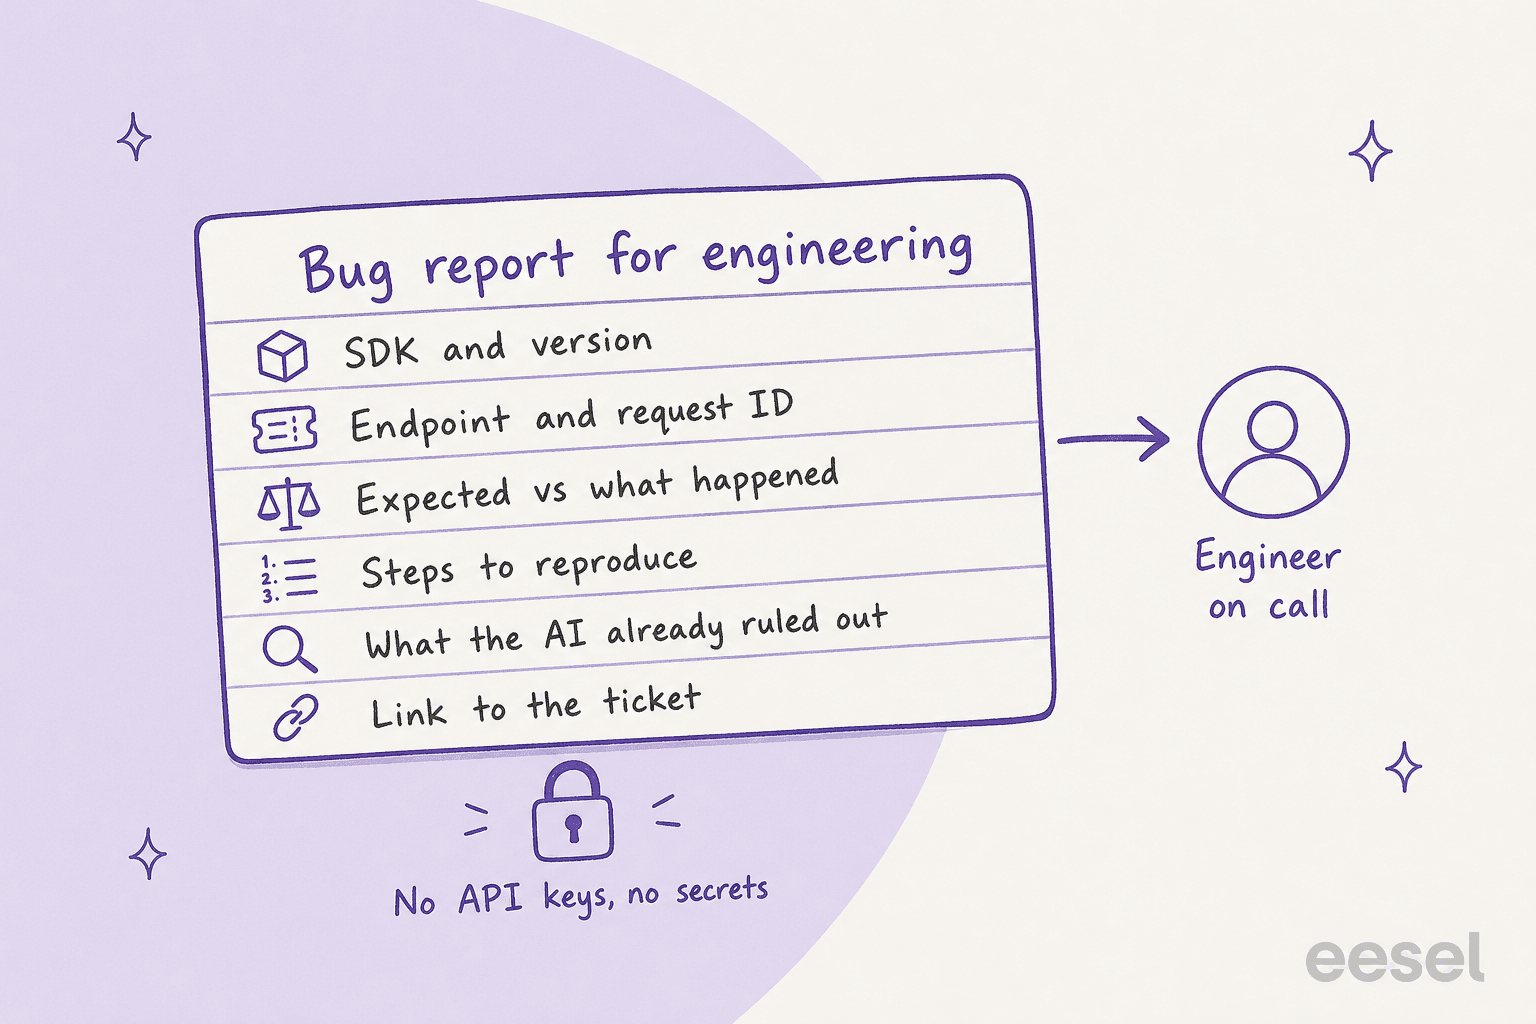
Un bon rapport contient :
- SDK, langage et version, plus la version de l'API si vous en versionnez une.
- Endpoint, ID de requête et horodatages.
- Ce que le développeur attendait et ce qu'il a obtenu, avec le corps de l'erreur.
- Étapes pour reproduire, autant que le développeur peut les donner.
- Ce que l'IA a déjà écarté : problèmes connus vérifiés, page de statut vérifiée, configuration apparemment correcte.
- Un lien vers le ticket.
Et une règle au-dessus des autres : l'IA peut dire « cela pourrait être un bug, je l'ai transmis à l'ingénierie », mais elle ne doit jamais dire à un développeur que quelque chose est un bug confirmé. C'est un jugement qui revient à la personne qui peut lire le code.
La destination du rapport dépend de votre stack. L'intégration Jira Service Management d'eesel peut répondre, laisser des notes internes, et déplacer, assigner, étiqueter et créer des tickets, et vous pouvez lui dire comment organiser ses notes. eesel n'a pas d'intégration native avec GitHub ou Linear. Plain liste des intégrations Linear, Jira et GitHub sur sa page de tarifs, et Pylon liste des connecteurs d'agents de programmation et des actions d'API personnalisées.
Si l'ingénierie vit déjà dans Jira, mon article sur l'escalade de Zendesk vers Jira va plus loin. La déduplication des tickets aide quand une seule panne arrive sous forme de quarante tickets.
Pourquoi les mauvaises réponses sont-elles le signal le plus utile ?
Toute équipe qui met cela en place craint que l'IA donne une mauvaise réponse, et cela arrivera, parfois. Ce qui m'a surpris dans la recherche, c'est la fréquence à laquelle une mauvaise réponse se révélait être un problème de documentation. Un développeur sur Hacker News a décrit comment son propre chatbot de documentation inventait de temps en temps une option de ligne de commande qui n'existait pas :
"So it was considered as product feedback. Maybe that exact flag wasn't needed, but something was missing and so the LLM hallucinated what it saw as an intuitive option."
C'est le bon réflexe. Un paramètre inventé, c'est l'IA qui vous montre où votre documentation laisse un trou dans lequel un développeur tomberait aussi.
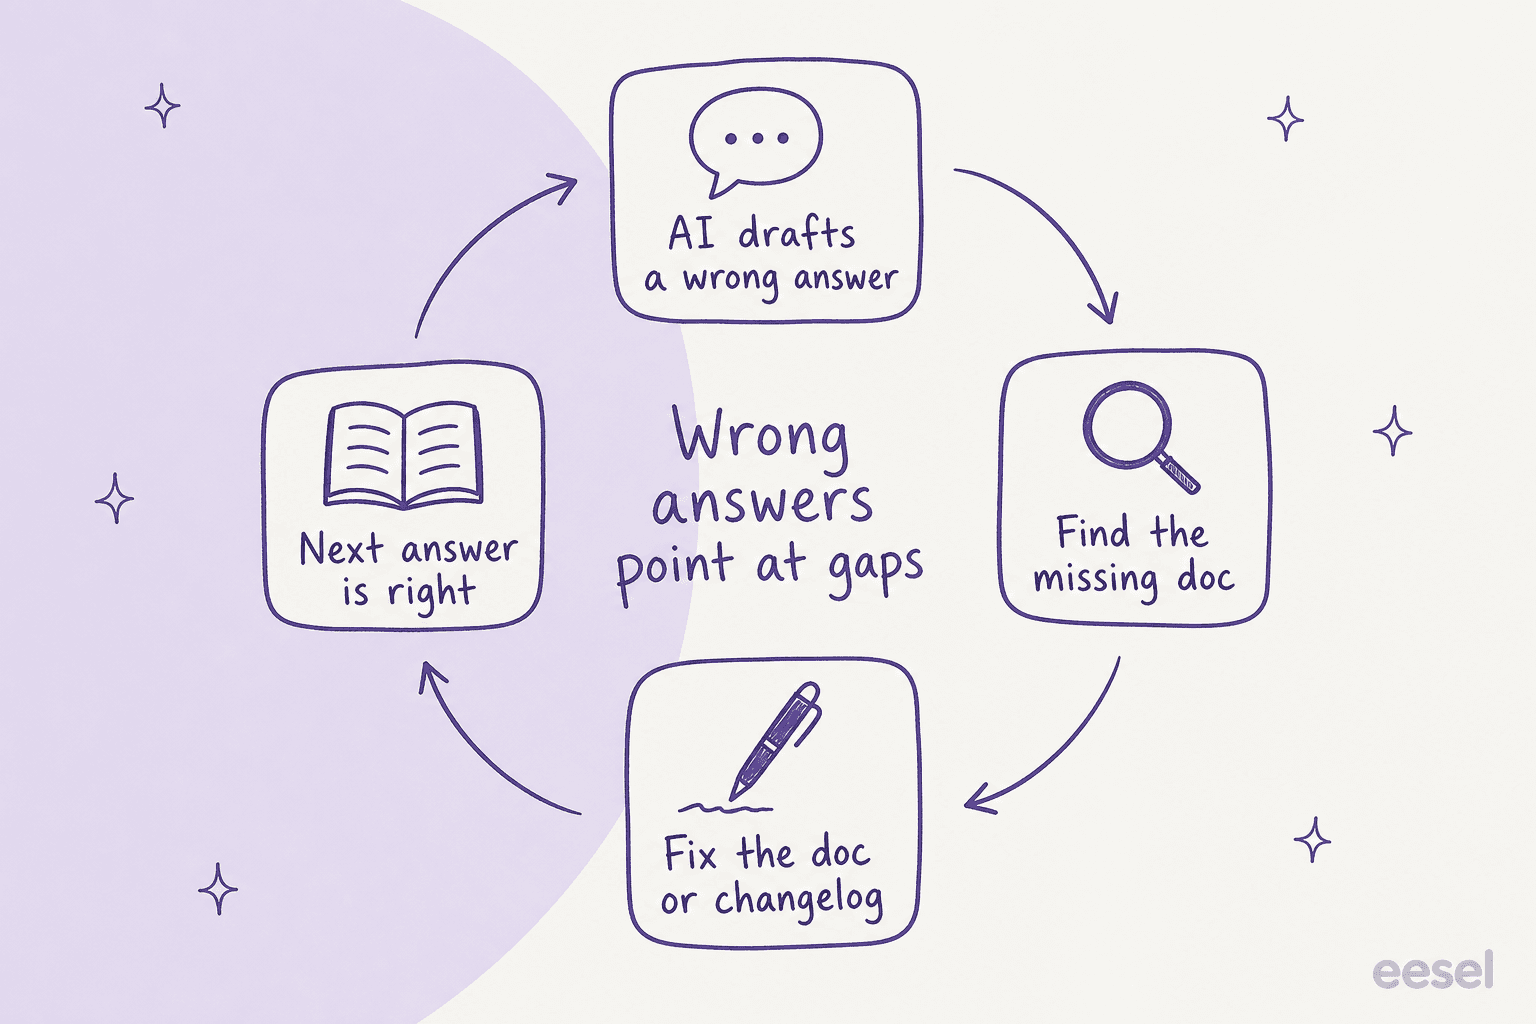
Qontro, qui vend des logiciels ERP en cloud, a construit son déploiement exactement autour de cela. Chaque ticket Freshdesk reçoit un brouillon en note interne, appuyé sur le centre d'aide et environ 9 800 tickets et articles passés. L'équipe compare chaque brouillon à la réponse qu'une personne a réellement envoyée, et là où le brouillon était faux, cela désigne généralement un article d'aide manquant ou une règle à resserrer. Leur témoignage indique qu'environ un brouillon sur dix part désormais avec peu ou pas de modification, et que cette part augmente. Les erreurs système, les pertes de données et les intégrations sur mesure vont directement à une personne.
Pour la mécanique qui garde les réponses ancrées, voyez mon article sur la prévention des hallucinations de l'IA dans le support, l'entrée du glossaire sur l'ancrage de l'IA et l'analyse des lacunes de connaissances du support pour transformer les mauvaises réponses en backlog.
Faut-il construire soi-même ou acheter un outil ?
La réponse de ChatGPT à cette question renvoyait directement à la documentation d'agents d'OpenAI et à une solution maison : une couche de recherche, des appels d'outils pour consulter les requêtes, des garde-fous et une étape d'escalade. C'est une vraie option si vous avez des ingénieurs pour la porter. Ce qu'elle omet, c'est ce que le fondateur de kapa.ai a signalé : la qualité de la recherche et les évaluations sont un travail continu, pas une tâche de lancement. Et il faut encore la brancher à votre helpdesk.
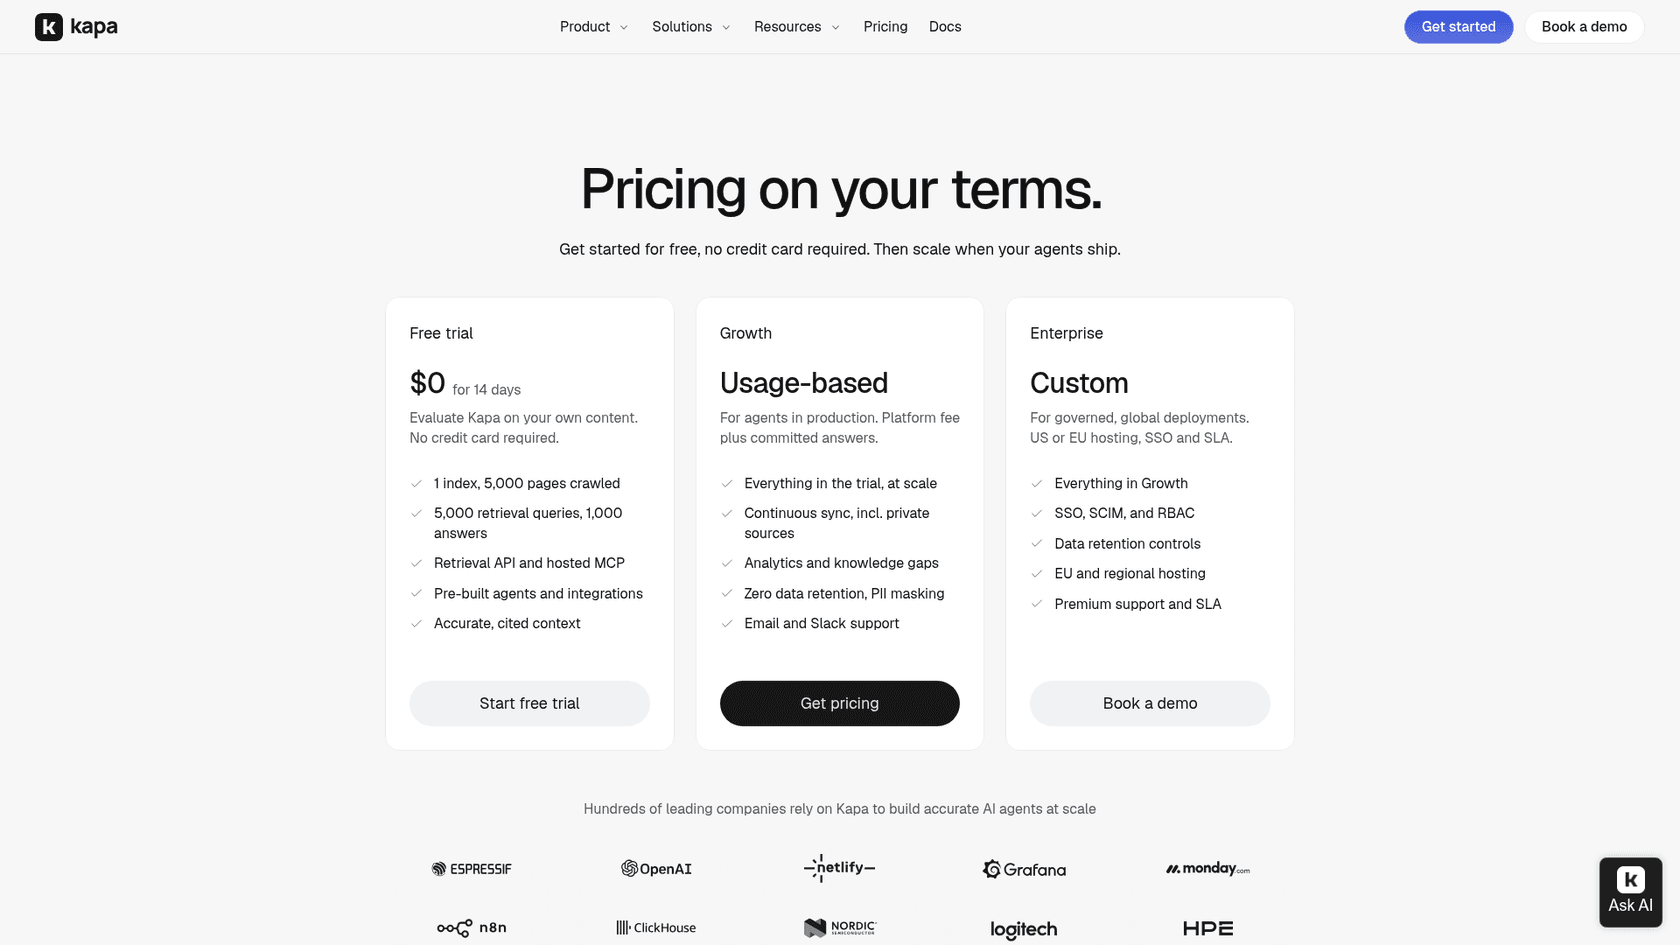
Voici comment se comparent les options que j'ai examinées. Les prix viennent de la page de tarifs de chaque éditeur, consultée le 30 octobre 2026.
| Option | Ce que c'est | Où l'IA répond | Modèle tarifaire | Prix public |
|---|---|---|---|---|
| kapa.ai | IA de documentation et API de recherche | Site de documentation, dans le produit, formulaire de support, Slack, Discord, Zendesk | Frais de plateforme plus réponses engagées | Essai gratuit de 14 jours, puis Growth sur devis uniquement |
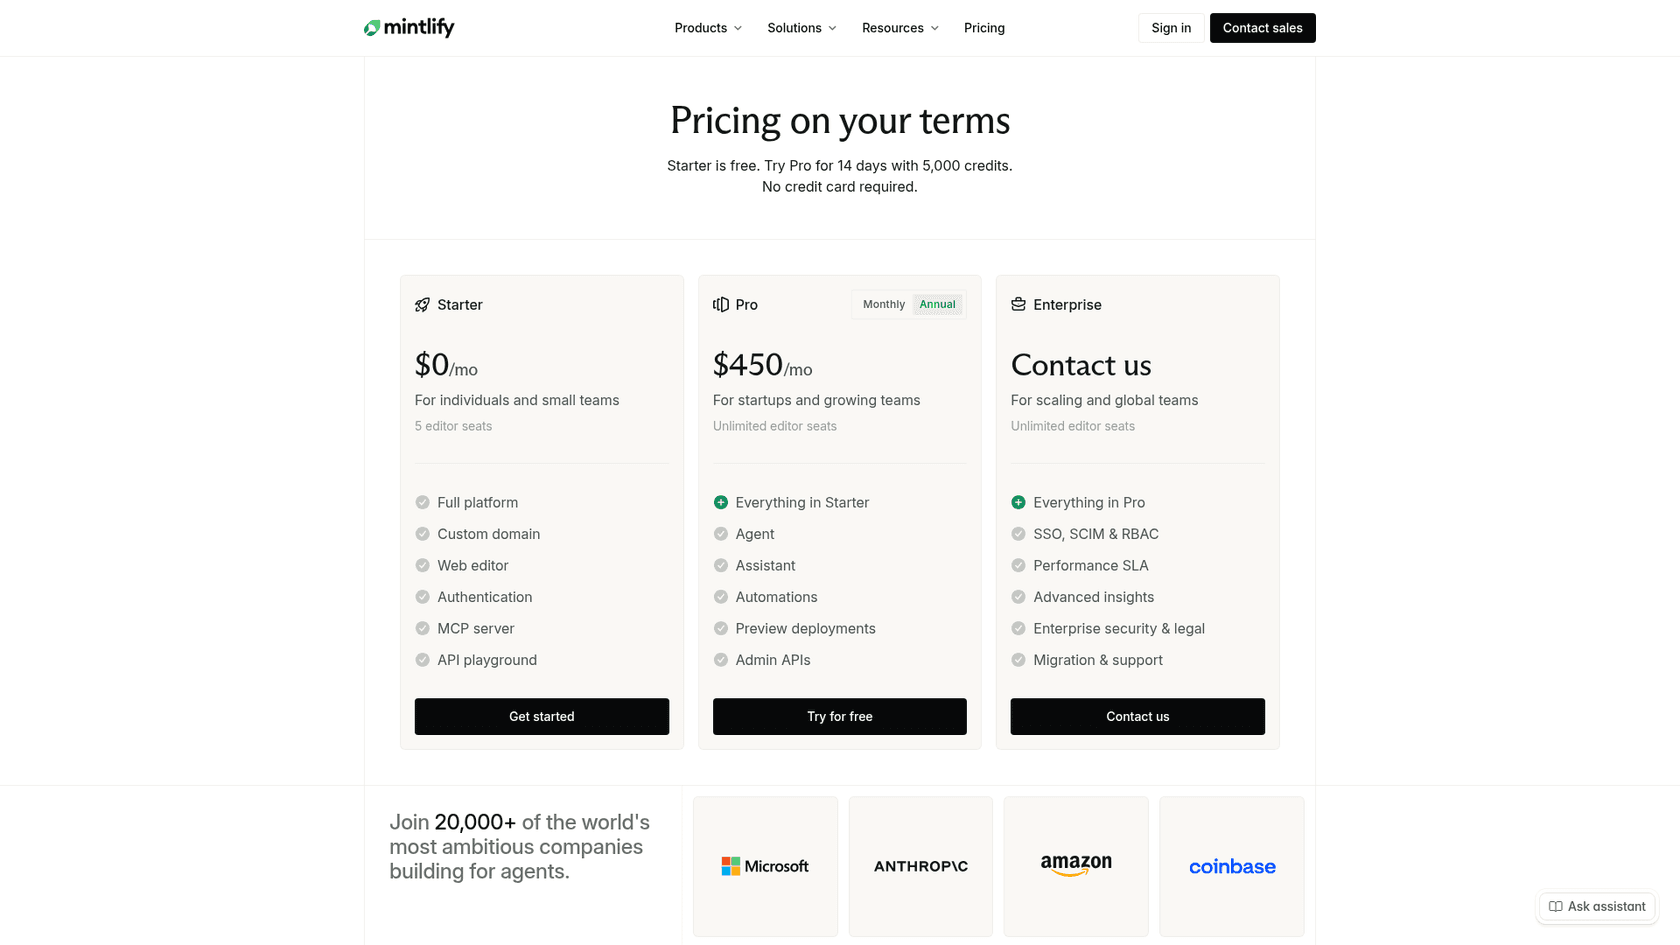
| Mintlify | Plateforme de documentation avec assistant IA | Votre site de documentation | Offre plus crédits | Pro 450 $/mois en facturation annuelle (540 $ au mois), 10 000 crédits, 25 crédits par réponse |
| Plain | Plateforme de support pour équipes B2B techniques | Slack, e-mail, dans l'app, chat | Par poste plus crédits | Foundation 45 $/utilisateur/mois en annuel (55 $ au mois), 100 crédits par résolution IA, +1 000 crédits pour 10 $ |
| Pylon | Plateforme de support B2B | Slack, Teams, e-mail, WhatsApp | Par poste plus crédits | Professional 89 $/poste/mois en annuel, crédits à 0,30 $ pièce en paiement à l'usage |
| eesel | Coéquipier IA dans votre helpdesk existant | Freshdesk, Zendesk, Jira Service Management, chat, Slack, e-mail | Crédits mensuels fixes | 299 $/mois pour 500 crédits, 1 crédit par ticket ou chat, postes illimités |
| Construire sur une API de modèle | Votre propre agent | Là où vous le branchez | Jetons plus temps d'ingénierie | Dépend de votre développement |
Combien cela coûte-t-il pour une équipe ?
Les prix par poste, par réponse et par résolution ne se comparent pas tant qu'ils ne sont pas chiffrés pour un même acheteur. Prenons donc une entreprise d'API avec 2 000 tickets de développeurs par mois, trois personnes au support et une IA qui résout entièrement 30 % des tickets (600), la même part de 30 % que Pylon utilise dans son propre exemple.
| Option | Le calcul | Coût mensuel |
|---|---|---|
| eesel | Offre de 2 000 crédits, postes illimités, chaque ticket traité compte | 849 $ |
| Plain (Foundation, annuel) | 3 postes x 45 $ = 135 $, plus 600 résolutions x 100 crédits = 60 000 crédits, moins 1 000 inclus = 59 000 x 0,01 $ = 590 $ | Environ 725 $, avant les crédits de rédaction de Sidekick pour les 1 400 autres |
| Pylon (Professional, annuel) | 3 postes x 89 $ = 267 $, plus l'estimation moyenne propre à Pylon pour 2 000 tickets de 26 395 $ par an en crédits engagés | Environ 2 467 $ |
| Mintlify (Pro, annuel) | 450 $ plus 2 000 réponses de documentation x 25 crédits = 50 000 crédits, moins 10 000 inclus = 40 000 x 0,01 $ = 400 $ | Environ 850 $, pour les réponses de documentation seulement, pas les tickets |
| kapa.ai | Non public | Devis |
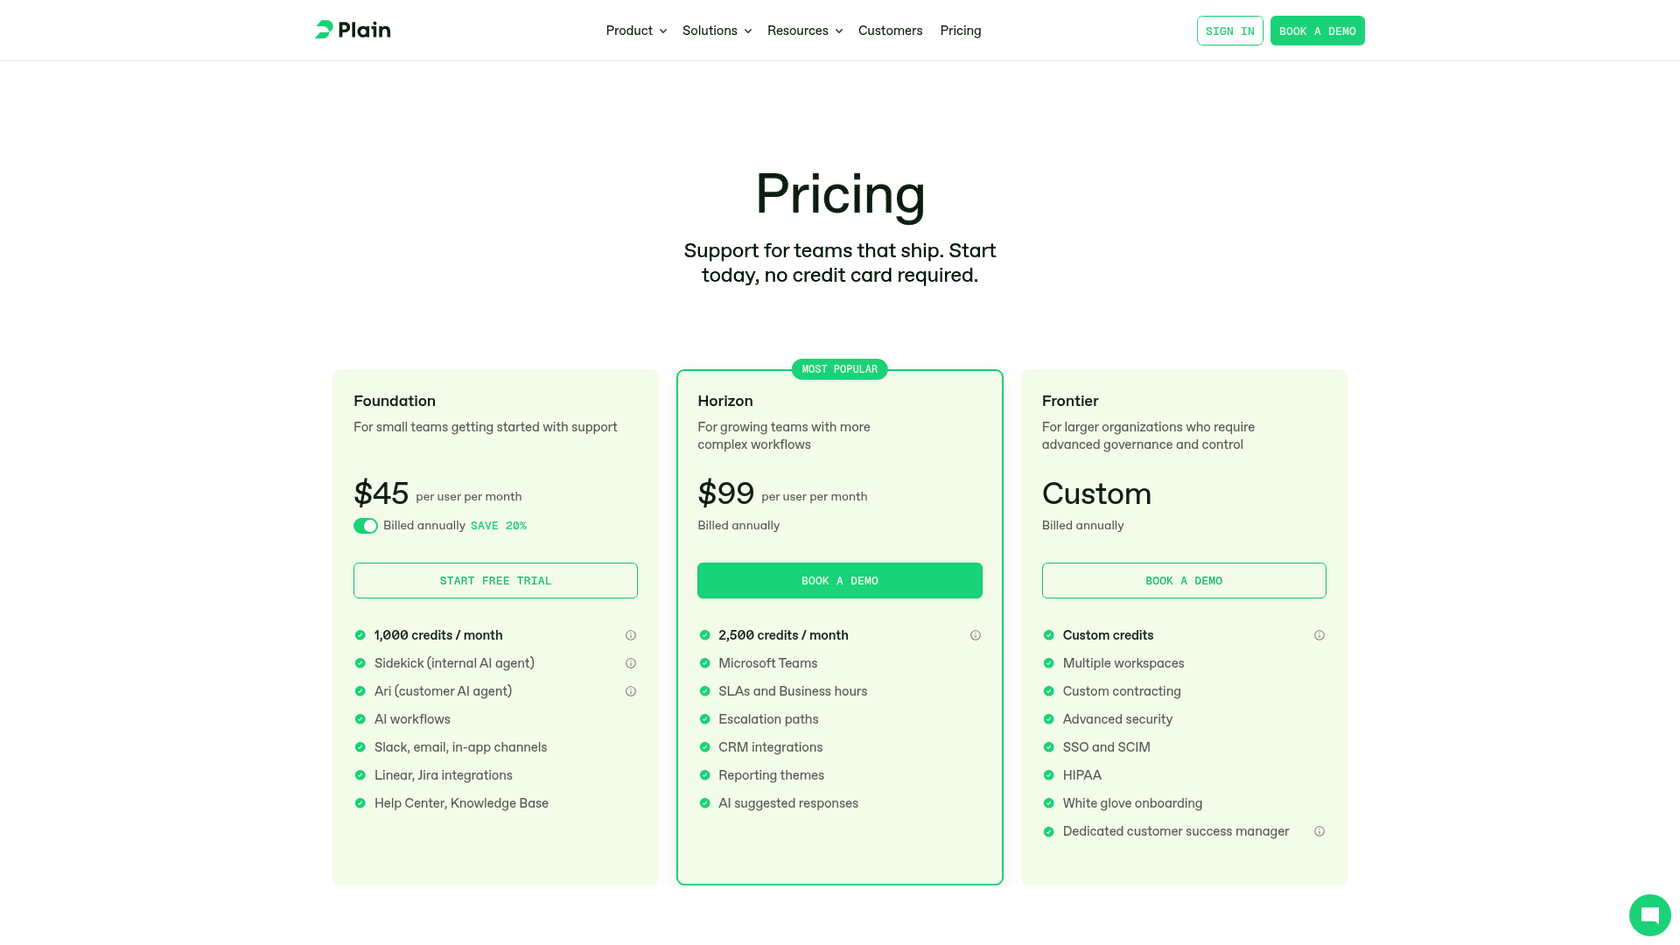
Deux réserves sur ce tableau. Les unités ne sont pas la même chose : eesel compte chaque ticket qu'il traite, rédigé ou répondu, alors que les 100 crédits de Plain ne valent que pour des résolutions IA complètes. Et l'assistant de Mintlify vit sur votre site de documentation, donc il réduit les tickets avant leur création au lieu de traiter ceux qui arrivent. Vous voudrez peut-être bien les deux.
Mon avis : si vous débutez et que la plupart des tickets sont des questions de documentation, commencez par l'assistant de documentation que votre plateforme propose déjà. Si vous utilisez déjà Freshdesk, Zendesk ou Jira Service Management et que le problème se situe dans la file de tickets, mettez l'IA là plutôt que de changer de helpdesk. Plain et Pylon ont le plus de sens si vous choisissez de toute façon un nouveau helpdesk, surtout si vos développeurs vivent dans Slack. Des panoramas du champ plus large sont dans meilleure IA pour le support SaaS et meilleur chatbot pour développeurs.
Comment le déployer sans entamer la confiance des développeurs ?
Les développeurs pardonnent un « je ne sais pas, je transmets à un ingénieur ». Ils ne pardonnent pas une mauvaise réponse assurée sur leur intégration en production. Déployez donc dans cet ordre :
- Des brouillons seulement, sur chaque ticket. L'IA écrit un brouillon ou une note interne, une personne envoie. C'est ainsi que fonctionne Timengo : en un mois, eesel a préparé environ 300 tickets Freshdesk, rédigé environ 180 brouillons de réponse et environ 260 notes internes, et n'a jamais envoyé de réponse seul.
- Ancré ou rien. Dites-lui de nommer le document ou le ticket utilisé et de laisser une note demandant une personne quand rien ne soutient une réponse. L'agent d'Orosoft fait exactement cela.
- Comparez les brouillons à ce qui a été envoyé. Corrigez la documentation là où le brouillon était faux, comme le fait Qontro.
- Ajoutez les consultations. Branchez un accès en lecture seule aux journaux de requêtes et de webhooks une fois que les réponses de documentation sont fiables.
- Laissez des sujets étroits passer en automatique. Limites de débit, scopes, étapes d'installation des SDK. Gardez les bugs, les changements de compte et tout ce qui touche à l'argent avec une personne.
Pour le calendrier, mon calendrier de mise en place du support IA donne des chiffres réalistes, et les tests de simulation du support IA expliquent comment tester sur des tickets passés avant la mise en ligne.
Une revue de sécurité vaut la peine avant de donner à une IA l'accès à des systèmes de production. Le moment de passer la main à une personne est traité dans les bonnes pratiques de transmission à un humain.
Les ingénieurs peuvent-ils le configurer depuis le terminal ?
Pour une entreprise d'API, cela compte. La CLI d'eesel exécute depuis un terminal le même agent que vous voyez dans le tableau de bord, et chaque commande affiche du JSON, si bien qu'un agent de programmation comme Claude Code, Cursor ou Codex peut aussi la piloter. npx @eesel/cli init chat-bubble --site https://your-site.com configure une bulle de chat sans compte, eesel files upload ajoute un document, eesel chat "how do I verify a webhook signature?" teste une réponse et eesel approvals approve <id> débloque une action retenue. Pour la CI ou un serveur, elle lit EESEL_API_URL et EESEL_API_TOKEN au lieu d'une connexion par navigateur. eesel fonctionne aussi comme serveur MCP pour Claude Code et d'autres clients MCP, pratique quand vos ingénieurs préfèrent mettre à jour les connaissances de l'agent depuis l'outil dans lequel ils écrivent la documentation. Le contexte de l'idée se trouve dans mon article sur les serveurs MCP pour agents IA.
Essayer eesel pour le support aux développeurs
Si vos tickets de développeurs arrivent dans Freshdesk, Zendesk ou Jira Service Management, eesel rejoint cette file comme un nouvel ingénieur support qui a déjà lu votre documentation, votre changelog et chaque ticket que vous avez résolu. Il rédige les réponses de documentation et de configuration avec la source liée, consulte les enregistrements de requêtes et de webhooks via votre propre API sans jamais détenir la clé, et laisse à l'ingénierie un rapport de bug plutôt qu'une plainte transférée.
Timengo assure ainsi son support technique en danois, avec un ingénieur qui envoie chaque réponse.
Les offres démarrent à 299 $ par mois pour 500 tickets ou chats, avec des postes illimités, et il existe un essai gratuit de 100 crédits. Essayez eesel sur les tickets du mois dernier et voyez quels brouillons votre équipe aurait envoyés.
Comment empêcher une IA d'inventer des endpoints ou des paramètres d'API ?