

Claude Fable 5.2 a été lancé le 9 novembre 2026 à 8$ par million de tokens en entrée et 40$ par million de tokens en sortie, une baisse de 20% par rapport aux 10$ et 50$ de Fable 5.1. Si vous utilisez Fable 5.1, passez au nouveau modèle : il est moins cher, plus rapide, et obtient des scores plus élevés sur chaque benchmark publié par Anthropic. Si vous utilisez Opus 5.5 à 4$ et 20$, restez-y jusqu'à ce que vos propres évaluations en effort élevé ne suffisent plus, car Fable 5.2 coûte le double par token et les premiers utilisateurs rapportent qu'il consomme bien plus de tokens par tâche.
C'est le schéma autour duquel je construirais : un modèle de pointe est une infrastructure, et le travail se fait dans la couche posée au-dessus. Pour le support ou la production de contenu, eesel est cette couche, avec un coéquipier IA pour le helpdesk et un rédacteur de blog IA qui tournent sur le modèle le plus performant du moment. La CLI eesel permet aussi à un agent de codage de téléverser des connaissances approuvées et de poser des questions de test avant que rien ne passe en production, bien que la connexion au helpdesk elle-même nécessite toujours l'approbation d'un administrateur.
Qu'est-ce qu'Anthropic a vraiment publié ?
Anthropic a lancé deux modèles le 9 novembre, Fable 5.2 et Mythos 5.2, et affirme qu'il s'agit « du même modèle sous-jacent ». Fable embarque de solides garde-fous en cybersécurité et biologie pour pouvoir être accessible à tous. Mythos est la version aux garde-fous plus légers, ouverte aux organisations des programmes de vérification Cyber et Sciences de la vie. J'avais déjà couvert Mythos 5.1, et Mythos 5.2 a son propre article.
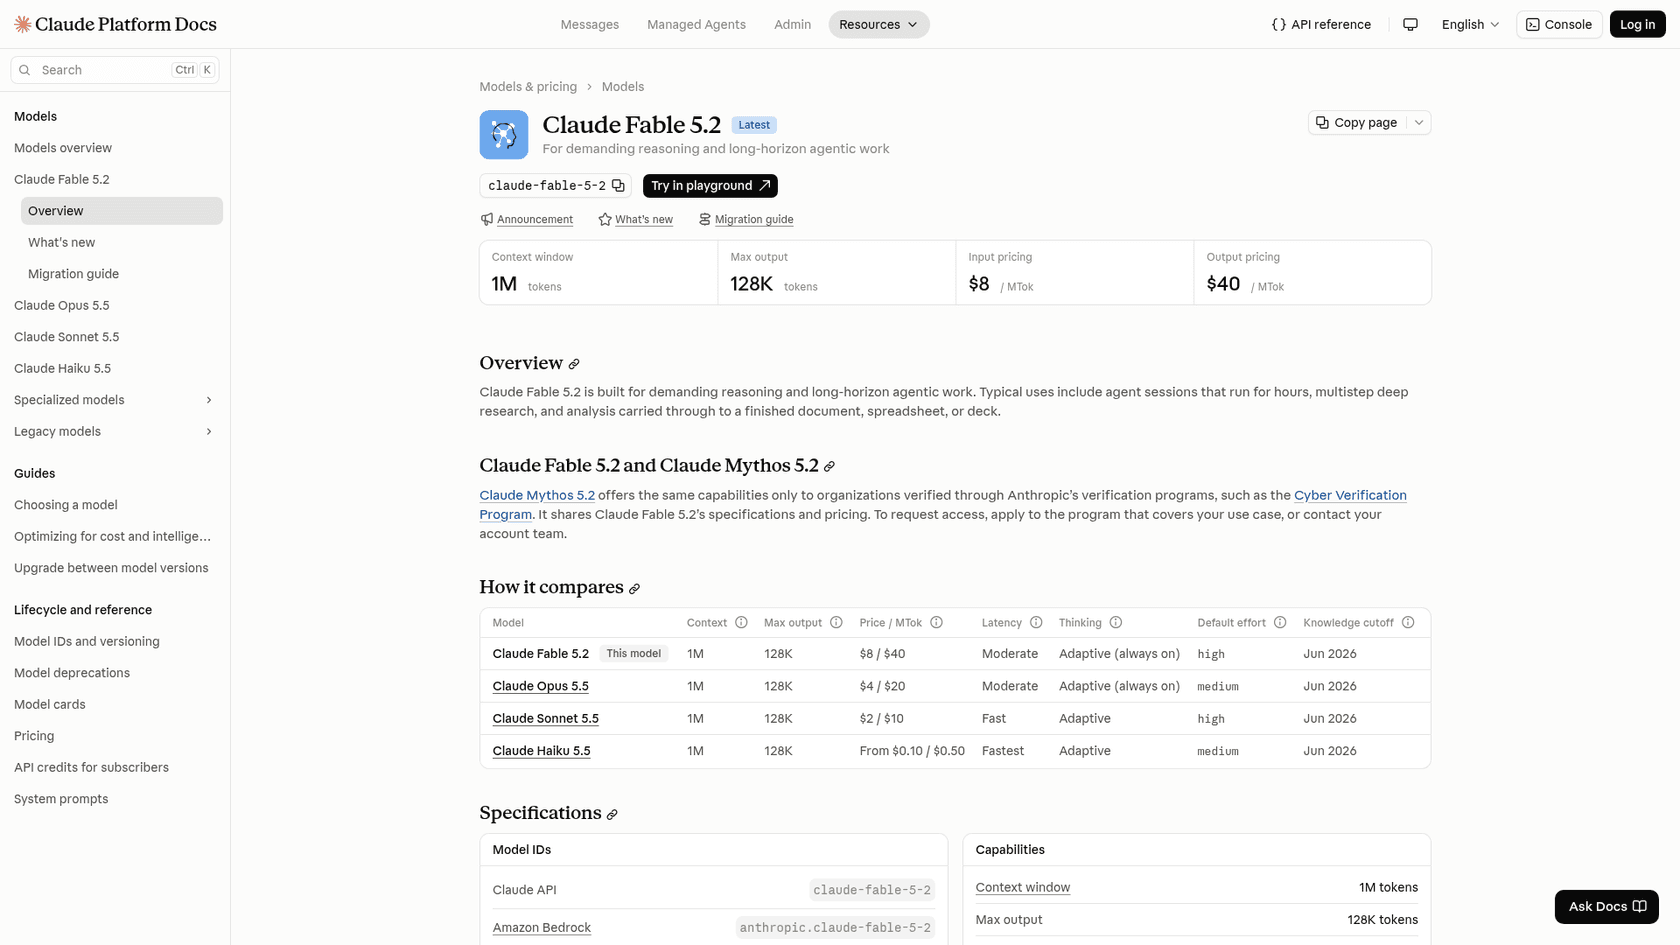
Les caractéristiques, tirées de la page du modèle :
| Caractéristique | Claude Fable 5.2 |
|---|---|
| ID du modèle API | claude-fable-5-2 (anthropic.claude-fable-5-2 sur Bedrock) |
| Date de sortie | 9 novembre 2026 |
| Prix par MTok | 8$ en entrée, 40$ en sortie |
| Lecture de cache / écriture 5 min / écriture 1h | 0,20$ / 10$ / 16$ |
| API par lots | 50% de remise sur l'entrée et la sortie |
| Mode rapide | 16$ en entrée, 80$ en sortie, sortie jusqu'à 2,5 fois plus rapide |
| Fenêtre de contexte | 1M de tokens |
| Sortie maximale | 128K tokens |
| Thinking | Adaptatif, toujours actif |
| Effort par défaut | high sur l'API |
| Date limite des connaissances | Juin 2026 |
Deux autres faits qui comptent pour le budget. Fable 5.2 exige une rétention des données de 30 jours et n'est pas disponible en rétention de données zéro, sauf autorisation expresse d'Anthropic. Et il n'est pas pris en charge sur le Priority Tier. Le détail complet des prix se trouve dans mon guide des tarifs de Fable 5.2.
Fable 5.2 est-il vraiment moins cher que Fable 5.1 ?
Par token, oui. Par tâche, cela dépend du réglage d'effort. Voici la comparaison des prix affichés, tirée de la page de tarifs et du guide de migration d'Anthropic :
| Mesure (par MTok) | Fable 5.2 | Fable 5.1 | Opus 5.5 |
|---|---|---|---|
| Entrée | 8$ | 10$ | 4$ |
| Sortie | 40$ | 50$ | 20$ |
| Lecture de cache | 0,20$ | 0,25$ | 0,20$ |
| Entrée / sortie par lots | 4$ / 20$ | 5$ / 25$ | 2$ / 10$ |
Mon calcul pour une tâche illustrative, 1M de tokens en entrée et 200K en sortie sans cache : Fable 5.1 coûte 20$, Fable 5.2 coûte 16$, Opus 5.5 coûte 8$. Sur le papier, Fable 5.2 est donc 20% moins cher que 5.1, et Opus 5.5 coûte la moitié de Fable 5.2.
Le piège, ce sont les tokens par tâche. Le propre graphique d'Anthropic montre que Fable 5.2 fait plus avec chaque token à effort plus faible, mais un lecteur de Hacker News a fouillé les chiffres tiers d'Artificial Analysis et a trouvé l'inverse à l'effort maximal :
"Forget about the scores... look at the Cost Per Task. Fable 5.1 was already the most expensive by a good margin, and now Fable 5.2 doubles it! This is with the price cut. The output tokens per task just exploded. From 118k tokens (46k Answer/71k Reasoning) in 5.1 to 274k tokens (81k Answer/192k Reasoning) in 5.2."

Un autre commentateur a répondu avec le contre-argument équitable, qui correspond à la façon dont Anthropic présente le modèle :
"The Artificial Analysis charts are great, but be warned that they show max effort by default. [...] Fable 5.2 on medium looks quite attractive compared to Opus 5.5 high/xhigh. Fable 5.2 on max (the default) looks like a good way to light your money on fire."
Ma lecture : Fable 5.2 est un modèle qu'il faut piloter avec le réglage d'effort, pas laisser au maximum. Le billet de lancement indique que Medium est la valeur par défaut dans les applications Claude et Claude Code, donc la facture que vous y voyez n'est pas la facture à effort maximal d'un graphique.
Que disent les benchmarks, et jusqu'où puis-je leur faire confiance ?
Anthropic a publié un long tableau. Voici les lignes qui comptent pour la plupart des acheteurs, toutes tirées du billet de lancement, à l'effort le plus élevé disponible pour chaque modèle, garde-fous activés :
| Benchmark | Fable 5.2 | Fable 5.1 | Opus 5.5 | GPT-6 Astra |
|---|---|---|---|---|
| FrontierCode 2.0 (codage agentique) | 49,1% (Xhigh) | 32,4% | 45,5% | 42,8% |
| FrontierSWE v2 (codage agentique) | 69,9% | 56,3% | 62,3% | 65,5% |
| AutomationBench (processus métier) | 51,4% | 31,4% | 42,5% | 41,4% |
| Terminal-Bench-Science 0.1 | 74,6% | 52,6% | 58,7% | 68,1% |
| Remote Labor Index | 41,3% | 17,9% | 21,3% | 20,8% |
| Humanity's Last Exam (avec outils) | 74,2% | 65,6% | 67,7% | 57,2% |
| OSWorld 2.1 (utilisation d'ordinateur, partiel) | 89,3% | 83,5% | 87,2% | 79,5% |
Les plus gros bonds par rapport à Fable 5.1 concernent la robotique (RoboDojo Sim, de 27,6% à 64,9%) et le Remote Labor Index, un test de travail freelance rémunéré. AutomationBench est la ligne à surveiller si vous automatisez des processus métier : de 31,4% à 51,4%. Une ligne va à l'encontre de Fable : Gemini 4 Carbon le dépasse de peu sur AutomationBench avec 53,9%.
Le graphique le plus utile est celui qui associe score et coût. À effort élevé, Fable 5.2 obtient un score à peu près équivalent à celui d'Opus 5.5 à son meilleur, pour environ moitié moins cher par tâche, et à Xhigh il atteint le meilleur score qu'Anthropic ait testé.
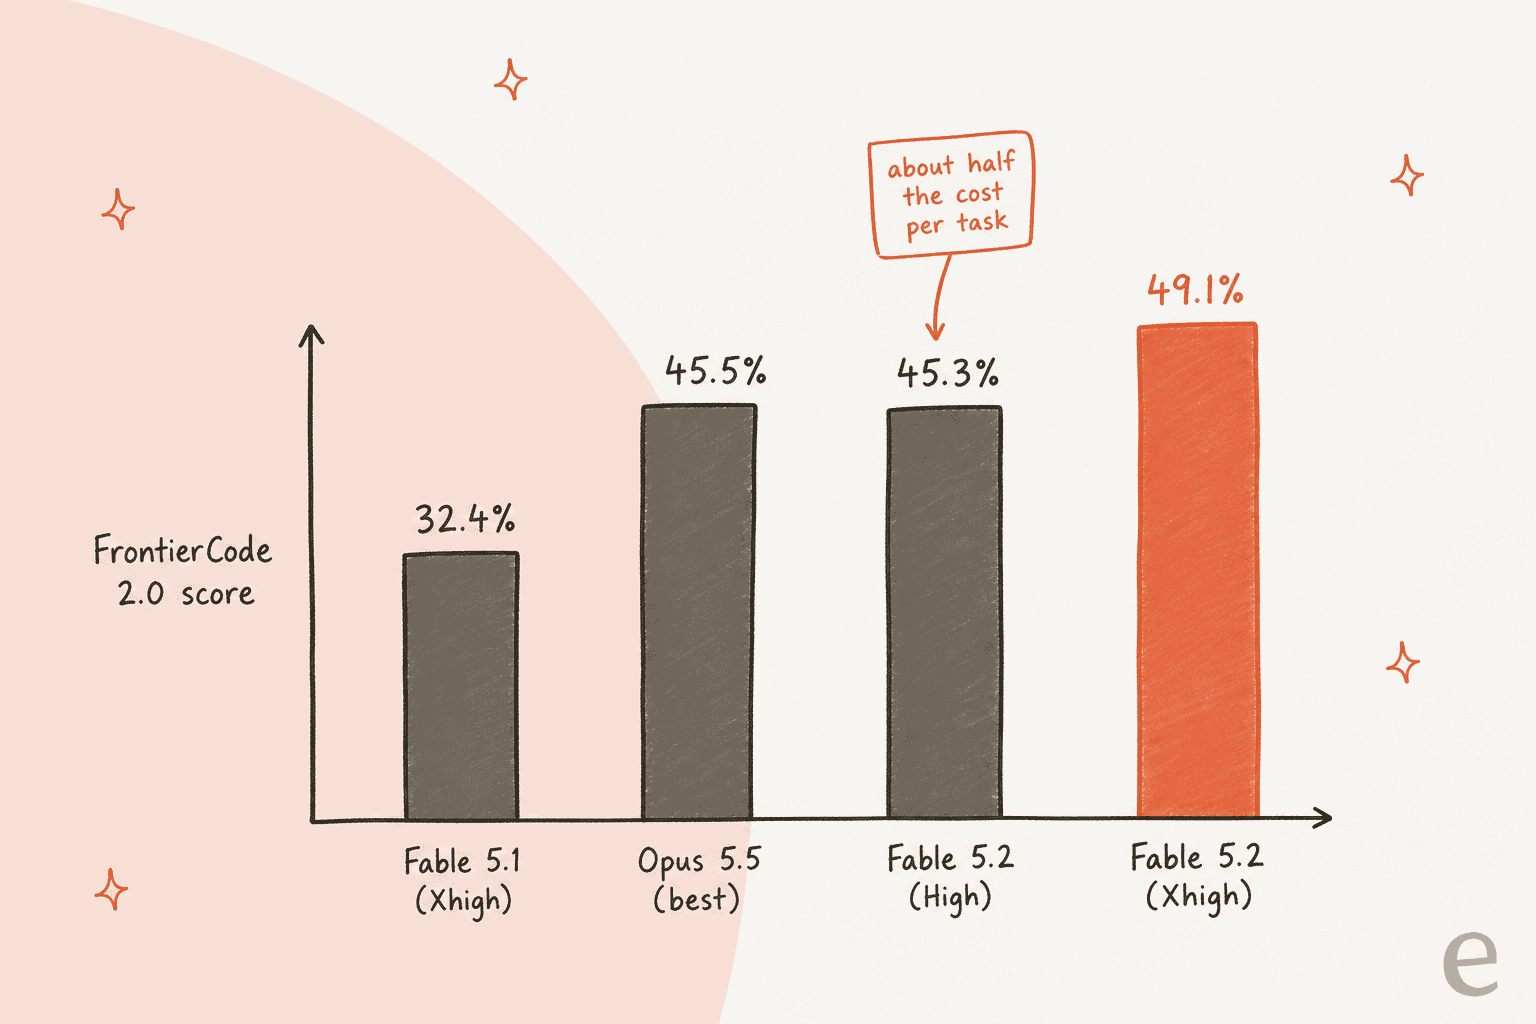
Remarquez ce que cela signifie. Fable 5.2 ne surpasse pas Opus 5.5 de loin sur ce test de codage, à moins de payer pour Xhigh. Le résumé honnête est qu'il relève le plafond et rend le chemin vers le niveau d'Opus moins cher, plutôt que de rendre le travail quotidien radicalement meilleur. Considérez tout cela comme des chiffres produits par le fournisseur lui-même : Anthropic les a obtenus avec les garde-fous activés, et un commentateur sceptique a noté que les scores concurrents de Gemini utilisent un harnais de test différent. C'est pourquoi j'accorde plus de poids aux retours clients ci-dessous qu'au tableau.
Que disent les personnes qui l'utilisent ?
Le fil de lancement sur Hacker News a dépassé 750 points et 400 commentaires en une journée. L'avis le plus utile que j'ai lu venait de quelqu'un qui l'avait déjà utilisé :
"Fable is good, but you really have to push the ambition of your prompt in order to see proper separation from Opus 5.5. I personally have a hard time telling the difference between Fable 5.2 and Opus 5.5 for ordinary coding tasks."
Le même commentateur a dit que Fable 5.2 était « way faster and more reliable » que 5.1, qui souffrait auparavant de dépassements du nombre maximal de tokens en sortie. Cela correspond à l'affirmation d'Anthropic de sorties jusqu'à 30% plus rapides et à la citation d'un ingénieur de Cognition selon laquelle il « says it doesn't know things instead of hallucinating. »
L'avertissement le plus marquant concerne les sous-agents. Les propres notes de migration d'Anthropic indiquent qu'à effort xhigh et max, Fable 5.2 a été observé utilisant des sous-agents pour revoir son propre travail, ce que Fable 5.1 ne faisait pas, et que les sous-agents peuvent représenter une grande part du coût d'une session. Un utilisateur en a fait l'expérience :
"Asked it to review a 80 kLoC codebase, something Opus does just fine, while asking it "max 4 subagents". Fable 5.2, like the well-aligned model it supposedly is, decided to spawn 6+ nested subagents, because these aren't subagents, apparently - resulting in 100% of 5hr usage being drained in less than 20min (on $100)."
Si vous travaillez avec les sous-agents de Claude Code ou des configurations multi-agents, fixez des limites explicites et surveillez les premières exécutions. Les propres testeurs nommés par Anthropic se trouvent à l'autre extrémité : Uber a mené un audit de sécurité de 10 à 12 heures qui a dépêché environ 170 agents évaluateurs, et Oracle a indiqué qu'il générait du SQL correct là où deux autres modèles additionnaient des montants 5 à 8 fois trop élevés. Je n'ai trouvé aucun fil X ou Reddit avec des détails de première main exploitables le jour du lancement, donc le signal communautaire ici se limite à Hacker News.
Qu'est-ce qui casse si je migre depuis Fable 5.1 ?
Anthropic qualifie le passage de « majoritairement direct » et liste quatre changements cassants :
- La vérification de préfixe des blocs de réflexion s'applique désormais à tous les comptes. Si votre code modifie le system prompt, les outils ou les messages précédents puis renvoie d'anciens blocs de réflexion, vous obtenez une erreur 400. Sur Fable 5.1, cela ne concernait que les comptes créés à partir du 31 août 2026, les comptes plus anciens ne l'ont donc peut-être jamais vu.
- Fable 5.1 ne peut pas lire les blocs de réflexion de Fable 5.2. Fable 5.2 lit ceux de 5.1, mais pas l'inverse, donc un repli de 5.2 vers 5.1 en cours de conversation fait perdre ce raisonnement et peut augmenter le coût.
- L'ancien outil d'utilisation d'ordinateur,
computer_20251124, renvoie une erreur 400 partout sauf sur Amazon Bedrock. Passez àcomputer_toolset_20260801. - Un exécuteur Fable 5.2 a besoin d'un conseiller Fable 5.2 ou Mythos 5.2 dans l'outil de conseiller. Un conseiller 5.1 renvoie une erreur 400.
Ce qui n'a pas changé depuis 5.1 et qu'il vaut la peine de retenir : le thinking adaptatif est toujours actif, le prefill et l'utilisation forcée d'outils (tool_choice à any ou tool) renvoient une erreur 400, et vous devriez omettre temperature, top_p et top_k. Fable 5.2 a aussi sa propre limite de débit, distincte du pool partagé par Fable 5 et 5.1, vérifiez-la donc avant de basculer du trafic de production. Autre changement de comportement : des lignes de prompt comme « answer directly without thinking » n'empêchent plus le modèle de réfléchir à effort moyen et au-delà, baissez plutôt le réglage d'effort. Si votre max_tokens est petit, le thinking peut tout consommer avant qu'aucun texte n'apparaisse.
Quel modèle devrais-je vraiment utiliser ?
Le conseil d'Anthropic lui-même est de commencer par Opus 5.5, puis de monter vers Fable ou Mythos, ou de descendre vers Sonnet 5.5 ou Haiku 5.5, selon l'ampleur et la complexité du travail. Je suis d'accord, et un commentateur de HN a résumé pourquoi le choix par défaut a changé :
"Anthropic is finally well balanced across models. Meaning: Opus 5.5 is so good that I do not feel Fable FOMO as I did when it was Fable 5/5.1 vs Opus 4.8/5."
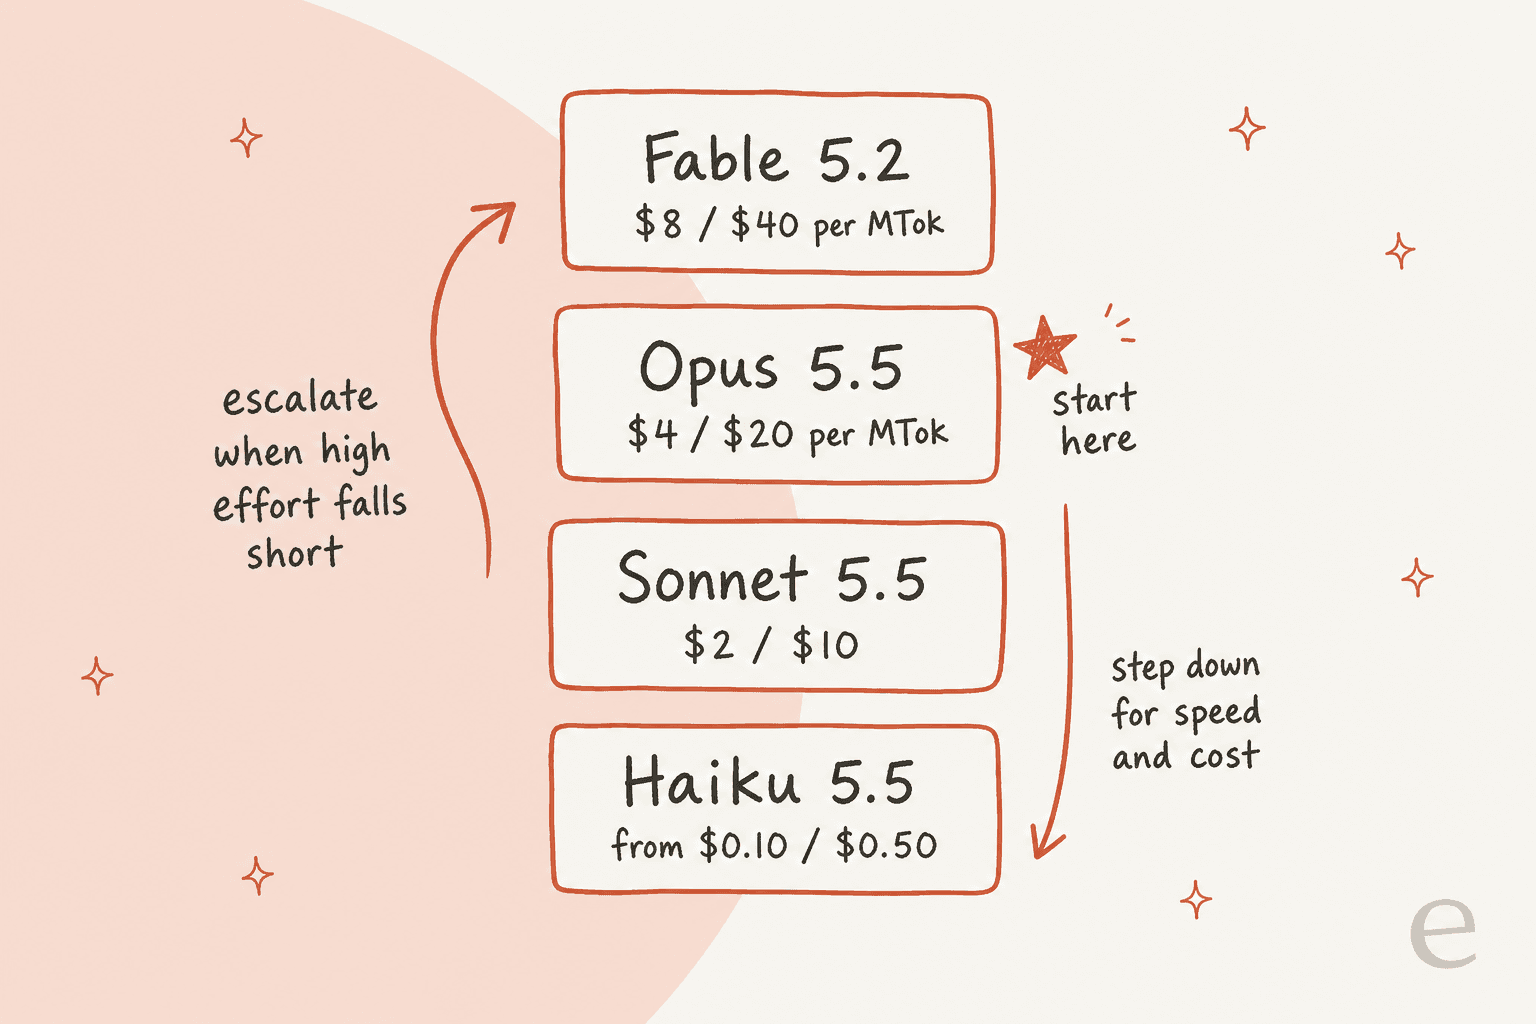
Voici comment je répartirais les cas :
- Vous utilisez Fable 5.1 aujourd'hui. Changez, après avoir fait tourner le test de vérification de préfixe sur votre propre générateur de requêtes. Vous obtenez une facture plus basse par token, des sorties plus rapides et de meilleurs scores pour le changement d'un seul ID de modèle.
- Vous utilisez Opus 5.5 et ça fonctionne. Restez-y. L'écart de prix est du double par token, et Opus 5.5 a été bien noté à titre indépendant. Consultez le guide des tarifs d'Opus 5.5 pour voir comment le réglage d'effort fait varier la facture.
- Vos évaluations d'Opus 5.5 à effort élevé sont encore insuffisantes. C'est exactement le cas pour lequel Fable 5.2 a été conçu : exécutions d'agents de plusieurs heures, recherche approfondie, travail mené jusqu'à un document, une feuille de calcul ou une présentation finis.
- Vous utilisez Claude Code sur abonnement. Essayez Fable 5.2 à effort moyen et surveillez votre consommation. Mes notes sur la sélection de modèle dans Claude Code couvrent les compromis.
- Vous choisissez entre fournisseurs. Comparez avec GPT-6 Sol et GPT-6 Astra sur vos propres tâches, et lisez la comparaison précédente Opus 5 contre Fable 5 pour voir comment la famille a évolué.
- Vous voulez un agent de support ou un rédacteur de contenu. Vous achetez au mauvais niveau, c'est l'objet de la section suivante.
Je devrais dire clairement ce qu'est cet avis : j'ai lu le billet de lancement d'Anthropic, la page du modèle, la documentation sur les tarifs et la migration, ainsi que la discussion publique sur Hacker News. Je n'ai pas fait tourner ma propre charge de production dessus, donc là où je donne une recommandation, elle provient de ces sources, pas d'un benchmark personnel.
Un modèle équivaut-il à un coéquipier ?
Non, et c'est l'angle que la plupart des articles sur Fable 5.2 évitent. Le modèle est une infrastructure. eesel est l'employé. Un modèle de pointe n'a aucune idée de ce que fait votre produit, ne peut pas voir votre centre d'aide ni vos 10 000 derniers tickets, et n'a aucune intégration dans votre helpdesk. Vous n'embauchez pas un modèle, vous embauchez un coéquipier prêt à travailler pour une tâche précise.
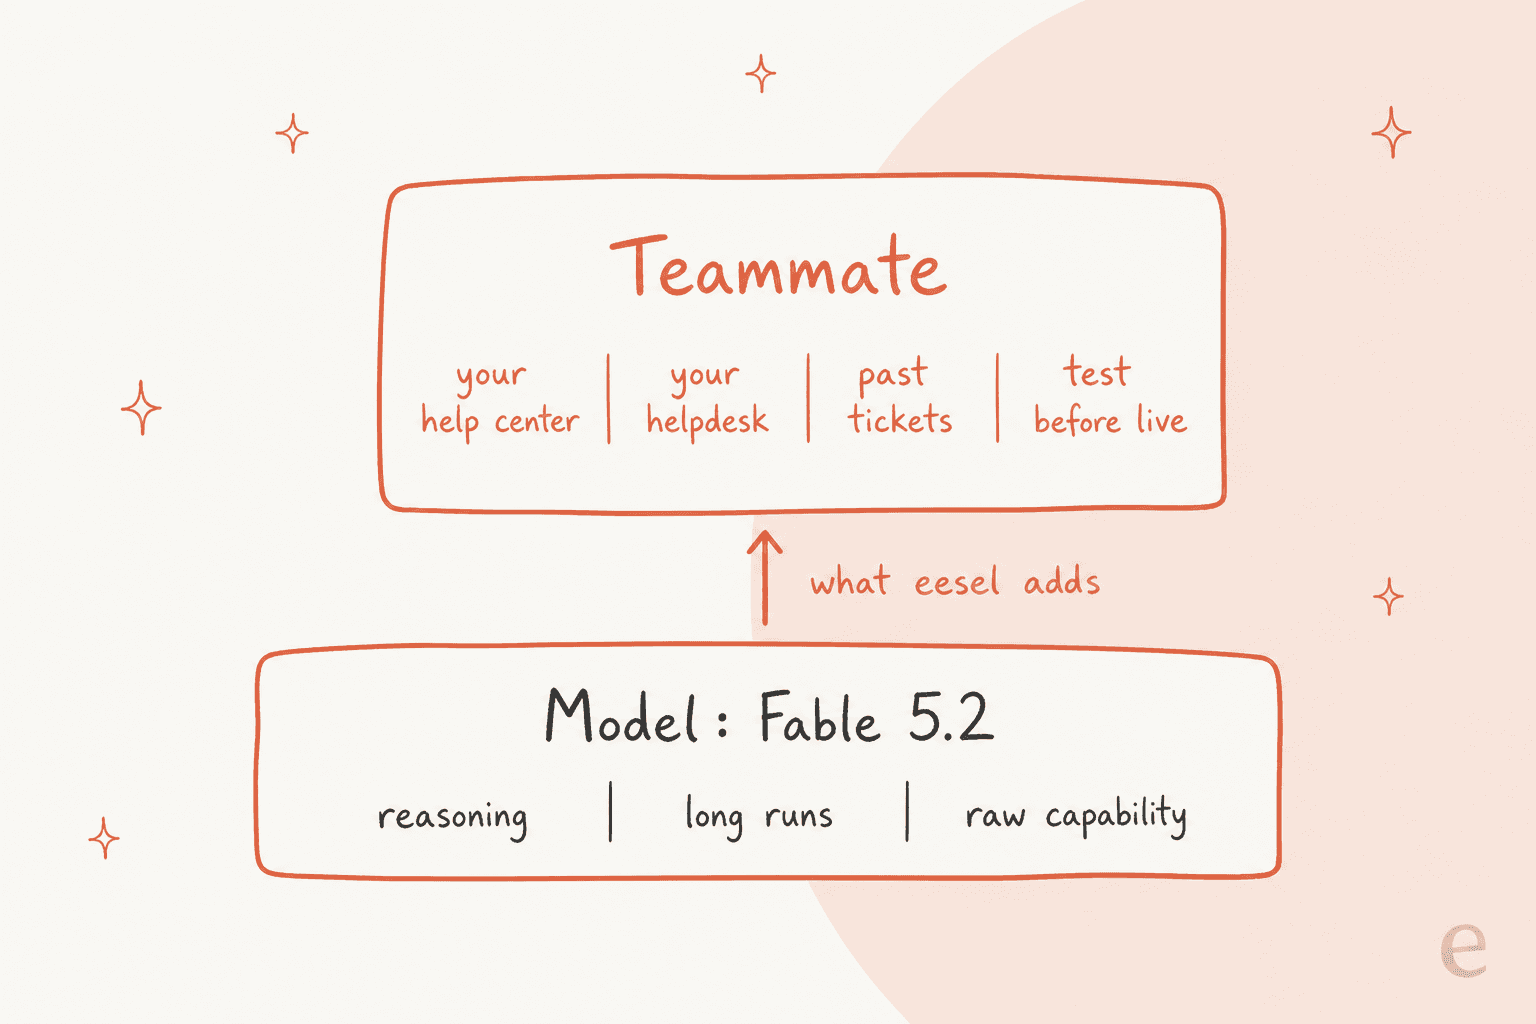
Le portefeuille actuel d'eesel comprend un coéquipier IA pour helpdesk qui s'intègre dans votre file de support existante, et un rédacteur de blog IA pour le contenu. Chacun arrive avec les compétences, intégrations et connaissance de l'entreprise que son poste exige. Les lecteurs qui suivent l'idée plus large des coéquipiers IA reconnaîtront la séparation : le modèle change chaque trimestre, la description du poste non.
La preuve est dans la façon dont les vraies équipes l'utilisent. SE Ranking fait tourner trois produits sur Zendesk avec un agent eesel par produit, et en un mois (du 8 août au 8 septembre 2026) ses agents ont traité 4 650 conversations : 2 554 tickets Zendesk et 2 102 chats en direct, en répondant à partir d'environ 16 800 pages de connaissance. SamCart utilise des agents distincts pour les tickets Freshdesk et le chat du site, chacun avec son propre ton. Rien de tout cela ne dépendait du choix de Fable plutôt que d'Opus. Cela dépendait du fait que l'agent cherche d'abord dans le centre d'aide, transfère les remboursements et les cas difficiles à une personne, et soit mesurable dans le helpdesk. C'est aussi ce qui garde le taux de résolution par l'IA honnête et évite les hallucinations de l'IA en support.
La CLI eesel est l'endroit où un modèle de pointe comme Fable 5.2 devient utile pour ce coéquipier. Un agent de codage comme Claude Code peut piloter le même espace de travail depuis un terminal : téléverser des articles d'aide et des macros exportés, ajuster les instructions de l'agent, et poser des questions de test pour vérifier les réponses avant qu'elles n'atteignent un client. La connexion au helpdesk elle-même nécessite toujours l'approbation de quelqu'un disposant d'un accès administrateur, et les connaissances téléversées ne sont « prêtes » que lorsque les réponses de test semblent correctes. Pour une vue plus large, consultez Claude pour le support client, les meilleurs agents de support client IA, et la perspective de coût dans coût du service client IA.
Essayer eesel
Si la vraie question derrière votre recherche sur Fable 5.2 est « quel modèle devrait faire tourner mon support », la meilleure question est quel coéquipier embaucher. eesel branche un coéquipier IA pour helpdesk sur votre file Zendesk, Freshdesk ou Gorgias, apprend de votre centre d'aide et de vos tickets passés, et vous permet de le simuler sur des tickets historiques avant qu'il ne réponde à un vrai client. Les développeurs qui veulent le piloter depuis du code peuvent utiliser la CLI eesel, et le modèle sous-jacent peut changer sans que vous n'ayez rien à reconstruire. Vous pouvez essayer eesel gratuitement.
Questions fréquentes
Claude Fable 5.2 en vaut-il la peine ?
Combien coûte Claude Fable 5.2 ?
Quel est l'ID du modèle Claude Fable 5.2 ?
claude-fable-5-2 sur l'API Claude, Microsoft Foundry et Google Cloud, et anthropic.claude-fable-5-2 sur Amazon Bedrock. Claude Mythos 5.2 est le même modèle avec des garde-fous plus légers, sous l'ID claude-mythos-5-2.