Las 6 mejores alternativas a GLM-5.3-Flash en 2026

Rama Adi

Katelin Teen
Última edición August 29, 2026
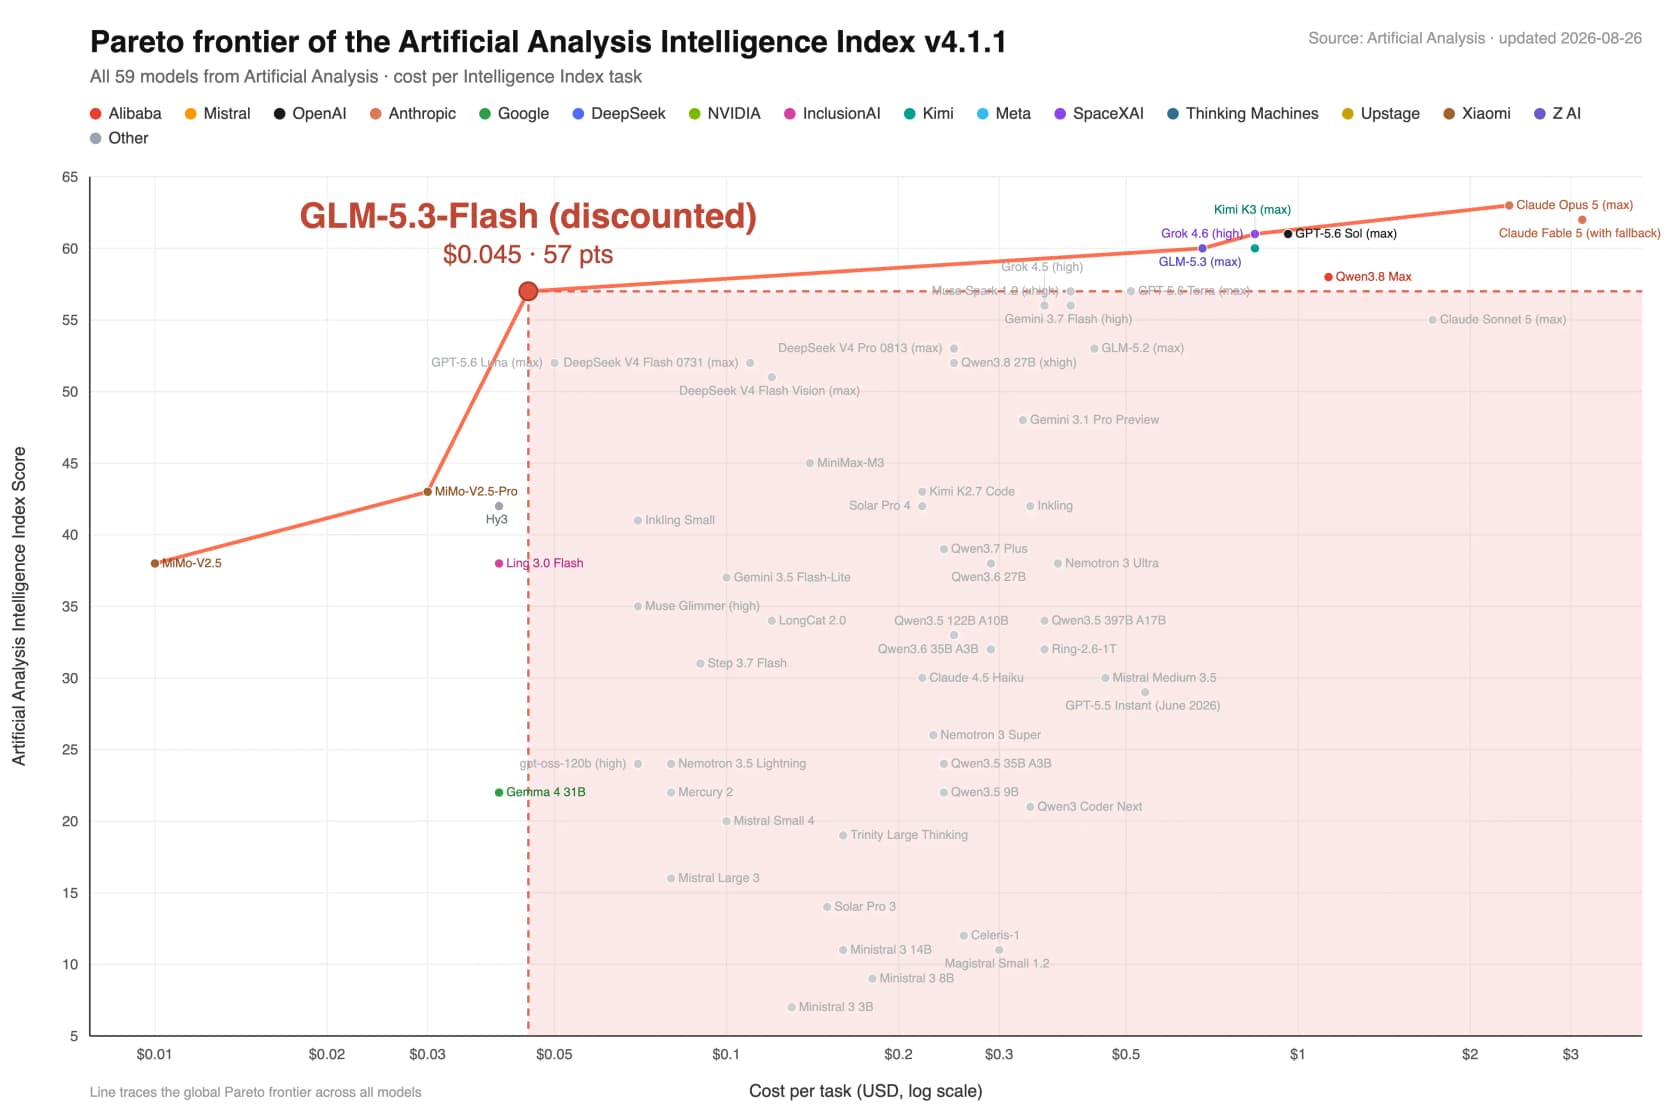
GLM-5.3-Flash es el modelo barato, multimodal de forma nativa y de pesos abiertos de Z.ai, y es una opción por defecto realmente sólida: unos $0.075/$0.25 por 1M de tokens en su promoción de lanzamiento, una ventana de contexto de 1M de tokens y un Intelligence Index de Artificial Analysis de 57 a unos $0.045 por tarea. La mayoría de los equipos que miran más allá buscan una de tres cosas: respuestas más rápidas, pesos totalmente abiertos que puedan autoalojar o un ecosistema de proveedor más grande.
Este es el resumen de a quién recurrir:
- Modelo cerrado más rápido: Gemini 3.7 Flash, unos 340 tokens/seg, pero su precio de lista se duplica en enero de 2027.
- Pesos abiertos más baratos: DeepSeek V4 Flash, con licencia MIT y casi gratis de autoalojar, aunque solo admite texto.
- Suelo absoluto de velocidad y precio: Gemini 3.5 Flash-Lite a $0.30/$2.50.
- Ecosistema de una gran marca: GPT-5.6 Luna a $0.20/$1.20, con las herramientas más amplias.
- Más barato en prompts pequeños: Qwen 3.7 Flash, si tus llamadas se mantienen por debajo de 32K tokens.
- Pesos abiertos más visión nativa: Kimi K3, el más cercano a GLM en capacidad, pero con precio de modelo estrella a $3/$15.
Algo que conviene decir desde el principio, tras años operando IA en colas de soporte reales: el modelo es la capa más barata y más fácil de cambiar. Si eliges uno para resolver tickets de clientes de verdad, la calidad del razonamiento importa mucho menos que la recuperación, las barreras de seguridad y las pruebas que construyes a su alrededor. Eso decide si el bot es útil o está seguro de algo equivocado.
¿Por qué mirar más allá de GLM-5.3-Flash?
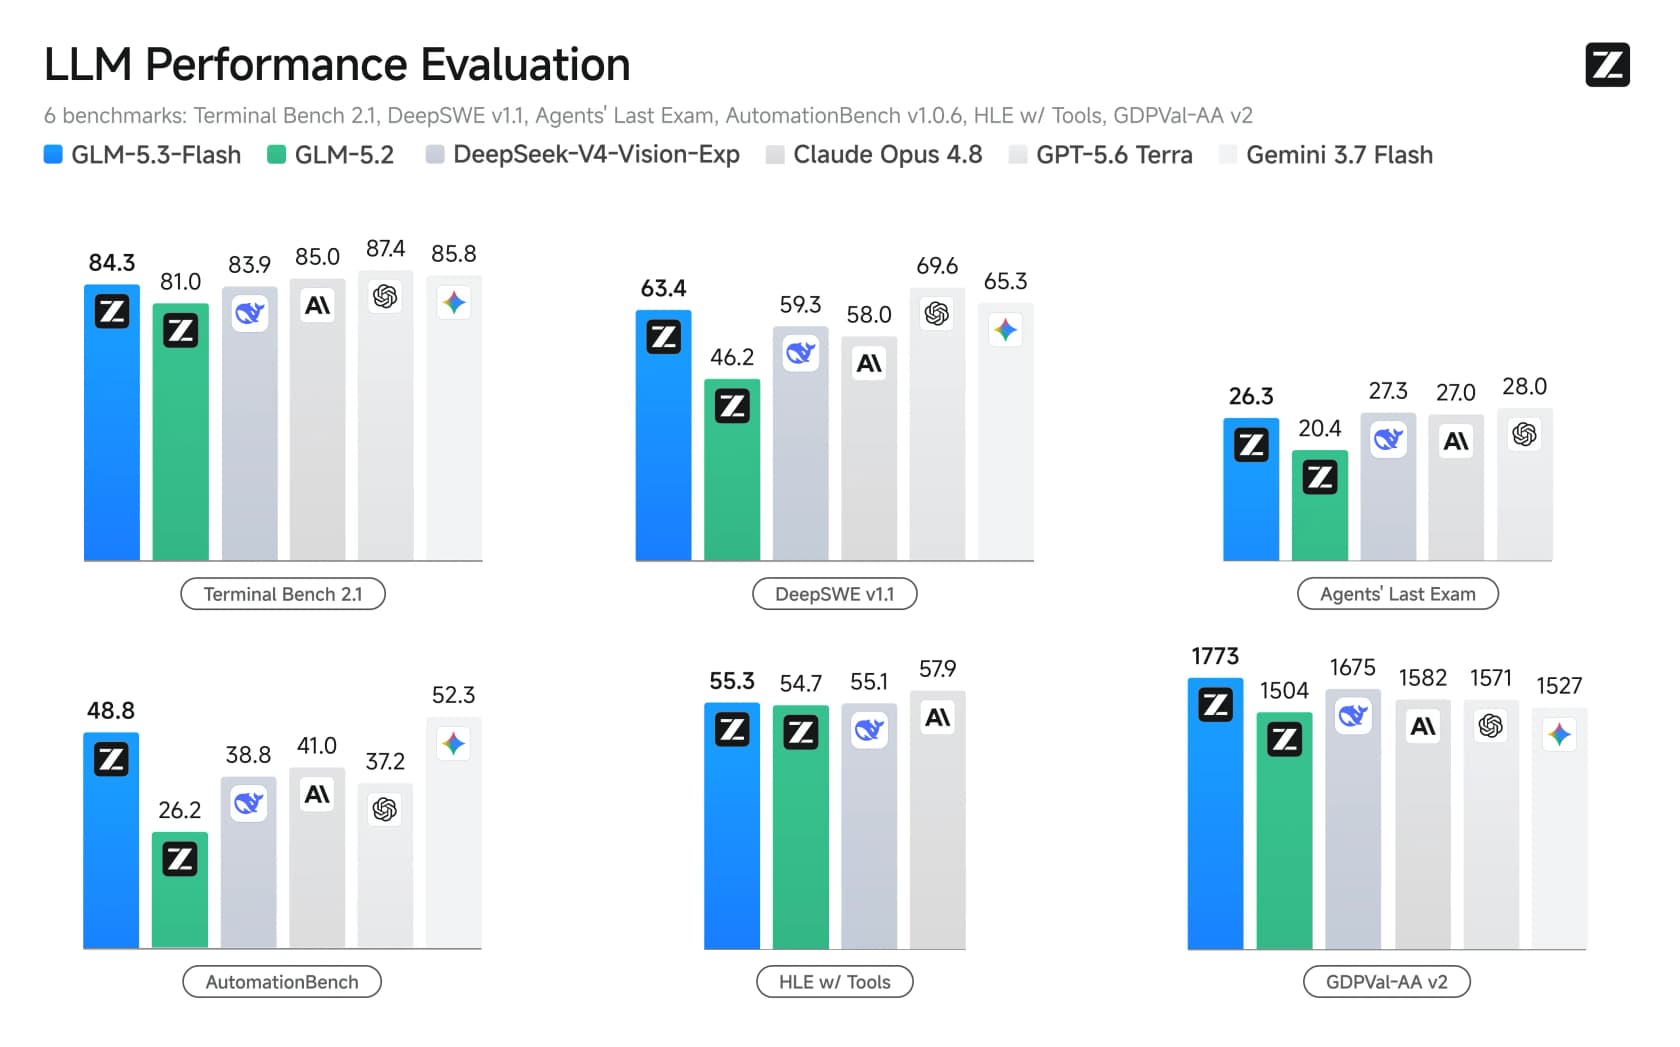
Primero, seamos justos con el favorito, porque se ha ganado el benchmark. GLM-5.3-Flash es un modelo de mezcla de expertos de 320B totales / 18B activos, el primer modelo multimodal nativo de la serie GLM-5, con una ventana de contexto de 1M de tokens y pesos abiertos. El planteamiento de Cloudflare es que supera a GLM-5.2 en todos los benchmarks "at one-tenth the price, while approaching Claude Opus 4.8 on coding and agentic benchmarks." En seis benchmarks de programación y agentes supera con holgura a su predecesor.
La razón por la que movió toda la conversación sobre precio e inteligencia es este gráfico de Pareto. GLM-5.3-Flash se sitúa en la frontera con unos $0.045 por tarea y 57 puntos, un lugar que casi nada más ocupa.
Entonces, ¿por qué la gente sigue comparando? Aparecen una y otra vez algunas razones reales:
- Velocidad en el endpoint del propio proveedor. En la API de Z.ai, GLM-5.3-Flash va lento, unos 49 tokens/seg, y un hilo de r/opencode lo calificó de "one of the slowest models AA has ever" visto. Los hosts de terceros lo arreglan (Databricks mide 272.9 t/s), pero eso implica comprometerte con un revendedor.
- La historia de los datos es pobre. Z.ai no publica un DPA ni una opción de retención cero, y los datos quedan bajo la ley de la RPC. Para cargas reguladas o con datos de clientes, es un bloqueo real salvo que autoalojes.
- El reloj de la promoción. La tarifa de $0.075/$0.25 es un descuento de lanzamiento que termina el 9 de septiembre de 2026; el precio de lista es el doble.
- Equipos solo de texto. Si nunca trabajas con imágenes, algunos especialistas en texto más baratos o rápidos tienen más sentido que pagar por una arquitectura multimodal que no vas a usar.
Nada de esto hace de GLM-5.3-Flash un mal modelo. Solo significa que no es automáticamente el adecuado para cada trabajo. Si quieres un análisis a fondo del modelo en sí, lo cubrimos en la reseña de GLM-5.3-Flash.
Cómo elegí estas alternativas
Me limité a modelos que alguien interesado en GLM-5.3-Flash compararía de verdad: de precio bajo a medio, rápidos e idealmente multimodales o de pesos abiertos. Cada uno se puntúa en las dimensiones que deciden un cambio real, no solo en un benchmark de titular:
- Precio y la factura real. Precio de lista por 1M de tokens, más los recargos que lo inflan.
- Velocidad (tokens/seg y tiempo hasta el primer token).
- Visión / soporte multimodal, ya que es la seña de identidad de GLM-5.3-Flash.
- Pesos abiertos vs. cerrados, para quien necesite autoalojar.
- Ventana de contexto y salida máxima.
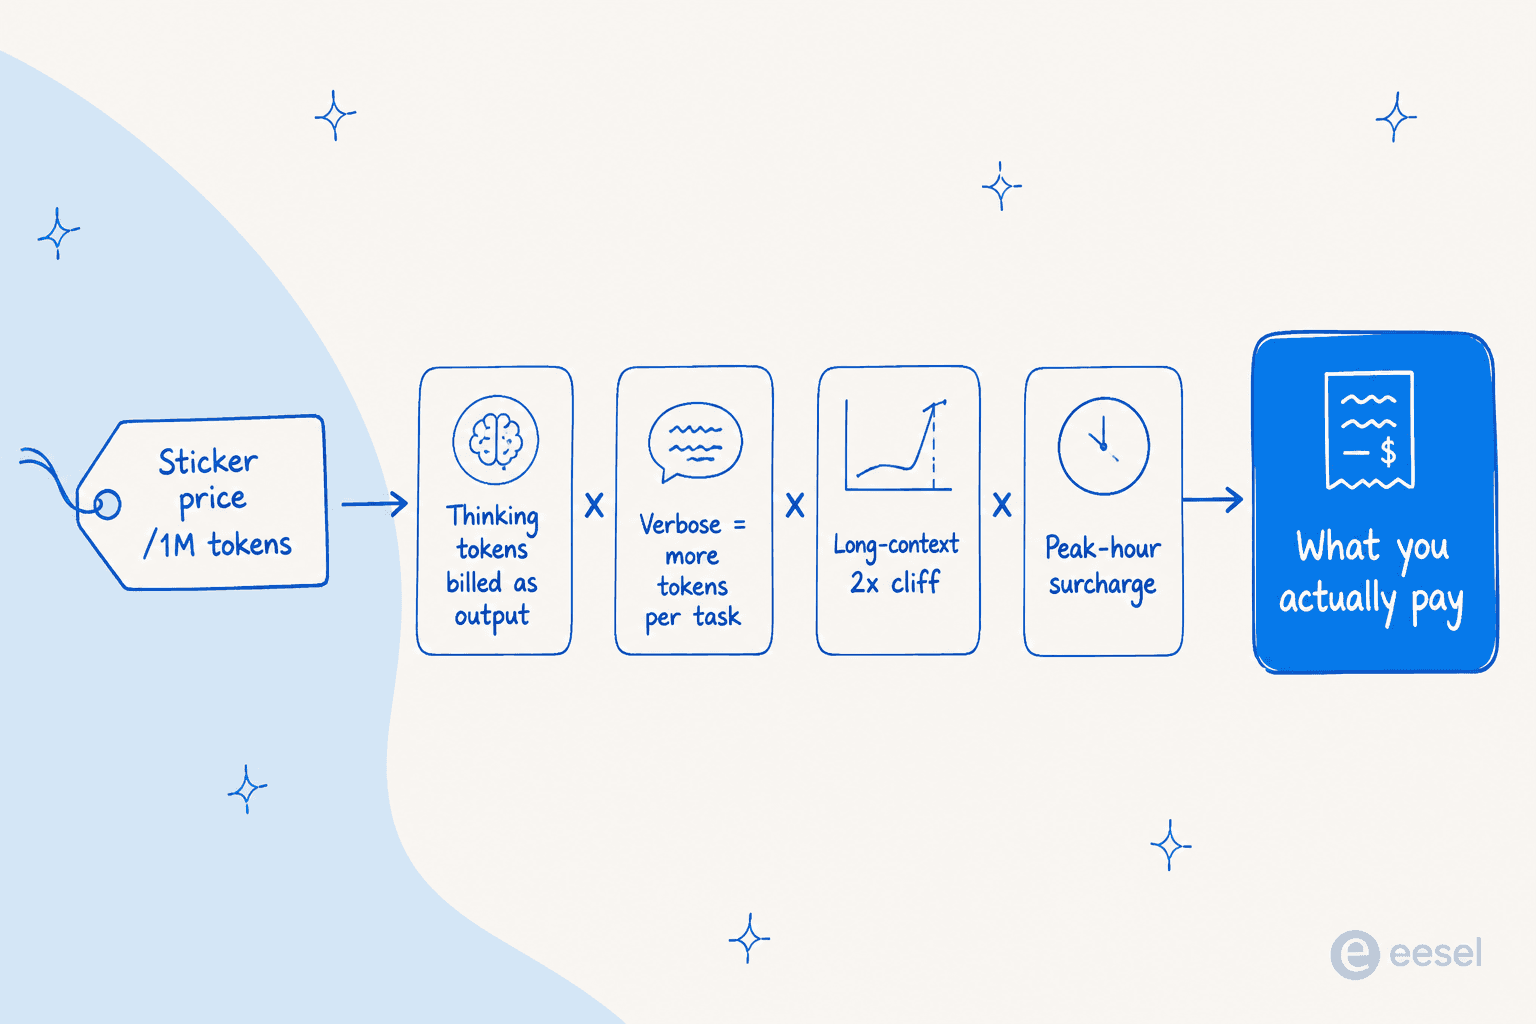
Un tema recorre todo esto: el precio de lista no es la factura. Los tokens de razonamiento se facturan a la tarifa de salida, los modelos verbosos gastan más tokens por tarea, algunos proveedores cobran un recargo por contexto largo, y DeepSeek incluso tiene un multiplicador en horas punta. Ten esto presente en cada fila de la tabla de abajo.
Así se sitúa cada opción en los dos ejes que más le importan a la mayoría: precio y si los pesos son abiertos.
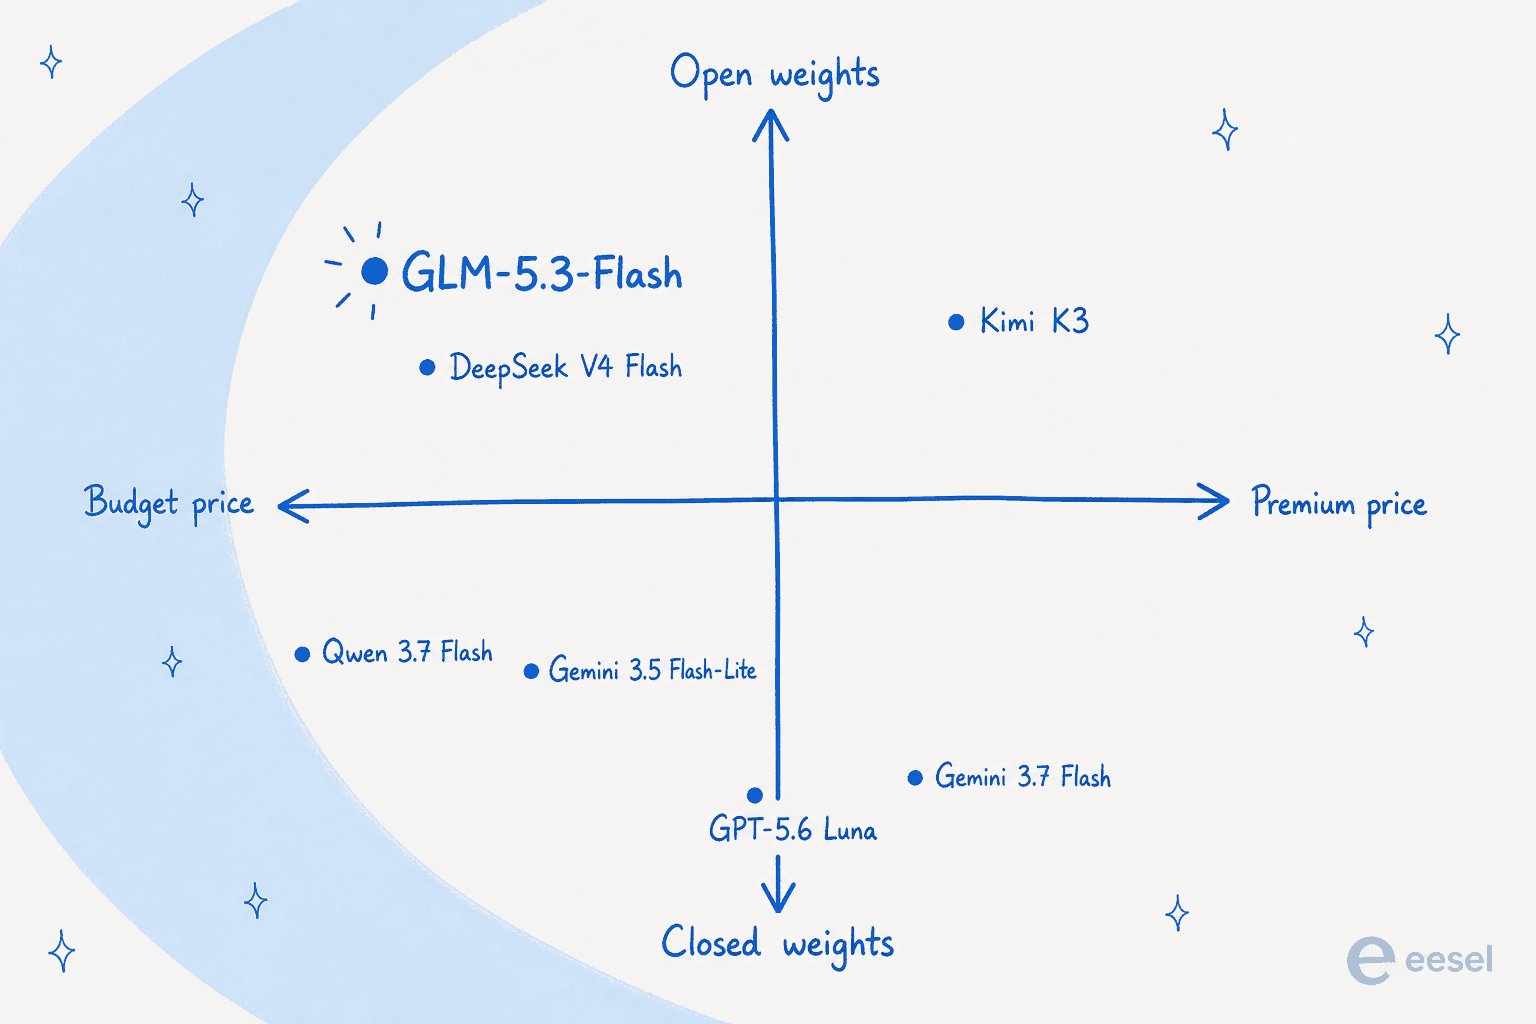
Alternativas a GLM-5.3-Flash de un vistazo
| Modelo | Ideal para | Entrada / Salida (por 1M) | Contexto | Pesos | Visión | Nota |
|---|---|---|---|---|---|---|
| GLM-5.3-Flash (el de referencia) | Multimodal abierto y barato | $0.075 / $0.25 (promo) | 1M | Abiertos | Sí | Índice AA 57; la promo termina el 9 sep |
| DeepSeek V4 Flash | Pesos abiertos más baratos | $0.22 / $0.66 (fuera de punta) | 1M | Abiertos (MIT) | No (texto) | Tarifas 2x en horas punta; verboso |
| Gemini 3.7 Flash | Modelo cerrado más rápido | $0.75 / $3.75 (promo) | ~1M | Cerrados | Sí | ~340 t/s; se duplica en ene 2027 |
| Gemini 3.5 Flash-Lite | Suelo de velocidad / precio | $0.30 / $2.50 | ~1M | Cerrados | Sí | Nivel Gemini más rápido y barato |
| GPT-5.6 Luna | Ecosistema de una gran marca | $0.20 / $1.20 | 1.05M | Cerrados | Sí (entrada de imagen) | 2x en entrada sobre 272K tokens |
| Qwen 3.7 Flash | Más barato en prompts pequeños | $0.03-$0.20 / $0.13-$0.80 | 1M | Cerrados | Sí | Precio por tramos según tamaño del prompt |
| Kimi K3 | Pesos abiertos + visión nativa | $3.00 / $15.00 | 1M | Abiertos | Sí (nativa) | Nivel estrella, no económico |
Ahora el detalle de cada uno, en el orden en que los consideraría.
1. DeepSeek V4 Flash
Ideal para: equipos que quieren pesos abiertos que de verdad puedan autoalojar y la factura más baja posible en cargas de texto.
Si GLM-5.3-Flash tiene un verdadero rival en el eje "barato y abierto", es DeepSeek V4 Flash. Es un MoE de 284B totales / 13B activos publicado bajo una auténtica licencia MIT, con 1M de tokens de contexto y pesos abiertos que funcionan en SGLang o vLLM. Incluso la reacción de la comunidad a GLM toma a DeepSeek como referencia, con una nota en r/opencode según la cual el "visible context grows half as fast as Deepseek Flash" de GLM.
Puntos fuertes. La licencia MIT es el verdadero atractivo: puedes alojar tú mismo los aproximadamente 167GB de pesos, lo que acerca tu coste marginal al precio de tus propias GPUs y mantiene los datos de clientes en tu infraestructura. Ese último punto es justo donde duele la pobre historia de datos de GLM. A máximo esfuerzo es un razonador capaz (Artificial Analysis le da 50), y también es realmente barato en la API alojada.
A tener en cuenta. Dos cosas. Primero, solo admite texto, sin entrada de imágenes documentada, así que no es un reemplazo equivalente si usas la visión de GLM. Segundo, el precio alojado tiene un recargo en horas punta: la entrada con fallo de caché cuesta $0.22/M fuera de punta pero $0.44/M en horas punta (01:00-04:00 y 06:00-10:00 UTC), con salida de $0.66 que sube a $1.32. Una cola de soporte de EE. UU. o la UE factura sobre todo fuera de punta, una rareza a tu favor, pero frágil. También es verboso, y gasta más tokens de salida por tarea que la mediana de su clase.
Precios. Fuera de punta $0.22 entrada / $0.66 salida por 1M; en punta, exactamente el doble. Los aciertos de caché son casi gratis a $0.007/M fuera de punta. Todas las cifras en nuestro artículo de precios de DeepSeek V4 Flash. También hay un experimento de texto más visión, DeepSeek V4 Flash Vision, si quieres cerrar la brecha multimodal.
Veredicto. La elección cuando los pesos abiertos y el autoalojamiento importan más que la visión. Si nunca envías imágenes y puedes ejecutar tu propia inferencia, supera a GLM en control de datos y coste marginal, y nuestra reseña de DeepSeek V4 Flash analiza la trampa de la configuración barata. Si necesitas visión o no quieres operar GPUs, sigue leyendo.
2. Gemini 3.7 Flash
Ideal para: equipos que quieren el modelo cerrado más rápido y una plataforma madura y bien documentada, y no les importa un precio de gran proveedor.
Gemini 3.7 Flash llegó a disponibilidad general el 13 de agosto de 2026 como el "most intelligent workhorse model yet for coding and agents" de Google. Es la elección natural si la velocidad del propio GLM es lo que te frena.
Puntos fuertes. La velocidad es el titular: Artificial Analysis la mide en 340.1 tokens/seg, puesto #1 de 188 modelos. Es multimodal, tiene aproximadamente 1M de tokens de contexto y viene con las herramientas, el grounding y la documentación de Google. Por nivel de esfuerzo, low obtiene 50.9 en el Intelligence Index a $0.16/tarea y un tiempo hasta el primer token inferior a un segundo, a un punto del antiguo 3.6 Flash a esfuerzo completo. Si bajas el esfuerzo, es rápido y barato a la vez.
A tener en cuenta. El precio es de introducción. Es $0.75/$3.75 por 1M hasta el 31 de diciembre de 2026, y luego $1.50/$7.50 desde el 1 de enero de 2027 según la página de precios de Google, una duplicación exacta. La API también cambió mucho: temperature, top_p y thinking_budget han desaparecido, y se eliminó el nivel de razonamiento minimal, el más barato, así que el suelo para trabajos baratos de OCR/clasificación es más alto que en 3.6 Flash. Y su tasa de alucinación empeoró hasta el 64.5% desde el 55.6% de 3.6 Flash, algo que importa mucho si lo apuntas a clientes sin protección.
Precios. $0.75 entrada / $3.75 salida por 1M hasta finales de 2026, luego el doble. Batch y Flex tienen un 50% de descuento.
Veredicto. La mejor velocidad bruta de aquí, en una plataforma seria. Elígelo si la latencia y la madurez del proveedor pesan más que el precio, y presupuesta ya el aumento de enero de 2027 en lugar de que te sorprenda.
3. Gemini 3.5 Flash-Lite
Ideal para: trabajos de alto rendimiento y alto volumen donde quieres el modelo de Google más barato y rápido y puedes aceptar un techo más bajo.
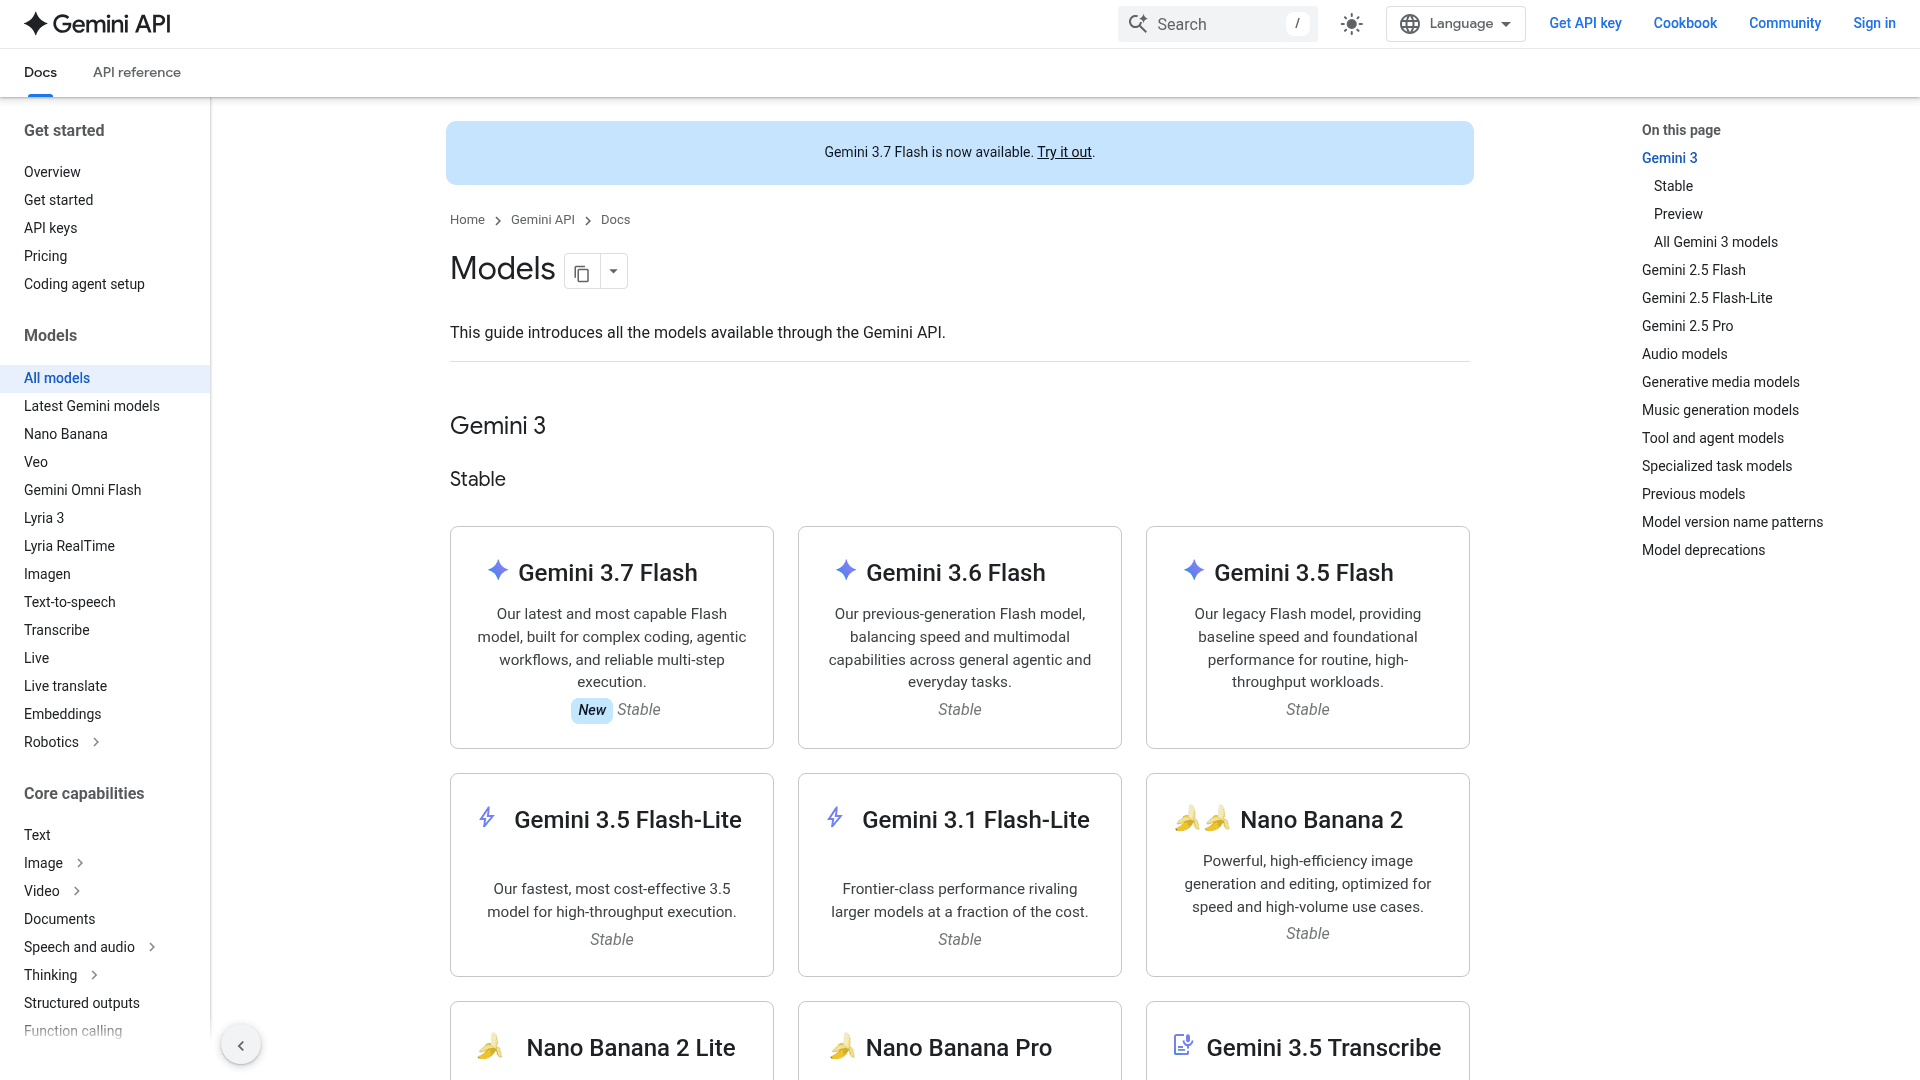
Si Gemini 3.7 Flash es el caballo de batalla, Flash-Lite es el velocista. Google lo describe como "our fastest, most cost-effective 3.5 model for high-throughput execution," y ese es justo el hueco que GLM-5.3-Flash tiene dificultades para llenar por sí solo con su lento endpoint propio.
Puntos fuertes. Es el suelo de precio y velocidad de las opciones cerradas a $0.30/$2.50 por 1M, funciona a unos 350+ tokens/seg y aun así conserva entrada multimodal, uso de ordenador y un contexto amplio. Para clasificación, enrutado, etiquetado y otro trabajo "barato y rápido" de alto volumen, es difícil de superar sin pasar a código abierto.
A tener en cuenta. Cambias inteligencia por rendimiento. En el gráfico de Pareto queda bastante por debajo de GLM-5.3-Flash en el Intelligence Index, así que no es el modelo para razonamiento difícil ni tareas agénticas matizadas de varios pasos. Es un especialista, no un sustituto de un modelo estrella.
Precios. $0.30 entrada / $2.50 salida por 1M, con batch a la mitad.
Veredicto. La opción correcta para pipelines de alto volumen y baja complejidad donde dominan la velocidad y el coste. Para cualquier cosa que necesite razonamiento al nivel de GLM, vuelve a un modelo Flash completo.
4. GPT-5.6 Luna
Ideal para: equipos que ya viven en el ecosistema de OpenAI y quieren un nivel barato sin salir de él.
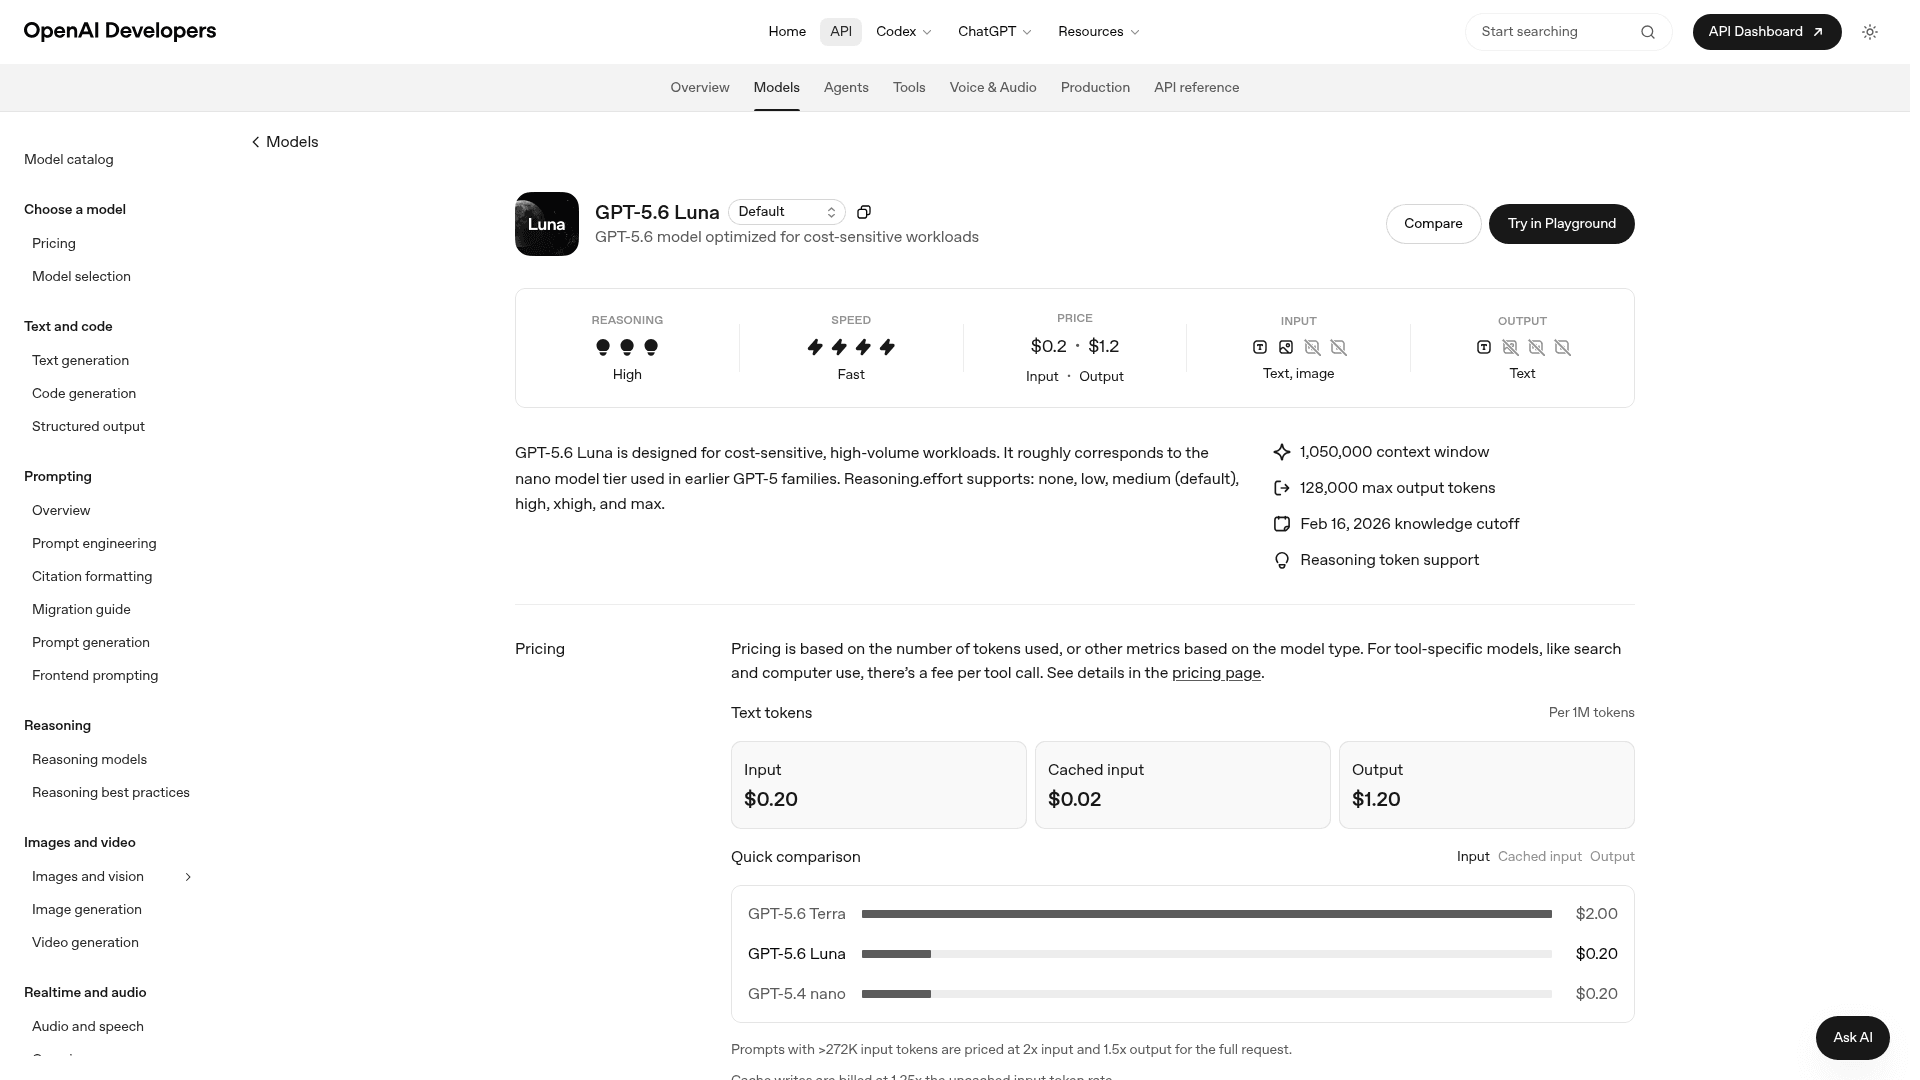
GPT-5.6 Luna es el nivel de OpenAI sensible al coste, "designed for cost-sensitive, high-volume workloads," más o menos el hueco de nano en familias GPT-5 anteriores. Es la alternativa para quienes valoran el ecosistema, las herramientas y el soporte del mayor proveedor por encima de exprimir el último céntimo.
Puntos fuertes. A $0.20/$1.20 por 1M es barato para un modelo de marca de frontera, con un contexto de 1,050,000 tokens, entrada de imágenes y todo el rango de reasoning.effort de none a max. Si tu equipo ya usa el SDK de OpenAI, Agents y sus herramientas, quedarte dentro elimina mucha fricción de integración. Parece la opción segura y aburrida, y a veces es la correcta.
A tener en cuenta. Hay un salto por contexto largo: los prompts de más de 272K tokens de entrada se facturan a 2x en entrada y 1.5x en salida durante toda la solicitud. Así que el "contexto de 1M" y los "$0.20" no pueden ser ciertos a la vez en un prompt muy largo. También es cerrado, solo texto e imagen (sin pesos abiertos ni autoalojamiento), y Luna queda por debajo de GLM-5.3-Flash en inteligencia bruta, al ser el nivel económico de la familia y no el caballo de batalla.
Precios. $0.20 entrada / $1.20 salida por 1M, entrada en caché $0.02, con el recargo de 272K indicado arriba. Más contexto de OpenAI en nuestra reseña de GPT-5.6.
Veredicto. Lo mejor cuando la gravedad del ecosistema pesa más que el precio por token. Si ya estás totalmente en OpenAI, Luna es la forma con menos fricción de tener un nivel barato; si buscas puramente coste o quieres pesos abiertos, ganan GLM o DeepSeek.
5. Qwen 3.7 Flash
Ideal para: trabajo de visión o texto de alto volumen con prompts cortos, donde tus llamadas se mantienen pequeñas.
Qwen 3.7 Flash, de Alibaba, es el otro modelo chino económico de la mezcla, y su modelo de precios es realmente distinto al de todos los demás aquí.
Puntos fuertes. En prompts pequeños es la opción más barata de este repaso: $0.03/M de entrada y $0.13/M de salida para llamadas de menos de 32K tokens. Es un modelo de visión con 1M de tokens de contexto, así que sobre el papel cubre el terreno multimodal de GLM con un precio de entrada más bajo.
A tener en cuenta. El precio va por tramos según el tamaño del prompt, y las dos cifras de titular son mutuamente excluyentes. Por encima de 32K tokens salta a $0.10/$0.40, y en el tramo de 256K-1M es $0.20/$0.80, una variación de 6.7x en la entrada. La mezcla móvil de OpenRouter de lo que los clientes pagan de verdad es $0.044/$0.149, por encima de la tarifa de entrada, lo que indica que el tráfico real llega a los tramos altos. Además es de pesos cerrados y está poco evaluado: sin benchmarks ni arquitectura publicados, y la única evaluación independiente (Roboflow) lo sitúa en el puesto #22 de 23 en general pero #1 en coste. "Flash" aquí significa barato, no rápido, a unos 59 tokens/seg.
Precios. Por tramos: $0.03-$0.20 entrada / $0.13-$0.80 salida por 1M según el tamaño del prompt. Desglose completo en nuestro artículo de precios de Qwen 3.7 Flash, y hay un hermano mayor en Qwen3.8-Max si necesitas más margen.
Veredicto. Una verdadera ganga si, y solo si, tus prompts se mantienen pequeños. Modela tu distribución real de tokens antes de cambiar, porque una carga de soporte con contexto largo puede dejarte silenciosamente en el tramo caro. Nuestra reseña de Qwen 3.7 Flash tiene más.
6. Kimi K3
Ideal para: equipos que quieren pesos abiertos y visión nativa como ofrece GLM, y están dispuestos a pagar precios de modelo estrella por un techo más alto.
Kimi K3 es el modelo estrella de Moonshot AI y el que más se parece a GLM-5.3-Flash en la combinación de "pesos abiertos más multimodal nativo". Es un MoE de 2.8T totales / 104B activos con 1M de tokens de contexto y comprensión nativa de imagen y vídeo, y sus pesos se publicaron en Hugging Face según lo previsto.
Puntos fuertes. La capacidad es la historia. Obtiene un Intelligence Index de Artificial Analysis de 57, igualando a GLM-5.3-Flash y quedando #4 en general, y supera a Opus 4.8 y GPT-5.5 en la mayoría de benchmarks. Visión nativa (imagen y vídeo) más pesos abiertos significa que puedes autoalojar y conservar las funciones multimodales, que es justo lo que ofrece GLM, pero con un mayor número de parámetros activos detrás.
A tener en cuenta. El precio. A $3/$15 por 1M está en la banda de Claude Sonnet, aproximadamente 50 veces el precio de salida de GLM-5.3-Flash. El razonamiento no se puede desactivar en ningún nivel, y en esfuerzo low obtiene un Index de 47 a $0.24/tarea, que es peor y unas 8 veces más caro que DeepSeek V4 Flash. Tampoco acepta URLs públicas de imágenes, solo base64 o IDs de archivo. No es un cambio económico.
Precios. $3 entrada / $15 salida por 1M, acierto de caché $0.30. Consulta nuestros artículos de precios de Kimi K3 y alternativas a Kimi K3 para el panorama completo.
Veredicto. La mejora de capacidad, no el ahorro de coste. Elige Kimi K3 cuando quieras la forma de GLM de abierto más multimodal con más inteligencia bruta y puedas absorber precios de modelo estrella. Si el coste es la razón por la que estás aquí, esta es la dirección equivocada.
¿Qué alternativa encaja realmente contigo?
La tabla y el cuadrante hacen la mayor parte del trabajo, pero la respuesta honesta depende de tu mayor restricción. Elige la que más importa y mira adónde apunta:
¿Qué es lo más importante para tu carga de trabajo?
Lo que la elección del modelo no resuelve
Esto es lo que le diría a cualquiera que se angustie con esta tabla, y viene de años poniendo IA en colas de soporte reales: cambiar el modelo es el 5% fácil. Si tu objetivo es responder tickets de clientes, el modelo es la capa inferior de la pila, y es la capa que menos cambia cuando cambias de proveedor.
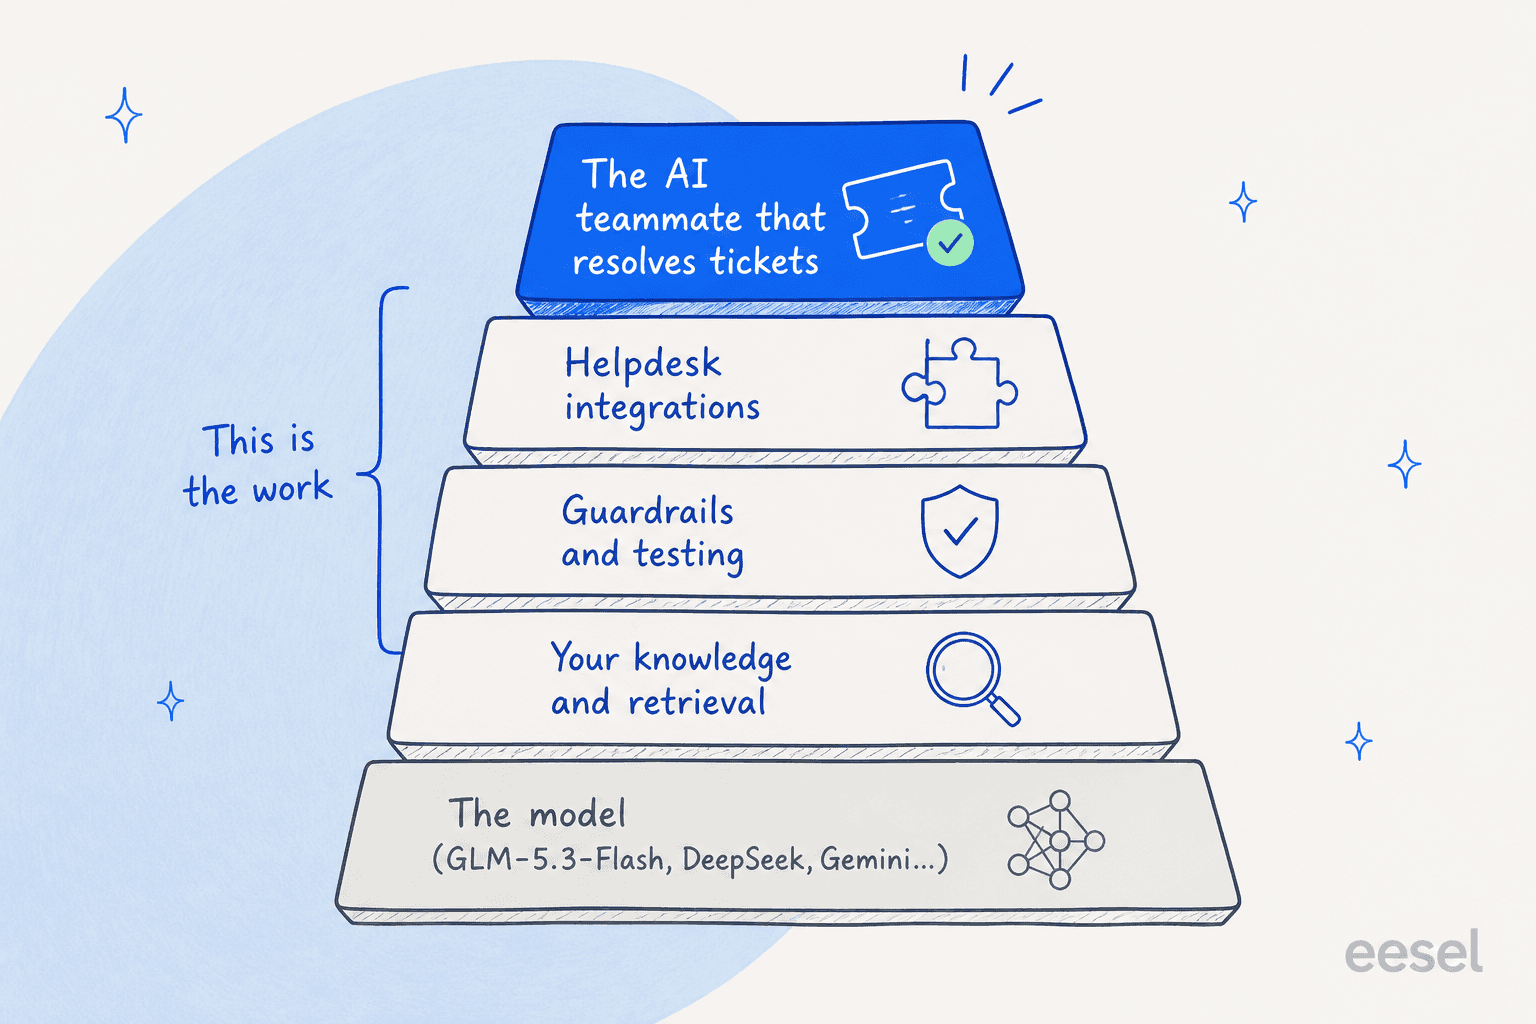
Es la misma lógica que hay detrás de contratar un empleado de IA en lugar de alquilar una API en bruto, y por eso los mejores compañeros de IA se juzgan por resultados, no por tokens por segundo. Todo lo que está sobre el modelo es el trabajo: conectar tu base de conocimiento para que las respuestas tengan fundamento, barreras de seguridad para que sepa qué no decir, pruebas para saber cómo se comporta antes que tus clientes, e integraciones con tu helpdesk para que pueda actuar de verdad. La razón por la que un modelo más barato rara vez mueve tu tasa de resolución es que la tasa de resolución vive en esas capas superiores, no en los tokens por segundo.
Aquí es también donde las cifras de alucinación de arriba dejan de ser una curiosidad. La tasa de alucinación del 64.5% de Gemini 3.7 Flash, o cualquiera de estos modelos respondiendo con seguridad cuando no debería, solo es peligrosa si llega a un cliente sin probar. Hemos visto a bots de apariencia segura dar respuestas erróneas sin que nadie lo notara, y por eso ahora simulamos cada despliegue con los tickets históricos reales de una empresa antes de salir en vivo. Ninguna elección del modelo barato "correcto" sustituye eso. Si quieres la visión a nivel de modelo específicamente para soporte, la escribimos aparte en el artículo del mejor modelo de IA para tickets de soporte.
Prueba eesel
Si comparas alternativas a GLM-5.3-Flash para construir automatización de atención al cliente, eesel es la capa que se sitúa sobre el modelo que elijas. Piensa en el modelo como el motor y en eesel como el compañero de IA que contratas: llega ya sabiendo conectarse con Zendesk, Freshdesk o Gorgias, aprende de tus tickets pasados y tu centro de ayuda, y sigue las barreras de seguridad que fijes.
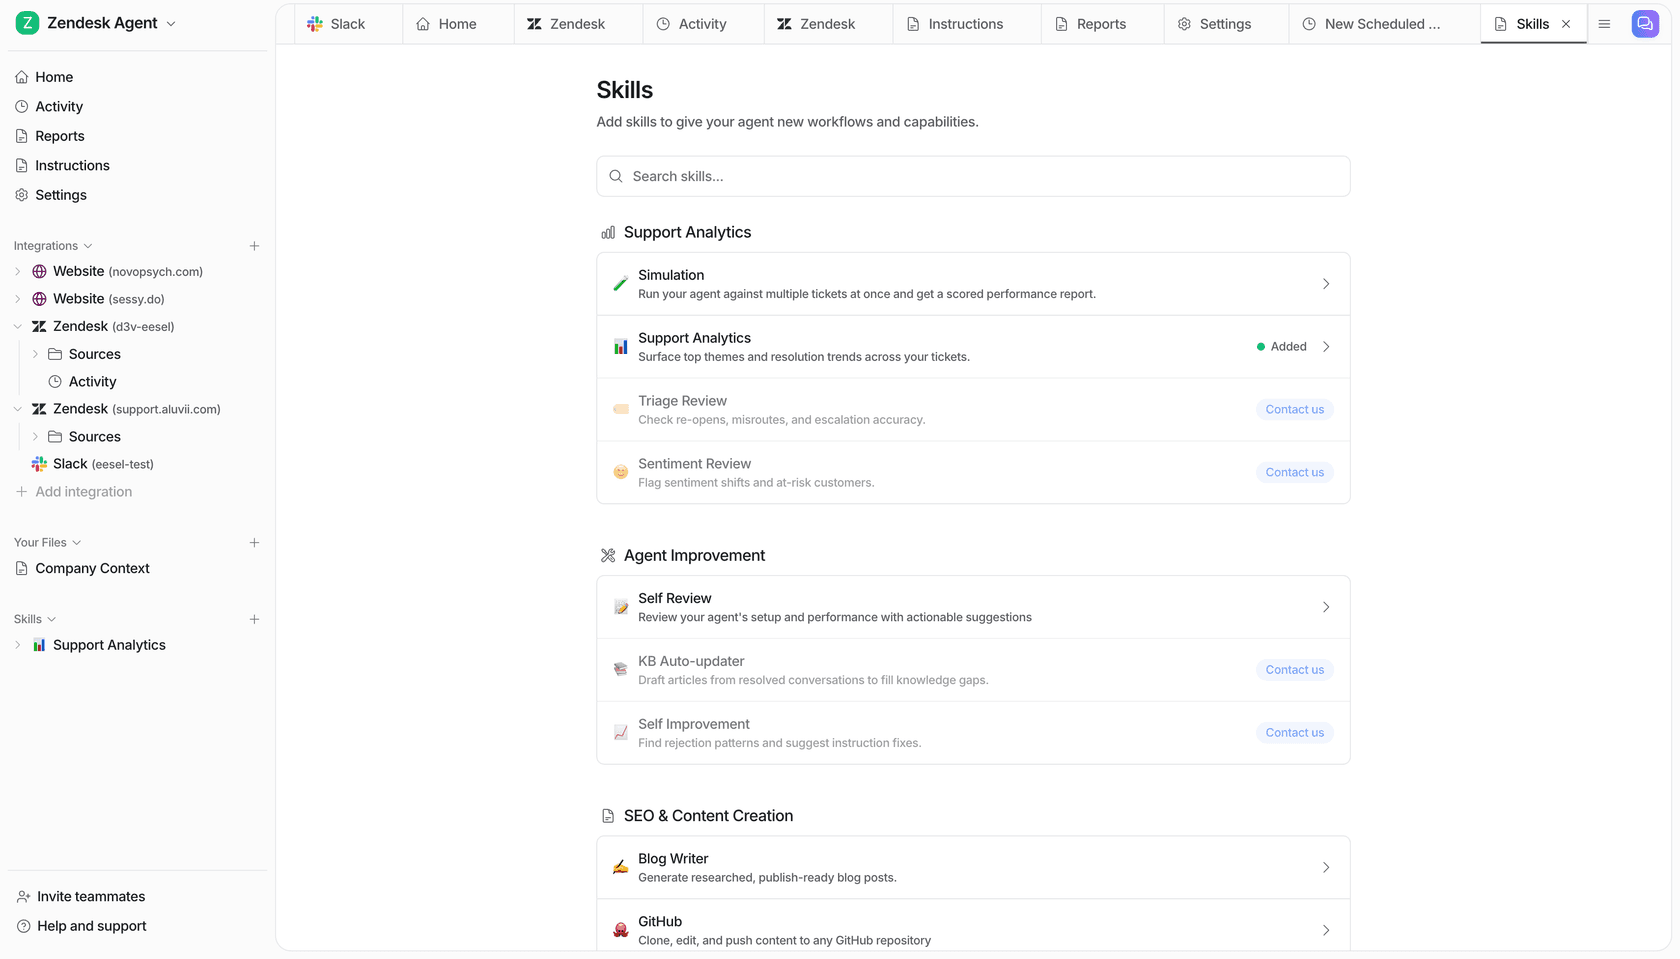
El diferenciador es la simulación: antes de que tu compañero de IA responda un solo ticket en vivo, eesel lo prueba con miles de tus conversaciones pasadas reales, de modo que ves la tasa de resolución y las respuestas exactas que habría enviado, y puedes corregirlas mientras el riesgo sigue siendo cero. Esa es la salvaguarda que convierte un modelo barato y capaz en un agente de soporte en el que realmente puedes confiar. Es gratis para probar, y puedes conectarlo a tu propio helpdesk en pocos minutos.