

Um Ihre Wissensdatenbank für KI-Agenten lesbar zu machen, reparieren Sie zuerst die Artikel, dann die Dateien: eine Frage pro Artikel, beantwortet in Klartext in den ersten zwei Sätzen, Abschnitte, die auch einzeln gelesen Sinn ergeben, und ein Datum auf allem, was sich ändert. Erlauben Sie dann in robots.txt die KI-Suchbots, die Sie wollen, und lassen Sie Login-Schranken dort, wo Sie sie wirklich wollen. llms.txt und MCP kommen zuletzt: Am 17. November 2026 lieferten die eigenen Wissensdatenbanken von Zendesk und Help Scout für /llms.txt noch immer einen 404-Fehler.
Der wichtigste Leser ist Ihre eigene Support-KI. Der KI-Helpdesk-Kollege von eesel beantwortet Anfragen anhand Ihrer Wissensdatenbank und früherer Tickets, und jeder Entwurf, den Ihr Team korrigiert, zeigt auf einen Artikel, der überarbeitet werden muss. Mit der eesel CLI kann ein Coding-Agent prüfen, was der Wissensdatenbank-Sync tatsächlich enthält, und vor dem Go-Live Testfragen stellen; die Verbindung zum Helpdesk selbst muss weiterhin ein Admin freigeben.
Wer liest Ihre Wissensdatenbank heute?
Ich bin Softwareentwickler bei eesel, habe zwei Jahre SEO-Arbeit hinter mir, und die Frage, die mir Support- und Doku-Verantwortliche stellen, hat sich geändert. Früher hieß es: „Warum rankt dieser Artikel nicht?" Jetzt heißt es: „Warum hat ChatGPT einem Kunden gesagt, unser Rückgabefenster seien 14 Tage, wenn es 30 sind?" Die kurze Antwort: Ihre Wissensdatenbank hat drei neue Leser, und jeder liest sie anders.
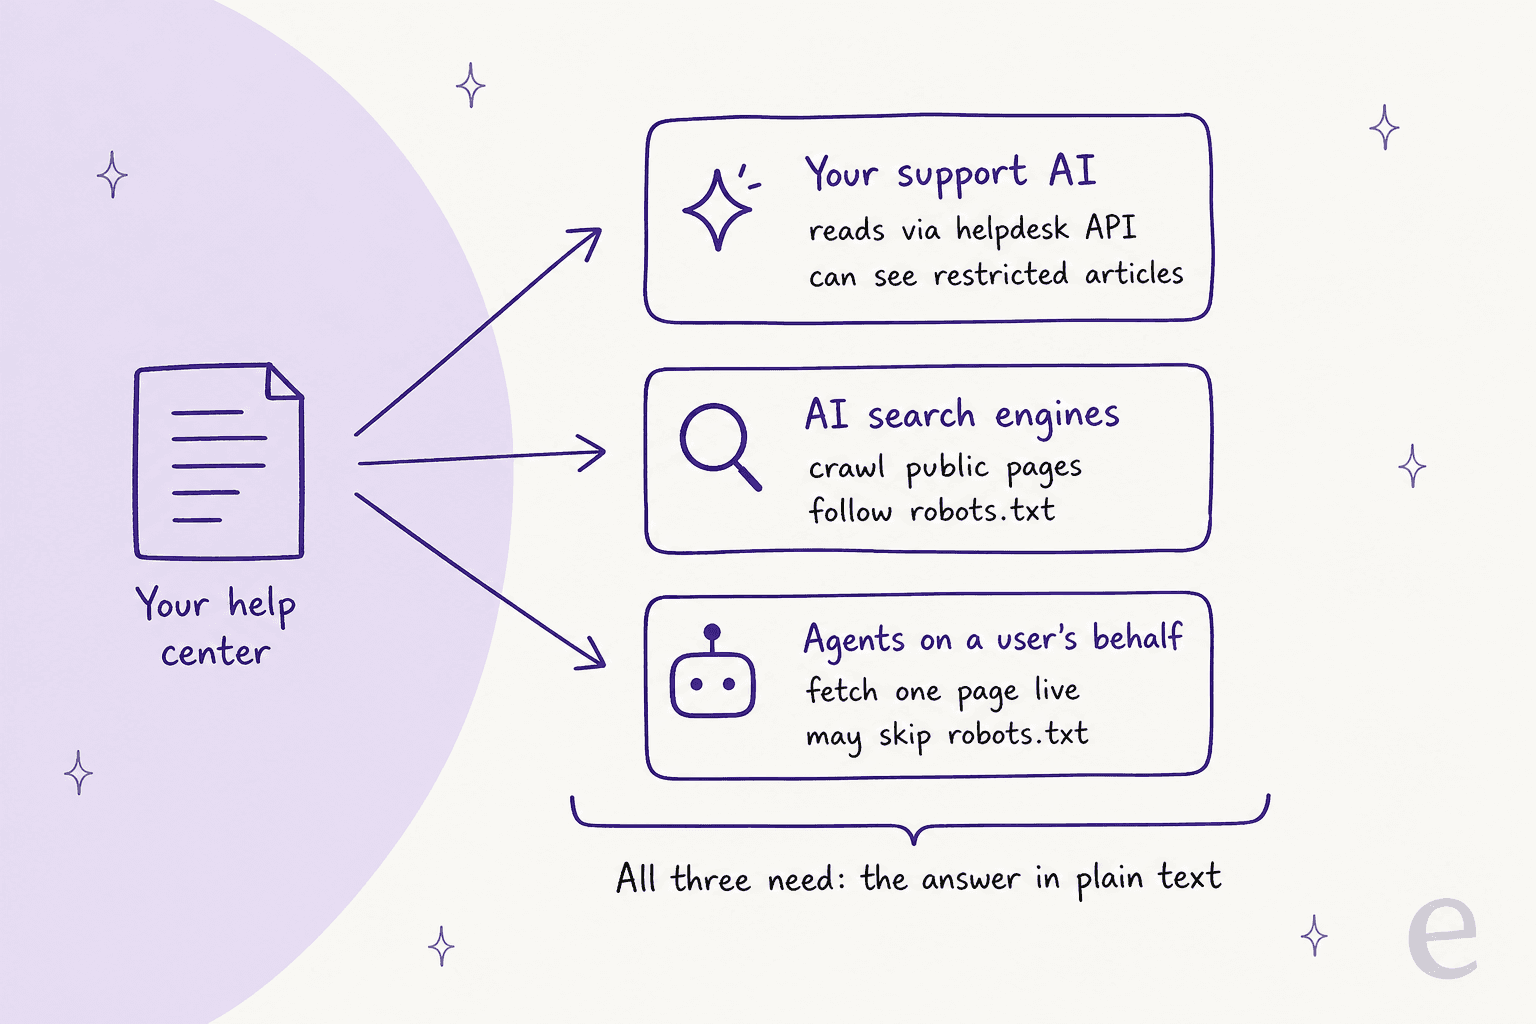
- Ihre eigene Support-KI. Der Bot oder Copilot, den Sie anhand Ihrer Wissensdatenbank trainiert haben, synchronisiert Artikel meist nach Zeitplan über die Helpdesk-API. robots.txt ist ihm egal, und er kann eingeschränkte Artikel lesen, wenn Sie es zulassen.
- KI-Suchmaschinen. ChatGPT-Suche, Claude, Perplexity und Googles AI Overviews crawlen Ihre öffentlichen Seiten im Voraus, genau wie KI-Suchmaschinen jeden Index aufbauen. Sie folgen robots.txt, eine Regel pro Bot.
- Agenten, die für einen Nutzer handeln. Wenn jemand ChatGPT nach Ihrem Produkt fragt, ruft es Ihre Seite womöglich live als
ChatGPT-Userab. Ein Coding-Agent zieht sich Ihre Doku vielleicht als Markdown, und ein MCP-Client fragt sie womöglich als Tool ab.
So unterscheiden sie sich bei den Dingen, die Sie kontrollieren:
| Leser | Wie er hineinkommt | Folgt robots.txt? | Sieht Artikel nur mit Anmeldung? | Führt JavaScript aus? |
|---|---|---|---|---|
| Ihre Support-KI | Helpdesk-API-Sync oder Connector | Nein, sie nutzt Ihren API-Zugang | Ja, wenn die Verbindung die Berechtigung hat | Nicht nötig, sie liest den Artikeltext |
| KI-Such-Crawler (OAI-SearchBot, Claude-SearchBot, PerplexityBot) | Crawlt öffentliche URLs | Ja | Nein | Die Crawler von ChatGPT und Claude taten es in Vercels Test nicht; Gemini schon |
| Nutzer-ausgelöste Abrufer (ChatGPT-User, Claude-User, Perplexity-User) | Ruft während eines Chats eine URL ab | Nicht immer, siehe Schritt 4 | Nein | Als Nein behandeln |
| Coding-Agenten und MCP-Clients | llms.txt, Markdown-Seiten, MCP-Tools | Hängt vom Client ab | Nur mit Zugangsdaten | Nicht nötig |
Die Spalte, die Sie beunruhigen sollte, ist die letzte. Vercels Analyse des KI-Crawler-Traffics ergab, dass die Crawler von ChatGPT und Claude JavaScript-Dateien abrufen, sie aber nicht ausführen, sodass alles, was clientseitig gerendert wird, für sie unsichtbar ist. Jeder Leser in der Tabelle kann Klartext lesen, der auf der Seite oder in der API-Antwort steht. Deshalb drehen sich die ersten drei Schritte unten um die Artikel selbst, und deshalb zahlen sie sich für alle vier Leser gleichzeitig aus. Wie die Support-KI dann einen Abschnitt auswählt, ist eine Frage des Retrievals, aber sie kann nur aus dem wählen, was sie lesen konnte.
Wie KI-lesbar ist Ihre Wissensdatenbank gerade?
Führen Sie vor den Schritten das Audit durch. Es dauert zehn Minuten, mit einem Artikel in einem Browser-Tab und Ihrem Helpdesk-Admin in einem anderen.
Haken Sie ab, was schon zutrifft; die Punktzahl zählt dabei hoch. Punkte, die Sie nicht abhaken können, verweisen auf die Schritte unten.
Schritt 1: Schreiben Sie eine Frage pro Artikel, beantwortet in den ersten Zeilen
Ein KI-Leser nutzt selten Ihren ganzen Artikel. Suchmaschinen und Support-Bots teilen Seiten in Abschnitte, ziehen die zwei oder drei, die der Frage am nächsten wirken, und schreiben daraus eine Antwort. Die Einheit, für die Sie schreiben, ist also der Abschnitt, nicht die Seite.
GitBook sagt es offen in seinem Leitfaden für KI-taugliche Doku: „GitBook übernimmt die Zustellungsebene. Ihr Text bestimmt die Qualität der KI-Antworten." Die Checkliste ist kurz: Geben Sie jeder Seite einen klaren Zweck, nutzen Sie aussagekräftige Überschriften und kurze Abschnitte, nennen Sie Einschränkungen, Standardwerte und Anforderungen direkt, geben Sie exakte Werte an und aktualisieren Sie Inhalte, wenn sich das Produkt ändert.
In der Praxis bedeutet das drei Änderungen für die meisten Wissensdatenbanken:
- Titel sind Fragen, die Kunden stellen. „Wie ändere ich meine Rechnungs-E-Mail?" schlägt „Übersicht der Rechnungseinstellungen". Das ist derselbe Rat, den ich für das Schreiben von Wissensdatenbank-Artikeln gebe, und er trifft meist auch, was Menschen in die Suche eintippen.
- Die Antwort kommt zuerst. Ein oder zwei Sätze, die die Frage lösen, dann die Schritte, dann die Sonderfälle. Wird ein Abschnitt allein herausgezogen, muss der erste Satz überleben.
- Jeder Abschnitt steht für sich. Wiederholen Sie das Hauptwort. „Es einschalten" bedeutet nichts in einem Abschnitt, der seine Überschrift verloren hat.
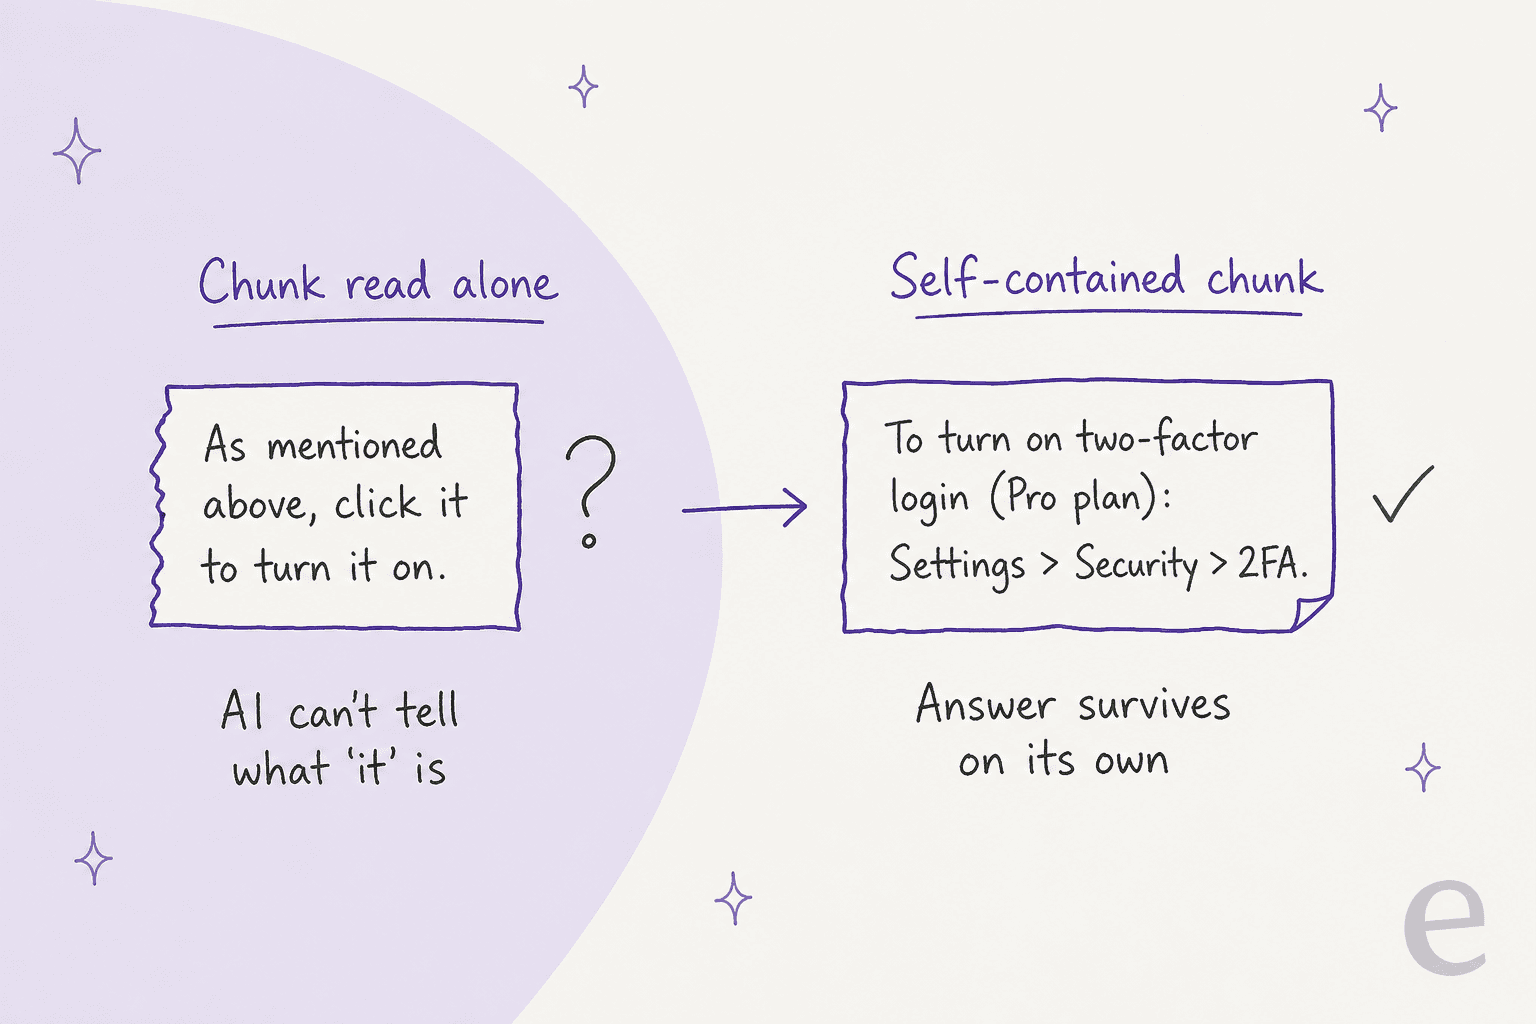
Eine Frage pro Artikel verhindert auch einen stillen Fehler. Eine lange „Konto-FAQ" mit 25 Antworten auf einer Seite wird in Abschnitte zerlegt, die alle denselben Titel teilen, sodass die KI nicht erkennen kann, welche Antwort zu welcher Frage gehört. Das Aufteilen großer FAQ-Seiten ist zuerst der schnellste Gewinn, den ich kenne, um FAQs mit KI abzufangen.
Wenn Sie Document360 nutzen, gibt es einen zweiten Grund für gute Zusammenfassungen: Die erzeugte llms.txt nutzt die „KI- und Suchbeschreibung" jedes Artikels, und laut Document360s llms.txt-Doku wird Inhalt ohne eine solche Beschreibung „nur mit Titel in llms.txt aufgenommen".
Schritt 2: Holen Sie Antworten aus Bildern, Videos, PDFs und Klick-zum-Öffnen-Widgets
Das ist der Schritt, der die meisten KI-Antworten kaputt macht, die ich sehe. Ein Hilfeartikel sagt „gehen Sie zu den unten gezeigten Einstellungen", und der einzige Ort, an dem der Pfad auftaucht, ist ein Screenshot. Die lesende Person sieht ihn. Die meisten KI-Leser nicht.
Googles eigene Hinweise zu KI-Funktionen nennen „sicherzustellen, dass wichtiger Inhalt in Textform verfügbar ist" als eine der Grundlagen, um in AI Overviews und AI Mode zu erscheinen. Dasselbe gilt für Ihre Support-KI: Ein Sync, der den Artikeltext zieht, bekommt den Text und die Bild-URL, nicht das, was im Bild gezeichnet ist.
Wo sich die Antwort meist versteckt, und was Sie dagegen tun können:
| Wo sich die Antwort versteckt | Was KI-Leser bekommen | Lösung |
|---|---|---|
| Screenshot einer Einstellungsseite | Eine Bild-URL und vielleicht Alt-Text | Schreiben Sie den Menüpfad als Text: Einstellungen > Sicherheit > 2FA. Behalten Sie den Screenshot als Backup (Formatierungstipps) |
| Eingebettete Video-Anleitung | Ein Player-Embed, keine Schritte | Fügen Sie die Schritte oder ein Transkript unter dem Video ein (Video-Embeds) |
| PDF- oder Folien-Anhang | Wird oft übersprungen oder ohne Struktur gelesen | Verschieben Sie den Inhalt in den Artikel (Anhänge) |
| Tabs oder Akkordeons, die per Skript geladen werden | Nichts, wenn der Text erst nach dem JavaScript-Lauf erscheint | Halten Sie den Text im HTML. Ein einfacher <details>-Block reicht, weil der Text schon da ist |
| Preise oder Limits in einem eingebetteten Widget | Nichts | Nennen Sie die Zahl in einem Satz mit Datum |
Das gilt auch für Ihren eigenen Bot, nicht nur für die öffentliche Suche. Bei SE Ranking beantwortet eesel Live-Chats für drei Produkte aus rund 14.100 Wissensdatenbank-Seiten, und seine Anweisungen sagen, dass es nie ein Menü oder eine Schaltfläche beschreibt, die es nicht im Wissen gefunden hat. Das ist die richtige Regel für einen Support-Agenten. Es bedeutet auch: Ein Menüpfad, der nur in einem Screenshot existiert, ist ein Pfad, den der Agent nicht nennen wird, sodass der Kunde für etwas an einen Menschen weitergegeben wird, das Ihre Wissensdatenbank bereits abdeckt.
Ein schneller Test für jeden Artikel: Sehen Sie sich den Seitenquelltext an (oder die API-Antwort) und suchen Sie nach dem entscheidenden Schritt. Steht er nicht im Text, gehen Sie davon aus, dass kein KI-Leser ihn hat.
Schritt 3: Datieren Sie Ihre Fakten, und stellen Sie alte Artikel richtig ein
Ein KI-Leser ist standardmäßig selbstsicher. Sagt ein alter Artikel, das Rückgabefenster seien 14 Tage, und ein neuerer sagt 30, kann das Modell beides zitieren, und es wird kein „aber prüfen Sie das Datum" ergänzen. Veralteter Inhalt richtet in einer KI-Antwort mehr Schaden an als auf einer Seite, weil der Kunde die Fußzeile „zuletzt aktualisiert 2023" nie sieht.
Drei Gewohnheiten beheben das meiste davon:
- Setzen Sie das Datum direkt neben die Tatsache. „Rückgaben sind 30 Tage nach dem Kauf möglich (Richtlinie Stand Oktober 2026)" überlebt es, in einen Abschnitt gezogen zu werden. Eine Fußzeile überlebt das nicht.
- Löschen oder verschmelzen Sie Duplikate. Zwei Artikel, die dieselbe Frage mit unterschiedlichen Zahlen beantworten, sind die häufigste Ursache für eine falsche KI-Antwort, die ich sehe. Machen Sie zuerst einen Durchgang zu veraltetem Wissensdatenbank-Inhalt.
- Leiten Sie weiter, liefern Sie keinen 404. In Vercels Crawler-Daten verbrachte ChatGPT 34,82 % seiner Abrufe auf 404-Seiten und weitere 14,36 % mit dem Folgen von Weiterleitungen. Wenn Sie einen Artikel verschieben, richten Sie die Weiterleitung ein, damit KI-Suchmaschinen auf der aktuellen Version landen.
Auch Ihre eigene Support-KI braucht eine Regel für Widersprüche. OroSoft betreibt eesel als Freshdesk-Copilot, der die Wissensdatenbank als Quelle der Wahrheit für Richtlinien behandelt, und wenn sich Wissensdatenbank und frühere Tickets widersprechen, folgt er dem aktuelleren. Die Wissensdatenbank wird jeden Montag neu synchronisiert. Das ist die Schleife, die jedes Team braucht, egal welches Tool es nutzt:
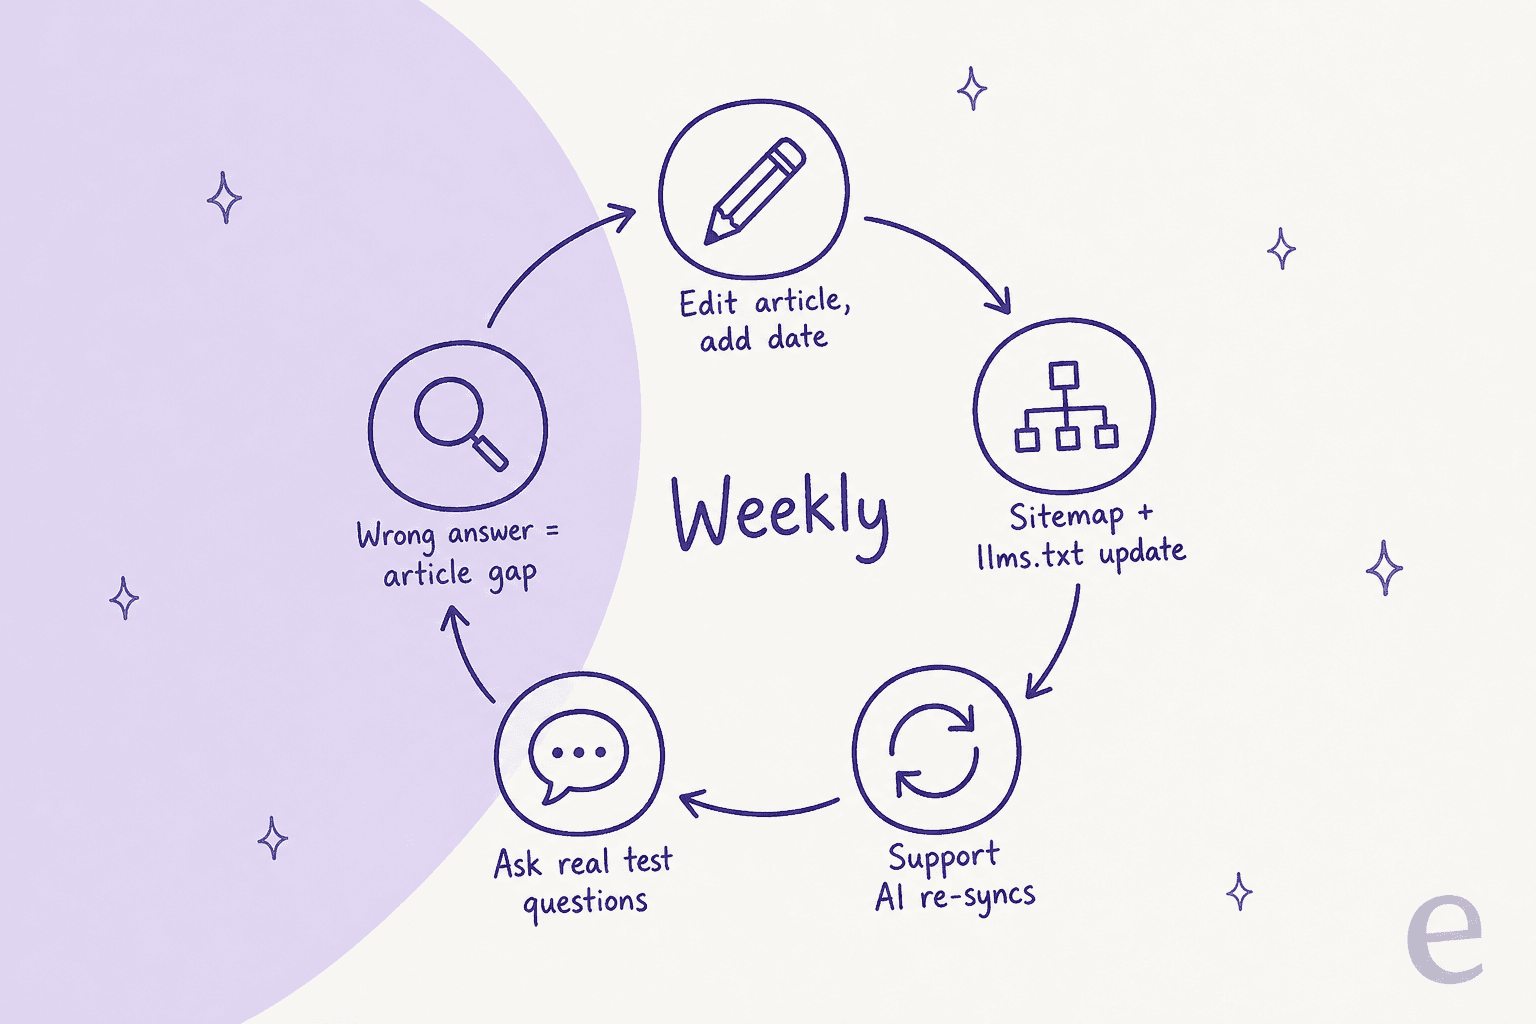
Zendesk erzeugt die Sitemap der Wissensdatenbank alle zwei Stunden neu, laut seinem Artikel zur Wissensdatenbank-SEO, sodass sich die öffentliche Seite meist selbst kümmert. Der Sync-Zeitplan Ihres Bots ist derjenige, den Sie prüfen sollten. Synchronisiert er monatlich, ist eine Richtlinienänderung bis zu einen Monat lang falsch in KI-Antworten. Eine sich selbst aktualisierende Wissensdatenbank hilft in die andere Richtung: Sie fängt Antworten ab, die es nie in einen Artikel geschafft haben.
Schritt 4: Entscheiden Sie, welche KI-Bots sie lesen dürfen
Die meisten KI-Firmen teilen ihre Bots inzwischen nach Aufgabe: einer für Modelltraining, einer für die Suche, einer für Abrufe, die ein Nutzer anfordert. Sie können den einen erlauben und den anderen sperren. Hier sehe ich Support-Teams versehentlich ihre Wissensdatenbank verstecken, meist nachdem jemand einen „Alle KI-Bots sperren"-robots.txt-Schnipsel eingefügt hat.
| Firma | Trainings-Crawler | Such-Crawler | Nutzer-ausgelöster Abrufer |
|---|---|---|---|
| OpenAI | GPTBot | OAI-SearchBot | ChatGPT-User („robots.txt-Regeln gelten womöglich nicht") |
| Anthropic | ClaudeBot | Claude-SearchBot | Claude-User (ein Sperren stoppt den nutzergesteuerten Abruf) |
| Perplexity | keiner gelistet | PerplexityBot | Perplexity-User („ignoriert robots.txt-Regeln in der Regel") |
| Google-Extended (ein Steuer-Token, kein eigener Bot) | Googlebot | hier nicht behandelt |
Jeder Firmenname verlinkt auf dessen eigene Crawler-Dokumentation.
Die Regel für eine öffentliche Wissensdatenbank ist einfach: erlauben Sie die Such-Crawler. OpenAI sagt, Seiten, die sich von OAI-SearchBot abmelden, „werden nicht in ChatGPT-Suchantworten gezeigt", und Anthropic sagt, das Sperren von Claude-SearchBot „kann die Sichtbarkeit und Genauigkeit Ihrer Seite in Nutzer-Suchergebnissen verringern". Ob Sie Trainings-Crawler zulassen, ist eine separate Entscheidung für Ihr Rechts- und Marketingteam.
Eine robots.txt für eine Wissensdatenbank, die den KI-Suchzugang behält und sich vom Training abmeldet, sieht so aus:
# KI-Suche: diese dürfen die Wissensdatenbank indexieren
User-agent: OAI-SearchBot
Allow: /

User-agent: Claude-SearchBot
Allow: /

User-agent: PerplexityBot
Allow: /

# Modelltraining: eine Grundsatzentscheidung, keine Antwort-Entscheidung
User-agent: GPTBot
Disallow: /

User-agent: ClaudeBot
Disallow: /
Drei Details, über die Menschen stolpern:
- Google-Extended macht mehr als Training. Google sagt, es steuere auch das Grounding in Gemini Apps und Vertex AI, sodass ein Sperren Ihre Artikel aus Gemini-Antworten heraushalten kann, während es „die Aufnahme einer Seite in die Google-Suche nicht beeinflusst".
- Änderungen wirken nicht sofort. OpenAI sagt, es könne rund 24 Stunden nach einer robots.txt-Änderung dauern, bis sich seine Suchsysteme anpassen.
- robots.txt deckt nur die Domain ab, auf der sie liegt. Anthropics Anleitung sagt, die Regeln für jede Subdomain zu wiederholen, was wichtig ist, wenn Ihre Wissensdatenbank auf
help.odersupport.liegt.
Wenn Sie sehen wollen, wie oft KI-Engines Sie danach tatsächlich zitieren, ist das eine Frage der Answer Engine Optimization, und diese Tools decken die Tracking-Seite ab.
Schritt 5: Setzen Sie die Login-Schranke dort, wo Sie sie wirklich wollen
Jeder öffentliche KI-Leser stoppt an einer Login-Seite. Zendesk ist da direkt: Wenn Ihre Wissensdatenbank eine Anmeldung erfordert, „wird die Sitemap nicht automatisch erzeugt. Web-Crawler können nicht auf geschlossene oder eingeschränkte Wissensdatenbanken zugreifen." Mintlifys llms.txt-Doku sagt dasselbe für seine erzeugten Dateien: Auf vollständig authentifizierten Seiten „können KI-Tools, die sich nicht authentifizieren können, nicht darauf zugreifen".
Das ist richtiges Verhalten. Der Fehler ist, öffentliche Antworten versehentlich hinter die Schranke zu stellen, oft weil eine ganze Kategorie für ein Nutzersegment wegen eines einzigen sensiblen Artikels eingeschränkt wurde. Prüfen Sie Einschränkungen Artikel für Artikel, und schränken Sie nach Segment ein nur das, was wirklich privat sein muss.
Planen Sie dann zwei Spuren:
- Öffentliche Spur: alles, was ein Interessent oder Kunde vor der Anmeldung fragen könnte. Das ist, was KI-Suchmaschinen und ChatGPT-artige Abrufer zitieren werden.
- Private Spur: kontospezifische, partnerexklusive oder interne Artikel. Nur Ihre eigene Support-KI sollte diese lesen, über eine API-Verbindung mit Berechtigung, etwa die Zendesk Guide API oder die Freshdesk-Wissensdatenbank-API.
Das wird konkreter, als die meisten erwarten. Bei einem eesel-Verkaufsgespräch brauchte ein Enterprise-Logistikteam zwei Agenten für ein Zendesk: einen für anonyme Nutzer, der nur aus öffentlichen Artikeln antwortet, und einen für registrierte Nutzer, der zusätzlich eine Teilmenge eingeschränkter Artikel liest. Das ist der richtige Instinkt. Entscheiden Sie, welches Publikum jeder KI-Leser bedient, und geben Sie ihm genau diesen Inhalt.
Schritt 6: Ergänzen Sie llms.txt und Markdown-Versionen
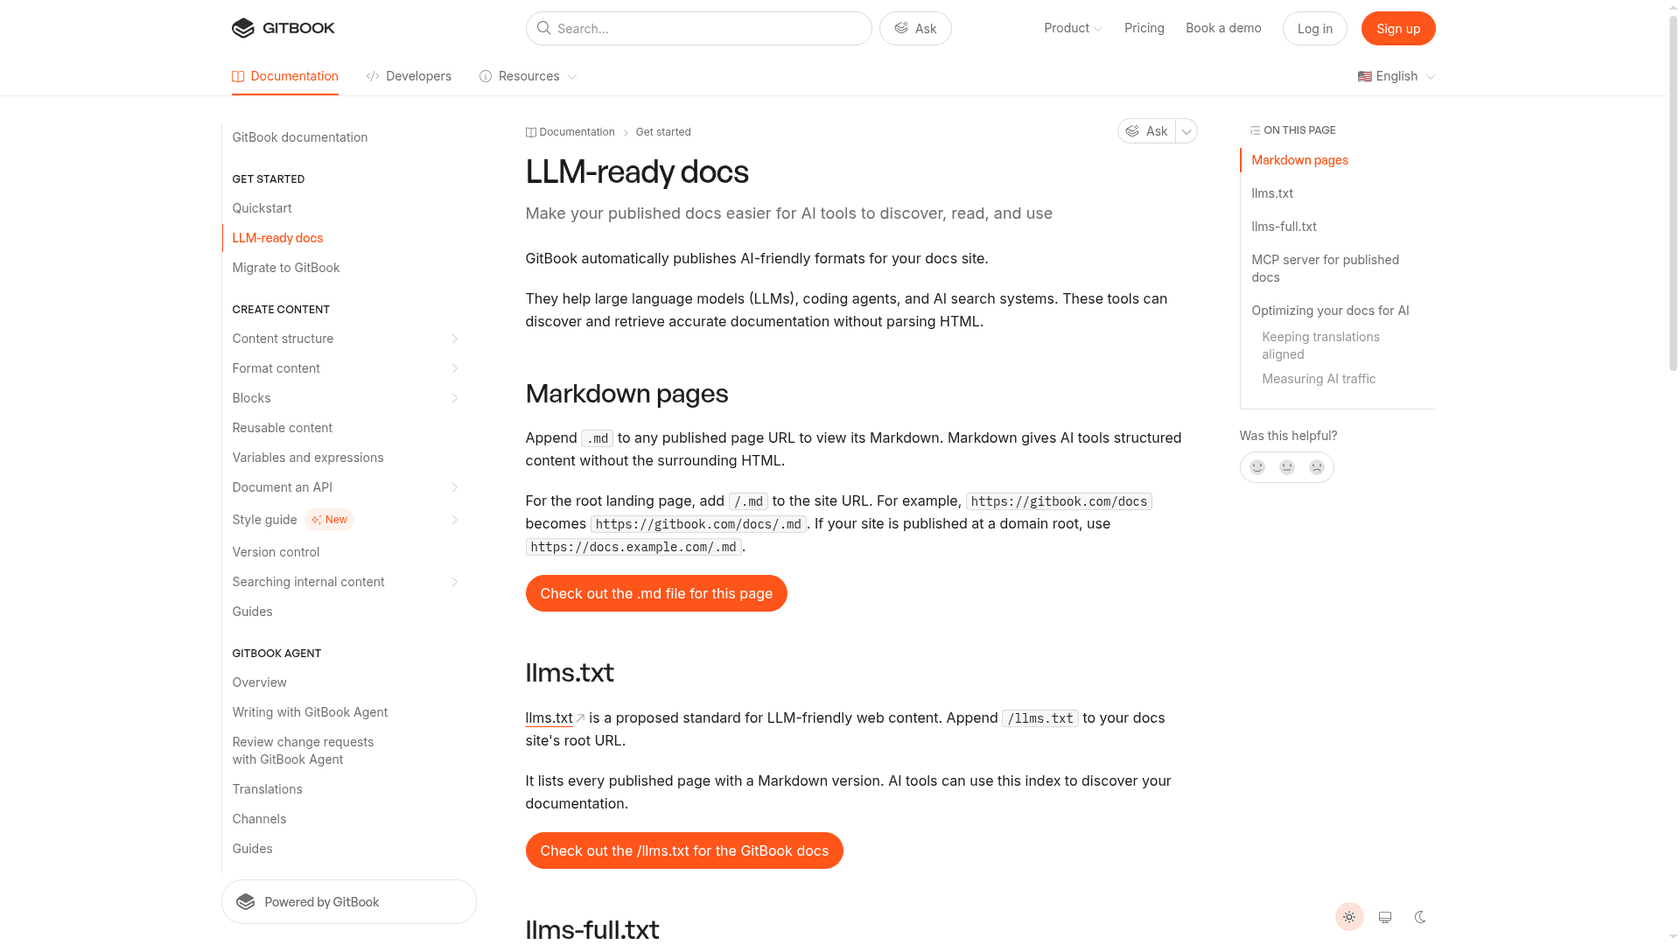
Jetzt der Teil, mit dem die meisten Leitfäden anfangen. llms.txt ist ein vorgeschlagener Standard: eine Markdown-Datei unter /llms.txt, die Ihre wichtigsten Seiten mit einzeiligen Beschreibungen aufführt, plus saubere Markdown-Versionen jeder Seite unter derselben URL mit angehängtem .md. Die Idee ist, einem Agenten das Parsen von Navigation, Skripten und Cookie-Bannern zu ersparen, um eine Antwort zu finden.
Stand der Dinge im November 2026:
- Coding-Agenten und KI-Clients nutzen es. Die Spezifikation sagt, llms.txt-Dateien würden „am stärksten für Software-Dokumentation genutzt, wo Coding-Agenten ihnen folgen, um API-Referenzen und Tutorials zu finden." Zendesk hat am 4. November 2026 llms.txt und Markdown-Seiten zu seiner Entwickler-Doku hinzugefügt, und seine Ankündigung sagt Entwicklern, sie sollten ihrem Agenten
developer.zendesk.com/llms.txtals Suchindex geben. - Suchmaschinen brauchen es nicht. Google sagt, AI Overviews und AI Mode hätten „keine zusätzlichen technischen Anforderungen" über die normale Suchberechtigung hinaus. Chromes Lighthouse-llms.txt-Audit markiert eine fehlende Datei als nicht zutreffend, „da die Bereitstellung der Datei derzeit optional ist."
- Kunden-Wissensdatenbanken haben meist noch keine. Am 17. November 2026 habe ich
/llms.txtbei support.zendesk.com, docs.helpscout.com und support.freshdesk.com angefragt. Alle drei lieferten 404. Die Wissensdatenbanken genau dieser Firmen ranken und werden trotzdem problemlos zitiert, was zeigt, wo llms.txt auf der Prioritätenliste steht.
Die Entwicklergemeinschaft ist sich uneinig, wie wichtig das ist, und beide Seiten haben einen Punkt:
"LLMs are not reading llms.txt nor AGENTS.md files from servers. We analyzed this on different websites/platforms, and except for random crawlers, no one from the big LLM companies actually requests them, so it's useless."

"llms.txt files have nothing to do with crawlers or big LLM companies. They are for individual client agents to use. I have my clients set up to always use them when they're available, and since I did that they've been way faster and more token efficient when using sites that have llms.txt files."
Der zweite Kommentar stammt vom Account von Jeremy Howard, der den llms.txt-Vorschlag geschrieben hat, und er deckt sich mit der Spezifikation: llms.txt ist für Agenten gedacht, die gezielt suchen, nicht für Crawler, die einen Index aufbauen. Wenn Ihre Wissensdatenbank von Coding-Agenten von Entwicklern gelesen wird (API-Produkte, Dev-Tools, alles mit einem SDK), lohnt es sich. Für eine Verbraucher-Wissensdatenbank ist es eine billige Versicherung, kein Ranking-Hebel.
Wenn Ihre Plattform das für Sie erledigt, schalten Sie es ein und machen Sie weiter:
| Plattform | llms.txt | Markdown-Seiten | Worauf achten |
|---|---|---|---|
| GitBook | Automatisch, plus llms-full.txt | .md an jede Seite anhängen | Versteckte Seiten stecken weiterhin in llms-full.txt und im MCP-Server |
| Mintlify | Automatisch, auch unter /.well-known/llms.txt | .md anhängen; HTML-Seiten verlinken ihre Markdown-Version | Die Einstellung „Don't index project" liefert für llms.txt einen 404, für llms-full.txt nicht |
| Document360 | Automatisch, bei jeder Veröffentlichung aktualisiert | Seiten bieten „View as Markdown" an | Nur öffentlicher Inhalt wird aufgenommen; Artikel ohne Beschreibung erscheinen nur mit Titel |
| Zendesk-Wissensdatenbank | Keine eingebaute Option gefunden; die KnowledgeBridge-App im Marketplace erzeugt beide Dateien | Über die App, oder Ihren eigenen Wissensdatenbank-Export | Sie hosten und aktualisieren das Ergebnis selbst |
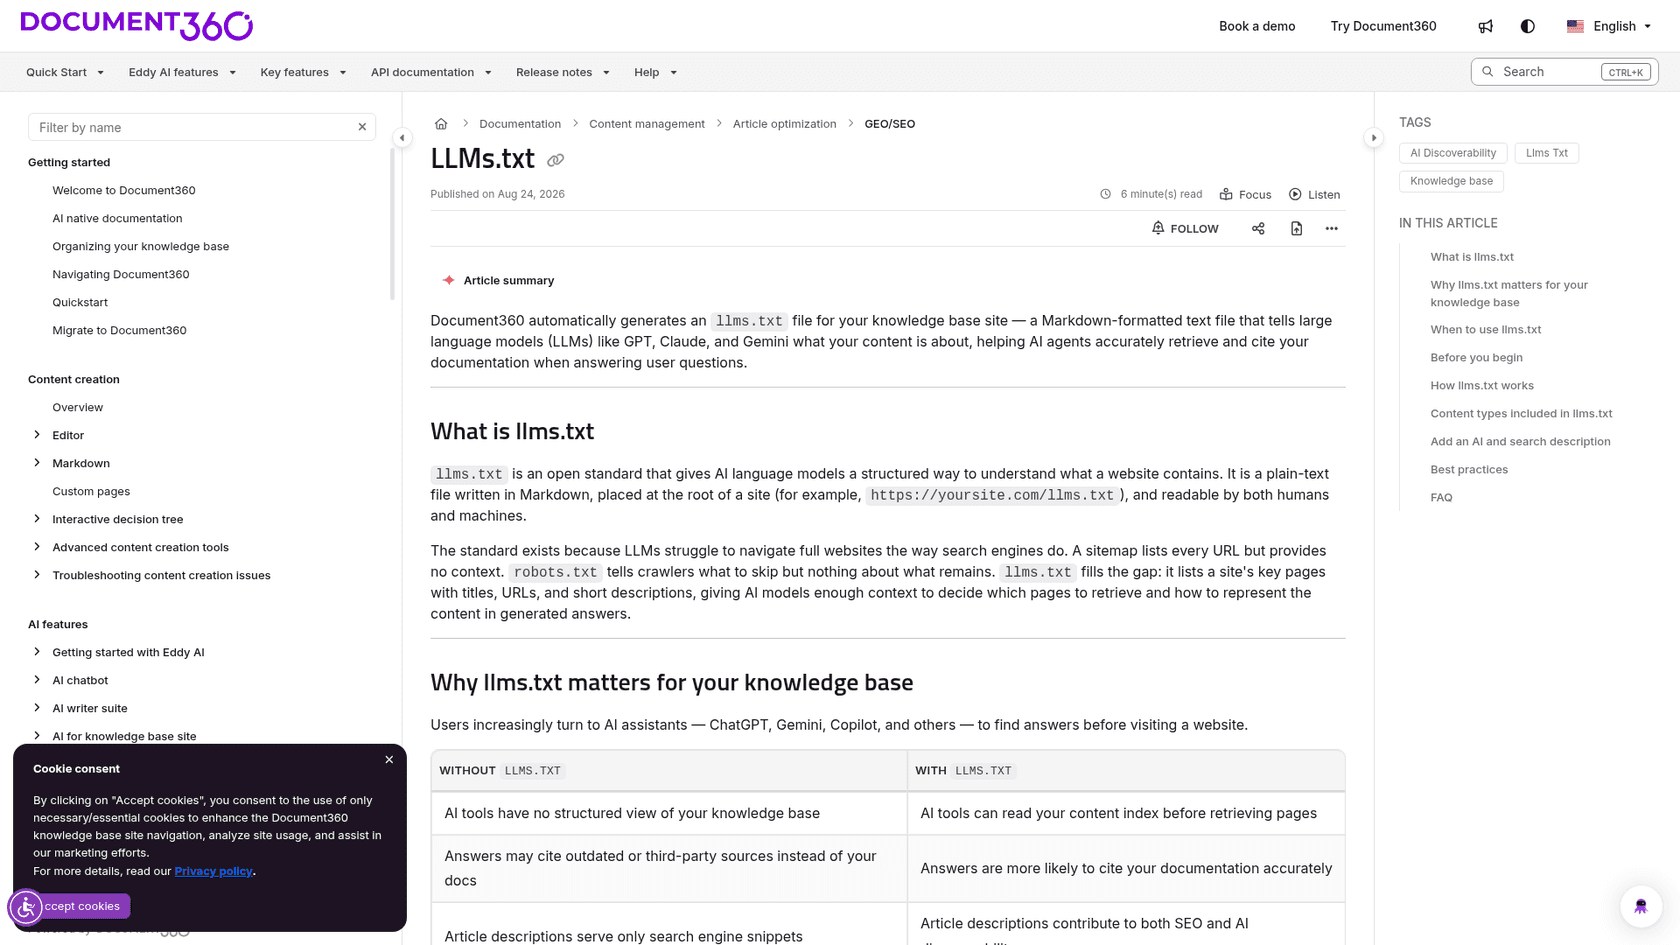
Die GitBook-Zeile verdient einen zweiten Blick. Laut GitBooks eigener Doku entfernt „das Verstecken einer Seite diese nur aus dem veröffentlichten Inhaltsverzeichnis." Wenn Sie eine veraltete oder interne Seite versteckt statt unveröffentlicht haben, können Agenten sie weiterhin lesen.
Schritt 7: Bieten Sie einen MCP-Server an, und wissen Sie, welche Art Sie anbieten
MCP (Model Context Protocol) lässt eine KI-App Ihre Wissensdatenbank als Tool aufrufen: durchsuchen, eine Seite lesen, Markdown zurückbekommen, statt HTML zu scrapen. Es gibt zwei sehr unterschiedliche Arten, und Support-Teams bringen sie durcheinander.
Öffentliche Doku-MCP-Server sind für die KI von jedem. GitBook „stellt für jede veröffentlichte Doku-Seite einen Model Context Protocol (MCP)-Server bereit" unter /~gitbook/mcp. Mintlifys Such-MCP-Server gibt Agenten drei Tools: Suche, ein nur lesbares Doku-Dateisystem, und ein Feedback-Tool, das „ein Doku-Problem an Ihr Team zurückmeldet, wenn ein Agent eine Seite findet, die falsch, veraltet, verwirrend oder unvollständig ist." Dieses letzte Tool ist die Idee, die ich zuerst kopieren würde: Der Agent, der Ihre Doku liest, meldet dort selbst den Fehler.
Konto-MCP-Server sind für die eigenen KI-Tools Ihres Teams, mit Ihren Berechtigungen:
- Help Scouts MCP verbindet Claude, ChatGPT oder Cursor mit Unterhaltungen, Kunden und Docs-Inhalten. Es braucht API-Zugang (Standard-, Plus- und Pro-Pläne) und einen Docs-API-Schlüssel für die Wissensdatenbank-Tools, und KI-Agenten „greifen nur auf Daten zu, für die Ihr jeweiliges Nutzerkonto berechtigt ist." Das ist eine andere Aufgabe als Help Scouts Self-Service-Tools für Kunden.
- Zendesk Bridge, im Early Access, lässt externe Agenten wie Claude, ChatGPT, Copilot oder Gemini Ihre Wissensdatenbank durchsuchen und Tickets über eine gesteuerte MCP-Verbindung bearbeiten, laut Zendesks EAP-Artikel. Das ist getrennt von Zendesks eigenem MCP-Client, der umgekehrt funktioniert und Zendesk andere Tools aufrufen lässt.
- Document360s MCP verbindet ChatGPT und Claude mit Ihrer Wissensdatenbank, um Artikel zu durchsuchen und zu verwalten.
Keine der beiden Arten ersetzt die Schritte 1 bis 3. Ein MCP-Server liefert Ihren Artikel schneller und sauberer; er kann einen veralteten Artikel nicht richtig machen. Für den Hintergrund, wie Agenten diese Server nutzen, deckt mein Beitrag zu KI-Agent-MCP-Servern das ab, und das Early-Access-Programm für Zendesks ChatGPT-Kanal zeigt, wohin das geht: „generative Antworten" in ChatGPT „direkt aus dem Help-Center-Inhalt Ihres Kontos", neben seinem conversational Help Center.
Wie testen Sie, ob KI-Agenten sie richtig lesen?
Fragen Sie sie. Das klingt offensichtlich, und fast niemand macht es nach Plan. Nehmen Sie zehn echte Fragen aus den Tickets des letzten Monats, die konkreten mit einer Zahl in der Antwort, und testen Sie sie an drei Stellen:
- ChatGPT, Claude und Perplexity mit aktivierter Suche. Prüfen Sie, ob sie Ihre Wissensdatenbank zitieren und ob die Zahl aktuell ist.
- Ein roher Abruf.
curl -A "OAI-SearchBot" https://help.yoursite.com/your-articleund suchen Sie in der Ausgabe nach dem entscheidenden Satz. Fehlt er, kann ein Crawler, der kein JavaScript ausführt, ihn nicht sehen. - Ihre eigene Support-KI, bevor Kunden sie sehen. Bei eesel wird jedes Rollout zuerst gegen historische Tickets getestet, weil ein Bot, der selbstsicher klingt und falsch liegt, mehr Vertrauen kostet als gar kein Bot.
Für Entwickler-Doku prüft Chromes Lighthouse-Kategorie Agentic Browsing (Chrome 150 oder neuer, noch experimentell) llms.txt, Layout-Stabilität und ob der Accessibility-Baum stimmt, was es den „maschinellen Blick" auf Ihre Seite nennt.
Die beste Testschleife, die ich gesehen habe, ist die, die bei jedem Ticket läuft. Qontro, ein ERP-Unternehmen, verband Freshdesk mit eesel und lud seine Wissensdatenbank, Support-Foren und rund 9.800 frühere Tickets. Jedes neue Ticket bekommt einen Antwortentwurf als interne Notiz mit verlinkten Hilfeartikeln. Das Team vergleicht jeden Entwurf mit der Antwort, die ein Mensch tatsächlich geschickt hat, und wo der Entwurf falsch lag, „verweist das meist auf einen fehlenden oder unvollständigen Hilfeartikel oder eine Regel, die enger gefasst werden muss." Die Wissensdatenbank wird jeden Freitag neu synchronisiert. Etwa einer von zehn Entwürfen geht inzwischen mit wenig oder keiner Bearbeitung hinaus, und der größere Gewinn bisher ist, was die Entwürfe über die Lücken zeigen.
Das ist Wissenslücken-Analyse ohne ein separates Projekt. Innr nutzt dieselbe Ehrlichkeitsregel aus der anderen Richtung: Deckt die Wissensdatenbank eine Frage nicht ab, sagt eesel das und übergibt, statt zu raten. Jede Übergabe ist ein fehlender Artikel, den Sie auch über das Abbilden von Suchanfragen auf Lücken finden können.
Welche Fehler machen eine Wissensdatenbank für KI schwerer lesbar?
Die, die ich am häufigsten sehe, ungefähr in der Reihenfolge des Schadens:
- llms.txt ausliefern, bevor die Artikel repariert sind. Es listet Ihre Seiten schneller auf; es macht sie nicht richtig.
- Eine kopierte „Alle KI-Bots sperren"-robots.txt. Sie sperrt meist OAI-SearchBot und Claude-SearchBot zusammen mit den Trainings-Crawlern, was Ihre Wissensdatenbank aus KI-Suchantworten herausnimmt.
- Verstecken statt unveröffentlichen. Bei GitBook bleiben versteckte Seiten in
llms-full.txtund im MCP-Server. - Antworten in Screenshots. Der häufigste Grund, warum eine KI „Das konnte ich nicht finden" zu etwas sagt, das Sie dokumentiert haben.
- Zwei aktive Antworten auf eine Frage. Die KI zitiert, welcher Abschnitt am nächsten wirkt, nicht, welcher neuer ist.
- Ein monatlicher Bot-Sync. Die öffentliche Suche holt in Stunden auf; ein langsamer Sync lässt Ihren eigenen Bot hinter der Wissensdatenbank zurück.
eesel: Lassen Sie Ihre Wissensdatenbank einen Support-Kollegen trainieren
Wenn die Haupt-KI, die Ihre Wissensdatenbank liest, Ihr eigener Support-Bot ist, ist der schnellste Weg, ihn lesbar zu machen, ihm beim Lesen zuzusehen. eesels KI-Helpdesk-Kollege tritt Ihrem Helpdesk bei, lernt aus Ihrer Wissensdatenbank, Ihren Makros und früheren Tickets, und entwirft oder schickt Antworten mit verlinktem Quellartikel. Jeder Entwurf, den Ihr Team bearbeitet, zeigt Ihnen einen Artikel, der eine klarere Antwort, ein Datum oder eine Zusammenführung braucht, so wie bei Qontro.
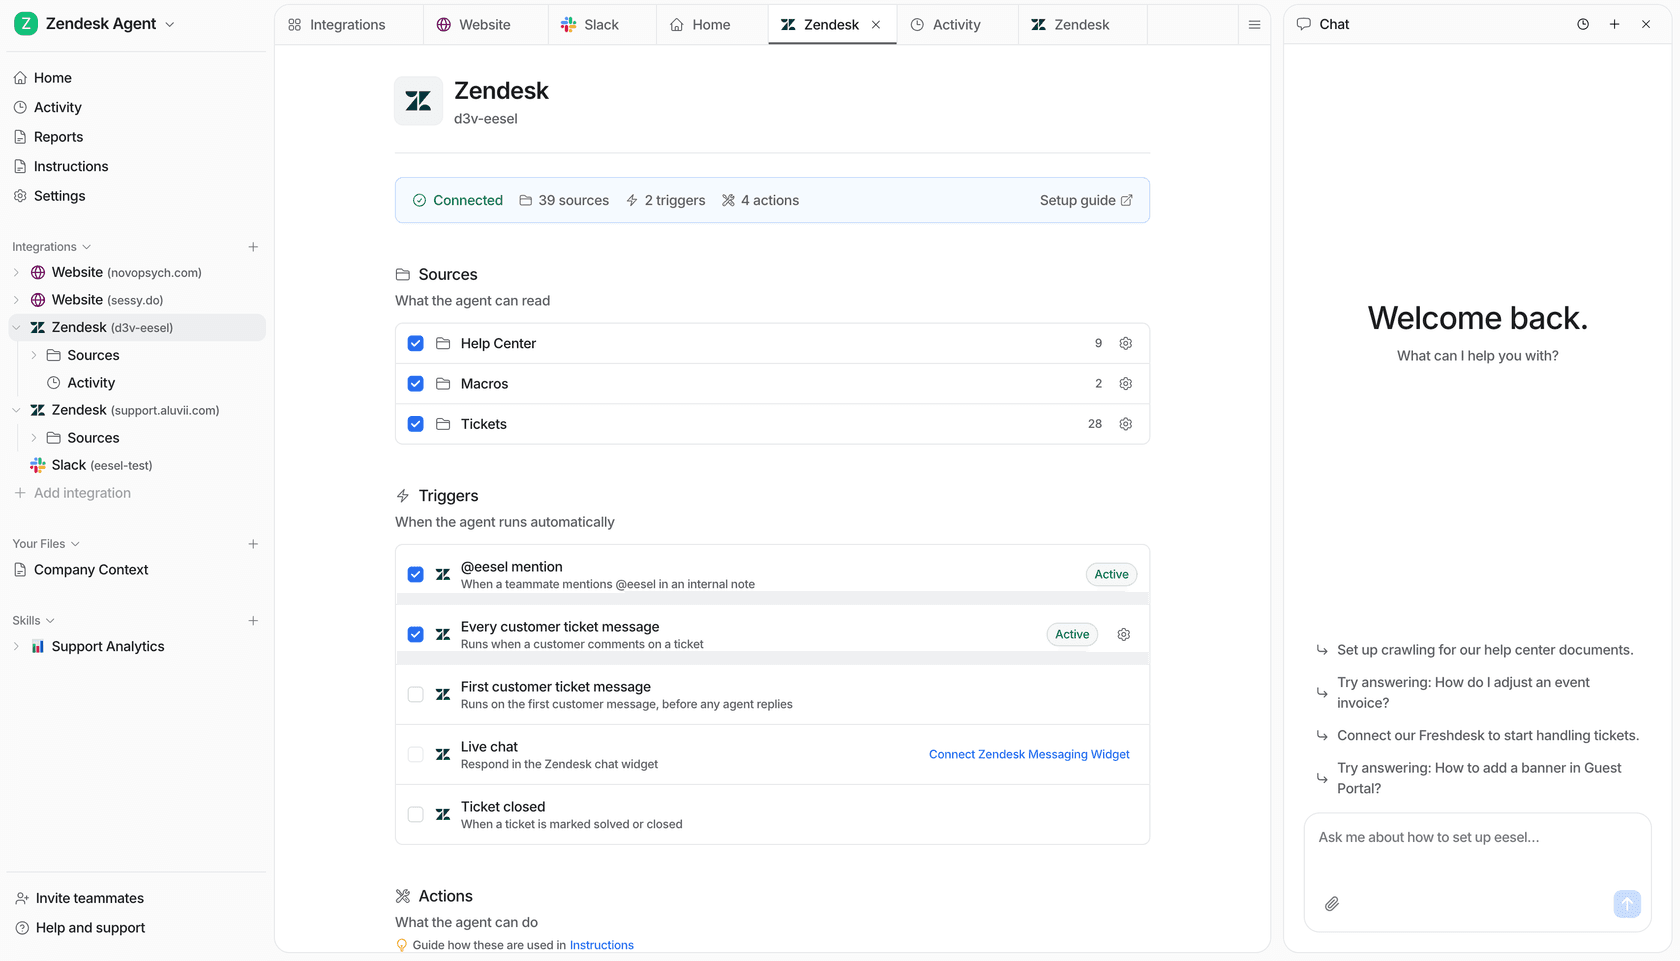
Von einem Terminal aus kann ein Coding-Agent eesel integrations sources zendesk ausführen, um zu sehen, was der Wissensdatenbank-Sync tatsächlich enthält, eine freigegebene Richtliniendatei hochladen und mit eesel chat Testfragen abschießen, bevor irgendetwas einen Kunden erreicht. Die Verbindung zum Helpdesk selbst muss weiterhin eine Person mit Admin-Zugang freigeben. Testen Sie eesel kostenlos und lassen Sie Ihre letzten zehn Tickets hindurchlaufen.