

Was ist ein Audit der Support-Wissensdatenbank?
Ein Audit der Support-Wissensdatenbank ist eine geplante Prüfung jedes Artikels in Ihrem Help Center (und der internen Dokumente, die Ihre Agenten und die KI lesen). Artikel für Artikel entscheiden Sie, ob er bleibt, korrigiert, in einen anderen Artikel eingearbeitet oder entfernt wird.
Es ist die Schwesteraufgabe zur Wissenslückenanalyse im Support. Die Lückenanalyse geht von Kundenfragen aus und fragt: "Was fehlt?" Das Audit geht von den Artikeln aus und fragt: "Stimmt das hier noch, wird es genutzt, und ist es die einzige Version?" Sie brauchen beides, aber die beiden erzeugen unterschiedliche To-do-Listen:
| Wissenslückenanalyse | Audit der Wissensdatenbank | |
|---|---|---|
| Ausgangspunkt | Tickets, fehlgeschlagene Suchen, KI-Eskalationen | Ihre Liste veröffentlichter Artikel |
| Frage, die es beantwortet | Was fragen Kunden, das niemand aufgeschrieben hat? | Ist jeder Artikel noch korrekt, genutzt und einzigartig? |
| Ergebnis | Zu schreibende Artikel | Artikel zum Behalten, Aktualisieren, Zusammenführen oder Archivieren |
| Typischer Rhythmus | Monatlich, aus frischen Ticketdaten | Vierteljährlich für Richtlinieninhalte, jährlich für den Rest |
| Größtes Risiko, das es findet | Kunden können eine häufige Frage nicht selbst lösen | Kunden (und die KI) erhalten eine falsche oder widersprüchliche Antwort |
Ich arbeite bei eesel jeden Tag in der Support-Queue, und das Audit ist die Aufgabe, die alle überspringen. Einen neuen Artikel zu schreiben (oder ihn mit KI zu erzeugen) fühlt sich nach Fortschritt an. 300 alte Artikel noch einmal zu lesen fühlt sich nach Hausaufgaben an. Aber die alten Artikel sind das, was Kunden und Bots gerade jetzt lesen, und ein selbstsicher falscher Artikel richtet mehr Schaden an als ein fehlender. Ein Kommentator in einem r/ITCareerQuestions-Thread hat es so gut gesagt wie kaum jemand:
"It leads to documentation become out of date and erroneous, which is often worse than nothing at all, and perpetuates the cycle."

Warum ein Audit wichtiger wird, wenn KI Ihr Help Center liest
Jahrelang war ein veralteter Artikel ein langsames Leck. Ein Kunde las ihn, wurde verwirrt und eröffnete ein Ticket. Ein Agent, der es besser wusste, antwortete richtig. Der Schaden war ein zusätzliches Ticket.
Ein KI-Agent nimmt dieses Sicherheitsnetz weg. Es ist das klassische KI-Halluzinations-Szenario, nur dass das Modell Ihre eigenen veralteten Worte getreu wiederholt. Es ruft den am besten passenden Artikel ab, antwortet selbstsicher, und dazwischen weiß niemand Bescheid. Ein Kommentator auf r/Rag hat den Mechanismus in einem Satz beschrieben:
"Your pipeline can retrieve an article successfully and still produce the wrong operational answer because the article itself is stale or incomplete."
So sieht das aus, wenn es beim Kunden ankommt:
"the two docs disagreeing thing is the scariest part, bot just picks whichever one it grabbed first and sounds totally sure about it we started doing the source-of-truth cleanup after one of our bots told a customer they could return something 3 years past the actual policy window, support had to eat that one"
Die Anbieter wissen das auch. Die Knowledge-Docs von Gorgias nennen genau dieses Beispiel: "if a help center article says your return window is 30 days but a guidance says 14, AI Agent might not respond the same way every time." Zendesk bewertet Help Center inzwischen in seinem Knowledge copilot nach "AI readability" und wertet Artikel ab, die medienlastig, lang, unstrukturiert oder linklastig sind. Das Audit ist leise zum Teil des Wissensmanagements für Support-Teams geworden, die einen KI-Agenten betreiben.
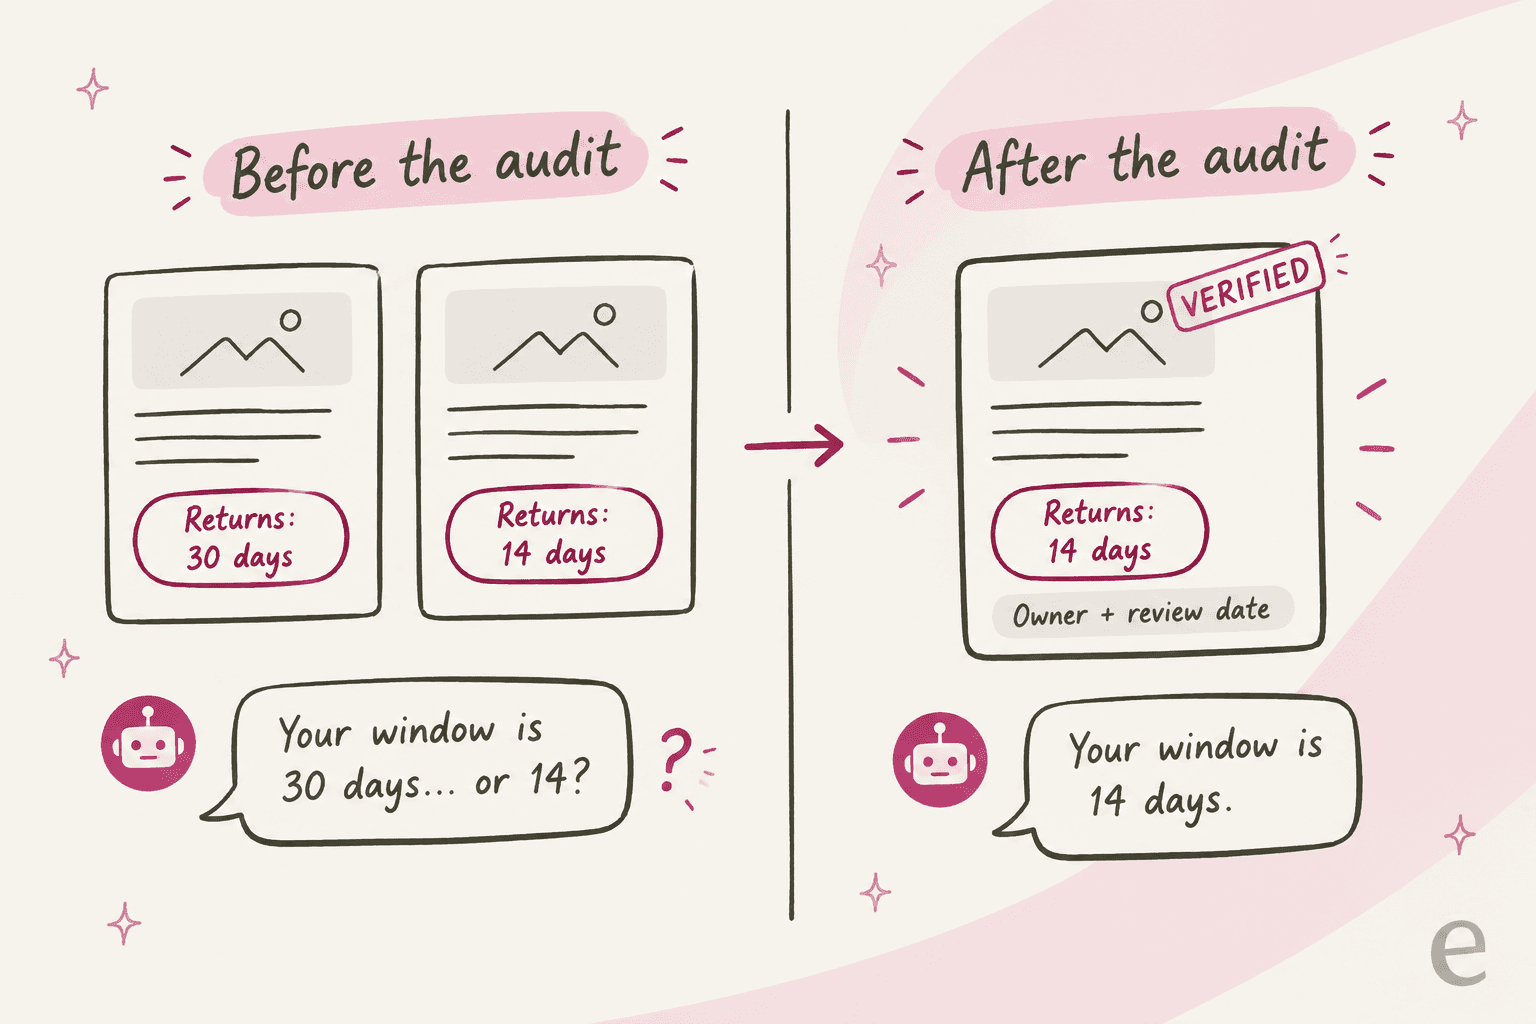
Daher kommt auch meine eigene Einschätzung. eesel setzt seit einigen Jahren ein KI-Teammitglied in laufende Support-Queues, und die erste Woche fast jedes Rollouts wird zu einem Wissens-Audit, ob jemand es geplant hat oder nicht. Ein typischer Fall aus den Verkaufsgesprächen von eesel: Eine DTC-Marke auf Gorgias mit rund 7.000 E-Mail-Tickets im Monat wollte, dass die KI die Hälfte davon löst. Ihr Wissen war verteilt auf SOPs in einem Projekt-Tool, nicht transkribierte Bildschirmaufnahmen und einen Haufen veralteter Makros, und es gab keine FAQ auf der Website. Keine KI kann genauer sein als ihr Quellmaterial. Deshalb wird jeder eesel-Rollout gegen vergangene Tickets simuliert, bevor er einem echten Kunden antwortet: In der Simulation tauchen die veralteten Artikel auf.
Was Sie vor dem Audit zusammenziehen sollten
Ein Audit geht schnell, wenn die Daten in einer Tabelle stehen, bevor jemand einen Artikel öffnet. Das würde ich in die Spalten schreiben und warum jede ihren Platz verdient.
| Spalte | Woher sie kommt | Was sie Ihnen sagt |
|---|---|---|
| Artikeltitel, URL, Bereich | Help-Center-Export oder API | Das Inventar selbst |
| Datum der letzten Aktualisierung | Artikelliste oder Export | Kandidaten für eine Prüfung auf Veraltung (Zendesks Copilot wertet sechs Monate als veraltet) |
| Verantwortlicher | Artikelautor oder zugewiesener Verantwortlicher | Wer die Korrektur freigibt |
| Aufrufe, letzte 90 Tage | Help-Center-Analytics | Ob ihn überhaupt jemand liest |
| Stimmen hilfreich / nicht hilfreich | Artikel-Feedback | Ob er die Frage beantwortet, wenn man ihn gelesen hat |
| Aus Tickets verlinkt | Artikellinks von Agenten, Makro-Verweise | Ob sich Agenten auf ihn verlassen |
| KI-Nutzung und Übergaben | Der Wissensbericht Ihres KI-Agenten | Ob der Bot ihn zitiert und ob diese Gespräche trotzdem eskalieren |
| Enthält Richtlinie, Preis oder Tarifnamen | Sie, beim Lesen des Titels | Ob er vierteljährlich statt jährlich geprüft werden muss |
Die letzte Zeile ist wichtiger, als sie aussieht. Bei Richtlinien- und Preisartikeln kostet eine falsche Antwort Geld, deshalb markiere ich sie zuerst und prüfe sie im kürzeren Takt. Der Leitfaden zu Richtlinienänderungen von eesel beschreibt, was Sie an dem Tag tun, an dem sich eine dieser Richtlinien ändert. Das Audit fängt die ab, die sich geändert haben, ohne dass jemand den Support informiert hat.
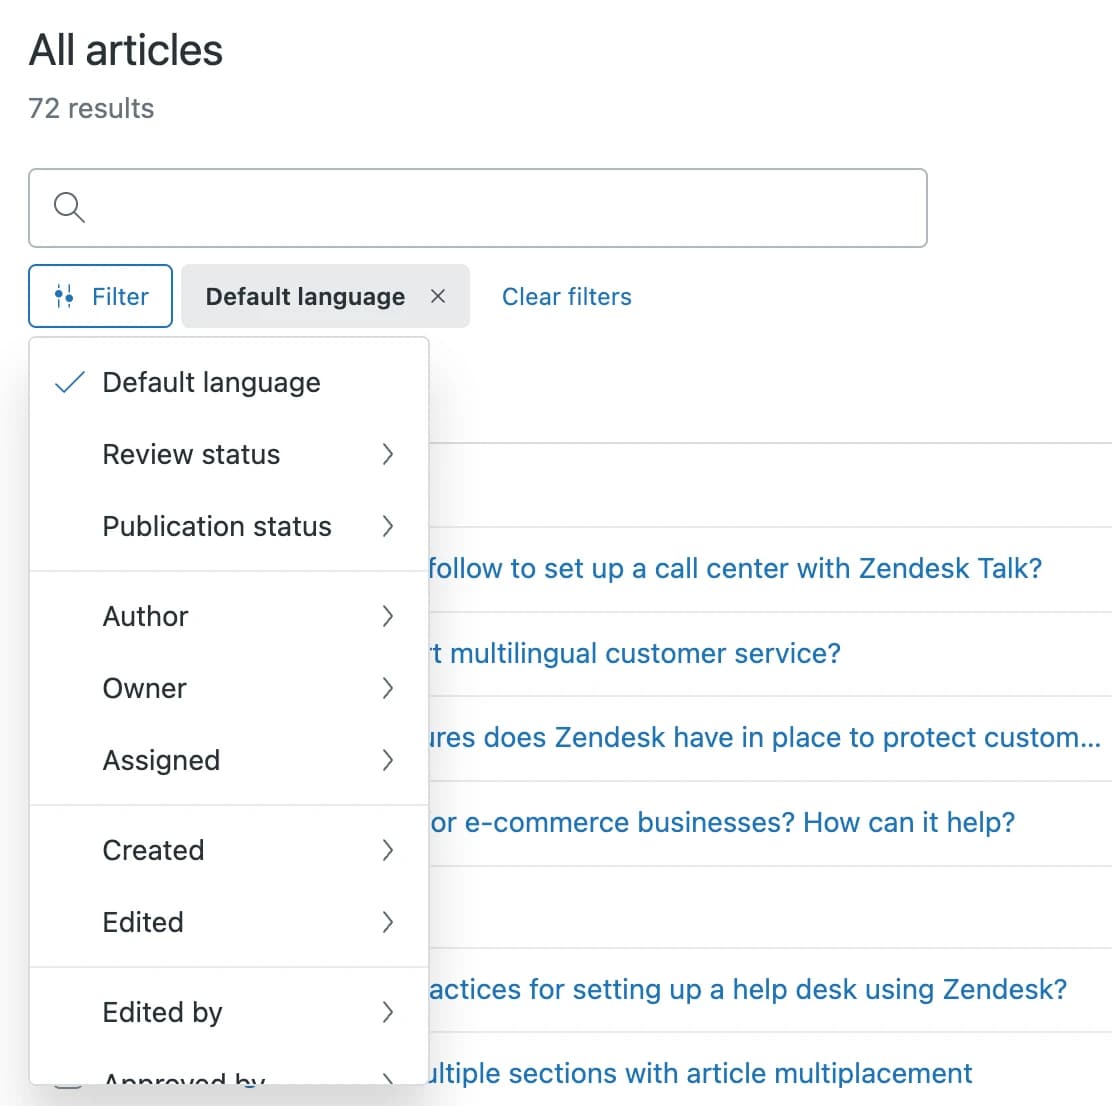
Die meisten dieser Spalten kommen direkt aus Ihrem Helpdesk. In Zendesk filtern die Artikellisten im Knowledge-Admin nach Verantwortlichem, Autor, Erstellungs- und Bearbeitungsdatum und Prüfstatus, und das Knowledge-Base-Dashboard sortiert Artikel nach Upvotes, Downvotes und Netto-Stimmen.
Der kuratierte Wissensdatenbank-Bericht von Freshdesk hat ab Pro eine fertige Liste der "10 am wenigsten aufgerufenen" und "meistkritisierten" Artikel. Der Analyze-Tab von HubSpot zeigt Aufrufe, hilfreiche und nicht hilfreiche Stimmen und Suchbegriffe ohne Ergebnis, und der Docs-Bericht von Help Scout markiert Artikel mit weniger als 60 % positiven Bewertungen mit einem traurigen Gesicht.
Eine Zendesk-Kennzahl würde ich immer ergänzen: "Tickets submitted after view" im Explore-Dataset zur Seiteneffizienz. Zendesk beschreibt sie als Weg, "articles where users couldn't get the answers they needed" zu finden. Eine hohe Zahl bei einem viel gelesenen Artikel ist das deutlichste Zeichen, dass er neu geschrieben werden muss. Sie erfordert Suite Professional oder Explore Professional und höher.
So sortieren Sie Artikel: behalten, aktualisieren, zusammenführen oder archivieren
Jeder Artikel landet am Ende des Audits in einem von vier Eimern. Zwei Fragen entscheiden über den Eimer: Wird er genutzt, und stimmt er noch? Duplikate sind die dritte Frage, denn zwei Kopien derselben Antwort sind der Weg, auf dem sich ein Help Center selbst widerspricht.
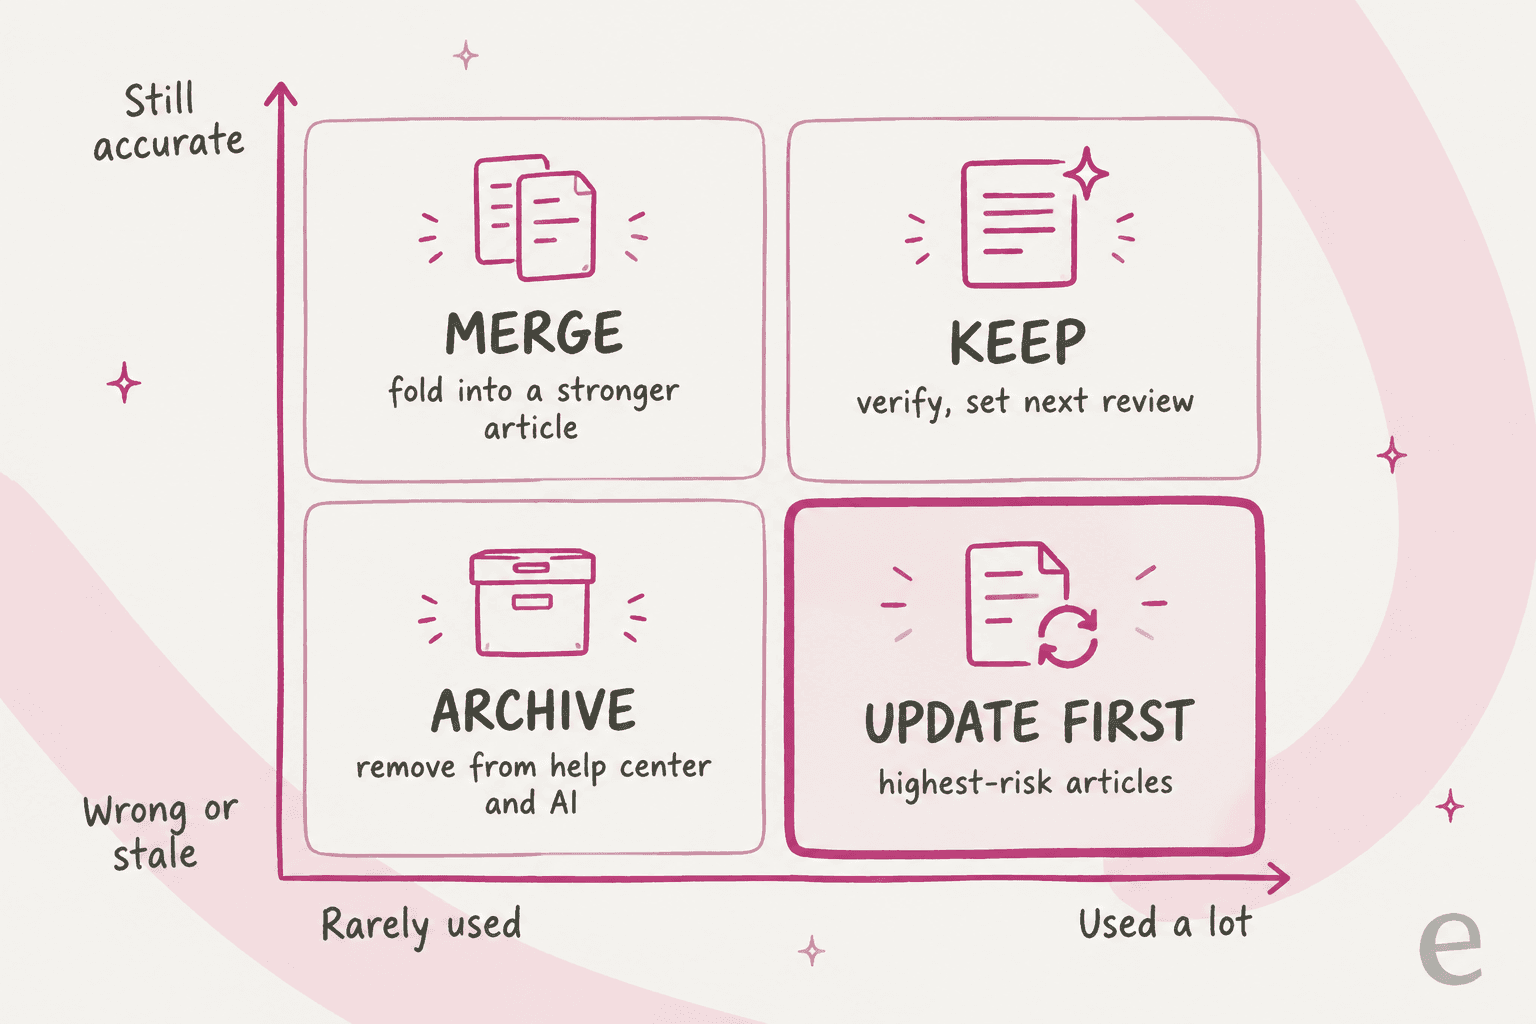
- Behalten: genutzt und korrekt. Als verifiziert markieren, einen Verantwortlichen benennen, das nächste Prüfdatum setzen.
- Zuerst aktualisieren: genutzt und falsch. Diese kommen ganz oben auf die Liste, denn sie führen Kunden heute in die Irre.
- Zusammenführen: korrekt, aber ein zweiter Artikel beantwortet dieselbe Frage. Das Nützliche in den stärkeren Artikel einarbeiten und die alte URL weiterleiten.
- Archivieren: ungenutzt und falsch oder zu einer Funktion oder Richtlinie, die es nicht mehr gibt. Aus dem Help Center und aus allem entfernen, was Ihr KI-Agent liest.
Probieren Sie es an einem Artikel aus Ihrem eigenen Help Center:
Behalten, aktualisieren, zusammenführen oder archivieren? Einen Artikel einordnen
Beantworten Sie drei Fragen zu einem einzelnen Help-Center-Artikel. Das Ergebnis sagt Ihnen, was Sie in diesem Audit mit ihm tun.
1. Wurde er in den letzten 90 Tagen genutzt?Artikelaufrufe, Links aus Tickets oder Zitate Ihres KI-Agenten.
2. Stimmt noch jede Angabe darin?Preise, Tarifnamen, Fristen, Screenshots, Schritte.
3. Beantwortet ein anderer Artikel dieselbe Frage?Suchen Sie im Help Center nach der Hauptfrage des Artikels.
Zwei Abwägungen, die Ihnen das Raster nicht abnimmt. Erstens: "ungenutzt" heißt nicht "nutzlos". Ein korrekter Artikel, den niemand liest, ist oft ein Titelproblem und kein Inhaltsproblem: Kunden suchen nach "Abo kündigen", und der Artikel heißt "Ihren Tarif verwalten". Vergleichen Sie die Titel mit Ihren Begriffen aus fehlgeschlagenen Suchen, bevor Sie archivieren. Zweitens: Richten Sie eine Weiterleitung ein, bevor Sie etwas archivieren (hier steht, wie Weiterleitungen in Zendesk funktionieren). Alte Artikellinks stecken in Makros, gespeicherten Antworten und früheren E-Mails, und ohne Weiterleitung brechen sie alle an dem Tag, an dem der Artikel verschwindet.
So führen Sie ein Audit der Support-Wissensdatenbank Schritt für Schritt durch
Das ist die Schleife, die ich von Anfang bis Ende fahren würde. Der erste Durchlauf ist der langsame. Wiederholungen gehen deutlich schneller, weil die meisten Artikel bei "behalten" landen und nur die fälligen komplett gelesen werden müssen.
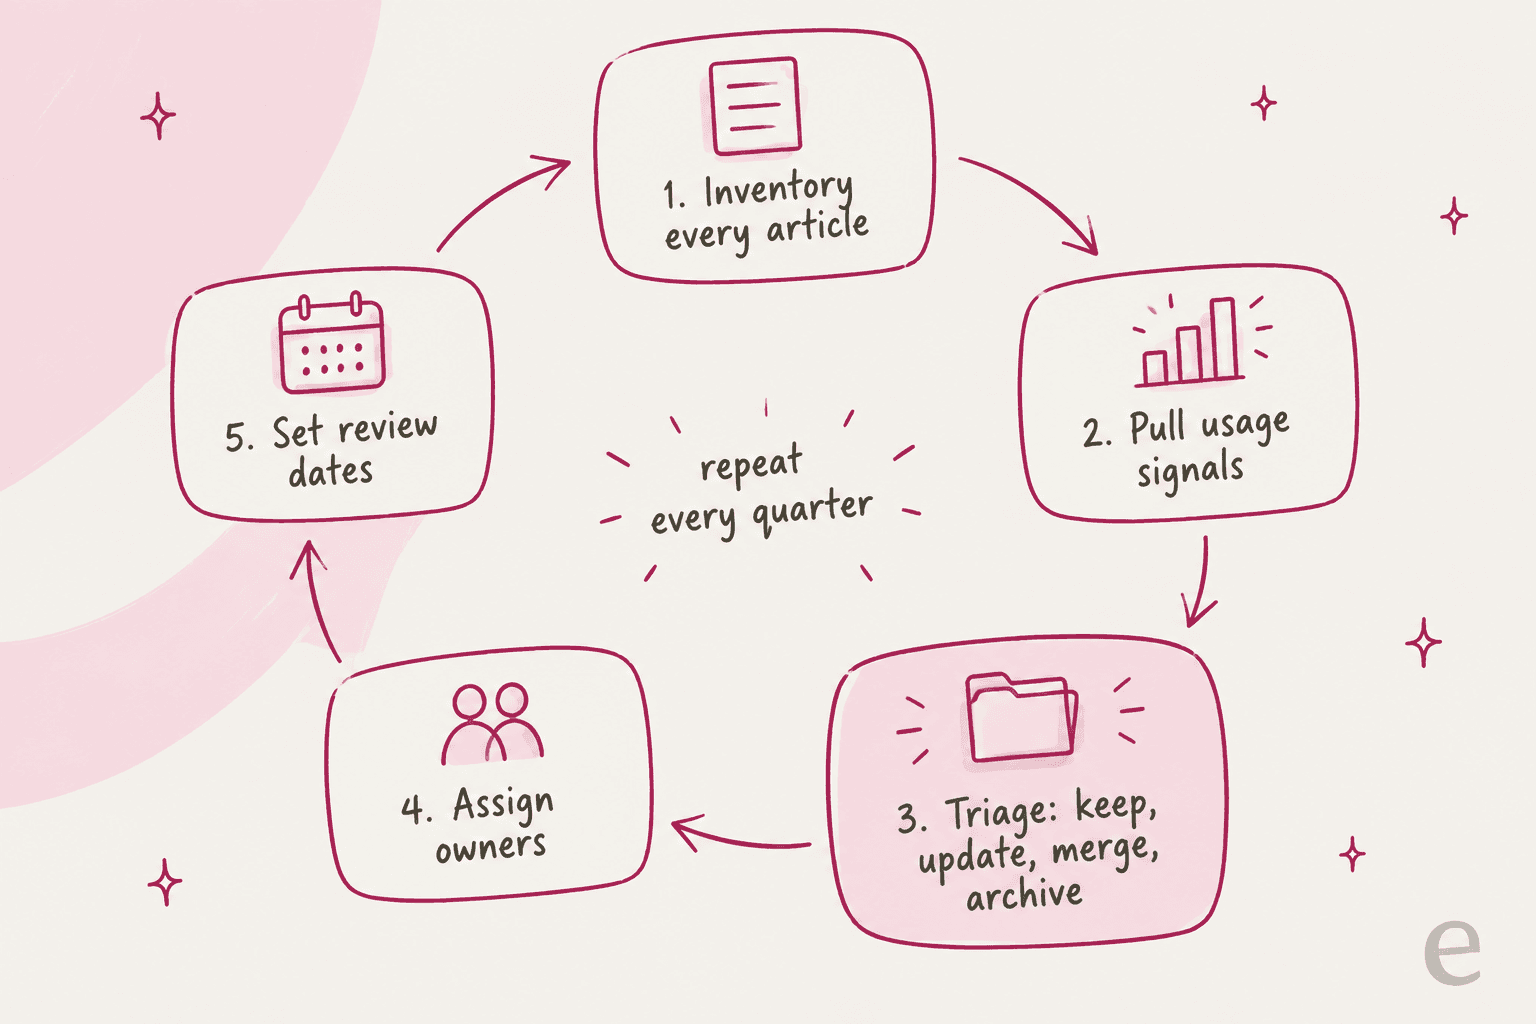
Schritt 1: Jeden Artikel inventarisieren, auch die, die Kunden nicht sehen
Exportieren Sie die vollständige Artikelliste: öffentliche Artikel, rein interne Artikel, Entwürfe und jede Sprachversion. Ergänzen Sie dann die Orte, aus denen Ihr KI-Agent liest und die gar keine Artikel sind. Meist sind das Makros und gespeicherte Antworten, ein Confluence- oder Google-Drive-Ordner mit SOPs und alle Website-Seiten, die die KI durchsucht. Die Docs zur KI von Help Scout weisen darauf hin, dass die "Improvements" der AI Answers eine eigene Wissensquelle sind, sodass eine alte Improvement eine veraltete Antwort weiter wiedergeben kann, nachdem Sie das Doc korrigiert haben. Das Audit muss jede Quelle abdecken, sonst überlebt die alte Antwort irgendwo.
Schritt 2: 90 Tage Nutzungssignale ziehen
Füllen Sie für jede Zeile Aufrufe, Stimmen, Ticket-Links und KI-Nutzung aus. 90 Tage sind lang genug, um saisonale Spitzen zu glätten, und kurz genug, dass die Daten Ihr aktuelles Produkt widerspiegeln. Sortieren Sie absteigend nach Aufrufen. Am Kopf dieser Liste verbringen Sie den größten Teil Ihrer Prüfzeit.
Schritt 3: Jeden Artikel in einen Eimer sortieren
Lesen Sie jeden Artikel im oberen Traffic-Bereich vollständig. Bei den seltener gelesenen reicht Überfliegen: Datum der letzten Aktualisierung, ob die Funktion noch existiert und ob die Screenshots zur aktuellen Oberfläche passen. Der Leitfaden zum Erkennen veralteter Inhalte nennt weitere Hinweise. Ordnen Sie jeden in behalten, aktualisieren, zusammenführen oder archivieren ein. Beantworten zwei Artikel dieselbe Frage, entscheiden Sie gleich, welcher der maßgebliche ist, solange beide offen sind.
Schritt 4: In der Reihenfolge der Priorität korrigieren
Arbeiten Sie zuerst den Eimer "zuerst aktualisieren" ab, dann die Zusammenführungen, dann die Archivierungen. Ändern Sie bei jedem aktualisierten Artikel die Fakten, erneuern Sie die Screenshots und schreiben Sie den Titel in den Worten um, mit denen Kunden tatsächlich suchen. Wenn Sie Inhaltsblöcke oder gemeinsame Snippets für Dinge wie eine Rückgabefrist nutzen, aktualisieren Sie den Block einmal statt jeden Artikel. Testen Sie dann Ihren KI-Agenten erneut zum Thema dieses Artikels, denn der Artikel ist nur die Hälfte dessen, was er liest (hier steht, warum eine Dokumentationsänderung besser ist als Nachtrainieren).
Schritt 5: Verantwortliche zuweisen und Prüfdaten setzen
Dieser Schritt entscheidet, ob Sie in einem Jahr wieder bei null anfangen. Jeder Artikel bekommt einen namentlich genannten Verantwortlichen (eine Person, nicht "Support") und ein nächstes Prüfdatum. Wenn Sie zusätzlich eine Freigabe wollen, ergänzen Zendesk-Freigabe-Workflows sie. Ich würde zwei Takte nutzen: vierteljährlich für alles mit Richtlinie, Preis, Tarifnamen oder rechtlichem Begriff, jährlich für den Rest. Lassen Sie dann den Helpdesk die Leute erinnern, und dafür kommt die native Funktionalität unten ins Spiel.
Schritt 6: Die Schleife jedes Quartal wiederholen
Das zweite Audit ist viel schneller als das erste, weil Verantwortliche und Prüfdaten die meiste Arbeit erledigen. Ziehen Sie jedes Quartal frische Signale, prüfen Sie nur die fälligen Artikel oder die, deren Zahlen sich bewegt haben (ein Sprung bei "nicht hilfreich"-Stimmen, mehr KI-Übergaben zu diesem Thema), und archivieren Sie alles, was zwei Quartale in Folge null Aufrufe hatte.
Welche Helpdesks beim Audit helfen und was gesperrt ist
Keiner der großen Helpdesks führt das ganze Audit für Sie durch, und die Funktionen, die am meisten leisten, liegen in höheren Tarifen. Das bietet jeder nativ, laut den Docs des jeweiligen Anbieters.
| Helpdesk | Alte Artikel finden | Prüferinnerungen oder Verifizierung | Nutzungsdaten pro Artikel | Massenarchivierung | Hinweise zum Tarif |
|---|---|---|---|---|---|
| Zendesk | Artikellisten filtern nach Verantwortlichem, erstellt, bearbeitet | Verifizierungsregeln, bis zu 20, wöchentlicher Lauf | Aufrufe, Stimmen, Tickets nach Aufruf eingereicht | 30 Artikel auf einmal, alle Tarife | Verifizierung und Massenverifizierung nur Enterprise |
| Freshdesk | Filter nach "Last modified at" | Keine dokumentiert | Am wenigsten aufgerufen, meistkritisiert, Feedback-Tickets | Massenaktionen | Filter, Massenaktionen und Berichte ab Pro |
| Gorgias | Wissen nach letzter Aktualisierung filtern (7 bis 90 Tage) | Keine dokumentiert | Tickets, Übergaben, CSAT pro Artikel (28 Tage) | Massenweise aktivieren, deaktivieren, löschen | Opportunities markiert widersprüchliches Wissen (Beta) |
| Front | Filter nach Prüfstatus und Datum | Geplante Prüfungen mit täglichen Erinnerungs-E-Mails | Wissensdatenbank-Bericht | Prüfungen pro Bereich in Masse planen | Prüfungen ab Professional (65 $/Platz) |
| Zoho Desk | Filter nach Ablauf heute, 7 oder 30 Tage | Artikelablauf mit E-Mails an Verantwortliche | KB-Dashboard, fehlgeschlagene Suchbegriffe | Tags, Verantwortliche, Status in Masse ändern | Dashboard ab Standard |
| HubSpot | Artikelliste; Datum der letzten Aktualisierung wird bei jeder Veröffentlichung gesetzt | Keine; Beta-KB-Agent schlägt Änderungen vor | Aufrufe, hilfreiche Stimmen, Suchen ohne Ergebnis | Archivieren und Veröffentlichung zurücknehmen | KB erfordert Service Hub Professional (90 $/Platz) |
| Help Scout | Keine Sortierung nach letzter Aktualisierung in der App (nur API) | Keine dokumentiert | Bewertungen, fehlgeschlagene Suchen | Keine Massenbearbeitung in der App | Berichtsverlauf: 2 Jahre in Standard |
Ein paar davon verdienen einen genaueren Blick, weil sie verändern, wie viel vom Audit Sie von Hand erledigen.
Zendesk: Verifizierungsregeln und Knowledge copilot
Zendesk hat das vollständigste Toolkit, auf mehrere Tarife verteilt, und der Versionsverlauf der Artikel macht Rollbacks sicher. Mit der Artikelverifizierung legen Sie bis zu 20 Regeln mit einer Häufigkeit (zwei Wochen, sechs Monate, ein Jahr) und Filtern nach Marke, Bereich oder Label an. Die Regeln laufen wöchentlich, nicht verifizierte Artikel landen in einer Liste "Needs verification", und Verantwortliche erhalten zweiwöchentlich E-Mails, bis sie verifizieren. Es ist genau die Gewohnheit mit Prüfdaten aus Schritt 5, automatisiert, erfordert aber Suite Enterprise oder Knowledge Enterprise, ein Tarif nur auf Anfrage.
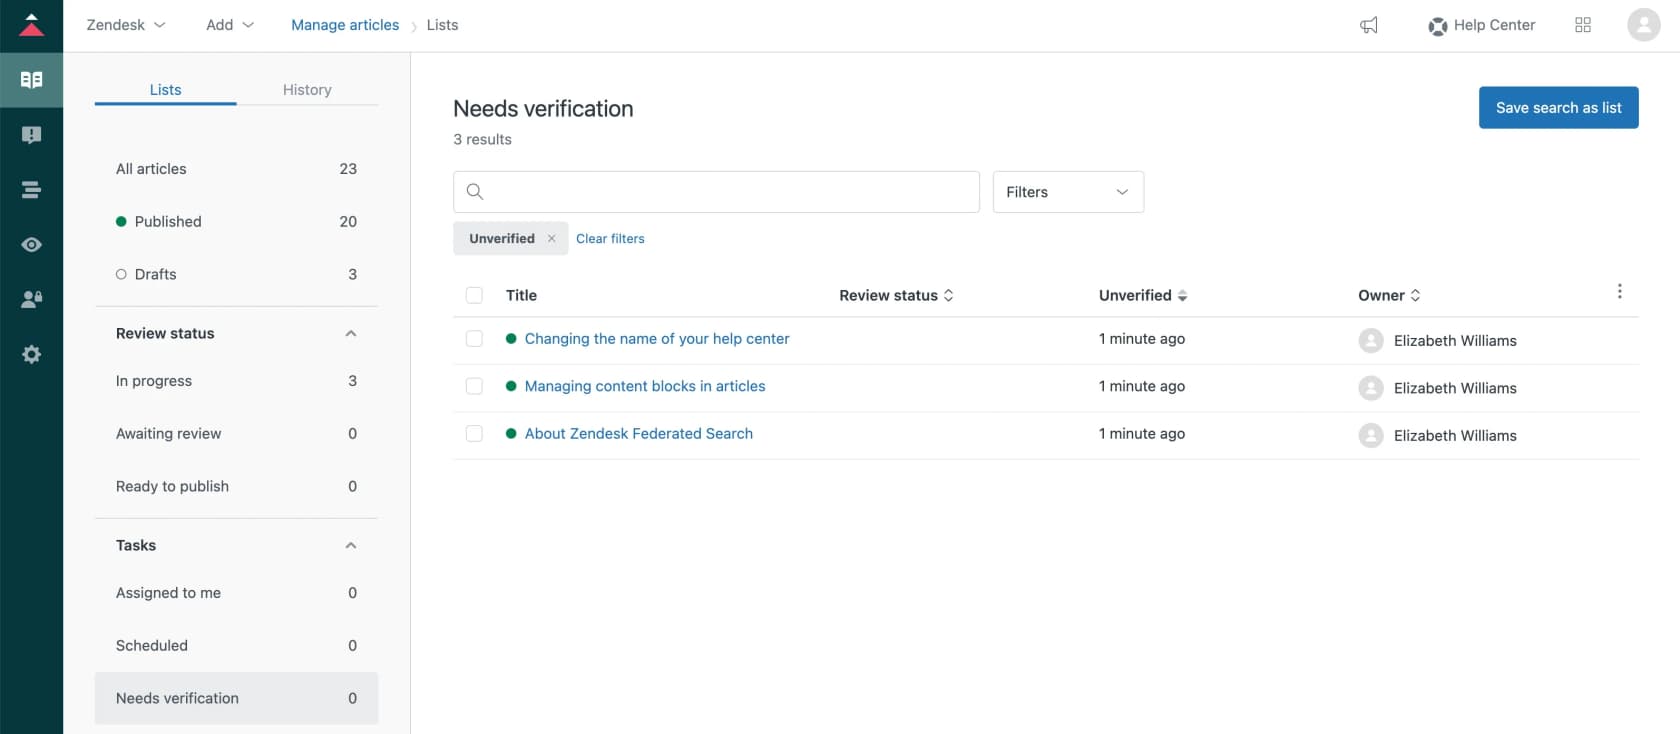
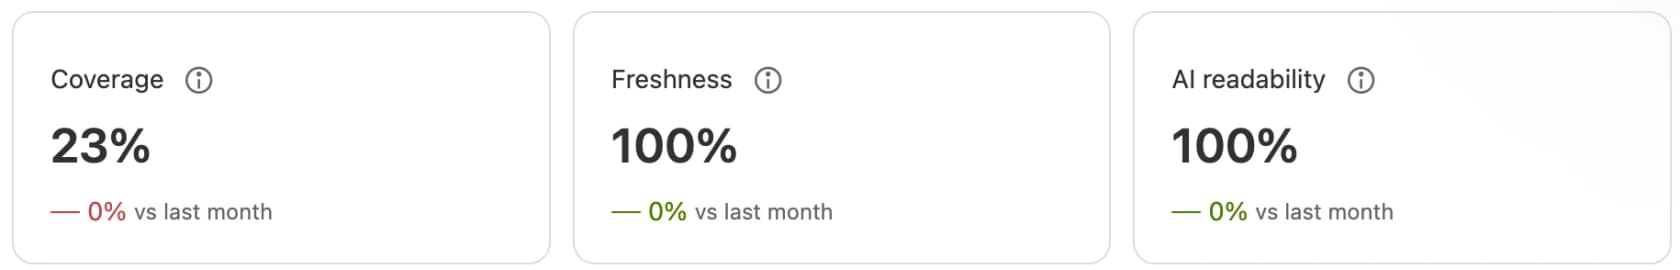
Das Neuere ist Knowledge copilot, ein Early-Access-Programm ab Suite Professional. Es bewertet Ihr Help Center wöchentlich nach Coverage (für wie viele häufige Ticket-Themen es einen Artikel gibt), Freshness (Artikel, die sechs Monate nicht aktualisiert wurden, senken die Bewertung) und AI readability und schlägt Aufgaben zum Erstellen, Aktualisieren oder Ablehnen vor. Nichts wird von selbst veröffentlicht; alles landet als Entwurf. Betrachten Sie es als dauerhaftes Audit-Dashboard und nicht als Ersatz für ein Audit.
Für die Bereinigung selbst können Sie in Zendesk 30 Artikel auf einmal auswählen und in jedem Tarif archivieren. Zwei Dinge sollten Sie vorher wissen: Archivieren entfernt den Artikel samt allen Übersetzungen, und nur Knowledge-Admins sehen archivierte Artikel oder können sie wiederherstellen, und sie kommen als Entwürfe zurück. Archivierte Artikel zählen außerdem nicht mehr zum Limit von 40.000 Artikeln bei Zendesk.
Front: geplante Prüfungen mit Erinnerungen
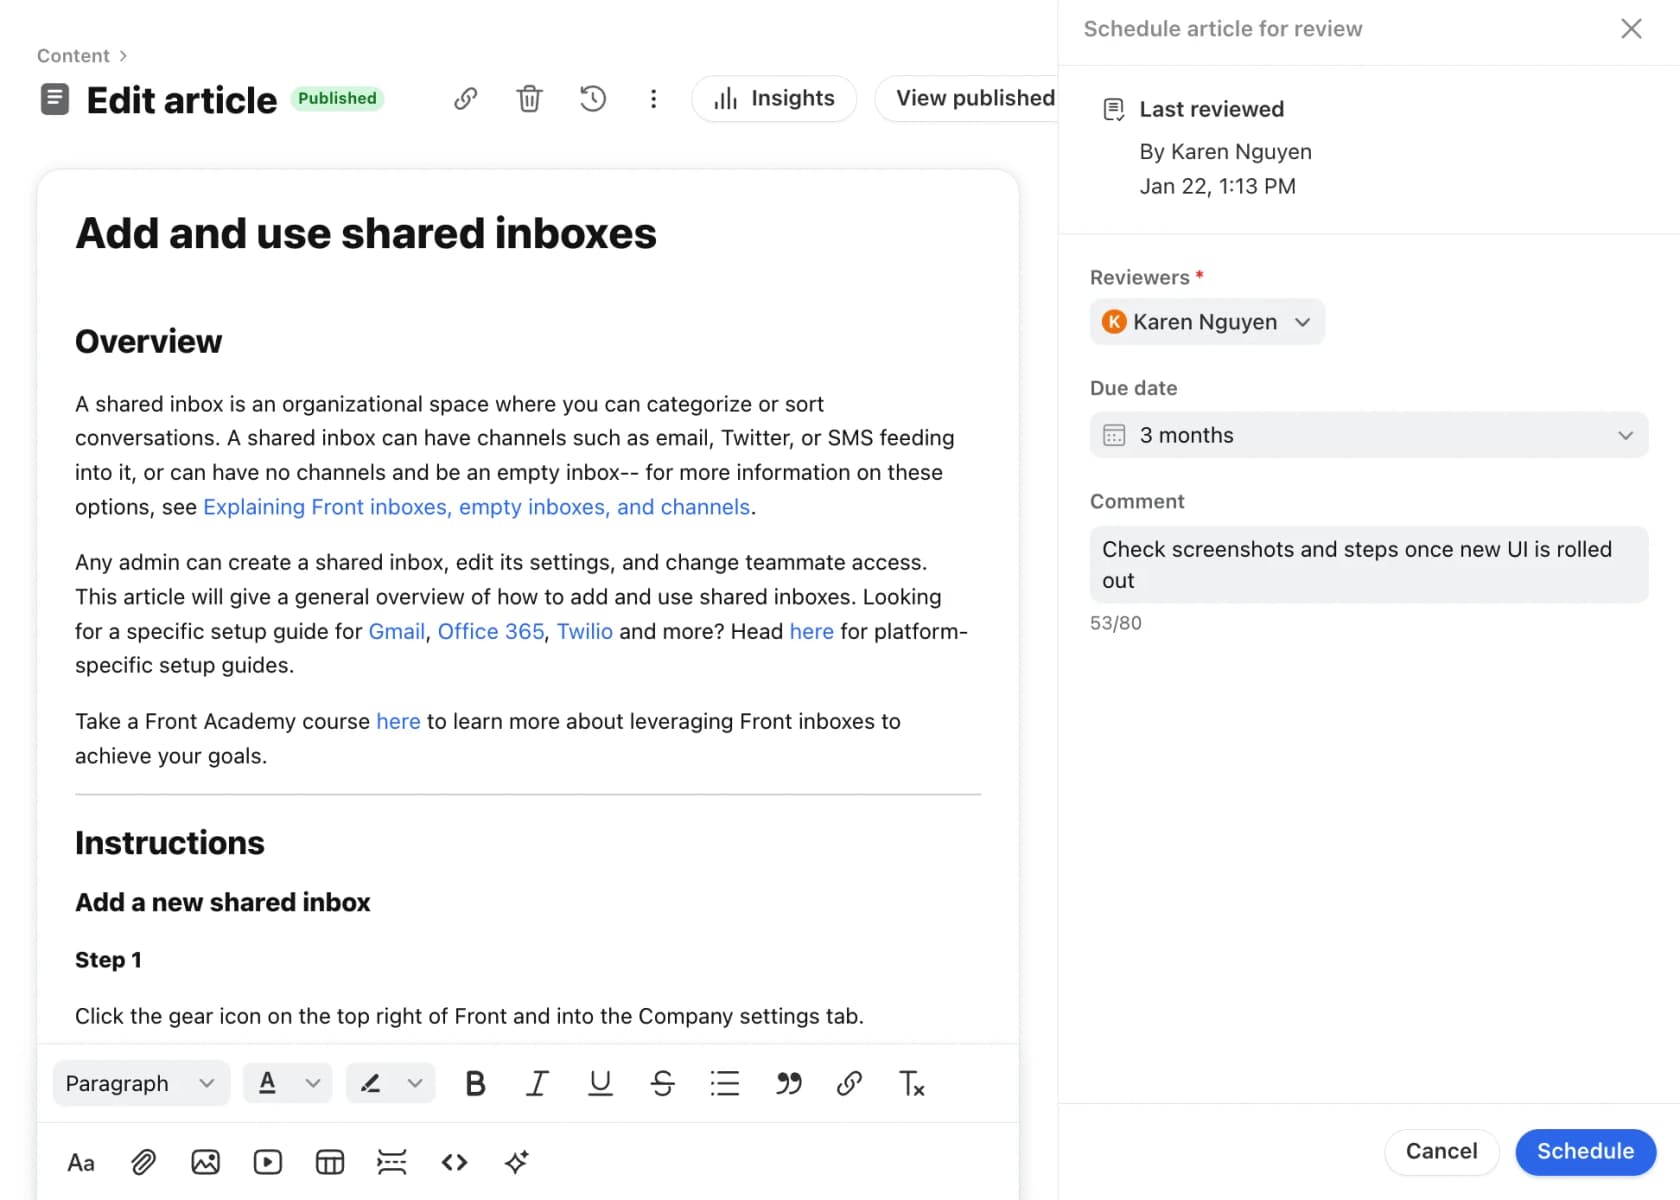
Fronts geplante Prüfungen sind die sauberste Version von "Prüfdatum setzen und erinnert werden". Sie wählen Prüfer, ein Fälligkeitsdatum und einen Kommentar; die Prüfer erhalten täglich eine Erinnerungs-E-Mail mit den an diesem Tag fälligen und überfälligen Prüfungen, und Sie können Prüfungen pro Kategorie oder Bereich in Masse planen oder abschließen. Es ist im aktuellen Professional-Tarif (65 $ pro Platz und Monat) und höher enthalten.
Zoho Desk: Artikel, die von selbst ablaufen
Zoho Desk ist in dieser Gruppe der einzige, der einen Artikel automatisch außer Dienst stellen kann. Sie setzen ein Ablaufdatum, und der Artikel "will no longer be available in the help center", wenn es erreicht ist; der Verantwortliche erhält E-Mails sieben Tage vorher, am Tag vorher und bei Ablauf. Bei einer Saisonaktion oder einer zeitlich begrenzten Richtlinie erledigt sich das Audit damit selbst. Das Wissensdatenbank-Dashboard listet außerdem "Failed"-Suchbegriffe ab Standard (14 $ pro Agent und Monat bei jährlicher Zahlung).
Gorgias: Nutzung pro Artikel und ein Konfliktfinder
Gorgias setzt auf Nutzungsdaten. Jedes Stück Wissen zeigt Leistungswerte (Ticketvolumen, Übergaben, durchschnittlicher CSAT und Intent) der letzten 28 Tage, und Sie können Wissen nach letzter Aktualisierung filtern (7, 30, 60 oder 90 Tage). Das Highlight für Audits sind die Opportunities, eine Beta, die "Resolve knowledge conflict"-Einträge markiert und die zwei widersprüchlichen Stücke nebeneinander zeigt. Das ist der Eimer "zusammenführen", für Sie gefunden.
Freshdesk, HubSpot und Help Scout: Berichte statt Erinnerungen
Diese drei liefern gute Nutzungsdaten und überlassen den Prüfplan Ihnen. Freshdesk nennt seine Artikel Lösungsartikel.
Freshdesk macht aus Leser-Feedback Tickets: Stimmt jemand bei einem Artikel mit "No" ab und fügt einen Kommentar hinzu, wird daraus ein Ticket, bei dem der Artikelautor als Beobachter hinzugefügt wird, ein kostenloses Audit-Signal.
Die Wissensdatenbank von HubSpot hat keine Funktion für Prüfdaten; der Knowledge-Base-Agent in der Beta schlägt Änderungen an unklaren oder veralteten Artikeln vor, zu 200 HubSpot Credits pro erzeugtem Artikel.
Help Scout Docs führt einen Revisionsverlauf, hat aber keine geplante Prüfung, daher ist eine Kalendererinnerung Ihre Verifizierungsregel.
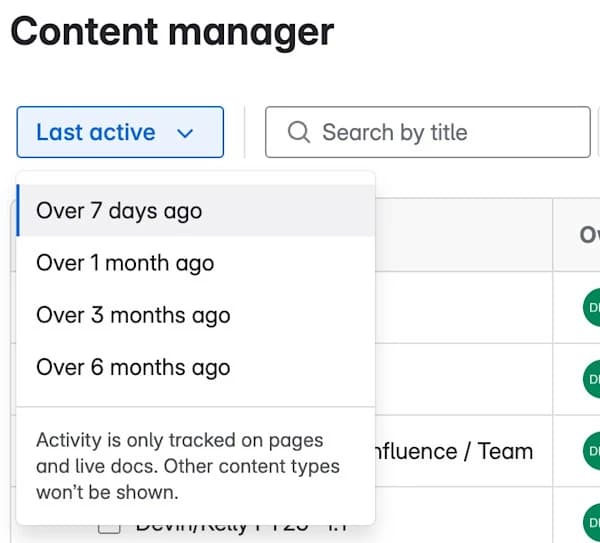
Liegt Ihre interne Wissensdatenbank in Confluence, filtert der Content Manager in Premium und Enterprise Seiten nach "Last active" (über 7 Tage bis über 6 Monate) und nach deaktivierten Verantwortlichen und archiviert bis zu 500 Seiten auf einmal. Archivierte Seiten behalten funktionierende Links, weshalb Confluence der mildeste Ort ist, um konsequent zu sein.
Was Support-Teams zur Pflege einer Wissensdatenbank sagen
Die Community-Threads dazu sind erfrischend einig: Das Tooling zählt weniger als die Frage, ob jemand die Aufgabe besitzt.
Der häufigste Wunsch ist der, den Zendesk bereits gebaut hat, hinter einer Tarifschranke. Ein Zendesk-Admin fragte auf r/Zendesk genau danach:
"Has anyone found an integration or way to audit articles yearly? It would be nice if there was a way to set a "renewal date" or something similar that would notify the author on a set date."
Einen Tag später, nachdem jemand auf die Artikelverifizierung hingewiesen hatte, ergänzte derselbe Admin: "Looks like Enterprise level is required and we are on professional." Diese Lücke füllen die meisten mittelgroßen Teams mit einer Tabelle und einer Kalendererinnerung.
Das Modell aus Verantwortlichem plus Ablaufdatum hat seine Fans und einen bekannten Fehlermodus. Ein Hacker-News-Kommentator schlug vor, Dokumentation wie medizinische Fachliteratur zu behandeln:
"every page is owned and every page has an expiry: when a page expires, the owners are obligated to review it."

Die Antwort im selben Thread gehört über Ihren Monitor geklebt:
"This becomes a problem if multiple people leave at once or someone is very busy when expiration comes up and rubber stamps the renewal with outdated information..."
Deshalb würde ich Prüfdaten mit Nutzungsdaten kombinieren, damit eine fällige Prüfung bei einem viel gelesenen Richtlinienartikel eine echte Lektüre bekommt und keinen Klick. Auf der Nutzungsseite beschrieb ein Sysadmin eine einfache Regel:
"if an article has not been viewed in one or two years then it automaticlly gets archieved and not part of then main search process, or it flags itself for review and then gets archieved."
Und wenn der Bot auf dieselbe Frage unterschiedliche Antworten gibt, nennt dieser Kommentar auf r/customerexperience die übliche Ursache:
"They are pulling from different KB entries, or one entry is outdated and the others are not, so the bot is not actually being inconsistent. It is being accurate to three slightly different pieces of content that should have been one."
"Three pieces of content that should have been one" ist der Eimer "zusammenführen" in einem Satz. Und wenn der Rückstand zu groß wirkt, widerstehen Sie dem Drang, eine neue Wissensdatenbank zu starten. Wie ein HN-Kommentator warnte, verfällt die neue "quickly falls into disarray just the same", und dann suchen Sie in zwei. Prüfen Sie die, die Sie haben.
Fehler, die ein Audit der Wissensdatenbank verschwenden
- Artikel prüfen, aber keine Makros. Agenten fügen Makros weit öfter ein, als sie Artikel verlinken, und Ihr KI-Agent liest sie womöglich auch. Ein Makro, das die Rückgabefrist vom letzten Jahr nennt, macht den soeben korrigierten Artikel zunichte. Zendesk-Teams können Makros exportieren, um sie in einer Datei zu durchsuchen. Der Leitfaden zur Makro-Verwaltung beschreibt die Bereinigung.
- Archivieren ohne Weiterleitungen. Alte URLs stecken in gespeicherten Antworten, früheren E-Mails und anderen Artikeln. Eine Archivierung ohne Weiterleitung macht aus einer veralteten Antwort einen toten Link.
- Das Help Center korrigieren und die anderen Quellen der KI vergessen. Liest Ihr KI-Agent auch eine durchsuchte Website, einen Google-Drive-Ordner oder ein internes Wiki, überlebt die alte Antwort dort, bis die Quelle neu synchronisiert oder die alte Datei entfernt wird.
- Am Ende kein Verantwortlicher. Ein Audit ohne Verantwortliche und Prüfdaten ist eine einmalige Bereinigung, keine Verwaltung der Wissensdatenbank. In einem Jahr stehen Sie wieder am Anfang.
- "Nicht aufgerufen" mit "nicht nötig" verwechseln. Prüfen Sie zuerst den Titel gegen fehlgeschlagene Suchen oder machen Sie eine schnelle Wissenslücken-Prüfung. Viele korrekte Artikel mit wenig Traffic heißen einfach in den Worten Ihres Teams statt in denen des Kunden.
- Alles in einer Sitzung erledigen wollen. Machen Sie den oberen Traffic-Bereich gründlich und arbeiten Sie den Rest in den folgenden Wochen ab. Ein abgeschlossenes Teil-Audit ist besser als ein abgebrochenes vollständiges.
eesel für das Audit Ihrer Support-Wissensdatenbank
Ein Audit korrigiert die Artikel. Der schwierigere Teil ist, Woche für Woche zu wissen, aus welchem Artikel eine Antwort tatsächlich stammt. Genau das soll Ihnen das KI-Helpdesk-Teammitglied von eesel zeigen.
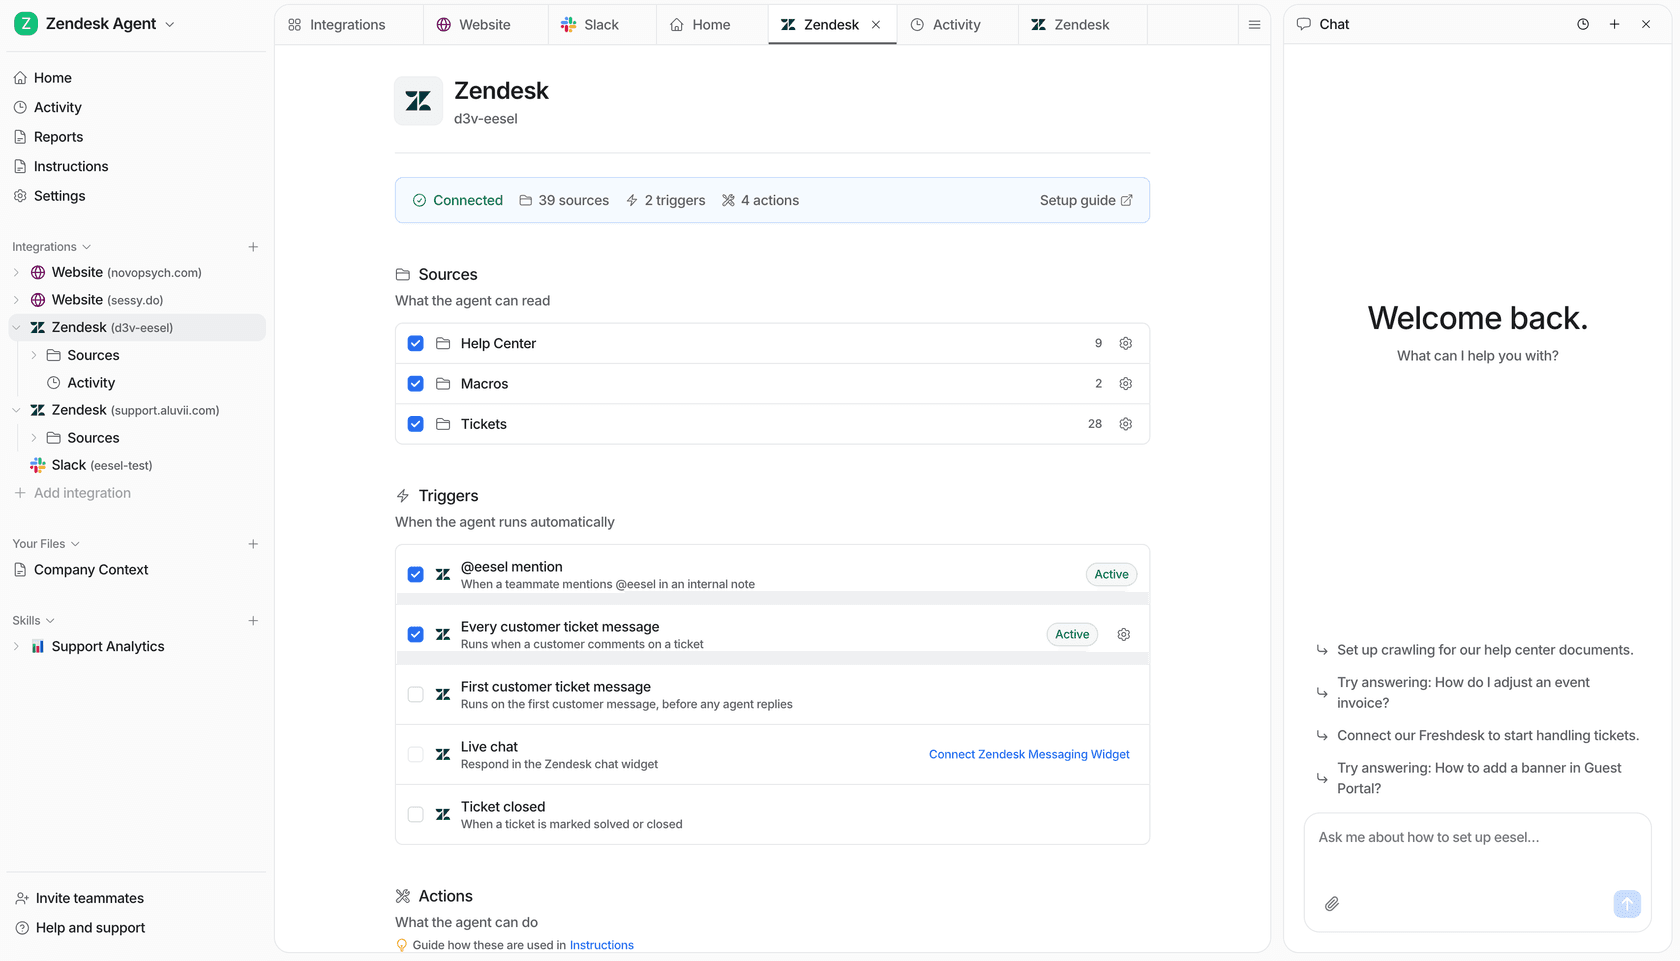
Es bindet sich an Zendesk, Freshdesk und den Rest Ihres Helpdesk-Stacks an und liest Ihr Help Center, Ihre Makros und vergangene Tickets zusammen mit Dokumenten in Confluence, Google Drive oder Notion. Jede Quelle hat einen eigenen Schalter, sodass Sie an dem Tag, an dem Ihr Audit einen veralteten Ordner archiviert, ihn abschalten, ohne etwas zu trennen.
Drei Dinge machen es für ein Audit besonders nützlich:
- Jede Antwort zeigt, was sie gelesen hat. Das Aktivitätsprotokoll jedes Tickets listet die Quellen auf, die der Agent durchsucht hat, und ob er auf eine Wissenslücke gestoßen ist, und jeder Entwurf nennt den genutzten Artikel. Stützt sich eine Antwort auf einen veralteten Artikel, sehen Sie, auf welchen.
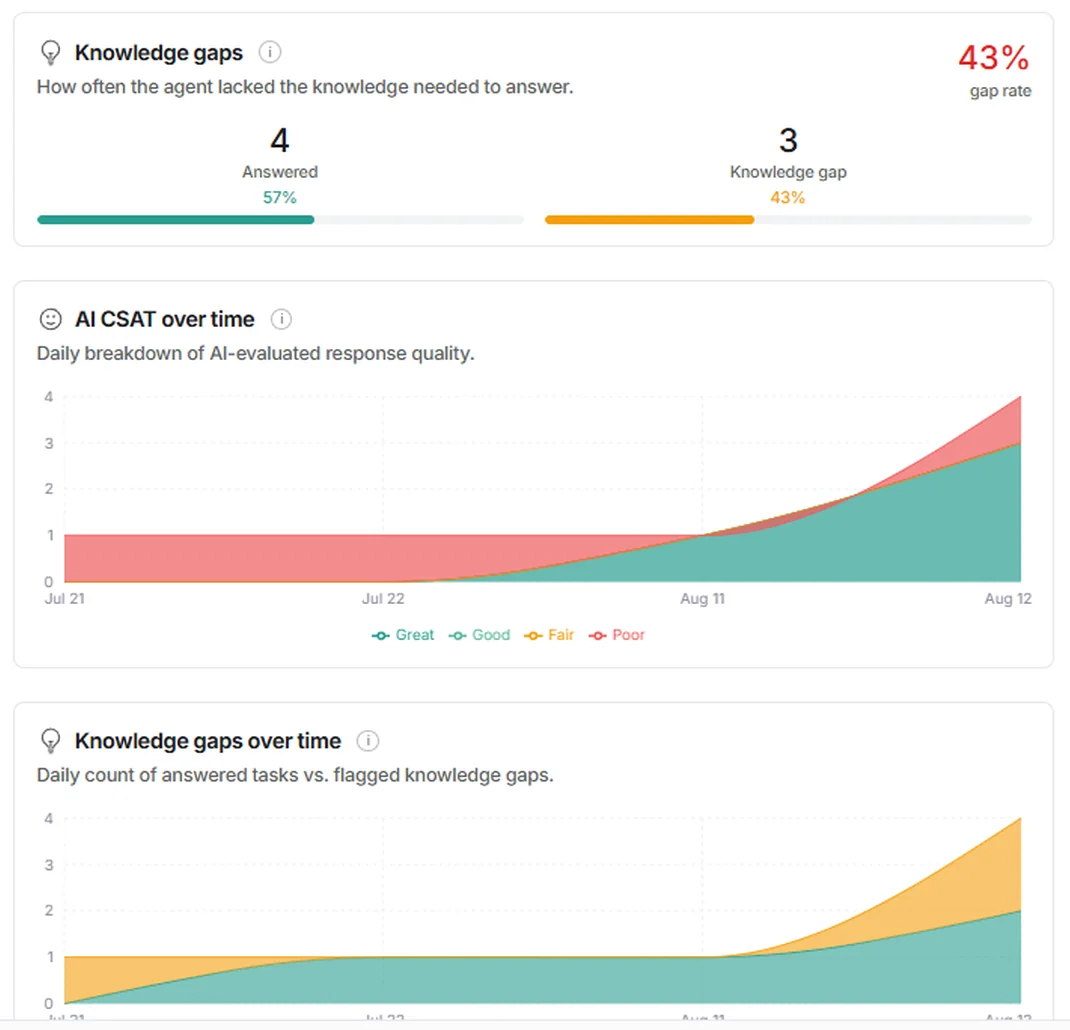
- Lücken werden für Sie gezählt. Die Reports-Seite hat eine Karte "Knowledge gaps" und eine Trendlinie. Die Docs von eesel sagen es schlicht: "A knowledge gap is your agent telling you something is missing." Der Skill Update knowledge base entwirft dann die fehlenden Artikel zu Ihrer Prüfung.
- Nach der Bereinigung können Sie erneut testen. Der Skill Simulation spielt echte vergangene Tickets noch einmal ab, bewertet jede Antwort gegen das, was Ihr Team gesendet hat, und schlägt Korrekturen vor, ohne etwas an einen Kunden zu senden.
Wo es nicht das richtige Werkzeug ist: eesel führt das Audit nicht für Sie durch. Die Entscheidungen über behalten, aktualisieren, zusammenführen und archivieren bleiben bei Ihrem Team, und die Verbindungen zu Website, Google Drive und Confluence lesen nur. Es liefert Ihnen die Belege dafür, wo Sie zuerst hinsehen sollten. Die Preise beginnen mit 100 kostenlosen Credits ohne Karte, danach kommt der Teammate-Tarif ab 299 $ im Monat für 500 Credits, wobei ein Ticket einen Credit kostet, egal wie lange es läuft. Testen Sie eesel an Ihrem eigenen Help Center und sehen Sie, nach welchen Artikeln es zuerst greift.