

Warum ich Hermes als KB-Pfleger sehe, nicht als KB
Ich bearbeite jeden Tag die Support-Queue von eesel, und wenn eine KI-Antwort danebengeht, ist selten das Modell schuld. Es ist der Hilfeartikel. Ein Support-Manager bei einem Bus-Tracking-Dienst mit 200 bis 250 Zendesk-Tickets im Monat merkte in einem Gespräch mit uns, dass seine gesamte Wissensdatenbank für Administratoren geschrieben war, während die Tickets von Fahrgästen kamen. Jede Antwort war technisch korrekt und praktisch nutzlos. Ein anderes Team, ein dänischer Solarenergie-Anbieter, sah, wie ein Bot Antworten erfand und an echte Kunden schickte, sobald seine Wissensdatenbank keinen Treffer hatte.
„Kann ein KI-Agent meine Wissensdatenbank verwalten?" sind also eigentlich zwei Fragen. Kann er das Wissen halten, und kann er es aktuell halten? Für Hermes Agent, den Open-Source-Agenten von Nous Research, lauten die ehrlichen Antworten „nein" und „ja, mit Vorsicht".
Hermes ist ein selbst gehosteter Agent unter MIT-Lizenz, den Sie auf Ihrem eigenen Rechner oder Server betreiben, und einer der besseren Open-Source-KI-Agenten. Wenn Sie ihn noch nicht kennen, behandelt mein Hermes-Agent-Test die Grundlagen.
Die Leitfäden zum Kundensupport und zum internen IT-Support behandeln die beiden anderen Aufgaben, die man ihm gern gibt. Hier geht es um die unscheinbare Arbeit des Wissensdatenbank-Managements: Artikel korrekt, auffindbar und vollständig halten.
Was Hermes tatsächlich weiß (und wo er es ablegt)
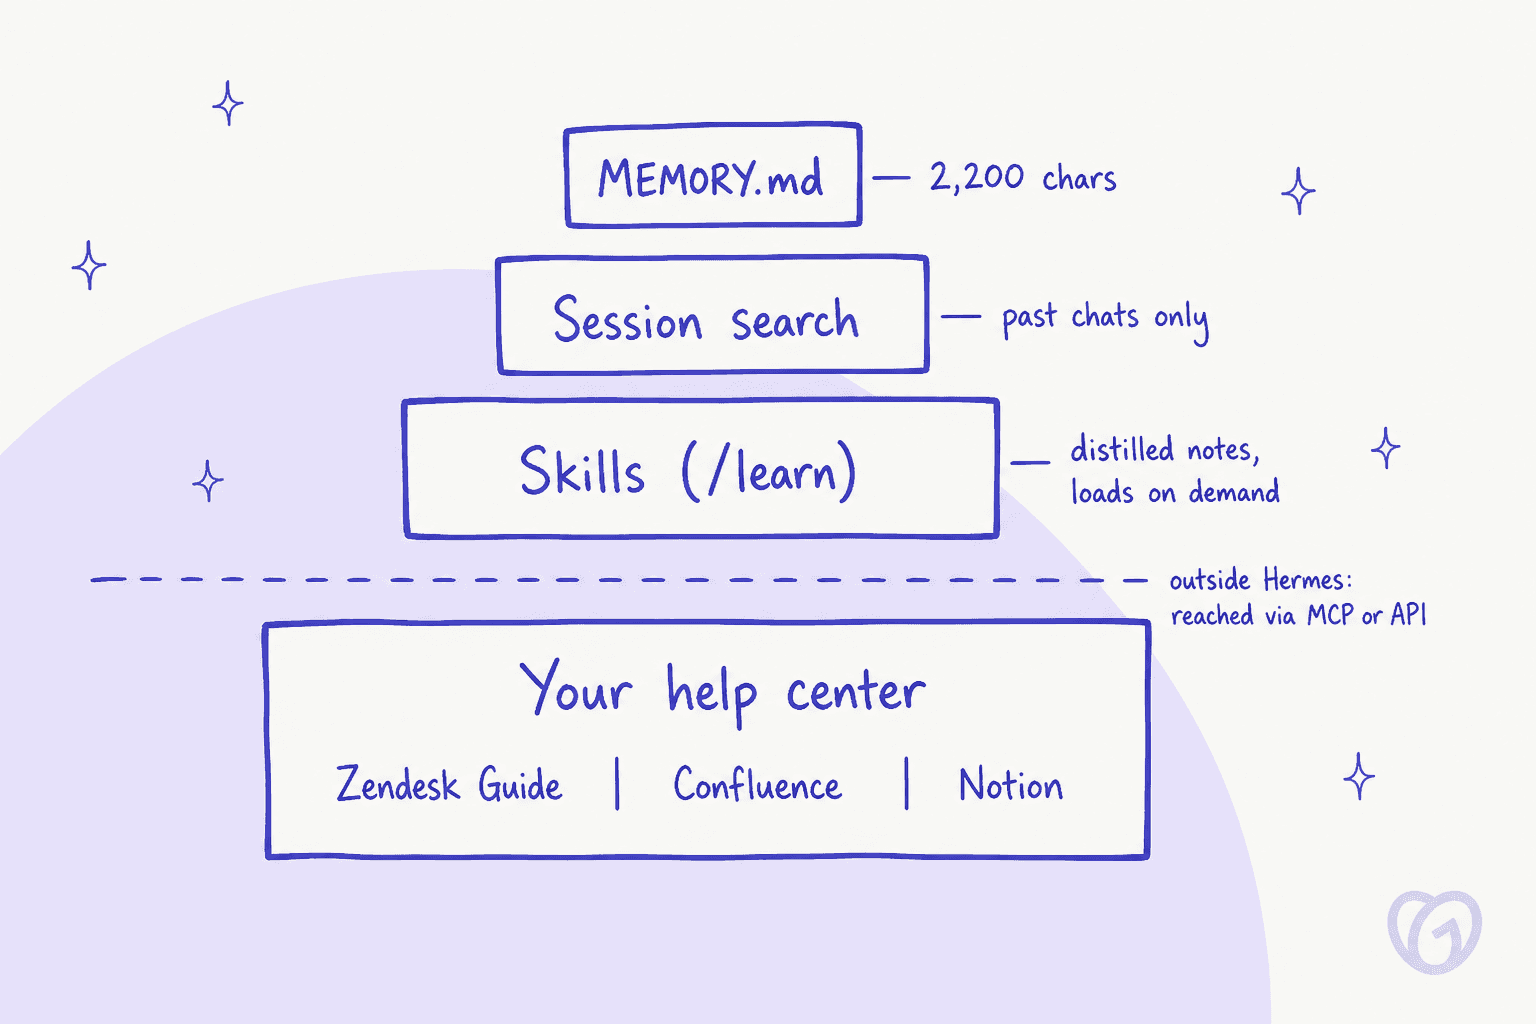
Hermes hat vier Orte, an denen Wissen liegen kann, und sie unterscheiden sich enorm in der Größe. Die meiste Verwirrung um „Hermes als Wissensdatenbank" entsteht, weil man sie durcheinanderbringt.
Speicher: absichtlich klein
Der dauerhafte Speicher von Hermes besteht aus zwei Dateien. MEMORY.md enthält die eigenen Notizen des Agenten mit 2,200 Zeichen (etwa 800 Tokens), und USER.md enthält Ihr Profil mit 1,375 Zeichen. Das sind grob 8 bis 15 Einträge. Beide werden beim Sitzungsstart als eingefrorener Schnappschuss in den System-Prompt geladen, und der Speicher wird nicht automatisch verdichtet: Ein Schreibvorgang über dem Limit gibt einen Fehler zurück, und der Agent muss Platz schaffen.
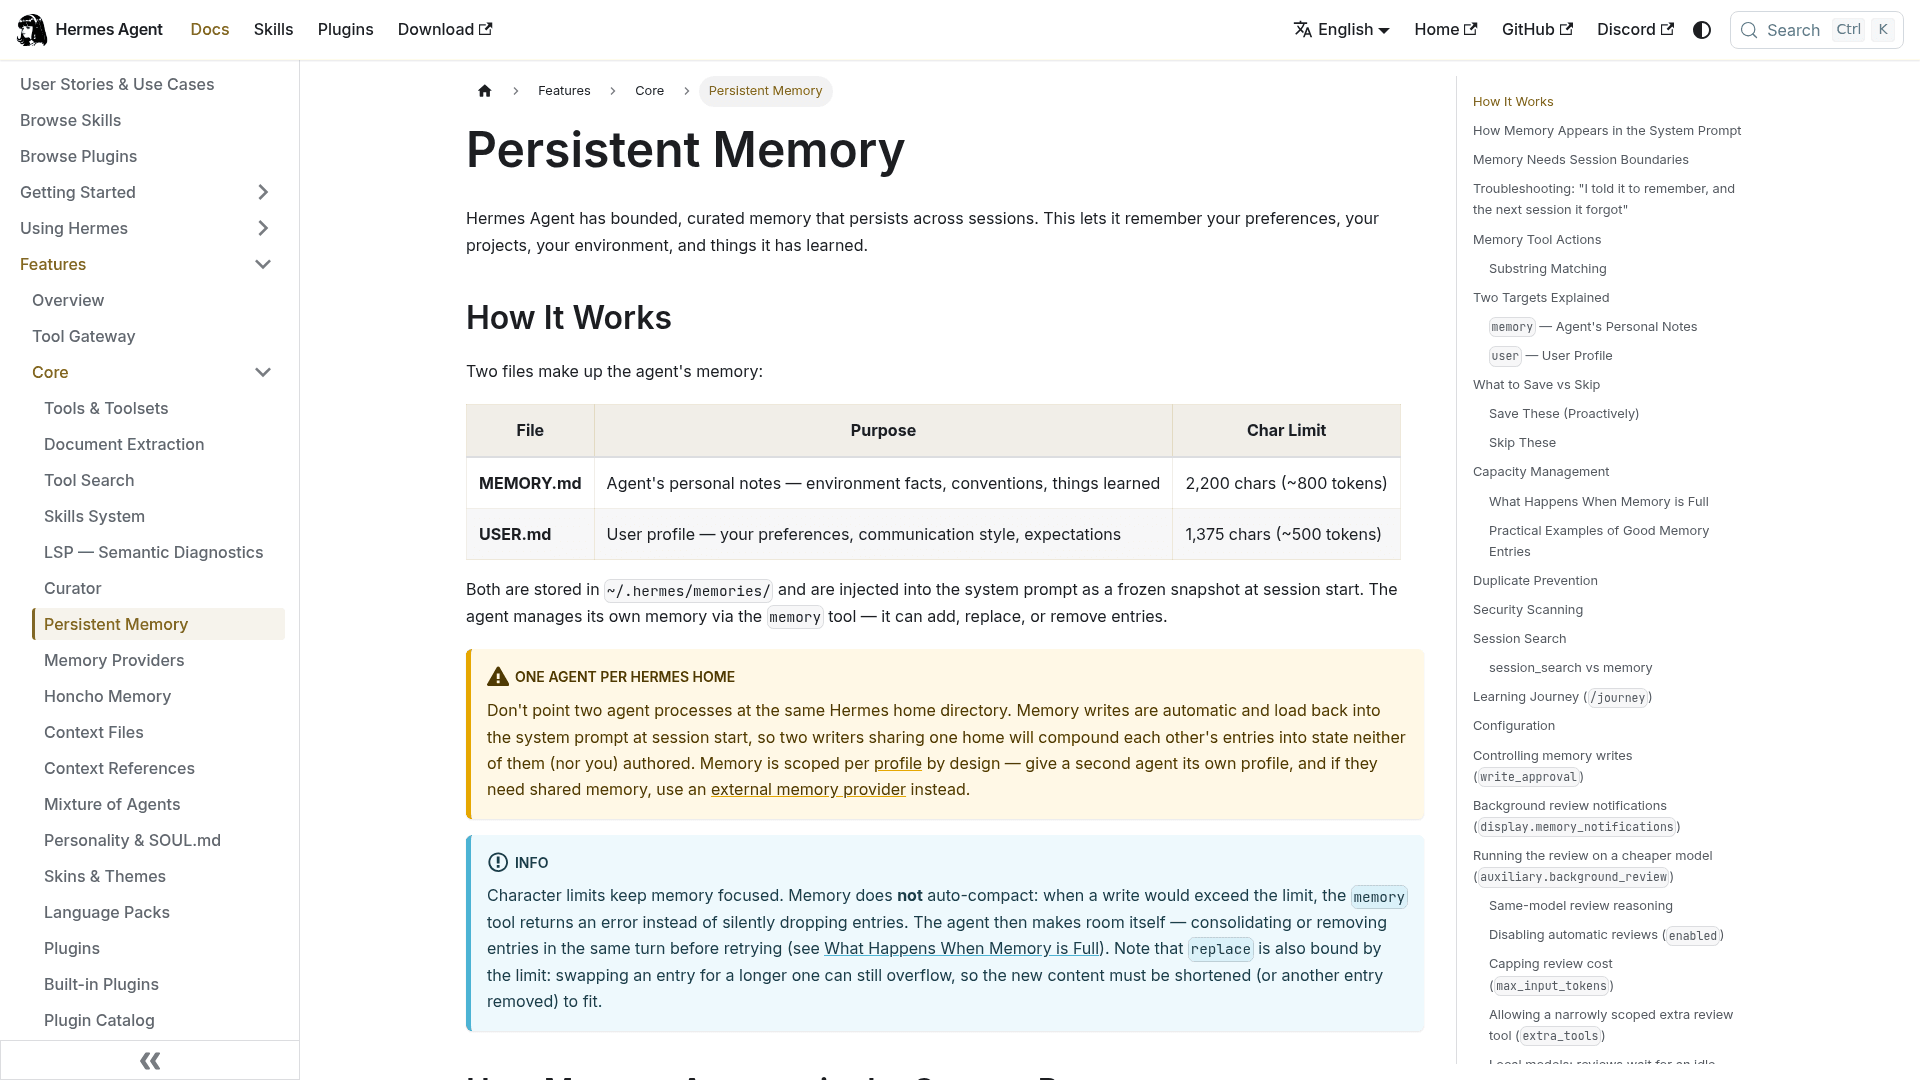
Die Dokumentation ist erfrischend direkt darin, was dort nicht hingehört. „Raw data dumps" stehen auf der Verzichtsliste, und für alles, was der Agent bei jedem Lauf braucht, sei ein Skill laut Docs „often the better home than a memory entry". Ein einziger Hilfeartikel zu Ihrer Erstattungsregel würde einen großen Teil dieses Budgets verbrauchen. Ein Help Center passt nicht hinein und war nie dafür gedacht.
Sitzungssuche: Unterhaltungen, keine Dokumente
session_search führt eine SQLite-Volltextsuche über jeden vergangenen Chat aus, mit etwa 20 ms pro Anfrage und ohne Modellaufrufe. Sie ist ideal für „haben wir das letzte Woche besprochen?". Dateien, Dokumente oder Ihr Help Center indiziert sie nicht. Ein Dokument wird hier nur durchsuchbar, wenn sein Text in einer vergangenen Unterhaltung vorkam.
Skills: das Nächste an einer eingebauten KB
Skills sind Wissensdokumente auf Abruf, die nur bei Relevanz geladen werden. Der Befehl /learn macht aus einem Docs-Ordner oder einer URL einen „Knowledge-Base-Skill": eine schlanke SKILL.md plus eine destillierte Datei pro Thema unter references/. Wird /learn erneut auf dasselbe Thema angewendet, fließt neues Material in den bestehenden Skill ein.
Zwei Haken sind für die KB-Arbeit wichtig:
- Es ist eine Zusammenfassung, keine Spiegelung. Laut Docs „never reproduces passages of the source text". Das ist nützlich, um dem Agenten Ihr Produkt beizubringen, aber es ist keine Kopie Ihrer Artikel, die Sie einem Kunden zitieren könnten.
- Ungenutzte Skills werden archiviert. Der Curator markiert vom Agenten erstellte Skills nach
14Tagen ohne Nutzung als veraltet und verschiebt sie nach30in einen Archivordner. Ein Wissens-Skill, den Sie nur bei einem Quartals-Audit anfassen, verschwindet stillschweigend, wenn Sie ihn nicht mithermes curator pin <skill>anheften.
Ihre eigentliche Wissensdatenbank: außerhalb, erreichbar per MCP oder API
Hermes hat kein eingebautes RAG und keine Vektorsuche. Semantische Suche über Dokumente bedeutet, sich für etwas zu entscheiden: einen externen Speicheranbieter (OpenViking und RetainDB sind die beiden dokumentierten mit Dokumenten-Ingestion, und RetainDB kostet $20/month), den optionalen Such-Skill qmd oder einen selbst betriebenen Vektordatenbank-Skill. Alles andere liegt in Ihrer echten KB, die Hermes über MCP erreicht, das Plug-in-Protokoll für externe Tools, oder über einfache API-Aufrufe.
Diese Trennung ist das ganze Denkmodell. Ihr Help Center ist die Quelle der Wahrheit. Hermes ist ein Arbeiter, der es besucht, dasselbe Muster, das ich für das Anbinden von KI an Unternehmenswissen beschreibe.
Die drei KB-Aufgaben, die Hermes gut erledigt
Sobald Sie aufhören, von Hermes zu verlangen, die Wissensdatenbank zu sein, wird er schnell nützlich. Diese drei Aufgaben würde ich ihm übergeben.
1. Wöchentliche Audits eines Markdown-Wikis oder Docs-Repositorys
Der mitgelieferte llm-wiki-Skill (basierend auf Andrej Karpathys LLM-Wiki-Idee) baut eine verlinkte Markdown-Wissensdatenbank auf und bringt einen Lint-Durchlauf mit. Dieser Lint prüft auf verwaiste Seiten, defekte Links, fehlende Indexeinträge, Widersprüche, Quellen-Drift, Seiten über 200 Zeilen und veraltete Inhalte, definiert als Seiten, deren updated-Datum mehr als 90 Tage älter ist als die neueste Quelle, die dieselben Themen erwähnt.
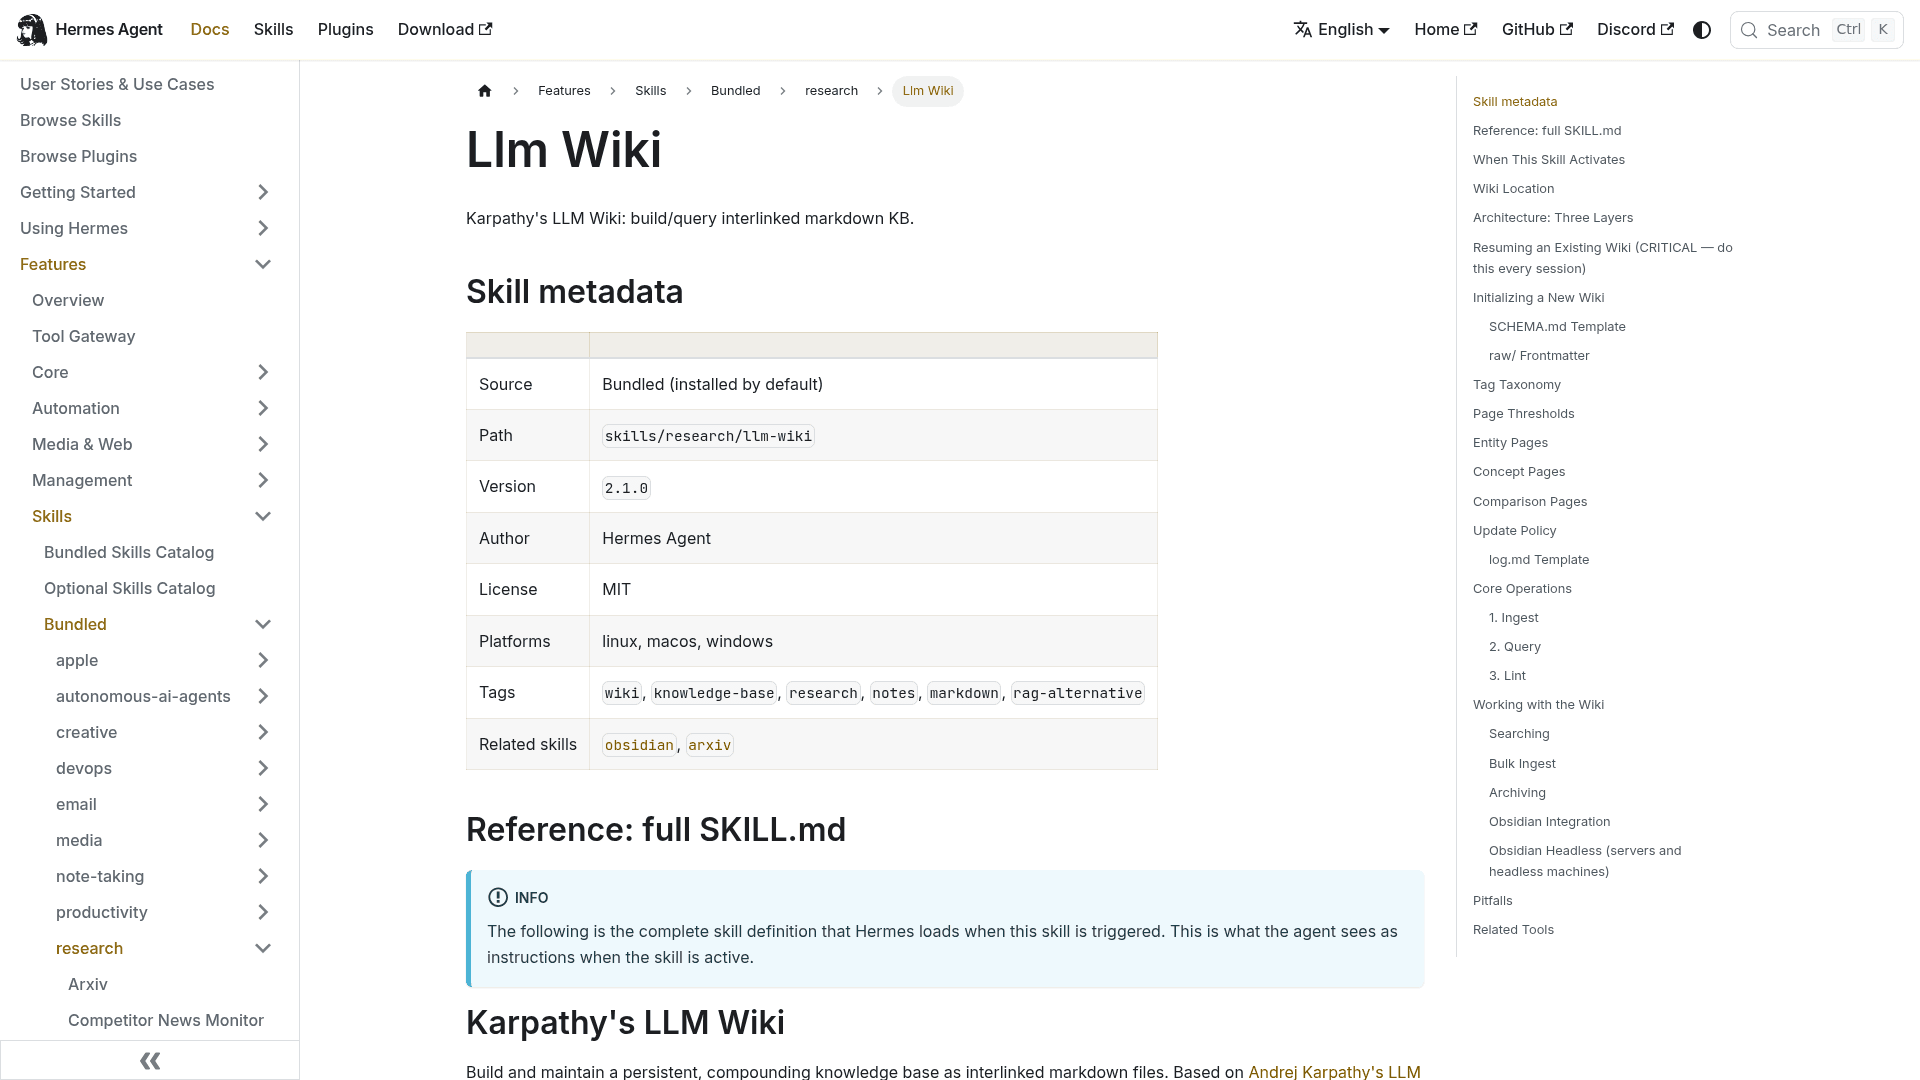
Das ist der Großteil eines Audits der Support-Wissensdatenbank gratis, wenn Ihre Dokumente als Markdown vorliegen. Für Docs-as-Code-Teams erledigen die Dateitools von Hermes den Rest: read_file blättert durch große Dateien (und kürzt ab etwa 100K Zeichen), patch macht gezielte Änderungen und liefert einen Diff, und search_files ist intern ripgrep.
2. Fehlende oder veraltete Artikel entwerfen
Hermes kann Artikel in Notion, Confluence, Freshdesk, Help Scout und GitHub über den MCP-Server oder die API der jeweiligen Plattform schreiben. Das Muster, das funktioniert, ist „entwerfen, nicht veröffentlichen": Der Agent schreibt einen Artikelvorschlag an eine Stelle, an der ein Mensch ihn prüft. Ein Zendesk-Admin auf Reddit beschrieb dieselbe Schleife, die er Jahre vor der Zeit der Agenten in Make.com gebaut hatte:
"If it can't it drafts me an article that would cover it, as well as tells me why."

Der Teil „tells me why" ist wichtig. Ein Entwurf mit beigefügter Begründung ist in Minuten geprüft. Ein Entwurf ohne Begründung liegt in einer Warteschlange. Mehr zur Schreibseite behandle ich in meinem Leitfaden zum Schreiben von KB-Artikeln mit KI.
3. Sich selbst Ihr Produkt beibringen, bevor er etwas beantwortet
Wenn Sie /learn auf Ihr öffentliches Help Center anwenden, erhält Hermes ein funktionierendes Modell Ihres Produkts, bevor er irgendetwas anderes anfasst. Das ist praktisch, wenn Sie Hermes auch nutzen, um anderswo Antworten zu entwerfen, und es ist dieselbe Idee wie KI auf Ihrer Wissensdatenbank zu trainieren. Ein Hacker-News-Kommentator betreibt genau diesen Aufbau:
"Hermes uses an llm-wiki [...] as a source of information when drafting suggested replies - I have a cronjob that feeds it all emails, slack messages, meeting minutes every single day."

Kann Hermes in Ihr Help Center schreiben? Das hängt von der Plattform ab
Hier laufen die meisten Setups schief, und es ist der Teil, den keine Hermes-Docs-Seite abdeckt, da keine von ihnen ein kundenseitiges Help Center erwähnt. Ob Hermes eine Änderung sicher vorschlagen kann, hängt weit mehr von Ihrer KB-Plattform ab als von Hermes.
Der kuratierte MCP-Katalog von Hermes hat 62 Einträge. Notion und Atlassian (Jira plus Confluence) sind dabei. Google Drive, GitHub und Zendesk nicht: GitHub fehlt absichtlich zugunsten des mitgelieferten gh-Skills, Google Drive braucht Ihren eigenen OAuth-Client, und Zendesk wird in den Docs nirgends erwähnt.
Wo liegt Ihre Wissensdatenbank?
Wählen Sie Ihre Plattform und sehen Sie, wie Hermes sie erreichen kann und welche eine Einstellung ihn am eigenständigen Veröffentlichen hindert.
Weg: Help-Center-REST-API aus einem Hermes-Skill oder per Terminal-Aufruf. Nicht im MCP-Katalog von Hermes, und der eigene MCP-Server von Zendesk hat noch keine öffentliche Dokumentation.
Sichere Einstellung: Geben Sie dem Konto des Agenten eine Berechtigungsgruppe ohne Veröffentlichungsrechte, damit er nur Artikel mit draft auf true erstellen kann.
Achtung: Das Draft-Flag gilt pro Übersetzung. Setzen Sie es bei einem live geschalteten Artikel, nimmt das diesen Artikel aus Ihrem Help Center. Schlagen Sie Änderungen stattdessen als neuen Entwurfsartikel vor.
Weg: Atlassians MCP-Server, der im Katalog von Hermes ist. Seine v2 listet 65 Confluence-Tools, darunter createConfluenceContent und updateConfluenceContent.
Sichere Einstellung: Markieren Sie den Server in Hermes mit trust: untrusted, damit jeder Schreibvorgang zuerst nachfragt. Unbeaufsichtigte Läufe brauchen ein API-Token, das ein Organisations-Admin aktiviert hat.
Achtung: Die MCP-Tools nennen keine Entwurfsoption, und das Tool für den Inhaltsstatus setzt ein Review-Label, keinen Veröffentlichungsstatus. Schreiben Sie in einen eingeschränkten Sammelbereich oder hinterlassen Sie einen Kommentar.
Weg: Notions gehosteter MCP-Server, im Katalog von Hermes. Die Notion-Docs zeigen die Hermes-Konfiguration und den Schritt hermes mcp login notion.
Sichere Einstellung: Nehmen Sie nur notion-search, notion-fetch und notion-create-comment auf, bis Sie ihm vertrauen, und ergänzen Sie dann eine Status-Eigenschaft als Prüfschranke.
Achtung: Die Anmeldung läuft nur per OAuth, es gibt noch kein Headless-Token, und der Entwurfsmodus erzeugt eine private Seite ohne übergeordnete Seite.
Weg: Freshdesks offizieller MCP-Server (seit dem 10. September 2026 allgemein verfügbar) hat createSolutionFolderArticle und updateSolutionArticle.
Sichere Einstellung: Erstellen Sie Artikel mit Status 1, das bedeutet Entwurf. Status 2 veröffentlicht.
Achtung: Jeder verbundene API-Schlüssel erhält alle Tools, und MCP wird abgerechnet: Growth enthält 1.200 Aktionen pro Jahr, danach 15 $ pro 1.000.
Weg: die Docs-API. Der MCP-Server von Help Scout ist für neue Verbindungen schreibgeschützt und kann Docs-Artikel nicht bearbeiten.
Sichere Einstellung: Der Endpunkt zum Speichern von Entwürfen schreibt einen Entwurf über einen live Artikel, „so that the published version will not be affected."
Achtung: Ihr Docs-API-Schlüssel braucht die Berechtigung „Docs: Create new, edit settings & Collections".
Weg: der mitgelieferte github-Skill von Hermes, der die gh-Kommandozeile steuert, oder GitHubs eigener MCP-Server.
Sichere Einstellung: in einen Branch schreiben und einen Draft-Pull-Request öffnen. Der Branch-Schutz auf main ist Ihr Veröffentlichen-Button.
Achtung: fast nichts. Für unbeaufsichtigte Läufe funktioniert ein Personal Access Token, anders als bei der Anmeldung von Notion.
Hier dasselbe Bild als Kurzreferenz:
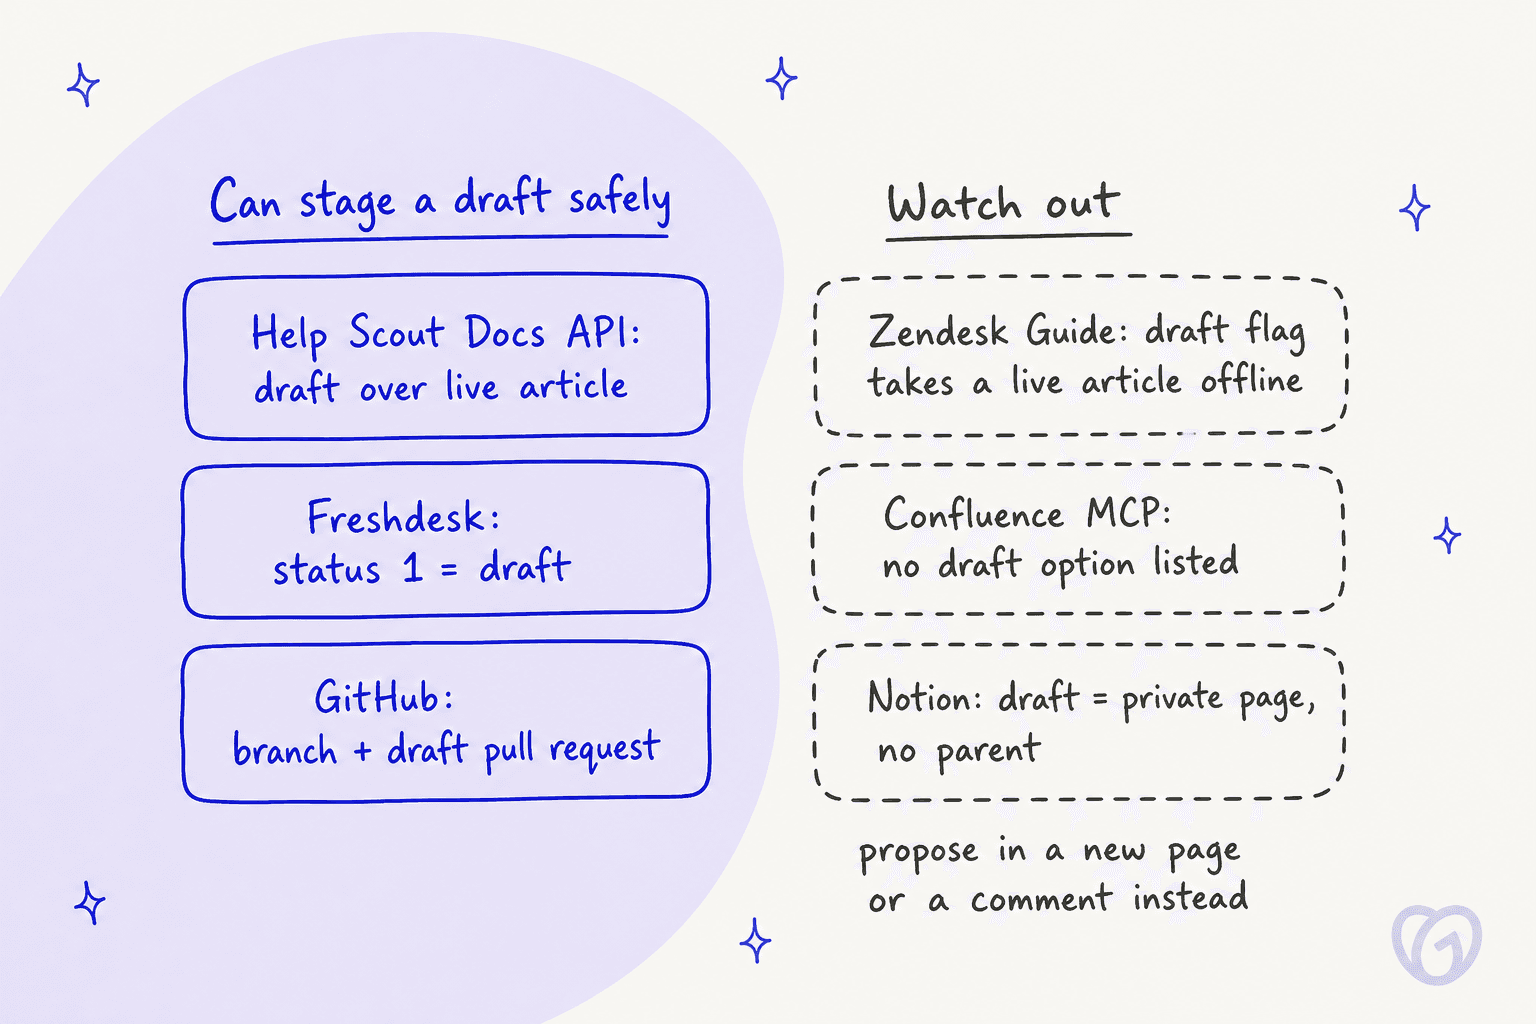
Das Zendesk-Thema überrascht die Leute am meisten. Laut der Help-Center-API kann das Feld draft „can be set when creating but not when updating", und Aktualisierungen laufen über den Translations-Endpunkt, wo draft für die gesamte Übersetzung gilt. Es gibt kein separates Objekt für „ausstehende Änderung", sodass ein Agent, der einen live Artikel auf Entwurf setzt, ihn depubliziert. Der Vorteil: Die API sagt auch, dass ohne Veröffentlichungsrechte „the article must be created using draft=true". Das ist eine saubere Leitplanke. Mein Beitrag zur Zendesk-Guide-API führt durch die Endpunkte, und Freshdesk-Nutzer finden das Äquivalent in meinem Leitfaden zur Freshdesk-Knowledge-Base-API.
| Plattform | Wie Hermes sie erreicht | Kann Entwurf vorbereiten | Anmeldung | Wissenswerte Limits |
|---|---|---|---|---|
| Zendesk Guide | REST-API (nicht im Katalog) | Nur neue Artikel, draft: true | OAuth-Token oder API-Token | 200 bis 2,500 Anfragen/Min. je nach Tarif |
| Confluence | Atlassian-MCP (im Katalog) | In den MCP-Tools nicht gelistet | OAuth 2.1 oder vom Admin aktiviertes API-Token | Schreibvorgänge kostenlos, angereicherte Aufrufe 1-10 Rovo-Credits |
| Notion | Notion-MCP (im Katalog) | Private Seite, ohne übergeordnete Seite | Nur OAuth | 600/Min. Business+, 180/Min. sonst |
| Freshdesk | Freshdesk-MCP | Ja, status: 1 | Nur API-Schlüssel | 1,200 Aktionen/Jahr bei Growth, danach $15/1.000 |
| Help Scout Docs | Docs-API (MCP ist schreibgeschützt) | Ja, Entwurf über live Artikel | Docs-API-Schlüssel | 2,000+ Anfragen pro 10 Min. |
| GitHub-Docs-Repository | github-Skill oder GitHub-MCP | Ja, Branch plus Draft-PR | OAuth oder Personal Token | 80 inhaltserzeugende Anfragen/Min. |
Hermes für das Wissensdatenbank-Management einrichten, Schritt für Schritt
So würde ich es für ein Support-Team aufsetzen, in der Reihenfolge, in der ich es machen würde. Planen Sie für die Schritte 1 bis 4 einen Nachmittag ein, wenn Hermes schon installiert ist.
Schritt 1: Entscheiden, wo die Quelle der Wahrheit liegt
Wählen Sie ein System als den Ort, an dem eine korrekte Antwort liegt. Wenn Ihr Help Center Zendesk Guide ist, aber die Hälfte der echten Antworten in Confluence steht, wird Hermes gern beides prüfen und in das entwerfen, was er zuerst erreicht. So widersprechen sich am Ende zwei Artikel. Wenn Ihre Agenten außerdem eine separate interne Wissensdatenbank führen, entscheiden Sie jetzt, welche bei einem Konflikt gewinnt. Ein Reddit-Kommentator in r/CustomerSuccess beschrieb, wohin das führt:
"the two docs disagreeing thing is the scariest part, bot just picks whichever one it grabbed first and sounds totally sure about it"
Schritt 2: Zuerst nur lesend verbinden
Wenn Sie einen MCP-Server hinzufügen, prüft Hermes ihn und zeigt eine Checkliste, und nur die angehakten Tools landen in tools.include. Beginnen Sie nur mit Such- und Lese-Tools. Für Notion, mit dem gehosteten Server aus den Hermes-Anweisungen von Notion:
mcp_servers:
  notion:
    url: "https://mcp.notion.com/mcp"
    auth: oauth
    trust: untrusted
    tools:
      include: [notion-search, notion-fetch, notion-create-comment]
Führen Sie dann einmal hermes mcp login notion aus, um die OAuth-Anmeldung abzuschließen.
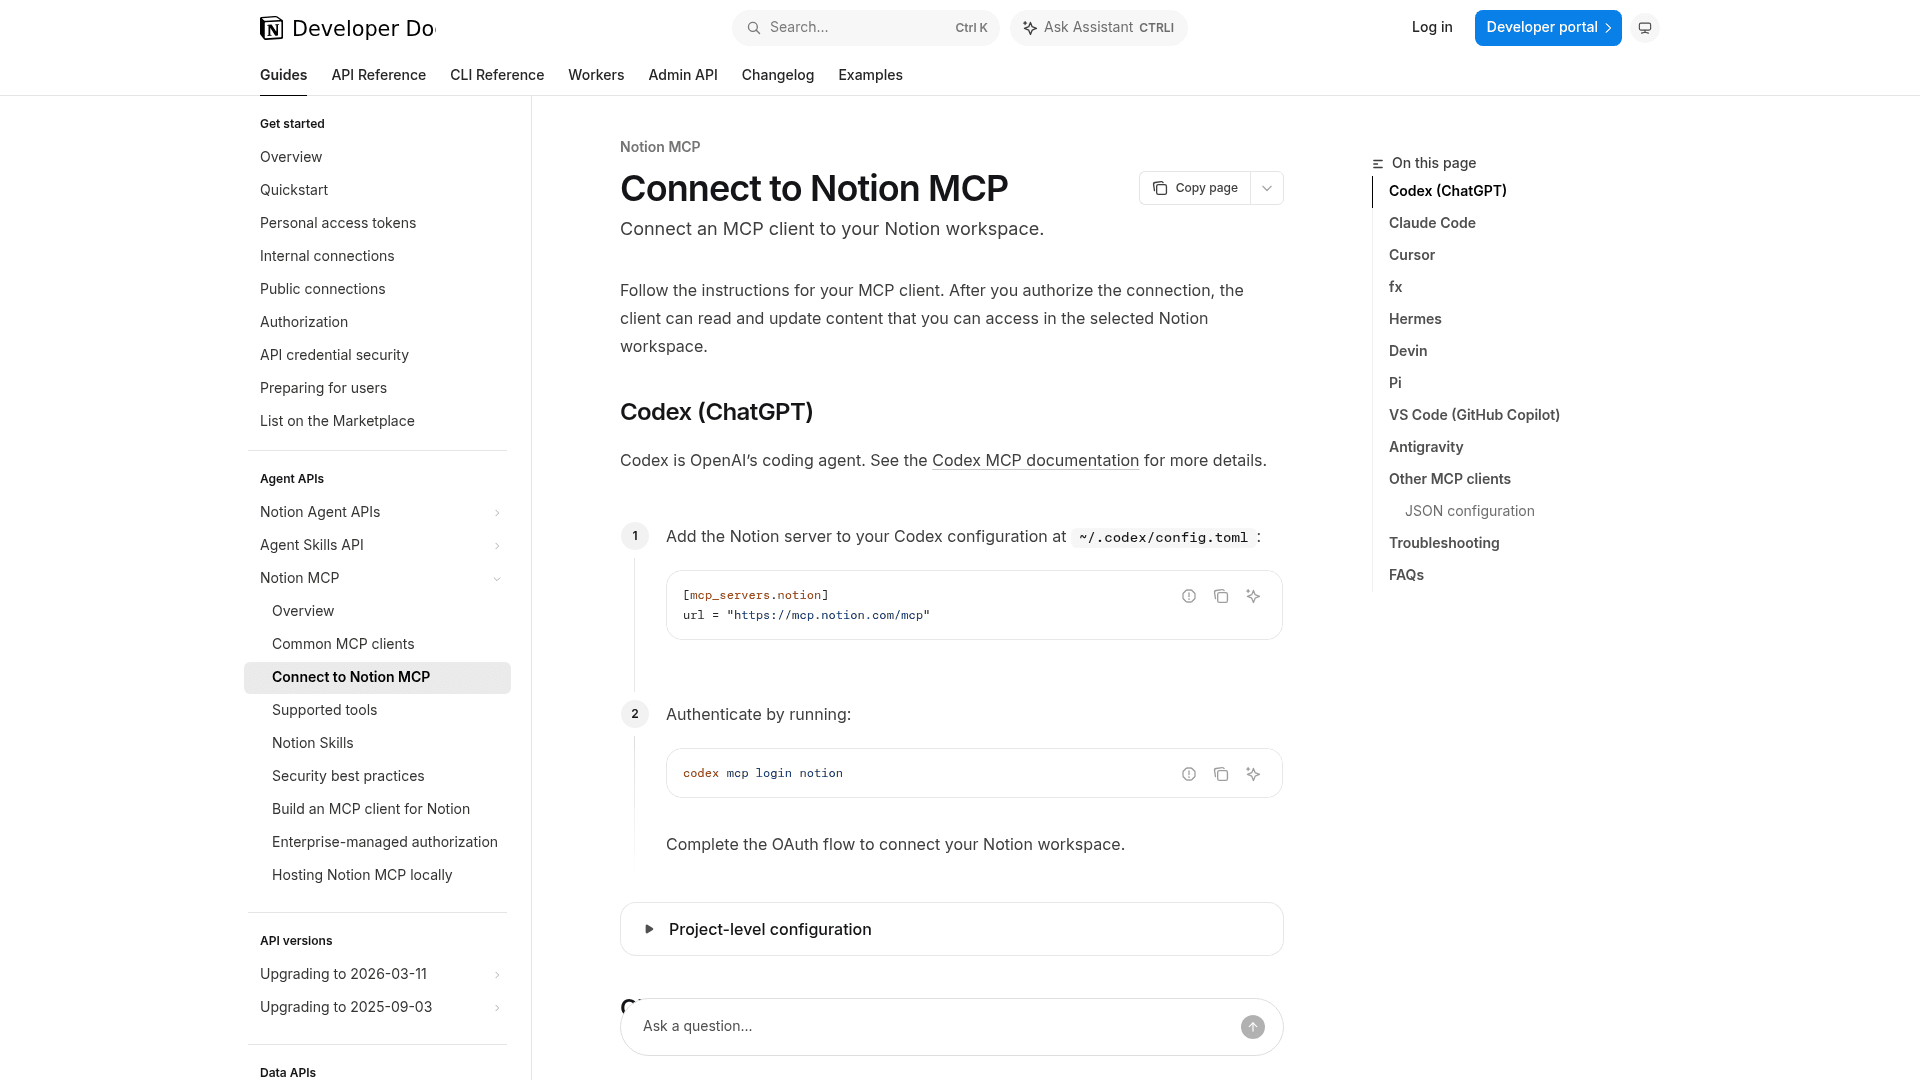
Die Zeile trust: untrusted leistet die Hauptarbeit. Laut MCP-Konfigurationsreferenz erfordert bei einem nicht vertrauenswürdigen Server „every write-capable tool call [...] requires user approval". Der Standard ist full, das heißt gar keine Abfrage.
Schritt 3: Die Schreibschranken aktivieren, die Hermes ausgeschaltet lässt
Das Freigabekonzept von Hermes ist uneinheitlich, also schalten Sie diese gezielt ein:
memory.write_approval: truestellt Speicherschreibvorgänge zur Prüfung bereit, mit/memory pendingund/memory approve <id>.skills.write_approval: truemacht dasselbe für Skill-Änderungen, und/skills diff <id>zeigt den vollständigen Diff.checkpoints.enabled: trueerstellt vor Dateischreibvorgängen einen Snapshot, damit/rollbackeine Markdown-Seite wiederherstellen kann. Checkpoints sind Opt-in.
Zwei Dinge decken diese nicht ab. Einfache Dateischreibvorgänge (write_file, patch) fragen nie nach; die Sicherheitsdokumentation sagt „there is no approval prompt", es gibt nur eine Liste gesperrter Pfade und eine optionale Schreib-Sandbox. Und Checkpoints sichern nur lokale Dateien, sodass bei einer per MCP geänderten Notion- oder Confluence-Seite das Rückgängigmachen auf die eigene Seitenhistorie der Plattform angewiesen ist.
Schritt 4: Ein wöchentliches Audit planen
Hermes cron versteht Zeitpläne in einfachem Englisch, kann Skills anhängen und liefert nach Slack. Ein erster Job könnte so aussehen:
hermes cron create "every monday 9am" "Lint the support wiki. List stale pages, orphan pages and contradictions with file paths. If nothing changed since last week, reply [SILENT]." --skill llm-wiki
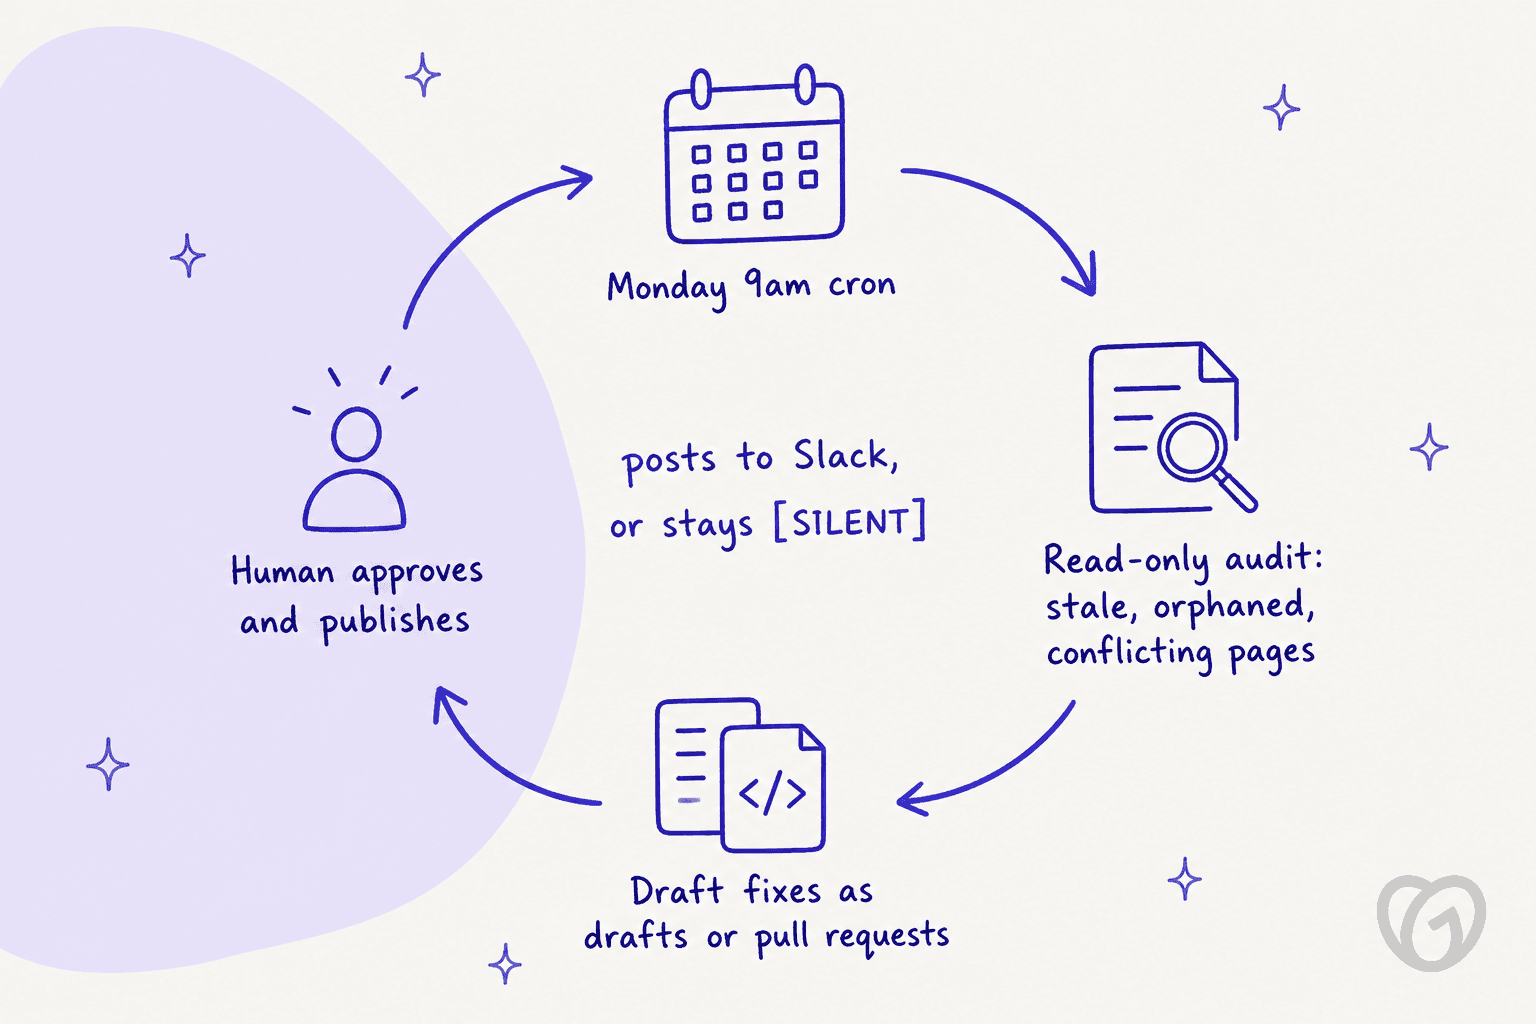
Cron verhält sich dafür gut. Eine Antwort mit [SILENT] unterdrückt die Zustellung, sodass Ihr Kanal nur etwas hört, wenn sich etwas geändert hat, während fehlgeschlagene Jobs immer zugestellt werden. Wenn ein Schlüssel, Skill oder MCP-Server nicht aufgelöst werden kann, wird der Job als blocked_config markiert, sendet einen Alarm und macht keinen Modellaufruf. In Cron sind gefährliche Shell-Befehle standardmäßig verweigert. Eine Eigenheit: Jeder Cron-Lauf startet eine komplett neue Sitzung, der Prompt muss also alles enthalten, was der Agent braucht.
Schritt 5: Entwerfen erst hinzufügen, wenn das Audit langweilig geworden ist
Erst nach einigen Wochen mit Audits, die dem entsprechen, was Sie selbst markiert hätten, würde ich Hermes schreiben lassen. Fügen Sie das Schreib-Tool Ihrer Plattform hinzu, lassen Sie den Server untrusted und richten Sie Entwürfe auf einen Prüfort: einen Draft-Pull-Request, einen Freshdesk-Entwurf, einen Help-Scout-Entwurf oder einen Kommentar auf der Confluence-Seite. Heften Sie jeden Wissens-Skill an, von dem der Job abhängt, damit der Curator ihn nicht mitten im Quartal archiviert.
Wo agentengeführte Wissensdatenbanken schiefgehen
Bisher berichtet niemand in der Hermes-Community, ihn gegen ein kundenseitiges Help Center zu betreiben. Alle Geschichten handeln von einem persönlichen oder Team-Wiki, meist einem Obsidian-Vault. Aber die Fehlerbilder lassen sich gut auf Support-KBs übertragen, und es lohnt sich, sie zu lesen, bevor Sie einem Agenten Schreibzugriff geben.
Unbeaufsichtigte Schreibvorgänge lassen das ganze Wiki verrotten
Das ist die meistgeupvotete Lektion in den r/hermesagent-Threads, die ich gelesen habe:
"Don't let the agent write the vault unsupervised. That's the one I wish I'd heard on day one. They will dump session recaps, fake "I remember" facts, and half finished incident notes into Obsidian like it's a trash can. Looks busy. A month later you don't trust a single file."
Die eigene Dokumentation von Hermes weist auf ein verwandtes Risiko hin: Bei kleinen lokalen Modellen sei „a sentence like 'I've added that to my memory' is just text". Der Agent kann sagen, er habe etwas gespeichert, was er nie gespeichert hat, weshalb die Docs einen Datei-Mutations-Verifizierer ergänzen und raten, „trust the verifier over the model's summary".
Agenten ergänzen, selten löschen
In einem Hacker-News-Thread mit dem Titel „Agents don't need memory, they need documentation" beschrieb ein Entwickler, wie die Wissensdatenbank seines Unternehmens zu einem „completely useless giant mess of stale, outdated, duplicated, or superfluous info" wuchs, selbst wenn Agenten den Abgleich übernahmen (kaydub, Hacker News). Agenten fügen einen Absatz hinzu, statt einen zu streichen. Für ein Help Center heißt das: Ihr Audit-Prompt sollte ausdrücklich nach Seiten fragen, die archiviert oder zusammengeführt werden sollen, nicht nur nach Seiten, die aktualisiert werden sollen. Mein Leitfaden zu veralteten Help-Center-Inhalten hat mehr dazu, wie man sie erkennt.
Schreibvorgänge scheitern still
"But the main problem is really that it can sometimes just not insert it."
Dabei ging es darum, dass Hermes Recherche-Zusammenfassungen in Notizen schreibt. Die Lösung ist für ein Help Center dieselbe: Prüfen Sie nach einem Schreibvorgang, ob der Artikel auf der Plattform existiert, und lassen Sie den Wochenbericht auflisten, was tatsächlich erstellt wurde, nicht was der Agent erstellen wollte.
Persönlicher Maßstab funktioniert, Unternehmensmaßstab ist schwerer
"There are a few successes on an individual level (I really like Hermes[0]) but nothing scales to a company level easily."
Der Hermes-Speicher ist pro Profil abgegrenzt, und die Docs verweisen für alles Gemeinsame auf einen externen Speicheranbieter. Für eine einzelne Docs-Verantwortliche ist das in Ordnung, und es ist auch der Grund, warum Wissenserhalt im Support nicht im Agenten einer einzelnen Person liegen kann. Bei einem Support-Team von 15, in dem alle dieselben Antworten erwarten, muss die gemeinsame Quelle Ihr Help Center sein, was Sie zurück zur Plattformtabelle oben bringt.
Er prüft, was geschrieben steht, nicht was Kunden fragen
Diese Lücke würde ich als Support-Mensch am stärksten gewichten. Der Lint von llm-wiki findet veraltete und widersprüchliche Seiten. Er kann Ihnen nicht sagen, dass eine Reihe von Tickets im letzten Monat nach einer Funktion ohne Artikel gefragt hat, weil nichts in Hermes Ihre Helpdesk-Tickets dafür liest, es sei denn, Sie bauen das. Wie ein Gründer auf r/startups sagte, besteht ein großer Teil der Arbeit darin zu wissen, „which legacy articles are broken by a new feature" (u/19Vicus90, Reddit r/startups). Tickets sind der Ort, an dem sich das zuerst zeigt. Mein Beitrag zur Analyse von Wissenslücken behandelt, welche Helpdesks diese Signale nativ liefern.
Hermes im Vergleich zu einer für den Support gebauten Option für die KB-Pflege
Fairerweise gegenüber Hermes: Wenn Ihre Dokumente Markdown in einem Repository sind und Sie bereit sind, einen Server zu betreiben, ist er ein flexibler, kostenloser Pfleger, und der llm-wiki-Lint ist eine durchdachte Prüfung veralteter Seiten für ein Markdown-Wiki. Kosten entstehen bei der supportspezifischen Anbindung, die KI-Wissensmanagement für ein Support-Team braucht.
| Hermes Agent | eesel Helpdesk-Teammate | |
|---|---|---|
| Wo das Wissen liegt | Ihre KB, erreichbar über MCP oder API, die Sie anbinden | Ihre KB, als Quelle verbunden (Zendesk, Confluence, Notion, Google Drive, Website und mehr) |
| Findet Lücken aus Tickets | Nicht eingebaut | Berichte zeigen eine Karte „Knowledge gaps" aus echten Unterhaltungen |
| Entwirft fehlende Artikel | Ja, über den Entwurfsweg Ihrer Plattform | Der Skill „Update knowledge base" entwirft die fehlenden Artikel |
| Lint veralteter Seiten bei Markdown | Ja, llm-wiki | Nicht der Fokus |
| Prüfung vor Veröffentlichung | Opt-in (trust: untrusted, Schreibfreigaben) | Aktionen laufen über Freigaben |
| Läuft auf | Ihrem Rechner oder Server | Gehostet |
| Kosten | Kostenlose Software plus Modell-Tokens und Hosting | Ab $299/month für 500 Credits, kostenlose Stufe mit 100 Credits |
eesel ist nicht für jeden die bessere Wahl. Wenn Ihr Help Center eine GitHub-Docs-Seite ist und niemand Tickets dazu stellt, ist Hermes mit einem Draft-Pull-Request die angenehmere Schleife. Wenn Ihre Wissensdatenbank dazu da ist, Kunden zu antworten, sind die Tickets das beste Signal, das Sie haben, und dort würde ich ansetzen. Für einen breiteren Überblick decken meine Übersichten zu Hermes-Alternativen und zu KI-Wissensdatenbank-Tools das Feld ab.
eesel für die Pflege der Wissensdatenbank ausprobieren
Wenn Sie keinen Server betreiben möchten, um Ihr Help Center ehrlich zu halten, schließt sich der KI-Helpdesk-Teammate von eesel an das Wissen an, das Sie schon haben. Er verbindet Zendesk, Confluence und Notion als Quellen (bis zu 15.000 Notion-Seiten pro Verbindung), antwortet daraus mit einer Quellenangabe in jeder Antwort und protokolliert jedes Mal, wenn er auf eine Frage stieß, die Ihre Dokumente nicht beantworten konnten.
Diese erscheinen in den Berichten als Wissenslücken, und der Skill „Update knowledge base" entwirft die fehlenden Artikel, die Ihr Team freigibt. Wenn die Kachel dieses Skills in Ihrem Workspace „Contact us" anzeigt, bitten Sie eesel, ihn zu aktivieren.

Es gibt auch ein Kommandozeilen-Tool, sodass Sie oder ein Coding-Agent wie Claude Code, wenn Ihnen der Hermes-Workflow gefallen hat, Quellen verbinden, Anweisungen lesen und angehaltene Aktionen vom Terminal aus freigeben können. Sie können kostenlos mit 100 Credits und ohne Karte auf der Preisseite starten. Testen Sie eesel an Ihrem eigenen Help Center und sehen Sie, welche Lücken es in der ersten Woche findet.