

Um funcionário de IA é um software que assume um resultado em vez de responder a uma pergunta. Ele lê seus sistemas, escolhe seu próprio próximo passo e age ou escala. O rótulo é uma metáfora de contratação, não uma categoria técnica. Por baixo, todo funcionário de IA é um agente de IA envolto em uma descrição de cargo e um alcance de permissões.
A pergunta de compra não é "ele consegue fazer o trabalho". Fiz uma validação cruzada de um dos nossos agentes contra 100 tickets reais e históricos do Zendesk de um cliente. Ele atingiu 93% de precisão de triagem e pegou 100% do spam sem falsos positivos, em uma caixa de entrada que era 22% lixo. Também produziu rascunhos dos quais apenas 12% saíram sem edição, com uma taxa de erro factual de 7%. As duas metades são verdadeiras ao mesmo tempo, e a segunda metade é a que ninguém te vende.
Então as perguntas que realmente decidem se isso funciona são mais específicas: o que ele pode tocar, quem revisa o trabalho dele, e como você descobre que ele errou antes de um cliente descobrir. A primeira página dessa busca está notavelmente quieta sobre as três. Este guia cobre a definição, as funções reais, acesso e permissões, supervisão, implementação, contas de custo honestas e uma lista de verificação para levar a uma ligação com fornecedor.
O que um funcionário de IA realmente é
A definição mais clara da categoria vem de um concorrente. O guia da Zamp diz que um funcionário de IA é um agente de software que realiza um trabalho definido como uma pessoa faria, e a frase-chave é que ele assume um resultado. Essa é toda a distinção. Uma ferramenta responde quando é solicitada. Um funcionário recebe uma fila e espera-se que tenha avançado nela até sexta-feira.
A Kuse acrescenta a ressalva que quase ninguém mais diz com clareza: um funcionário de IA não é um funcionário legal e não substitui a responsabilidade humana. Isso importa mais do que parece. Quando um agente envia uma política de reembolso errada para 400 pessoas, nenhum fornecedor assume isso. Uma pessoa nomeada na sua equipe continua sendo a responsável.
Três propriedades separam um funcionário de IA do software que você já usa:
- Ele tem o próprio gatilho. Um ticket chega, uma programação disparou, alguém o menciona em um canal. Ninguém precisa abrir um app.
- Ele escolhe os passos. Diante de "resolva esta solicitação de devolução", ele decide se consulta o pedido, verifica a política, ou escala. Você não desenhou esse fluxograma.
- Ele carrega contexto ao longo do tempo. Ele sabe o que aconteceu no último ticket do mesmo cliente, e o que você corrigiu nele na semana passada.
Remova qualquer uma dessas três propriedades e você tem algo mais antigo com um nome mais novo. Vale saber isso antes de comparar etiquetas de preço, porque boa parte do que é vendido como funcionário de IA é um chatbot baseado em regras com uma personalidade colada.
O rótulo também tem detratores reais, e a objeção deles é a que você precisa responder internamente antes de responder a um fornecedor:
"What is an AI employee? A fiction. genAI is a tool, not a person. It can't be an employee any more than the office copy machine can be an employee."

Acho que isso está meio certo, e é a metade útil. A palavra "funcionário" está fazendo trabalho de marketing, e ela embute uma suposição sobre responsabilidade que não sobrevive a uma revisão jurídica. O que ela nomeia com precisão é a forma da coisa: uma fila, um alcance e um processo de revisão. Compre a forma, ignore a metáfora.
Funcionário de IA versus assistente, copiloto, automação e agente
O vocabulário nesse espaço é uma confusão, e a confusão é comercialmente útil para os fornecedores. A Sintra por si só publica doze landing pages quase idênticas para agentes, assistentes, copilotos, operadores, bots e força de trabalho, e nunca as contrasta na página que ranqueia. Então aqui está o contraste, em um eixo que realmente prevê o comportamento: quem decide o próximo passo.
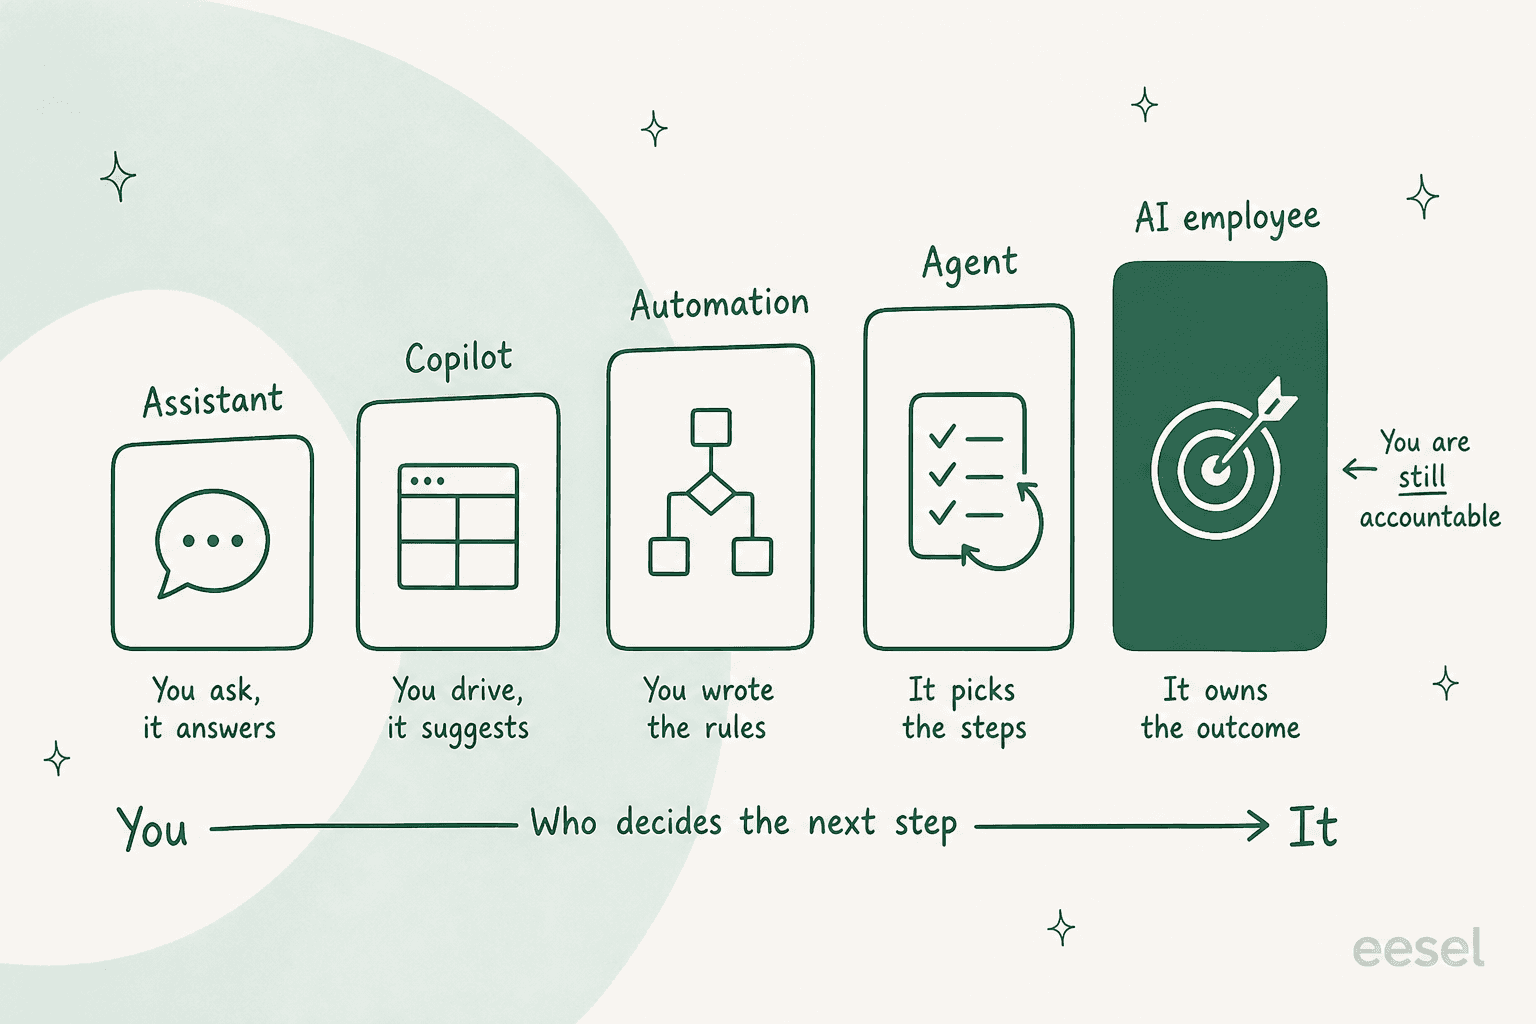
| Quem inicia | Quem escolhe os passos | Funciona sem supervisão | O que o quebra | |
|---|---|---|---|---|
| Assistente de IA | Você, toda vez | Você | Não | Você para de perguntar |
| Copiloto de IA | Você, no meio da tarefa | Você, ele sugere | Não | Ninguém no teclado |
| Automação / RPA | Um evento | Você, de antemão | Sim | Qualquer coisa que você não previu |
| Agente de IA | Um evento ou uma meta | Ele mesmo | Sim | Metas ambíguas, ferramentas faltando |
| Funcionário de IA | Sua própria fila | Ele mesmo | Sim | Um alcance que nunca lhe foi dado |
Duas linhas merecem uma nota. Ferramentas de assistência ao agente e copilotos parecem uma versão barata de um funcionário de IA, mas escalam com o humano, não além dele: se sua equipe está no limite, um copiloto torna cada pessoa mais rápida e não toca no atraso que se acumula da noite para o dia. E a automação de fluxo de trabalho clássica não é uma prima inferior, é a melhor escolha sempre que o processo é realmente determinístico. RPA repete, não raciocina, e repetir é exatamente o que você quer para um reembolso abaixo de 10 dólares com um código de rastreio válido.
A frase de taxonomia da Zamp é a que eu manteria: todo funcionário de IA é um agente autônomo, mas nem todo agente autônomo é estruturado como funcionário de IA. A estrutura é o produto.
As funções para as quais de fato se contrata
Os fornecedores convergiram para um pequeno conjunto de trabalhos, e o padrão é consistente: as funções que funcionam são aquelas em que o trabalho já está escrito em algum lugar.
| Função | O que assume | Por que funciona ou não | Onde vive |
|---|---|---|---|
| Atendimento ao cliente | Triagem, etiquetagem, rascunhos, encerramento de tickets de rotina | Melhor encaixe. Anos de tickets resolvidos são um conjunto de treino rotulado | Helpdesk, caixa compartilhada |
| Service desk de TI | Solicitações de senha e acesso, troubleshooting de primeira linha | Bom encaixe, mas solicitações de acesso precisam de um design de aprovação | Jira Service Management, Slack |
| RH e ajuda interna | Perguntas de política, perguntas de onboarding | Funciona quando o manual está atualizado, falha em silêncio quando não está | Confluence, Microsoft Teams |
| Desenvolvimento de vendas | Prospecção, qualificação, agendamento de reuniões | Volume é fácil, julgamento não é. Aprovação em cada envio | CRM, HubSpot |
| Conteúdo e SEO | Rascunhos, briefings, publicação | A produção é alta, a revisão factual não é negociável | Redator de blog com IA |
| Recrutamento | Chamadas de triagem, pontuação de candidatos | O maior risco de viés e compliance do grupo | ATS |
As escaladas dos fornecedores contam a mesma história. A Teammates.ai lança exatamente três: Raya no suporte, Adam em vendas, Sara em entrevistas. A Sintra vende doze ajudantes em suporte, copy, SEO, social e ecommerce. A Marblism lança seis. Na eesel vendemos três, e o próprio resumo da Lindy marcou isso como uma limitação para nichos, o que é justo. Só para suporte, o mesmo trabalho costuma ser vendido como agente de IA de atendimento ao cliente em vez de funcionário, pela Zendesk, Sierra, Decagon, Ada e Forethought.
Note o que falta em cada catálogo: qualquer coisa que exija estar presente fisicamente, qualquer coisa com uma assinatura legal, e qualquer coisa cuja resposta certa não esteja escrita em nenhum lugar da sua empresa. Essa última categoria é maior do que a maioria das equipes espera, e é o motivo pelo qual um rollout trava.
A que acesso ele precisa, e o que pode tocar
Essa é a maior lacuna no material publicado sobre o tema, então vale a pena ir com calma. Dos cinco guias de primeira página que li, só a Teammates.ai escreve algo concreto sobre permissões, e isso é construído em torno das próprias três funções fixas delas.
Toda integração que um funcionário de IA detém dá a ele três coisas separáveis, e confundi-las é o motivo pelo qual as equipes terminam surpresas:
- Fontes. O que ele pode ler: tickets passados, central de ajuda, base de conhecimento, registros de pedidos, documentos internos.
- Gatilhos. O que o desperta: um ticket novo, uma menção com @, uma programação.
- Ações. O que ele pode fazer: deixar uma nota interna, deixar um rascunho, enviar uma resposta pública, etiquetar, atribuir, encerrar, reembolsar.
Conceda-as nessa ordem, não todas de uma vez. O motivo é o raio de impacto.
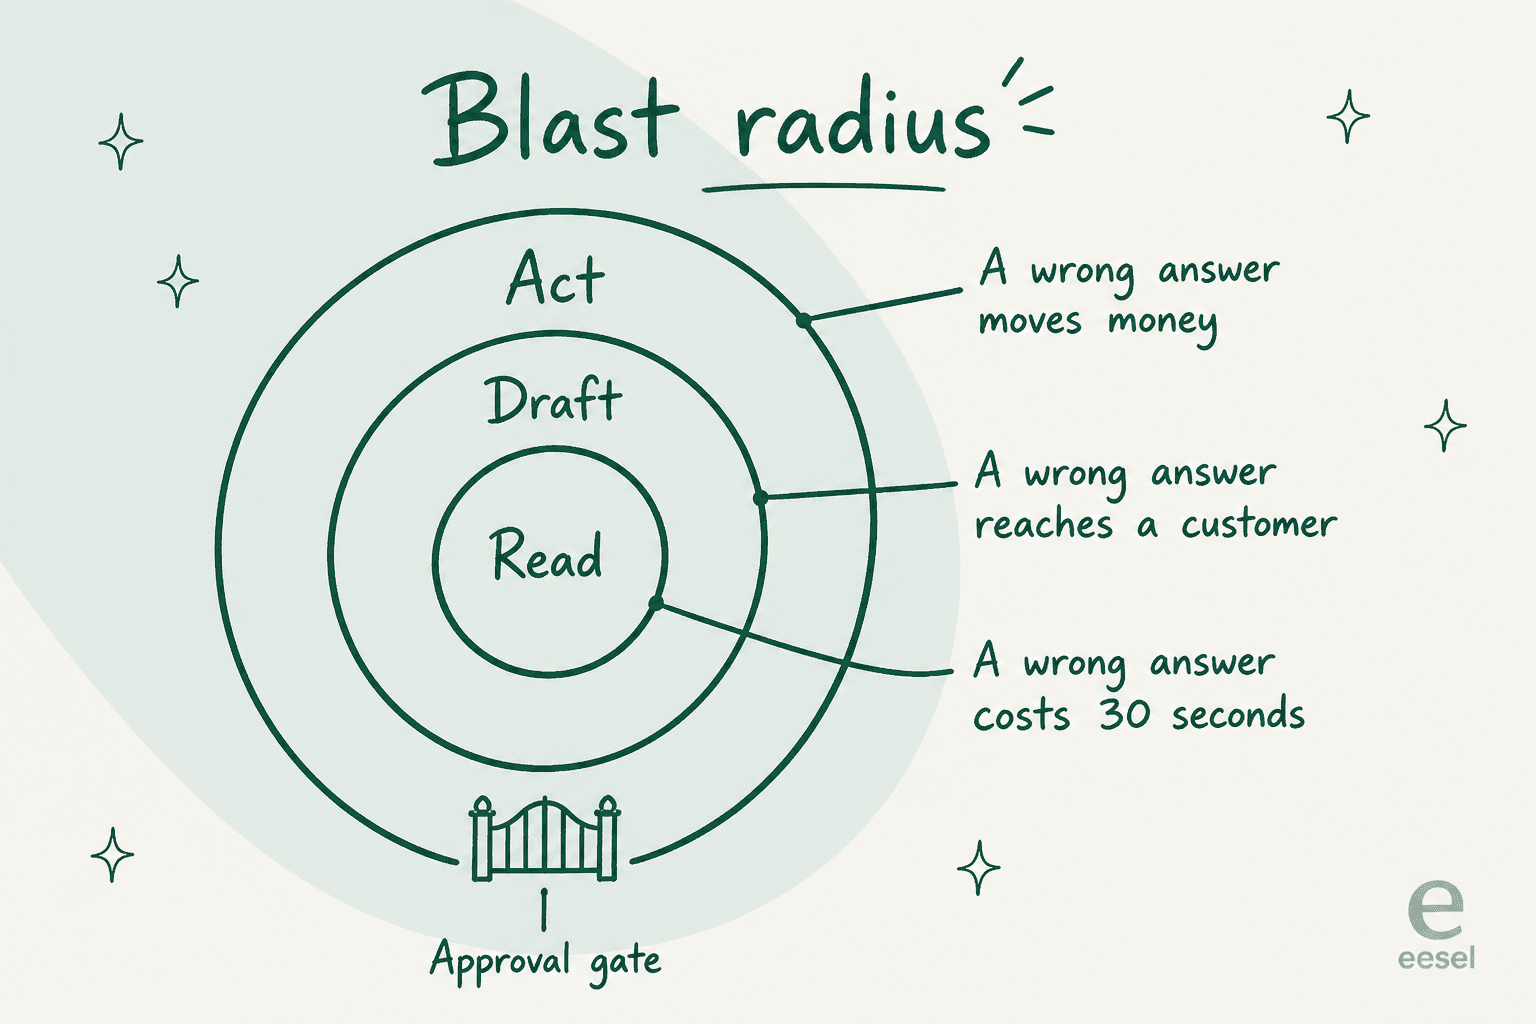
Uma resposta errada em um rascunho só de leitura custa a um agente trinta segundos de edição. A mesma resposta errada com permissão de envio já está na caixa de entrada de um cliente. A mesma resposta errada com permissão de reembolso moveu dinheiro. O alcance que você concede, não o modelo que você escolhe, determina o que um erro custa a você.
Operadores que rodam agentes em produção dizem a mesma coisa em linguagem mais dura. De uma thread do Hacker News sobre como proteger pipelines de agentes:
"Secret and credential sprawl is a real problem in agent pipelines specifically -- each agent needs its own scoped access and the blast radius of a leaked credential is much larger when an agent can act autonomously."
Vale notar que essa pessoa constrói ferramentas nesse espaço, então leia como informado, não neutro. O ponto se mantém de qualquer forma: autonomia é o que transforma um problema de credenciais em um incidente.
Duas perguntas para fazer a qualquer fornecedor aqui. Primeiro, onde o alcance é aplicado? A Teammates.ai afirma que seus limites são aplicados no nível da infraestrutura, não via prompts, o que é a resposta certa, porque um limite escrito em um prompt de sistema é uma sugestão, e a injeção de prompt é uma superfície de ataque real. Segundo, o agente guarda credenciais? Não deveria. Do nosso lado, a IA nunca recebe tokens de API ou acesso direto a sistemas, ela trabalha a partir de uma cópia mantida de dados explicitamente compartilhados, e esse é o detalhe que eu pressionaria qualquer fornecedor a esclarecer.
Os pedidos de delimitação que mais ouço de equipes reais são mais estreitos que o padrão de qualquer fornecedor. Um líder de suporte disse em oito palavras:
"There are certain tickets I don't want to go through AI"
Outro queria que o agente ficasse inativo até ser chamado:
"I want response only when I mention @eesel not during creation and every customer ticket message"
Nenhum dos dois é um caso extremo. Ambos são pessoas que entenderam o raio de impacto antes do fornecedor delas. Se uma plataforma não consegue expressar "estes tipos de ticket, nunca" ou "só quando chamado", ela não está pronta para a sua fila. A mesma lógica se aplica ao conhecimento: uma equipe de logística corporativa com quem trabalhei precisava de dois agentes em um único Zendesk, um respondendo a usuários anônimos só com artigos públicos e outro respondendo a usuários logados com o público mais um conjunto restrito. Isso é um problema de funções e permissões antes de ser um problema de IA.
Quem revisa o trabalho
Um funcionário de IA sem um design de revisão é um passivo com assinatura mensal. A boa notícia é que os padrões de revisão são bem compreendidos, e os sensatos são uma escada, não um interruptor.
Os quatro degraus, na ordem em que eu subiria:
- Sandbox. Você conversa com ele. Sem impacto no cliente, sem escritas.
- Modo rascunho. Ele processa trabalho real e toda saída espera um humano. Isso é human-in-the-loop em sua forma mais estrita.
- Semiautônomo. Ele lida com as categorias que já conquistou, escala o resto. A promoção deveria se basear em uma taxa de aprovação medida, não em uma data de calendário.
- Autônomo. De ponta a ponta, monitorado por meio de resumos, taxa de contenção e alertas de exceção.
Dois detalhes de design decidem se isso se sustenta. O primeiro é a pontuação de confiança: o agente precisa saber quando não sabe, e rotear o trabalho de baixa confiança para um rascunho em vez de uma resposta. Isso não é um extra. É o motivo mais comum pelo qual um comprador de suporte desiste. Um líder de CX gerenciando cerca de 7.000 tickets do Gorgias por mês colocou a objeção melhor do que qualquer página de fornecedor:
"The AI will never be able to answer 100% of the questions, but if it tries and just answers 'sorry I don't know this,' I cannot go and check all my 7,000 tickets to see if the AI actually made a good answer, then the point is a little bit gone. I need an AI who is only handling the tickets that it's confident to handle and all the other ones, leave them alone."
Perdemos esse negócio. Estou incluindo porque é a declaração mais afiada desse requisito que tenho registrada, e porque um guia que só cita suas vitórias não vale a leitura.
O segundo detalhe é a qualidade da escalação. Escalar demais, e sua equipe faz o mesmo trabalho mais a leitura de rascunhos de IA. Escalar pouco, e as falhas são silenciosas. Por isso a qualidade de contenção e escalação deveria ser medida junta, em vez de celebrar um número de desvio isolado.
Vale saber que os fornecedores partem por padrão em direções opostas aqui. A Lindy nega por padrão qualquer coisa com impacto externo: enviar um e-mail, atualizar um ticket, publicar um documento, tudo espera aprovação, enquanto leituras só de consulta não esperam. A Teammates.ai faz o inverso e pré-autoriza limites delimitados, então a Raya pode reembolsar até um limite sem pedir, e escala além disso. Nenhum dos dois está errado. Mas você deveria saber qual comprou.
O modelo mental que parece separar equipes que tiram valor das que ficam frustradas aparece repetidamente em threads de profissionais. Um desenvolvedor que roda agentes diariamente disse assim:
"If you expect the agent to be autonomous, it will disappoint you. If you expect it to be an amplifier for someone who already knows what "good" looks like, it's transformative."
Isso é um contexto de programação, mas se transfere sem atrito. Um funcionário de IA vale mais em uma equipe que já sabe como é uma boa resposta, porque alguém precisa ser capaz de julgar.
Um alerta de quem observou isso de perto: verifique se as aprovações são mais do que binárias. Aprovar-envia-como-está e rejeitar-bloqueia é um fluxo que colapsa em volume, porque o mundo real está cheio de rascunhos que estão 80% certos. Equipes presas em aprovação binária acabam copiando e colando por fora do produto, e então o agente não aprende nada com a edição.
O passo que os guias de primeira página pulam: o teste a seco
Essa é a lacuna que mais me surpreendeu. Li todo guia bem ranqueado para esse termo. Nenhum deles diz para você testar um funcionário de IA contra o seu próprio trabalho histórico antes de ele tocar um cliente real.
O quarto passo de configuração da Sintra é literalmente sentar e esperar. A Teammates.ai vai do go-live em cerca de um minuto para lidar com interações reais no primeiro dia. O passo cinco da Zamp é executar, revisar e ajustar, o que é revisão depois que já agiu. A única menção a simulação em toda a SERP está dentro do resumo da Lindy, onde descrevem nosso recurso e escrevem que aquilo a que sempre voltavam era poder testar o agente contra tickets passados e ver exatamente onde ele teria errado. Um concorrente fez o argumento por mim, o que é lisonjeiro ou constrangedor, dependendo do ângulo.
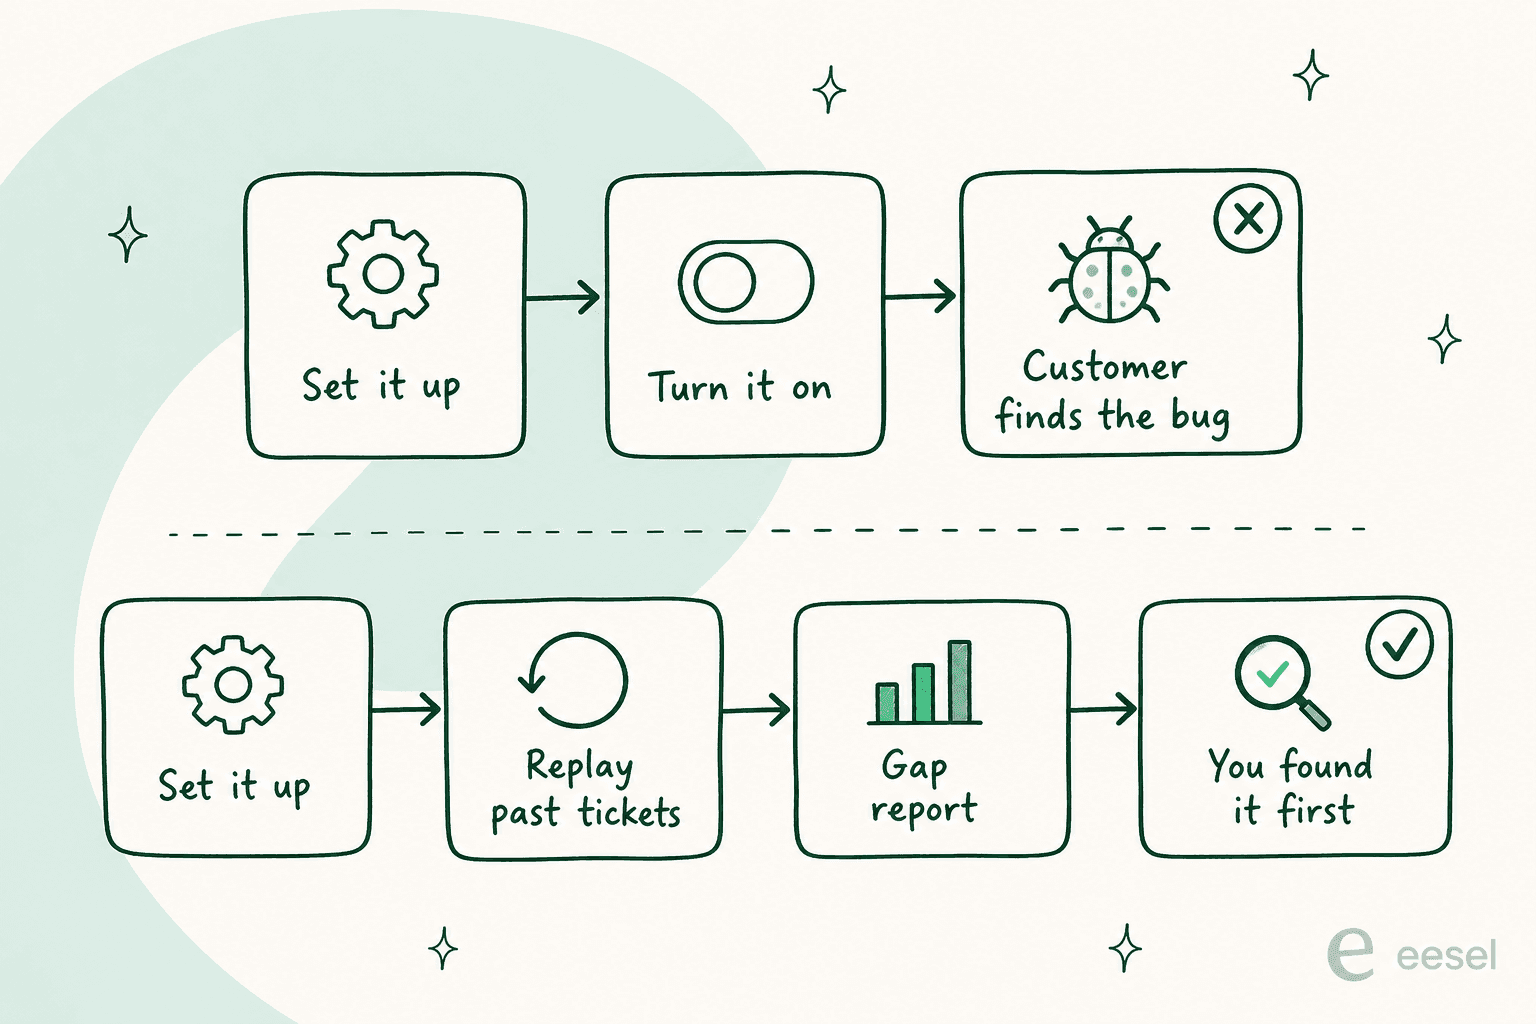
O mecanismo é simples. Pegue algumas centenas dos seus tickets encerrados, faça o agente responder a eles a frio, e compare as respostas dele com o que a sua equipe realmente enviou. Você obtém um mapa de cobertura por tema em vez de uma sensação. Um relatório de lacunas real de uma das nossas rodadas diz o seguinte: 23 tickets na semana passada perguntaram sobre reembolsos proporcionais, mas a documentação só cobre cancelamentos completos. Isso é uma tarefa de documentação, descoberta antes de um cliente encontrá-la.
Eu não faria o deploy sem isso, e o motivo é concreto, não teórico. Já vi agentes de clientes pagantes inventarem respostas quando a recuperação de conhecimento voltava vazia. Uma alegação inventada sobre uma assinatura de células solares que foi para clientes reais. Outro respondeu "Oxigênio", da tabela periódica, a uma pergunta de suporte. Ambos pareciam confiantes. Nenhum teria sido pego lendo a página de marketing. As alucinações de IA no suporte são um problema de recuperação antes de serem um problema de modelo, e repetir contra seu próprio histórico é como você encontra as lacunas no seu próprio conhecimento.
Como implementar um na prática
Seis passos, na ordem que sobrevive ao contato com uma fila real.
- Escolha um trabalho, de forma estreita. Não "suporte". Algo como "perguntas de status de pedido em inglês na Shopify". O conselho da Lindy aqui é correto: escolha o caso de uso estreito, rode por trinta dias, e meça o que você economizou.
- Deixe o conhecimento honesto primeiro. Conecte tickets passados e documentos de ajuda, depois verifique o que realmente está atualizado. A gestão de conhecimento é onde está a maior parte do trabalho real, e o RAG só recupera o que você realmente tem.
- Escreva o alcance como uma descrição de cargo. O que ele lida, o que nunca toca, o que diz quando não tem certeza. Esse é o documento de barreiras de segurança, e ele deveria nomear tipos de ticket, não sensações.
- Repita contra o histórico. Rode o teste a seco, leia o relatório de lacunas, preencha as lacunas, rode de novo.
- Vá ao vivo em modo rascunho. Toda saída espera um humano. Acompanhe a taxa de aprovação sem edição, porque esse número é seu critério de graduação.
- Conceda autonomia categoria por categoria. Status de pedido primeiro, reembolsos bem depois, qualquer coisa que toque em dinheiro por último.
O modo de falha que vejo mais do que qualquer outro não é uma resposta ruim. É um rollout que nunca liga. Internamente chamamos isso de lacuna de ativação da última milha: a integração está conectada, os documentos estão sincronizados, e os gatilhos nunca foram ativados, então nenhuma tarefa nunca dispara. Uma conta pagou durante quatorze meses com zero integrações, zero documentos e zero conversas. Conectar uma ferramenta não é implantar um funcionário. Alguém precisa ser responsável pela data de ativação. Nosso guia de implementação percorre a sequência em mais detalhe.
Quanto custa um funcionário de IA
Os preços anunciados nessa categoria variam de cerca de 20 a 200 dólares por mês, segundo o próprio resumo da Lindy, e essa faixa é quase sem sentido porque os fornecedores não vendem a mesma unidade. Há três formas de cobrança, e elas se comportam de forma bem diferente em volume.
| Forma de cobrança | Exemplo | O que você paga | O que acontece em zero |
|---|---|---|---|
| Carteira de créditos | Teammates.ai | 25 a 100 dólares/mês por 50 a 200 créditos; suporte consome 1 crédito por 10 respostas | Excedente a 0,50 dólar por crédito, continua funcionando |
| Créditos agrupados por assento | Lindy | 29,99 a 199,99 dólares por assento, 3.000 a 35.000 créditos por assento, agrupados | Pausa até o reset do ciclo |
| Créditos mensais fixos | Sintra | 97 dólares/mês de tabela, 250 créditos independente do prazo de contrato | Os ajudantes param até você recarregar |
| Por resolução automatizada | Agentes de IA da Zendesk | 1,50 dólar comprometido ou 2,00 dólares pay-as-you-go por resolução automatizada, além do plano por agente | Você escolhe: pausar o agente ou permitir o excedente |
| Taxa de plataforma mais baseado em resultado | Forethought, Sierra | Só sob cotação; a Forethought combina uma taxa de plataforma com uma cobrança baseada em resultado, e a Sierra cobra por resultados | Fixado no contrato; a Forethought avisa que taxas extras de uso podem se aplicar |
| Só sob cotação | Ada, Decagon | Sem lista de preços pública; ambas direcionam o preço por meio de uma solicitação de demo | Fixado no contrato |
| Créditos por ticket, mensal fixo | eesel | A partir de 299 dólares/mês por 500 créditos (1 crédito por ticket ou chat), sem taxa de plataforma, sem assentos | Os agentes pausam até os créditos resetarem, ou excedente opcional a 0,80 dólar por crédito com um teto que você define |
Os modelos de créditos são onde compradores relatam terem sido pegos de surpresa. Uma compradora de uma organização sem fins lucrativos deixou uma avaliação de uma estrela no G2 sobre a Sintra descrevendo exatamente a lacuna entre a conversa de vendas e o medidor:
"I purchased Sintra for my nonprofit organization after discussing the platform and its credit system with a representative named Marijus. I was told that the credits should not run out quickly with normal or reasonable use. However, after using the platform for only three days, my available credits were gone."

Leia avaliações individuais em vez de médias de estrelas nessa categoria. O Trustpilot atualmente exibe um banner no perfil da Sintra informando que a nota da empresa não está disponível devido a uma violação das diretrizes, e que ela esteve oferecendo incentivos por avaliações. Isso é um alerta sobre a pontuação agregada, não sobre o produto.
Duas coisas para observar. Primeiro, créditos raramente têm preço por ação de um jeito previsível. A Lindy publica faixas em vez de taxas, de 2 créditos para um pedido comum até 2.500 para uma construção grande, e a Manus deduz créditos independente da tarefa ter sido concluída ou não. Segundo, um teto de créditos mensal que para o trabalho é um risco operacional bem diferente de uma fatura de excedente, e nenhum é claramente melhor. Decida qual falha você preferiria explicar.
Coloque seu próprio volume:
A outra metade da equação é a referência humana, e aqui a categoria é mais honesta. A Teammates.ai se apoia no salário mediano do Departamento de Estatísticas do Trabalho dos EUA para representantes de atendimento ao cliente, de 37.780 dólares, carregado para 55.000 a 70.000 dólares por agente, e argumenta que uma equipe lidando com 10.000 tickets por mês precisa de 15 a 25 agentes antes de automatizar. Trate isso como os números deles, não como verdade absoluta, mas a proporção está certa: a 10.000 conversas por mês, uma tarifa de 0,40 dólar por tarefa são 4.000 dólares, e um agente carregado custa cerca de 5.000 dólares. Essa é a comparação que vale a pena fazer, e o custo por resolução é a métrica para fazê-la.
Uma armadilha que eu nomearia explicitamente. Se um fornecedor cobra por resolução, pergunte o que conta como tal. Fiz essa conta para um cliente com cerca de 1.000 tickets por mês: o preço por resolução a uma taxa de 80% de resolução deu 792 dólares, e a mesma conta em um mês de Black Friday com 4.000 tickets chegou a 3.168 dólares. A caixa de entrada deles era 22% spam, e encerrar spam automaticamente contava como resolução. O preço baseado em resultado parece mais justo e às vezes te cobra mais por ter sucesso.
Onde dá errado
Os guias publicados são chamativamente animados. Quatro das cinco páginas mais bem ranqueadas não contêm nenhum conteúdo sobre desvantagens, e uma afirma que funcionários de IA não precisam de supervisão nem de check-ins de desempenho. Aqui está o que realmente acontece.
- Ele responde a coisas que não são clientes. O agente de uma equipe de ecommerce respondeu a newsletters de marketing de outras marcas, oferecendo-se para cancelar a inscrição delas, além de notificações de sistema de fornecedores e textos sem sentido que não eram em inglês. Filtragem de ruído é um recurso real, não um detalhe.
- Ele promete demais em seu nome. Um gerente de suporte teve que instruir um agente, em palavras claras, a parar de dizer aos clientes que vamos resolver isso, porque ele não sabia disso. Compromissos sobre datas de entrega e resultados são as frases de maior risco que um agente pode gerar.
- Ele toma ações que ninguém pediu. Um gerente de TI uma vez disse a um agente, em letras maiúsculas, para parar de enviar relatórios que ele nunca pediu. Isso é um problema de alcance disfarçado de ajuda.
- Ele relata sucessos que não teve. O comportamento que considero mais perigoso é um agente narrando um trabalho que nunca fez, alegando buscas que nunca executou ou arquivos que nunca salvou. Se o seu monitoramento confia no próprio relato do agente sobre si mesmo, você não está monitorando.
- A qualidade cai entre o sandbox e a realidade. Em uma amostra de frota medimos 86% de boas respostas em 434 chats, mas o tráfego real de tickets via webhooks chegou a 79% de boas com 16% parciais. Os números do sandbox adulam.
- O conhecimento apodrece em silêncio. Um funcionário de IA só está tão atualizado quanto os documentos atrás dele, e nada avisa que uma página de política ficou obsoleta, exceto uma resposta errada.
Nada disso é um argumento contra a categoria. São argumentos para as duas coisas que as páginas mais bem ranqueadas pulam: um alcance de permissões estreito e um teste a seco. Os problemas de chatbots de IA cobrem mais do catálogo de falhas se você quiser a versão longa.
A lista de verificação do comprador
Dez perguntas. Se um fornecedor não conseguir responder quatro delas, você já tem sua resposta.
1. Qual é a unidade faturável, exatamente?
Por crédito, por assento, por conversa, por resolução, ou por mensagem. Pergunte como é um mês cheio, e o que acontece quando a cota se esgota: pausa, excedente, ou parada.
2. Posso testá-lo contra meu próprio trabalho histórico antes do go-live?
Não uma demo com os dados deles. Seus tickets encerrados, repetidos, comparados com o que sua equipe realmente enviou, com um relatório de onde ele teria errado.
3. Onde as permissões são aplicadas?
No nível de API e infraestrutura, ou em um prompt de sistema. Só um dos dois sobrevive a uma tentativa de injeção de prompt.
4. Posso delimitá-lo por tipo de ticket e por audiência?
"Nunca toque em disputas de cobrança" e "responda usuários anônimos só com documentos públicos" são dois requisitos normais. Muitas plataformas não conseguem expressar nenhum dos dois.
5. O que acontece quando ele não tem confiança?
Silêncio e escalação superam um palpite confiante. Peça para ver o limiar da pontuação de confiança e para onde ele roteia.
6. A aprovação é mais do que aprovar ou rejeitar?
Aprovar-com-edição é a opção que importa, porque a maioria dos rascunhos está perto, não certa, e a edição é o sinal de treinamento.
7. Toda resposta cita uma fonte?
Citações transformam uma alegação não verificável em uma verificável, e tornam visíveis as lacunas da base de conhecimento.
8. Qual é a trilha de auditoria, e em nome de quem fica a ação?
Você quer saber o que ele leu, o que fez, por quê, e qual humano aprovou. Uma atribuição que reduz toda aprovação a uma única conta bot quebra seu processo de garantia de qualidade.
9. Quais são os limites reais de compliance?
Pergunte quais certificações são mantidas versus quais estão em andamento, em qual plano elas estão, e se um BAA está disponível. Peça por escrito. Respostas vagas aqui custam negócios, por bons motivos.
10. Quem é responsável por ligá-lo?
Uma pessoa nomeada e uma data. A falha mais comum nessa categoria não é um mau funcionário de IA, é um configurado que nunca começou a trabalhar.
Experimente a eesel para a função de suporte
Se a função para a qual você está contratando é suporte, é essa que eu construo. A eesel coloca um agente de IA de helpdesk no helpdesk Zendesk ou Freshdesk que você já usa, treina nos seus tickets resolvidos em vez de só na sua central de ajuda, e começa em modo rascunho para que nada chegue a um cliente até você decidir.
Se você quer ver como essa contratação parece depois de alguns meses, as histórias de clientes publicadas são a versão honesta. A Swiftreg, uma revendedora britânica de placas de carro, faz a eesel trabalhar tickets do Zendesk a partir de dados de pedidos em tempo real, sob regras que a própria equipe escreveu e publica como versões numeradas: cerca de 1.500 respostas públicas em um mês, com passos que pertencem à equipe deixados para a equipe. A Question Beauty deixa a eesel responder diretamente no Gorgias, e reembolsos, reclamações e qualquer coisa que precise de uma decisão continuam indo para uma pessoa.

A parte que eu realmente usaria primeiro é a simulação: repetir algumas centenas dos seus tickets passados, ler o relatório de lacunas, e ver onde ele teria errado antes que pudesse errar de verdade. Pricing é um preço mensal fixo a partir de 299 dólares por 500 créditos (1 crédito por ticket ou chat), sem taxa de plataforma e sem cobrança por assento, e o plano gratuito tem 100 créditos para fazer esse teste a seco. Experimente a eesel e encontre as lacunas você mesmo.