O que as pessoas realmente querem dizer com "API de agente de suporte ao cliente"
Pesquise "customer support agent API" e você vai obter resultados que quase não têm nada a ver uns com os outros. Isso acontece porque a expressão reúne três trabalhos genuinamente diferentes em uma única frase, e o leitor por trás de cada resultado quer uma coisa diferente.
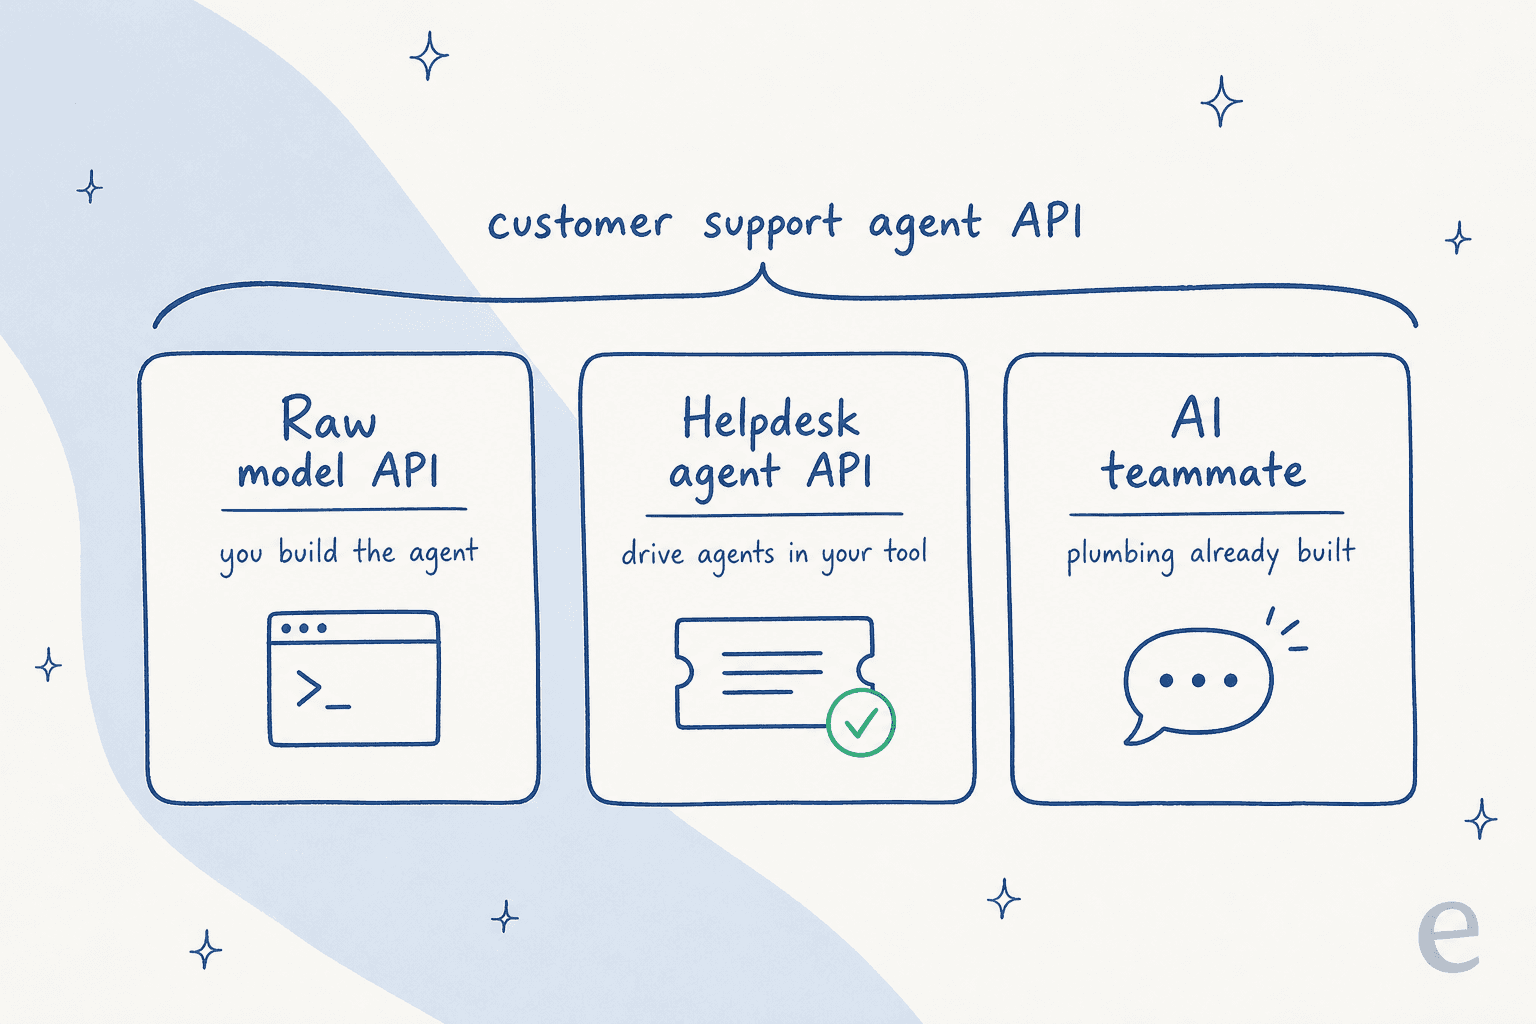
Os três caminhos, em ordem de quanto você mesmo constrói:
- Construa o seu sobre uma API de modelo de fundação. Você recebe um modelo e primitivas; você monta o agente.
- Conduza o seu helpdesk por meio da API de agente, conversas ou MCP dele. O fornecedor é dono da superfície de suporte; você aponta um agente para ela.
- Contrate um colega de equipe já pronto que já sabe fazer suporte. A infraestrutura está construída; você configura e entra no ar.
Vou percorrer cada um, o que ele realmente entrega e onde mora o trabalho escondido. Se você só levar uma coisa deste artigo: a API nunca é o agente. Vamos entender o porquê.
Caminho 1: construa o seu sobre uma API de modelo pura
Este é o caminho que a maioria dos engenheiros imagina primeiro, e é o que silenciosamente vira um projeto de nove meses. Tanto a OpenAI quanto a Anthropic vendem infraestrutura de modelo, não um agente de suporte pronto. Ambas são excelentes no que fazem. Elas simplesmente cobrem uma fatia muito menor de "agente de suporte ao cliente" do que a expressão sugere.
Aqui está o que você recebe. A Responses API da OpenAI é a principal superfície de chamadas, e o Agents SDK de código aberto executa o loop do agente no seu próprio processo. A documentação da OpenAI é direta sobre a divisão: você é dono do "deployment, das implementações de ferramentas, do armazenamento de estado e das decisões de aprovação, enquanto o SDK executa o loop do agente". O formato da Anthropic é o mesmo. A Messages API mais o uso de ferramentas te dá uma chamada de ferramenta estruturada; seu código a executa. O Claude Agent SDK adiciona sessões, hooks, subagentes e permissões, mas o loop ainda roda no seu processo e a persistência é sua integração.
Ambos te dão os mesmos blocos de construção: um modelo, uma forma de definir ferramentas, um loop de agente, primitivas de recuperação hospedadas (a busca de arquivos da OpenAI, o uso de ferramentas no lado do servidor na Anthropic) e, para suporte por voz, a Realtime API da OpenAI. O que nenhum dos dois te dá é o agente de suporte de fato.
O que a API te entrega vs. o que você constrói
A lacuna é maior do que parece em um quickstart. Uma função de "buscar o pedido e emitir o reembolso" é uma chamada de ferramenta que o modelo emite; o código que fala com a Shopify e com seu sistema de faturamento é inteiramente seu. O mesmo vale para toda outra peça estrutural de um agente de suporte.
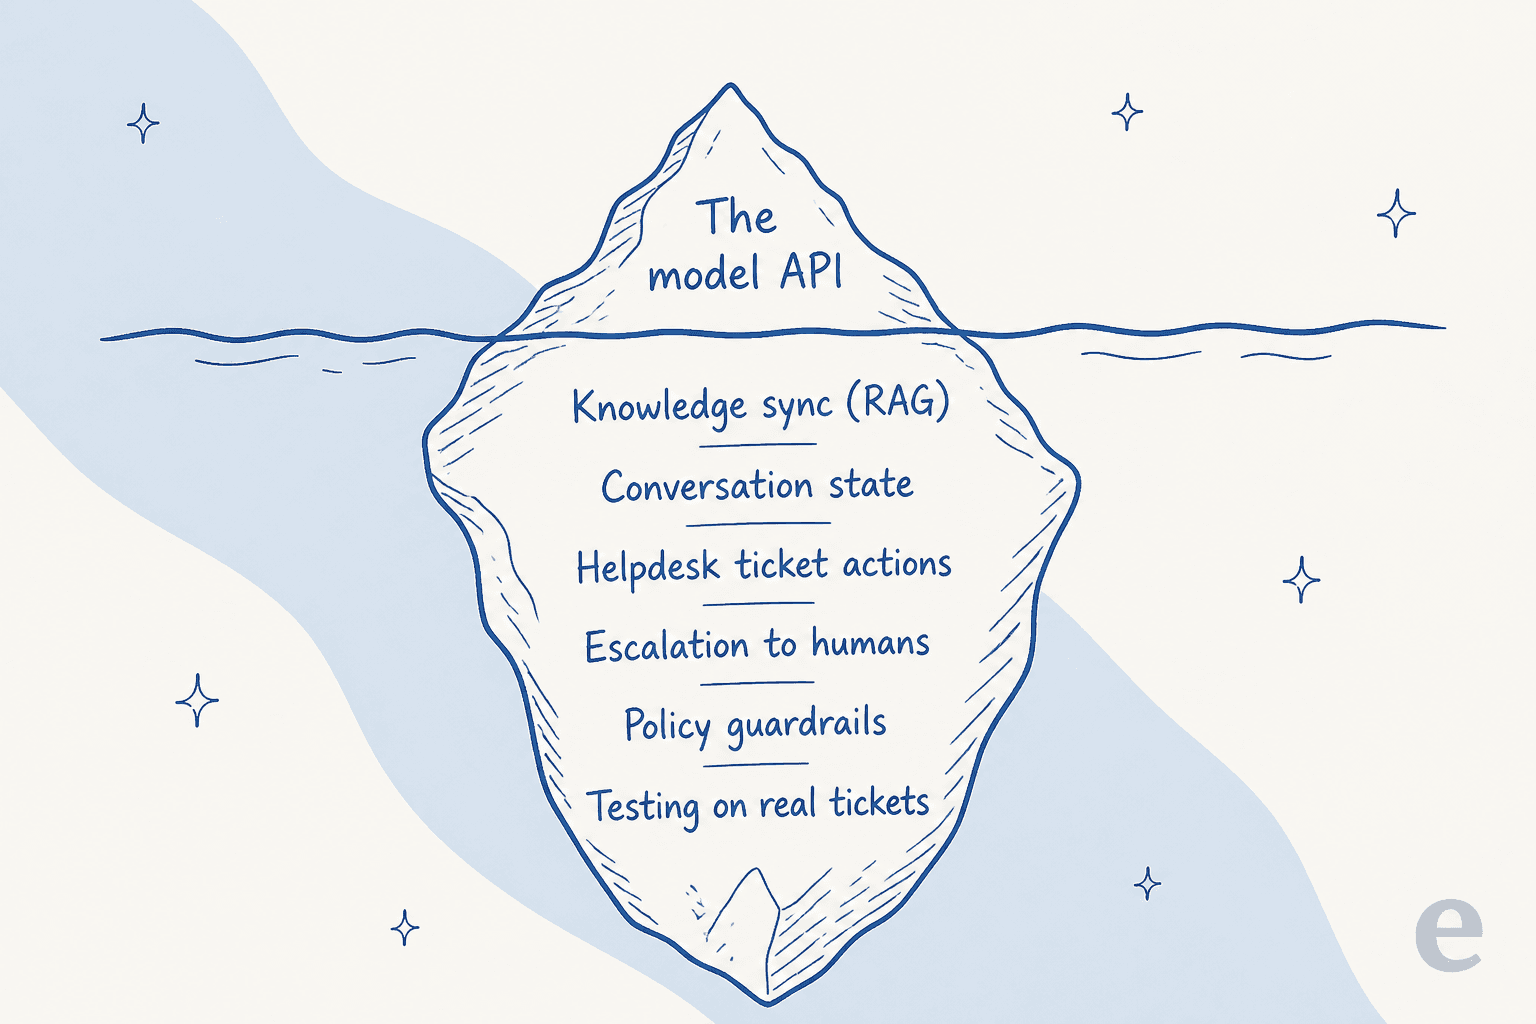
Tudo abaixo da linha d'água é engenharia sua:
- Sincronização de conhecimento e recuperação. A busca de arquivos e o uso de ferramentas te dão um mecanismo de recuperação, mas mantê-lo sincronizado com sua central de ajuda ao vivo, além de chunking, reranking e controle de acesso, é seu.
- Estado da conversa. As APIs base não mantêm estado entre chamadas. Você armazena e reenvia o histórico.
- Ações em tickets. Atualizar um ticket do Zendesk, escalar para o nível 2, aplicar uma tag: tudo são ferramentas de função que você implementa.
- Guardrails e escalonamento. Ambos os SDKs expõem guardrails de entrada, saída e ferramenta, além de aprovação humana, mas cada um é código que você escreve por política.
- Testes contra tickets reais. Você recebe rastreamento e hooks de avaliação. O conjunto de testes que reproduz seu histórico e pontua as respostas é seu.
Isso não é uma crítica aos provedores de modelo. É simplesmente o escopo honesto. Se você quiser a comparação mais profunda de primitivas, nossa análise AgentKit vs Anthropic API percorre ferramenta por ferramenta.
A conta por token que ninguém prevê
O modelo de custo é a surpresa mais dura. Você paga por token em cada mensagem, o ticket sendo resolvido ou não, pelo prompt de sistema, pelos trechos de conhecimento recuperados, pelas idas e vindas das chamadas de ferramentas, pelo raciocínio do modelo e por cada nova tentativa.
Preços aproximados dos próprios fornecedores, por milhão de tokens no nível padrão:
| Modelo | Entrada | Entrada em cache / acerto | Saída |
|---|---|---|---|
| OpenAI gpt-6-astra | $10.00 | $1.00 | $50.00 |
| OpenAI gpt-5.6-terra | $2.00 | $0.20 | $12.00 |
| Anthropic Claude Opus 5 | $5.00 | $0.50 | $25.00 |
| Anthropic Claude Sonnet 5 | $2.00 | $0.20 | $10.00 |
| Anthropic Claude Haiku 4.5 | $1.00 | $0.10 | $5.00 |
O cache de prompt ajuda muito no suporte, já que você reenvia o mesmo contexto da central de ajuda em cada turno: um acerto de cache é lido a cerca de 10% do preço padrão de entrada. Mas o cache suaviza o número, não muda a unidade de cobrança. Uma conversa de suporte que dura dez turnos, recupera doze trechos a cada turno e faz duas novas tentativas, cobra tudo isso, mesmo que o cliente vá embora insatisfeito.
Caminho 2: conduza seu helpdesk pela própria API de agente dele
O segundo caminho pula a construção do agente inteiro e, em vez disso, aponta um para o helpdesk que você já usa. Todo helpdesk relevante expõe uma superfície programática, e o formato dessa superfície mudou bastante no último ano.
A versão clássica é uma API REST mais webhooks. Pegue o Zendesk. Você pode conectar um modelo externo por quatro caminhos: um conector próprio com sua própria chave, um webhook a partir de um gatilho para seu próprio serviço e de volta via API REST, um app de barra lateral chamando o modelo pelo proxy do Zendesk, ou um servidor MCP. Funciona, mas o pipeline feito por você (caminho dois) significa que você é responsável pela autenticação, pelo polling, pelas novas tentativas e, crucialmente, pelos limites de taxa. Esses limites são o teto real de qualquer integração:
| Plano do Zendesk Suite | Requisições de API / minuto |
|---|---|
| Team | 200 |
| Growth | 400 |
| Professional | 400 |
| Enterprise | 700 |
| Enterprise Plus | 2.500 |
Todo enriquecimento, toda escrita de volta e todo reprocessamento de tickets históricos gasta do mesmo orçamento por minuto. É fácil esquecer isso até que um job de reprocessamento em massa o ultrapasse.
O MCP está mudando esse caminho silenciosamente
A mudança maior é que os helpdesks passaram de "aqui está uma API REST, construa você mesmo" para oferecer seus próprios servidores de Model Context Protocol. O MCP é um padrão aberto, introduzido pela Anthropic, para conectar agentes a sistemas externos por meio de um protocolo padronizado, em vez de uma integração sob medida por ferramenta. A própria forma como o Zendesk descreve a antiga dor é reveladora: conectar dados em tempo real à IA hoje "exige APIs, um desenvolvedor experiente (ou dois) e prazos longos", e agora eles promovem um cliente MCP do Zendesk em que, "diferentemente das APIs, as integrações MCP só precisam ser configuradas uma vez".
A lista de servidores próprios cresce rápido:
- A Gorgias oferece um servidor MCP gratuito em
mcp.gorgias.com/mcp, agora em beta aberto, que conecta um workspace a qualquer cliente compatível com MCP. - O Front documenta um servidor em
mcp.frontapp.com/mcpcom um modelo de permissões incomumente limpo: OAuth 2.1 com PKCE, tokens por usuário, e os escoposread,write,send, de modo que "as permissões efetivas do agente são exatamente as permissões do colega que autoriza". - A Atlassian opera um servidor MCP remoto oficial que conecta Jira, Confluence e Jira Service Management a agentes via OAuth. Para um público de ITSM, essa é a principal forma de conduzir uma central de serviços a partir de um agente.
Isso é uma ótima notícia para o cálculo de comprar versus construir. A infraestrutura que você costumava escrever à mão, agora o fornecedor mantém. O que o MCP não resolve é o agente em si: o servidor expõe ferramentas, mas o cérebro, a qualidade da recuperação e os guardrails que decidem quando de fato emitir aquele reembolso ainda são seus para trazer. Se você quiser a versão sem código para conectar um modelo a um helpdesk, nosso guia sobre integrar o ChatGPT com o Zendesk cobre isso.
Caminho 3: contrate um colega de equipe que traz a infraestrutura pronta
O terceiro caminho é o que corresponde ao que a maioria das pessoas que digitam "customer support agent API" realmente quer: um agente que já sabe fazer suporte, que elas podem apontar para sua própria stack e configurar, em vez de montar. É aqui que uma ferramenta como a eesel se encaixa, e vale a pena ser preciso sobre por que ela é uma categoria diferente dos dois primeiros caminhos, e não apenas um invólucro mais bonito sobre eles.
Um colega de equipe de helpdesk com IA chega com todo o iceberg já pronto. Ele treina com seus tickets passados e sua central de ajuda, entra na fila dentro do helpdesk que você já usa, consulta pedidos, marca e triagem, e redige ou envia respostas. A stack de recuperação, o estado da conversa, as ações em tickets e a lógica de escalonamento estão todos resolvidos. Você configura o comportamento, não implementa infraestrutura.
A parte que mais importa para um desenvolvedor é que "já pronto" não significa "caixa fechada". A eesel mantém uma superfície programável real para as bordas que os padrões não cobrem:
- Network Access permite que o agente acesse qualquer API REST que você autorizar, com GET, POST, PATCH e DELETE, e cabeçalhos de autenticação por domínio. As credenciais são armazenadas como cabeçalhos e nunca são mostradas ao modelo.
- Webhooks dão a qualquer ferramenta uma URL única que acorda o agente com o que quer que ela envie.
- Uma CLI e skills personalizadas permitem que você programe as partes que quer controlar, e uma única skill pode abranger várias ferramentas em uma execução: ler o helpdesk, checar a Shopify, postar no Slack.
A distinção que eu manteria: uma API de modelo pura é infraestrutura, e a eesel é a funcionária. Você continua escrevendo código onde o código agrega valor; só não precisa reconstruir recuperação, estado e conectores de helpdesk do zero para chegar lá.
Os 90% que a palavra "API" sempre esconde
Aqui é onde eu questionaria o instinto de construir. O consenso dos desenvolvedores que de fato lançaram agentes de suporte é notavelmente consistente, e não é "nunca construa". É que a chamada ao modelo é a parte fácil, e a manutenção contínua é onde o custo mora.
Comece pela recuperação, que todo mundo subestima. A thread de RAG com mais engajamento no Hacker News (551 pontos) é um post-mortem sobre o processamento de mais de 5 milhões de documentos, e um engenheiro da Microsoft que mantém um template de RAG de código aberto popular rebateu com força o instinto de "só adicione um banco vetorial":
"So few developers realize that you need more than just vector search for RAG, so I still spend many of my talks emphasizing the FULL retrieval stack for RAG."

A própria conclusão do autor original foi que a recuperação de tentativa única não é suficiente; você acaba precisando de um loop agêntico que avalia resultados e faz consultas de acompanhamento. Isso é um sistema real, não uma opção de configuração.
Depois há o problema de que um agente de suporte pode agir, não só falar. Em um Ask HN sobre como prevenir alucinações em produção, a formulação mais afiada foi exatamente sobre isso:
"The failure mode I keep seeing isn't hallucination per se... it's blurred responsibility between intent and execution. Once a model can both decide and act, you've already lost determinism."
Um agente que pode emitir reembolsos ou mudar o estado de uma conta precisa de espaços de ação restritos e listas de permissão/negação, não apenas de um prompt melhor. E você não consegue saber se seus guardrails seguram sem testes, o que quase ninguém faz direito. Como colocou uma thread do r/AI_Agents, "nenhum erro lançado" e "tarefa concluída" podem ser ambos verdadeiros enquanto a resposta estava errada de um jeito que importa. Esse é o argumento mais forte para a simulação: reproduzir tickets reais do passado e pontuar as respostas do agente contra o que sua equipe realmente enviou, em um ambiente isolado, antes que ele toque uma fila ao vivo. É uma das skills centrais da eesel exatamente por esse motivo, e é a coisa que uma construção do zero quase sempre entrega sem.
Por fim, a manutenção contínua, que é o número real. O alerta de realidade mais citado, de uma thread do r/AI_Agents com mais de 460 comentários, nomeia isso diretamente:
"The hardest part wasn't the LLM or voice quality - it was keeping the agent's knowledge current as policies changed and edge cases emerged."

Essa é a manutenção que a maioria dos planos de construir por conta própria nunca orça. Rodamos IA em filas de suporte ao vivo há anos, e os casos extremos são o trabalho todo: a política que mudou na semana passada, a linha de produto lançada ontem, aquele fluxo de reembolso esquisito que quebra qualquer agente genérico. É exatamente o trabalho que não aparece em um quickstart e nunca para.
Por token vs. por resultado: o modelo de custo que realmente decide
Dando um passo atrás, os três caminhos se dividem claramente em um eixo: como você paga. Os caminhos um e dois te colocam em um medidor por token. Um agente já pronto normalmente cobra por unidade de trabalho resolvido, em vez disso.
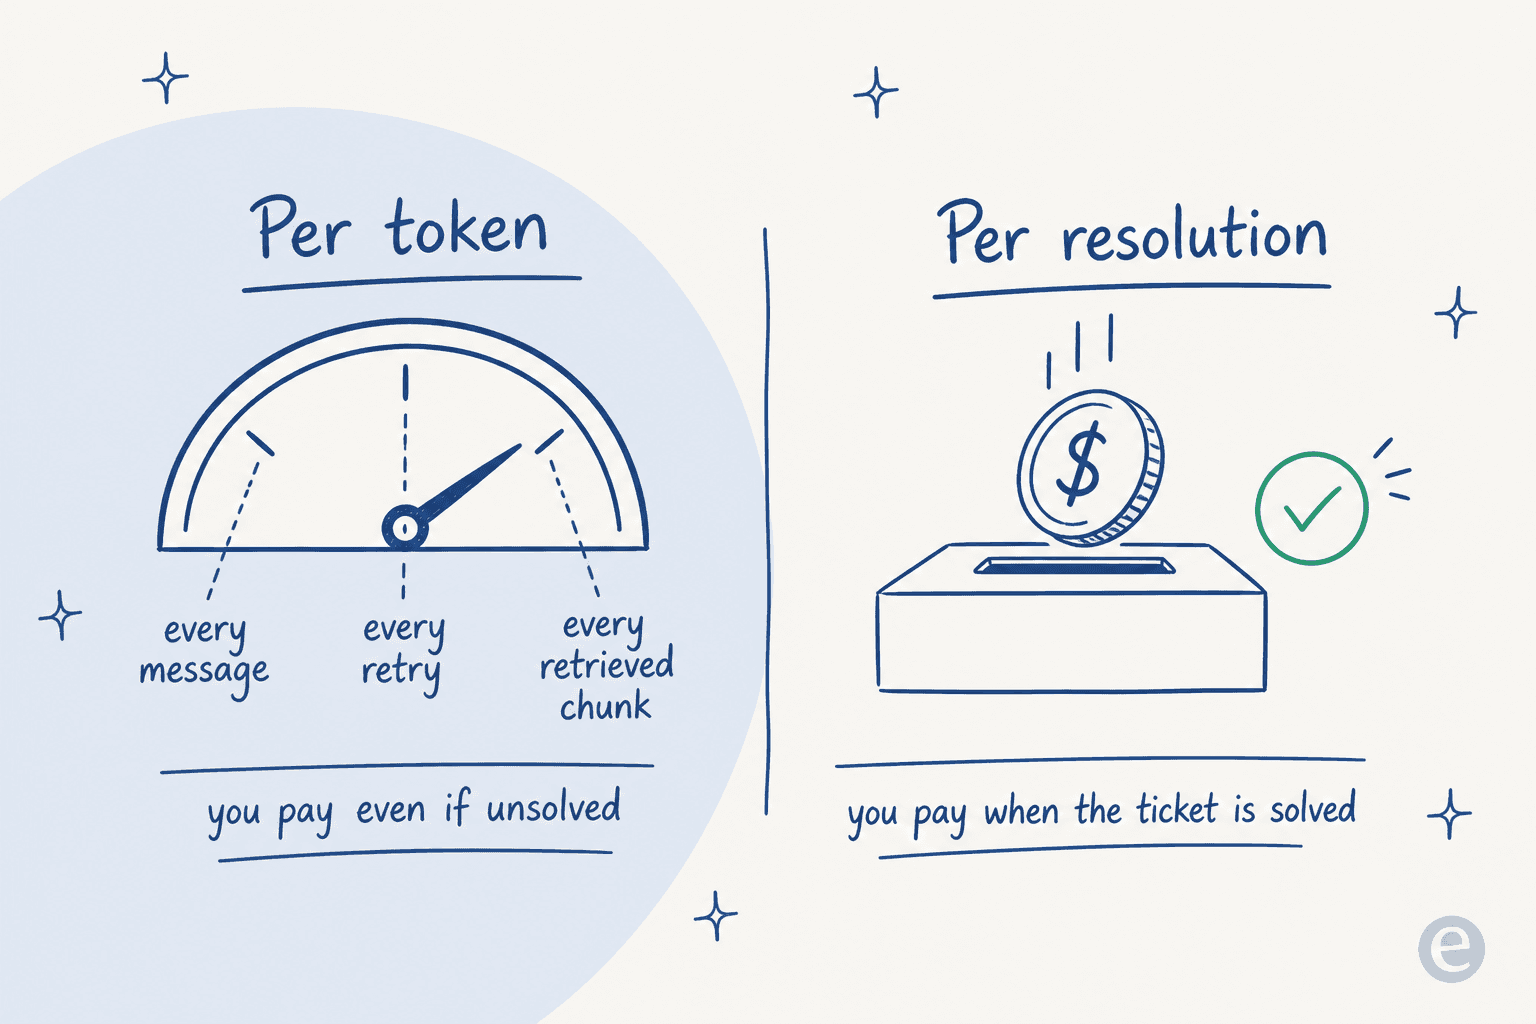
A diferença não é acadêmica. Por token significa uma conta ilimitada, moldada pelo uso, que você precisa prever e limitar, e ela sobe com cada nova tentativa e cada conversa longa, resolvida ou não. O preço por resultado atrela o gasto ao trabalho feito. A eesel, por exemplo, é baseada em uso, a cerca de 40 centavos de dólar por ticket atendido, cobrado por ticket ou conversa de helpdesk em vez de por resposta, sem taxa por assento, sem taxa de plataforma e sem mínimo mensal. Some o salário de engenharia por trás de um agente construído do zero e as horas de manutenção que ele consome toda semana, e o caminho DIY "mais barato" muitas vezes não é. Como disse um desenvolvedor, agentes que "economizam 10 minutos por dia mas silenciosamente custam horas por semana em manutenção" são a armadilha; o custo real nunca está na construção.
Então, qual caminho você deveria realmente escolher?
Nenhum desses caminhos está errado. Eles se encaixam em equipes diferentes. Aqui vai a versão curta, e depois uma forma rápida de se posicionar.
E as mesmas compensações em forma de tabela:
| Dimensão | API de modelo pura | Agente de helpdesk / API MCP | Colega de equipe já pronto |
|---|---|---|---|
| Você constrói o agente | Sim, tudo | O cérebro e os guardrails | Não, você configura |
| Recuperação / sincronização de conhecimento | Sua | Sua | Já embutida |
| Conectores de helpdesk | Seus | Do fornecedor (uma plataforma) | Já embutidos (1000+) |
| Testar antes de ir ao ar | Você constrói o arcabouço de testes | Você constrói o arcabouço de testes | Simulação em tickets passados |
| Unidade de cobrança | Por token | Por token + limites de plano | Por ticket atendido |
| Tempo até o primeiro ticket resolvido | Semanas a meses | Dias a semanas | Minutos a horas |
| Código personalizado ainda é possível | Totalmente | Totalmente | Network Access, CLI, skills |
Se você ainda está mapeando o campo mais amplo, nossos comparativos dos melhores agentes de IA e da melhor IA para triagem de tickets percorrem ferramenta por ferramenta.
Experimente a eesel
Se você chegou até aqui pesando "construir sobre uma API de modelo" contra "comprar um agente", a resposta honesta para a maioria das equipes de suporte é que a construção própria parece mais barata em um quickstart e custa mais no segundo ano. A eesel é o terceiro caminho feito corretamente: um colega de suporte com IA que se conecta ao helpdesk que você já usa, treina com seus tickets e documentos passados e, a parte que uma construção do zero quase sempre pula, simula no seu histórico real de tickets antes de responder a um ao vivo.
Você mantém a superfície programável onde ela importa, Network Access para qualquer API REST, webhooks, uma CLI e skills personalizadas, sem reconstruir recuperação, estado e conectores primeiro. É gratuito para começar, sem cartão de crédito e sem chamada de vendas, e o preço é por ticket atendido, então você paga pelo trabalho feito em vez de tokens consumidos. Se você prefere apontar um agente para sua fila em vez de passar um trimestre construindo um, essa é a forma mais rápida de ver isso funcionando nos seus próprios tickets.
Perguntas frequentes
O que é uma API de agente de suporte ao cliente?
Devo construir um agente de suporte sobre uma API de modelo ou comprar um?
Quanto custa uma API de agente de suporte ao cliente?
O que é o MCP e como ele se relaciona com uma API de agente de suporte?
Posso conectar um agente de IA ao meu helpdesk atual por meio de uma API?


Article by
Rama Adi Nugraha
Rama is a software engineer at eesel AI with two years of experience writing about B2B SaaS, AI tools, and customer support technology. Based in Bali, Indonesia, he brings a developer's perspective to product comparisons — cutting through marketing copy to what the integrations and APIs actually do.