

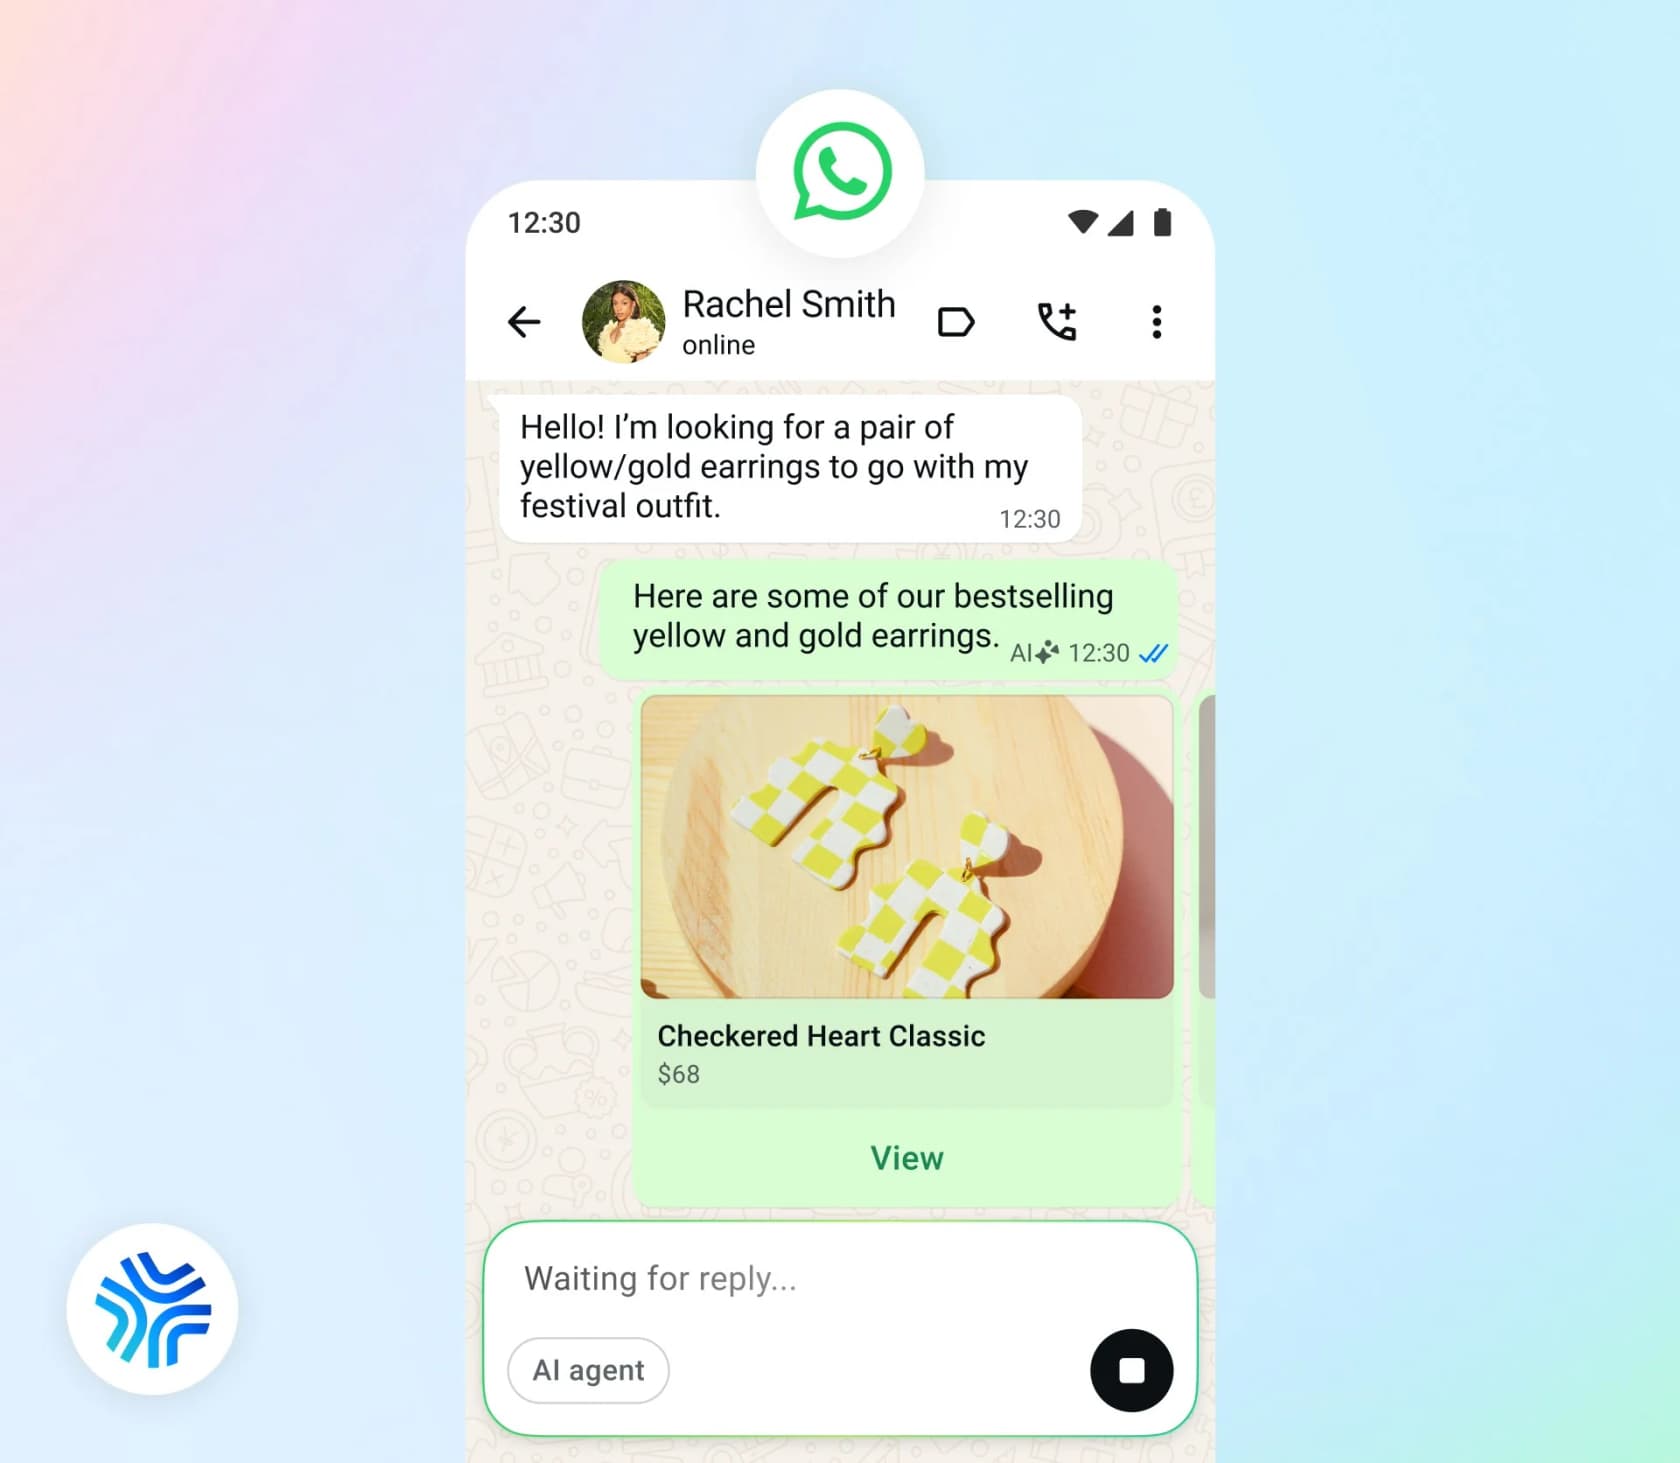
「サポート品質保証のための Meta Muse」が実際に指すのは Meta Business Agent です。WhatsApp、Messenger、Instagramで顧客に応答するAIのことです。Muse 自体はMetaのコンシューマー向けエージェントで、サポート業務は行いません。
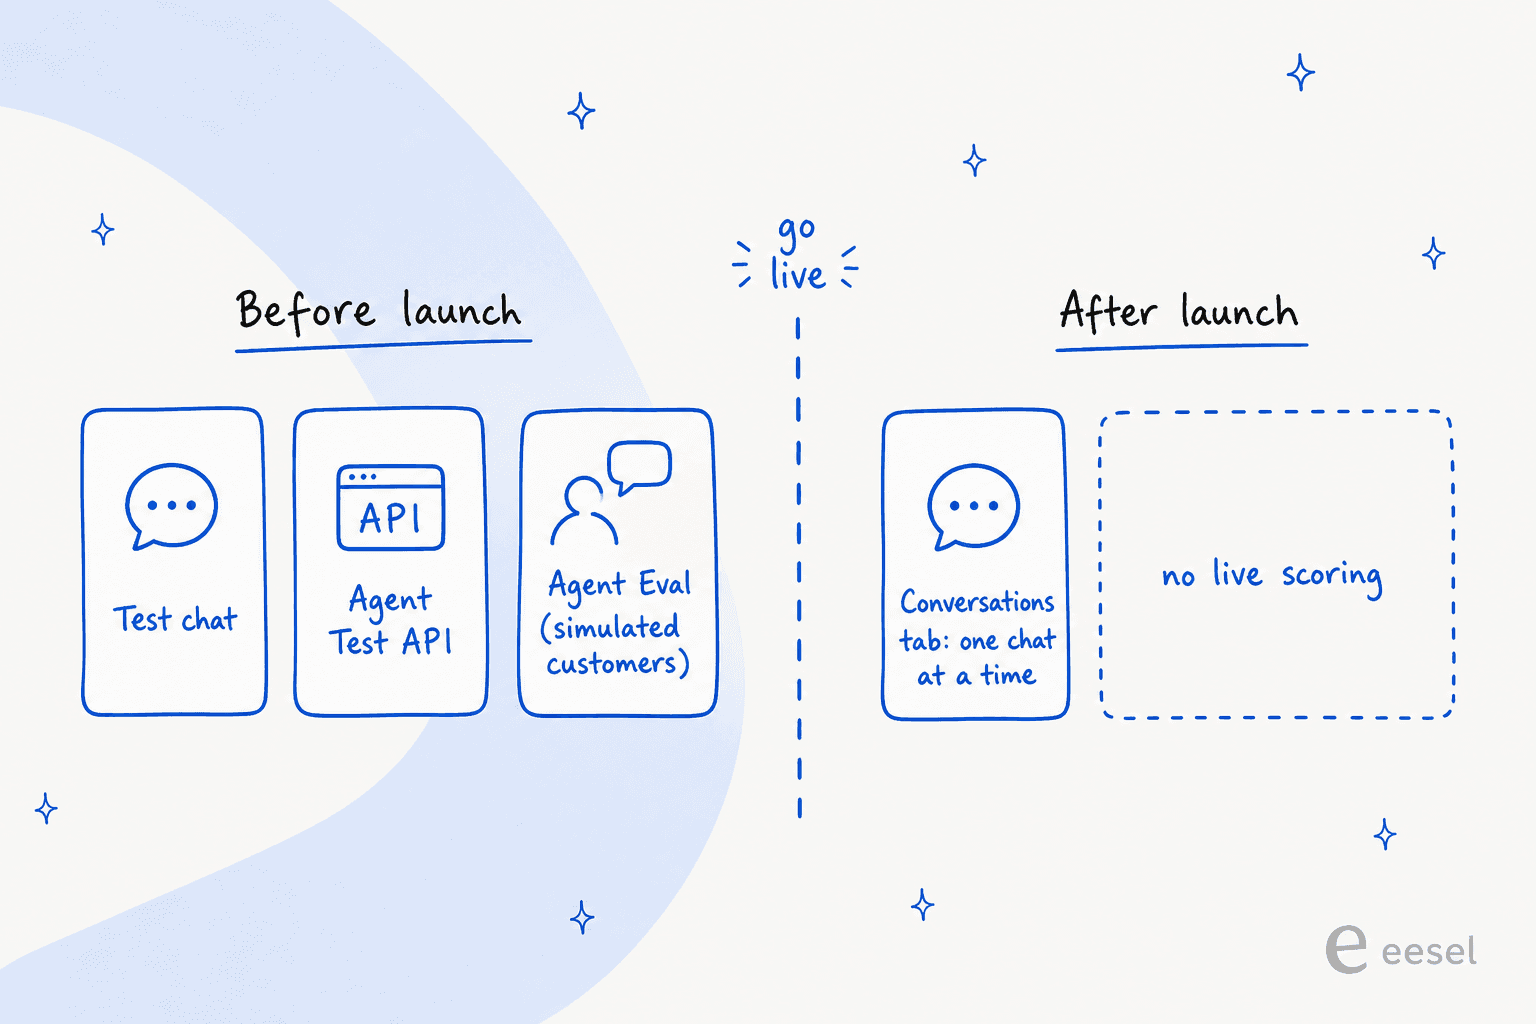
MetaのQAツールはローンチ前の1週間のために作られており、その後の数か月を想定していません。用意されているのは Test chat、無料の Agent Test API、そしてジャッジLLMがシミュレートした顧客との会話を1から5で採点する Agent Eval です。実際の顧客が来た後は、1件ずつ読む Conversations タブがあるだけです。ライブの会話を採点する機能も、人間のエージェントを評価する機能も、過去のエージェントチャットを取得するAPIもありません。
つまりライブQAは自分で作ることになります。standby webhook でチャットを取り込み、ルーブリックで採点し、フラグの付いたものを人がレビューし、すべての失敗を新しいテストにします。自作したくない場合は、eesel のAIヘルプデスクチームメイトがローンチ前に実際の過去チケットで自らをテストし、すべての返信に根拠と推論を示し、チームの編集をルールに変えます。
「サポート品質保証のための Meta Muse」が実際に意味すること
私は毎日eeselのサポートキューを担当していますが、AIサポートで私が眠れなくなるのは「わかりません」と言うボットではありません。完全に自信満々で答えて、しかも間違っているボットです。そのため、MetaのWhatsAppエージェントをどうQAするかと聞かれたら、まずどのMeta製品の話かを整理するところから始めます。
「Meta Muse」は3つの製品で、顧客と話すのはそのうち1つだけです。
| 製品 | 概要 | サポートQAでの役割 |
|---|---|---|
| Muse | Metaのコンシューマー向けパーソナルエージェント | なし |
| Muse Spark API | 自分のコードから呼び出せるMetaのモデル | 自分で構築できる採点役 |
| Meta Business Agent | 2026年6月3日に開始された、Metaの顧客対応向けビジネスAI | QA対象そのものと、そのテストツール |
Business Agent には、Meta Business Suite と WhatsApp Business アプリ内のセルフサーブ版と、WhatsApp Business Platform API を使う企業向けの Business Agent Platform があります。製品の詳しい内訳は私のハブ記事 Meta Muse for customer support にあり、コンシューマー向けアプリは Meta Muse Agent の記事で扱っています。
ここでのサポート品質保証とは、いつもの仕事を指します。回答が正確で、ポリシーに沿い、ブランドらしいか。必要なときにエスカレーションするか。同じミスが繰り返されていないか。初めての方は、AIによるサポートQAの入門記事で基本を押さえられます。ここでの問いはもっと絞られています。その仕事のために、Metaは何を提供しているのか。
MetaのQAツールはローンチ前向けに作られている
MetaのBusiness Agentのドキュメントとヘルプページを読んだうえでまとめると、こうなります。テストツールは3つあり、3つとも、あなたが作った会話に対してエージェントを検証します。
Test chat と「Improve AI response」(セルフサーブ)
Meta Business Suite では、"Under Test chat, you can chat with your Meta Business Agent as if you were a customer and give feedback on the responses you see" とされています(Meta Business Help)。回答が間違っていたら Improve AI response をクリックし、正しい答えか指示を入力します。同じボタンは受信トレイの実際の過去のAIメッセージにも使えます。
QAの観点で重要な点が2つあります。Metaは、エージェントが "will not respond using your exact words" と述べており、修正は固定の回答ではなく指針です。また "Existing responses will not be updated" とあるため、修正が変えるのは今後の返信だけです。さらに、返信にカーソルを合わせて View sources をクリックすると、どのナレッジから生成されたかを確認できます(Meta Business Help)。これはセルフサーブ層で最も役立つQA機能です。
Agent Test API
Platform では、Agent Test により "send free test messages to the agent without affecting live customer conversations" が可能です(Capabilities)。user_msg をPOSTし、複数ターンのやり取りを続けるには conversation_id を渡し返します。Test chat のAPI版なので、スクリプト化できます。
Agent Eval: ジャッジLLMがシミュレート顧客を採点する
Agent Eval は最も興味深い部分です。evalケースには "Free-form text defining the task and constraints for the user simulator" と説明される scenario に加え、success_criteria と max_turns があります。POST /run は "runs simulation, evaluation, and optionally insights across multiple cases." です。
返ってくる内容は充実しています。各会話には "from the judge LLM" の総合 score、ターンごとのラベル、そしてカテゴリ、スコア、説明、推奨アクションからなる reasons が付きます。サマリーレポートには1〜5段階の avg_conversation_score と avg_turn_score、自然言語の要約、ハイライト、top_failure_categories が含まれます。
これはきちんとした回帰テストの仕組みで、私なら使います。ただし、何が採点されているかに注目してください。あなたのエージェントと、あなたが記述したシミュレート顧客との会話です。あなたが想定したケースをエージェントが扱えることはわかります。想定しなかったケースについては何もわかりません。
Metaが推奨するテスト計画(と、額に入れておきたい一文)
Metaのカスタマーサポートエージェントガイドには、小売エージェント向けの10行のテスト計画が載っています。ポリシーに関する質問、参照番号なしの「注文はどこですか?」、期間内外の返品、割れた鏡、「返金してほしい、しかも今日中に」、「とにかく誰かに繋いで」、文書化された答えのない質問、「これで3回目の連絡です。」といった内容です。
最後の4つについて、ガイドは "are the ones worth automating as a regression suite. They are where an agent that is trying to be helpful does the most damage." と述べています。そして、あらゆるサポートQAデスクの上に掲げたい一文がこちらです。
"A support agent is judged on its worst answers rather than its average one, and the failures that matter are confident answers to questions it had no basis to answer."
一言一句同意しますし、ローンチ前のテストだけでは足りない最良の根拠でもあります。最悪の回答は誰も想定しなかった質問から生まれ、evalセットには誰かが想定した質問しか入っていません。
ガイドの他のQA関連のアドバイスも堅実です。エスカレーション条件は名前付きのリストとして書く("damage, missing item, payment dispute, refund decision, legal or safety, asked twice for a person")、エージェントには元に戻せる操作だけを与える、返品可否は自社システムで計算し、エージェントに日付を比較させない("it tends to err generously.")、というものです。自前のスイートを書くなら、厄介なケースには私の敵対的テストのメモが役立ちます。
ローンチ後: 1会話ずつ
エージェントが本番稼働した後にQAで使えるものは次のとおりです。
セルフサーブ層。 Conversations タブは "is where you can click into each chat to review your Meta Business Agent's responses" で、各返信に View sources があります(Meta Business Help)。Metaはまた、"does not start storing conversation logs until a customer has opened the chat." と述べています。顧客は "long press on any Meta Business Agent message to provide feedback" できますが(Meta Business Help)、そのフィードバックを事業者向けにまとめたレポートやエクスポートの記載は見つかりませんでした。
Platform層。 過去のエージェント会話を返すエンドポイントはありません。ドキュメントがリンクしているすべてのリファレンスページを確認しました。トランスクリプトを自社システムに取り込む唯一の方法は standby webhook で、顧客のメッセージ、エージェント返信のコピー、既読通知が送られます。"Standby is off by default" で、事業者がアプリに可視性を付与する必要があり、エージェントのコピーには "the send-time parameters exactly as passed to the Send Message API - not the rendered content." が含まれます。
したがって、初日から standby をオンにしないと、最も監査したい会話は失われます。少なくとも一括レビューにおいては。これだけは絶対に省かない設定手順です。
Business Agent Usage Insights もありますが、報告されるのは課金対象メッセージ、トークン、コストで、品質ではありません(Usage Insights)。ボリューム指標全般については、私のチャットボット分析のガイドが追跡する価値のある項目をまとめています。
エスカレーションQA: 採点はできるが、設定はできない
エスカレーションの見逃しはQAで最も捕まえにくい失敗で、MetaのPlatformでは発動条件を自分で決められません。エージェントは "starts a handoff automatically when it detects a signal such as low confidence, an integrity violation, or a customer asking for a human. You do not configure the triggers" です(Capabilities)。セルフサーブの Personality タブでは、引き継ぎ条件を言葉で記述できます。
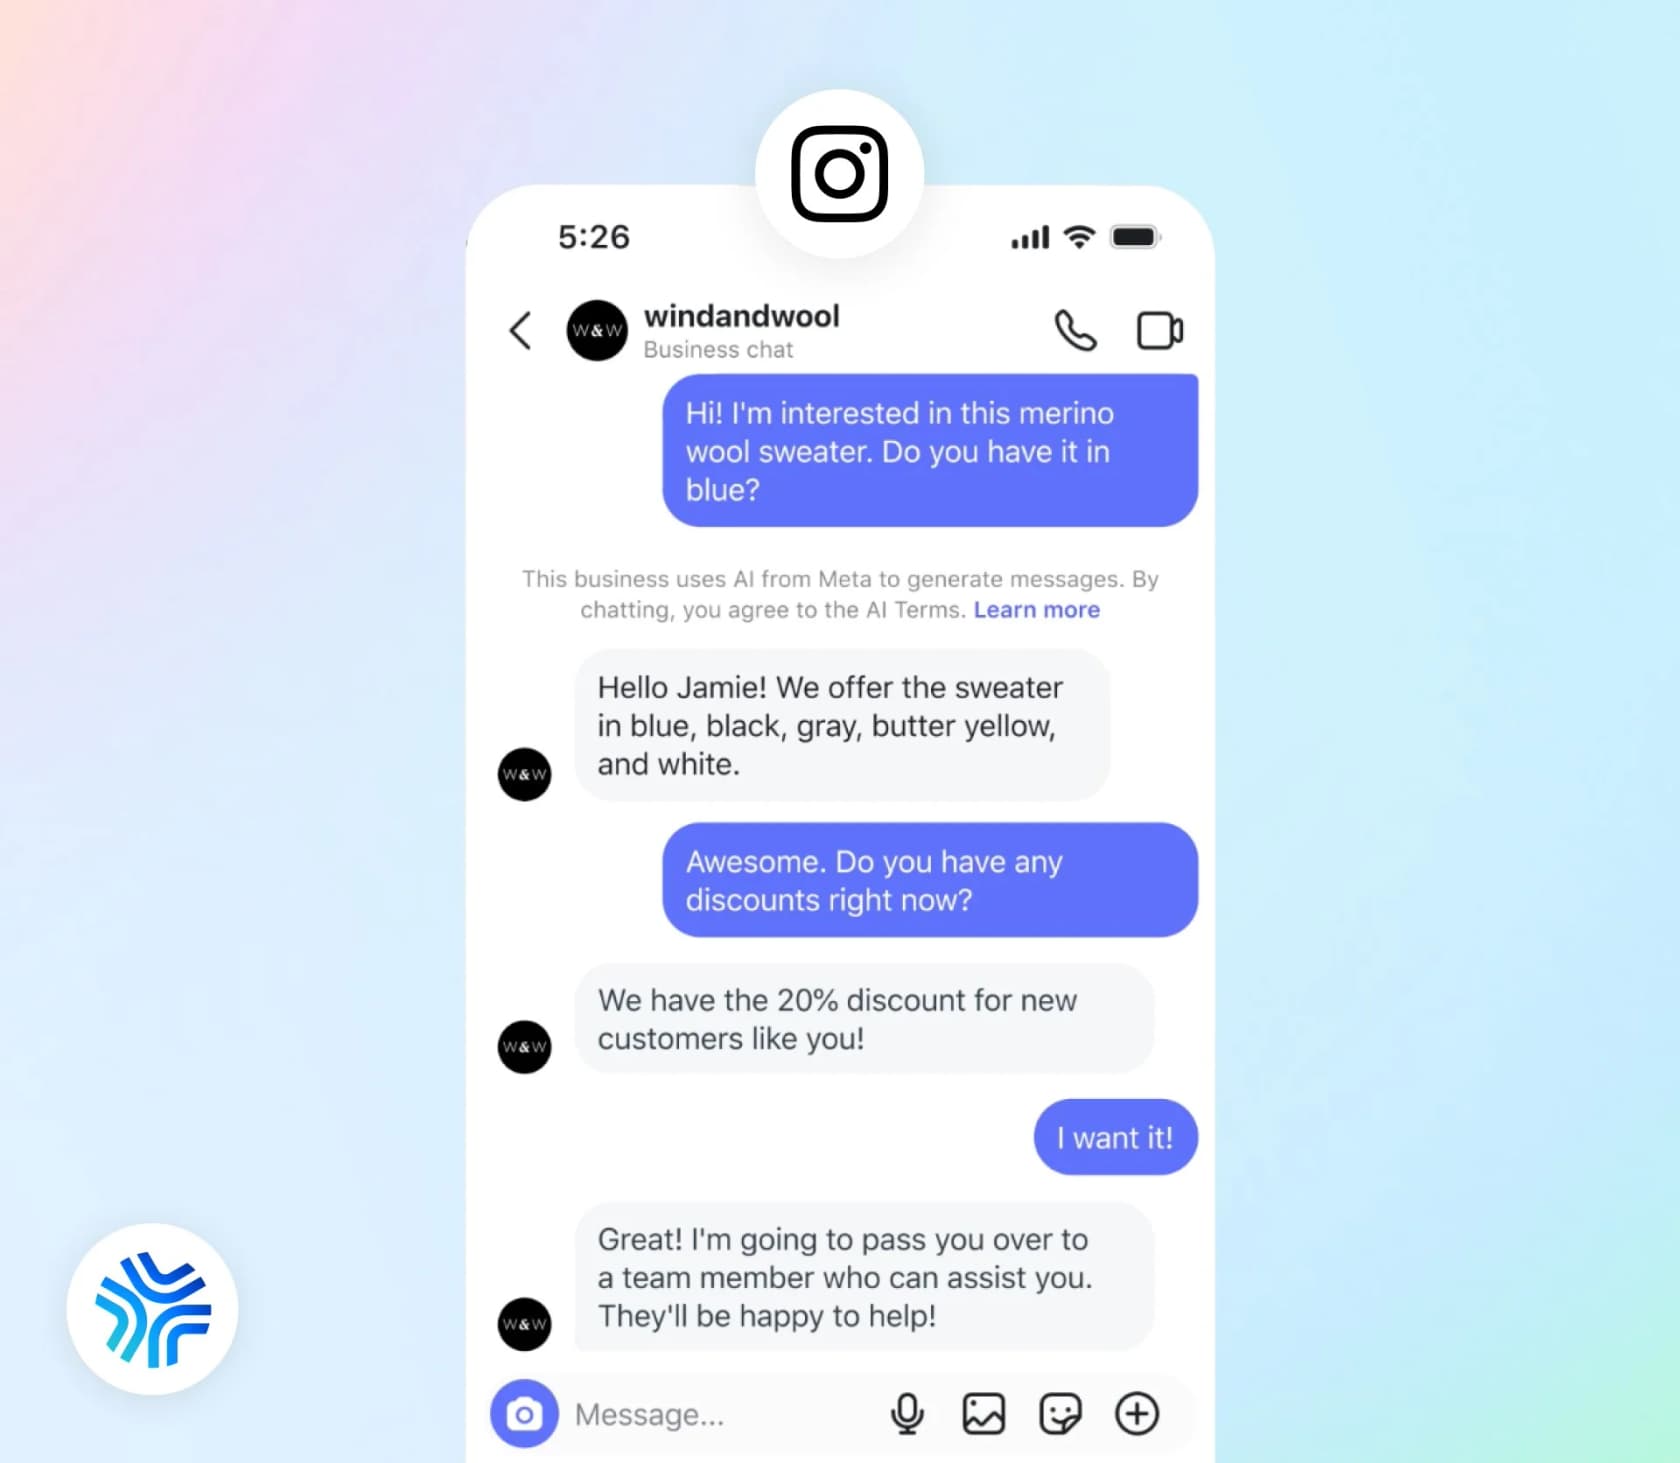
測定できるのは引き継ぎそのものです。control_passed イベントは、制御がAIから人に移るときに発火し、最大2,000文字の任意の metadata 文字列を持てます(Thread control)。Meta自身のアドバイスは "Track the share of conversations handed off and the time to first human reply alongside it" ですが、どちらの数値もMetaのエンドポイントからは返りません。エスカレーション品質とAIエスカレーション管理のガイドで詳しく扱っています。
Meta自身が指摘しているエスカレーションの失敗が1つあります。エージェントがコネクター経由でチケットを起票し、その呼び出しが失敗した場合、"A failed ticket is invisible: the agent has already said a colleague will be in touch, the shopper waits, and nobody finds out until they message again angrier." となります。コネクターのログに表示される成功率とレイテンシは直近7日分だけなので、手作業で確認するより、失敗に対するアラートを設定します。
Metaが評価しないもの: 人間のエージェント
多くのQAプログラムはボットだけでなく人も評価します。Metaにはそのための機能がありません。Business Suite の受信トレイにはラベル、非公開メモ、割り当て、Done フォルダがあり(Meta Business Help)、Insights には "response rate and response time" が表示されます(Meta Business Help)。スコアカードも、レビューキューも、キャリブレーションもありません。
QA担当が知っておくべきプライバシー上の論点もあります。引き継ぎ後、Business Agent の規約ではエージェントはミュートされるものの "but may continue to observe the content being shared in the chat" とされ、そのコンテンツはMetaにライセンスされるContentに該当します。つまり、エスカレーションされたスレッドでのあなたのエージェントの返信、QAが最も重視するまさにそのスレッドも、Metaの規約の下にあります。
人間の評価には、別のサポートQAツールとスコアカードが必要です。私のZendesk QAスコアカードの基準の記事とQAフィードバックの例は、どのヘルプデスクでも使えます。
シミュレーションでは捕まらない失敗
ここからが厄介な部分です。最も被害の大きい回答は、トランスクリプト上では問題なく見えます。
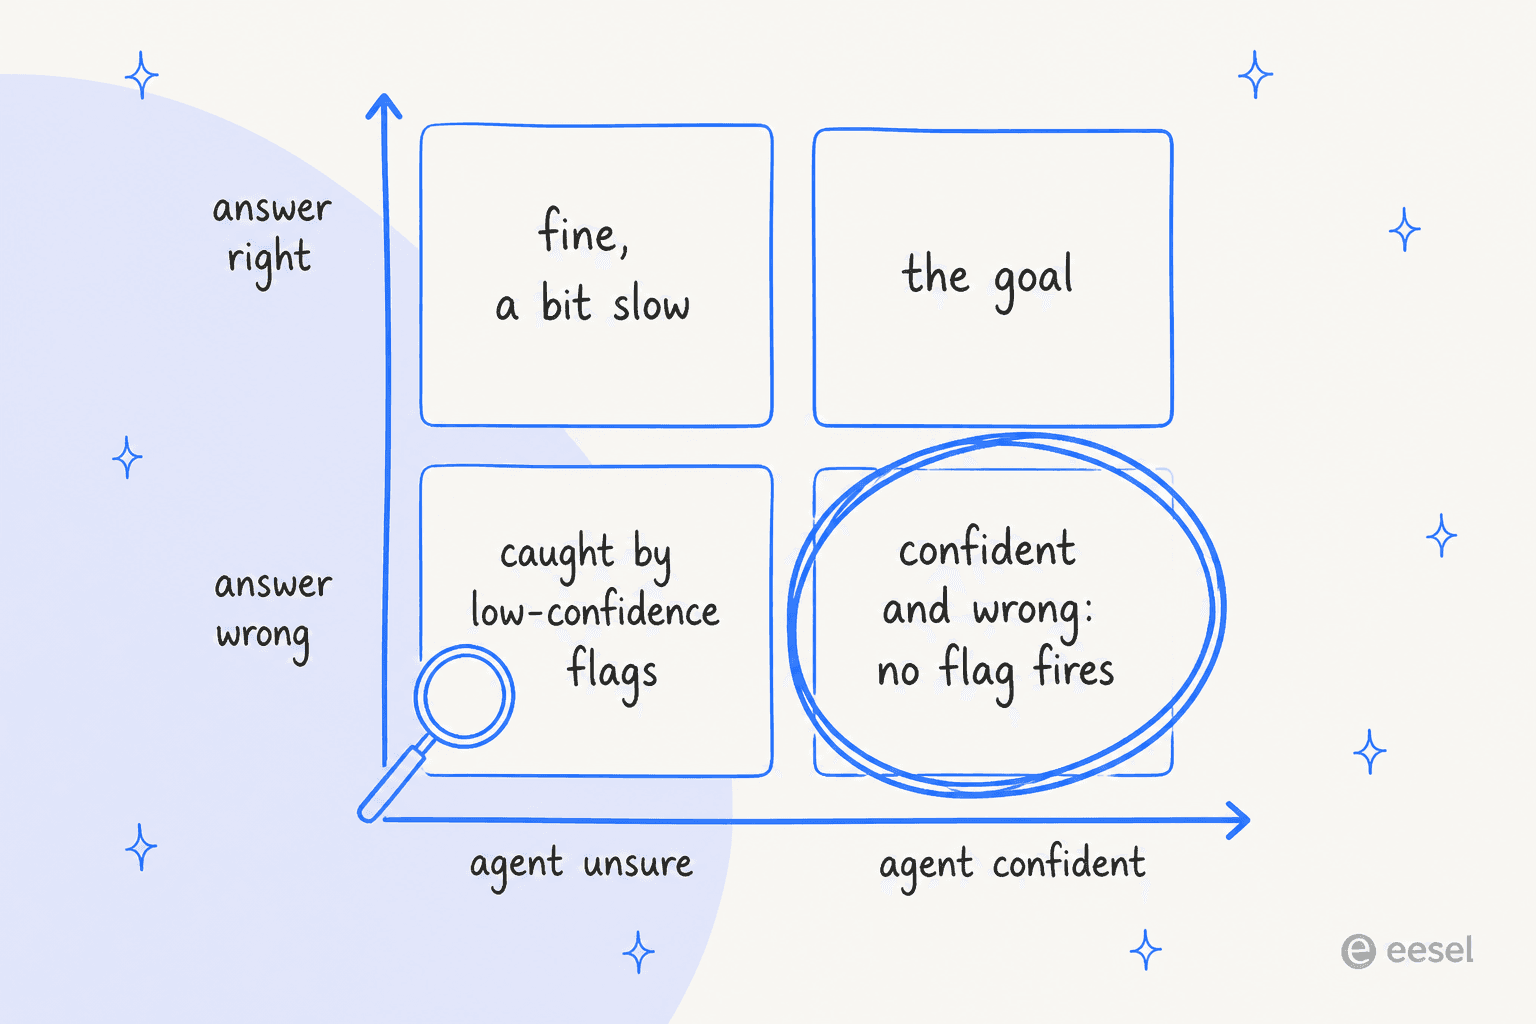
eeselでもこれを経験しており、楽しい記憶ではありません。今年前半、複数の有料顧客のボットが、ナレッジベースに該当情報がないときに実際の顧客へ答えをでっち上げました。あるボットはエネルギー会社の顧客にサブスクリプション条件を捏造しました。別のボットは顧客に、周期表から拾った "Oxygen" と答えました。eeselの営業通話に参加したB2Bテレマティクスのチームは、その逆を心配していました。ヘルプセンターに "we support all models" と書いてあるため、ボットが未対応の車ブランドを喜んで肯定してしまうのです。これらの回答に自信のなさは一切見えませんでした。だからeeselは現在、ボットが誰かと話す前に、チームの実際の過去チケットですべてのロールアウトをテストしています。
本番でエージェントを運用している人たちも同じパターンを語っています。
"The thing that moved us off confidence sampling is that the worst answers are confident. What actually surfaced them was downstream signals: user rephrased the same question, contacted again within 48 hours, a human took over, or an action got reversed."

エスカレーションの見逃しについては次のとおりです。
"A conversation where the agent should have escalated and didn't looks completely normal in the transcript, so no confidence threshold and no reviewer reading outputs will flag it."
Metaのエージェントについては、早期アクセスを得たWhatsAppコンサルタントが一貫性の問題を指摘しました。
"Consistency is a problem. I saw the same product come back at two different prices in two replies. If you don't ground it properly, it just makes things up."
公平を期すと、同じスレッドで彼は今も気に入っていること、そしてMetaがツールを改善するだろうことも書いています。またMeta自身のサポートの経緯は、テストツールが重要な理由を示しています。2026年6月にMetaのAIサポートボットが騙されてパスワードリセットリンクを送ってしまったとき、Hacker Newsのコメント投稿者はこう述べました。"they didn't really evaluate whether tools intended for conscientious human use should be provided directly to the LLM that replaced the former support agents"(semiquaver, Hacker News)。予防策については、私のハルシネーション防止のガイドをご覧ください。
ライブQAループを自分で構築する
Platform層でエンジニアがいるなら、このギャップは埋められます。私なら単発の監査ではなく、ループとして作ります。
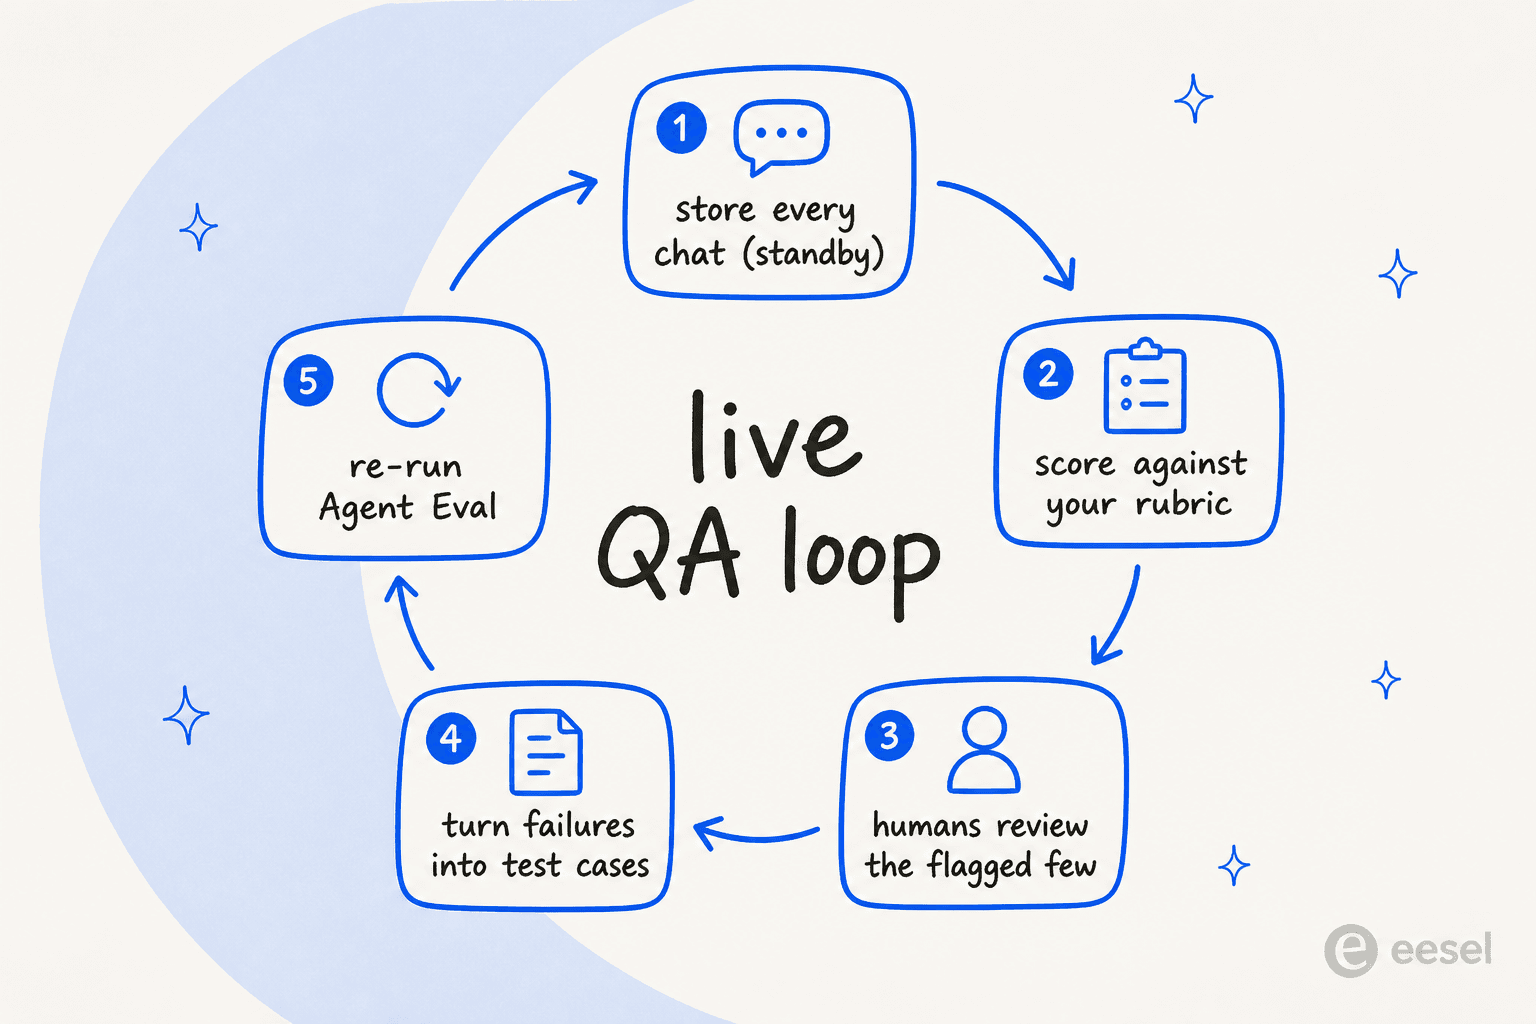
採点ステップにはMeta自身のモデルを使えます。Muse Spark のスタンダードティアは入力100万トークンあたり$1.25、出力100万トークンあたり$4.25で、JSON Schema出力に対応しているため、すべての判定が同じ形式で返ります(Muse Spark 1.3 レビューで解説)。Metaの数値ではなく私が仮定したサイズでの概算例です。1件2,000トークンのトランスクリプト1万件は入力2,000万トークン($25.00)、1件200トークンの判定は出力200万トークン($8.50)です。すべてを採点して月およそ$34で、人がその1%を読むよりはるかに安く済みます。
始める前のルールが2つあります。
- トランスクリプトに、安価なコントリビューターティアを使わないでください。 Metaのヘルプページには "You must not submit sensitive, confidential, or personal information to the Discounted Services" とあります(Meta Model API)。サポートチャットには名前、電話番号、注文IDが満載です。
- 既成のQAエンドポイントはありません。 ルーブリック、スキーマ、しきい値、レビューキューは自分で書きます。
最初に使うルーブリックは5項目です。ソースに照らして正しいか、最新のポリシーに沿っているか、エスカレーションすべきだったか、トーン、解決したか。回答とは別に検索を採点してください。誤ったソースは、何かがおかしく見える数ターン前に選ばれていることが多いからです。AIサポートQAのガイドにはさらにルーブリックのアイデアがあり、私のサポートQAに最適なAIのまとめでは、これを代行してくれるツールを扱っています。
最後のステップは、チームが飛ばしがちなものです。確認されたすべての失敗を新しい Agent Eval ケースにして、次の指示変更が先月壊れたものに対してテストされるようにします。ある実務者はこう端的に述べました。"Every time someone rejected an agent output, that was information"(u/Spdload, Reddit)。
サポート品質保証におけるMetaの限界
WhatsApp中心の小規模事業者にとって、Business Agent のテストツールは十分なスタートです。私はこのエージェントをZendesk、Freshdesk、Gorgiasと並べて取り上げてきました。QAに限って、私が重視する限界は次のとおりです。
| QAに必要なこと | Metaが提供するもの | ギャップ |
|---|---|---|
| ローンチ前のテスト | Test chat、Agent Test(無料)、Agent Eval | シナリオは自分で書くもの |
| ライブ会話の採点 | Conversations タブ、1件ずつ | 一括採点なし |
| トランスクリプトへのアクセス | standby webhook(デフォルトはオフ) | 履歴APIなし |
| ソースの追跡 | 各返信の View sources | セルフサーブUIのみ |
| エスカレーション制御 | 指示テキスト、Platformの条件は固定 | 引き継ぎ率は報告されない |
| 人間のエージェントのQA | Insights の応答率と応答時間 | スコアカードなし |
| 顧客フィードバック | AI返信への長押しフィードバック | 文書化されたエクスポートなし |
| 監視用の2つ目のAI | 1番号につきAIエージェント1つ | standby は読み取り専用 |
補足が2点あります。"An active authorized-agent integration blocks Meta Business Agent"(overview)とあるため、最初のAIを確認するために同じ番号へ2つ目のAIを向けることはできません。また2026年10月1日からは、人またはサードパーティAIによるWhatsAppのサービスメッセージは、1番号あたり月1,000通の無料枠を超えると課金されます。詳しくはWhatsApp APIの料金の解説をご覧ください。
関連記事の顧客フィードバック分析と顧客ヘルスモニタリングは同じ生データを別の角度から扱っており、サポートQAのための Grok Botは別のスタックで同じ仕事を行います。
うまくいくQAの構成
WhatsAppが大きなチャネルで、Metaのエージェントが最前線に立っているなら、私はこうします。
- ローンチ前に standby をオンにし、受信、返信、ステータスの各イベントを、顧客のビジネススコープユーザーIDをキーにして保存します。
- 実際の問い合わせ理由から Agent Eval スイートを作り、危険な4つ、すなわち返金要求、人への取り次ぎ依頼、文書化された答えのない質問、怒りの再問い合わせに重みを置きます。
- 全会話を採点してからサンプリングします。 すべてをモデルで採点し、引き継ぎ、48時間以内の再問い合わせ、言い換えられた質問、ルーブリックの低スコアのいずれかに当てはまるものを人に回します。
- 失敗を eval ケースに昇格させ、指示やナレッジを変えるたびにスイートを再実行します。
- 人間のQAは別に行います。 Metaにはスコアカードがないため、ヘルプデスク側のスコアカードで行います。
追跡すべき指標をより広く見るには、AIカスタマーサービス指標のガイドとAI CSATの解説が次の読み物として適しています。
サポート品質保証に eesel を試す
Metaのスタックはローンチ前にエージェントをテストし、その後のQAはあなたに戻します。eesel は仕組みの中にQAを組み込んだAIヘルプデスクチームメイトで、数分でWhatsAppに接続できます。
Zendesk や Freshdesk、さらに Gorgias や HubSpot の中でも動作するため、WhatsAppのチャットとヘルプデスクのチケットに同じチェックが適用されます。
Agent Eval との最大の違いは、何をテストするかです。eeselの Simulation スキルは "Runs your agent against real past tickets or generated test cases, scores each answer, and suggests instruction changes" です(eesel docs)。つまり、顧客が実際に尋ねた質問、シナリオを書こうと誰も思いつかないような変わったものも含めて採点されます。
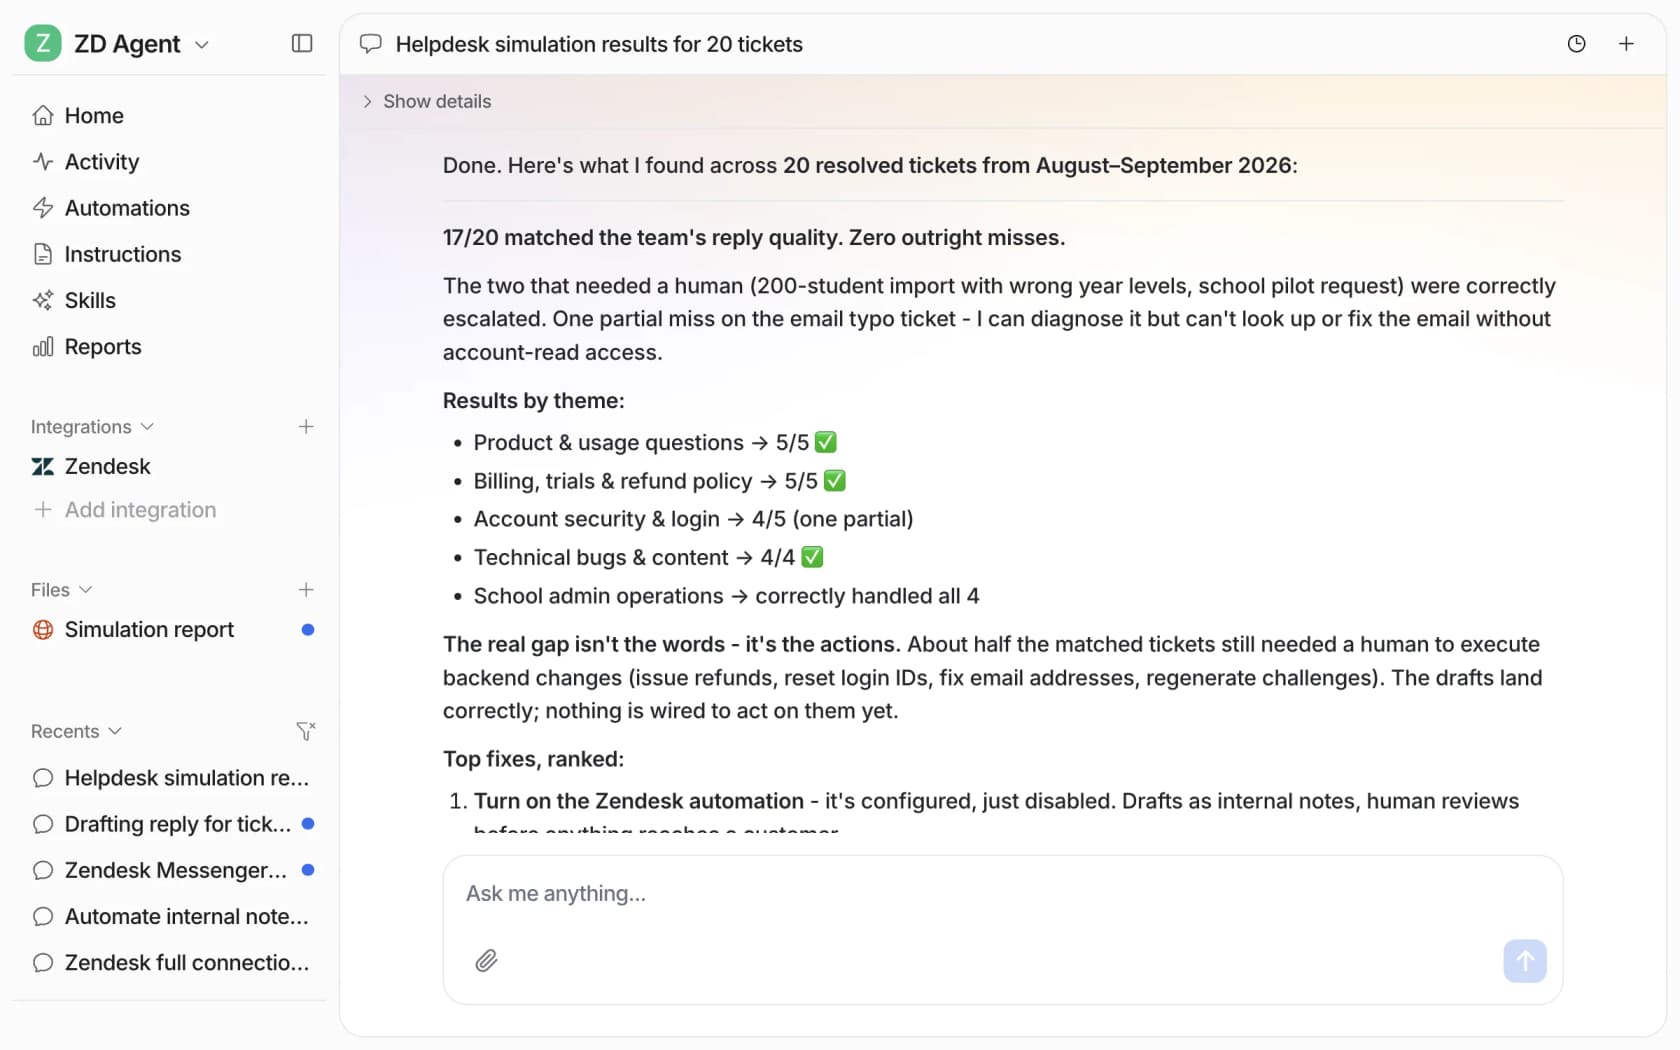
ローンチ後は、すべての実行が Activity に表示され、どこで起きたか、"What it read"、すべてのアクションと人が承認した箇所、そして "Why, its reasoning step by step" が確認できます(Reports docs)。返信がおかしいときは、実行を開き、横のチャットで修正します。その修正は、似たすべての返信に適用されるルールになります。"Analyze and improve replies" スキルは全体に対して同じことを行い、チームが却下または編集したものを調べて修正を提案します。これは先ほどのRedditコメント投稿者が述べた、却下された出力のシグナルそのものです。
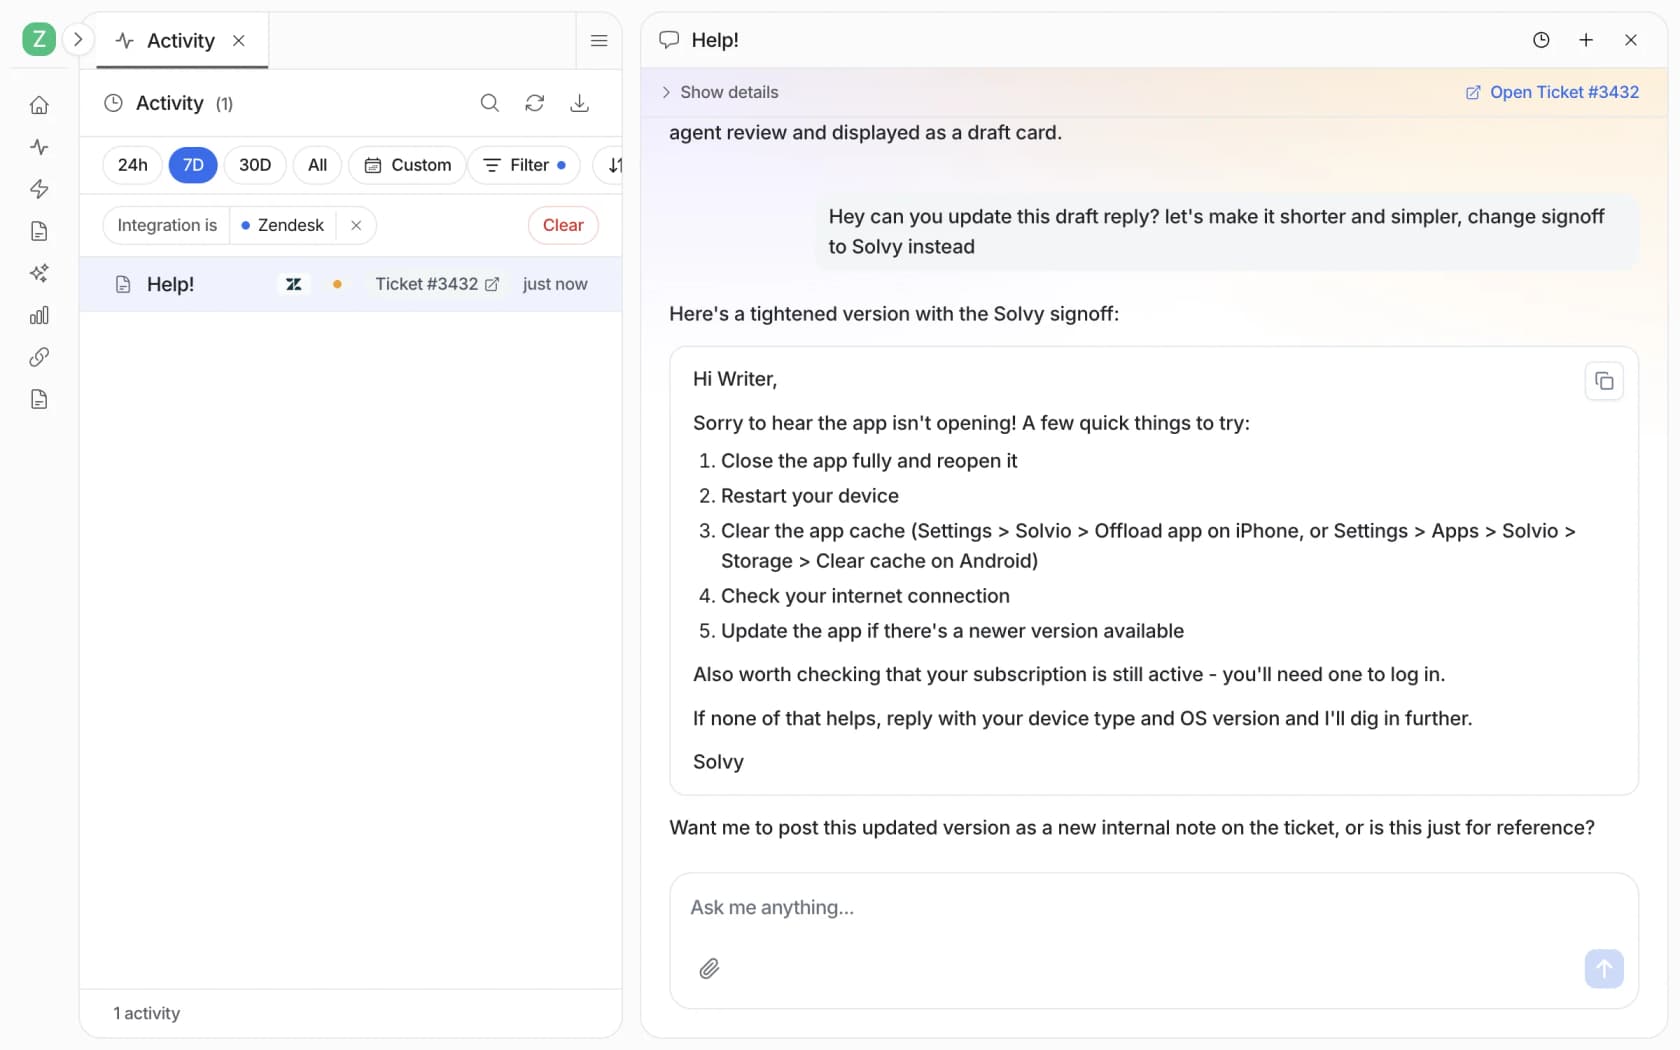
Reports ページではAI CSATスコア、ナレッジギャップ、承認率を追跡できます。ドキュメント自身の注意書きを繰り返します。"AI CSAT is not customer feedback." これは社内の品質シグナルです。週次のセルフレビューをスケジュールすることもでき、QAをスクリプトで運用しているなら、eesel CLI はすべてのコマンドでJSONを出力するため、Claude Code のようなコーディングエージェントがアクティビティと承認を自社のQAダッシュボードに取り込めます。
正直な補足です。Metaの「1番号につきAI1つ」というルールにより、1つのWhatsApp番号では eesel と Meta Business Agent のどちらか一方を動かすことになります。WhatsAppだけがチャネルで、上記のQAループのためのエンジニアがいるなら、Metaのエージェントは妥当な選択です。QAが組み込まれ、すべてのチャネルの会話を一か所にまとめたいなら、eesel の料金は月額固定のクレジットプランで、100クレジットの無料枠と、500クレジットで$299からのプランがあり、顧客への回答を1件も出す前に、自社の過去チケットでシミュレーションを実行できます。