要点
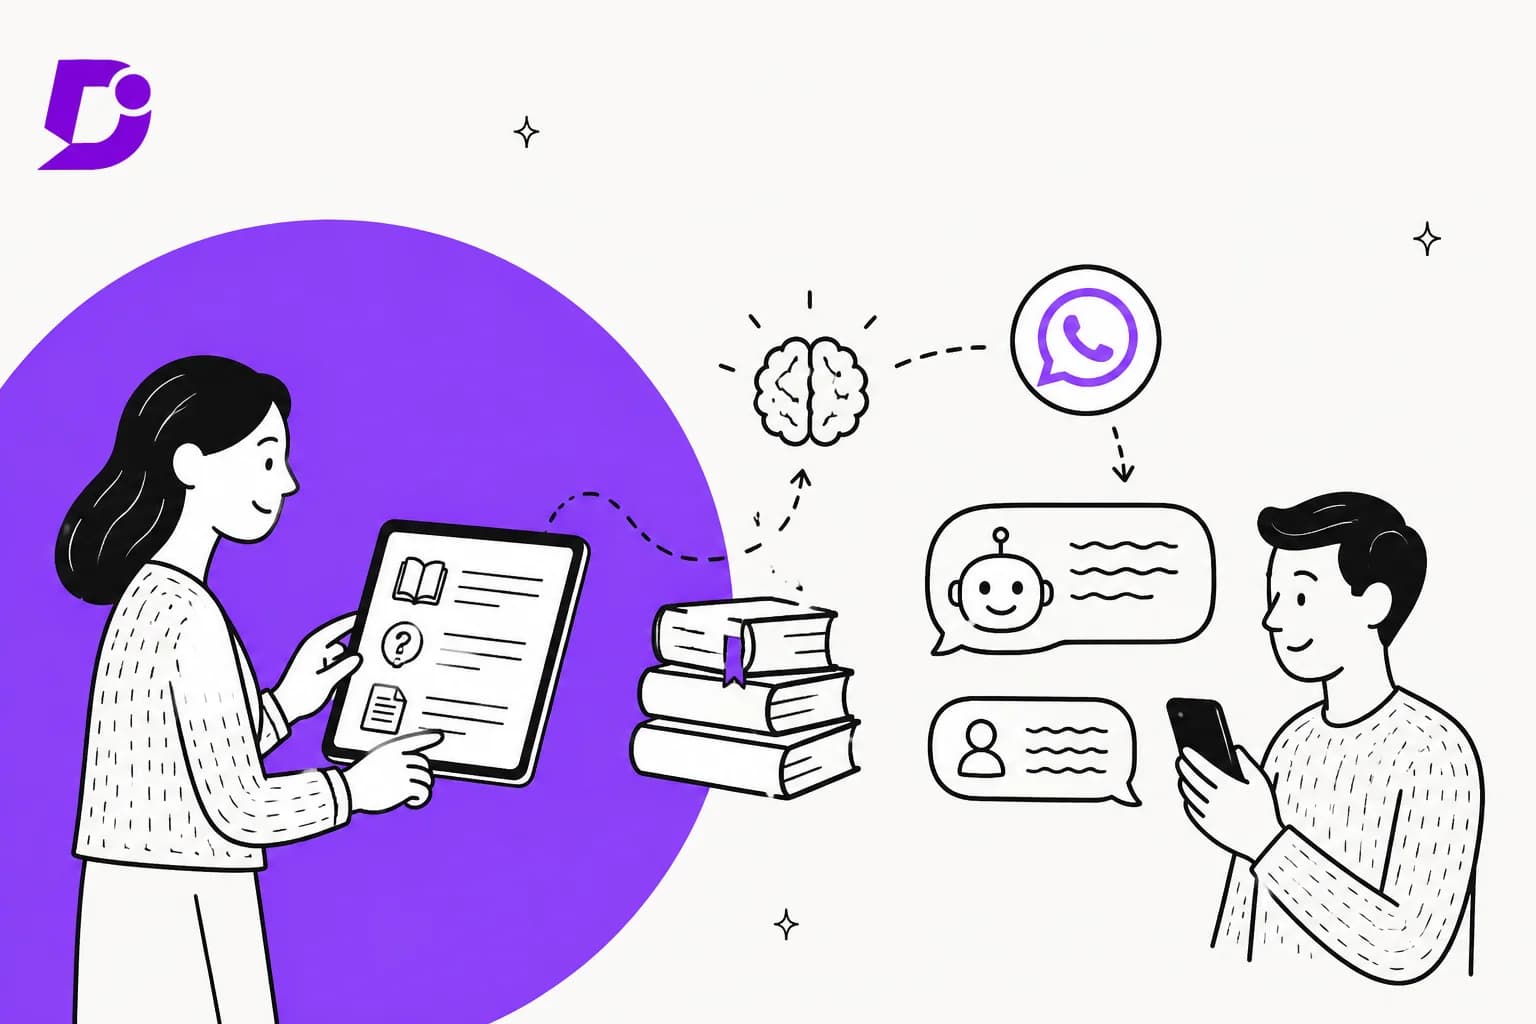
「Meta Muse for Document360」とは、実際にはDocument360のナレッジベースをMeta Business Agentに読み込ませることを指します。Business AgentはWhatsAppとMessengerで顧客に回答するAIです。Muse自体は一般消費者向けのエージェントです。Business AgentにはDocument360のインポーターがなく、学習元は4つだけです。ビジネス情報、FAQエントリ、アップロードしたファイル、クロールした公開ウェブサイトです。
Document360は、公開サイトがそもそもクロールされる前提で作られているため、多くのツールより簡単です。難しいのは非公開プロジェクトと情報の鮮度です。Metaはリーダーログインの内側をクロールできず、アップロードしたファイルは自動では更新されず、Document360自身のMCPサーバーはユーザーOAuthフローでサインインするため、Metaのコネクタでは扱えません。合う認証は、読み取り専用のv3 APIキーです。
eeselは長年、実際のサポートキューでAIを運用してきました。最もよく見る失敗は、ナレッジベースにその話題がないのに自信満々に答えるボットです。Document360の記事が毎週変わるなら、eeselはDocument360サイトをクロールし、すべての回答に元記事へのリンクを付け、誰かに返信する前に過去のチケットでテストされます。
「Meta Muse for Document360」が実際に意味するもの
私は購入前に人々がGoogleで何を検索するかに多くの時間を割いています。「Meta Muse for Document360」は、間違った製品を指す検索の好例です。Museの名を冠する、またはそれに近いMetaの製品は3つあり、顧客と話すのはそのうち1つだけです(3つすべては私のカスタマーサポート向けMeta Museハブで掘り下げています)。
- Muse:Metaが一般消費者の用事向けに公開したパーソナルAIエージェント。企業の顧客に回答するために作られてはいません。
- Muse Spark 1.3:Meta Model APIで提供されるモデル。これでDocument360ボットを自作することもでき、モデルの詳細は私のMuse Spark 1.3の概要にあります。
- Meta Business Agent:Metaが6月に公開した、WhatsApp、Messenger、Instagramで顧客に回答するAI。Metaによれば、すでに100万以上の企業が利用しています。
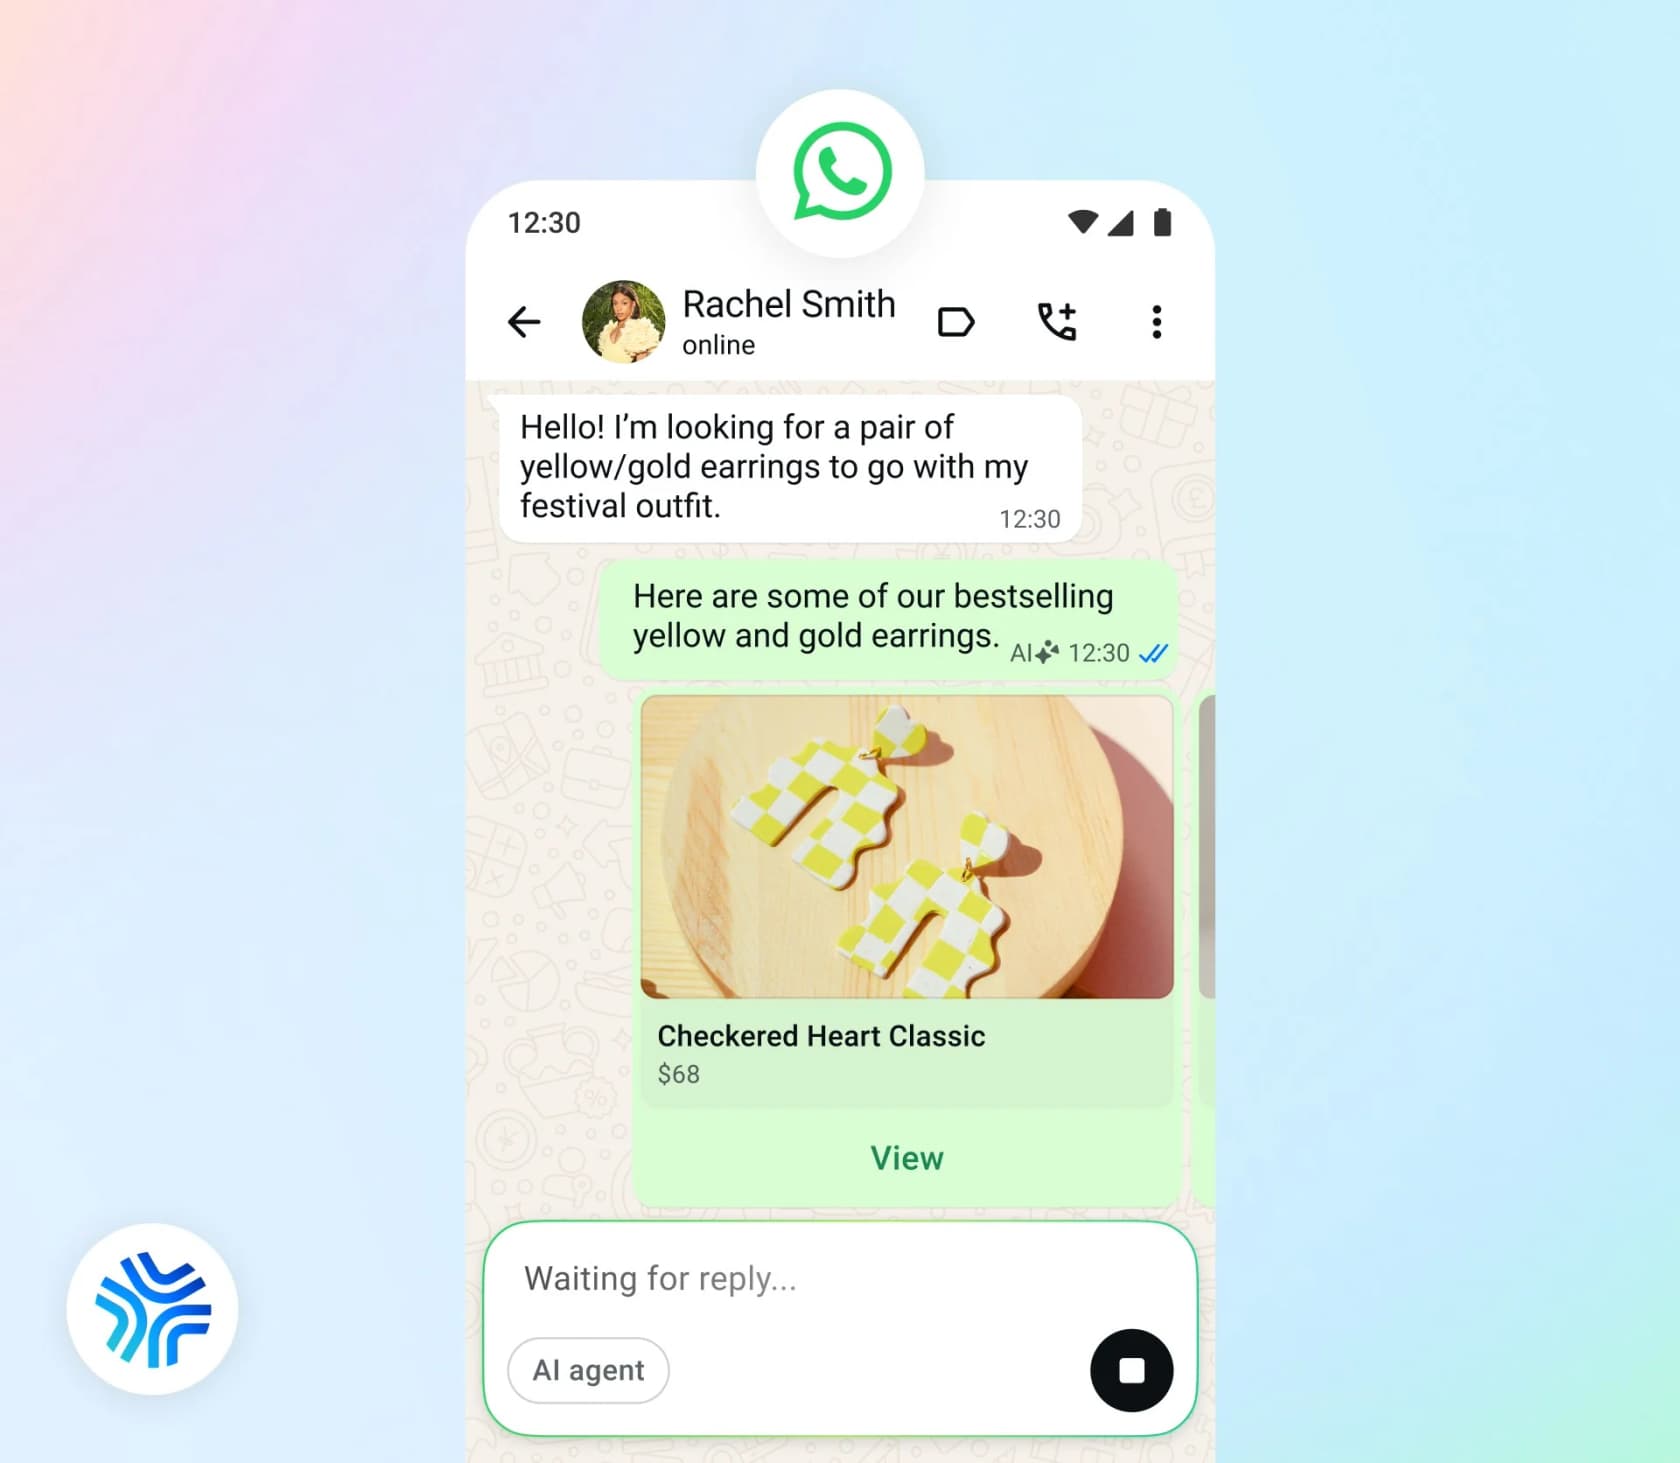
つまり、この検索の裏にある本当の購入判断は、Document360のコンテンツをどうやってWhatsAppボットに届けるかです。これは、会話が届くZendeskやFreshdeskのようなこのシリーズのヘルプデスク記事とは別の仕事です。Document360は回答が置かれている場所で、すでに独自のAIであるEddyを備えています。Eddyについては後で触れます。
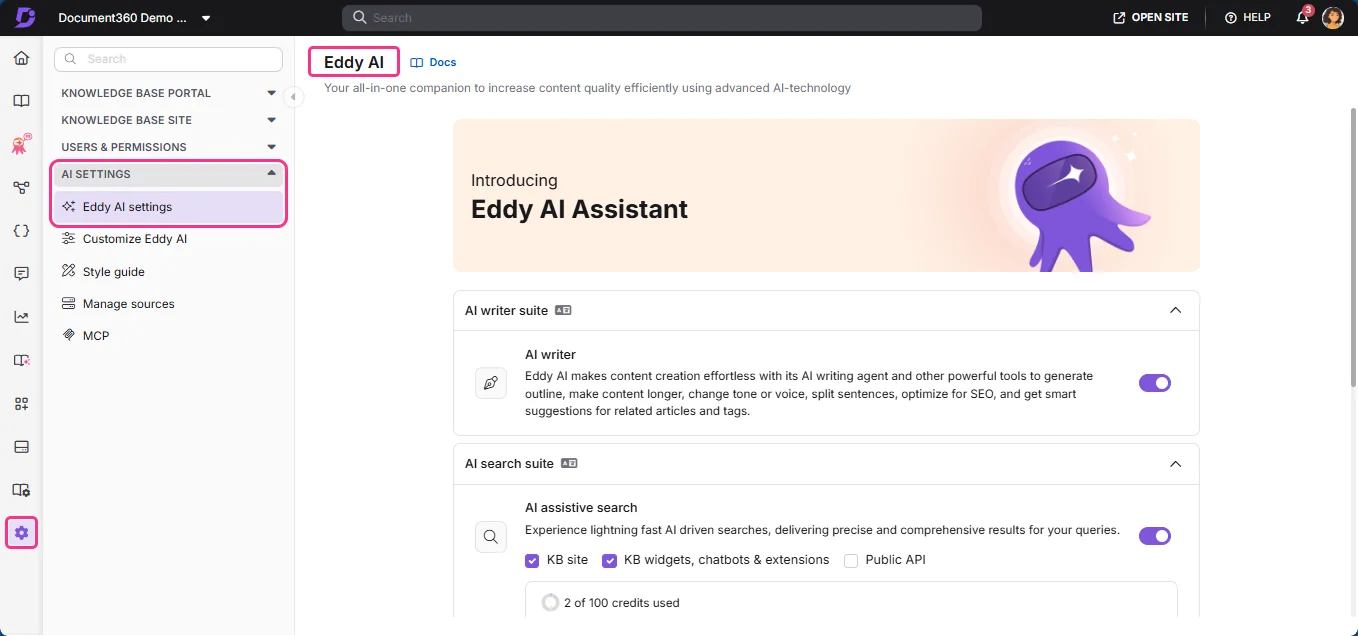
Document360は、どのヘルプデスクよりも、この記事のConfluence版に近い形をしています。違いは、Document360サイトの大半が設計上顧客向けであることで、そのためどの方法が最も簡単かが変わります。
Document360のコンテンツをMetaのエージェントに届ける4つの方法
Metaの機能ページは、Platform APIのナレッジソースとして、Business Info、FAQs、Files、Websitesの4つを挙げています。アクションや照会はコネクタを通ります。これは自分で定義するHTTPまたはMCP連携です。MetaのドキュメントにDocument360の名前はどこにもありません。
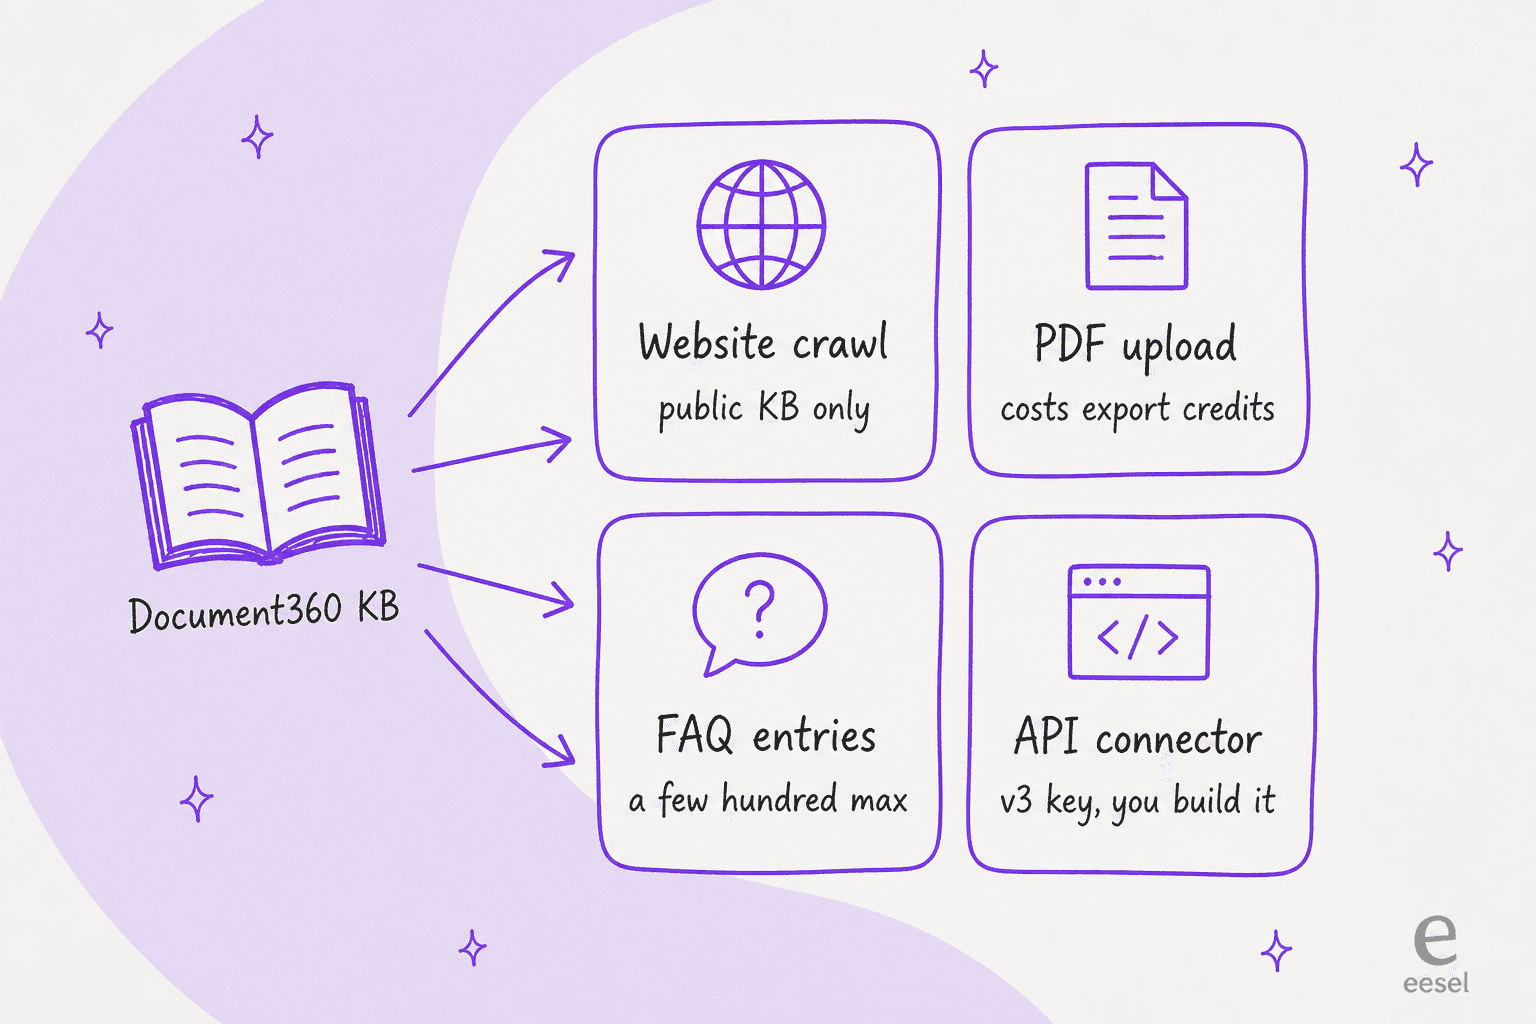
個別に見る前に、4つを比較します。
| 方法 | Metaの入力 | Document360側の設定 | 非公開プロジェクト | 鮮度 | 主な落とし穴 |
|---|---|---|---|---|---|
| 公開クロール | Websites API | 公開または混在プロジェクト、サイトマップ有効 | 不可 | 次回の再クロール時、間隔は非公開 | 公開記事にしか使えない |
| PDFアップロード | Files API | 記事をPDFでエクスポート | 可(エクスポートすれば) | 再アップロードするまで更新されない | PDFエクスポートクレジットを消費、古いファイルが残る |
| FAQへの書き換え | FAQs API | 不要、手作業またはAI FAQジェネレーターで書き換え | 可 | エントリを更新したとき | 数百件を超えると品質が落ちる |
| APIコネクタ | HTTPコネクタ | 読み取り専用でスコープを絞ったv3 APIキー | 可(キーのコンテンツスコープ次第) | ライブ | 自分で作り、保守する |
方法1:Metaに公開Document360サイトをクロールさせる
公開Document360プロジェクトはすでにウェブサイトなので、多くのDocument360チームが今日使えるのがこの方法です。
MetaのWebsites APIはURLをクロールして内容を取り込みます。デフォルトでは「ドメイン全体」を対象とし、サブドメイン、URLパターン、単一URLの項目で絞り込めます。リクエストにはログインやCookieの項目がなく、Metaのサポートエージェントガイドは「公開ウェブサイト」をクロールするものと説明しています。つまり対象になるのは、ログインなしで誰でも開けるコンテンツだけです。
Document360には、クロールをきれいにするいくつかの制御があります。
- サイトマップ。 Document360はサイトのサイトマップを生成し、これがクローラーがたどる地図になります。含まれる内容はサイトマップのドキュメントにあります。
- Robots.txt。 ナレッジベースのサイト設定で編集し、すべてのクローラーまたは特定のユーザーエージェントに対してパスをブロックできます(Document360のrobots.txtページより)。MetaはBusiness Agentのドキュメントでクローラーのユーザーエージェントを公開していないため、robotsルールに頼らず、MetaのURLパターン項目で範囲を絞ります。
- 検索での可視性。 記事ごとの切り替えで、ページをGoogle、ナレッジベース検索、Eddy AIから除外できます。落とし穴はDocument360の検索可視性のドキュメントにあり、この設定は「アクセスを制限しません」。除外した記事もURLでは読めるため、リンクを見つけたクローラーは読めてしまいます。
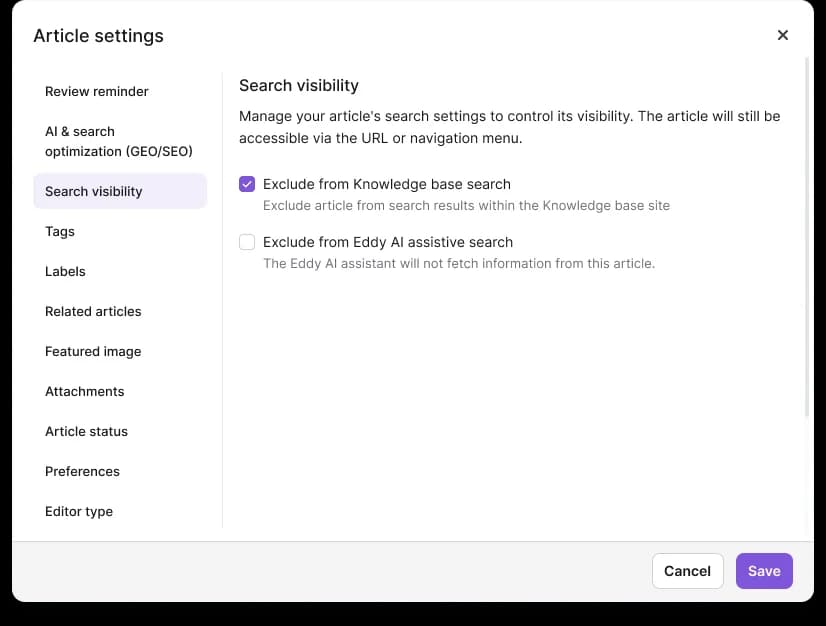
最後の点は、一部のカテゴリが公開で、一部がサインイン済みリーダー向けの混在プロジェクトを運用している場合に重要です。Document360の料金FAQは、プロジェクトを公開、非公開、混在に分け、リーダーアカウントは「非公開ナレッジベースにのみ適用」と説明しています(Document360の料金)。Metaが見るのは公開部分だけなので、顧客が最もよく聞く回答がリーダー専用側にないか確認してください。
それでもクロールの範囲は厳しく絞ってください。Metaのガイドは、サイト全体をクロールすると「エージェントが回答の拠り所にすべきヘルプコンテンツが薄まる」と警告しています。Document360サイトにAPIリファレンスやリリースノートも含まれるなら、Metaにはヘルプカテゴリだけを指定します。
方法2:記事をPDFでエクスポートしてアップロードする
非公開プロジェクトでは、コンテンツをエクスポートしてファイルをMetaに渡せます。Document360のPDFエクスポートでは、カテゴリと記事を選び、テンプレートを適用して、1つのPDFをダウンロードできます。
MetaのFiles APIは、.pdf、.doc、.docx、画像を受け付け、抽出を有効にするとCSVとXLSXも扱え、1ファイル最大100,000,000バイトです。MarkdownとHTMLはリストにないため、ここではPDFが現実的な形式です。先に知っておきたいDocument360の詳細が2つあります。
- エクスポートはクレジットを消費します。 「生成されたPDFの各ページが1クレジットを消費」し、月ごとの枠から引かれます。この枠は、読者がサイトからダウンロードするPDFと共有されます。毎週200ページをエクスポートすると積み上がります。
- 公開済みコンテンツだけが対象です。 非表示の記事やカテゴリは選択できません。下書きがボットに入らないので便利です。
そして、Meta自身がサポートガイドで指摘している点があります。
「更新の呼び出しはありません。ドキュメントを置き換えるには、古いエントリを削除して新しいものをアップロードしてください。そうしないと、エージェントは両方のバージョンを参照し、すでに撤回した用語を引用することがあります。」
返品期間が30日から14日に変わり、誰かが古いPDFを削除せずに新しいPDFをアップロードしたとします。エージェントはWhatsAppでどちらの数字も引用しうるのです。Document360自身のエクスポートのドキュメントも、逆の側から同じことを述べています。エクスポートしたPDFは「静的」で、後の編集は「PDFに反映されません」。したがってこの方法では、コンテンツが変わるたびに、以前のファイルをIDで削除して新しいものをアップロードするスクリプトが必要です。
Metaは、すべてをアップロードすることにも警告しています。「ドキュメントセットが大きいと、エージェントが適切な箇所を見つけるのが遅くなります」。巨大な1つのエクスポートより、カテゴリごとの小さなPDFのほうが優れています。
方法3:主要記事をFAQエントリに書き換える
MetaのFAQs APIは、その場で更新できる質問と回答のペアを保存します。エージェントは一致するエントリを答えとして扱い、「他のナレッジソースから答えを推測するのではなく、そこから回答」します。そのためFAQは、返金条件や料金のように正確でなければならない回答に最も予測しやすい入力になります。
上限は低めです。Metaは、品質が「一般に数百件を超えると」劣化しうると述べています。Document360チームにとって、この方法は思うより安上がりです。EddyのAI FAQジェネレーターは、記事からQ&Aペアをすでに下書きしてくれるからです。私なら、前四半期のチケット発生源の上位(この一覧はWhatsAppチケット偏向と同じものです)を取り、それらの記事のFAQを生成し、手で編集してMetaに送ります。ロングテールはクロールかコネクタに任せます。
方法4:スコープを絞ったv3キーでAPIコネクタを作る
非公開コンテンツを非公開のまま、しかも最新に保てる唯一の方法で、自分で作る必要があります。
Metaのコネクタのリファレンスでは、エージェントをHTTP APIまたはリモートMCPサーバーに向けられます。認証は限られています。「現在サポートされているのはOAUTH2_CLIENT_CREDENTIALS、API_KEY、NONEのみです」。この1行で、使えるDocument360のインターフェースが決まります。
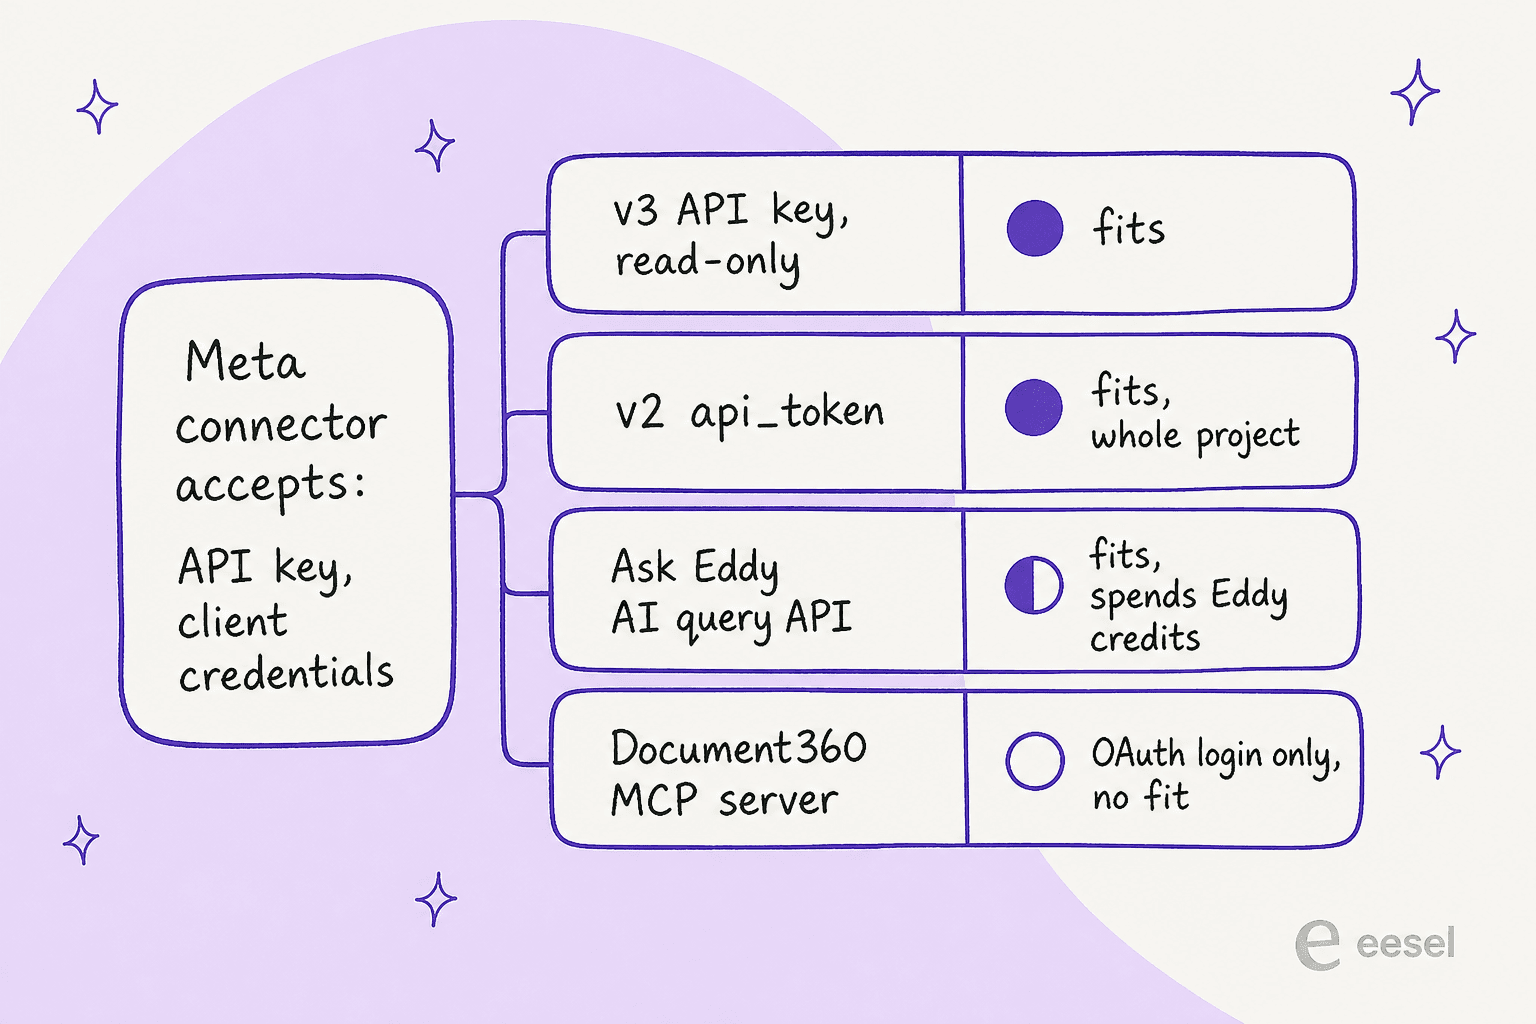
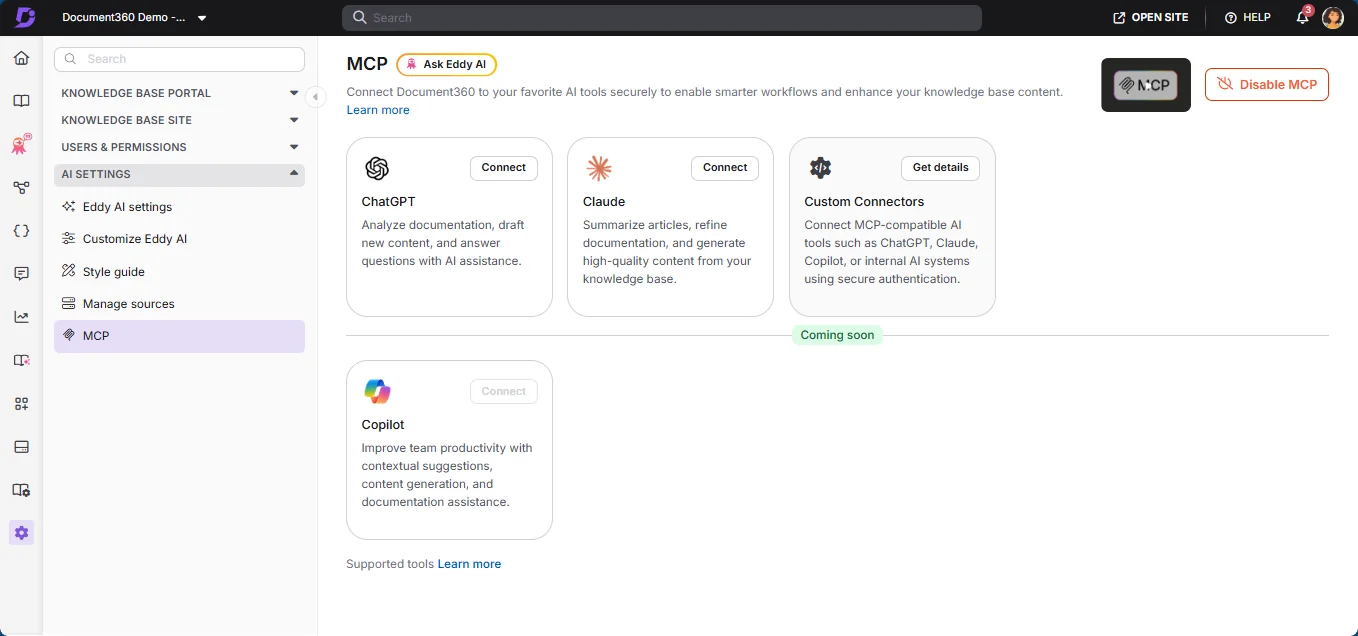
Document360のMCPサーバーは、文書化されている限り適合しません。 すでにdocument360-mcp-searchツールがあるため、まず思いつくのはこれです。しかしMCPの概要には、「認証にOAuthを使用」し、各接続を「OAuthフローを完了したユーザーアカウント」に紐づけるとあります。これはブラウザ上の同意画面であり、Metaのコネクタにはクリックして通過できません。
v3 REST APIは適合します。 MCPが初めてなら、認証モデルがなぜそこまで重要かを私のカスタマーサポート向けMCPの解説で説明しています。Document360のAPIキーのページによれば、キーはX-API-Keyヘッダーに入れ、「Authorization: Bearerとしても受け付けられ」ます。これはMetaのAPI_KEY認証タイプに対応します。便利なのはスコープです。v3キーにはポータルロール、コンテンツロール、コンテンツアクセススコープがあるため、1つのワークスペースまたはいくつかのカテゴリだけを読めるGET専用キーを発行できます。v3より前に作られたプロジェクトには、古いv2のapi_tokenが残っている場合があります。これも使えますが、コンテンツのスコープ指定はできません。
基本的なコネクタには、2つのツールが必要です。
- 検索:v3のsearch workspace articlesエンドポイントを使います。公開済みで可視の記事に対するキーワード検索で、
page_sizeの上限は100です。 - 記事の取得:最良の一致の全文を取ってきます。
より興味深い3つ目の選択肢があります。v3のAI search queryエンドポイントは、自然言語の質問をEddyに送り、ドキュメントから生成した回答を返します。これをツールとして接続すれば、Metaのエージェントは回答をEddyに尋ねる形になります。同じAPIキーで動きますが、呼び出しごとにEddyクエリとなり、Eddyクエリはクレジットで計量されます。
最初から3つの落とし穴を見込んでください。
- レート制限。 レート制限のページによると、v3はプランに応じてキーごとに毎分120または200回の読み取りを許可します。小さなチームには十分で、繁忙期の前に確認する価値があります。
- レスポンスのサイズ。 Metaのコネクタツールのリファレンスは、大きすぎるレスポンスは「エージェントの回答品質を低下させる」と警告しています。その
transformation_specを使って、記事本文をテキストだけに絞ります。 - ナレッジソースではなく照会です。 Metaは、注文状況などのアクションや顧客照会のためのコネクタを文書化しています。ナレッジベースとして説明したことはないため、「Document360を検索する」ツールは、Metaが保証するものではなく、しっかりテストすべきものです。
Document360の仕組みに触れる2つの方法の両方で、制限に予算を割いてください。G2のあるDocument360管理者は、この記事が拠り所とするまさにその2点を指摘していました。
「最後に、APIトークンの使用、1日あたりのエクスポートサイズ制限、その他の使用上限などに制約があります。こうした制限は、大規模にドキュメントを管理するチームに追加コストや運用上の摩擦を生む可能性があります。」

デモに出てこない鮮度の問題
多くのセットアップガイドは、ボットが最初のテスト質問に答えたところで終わります。Document360チームにとって本当のテストは、翌週の火曜日、誰かが編集を公開したときに何が起こるかです。
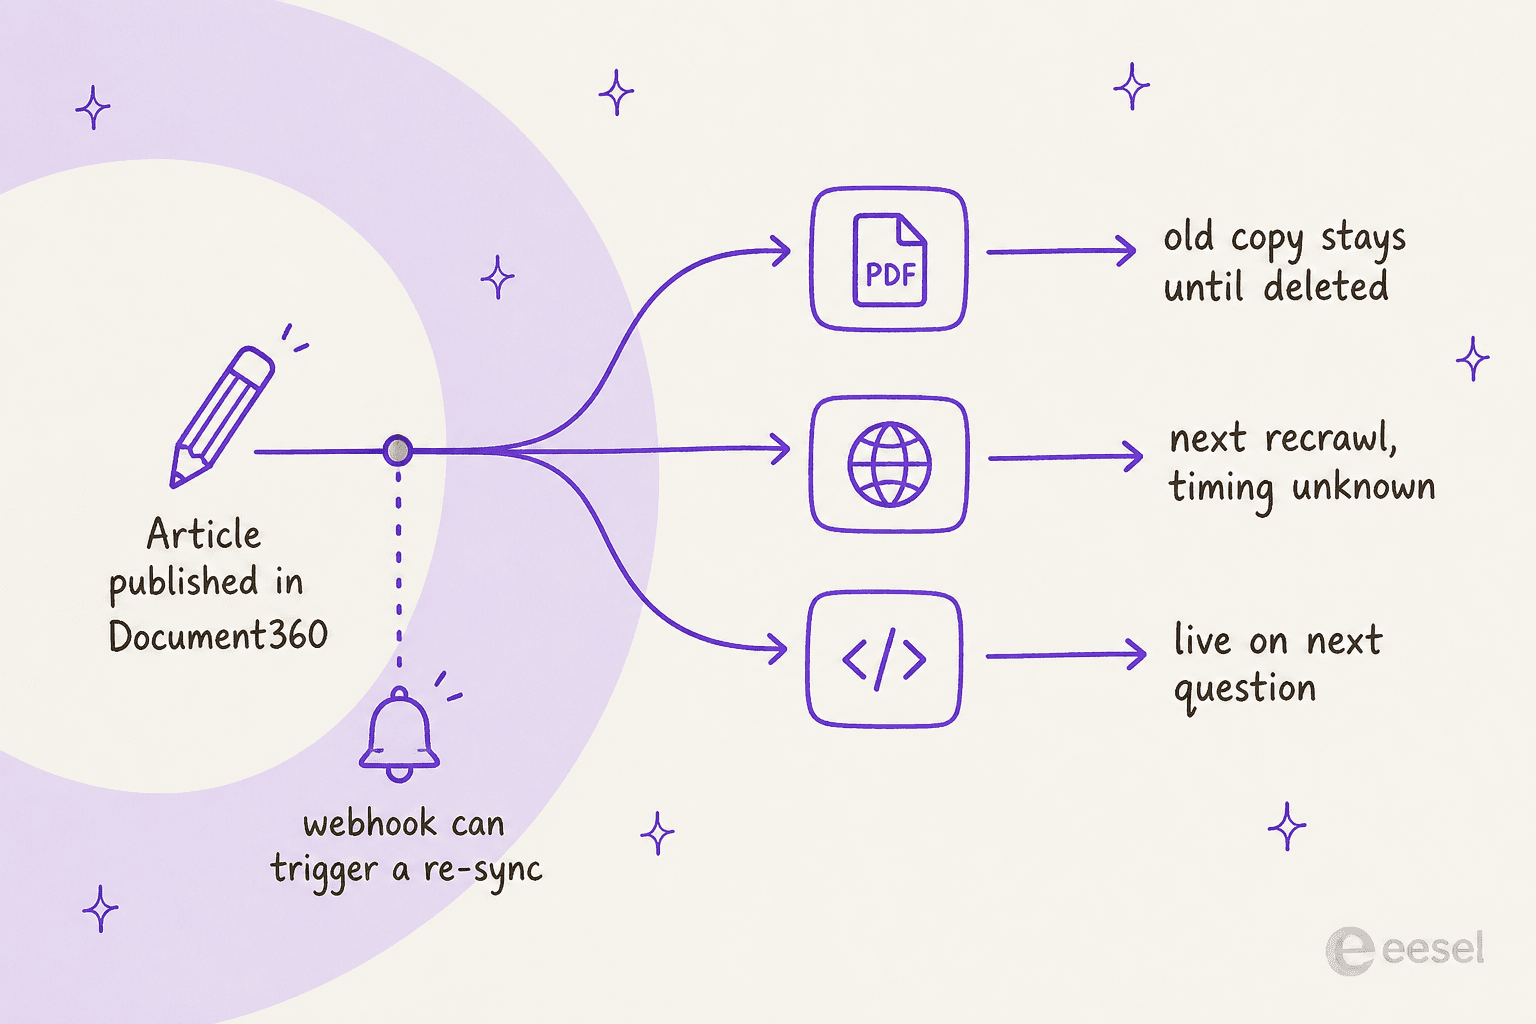
Metaは、クロールしたサイトは「定期的に再クロールされる」としながら間隔を示さず、ガイドでもウェブサイトのナレッジは「クロール時点のスナップショット」だと付け加えています。ファイルは決して更新されません。FAQはAPIを呼んだときに変わります。編集をすぐに見られるのは、ライブのコネクタだけです。
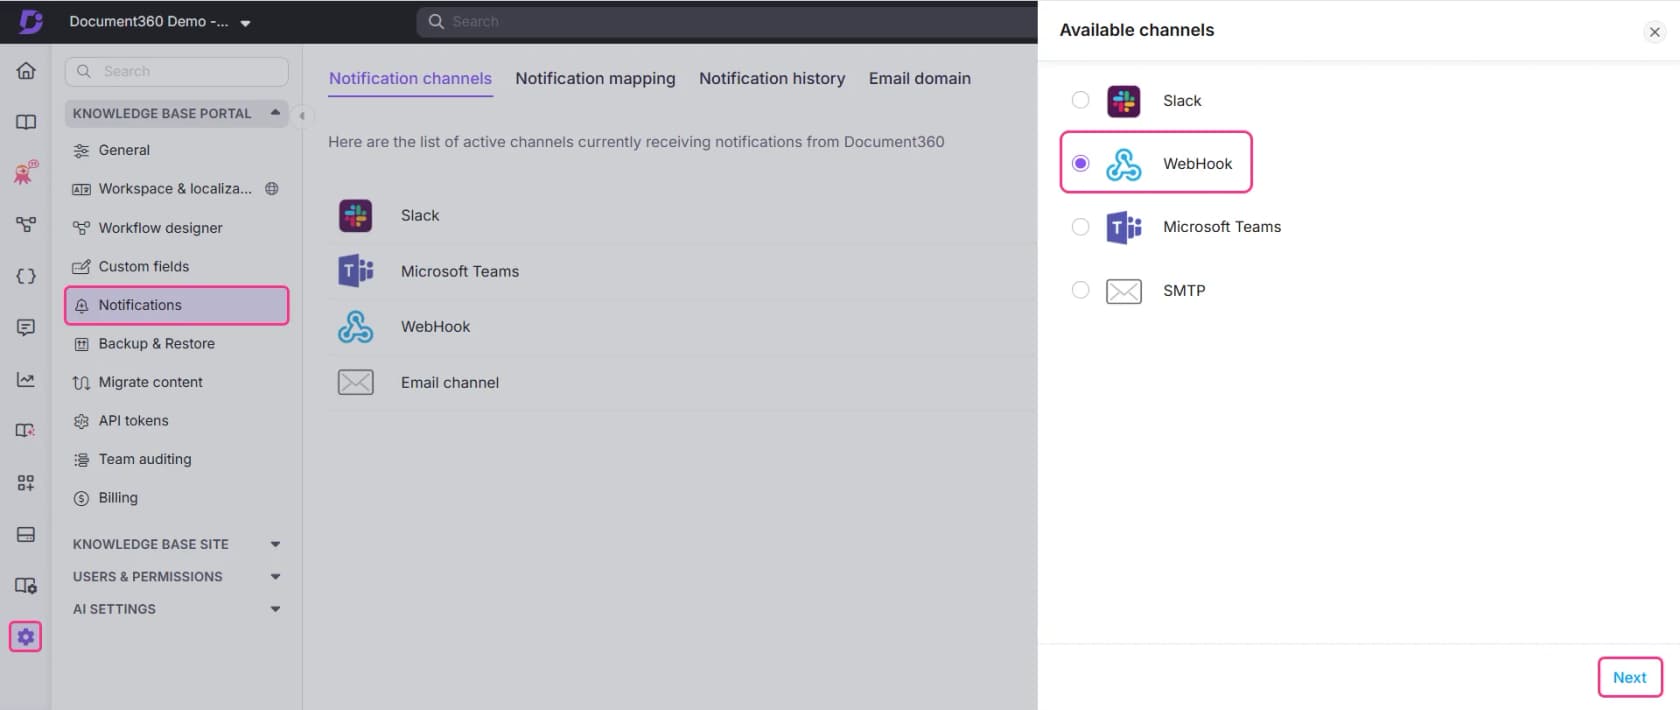
ここで役立つDocument360の機能が、Webhook通知です。記事の公開、更新、削除といったイベントをWebhook URLに対応づけられます(Webhookチャネルのドキュメントより)。Document360はキャッシュの無効化を用途の一例としています。これが再アップロードスクリプトに必要なトリガーで、どんなWhatsAppサポート自動化とも同じパターンです。公開時に記事をエクスポートし、Metaの古いファイルを削除して、新しいものをアップロードします。自分で運用するスクリプトであることに変わりはありませんが、少なくとも誰かが思い出すのではなく、実際のイベントで動きます。
鮮度のもう半分は、ナレッジベースに質問への答えがないときのボットの振る舞いです。Metaには「ナレッジからのみ回答」のスイッチがありません。グラウンディングは指示文の一行で、Metaのサンプルはこうです。「ポリシーの質問には文書化されたポリシーからのみ答え、答えがない場合は推測せず、同僚に確認すると伝えること」。Redditの初期のBusiness Agentテスターは、それがないとどうなるかを書いていました。
「一貫性が問題です。同じ商品が2つの返信で違う価格で返ってくるのを見ました。きちんと根拠づけしないと、ただ作り話をします。」

実際のeesel導入でも同じことを見てきました。検索結果が空のときに、ボットが実際の顧客に作り話の回答をしてしまった有料のお客様がいました。だから今では、ボットを公開する前に、ナレッジ不足時のフォールバックと過去チケットでのテスト実行が標準になっています。ハルシネーション防止のガイドで、その設定を順に説明しています。
ボットが使いやすい記事を書くことも役立ちます。1つのトピックに絞った短いページで、最初の段落に答えを置くと、長いページより検索されやすくなります。構成の仕方はナレッジベースでの学習のチュートリアルにあります。
Eddy AIの位置づけ
これらを構築する前に、Document360自身のAIがすでに仕事をこなしていないかを問うのは妥当です。Eddyは、ナレッジベースサイト、KBウィジェット、Chatbot Keyで埋め込む単独のチャットボットで回答します。FreshdeskやZendeskのチケットで学習することもでき、その手順はFreshdeskとDocument360のガイドで説明しています。使った記事を引用し、サインイン済みリーダー向けの記事権限も尊重します。
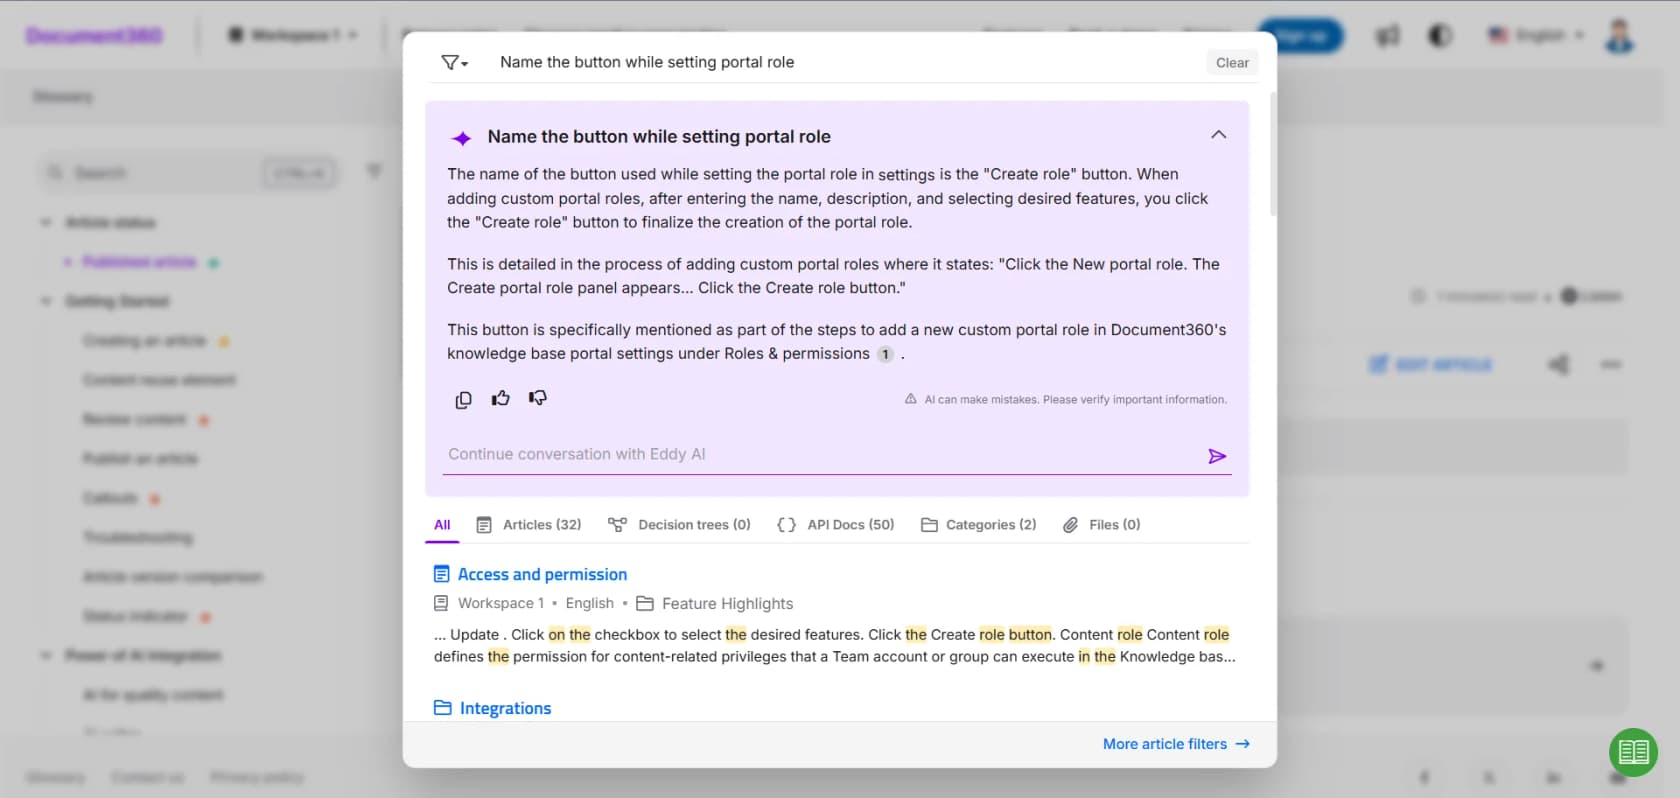
Document360が文書化していないのは、EddyのWhatsAppチャネルです。チャットボットはウェブサイトに、ドメインごとに1つ展開され、ヘルプデスク上の唯一のアクションはZendeskまたはFreshdeskでのチケット作成です。ですので、線引きは単純です。
- 顧客がサイトやヘルプセンターで質問する場合: Eddyはすでにそこにいます。詳しくは私のDocument360 AIのレビューで、Document360のKBから回答できるほかの選択肢はEddy AIの代替のリストで扱っています。
- 顧客がWhatsAppで質問する場合: その番号はMetaのエージェントが担い、EddyのAI検索APIをコネクタに配線した場合にのみEddyが役立ちます。
代わりにDocument360の上で汎用アシスタントを使いたい場合は、Document360向けChatGPTとDocument360向けGrok Botのガイドがそれらの方法を扱い、Document360向けAIはドキュメントを書くことと、そこから回答することを比較しています。
コスト
請求は2つあります。Metaの分とDocument360の分です。
| コスト項目 | 価格 | 出典 |
|---|---|---|
| Meta Business Agent、WhatsApp Platform | 100万トークンあたり2.00ドル。単純な会話で約16〜20セント、複雑な会話で40〜50セント | Metaの料金 |
| チームのWhatsApp返信(2026年10月1日から) | ユーティリティ料金でメッセージ単位、番号ごとに月1,000通まで無料 | Metaの料金 |
| Document360のプラン | 見積もり制。チームアカウント、ワークスペース、言語、SSO、プライバシーモデル、AI Premium Suiteの利用量で決まる | Document360の料金 |
| Document360のリーダーアカウント | 課金対象、非公開プロジェクトのみ | Document360の料金 |
| PDFエクスポート(方法2) | PDF1ページにつきエクスポートクレジット1、月ごとの枠 | Document360のドキュメント |
| API経由のEddy AI検索(方法4のオプション) | 1クエリにつきEddyクレジット1、枠は見積もりで決まる | Document360のドキュメント |
Document360側は、どのプランも個別見積もりのため数字にしにくいです。何が金額を動かすかは、私のDocument360の料金の解説で説明しています。6つの要因のうち、この記事につながるのがプライバシーモデルです。非公開プロジェクトには有料のリーダーアカウントが必要で、それはMetaがクロールできない構成でもあります。
Meta側では、10月1日の変更に注意してください。Metaの料金ページによれば、各メッセージは「Meta Business Agentのメッセージ_または_サービスメッセージのどちらか一方で課金され、両方にはならない」ため、AIの返信はトークンで課金され、引き継ぎ後にチームが送るものはすべてサービスメッセージとして課金されます。全履歴は私のWhatsApp APIの料金の解説にあります。
Document360チームにとってMetaのエージェントが止まるところ
Metaのエージェントは、一部のチームにとって妥当な選択です。限界は次のとおりです。
- 1番号につき1つのAI。 Metaのプラットフォーム概要には「有効な認可済みエージェント連携はMeta Business Agentをブロックします」とあります。WhatsApp番号ごとに1つのボットを選びます。
- Metaの面のみ。 回答できるのはWhatsApp、Messenger、Instagram、そして今のところShopifyに紐づくウェブサイトプラグインです。Metaのアプリ以外でも回答するツールは、私のWhatsAppチャットボットリストで比較しています。メールやヘルプデスクのキューは対象外で、セルフサービスが失敗したときに多くのDocument360読者が行き着くのがそこです。
- 引用の設定がない。 Metaのドキュメントには、エージェントに使った記事へリンクさせる設定がありません。Eddyはリンクし、ほとんどのナレッジベースチャットボットもそうです。
- 引き継ぎで受信箱が移る。 Business Agentが番号を引き受けると、既存のWhatsApp受信箱はスタンバイになります。この記事のZendesk版がMetaのConversation Routingを扱い、良い引き継ぎがどういうものかはAIエージェントの引き継ぎのガイドにあります。
- APIドキュメントはサポートの回答ではない。 多くのDocument360サイトは、ヘルプ記事とAPIリファレンスが混在しています。リファレンスはクロールから外してください。さもないとボットが請求の質問にエンドポイントの説明で答えます。
Document360チームに合う構成
私ならこう選びます。
| 状況 | 私が選ぶ方法 |
|---|---|
| 公開のDocument360ヘルプセンター、WhatsAppのみ | ヘルプカテゴリに絞ったウェブクロール |
| 正確でなければならない主要回答が100件未満 | AI FAQジェネレーターで作ったFAQエントリ、残りはクロール |
| 非公開プロジェクト、コンテンツは月次で変わる | カテゴリごとのPDFアップロード、最初に古いファイルを削除するWebhook起動のスクリプト付き |
| 非公開プロジェクト、週次で変更、余っているエンジニアがいる | 読み取り専用でカテゴリにスコープを絞ったv3 APIキーのHTTPコネクタ |
| すでにEddyクレジットを支払っている | EddyのAI検索APIを呼ぶコネクタ、クレジット消費に注意 |
| ヘルプデスクやサイトチャットでも回答している | すべてのチャネルを横断する1つのAI、そしてどのボットがWhatsAppを担うか決める |
方法ではなくツールを比較している段階ですか? WhatsAppサポート向けベストAIの比較とベストAIナレッジベースツールのリストは、それぞれ別の端から迫り、Document360の代替はKB自体の乗り換えを扱っています。
コネクタを自作したくなったなら、先に構築か購入かの記事に10分かける価値があります。
Document360でeeselを試す
上のどの方法も、チームの誰かがMeta側のナレッジベースのコピーを同期し続ける形で終わります。eeselはその手間を省きます。これはDocument360サイトをウェブサイトのナレッジソースとして読むAIヘルプデスクのチームメイトです。ヘルプセンターのURLを渡すと、サイトマップとリンクをたどって最大2,000ページをクロールし、すべての回答に出典記事へのリンクを付けます。含めるパスと除外するパスでAPIリファレンスを外せ、カスタムヘッダー(Cookie、Basic、Bearer)はログイン付きサイト向けにあり、非公開プロジェクトで試す価値があります。
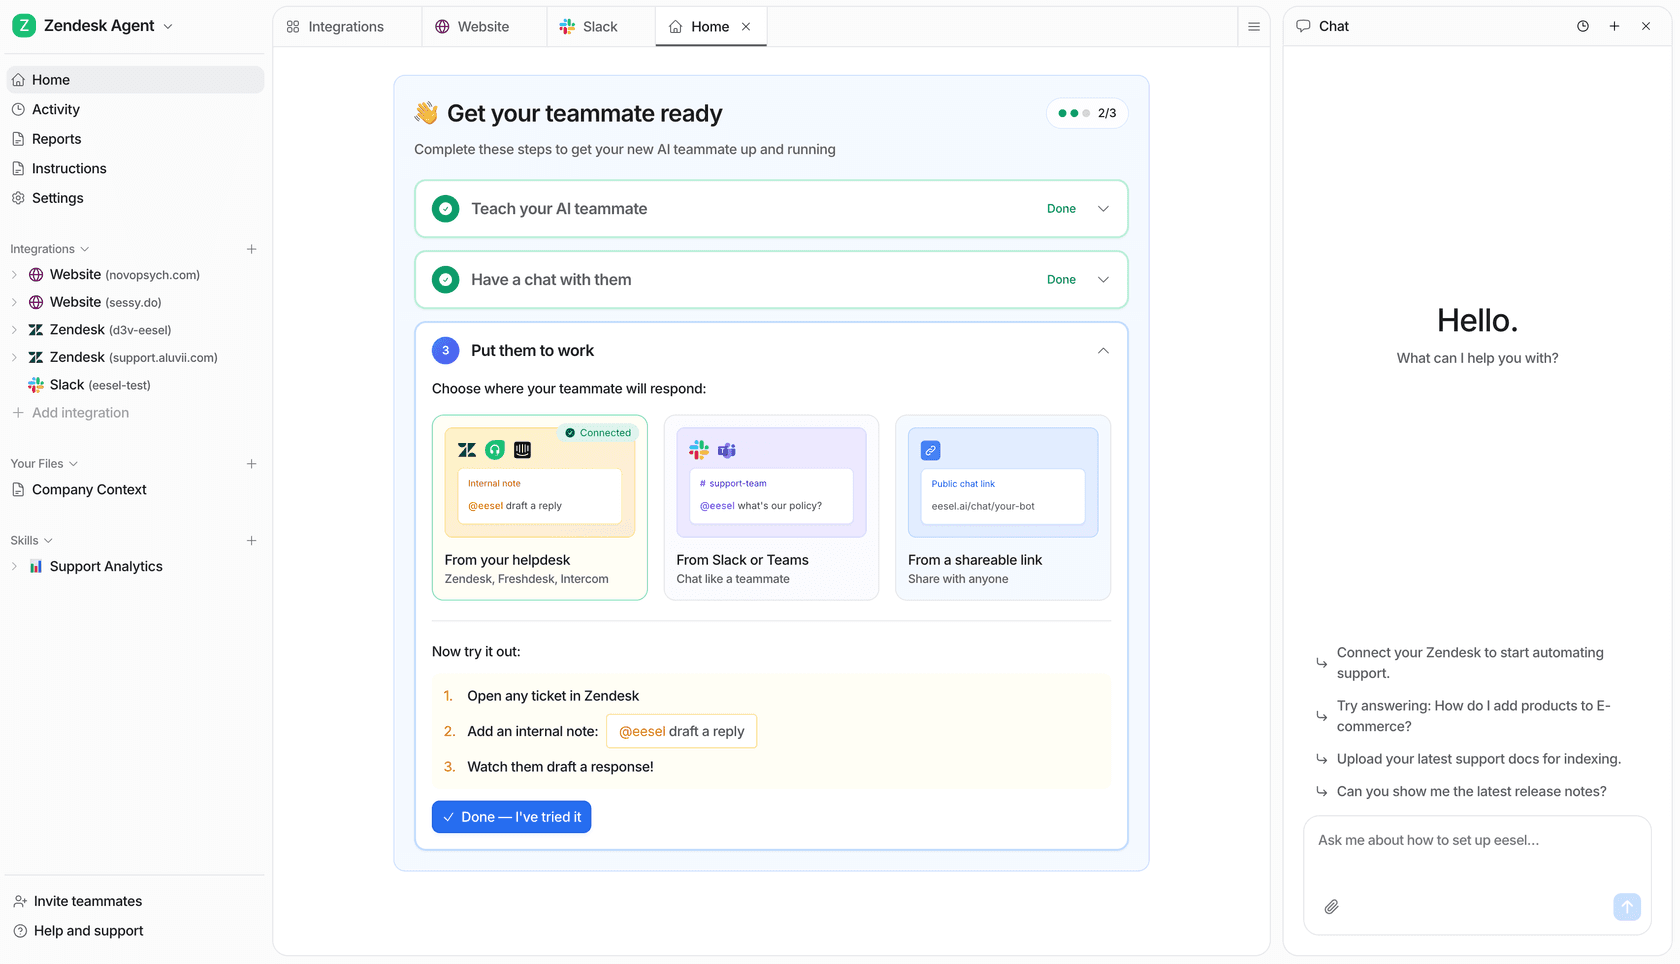
ネイティブのDocument360コネクタはないので、そうではないふりはしません。eeselがクロールに加えて提供するのは、サポート回答に必要なそれ以外のすべてです。過去のチケット、マクロ、ヘルプデスクをDocument360の記事と合わせ、ボットが実際の顧客に答える前に過去チケットでシミュレーションを実行します。ターミナルで作業するなら、eesel CLIが同じセットアップをコマンドで実行します。eesel integrations connect websiteでDocument360サイトを追加し、eesel statusでページ数を確認できるので、Claude CodeやCursorに任せることもできます。
WhatsAppが必要なチャネルなら、eeselのWhatsApp連携を見て、選ぶ際にMetaの「1番号につき1つのAI」というルールを念頭に置いてください。無料プランには100クレジットが付き、カードは不要です。有料プランは月500件のチケットまたはチャットで299ドルから。Document360のヘルプセンターでeeselを試して、どう回答するか確かめてください。
よくある質問
Meta Muse for Document360とは何ですか?
Meta Business Agentは非公開のDocument360ナレッジベースを読めますか?
Document360のMCPサーバーはMetaのWhatsAppエージェントで使えますか?
Metaのエージェントがすでに使っているDocument360の記事を更新するとどうなりますか?
Document360対応のMeta Museの費用はいくらですか?
WhatsAppサポートにはEddy AIとMeta Business Agentのどちらを使うべきですか?
Document360の情報でWhatsAppの顧客に答えるのに、もっと良いAIはありますか?


Article by
Kurnia Kharisma
Kurnia is a software engineer and writer at eesel AI with two years of SEO experience, writing about AI tools, helpdesk software, and customer support. He pairs a developer's understanding of how these products are built with search-driven research into what actually ranks and resonates with the people searching for them.