

Cloudflare Web Search APIとは実際に何か
Michelle Chen、Sam Else、Gabriel Massadasによる公開時のブログ記事は、面白い告白から始まります。エージェントはライブのページが必要になると、たいていURLを推測してcurlで取りに行くため、エージェントのログに404が大量に出る、というものです。ウェブ検索は、エージェントに本当の出発点を与えます。クエリを送り、結果のリストを受け取り、モデルに渡すだけです。
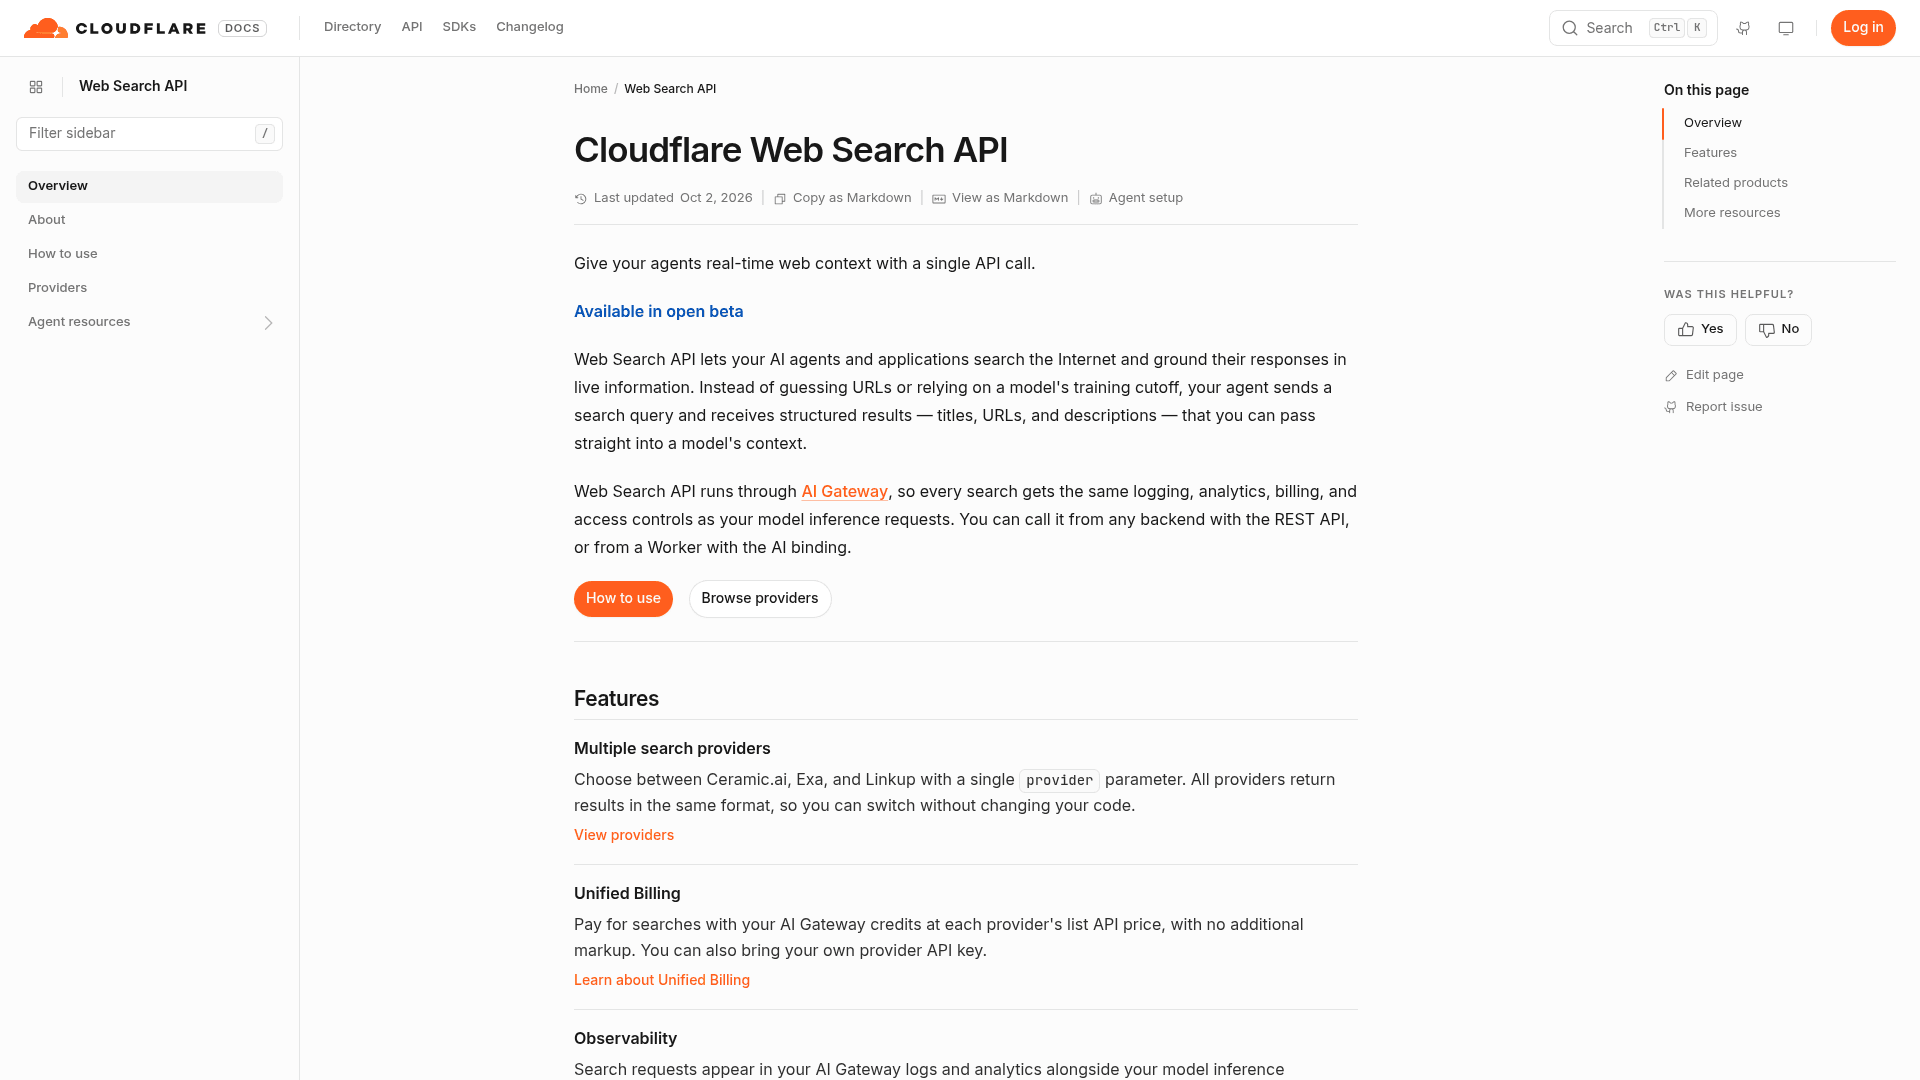
中身はルーティング層であり、検索エンジンではありません。CloudflareのAboutページは、各リクエストの4つのステップを挙げています。
- 指定したAI Gateway経由でリクエストをルーティングする。
- 選んだプロバイダーに、選んでいなければCeramic.aiにクエリを転送する。
- レスポンスを1つの形式に正規化する。URL、タイトル、そして任意で説明、画像、ファビコン、最終更新日。
- リクエストをログに記録し、アカウントに課金する。
現時点ではこれが製品のすべてで、これは褒め言葉として言っています。すでにモデル呼び出しをAI Gateway経由で行っているなら、検索も同じログ、同じ予算、同じアクセスルールの下に表示されます。Cloudflareはサーバーツールも予定していると述べており、ウェブ検索は自分で組み込むツールではなく、コントロールプレーンに組み込まれる形になっていくはずです。
発表はBirthday Weekに行われ、明らかに反響を呼びました。Hacker Newsのスレッドは590ポイント、284コメントに達し、Kitesurfブラウザの発表を上回りました。Cloudflare自身のXでの告知には、関心の理由を端的に示す返信が付きました。
"search in the same gateway as the model calls is the nice part. wiring exa into my agent tonight"
リクエストはどう流れるか
お金の話に入る前に、動く部品を見ておくと役立ちます。面白い判断はすべてそのどれかにあるからです。
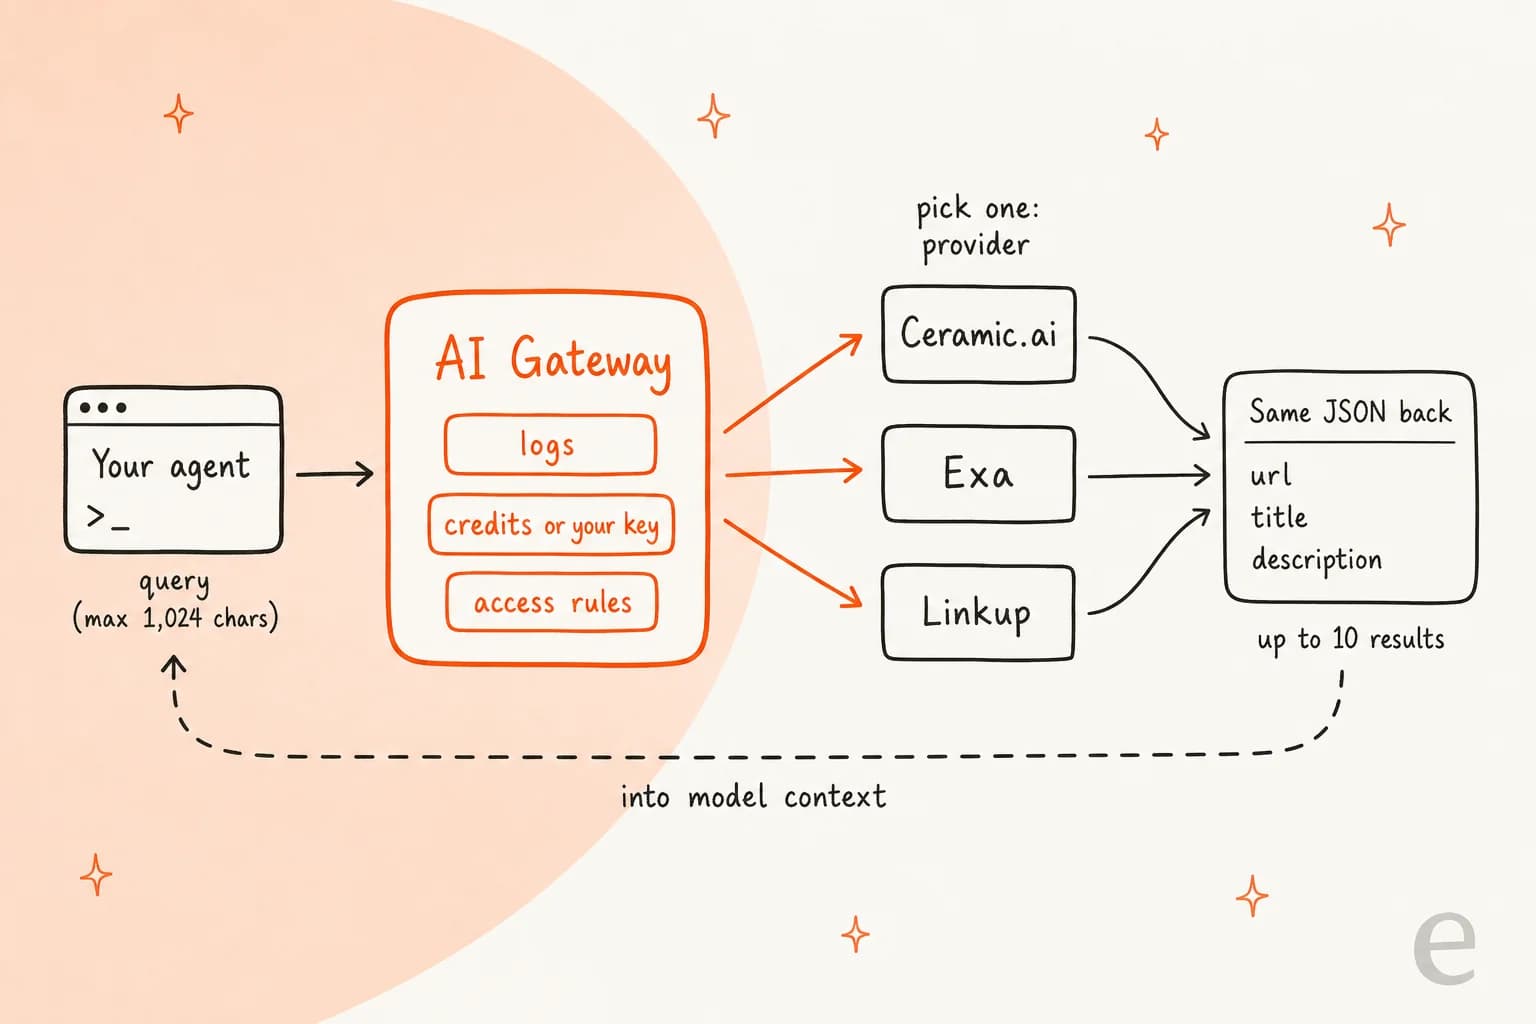
呼び出し方は2通りあり、どちらも使い方ページに記載されています。
- REST:
POST https://api.cloudflare.com/client/v4/accounts/{account_id}/ai/websearch/。Workers AI ReadとAI Gateway Readの両方の権限を持つCloudflare APIトークンで認証します。 - Workersバインディング:
env.AI.websearch({ gatewayId, query, provider, limit })。標準のResponseが返るので、.json()を呼びます。
リクエストの調整項目は非常に少なく、そこに設計の考え方が表れています。
| パラメーター | 役割 | 制限 |
|---|---|---|
query | 検索テキスト | 1〜1,024文字 |
provider | どのエンジンで実行するか | ceramic(デフォルト)、exa、linkup |
limit | 返す結果の件数 | 1〜10、デフォルト10 |
byokAlias | ゲートウェイに保存したプロバイダーキーを使う | 未設定の場合は400で失敗 |
gateway.id | どのAI Gatewayを経由するか | どのアカウントにもdefaultがある |
日付フィルター、ドメインの許可リスト、国の指定、ページ全文の取得オプションはありません。各プロバイダーは固定のモードで動きます。プロバイダーページによると、Exaはautoの検索タイプでハイライトを説明として使い、Linkupはfastの深さで生の結果を返します。ExaやLinkupのより深いモードが必要なら、直接呼び出します。
レスポンスは意図的に薄く作られています。items配列と、クエリ、リクエストID、latencyMsを含むmetadataブロックだけです。この薄さが狙いです。プロバイダーごとにパーサーを書かなくても、そのままモデルのコンテキストウィンドウに収まります。Cloudflareのドキュメントには、Workers AI上で動くGemma 4のようなモデル向けに、web_searchツールとして組み込む完全な例も載っています。
プロバイダーのパラメーターが本当の価格判断である理由
重要なのはこの表です。以下の数字はすべてCloudflareのプロバイダーページから取ったもので、2026年10月8日に確認しました。
| プロバイダー | providerの値 | 1,000リクエストあたりの価格 | ゼロデータ保持 | 返ってくるもの |
|---|---|---|---|---|
| Ceramic.ai(デフォルト) | ceramic | 0.25ドル | あり | 400億ページ以上の独自インデックス、最大8,000文字の説明 |
| Linkup | linkup | 5.00ドル | あり | fastの深さ、出典付きの生の結果、生成された回答なし |
| Exa | exa | 7.00ドル | なし | autoの検索タイプ、クエリに関連するハイライトを説明として返す |
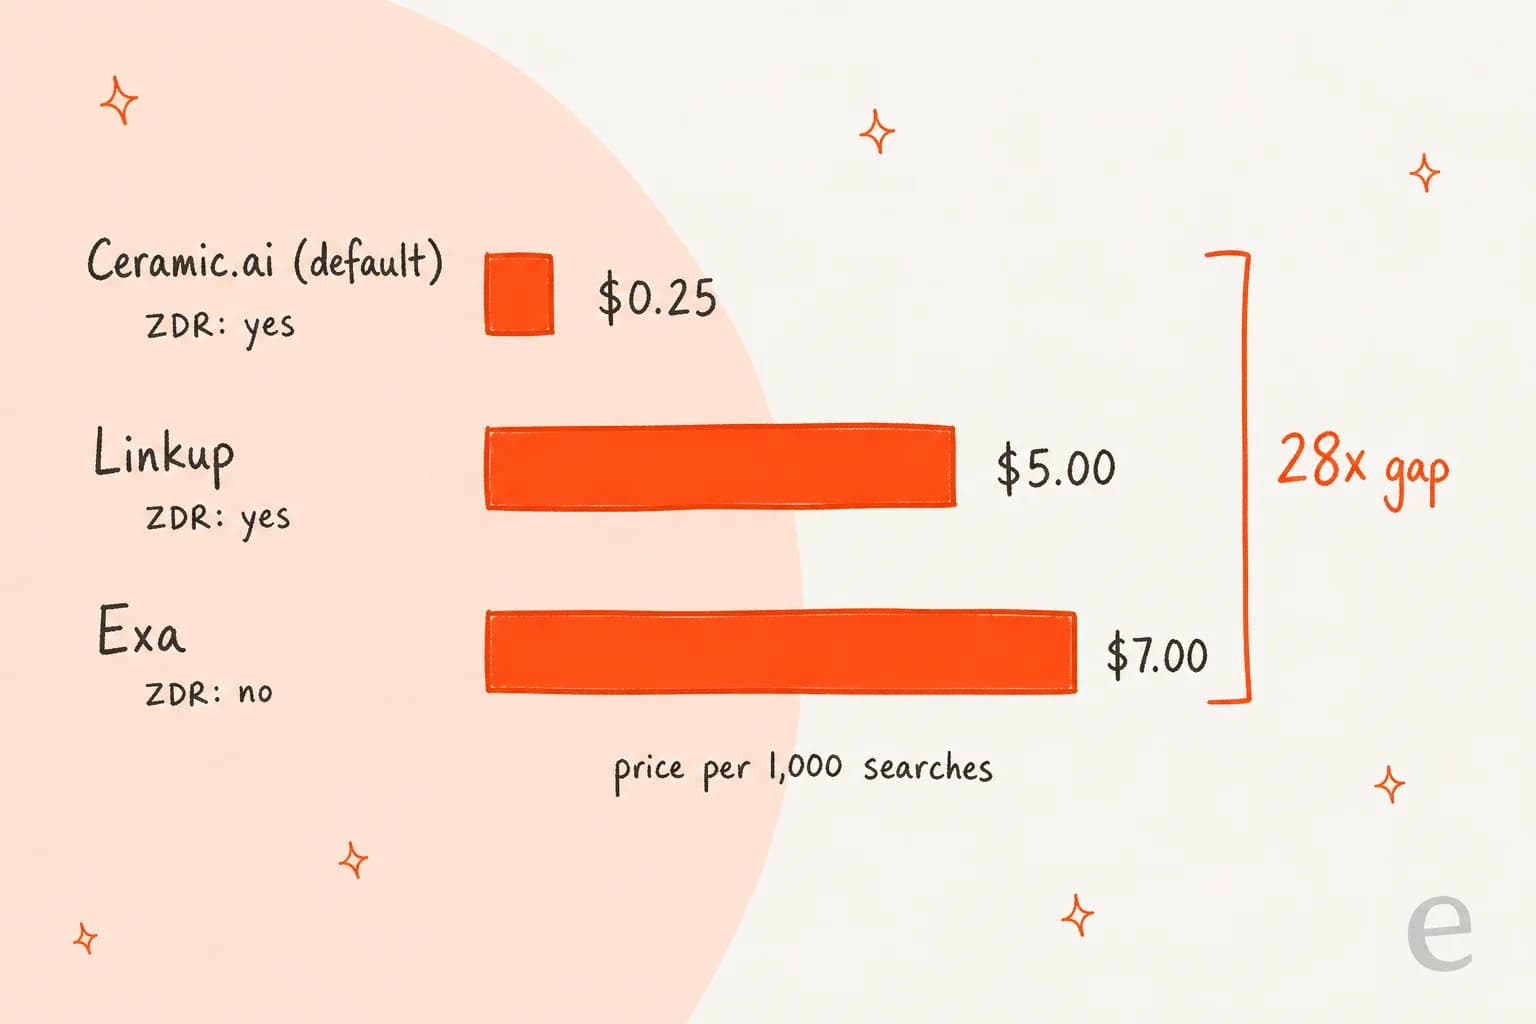
同じ形のリクエストで、ExaのコストはCeramicの28倍です。しかも切り替えは文字列1つで済みます。実験には最適ですが、予算には危険です。チームの誰かが設定ファイルでceramicをexaに変えても、コードは何も変わらないからです。価格表を投稿したHNのコメント投稿者は、的確な疑問を投げかけました。
"Does anyone have insights on the quality differences? Web search API pricing for AI agent usecases has always felt so expensive for what it is, but I have no grounding on the economics of running a web index."

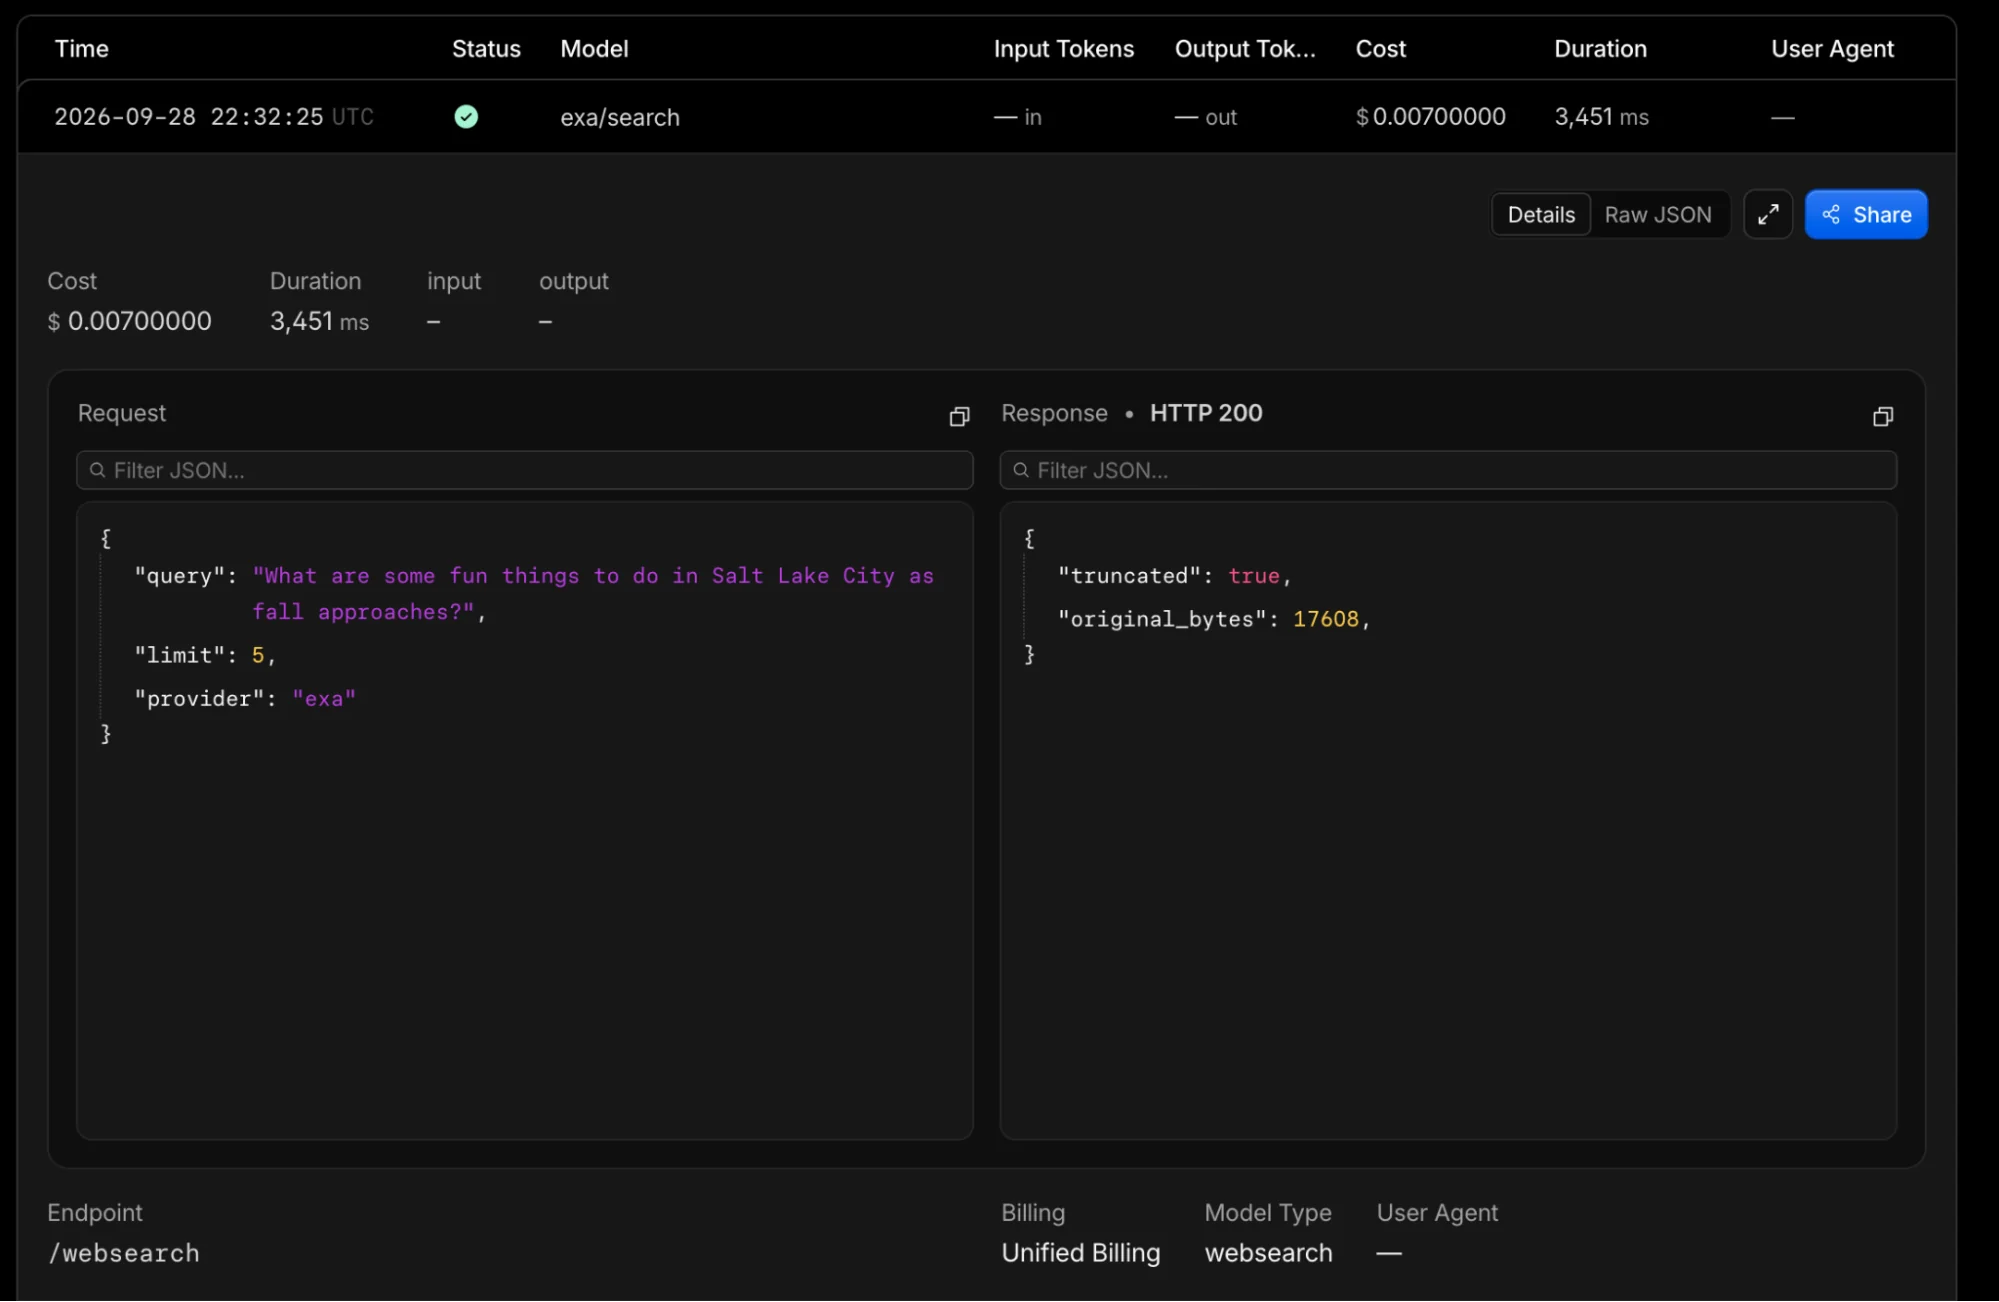
Cloudflareの発表記事には、1検索あたりのコストをはっきり示すログのスクリーンショットがあります。exa/searchの1回の呼び出しが0.007ドルで課金されており、これはちょうど1,000回あたり7.00ドルです。
「上乗せなし」という文言を丁寧に読む
Cloudflareは、検索は"at each provider's list API price, with no additional markup."で課金されると述べています。1回の検索あたりについては事実です。ただしAI GatewayのクレジットはUnified Billingで購入し、そのページには購入したすべてのクレジットに5%の手数料がかかると書かれています。100ドルのチャージは105ドルの請求になります。つまりクレジットで支払うと、実効レートは定価より約5%高くなります。自分のキーを持ち込む場合は、プロバイダーから直接請求され、その検索にはクレジット手数料がかかりません。
1リクエストにつき1回の検索と仮定して、実際の規模で見るとこうなります。
| 月間の検索回数 | Ceramic.ai(定価 / クレジット経由) | Linkup(定価 / クレジット経由) | Exa(定価 / クレジット経由) |
|---|---|---|---|
| 10,000 | 2.50ドル / 2.63ドル | 50.00ドル / 52.50ドル | 70.00ドル / 73.50ドル |
| 100,000 | 25.00ドル / 26.25ドル | 500.00ドル / 525.00ドル | 700.00ドル / 735.00ドル |
| 1,000,000 | 250.00ドル / 262.50ドル | 5,000.00ドル / 5,250.00ドル | 7,000.00ドル / 7,350.00ドル |
5%はプロバイダー選びに比べれば誤差です。月100万回の検索なら、CeramicではなくExaを選ぶ差は定価で6,750ドル。その上に乗るクレジット手数料は最大でも350ドルです。しかもエージェントがタスクごとに検索する回数は1回で済むことはまれです。ユーザーの質問1件につき5回検索するリサーチループなら、20万件の質問が100万回の検索になり、「安い」機能が経理のレビュー対象になります。自分の数字で試したい場合は、この計算ツールが掛け算をしてくれます。
Cloudflareが統一したものと、統一しなかったもの
多くの記事が見落としているのは、この視点だと思います。Cloudflareは3つのプロバイダーを、APIレベルでは同じに見えるようにしました。しかし、プロダクトチームにとって重要な点では同じではありません。
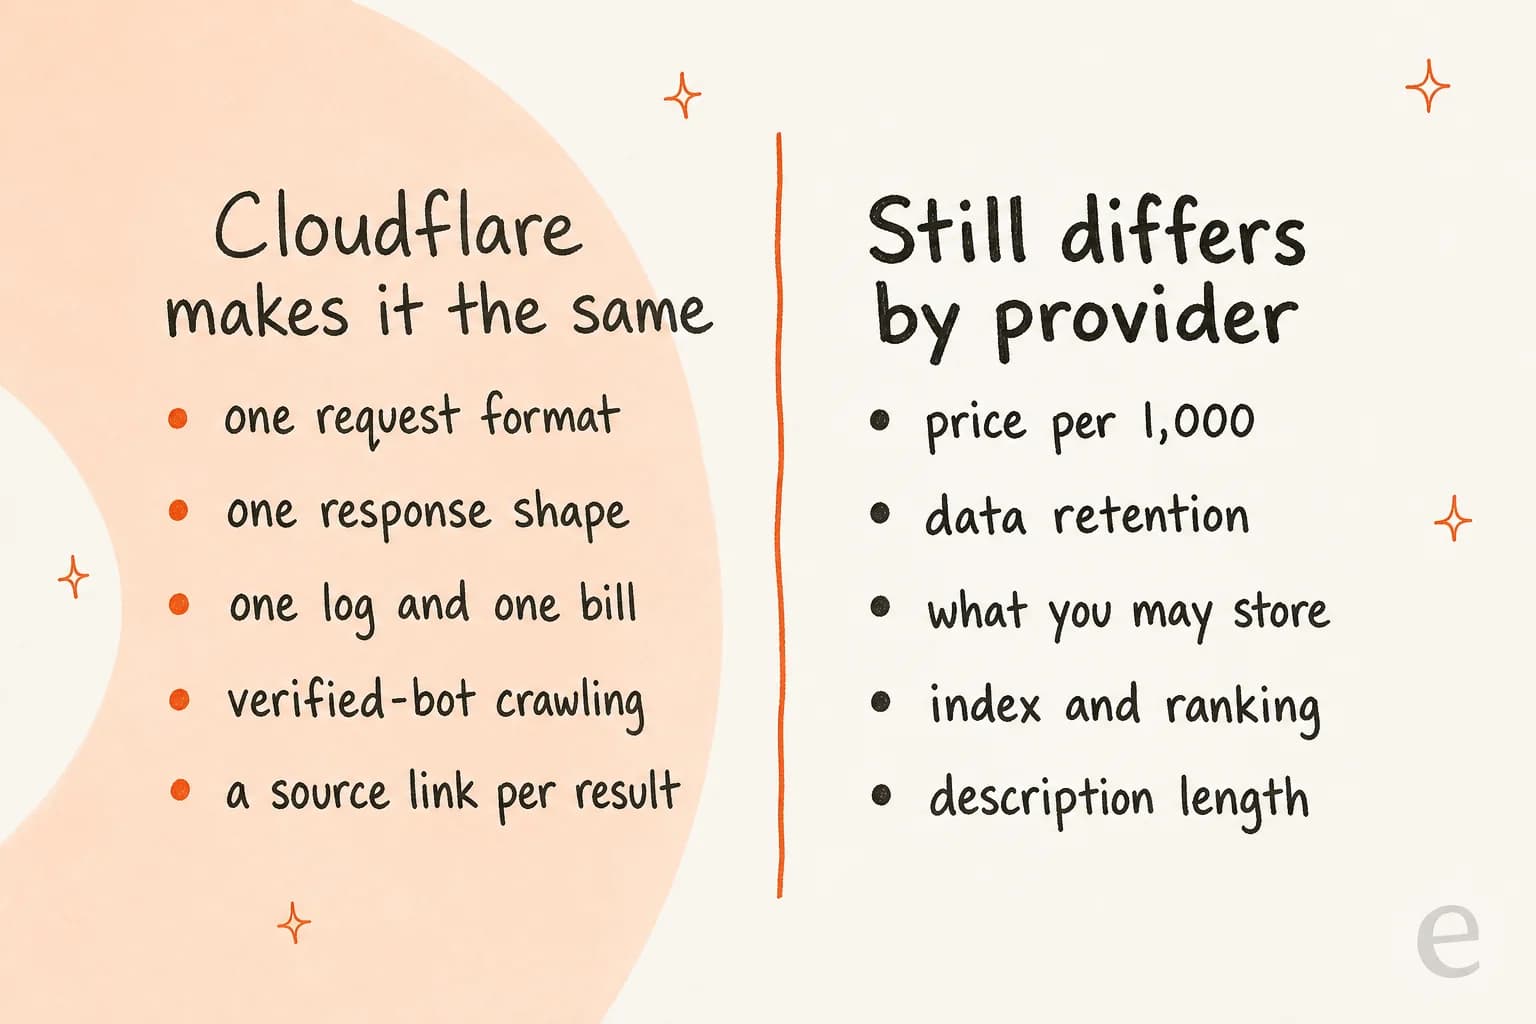
あるXの投稿が、私よりうまく言い表しています。
"The catch is that a unified endpoint also makes search providers look interchangeable when result quality, coverage, ranking, and failure modes probably won’t be."
本番投入の前に確認すべき点が3つあります。
データ保持について、2つのページが違うことを言っている
チェンジログのエントリには"all three support Zero Data Retention for requests made through Cloudflare."とあります。同じ日に更新されたプロバイダーページでは、Exaは"Zero Data Retention: No."です。10月8日に確認した時点でも、両方のページがそのままでした。HNの読者は数時間以内に気づき、Exaの関係者が返信しました。
"Thanks for raising this! We're looking into this discrepancy (I work at Exa)."
両者が一致するまでは、プロバイダーの表が正しいものとして計画するのが無難です。クエリに顧客名、注文番号、チケット由来の情報が含まれるなら、CeramicかLinkupのほうが安全な選択になります。また、Unified BillingのZDR設定はAI Gatewayのログ記録を制御しません。それは別のスイッチです。
何を保存してよいかは、各プロバイダーの利用規約で決まる
CloudflareはJSONを統一しましたが、ライセンスは統一していません。Simon Willisonは、「このチャットを共有」ボタンを持つすべての製品が問うべき疑問を挙げました。
"My number one question about search APIs is always if they allow you to store and resyndicate results you get from them."
彼はそのうえでCeramicの利用規約を引用しました。そこでは、出力を保持、キャッシュ、保存することが、"reasonably necessary to display such Output to your authorized end users in the ordinary and real-time course of use."を超える範囲では禁じられています。エージェントが検索結果を保存済みのトランスクリプト、ナレッジベース、キャッシュに書き込むなら、選んだプロバイダーの規約を読んでください。ExaとLinkupも、同じプロバイダー表から自社の規約にリンクしています。
結果の品質はパラメーターではない
最も安いプロバイダーがデフォルトで、ドキュメントはCeramicを"low-latency, low-cost search."向けに作られたものと位置づけています。初期のテスターは、そのインデックスにムラがあると感じました。
"Tried one query on ceramic.ai (the default provider for cloudflare web search api): "qwen-3.8 flash next and rtx 5090 best inference setup" ... 0 results ... same query on google and ddg both yield proper results."
1件の体験談はベンチマークではありません。Exaのインデックス責任者も同じスレッドで、検索品質はクエリの種類によって異なるという妥当な指摘をしています。それでも、結果が空になるのは、エージェントが扱わなければならない通常の結果であり、例外的なケースではないという注意喚起にはなります。なぜ重要かは、このあとで説明します。
Web Search APIと、エージェントに検索を持たせる他の方法
Cloudflareには現在「web search」と呼ばれるものが2つあり、混乱した読者もいました。AI Gatewayの以前からあるウェブ検索ページ(6月更新)は、各モデルベンダー独自の検索ツールのプロキシを扱っています。新しいAPIは別の製品です。
| 選択肢 | 検索が実行される場所 | 結果を選ぶのは誰か | どのモデルでも使えるか |
|---|---|---|---|
| Cloudflare Web Search API | Ceramic.ai、Exa、Linkup | 生の結果を受け取り、何を渡すかは自分で決める | はい、オープンモデルも含む |
AI Gateway経由のネイティブツール(Anthropic web_search_20250305、OpenAI web_search_preview、xAI web_search、Alibaba enable_search) | モデルベンダーの呼び出しの内部 | モデル | そのベンダーが対応するモデルのみ |
| AI Gatewayプロキシ経由の検索特化API(Perplexity、Parallel) | プロバイダー | プロバイダー自身のエンドポイント | 別の呼び出し、プロバイダー固有の形式 |
| 検索プロバイダーを直接呼び出す | プロバイダー | 自分 | はい、ただしプロバイダーごとに連携が必要 |
AnthropicのAPIやOpenAIのAPIを使っていて、組み込みの検索に満足しているなら、ネイティブツールのほうが配線は少なくて済みます。Web Search APIが価値を発揮するのは、独自の検索パートナーを持たないオープンモデルを動かす場合です。たとえばKimi K3や、DeepSeek Harnessの背後にあるモデルです。HNのあるコメント投稿者がまさにそう推測していました。大手のコーディングエージェントには検索パートナーが付いてくるが、オープンモデルはどこかから検索を調達する必要がある、というわけです。
多くの開発者が「なぜプロバイダーを直接呼ばないのか」と尋ねました。スレッドでの正直な答えは、技術ではなく調達と予算です。あるコメント投稿者は、サービスごとにプロキシを作る代わりに、支出上限付きのCloudflareトークンを1つエージェントに渡した、と書いています。
"Instead I put my API keys to cloudflare, set limits, and gave the agent the CloudFlare token, and in minutes it could contact tens of services."
これはCloudflareのドキュメントとも一致します。ゲートウェイごとに、モデル、プロバイダー、カスタムメタデータ単位で設定できる支出上限があります。すでにCloudflareに支払っているチームなら、検索の追加は新規ベンダー審査ではなく予算の1項目で済みます。そうでなければ、ExaやFirecrawlのようなスクレイパーとの直接連携も同じくらい早いかもしれません。状況は足元でも変わっています。GoogleのCustom Search JSON APIは新規顧客の受付を終了しており、既存顧客は2027年1月1日までに移行する必要があります。
サポートエージェントに向く場面と向かない場面
先に私の偏りを述べます。私はSEOに2年携わってきましたが、そこで最初に学ぶのは、検索意図がすべてを決めるということです。顧客が「30日過ぎても返品できますか?」と聞くとき、インターネットに聞いているのではありません。あなたに聞いています。正しい情報源は、「30日 返品ポリシー」の上位10件ではなく、自社の返品ポリシーです。
これが重要なのは、身近で見た失敗があるからです。eeselの有料顧客のボットが、ナレッジベースの検索結果が空だったときに、実際の顧客に作り話で答えたことがありました。ある返信では、元素の周期表から「Oxygen」を引っ張ってきていました。解決策は検索を増やすことではありませんでした。厳格なフォールバックです。自社の情報源に何もないときは、モデルが手当たり次第に隙間を埋めるのではなく、人間に引き継ぎます。汎用のウェブ検索APIはこの隙間を小さくするどころか大きくします。モデルが自信満々に間違えられる材料が、インターネット全体に広がるからです。対処のパターンは、eeselのサポートにおけるAIハルシネーションのガイドにまとめています。
そこで、サポートでは情報源を次の順に並べます。
- ヘルプセンター、マクロ、過去のチケット。 サポート向けの検索拡張生成とは本来これを指すべきです。
- 自社サイトと製品ドキュメント(自社ドメインに限定)。
- オープンウェブは最後。 本当に社外の話題の質問向けです。運送会社のサービス障害、公的な規制、サードパーティ連携のチェンジログなどです。
Cloudflare Web Search APIは、この3番目の領域には妥当なツールです。最初の2つの代わりにはなりませんし、Cloudflareもそうは売り込んでいません。
検索APIの隣でeeselはどう位置づくか
ウェブ検索はインフラです。eeselは従業員です。Cloudflareはエージェントに調べ物の手段を与え、eeselは答えの在りかをすでに知っている、すぐ働ける同僚を提供します。AIヘルプデスクの同僚は、Zendeskなどのツールにある既存のキューに加わり、ヘルプセンターと過去のチケットから学び、返信を下書きまたは送信し、根拠のある答えがないときはエスカレーションします。現在のラインナップには、コンテンツチーム向けのAIブログライターも含まれます。

Cloudflareのチェンジログを趣味で読むようなチームなら、eesel CLIも気に入るはずです。同じ同僚をターミナルから動かせて、そこで設定したものはダッシュボードに反映されます。コマンドは「まず自社の情報源」という考え方にうまく対応しています。
npx @eesel/cli init chat-bubble --site https://your-site.comは、自社サイトの読み込みを始めるエージェントを作成します。7日間のトライアルワークスペースにはアカウントは不要です。eesel integrations connect website --url ...またはeesel integrations connect <platform>で、ヘルプデスクやドキュメントをナレッジとして追加し、eesel files upload ./refund-policy.pdfで個別のポリシーを追加します。eesel chat "what's our refund policy?"は、顧客の目に触れる前に回答をテストします。eesel approvalsは、人の承認待ちになっているアクションを一覧表示します。エージェントが行いたい書き込みは、承認されるまで待機します。
すべてのコマンドはJSONを出力し、すべてのエラーにはhintが付いて返るので、Claude CodeやCodexのようなコーディングエージェントが、セットアップ全体を実行して結果を自分で読めます。eesel mcp tokenは、ワークスペースをMCPサーバーにもします。検索にすでにCloudflareを使っているエージェントにつなぐなら、この方法をとります。カスタマーサポートのCLIで扱ったのと同じパターンで、ターミナル、スクリプト、エージェントが1人の同僚を操作します。
eeselが向かないケース:公開ウェブのデータで動く汎用のリサーチエージェントを作るなら、ヘルプデスクの同僚ではなく、Cloudflareのような検索APIが必要です。
Cloudflare Web Search APIについての私の結論
すっきりしていて、小さく、誠実な製品です。頼る前に、私ならこの3つを行います。
providerを明示的に固定する。 Ceramicを使いたい場合でもです。書き留めていないデフォルトは、28倍の請求差に気づかない誰かが変更してしまうデフォルトです。- Exaについては、ZDRの列を未確定として扱う。 チェンジログとプロバイダーページが一致するまで、そして使い続けるプロバイダーの保存に関する規約を読んでおきます。
- 結果ゼロを意図的に処理する。 モデルに即興させるのではなく、「わかりません」と返すか、引き継ぎます。これが、AIグラウンディングをAIハルシネーションに変えない唯一の習慣です。
すでにCloudflare上で構築しているなら、オープンモデルに1つの請求と1つのログでライブ検索を与える、最も簡単な方法です。顧客向けエージェントの検索を検討しているなら、まず自社のナレッジから始め、ウェブは最後の手段として加えてください。Cloudflareのエージェントスタックについては、Clefの判断モデルとKitesurfの代替のメモをご覧いただくか、より広いAI検索エンジンの世界も見てみてください。
根拠のあるサポート回答のためにeeselを試す
ウェブ検索APIを検討している理由が、サポートボットが根拠なく答えてしまうことなら、解決策はたいてい身近にあります。eeselのAIヘルプデスクの同僚は、ヘルプセンター、マクロ、過去のチケットから学び、根拠のある答えがないときはチームにエスカレーションします。実際のチケットに触れる前に、自社のナレッジベースでテストでき、プランは料金ページで確認できます。eeselを無料で試す。
よくある質問
Cloudflare Web Search APIとは何ですか?
Cloudflare Web Search APIの料金はいくらですか?
Cloudflare Web Search APIはデフォルトでどのプロバイダーを使いますか?
providerパラメーターを省略すると、すべてのリクエストがCeramicに送られます。最も安く、400億ページ以上の独自インデックスを持っています。コスト面では妥当なデフォルトですが、回答のグラウンディングに頼る前に、自分のクエリで試してください。Cloudflare Web Search APIはゼロデータ保持に対応していますか?
自分のExaまたはLinkupのAPIキーを使えますか?
byokAliasを渡します。エイリアスを指定したのに設定されていない場合、Cloudflareのクレジットから黙って課金されることはなく、リクエストは400で失敗します。Cloudflareがモデルキーに使っているのと同じ仕組みで、OpenAI APIキーの解説でも触れています。Cloudflare Web Search APIは結果を何件返しますか?
limitパラメーターは1〜10で、デフォルトは10、クエリ自体は1,024文字までです。各結果にはURLとタイトルが含まれ、プロバイダーが返す場合は説明、画像、ファビコン、最終更新日も付きます。そのためコンテキストウィンドウのコストが予測しやすくなります。Cloudflare Web Search APIはカスタマーサポートのエージェントに向いていますか?
Web Search APIは、AI Gatewayのネイティブなウェブ検索とどう違いますか?
web_search_20250305やOpenAIのweb_search_previewのように、各モデルプロバイダー独自の検索ツールをプロキシしていました。この場合、検索はモデル呼び出しの内部で実行されます。Web Search APIは別のエンドポイントで、自分で選んだプロバイダーから、自分で扱える生の結果を返します。そのため、Workers AI上のオープンモデルを含め、どのモデルでも使えます。