

La résidence des données du support IA a deux moitiés, et la plupart des éditeurs n'en promettent qu'une. Stocker vos tickets dans l'UE n'est pas la même chose que faire tourner l'IA dans l'UE. Zendesk, Freshdesk, HubSpot et Front peuvent tous héberger des données en Europe, mais chacun a des exceptions pour certaines fonctions d'IA, régions ou anciens comptes, et Help Scout et Gorgias indiquent que leurs fournisseurs d'IA sont uniquement aux États-Unis.
Le RGPD n'exige pas un stockage dans l'UE. Il exige une base légale pour chaque transfert, et le CEPD compte l'accès à distance depuis les États-Unis comme tel. Posez donc trois questions à chaque éditeur : où le ticket est stocké, où tourne le modèle, et qui peut y accéder depuis où. Prévoyez environ 10% de plus pour un traitement du modèle dans la région.
eesel stocke les espaces de travail UE en Irlande et peut faire tourner ses modèles sur AWS Bedrock dans l'UE sur demande.
Que signifie la résidence des données pour le support IA ?
Je construis des intégrations chez eesel, et dans le support IA un seul ticket est copié bien plus souvent que les acheteurs ne le pensent. Il se trouve dans votre helpdesk. Une copie va dans l'index de recherche de l'outil d'IA pour que l'agent retrouve des tickets passés similaires. Le texte est envoyé à un grand modèle de langage pour rédiger une réponse. Et des traces de tout cela atterrissent dans les journaux et les sauvegardes. Chacune de ces étapes peut se trouver dans un pays différent.
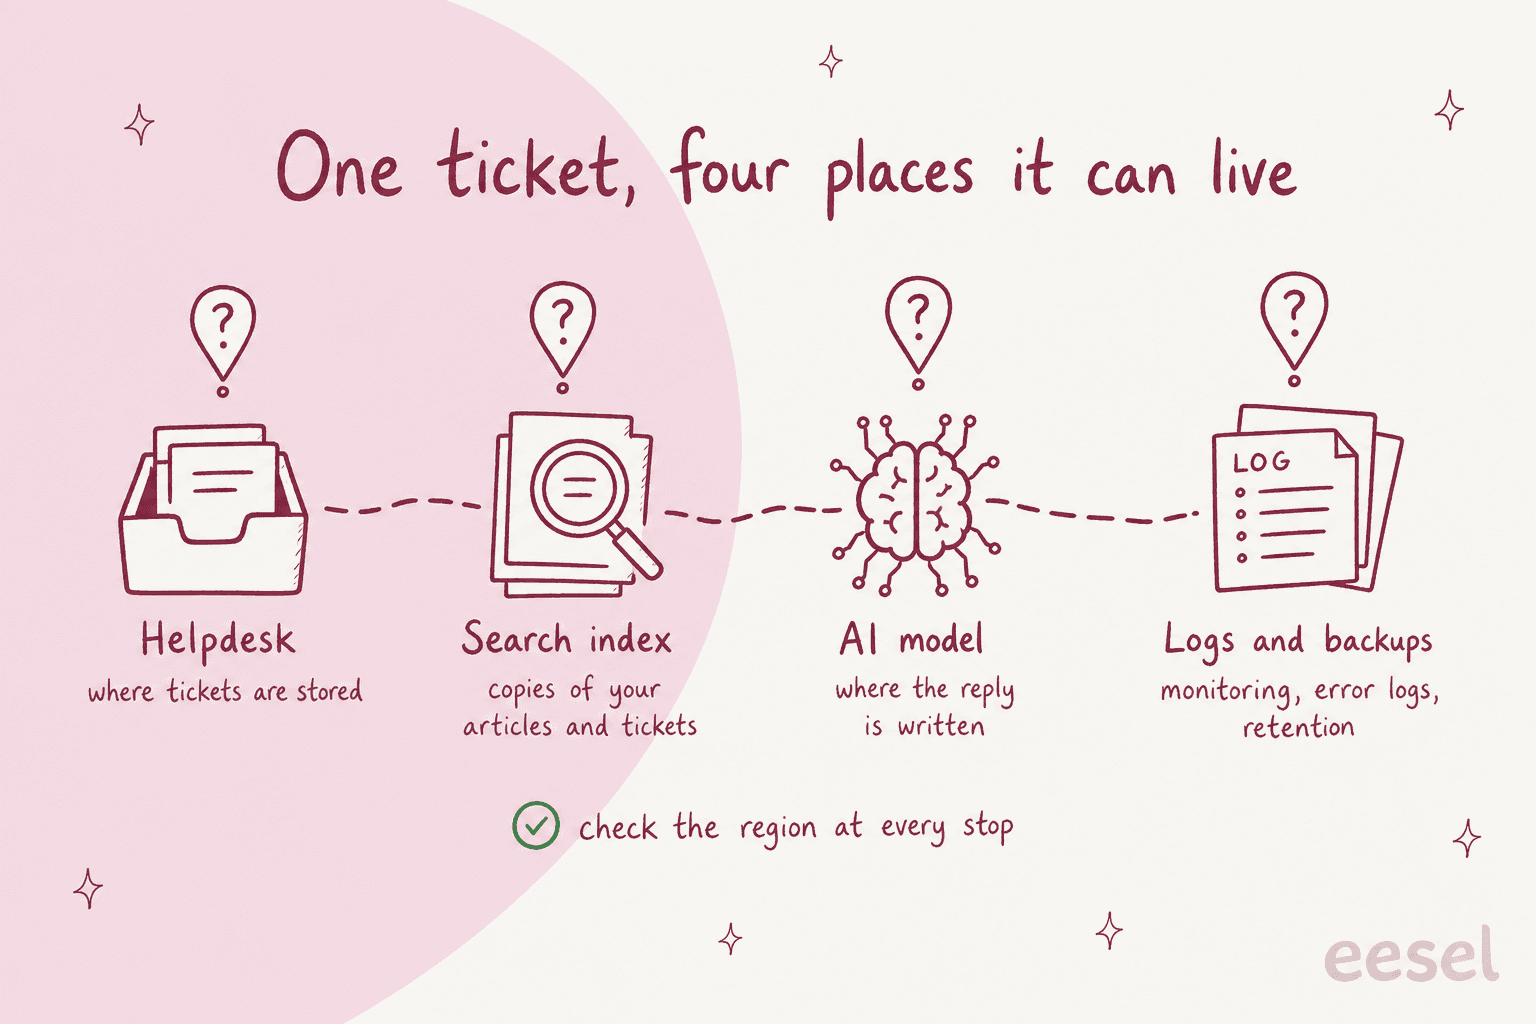
C'est pourquoi je scinde la question en deux :
- Résidence des données (stockage) : où sont conservés les tickets, pièces jointes, embeddings et sauvegardes quand rien ne se passe.
- Résidence du traitement (inférence) : où le modèle tourne réellement quand il lit un ticket et rédige une réponse.
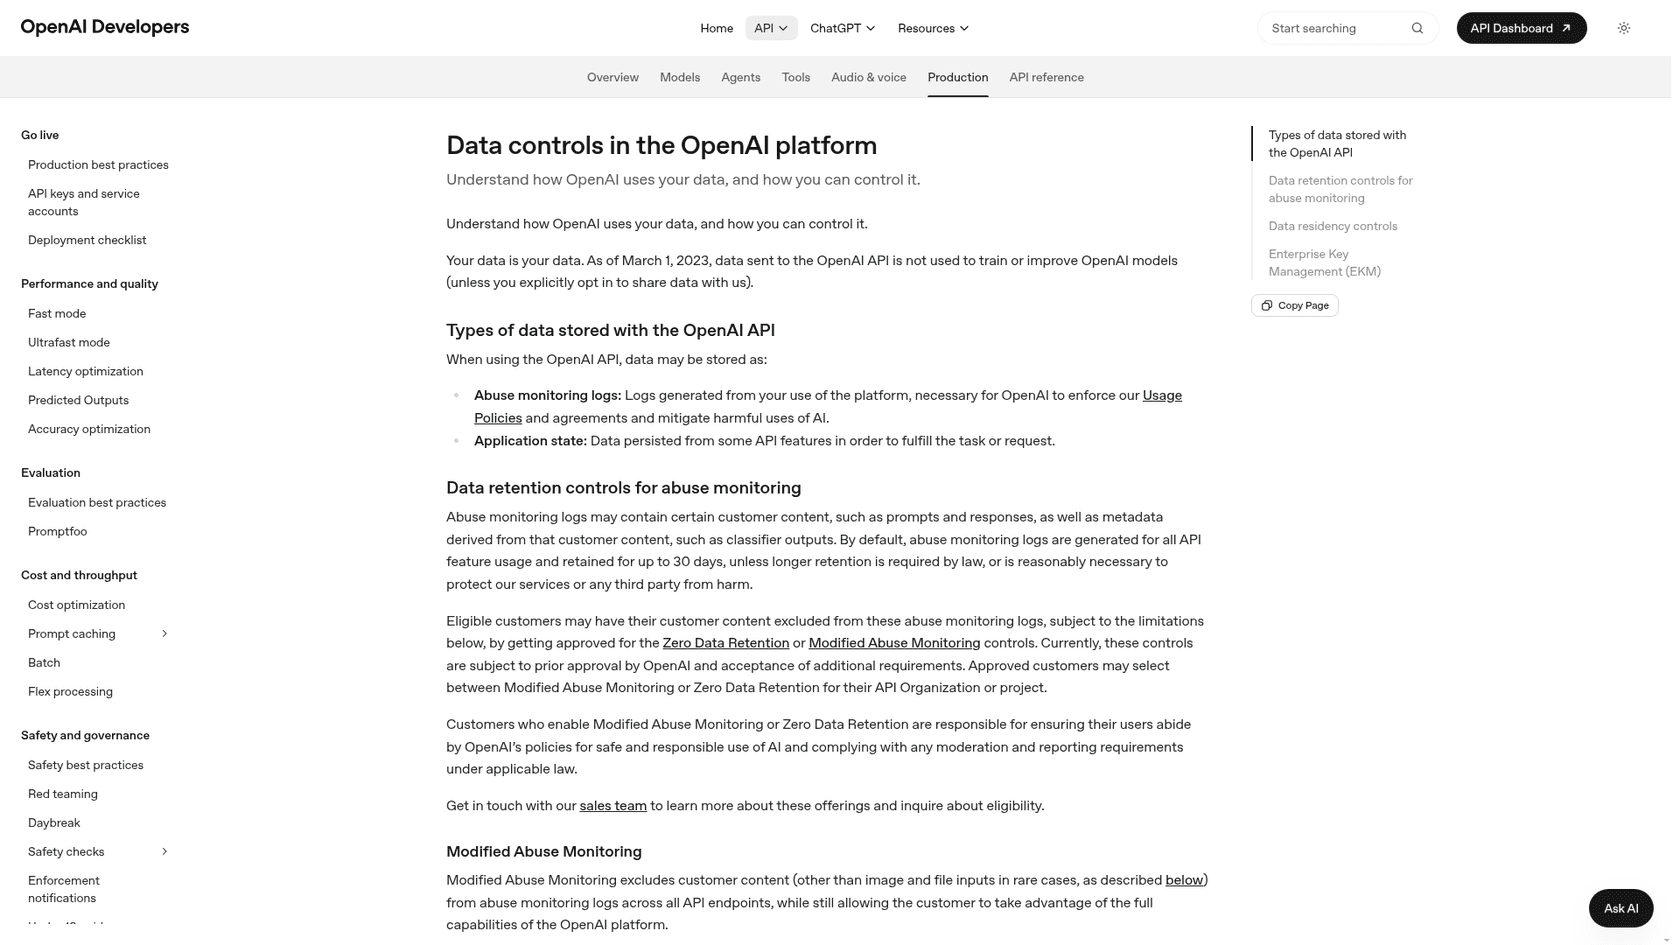
Les éditeurs sont généralement précis sur le premier point et vagues sur le second. La documentation d'OpenAI trace la ligne clairement : le contenu est "stored at rest in the selected region", et seules certaines régions font aussi l'inférence sur place. Sa documentation sur la résidence des données liste l'Australie, le Canada, le Japon, l'Inde, Singapour, la Corée du Sud et le Royaume-Uni comme régions de stockage uniquement.
Cela revient dans de vraies conversations commerciales. Une équipe danoise de télématique nous a dit que sa revue de sécurité était un passage obligé avant tout essai, et sa première question était de savoir si les données de tickets contenant numéros de carte et mots de passe restent dans son environnement. Un évaluateur dans le matériel pour semi-conducteurs voulait savoir si l'agent "uses some kind of other ChatGPT" en silence quand il ne connaît pas une réponse. Et une entreprise nordique de logiciels de conformité RH l'a dit simplement quand elle a eu ce qu'il lui fallait :
"We needed a turnkey solution for Confluence that met our GDPR requirements and could serve different teams through dedicated Slack bots. eesel AI delivered exactly that, with EU data residency included."
Flemming Ottosen, Development Director, Simployer
Si vous travaillez avec la CLI eesel, un agent de code IA comme Claude Code peut téléverser vos articles d'aide et macros approuvés, puis poser des questions de test à l'agent avant toute mise en ligne. Connecter le helpdesk lui-même demande toujours l'approbation d'une personne ayant un accès administrateur.
Le RGPD exige-t-il vraiment une résidence des données dans l'UE ?
Non, et c'est la partie que je vois le plus souvent mal comprise. Rien dans le RGPD ne dit que les données personnelles doivent être stockées dans l'UE. Ce qu'il encadre, c'est le transfert hors de l'EEE, au chapitre V. L'article 44 dit qu'un transfert ne peut avoir lieu que si les conditions du chapitre sont remplies.
Il y a deux voies courantes pour un éditeur américain :
- Décision d'adéquation (article 45). Le cadre de protection des données UE-États-Unis permet aux données de circuler vers les entreprises américaines auto-certifiées. Il ne couvre que les entreprises de la liste DPF, vérifiez donc le fournisseur d'IA et son fournisseur de modèle.
- Clauses contractuelles types (article 46). Les CCT de 2021 incluent une évaluation du transfert. La clause 14 demande de peser "the length of the processing chain" et "intended onward transfers", ce qui décrit bien une pile de support IA : helpdesk, puis fournisseur d'IA, puis fournisseur de modèle.
Le DPF est en vigueur en novembre 2026. Le Tribunal de l'UE l'a confirmé en septembre 2025 dans l'affaire Latombe c. Commission. Un pourvoi devant la Cour de justice (C-703/25 P) est toujours en cours, et les deux cadres précédents ont été invalidés dans Schrems I et II. C'est pourquoi beaucoup d'acheteurs de l'UE demandent encore des CCT ou un hébergement dans l'UE en solution de repli.
Pourquoi "hébergé dans l'UE" ne clôt pas la conversation
La phrase qui compte le plus pour les équipes support vient du CEPD. Ses lignes directrices 05/2021 disent qu'un accès à distance depuis un pays tiers "is also considered to be a transfer", même lorsqu'il s'agit seulement de "displaying personal data on a screen, for example in support situations".
Donc si vos tickets sont à Francfort mais que le fournisseur d'IA les traite en Virginie, ou que les ingénieurs américains de l'éditeur peuvent les ouvrir, c'est toujours un transfert et cela exige toujours le DPF ou les CCT. Le stockage dans l'UE réduit le problème. Il ne le supprime pas.
Si vous travaillez aussi sur le règlement européen sur l'IA, c'est un autre ensemble d'obligations. Je le couvre dans mon guide du règlement européen sur l'IA.
Et hors de l'UE ?
La plupart des autres lois sur la vie privée fonctionnent de la même façon : responsabilité sur les transferts, pas de stockage local imposé. La Chine est la principale exception.
| Juridiction | Stockage local exigé ? | Ce qui est réellement demandé |
|---|---|---|
| UE / EEE (RGPD) | Non | Un outil de transfert pour tout accès hors EEE : adéquation (DPF) ou CCT plus évaluation |
| Royaume-Uni | Non | L'extension britannique du DPF, ou les outils de transfert britanniques |
| Australie (APP 8) | Non | Des mesures raisonnables, et vous restez responsable du prestataire à l'étranger |
| Inde (DPDP Act s.16) | Non, par défaut | Transferts autorisés sauf si le gouvernement restreint un pays |
| Arabie saoudite (PDPL Art. 29) | Non, sous conditions | Protection adéquate et uniquement les données minimales nécessaires |
| Québec (Law 25 s.17) | Non | D'abord une évaluation des facteurs relatifs à la vie privée et un accord écrit |
| Chine (PIPL Art. 40) | Oui, pour les opérateurs critiques et les gros volumes | Stockage national, plus une évaluation de sécurité pour envoyer des données à l'étranger |
Que peut signifier "traitement dans l'UE" au niveau du modèle ?
Quand un éditeur dit que l'IA tourne "dans l'UE", cela peut vouloir dire trois choses. Les fournisseurs de modèles proposent tous les mêmes trois options sous des noms différents.
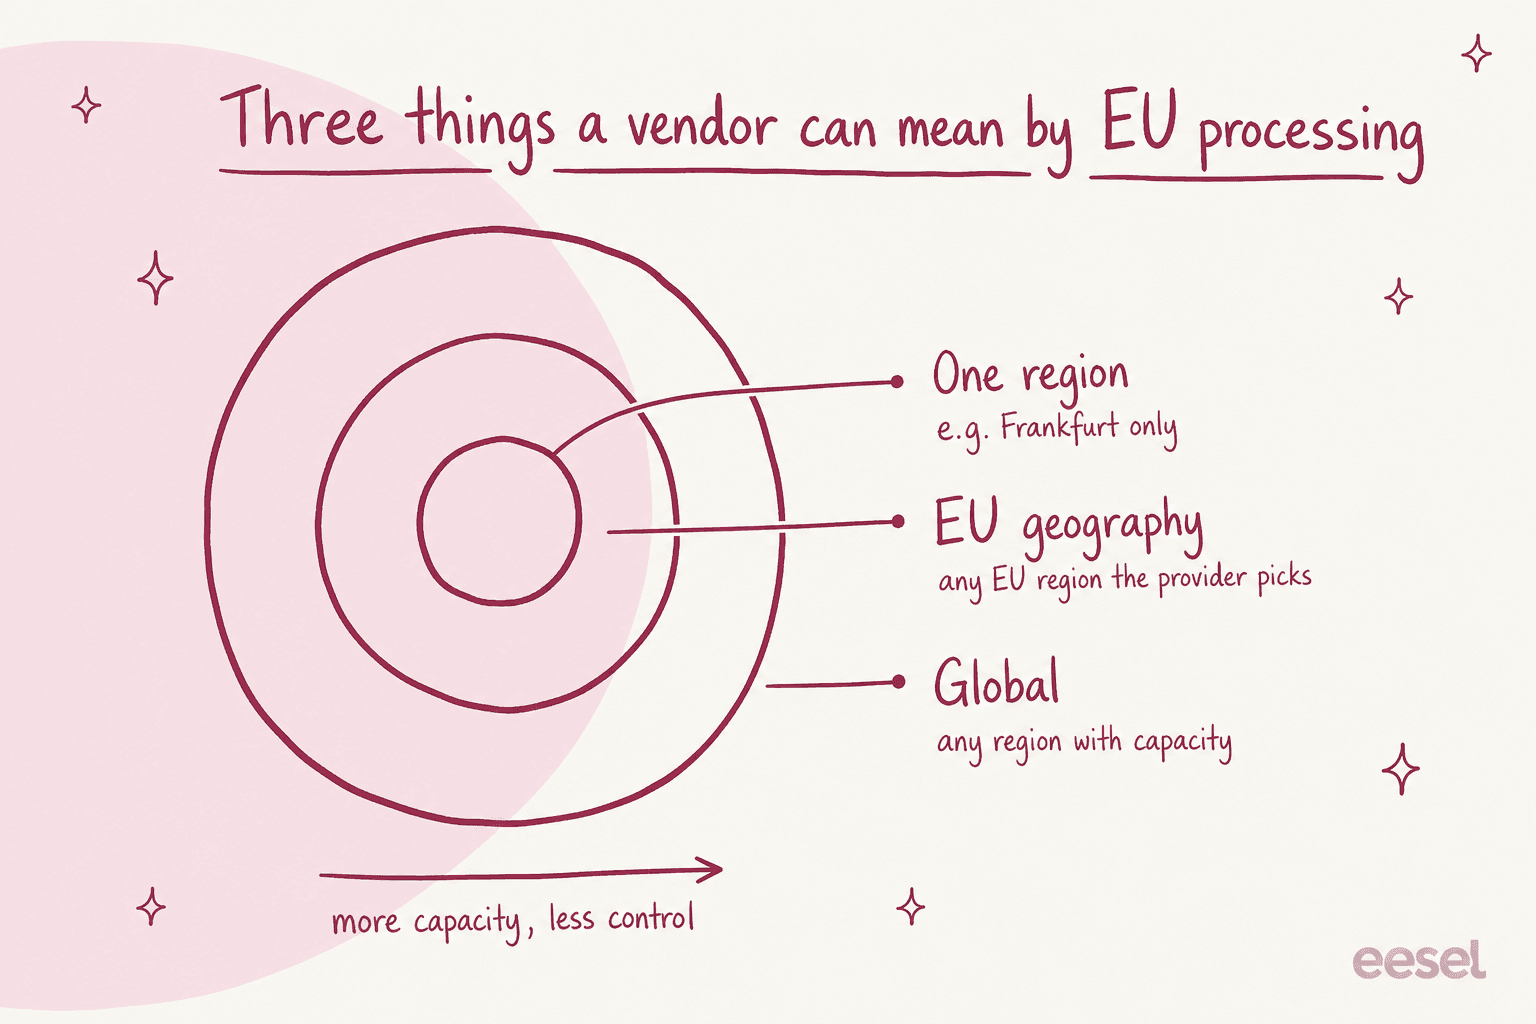
- Global. La requête va là où il y a de la capacité disponible. Google est direct : un point de terminaison global "may be processed in any Google Cloud location" et n'offre aucune garantie de résidence.
- Géographie. Le traitement reste dans une zone comme l'UE, mais le fournisseur choisit la région. La Data Zone d'Azure et les profils inter-régions
eu.de Bedrock fonctionnent ainsi. La zone UE d'Azure suit l'EU Data Boundary, qui peut inclure la Norvège et la Suisse, et Microsoft "can add regions to either data zone without prior notice". - Région unique. Une région nommée, comme Francfort. C'est le plus de contrôle, mais les nouveaux modèles y arrivent en dernier. Microsoft dit que les déploiements basés sur la géographie "have no guaranteed availability date".
Voici comment se situent les principaux fournisseurs en novembre 2026 :
| Fournisseur | Option UE | Prix vs global | Piège |
|---|---|---|---|
| API OpenAI | eu.api.openai.com, stockage et inférence dans la région | +10% sur les modèles sortis à partir du 5 mars 2026 | Nécessite une approbation pour les contrôles de surveillance des abus et un avenant Modified Retention. Les données de compte et d'usage restent hors périmètre |
| Azure OpenAI | EU Data Zone ou région unique | +10% (GPT-6.1 Sol entrée $2.00 à $2.20) | Batch est un type global et peut traiter n'importe où |
| API Claude (directe) | Aucune aujourd'hui : seulement us ou global | US seul : 1.1x | Données stockées uniquement aux États-Unis |
| Claude sur Bedrock ou Vertex | Régional UE ou multi-région eu | +10% | Les régions uniques de Vertex ne servent que Sonnet 4.6 et antérieurs |
| AWS Bedrock | Profil géographique eu. | Prix standard (global environ 10% moins cher) | Les prompts peuvent passer d'une région UE à l'autre |
| Google Vertex (Gemini) | Multi-région UE ou région d'un pays | +10% (Gemini 4 Argon entrée $2.00 à $2.20) | Journaux de search grounding conservés jusqu'à 3 jours sans interrupteur |

L'écart de prix est constant : environ 10 % sur le prix catalogue chez chaque fournisseur qui propose l'option. Sur une pile de support, c'est généralement faible à côté des licences du helpdesk, mais c'est réel, et c'est une raison pour laquelle un éditeur peut discrètement choisir le routage global par défaut.
Pour une comparaison plus large de ces API de modèles, voir OpenAI vs Anthropic vs Gemini.
Quelle IA de helpdesk garde les données dans la région ?
J'ai parcouru les pages de résidence et les listes de sous-traitants de chaque éditeur. Tous les helpdesks ci-dessous, sauf Help Scout, peuvent stocker des données en Europe. Que l'IA suive dépend de l'éditeur, de la région et parfois de la date de création de votre compte.
| Helpdesk | Régions de stockage | Résidence sur quel plan | L'IA reste-t-elle dans la région ? | Fournisseurs de modèles cités |
|---|---|---|---|---|
| Zendesk | États-Unis, EEE, Royaume-Uni, Japon, Australie | Gratuit à partir de Suite Professional, à activer | En grande partie. Les LLM sont en rétention zéro, mais la transcription vocale est US uniquement et les anciens comptes d'agents IA sont EEE ou US seulement | OpenAI, Google Gemini, ElevenLabs, plus Bedrock, Azure, Groq, Fireworks, Baseten |
| Freshdesk | États-Unis, EEE, EAU, Inde, Australie | Choisi à l'inscription | Oui pour les États-Unis et l'UE par défaut. Certaines fonctions Inde, Australie et Moyen-Orient utilisent un traitement aux États-Unis | Azure OpenAI |
| HubSpot | États-Unis, UE (Allemagne), Canada, Australie | Tout niveau payant peut changer | Oui pour l'UE. L'IA du Canada et de l'Australie tourne aux États-Unis, et la recherche web IA est américaine dans toutes les régions | OpenAI, Google, AWS, Baseten |
| Front | États-Unis ou EEE | Demandez à votre commercial | En partie. L'IA d'Azure, AWS et Google peut tourner dans l'UE ; OpenAI en direct est listé comme US | OpenAI, Azure OpenAI, Mistral sur AWS |
| Gorgias | États-Unis, UE, Australie (selon l'emplacement) | Attribué automatiquement | Non précisé. OpenAI et Anthropic sont listés comme sous-traitants américains | OpenAI, Anthropic, modèles maison |
| Help Scout | États-Unis uniquement | Aucune option | Non | OpenAI, plus Anthropic et Google listés |
| Salesforce | 18 pays Hyperforce | EU Operating Zone est un module payant | Route vers la région la plus proche, mais bascule par défaut vers d'autres régions | OpenAI / Azure, Claude sur Bedrock, Gemini, Amazon Nova |
Choisissez votre helpdesk ci-dessous pour voir le piège qui compte le plus pour lui.
Où l'IA de mon helpdesk tourne-t-elle réellement ?
Choisissez votre helpdesk. Les faits proviennent des pages de résidence et de sous-traitants de chaque éditeur, vérifiées en novembre 2026.
Le piège : le module de localisation n'est pas activé automatiquement, les comptes d'agents IA créés avant le 10 mars 2026 ne prennent en charge que l'hébergement EEE (Belgique) ou États-Unis, et la transcription vocale en temps réel tourne aux États-Unis. Demandez : "Le module est-il actif sur notre compte, et quelles fonctions d'IA sont hors périmètre ?"
Le piège : pour les comptes d'Inde, d'Australie et du Moyen-Orient, certaines fonctions Freddy traitent aux États-Unis, et ces fonctions sont désactivées par défaut. Refuser l'entraînement des modèles passe par un e-mail au support. Demandez : "Quelles fonctions Freddy sont désactivées pour notre région, et avons-nous refusé l'entraînement ?"
Le piège : les centres de données du Canada et de l'Australie envoient le traitement IA aux États-Unis, et les outils de recherche web derrière HubSpot AI tournent aux États-Unis dans toutes les régions, y compris l'UE. Demandez : "Pouvons-nous désactiver la recherche web IA sur notre compte ?"
Le piège : l'IA d'Azure, AWS et Google peut tourner dans l'UE pour les comptes EEE, mais OpenAI en direct est listé comme US, et Front ne dit pas quelles fonctions utilisent quoi. Les sauvegardes et les journaux peuvent être traités hors des États-Unis et de l'EEE. Demandez : "Quelles fonctions d'IA appellent OpenAI directement pour un compte EEE ?"
Le piège : la liste des sous-traitants montre OpenAI et Anthropic aux États-Unis uniquement, et Gorgias dit que AI Agent apprend des interactions entre marques, avec des garde-fous. Demandez : "Où tournent les appels de modèle de AI Agent pour une boutique hébergée dans l'UE ?"
Le piège : il n'y a pas d'hébergement régional, et les données d'AI Assist peuvent être conservées par OpenAI jusqu'à 30 jours. Les équipes UE s'appuient sur des outils de transfert, pas sur la résidence. Demandez : "Quel mécanisme de transfert couvre nos données et vos fournisseurs d'IA ?"
Le piège : si une requête échoue dans votre région, elle est redirigée vers une autre région par défaut. Vous devez activer les requêtes uniquement dans la région, et la route OpenAI peut basculer vers Azure aux États-Unis. Demandez : "La bascule entre régions est-elle désactivée sur notre organisation ?"
Zendesk : gratuit, mais il faut l'activer
Le module Data Center Location de Zendesk est "free of charge for Zendesk Suite Professional or higher plans, but it is not automatically activated". Tant qu'il n'est pas activé, Zendesk dit pouvoir déplacer les données du compte "between regions without notice". Côté IA, Zendesk affirme que les fournisseurs de modèles ne conservent rien : "all processing occurs with zero data retention", et qu'il a été "one of the first companies to access OpenAI's European endpoints".
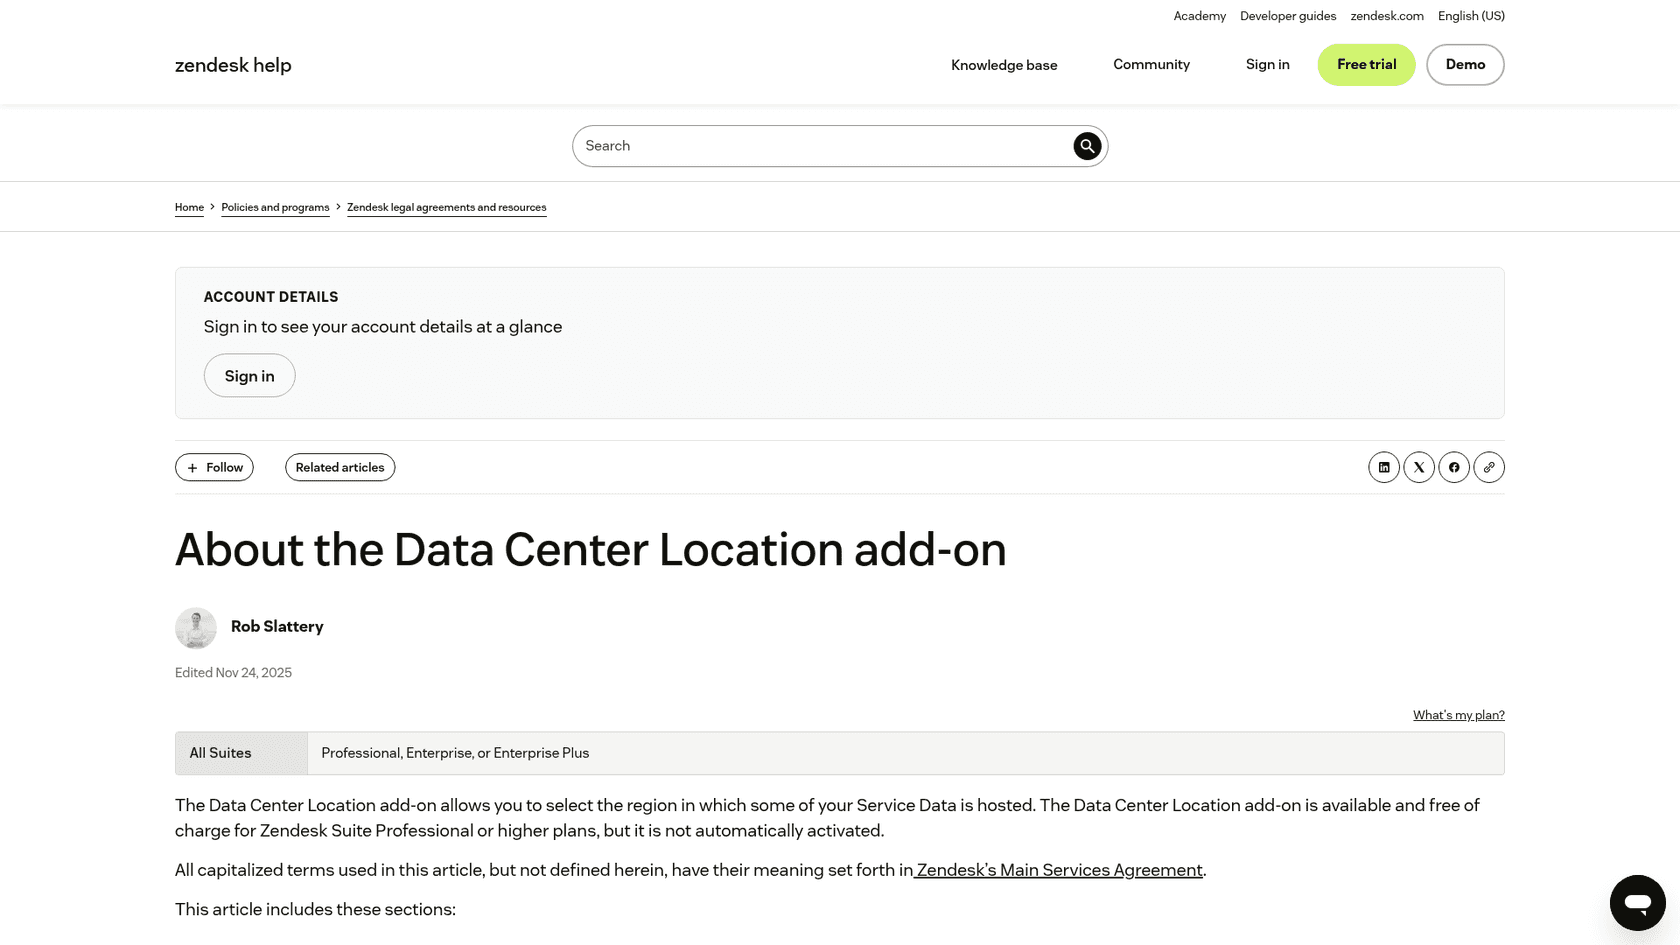
Les exceptions figurent dans la politique d'hébergement régional : les comptes d'agents IA créés avant le 10 mars 2026 ne prennent en charge que l'hébergement EEE (Belgique) ou États-Unis, et Forethought AI Agents n'est pas couvert. Plus de détails dans mon article sur la confidentialité des données de Zendesk AI.
Freshdesk : dans la région par défaut, avec des exceptions selon la région
Freshworks dit que les données de Freddy AI Copilot sont par défaut "processed and stored within your local data centers", et que les fonctions nécessitant un traitement hors région sont désactivées par défaut. Les exceptions sont les comptes d'Inde, d'Australie et du Moyen-Orient. Si vous évaluez Freddy AI pour une équipe UE, la résidence est l'un de ses points forts, puisque Freddy tourne sur Azure OpenAI.
HubSpot : le tableau le plus clair de tous
HubSpot publie une colonne par centre de données montrant où chaque fournisseur d'IA traite les données. Pour les comptes UE, OpenAI tourne dans l'"European Economic Area and Switzerland". Pour le Canada et l'Australie, ce sont les États-Unis.
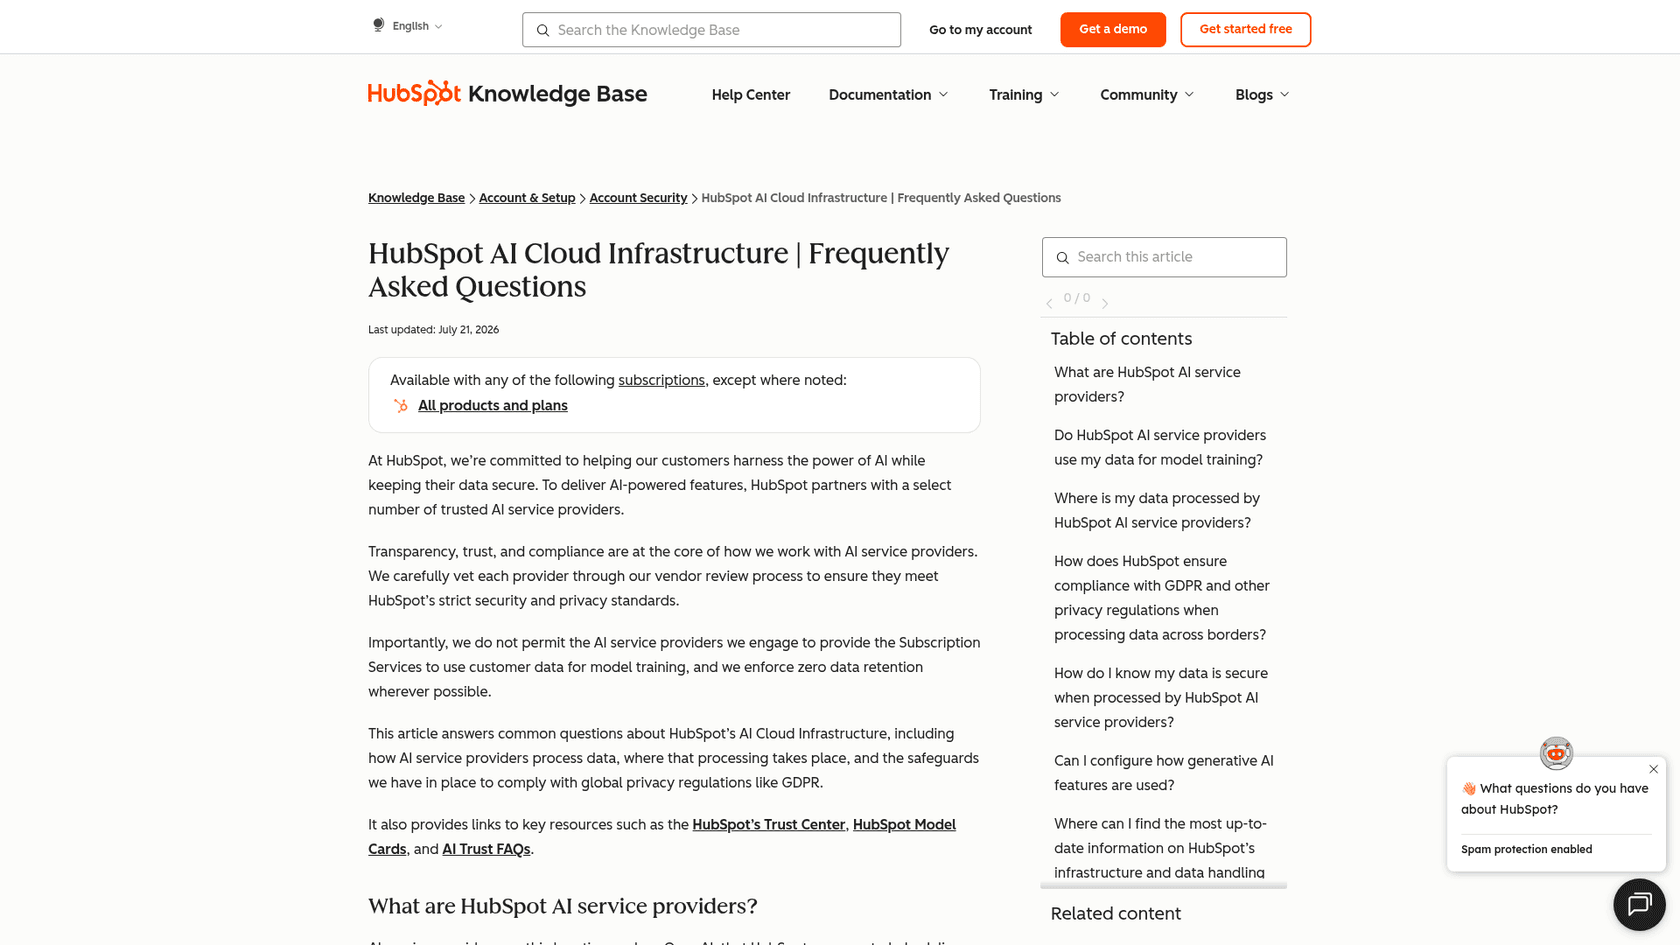
Les outils de recherche web que HubSpot AI utilise (Bright Data et Exa) tournent aux États-Unis dans tous les centres de données, selon sa page des sous-traitants. Si cela compte pour vous, vérifiez si vous pouvez désactiver la recherche web IA. Mon article sur les alternatives IA à HubSpot Service Hub couvre le reste de la pile d'IA.
Help Scout et Gorgias : pas de promesse d'IA dans la région
Help Scout est hébergé "on AWS servers in the United States", sans option UE, et les données d'AI Assist "will be stored by OpenAI for up to 30 days". Gorgias héberge les boutiques UE dans l'UE, mais liste ses fournisseurs d'IA comme uniquement américains. Cela ne les exclut pas pour les équipes UE. Elles s'appuient sur des outils de transfert plutôt que sur la résidence. Si la résidence est une exigence ferme, voyez les alternatives IA à Help Scout ou les tarifs de Gorgias AI Agent pour le coût du changement.
Quelles lacunes les éditeurs laissent-ils hors du titre ?
La page de résidence couvre en général le stockage des tickets. Voici les éléments qui se trouvent souvent en dehors, tous tirés des petites lignes des éditeurs :
- Routage de repli. Salesforce redirige une requête échouée "to another region to avoid returning an error" sauf si vous activez les requêtes uniquement dans la région. C'est un choix par défaut raisonnable pour la disponibilité, et une surprise pour un audit de résidence.
- Données système et de compte. OpenAI dit que la résidence "does not apply to system data", ce qui couvre les métadonnées, l'usage et la facturation.
- Journaux et sauvegardes. La politique de Front dit que les sauvegardes et journaux "may be otherwise processed outside of the EEA and the US".
- Fonctions de modules complémentaires. La transcription vocale de Zendesk est US uniquement, la recherche web IA de HubSpot est US uniquement, et Google conserve les journaux de search grounding jusqu'à trois jours.
- Ancienneté du compte. Les agents IA de Zendesk et l'IA générative de Salesforce traitent les anciens comptes différemment des nouveaux.
Rien de tout cela n'est caché. Ce n'est simplement pas sur la diapositive commerciale. La checklist de sécurité des éditeurs de support IA propose une liste plus large, et la rédaction des données personnelles réduit ce qui est exposé si quelque chose quitte la région.
Que demander à un éditeur de support IA ?
Envoyez ces questions avant la démo, pas après. Un éditeur qui connaît sa propre pile y répond en cinq minutes.
- Où sont stockés les tickets, les pièces jointes et l'index de recherche ? Demandez la région, pas "l'UE".
- Où tourne le modèle, et quel fournisseur le fait tourner ? Demandez s'il est global, une géographie ou une région unique.
- Une requête peut-elle basculer vers une autre région ? Si oui, demandez comment le désactiver.
- Quelles fonctions sont exclues ? Voix, recherche web, analytique et notation de la qualité sont les plus courantes.
- Où vont les journaux et les sauvegardes, et pour combien de temps ?
- Qui peut accéder aux données depuis l'extérieur de la région ? D'après les lignes directrices du CEPD, les ingénieurs du support comptent.
- Le modèle est-il entraîné sur nos tickets ? Obtenez le "non" dans l'accord de traitement des données, pas dans un blog.
Si vous menez un processus formel, mon modèle d'appel d'offres pour le support IA en fait des questions notées, et mener une revue de sécurité précise qui est responsable de chaque étape.
Pour les équipes très réglementées, l'IA pour les secteurs réglementés et l'IA conforme HIPAA vont plus loin.
Comment eesel gère-t-il la résidence des données ?
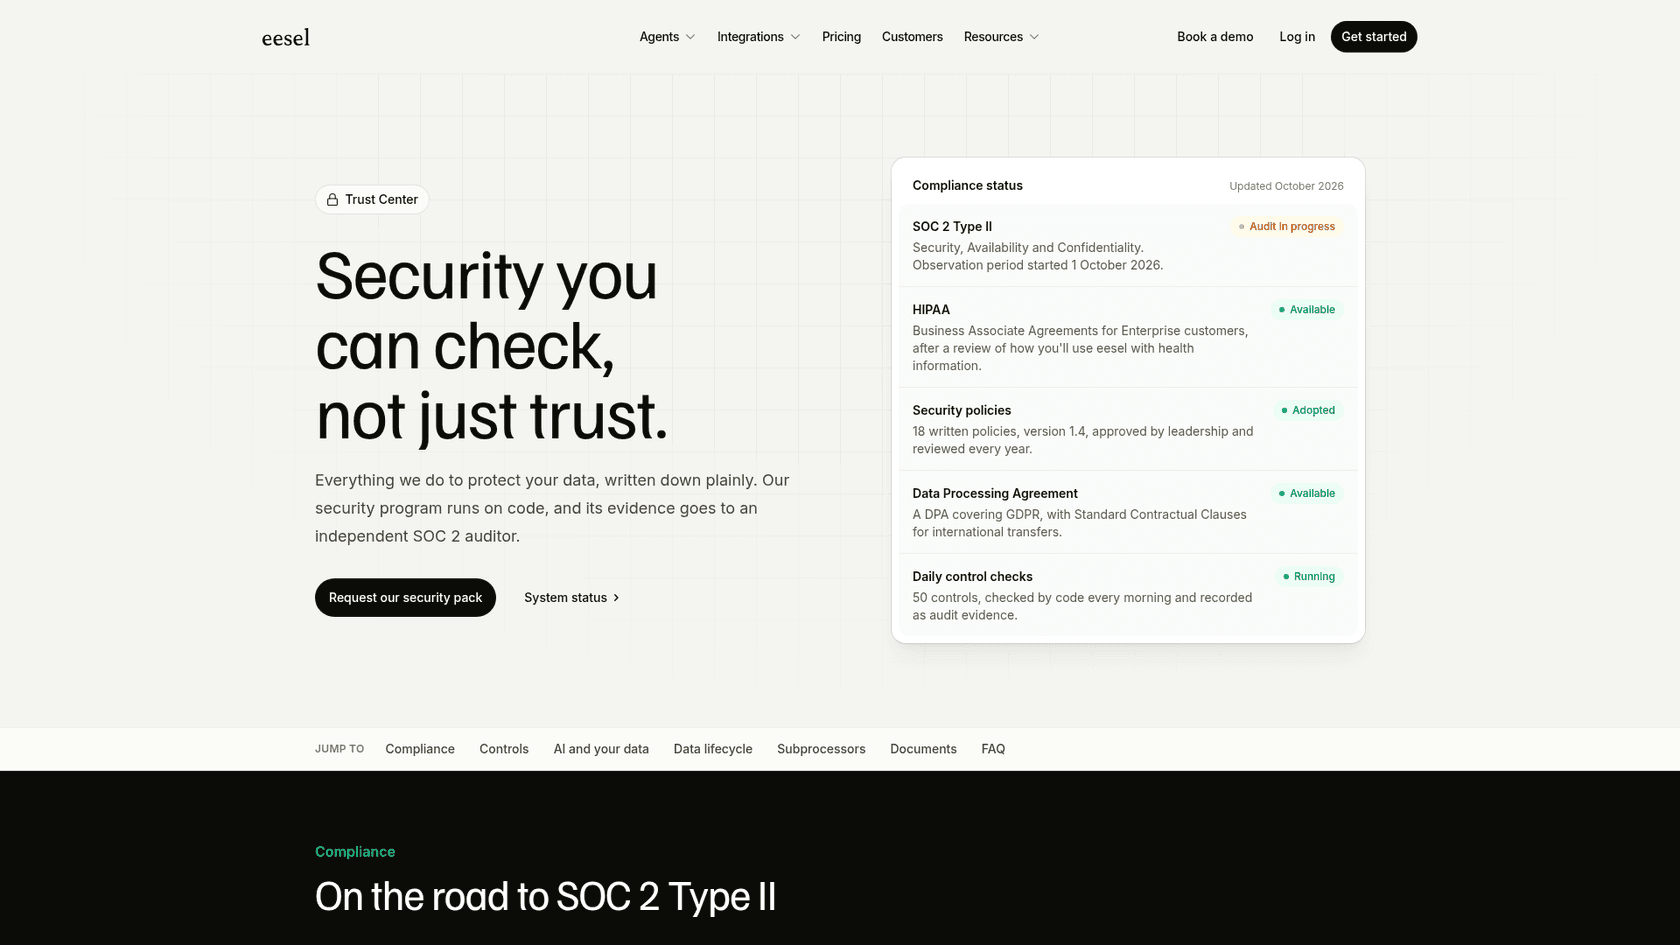
Je préfère vous montrer la configuration d'eesel avec la même honnêteté que celle appliquée à tous les autres, la voici donc, depuis notre centre de confiance et notre liste de sous-traitants :
- Par défaut : la production tourne sur AWS aux États-Unis (N. Virginia).
- Espaces de travail UE : stockés sur AWS en Irlande, avec l'index de recherche dans l'UE sur Pinecone. La page des tarifs liste "EU or US data residency" sur les plans Free et Teammate.
- Traitement IA dans l'UE : par défaut, les appels de modèle vont aux fournisseurs de la liste des sous-traitants, basés aux États-Unis. Pour garder le traitement IA dans l'UE, l'option Bedrock exécute chaque appel de modèle sur AWS Bedrock dans le propre compte AWS d'eesel, dans des régions UE sur demande. C'est la même configuration que celle de nos espaces de travail HIPAA, et les outils comme la recherche web qui enverraient du contenu ailleurs sont désactivés.
- Ce qui reste à l'extérieur : les bacs à sable des agents sont hébergés par Vercel aux États-Unis, même avec l'option Bedrock. C'est sur la page des sous-traitants, et je préfère que vous le lisiez d'abord ici.
- Entraînement et conservation : eesel n'entraîne ni n'affine de modèles sur vos données. Les sauvegardes sont chiffrées et expirent dans les 35 jours suivant la suppression d'un espace de travail.
Beaucoup de nos clients sont des équipes européennes qui répondent dans leur propre langue. smava à Berlin traite environ 27,000 tickets de prêt Zendesk par mois, triés et rédigés en allemand. Timengo, qui édite un logiciel de messagerie sécurisée au Danemark, rédige des réponses en danois à partir d'environ 5,300 anciens tickets et articles. Dokument 24 reçoit un brouillon en danois et une étiquette produit sur chaque nouveau ticket Zendesk.
Si vous comparez des outils pour ce type d'équipe, la meilleure IA pour le support multilingue est une bonne lecture suivante.
L'audit SOC 2 Type II d'eesel est en cours, avec une période d'observation courant jusqu'au 31 décembre 2026. Si un rapport finalisé est une exigence ferme aujourd'hui, c'est une raison légitime d'attendre.
Essayez eesel sur un espace de travail UE
Si votre équipe soutient des clients européens et a besoin que l'IA reste aussi en Europe, eesel est un coéquipier IA pour helpdesk qui rejoint votre file Zendesk, Freshdesk ou Gorgias existante et rédige des réponses à partir de vos anciens tickets et de votre centre d'aide.
Configurez l'espace de travail dans l'UE, demandez le traitement de modèle dans l'UE avec l'option Bedrock, et lancez une simulation sur vos propres tickets résolus avant que quiconque signe un accord de traitement des données. Vous recevez d'emblée notre liste complète de sous-traitants avec leurs emplacements, pour que votre équipe vie privée puisse vérifier chaque étape sur la carte. Le plan Teammate démarre à $299 par mois pour 500 crédits, et le plan entreprise ajoute une résidence des données sur mesure et un BAA. Essayer eesel.