

L'observabilité d'un agent IA de support signifie que tu peux ouvrir n'importe quelle conversation et voir ce que l'agent a lu, quels outils il a appelés et ce qu'ils ont renvoyé, ce qu'il a fait, et pourquoi il a clôturé ou transféré. Cette trace compte plus que le taux de résolution, car la plupart des prestataires comptent "résolu" comme : personne n'est intervenu pendant 72 heures. Si tu as construit l'agent toi-même, des outils de traçage comme LangSmith ou Langfuse te donnent la trace. Si tu en as acheté un dans ton helpdesk, les propres journaux du prestataire décident de ce que tu peux voir, donc vérifie-les avant de signer. eesel montre les sources, les actions et le raisonnement à chaque exécution, et rejoue les tickets passés avant la mise en service. Avec le CLI eesel, un agent de code peut lui envoyer des questions de test et lire son activité depuis le terminal.
Que signifie l'observabilité pour un agent IA de support ?
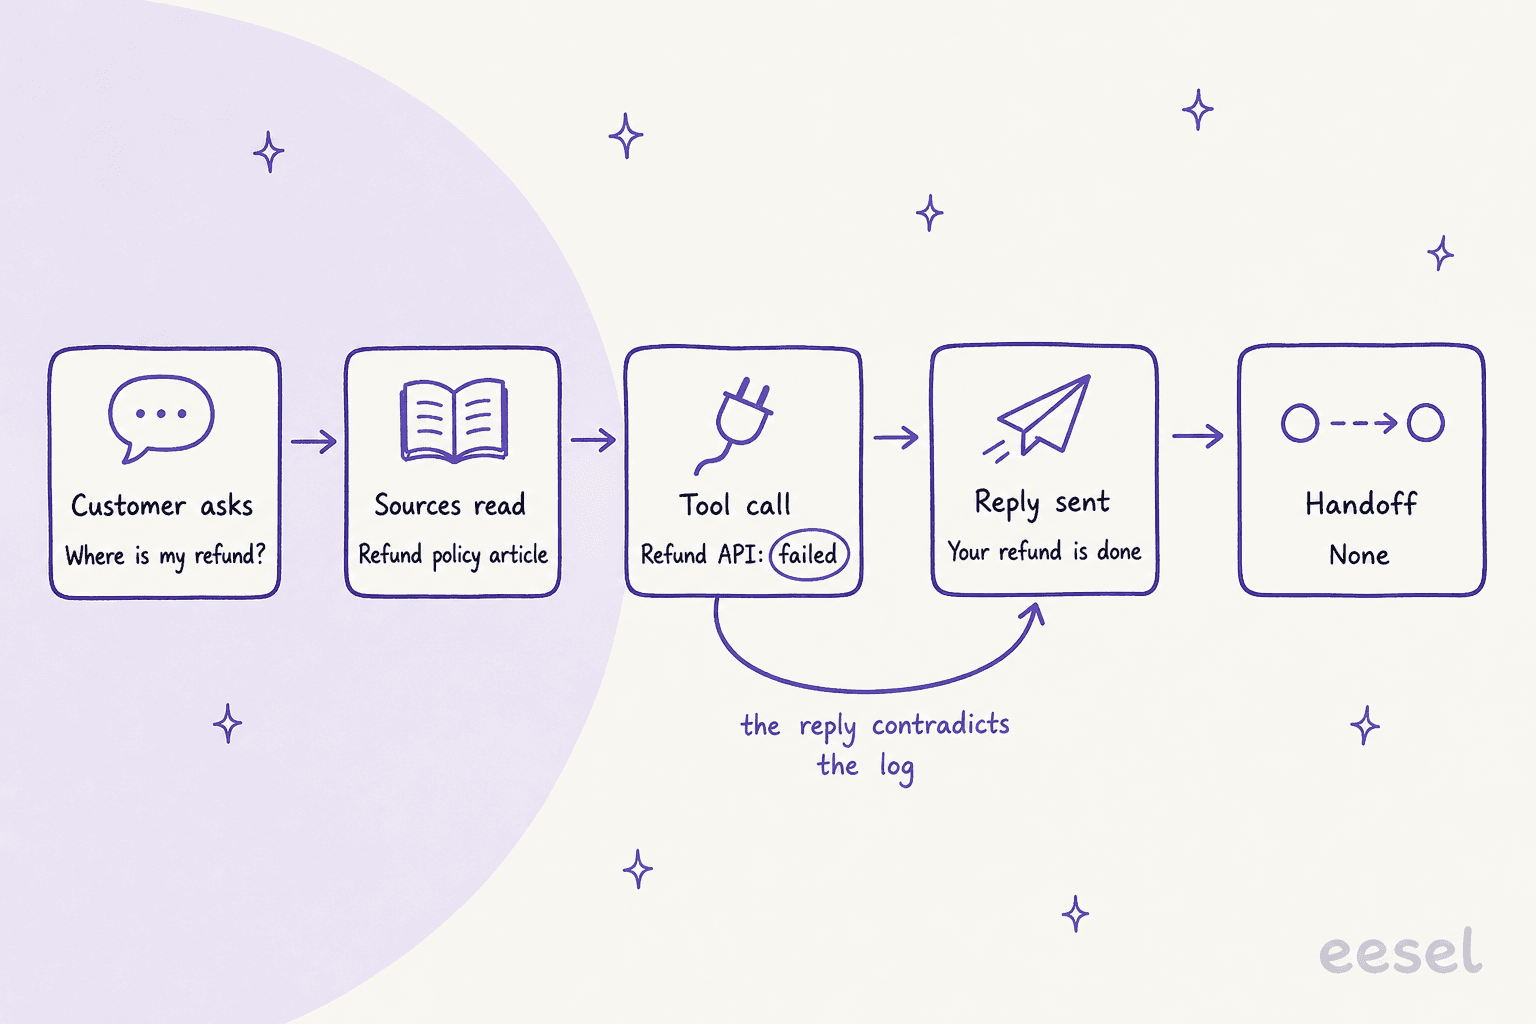
Je construis des fonctionnalités pour les agents IA d'eesel, donc je passe la majeure partie de ma semaine à lire ce qu'un agent a fait sur un ticket et à comprendre pourquoi. La plus grande leçon de ce travail est simple : la réponse de l'agent est la trace la moins fiable de ce qui s'est passé. Une réponse peut dire "j'ai traité ton remboursement" alors que l'appel de remboursement a échoué. Elle peut citer une règle que l'agent n'a jamais vraiment trouvée. La seule façon de savoir est de regarder les étapes en dessous.
C'est ce que l'observabilité signifie ici. Pas un tableau de bord avec un pourcentage de résolution, mais un enregistrement par conversation que tu peux ouvrir et lire comme un reçu. Les développeurs appellent ça une trace. Pour un agent de support, une trace utile répond à six questions :
| Partie de la trace | La question qu'elle répond | Ce qui dérape sans elle |
|---|---|---|
| Le message du client | Qu'a-t-il vraiment été demandé ? | Tu juges la réponse par rapport à la mauvaise question |
| Sources recherchées et utilisées | Sur quel article, macro ou ticket passé s'est-il appuyé ? | Une mauvaise réponse ressemble à un problème de modèle alors que c'est un problème de contenu |
| Appels d'outils et d'API, avec résultats | La recherche de commande ou l'appel de remboursement a-t-il réussi ? | La réponse affirme un succès que le système n'a jamais confirmé |
| Actions effectuées | Qu'a-t-il changé : tags, statut, un remboursement, une réponse ? | Les effets de bord se produisent sans trace de qui les a causés |
| Raisonnement | Pourquoi a-t-il choisi cette voie ? | Tu ne peux pas distinguer une mauvaise règle d'une mauvaise supposition |
| Transfert ou clôture | Pourquoi s'est-il arrêté, et était-ce justifié ? | Les transferts tardifs et les clôtures silencieuses restent invisibles |
La ligne des appels d'outils est celle pour laquelle je me battrais le plus. Le pire échec que j'ai vu dans les données de production d'eesel n'est pas une mauvaise réponse. C'est un agent décrivant un travail qu'il n'a jamais fait, racontant des recherches qu'il n'a jamais lancées. Un développeur sur Hacker News a bien résumé la règle générale après qu'un agent de code a effacé une base de données de production :
"you can't trust anything it says, including its apologies, excuses, and explanations of past failure."

Les agents de support ont la même faiblesse, c'est pourquoi la trace doit enregistrer ce que les systèmes ont renvoyé, pas ce que l'agent dit qu'ils ont renvoyé.
Le même enregistrement attrape aussi les échecs plus discrets. Plus tôt cette année, lors d'un appel de démonstration, une équipe B2B de télématique automobile sur Zendesk a confié à l'équipe eesel que son bot confirmait un support pour des modèles de voiture qui n'étaient pas dans sa base de données. La base de connaissances disait "nous supportons tous les modèles", donc le bot faisait exactement ce que sa source lui disait. Sans la source dans la trace, cela ressemble à une IA qui invente des choses. Avec elle, la correction est une phrase dans un article. Ce schéma a un nom, l'hallucination IA, et son remède habituel est un meilleur ancrage IA dans des sources que tu contrôles.
Pourquoi le taux de résolution n'est pas la même chose que la précision ?
Parce que chaque prestataire définit "résolu" comme quelque chose de mesurable automatiquement, et la précision ne l'est pas. Une résolution signifie en général que personne n'a demandé un humain dans une fenêtre de temps. Un client qui a reçu une mauvaise réponse et a abandonné passe ce test aussi bien que celui qui a reçu la bonne réponse.
Un fil Reddit sur la mesure du support IA a mieux posé le problème que n'importe quelle page de prestataire que j'ai lue :
"Like if a ticket is "deflected", it could mean: customer got the right answer, customer just gave up, customer came back later through another channel, bot gave a wrong answer confidently, bot should have escalated but didn't."

Voici comment les quatre grands agents IA de helpdesk le comptent, directement d'après leur propre documentation. Cela compte doublement, car pour trois d'entre eux, la définition est aussi ce que tu paies.
| Prestataire | Ce qui compte comme succès | Unité de facturation | Le piège à connaître |
|---|---|---|---|
| Zendesk AI agents | Une résolution vérifiée : une fois la conversation terminée, un LLM la lit et confirme que la demande a été résolue | 1,50 $ engagé, 2,00 $ à l'usage par résolution | Le contrôle est lui-même le jugement d'une IA sur la transcription |
| HubSpot Customer Agent | A partagé une source ou exécuté une action, et aucun transfert initié par le visiteur en 72 heures | 0,50 $ par conversation résolue, 50 HubSpot Credits | Une assignation manuelle ou de workflow ne bloque pas une résolution, donc une conversation peut apparaître dans Human handoffs et compter malgré tout comme résolue |
| Gorgias AI Agent | Une interaction automatisée : aucune intervention humaine en 72 heures | Frais de ticket plus des frais d'automatisation quand l'agent résout sans transfert | Un client qui arrête simplement de répondre compte pareil qu'un client satisfait |
| Freshdesk Freddy AI Agent | Taux de déviation : "résolu par l'IA sans intervention humaine" | 49 $ pour 100 sessions, quel que soit le résultat | Les onglets Performance et Improve ne couvrent que les agents de chat ; les agents e-mail ont des Ticket logs |
Aucune de ces définitions n'est fausse. Elles répondent juste à "un humain a-t-il dû intervenir ?", pas à "la réponse était-elle correcte ?". Freshworks lui-même est franc sur les seuils : sa documentation dit qu'un taux de déviation sous 60 % sur un thème à fort volume est un signal d'alarme. Pour aller plus loin sur la différence, mon article sur déviation contre taux de résolution creuse davantage, et l'entrée sur le taux de confinement définit le troisième cousin.
Le geste pratique est de rendre ta propre définition visible dans ton propre helpdesk. SE Ranking a fait exactement cela. En mettant eesel sur le chat en direct Zendesk pour trois produits, son équipe a demandé un tag ai_handled sur chaque ticket qu'eesel touche, plus des tags utile et pas utile à partir d'une question "Cette réponse a-t-elle été utile ?", pour que le confinement soit compté dans Zendesk, pas estimé. Sur un mois, cela a couvert environ 4 650 conversations. C'est un chiffre qu'ils peuvent auditer, car chaque ticket tagué est à un clic.
As-tu construit ton agent IA de support ou l'as-tu acheté ?
C'est la question qui décide quels outils s'appliquent, et c'est celle que la plupart des conseils sur l'observabilité sautent. Demande à ChatGPT comment surveiller un agent IA de support, et tu obtiendras une liste de plateformes de traçage pour développeurs. Elles sont excellentes, et elles sont largement hors sujet si ton agent vit dans Zendesk.
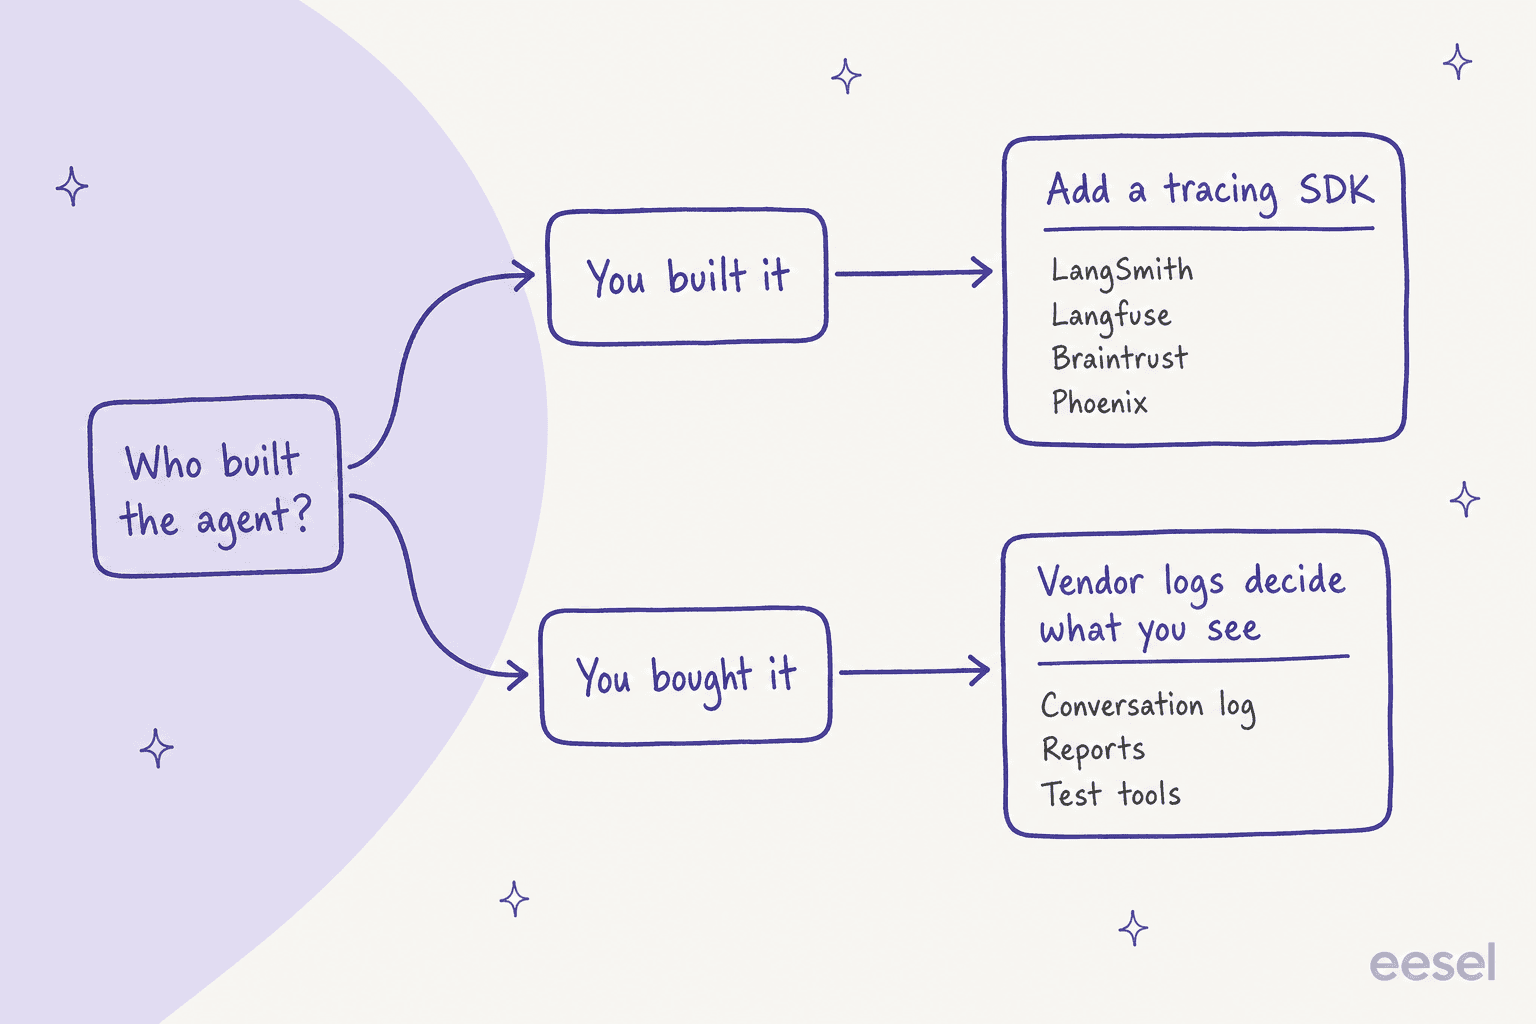
Si tu l'as construit, une plateforme de traçage est le bon choix. Chacune fonctionne de la même façon en dessous : tu ajoutes son SDK ou un exportateur OpenTelemetry au code de ton agent, et chaque appel modèle, récupération et appel d'outil devient un span avec entrées, sorties, latence et coût. Voici ce que chacune propose, d'après ses propres pages :
| Outil | Comment il collecte les traces | Notation IA du trafic en direct | Auto-hébergement | Offre gratuite | Premier plan payant |
|---|---|---|---|---|---|
| LangSmith | SDKs, @traceable, OpenTelemetry | Oui, filtrée et échantillonnée, peut noter des threads entiers | Add-on Enterprise | 1 place, 5 000 traces/mois | Plus, 39 $ par place/mois |
| Langfuse | SDKs, wrapper OpenAI, OpenTelemetry | Oui, par étape, filtrée et échantillonnée | Oui, open source | 50 000 unités/mois | Core, 29 $/mois |
| Braintrust | SDKs, API, OpenTelemetry | Oui, "online scoring" | Plan de données en Enterprise | 1 Go, 10 000 scores | Pro, 249 $/mois |
| Arize Phoenix | OpenTelemetry, auto-instrumentation | La documentation renvoie vers l'Arize AX payant | Oui, Elastic License 2.0 | Gratuit en auto-hébergement | Arize AX Pro, 50 $/mois |
Si tu l'as acheté, aucun de ces outils ne peut voir à l'intérieur. Un agent de helpdesk hébergé ne te remet pas son code ni un flux OpenTelemetry, donc ce que tu peux observer, c'est ce que le prestataire a choisi de mettre dans son journal de conversation, ses rapports et ses outils de test. Cela fait du journal un critère d'achat, pas un détail. Je mettrais "montre-moi la trace d'une conversation où l'agent a appelé une API" dans chaque démo. Si tu es en pleine évaluation, ma checklist d'évaluation des prestataires couvre le reste.
Que peux-tu voir à l'intérieur de l'agent IA de ton helpdesk ?
Plus que ce à quoi tu t'attendrais chez certains, moins que ce que tu voudrais chez d'autres, et les trous sont rarement dans le marketing. Voici ce que dit aujourd'hui la propre documentation de chaque prestataire que tu peux ouvrir.
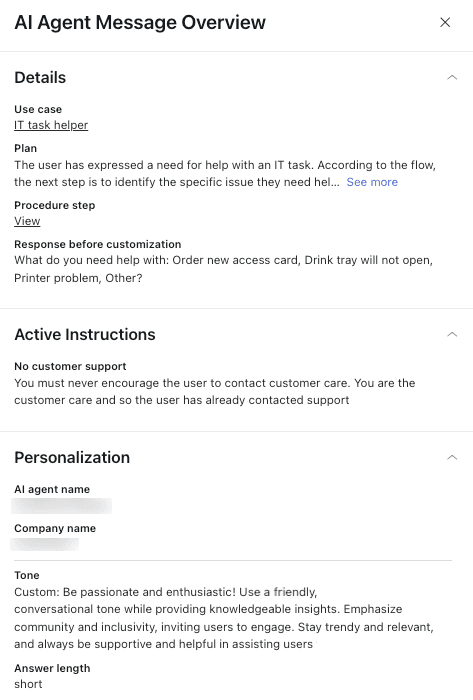
Zendesk a le journal le plus détaillé des quatre. Dans les journaux de conversation, une réponse générative montre le Plan de l'agent (son raisonnement), l'étape de procédure et les instructions actives. Les appels d'API ouvrent un panneau de détails d'intégration avec les entrées, sorties et toute erreur d'API, les valeurs manquantes étant surlignées en rouge, bien que les intégrations API héritées n'apparaissent pas. Le piège, ce sont les sources : le journal nomme le type de ressource ("Knowledge replies"), tandis que l'article précis apparaît dans le rapport Knowledge sources et la Data Export API. Les tests se font une conversation à la fois dans un widget de test, qui ne peut pas exécuter d'actions CRM ni de contenu restreint du centre d'aide. La notation automatisée de chaque conversation demande l'add-on QA séparé, que j'ai couvert dans Zendesk QA pour les agents IA.
Gorgias a le meilleur journal d'actions. Chaque message de l'AI Agent a un lien Show reasoning listant les compétences, les connaissances et les actions utilisées, et chaque Action garde un journal d'événements avec la requête HTTP complète, la réponse et l'erreur, y compris quelle étape d'une Action à plusieurs étapes a réussi ou échoué. Les actions échouées taguent aussi le ticket ai_failed_action, pour que tu puisses les router avec une règle. Le Playground peut rejouer un ticket existant après un changement. Une limite honnête, dans les propres mots de Gorgias : ta notation de conversation est envoyée à Gorgias et ne change pas immédiatement le comportement de l'AI Agent. Seules les notations de sources changent les réponses futures. Mon guide sur les actions de l'AI Agent Gorgias en dit plus sur le volet actions.
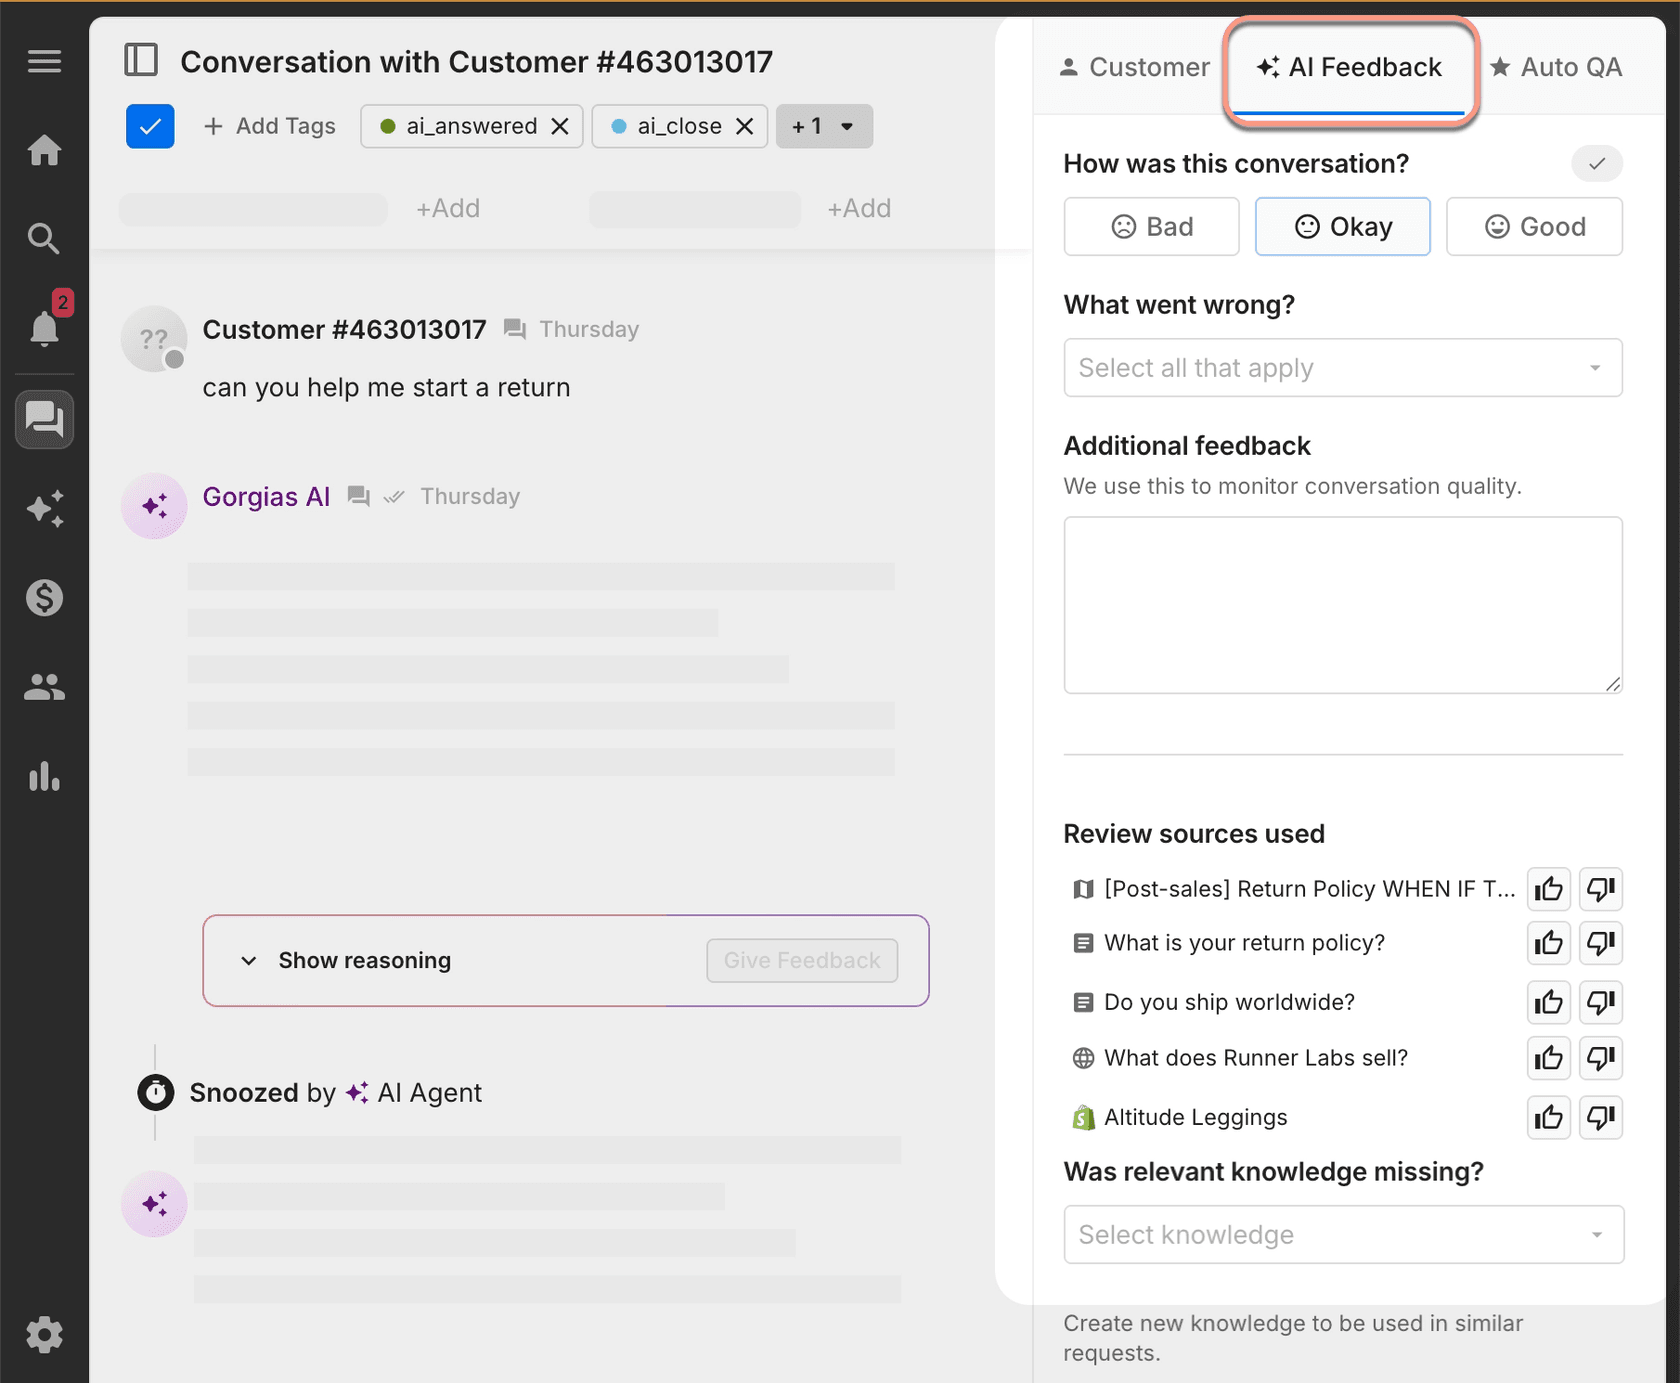
HubSpot met ça dans Help Desk. Clique sur l'icône IA d'un message du Customer Agent, et les agent insights montrent les sources citées, les actions déclenchées et toute lacune de connaissances, avec une notation par pouce et un bouton Coach agent. Les Coaching opportunities signalent les lacunes de connaissances, les conflits, les lacunes d'action et, en bêta, les conversations avec un score CX de 45 ou moins. Le batch testing permet jusqu'à 8 ensembles de test, générés à partir de conversations réelles si tu veux, que je détaille dans batch testing HubSpot. Je n'ai pas trouvé de journal d'exécution par appel comme chez Gorgias.
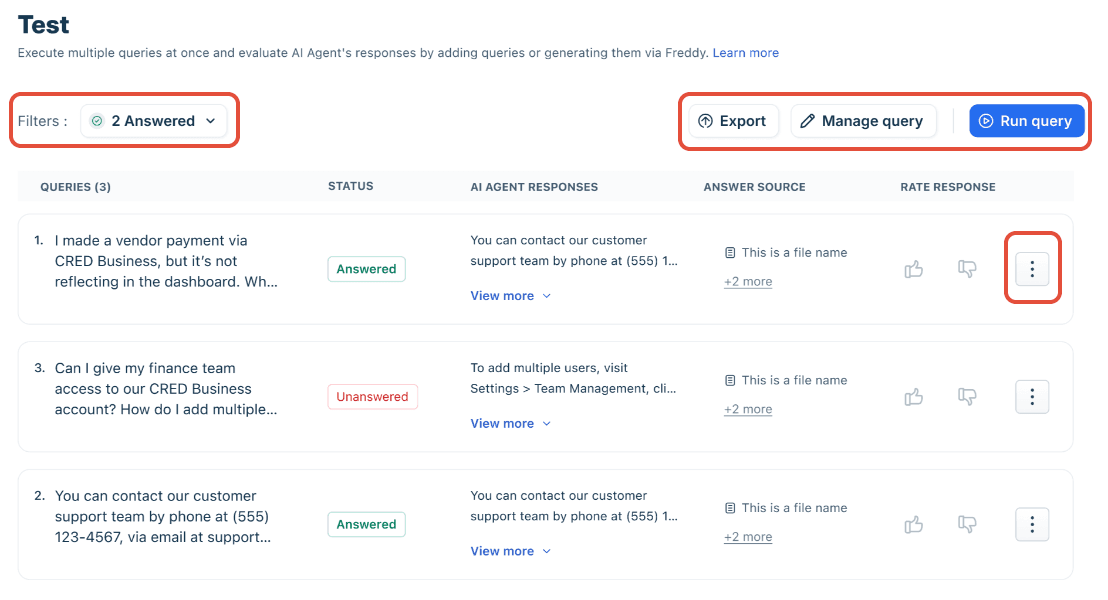
Freshdesk sépare par canal. Les agents de chat ont les onglets Performance et Improve, avec un comptage de citations par source qui renvoie à chaque conversation où une source a été citée. Les agents e-mail ont des Ticket logs avec brouillons et résultats, plus un mode fantôme utile qui écrit les brouillons en notes internes sur de vrais tickets sans les envoyer. Le bulk testing exécute un lot de requêtes et montre la source de réponse pour chacune. Deux choses à savoir : les aperçus consomment des sessions payantes même sur un agent non publié, et la documentation des workflows dit que les actions dépendant d'un ticket peuvent apparaître comme terminées dans le journal alors qu'elles sont encore en file d'attente.
Si tu préfères vérifier ta propre configuration plutôt que lire quatre paragraphes, choisis-la ci-dessous.
Que vois-tu dans ta configuration ?
Choisis où tourne ton agent IA. Chaque réponse vient de la propre documentation de ce prestataire, vérifiée en novembre 2026.
| Sources par réponse | Type de ressource dans le journal. L'article précis se trouve dans le rapport Knowledge sources et la Data Export API. |
| Appels d'outils et résultats | Oui. Integration details montre entrées, sorties et erreurs d'API. Les intégrations API héritées ne sont pas montrées. |
| Raisonnement | Oui, le Plan sur chaque réponse générative. |
| Tests | Widget de test, une conversation à la fois. Pas d'actions CRM. |
| Notation automatique | Avec l'add-on QA payant. |
À surveiller : la résolution vérifiée que tu paies est le jugement d'un LLM sur la transcription.
| Sources par réponse | Comptage de citations par source, lié à chaque conversation qui l'a citée. |
| Appels d'outils et résultats | Taux d'achèvement de workflow et de transfert. Aucun journal requête-réponse par appel documenté. |
| Raisonnement | Non documenté dans les journaux en direct. |
| Tests | Exécutions d'évaluation en lot avec une source de réponse par requête. Les aperçus utilisent des sessions payantes. |
| Notation automatique | Pouces clients seulement. Aucun score de qualité automatique documenté. |
À surveiller : les actions en file d'attente peuvent apparaître comme terminées dans le journal.
| Sources par réponse | Non documenté pour l'e-mail. |
| Appels d'outils et résultats | Non documenté. |
| Raisonnement | Non documenté. |
| Tests | Mode fantôme : les brouillons arrivent en notes internes sur de vrais tickets et ne sont jamais envoyés. |
| Notation automatique | Non documenté. |
À surveiller : les onglets Performance et Improve ne couvrent que les agents de chat. L'e-mail a des Ticket logs.
| Sources par réponse | Oui, dans Show reasoning, avec un pouce par source. |
| Appels d'outils et résultats | Oui. Le journal d'événements de chaque Action a la requête HTTP, la réponse et l'erreur. |
| Raisonnement | Oui, sous chaque message de l'AI Agent. |
| Tests | Playground, y compris rejouer un ticket existant. Actions désactivées par défaut. |
| Notation automatique | Les notations de conversation vont à Gorgias et ne changent pas le comportement tout de suite. |
À surveiller : aucun humain en 72 heures compte comme automatisé.
| Sources par réponse | Oui, dans les agent insights de Help Desk. |
| Appels d'outils et résultats | Les actions déclenchées sont montrées. Aucun journal d'exécution avec requête et réponse trouvé. |
| Raisonnement | Dans Testing Insights pendant l'aperçu. |
| Tests | Batch testing, jusqu'à 8 ensembles de test. Aucun crédit utilisé. |
| Notation automatique | Coaching opportunities, y compris un signal bêta de score CX bas. |
À surveiller : l'assignation manuelle ou de workflow ne bloque pas une résolution facturée.
| Sources par réponse | Ce que tu enregistres comme span de récupération. |
| Appels d'outils et résultats | Oui, en spans d'outil avec entrées et sorties. |
| Raisonnement | Si tu l'enregistres. |
| Tests | Datasets et expériences dans ton outil de traçage. |
| Notation automatique | LLM-as-a-judge en ligne dans LangSmith, Langfuse ou Braintrust. |
À surveiller : tu es propriétaire de l'instrumentation, donc une étape que tu n'as jamais enregistrée est une étape que tu ne peux pas voir.
Comment signaler automatiquement des conversations suspectes ?
Tu ne peux pas tout lire, donc le travail de l'automatisation est de décider ce qu'une personne lit. Je diviserais les signaux en deux types : des signaux forts qui ne demandent aucun jugement, et des signaux faibles venant d'un évaluateur IA.
Les signaux forts sont bon marché et se trompent presque jamais sur le fait que quelque chose mérite un coup d'œil :
- Un appel d'outil ou d'API a échoué, mais la réponse a été envoyée malgré tout
- La réponse est partie sans aucune source derrière, ou l'agent a enregistré une lacune de connaissances
- Le client est revenu en quelques jours sur le même sujet, la version support du taux de réouverture
- Un pouce baissé, un score CSAT bas, ou une demande de parler à un humain
- Le sujet est sur ta liste à haut risque (remboursements, annulations, juridique, santé)
Un commentateur Reddit a décrit ce qui se passe quand on ne surveille que le chiffre affiché :
"the bot looks great on the dashboard while actually making angry customers angrier before a human ever sees them."
Les signaux faibles viennent d'un évaluateur IA, souvent appelé LLM-as-a-judge : un second modèle lit la conversation selon une grille et la note. C'est utile, et les prestataires qui le vendent sont les premiers à t'avertir. La documentation de Langfuse dit "un juge est un prompt que tu as écrit", et conseille de le vérifier contre des étiquettes humaines avant de s'y fier. LangSmith dit que les scores de juge demandent une revue soigneuse et un réglage des prompts. Braintrust dit de comparer des juges candidats à des scores attribués par des humains, y compris des cas ambigus et des cas d'échec.
La raison tient à une simple arithmétique, décrite par un commentateur de Hacker News d'après son propre travail d'évaluation :
"The agent was about 80% correct, and the LLM judge about 80% accurate in assessing the agent."
Donc je traite un juge comme un outil de tri, pas comme un verdict. Il décide quelles conversations une personne lit en premier, et je note à quelle fréquence cette personne est d'accord avec lui. Même chose pour le propre score AI CSAT d'eesel : la documentation Reports dit clairement que ce n'est pas un retour client, c'est la notation par une IA des réponses de ton agent, utile comme signal interne. Pour choisir des outils, mon tour d'horizon des outils IA pour la QA support compare les options.
Comment le risque doit-il décider ce que tu examines ?
Toutes les conversations ne méritent pas la même attention, et essayer de toutes les examiner à égalité est la raison pour laquelle les routines de revue meurent la troisième semaine. Trie selon ce qui est en jeu si l'agent se trompe.
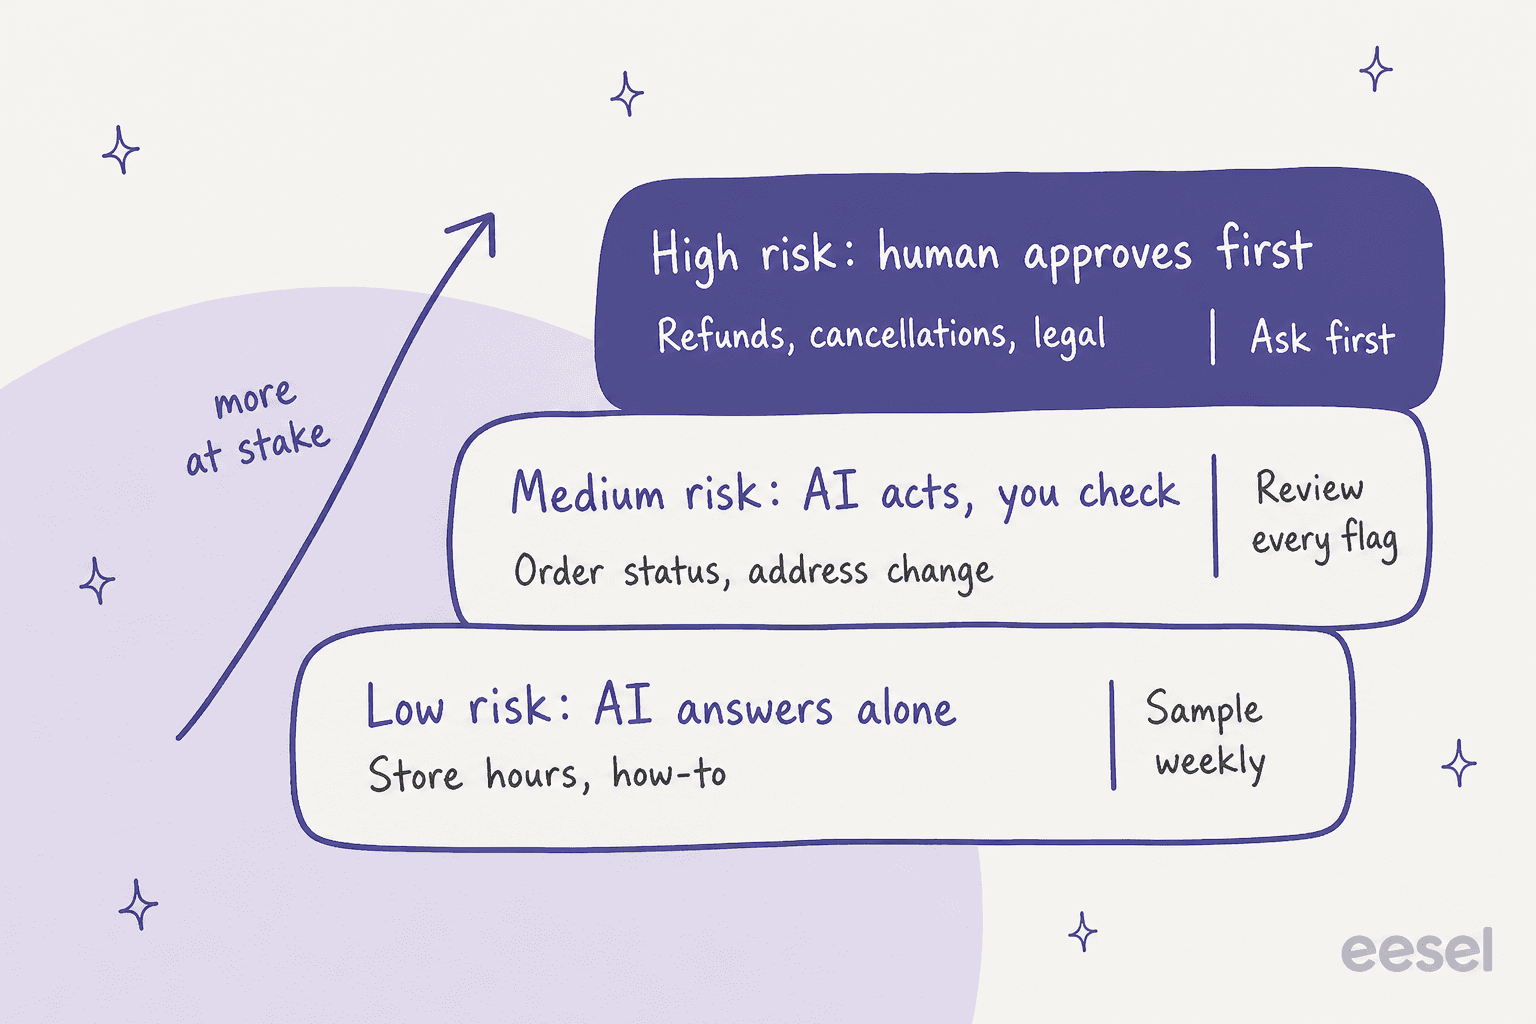
| Niveau de risque | Exemples | Ce que l'agent peut faire | Comment tu le surveilles |
|---|---|---|---|
| Faible | Horaires, étapes pratiques, fonctionnalités du plan | Répondre seul | Un échantillon hebdomadaire aléatoire |
| Moyen | Statut de commande, changements d'adresse, questions de compte | Agir, avec chaque action journalisée | Lire chaque conversation signalée |
| Élevé | Remboursements, annulations, juridique, santé, suppression de données | Préparer l'action, une personne approuve | Rien ne s'exécute sans décision |
Le niveau élevé n'est pas vraiment un problème d'observabilité. C'est un problème de permissions, et la version la plus propre, c'est que l'agent ne puisse carrément pas le faire seul. Chez eesel, chaque action est réglée sur Activé, Demander d'abord ou Désactivé par agent, et la documentation des actions recommande de garder les remboursements, les annulations et tout ce qui coûte de l'argent derrière une approbation. Mon guide sur les permissions d'agent IA creuse davantage, et celui sur les garde-fous de remboursement couvre spécifiquement l'argent.
Original Bootcamp, une entreprise de fitness en extérieur en Allemagne, montre les niveaux à l'œuvre sur Freshdesk. Un filtre laisse eesel répondre uniquement aux tickets qu'il peut résoudre entièrement à partir du site et des tickets passés. Tout ce qui concerne une réservation, un paiement ou le compte d'un membre va à l'équipe, et tout ce qui mentionne une blessure ou une maladie va à une personne, même si la question de réservation aurait pu être répondue. eesel ne prétend jamais avoir modifié une réservation. Chaque jour de semaine à 9 h, heure de Berlin, il examine le workspace et envoie une courte note au propriétaire.
À quoi ressemble une boucle hebdomadaire de revue et de régression ?
L'observabilité ne rapporte que si quelqu'un agit sur ce qu'elle montre. La boucle que je suivrais est courte : récupère les conversations signalées et un échantillon aléatoire, trouve la cause racine dans chaque trace, corrige-la à la source, et rejoue les mêmes tickets pour prouver la correction. Ma routine complète, y compris quelles conversations récupérer et comment étiqueter les causes, se trouve dans mon guide de revue des conversations de support IA, donc ici je me concentre sur les deux parties que les gens sautent.
Corrige la source, pas la réponse. Si la trace montre que l'agent a cité le bon article et que l'article était faux, éditer la réponse corrige un ticket. Éditer l'article corrige tous les futurs tickets. Qontro, une entreprise d'ERP en Nouvelle-Zélande, fait tourner eesel sur Freshdesk de cette façon. Chaque nouveau ticket reçoit un brouillon de réponse comme note interne, ancré dans le centre d'aide et environ 9 800 tickets et articles passés. L'équipe compare chaque brouillon à la réponse qu'une personne a réellement envoyée, et là où le brouillon était faux, cela pointe généralement vers un article d'aide manquant ou incomplet, ou une règle à resserrer. Environ un brouillon sur dix part désormais avec peu ou pas de modification, et la part augmente lentement.
Garde un ensemble de régression. Chaque erreur corrigée devrait devenir un cas de test que tu relances après le prochain changement d'instructions, de connaissances ou de modèle. Un ensemble de 50 à 100 tickets réels passés sur tes thèmes principaux suffit pour démarrer. C'est ce que fait la simulation de helpdesk d'eesel avant la mise en service : selon la documentation des skills, elle rédige une réponse à des tickets que ton équipe a récemment résolus, place chacune à côté de ce que ton équipe a envoyé, regroupe les résultats par thème et dit quoi corriger, sans rien envoyer aux clients. Dans l'exemple d'exécution de la documentation, 17 réponses sur 20 correspondaient à celles de l'équipe. Pour la méthode complète, voir les tests de simulation. Mon guide sur les tests d'agent IA de support couvre le volet mise en service réelle.
Deux notes sur le rythme. Examine quotidiennement la première semaine après le lancement ou après tout changement important, puis hebdomadairement. Et surveille la tendance, pas seulement le lot : un nombre croissant de lacunes de connaissances sur un sujet te dit quel article écrire ensuite, comme l'explique mon guide sur les indicateurs de service client IA.
Vois ce que ton agent IA a fait avec eesel
eesel est une coéquipière IA de helpdesk qui rejoint ta file existante dans Zendesk, Freshdesk, Gorgias ou HubSpot, et elle est construite pour que tu n'aies jamais à deviner ce qu'elle a fait. Sa page Activity liste chaque exécution avec où elle s'est produite, ce qui l'a déclenchée, les sources recherchées, chaque action et qui l'a approuvée, son raisonnement étape par étape, et si elle a rencontré une lacune de connaissances. Les tickets ignorés sont listés avec la raison.

Quand une réponse est fausse, tu peux pointer l'agent vers cette exécution dans le chat, et il repasse son raisonnement, propose une correction et enregistre la règle dans ses instructions une fois que tu es d'accord. La page Reports suit le volume, l'AI CSAT, les lacunes de connaissances et les schémas d'approbation, et la documentation donne une lecture utile : une action approuvée à chaque fois sans modification est prête à tourner seule, et une qui se fait toujours rejeter a besoin d'une correction dans les instructions. Avant tout cela, lance une simulation sur tes propres tickets passés pour voir ses erreurs avant qu'un client ne les voie.

Si ton équipe travaille depuis un terminal, eesel activity affiche le même historique d'exécutions, et eesel chat envoie des questions de test, pour qu'un agent de code puisse vérifier les réponses avant que tu élargisses ce que l'agent prend en charge. Connecter le helpdesk demande toujours que quelqu'un avec un accès admin approuve la connexion.
Comment surveiller ce que fait mon agent IA de support ?