Meta Muse pour Confluence : intégrer votre wiki à l'IA WhatsApp de Meta en 2026

Kira

Katelin Teen
Dernière modification September 29, 2026
En bref
« Meta Muse pour Confluence » signifie en réalité alimenter Meta Business Agent avec votre base de connaissances Confluence, l'IA qui répond aux clients sur WhatsApp et Messenger. Muse lui-même est un agent grand public. Business Agent n'a aucun importeur Confluence. Il apprend à partir de quatre entrées : les informations sur l'entreprise, les entrées de FAQ, les fichiers importés et les sites web publics crawlés.
Cela laisse quatre voies. Vous pouvez rendre un espace public pour que Meta le crawle (forfait Standard et supérieur, et Google l'indexe aussi), exporter des pages en PDF ou Word et les importer, réécrire des articles sous forme d'entrées de FAQ (Meta prévient que la qualité baisse au-delà de quelques centaines) ou construire un connecteur qui interroge Confluence en direct via un compte de service. Le point délicat, c'est la fraîcheur. Les fichiers importés ne se mettent jamais à jour, et la documentation de Meta avertit elle-même que l'agent citera l'ancienne et la nouvelle version si vous oubliez d'en supprimer une.
Le premier produit d'eesel était une application IA pour Confluence, j'ai donc vu beaucoup d'équipes tenter de brancher un chatbot sur un wiki. Si votre Confluence change chaque semaine, eesel lit les espaces que vous choisissez, réindexe les pages lorsque vous les modifiez et met un lien vers la page source dans chaque réponse. Personne n'a à faire tourner un script d'export.
Ce que « Meta Muse pour Confluence » signifie vraiment
Je construis des fonctionnalités d'agents pour gagner ma vie, et pourtant la nomenclature de Meta en 2026 me demande un moment pour être démêlée. Trois produits Meta portent le nom Muse ou en sont proches, et un seul parle à vos clients :
- Muse, l'agent IA personnel que Meta a lancé pour les démarches des particuliers. Il n'est pas conçu pour répondre aux clients d'une entreprise.
- Muse Spark 1.3, le modèle, vendu via la Meta Model API. Vous pourriez construire vous-même un bot Confluence dessus. Mon aperçu de Muse Spark 1.3 donne les détails du modèle.
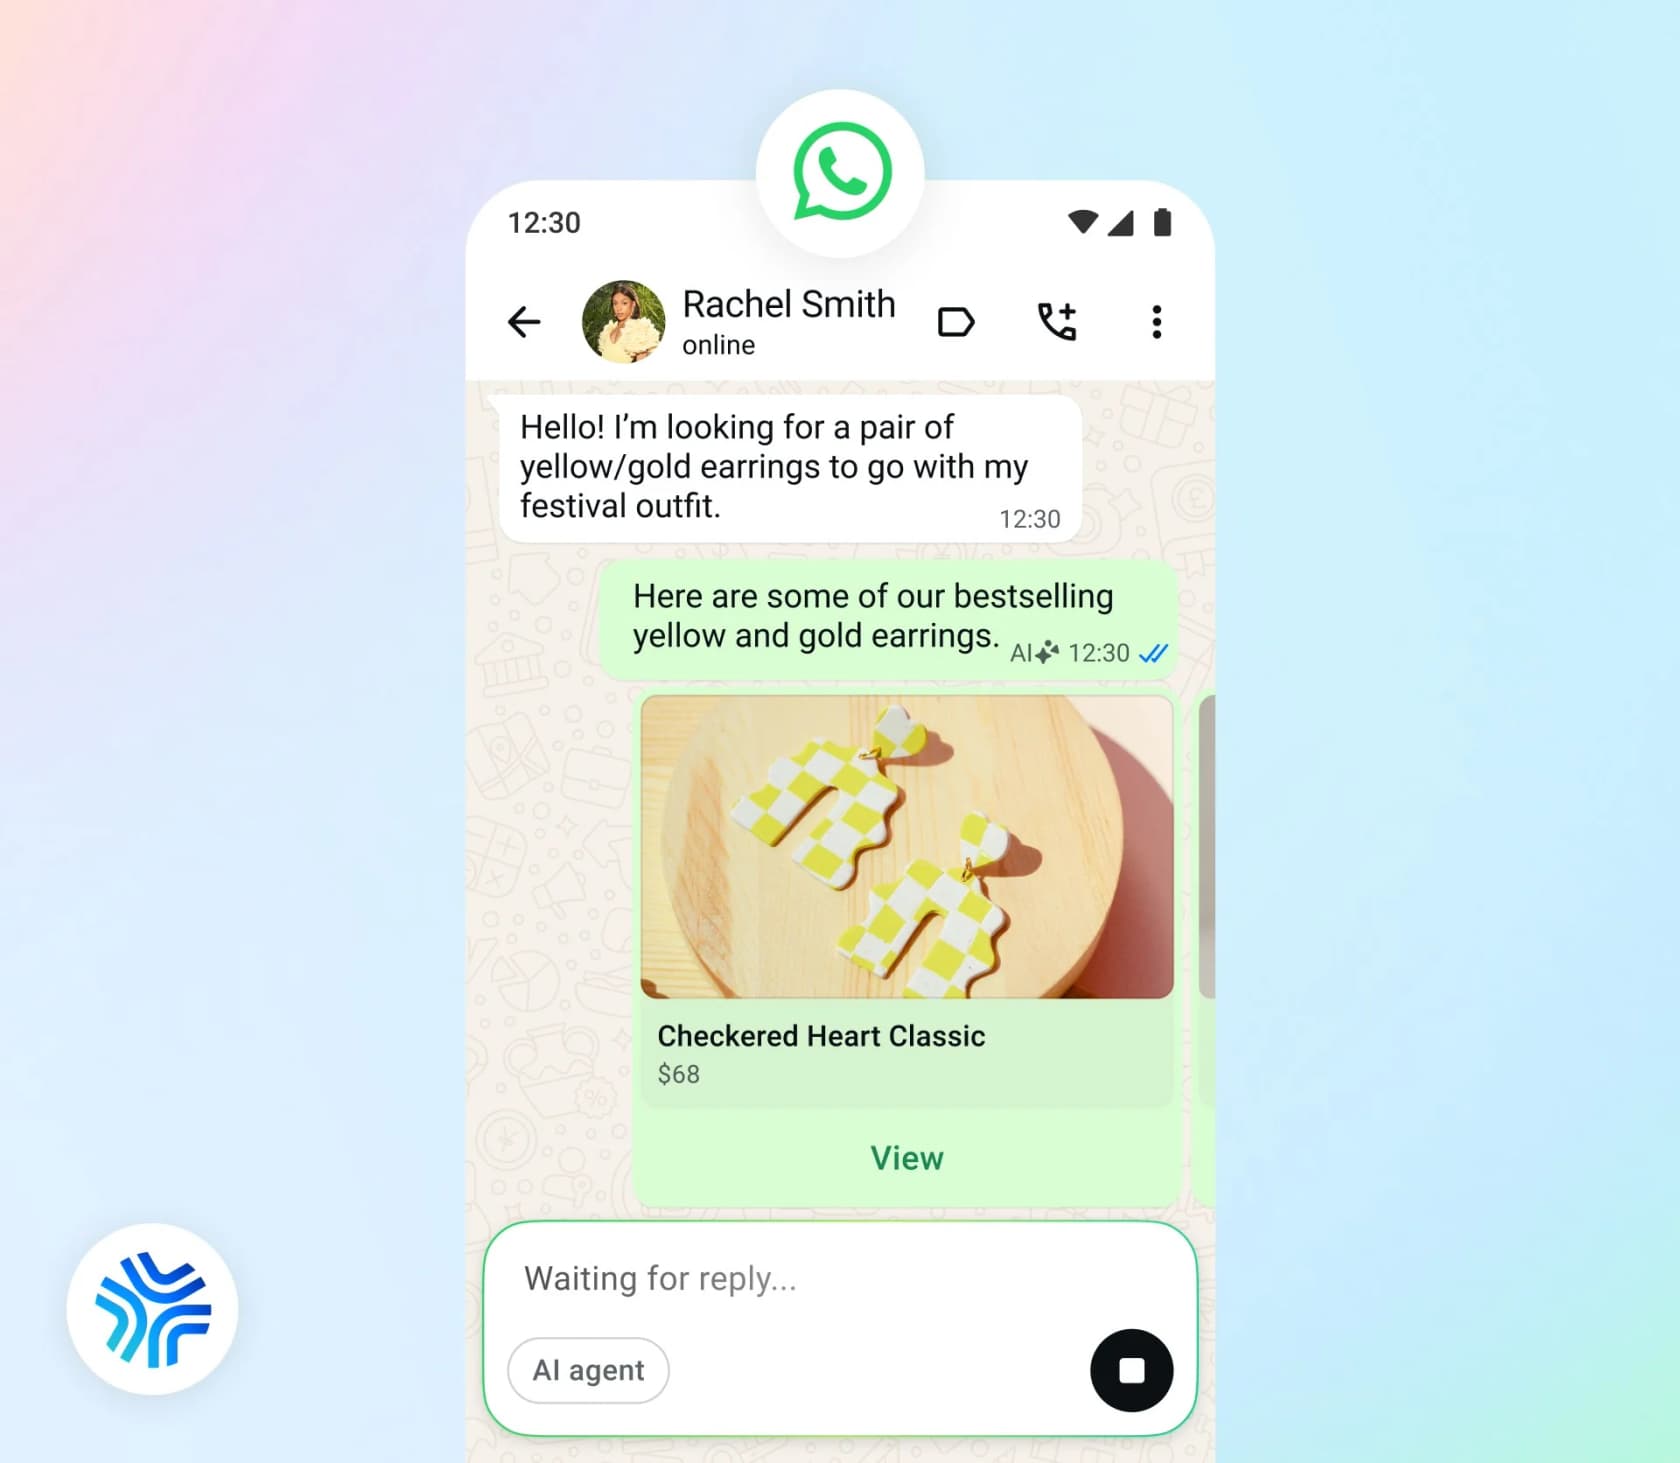
- Meta Business Agent, que Meta a lancé en juin comme l'IA qui répond aux clients sur WhatsApp, Messenger et Instagram. Meta affirme que plus d'un million d'entreprises l'utilisent déjà.
Confluence s'intègre différemment des helpdesks des articles de cette série. Zendesk, Freshdesk et Jira Service Management sont des lieux où atterrissent les conversations. Confluence est l'endroit où vivent les réponses. La question n'est donc pas de savoir comment une discussion WhatsApp atteint votre équipe, mais comment votre wiki atteint le bot.
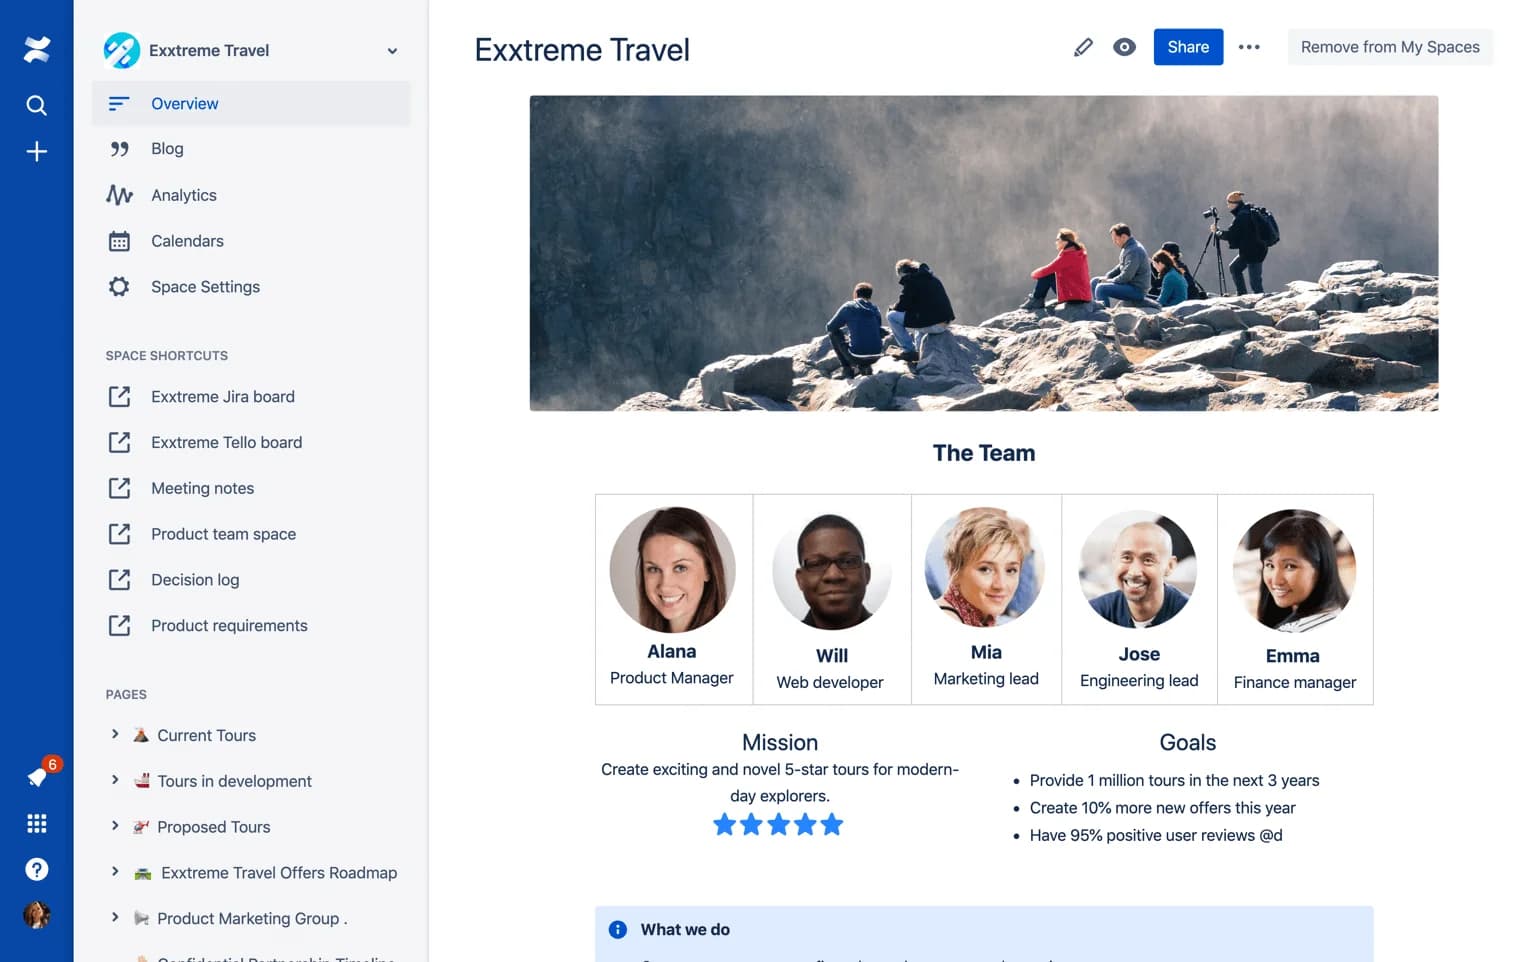
C'est aussi un problème qu'eesel connaît bien : avant le coéquipier pour helpdesk, son premier moteur de croissance était une application IA sur l'Atlassian Marketplace qui répondait aux questions à partir de Confluence. Un client que je citerais est GENERAL BYTES, un fabricant de distributeurs de Bitcoin avec plus de 12 000 machines dans plus de 60 pays. Ils ont placé une base de connaissances Confluence de 329 articles derrière un bot client sur Telegram, qui a la même forme d'application de messagerie que WhatsApp. Ce qui a fait fonctionner l'ensemble, c'est la partie que l'agent de Meta vous laisse : le bot lit les pages Confluence les plus récentes au fur et à mesure qu'elles changent.
Quatre façons de faire parvenir le contenu Confluence à l'agent de Meta
La page des capacités de Meta liste quatre sources de connaissances dans la Platform API : Business Info, FAQs, Files et Websites. Les actions et les recherches passent par des connecteurs, qui sont des intégrations HTTP ou MCP que vous définissez. Rien dans la documentation ne mentionne nommément Confluence, Notion ni aucun autre wiki.
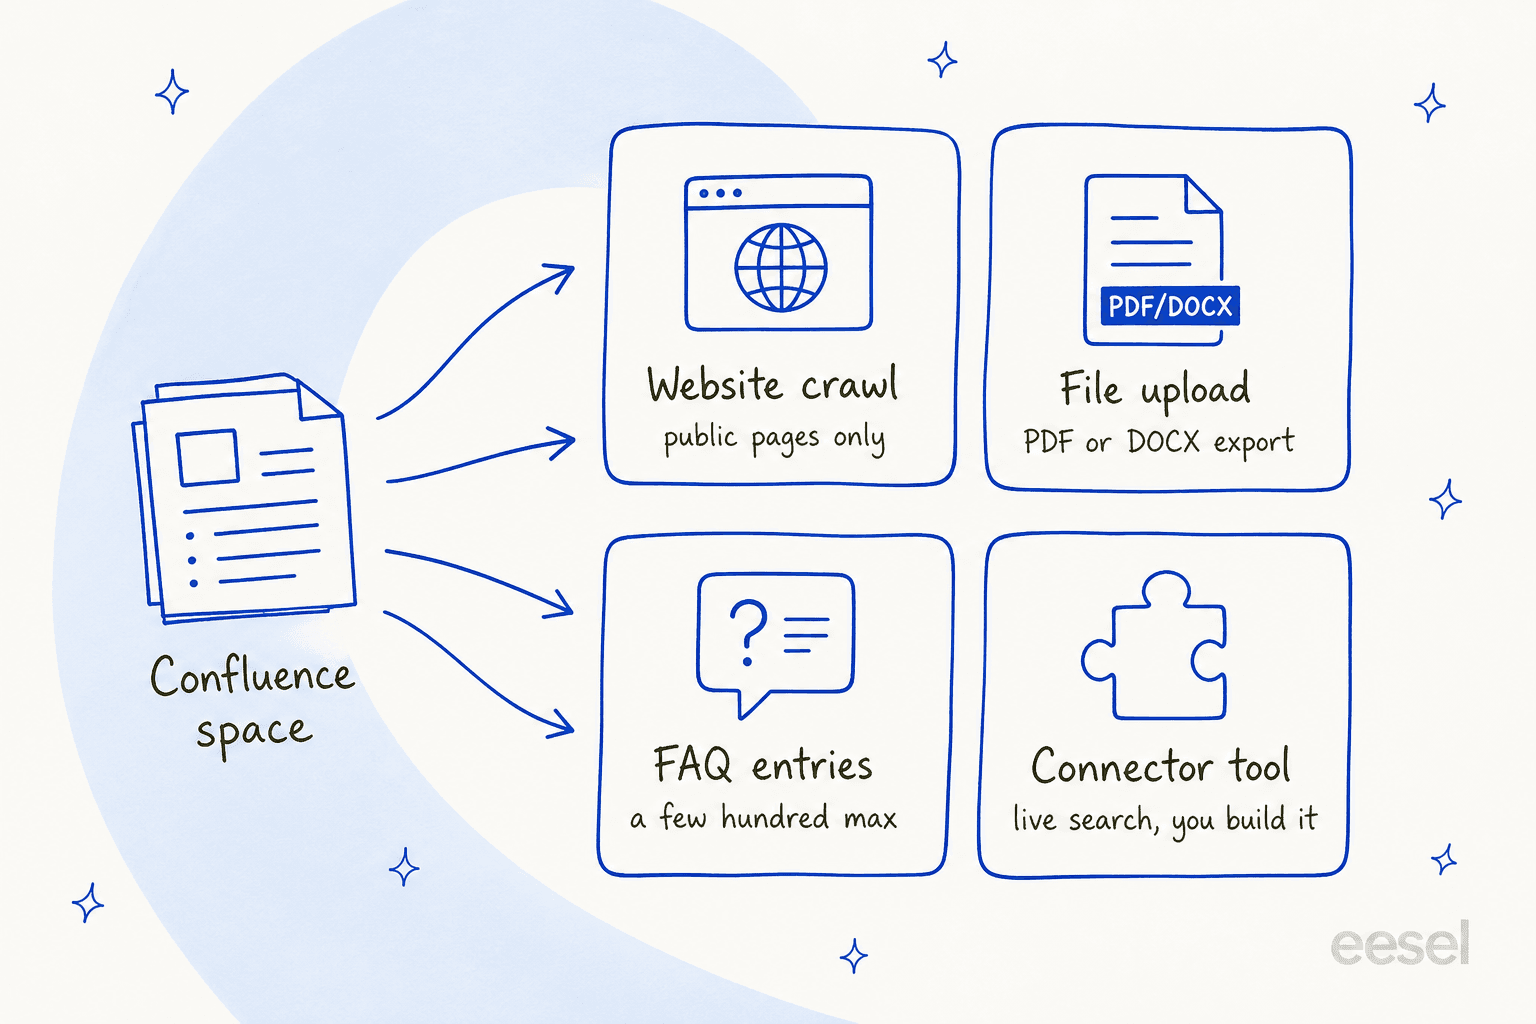
Voici comment les quatre se comparent avant que je détaille chacune :
| Voie | Entrée Meta | Configuration Confluence | Pages privées ? | Fraîcheur | Principal inconvénient |
|---|---|---|---|---|---|
| Crawl public | API Websites | Accès anonyme sur un espace, forfait Standard et supérieur | Non | Prochain recrawl, intervalle non publié | L'espace entier devient public et indexé par Google |
| Export et import | API Files | Export PDF ou Word | Oui, si vous les exportez | Jamais, jusqu'à un nouvel import | Les anciens fichiers restent actifs jusqu'à leur suppression |
| Réécriture en FAQ | API FAQs | Aucune, vous réécrivez à la main ou par script | Oui | Quand vous mettez l'entrée à jour | La qualité baisse au-delà de quelques centaines d'entrées |
| Connecteur en direct | Connecteur HTTP ou MCP | Compte de service plus scopes d'API | Oui, selon les permissions du compte | En direct | Vous le construisez et le maintenez |
Voie 1 : rendre l'espace public et laisser Meta le crawler
C'est la voie la plus simple à configurer, et aussi celle qui comporte le plus gros compromis.
L'API Websites de Meta crawle une URL et en récupère le contenu. Par défaut, elle prend « le domaine entier », et vous pouvez la restreindre avec des champs de sous-domaine, de motif d'URL et d'URL unique. Le guide de l'agent de support de Meta appelle ce crawl « votre site web public », et la requête n'a aucun champ pour une connexion ou un cookie. Un espace Confluence derrière une connexion Atlassian ne peut donc pas être crawlé.
Pour rendre un espace crawlable, vous activeriez l'accès anonyme. C'est une fonctionnalité payante : la page de tarifs de Confluence place l'accès anonyme dans Standard et au-dessus, et le forfait Free ne l'a pas. Il fonctionne sur trois niveaux. Un administrateur du site autorise les utilisateurs anonymes sur le site, un administrateur de l'espace l'active espace par espace, et les pages définies comme Restreintes restent masquées. Les nouveaux espaces démarrent fermés « même si le paramètre global est activé », selon le guide de configuration d'Atlassian.
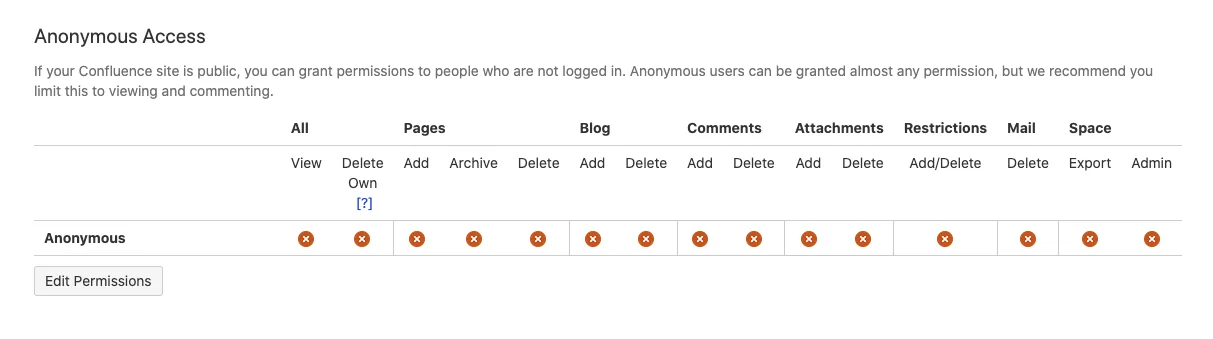
Le compromis tient aux propres mots d'Atlassian : dès que des utilisateurs anonymes ont accès, « votre contenu sera indexé par les moteurs de recherche ». C'est acceptable pour un centre d'aide public et un problème pour un wiki qui mélange documentation client et notes internes. Si vos articles clients se trouvent déjà dans une base de connaissances JSM, vous pouvez aussi la rendre publique, mais seulement lorsqu'elle repose sur un forfait Confluence payant, et elle fonctionne de la même façon en dessous.
Et les liens publics de Confluence ? Ils n'aident guère ici. Atlassian dit avoir pris des mesures « pour s'assurer que les moteurs de recherche n'indexent pas nos liens publics », selon sa page sur la sécurité des liens publics, donc un crawler ne peut pas les trouver sauf si vous listez chaque URL dans le champ single_urls de Meta. Et un lien public ignore les restrictions de page, il est donc facile d'exposer quelque chose que vous ne vouliez pas.
Restreignez le crawl avec soin, car le guide de Meta prévient que crawler un site entier « dilue le contenu d'aide à partir duquel l'agent devrait répondre ». Avec Confluence, cela signifie pointer le crawl sur un seul espace destiné aux clients et non sur l'ensemble du site.
Voie 2 : exporter les pages et les importer comme fichiers
Si le contenu doit rester privé, vous pouvez l'exporter et remettre les fichiers à Meta. Confluence peut exporter une page en PDF ou Word, et les administrateurs d'espace peuvent exporter un espace entier en un seul PDF.
L'API Files de Meta accepte .pdf, .doc, .docx et les images, ainsi que CSV et XLSX lorsque l'extraction est activée. La limite est de 100 000 000 d'octets par fichier. HTML, Markdown et zip ne figurent pas dans la liste, donc l'export HTML d'espace de Confluence ne passe pas tel quel. Deux détails d'export méritent aussi d'être connus : les exports PDF n'incluent jamais les commentaires, et les articles de blog sont exclus d'un PDF d'espace.
Le plus important est ce qui se passe ensuite. Le guide de support de Meta dit :
« There is no update call. To replace a document, delete the old entry and upload the new one, otherwise the agent draws on both versions and can quote a term you have already withdrawn. »
Imaginez une politique de remboursement qui passe de 30 à 14 jours. Si quelqu'un importe le nouveau PDF et oublie l'ancien, l'agent peut citer l'un ou l'autre chiffre à un client sur WhatsApp. En pratique, cette voie revient donc à écrire un script qui exporte les pages modifiées, supprime le fichier précédent par son ID, puis importe le nouveau. L'API Files autorise 1 000 requêtes par heure, ce qui suffit largement pour une telle tâche.
Meta déconseille aussi de tout importer : « un grand ensemble de documents ralentit l'agent pour trouver le bon passage ». Un PDF d'espace de 300 pages est exactement le type d'import visé par ce conseil. Si vous cherchez la réflexion derrière une base de connaissances IA bien conçue, le guide de la base de connaissances IA de Confluence explique comment la structurer.
Voie 3 : réécrire les articles sous forme d'entrées de FAQ
L'API FAQs de Meta stocke des paires question-réponse, et contrairement aux fichiers, elles peuvent être mises à jour. L'agent traite chaque entrée séparément : il « répond à partir d'elle, plutôt que de déduire une réponse de vos autres sources de connaissances ». Cela fait des FAQ l'entrée la plus prévisible pour vos réponses les plus sensibles.
Le plafond est bas. Meta prévient : « Ajouter trop de FAQ (en général au-delà de quelques centaines) peut dégrader la capacité de l'agent à trouver la bonne réponse. » Les FAQ conviennent donc à vos 50 ou 100 premières questions, pas à un wiki entier. Le conseil de Meta est de prendre les principaux motifs de tickets du dernier trimestre et de rédiger des entrées pour ceux-ci. Pour une équipe Confluence, je ferais la même chose : réécrire les articles principaux sous forme de paires Q&R concises, puis envoyer la longue traîne vers l'une des autres voies.
Voie 4 : construire un connecteur qui interroge Confluence en direct
C'est la seule voie qui garde le contenu privé à la fois privé et à jour, et aussi la seule que vous devez construire.
La référence des connecteurs de Meta vous permet de pointer l'agent vers une API HTTP ou un serveur MCP distant. L'authentification est limitée : « Actuellement, seuls OAUTH2_CLIENT_CREDENTIALS, API_KEY et NONE sont pris en charge. » L'authentification basique est listée mais non prise en charge. Cela exclut la manière habituelle de se connecter aux outils Atlassian, à savoir un écran de consentement dans le navigateur.
La bonne nouvelle, c'est que les comptes de service Atlassian conviennent. Un jeton d'API de compte de service fonctionne comme en-tête Bearer auprès de la passerelle Atlassian, et la page sur les jetons de comptes de service d'Atlassian prend un endpoint Confluence pour exemple : https://api.atlassian.com/ex/confluence/{cloudId}/wiki/rest/api/space. Les comptes de service prennent aussi en charge les identifiants client OAuth, qui correspondent à l'autre type d'authentification de Meta. Atlassian donne 5 comptes de service gratuits à chaque organisation, et ils ne comptent pas dans votre limite d'utilisateurs Confluence, selon Understand service accounts.
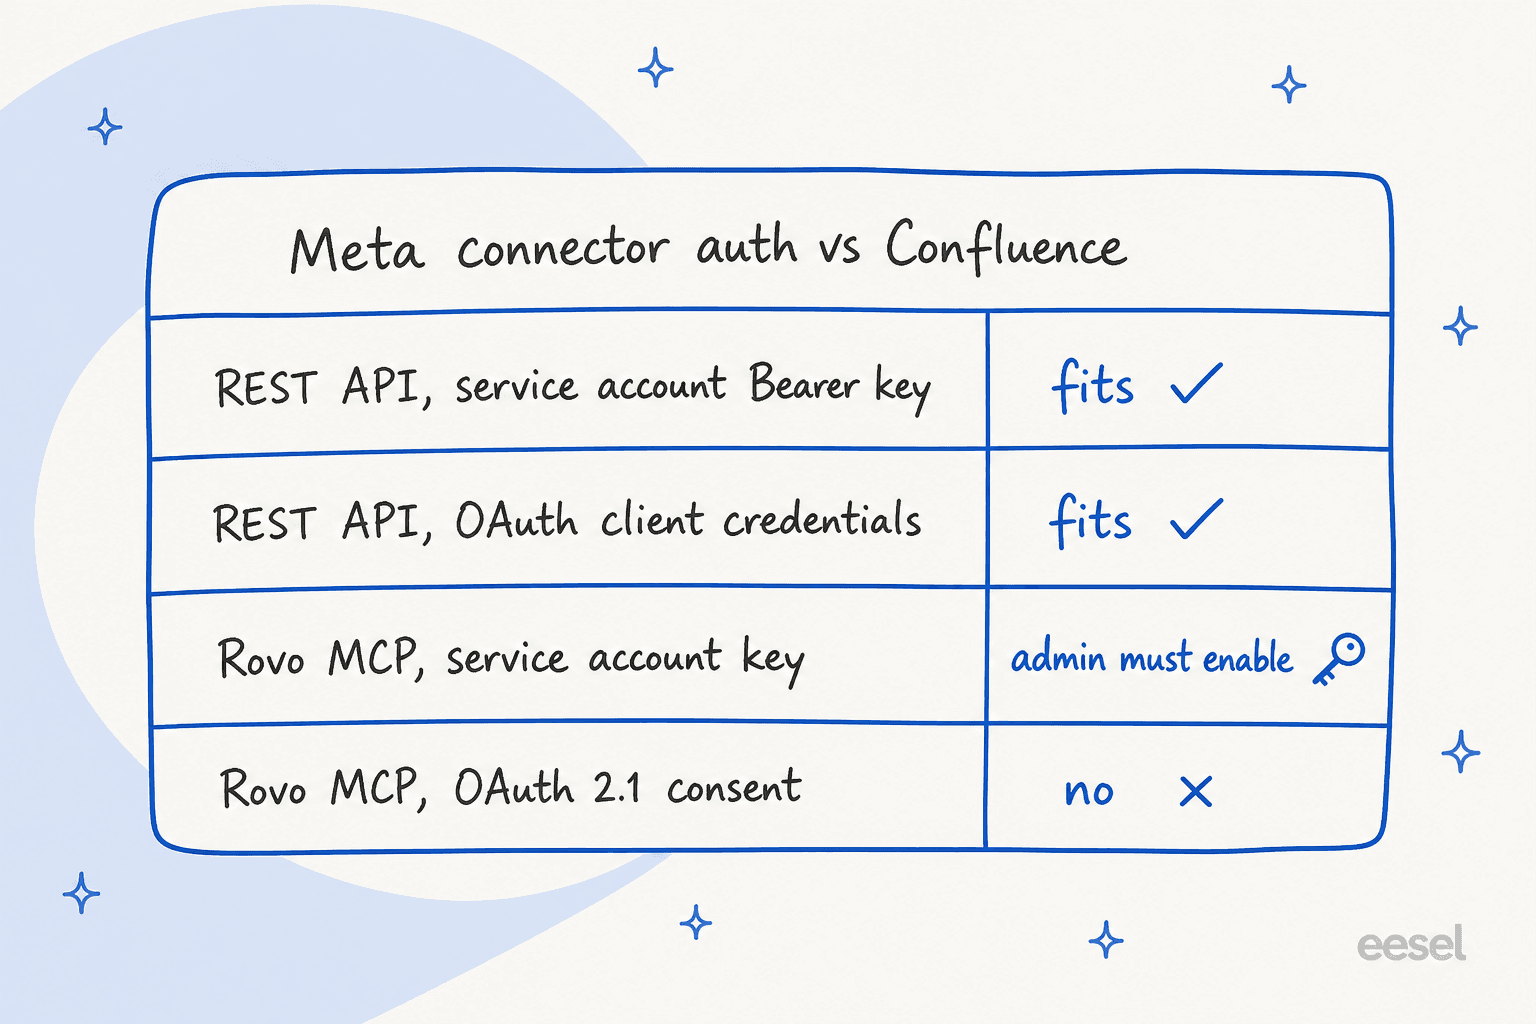
Un connecteur Confluence de base nécessite deux outils :
- Recherche, avec CQL sur l'endpoint de recherche v1 (
/wiki/rest/api/search?cql=...) avec le scopesearch:confluence. - Obtenir une page, avec l'endpoint de page v2 avec
read:page:confluenceet un paramètrebody-format.
Trois pièges méritent d'être anticipés. Premièrement, les corps de page reviennent au format de stockage Confluence ou en JSON ADF sauf si vous demandez la vue rendue, donc l'agent lit beaucoup de balisage. La référence des outils de connecteur de Meta avertit que les réponses trop volumineuses « dégradent la qualité de réponse de l'agent », et propose un transformation_spec pour les réduire. Deuxièmement, le compte de service voit ce que ses permissions autorisent, donc accordez-lui un espace plutôt que de l'ajouter à un large groupe. Troisièmement, la documentation de Meta décrit des connecteurs pour des actions et des recherches client, comme l'état d'une commande ou des tickets. Elle ne décrit jamais un connecteur comme source de connaissances, donc un outil « rechercher dans Confluence » est quelque chose que vous devriez tester avec soin plutôt que quelque chose que Meta documente.
L'autre option est le serveur MCP Atlassian Rovo à l'adresse https://mcp.atlassian.com/v2/mcp, qui possède déjà un outil searchConfluence. Sa connexion par défaut est OAuth 2.1 avec écran de consentement, que Meta ne sait pas gérer. Une clé d'API de compte de service envoyée comme jeton Bearer fonctionne, mais seulement « si elle est activée par l'administrateur de votre organisation », selon la page d'authentification par jeton d'API d'Atlassian. Chaque appel nécessite aussi un cloudId. Mon article Claude pour Confluence en dit plus sur les outils de Rovo MCP et leurs particularités.
Les développeurs qui ont utilisé la recherche Confluence via MCP ont tendance à la juger bonne, ce qui joue en faveur de cette voie :
« Considering how poor the Confluence search function is, the results from Confluence via an MCP-powered search are remarkably good. I was able to solve one or two obscure, company-specific issues purely by using the MCP search, and I'm convinced that finding these pages would have been almost impossible without it. »

Le problème de fraîcheur dont personne ne parle dans la démo
La plupart des articles sur Meta Business Agent s'arrêtent à la configuration, mais pour une équipe Confluence, la vraie question est ce qui se passe un mardi quand quelqu'un modifie une page.
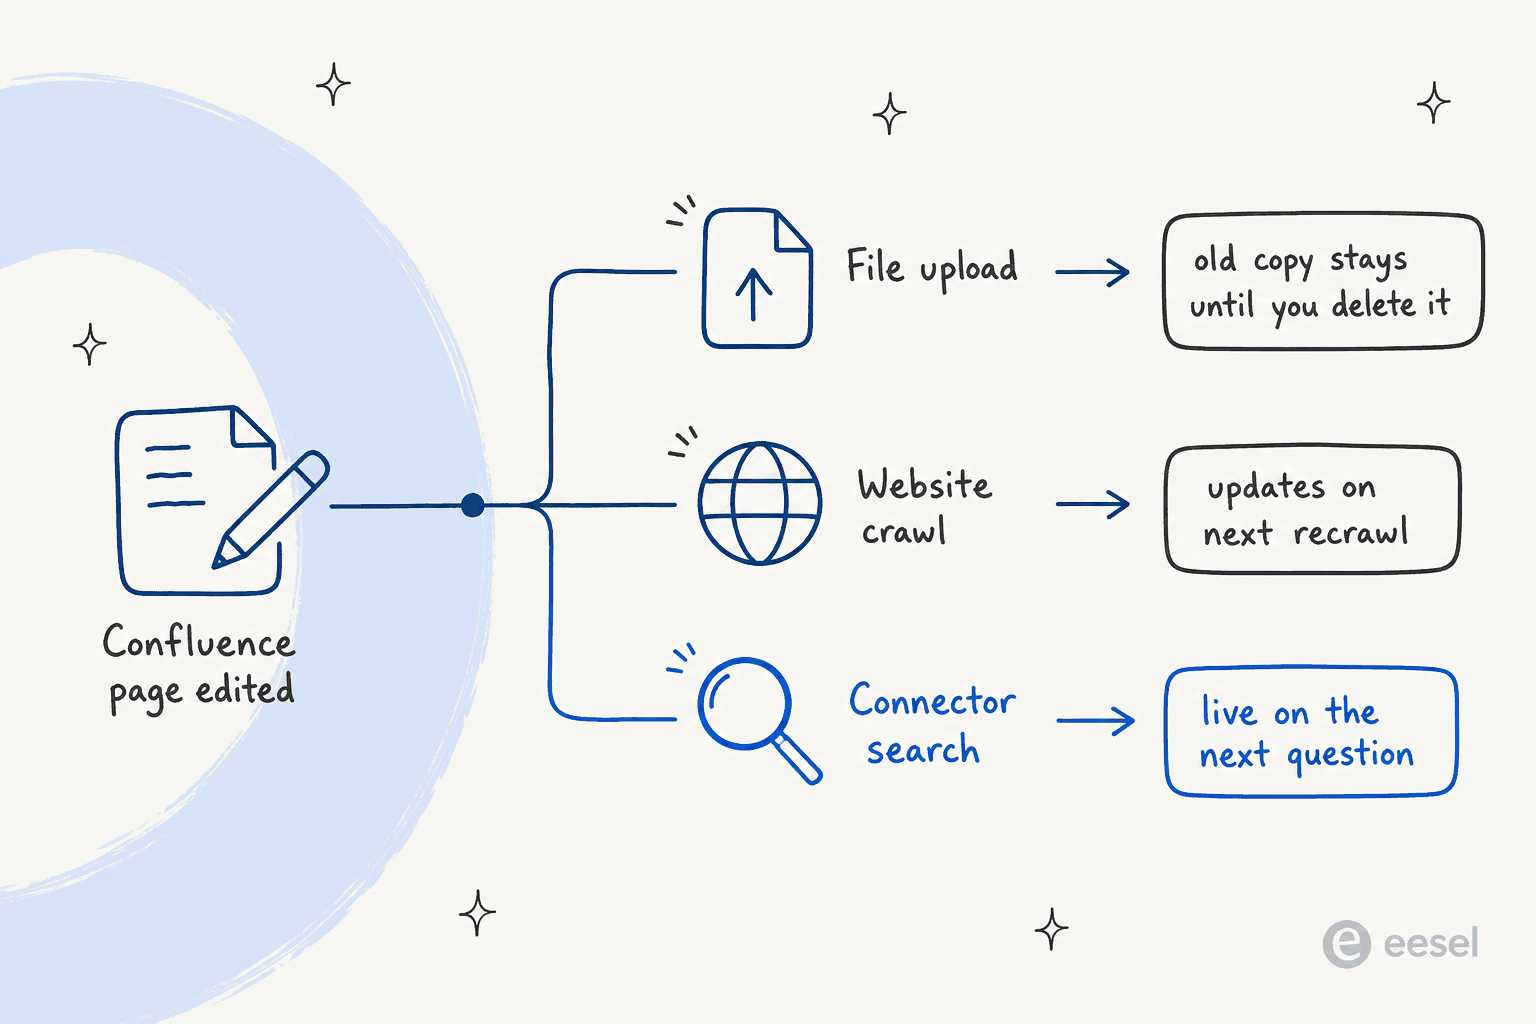
Meta indique que les sites crawlés sont « recrawlés périodiquement » mais ne donne aucun intervalle, et son guide ajoute : « Website knowledge is a snapshot taken at crawl time... re-crawl whenever those pages change materially. » Les fichiers ne se rafraîchissent jamais d'eux-mêmes. Les FAQ ne changent que lorsque vous appelez l'API. Seul un connecteur en direct voit une modification immédiatement.
L'autre moitié de la fraîcheur est de savoir si le wiki était exact dès le départ. Une IA qui répond à partir de Confluence vaut ce que contient Confluence, et beaucoup d'ingénieurs sont francs à ce sujet :
« How can AI search into documentation, if the documentation is a thousands of obsolete and contradicting Jira tickets, few outdated Confluence pages with mail attachments and handful of excel files on SharePoint? »
L'ancrage dans les sources se configure aussi par un prompt. Meta n'a pas d'interrupteur « répondre uniquement à partir des connaissances ». Son instruction d'exemple dit : « Answer policy questions from the documented policies only, and say you will check with a colleague rather than guessing when the answer is not there. » Un des premiers testeurs de Business Agent sur Reddit a résumé le risque sans détour :
« Consistency is a problem. I saw the same product come back at two different prices in two replies. If you don't ground it properly, it just makes things up. »

C'est la leçon qu'eesel a apprise tôt avec ses clients Confluence, et c'est pourquoi chaque déploiement est testé sur de vraies questions passées avant que le bot ne réponde à qui que ce soit. Un bot qui répond avec assurance à partir d'une page périmée est pire qu'un bot qui dit qu'il va vérifier. Le tutoriel relier Confluence à un bot de connaissances montre le côté synchronisation de cette configuration.
Ce que cela coûte
Il y a ici deux factures : celle de Meta et celle d'Atlassian.
| Poste de coût | Prix | Source |
|---|---|---|
| Meta Business Agent, plateforme WhatsApp | 2,00 $ par million de tokens, environ 16 à 20 cents pour une conversation simple et 40 à 50 cents pour une complexe | Tarifs Meta |
| Réponses WhatsApp de votre équipe, à partir du 1er oct. 2026 | Au message aux tarifs utilitaires, après 1 000 gratuits par numéro et par mois | Tarifs Meta |
| Confluence Free | 0 $, 10 utilisateurs, sans accès anonyme ni liens publics | Tarifs Confluence |
| Confluence Standard | 6,70 $ par utilisateur et par mois, inclut l'accès anonyme | Tarifs Confluence |
| Confluence Premium | 13,20 $ par utilisateur et par mois | Tarifs Confluence |
| Comptes de service Atlassian | 5 gratuits, jusqu'à 250 avec Atlassian Guard Standard | Atlassian Support |
Une équipe Confluence sur le forfait Free se heurte tout de suite à un mur : pas d'accès anonyme, donc pas de voie par crawl public. Cette équipe passerait à Standard ou choisirait la voie de l'export, et l'autre choix est de construire un connecteur. Les analyses des tarifs Confluence et des tarifs IA de Confluence approfondissent le côté Atlassian, et l'explication des tarifs Rovo couvre les crédits IA propres à Atlassian.
Côté Meta, le changement du 1er octobre est celui à surveiller. La page de tarifs de Meta indique que chaque message est facturé « soit comme message Meta Business Agent soit comme message de service, jamais les deux », donc les réponses de l'IA sont facturées en tokens et tout ce que votre équipe envoie après un transfert est facturé comme messages de service. Mon explication des tarifs de l'API WhatsApp donne tout l'historique des tarifs.
Où l'agent de Meta s'arrête pour une équipe Confluence
L'agent de Meta est un choix raisonnable pour certaines équipes, et il est utile de savoir où il s'arrête :
- Une IA par numéro. La présentation de la plateforme de Meta indique qu'un numéro qui « exécute déjà un autre agent IA » est bloqué, car « une intégration d'agent autorisé active bloque Meta Business Agent ». Vous choisissez un bot par numéro WhatsApp.
- Uniquement les surfaces Meta. Il répond sur WhatsApp, Messenger, Instagram et un plugin de site web qui est pour l'instant lié à Shopify. Il ne répond pas par e-mail, dans un helpdesk, dans Slack ou dans Teams, là où la plupart des lecteurs de Confluence posent leurs questions.
- Pas de réglage de citations. Rien dans la documentation ne fait en sorte que l'agent mette un lien vers la page Confluence dont il s'est servi. Comparez avec les outils conçus pour Confluence, où le lien vers la source est l'essentiel. Le guide de l'IA de recherche Confluence montre à quoi cela ressemble.
- Le transfert est un changement de routage, pas un ticket. Une fois que Business Agent prend le numéro, votre boîte de réception WhatsApp existante passe en veille. Ma version Zendesk de cet article détaille le Conversation Routing de Meta, et le guide du transfert d'agent IA explique ce qu'est un bon transfert.
- Les wikis internes n'ont pas leur place sur WhatsApp. La plupart des espaces Confluence sont rédigés pour le personnel, donc avant de choisir une voie, vous devriez isoler un espace destiné aux clients, sans quoi le bot risque de citer des notes internes à un client.
Quelle configuration convient à votre équipe Confluence
Voici comment je choisirais :
| Votre situation | Voie que j'utiliserais |
|---|---|
| Documentation client déjà dans un centre d'aide public sur Confluence Standard | Crawl de site ciblé sur cet espace |
| Moins de 100 articles stables, WhatsApp uniquement | Entrées de FAQ pour les questions principales, plus un crawl ou quelques fichiers |
| Documents privés qui changent chaque mois | Export et import, avec un script qui supprime d'abord l'ancien fichier |
| Documents privés qui changent chaque semaine, et un ingénieur disponible | Connecteur HTTP avec compte de service, recherche v1 plus lectures de page v2 |
| Confluence en Free, sans ingénieur | Passer à Standard pour le crawl, ou utiliser un outil qui lit Confluence nativement |
| Vous répondez aussi dans un helpdesk, dans Slack ou dans un chat web | Une IA native Confluence sur tous les canaux, et décider quel bot possède WhatsApp |
Si vous comparez encore des outils plutôt que des voies, mes comparatifs des meilleures IA pour Confluence et des meilleures IA pour le support WhatsApp abordent le sujet par chaque bout.
Vous envisagez plutôt un assistant généraliste ? Le guide ChatGPT pour Confluence couvre la voie d'OpenAI. La version Grok Bot couvre celle de xAI.
Et si l'idée de construire vous-même le connecteur vous tente, l'article construire ou acheter vaut dix minutes au préalable. GENERAL BYTES a envisagé de construire le sien et y a renoncé : « We wanted something that we would not have to maintain and something that somebody else will work on improving. »
Essayer eesel avec Confluence
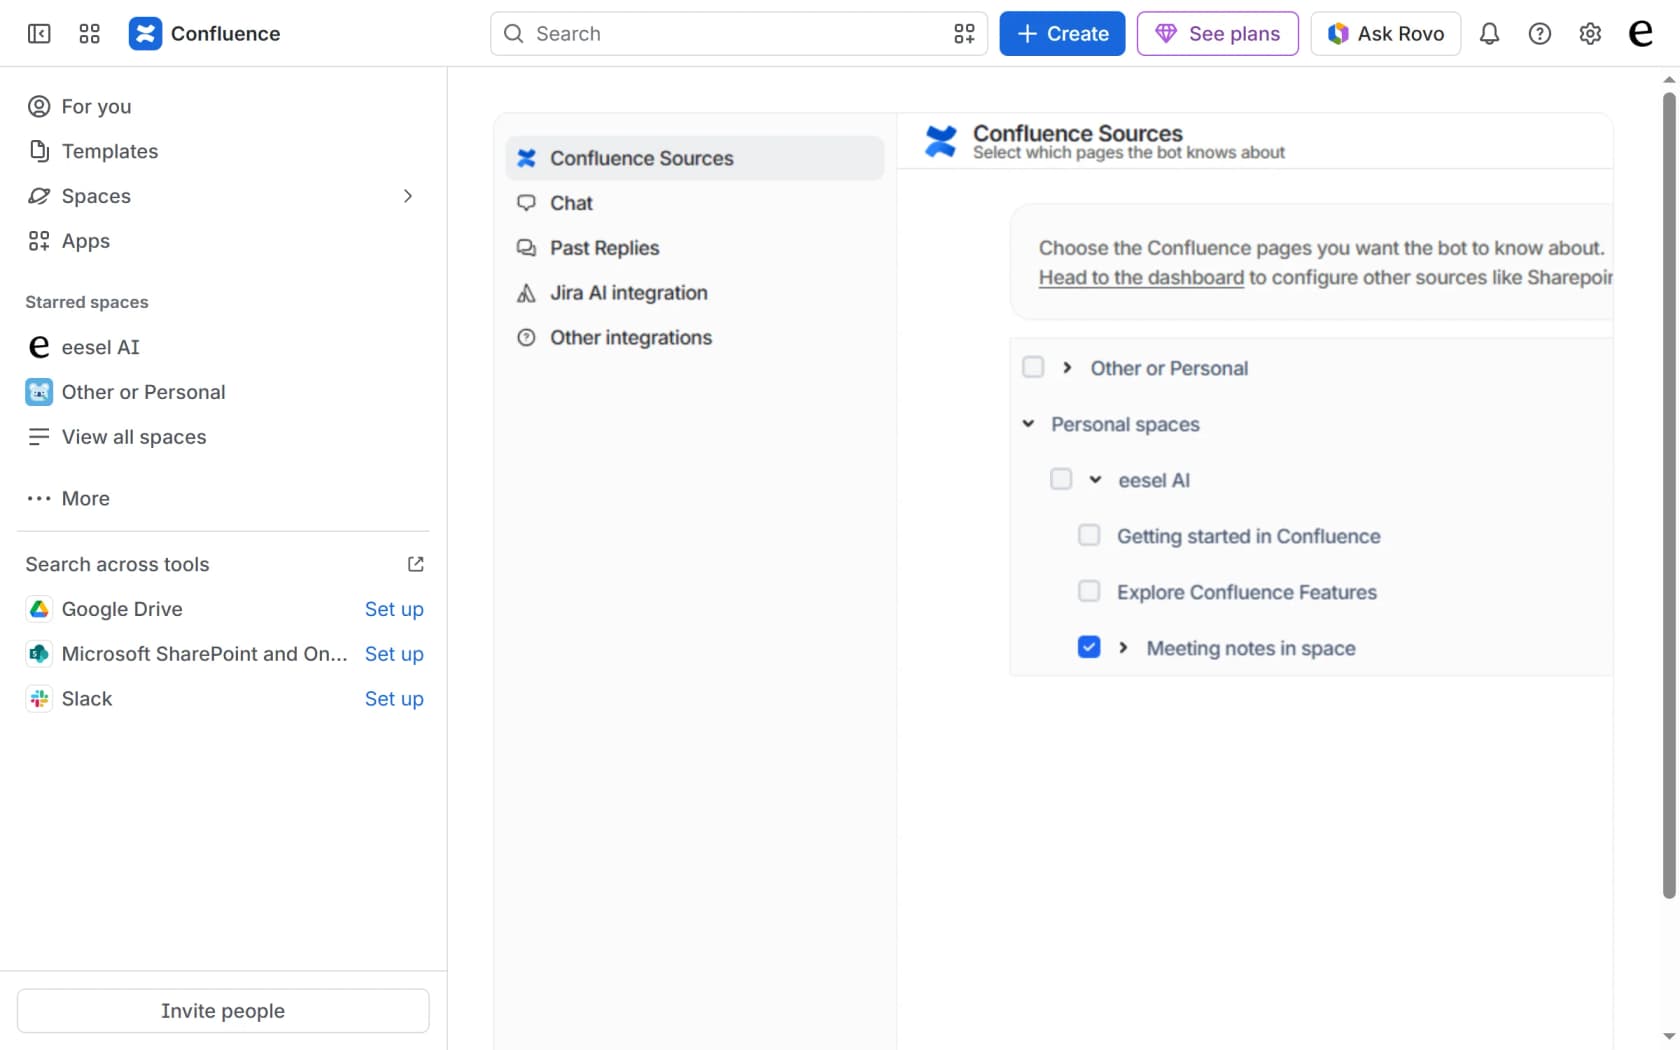
Toutes les voies ci-dessus se terminent par quelqu'un de votre équipe qui maintient la copie de Meta de votre wiki synchronisée. eesel saute cette étape. C'est un coéquipier IA pour votre helpdesk : vous choisissez les espaces et pages Confluence qu'il lit, cocher une page parente emmène ses pages enfants, et la documentation eesel pour Confluence le résume ainsi : « Edits re-index on their own. » Chaque réponse renvoie vers la page dont elle provient.
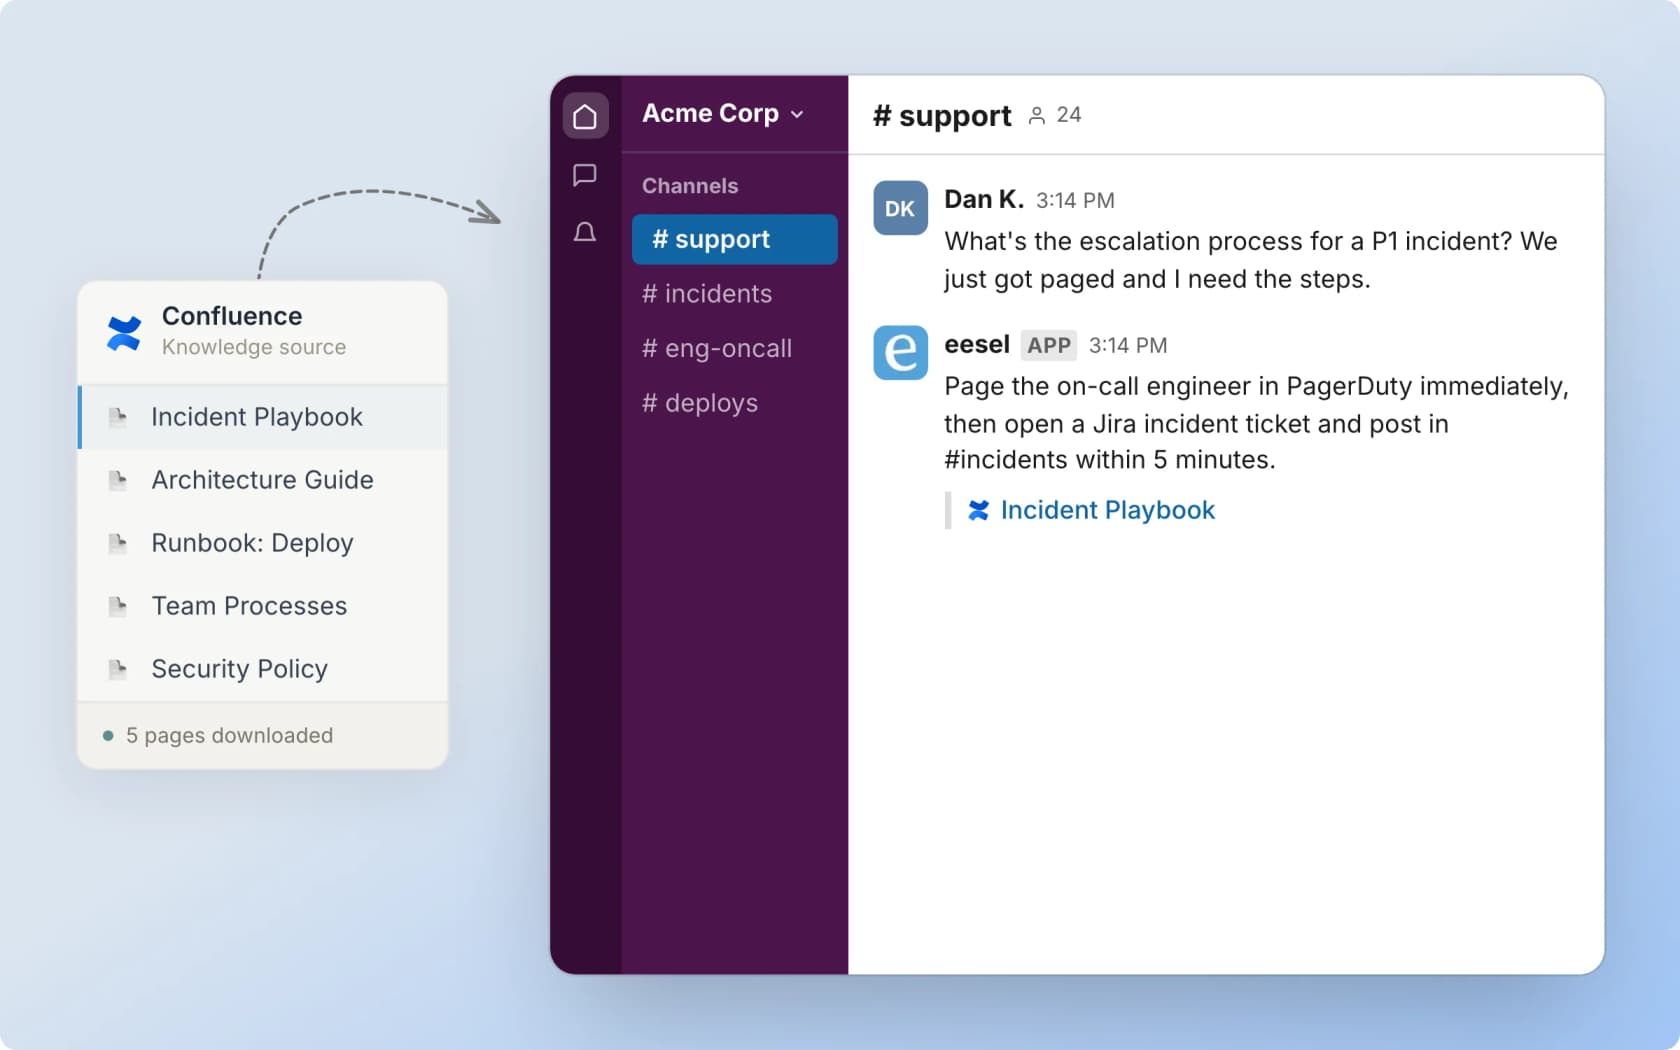
Ces mêmes connaissances répondent ensuite partout où vos clients et votre équipe posent leurs questions : votre helpdesk, Slack, Microsoft Teams, une bulle de chat sur votre site ou un onglet Chat dans Confluence lui-même. Il réunit Confluence avec votre centre d'aide et vos anciens tickets, de sorte qu'une réponse peut puiser dans les trois. Flemming Ottosen, Development Director chez Simployer, a décrit ce dont ils avaient besoin comme « a turnkey solution for Confluence that met our GDPR requirements and could serve different teams through dedicated Slack bots. »
Si WhatsApp est le canal dont vous avez besoin, jetez aussi un œil à l'intégration WhatsApp d'eesel, et gardez en tête la règle d'une IA par numéro de Meta au moment de choisir. Le forfait gratuit comprend 100 crédits et ne demande pas de carte, et les forfaits payants commencent à 299 $ pour 500 tickets ou chats par mois. Essayez eesel sur un espace Confluence et voyez comment il répond.
Foire aux questions
Puis-je utiliser Meta Muse avec Confluence ?
Meta Business Agent se connecte-t-il directement à Confluence ?
L'agent de Meta peut-il crawler un espace Confluence privé ?
Que se passe-t-il quand je modifie une page Confluence déjà utilisée par l'agent de Meta ?
Combien coûte Meta Muse pour Confluence ?
Puis-je utiliser le serveur MCP Atlassian Rovo avec Meta Business Agent ?
Existe-t-il une meilleure IA pour répondre aux clients à partir de Confluence ?



Article by
Kira
Kira is a writer at eesel AI with a Computer Science background and over a year of hands-on experience evaluating AI-powered customer service tools. She focuses on breaking down how helpdesk platforms and AI agents actually work so that support teams can make better buying decisions.