

Ajoutez llms.txt à votre centre d'aide si votre plateforme en fait un interrupteur, mais n'en attendez pas de trafic de recherche. C'est une carte pour les agents IA que quelqu'un envoie vers votre site, pas un signal de classement : Google dit que ses fonctionnalités IA ne l'utilisent pas, et les opérateurs qui journalisent leur trafic voient les robots IA la contourner. GitBook, Mintlify, Document360, ReadMe et HelpDocs en génèrent une. Zendesk, Help Scout et Freshdesk ne le font pas, donc vous générez un fichier sélectionné et l'hébergez vous-même. Une IA support connectée à votre helpdesk, comme eesel, lit vos articles directement et n'a besoin du fichier en aucun cas.
Qu'est-ce que llms.txt, en termes de centre d'aide ?
llms.txt est un simple fichier markdown qui liste vos pages les plus utiles, avec une note d'une ligne sur chacune, pour qu'un agent IA trouve le bon article sans devoir traverser des menus de navigation et des bannières de cookies. Jeremy Howard a publié la proposition en septembre 2024, et la version 2 est arrivée en août 2026. L'argument de la spécification elle-même est que « le fichier lui-même reste assez petit pour tenir dans le contexte » tandis que le détail vit derrière les liens.
Je construis des agents IA chez eesel, et le mécanisme est plus simple que ce que la plupart des guides laissent entendre. Un agent (Claude Code, Cursor, une session ChatGPT où quelqu'un a collé votre URL) récupère /llms.txt, lit la liste, choisit les liens qui correspondent à la question, et ouvre ces pages. Si chaque lien pointe vers une version markdown propre de l'article, l'agent obtient la réponse sans devoir analyser votre thème graphique. Rien d'autre ne se passe.
Le format a une partie obligatoire et quelques parties optionnelles, selon la spécification du format llms.txt :
- Un H1 avec le nom du site. « C'est la seule section obligatoire. »
- Un résumé en bloc de citation qui indique à l'agent ce que couvre le centre d'aide.
- Du texte libre avec des notes sur la façon de lire le fichier.
- Des sections H2 de liens, chaque ligne étant
[nom](url) : description. - Une section
## Optionalpar convention, pour les liens qu'un agent peut ignorer quand il manque de place. La version 2 a supprimé toute signification d'analyse spéciale pour elle, selon la page des changements.
Deux détails comptent particulièrement pour les centres d'aide. Premièrement, un fichier couvre les URL sous son chemin, donc un centre d'aide situé sur yourcompany.com/help peut avoir son propre /help/llms.txt. Deuxièmement, la spécification demande des versions markdown de chaque page à la même URL avec .md ajouté. La plupart des centres d'aide hébergés par un helpdesk ne les servent pas, ce qui affecte le chemin de configuration que vous choisirez ci-dessous.
Si vous voulez la vue d'ensemble de qui lit un centre d'aide aujourd'hui (moteurs de recherche, moteurs de réponse IA, agents de codage, votre propre bot de support), ma checklist de lisibilité IA couvre les corrections d'articles qui viennent avant tout cela.
llms.txt aide-t-il vraiment un centre d'aide ?
Il aide un type de lecteur et ne fait rien pour un autre. Voici ce que disent les sources primaires, objectif par objectif :
| Ce que vous voulez | llms.txt aide-t-il ? | La preuve |
|---|---|---|
| Un meilleur classement Google | Non | Google dit que vous pouvez ignorer les « fichiers texte IA inutiles (comme llms.txt) » (guide d'optimisation IA) |
| Apparaître dans AI Overviews ou AI Mode | Non | « Il n'y a aucune exigence technique supplémentaire » au-delà d'être indexé avec un extrait (fonctionnalités IA de Google) |
| Citations dans les réponses de ChatGPT ou Claude | Non prouvé | Des opérateurs avec journaux serveur rapportent que les robots IA ne le récupèrent pas (citations ci-dessous) |
| Un agent de codage configurant votre produit | Oui | La spécification dit que les agents « suivent les liens pertinents » ; c'est son usage le plus intense |
| Un agent trouvant une réponse dans un grand centre d'aide | Oui, si le fichier est sélectionné | Un court index tient dans le contexte ; 4 000 liens non |
| Remplacer votre sitemap | Non | La spécification appelle les sitemaps la liste complète et llms.txt « un aperçu sélectionné » |
Google est inhabituellement direct là-dessus. Son guide sur l'IA générative dit que vous n'avez pas besoin de « nouveaux fichiers lisibles par machine, fichiers texte IA, balisage ou Markdown pour apparaître dans la Recherche Google », parce que « la Recherche Google elle-même ne les utilise pas ». L'audit llms.txt de Lighthouse de Chrome marque un fichier manquant comme non applicable, « car fournir le fichier est optionnel pour le moment », et ne signale que lorsque la requête renvoie une erreur serveur.
L'adoption reste faible. Le HTTP Archive Web Almanac 2025 a trouvé llms.txt sur 2,13 % des sites de bureau et 2,10 % des sites mobiles lors de son exploration de juillet 2025, et 39,6 % de ces fichiers venaient d'un seul plugin SEO WordPress, donc une partie d'entre eux n'a jamais été un choix délibéré.
Les rapports de journaux serveur concordent avec cela :
"I can definitively say llms.txt is not used by any AI players. I run a blogging platform with around 80k blogs and /llms.txt is not requested by anything (other than humans checking to see if there's an llms.txt path)."

L'argument en sa faveur vient de gens qui remettent le fichier à un agent délibérément :
"It's a single link you can give your AI agent and ask to "read this, understand it does, implement it"."
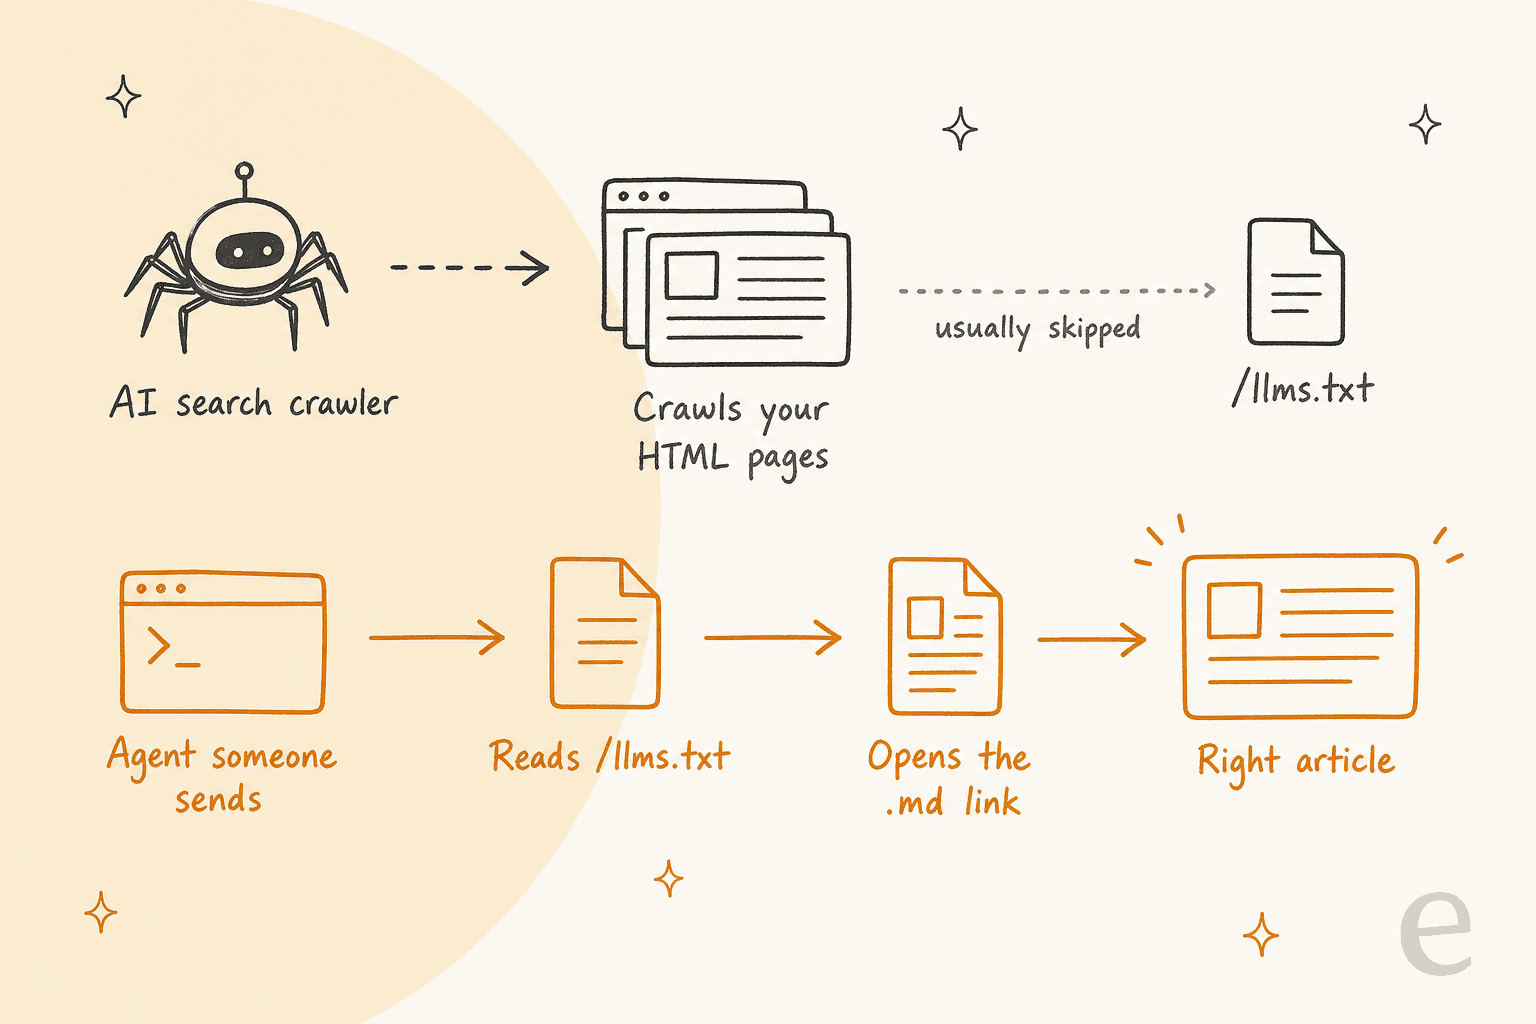
Le verdict honnête, donc : llms.txt est consulté par des agents qui viennent le chercher, pas poussé dans les index de recherche. Pour un centre d'aide, ce lecteur est un développeur qui connecte votre API, un client qui a collé l'URL de votre aide dans un assistant IA, ou l'agent d'un partenaire qui vérifie votre politique de remboursement. Si rien de tout cela ne vous concerne, mieux vaut investir l'heure dans vos articles. Si vous êtes curieux de savoir comment les moteurs de réponse IA choisissent leurs sources, mon explication des moteurs de recherche IA couvre ce sujet.
Quelles plateformes de centre d'aide peuvent publier /llms.txt ?
C'est la question que la plupart des guides llms.txt sautent, et elle décide combien de travail vous attend. Votre plateforme de centre d'aide tombe dans l'un de trois groupes.
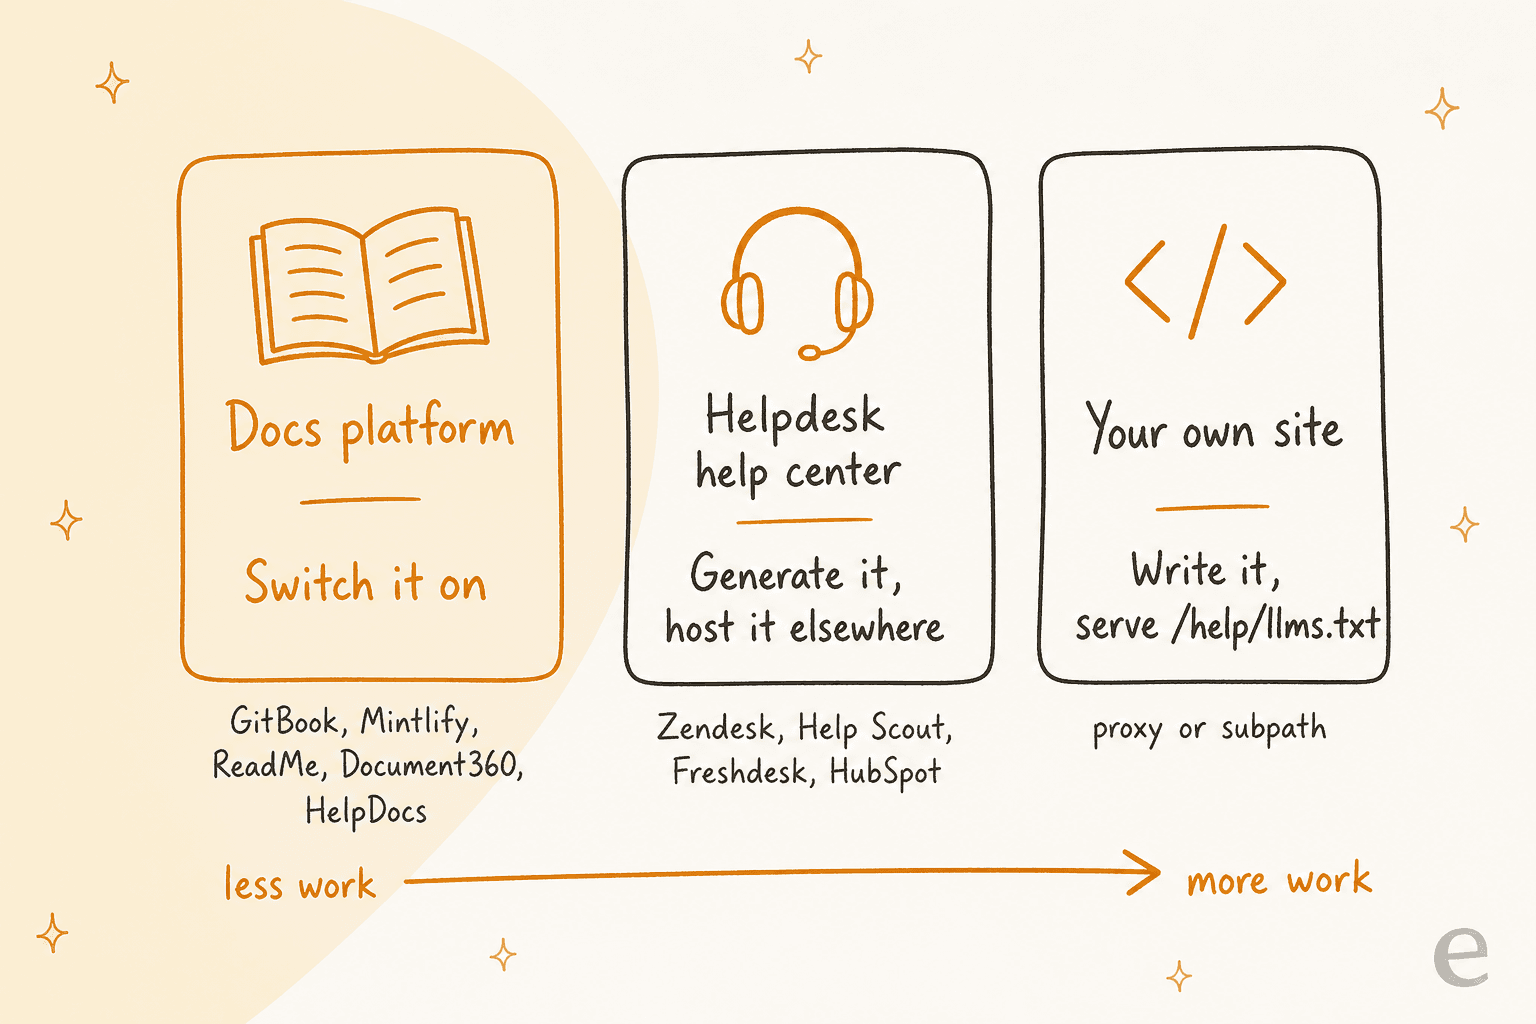
J'ai vérifié la documentation de chaque fournisseur le 17 novembre 2026. Voici où les choses en sont :
| Plateforme | llms.txt | llms-full.txt | Contrôle de sélection | À surveiller |
|---|---|---|---|---|
| GitBook | Automatique, sur tous les forfaits y compris Free | Oui | Non documenté | Les pages masquées restent dans llms-full.txt |
| Mintlify | Automatique, aussi sur /.well-known/llms.txt | Oui | Pages masquées et noindex exclues ; un fichier personnalisé les remplace | Fichier généré limité à 100 000 caractères, puis divisé |
| ReadMe | Activé par défaut, tous les forfaits | Non documenté | Pages masquées exclues ; fichier personnalisé autorisé | Un fichier personnalisé arrête la mise à jour automatique |
| Document360 | Automatique, reconstruit à la publication | Non documenté | Exclure un article des moteurs de recherche le retire aussi de llms.txt | Les articles sans description apparaissent seulement par titre |
| HelpDocs | Interrupteur dans Settings, AI, tous les forfaits | Non documenté | Non documenté | Les centres d'aide privés n'ont pas de fichier |
| Zendesk Guide | Pas d'option native | Via une application du Marketplace | L'application peut exclure catégories, sections, labels | Vous hébergez le fichier vous-même |
| Help Scout Docs | Aucune mention dans la documentation | Non | n/a | Générez et hébergez-le vous-même |
| Freshdesk | Aucune mention dans la documentation | Non | n/a | Générez et hébergez-le vous-même |
| Base de connaissances HubSpot | Aucune mention dans la documentation | Non | n/a | Générez et hébergez-le vous-même |
Les sources de chaque ligne sont liées dans les sections ci-dessous.
Les plateformes de documentation qui le construisent pour vous
Si votre centre d'aide tourne sur une plateforme de documentation, le travail est largement fait. La documentation de GitBook dit qu'elle « publie automatiquement des formats adaptés à l'IA », incluant llms.txt, llms-full.txt et des versions .md de chaque page. Un piège facile à manquer : « Hiding a page only removes it from the published table of contents », donc une page masquée reste dans llms-full.txt. Dépubliez tout ce que vous ne voulez pas que les agents lisent. Mon analyse des tarifs GitBook couvre quel forfait il vous faut pour un domaine personnalisé.
Mintlify vous donne le plus de contrôle. Il exclut les pages masquées et noindex, vous permet d'insérer votre propre llms.txt pour remplacer celui généré, et sur les sites partiellement authentifiés ne liste que les pages publiques aux visiteurs anonymes.
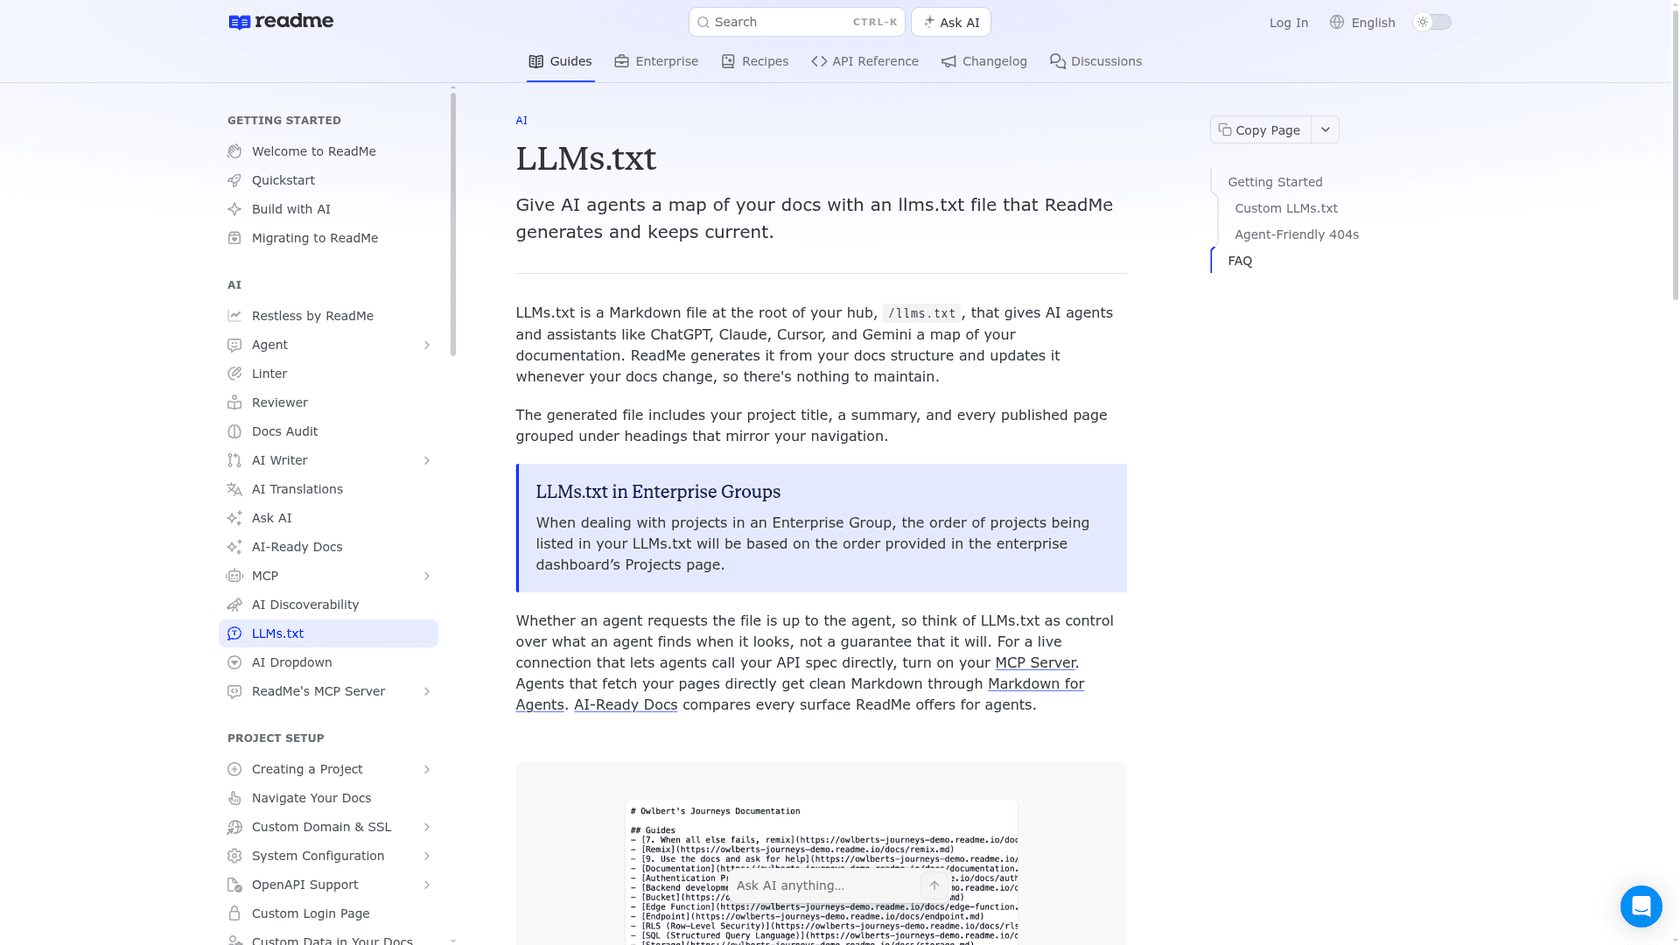
La page llms.txt de ReadMe est directe sur ce que le fichier peut et ne peut pas faire : "think of LLMs.txt as control over what an agent finds when it looks, not a guarantee that it will."
Document360 construit le fichier à partir de votre contenu publié et le met à jour « whenever you publish, update, or remove content. » Les descriptions viennent de la description de recherche de chaque article, donc un article sans description apparaît avec seulement un titre nu, ce qui donne à un agent presque rien pour choisir. Si vous comparez des fournisseurs de base de connaissances sur ce point, ma liste des alternatives à Document360 est un bon point de départ.
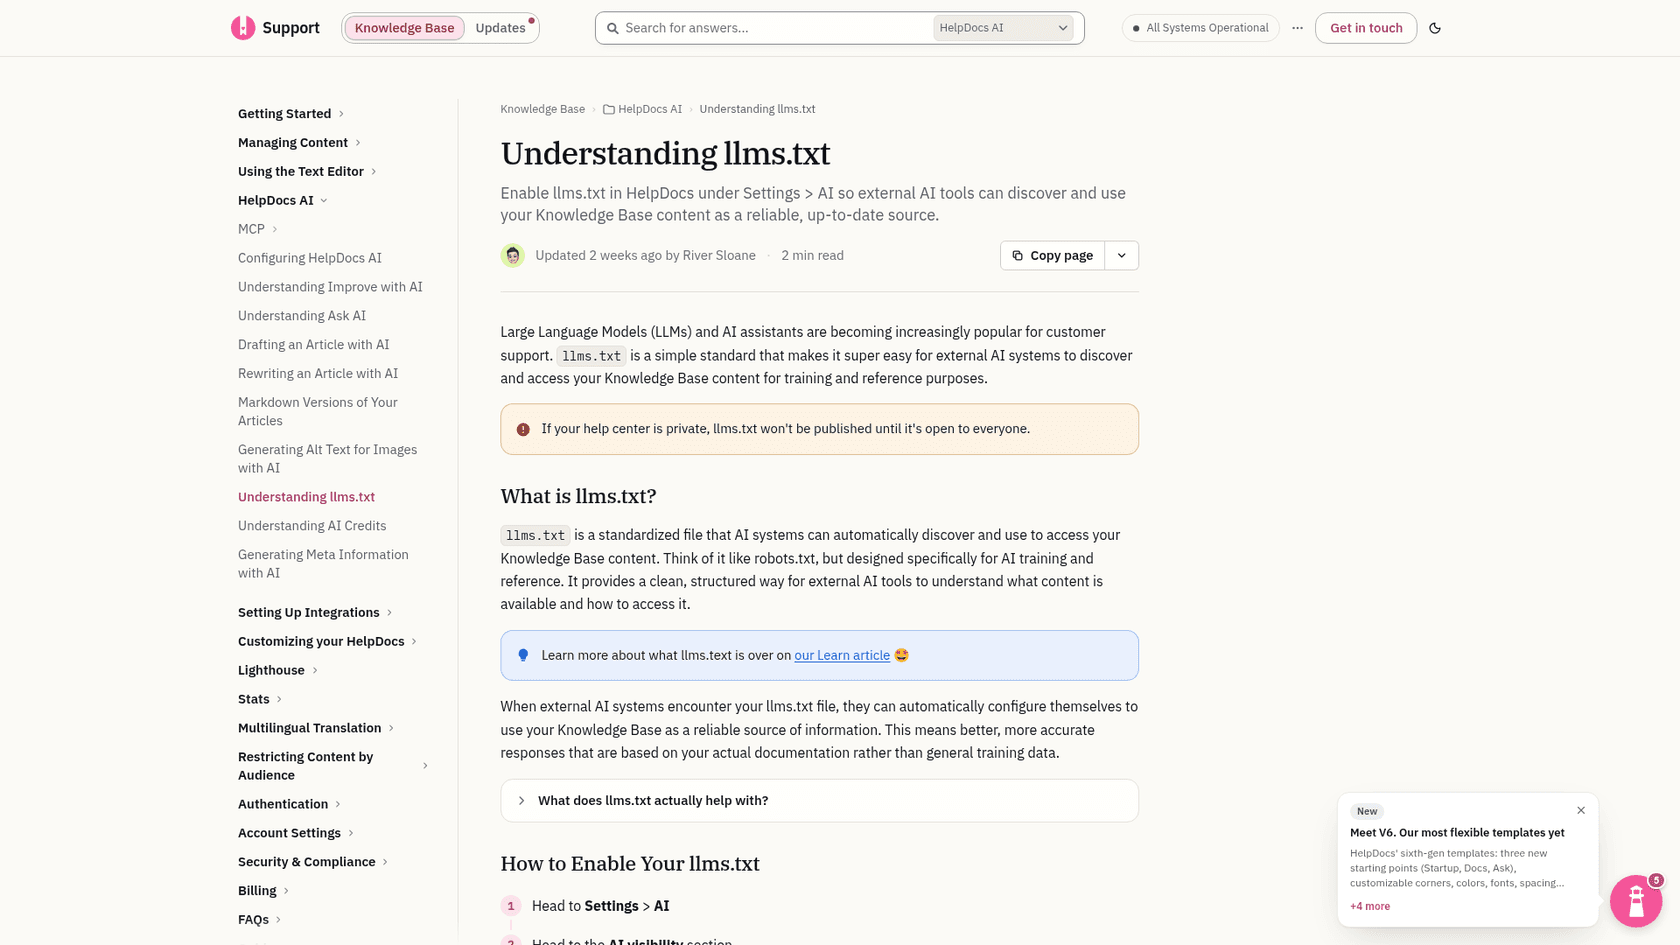
HelpDocs est l'ajout le plus récent. Sa mise à jour du 14 octobre 2026 a rendu les articles markdown et llms.txt « available now, on every plan », et vous l'activez sous Settings, AI, AI visibility.
Les centres d'aide de helpdesk qui ne le font pas (encore)
Les centres d'aide fournis avec les helpdesks, c'est une autre histoire. J'ai cherché dans la documentation de Zendesk Guide, Help Scout Docs, Freshdesk, la base de connaissances de HubSpot, Helpjuice et Zoho Desk une fonctionnalité llms.txt et n'en ai trouvé aucune. J'ai aussi demandé /llms.txt sur le centre d'aide propre de chaque fournisseur le 17 novembre 2026 :
| Centre d'aide | /llms.txt le 17 nov. 2026 |
|---|---|
| support.zendesk.com | 404 |
| docs.helpscout.com | 404 |
| support.freshdesk.com | 404 |
| knowledge.hubspot.com | 404 |
| docs.gorgias.com | 200, avec des liens d'articles .md |
| help.shopify.com | Redirection 308 vers un guide pour agents |
Gorgias est le cas atypique intéressant : son propre centre d'aide sert un fichier avec des liens .md, mais je n'ai trouvé aucun article d'aide qui le propose comme fonctionnalité client, donc vérifiez votre propre centre d'aide Gorgias avant de compter sur cela.
Pour Zendesk, les limites sont documentées. Guide vous permet d'uploader des fichiers .txt comme ressources de thème, mais ceux-ci vivent sur un chemin CDN, pas à /llms.txt. Le mappage d'hôte pointe support.yourcompany.com vers Zendesk avec un CNAME, et c'est tout ce que ça change. Mon guide sous-domaine contre domaine personnalisé couvre cette configuration plus en détail.
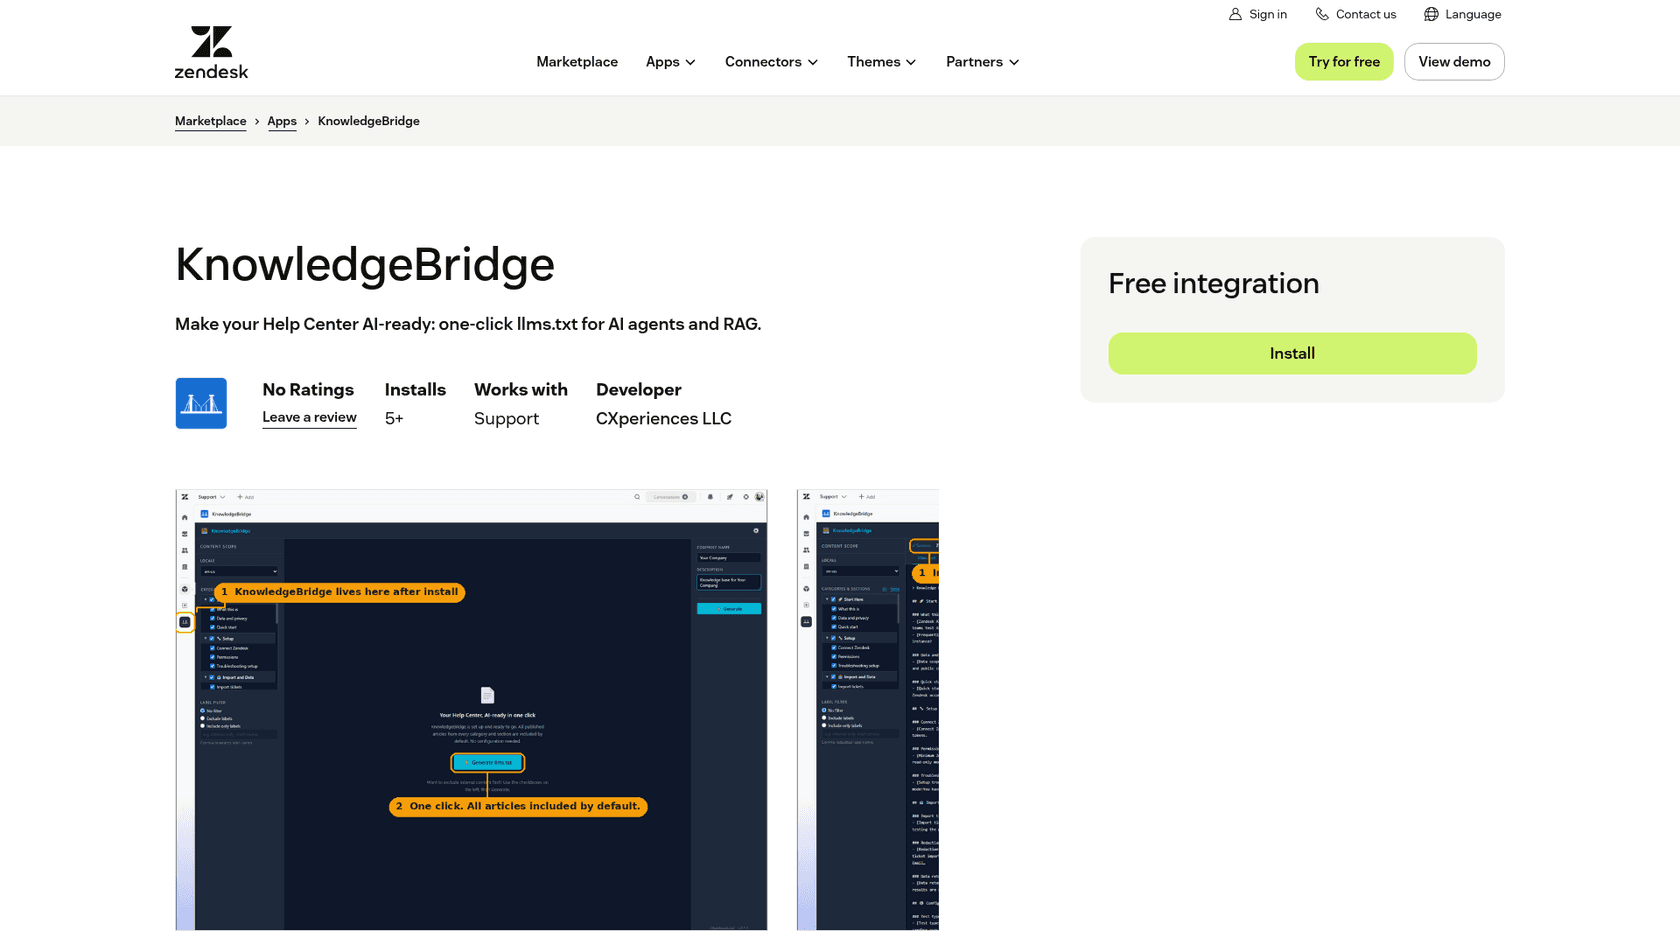
Ce qui s'approche le plus d'une option native est KnowledgeBridge, une application gratuite du Marketplace de CXperiences LLC avec plus de 5 installations. Elle construit llms.txt et llms-full.txt à partir de votre centre d'aide et peut ignorer catégories, sections ou articles étiquetés, mais la sortie est un téléchargement. Ses propres étapes de configuration vous disent d'héberger les fichiers sur votre domaine.
Comment ajouter llms.txt à Zendesk, Help Scout ou Freshdesk ?
Vous générez le fichier ailleurs et l'hébergez là où vous contrôlez la racine. Voici la configuration que j'utiliserais, du début à la fin, en environ une heure pour un centre d'aide de quelques centaines d'articles.
- Choisissez où le fichier vivra. L'option facile est votre site principal :
yourcompany.com/llms.txtavec une section## Help centerqui renvoie vers les articles de votre centre d'aide. Si votre site marketing a déjà une llms.txt (les plugins SEO WordPress en génèrent souvent une), ajoutez la section à ce fichier plutôt que d'en faire un second. L'option plus solide, si votre centre d'aide se trouve sous un sous-chemin commeyourcompany.com/helpvia un reverse proxy, est/help/llms.txt, car la spécification dit que le fichier le plus spécifique gagne. - Récupérez la liste des articles publics. Le point de terminaison List Articles de Zendesk fonctionne sans connexion, et « the response lists only the articles that the requesting agent, end user, or anonymous user can view », donc un appel anonyme ne peut pas divulguer un article restreint. Mon tour de l'API des articles couvre la pagination. Pour Freshdesk, l'API de base de connaissances fait le même travail, et Help Scout a sa propre API Docs.
- Présélectionnez et décrivez. Si vous préférez travailler dans un tableur, commencez à partir d'un export du centre d'aide. Prenez les 30 à 100 articles qui répondent à la plupart de vos tickets, regroupez-les sous vos vrais noms de catégorie, et écrivez une ligne par article qui dit à quelle question il répond.
- Uploadez et liez-le. Mettez le fichier sur votre site principal et liez-le depuis le pied de page de votre centre d'aide, pour que les humains (et les agents qui démarrent sur votre centre d'aide) le trouvent.
- Testez-le comme la spécification le dit. « Test your file by asking an agent questions about your content, giving it only your llms.txt as a starting point », selon llmstxt.org. Posez les cinq questions auxquelles votre équipe répond le plus et vérifiez quel article l'agent ouvre.
Pour l'étape 2 sur Zendesk, ceci récupère les articles publics en anglais, les plus récents d'abord, comme lignes de liste prêtes à l'édition :
curl -s "https://support.yourcompany.com/api/v2/help_center/en-us/articles.json?per_page=100&sort_by=updated_at&sort_order=desc" \
  | jq -r '.articles[] | select(.draft == false) | "- [\(.title)](\(.html_url)): "'
Collez la sortie dans votre modèle et remplissez les descriptions à la main. Pour voir pourquoi la sélection compte sur Zendesk : le même appel contre le propre centre d'aide de Zendesk a rapporté 4 687 articles en anglais le 17 novembre 2026. Personne ne veut d'un agent lisant cette liste.
Deux pièges spécifiques à Zendesk. Si vous restreignez des articles avec des segments d'utilisateurs, l'appel anonyme les retire silencieusement, ce qui est souhaité, mais vérifiez-le avant d'ajouter un article à la main. Et si vous gérez plusieurs centres d'aide de marque, donnez à chaque marque sa propre section, ou son propre fichier par domaine de marque, pour qu'un agent ne mélange pas deux politiques de retour.
À quoi devrait ressembler le llms.txt d'un centre d'aide ?
Court, regroupé par les questions que posent les clients, et écrit pour un lecteur sans contexte. Voici un modèle que vous pouvez copier :
# Acme Help Center

> Official help for Acme customers: setting up an account, billing and invoices,
> shipping and returns, and connecting Acme to other tools. Answers here are
> current; if an article and an old blog post disagree, the article wins.

Articles are written for customers, not admins. For API reference, see
https://developers.acme.com/llms.txt. To reach a person, see "Contact support" below.

## Getting started

- [Create your Acme account](https://help.acme.com/en-us/articles/101): Sign-up steps, email verification, and what the free trial includes.
- [Invite your team](https://help.acme.com/en-us/articles/102): Adding users, roles and seat limits.

## Billing

- [Change or cancel your plan](https://help.acme.com/en-us/articles/201): Upgrades, downgrades, cancellation and when changes take effect.
- [Refund policy](https://help.acme.com/en-us/articles/202): Who qualifies for a refund, the 30-day window, and how to request one.

## Shipping and returns

- [Start a return](https://help.acme.com/en-us/articles/301): The returns portal, return labels and what items can't be returned.

## Contact support

- [Contact support](https://help.acme.com/en-us/articles/401): Hours, channels and what to include so we can help faster.

## Optional

- [Release notes](https://help.acme.com/en-us/articles/501): Product changes by month.
- [Full sitemap](https://help.acme.com/sitemap.xml): Every public article.
Quelques choix là-dedans sont délibérés :
- Le bloc de citation dit à l'agent quelle source gagne. Le contenu de support se contredit entre articles de blog, anciennes macros et articles archivés. Une ligne disant que le centre d'aide est la source actuelle évite à un agent de citer un article de blog de 2023.
- Les descriptions nomment la question, pas le sujet. « Who qualifies for a refund, the 30-day window, and how to request one » permet à un agent de faire correspondre la question d'un client. « Refund information » ne le permet pas. C'est le même travail que d'écrire de bonnes meta descriptions, et vous pouvez souvent les réutiliser.
- Le contact support a sa propre section. Le centre d'aide de Shopify fait quelque chose de similaire : son fichier demande aux agents de répondre d'abord à partir des articles actuels et de lire un guide de support avant de contacter le support au nom d'un marchand.
- La documentation développeur reçoit un pointeur, pas une fusion. Si vous avez une API, liez son propre llms.txt plutôt que d'entasser des points de terminaison dans le fichier du centre d'aide.
Devriez-vous lister chaque article ou sélectionner ?
Sélectionnez. Tout l'intérêt de la spécification est un fichier qui tient dans le contexte d'un agent, et une liste complète d'articles d'un centre d'aide mature n'y tient pas. Voici ce que pesaient trois vrais fichiers de centre d'aide quand je les ai récupérés le 17 novembre 2026 :
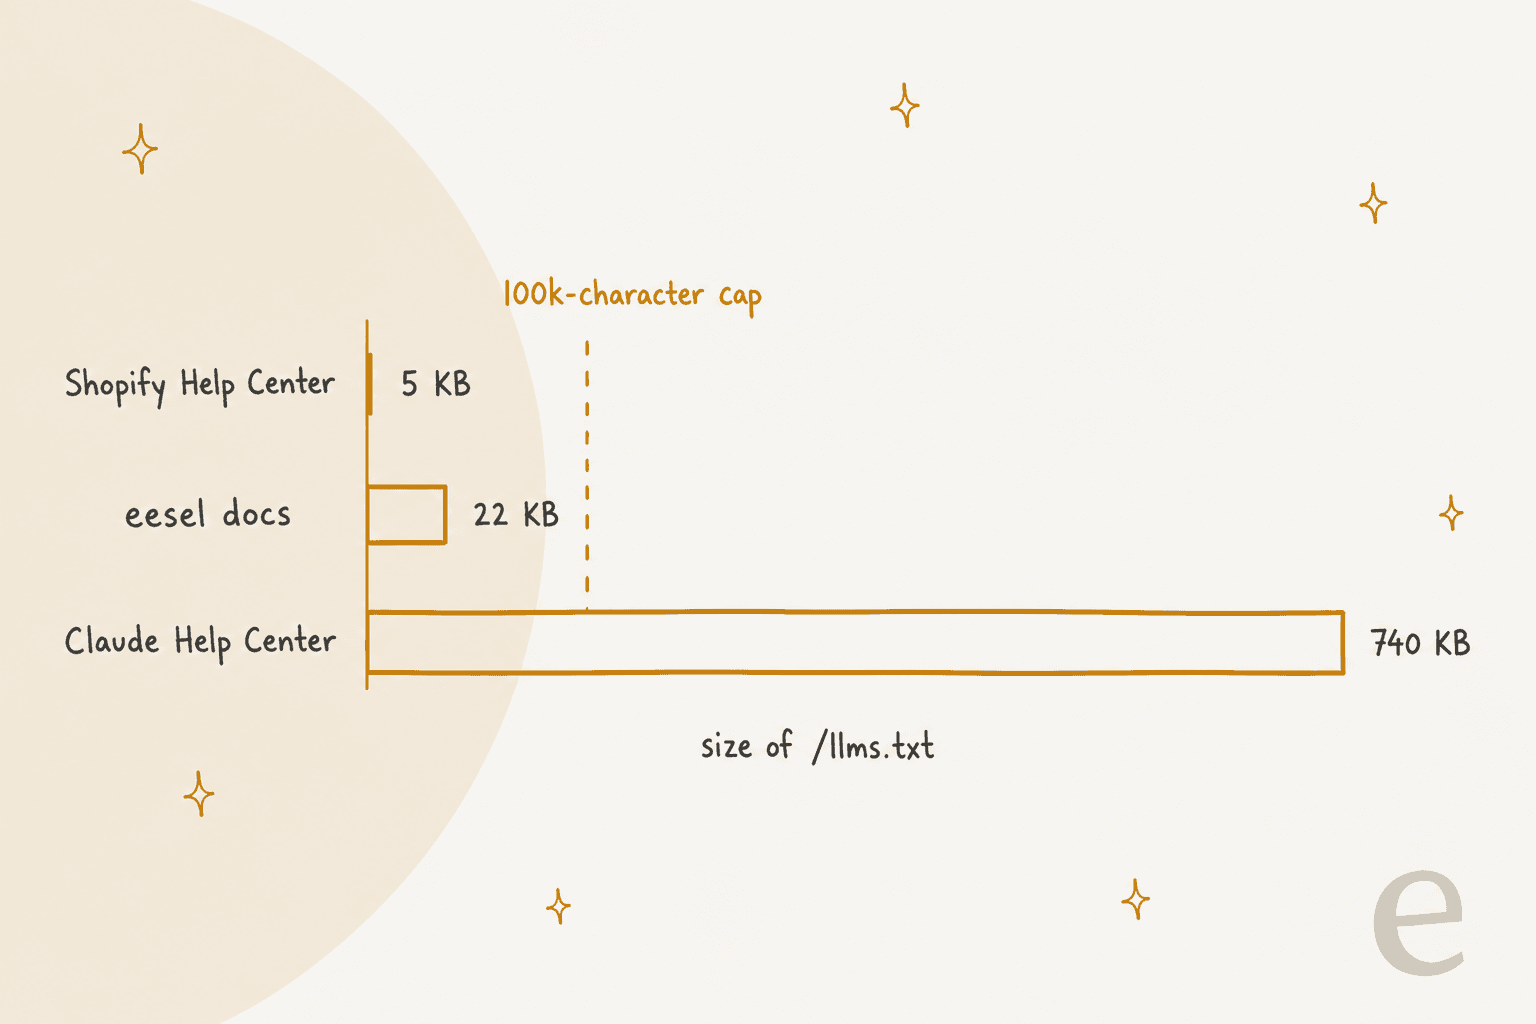
- Centre d'aide Claude : 740 Ko, 4 528 liens. Chaque article, répété sur plus de 10 sections de langue.
- Documentation propre d'eesel : 22 Ko, 86 liens, chacun avec une description d'une ligne. Elle est générée par GitBook et couvre tout le centre d'aide d'eesel, qui est petit parce que la documentation produit est petite.
- Centre d'aide Shopify : 5 Ko et aucune liste d'articles du tout. C'est un guide pour agents : comment obtenir n'importe quelle page en markdown, comment fonctionnent les URL, et où se trouve le sitemap markdown.
À titre de comparaison, Mintlify limite son llms.txt généré à 100 000 caractères avant de le diviser en index plus petits, selon sa documentation llms.txt. ReadMe propose une option « Summarize Index » pour la même raison, selon sa page AI Discoverability.
Ensuite il y a llms-full.txt, le fichier unique avec le texte intégral de chaque page. Il n'est pas du tout dans la spécification actuelle ; la page des changements dit que l'outillage d'expansion de contexte « is no longer part of the proposal. » GitBook et Mintlify en produisent quand même une, et celle d'eesel atteint 1,3 Mo. C'est utile pour un développeur qui veut télécharger votre documentation dans un dépôt, mais trop gros pour un agent qui essaie de répondre à une seule question de remboursement.
Ma règle générale : sous environ 100 articles, listez-les tous avec des descriptions. Au-delà, listez les 30 à 100 premiers par volume de tickets, et renvoyez vers votre sitemap dans ## Optional pour le reste, comme Shopify renvoie les agents vers son sitemap markdown. Pour trouver quels articles portent la charge, faire correspondre les requêtes de recherche et vérifier lesquels vos agents lient le plus est plus rapide que de deviner.
Comment garder llms.txt à jour ?
Un llms.txt obsolète est pire que pas de llms.txt du tout, parce qu'il envoie les agents avec confiance vers des articles déplacés ou supprimés. La quantité de travail dépend du chemin de configuration :
- Les fichiers générés se rafraîchissent eux-mêmes. Document360 et ReadMe reconstruisent à la publication, et Mintlify appelle sa version « always up to date. »
- Les fichiers personnalisés se figent. ReadMe dit sans détour qu'avec un fichier personnalisé « your llms.txt will no longer be updated automatically. » Mintlify restaure la version générée si vous supprimez la vôtre, donc vous pouvez toujours faire marche arrière.
- Les fichiers auto-hébergés ont besoin d'un calendrier. Comme tout processus de base de connaissances auto-actualisante, relancez l'extraction des articles mensuellement, ou chaque fois que vous réorganisez les catégories. Un petit job planifié qui compare la nouvelle liste à l'ancienne et signale les URL retirées attrape la plupart des casses.
À chaque régénération, vérifiez les liens. Cette ligne unique affiche toute URL du fichier qui ne renvoie pas un 200 :
grep -oE 'https://[^)]+' llms.txt | while read u; do
  code=$(curl -s -o /dev/null -w '%{http_code}' -L "$u"); [ "$code" != "200" ] && echo "$code $u"
done
Les articles déplacés sont généralement le coupable habituel. Les redirections de Zendesk pour les articles déplacés maintiennent les anciens liens fonctionnels pour les humains, mais un fichier sélectionné devrait pointer vers l'URL actuelle pour que l'agent ne gaspille pas un saut. Si les articles obsolètes sont un problème récurrent, mon guide pour détecter le contenu obsolète couvre comment les attraper avant qu'ils n'atteignent un lecteur quelconque, humain ou IA.
Pour les centres d'aide localisés, décidez par langue. Un centre d'aide multilingue peut avoir un fichier par langue, ou un fichier avec la langue par défaut et une note sur le fonctionnement des URL de langue, ce que fait Shopify.
Comment savoir si quelque chose le lit ?
Vérifiez vos journaux, parce que les tableaux de bord ne vous le diront pas. Filtrez les journaux de votre serveur web ou CDN pour les requêtes vers /llms.txt et regardez les agents utilisateurs. Deux des plateformes de documentation font cela pour vous : HelpDocs affiche les requêtes d'outils IA reconnus dans son onglet statistiques IA, et GitBook a un rapport Agents & MCP.
Ajustez vos attentes à partir de personnes qui ont déjà regardé :
"What I've seen from ASNs is that visits are coming from GOOGLE-CLOUD-PLATFORM (not from Google itself), and OVH. Based on UA, users are: WebPageTest, BuiltWith, and zero LLMs based on both ASN and UA."
Les visites qui méritent d'être comptées sont celles initiées par un utilisateur, comme le ChatGPT-User d'OpenAI, que sa documentation de robots décrit comme des visites déclenchées par une personne plutôt qu'une exploration automatique, plus les requêtes d'outils de codage. Ce sont les lecteurs pour qui llms.txt existe. Si le chiffre reste proche de zéro après un trimestre, c'est votre réponse pour ce centre d'aide, et l'heure est mieux investie dans les articles eux-mêmes, ou dans un serveur MCP, qui répond à des questions en direct plutôt que de remettre une liste statique.
Votre IA support a-t-elle besoin de llms.txt ?
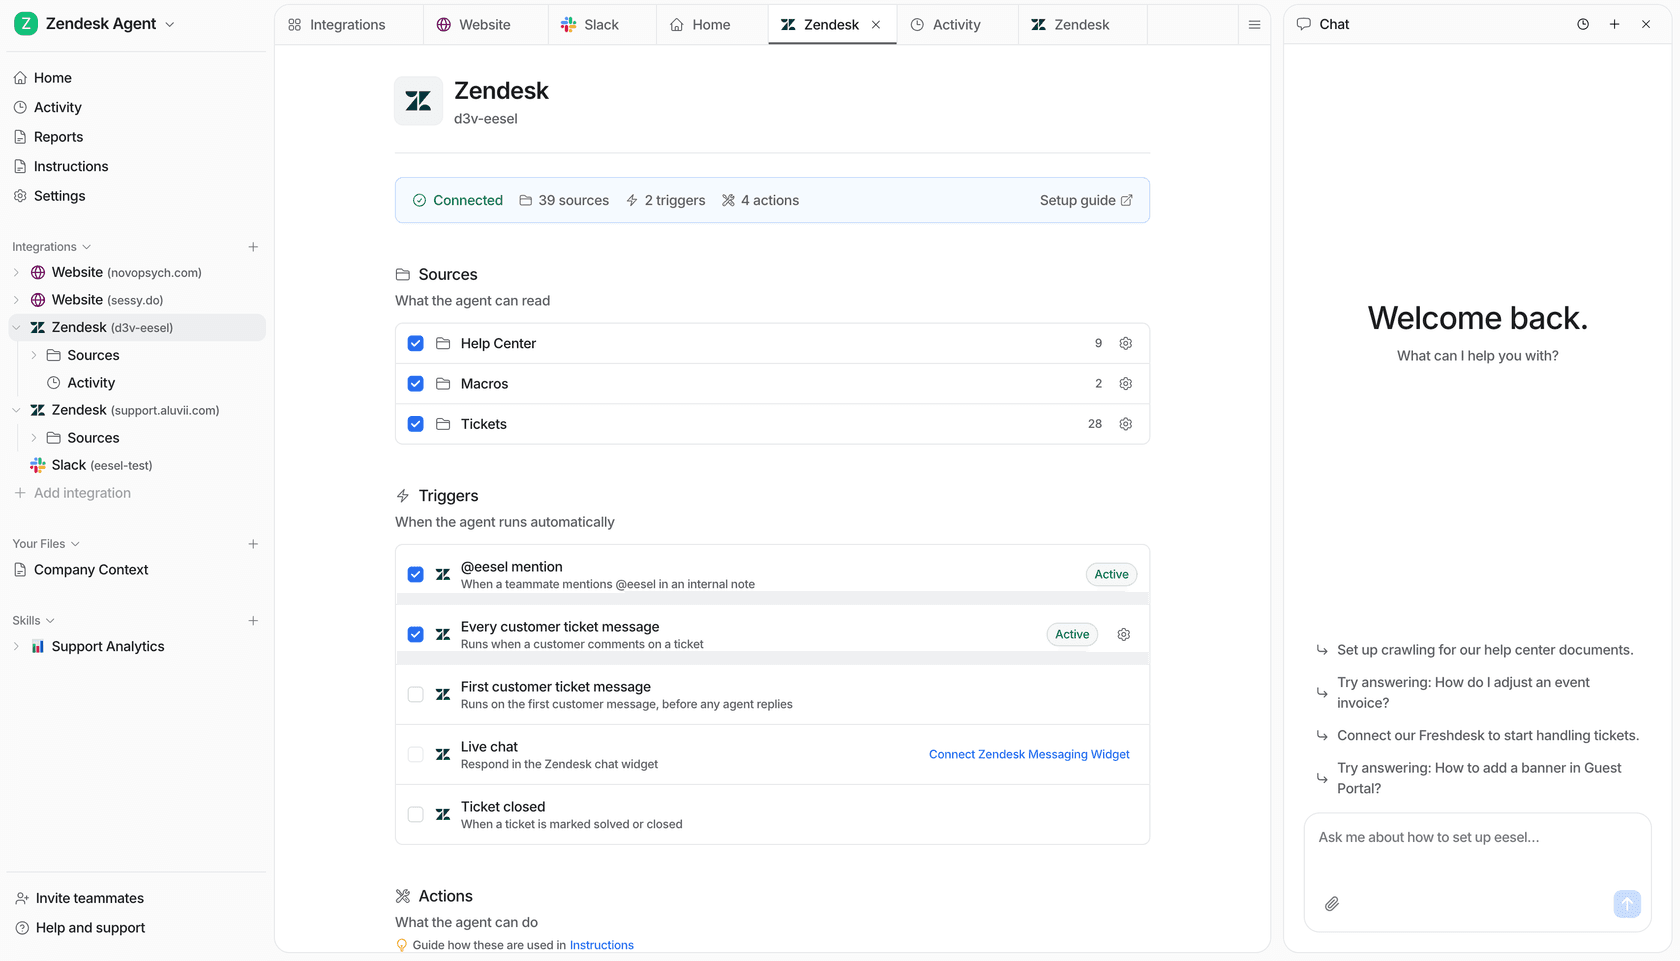
Pas si elle se branche sur votre helpdesk. llms.txt existe pour les agents externes qui n'ont que votre URL. Votre propre IA support ne devrait pas en être une : elle devrait lire chaque article public directement, plus les macros et anciens tickets qui n'arrivent jamais dans le centre d'aide.
C'est comment fonctionne le coéquipier IA helpdesk d'eesel. Il se connecte à Zendesk, Freshdesk, Help Scout, HubSpot ou Gorgias, synchronise le centre d'aide comme source de connaissances, et rédige ou envoie des réponses avec l'article utilisé lié. Dokument 24, un service danois de documents juridiques sur Zendesk, le fait fonctionner sur environ 1 900 pages de son site et 640 tickets et articles Zendesk, et entre le 8 août et le 8 septembre 2026 il a préparé environ 680 tickets avec des brouillons de réponse en danois pour que l'équipe les envoie.
Ce que llms.txt ne peut pas corriger, c'est ce que disent les articles. Lors d'un appel commercial d'eesel dont j'ai tiré une leçon, une équipe danoise de télématique automobile sur Zendesk a décrit un bot confirmant un support pour des marques de voitures qu'ils ne supportaient pas, parce qu'un article disait qu'ils supportaient « tous les modèles ». Un llms.txt parfaitement sélectionné aurait pointé droit vers cet article. La correction, c'était la phrase, pas l'index, c'est pourquoi un audit de base de connaissances l'emporte généralement sur un nouveau fichier. Si vous pesez RAG contre fine-tuning pour votre centre d'aide, le même point s'applique : la récupération ne renvoie que ce que l'article dit.
eesel : laissez votre centre d'aide répondre aux tickets
Si l'IA qui vous préoccupe le plus est celle qui répond à vos clients, commencez par là. Le coéquipier helpdesk d'eesel apprend de votre centre d'aide le jour où vous le connectez, sans llms.txt requis, et vous montre quels articles produisent des brouillons faibles. Une entreprise d'automatisation industrielle a placé sa bibliothèque technique derrière un chat eesel qui répond uniquement à partir des documents, et les lacunes dans ces réponses vont maintenant directement dans le carnet de l'équipe de documentation. C'est la boucle qui rend un centre d'aide meilleur pour chaque lecteur, IA ou humain.
Les développeurs peuvent le configurer sans le tableau de bord. Avec la CLI eesel, un agent de codage peut uploader un fichier de politique approuvé avec eesel files upload, vérifier ce que contient la synchronisation du centre d'aide, et poser des questions de test avec eesel chat avant que quoi que ce soit n'atteigne un client. Connecter le helpdesk lui-même a encore besoin que quelqu'un avec un accès admin l'approuve. Essayez eesel gratuitement pendant 7 jours et passez vos dix derniers tickets à travers.
Comment ajouter llms.txt à un centre d'aide Zendesk ?
/llms.txt, et le mappage d'hôte ne change que le nom d'hôte. Générez la liste depuis l'API du centre d'aide (un appel anonyme ne renvoie que les articles publics) ou l'application gratuite KnowledgeBridge du Marketplace, puis hébergez-la sur votre site principal avec un lien depuis votre centre d'aide. Mon guide de l'API des articles détaille l'appel de liste.