

En bref
Claude Opus 5.5 est le modèle le plus intelligent. GPT-6 Sol est le moins cher. Les deux sont sortis le 22 septembre 2026. Dans la comparaison d'Artificial Analysis, Opus 5.5 obtient 58 à l'Intelligence Index contre 48 pour Sol, et il mène sur GDPval-AA, Terminal-Bench 4.0 et AutomationBench. Sol coûte moitié moins par token : 2 $/10 $ par million contre 4 $/20 $.
L'étiquette dit qu'Opus coûte le double. À effort maximal, il a coûté 5,6 fois plus par tâche terminée (5,98 $ contre 1,06 $), parce qu'il a écrit près de quatre fois plus de tokens de sortie. Si on les compare à coût équivalent plutôt qu'à étiquettes d'effort équivalentes, le tableau s'inverse encore : Opus 5.5 à effort medium bat Sol à max, 51 contre 48, pour 1,34 $ la tâche contre 1,06 $.
Mon choix : Sol pour le travail courant à gros volume où la réponse est bien définie. Opus 5.5 en medium pour les tâches difficiles, longues et agentiques où une mauvaise réponse coûte plus cher que les tokens. Si le travail consiste à répondre aux clients, le modèle compte moins que le système qui l'entoure, ce que gère un coéquipier de helpdesk IA comme eesel, facturé par ticket résolu plutôt que par token.
Deux lancements, un après-midi
Je construis des agents IA chez eesel, et chaque sortie d'un modèle de pointe signifie pour moi le même rituel : relancer mes évaluations, regarder le coût par tâche terminée et décider quel travail passe sur le nouveau modèle. Cette semaine, le rituel est venu deux fois de suite. Anthropic a lancé Claude Opus 5.5 le 22 septembre, et OpenAI a suivi en quelques heures avec GPT-6 Sol et Luna.
Ce calendrier compte pour lire les annonces. Le tableau de benchmarks d'Anthropic compare Opus 5.5 à GPT-5.6 Sol et à GPT-6 Astra, car GPT-6 Sol n'existait pas encore. Le tableau d'OpenAI compare Sol à Claude Opus 5 et à Claude Fable 5.1, pas à Opus 5.5. Aucun des deux éditeurs n'a mesuré le nouveau modèle de l'autre. Pour un duel équitable, je m'appuie donc sur les tests indépendants d'Artificial Analysis, qui a fait passer les deux dans le même banc d'essai.
Sont-ils seulement de la même catégorie ? Certains lecteurs pensent que non, puisque Sol coûte moitié moins. Un commentateur de HN a exprimé clairement l'avis inverse :
"Sol is OpenAI's Opus, and Astra is OpenAI's Fable. Both pricing-wise, and performance-wise."

Je suis d'accord avec cette équivalence. Chacun est le modèle « à utiliser par défaut » de son éditeur, un cran sous le modèle phare. C'est précisément pourquoi les développeurs hésitent entre les deux cette semaine.
Ce qu'est chaque modèle
GPT-6 Sol
GPT-6 Sol est le milieu de la famille GPT-6 d'OpenAI, entre le modèle économique GPT-6 Luna et le modèle phare Astra. La formule d'OpenAI est « Build with Sol. Scale with Luna. » Le titre, c'est le prix : 2 $ en entrée et 10 $ en sortie par million de tokens, une baisse nette de 50 % par rapport à GPT-5.6 Sol. Artificial Analysis situe son intelligence à peu près au niveau de GPT-5.6 Sol, avec le vrai gain de qualité sur la fiabilité factuelle.
La page du modèle liste six réglages de raisonnement de none à max, avec medium par défaut, et tout l'ensemble d'outils de la Responses API : recherche web et de fichiers, interpréteur de code, shell hébergé, utilisation de l'ordinateur et MCP.
Claude Opus 5.5
Claude Opus 5.5 est la passe d'efficacité d'Anthropic sur Opus 5. C'est le premier Opus à baisser de prix, 20 % de moins, à 4 $/20 $, et Anthropic recommande désormais de commencer par lui pour la plupart des travaux au lieu de traiter Opus comme le dernier recours haut de gamme. L'effort par défaut est passé de high à medium, la réflexion est toujours active et la documentation d'Opus 5.5 indique une date limite en juin 2026.
Anthropic le positionne au niveau de qualité de Fable 5.1 sur la plupart des tâches. Artificial Analysis le classe actuellement n° 1 sur 212 modèles sur son Intelligence Index.
Caractéristiques et prix côte à côte
La plupart de la fiche technique est un match nul. La différence se situe presque entièrement dans la colonne des prix.
| GPT-6 Sol | Claude Opus 5.5 | |
|---|---|---|
| ID du modèle dans l'API | gpt-6-sol | claude-opus-5-5 |
| Entrée / sortie par 1M de tokens | 2 $ / 10 $ | 4 $ / 20 $ |
| Lectures de cache par 1M | 0,20 $ | 0,20 $ |
| Batch API | 50 % de remise (1 $ / 5 $) | 50 % de remise (2 $ / 10 $) |
| Surcoût contexte long | 2x en entrée, 1,5x en sortie au-delà de 272K | Aucun |
| Fenêtre de contexte | 1 050 000 tokens | 1M de tokens |
| Sortie maximale | 128 000 tokens | 128K (300K en bêta Batch) |
| Date limite de connaissances | 20 avril 2026 | Juin 2026 |
| Effort par défaut | Medium | Medium |
| Raisonnement désactivable | Oui (none) | Non, réflexion toujours active |
| Entrée / sortie | Texte + image en entrée, texte en sortie | Texte + image en entrée, texte en sortie |
Deux lignes méritent l'attention. D'abord, les lectures de cache coûtent pareil des deux côtés. Si votre charge est un gros prompt système stable plus de courtes questions, une grande part de votre facture d'entrée est identique. Ensuite, la ligne du contexte long. Au-delà de 272K tokens d'entrée, le prix d'entrée de Sol double, donc sur les tâches à contexte énorme l'écart du simple au double se referme vite. Comme l'a noté un utilisateur de HN :
"Once you exceed 272K input tokens, Codex Sol is roughly the same price as Opus; and Astra similar to Fable."
Pour les grilles tarifaires complètes, y compris le mode Fast et les prix régionaux, voyez mon décryptage des tarifs de GPT-6 Sol et son équivalent pour Opus 5.5. La comparaison plus large API OpenAI vs API Anthropic couvre les deux plateformes.
Les benchmarks : Opus 5.5 gagne presque toutes les lignes
Artificial Analysis a fait tourner les deux à effort maximal dans le même banc d'essai. C'est le duel le plus propre disponible actuellement.
| Benchmark (Artificial Analysis, effort maximal) | GPT-6 Sol | Claude Opus 5.5 |
|---|---|---|
| Intelligence Index | 48 | 58 |
| GDPval-AA v2.1 (Elo, tâches de travail réelles) | 1487 | 1846 |
| AA-Briefcase v1.1 (Elo) | 1483 | 1822 |
| AutomationBench-AA | 62 % | 70 % |
| Terminal-Bench 4.0 | 44 % | 60 % |
| SciCode | 58 % | 67 % |
| Humanity's Last Exam | 48 % | 61 % |
| AA-LCR (raisonnement en contexte long) | 84 % | 85 % |
| CritPt | 31 % | 32 % |
| AA-Omniscience Index | 27 | 46 |
| Taux d'hallucination (plus bas = mieux) | 60 % | 58,6 % |
Les gros écarts se trouvent sur le travail qui ressemble le plus à un vrai métier : GDPval-AA de 359 points Elo, Terminal-Bench de 16 points et l'Intelligence Index de 10. Les petits écarts sont aussi parlants. Le raisonnement en contexte long et CritPt sont à un point, et les taux d'hallucination sont presque identiques. La forte amélioration de Sol sur la fiabilité factuelle par rapport à GPT-5.6 le met au niveau d'Opus sur le taux d'hallucination, même si Opus en sait toujours plus, avec 46 contre 27 sur l'Omniscience Index.
Quelques réserves honnêtes sur les chiffres. Anthropic annonce Opus 5.5 à 66,4 % sur Terminal-Bench 4.0 avec son propre dispositif en xhigh, plus que les 60 % mesurés par Artificial Analysis ; pour comparer à Sol, la paire indépendante est plus équitable. Les chiffres OSWorld 2.0 des deux éditeurs (60,5 % pour Sol, 81,8 % pour Opus) utilisent des jeux de test différents, donc je n'y lirais pas d'écart. Et il n'y a pas encore de score d'Opus 5.5 sur DeepSWE, où Sol affiche 68,8 % et 69,0 % dans Codex sur le Coding Agent Index.
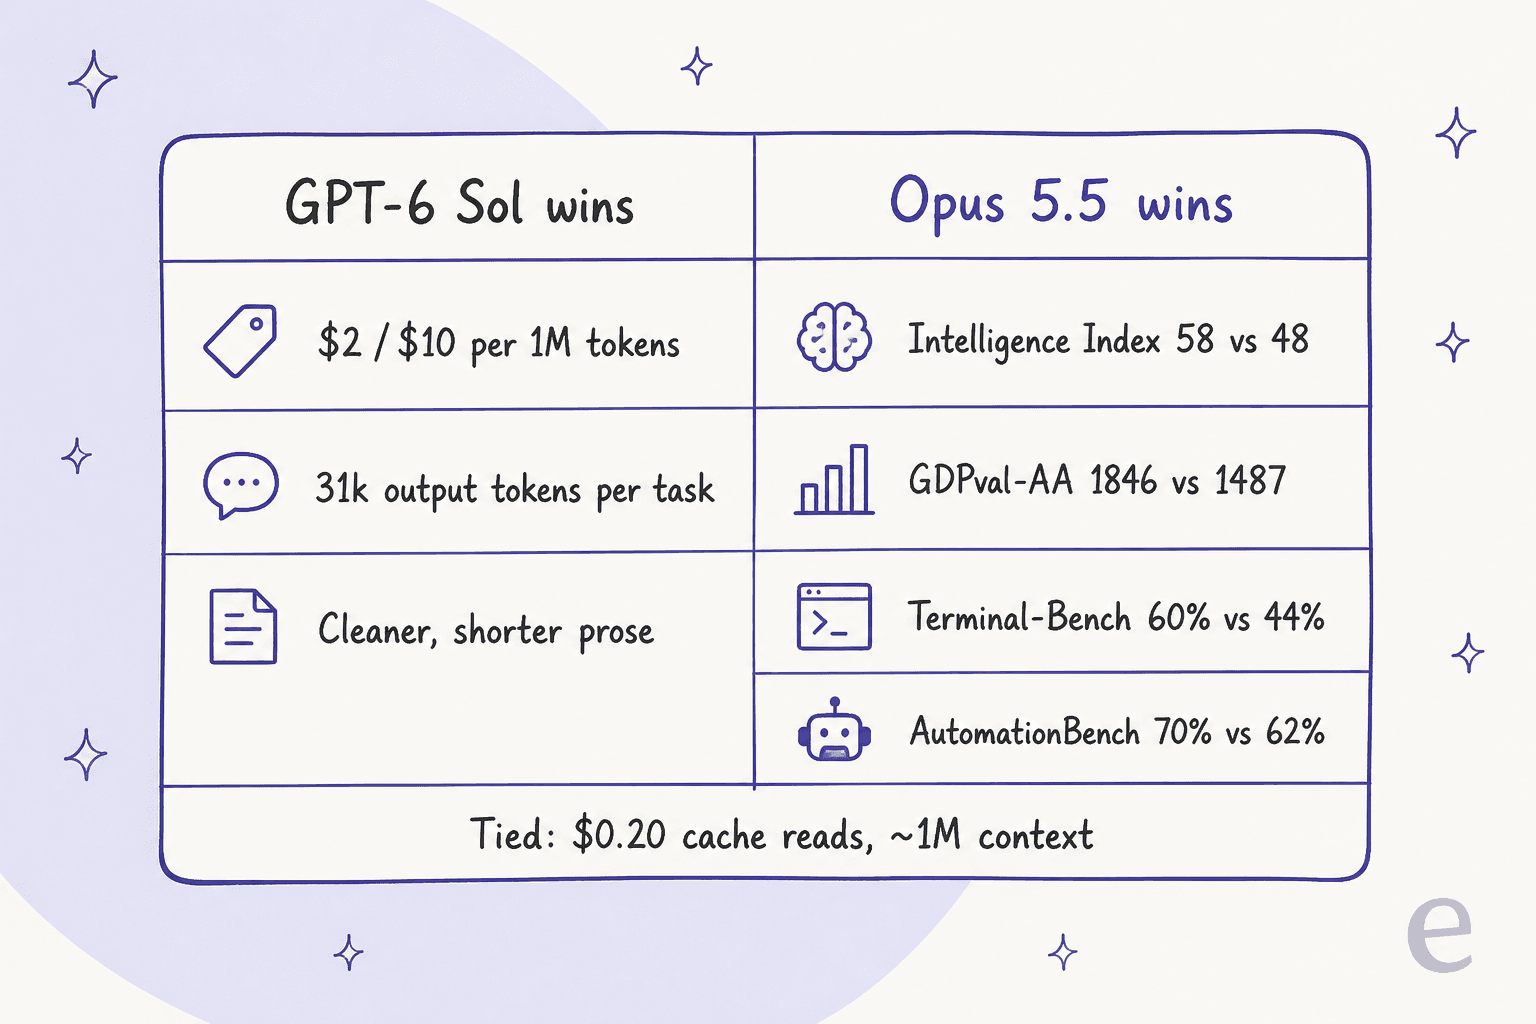
Le motif de ce tableau de score résume toute l'histoire en une image : Opus 5.5 gagne les lignes de capacité, Sol gagne les lignes de coût. Laquelle compte le plus dépend de ce que vous coûte une erreur.
Ce que la plupart des comparatifs oublient : le coût par tâche, pas par token
Le prix par token est le chiffre de la page tarifaire. Le coût par tâche terminée est le chiffre de votre facture. Ils peuvent être très différents, car les modèles dépensent des quantités de tokens très différentes pour arriver à une réponse.
Sur l'indice Artificial Analysis, à effort maximal :
| Par tâche, effort maximal | GPT-6 Sol | Claude Opus 5.5 |
|---|---|---|
| Tokens de sortie par tâche | ~31k | ~119k |
| Coût par tâche | 1,06 $ | 5,98 $ |
| Coût total pour exécuter tout l'indice | 1 550 $ | 8 708 $ |
L'écart de 2x de l'étiquette devient donc un écart de 5,6x par tâche à max. C'est une surprise, puisque l'argument d'Opus 5.5 est l'efficacité. L'affirmation d'efficacité est réelle face à Opus 5 au même effort, mais à effort maximal Opus 5.5 réfléchit beaucoup. Artificial Analysis a mesuré qu'il utilise plus de tokens de sortie par tâche qu'Opus 5, Fable 5.1 ou GPT-6 Astra :
"Opus 5.5 (max) uses ~119k output tokens per Intelligence Index task, against ~73k for Opus 5 (max), ~78k for Fable 5.1 (max) and ~27k for GPT-6 Astra (max)"
C'est ici que ça rebascule. Les étiquettes d'effort ne veulent pas dire la même chose d'un éditeur à l'autre, donc comparer « max contre max » n'est pas vraiment équitable. Alignez-les plutôt par coût, en utilisant les chiffres par niveau d'effort des pages de sortie d'Artificial Analysis pour chaque modèle :
| Effort | GPT-6 Sol score / coût par tâche | Opus 5.5 score / coût par tâche |
|---|---|---|
| low | 34 / 0,13 $ | 42 / 0,55 $ |
| medium | 40 / 0,25 $ | 51 / 1,34 $ |
| high | 43 / 0,37 $ | 54 / 1,82 $ |
| xhigh | 44 / 0,53 $ | 56 / 3,46 $ |
| max | 48 / 1,06 $ | 58 / 5,98 $ |
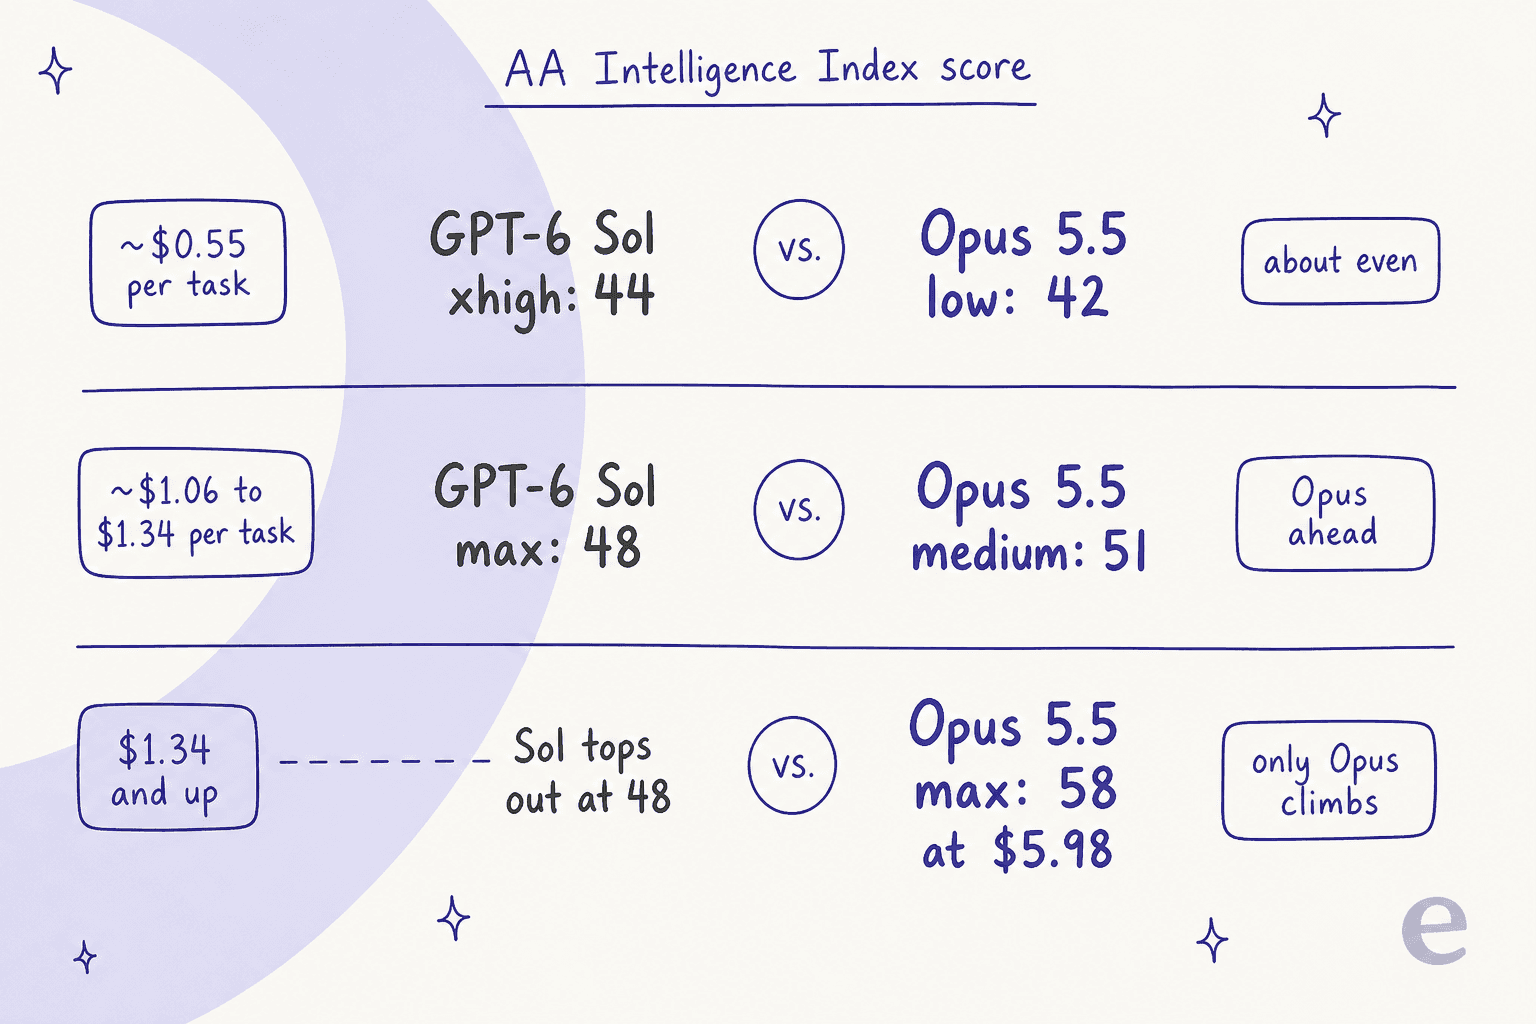
Lisez le tableau ainsi :
- Sous environ 0,55 $ par tâche, ils sont à égalité. Sol en xhigh (44) et Opus en low (42) coûtent presque pareil. En dessous, seul Sol descend encore : 40 points pour un quart de dollar.
- Autour d'un dollar par tâche, Opus prend l'avantage. Opus 5.5 en medium obtient 51 pour 1,34 $, trois points au-dessus du meilleur effort de Sol pour environ 26 % d'argent en plus.
- Au-delà, seul Opus continue de grimper. Le plafond de Sol est 48. Si vous avez besoin de plus, Opus est le seul des deux à l'avoir, jusqu'à 58.
Cela rejoint ce que les premiers utilisateurs ont dit. Un commentateur de HN :
"I personally am preferring Opus 5.5 at medium over GPT-6 Sol Max, in very very early tests. Similar price range, more capability."
Une réponse a objecté que l'appariement plus juste est Opus medium contre Sol high. Dans cet appariement, Sol coûte 0,37 $ par tâche contre 1,34 $ pour Opus, donc la question devient : 8 points de plus valent-ils une facture 3,6 fois plus élevée ? Pour le travail en masse, en général non. Pour une exécution agentique difficile où un échec signifie de recommencer, souvent oui.
Envie de voir ce que cela donne à votre volume ? Saisissez vos chiffres. Les coûts viennent des résultats par tâche d'Artificial Analysis, considérez-les donc comme un repère relatif : vos tâches seront plus courtes ou plus longues que les leurs.
Ce qu'ils donnent au quotidien
Les benchmarks donnent le plafond. L'usage quotidien dit à quoi ressemble l'expérience par défaut, et ici les premiers retours se séparent selon une ligne claire.
Le retour pratique le plus utile à ce jour vient de Dan Shipper chez Every, qui a testé les deux sur du vrai travail. En programmation, il a donné l'avantage à Opus :
"Sol improves on GPT-5.6—including better Ruby code in @kieranklaassen tests—but Opus 5.5 has the higher ceiling for long, autonomous builds."
Dans le même post, il a trouvé l'écriture de Sol plus propre, avec l'idée importante en premier, alors que les brouillons d'Opus 5.5 ont encore tendance à enterrer l'essentiel. Son verdict dépend du travail : Sol pour une journée passée à « reading, writing, and getting things done » dans Codex, Opus 5.5 quand vous « hand an agent a hard coding or visual project and see how far it can take it. »
Le comportement diffère aussi. Sol a tendance à en faire plus que ce que vous avez demandé ; Claude a tendance à faire ce que vous avez demandé et à s'arrêter. Un développeur de HN a décrit le côté OpenAI de façon imagée :
"OpenAI models are also much more eager than Anthropic, which are on the lazier side. Left unsupervised, Sol/Astra will attempt to build a sha256 verified rocket ship if you ask them to fix a race condition in your to-do list app."
La verbosité est la question ouverte sur Opus 5.5. Certains utilisateurs disent qu'il se lit enfin clairement, d'autres qu'il est aussi bavard qu'Opus 5. Les nombres de tokens ci-dessus suggèrent que les deux peuvent être vrais : réponses visibles courtes, longue réflexion cachée à effort élevé. Si c'est cette réflexion que vous payez, réglez le curseur d'effort volontairement plutôt que de le laisser sur max.
Les limites d'abonnement sont également contestées. Sur HN, un utilisateur a dit qu'une semaine de Codex avait tenu un à deux jours d'usage semi-intensif avec un seul agent sur Sol High, tandis qu'un autre a dit que Codex gagne sur l'usage « by a mile ». Si vous vivez dans Claude Code ou Codex plutôt que dans l'API, testez votre propre semaine avant de changer de forfait.
Lequel utiliser ?
Voici comment je répartirais le travail, d'après les chiffres ci-dessus.
| Si votre travail est... | Utilisez | Pourquoi |
|---|---|---|
| Classification, extraction, routage à gros volume | GPT-6 Sol en low ou medium | 40 points pour 0,25 $ la tâche, et on peut désactiver complètement le raisonnement |
| Rédaction courante, résumés, réponses courtes | GPT-6 Sol | Moins cher par tâche, prose plus propre d'après les premiers retours |
| Longues exécutions de code autonomes, agents en plusieurs étapes | Claude Opus 5.5 en medium | Bat le meilleur score de Sol pour environ 26 % de plus par tâche |
| Le raisonnement le plus difficile où une erreur coûte cher | Claude Opus 5.5 en high ou max | Seule option qui dépasse 48 |
| Très grand contexte (plus de 272K tokens) | Claude Opus 5.5 | Pas de surcoût contexte long, donc l'écart de prix disparaît en grande partie |
| Gros prompts stables, beaucoup de succès de cache | L'un ou l'autre | Les lectures de cache coûtent 0,20 $ des deux côtés |
L'erreur que j'éviterais est d'en choisir un pour tout. Les deux éditeurs facilitent désormais le routage, et les courbes de coût disent que la réponse bonne la moins chère vient de Sol en bas de gamme et d'Opus en haut. Si vous êtes déjà dans l'écosystème OpenAI, GPT-6 Luna vaut un coup d'œil pour le palier très économique. Côté Anthropic, Claude Sonnet 5 joue le même rôle, comme le montre mon décryptage Opus 5 vs Sonnet 5.
Pour une vue plus large, la liste des modèles OpenAI couvre le reste de la gamme d'OpenAI, et mon guide des tarifs de l'API Anthropic fait de même pour Claude.
Si le modèle doit répondre à vos clients
Beaucoup de gens qui comparent ces deux modèles posent en réalité une autre question : lequel doit propulser notre bot de support ? Ici, l'écart de benchmarks compte moins qu'on ne le croit.
Un modèle de pointe est une infrastructure. Pour résoudre un ticket, il lui faut aussi votre centre d'aide et vos anciens tickets pour fonder ses réponses, des actions dans votre helpdesk (étiqueter, router, rembourser, consulter une commande), des garde-fous pour savoir quand passer la main, et un moyen de tester tout cela avant que de vrais clients ne le voient. Cette dernière partie est celle où la plupart des bots maison échouent. Chez eesel, j'ai vu des réponses d'apparence assurée se révéler fausses en test, c'est pourquoi eesel simule chaque déploiement sur des tickets historiques avant sa mise en ligne.
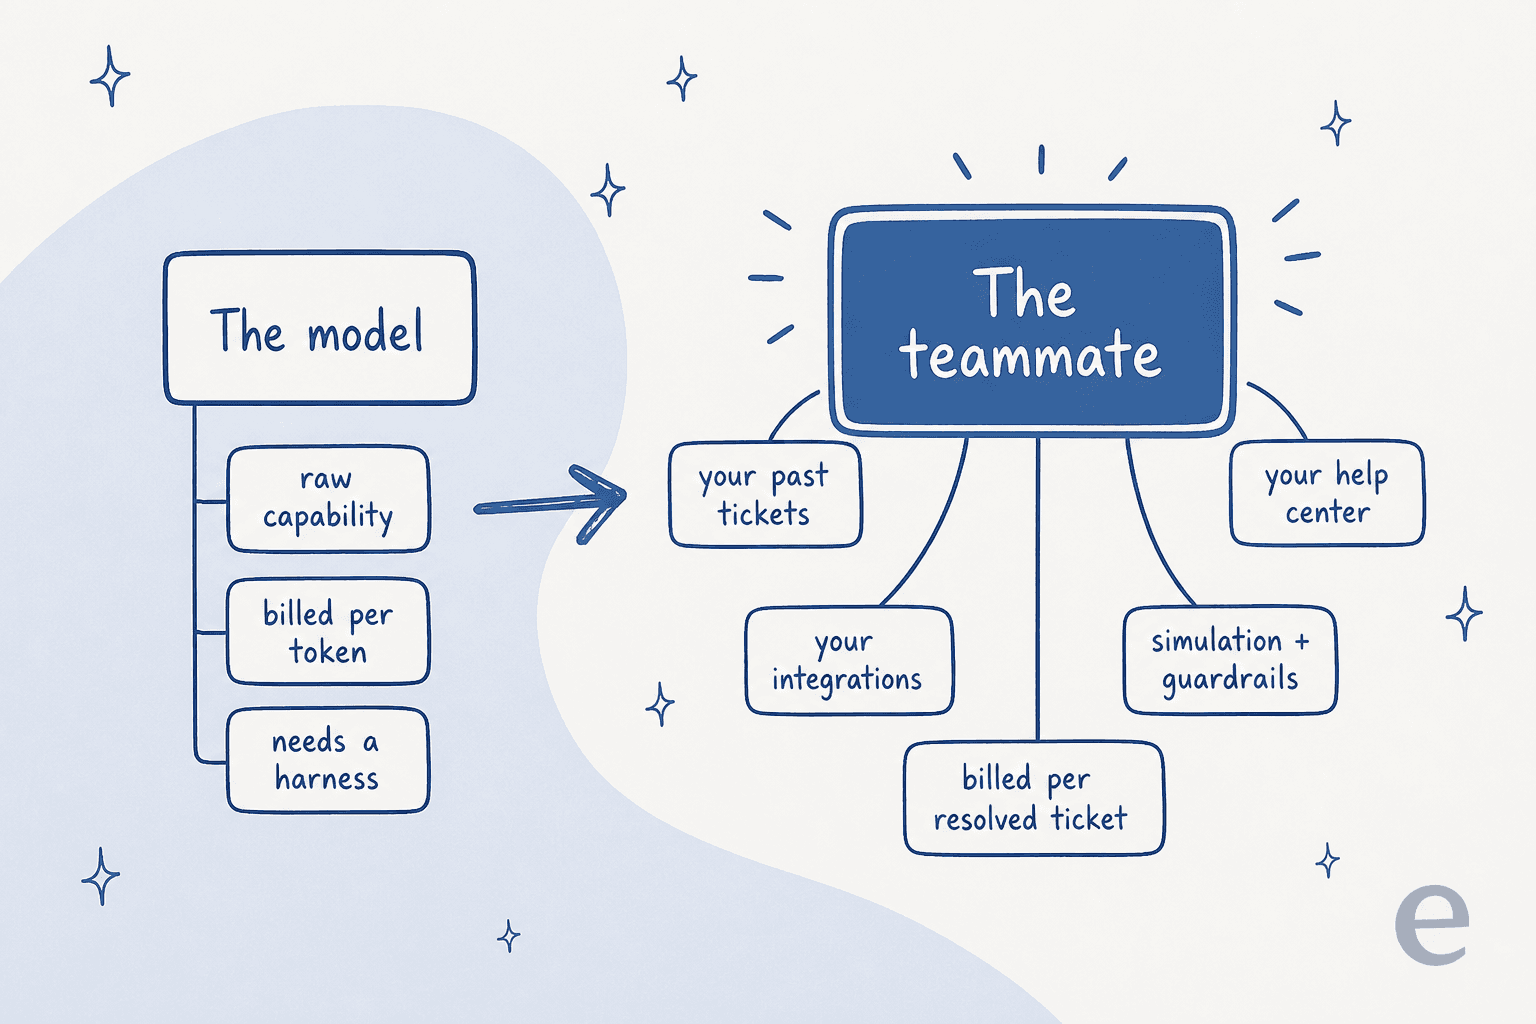
C'est pourquoi je vois eesel comme l'employé et le modèle comme le moteur. Le coéquipier de helpdesk IA se branche sur des outils comme Zendesk, Freshdesk et Gorgias, apprend de vos anciens tickets et facture par ticket résolu plutôt que par token, donc le calcul de tokens Sol contre Opus n'est pas votre problème.
Si vous voulez d'abord comparer les options, mon panorama des meilleurs logiciels de helpdesk IA est un bon point de départ, et ce décryptage du coût IA vs humain montre le calcul par ticket.
Pour le lecteur technique arrivé sur cet article via une comparaison de modèles : le même coéquipier est aussi scriptable. La CLI eesel (npm i -g @eesel/cli) vous permet de connecter des intégrations, de modifier les instructions permanentes de l'agent, de lire chaque exécution avec eesel activity et d'approuver ou de refuser les actions en attente depuis le terminal. Chaque commande affiche du JSON et prend en charge --dry-run, donc Claude Code ou Codex peuvent la piloter. Chaque espace de travail est aussi un serveur MCP, de sorte que vous pouvez gérer des agents IA depuis votre terminal avec celui de ces deux modèles que vous choisirez.
Essayer eesel
Si vous comparez GPT-6 Sol à Opus 5.5 parce que vous voulez une IA qui répond aux tickets de support, vous pouvez sauter le duel de modèles. Le coéquipier de helpdesk IA d'eesel rejoint votre helpdesk existant, apprend de vos anciens tickets et de votre centre d'aide, et est testé sur votre historique réel de tickets avant de répondre à un seul client. Vous payez par ticket résolu, pas par token.

Essayez eesel gratuitement et voyez-le tourner sur vos propres tickets.