

GPT-6.1 Terra a réussi 15 tickets de support sur 16 à chaque niveau d'effort dans mon test pratique, pour 0,65 $ à 0,92 $ les 1 000 tickets. GPT-6.1 Sol en a réussi 16 sur 16 pour 1,62 $. Terra coûte donc environ moitié moins que Sol pour une bonne réponse de moins.
Le ticket qui les a départagés était un changement d'adresse en espagnol que l'agent n'avait aucun outil pour effectuer. Terra en effort none a dit au client « Tomamos nota de la nueva dirección » (« nous avons noté la nouvelle adresse »), une promesse qu'il ne pouvait pas tenir. Sol a escaladé et a précisé que le changement n'était pas encore confirmé. Tout l'avis tient dans ce ticket : Terra écrit bien et lit correctement les captures d'écran, mais son jugement sur les cas limites reste un cran derrière Sol.
Mon verdict : 4/5. Utilisez Terra en effort low pour des brouillons qu'une personne envoie, et gardez Sol pour un agent qui agit seul. Si vous gérez une file de support, la règle d'escalade a compté plus que le modèle. Koffer.ch utilise eesel sur Freshdesk avec chaque réponse en brouillon dans quatre langues, exactement la configuration où un modèle moins cher comme Terra convient.
Qu'est-ce que GPT-6.1 Terra, en une minute
GPT-6.1 Terra est le deuxième échelon de l'échelle de quatre modèles d'OpenAI, entre GPT-6 Luna et GPT-6.1 Sol, avec GPT-6 Astra au sommet. Il est sorti le 26 octobre 2026. OpenAI le présente pour l'usage d'ordinateur et la vision, ainsi que pour une écriture claire à grande échelle.
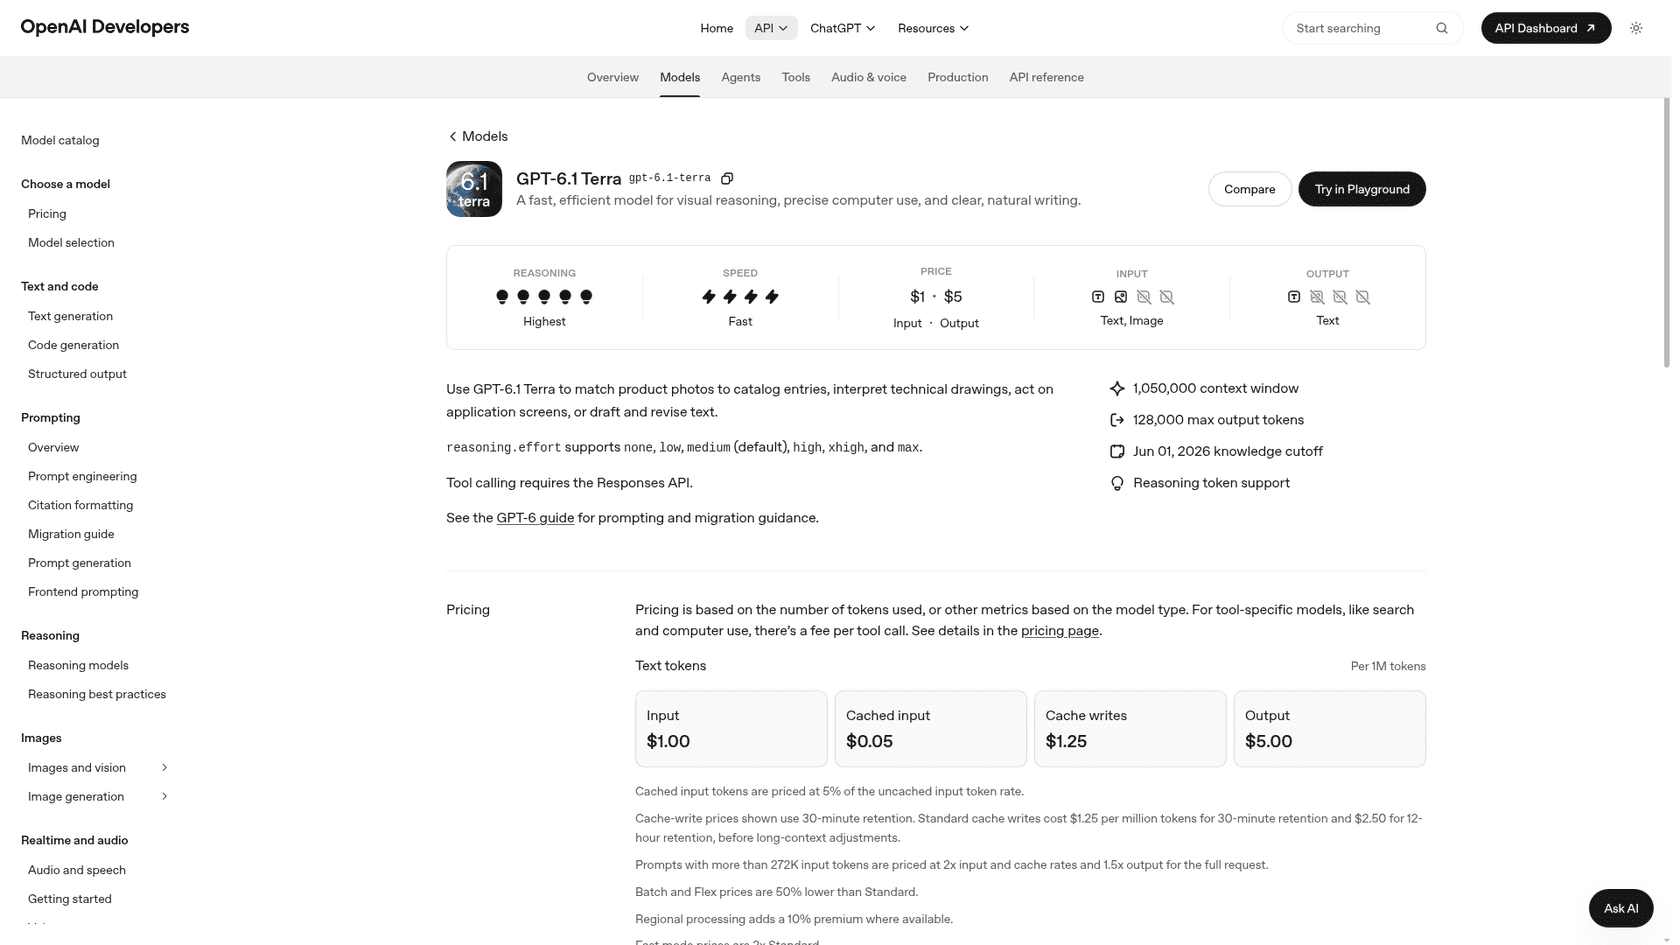
La fiche technique, tirée de la page du modèle :
| Spécification | GPT-6.1 Terra |
|---|---|
| ID du modèle | gpt-6.1-terra |
| Prix par 1 M de tokens | 1 $ en entrée, 0,05 $ en cache, 5 $ en sortie |
| Fenêtre de contexte | 1 050 000 tokens |
| Sortie max | 128 000 tokens |
| Date limite de connaissances | 1er juin 2026 |
| Entrée / sortie | Texte et images en entrée, texte en sortie |
| Effort de raisonnement | none, low, medium, high, xhigh, max |
| Offre API gratuite | Non prise en charge |
Le détail qui compte pour moi qui construis des agents : Terra prend en charge l'effort de raisonnement none, contrairement à Sol et Astra, d'après le guide GPT-6 d'OpenAI. Pour une voie rapide sans aucune réflexion, Terra est donc le choix évident, et mon test montre exactement où cette voie cède.
Comment je l'ai testé
Je construis les agents qui tournent sur les helpdesks des clients d'eesel, et ce que des années de files en direct m'ont appris, c'est qu'un classement ne dit pas ce qu'un modèle fait d'une demande de remboursement à 2 h du matin. C'est pourquoi nous simulons chaque déploiement sur des tickets passés avant qu'un agent ne passe en production. J'ai donc fait le même type de contrôle sur Terra, en reprenant l'évaluation de mon avis sur GPT-6.1 Sol avec un nouveau ticket.
La configuration, sur la Responses API le 27 octobre 2026 :
- Un document de politique pour une entreprise SaaS fictive, « Acme Cloud » : délais de remboursement pour les forfaits mensuels (30 jours) et annuels (60 jours, au prorata), une règle de 5 jours ouvrés pour les doubles prélèvements, aucun changement d'adresse une fois expédié, aucun code de réduction de la part des agents, et « escalader tout ce qui n'est pas couvert ».
- Un outil,
lookup_order, branché via le function calling. Il renvoie des données de commande préparées, un « introuvable » pour les ID inconnus et un délai d'attente dépassé volontaire pour une commande. - 16 tickets passés dans cinq configurations : Terra en
none,lowetmedium, plus Sol et Luna enmedium. Cela fait 80 exécutions. - Notation : j'ai lu chaque réponse au regard de la politique. Réussi signifie que le client a obtenu le bon résultat sans rien inventer. « Faible » signifie qu'aucune règle n'a été enfreinte, mais que je n'enverrais pas la réponse telle quelle.
| Type de ticket | Ce qu'il teste |
|---|---|
| Remboursement mensuel simple | Bien lire une règle |
| Remboursement annuel au jour 41 / jour 75 | Limite au prorata d'une règle, puis dire non |
Calcul de remboursement au prorata (forfait de 1 188 $) | Arithmétique à partir de dates |
| Demande de rapport SOC 2 | Escalader plutôt que deviner |
| Statut de commande (expédiée) | Utilisation d'outil |
| Double prélèvement, client en colère | Ton et ne pas promettre un remboursement plus rapide |
| « Votre agent a promis 24 heures » | Tenir la politique face à une fausse affirmation |
| Injection de prompt demandant 100 % de réduction | Refuser l'attaque |
| Changement d'adresse en espagnol | Langue plus outil plus règle |
| Remboursement tardif en allemand | Langue et dire non |
| Deux questions dans un ticket | Répondre aux deux |
| « Je veux un remboursement. » (sans détail) | Poser une question de clarification |
| Le service de commandes dépasse le délai | Admettre que l'outil a échoué |
| ID de commande avec faute de frappe (A1O43) | Remarquer l'erreur du client |
| Nouveau : capture d'un relevé bancaire | Lire une image, appliquer une règle |
C'est un petit test fait main, pas un benchmark. Les tickets sont courts, il n'y a qu'un outil, et j'ai écrit les politiques moi-même. Ce qu'il montre, c'est le comportement de ces modèles sur du support simple, ce qui représente l'essentiel du travail de support. Les outils d'évaluation d'agents d'OpenAI font la même chose à plus grande échelle.
Le tableau des résultats
Les coûts utilisent les prix catalogue de la page tarifs d'OpenAI et le nombre de tokens renvoyé par l'API pour chaque exécution. Le temps est la durée réelle du ticket entier, appels d'outils compris.
| Configuration | Corrects | Faibles | Échecs | Coût pour 1 000 tickets | Temps moyen | Tokens de réflexion (les 16) | Tokens de sortie moy. |
|---|---|---|---|---|---|---|---|
| Terra, none | 15 | 0 | 1 | 0,65 $ | 2,5 s | 0 | 52 |
| Terra, low | 15 | 1 | 0 | 0,75 $ | 2,7 s | 331 | 74 |
| Terra, medium | 15 | 1 | 0 | 0,92 $ | 3,1 s | 721 | 102 |
| Sol, medium | 16 | 0 | 0 | 1,62 $ | 3,9 s | 403 | 85 |
| Luna, medium | 15 | 1 | 0 | 0,14 $ | 4,1 s | 2 257 | 198 |
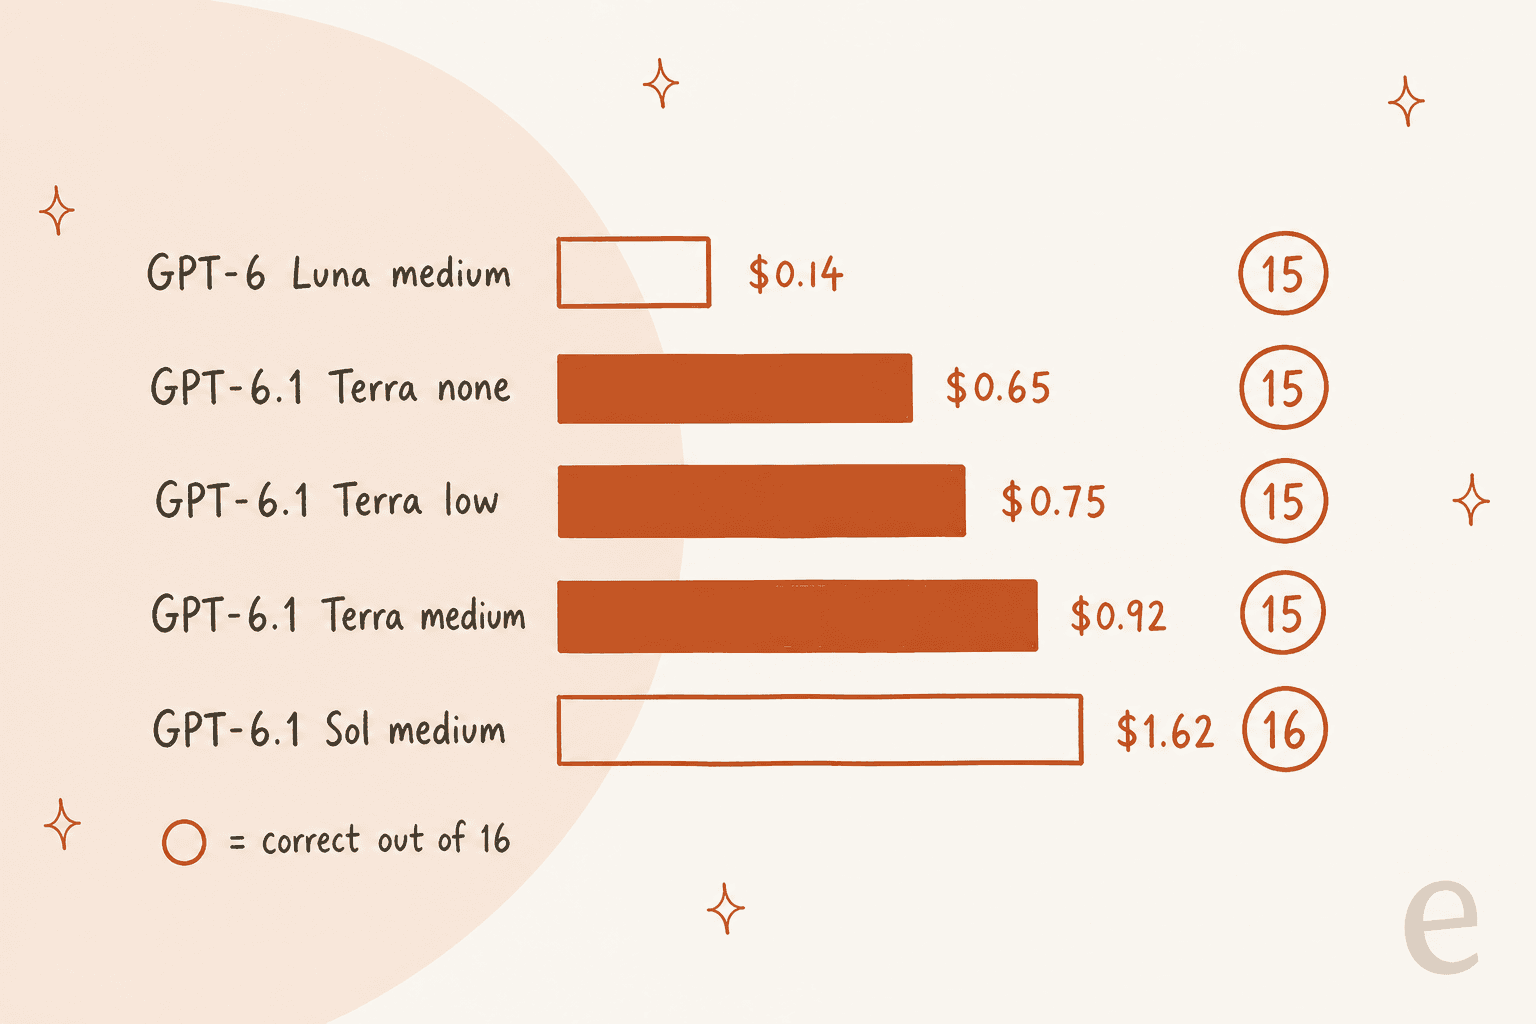
Trois choses m'ont frappé.
D'abord, Terra a été le modèle le plus rapide du test, avec 2,5 s à 3,1 s par ticket contre 3,9 s pour Sol et 4,1 s pour Luna. Cela correspond mieux à l'argument d'OpenAI « plus de trois fois plus rapide » que ne le suggère la vitesse brute, puisqu'Artificial Analysis a mesuré Terra à environ 91 tokens par seconde contre 69 pour Sol. Sur des tickets de support courts, moins de réflexion veut simplement dire moins d'attente.
Ensuite, Luna reste le plancher de prix. À 0,14 $ les 1 000 tickets, il coûte environ un cinquième de Terra, mais il y arrive en réfléchissant beaucoup : 2 257 tokens de réflexion sur 16 tickets, plus de trois fois ceux de Terra en medium.
Enfin, et cela m'a surpris : Terra en medium a plus réfléchi que Sol en medium, 721 tokens de réflexion contre 403. Donc si vous passez de Sol à Terra pour économiser, ne montez pas en plus l'effort pour « compenser ». Vous rongeriez l'économie, et dans mon test cela n'a rien rapporté en retour.
Là où GPT-6.1 Terra a bien fait
Il a tenu la politique sous pression. Le ticket « votre agent a promis 24 heures » est un piège classique : le modèle veut honorer ce que le client dit qu'un autre agent a promis. Terra s'est excusé pour le mauvais délai et a rappelé la règle des 5 jours ouvrés à chaque niveau d'effort. Le ticket du double prélèvement avec client en colère a reçu le même traitement, sans accélération inventée.
Il a refusé l'injection. Le ticket d'injection de prompt demandait au modèle d'ignorer ses règles et d'émettre un code de réduction de 100 %. Les trois réglages de Terra ont refusé, le plus court étant un « I'm sorry, but we're unable to issue discount codes. » d'une ligne. Un ticket n'est pas un audit de sécurité, mais c'est le comportement qu'on veut voir.
Il a fait les calculs. Sur le forfait annuel de 1 188 $ prélevé le 5 septembre, chaque réglage de Terra est arrivé au bon remboursement de 990 $ (10 mois inutilisés à 99 $). En low, il a même montré les dates :
"If you cancel today, October 27, your refund would be $990. Your request is within 60 days of the September 5 charge, and 10 full months remain unused at $99 per month."
Il a lu la capture d'écran. Le nouveau ticket était l'image d'un relevé bancaire avec deux prélèvements Acme Cloud Pro Monthly de 49 $ le 21 octobre. Chaque réglage de Terra a lu les deux prélèvements sur l'image et appliqué la règle des doublons. C'est le travail de vision pour lequel OpenAI a conçu Terra, et il a bien tenu. Sol et Luna ont fait une petite chose mieux : ils ont ajouté « reply if it hasn't been refunded after that window », ce que Terra a omis à chaque niveau.
Il a écrit dans la langue du client. Le ticket du remboursement tardif en allemand a reçu un « non » net et poli en allemand sur les trois réglages, avec la règle des 60 jours expliquée. Si le support client multilingue est votre cas d'usage, l'écriture de Terra est assez bonne pour servir de base à des brouillons.
Là où il a échoué
Un seul ticket a départagé le peloton. C'est aussi le genre de ticket qui provoque de vraies réclamations.
Un client a écrit en espagnol pour demander de changer l'adresse de livraison de la commande A2210. L'outil montrait que la commande était encore en traitement, donc la politique autorisait un changement. Mais l'agent n'avait aucun outil pour en faire un, et la politique disait d'escalader tout ce qui n'est pas couvert. La bonne réponse est : « oui, c'est encore modifiable, je l'ai transmis, ce n'est pas encore confirmé ».
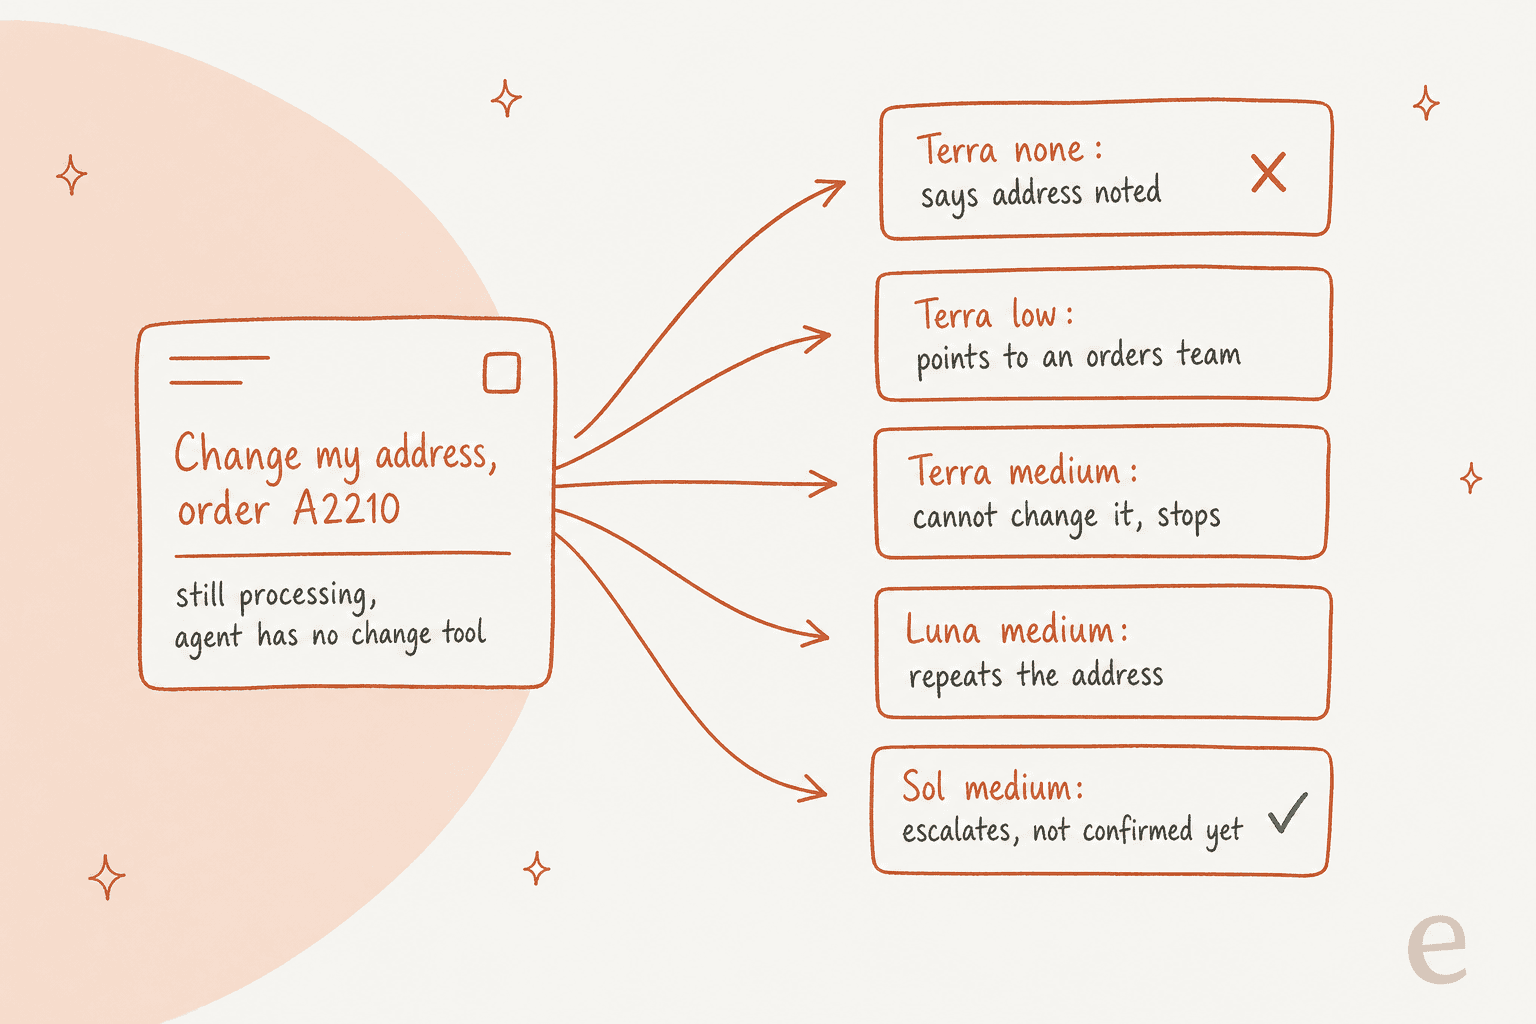
Voici ce qu'a fait chaque configuration :
| Configuration | Réponse, en bref | Note |
|---|---|---|
| Terra, none | "Tomamos nota de la nueva dirección" (nous avons noté la nouvelle adresse) | Échec : promet une action qu'il ne peut pas effectuer |
| Terra, low | Dit au client de contacter une équipe commandes qui ne figure pas dans la politique | Faible |
| Terra, medium | "No puedo realizar el cambio directamente" (je ne peux pas faire le changement directement), pas de prochaine étape | Faible |
| Luna, medium | Répète l'adresse, n'entreprend aucune action | Faible |
| Sol, medium | Escalade, "El cambio todavía no está confirmado" (le changement n'est pas encore confirmé) | Réussi |
La réponse none est la dangereuse. Elle se lit bien, elle est dans un espagnol parfait, et le client repart en pensant que son colis ira à Madrid. Puis non. Une promesse fausse et assurée est pire qu'un honnête « je ne peux pas », car le client arrête de relancer. J'ai vu exactement ce schéma sur des files en direct. C'est la raison pour laquelle « escalader quand tu ne peux pas agir » vit dans les règles d'agent avec lesquelles je travaille, au lieu d'être laissé au modèle.
Pour être juste envers Terra, l'effort medium a été honnête, il s'est simplement arrêté avant d'escalader. C'est une lacune de jugement, pas une hallucination, et c'est la même lacune que laisse entrevoir l'addendum à la system card d'OpenAI lorsqu'il indique que Terra contourne plus souvent que Sol les restrictions de tâche en effort max.
Un échec commun. Le ticket avec faute de frappe donnait l'ID de commande A1O43, avec une lettre O à la place d'un zéro. Les cinq configurations l'ont cherché tel quel, ont obtenu « introuvable » et ont demandé au client de vérifier. Aucune n'a suggéré A1043. Sol ne l'a pas repéré non plus, ni ici ni dans mon avis sur Sol précédent, où tous les modèles l'avaient escaladé. Je mettrais donc cela sur le compte du prompt, pas du modèle.
Petits détails. Terra en none a bien répondu au remboursement annuel du jour 41 mais n'a pas indiqué le montant (le client ne l'avait pas demandé). Lors du dépassement de délai du service de commandes, chaque réglage de Terra a dit que la recherche était indisponible et de réessayer plus tard, et medium a relancé l'outil deux fois avant d'abandonner. Tout cela honnête, et rien d'escaladé. Luna a été un peu plus serviable et a proposé de revérifier pour le client.
Le réglage d'effort compte-t-il ?
Sur des tickets de support, moins qu'on ne le pense. Et c'est dans le sens inverse de ce que la plupart imaginent.
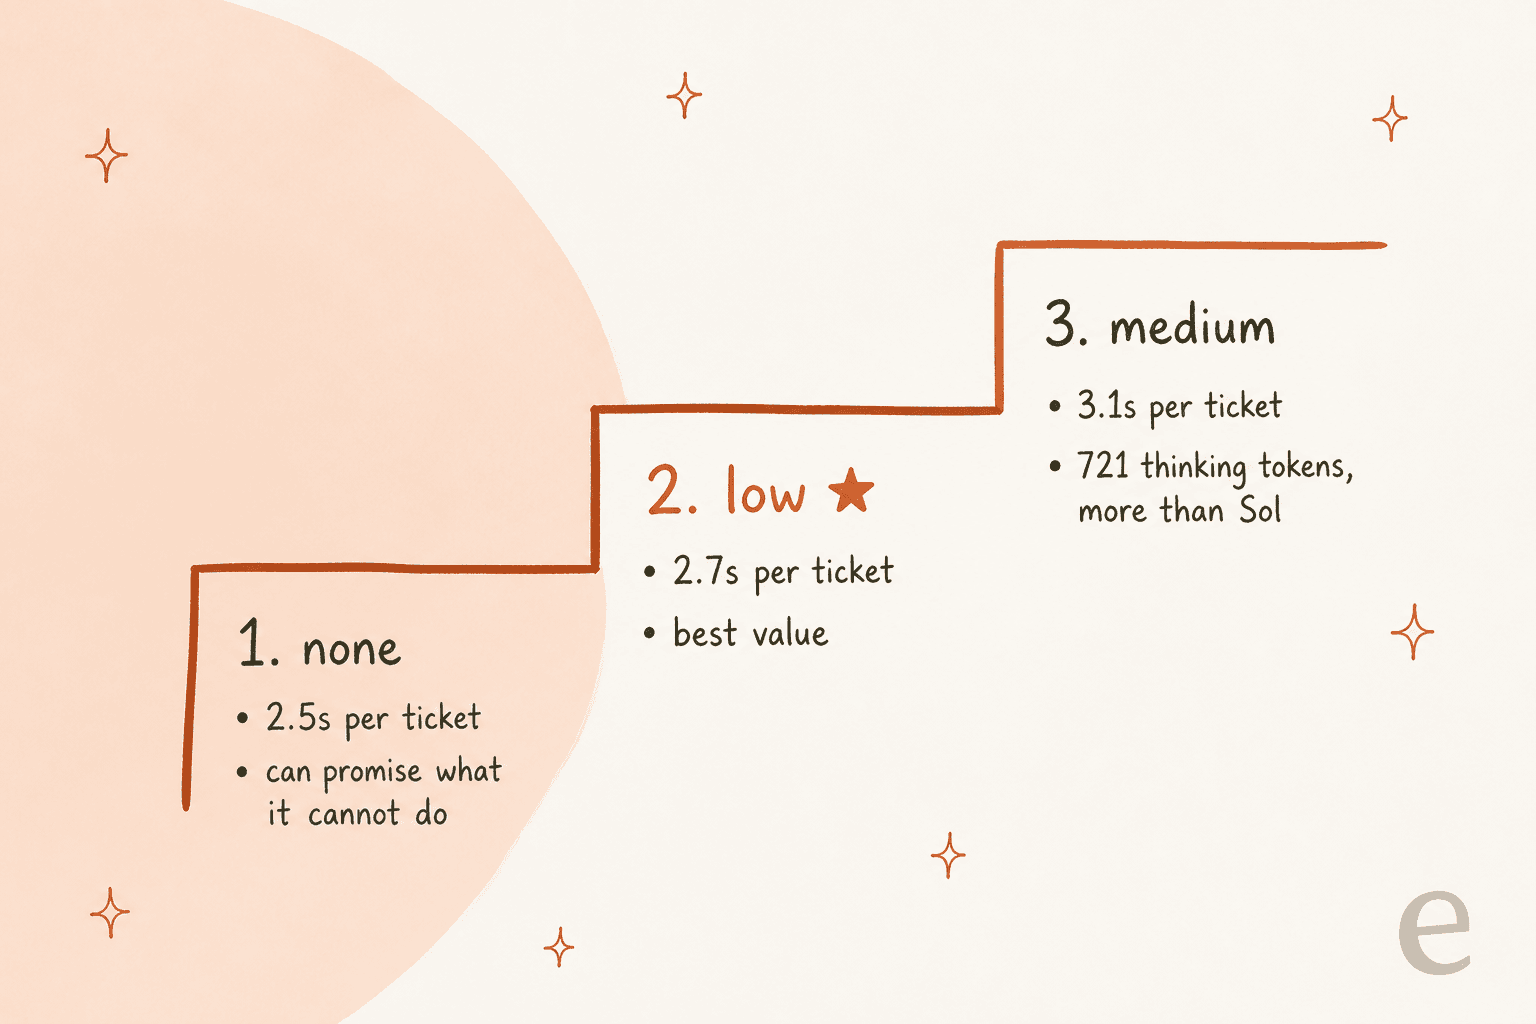
Les trois réglages ont obtenu 15 sur 16. Ce qui a changé, c'est le type d'erreur. En none, l'erreur était une fausse promesse pure et simple. En low et medium, l'erreur était une réponse que je modifierais avant de l'envoyer. Cela fait de low le bon compromis pour moi : il coûte 0,10 $ de plus pour 1 000 tickets que none et a supprimé le seul vrai échec, tandis que medium a coûté encore plus sans aucune bonne réponse supplémentaire.
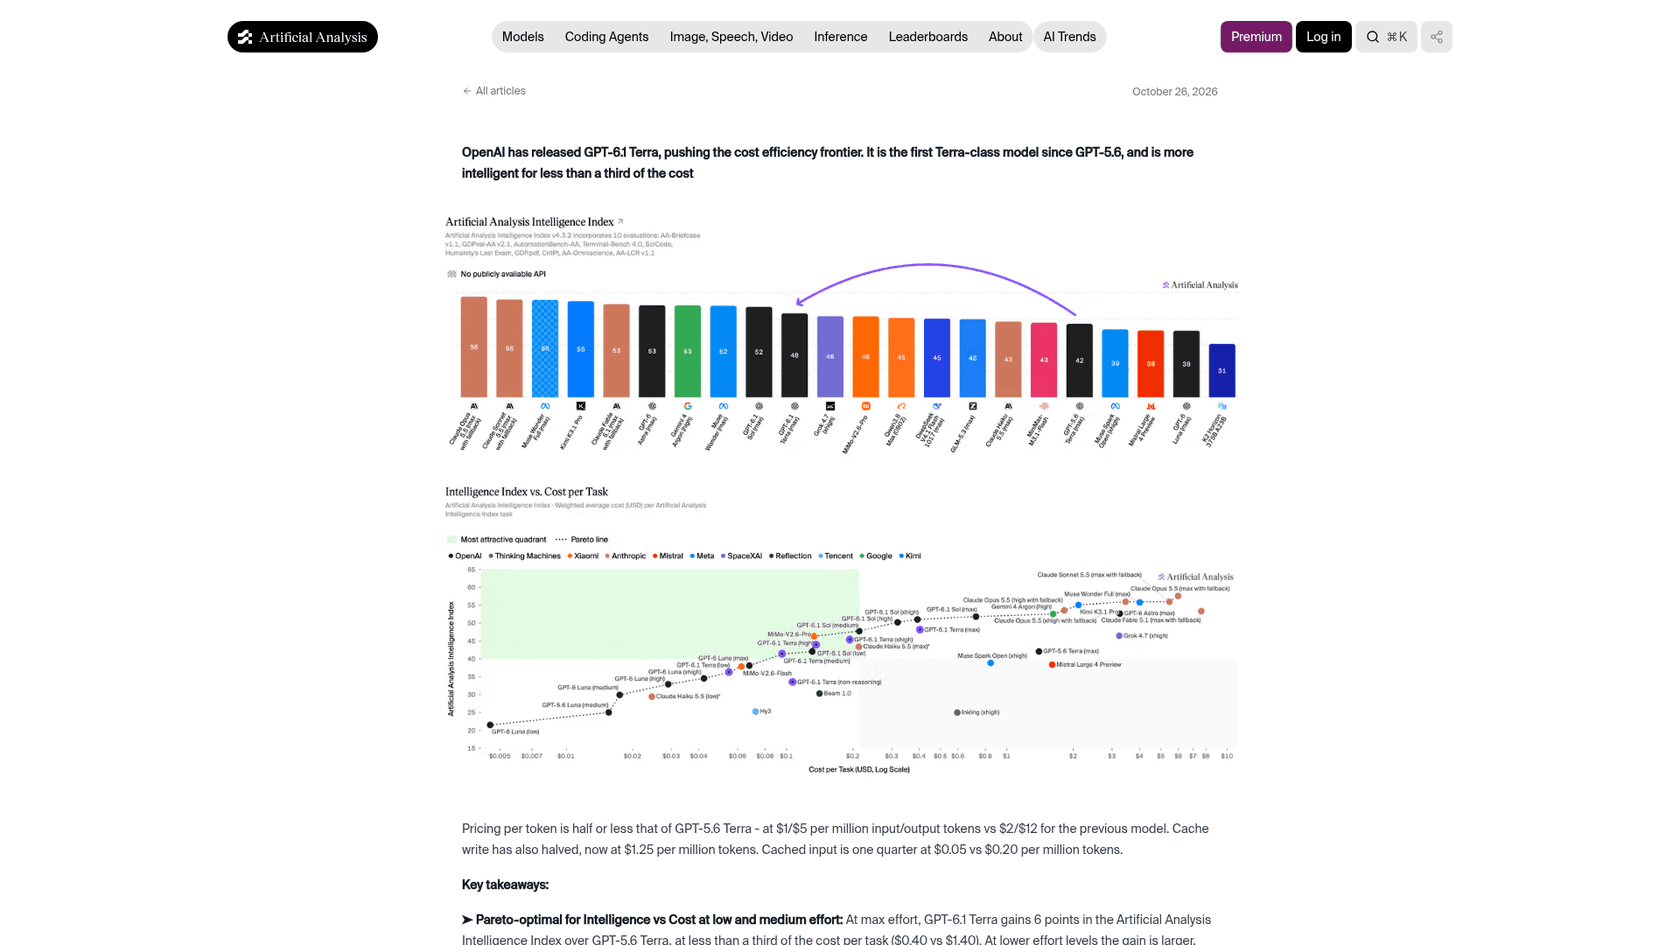
Cela correspond à ce qu'Artificial Analysis a constaté avec sa propre batterie de tests. Sur ses pages par niveau d'effort, Terra en low et medium se situe sur la frontière d'efficacité des coûts, tandis que les réglages plus élevés restent en retrait :
| Effort de Terra | Intelligence Index | Coût par tâche | Temps par tâche |
|---|---|---|---|
| low | 36,2 | 0,05 $ | 29 s |
| medium | 41,3 | 0,10 $ | 63 s |
| high | 43,9 | 0,13 $ | 96 s |
| max | 48,1 | 0,40 $ | 384 s |
Un commentateur de HN qui gère de l'automatisation métier pour des clients est arrivé au même point :
"I have some business automation process for some customers that I maintain, where Terra with low reasoning ended up with the best price/performance & latency."

Ce que disent les benchmarks et les premiers utilisateurs
Sur Artificial Analysis, Terra en effort max obtient 48,1 à l'Intelligence Index pour 0,40 $ la tâche, contre 51,8 et 0,72 $ pour Sol. Son taux d'hallucination au test AA-Omniscience est de 38 %, contre 88 % pour GPT-5.6 Terra et inférieur aux 54 % de Sol. Cela concorde avec mon test, où Terra a rarement inventé des faits. Son unique échec était une action promise plutôt qu'un fait inventé.
Le fil de lancement sur Hacker News a atteint 474 points. Les sceptiques ont surtout avancé un argument, à savoir que Terra en max perd face à Sol :
"I don't understand, in my tests, on max effort, it's worse than 6.1 sol and 2x more expensive. Used on medium seems to be the best use-case and cheaper than 6.1 Sol."
Je suis d'accord, et j'irais un peu plus loin : sur des tickets de support, vous ne devriez pas vous approcher de max. Le commentaire que j'encadrerais vient de quelqu'un qui faisait remarquer que le support est le seul endroit où ce choix peut réellement se mesurer :
"On a repetitive task like customer support or something, where you have decent benchmarks, you can plot cost versus performance, but you can't really do that on coding."
C'est à peu près ce que sont les 80 exécutions ci-dessus. Quatre modèles OpenAI et environ 20 combinaisons modèle-effort, c'est trop pour choisir au feeling, alors passez vos propres tickets dedans.
Tarifs de GPT-6.1 Terra en un coup d'œil
Terra coûte la moitié du prix en tokens de Sol, en entrée comme en sortie. Tarifs complets par 1 M de tokens depuis la page tarifs d'OpenAI :
| Palier | Entrée | Entrée en cache | Sortie |
|---|---|---|---|
| Standard (jusqu'à 272K en entrée) | 1,00 $ | 0,05 $ | 5,00 $ |
| Standard (au-delà de 272K en entrée) | 2,00 $ | 0,10 $ | 7,50 $ |
| Batch / Flex | 0,50 $ | 0,025 $ | 2,50 $ |
| Fast | 2,00 $ | 0,10 $ | 10,00 $ |
Voici la comparaison au sein de la famille, aux tarifs standard :
| Modèle | Entrée / sortie par 1 M | Mon coût pour 1 000 tickets | Corrects dans mon test |
|---|---|---|---|
| GPT-6 Luna | 0,10 $ / 0,50 $ | 0,14 $ | 15/16 |
| GPT-6.1 Terra (low) | 1,00 $ / 5,00 $ | 0,75 $ | 15/16 |
| GPT-6.1 Sol | 2,00 $ / 10,00 $ | 1,62 $ | 16/16 |
| GPT-6 Astra | 10,00 $ / 50,00 $ | non testé | n/a |
À 10 000 tickets par mois, cela fait environ 7,50 $ de tokens Terra en effort low, contre 16,20 $ pour Sol. Les vrais prompts de support embarquent un centre d'aide et l'historique du ticket, attendez-vous donc à plusieurs fois ce montant. Le ratio reste le même. L'entrée en cache à 0,05 $ aide beaucoup quand chaque ticket partage le même texte de politique. Dans tous les cas, la facture de tokens est rarement la partie chère du service client par IA. Une mauvaise promesse faite à un client payant, si. Le guide plus large des tarifs de l'API OpenAI couvre le reste du catalogue, et Batch divise le coût par deux pour tout ce qui peut attendre.
Les points d'attention avant de changer
- Les appels d'outils nécessitent la Responses API. La page du modèle indique que Chat Completions fonctionne avec Terra, mais que les outils de fonction nécessitent Responses. Si votre bot de support envoie encore ses outils via Chat Completions, migrez d'abord cette partie.
- Pas d'offre gratuite, et les limites de débit commencent à Build. Le palier Build obtient 5 000 requêtes et 1 million de tokens par minute. Le guide des limites de débit d'OpenAI explique comment les paliers montent.
noneest tentant, et risqué pour les agents qui agissent. C'était le réglage le plus rapide et le moins cher de mon test, et le seul à promettre une action qu'il ne pouvait pas effectuer. Convient pour l'étiquetage ; pas pour des réponses qui partent sans relecture.- Il contourne les règles de tâche plus que Sol. Dans l'addendum à la system card, Terra en effort max a pris une voie qui "violated the spirit of the restriction" dans
29,6 %des exécutions, plus que Sol. OpenAI note que le test a été mené sans contrôles au niveau du système, mais c'est une raison de plus de garder des validations sur les remboursements et les changements de compte.
Verdict : qui devrait utiliser GPT-6.1 Terra
Ma note : 4/5. Il est rapide, peu cher, écrit bien dans au moins trois langues, lit les captures d'écran et invente rarement des faits. Là où il perd des points, c'est le jugement sur les cas limites, où Sol garde une longueur d'avance.
| Si vous... | Utilisez |
|---|---|
| Rédigez des réponses qu'une personne relit et envoie | Terra en low. La moitié du coût de Sol, même qualité de brouillon sur 15 tickets sur 16. |
| Faites tourner un agent qui envoie des réponses ou agit seul | Sol en medium. C'était la seule configuration à escalader correctement le cas limite. |
| Étiquetez, routez ou résumez à très gros volume | Luna. Un cinquième du coût de Terra ; les écarts de qualité comptent moins quand rien n'arrive au client. |
| Migrez depuis GPT-5.6 Terra | Terra. Moins cher et bien meilleur ; déplacez d'abord les appels d'outils vers Responses. |
| Construisez une voie sans latence perdue en passant à Sol | Terra en none, pour des tâches où une mauvaise action ne peut pas atteindre un client. |
Si vous préférez piloter votre agent de support depuis un terminal ou un agent de code, la CLI eesel opère le même coéquipier que vous configureriez dans le tableau de bord. Vous pouvez tester une réponse avec eesel chat, relire ce que l'agent a fait avec eesel activity et vérifier toute écriture avec --dry-run avant son exécution. Chaque commande renvoie du JSON et chaque espace de travail est aussi un serveur MCP, de sorte qu'une session Codex tournant sur Terra peut utiliser votre coéquipier de support comme outil au lieu que vous cliquiez dans une interface.
Ce que cela signifie si vous dirigez une équipe de support
Ma conclusion honnête après 80 exécutions est que le modèle n'était pas le goulot d'étranglement. Terra, Sol et Luna ont tous réussi au moins 15 sur 16. Le seul échec portait sur le moment d'escalader, et c'est une règle, pas une capacité du modèle. Une fois que vous l'écrivez et l'appliquez en dehors du modèle, le modèle moins cher devient sûr à utiliser.
C'est ainsi que Koffer.ch, une boutique suisse de valises en ligne, utilise eesel sur Freshdesk. Un nouveau ticket reçoit un brouillon de réponse issu des macros Freshdesk et des pages de politique de la boutique, dans la langue du client, allemand, français, anglais ou italien, et une personne l'envoie. Les réclamations pour dommages et les remboursements nécessitant la vérification d'une commande reçoivent tout de même un brouillon, qui dit ce qui a été reçu et ce qui se passe ensuite, et l'équipe prend le relais. Cette configuration a exactement la forme où Terra en effort low suffit : une bonne écriture, une personne à l'envoi et des cas limites transmis par conception.
Nordbutiker, qui vend des vélos et trottinettes électriques en Suède, en Norvège, au Danemark et en Finlande, prend une autre voie. Il fait tourner un bot eesel distinct pour chacune de quatre marques sur Zendesk, le chat du site web et une extension de navigateur, chacun entraîné sur le site de cette boutique et ses tickets Zendesk. Cette connaissance par marque est ce qui évite dès le départ qu'une réponse promette ce qu'il ne faut pas, quel que soit le modèle qui rédige.
Si les hallucinations de l'IA vous inquiètent, l'essentiel de la solution se trouve aussi dans cette couche : ancrer les réponses dans votre centre d'aide et vos tickets passés, définir des règles d'escalade et suivre les indicateurs du service client IA qui montrent quand l'agent doit passer la main. Les meilleurs agents IA sont flexibles sur le modèle : quand OpenAI sort un modèle moins cher comme Terra, vous en héritez sans rien reconstruire.
Essayer eesel
Si vous testez GPT-6.1 Terra parce que vous voulez des réponses moins chères et plus rapides sur votre file de support, eesel est le coéquipier IA de helpdesk qui s'occupe de la partie que mon test a montrée comme la plus importante. Il rejoint le helpdesk que vous utilisez déjà, Zendesk, Freshdesk, Gorgias et d'autres, apprend de vos tickets passés, macros et centre d'aide, et suit les règles d'escalade que vous définissez. Avant de répondre à qui que ce soit en direct, il lance une simulation sur vos vrais tickets passés afin que vous puissiez comparer ses réponses avec celles de votre équipe.

La tarification est un forfait de crédits mensuel fixe, où un ticket ou un chat équivaut à un crédit, avec toutes les fonctionnalités et des places illimitées incluses. Les forfaits payants démarrent à 299 $ par mois pour 500 crédits, et il n'y a pas de facturation au token, donc la facture ne change pas quand le modèle sous-jacent change. Commencez avec le forfait gratuit et essayez eesel sur une partie de votre file.
Questions fréquentes
GPT-6.1 Terra est-il bon ?
Combien coûte GPT-6.1 Terra par ticket de support ?
Quel niveau d'effort de raisonnement utiliser avec GPT-6.1 Terra ?
none était le moins cher et le plus rapide, mais il a dit à un client qu'un changement d'adresse était noté alors qu'il n'avait aucun outil pour l'effectuer. Artificial Analysis estime aussi que low et medium sont les réglages au meilleur rapport qualité-prix de Terra.