

Jalapeño est la première puce d'IA sur mesure d'OpenAI, un ASIC d'inférence conçu avec Broadcom et annoncé le 24 juin 2026. Elle a un seul travail : faire tourner de grands modèles de langage comme ChatGPT et Codex aussi vite et à moindre coût que possible. Elle n'entraîne pas de modèles, et vous ne pouvez pas l'acheter.
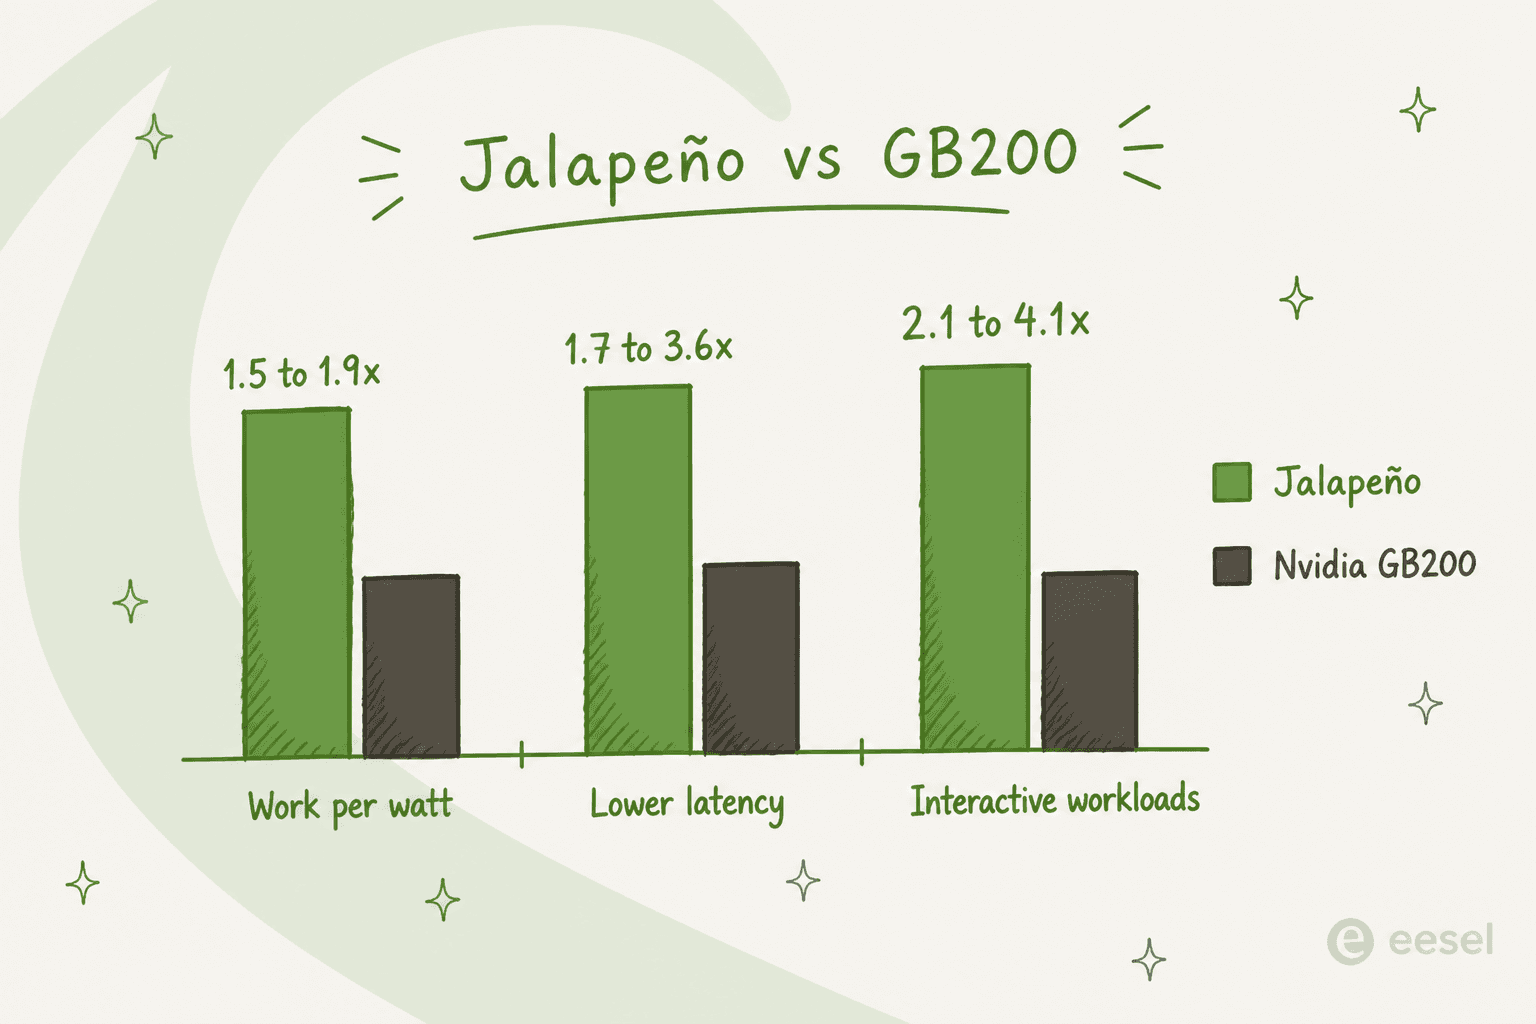
Sur les premiers benchmarks publiés par OpenAI (25 août 2026), Jalapeño a fourni 1,5 à 1,9 fois plus de travail d'IA par watt et une latence 1,7 à 3,6 fois plus faible que le système Nvidia GB200 de référence, sur trois modèles publics. OpenAI prévoit de la déployer dans ses propres centres de données d'ici fin 2026, comme première étape d'une feuille de route sur plusieurs générations liée à un déploiement de 10 GW avec Broadcom.
Si vous n'êtes pas OpenAI, l'essentiel est simple : c'est la tuyauterie sous les modèles, et une tuyauterie moins chère signifie une IA moins chère. C'est la même force qui fait qu'un agent IA coûte moins qu'un agent humain à grande échelle. Des outils comme eesel tournent sur ces modèles pour faire du vrai travail : quand le silicium en dessous devient plus efficace, l'économie du support et de l'automatisation par l'IA s'améliore sans que vous ayez rien à faire.
Ce qu'OpenAI a réellement annoncé
Je construis des agents IA pour vivre, donc je lis les lancements de puces avec une seule question : est-ce que cela change ce que les modèles au-dessus peuvent faire, ou ce qu'ils coûtent à faire tourner ? Jalapeño relève clairement de la seconde catégorie, et pas des moindres.
Le 24 juin 2026, OpenAI et Broadcom ont dévoilé Jalapeño, la première puce maison d'OpenAI. Le nom est une plaisanterie sur la chaleur et la vitesse ; l'essentiel est qu'OpenAI ne loue plus toute sa puissance de calcul à d'autres. Elle a conçu son propre silicium, a rapporté TechCrunch, et Bloomberg a noté qu'elle avait déjà reçu les premiers échantillons physiques et les testait.
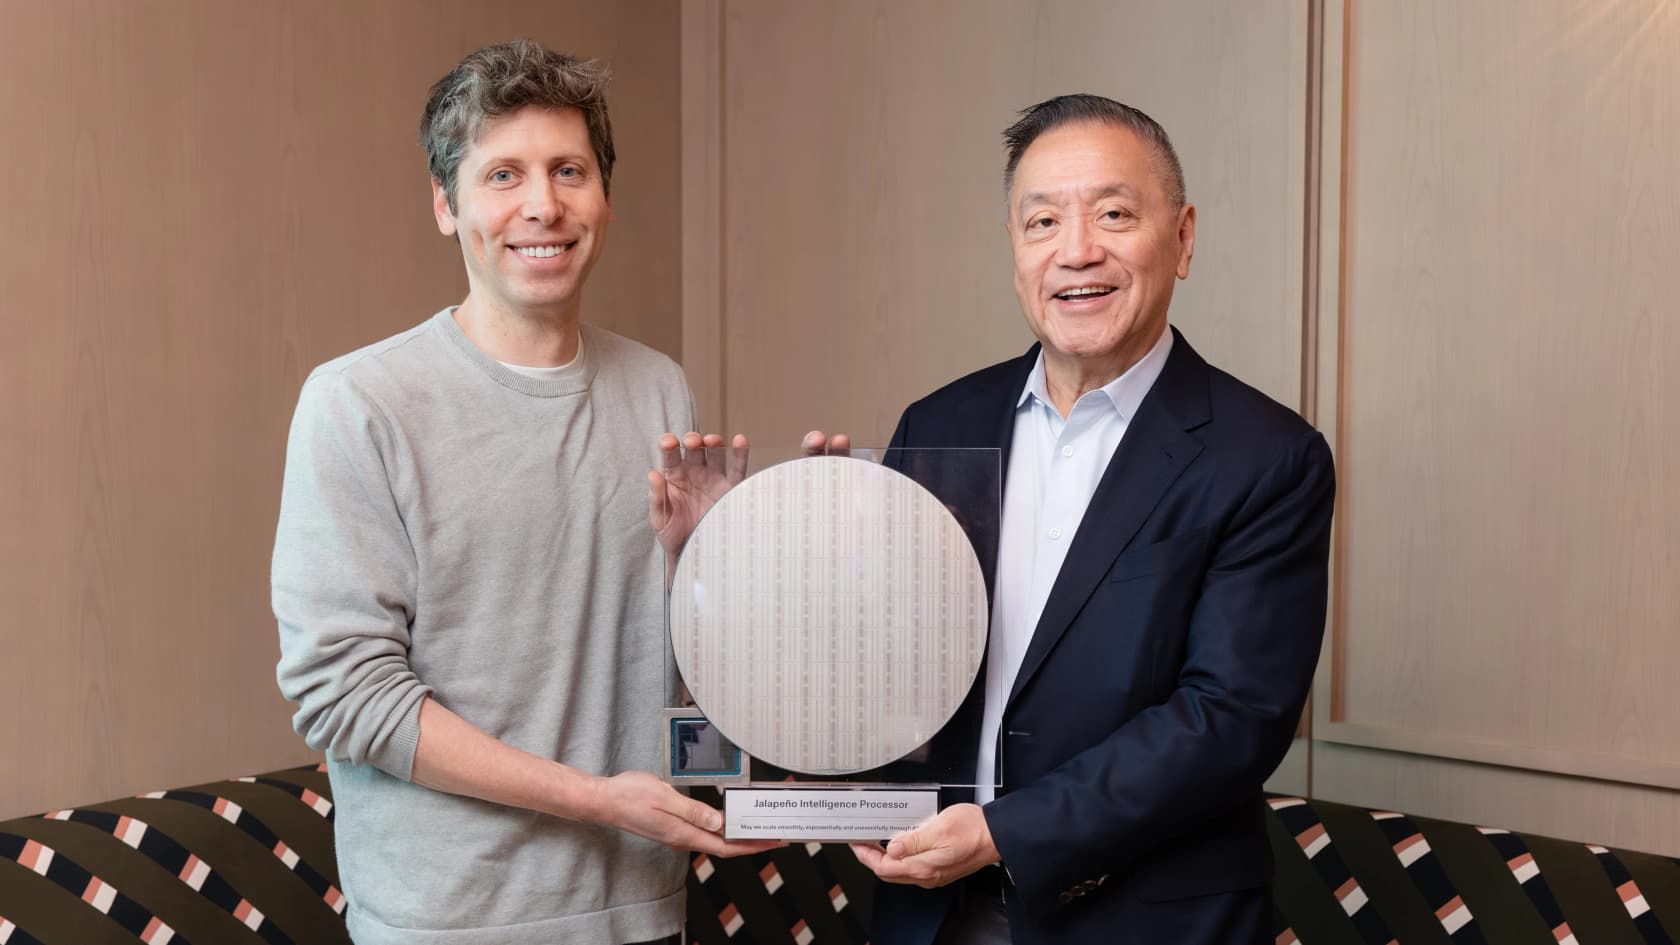
L'échelle est le titre que la plupart ont manqué. Cette puce est un élément d'un partenariat visant à déployer 10 GW d'accélérateurs conçus par OpenAI dans les prochaines années, un déploiement qu'OpenAI inscrit dans son "plan full stack" plus large pour tout maîtriser : modèles, produits, logiciels de service, puces, mémoire et réseau. Avec Jalapeño, ce plan cesse d'être une diapositive pour devenir du silicium qui fonctionne.
Ce qu'est Jalapeño, et ce qu'elle n'est pas
Quelques distinctions comptent, car « OpenAI a fait une puce » se réduit vite à « OpenAI s'attaque à Nvidia », ce qui passe à côté de l'essentiel.
Jalapeño est un ASIC, une puce spécifique à une application. Là où un GPU Nvidia est un processeur généraliste et flexible capable d'entraîner des modèles, de faire du graphisme et de servir de l'inférence, un ASIC fait une seule tâche étroite extrêmement bien et rien d'autre. L'unique travail de Jalapeño est l'inférence, le côté service où un modèle entraîné lit votre prompt et génère une réponse. Elle n'entraîne pas de modèles. Pour cela, OpenAI utilise toujours Nvidia et d'autres partenaires.
Et vous ne pouvez pas l'acheter. Jalapeño n'est pas un produit ; elle tourne dans l'infrastructure propre d'OpenAI pour servir ChatGPT, Codex, l'API et les produits agentiques. Pour tous les autres, la puce se manifeste indirectement, sous forme de modèles OpenAI plus rapides et moins chers, pas de matériel dans votre baie. Si vous cherchez la version de cette histoire avec du matériel d'inférence spécialisé que l'on peut vraiment louer, ce marché existe déjà avec des plateformes comme Baseten.
Autre point pour être juste : ça a été rapide. OpenAI affirme être passée de la conception au tapeout en neuf mois, ce qui est rapide pour du silicium sur mesure et montre à quel point les talents et l'argent du secteur visent désormais le coût de l'inférence.
Les chiffres des benchmarks
Le 25 août 2026, OpenAI a publié les premiers résultats de Jalapeño, et ces chiffres expliquent pourquoi ce lancement a fait parler de lui.
Testée sur trois modèles publics, GPT-OSS 120B, DeepSeek R1 670B et Kimi K2.5 1T, OpenAI a indiqué que Jalapeño avait fourni :
- 1,5 à 1,9 fois plus de travail d'IA par watt au débit maximal
- Une latence de bout en bout 1,7 à 3,6 fois plus faible
- Des performances 2,1 à 4,1 fois supérieures sur les charges de travail très interactives
La puce de comparaison dans les graphiques d'OpenAI est la Nvidia GB200, donnée pour 1 200 watts contre 700 pour Jalapeño. Le point sur lequel OpenAI insiste est d'avoir obtenu à la fois un débit plus élevé et une latence plus faible avec une seule conception, là où le matériel existant impose généralement un compromis entre les deux.
La lecture indépendante vient de SemiAnalysis, dont le benchmark InferenceX a été utilisé par OpenAI. Leur verdict était sans détour dès le titre, "Better Than Nvidia Blackwell", en citant près de 700 tokens par seconde et par utilisateur pour Jalapeño et plus de 9 fois la meilleure puce suivante à objectif d'interactivité égal. Un point à garder en tête, que j'aborde plus bas : SemiAnalysis possède le benchmark qu'OpenAI a choisi de faire tourner.
Le plus intéressant : la puce s'est conçue elle-même
Voici le détail que je mettrais en une, et qu'OpenAI a presque enterré. Si du silicium en neuf mois a été possible, c'est parce qu'OpenAI a utilisé ses propres modèles pour concevoir la puce.
Les modèles précédents ont aidé à mettre la puce en route ; les plus récents l'optimisent et la programment. Avec Codex et GPT-Astra, l'équipe a amené à de hautes performances, en deux mois, trois modèles à poids ouverts qui n'étaient pas dans le plan initial. Sur certains blocs d'attention et de mixture-of-experts, les implémentations générées par IA tournaient 1,5 à 1,8 fois plus vite que les versions d'experts humains.
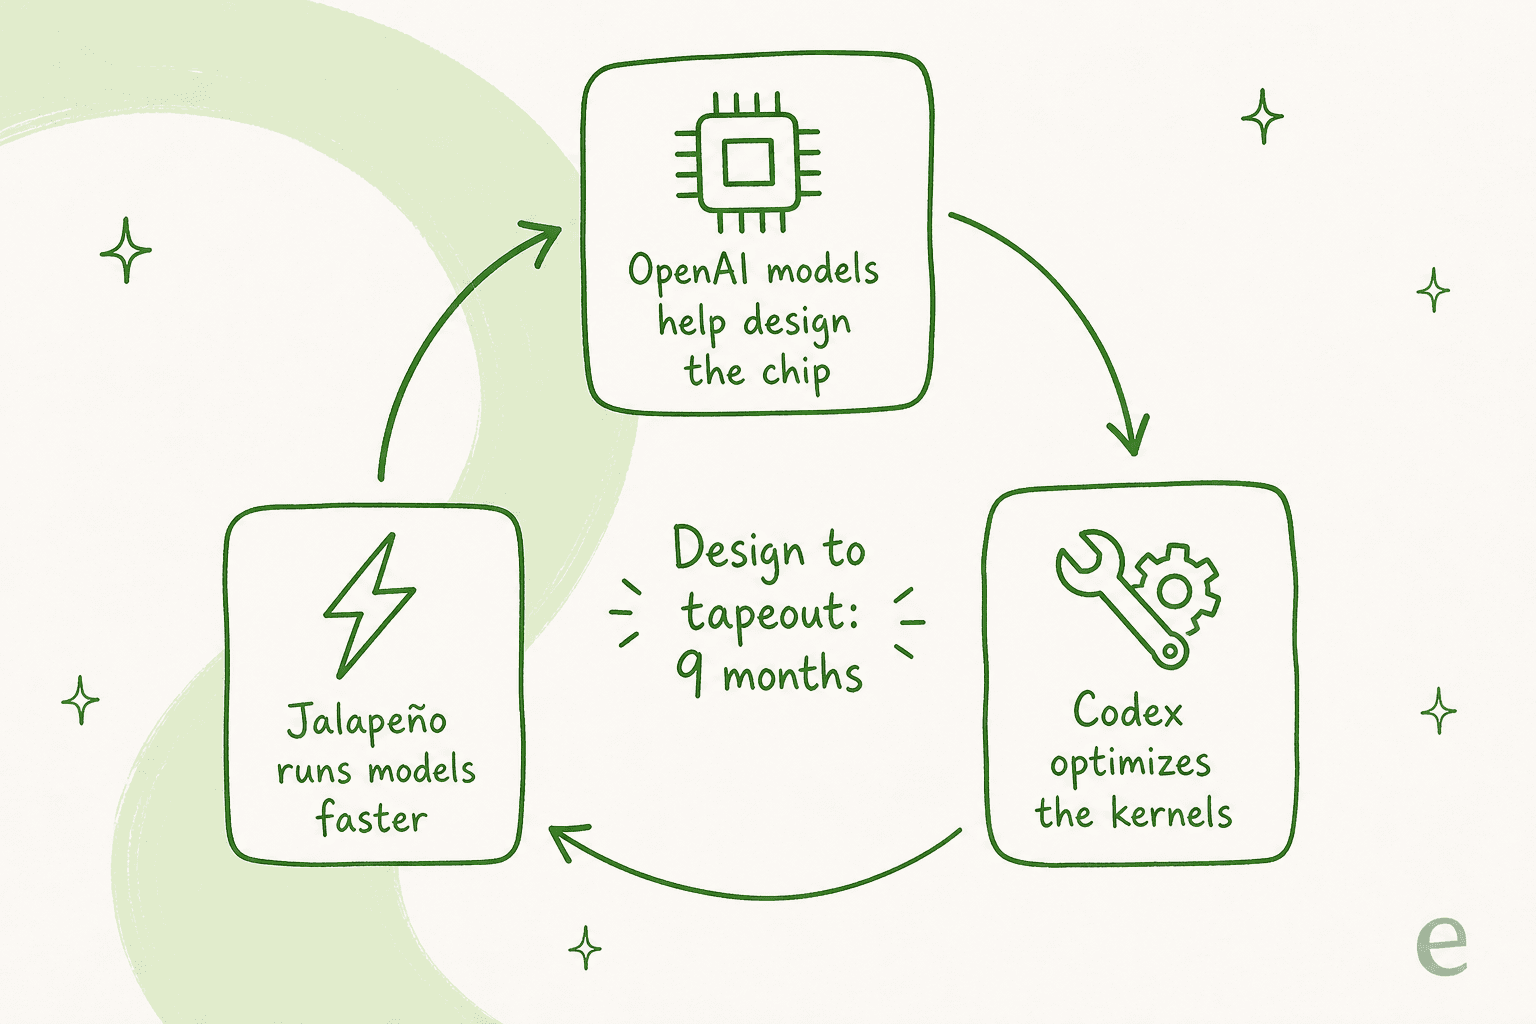
C'est une boucle : les modèles aident à concevoir le silicium, le silicium fait tourner les modèles plus vite, et les modèles plus rapides aident à concevoir le silicium suivant. La Gen 2 est « deep in development » et la Gen 3 « taking shape ». Quoi que vous pensiez des benchmarks, cette boucle de rétroaction est ce qui se cumule, et c'est la même raison pour laquelle les assistants de code IA pèsent de plus en plus dans la façon dont les vrais produits sont construits.
Ce que la communauté en a pensé
La réaction n'a pas été un tour d'honneur sans nuage, et le scepticisme est assez légitime pour être mentionné.
La critique la plus tranchante sur Hacker News était qu'il ne s'agit pas d'une comparaison équitable :
"OpenAI's chip is targeting inference (FP8, FP4), while most of the chips it is being compared to are general purpose."

Un ASIC d'inférence conçu pour cela devrait battre un GPU généraliste en inférence par watt. C'est ce que la spécialisation apporte : la victoire est réelle, mais aussi un peu attendue. D'autres ont pointé qui avait écrit le tableau de score :
"This semi-analysis article reads a lot more like an OpenAI press release than a real analysis."
Du côté investisseurs de Reddit, le cadrage portait moins sur les tokens que sur les marges : r/NVDA_Stock voyait le silicium sur mesure comme une menace lente pour le pouvoir de fixation des prix de Nvidia plutôt que comme une menace immédiate. Ma propre lecture se situe entre les deux : les chiffres sont probablement vrais dans leur direction et réels pour les charges de travail d'OpenAI, et ce sont aussi exactement ceux qu'on attendrait d'une puce spécialisée évaluée sur le test de son propre auteur.
Pourquoi une annonce de puce compte si vous n'êtes pas OpenAI
Vous n'allez pas installer Jalapeño. Alors pourquoi s'y intéresser ? Parce que le coût d'inférence est le chiffre silencieux sous chaque produit d'IA que vous utilisez ou construisez.
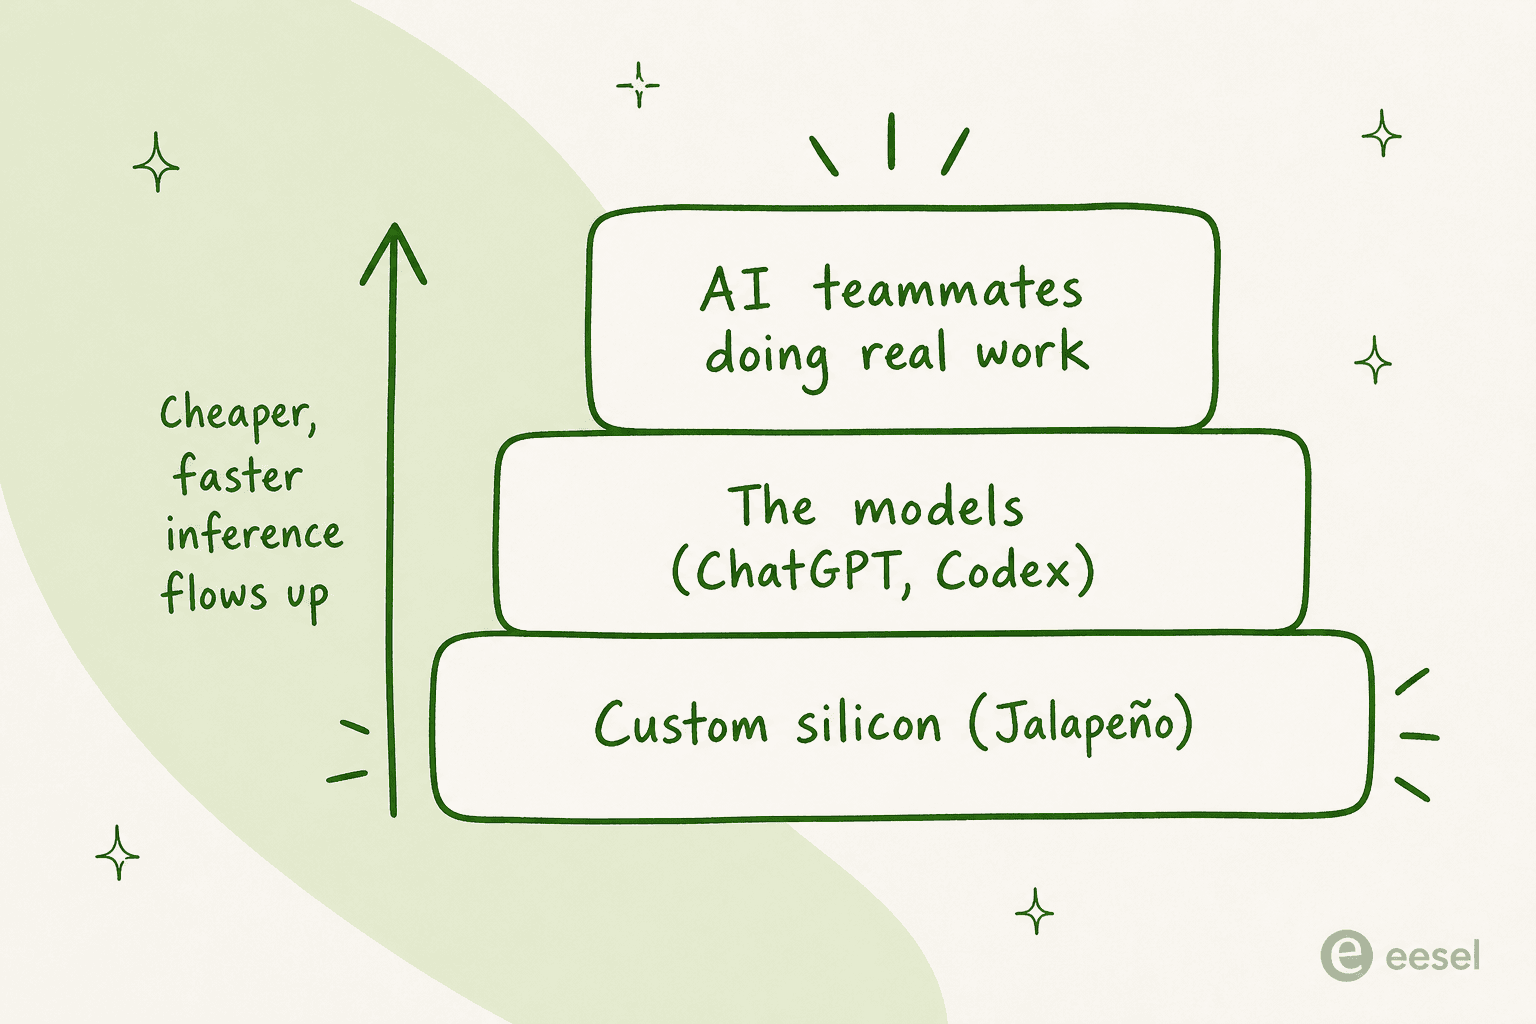
Chaque réponse de support par IA, chaque e-mail rédigé, chaque agent IA qui lit une commande et répond à un client est un appel d'inférence qui coûte de l'argent réel à servir. Quand OpenAI fait baisser ce coût, elle améliore d'abord ses propres marges, mais l'effet remonte la pile avec le temps, sous forme de tarifs d'API plus bas et de modèles qui en font plus pour chaque dollar. C'est le vent favorable qui continue de transformer le support par IA d'une démo en une ligne de dépense qui se rembourse à l'évidence, le même calcul que derrière ce que l'IA peut réellement faire économiser dans le support client.
C'est aussi un rappel de l'endroit où se trouve le vrai levier pour la plupart des équipes. On ne rivalise pas en possédant du silicium ; on rivalise en mettant les modèles au travail sur ses vrais problèmes. La puce, c'est l'atelier. L'agent IA qui traite vos tickets est l'employé, et l'employé est la partie que vous pouvez embaucher.
Essayer eesel
Jalapeño est de l'infrastructure, la couche sous les modèles. eesel est la couche au-dessus, celle que vous mettez réellement au travail. C'est une plateforme de coéquipiers IA : vous embauchez des coéquipiers prêts à l'emploi pour des tâches précises, et le coéquipier IA de helpdesk rejoint votre file Zendesk, Freshdesk ou Gorgias existante, apprend de vos anciens tickets et de votre centre d'aide, puis commence à rédiger ou envoyer des réponses.
La différence que je soulignerais, c'est que vous pouvez simuler un coéquipier sur vos tickets historiques avant qu'il ne réponde à un vrai client, pour voir ses performances à l'avance plutôt que d'actionner un interrupteur en espérant que tout aille bien. Le tarif est à partir de 299 $/mois pour 500 crédits (1 crédit par ticket ou chat), sans frais par utilisateur, et vous pouvez commencer gratuitement avec 100 crédits. Un silicium moins cher sous le capot, c'est bien ; un coéquipier que vous pouvez essayer dès aujourd'hui, c'est ce qui change votre semaine.