Les 8 meilleures alternatives à Empromptu en 2026 : vrais prix, vraies limites

Kira

Katelin Teen
Dernière modification October 14, 2026
Empromptu vend une seule chose, et cette chose est une précision que l'on peut prouver. Vous apportez un prototype d'IA qui existe déjà. Par-dessus, ils greffent des évaluations et des politiques, des contrôles de coûts et de la surveillance aussi, et ils disent que le déploiement par défaut est sur site. Un vrai produit, et un créneau mal servi. Les prix sont aussi plus transparents que dans la plupart de cette catégorie, ce que je n'attendais pas.
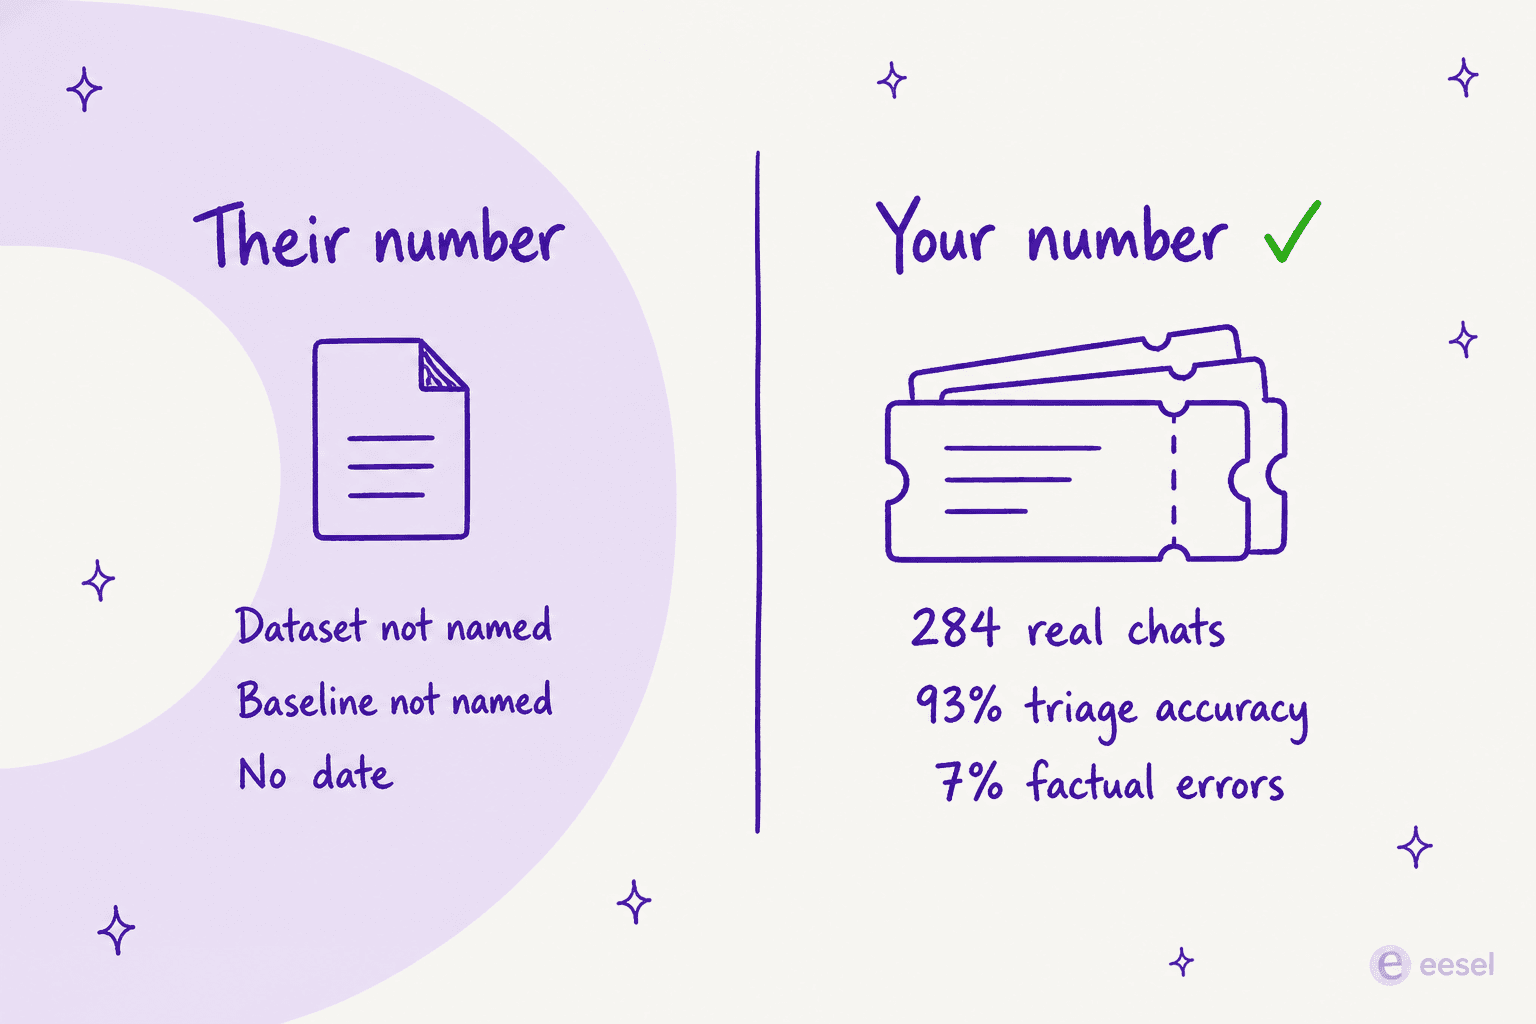
Le piège se trouve dans le chiffre affiché sur la boîte. Leur propre centre d'aide explique ce chiffre mieux que la page marketing, ce qui est étrange pour une page marketing. Le score de précision est une note que l'on se donne soi-même : votre application produit une sortie, chaque critère d'évaluation que vous avez rédigé la note de 0 à 10, et ces notes sont moyennées. La documentation montre même le calcul, (8.0 + 6.5 + 7.5) ÷ 3 = 7.3. Donc « 90 %+ de précision » veut dire 9,0 ou mieux sur 10, évalué selon des critères que vous avez écrits vous-même. Nulle part dans les 73 articles du centre d'aide on ne trouve de jeu de données ou de référence, ni de benchmark externe. Le parcours d'optimisation typique de leur propre documentation plafonne à 8,4.
Ce qui signifie que la question qui trie chaque alternative à Empromptu n'a rien à voir avec celle dont l'affirmation de précision est la plus élevée. La vraie question est : dont vous pouvez mesurer la précision sur vos propres données avant qu'un client ne la voie. Cela répartit les huit options ci-dessous en trois voies, et les voies sont : le construire vous-même, ou mesurer quelque chose que vous avez déjà construit, ou embaucher un collègue qui fait déjà le travail. Si le travail est le support client, eesel se situe dans cette troisième voie. Il exécute une simulation sur vos tickets historiques avant la mise en production, et la facturation est de 0,40 $ par ticket traité, tarif publié directement sur la page.
Pourquoi les équipes se mettent à chercher des alternatives à Empromptu
Soyons d'abord justes envers Empromptu. L'idée est bonne.
La plupart des outils d'IA supposent l'une de deux choses sur vous. Soit vous n'avez rien, alors voici un constructeur, soit vous avez une équipe plateforme, alors voici un SDK. Empromptu vise le créneau intermédiaire, et le pitch en trois étapes est honnête sur ce qu'il promet : vous apportez une application d'IA, ils ajoutent les contrôles de précision, les politiques et la surveillance, puis votre équipe garde ce qu'elle apprend. La phrase de la page d'accueil qui m'a fait acquiescer était "Most AI fails in production, not because the model was wrong, but because nothing was in place to catch it." Ce qui est exact. Je l'ai vu arriver aussi.
L'histoire d'origine du fondateur est la même observation :
"We started Empromptu after burning through thousands of credits on AI builders and hitting the same problem: cool looking prototypes or demos that break with real users."

Et les praticiens disent la même chose, sans que personne ne leur demande. Celle-ci vient d'un fil sur les raisons pour lesquelles les projets d'agents s'enlisent, et pour toute la prémisse d'Empromptu, c'est le meilleur argument en une ligne que j'aie trouvé n'importe où :
"Companies need processes, not tools. Once they deploy an agent, it should be boring and reliable. Measurable quality, failure alerts, "report to human" cases. All those wrappers make the enterprise-ready solution much more complicated than building an agent itself."

C'est aussi une jeune entreprise. Empromptu a levé 2 M$ en pre-seed, menés par Precursor Ventures, annoncés en décembre 2025, avec une équipe d'environ douze personnes. Les fondateurs sont aussi des opérateurs crédibles : Shanea Leven dirigeait auparavant CodeSee, et le CTO Dr. Sean Robinson a construit la technologie d'optimisation chez Madrona Venture Studio.
Voici donc la partie qui envoie réellement les acheteurs chercher ailleurs.
Le chiffre de précision est auto-noté, et la documentation le dit. Quatre formulations figurent sur la page d'accueil : un « 98 % de précision en production, mesuré » ferme, un « jusqu'à 98 % de précision » nuancé dans la FAQ, un « 98 % même avec plus de 250 documents alors que les autres outils tombent à 60-70 % » en comparaison sans source, et un chiffre de 98,2 % dans une maquette d'interface marketing. Le centre d'aide utilise plutôt « 90 %+ », dans six articles, puis explique le mécanisme assez clairement : chaque évaluation active est un critère en langage naturel, un modèle note ce critère de 0 à 10, puis les notes sont moyennées. Changez les critères, le chiffre change. Il y a un interrupteur Actif/Inactif par évaluation, et les évaluations inactives n'affectent pas le score actuel.
À l'honneur d'Empromptu, la documentation est franche sur ce point précis. Evaluations Overview contient une entrée de dépannage intitulée "High Scores But Poor Real-World Performance", avec pour causes des évaluations qui ne correspondent pas aux cas d'usage réels et des critères manquants. Les recommandations publiées sont aussi plus modestes que le marketing : viser 6,0 pour les nouvelles tâches, 7,5 une fois en production, et 8,5 pour les tâches critiques. Nulle part la documentation ne prétend que 9,0+ soit typique. Le parcours d'optimisation documenté s'arrête à 8,4.
« RAG inclus » est affirmé mais pas spécifié. Quatre articles disent que la récupération est livrée avec chaque application. Pas un des 73 ne nomme une stratégie de découpage, un index, un magasin de vecteurs, une liste de connecteurs, un réglage top-k ou une configuration de citations. Une seule primitive de récupération est documentée, le text_embedder, et la connaissance s'y rattache en la décrivant dans le prompt de construction. La collection Prompting conseille activement aux utilisateurs d'arrêter de nommer des choses comme les bases de données vectorielles, ce qui est un conseil raisonnable de prompt engineering, même si cela laisse la configuration de la récupération non documentée. Si la qualité de la récupération est ce qui brise votre précision, et avec du contenu de support c'est généralement le cas, c'est exactement la partie que vous voudriez voir spécifiée. Notre comparatif RAG et fine-tuning explique pourquoi.
La surface de conformité est plus mince que ne le suggèrent les badges. Le bandeau principal indique SOC 2, HIPAA, Zero vendor lock-in. Leur propre FAQ de la page À propos décrit SOC 2 comme en cours. La page de tarifs qualifie Enterprise de "Built for regulated industries" puis ne nomme aucune certification : ni SOC 2, ni HIPAA, ni ISO 27001, ni BAA, ni résidence des données, ni SLA. Dans l'ensemble des 73 articles du centre d'aide, HIPAA apparaît exactement une fois, et c'est une case non cochée sur une fiche de travail précédant la construction. /security et /trust renvoient tous deux une erreur 404. L'histoire du sur site est aussi plus étroite que ne le suggère « sur site par défaut » : la documentation la décrit comme une démarche commerciale pour grands comptes et comme hybride par conception, où l'application tourne en local mais garde une connexion vers Empromptu pour l'optimisation. Aucun mode isolé n'est documenté, et aucune déclaration n'indique ce qui franchit cette frontière. Pour un acheteur du secteur de la santé ou de la fintech, ce n'est pas rédhibitoire. C'est toutefois une revue de sécurité à mener avant le pilote, pas après.
La documentation est réelle mais cachée. Il existe un centre d'aide complet sur docs.empromptu.ai, 73 articles répartis en 15 collections, et honnêtement il est plus utile que le site marketing. Il est aussi réglé sur noindex, ce qui veut dire qu'un moteur de recherche ne vous y enverra jamais. Aucune capture d'écran non plus. Un article sur l'optimisation des modèles s'arrête en plein milieu de liste après sa puce sur Claude 3 Sonnet, sans livrer aucune des cinq sections que promet sa propre introduction, et sa liste de modèles cite encore GPT-4o et Claude 3 Opus en août 2026.
Le coût marginal est impossible à connaître. Le coût groupé est exceptionnellement clair et je le reconnais plus bas. Le dépassement est la pièce manquante : pas de prix de recharge, pas de politique de report, et aucune déclaration sur ce qui se passe quand les crédits sont épuisés. Le forfait, vous pouvez donc le dimensionner. La facture, non.
Il n'y a presque aucun signal de tiers. Neuf publications Show HN et Launch HN auto-soumises entre juin et décembre 2025 ont recueilli 14 points au total et exactement une réponse d'une personne extérieure aux fondateurs, qui était une demande d'expliquer en deux phrases la différence avec les alternatives. G2 dit explicitement qu'il n'y a pas assez d'avis pour éclairer un achat, et sur Capterra ou Trustpilot il n'y a aucune fiche. Pour une entreprise en pre-seed, c'est normal, et ce n'est pas une critique de ma part. Cela signifie néanmoins que chaque affirmation que vous finirez par évaluer vient du fournisseur lui-même.
Comment j'ai comparé ces outils
Je suis ingénieur dans l'équipe produit d'eesel, donc je les lis comme je lis une dépendance. Quelle est l'unité. Qu'est-ce qui est verrouillé. Qu'est-ce qui casse quand on passe à l'échelle.
Pour chacun des huit, j'ai relevé la page de tarifs du fournisseur ainsi que la documentation, et j'ai noté cinq choses :
- L'unité de facturation, exactement telle que le fournisseur la définit. Crédits et jetons, spans de trace, points de contrôle, tickets : ce ne sont pas des choses interchangeables.
- Si le tarif de dépassement est publié. Un prix publié à côté d'un dépassement non publié n'est que la moitié d'une grille tarifaire.
- Si la mesure de la précision est intégrée, par opposition à des tests logiciels ou à des analyses de sécurité sous le même habit. La différence entre les deux est réelle, et je l'explique dans évaluer les performances des agents d'IA.
- Si vous pouvez tester sur vos propres données avant le lancement, et non après.
- La vraie réponse en matière de conformité : BAA signé, type de rapport SOC 2, auto-hébergement, résidence des données.
Deux choses que je n'ai délibérément pas faites. Je n'ai noté personne avec un benchmark que j'aurais exécuté moi-même, parce qu'un benchmark sur mes données ne vous dit rien sur les vôtres, et c'est tout l'enjeu de cet article. Et je n'ai pas inclus Empromptu parmi les huit, c'est le sortant ici.
La question qui trie toute cette liste
Chaque outil ci-dessous se situe dans l'une de trois voies, et la voie décide de tout le reste de la décision.
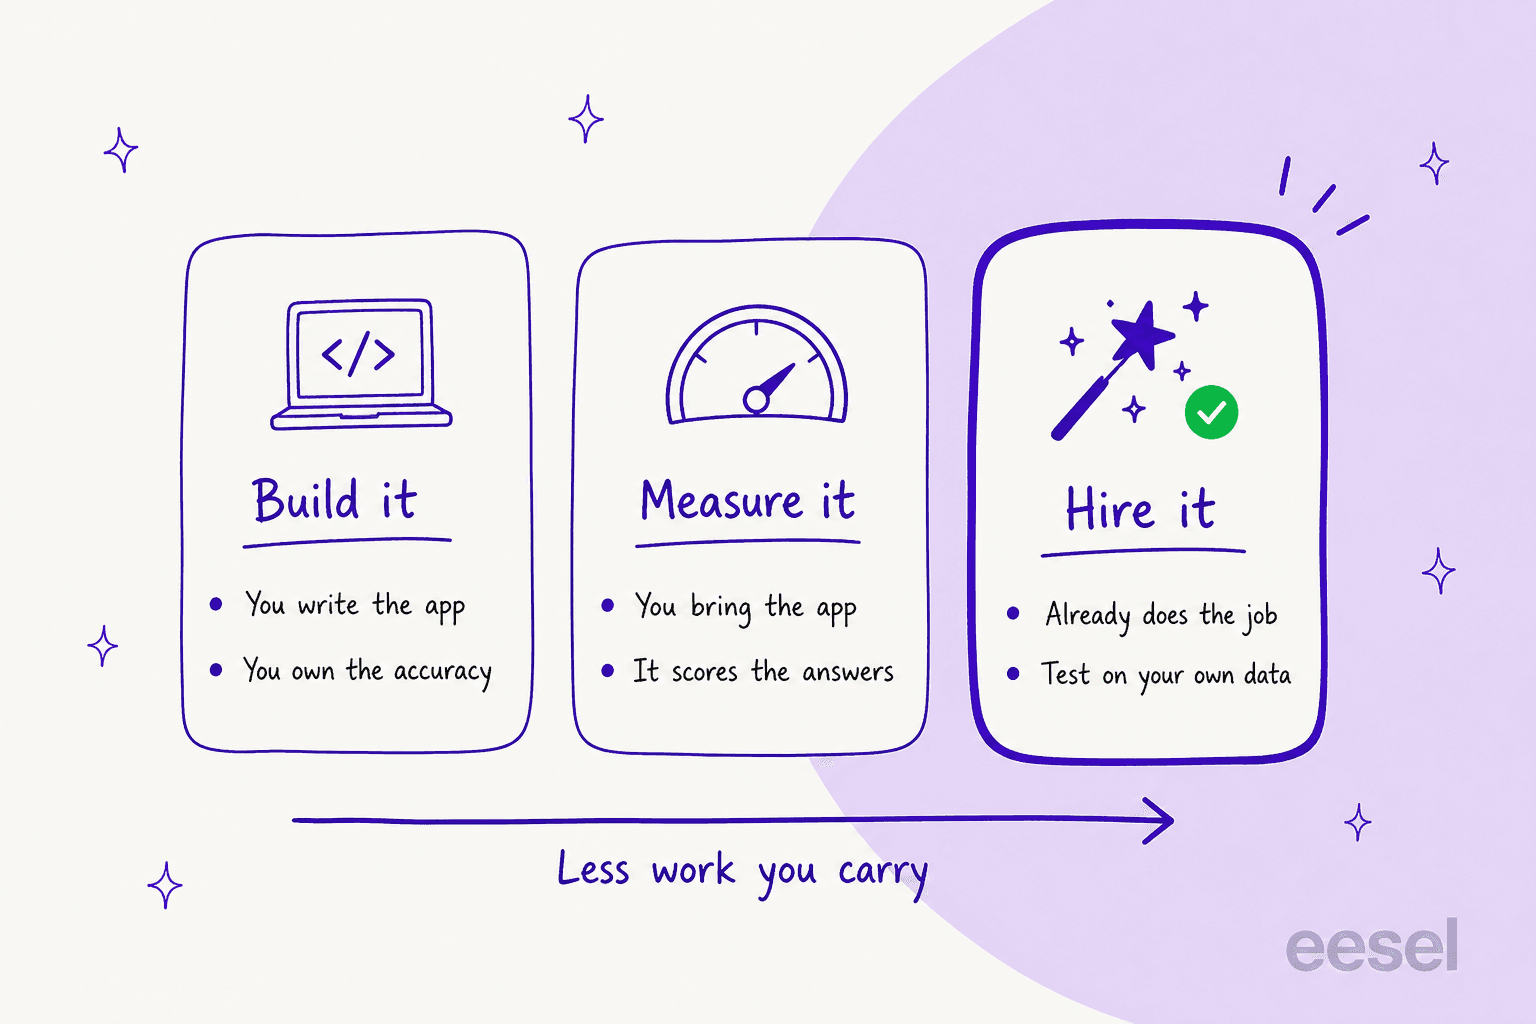
Le construire. Lovable, Replit, Bolt et la plateforme de Google vous donnent un moyen de produire une application. Aucun ne vous dira si ses réponses sont justes. Ce n'est pas un défaut, c'est simplement le périmètre de la chose. Cela signifie que vous êtes propriétaire du problème de précision, et la précision est l'endroit où ces projets vont mourir.
Le mesurer. Arize et Langfuse sont la couche de mesure, seule. Ils sont bons à cela, et honnêtes aussi sur la frontière : la documentation de Langfuse définit une tâche comme "the application code that you want to test", ce qui dit clairement que l'application est la vôtre. À savoir : ces deux outils appliquent la même méthode sous-jacente qu'Empromptu, un LLM comme juge face à des critères que vous rédigez, donc le mécanisme lui-même n'est pas le différenciateur. La différence est de pouvoir le pointer sur du vrai trafic historique avant le lancement, ou seulement sur le trafic qui arrive après.
L'embaucher. Glean et eesel forment la voie de l'achat. Le travail est déjà fait, les intégrations sont déjà là, et vous ne configurez que le périmètre et les garde-fous. La raison pour laquelle cette voie l'emporte pour le support en particulier est que le modèle n'a jamais été la partie difficile, c'étaient la récupération et la logique d'escalade, ce qui est exactement ce que j'ai constaté en comparant le RAG à un LLM brut.
Cette voie compte plus de noms qu'il n'en tient ici. Si le travail est du support orienté client et non une application d'IA interne, la liste restreinte est différente, et Decagon ou Sierra y ont aussi leur place.
Le test auquel je reviens sans cesse a été formulé par un ingénieur mieux que je ne saurais le faire :
"you shouldn't build anything that doesn't make YOUR beer taste better... your CS team buys a COTS solution for their tickets - why should you build an agent when there are multiple startups doing this? What, are you going to be better at it than those startups?"
Une réserve qui va dans l'autre sens, et je la dis clairement parce qu'eesel perd des contrats à cause d'elle : pour une équipe technique, construire directement sur l'API de Claude ou d'OpenAI est une vraie alternative, et pas toujours le mauvais choix. Plusieurs clients d'eesel sont partis faire exactement cela, dont une entreprise de technologie de la construction en RA et une marque de beauté DTC passée directement à l'API de Claude. Cas d'usage étroit, faible volume, ingénieurs avec du temps disponible : construisez.
Le contrepoids apparaît quand quelqu'un chiffre réellement la construction :
"When I started deep diving into the BRD I realized there were several full startups, charging thousands if not tens of thousands of dollars monthly for what we were trying to build. When I brought this up to my manager and showed them examples, they said ya that BRD probably has to be redone"
Les alternatives à Empromptu comparées
| Outil | Idéal pour | Voie | Prix d'entrée publié | Unité de facturation | Dépassement publié ? | Évaluations de précision intégrées ? | Test sur vos données avant le lancement ? | HIPAA / BAA | SOC 2 | Auto-hébergement ou sur site | Niveau gratuit |
|---|---|---|---|---|---|---|---|---|---|---|---|
| eesel AI | Embaucher un collègue de support | Embaucher | À partir de 299 $/mois (500 crédits) | Crédit (1 ticket ou chat) | Dépassement optionnel plafonné, 0,80 $ par crédit supplémentaire | Simulation sur les tickets passés | Oui | HIPAA sur Enterprise avec BAA signé, contactez-nous | SOC 2 Type II certifié | Non | 100 crédits gratuits, sans carte |
| Gemini Enterprise Agent Platform | Constructions réglementées avec BAA signé | Construire | Consommation uniquement, pas de frais par utilisateur | Jetons plus compteurs par composant | Oui, grille complète | Service d'évaluation, personas synthétiques | Synthétique uniquement | Oui, le BAA le couvre | Oui | Google Cloud, VPC-SC, CMEK | 300 $ de crédit |
| Glean | IA à l'échelle de l'entreprise sur les connaissances internes | Embaucher | Non publié, la page redirige désormais | Flex seat plus FlexCredits | Tarif du crédit non publié | Évaluation des agents dans la plateforme | Limité | Évaluation HIPAA | Type 2 | Déploiement privé | Non |
| Arize AX | Mesurer une application que vous exploitez déjà | Mesurer | 0 $ Free, 50 $/mois Pro | Spans de trace plus Go ingérés | Non | Oui, LLM comme juge | Hors ligne sur vos jeux de données | Enterprise uniquement | À partir du niveau Pro | Phoenix, ELv2 | Oui, 25k spans |
| Langfuse | Évaluations open source que vous contrôlez | Mesurer | 0 $ Hobby, 29 $/mois Core | Unités : traces, observations, scores | Oui, 8 $ par 100k | Oui, juges et expériences | Hors ligne sur vos jeux de données | Région prête pour HIPAA, Pro+ | Oui | Oui, licence MIT | Oui, 50k unités |
| Lovable | Livrer rapidement le prototype | Construire | 25 $/mois Pro | Crédits | Oui, 0,30 $ par crédit | Non | Non | Non, ne signe pas de BAA | Type II plus ISO 27001 | Non | Oui, plafonné |
| Replit | Construire et héberger au même endroit | Construire | 20 $/mois Core | Points de contrôle selon l'effort | Packs de crédits uniquement | Non | Non | Non documenté | Type II | Enterprise mono-locataire | Oui, limité |
| Bolt | Le premier jet le moins cher | Construire | 25 $/mois Pro | Jetons | Non publié | Non | Non | Formulé comme prêt, non certifié | Type 2 | Enterprise avec cloud propre | Oui, 300K par jour |
Deux tendances ressortent de ce tableau. Seuls trois des huit publient un tarif de dépassement, et les trois constructeurs de prototypes face auxquels Empromptu se positionne publient tous un prix, tout en ne livrant rien qui mesure si une réponse est même correcte. Sur cet écart, Empromptu a raison. La discussion porte uniquement sur qui doit le combler.
Si vous voulez ratisser plus large que ces huit, les panoramas d'eesel sur les applications d'IA pour le travail et les constructeurs d'agents sans code couvrent les rayons voisins.
Dimensionnez la facture Empromptu avant de comparer
Avant la liste, un peu d'arithmétique qui vaut la peine d'être faite. Empromptu est l'un des rares fournisseurs ici à publier à la fois la grille tarifaire et le tableau de consommation des crédits, donc convertir des dollars en opérations ne demande pas d'appel avec les ventes. Une réponse de chat coûte 10 crédits, un appel de recherche web 10, une exécution d'optimisation 10, et les petites opérations comme appliquer un prompt ou créer une évaluation 1 chacune.
Saisissez vos propres volumes :
Ce qui mérite qu'on s'y attarde : le niveau « Most Popular » Launch à 199 $ a le pire tarif par crédit de toute la grille, à 0,0796 $ contre 0,078 $ pour Build. Ce que les 199 $ achètent réellement, ce sont des capacités et non du volume : déploiement en production, domaine personnalisé, export GitHub, puis évaluations de base plus observabilité, tout commence à ce niveau. La seule vraie remise de volume arrive avec Operate, où les crédits baissent d'environ 37 % à 0,0499 $ pièce.
À 10 crédits par chat, le forfait gratuit revient à 10 conversations par mois et Build à 50, donc une charge conversationnelle consomme l'allocation dix fois plus vite que les opérations de construction. Cela vaut la peine de comparer avec un tarif forfaitaire par conversation avant de s'engager, comme je l'ai fait dans cette analyse des coûts du support par IA.
Un autre plancher à prévoir : l'Edge Case Detection, le nuage de points qui repère vos groupes de défaillances, a besoin d'environ 15 à 20 exécutions d'optimisation avant de montrer une tendance, selon la documentation elle-même. À 10 crédits chacune, cela fait 150 à 200 crédits dépensés avant que la fonction ne vous apprenne quoi que ce soit, face à un niveau gratuit de 100 crédits. Et la fonction elle-même ne commence qu'avec le forfait Operate à 499 $.
1. eesel AI
Idéal pour : les équipes qui veulent le travail de support fait plutôt qu'une plateforme pour le faire.
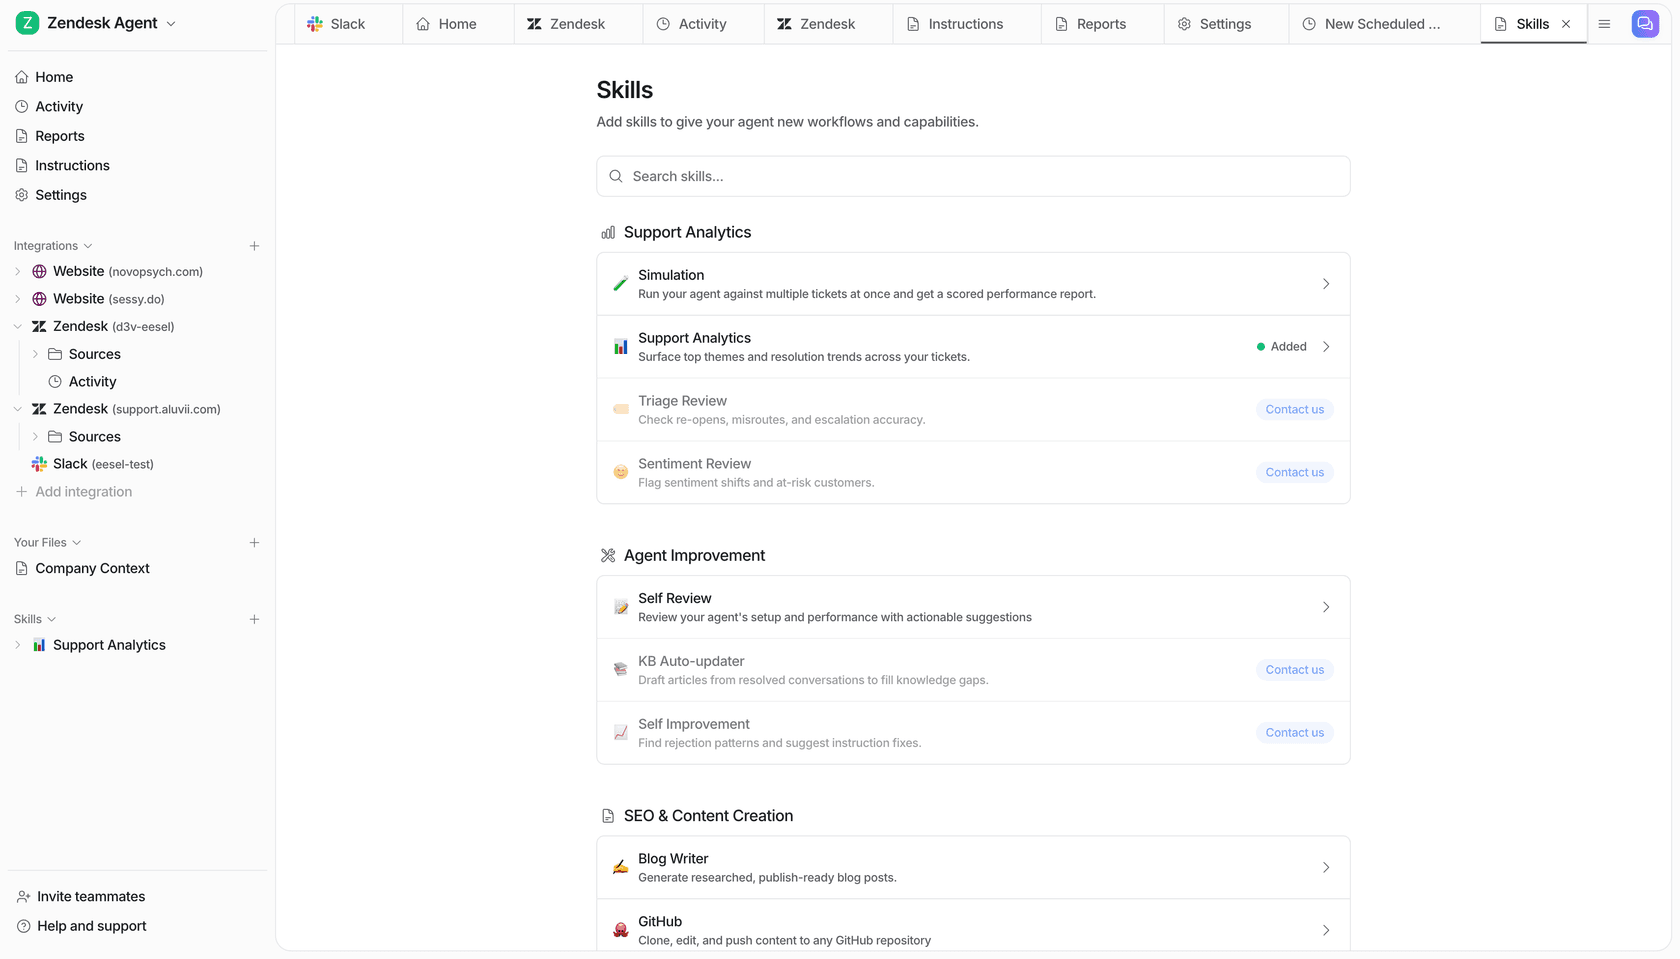
Je travaille sur celui-ci, alors lisez la suite en gardant cela en tête. Le positionnement honnête est le suivant : Empromptu est l'infrastructure, eesel est l'employé. eesel est une plateforme de collègues IA, et l'effectif actuel comprend un agent IA de helpdesk et un rédacteur de blog IA. Un collègue n'est pas quelque chose que l'on construit. On l'embauche, et il arrive en sachant déjà travailler une file.
Ce qu'il fait. Le collègue de helpdesk se connecte au helpdesk que vous utilisez déjà, ingère le centre d'aide, les tickets passés et vos documents internes, puis rédige ou résout des tickets dans le même outil où se trouvent déjà vos agents. Des seuils de confiance et des exclusions par type de ticket décident de ce qu'il traite. L'escalade vers un humain est le comportement par défaut pour tout ce qui sort du périmètre.
La partie qui compte pour cette comparaison. Avant la mise en production, il exécute une simulation sur vos tickets historiques, puis vous renvoie une prévision. La mesure se fait donc sur vos données. Pas sur celles du fournisseur. Le raisonnement derrière cette conception est dans notre analyse construire ou acheter, et le volet garde-fous dans la prévention des hallucinations pour le support.
Tarifs
| Forfait | Crédits par mois | Prix |
|---|---|---|
| Free | 100 | 0 $, sans carte |
| Teammate | 500 | 299 $/mois |
| Teammate | 1 000 | 499 $/mois |
| Teammate | 2 500 | 999 $/mois |
| Teammate | 5 000 | 1 899 $/mois |
| Brouillon d'article de blog | Par article | 4 $ chacun |
Un crédit correspond à un ticket ou un chat, quel que soit le nombre de réponses nécessaires au final. Il n'y a ni frais de plateforme ni frais par utilisateur. La page de tarifs publie la liste complète des lots, et au-delà de 5 000 crédits vous parlez à l'équipe. Payer un an à l'avance donne deux mois gratuits. Si vous êtes à court de crédits, vous pouvez activer le dépassement avec un plafond mensuel que vous fixez (0,80 $ par crédit supplémentaire). SSO et MFA sont des options à partir de 199 $ par mois, et HIPAA avec un BAA signé est disponible sur Enterprise en nous contactant. Le forfait gratuit donne 100 crédits sans carte bancaire.
Avantages
- Simulation sur vos propres tickets passés avant le lancement, et c'est l'écart que présente chaque option de la voie construire ici.
- L'unité est un ticket, donc la facture suit le travail et non un crédit qu'il faut d'abord convertir.
- Routage fondé sur la confiance et exclusion par type de ticket, l'objection que j'entends le plus de la part des responsables de support.
- En production dans un helpdesk en quelques minutes plutôt qu'en un sprint.
Inconvénients
- HIPAA relève d'un arrangement du forfait Enterprise (BAA signé) que vous mettez en place en parlant à l'équipe, et il n'y a pas d'option en libre-service. Pour une petite équipe de santé, c'est un vrai obstacle.
- Il est cantonné à des tâches précises. Si l'objectif est de construire une application d'IA quelconque, c'est la mauvaise voie, et Empromptu convient mieux.
- Vous payez les tâches que le résultat ait été parfait ou non, comme pour tout outil d'IA facturé au crédit.
Mon avis : si l'application d'IA que vous alliez construire est un agent de support, alors ne la construisez pas. Un client l'a mieux dit que moi :
"We could try to write our own LLM application but we didn't want to invest our time into that. We wanted something that we would not have to maintain."
Karel, GENERAL BYTES, from our case study
Passez votre chemin quand le cas d'usage est une chaîne de traitement de documents ou un tableau de bord prédictif. Les deux figurent sur la propre liste de choses constructibles d'Empromptu, et aucun n'est ce que fait un collègue de helpdesk.
2. Gemini Enterprise Agent Platform
Idéal pour : les constructions réglementées qui exigent un BAA signé et une vraie traçabilité de conformité.
Notez d'abord le changement de nom, avant d'aller chercher : ce qui s'appelait Vertex AI Agent Builder redirige désormais vers la Gemini Enterprise Agent Platform, que Google décrit comme "an evolution of Vertex AI". Agent Engine est devenu Agent Runtime, et Vertex AI Search est devenu Agent Search.
Ce qu'il fait. Tout ce vers quoi le niveau Enterprise d'Empromptu fait signe, mais dégroupé et tarifé par composant : inférence de modèles, un RAG Engine, Vector Search, ancrage, un service d'évaluation, des garde-fous et un environnement d'exécution d'agents géré. L'assemblage vous revient.
La conformité, qui est la vraie raison de le choisir. La couverture BAA de HIPAA cite explicitement l'Agent Platform, Agent Search et l'IA générative sur la plateforme. SOC 2 et ISO/IEC 27001:2022 sont tous deux dans le périmètre, et FedRAMP High est disponible via Assured Workloads. VPC Service Controls et CMEK sont aussi pris en charge, même si RAG Engine est ici la case faible : pas de garantie de résidence, et CMEK uniquement en mode Spanner.
Tarifs
| Compteur | Tarif |
|---|---|
| Gemini 3.1 Pro Preview | 2,00 $ en entrée / 12,00 $ en sortie par million de jetons, sous 200K de contexte |
| Gemini 3.7 et 3.6 Flash | 0,75 $ en entrée / 3,75 $ en sortie par million, passant à 1,50 $ / 7,50 $ le 1er janv. 2027 |
| Ancrage avec Google Search | 14 $ pour 1 000 requêtes d'ancrage, 5 000 gratuites par mois |
| Ancrage avec vos données | 2,50 $ pour 1 000 prompts |
| Vector Search | 3,00 $ par Gio traité, 0,45 $ par Gio d'insertions en flux, plus des heures de nœud à partir de 0,0938 $/h |
| Agent Compute | 0,085 $ par heure de vCPU, 50 heures gratuites par mois |
| Crédit nouveau client | 300 $ |
Avantages
- La réponse de conformité dont un acheteur réglementé a réellement besoin, par écrit, avec un BAA.
- Pas de prix par utilisateur ni de frais de plateforme. Pure consommation, donc un mois calme est un mois peu coûteux.
- Chaque tarif est publié, y compris les plus gênants.
- L'échelle de prix de Gemini 3 vous donne un niveau de modèle bon marché pour les 80 % ennuyeux du trafic.
Inconvénients
- Le seuil de 200K de contexte retarife toute la requête aux tarifs de contexte long, y compris les jetons sous la limite.
- Il n'existe aucun connecteur de helpdesk. Ni Zendesk, ni Freshdesk, ni Gorgias, ni Front. Chaque intégration est du code que vous écrivez puis maintenez.
- Le service d'évaluation simule des personas synthétiques, pas vos propres tickets historiques, donc ce qu'il vous dit est la façon dont l'agent traite un client imaginaire.
- Plusieurs compteurs n'ont pas encore commencé à facturer, donc la facture d'aujourd'hui n'est pas le régime établi.
- Google présente son application packagée comme ne nécessitant "no IT setup", ce qui est un aveu discret sur la plateforme.
Mon avis : la bonne réponse quand vous avez une équipe plateforme plus un responsable conformité, et la mauvaise si vous espériez vous passer des deux. Les coûts de Vector Search montent aussi fortement : l'exemple de Google lui-même chiffre un milliard de vecteurs à 5 910 $ par mois. Lisez notre guide du pipeline RAG avant de supposer que la moitié récupération est la facile, et évaluez les alternatives à Gemini si vous n'êtes pas déjà sur Google Cloud.
3. Glean
Idéal pour : déployer l'IA sur toutes les connaissances internes d'une entreprise, avec les permissions intactes.
Ce qu'il fait. Recherche d'entreprise plus agents sur plus de 275 connecteurs, et le dispositif de permissions le plus solide de cette liste. Le mécanisme porte un nom, "permission mirroring" : les connecteurs ingèrent les ACL et les appartenances à des groupes de chaque source au moment de l'exploration, et Glean évalue l'utilisateur connecté par rapport à ces permissions reflétées au moment de la requête. Les agents s'exécutent avec l'identité de l'utilisateur qui les déclenche, pas celle de l'auteur.
Conformité. SOC 2 Type 2, ISO 27001:2022, ISO/IEC 42001:2023 pour la gestion de l'IA, un rapport d'évaluation HIPAA, RGPD et TX-RAMP niveau 2. FedRAMP n'est revendiqué nulle part, ce qui mérite d'être noté, car TX-RAMP semble voisin sans être du tout la même chose. Pour voir comment cela se compare à des options plus légères, consultez notre panorama des outils de récupération de connaissances.
Tarifs
| Élément | Ce qui est publié |
|---|---|
| Prix des forfaits | Aucun. glean.com/pricing renvoie désormais un 301 vers la page d'accueil |
| Unité de facturation | Enterprise Flex Seats par utilisateur et par mois, plus FlexCredits mutualisés |
| Tarif en dollars du FlexCredit | Non publié |
| Requêtes Fast Mode | Illimitées |
| Thinking Mode, modèles standard | 100 par utilisateur et par semaine incluses, puis compteurs |
| Glean Agent Run | ~7 FlexCredits en médiane, ~114 au p90 |
| Deep Research | ~33 en médiane, ~144 au p90 |
| Frais de plateforme | Deux frais annuels à l'échelle du site : Glean Protect+ et Premium Support |
Avantages
- Le permission mirroring est réel, et non un filtre ajouté après coup.
- Plus de 275 connecteurs, donc le travail d'intégration est déjà fait.
- Glean publie son propre calendrier de déploiement d'environ 1 à 3 semaines, ce qui est exceptionnellement franc.
- La création, le test et le partage d'agents ne sont pas comptés. Seules les exécutions le sont.
Inconvénients
- La page de tarifs a disparu. Chaque chiffre en dollars vient désormais d'une conversation commerciale.
- Les FlexCredits sont une grille tarifaire complète libellée dans une unité sans prix, donc vous pouvez comparer les opérations entre elles mais pas à de l'argent.
- Les seats sont "designed to be deployed to every employee", ce qui relève le plancher.
- Deux frais annuels distincts de plateforme à l'échelle du site, en plus des seats.
Mon avis : le bon achat quand le problème est l'accès aux connaissances à l'échelle de l'entreprise et qu'il existe un processus d'achat à la hauteur. Si le problème est une seule file de support, c'est un instrument lourd, et notre décomposition des prix de Glean et les avis sur Glean détaillent où il se situe. Notez aussi que le p90 d'un Agent Run est seize fois la médiane, donc une charge qui paraît peu coûteuse pendant le pilote peut se facturer très différemment en production.
4. Arize AX
Idéal pour : mesurer une application d'IA que vous avez déjà construite et que vous exploitez vous-même.
Le fondateur d'Empromptu a nommé celui-ci directement sur Hacker News, le classant parmi les outils qui "require dedicated teams most startups don't have". À moitié vrai. Le niveau gratuit d'Arize et le projet open source Phoenix mettent une vraie évaluation à la portée d'un ingénieur seul. L'autre moitié est justifiée, car il mesure plutôt qu'il ne construit.
Ce qu'il fait. Traçage, évaluation et observabilité pour les applications LLM. Évaluateurs LLM comme juge, évaluations personnalisées, puis jeux de données et expériences, en ligne comme hors ligne. Phoenix est le noyau open source sous ELv2, auto-hébergeable en local, dans Docker ou sur Kubernetes.
Tarifs
| Forfait | Prix | Inclus | Rétention | Déploiement |
|---|---|---|---|---|
| AX Free | 0 $ | 25k spans de trace/mois, 1 Go d'ingestion | 15 jours | SaaS |
| AX Pro | 50 $/mois | 50k spans de trace/mois, 10 Go d'ingestion | 30 jours | SaaS |
| AX Enterprise | Sur mesure | Sur mesure | Sur mesure | SaaS ou auto-hébergé |
| Phoenix (OSS) | Gratuit, ELv2 | Pas de compteur | La vôtre | Votre infrastructure |
Avantages
- Utilisateurs, évaluations, expériences et files d'annotation sont illimités à chaque niveau. Le compteur porte sur les spans, pas sur les personnes.
- Phoenix est un projet open source sérieux, et l'auto-hébergement garde les traces sensibles sur votre propre infrastructure.
- Évaluation hors ligne sur vos propres jeux de données, ce qui se rapproche le plus d'un test avant lancement dans la voie mesurer.
- Le choix de la région des données est identique à tous les niveaux au lieu d'être une montée en gamme.
Inconvénients
- Aucun tarif de dépassement n'est publié nulle part. La page dit "included 25k/month" et s'arrête.
- HIPAA, SSO, journaux d'audit, évaluateurs de code personnalisés et auto-hébergement sont tous réservés à Enterprise.
- SOC 2 Type II et RGPD commencent à Pro, pas à Free.
- Le propre tableau d'Arize se contredit sur Signal : la ligne Core Platform donne une allocation à Free et Pro alors que la section Observabilité indique la détection des modes de défaillance comme réservée à Enterprise.
- Il ne construit ni n'héberge jamais votre application. La documentation énonce le prérequis sans détour : il faut d'abord des données qui circulent et un fournisseur de LLM configuré.
Mon avis : le bon choix quand l'application existe déjà et que ce qui manque, ce sont des chiffres honnêtes à son sujet. Traitez-le comme un complément d'un constructeur et non un remplacement, avec l'ensemble plus large d'outils de suivi de LLM et la boucle de réglage de l'optimisation des LLM. Il ne vous dira pas s'il faut lancer. Seulement ce qui s'est passé après.
5. Langfuse
Idéal pour : les équipes qui veulent la couche d'évaluation et veulent posséder la machine sur laquelle elle tourne.
Ce qu'il fait. Traçage, gestion de prompts, jeux de données, expériences, files d'annotation et notation par LLM comme juge. Sur la frontière, la documentation est d'une littéralité rafraîchissante : une tâche est "the application code that you want to test". Les seules choses qui s'exécutent à l'intérieur de Langfuse sont le playground et les expériences de prompts, ainsi que les appels du juge.
L'auto-hébergement est le titre phare. Langfuse OSS est sous licence MIT et gratuit avec une utilisation illimitée, et il tourne sur la même infrastructure que leur cloud, sans limite de montée en charge. Neuf fonctions de gouvernance nécessitent une clé de licence entreprise : RBAC au niveau du projet, étiquettes de prompts protégées, politiques de rétention, journaux d'audit, masquage des données côté serveur, personnalisation de l'interface, créateurs d'organisation, l'API de gestion d'organisation avec SCIM et l'API de gestion d'instance. Pour une équipe réglementée qui veut tout dans son propre VPC, c'est la réponse la plus propre de toute la liste.
Tarifs
| Forfait | Prix | Unités incluses | Dépassement | Utilisateurs | Accès aux données |
|---|---|---|---|---|---|
| Hobby | Gratuit, sans carte | 50k/mois | Aucun | 2 | 30 jours |
| Core | 29 $/mois | 100k/mois | 8 $ par 100k | Illimités | 90 jours |
| Pro | 199 $/mois | 100k/mois | 8 $ par 100k | Illimités | 3 ans |
| Option Teams | +300 $/mois | Option | - | - | - |
| Enterprise | 2 499 $/mois, engagement annuel | 100k/mois | 8 $ par 100k | Illimités | 3 ans |
Une unité est une trace, une observation ou un score. Le dépassement dégressif est de 8 $ par 100k jusqu'à 1M, puis 7 $, 6,50 $ et 6 $ à mesure que le volume augmente.
Avantages
- Auto-hébergement MIT sans plafond d'utilisation, ce qui est rare et très généreux.
- Le tarif de dépassement est publié, dégressif et facile à modéliser.
- Utilisateurs illimités à chaque niveau payant.
- Indépendant du framework, il se place à côté de ce que vous avez construit plutôt que de le remplacer.
Inconvénients
- Chaque niveau payant inclut les mêmes 100k unités et le même dépassement de 8 $. Ce qu'achète l'échelle de 29 $ à 199 $ à 2 499 $, c'est de la rétention et des limites de débit, de la sécurité et du support. Jamais du volume.
- Ses propres évaluations sont facturées : scores du juge, files d'annotation et expériences comptent tous comme unités.
- HIPAA est une "HIPAA-ready region" à partir de Pro, ce qui est une option de déploiement et non une certification.
- Okta SSO et RBAC au niveau du projet sur Cloud Pro nécessitent l'option Teams à 300 $/mois, donc une équipe Pro ayant besoin d'Okta coûte en réalité 499 $/mois.
- Le prix d'Enterprise auto-hébergé s'ajoute à votre forfait ClickHouse, selon la déclaration même de Langfuse.
Mon avis : ma recommandation par défaut dans la voie mesurer, et surtout à cause de la licence. Si ce qui vous attirait chez Empromptu était le déploiement sur site et la propriété de vos propres outils, Langfuse livre cette moitié intégralement, et l'essayer ne coûte rien. L'autre moitié, l'application elle-même, vous devez toujours l'écrire. Notre comparatif LangChain et LangGraph couvre ce qui se place habituellement dans cet écart.
6. Lovable
Idéal pour : mettre un prototype fonctionnel sous les yeux de quelqu'un cet après-midi.
La propre page de comparaison d'Empromptu soutient que "vibe coding tools get you to demo. They don't get you to production." Sur le point précis de la précision, c'est une lecture juste de ce que Lovable livre réellement.
Ce qu'il fait. Vous décrivez une application dans le chat, vous récupérez une application full-stack fonctionnelle, avec hébergement, authentification et base de données. La synchronisation Git avec GitHub et GitLab est incluse dans chaque forfait, Free compris, et le code est le vôtre par écrit.
Sur les évaluations, précisément. Il n'y a pas de banc d'évaluation, pas de jeu de données de référence, pas de métrique de précision et pas de simulation, sur aucun forfait. Ce qu'il livre, ce sont des tests logiciels (tests de navigateur, Vitest, tests d'edge functions) et une analyse de sécurité, faciles à confondre avec des évaluations. Ce qu'ils mesurent, c'est si l'application tourne. Pas si l'IA a raison. Le RAG est aussi une cible de construction ici : vous obtenez des modèles d'embeddings pour que la récupération soit à construire par vous, et il n'y a ni ingestion gérée ni rapport sur la qualité de la récupération.
Tarifs
| Forfait | Prix | Crédits | Notes |
|---|---|---|---|
| Free | 0 $ | 5 crédits de construction par jour, plafonnés à 30/mois | Pas de téléchargement du code, pas de domaines personnalisés |
| Pro | 25 $/mois | 100/mois | Édition et téléchargement du code débloqués |
| Business | 50 $/mois | 100/mois | Mêmes crédits que Pro, ajoute SSO, RBAC, centre de sécurité |
| Enterprise | Frais de plateforme plus volume, sur devis | Selon le volume | Pas de crédits de construction quotidiens |
Le dépassement est publié : 0,30 $ par crédit sur Pro et 0,60 $ sur Business. Les crédits du forfait expirent après deux mois, les recharges après douze. Les deux échelles montent jusqu'à 10 000 crédits, à 2 250 $/mois sur Pro et 4 300 $/mois sur Business.
Avantages
- Le chemin le plus rapide d'une idée à quelque chose de cliquable.
- Tarif de dépassement publié sur les deux niveaux, ce que tout le monde ici ne fait pas.
- SOC 2 Type II, ISO 27001:2022 et RGPD avec DPA.
- Membres illimités sur chaque forfait, et synchronisation Git même sur Free.
Inconvénients
- HIPAA est explicitement exclu. La documentation entreprise indique que Lovable ne signe pas de BAA et n'est pas conforme à HIPAA, ce qui l'écarte pour l'acheteur central d'Empromptu dans la santé.
- Pas d'option VPC, mono-locataire ou auto-hébergée. C'est du multi-locataire avec isolation logique et épinglage de région.
- Business coûte exactement le double de Pro pour des crédits identiques, donc vous payez pour des fonctions de gouvernance.
- Les recharges portent une majoration d'environ 20 % par rapport au tarif du crédit implicite de l'abonnement.
Mon avis : utilisez-le pour la démo, puis décidez séparément de qui possède la production. Notre test de Lovable en donne la version longue, et Emergent est le pair le plus proche si cette forme vous séduit mais pas la réponse de conformité.
7. Replit
Idéal pour : construire, héberger et exécuter la chose au même endroit.
Ce qu'il fait. Un environnement de développement cloud complet, avec un agent qui écrit, exécute et déploie. Téléchargement zip, synchronisation GitHub bidirectionnelle et accès shell rendent la propriété du code réelle, avec une subtilité : les administrateurs Enterprise disposent d'un interrupteur "Ban source code export".
Sur les évaluations. J'ai parcouru l'index complet de la documentation de Replit, les 412 entrées, et il y a zéro occurrence de "eval" et aucune page sur la précision, le RAG, la récupération, les embeddings, la vérité terrain, le benchmarking ou l'hallucination. Trois fonctions ressemblent à des évaluations sans en être : App Testing pilote un vrai navigateur mais vérifie si l'application tourne, la revue de code intégrée vérifie la qualité du code, et l'analyse de sécurité vérifie la posture face aux vulnérabilités.
Tarifs
| Forfait | Prix | Unité | Inclus | Dépassement |
|---|---|---|---|---|
| Starter | Gratuit | Crédits d'agent quotidiens | Quantité jamais publiée | Builds Lite, 1 application, expire à 30 jours |
| Core | 20 $/mois, 18 $ en annuel | Points de contrôle selon l'effort | "$20 towards most powerful models" | Packs de crédits |
| Pro | 100 $/mois, 90 $ en annuel | Points de contrôle selon l'effort | "$100 towards most powerful models" | Packs de crédits, report de 2 mois |
| Niveaux Pro supérieurs | 215 $ / 425 $ / 825 $ / 2 000 $ | Identique | Quantité de crédits non indiquée par prix | Identique |
| Enterprise | Sur mesure | Seats plus usage | Non publié | SSO/SAML, mono-locataire, IP statiques |
Les packs de crédits sont la seule voie de dépassement : 100 $ pour 100 $, 300 $ pour 290 $, 500 $ pour 480 $, 1 000 $ pour 950 $. Ils expirent au bout de six mois.
Avantages
- Un seul environnement pour construire, tester, héberger et déployer.
- Vraie portabilité du code grâce au téléchargement zip et à la synchronisation GitHub.
- Les dépenses de modèles sont répercutées au tarif d'API public du fournisseur, sans majoration.
- SOC 2 Type II est celui de Replit lui-même, non hérité.
Inconvénients
- Le compteur est l'« effort », et l'effort n'a pas de tarif publié. La documentation de Replit renvoie vers une application d'estimation plutôt qu'une grille tarifaire.
- HIPAA est totalement absent de la documentation, du livre blanc de sécurité et du centre de confiance.
- ISO 27001 dans la liste de conformité appartient à Google Cloud, présenté comme une assurance d'infrastructure et non comme celle de Replit.
- La documentation se contredit sur les noms des modes d'agent, avec Free/Power/Max sur certaines pages et Lite/Economy/Power sur d'autres.
- Mono-locataire et SSO sont des verrous Enterprise sur devis.
Mon avis : le meilleur récit de construction et d'hébergement des trois constructeurs de prototypes, et aussi le plus difficile pour lequel prévoir une facture. Un compteur que vous ne pouvez pas chiffrer est un vrai problème sur un projet réglementé, où le budget doit être approuvé avant que quoi que ce soit ne commence. Notre décomposition des prix de Replit et le test de Replit donnent une lecture plus poussée.
8. Bolt
Idéal pour : le premier jet le moins cher possible, avec une propriété du code claire.
Ce qu'il fait. Construction de prompt à application dans le navigateur, par StackBlitz, avec synchronisation GitHub bidirectionnelle, import de dépôts et déploiement hors de la plateforme. La propriété est énoncée simplement : tout le code que vous créez est votre propre code. Supabase et Netlify sont aussi documentés comme alternatives à Bolt Cloud, donc la couture du verrouillage se situe dans l'infrastructure et non dans le code.
Sur les évaluations. Aucune. J'ai lu l'index complet de la documentation, et il n'y a aucune page sur les évaluations ou les tests, aucune sur la notation de précision, le benchmarking ou le RAG. La seule fonction qui ressemble à une mesure est un audit de sécurité de l'application qu'il a construite, et face à une sortie erronée, le filet de sécurité est le retour en arrière via l'historique des versions.
Tarifs
| Forfait | Prix | Jetons | Notes |
|---|---|---|---|
| Free | 0 $ | 300K/jour plus 1M/mois | Le site se met hors ligne au plafond, support uniquement via Discord |
| Pro | 25 $/mois, 216 $/an | 10M/mois | Pas de limite quotidienne, domaines personnalisés |
| Pro 50 | 50 $/mois, 540 $/an | 26M/mois | |
| Pro 100 | 100 $/mois | 55M/mois | |
| Pro 200 | 200 $/mois | Non publié | Confirmé dans un exemple d'un document de facturation |
| Teams | 30 $/mois par membre | Par niveau, par seat, jamais mutualisés | Requis pour votre propre système de design |
| Enterprise | Sur devis | - | SSO, journaux d'audit, AWS ou Azure en propre |
Avantages
- Le point d'entrée réel le moins cher de la voie construire, avec un niveau gratuit utilisable.
- La propriété et la portabilité du code sont énoncées clairement et appuyées par une synchronisation bidirectionnelle.
- Enterprise permet d'apporter votre propre AWS ou Azure, ce qui compte pour la maîtrise des données.
- Un chemin d'import documenté depuis Lovable, si vous avez commencé là.
Inconvénients
- Le compteur est le jeton du modèle, et la FAQ même de Bolt dit que l'essentiel de l'usage vient de la synchronisation du système de fichiers de votre projet avec l'IA, donc le coût monte à mesure que la base de code grossit.
- Les jetons du forfait expirent après deux mois et ne survivent que tant que vous payez. Résiliez, et les jetons reportés meurent à la fin du cycle.
- Le tarif de recharge n'est pas publié et n'est visible qu'après connexion.
- HIPAA et FedRAMP sont formulés comme "ready" plutôt que certifiés, et seul SOC 2 Type 2 porte une véritable affirmation de conformité. Le RGPD n'apparaît nulle part dans la documentation produit.
- La remise annuelle se contredit d'une page à l'autre, avec "up to 28%" sur les tarifs et 10 % dans le document de facturation.
Mon avis : le moyen le moins cher de savoir si l'idée vaut d'être construite, et le moins adapté pour la porter ensuite. Si c'est la maison mère que vous étudiez, nos pages sur les prix de StackBlitz et les alternatives à StackBlitz couvrent ce côté.
À quoi ressemble réellement une précision mesurée
J'ai passé assez de temps auprès de files de support en production pour savoir que le bot qui sonne sûr de lui est le dangereux. C'est pourquoi chaque déploiement d'eesel simule d'abord sur des tickets historiques, avant de toucher un client.
Voici ce qui est ressorti de l'un d'eux, pour un bijoutier allemand en ligne qui traite environ 1 000 tickets par mois entre Zendesk et Shopify. Sur 284 chats réels plus une validation croisée de 100 tickets, voici ce que disait le rapport : 93 % de précision du tri, 100 % de détection du spam avec zéro faux positif dans une boîte de réception composée à 22 % de spam, 88 % de précision directionnelle des brouillons et un taux d'erreur factuelle de 7 %. Par catégorie, l'utilité des brouillons s'est établie à 93,8 % pour les retours et remboursements, 96,4 % pour les demandes de garantie et 100 % pour les questions sur les produits.
Regardez ce qui rend ceci différent de « 98 % ». Le jeu de données est nommé. Le volume aussi. Et les ratés sont publiés dans le même souffle que les réussites, car une mesure sans taux d'erreur joint est un chiffre marketing.
C'est la norme à laquelle je tiendrais chaque fournisseur de cette liste, eesel compris. Demandez le jeu de données, puis insistez pour relancer la mesure sur le vôtre.
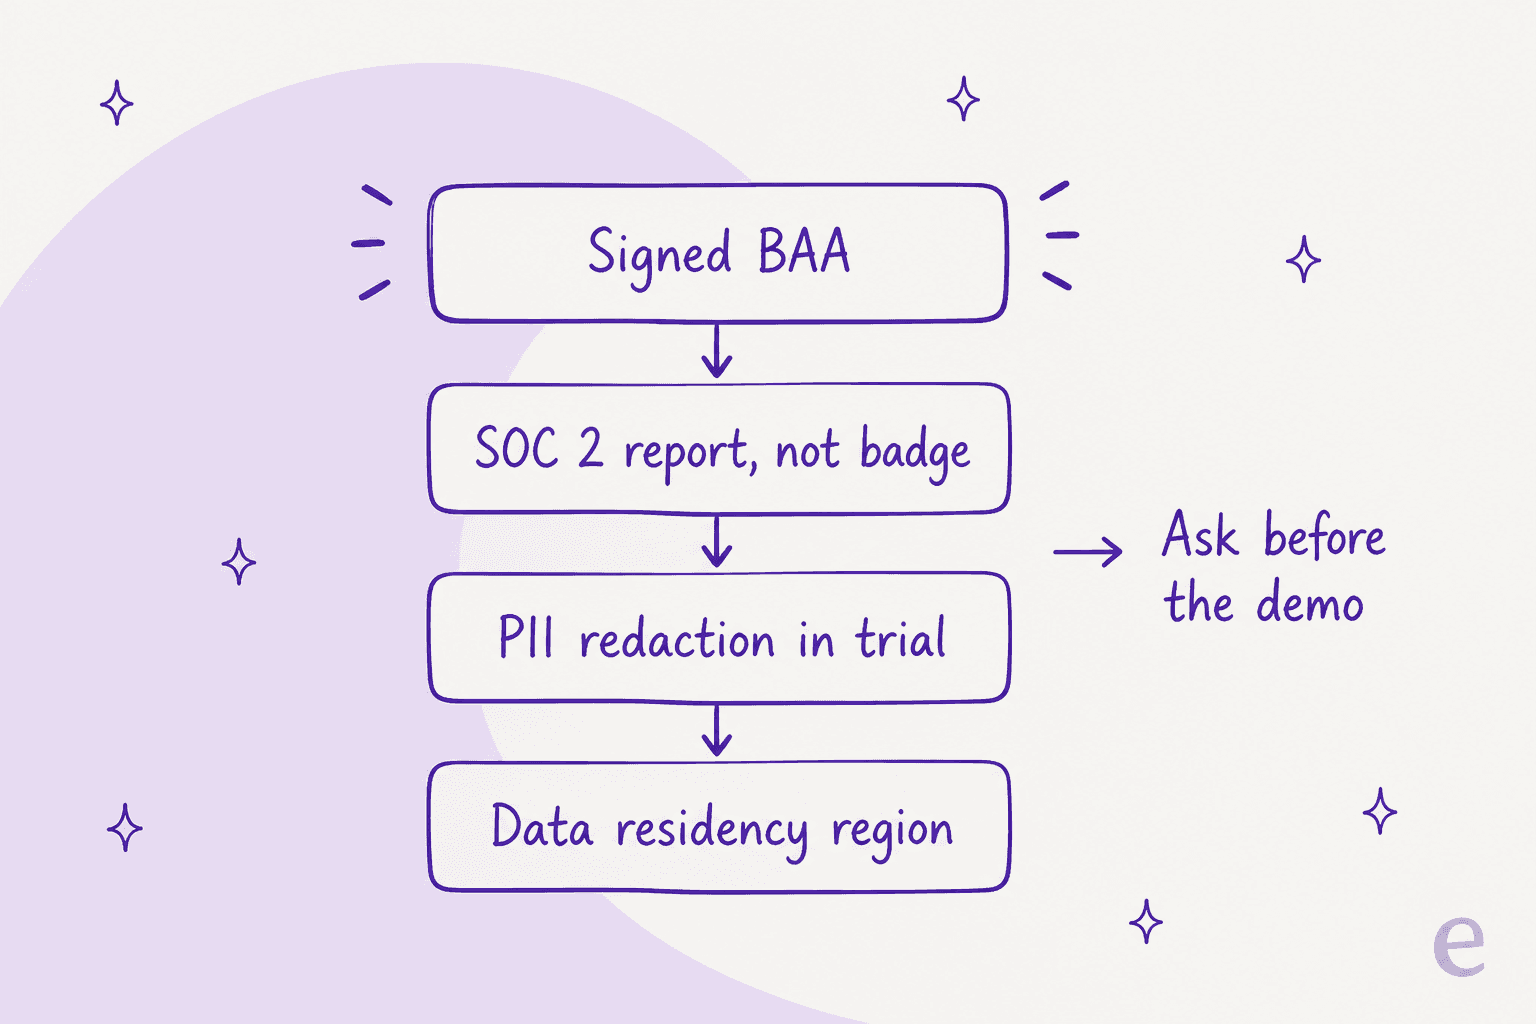
Et si l'achat concerne une équipe réglementée, franchissez les quatre portes ci-dessus avant la démo, pas après. eesel a perdu des contrats sur les quatre. Une plateforme de santé américaine sur Zendesk s'est bloquée net sur HIPAA et un BAA pendant l'appel lui-même. Une plateforme de podcasts sur Freshdesk ne pouvait pas avancer sans SOC 2. Une entreprise de médias traitant environ 1 000 tickets par semaine a fait du masquage des données personnelles pendant l'essai sa principale objection. Ces conversations coûtent beaucoup moins cher la première semaine que la sixième, quel que soit le fournisseur que vous choisissez au final. Mes notes sur l'IA conforme à HIPAA et les plateformes conformes à HIPAA listent les questions qui valent d'être envoyées à l'avance.
Essayer eesel
Si l'application d'IA qui figure sur votre feuille de route est un agent de support, alors le chemin le plus rapide est de ne pas la construire. Le collègue IA pour helpdesk d'eesel se branche sur le helpdesk que vous utilisez déjà, apprend de votre centre d'aide et de vos tickets passés, et commence à rédiger ou résoudre dans la file où vivent déjà vos agents. Les forfaits commencent à 299 $ par mois pour 500 crédits (1 crédit par ticket traité), sans frais de plateforme et sans seats, plus un forfait gratuit de 100 crédits pour démarrer et sans carte bancaire.
La partie qui concerne tout ce qui précède : vous le simulez d'abord sur vos propres tickets historiques et vous voyez la prévision avant qu'un client ne la voie. Les seuils de confiance et les exclusions par type de ticket décident de ce qu'il a le droit de traiter, ce qui rend le déploiement progressif par conception plutôt qu'un interrupteur tout ou rien.

Vous voulez la prévision sur vos propres tickets avant de vous engager à quoi que ce soit ? Essayez eesel gratuitement, ou lisez comment eesel mesure le ROI du support par IA pour savoir quoi chercher dans le rapport.
Questions fréquentes
Quelles sont les meilleures alternatives à Empromptu en 2026 ?
Combien coûte Empromptu ?
Empromptu est-il conforme à HIPAA ?
/security comme /trust renvoient une erreur 404. Pour un déploiement réglementé, demandez le BAA signé et le véritable rapport SOC 2 avant la démo. Nos notes sur l'IA conforme à HIPAA et SOC 2 pour les chatbots de support expliquent quoi demander.