Was ist ein Voice-of-Customer-Alert eigentlich?
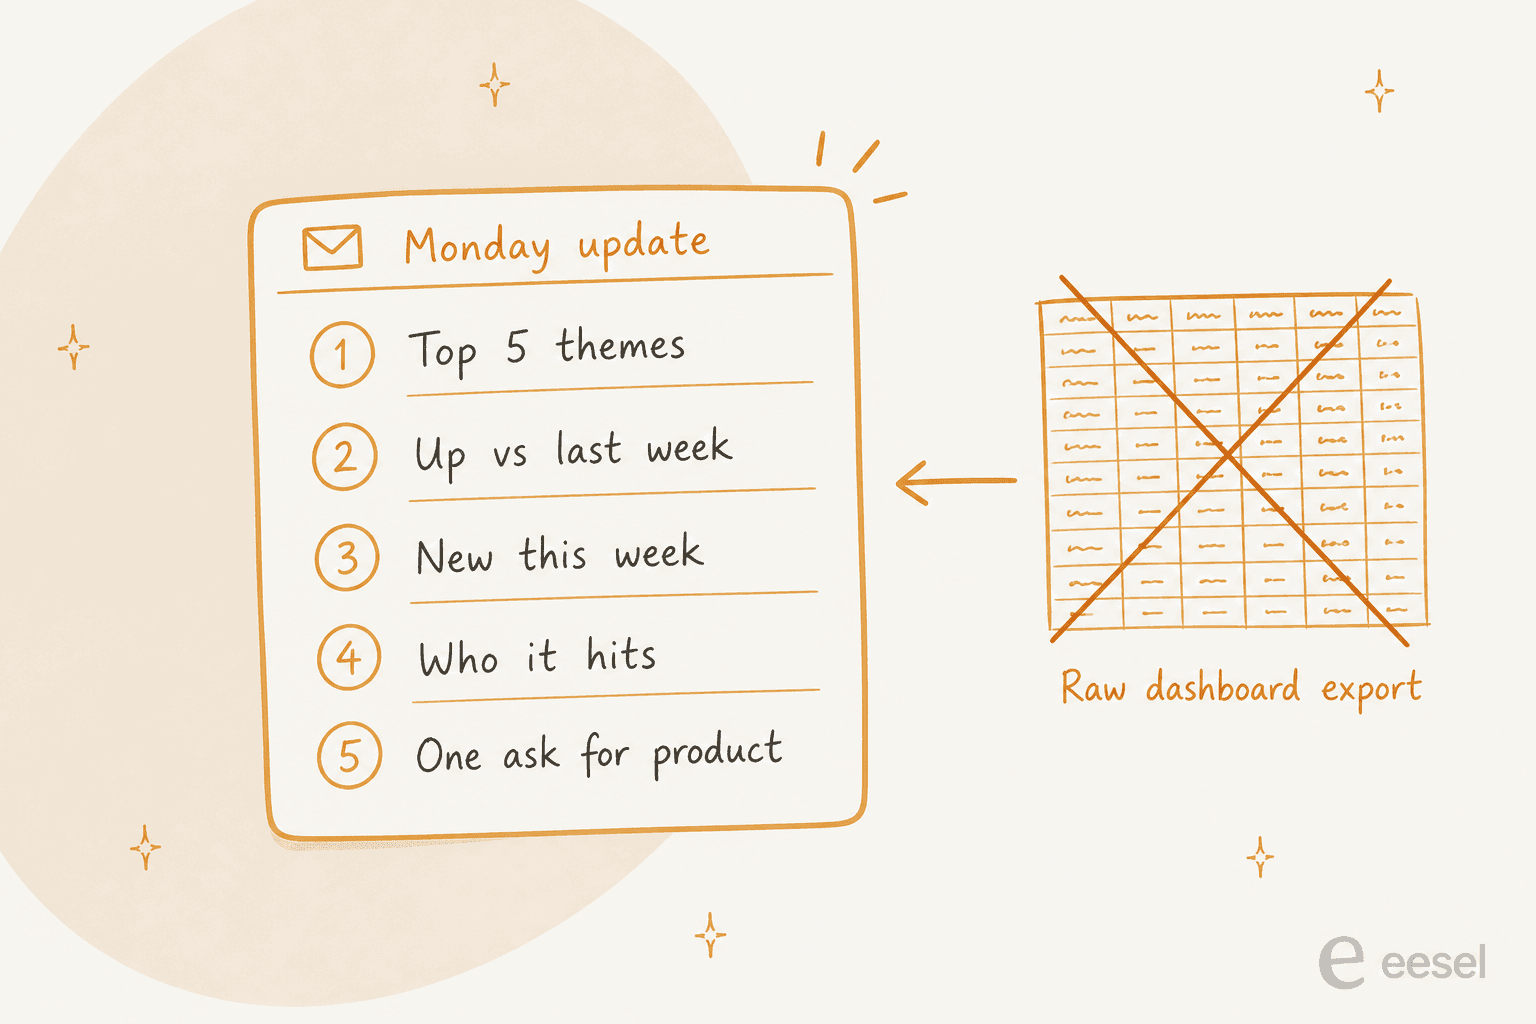
Ein Voice-of-Customer-Alert (VoC-Alert) ist die planmäßige Push-Variante der Arbeit mit der Stimme des Kunden. Statt zu warten, bis ein Product Manager einen Bericht öffnet, sendet der Support jede Woche einen Digest, der fünf Fragen beantwortet:
- Worüber beschweren sich Kunden am meisten?
- Welche Beschwerden nehmen gegenüber der Vorwoche zu?
- Was ist diese Woche neu und war vorher nicht da?
- Welche Probleme treffen die meisten Kunden oder die wichtigsten Accounts?
- Was sollten Produktteam oder Führung dagegen tun?
Diese Liste ist das ganze Format. Alles andere, die Diagramme, die vollständige Tag-Aufschlüsselung, die CSV, ist ein Drill-down-Link am Ende.
Das Format ist wichtig, weil ein Support-Team die Daten meist schon hat. Was fehlt, ist eine Version, die das Produktteam liest. Diese Reddit-Antwort einer Customer-Success-Leiterin zeigt, was passiert, wenn man stattdessen die rohen Themen schickt:
"product managers would just smile and nod at our theme reports. we eventually stopped sending summaries entirely. now i just grab 2 or 3 raw tickets where a customer explains the ridiculous workaround they had to invent, and drop those direct quotes into the product sync. they engage with the raw friction a lot faster than a pie chart."

Von der Queue-Seite sehe ich dasselbe. Eine Zahl sagt "Abrechnung: 214 Tickets". Ein Zitat aus Ticket #4.812, in dem der Kunde schreibt, dass er doppelt belastet wurde und seine Bank anrufen musste, sagt, warum es wichtig ist. Ein guter Alert enthält beides. Wenn Sie das größere Programm drumherum aufbauen, behandelt unsere Anleitung zum Voice-of-Customer-Programm die Seite von Erhebung und Rückmeldung; dieser Beitrag handelt vom wöchentlichen Versand.
Warum werden die meisten wöchentlichen VoC-Alerts ignoriert?
Drei Schwachstellen tauchen immer wieder auf, und keine davon ist das E-Mail-Tool.
Die Tags darunter sind inkonsistent
Jede Wochenzahl ist nur so gut wie das Ticket-Tagging dahinter. Wenn ein Mitarbeiter "refund" taggt und ein anderer "billing-issue" für dasselbe Problem, teilt der Alert ein steigendes Thema in zwei flache auf. Wenn die Hälfte der Tickets gar keinen Tag hat, untererfasst der Alert genau die Woche, in der ein Brand ausbricht, denn in dieser Woche haben die Mitarbeiter keine Zeit zum Taggen.
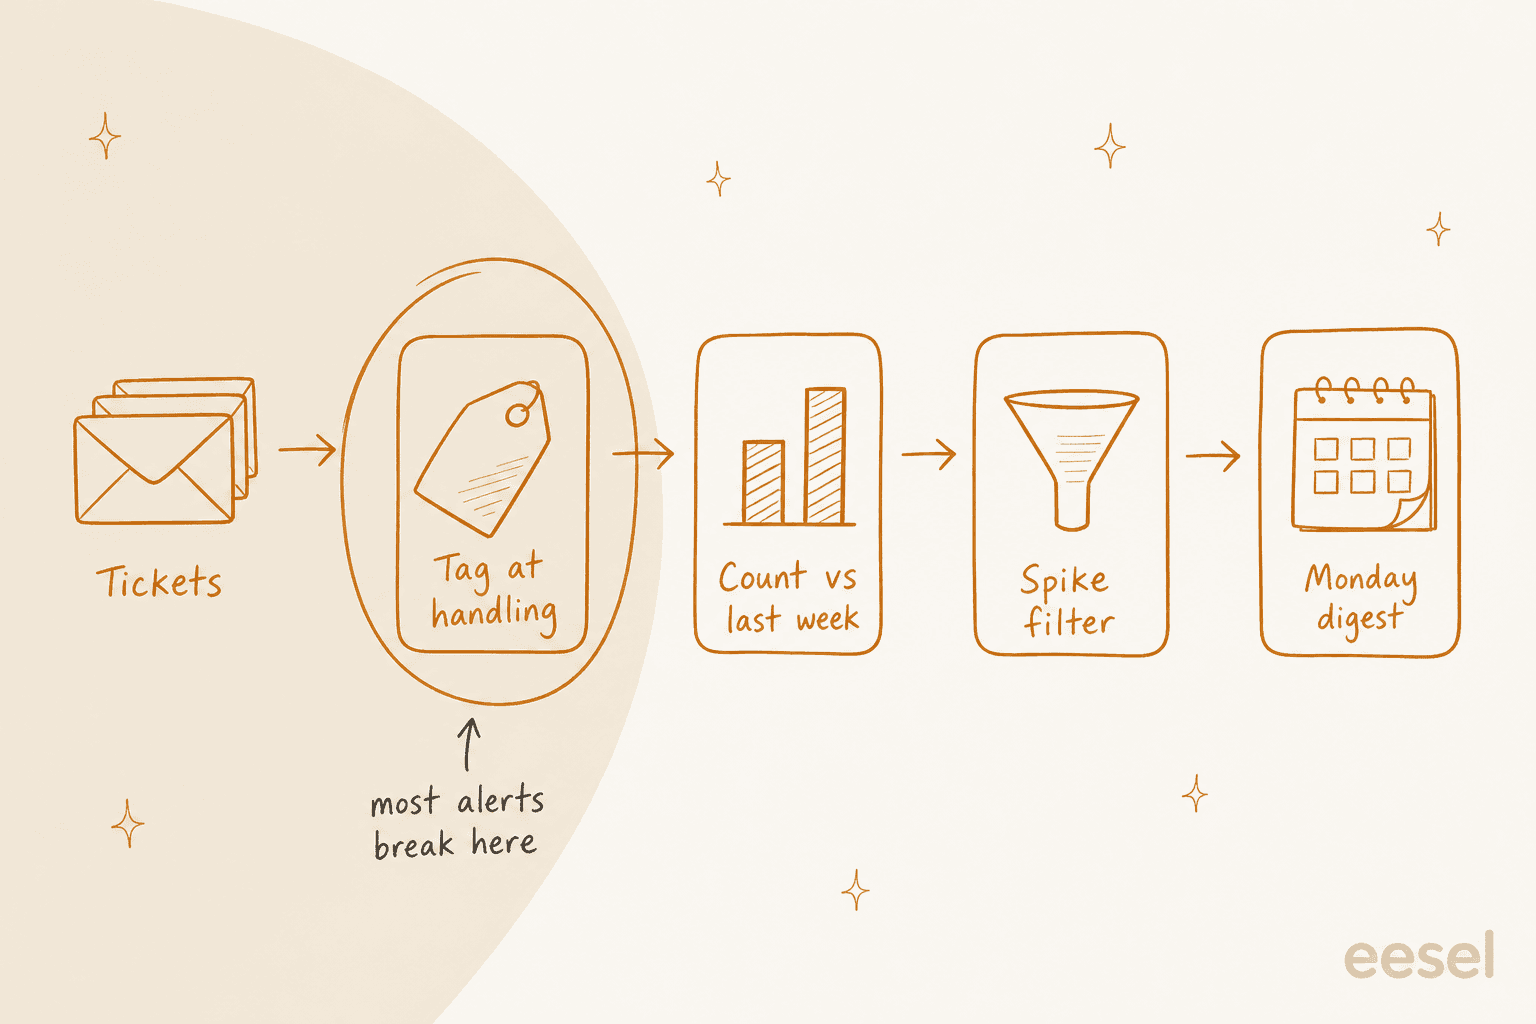
Die Lösung: Das Tagging dorthin verlagern, wo das Ticket bearbeitet wird, idealerweise per KI, damit es nicht vom Gedächtnis der Mitarbeiter abhängt. Dafür gibt es die KI-Ticket-Klassifizierung, und das würde ich beheben, bevor ich irgendein Reporting-Tool anfasse. Ein Reddit-Thread zum selben Problem enthielt diese Warnung davor, dass die Schleife veraltet:
"The last mile usually fails when the CS summary is still a pile of themes instead of something product can make a decision on. ... If CSMs never see which themes product accepted or rejected, tagging gets noisy again because nobody knows what good input looks like. Product has to train the signal, not just consume the report."
Die prozentuale Veränderung allein schlägt Fehlalarm
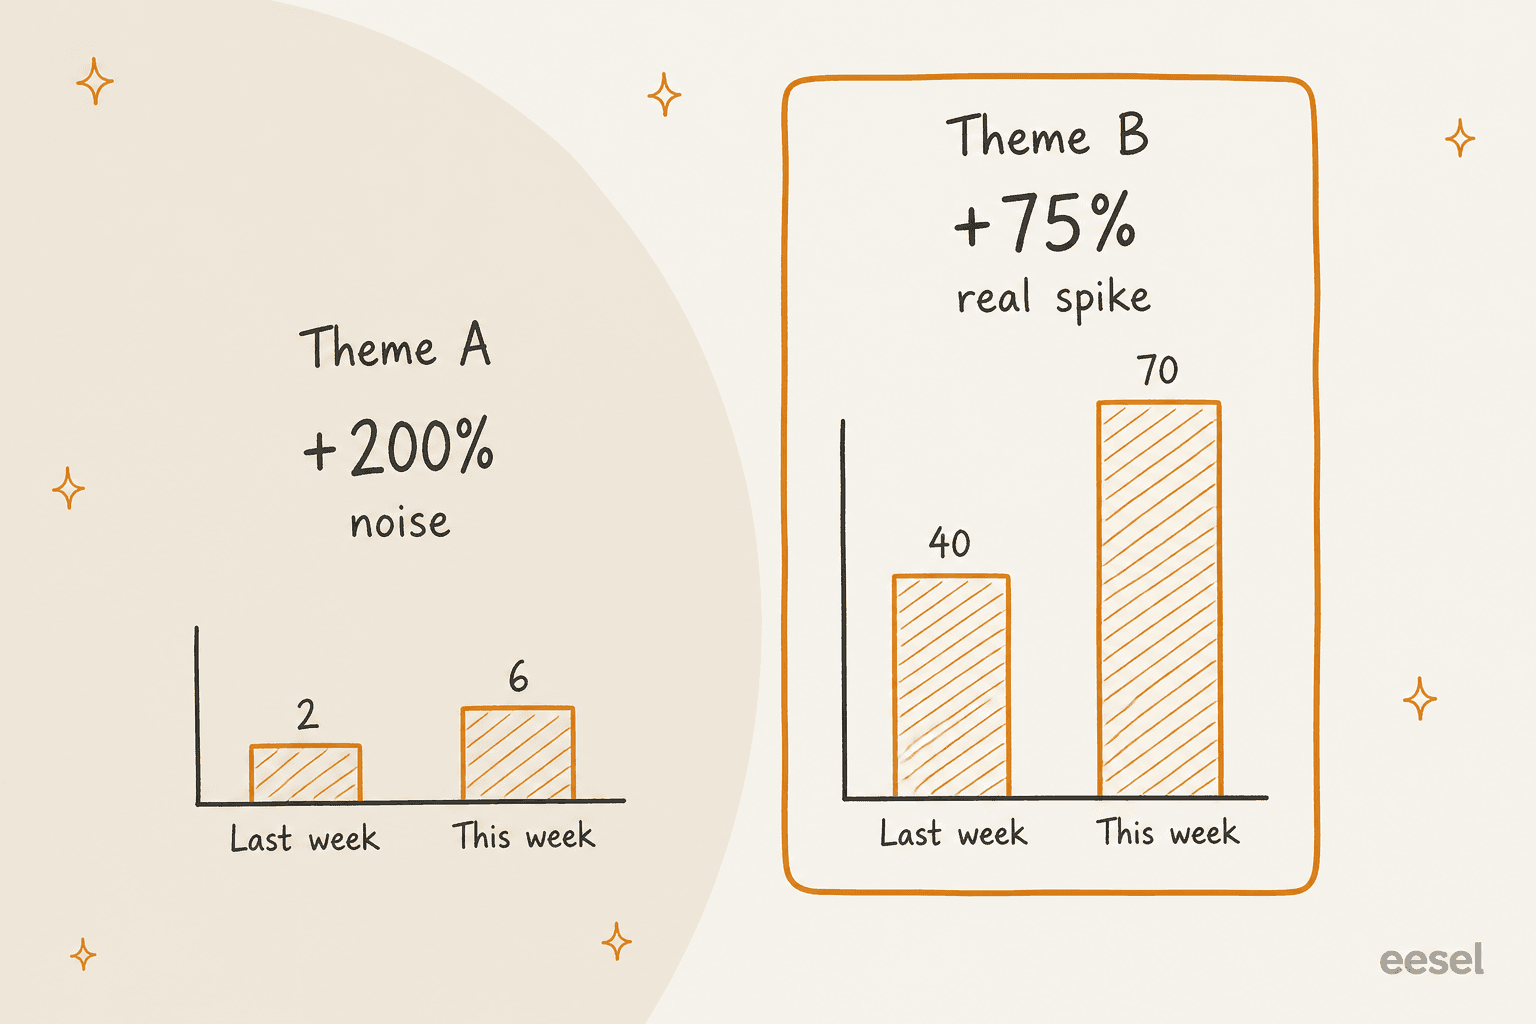
"Diese Woche +200 %" klingt dringend. Ist das Thema von 2 auf 6 Tickets gestiegen, ist es Rauschen. Ist ein anderes Thema von 40 auf 70 gestiegen, sind das nur +75 %, und genau dieses braucht heute einen Product Owner.
Gorgias formuliert das in der eigenen Reporting-Dokumentation gut: "A contact reason that's big but flat is a cost to design out; one that's smaller but climbing week over week is usually a new problem worth investigating now." Der Satz stammt aus dem Artikel zu Gorgias-Ticket-Attributen und ist die beste Ein-Satz-Spike-Regel, die ich von einem Helpdesk-Anbieter gelesen habe.
Er kommt zu spät, um noch etwas zu ändern
Ein Monatsbericht ist eine Geschichtsstunde. Ein Interessent in einem eesel-Verkaufsgespräch, ein CX-Leiter einer Nahrungsergänzungsmarke mit rund 7.000 Tickets im Monat, lehnte monatliche Analysen rundweg ab: "The customer doesn't want to wait for me to do my monthly report." Wöchentlich ist der langsamste Rhythmus, den ich für einen VoC-Alert fahren würde, mit Echtzeit-Pings nur für echte Spikes.
Wie richten Sie einen wöchentlichen VoC-Alert aus Support-Tickets ein?
So würde ich vorgehen, der Reihe nach. Die Schritte 1 und 2 kosten die meiste Zeit; die Schritte 3 bis 5 dauern einen Nachmittag, sobald die Daten sauber sind.
1. Eine kurze Liste von Kontaktgründen festlegen
Wählen Sie eine Liste von Kontaktgründen, die auf einen Bildschirm passt, und schreiben Sie zu jedem eine einzeilige Definition. Lassen Sie "Sonstiges" weg, wenn möglich. Ein Reddit-Kommentator sagte es klar: "If you open teh door with "other" then you end up back where you started with a pile of free-text entries" (u/SpeedyGoneGarbage, Reddit). Unsere Anleitung, wie Sie Support-Tickets klassifizieren, enthält ein durchgerechnetes Beispiel für eine Startliste.
2. Jedes Ticket bei der Bearbeitung taggen
Nutzen Sie die native KI Ihres Helpdesks, wo es sie gibt, oder einen KI-Agenten, der im Helpdesk arbeitet. Die Optionen:
- Zendesk: Die Intelligent Triage klassifiziert Thema, Stimmung (fünf Stufen) und Sprache anhand von Betreff und erstem öffentlichen Kommentar. Die Klassifizierungen gibt es ab den Professional-Tarifen, aber ihre Nutzung in Workflows erfordert das Copilot-Add-on für 50 $ pro Agent/Monat (jährlich).
- Gorgias: Intents werden bei jedem Ticket automatisch erkannt, in bis zu drei Detailstufen, in allen Helpdesk-Tarifen.
- Bei allen dreien: Ein KI-Teamkollege wie eesel kann Tags hinzufügen, zuweisen und Felder aktualisieren bei Zendesk-Tickets und dasselbe in Freshdesk und Gorgias.
Für den vollständigen Vergleich geht unsere Übersicht zur Automatisierung des Ticket-Taggings tiefer auf Genauigkeit und Einrichtungszeit ein.
3. Mit der Vorwoche und einer längeren Baseline vergleichen
Der Wochenvergleich fängt plötzliche Sprünge ab. Eine längere Baseline fängt langsame Anstiege ab, die in keiner einzelnen Woche dramatisch aussehen. Chattermill vergleicht zum Beispiel die letzte Kalenderwoche mit den vorherigen sechs Monaten (Chattermill-Dokumentation). Wenn Sie das selbst in einem Helpdesk-Bericht bauen, ergänzen Sie neben "diese Woche" und "letzte Woche" eine Spalte mit dem Vier-Wochen-Durchschnitt.
4. Eine Spike-Regel mit zwei Bedingungen festlegen
Markieren Sie ein Thema nur, wenn es sowohl eine Mindestanzahl als auch eine prozentuale Veränderung überschreitet, zum Beispiel "mindestens 20 Tickets und 50 % oder mehr Anstieg". Wählen Sie Zahlen, die zu Ihrem Volumen passen; ein Team mit 300 Tickets pro Woche braucht eine niedrigere Untergrenze als eines mit 30.000. Thematics eingebaute Version markiert Themen, die sich "two standard deviations above or below the recent average" bewegen (Thematic Help Center), was statistisch denselben Zweck erfüllt.
5. Dorthin senden, wo das Produktteam liest, mit Zitaten und einer Bitte
Montagmorgen, in den Slack-Kanal, in dem das Produktteam ohnehin sitzt, oder an eine kurze E-Mail-Liste. Beginnen Sie mit den fünf Zeilen, hängen Sie zwei oder drei wörtliche Ticket-Zitate an und enden Sie mit einer einzigen Bitte. Dieser Reddit-Kommentar beschreibt die Version, die bei einem Team funktionierte:
"we finally got traction by forcing everything into one simple intake (one form/tagging scheme for tickets, QBR notes, churn reasons, calls) and then doing a weekly "top 5 themes" review with PMs that includes volume, impact, a couple raw quotes, and a clear ask like "ship / research / ignore for now.""
Erfassen Sie nach Möglichkeit die Stimmung in Tickets neben dem Volumen. Ein Thema, das beim Volumen stabil bleibt, während die Stimmung sinkt, ist oft das frühe Zeichen dafür, dass sich Abwanderungssignale aufbauen.
Welche Tools können einen wöchentlichen VoC-Alert senden?
Es gibt drei Wege: aus dem eigenen Helpdesk berichten, eine Feedback-Analytics-Plattform kaufen oder es selbst mit Zapier und einem KI-Schritt verdrahten. Hier der Vergleich der Tools, die Käufer am häufigsten nennen, mit Preisen nur dort, wo der Anbieter sie veröffentlicht.
| Tool | So entsteht der Alert | Wöchentlicher Digest | Spike-Alerts | Kanäle | Veröffentlichter Preis |
|---|---|---|---|---|---|
| Zendesk Explore | Geplante Dashboard-Zustellung bei Tag- oder Triage-Berichten | Ja, beliebiger Rhythmus | Nein (nur Bericht) | E-Mail an Zendesk-Nutzer | Suite Professional 115 $/Agent/Monat (jährlich) |
| Zendesk VOC Patterns | KI-Muster aus gelösten Tickets, alle 12 Stunden aktualisiert | Kein geplanter Versand | Nein | In der App, kopieren und teilen | Kostenlose Zendesk-Labs-App |
| Freshdesk Analytics | Geplante Bericht-E-Mail | Ja (täglich, wöchentlich, monatlich) | Freddy-AI-Insights-Karten, nur in der App | E-Mail (PDF) | Pro 55 $/Agent/Monat (jährlich) |
| Gorgias | Ticket-Attribute-Bericht mit Trend ggü. Vorperiode | Keine Planung dokumentiert | Nein | CSV- oder PDF-Export | Basic 60 $/Monat (monatlich) |
| Enterpret | Agent Automations schreiben einen wöchentlichen VoC-Digest | Ja | Quality Monitor, laufend | Slack, E-Mail, PDF | Nicht veröffentlicht |
| SentiSum | Early Warning Agent und Monday Brief | Ja | Ja, in Echtzeit | E-Mail, Slack, Teams | Ab 100.000 $/Jahr |
| unitQ | Monitor mit geplanten Updates | Geplante Updates im Posteingang | Ja | Slack, Teams, PagerDuty | Nicht veröffentlicht |
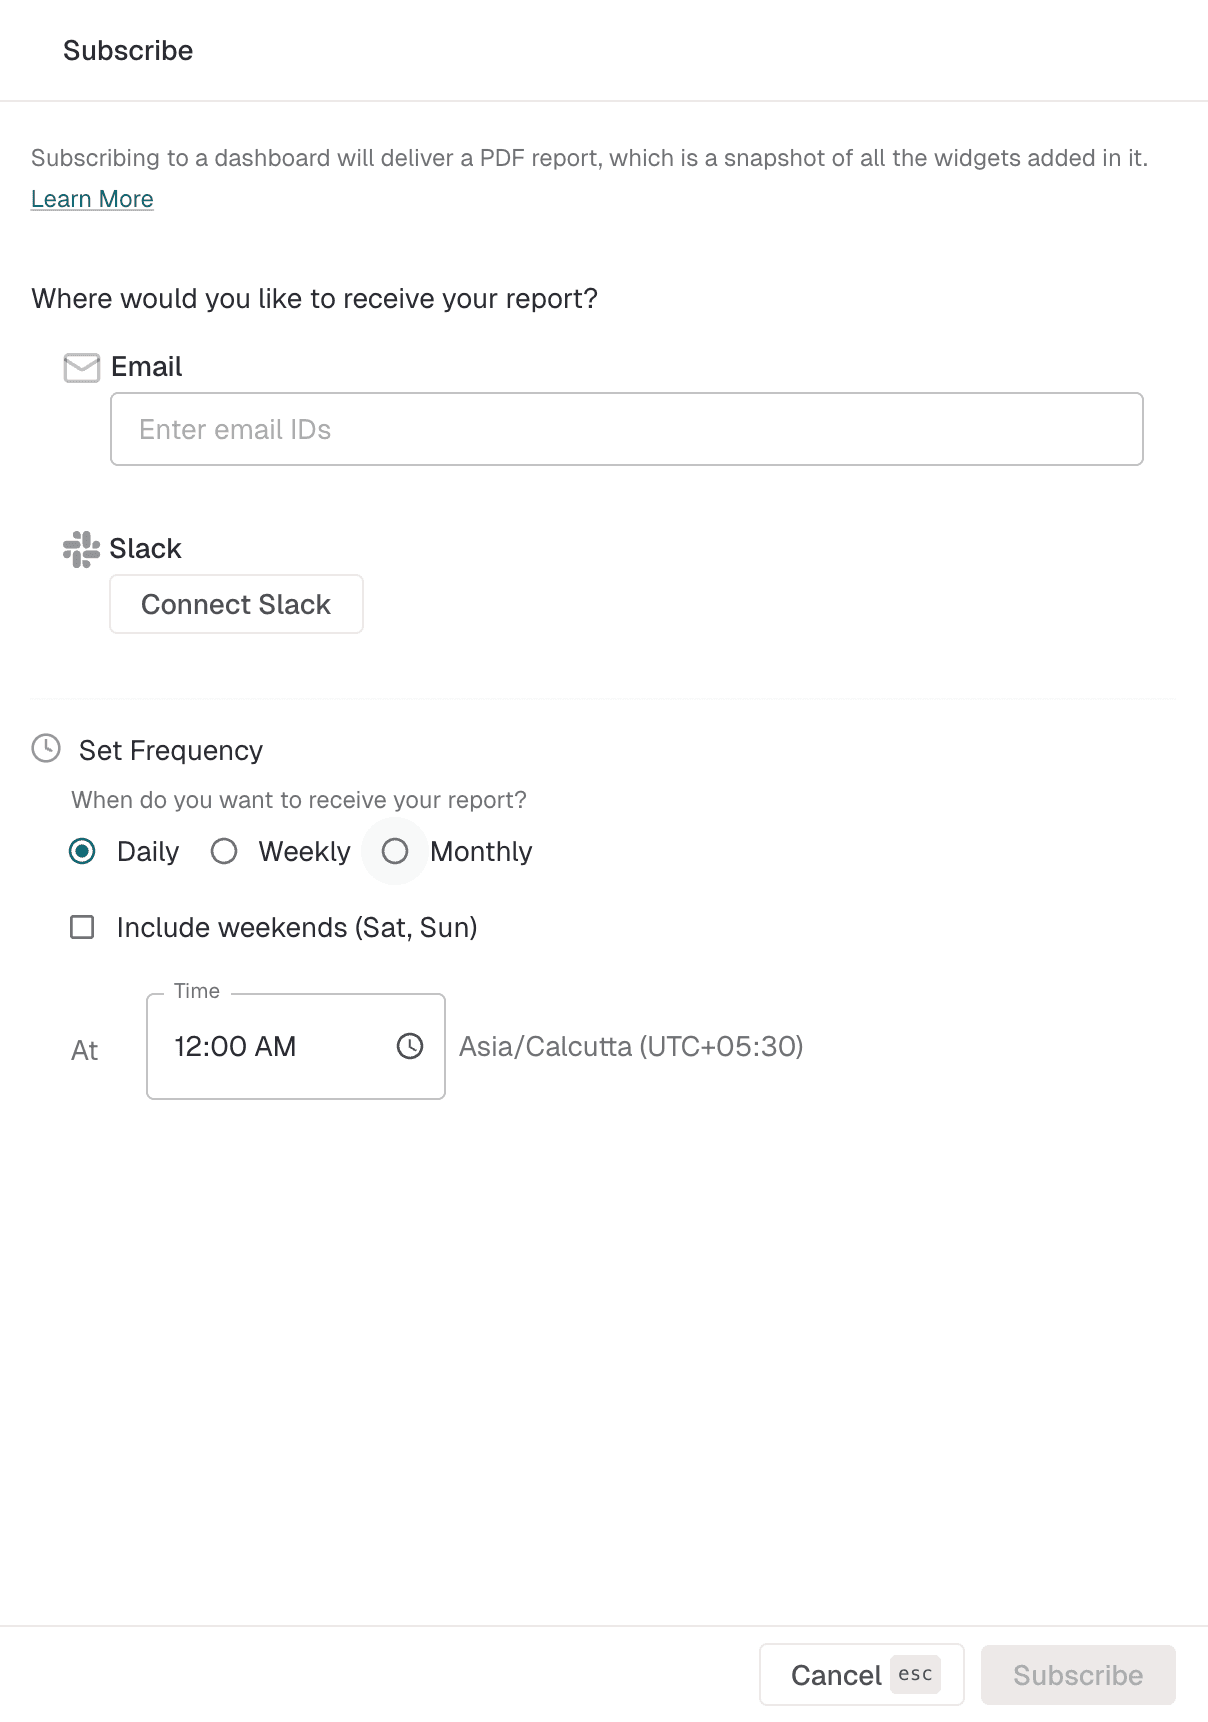
| Thematic | Workflows: Spike-Erkennung, Theme Discovery | Ja | Ja (zwei Standardabweichungen) | E-Mail, Slack | Nicht veröffentlicht |
| Chattermill | Anomalie-Alerts und geplante Berichte | Ja | Ja (ggü. sechs Monaten) | E-Mail, Slack, Jira | Nicht veröffentlicht |
| Productboard | Zendesk-Tickets als Notizen importiert, Spark-Briefing | Briefing in der App | Nein | In der App, E-Mail, Slack über Spark | Nicht veröffentlicht |
| Zapier | Digest by Zapier plus ein KI-Schritt | Ja, Sie bauen es selbst | Nur wenn Sie es bauen | E-Mail, Slack, beliebig | Professional ab 19,99 $/Monat |
| eesel | KI-Teamkollege taggt Tickets, Ticket-Trends-Skill nach Zeitplan | Ja | Kein eigener Spike-Monitor | Slack, Dateien | Ab 299 $/Monat |
Weg 1: im eigenen Helpdesk
Das ist der günstigste Weg, wenn Ihre Tags schon sauber sind, und der begrenzteste bei der Hälfte "was hat sich verändert und warum".
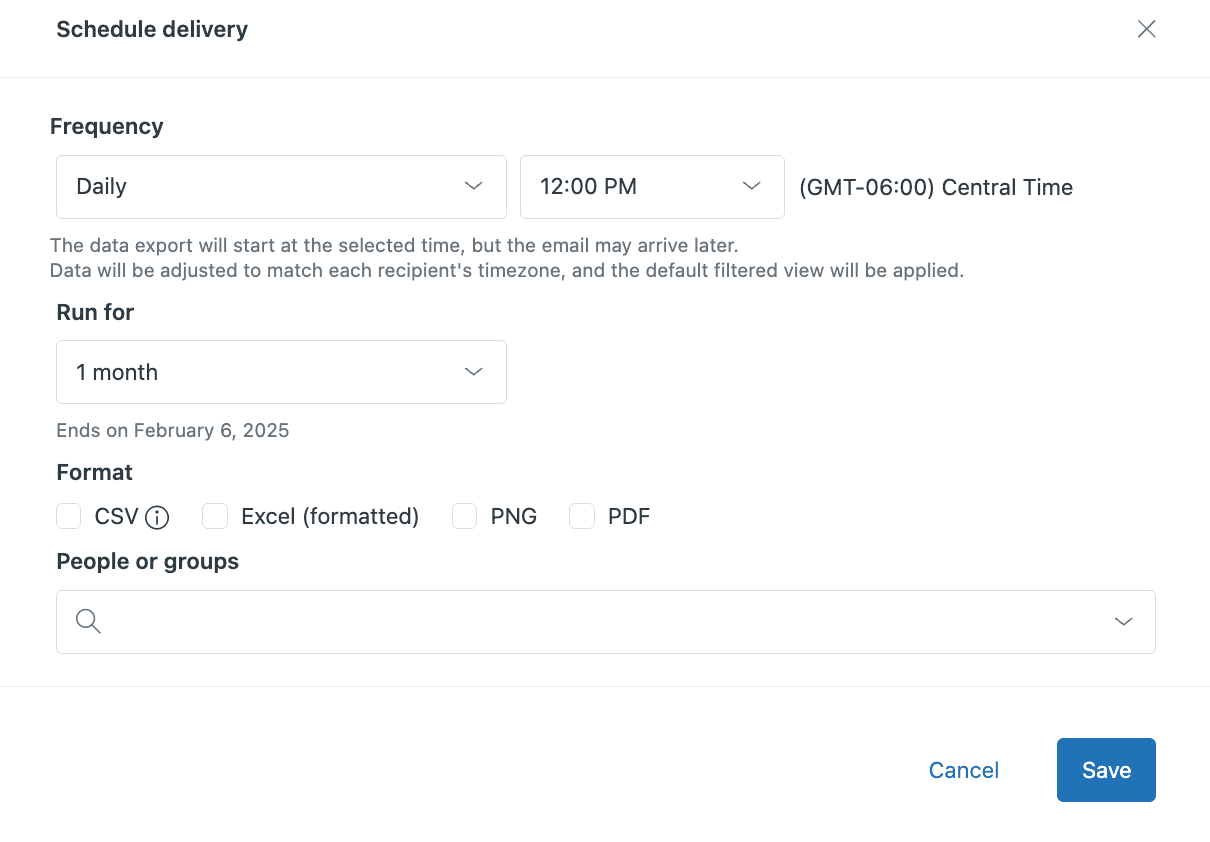
Zendesk hat keinen einzelnen Button für eine "wöchentliche VoC-E-Mail". Der native Weg besteht aus drei Teilen: Die Intelligent Triage füllt die Felder für Thema und Stimmung, ein Explore-Dashboard berichtet darüber, und die geplante Dashboard-Zustellung versendet es per E-Mail. Die Planung erfordert laut Zendesk-Preisen Suite Professional, Enterprise oder Enterprise Plus (oder Support mit Explore Professional oder Enterprise). Suite Team für 55 $ pro Agent/Monat hat gar keine geplante Zustellung.
Drei Stolpersteine aus Zendesks eigener Dokumentation, die gerade VoC-Alerts treffen:
- Empfänger müssen Zendesk-Nutzer sein. Der Versand an Personen ohne Lizenz erfordert einen Enterprise-Tarif, eine Admin-Einstellung und einen
explore-Tag im Profil der Person (Zendesk Help Center). - Jeder Zeitplan läuft höchstens 12 Monate und verfällt dann, und eine Zustellung wird nach fünf fehlgeschlagenen Exporten in Folge ausgesetzt.
- Wird der Agent, der einen Zeitplan erstellt hat, herabgestuft, werden seine Zustellungen sofort gelöscht.
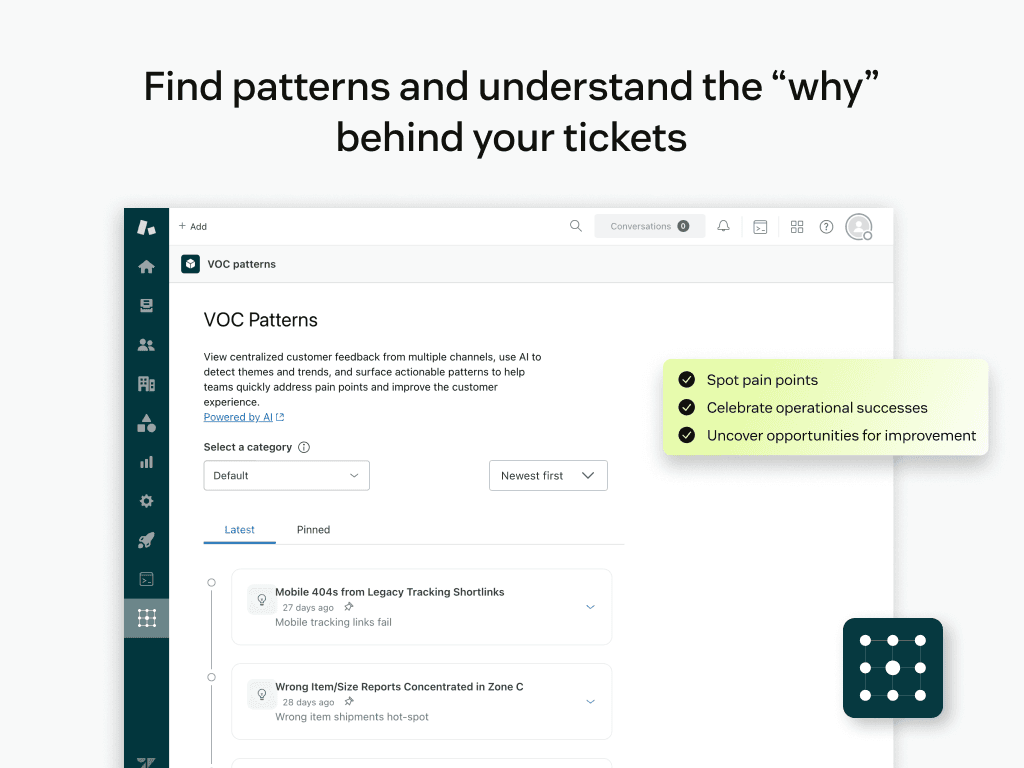
Für die "Warum"-Hälfte liefert Zendesk Labs die kostenlose VOC-Patterns-App. Sie gruppiert gelöste und geschlossene Tickets in bis zu fünf Kategorien und schreibt dann Muster mit Ursachen, empfohlenen Maßnahmen und echten Kundenkommentaren. Sie aktualisiert alle 12 Stunden und empfiehlt etwa 50 Tickets pro Kategorie. Der Haken bei einem wöchentlichen Alert: Muster "can be copied and shared through text, chat, or email, but not exported as files", und es gibt keinen geplanten Versand.
Die Spotlight Insights von Zendesk QA können ebenfalls Kundenverhalten markieren, etwa Erwähnungen von Wettbewerbern, mit bis zu 10 aktiven Prompts pro Account, brauchen aber das QA- oder WEM-Add-on und versenden keinen Digest. Für die Selbstbau-Details behandeln unsere Anleitungen zu Ticket-Trends in Explore und zum Attribut Ticket-Tags die Berichtsseite.
Freshdesk kann Berichte per E-Mail planen, täglich, wöchentlich oder monatlich, in Pro und Enterprise, wobei ganze Berichte als PDF kommen. Die Proactive Insights von Freddy AI markieren Spikes und Einbrüche im Wochenvergleich in Enterprise, aber laut FAQ lassen sich Insights nicht exportieren, und es gibt noch keine Benachrichtigungen per E-Mail, Slack oder Teams. Unsere Anleitungen zu Freddy AI Insights und Freshdesk Analytics gehen weiter.
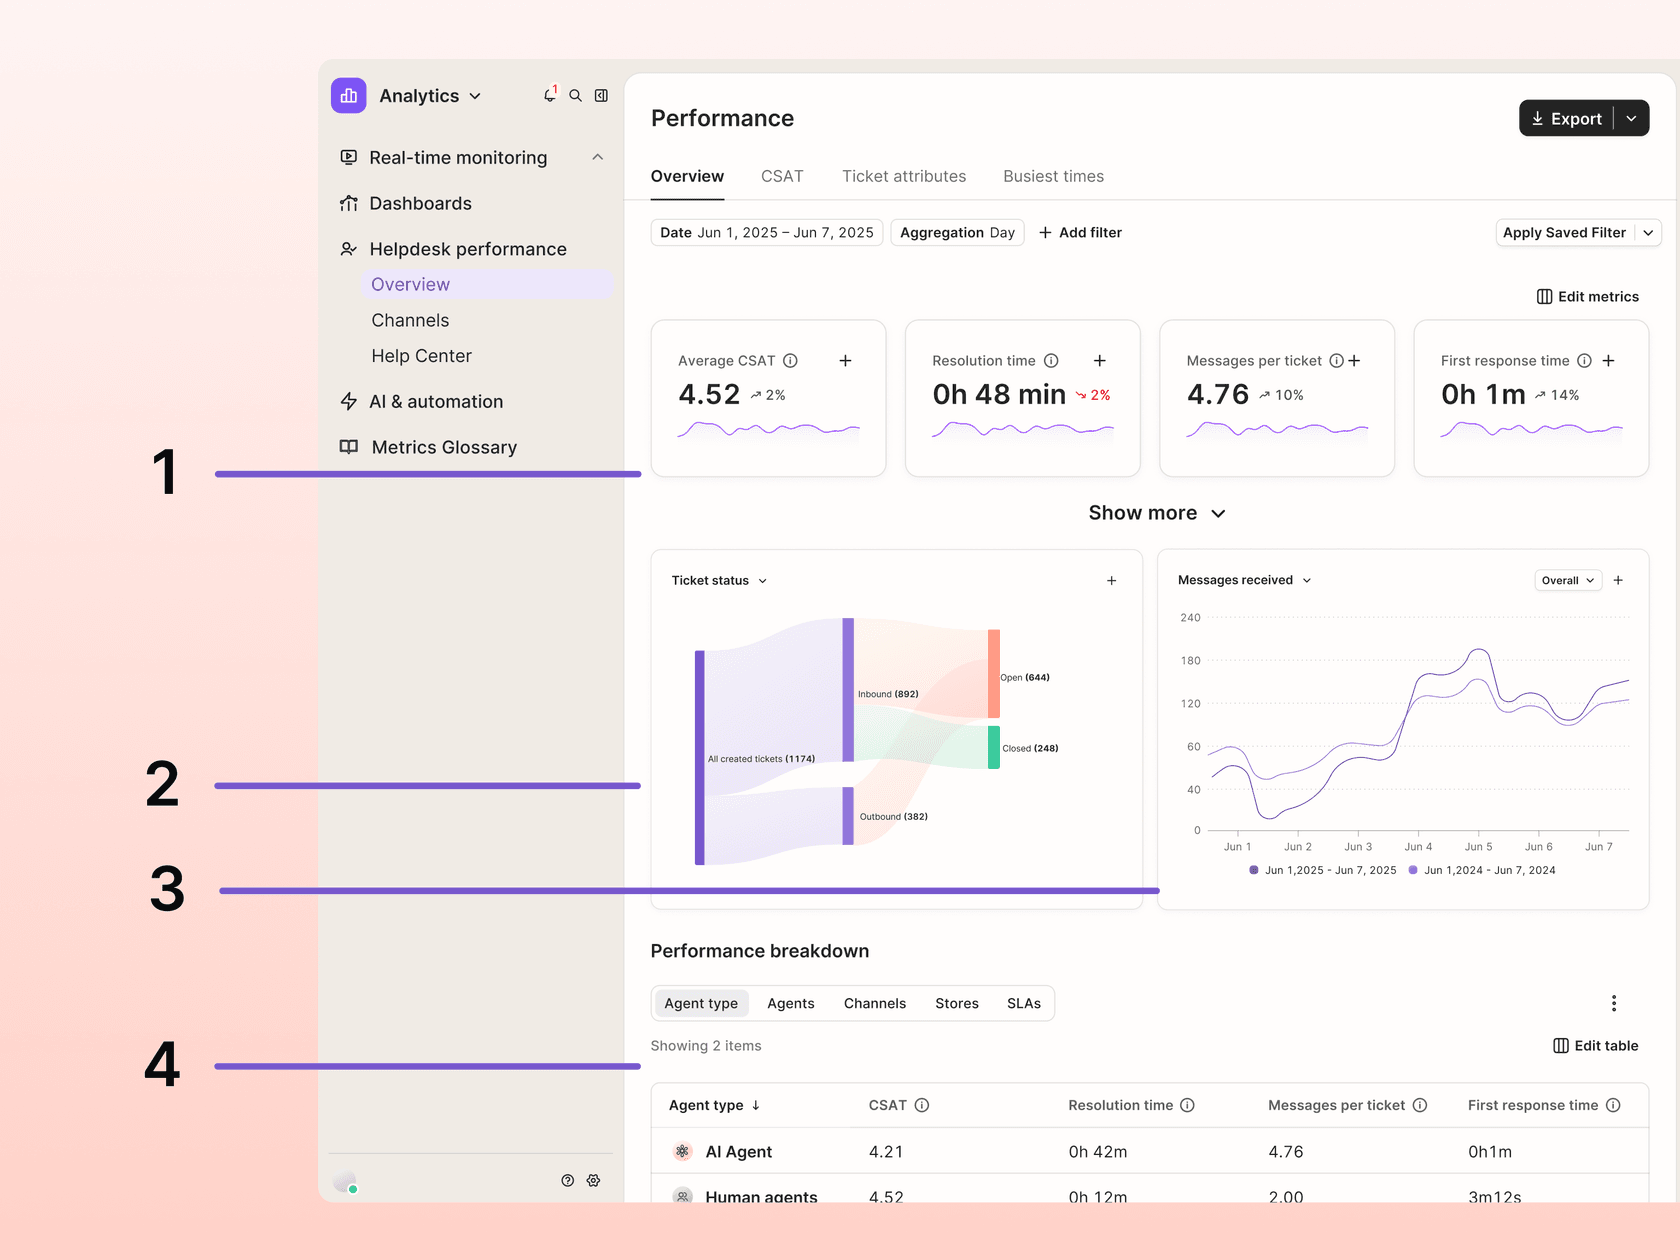
Gorgias hat einen starken Bericht für diese Aufgabe und keinen Scheduler. Der Tab Ticket-Attribute reiht das Volumen nach Intent, Tag oder Ticket-Feld, mit einer Trendspalte gegenüber der vorherigen Periode gleicher Länge, in allen Helpdesk-Tarifen. In der Reporting-Dokumentation habe ich keine geplante E-Mail gefunden, also exportiert jemand am Montag ein PDF oder verdrahtet es mit Zapier.
Weg 2: eine Feedback-Analytics-Plattform
Diese Tools existieren, um Themenerkennung, Spike-Rechnung und Digest-Texte für Sie zu übernehmen. Sie ziehen auch Bewertungen, Umfragen und Anrufe ein, was ein Helpdesk-Bericht nicht kann. Der Preis dafür sind die Kosten und eine zweite Taxonomie, die gepflegt werden muss; keines der fünf folgenden Tools veröffentlicht einen Self-Serve-Preis außer SentiSum, und dessen Einstieg ist hoch. Für eine breitere Auswahl siehe unsere Übersicht der Customer-Feedback-Tools.
Enterpret passt am besten zum oben beschriebenen Alert-Format. Seine Agent Automations liefern "a short executive snapshot, the themes that moved with volume and week-over-week deltas, representative verbatim quotes, and a link back to the source feedback behind every claim." Der Beispielzeitplan der Doku ist wöchentlich, montags, 8:00 Uhr, zugestellt an einen Slack-Kanal, eine Slack-DM oder per E-Mail. Ein separater Quality Monitor überwacht laufend und alarmiert nur bei Spikes. Zendesk-Tickets werden alle vier Stunden synchronisiert. Kein öffentlicher Preis; die Nutzung läuft über KI-Credits.
Ein G2-Rezensent nannte den Kompromiss ehrlich: "you can't expect it to be 100% accurate from day one. It takes some investment to refine the data taxonomy" (Verified User, G2).
SentiSum verkauft einen "Monday Brief", der die Erkenntnisse der Vorwoche nach Dollar-Auswirkung ordnet, plus Echtzeit-Slack-Alerts seines Early Warning Agent, der Spikes bei Volumen, Stimmung, wiederholten Kontakten und Lösungszeiten verfolgt. Der Preis steht auf SentiSums Preisseite: "One annual partnership. From $100,000." Dafür gibt es unbegrenzt Nutzer und die Einrichtung durch das eigene Team, mit einem Ausstiegsrecht in den ersten 90 Tagen.
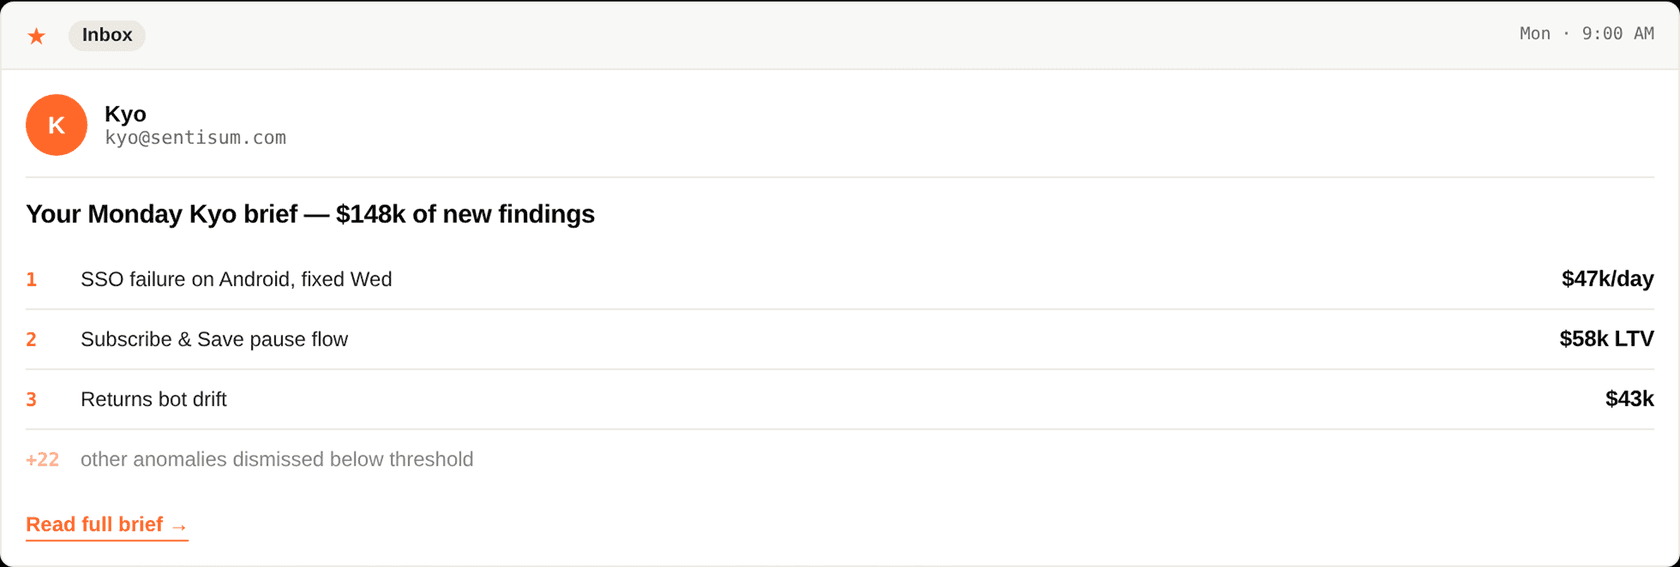
Beachten Sie die Zeile "+22 other anomalies dismissed below threshold" in dieser E-Mail. Das ist die Spike-Regel aus Schritt 4, fertig für Sie erledigt.
unitQ erkennt Anomalien im Feedback und alarmiert über Slack, Microsoft Teams oder PagerDuty, mit Wochenvergleich und geplanten Updates im Posteingang, laut Seite zum unitQ Monitor. Ein G2-Rezensent beschrieb, wie er damit "monitor trends in this feedback through automated alerts that quickly inform us through Slack" (Ilya K., G2). Nur per Demo, kein öffentlicher Preis.
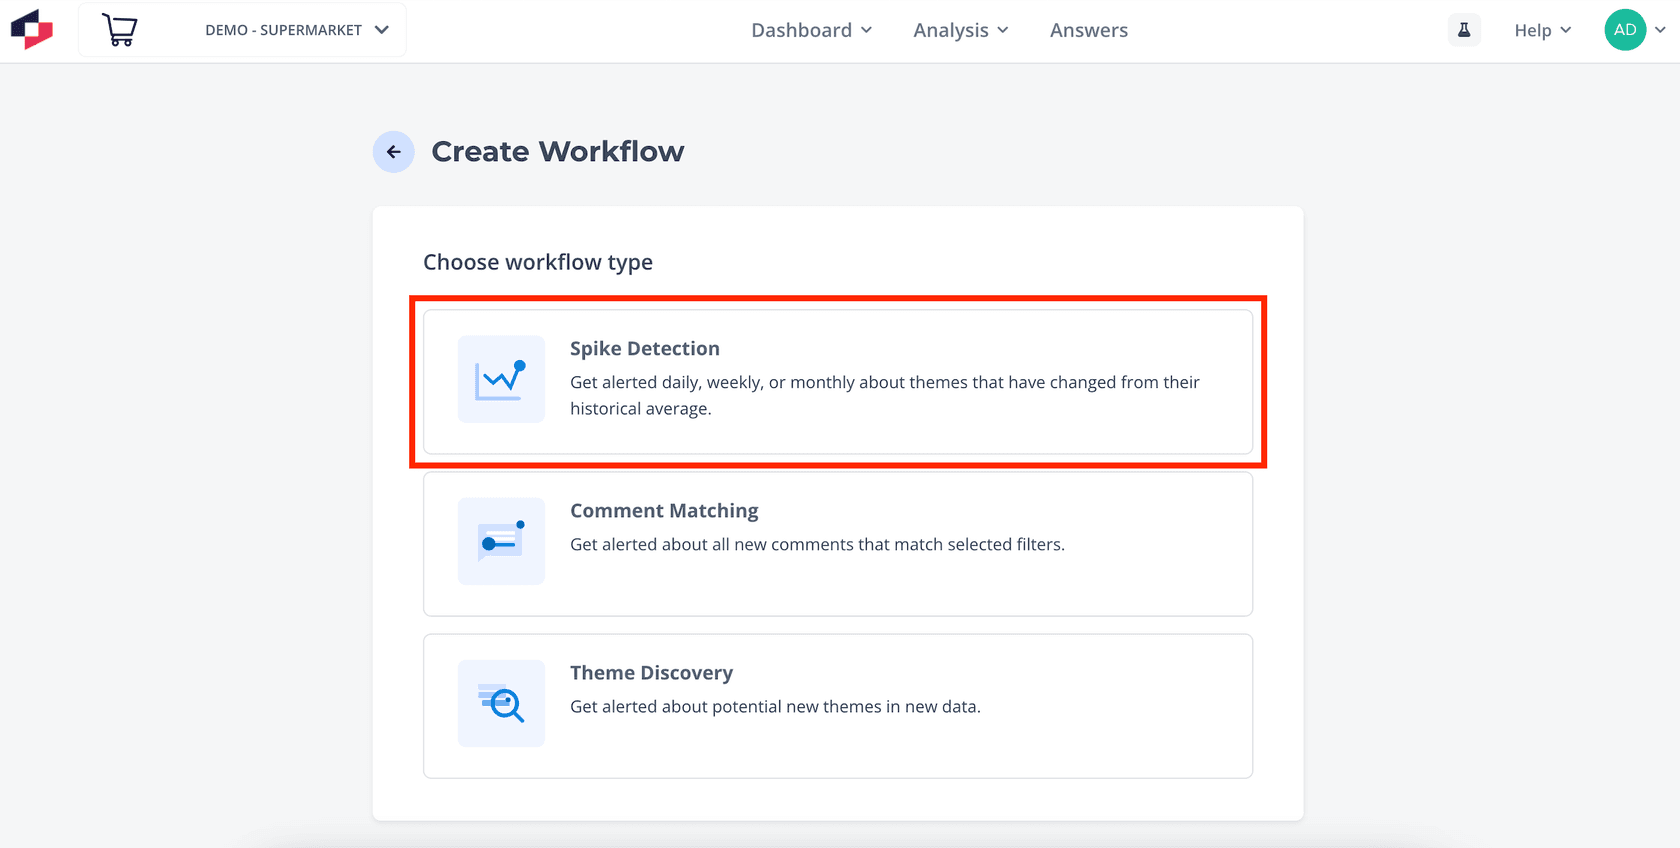
Thematic hat drei Alert-Workflows: Spike Detection, Comment Matching und Theme Discovery, jeweils per E-Mail oder Slack versendet. Die Produktseite verspricht "custom dashboards and weekly digests" für Führungskräfte, die sich nie einloggen.
Chattermill sendet Anomalie-Alerts zu Volumen oder Net Sentiment bei hoher, mittlerer oder niedriger Empfindlichkeit, plus geplante PDF-Berichte per E-Mail oder Slack. Eine Warnung: Die Seite zur Zendesk-Integration behauptet Ticket-Sync, während der einzige Einrichtungsartikel im Help Center CSAT-Umfragekommentare betrifft; klären Sie die Ticket-Abdeckung also in einer Demo.
Productboard ist die Seite des Produktteams bei der Übergabe. Seine Zendesk-Integration schiebt Tickets als Feedback-Notizen hinein, sobald sie Ihren Importregeln entsprechen, und Spark baut ein wöchentliches Briefing der drei größten Kundenprobleme auf der Startseite. Es funktioniert am besten, wenn das Produktteam Tickets mit Roadmap-Funktionen verknüpfen will, nicht als Absender des Alerts selbst.
Weg 3: mit Zapier und einem KI-Schritt selbst bauen
Wenn Sie diese Woche etwas ohne neuen Vertrag brauchen, kann Zapier das. Verbinden Sie einen Zendesk-Trigger "New Ticket" mit Digest by Zapier, mit der Aktion Append Entry and Schedule Digest auf wöchentlich, und fügen Sie dann einen Schritt AI by Zapier hinzu, der die Einträge der Woche zu Themen gruppiert, vor dem E-Mail- oder Slack-Schritt. Digest und Schedule zählen nicht als Tasks, KI-Schritte aber schon: 1 Task bei Standard-Modellen, 3 bei Advanced und 5 bei Premium, und neue KI-Schritte stehen standardmäßig auf Premium.
Preise laut Zapiers Preisseite: Free kann das nicht, da es nur Zaps mit zwei Schritten gibt und kein AI by Zapier. Professional beginnt bei 19,99 $/Monat und bringt mehrstufige Zaps und Premium-Apps wie Zendesk. Unsere Übersicht zu den Zapier-Tarifen erklärt, wie Tasks sich summieren.
Der Haken: Digest fügt nur Roheinträge zusammen. Es vergleicht keine Wochen und wendet keine Spike-Regel an, also leistet der KI-Prompt die gesamte Analyse auf einer Woche Text, ohne Baseline. Für eine Notiz zu den Top-Themen reicht das; bei "was steigt" ist es schwach. Was der KI-Schritt kann und was nicht, lesen Sie in unserer Anleitung zu Zapier AI.
Welches wöchentliche VoC-Setup passt zu Ihrem Team?
Wählen Sie die Zeile, die Ihrer heutigen Lage am nächsten kommt.
Wählen Sie Ihren Ausgangspunkt, um das Setup zu sehen, das ich zuerst fahren würde. Die Preise stammen von der jeweiligen Preisseite der Anbieter.
Wo passt ein KI-Helpdesk-Teamkollege hinein?
Jeder Weg oben setzt voraus, dass die Tickets schon gut etikettiert sind. Genau diesen Teil verändert ein KI-Agent im Helpdesk, weil er ohnehin jedes Ticket liest.
Der KI-Agent von eesel für Zendesk arbeitet in der Queue wie ein weiterer Agent: Er entwirft oder sendet Antworten, fügt Tags hinzu, weist Tickets zu und aktualisiert Felder, mit einem Trigger für die Triage bei der ersten Kundennachricht. Dieselben Aktionen gibt es für eesel für Freshdesk und eesel für Gorgias, wo er auch benutzerdefinierte Felder wie Produkt oder Anliegen-Typ füllen kann. Jede Aktion kann eigenständig laufen, zuerst um Freigabe bitten oder ausgeschaltet bleiben. Kim Simpson von Gridwise schrieb in einer G2-Rezension, eesel "even includes automations for ticket tagging, assignment, and status updates."
Bei großem Volumen macht genau das eine Wochenzahl lesenswert. Bei smava, einem deutschen Kreditvergleichsportal, ordnet eesel rund 14.600 der 27.000 monatlichen Zendesk-Tickets einer Kategorie aus einem vom Team geschriebenen Mapping-Dokument zu, mit dem Ergebnis in Zendesk-Feldern. Bei Dokument 24, einer dänischen Seite für Rechtsdokumente, ist jede erste Nachricht nach Produkt getaggt (Testament, Ehevertrag, Vorsorgevollmacht oder Firmengründung), 430 Tickets in einem Monat. Solche Tags werden gesetzt, wenn das Ticket eintrifft, nicht aus dem Gedächtnis des Mitarbeiters beim Schließen.
Für den Digest selbst hat eesel einen Skill "Analyze ticket trends", der wiederkehrende Themen, Stimmung, Volumen und Lösungsmuster über Ihre Gespräche berichtet. Die eesel-Skills-Dokumentation beschreibt, wie man einen Skill an einen Zeitplan hängt, "for example a report every Monday morning", und das Ergebnis über eesel in Slack in Slack postet.
Um ehrlich über die Grenzen zu sein: eesel ist keine Feedback-Analytics-Plattform. Es zieht keine App-Bewertungen oder Umfrageantworten ein, hat keinen eigenen Spike-Monitor und kein VoC-Dashboard. Wenn Sie eine kanalübergreifende Taxonomie brauchen, ist Weg 2 der richtige Kauf. Wenn Ihr VoC-Signal überwiegend aus Support-Tickets besteht, bringen saubere Tags plus ein wöchentlicher Trendbericht Sie ein gutes Stück weit.
Fehler, die ich auf der Support-Seite sehe
- Jedes Thema senden. Wenn der Alert 40 Tags auflistet, liest niemand über den fünften hinaus. Kürzen Sie auf die Top fünf und die Aufsteiger.
- Keine Zitate. Eine Zahl ohne Kundensatz bekommt ein Nicken. Eine Zahl mit einem schmerzhaften Zitat bekommt ein Ticket.
- Keine Bitte. Enden Sie bei einem Punkt mit "ship, research or ignore". Ein Reddit-Kommentator sagte, ein wöchentliches Review habe erst Zugkraft bekommen, als es "a clear ask" enthielt.
- Die Schleife zu den Agenten nie schließen. Wenn Agenten nie hören, was das Produktteam mit einem Thema gemacht hat, sinkt die Tagging-Qualität binnen Wochen.
- Stimmung ignorieren. Ein stabiles Thema mit sinkender Stimmung übersieht man leicht; Zendesk-Stimmungsanalyse oder Freshdesk-Stimmungsanalyse können diese Spalte füllen.
Ein Hacker-News-Kommentator beschrieb die Kosten, wenn man all das auslässt, besser, als ich es könnte:
"This is a huge pet peeve of mine. Parts of the organization are in direct contact with customers, and are in a position to learn a lot. And those parts are often only connected to the decide-what-to-make parts either informally or via going all the way up to the C-level and then back down. It's maddening."

Ein wöchentlicher VoC-Alert ist die günstige Lösung für diese Lücke. Kombinieren Sie ihn mit den Kundenservice-KPIs, die die Führung ohnehin verfolgt, und Themen erscheinen neben den Zahlen, die sie erklären, etwa CSAT und Abwanderung.
eesel für sauberere wöchentliche VoC-Alerts testen
Wenn Ihr Montags-Digest immer wieder auseinanderfällt, weil die Hälfte der Queue ungetaggt ist, beginnen Sie mit dem Tagging. eesel stößt als KI-Teamkollege zu Zendesk, Freshdesk oder Gorgias, taggt und routet Tickets, während er sie bearbeitet, und kann jeden Montag einen Ticket-Trendbericht in Slack ausführen, sodass der Alert, den Sie dem Produktteam senden, jedes Ticket zählt und nicht nur die, die ein Mitarbeiter Zeit hatte zu etikettieren. Die Tarife beginnen bei 299 $/Monat für 500 Credits auf den eesel-Preisen, mit Berichten und geplanten Agenten inklusive, und der kostenlose Tarif gibt Ihnen 100 Credits, um es an Ihren eigenen Tickets zu testen.