

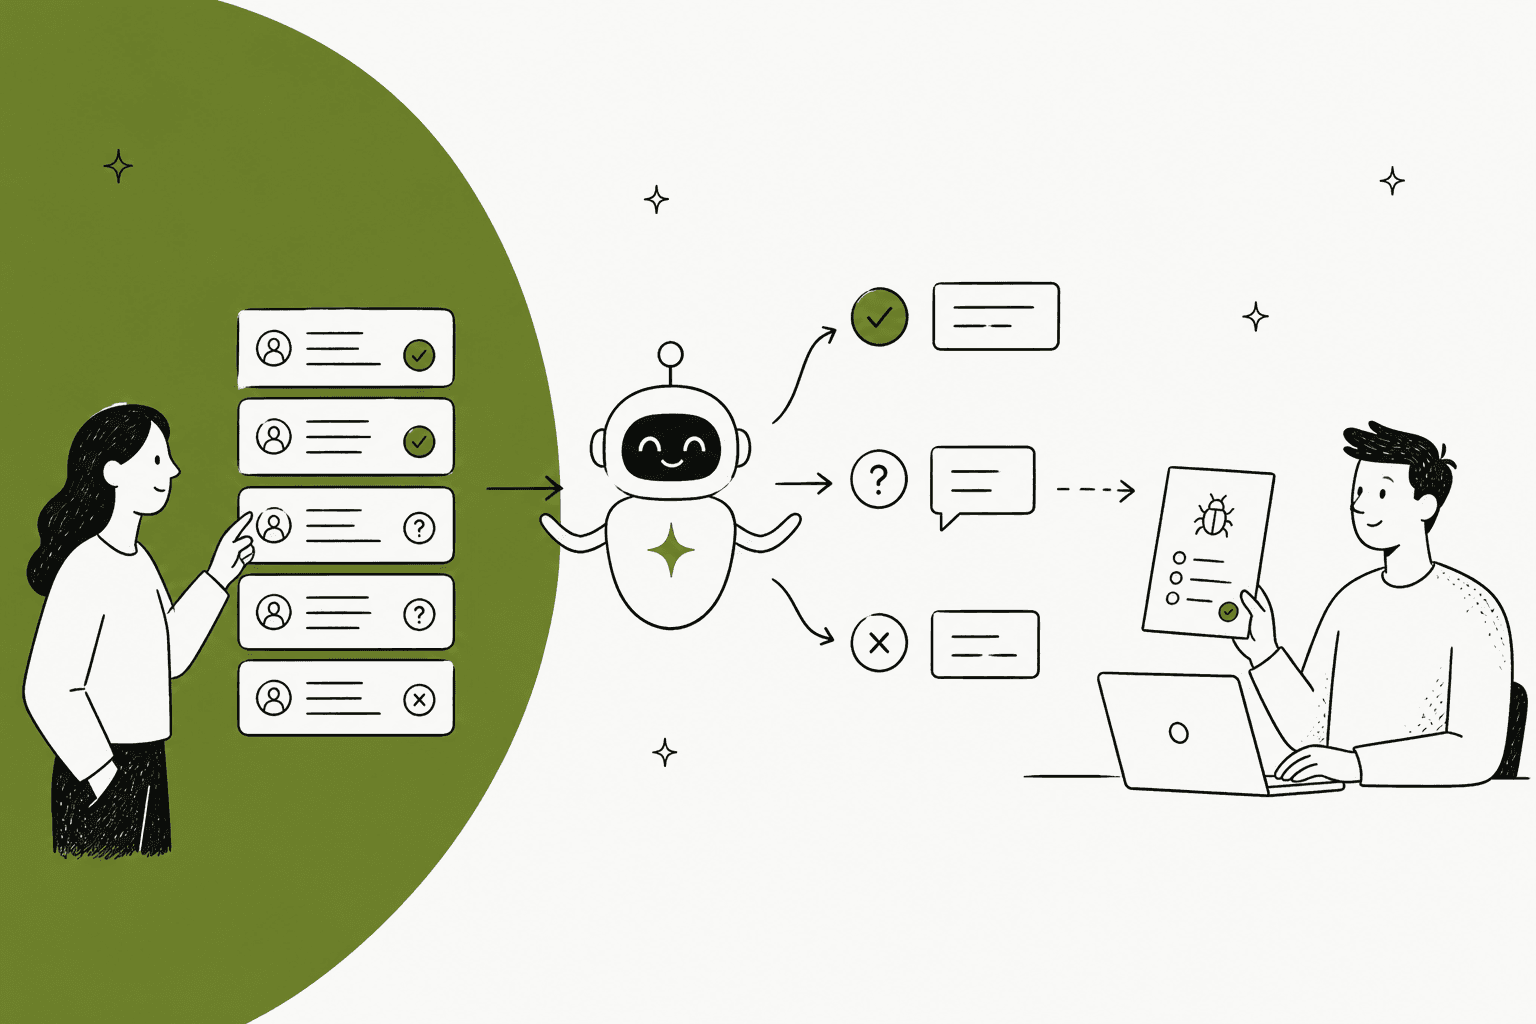
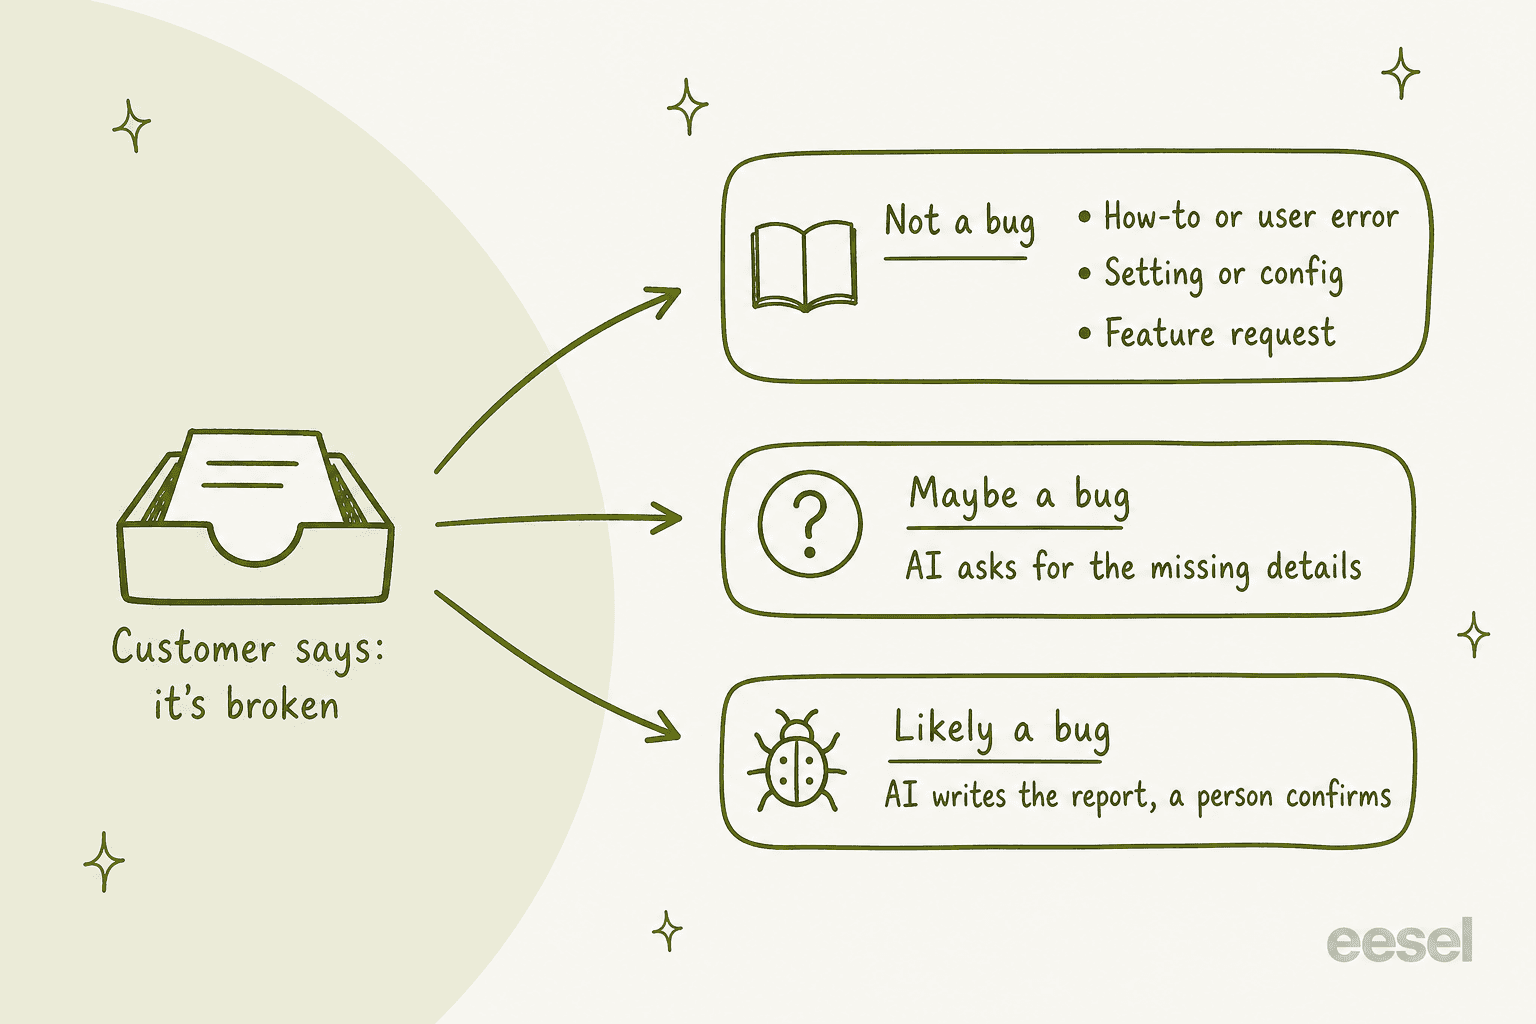
KI für Bug-Triage funktioniert am besten in der Support-Queue, nicht im Engineering-Backlog. Sortiere jedes „es ist kaputt“-Ticket in drei Spuren: kein Bug (Anleitungsfrage, Einstellung, Feature-Wunsch), vielleicht ein Bug (die KI fragt die fehlenden Details nach) und wahrscheinlich ein Bug (die KI schreibt den Bericht, und ein Mensch bestätigt ihn). Den größten Teil der gesparten Zeit bringen die ersten beiden Spuren, weil die meisten „Bugs“, die Kunden melden, das Engineering nie erreichen.
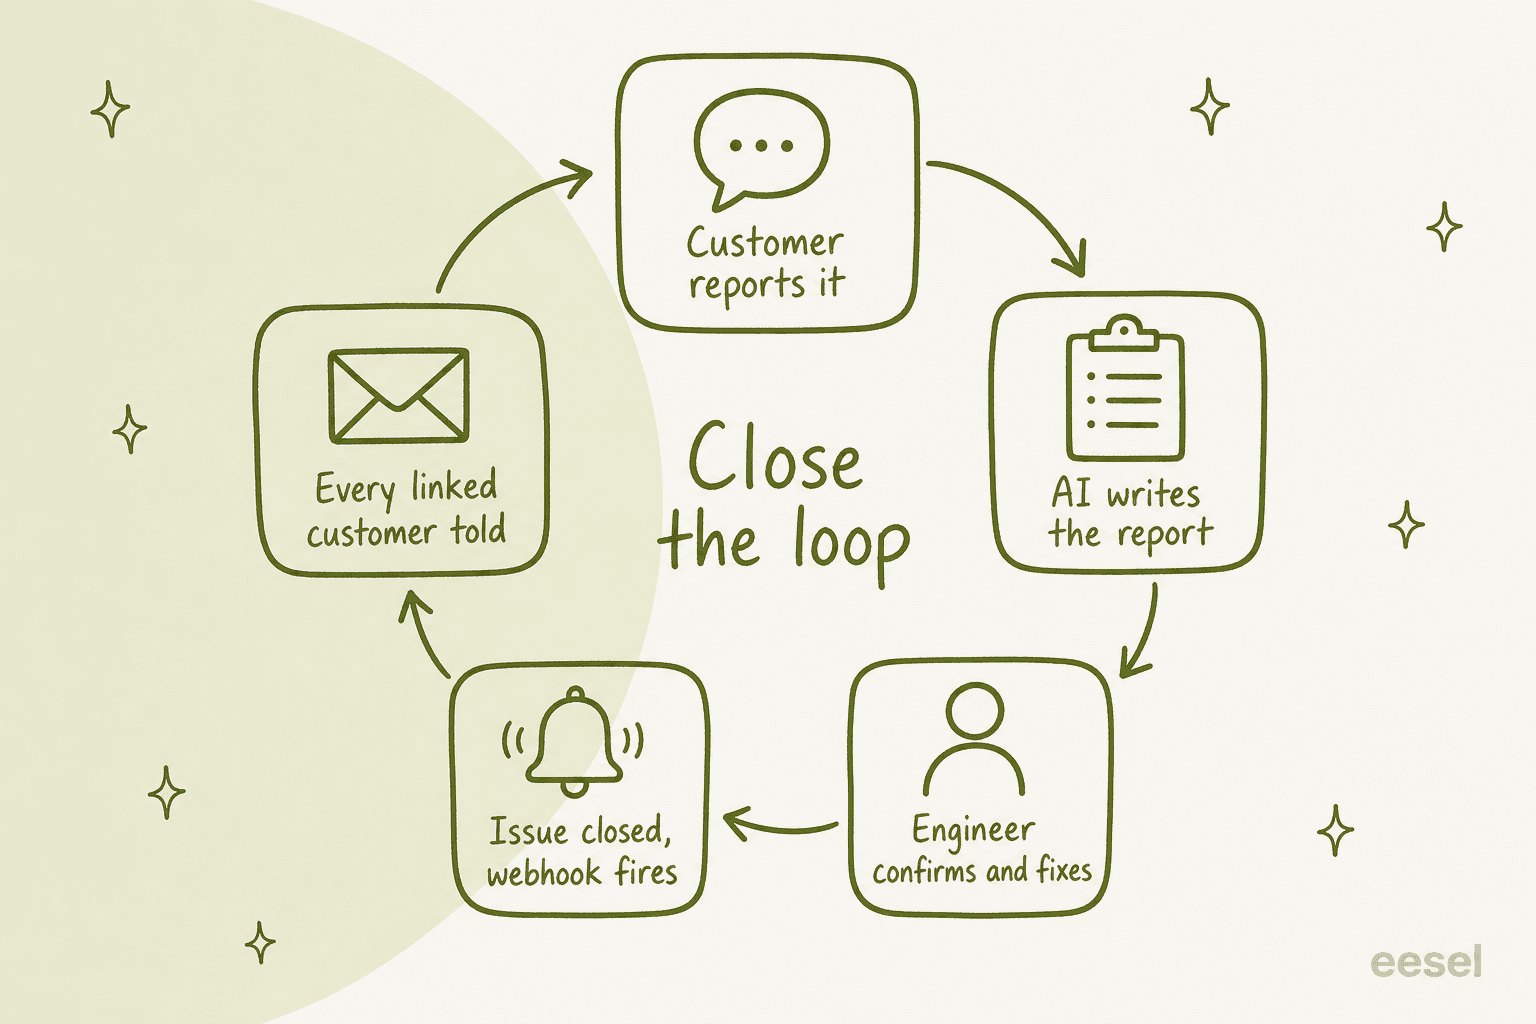
Die Regel, die das Vertrauen der Engineers erhält: Die KI sagt einem Kunden nie, etwas sei ein bestätigter Bug, und sie legt nie einen Bericht ohne Schritte zur Reproduktion, das Konto und eine Duplikatsprüfung an. Wenn der Fix erscheint, informiert sie jeden Kunden, der das Problem gemeldet hat.
eesel macht das in dem Helpdesk, den du bereits nutzt. SE Ranking verwandelt damit Fragen zu falschen Daten und zur API in Tier-2-Tickets, wobei Domain, Audit-Link oder Screenshot zuerst gesammelt werden, bei rund 4.650 Gesprächen im Monat.
Warum verstopfen Bug-Meldungen eine Support-Queue?
Ich arbeite in der Support-Queue bei eesel, und ein guter Teil dessen, was dort landet, beginnt mit irgendeiner Version von „Ich glaube, etwas ist kaputt“. Manches davon sind Bugs. Das meiste nicht. Es ist eine Einstellung, die jemand geändert hat, ein Button, der verschoben wurde, eine Browser-Erweiterung, die stört, oder ein Feature, das es nie gab. Das Problem ist, dass im Posteingang alle gleich aussehen und die echten zwischen den übrigen untergehen.
Diese Mischung erzeugt zweierlei Verschwendung: Der Support verbringt Zeit mit Tickets, die das Engineering brauchen, und das Engineering verbringt Zeit mit Tickets, die nie Bugs waren. Jemand auf Hacker News beschrieb bei Netzwerkanbietern das zweite Problem in Extremform:
"Especially with network vendors where 99%+ of their support workload is dealing with client or reseller misconfiguration."

Dein Verhältnis wird nicht so schief sein, aber die Form ist vertraut. Und wenn ein echter Bug zum Engineering geht, geht er oft mit zu wenigen Details. Ein Engineer, der mit Support-Mitarbeitern zusammenarbeitet, beschrieb auf Hacker News die Lücke:
"they're not developers and every now and then they cut the corner and need to be reminded that "I cannot press this button" is not good enough"
Das ist die Aufgabe, bei der KI an dieser Stelle gut ist. Nicht zu entscheiden, was ein Bug ist, sondern das Sortieren und die Nachfragen zu übernehmen, die ein beschäftigtes Support-Team auslässt. Wenn du die Sicht des Engineerings willst (Sentry, Linear und GitHub sortieren Issues, sobald sie existieren), habe ich sie in KI für Bug-Report-Triage beschrieben. Dieser Beitrag behandelt den Schritt davor: vom Ticket eines Kunden zu einem Issue, das sich anzulegen lohnt.
Wie sollte KI eine Kunden-Bug-Meldung sortieren?
Als ich ChatGPT fragte, wie ein Support-Team Bug-Meldungen triagieren sollte, beschrieb es dieselbe Pipeline, auf die die meisten Teams kommen: klassifizieren, dann untersuchen, dann übergeben. Ich würde den Klassifizierungsschritt konkreter machen, und der Punkt hier sind drei Spuren, mit jeweils einer anderen Aufgabe für die KI.
| Spur | Typische Meldung | Was die KI tut | Wer entscheidet |
|---|---|---|---|
| Kein Bug: Anleitung oder Bedienfehler | "I can't find the export button anymore" | Antwortet aus dem Help Center und dem Changelog, verlinkt den Artikel | KI, nach dem Test |
| Kein Bug: Einstellung oder Konfiguration | "The report totals are wrong" | Prüft zuerst die üblichen Einstellungen (Zeitraum, Filter, Zeitzone) | KI, anfangs mit einem Menschen bei den Entwürfen |
| Kein Bug: Feature-Wunsch | "Can you add dark mode?" | Bedankt sich, protokolliert den Wunsch, verspricht nie etwas | KI |
| Vielleicht ein Bug | "Nothing works since this morning" | Fragt nach Schritten, Konto, Browser- oder App-Version, einem Screenshot | KI fragt, sortiert dann neu |
| Wahrscheinlich ein Bug | "Export freezes at 99% since Tuesday's update, worked last week" | Prüft bekannte Probleme und Status, schreibt den Bericht, sagt dem Kunden, dass es beim Team ist | Ein Mensch bestätigt |
| Ausfall | "Login shows a 500 for everyone in our org" | Prüft die Statusseite, alarmiert sofort einen Menschen | Ein Mensch, sofort |
Das Detail „worked last week“ ist wichtiger, als es scheint. ChatGPTs Antwort nannte es einen Regressionshinweis, und ich stimme zu: Eine Meldung, die etwas nennt, das früher funktionierte, plus eine kürzliche Änderung, ist das stärkste Signal, das ein Kunde geben kann. Die KI sollte solche Meldungen wie wahrscheinliche Bugs behandeln, auch wenn die Beschreibung des Kunden vage ist.
Sortiere selbst ein paar Meldungen:
In welcher Spur liegt diese Bug-Meldung?
Wähle eine Kundenmeldung, um zu sehen, wohin sie geht und was die KI als Nächstes tun sollte.
Noch nichts gewählt. Fang mit einer beliebigen Meldung oben an.
Die KI prüft zuerst den Changelog. Wurde der Button in einem aktuellen Release verschoben, antwortet sie, wo er jetzt zu finden ist, und verlinkt die Release Note. Hat sich nichts geändert, fragt sie nach einem Screenshot, bevor sie es anders einordnet.
Braucht: Help Center, Changelog, vergangene Tickets.
Die meisten „die Zahlen stimmen nicht“-Tickets sind ein Zeitraum, ein Filter, eine Zeitzone oder ein Dokumententwurf. Die KI geht diese Prüfungen in einer Antwort durch. Sieht alles richtig aus, rückt das Ticket zu vielleicht ein Bug vor, und die KI fragt nach einem Beispieldatensatz.
Braucht: eine schriftliche Regel für Meldungen zu falschen Zahlen, vergangene Tickets.
Die KI bedankt sich, sagt klar, dass es heute nicht verfügbar ist, markiert das Ticket als Feature-Wunsch, damit das Produktteam mitzählen kann, und deutet nie einen Release-Termin an.
Braucht: einen Tag für Feature-Wünsche, eine Regel gegen Versprechen zur Roadmap.
Zu vage zum Sortieren. Die KI prüft die Statusseite und fragt dann nach dem, was sie nicht nachschlagen kann: was der Kunde tun wollte, was er sah, Browser- oder App-Version und einen Screenshot. Mit der Antwort sortiert sie erneut.
Braucht: Statusseite, eine kurze Fragenliste pro Produktbereich.
„Worked last week“ plus ein kürzliches Update ist ein Regressionssignal. Die KI sucht nach einem bestehenden Ticket oder Issue mit demselben Symptom, verknüpft es, falls vorhanden, und schreibt sonst den Bericht fürs Engineering. Sie sagt dem Kunden, dass das Team es prüft, und nennt es nie bestätigt.
Braucht: bekannte Probleme, Ticket-Suche, eine Möglichkeit, in deinen Tracker zu schreiben.
Viele Nutzer, ein Symptom, alle gleichzeitig. Die KI prüft die Statusseite, verknüpft das Ticket mit dem Vorfall, falls einer offen ist, und alarmiert sonst die Bereitschaftsperson. Keine Fehlerbehebungsschritte bei einem Ausfall.
Braucht: Statusseite, einen dringenden Weg zu einem Menschen.
Ein Hinweis, wie die KI sortieren sollte: Lass sie deine vergangenen Tickets lesen, keine Stichwortliste. „It's broken“ bedeutet in verschiedenen Produkten ganz Unterschiedliches, und deshalb stecken die Worte, die deine Kunden für einen echten Bug benutzen, schon in deinen gelösten Tickets. Wenn du das umfassendere Routing darum herum aufsetzt, behandeln KI-Ticket-Routing für SaaS und Ticket-Triage automatisieren den Rest der Queue.
Was sollte die KI den Kunden fragen, bevor sie es einen Bug nennt?
Die Spur „vielleicht“ ist der Ort, an dem die KI sich bewährt, denn es ist der Schritt, den Support-Teams unter Druck überspringen. Jemand mit vierzig offenen Tickets leitet „nothing works“ ans Engineering weiter und macht weiter. Eine KI kann die Nachfragen jedes einzelne Mal stellen, solange der Kunde noch im Gespräch ist und noch weiß, worauf er geklickt hat.
Was ich sie fragen lassen würde, in ungefähr dieser Reihenfolge:
- Was wolltest du tun? Das Ziel, nicht den Fehler. Die Hälfte der Zeit stellt sich heraus, dass es eine Anleitungsfrage ist.
- Was ist stattdessen passiert, und was hast du erwartet? Den genauen Fehlertext, falls es einen gibt.
- Seit wann tritt es auf, und hat es vorher funktioniert? Das ist die Regressionsfrage.
- Welches Konto, welcher Workspace oder welches Projekt? Damit später niemand erneut fragen muss.
- Welcher Browser, welche App oder Version? Überspringen, wenn deine Systeme das schon protokollieren.
- Kannst du einen Screenshot oder eine kurze Aufnahme schicken? Ein Bild erspart drei Antworten.
Zwei Regeln sorgen dafür, dass sich das hilfreich anfühlt und nicht wie ein Formular. Erstens sollte die KI suchen, bevor sie fragt. Der Agent von SE Ranking ist so eingestellt, dass er nie eine Rückfrage stellt, bevor er Help Center, Makros und vergangene Tickets geprüft hat. Zweitens frage nach einer oder zwei Sachen auf einmal, und frage nach nichts, was die KI selbst nachschlagen kann.
Das Setup von SE Ranking zeigt, wie das aussieht, wenn es gut gemacht ist. Falsche Daten in den Recherche-Tools, White-Label-Einrichtung, Audit-Fragen, die API und Looker Studio werden alle zu einem Ticket für die Tier-2-Gruppe, wobei Domain, Audit-Link oder Connector-Screenshot zuerst gesammelt werden. Sagt ein Kunde, sein Bildschirm stimme nicht mit dem überein, was die KI beschrieben hat, hört sie mit der Fehlerbehebung auf und übergibt mit einer Notiz darüber, was sie ihm schon gesagt hat. In einem Monat waren das etwa 400 Tickets für Tier 2 und Wochenendfälle, bei rund 4.650 Gesprächen über drei Produkte.
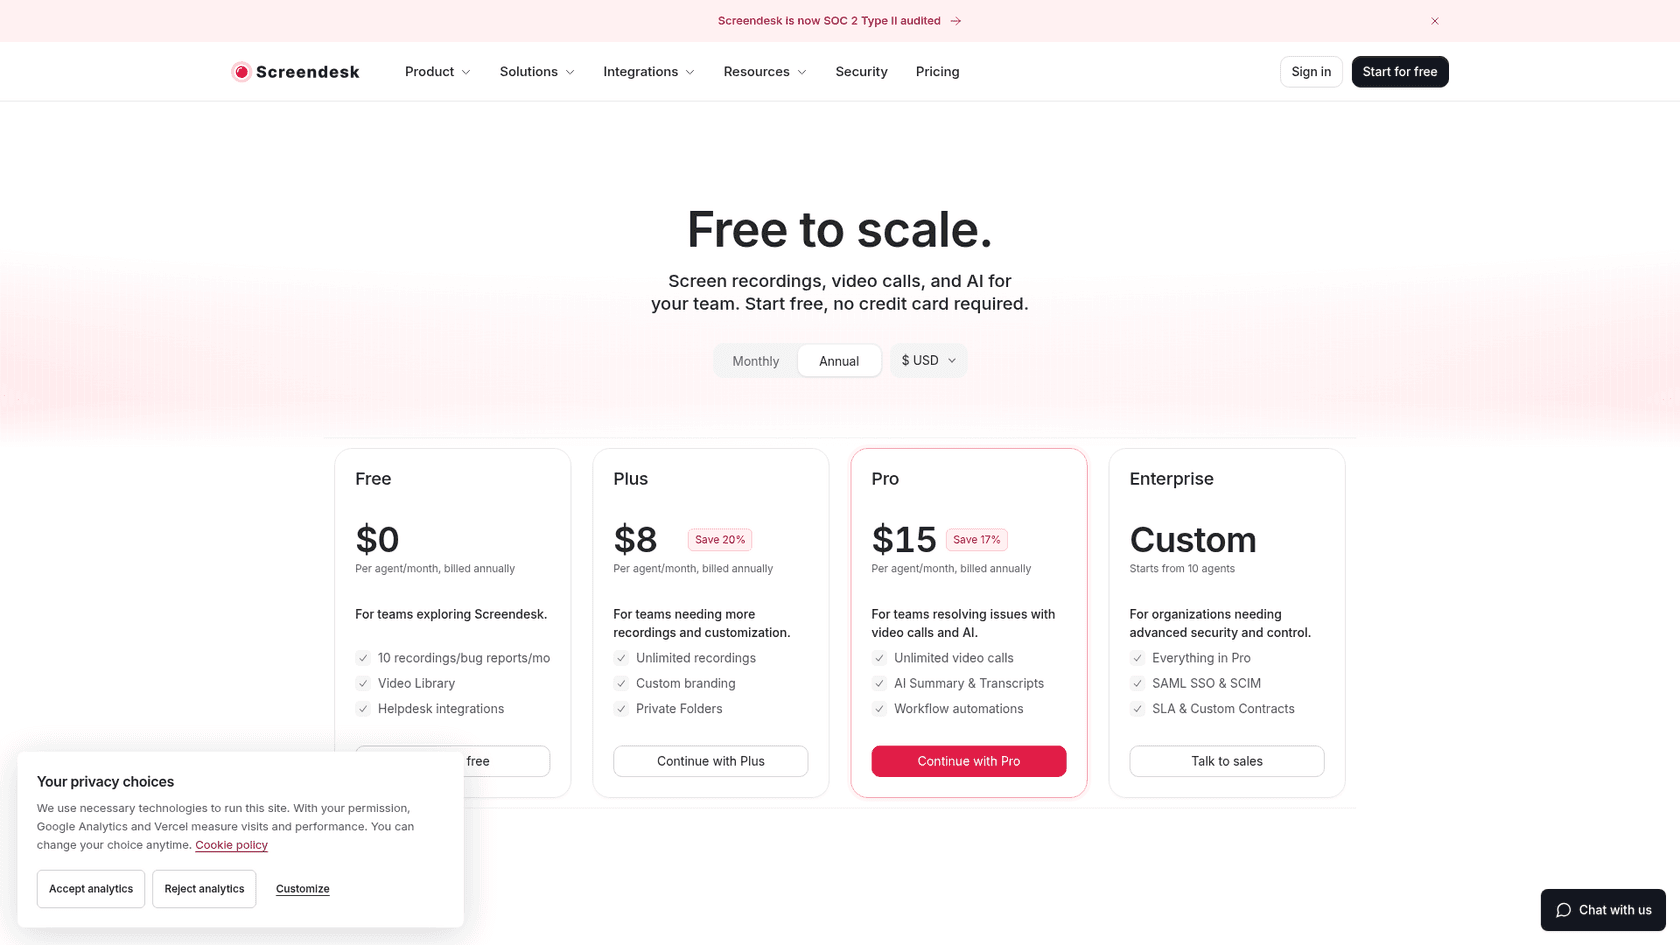
Auch Bildschirmaufnahmen helfen hier. Screendesk ergänzt Helpdesks wie Zendesk, Freshdesk, Help Scout und Jira Service Management um Aufnahme- und Bug-Report-Links, und sein Pro-Plan füllt Titel und Schritte zur Reproduktion per KI aus. Das passt gut zu einem KI-Agenten: Der Agent fragt nach der Aufnahme, dann füllt die Aufnahme die Schritte aus.
Wie prüft die KI, ob das Engineering es schon kennt?
Bevor irgendetwas ans Engineering geht, sollte die KI eine Frage beantworten: Ist das bereits bekannt? Es gibt drei Stellen zum Nachsehen:
- Offene Tickets in deinem Helpdesk. Haben sechs Kunden heute Morgen dasselbe Einfrieren des Exports gemeldet, ist der siebte ein Link, kein neuer Bericht.
- Bekannte Probleme und die Statusseite. Damit die KI „wir wissen davon und arbeiten daran“ sagt, statt einen Kunden durch eine Lösung für einen Ausfall zu führen.
- Der Issue-Tracker selbst. Ein offenes Issue mit demselben Symptom bedeutet, dass das Ticket damit verknüpft wird und der Kunde erfährt, wann es geschlossen wird.
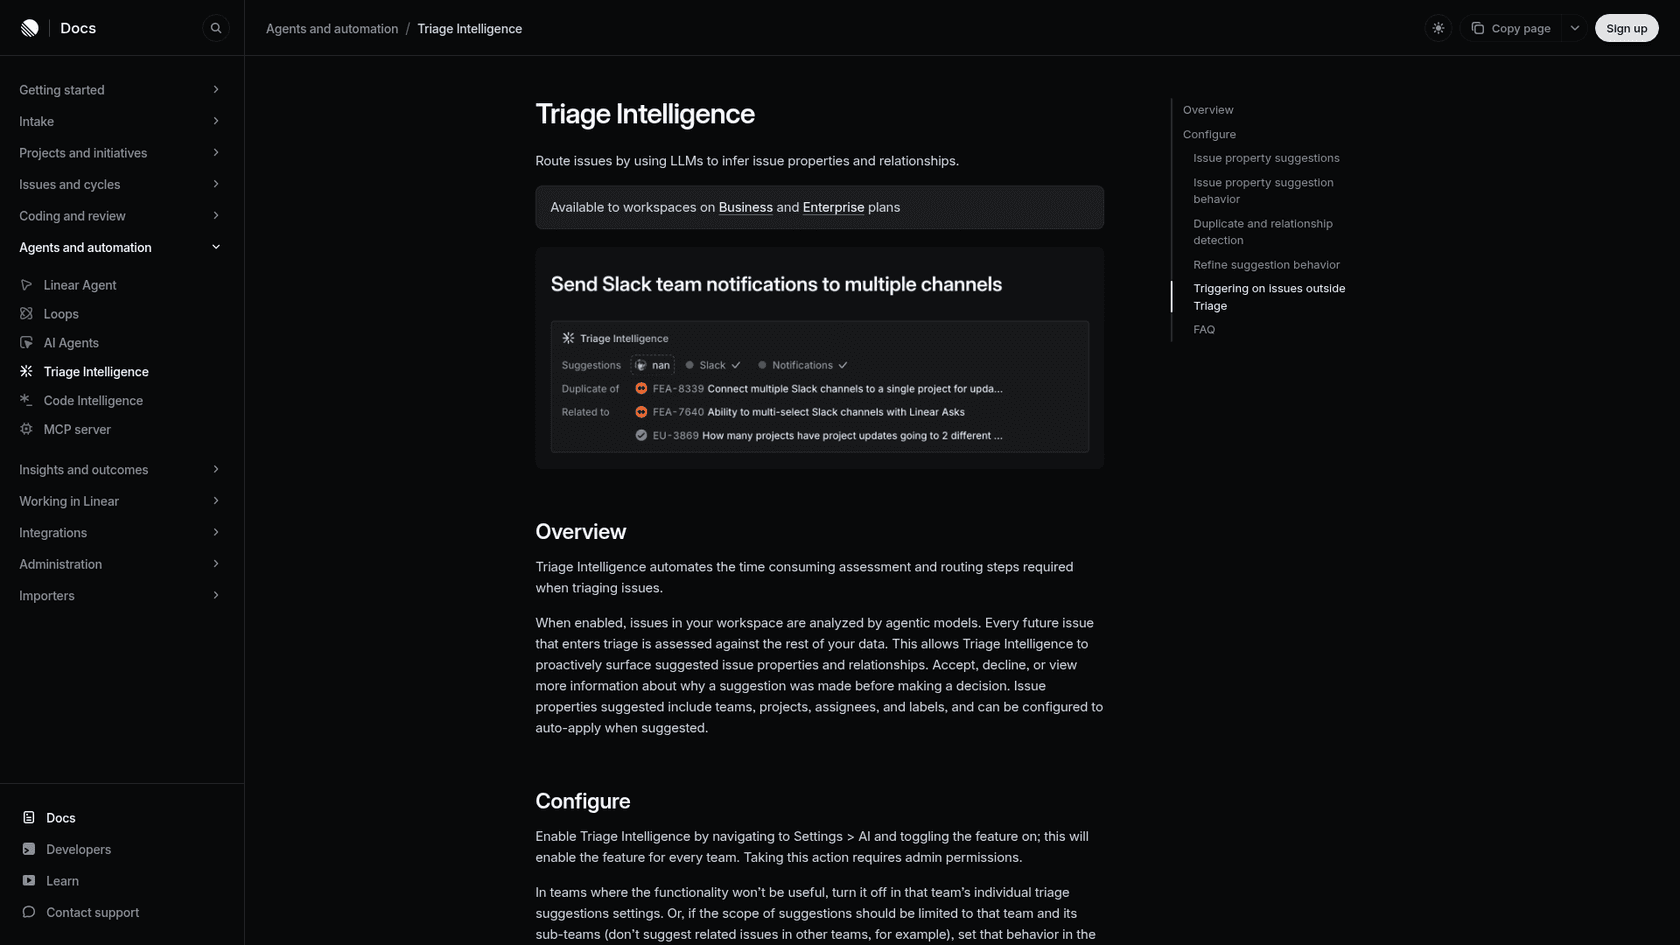
Sowohl die Helpdesks als auch die Tracker haben dafür KI ergänzt. Zendesk führt Vorschläge zum Zusammenführen und ähnliche Tickets unter seinen Copilot-Funktionen auf. Auf der Engineering-Seite markiert Linears Triage Intelligence ein wahrscheinliches Duplikat, wenn ein Issue in der Triage "a strong semantic similarity" zu einem bestehenden hat, und zeigt seine Begründung, bevor du es akzeptierst.
Die Prüfung auf der Support-Seite lohnt sich trotzdem, weil sie verändert, was du dem Kunden sagst. Ein verknüpftes Ticket bedeutet, der Kunde hört heute „wir wissen Bescheid, es wird bearbeitet“ statt in drei Tagen, und es gibt dem Engineering eine echte Zahl. „Vierzehn Kunden im Pro-Plan, seit Dienstag“ ist ein Argument für die Priorität; „ein Kunde sagt, der Export ist kaputt“ nicht. Mein Beitrag zur Ticket-Deduplizierung behandelt, wann man zusammenführt und wann man verknüpft.
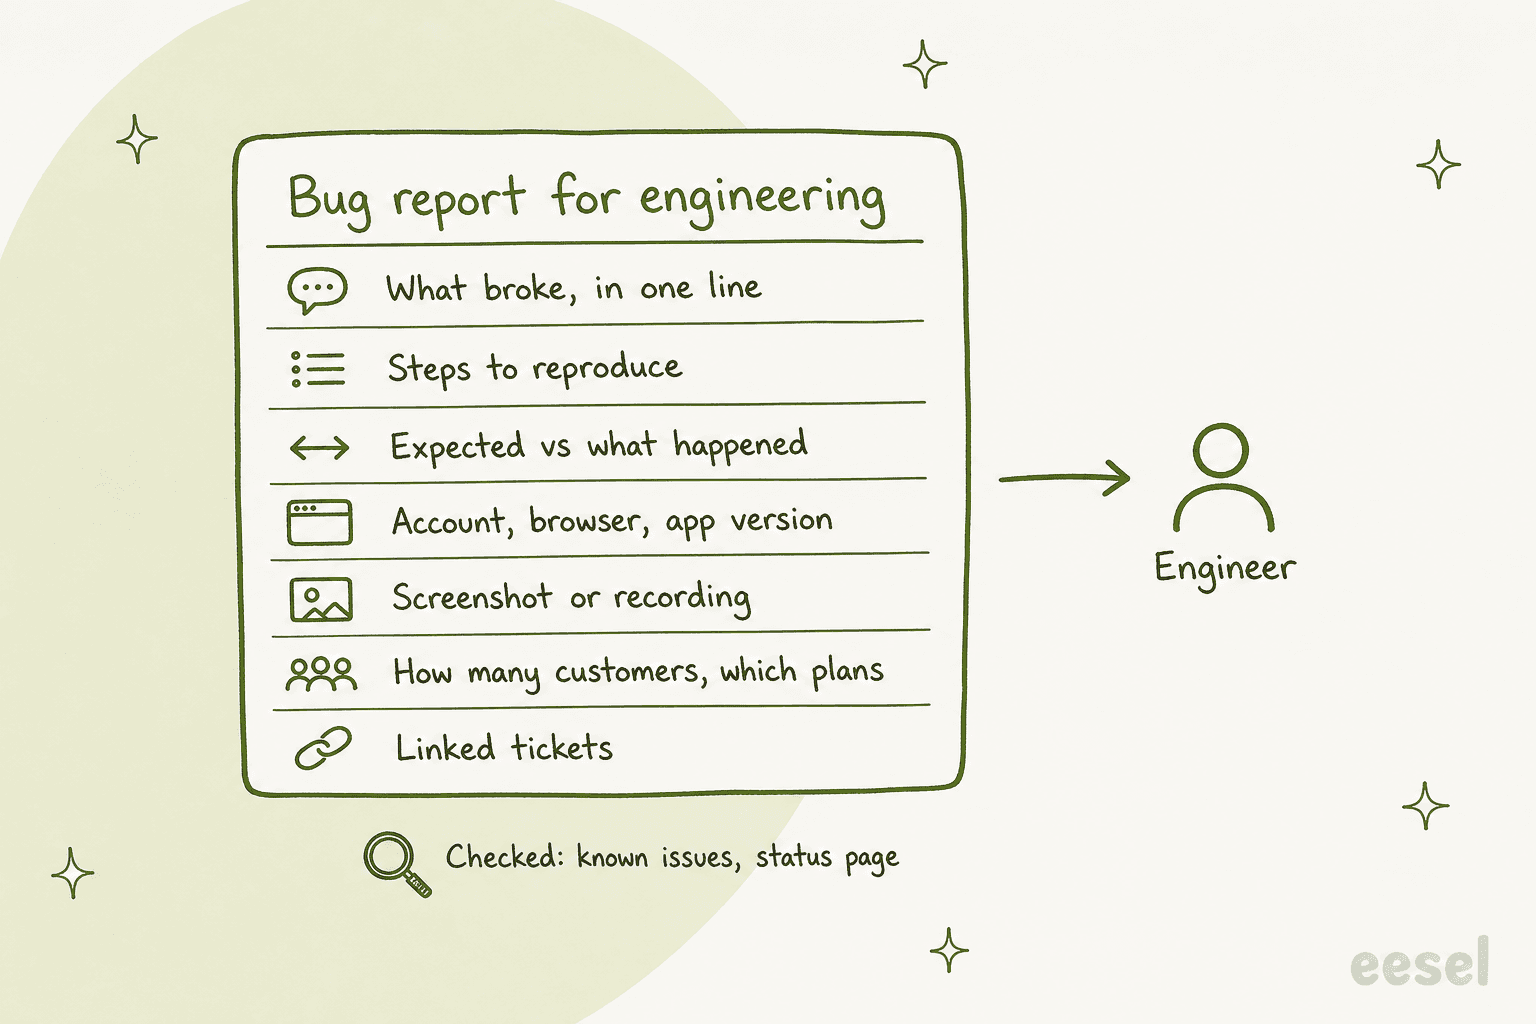
Wie sieht ein Bug-Report aus, mit dem das Engineering arbeiten kann?
Die schlechteste Übergabe, die ein Engineer bekommen kann, ist ein weitergeleitetes Ticket mit „customer says export is broken“ obenauf. Die beste ist ein Bericht, mit dem er in fünf Minuten arbeiten kann. Hier zahlt sich eine KI aus, die die Fragen schon gestellt und nach Duplikaten gesucht hat: Sie kann jedes Mal die zweite Sorte schreiben.
Ein guter Bericht enthält:
- Was kaputtging, in einer Zeile. "Monthly CSV export stops at 99% for large workspaces."
- Schritte zur Reproduktion, soweit der Kunde sie geben konnte.
- Erwartet versus passiert, mit dem genauen Fehlertext.
- Konto, Browser und App-Version, und seit wann es auftritt.
- Einen Screenshot oder eine Aufnahme.
- Auswirkung: wie viele Kunden, welche Pläne, verknüpfte Tickets.
- Was bereits geprüft wurde: bekannte Probleme, Statusseite, die üblichen Einstellungen.
- Einen Link zurück zu jedem Ticket, damit das Engineering sieht, wer wartet.
Und eine Regel über allen anderen: Die KI darf sagen „das sieht nach einem Bug aus, und ich habe es ans Team weitergegeben“, aber sie sollte einem Kunden nie sagen, etwas sei ein bestätigter Bug, oder einen Termin für die Behebung versprechen. Einen Defekt zu bestätigen ist Sache von jemandem, der ihn reproduzieren oder den Code lesen kann. ChatGPTs eigene Antwort sagte dasselbe mit anderen Worten: Lass nicht allein die Sicherheit der KI darüber entscheiden, ob etwas ein echter Bug ist.
Hier eine Warnung aus einem Verkaufsgespräch. Ein Digitalmedien-Unternehmen mit etwa 4.000 Zendesk-Tickets im Monat beschrieb den gewünschten Ablauf als "User contacts → AI troubleshooting → escalate to Jira if unresolved." Während des Pilots ging eine Eskalation als E-Mail raus, die dann automatisch geschlossen wurde, sodass sie niemand im Team je sah. Eine Übergabe, die niemand liest, ist schlimmer als keine Übergabe, denn dem Kunden wurde gesagt, dass jemand sich darum kümmert. Welchen Weg du auch wählst, prüfe, dass der Bericht an der Stelle ankommt, an der eine benannte Person oder ein Team tatsächlich arbeitet.
Wie gelangt der Bericht zu Jira, Linear oder GitHub?
Das hängt davon ab, wo deine Engineers arbeiten, und hier unterscheiden sich die Tools am meisten. Die ehrliche Übersicht steht unten:
| Weg | So funktioniert es | Worauf du achten solltest |
|---|---|---|
| Jira Service Management, mit eesel | eesels JSM-Integration antwortet, hinterlässt interne Notizen und verschiebt, weist zu, labelt und legt Issues an | Token-Ablauf: Atlassian setzt einen, und du verbindest neu, wenn er abläuft |
| Plain mit Linear, GitHub, Jira oder Shortcut | Ein Issue aus dem Support-Thread anlegen oder verknüpfen; der Linear-Status synchronisiert zurück | Plain ist ein Helpdesk, das heißt, du wechselst von deinem weg |
| Linear Asks | Jede eingehende E-Mail oder Slack-Nachricht wird ein Issue in der Triage des Teams | Business- oder Enterprise-Plan; für interne Anfragen gebaut |
| Screendesk-Automatisierungen | Eine neue Aufnahme oder ein Bug Report kann ein Jira- oder GitHub-Issue anlegen und in Slack posten | Pro-Plan; der Auslöser ist die Aufnahme, nicht der Ticket-Text |
| eesel zu Linear oder GitHub | Keine eingebaute Integration; eesel ruft deren API über Network Access auf | Domain, Auth-Header und Anweisungen richtest du selbst ein |
Plains eigener Leitfaden macht einen Punkt, dem ich zustimme: Ein einseitiger Push in den Tracker reicht nicht. Wird in Plain ein verknüpftes Linear-Issue abgeschlossen oder abgebrochen, wechselt der Thread laut dem Linear-und-GitHub-Leitfaden in den Zustand „Close the Loop“, als Aufforderung, es dem Kunden mitzuteilen. Er weist auch auf eine Einrichtungsfalle hin: Ist die Linear-Integration auf einige Teams beschränkt, werden Statusupdates nicht synchronisiert.
Linear Asks ist die leichteste Option, wenn du schon auf Linears Business-Plan bist. Seine Docs nennen "engineering teams receiving bug reports from non-technical teammates" als Kernanwendung, und bei einem E-Mail-Ask wird der Betreff zum Issue-Titel und der Text zur Beschreibung. Das heißt, ein sauberer Bericht von deiner Support-Seite wird ein sauberes Linear-Issue, ohne zusätzliche Verkabelung.
Für eesel bei einem Tracker, mit dem es nicht integriert ist, ist der Weg Network Access. Du erlaubst die Domain des Trackers, fügst den Auth-Header hinzu und sagst dem Agenten in einfachen Worten, wofür die Verbindung da ist. Die Zugangsdaten bleiben in deinen Einstellungen, und eesel hängt sie an jede Anfrage an, sodass die KI den Schlüssel nie sieht. Es unterstützt GET, POST, PATCH und DELETE, was das Anlegen eines Issues und das Hinzufügen eines Kommentars abdeckt. Ich würde diese Aktion zunächst hinter eine Freigabe stellen, sodass ein Mensch jedes neue Issue abnimmt, bis du den Berichten vertraust. Mit eesels Aktionen und Freigaben stellst du jede Aktion auf Auto, Freigabe nötig oder Deaktiviert.
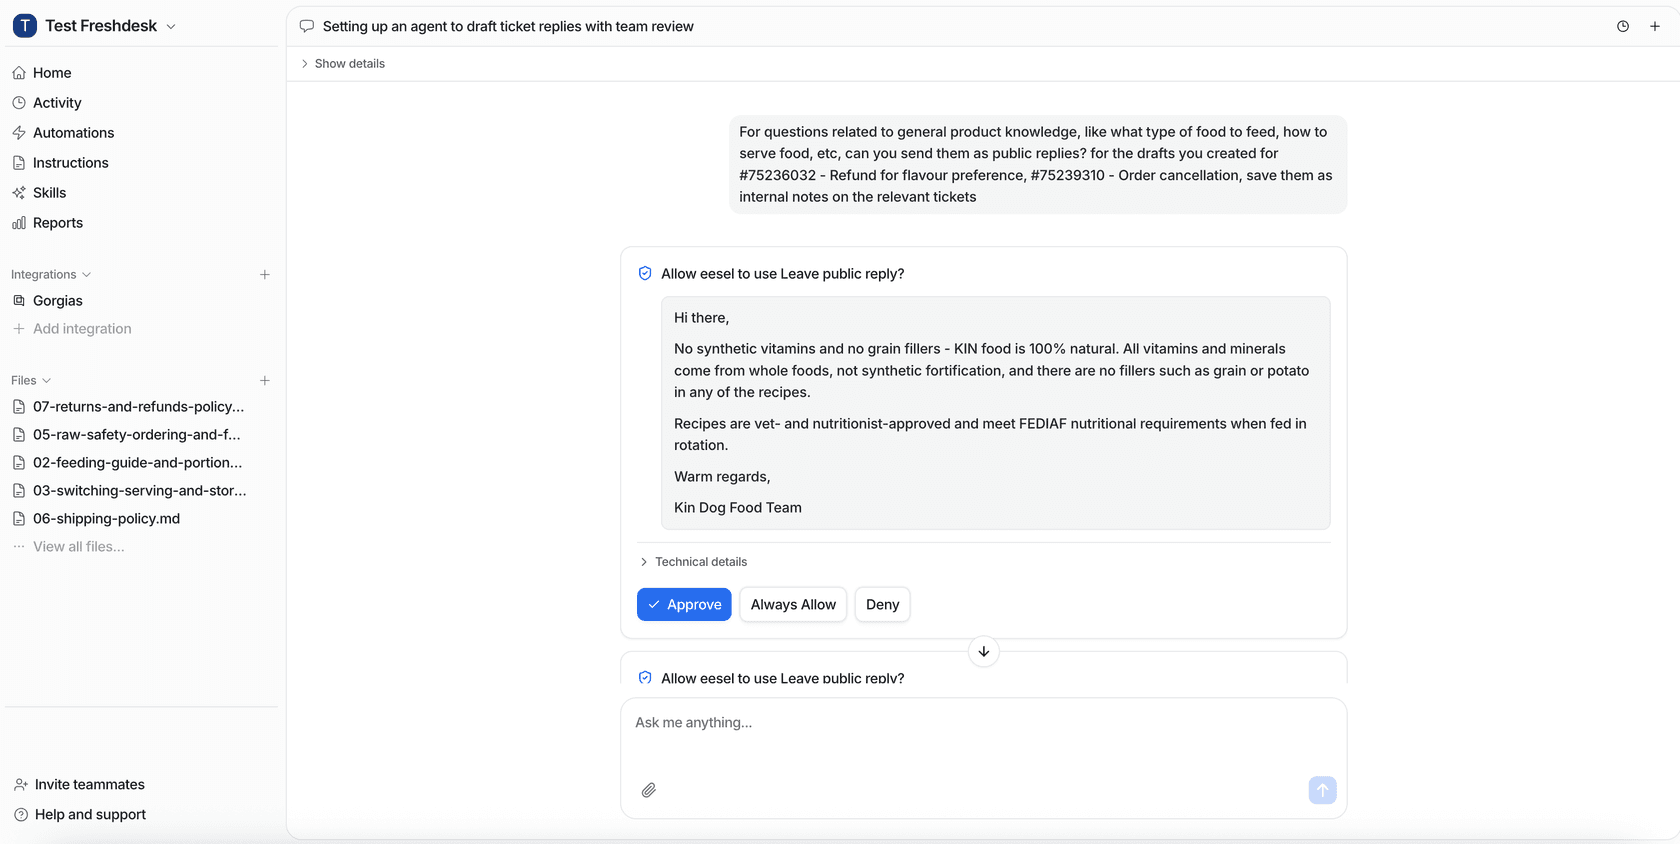
Wenn deine Engineers ohnehin in Jira leben, gehen meine Leitfäden zur Zendesk-zu-Jira-Eskalation und zur Zendesk-Jira-Integration tiefer.
Für Linear siehe Linear AI und Linear vs Jira.
Wie erfahren Kunden, dass ein Bug behoben ist?
Das ist der Schritt, den fast alle vergessen. Der Fix erscheint, das Engineering-Issue wird geschlossen, und der Kunde, der es gemeldet hat, erfährt nie davon. Modems Startseite beschreibt genau das: "The fix ships. Whoever heard the complaint never finds out." Ein Hacker-News-Kommentator beschrieb die ganze Schleife vom Support zum Engineering und endete genauso, damit, dass der Support den Kunden zum erneuten Testen kontaktiert:
"as soon as you have multiple people involved in a communication chain, details get lost, and feedback loops become really extensive because of all the latency involved"
KI macht den letzten Schritt billig, solange zwei Dinge stimmen: Jedes Kunden-Ticket ist mit dem Issue verknüpft, und etwas sagt der KI, wann das Issue geschlossen wird. In Plain erledigt das die Statussynchronisation. Bei eesel erledigt es eine Webhook-Automatisierung: eesel gibt dir eine URL, und jeder Dienst, der eine Web-Anfrage senden kann (Zapier, Make, dein eigenes Backend, der Webhook eines Issue-Trackers), kann den Agenten mit dem geschlossenen Issue und Anweisungen wecken. Der Agent sucht dann die mit diesem Issue getaggten Tickets, schreibt jedem Kunden eine kurze Nachricht, dass der Fix draußen ist, und bittet ihn, es auf seiner Seite zu prüfen.
Vierzehn Kunden zu sagen „der Bug, den ihr gemeldet habt, ist behoben“ ist einer der günstigsten Goodwill-Erfolge im Support, und von Hand passiert es fast nie. Es fängt auch die Fälle ab, in denen der Fix das Problem nicht behoben hat, was man vor dem nächsten Sprint wissen sollte.
Welche Tools machen KI-Bug-Triage, und was kosten sie?
ChatGPTs Shortlist für diese Frage bestand aus Modem, Plain und einem bestehenden Helpdesk plus KI und Zapier. So vergleichen sich die Optionen, die ich mir angesehen habe, mit Preisen von der jeweiligen Preisseite des Anbieters, geprüft am 30. Oktober 2026. Sie machen nicht alle dieselbe Arbeit, daher zählt bei der Wahl die Spalte „Wo es sitzt“ so viel wie der Preis.
| Tool | Wo es sitzt | Was es für Bug-Triage leistet | Preis |
|---|---|---|---|
| Zendesk intelligent triage | In Zendesk | Klassifiziert Tickets nach Thema, Stimmung und Sprache, jeweils mit einem Konfidenzfeld | Suite Professional 115 $/Agent/Monat plus Copilot 50 $/Agent/Monat, jährlich abgerechnet |
| Linear Triage Intelligence | Engineering-Tracker | Schlägt Team, Bearbeiter, Labels und Duplikate für Issues in der Triage vor | Business 16 $/Nutzer/Monat, jährlich abgerechnet, inkl. Asks |
| Jira Service Management | Service Desk | Anfrageerfassung mit Rovo-Agenten und KI in bezahlten Plänen | Kostenlos für 3 Agenten, Standard 21,50 $/Agent/Monat |
| Plain | Helpdesk für technische B2B-Teams | Native Linear-, GitHub-, Jira-Verknüpfungen mit Statussynchronisation | Foundation 45 $/Nutzer/Monat, jährlich abgerechnet, 100 Credits pro KI-Lösung |
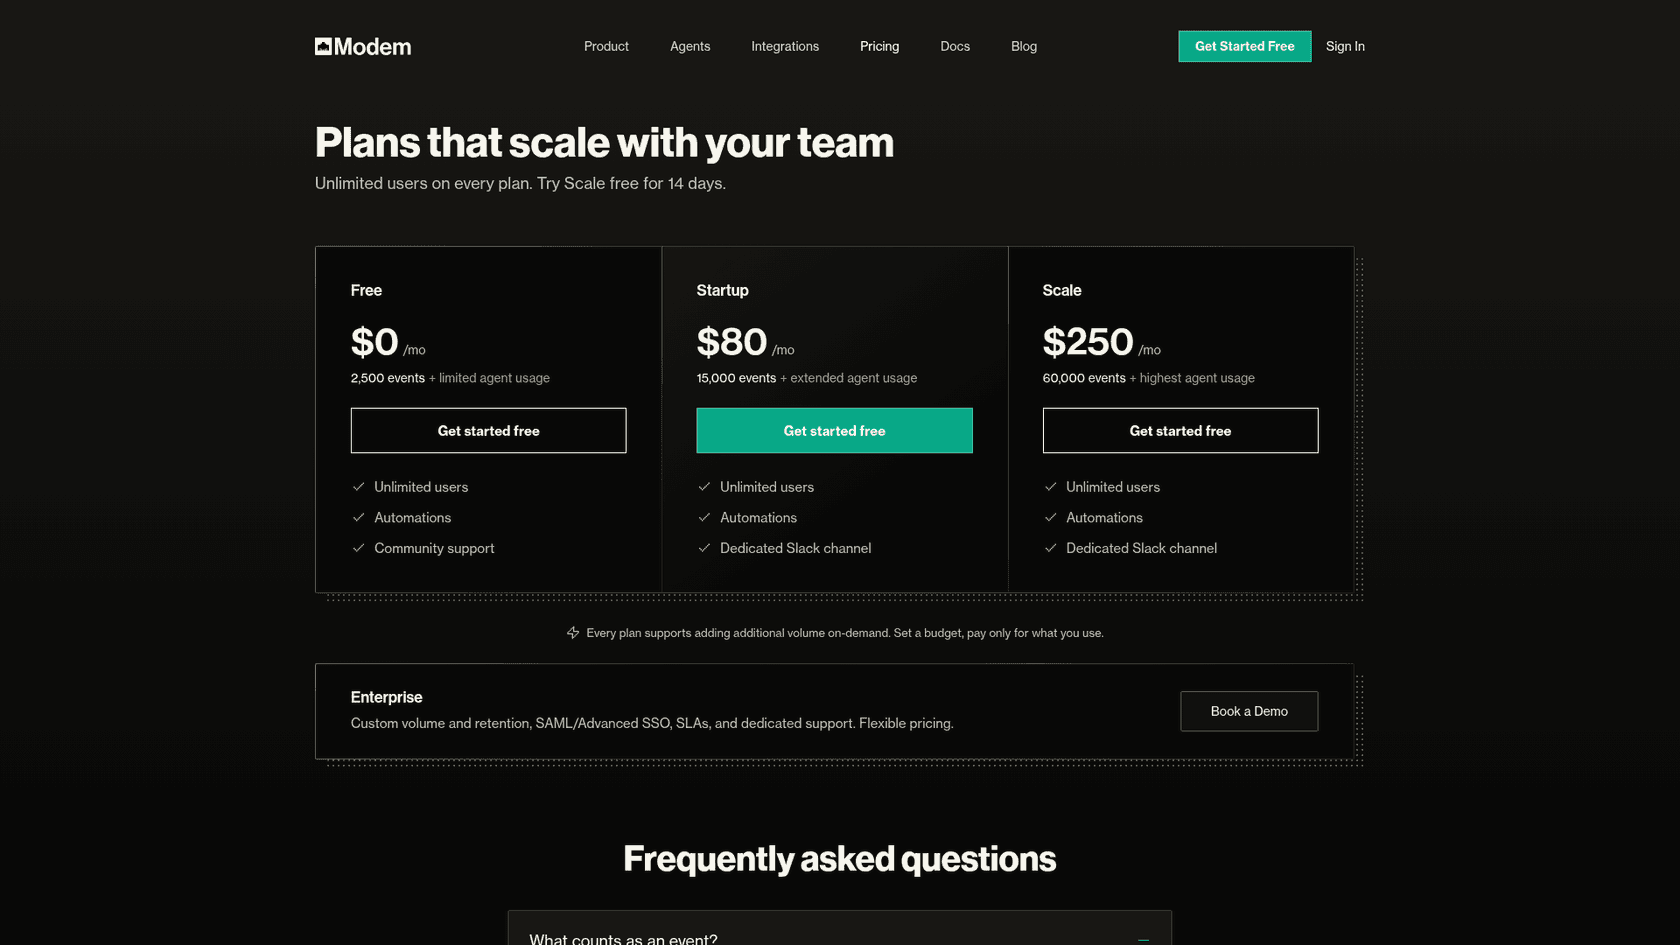
| Modem | Über Slack, Discord, GitHub und Support hinweg | Findet wiederkehrende Kundenanliegen und verfolgt sie bis zum Fix | Kostenlos, Startup 80 $/Monat (15.000 Events), Scale 250 $/Monat |
| Screendesk | Add-on zu deinem Helpdesk | Bildschirmaufnahmen, KI-Schritte zur Reproduktion, Jira- und GitHub-Automatisierungen | Kostenlos, Plus 8 $, Pro 15 $ pro Agent/Monat, jährlich abgerechnet |
| eesel | KI-Teammitglied in deinem Helpdesk | Sortiert, fragt nach Details, schreibt und legt den Bericht an, informiert Kunden bei Behebung | 299 $/Monat für 500 Tickets, unbegrenzte Plätze |
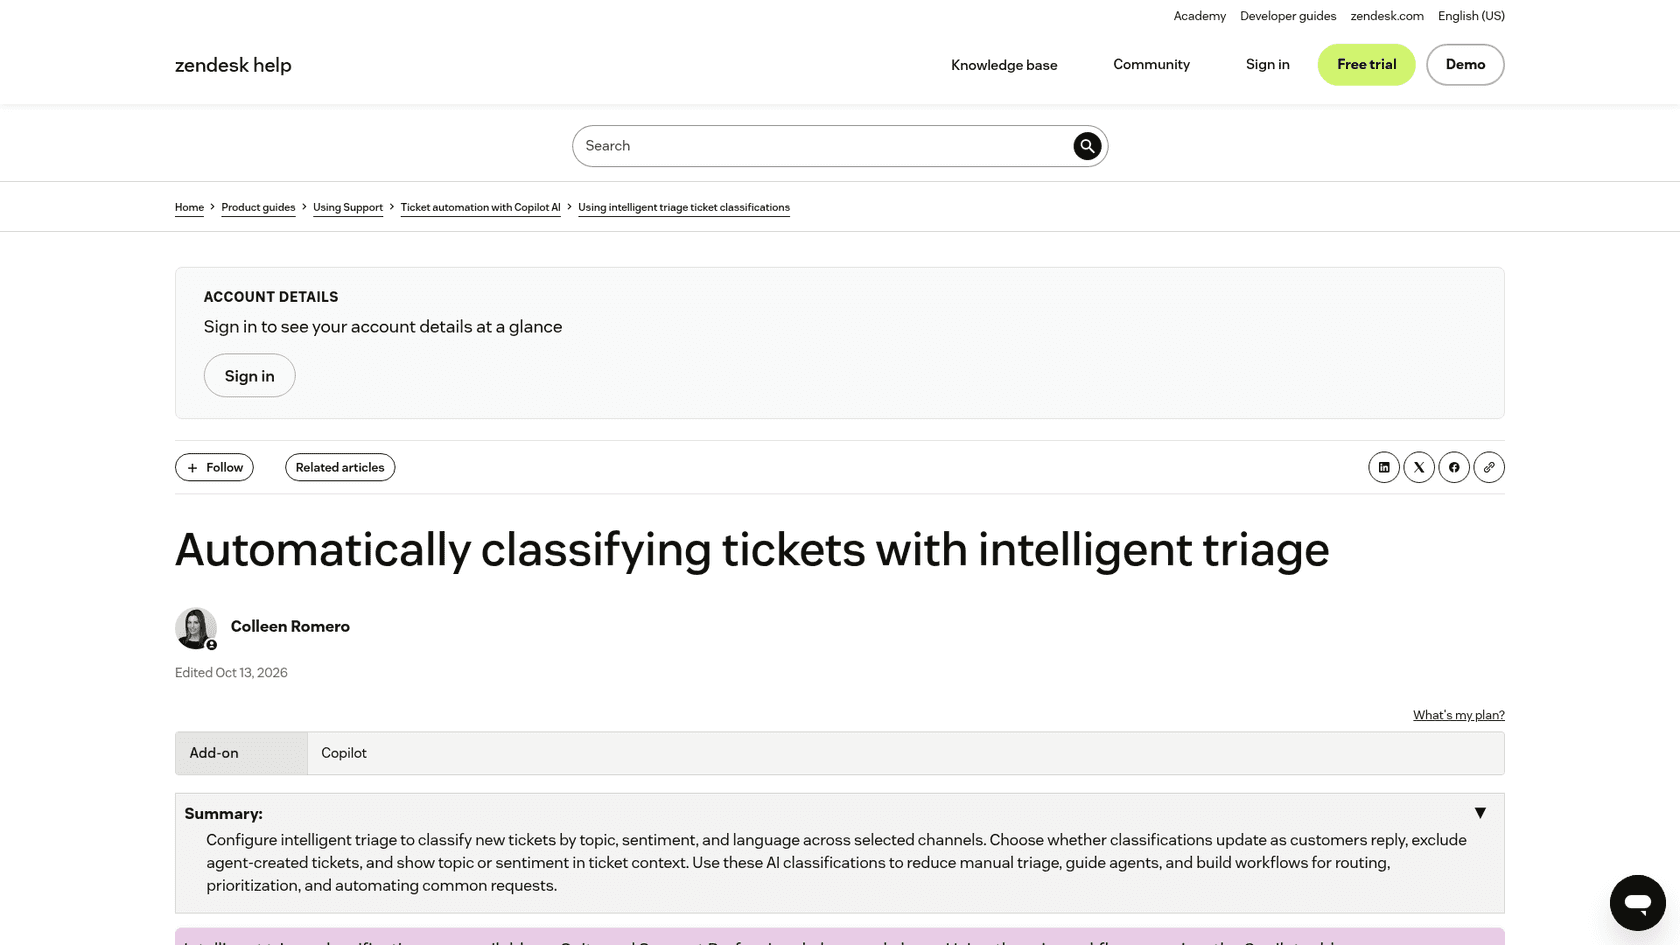
Ein paar Anmerkungen zu dieser Tabelle. Zendesks intelligente Triage klassifiziert anhand des Betreffs und des ersten öffentlichen Kommentars, und du siehst die Klassifizierungen in Suite Professional, aber sie in Triggern und im Routing zu nutzen, erfordert Copilot. Linear sagt, Triage Intelligence braucht 1 bis 4 Minuten pro Issue, was in Ordnung ist, da es auf Issues läuft, nachdem aus einem Ticket schon eines geworden ist. Modem zählt als „Event“ jede Eingabe, auf der es KI laufen lässt, etwa eine Slack-Nachricht oder ein GitHub-Issue.
Was kostet es für ein Support-Team?
Preise pro Agent, pro Nutzer, pro Event und pro Ticket lassen sich nicht vergleichen, bis man sie für ein Team durchrechnet. Nimm also das SaaS-Unternehmen mit sechs Support-Agenten, 3.000 Tickets im Monat und zehn Engineers, bereits mit einem Helpdesk.
| Setup | Die Rechnung | Monatliche Kosten |
|---|---|---|
| Zendesk mit Copilot (Suite Professional, jährlich) | 6 x (115 $ + 50 $) | 990 $, Helpdesk inklusive |
| eesel liest jedes neue Ticket | 3.000 Credits, unbegrenzte Plätze | 1.149 $, und dieselben Credits erstellen Antwortentwürfe für die Nicht-Bug-Tickets |
| eesel nur bei bug-ähnlichen Tickets | Geweckt durch ein „Problem“-Formular oder einen Tag, etwa 500 im Monat | 299 $ |
| Screendesk Pro zu deinem Helpdesk hinzugefügt | 6 x 15 $ | 90 $ |
| Linear Business fürs Engineering | 10 x 16 $ | 160 $ |
| Plain Foundation (Helpdesk-Wechsel) | 6 x 45 $, plus 100 Credits pro KI-Lösung nach 1.000 inbegriffenen | 270 $ plus Credits |
| Modem Startup | Pauschal, bis zu 15.000 Events | 80 $ |
Meine Einschätzung: Diese Tools ergänzen sich eher, als dass sie konkurrieren. Sind deine Engineers auf Linear Business, schalte Triage Intelligence ein, es ist schon bezahlt. Lebt dein Support in Zendesk und du willst vor allem Tickets klassifiziert und geroutet haben, macht Copilot das innerhalb von Zendesk. Willst du die Nachfragen, den geschriebenen Bericht und den Kunden informiert, wenn der Fix erscheint, ist das die Support-Arbeit, die ein KI-Teammitglied übernimmt, und dort würde ich zuerst Geld ausgeben. Für das weitere Feld habe ich auch Übersichten zu den besten KI-Tools für Ticket-Triage und zu bester KI für SaaS-Support geschrieben.
Wie führst du KI-Bug-Triage ein, ohne das Engineering zu verärgern?
Engineers verzeihen „das könnte ein Bug sein, hier ist, was ich gesammelt habe“. Sie verzeihen keinen Strom selbstsicherer Berichte, die sich als Einstellungen entpuppen, also führe es in dieser Reihenfolge ein:
- Nur Entwürfe und Notizen. Die KI sortiert jedes Ticket und hinterlässt ihre Spur, ihre Fragen und jeden Berichtsentwurf als interne Notiz, dann sendet ein Mensch. So betreibt Timengo den technischen Support für sein sicheres Mail-Produkt auf Freshdesk: Jedes neue Ticket bekommt einen dänischen Entwurf und eine interne Notiz für den Engineer, und eesel sendet nie von selbst.
- Schreibe die Nicht-Bug-Regeln auf. Die häufigen Fehlalarme in deinem Produkt, in einfachen Worten, als kurze Liste. Qontro, ein Cloud-ERP auf Freshdesk, schrieb eine Regel dafür, wie mit einer Meldung umzugehen ist, die Zahlen seien falsch, und schickt Systemfehler und Datenverlust direkt an einen Menschen.
- Vergleiche ihre Spuren mit dem, was dein Team entschieden hat. Wo die KI etwas Bug nannte und es keiner war, schärfe die Regel nach oder behebe den Hilfeartikel. Qontro nutzt seine Entwürfe so: Ein falscher Entwurf weist meist auf einen fehlenden Artikel oder eine Regel hin, die nachgeschärft werden muss.
- Lass die Spur kein Bug automatisch laufen. Anleitungs- und Einstellungsantworten zu eng gefassten Themen, sobald sie an vergangenen Tickets bestehen.
- Schalte das Anlegen ein, hinter einer Freigabe. Die KI legt den Bericht in Jira, Linear oder GitHub an, und ein Mensch gibt jeden frei, bis die Berichte durchgehend gut sind.
- Schließe die Schleife. Verbinde das Ereignis „Issue geschlossen“ des Trackers zurück mit der KI, damit verknüpfte Kunden vom Fix erfahren.
Teste vor Schritt vier. KI-Support-Simulationstests behandeln, wie man den Agenten über die Tickets des letzten Monats laufen lässt, und mein Implementierungszeitplan hat die realistischen Zahlen für jede Phase.
Ein paar weitere Beiträge, die unterwegs helfen. Best Practices für die Übergabe an Menschen behandelt, was der Kunde hören sollte, wenn die KI ein Ticket weitergibt, und KI für Tier-2-Support behandelt die Untersuchungsarbeit, sobald ein Bericht vorliegt. Und wenn falsche Antworten immer wieder auf dünne Dokumentation zurückgehen, macht die Support-Wissenslückenanalyse daraus einen Backlog.
Können Engineers es vom Terminal aus einrichten?
Für ein Software-Team ist das praktisch. Die eesel CLI führt denselben Agenten aus, den du im Dashboard siehst, aus einem Terminal, und jeder Befehl gibt JSON aus, sodass auch ein Coding-Agent wie Claude Code, Cursor oder Codex ihn steuern kann. Ein Engineer kann das Dokument mit bekannten Problemen mit eesel files upload hinzufügen, mit eesel chat "export freezes at 99% since the update" testen, wie der Agent eine Beispielmeldung sortiert, und mit eesel approvals approve <id> eine zurückgehaltene Issue-Anlege-Aktion freigeben, alles ohne das Dashboard zu öffnen. eesel automations listet die Webhook-Automatisierung auf, die die Schleife schließt. Hintergrund zur Idee steht in meinem Beitrag über KI-Agent-MCP-Server.
eesel für Bug-Triage ausprobieren
Wenn deine Bug-Meldungen in Zendesk, Freshdesk oder Jira Service Management eingehen, tritt eesel dieser Queue bei wie ein Support-Kollege, der dein Help Center, deinen Changelog und jedes gelöste Ticket gelesen hat. Es beantwortet die Anleitungs- und Einstellungstickets, fragt Kunden nach den Schritten und Screenshots, die das Engineering braucht, markiert Duplikate mit dem bereits offenen Bericht und schreibt dann den Bericht, den ein Mensch bestätigt, bevor er angelegt wird. Wenn der Fix erscheint, informiert es alle, die das Problem gemeldet haben.
SE Ranking betreibt es so über drei Produkte in Zendesk und schickt Fragen zu falschen Daten und zur API mit den bereits angehängten Belegen an Tier 2.
Pläne beginnen bei 299 $ im Monat für 500 Tickets oder Chats, mit unbegrenzten Plätzen, und es gibt eine kostenlose Testphase mit 100 Credits. Probiere eesel an den Bug-Meldungen des letzten Monats aus und sieh, welche es so sortiert hätte wie dein Team.