

Warum die meisten KI-Support-Piloten nichts beweisen
Ich arbeite bei eesel jeden Tag in der Support-Queue und verbringe viel Zeit auf der anderen Seite genau dieses Prozesses: bei Teams, die mitten in einem Test stecken und herausfinden wollen, ob das, was sie sehen, echt ist. Das häufigste Muster ist nicht eine schlechte KI. Es ist ein Pilot ohne Bestehensgrenze. Der Test beginnt, das Dashboard des Anbieters füllt sich mit Grün, und drei Wochen später muss jemand über einen Vertrag entscheiden, und zwar anhand von Zahlen, die das verkaufende Unternehmen selbst definiert hat.
Das ist kein Vorwurf an einen bestimmten Anbieter. Es liegt daran, dass „gelöst“ auf jeder Plattform etwas anderes bedeutet und jede Definition zugleich die Abrechnungseinheit ist:
- Zendesk zählt eine automatisierte Lösung (erklärt im Leitfaden Zendesk automatisierte Lösungen) nur, wenn der Kunde nicht nachfasst und ein LLM das Transkript liest und bestätigt, dass es gelöst wurde. Unterhaltungen, die diese Prüfung nicht bestehen, gelten als „eingedämmt“, nicht als gelöst. Das Fenster beträgt bei Messaging
2 hoursab der ersten Nachricht (bis zu 72 einstellbar) und bei E-Mail72 hours. - Gorgias zählt eine automatisierte Interaktion, wenn „the customer does not require the involvement of a human agent within 72 hours.“
- HubSpot setzt den Lösungsstatus 72 Stunden nach der letzten Antwort des Besuchers und sagt deutlich, dass „deflections do not always indicate resolution“, denn ein Kunde, der aufgegeben hat und gegangen ist, sieht genauso aus wie einer, der eine Antwort bekommen hat.
- Freshdesk rechnet den Freddy AI Agent pro Session ab,
$49pro 100, egal ob die Session gelöst, eskaliert oder abgebrochen wurde.
Keine dieser Definitionen prüft, ob derselbe Kunde nächste Woche wegen desselben Problems wieder schreibt. Genau diese Zahl zeigt aber, ob die KI etwas behoben oder nur eine Unterhaltung beendet hat, und Sie müssen sie selbst messen.
""Deflection" in the customer service world means when you prevent a customer from talking to a human. It's a critical metric for CSR orgs. Often you improve deflection rates by putting hurdles between a customer and a rep."

Die Definitionen habe ich ausführlich in CX-KI-Kennzahlen behandelt; dieser Beitrag zeigt, wie Sie sie für eine Kaufentscheidung nutzen.
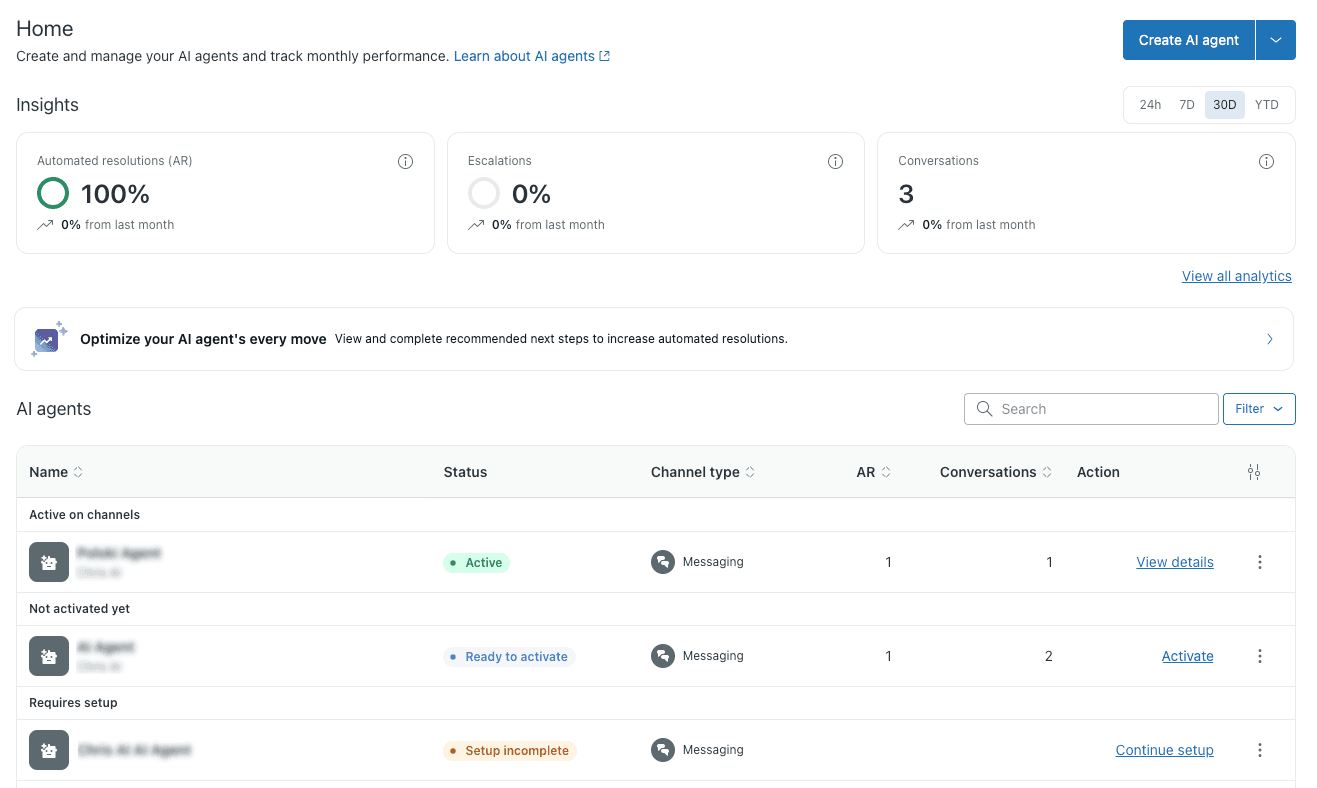
Dieser Screenshot ist das eigene Beispiel aus dem Zendesk-Hilfecenter und eine gute Erinnerung daran, was ein Dashboard bereitwillig anzeigt: 100 % automatisierte Lösungen bei 3 Unterhaltungen. Daran ist nichts falsch. Es ist nur noch kein Beleg für irgendetwas, und frühe Pilotzahlen sehen oft genau so aus.
Was gehört auf eine KI-Pilot-Scorecard?
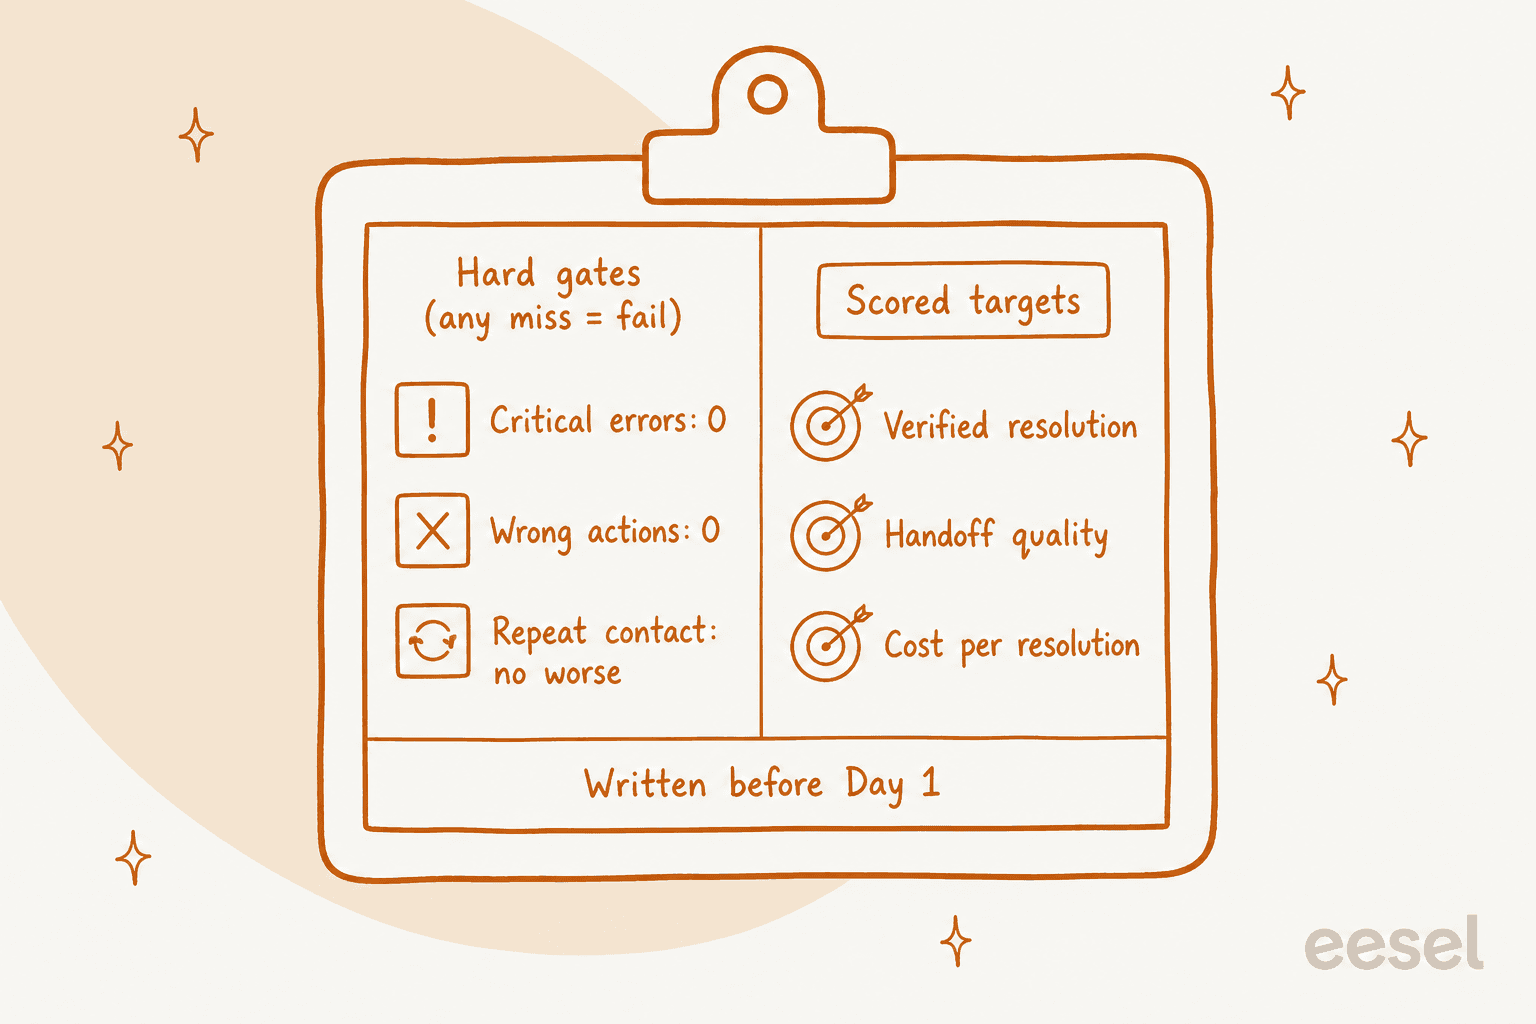
Sechs Kennzahlen, aufgeteilt in zwei Arten. Kriterien sind bestanden oder nicht und lassen sich nicht gegeneinander aufrechnen: Ein Pilot, der 60 % der Tickets löst, aber einmal die falsche Bestellung erstattet hat, ist durchgefallen. Zielwerte sind die Zahlen, die Sie tatsächlich einkaufen, und Sie legen sie vor Pilotstart anhand Ihrer eigenen Ausgangslage fest.
| Kennzahl | Art | So messen Sie sie | Vorab zu vereinbarende Bestehensgrenze |
|---|---|---|---|
| Kritische Fehler | Kriterium | Jede Erstattung, Kündigung, Kontoänderung oder Richtlinienaussage im Pilot, von einer Person geprüft | 0 |
| Falsche Aktionen | Kriterium | Das Aktivitätsprotokoll der KI im Abgleich mit dem, was der Kunde tatsächlich wollte (richtige Bestellung, richtiges Konto, richtiger Betrag) | 0 |
| Folgekontakt innerhalb von 7 Tagen | Kriterium | Kunden mit von der KI gelösten Tickets, die sich zum selben Anliegen erneut melden, verglichen mit der Vergleichsgruppe | Nicht schlechter als die Vergleichsgruppe |
| Verifizierte Lösungsquote | Zielwert | Lösungen, die die 7-Tage-Prüfung überstanden haben, geteilt durch alles, was die KI in ihrer Spur angefasst hat | Ihr Wert, abgeleitet aus den Tickettypen im Umfang |
| Qualität der Übergabe | Zielwert | Eine Stichprobe von Eskalationen: Hat der Mitarbeiter die Bestellnummer erhalten, was wurde versucht und warum wurde übergeben? | Der Mitarbeiter muss den Kunden nichts erneut fragen |
| Kosten pro gehaltener Lösung | Zielwert | KI-Ausgaben des Piloten geteilt durch Lösungen, die Bestand hatten | Niedriger als Ihre Kosten pro von Menschen bearbeitetem Ticket |
Ich würde KI-CSAT während eines Piloten im Bericht lassen, aber nicht auf die Scorecard nehmen. Die Rücklaufquoten sind bei kurzen Tests klein, und bei Zendesk wird die BSAT-Umfrage bei eskalierten Unterhaltungen nicht versendet, sodass sie zu den einfachen Fällen verzerrt ist.
Beim Zielwert für die Lösungsquote liegen die Leute in beide Richtungen falsch. Fallstudien von Anbietern nennen große Zahlen aus ausgereiften Einführungen, und der erste Monat sieht selten so aus. Leiten Sie ihn aus dem Anteil Ihres Volumens ab, der tatsächlich im Umfang liegt. Wenn Fragen zum Bestellstatus 30 % Ihrer Tickets ausmachen und Sie nur diese testen, ist eine Gesamtlösungsquote von 25 % ein großartiges Ergebnis, kein enttäuschendes. Der Leitfaden KI-Lösungsquote erklärt mehr dazu, wie eine realistische Zahl aussieht.
So richten Sie den Pilot ein, damit die Zahlen etwas bedeuten
Eine Scorecard ist nur so gut wie der Vergleich dahinter. Drei Entscheidungen bei der Einrichtung bestimmen, ob Ihre Zahlen standhalten, wenn die Finanzabteilung nachfragt.
Wählen Sie eine Spur, nicht den ganzen Posteingang
Wählen Sie zwei oder drei Tickettypen, die häufig vorkommen, aus Ihrer Dokumentation beantwortbar sind und wenig Risiko bergen, falls die KI einmal danebenliegt: Bestellstatus, Rückgaberichtlinie, Passwort-Zurücksetzungen, Anleitungsfragen. Nehmen Sie einen Kanal in den Umfang (E-Mail oder Chat, nicht beides an Tag eins). Alles andere bleibt bei Ihrem Team. Jeder Anbieter unterstützt irgendeine Variante davon, und das ist der Unterschied zwischen einem Pilot, den Sie auswerten können, und einem, bei dem sich jede schlechte Antwort in eine Debatte darüber verwandelt, ob dieser Tickettyp überhaupt hätte dabei sein sollen.
Ein IT-Manager auf Reddit hat dasselbe Muster für einen Bot an der ersten Kontaktstelle beschrieben:
"I'd be wary of making the bot the only front door, especially for a distributed user base. A good first-line flow should handle a small set of low-risk, high-volume requests and make escalation obvious when confidence is low or the user is stuck. Put a prominent "talk to a person" path beside the guided steps, not three screens deep. Measure containment together with reopen rate, time to resolution, transfer rate, and user satisfaction, because deflecting a ticket that comes back angry is not a win. I'd pilot it with one office or request category, review the transcripts with the service desk every week, and keep a human fallback for outages and accessibility issues."

Die wöchentliche Durchsicht der Transkripte ist der Teil, den Teams als Erstes weglassen, und gleichzeitig der, der die Probleme findet.
So lässt sich bei den einzelnen Helpdesks eine Pilot-Spur eingrenzen:
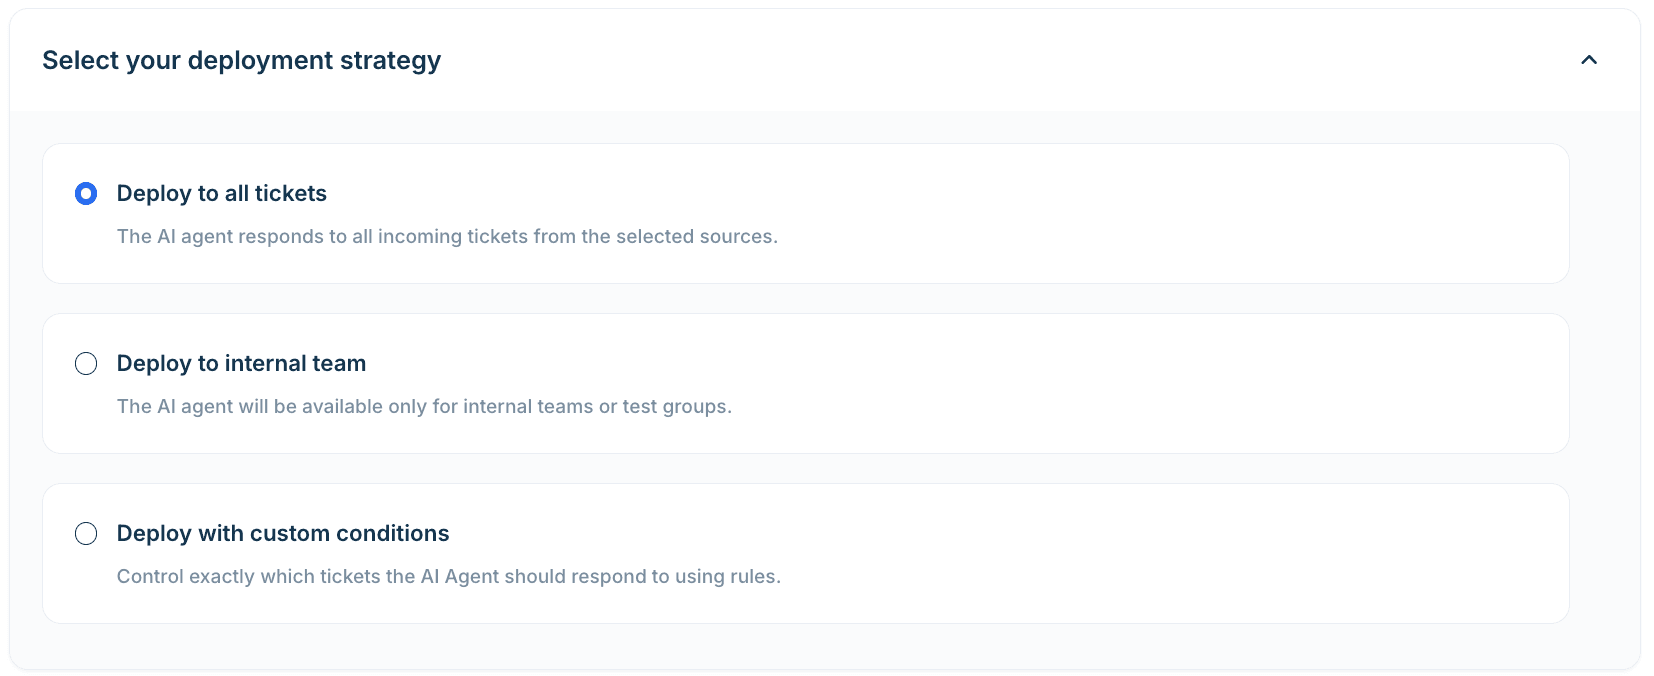
- Freshdesk: Der E-Mail-AI-Agent hat die Option „Deploy to internal teams“, die Freshworks selbst als „a safe pilot rollout“ beschreibt, dazu benutzerdefinierte Regeln mit bis zu fünf Ebenen AND/OR-Logik, sodass Sie „Rückgabe-E-Mails im Hauptpostfach“ und sonst nichts ansprechen können.
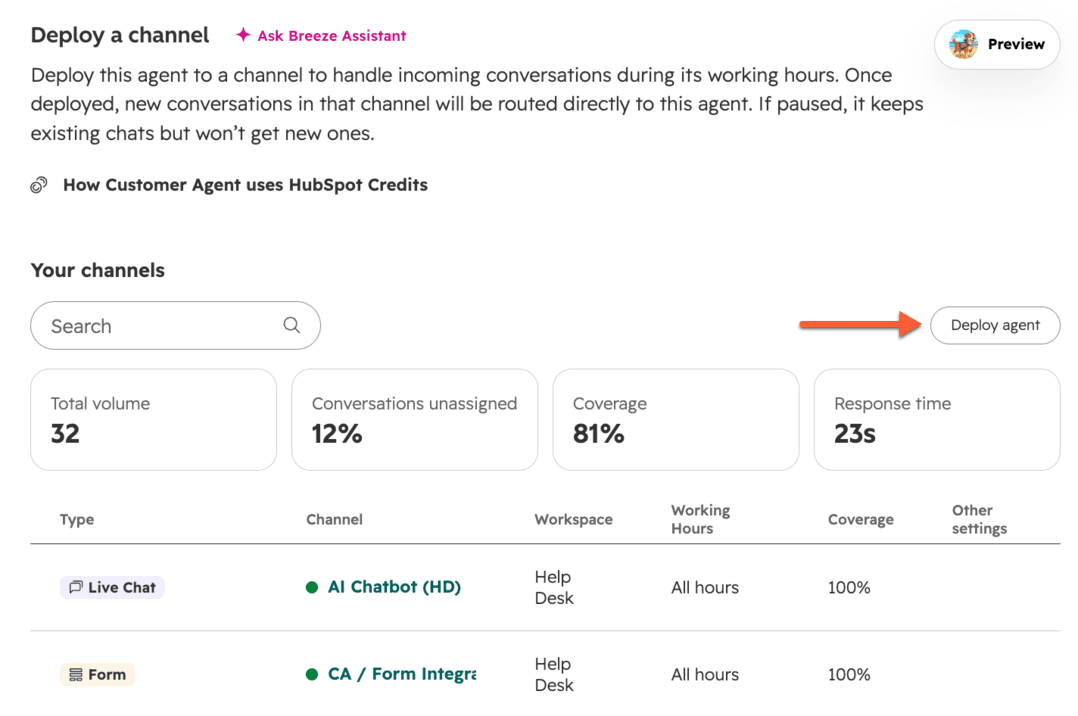
- HubSpot: Jede Kanalbereitstellung hat einen Prozentsatz „Conversation coverage“, Arbeitszeiten und Einschluss-/Ausschlusslisten für Kontakte bei E-Mail. HubSpot empfiehlt, niedrig zu starten und die Abdeckung zu erhöhen, wenn der Agent gut arbeitet.
- Zendesk: Sie wählen die Kanäle pro AI-Agent, und ein E-Mail-Agent wird über einen bearbeitbaren Trigger eingegrenzt, zum Beispiel über eine separate Support-Adresse.
- Gorgias: Der AI Agent wird pro Kanal aktiviert (E-Mail, Chat), und Gorgias beschreibt die Einführung als einen Skill oder Unterhaltungstyp nach dem anderen.
- Help Scout: Scout (die Umbenennung von AI Answers, siehe Help-Scout-Preise) lässt sich bei E-Mail auf „Only customers matching these conditions“ beschränken.
Behalten Sie eine Vergleichsgruppe
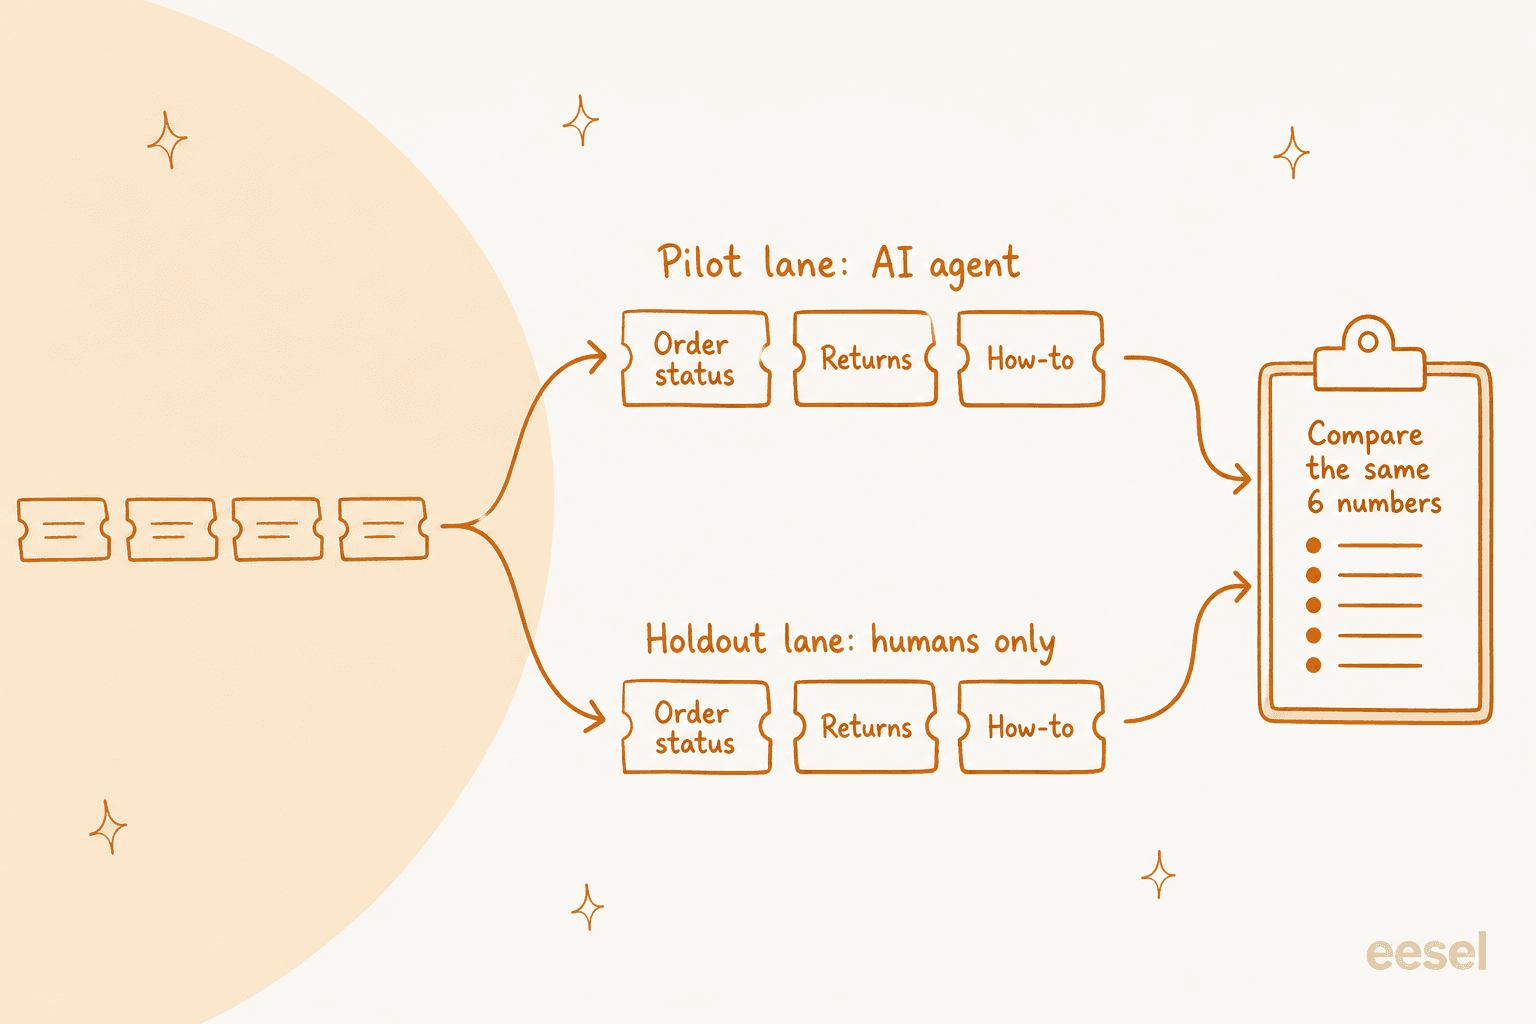
Diesen Schritt macht fast niemand, und er sorgt dafür, dass das Kriterium Folgekontakte funktioniert. Leiten Sie für einen Teil des Traffics dieselben Tickettypen im selben Kanal nur an Menschen. So messen Sie auch die Erstlösungsquote ehrlich. Dann können Sie Gleiches mit Gleichem vergleichen: Wenn Kunden nach 9 % der KI-Lösungen innerhalb von 7 Tagen zurückkommen, nach menschlichen aber nur nach 6 %, erzeugt die KI Mehrarbeit, egal wie gut ihre Lösungsquote aussieht.
"And before-and-after is not evidence. Volume shifts, seasonality, ticket mix, and the agent itself changes which cases humans see, so the human baseline you're comparing against no longer exists. If you want to actually prove improvement rather than assert it, keep a holdout, route some percentage to the old path permanently. It costs a few percent of the gain and it's the difference between a number and an argument. Most teams skip it and then spend six months debating attribution."
Der letzte Satz benennt die ehrlichen Kosten einer Vergleichsgruppe: Sie geben während des Piloten ein paar Prozent des Gewinns auf, und dafür lässt sich das Ergebnis nicht als ruhiger Monat wegdiskutieren.
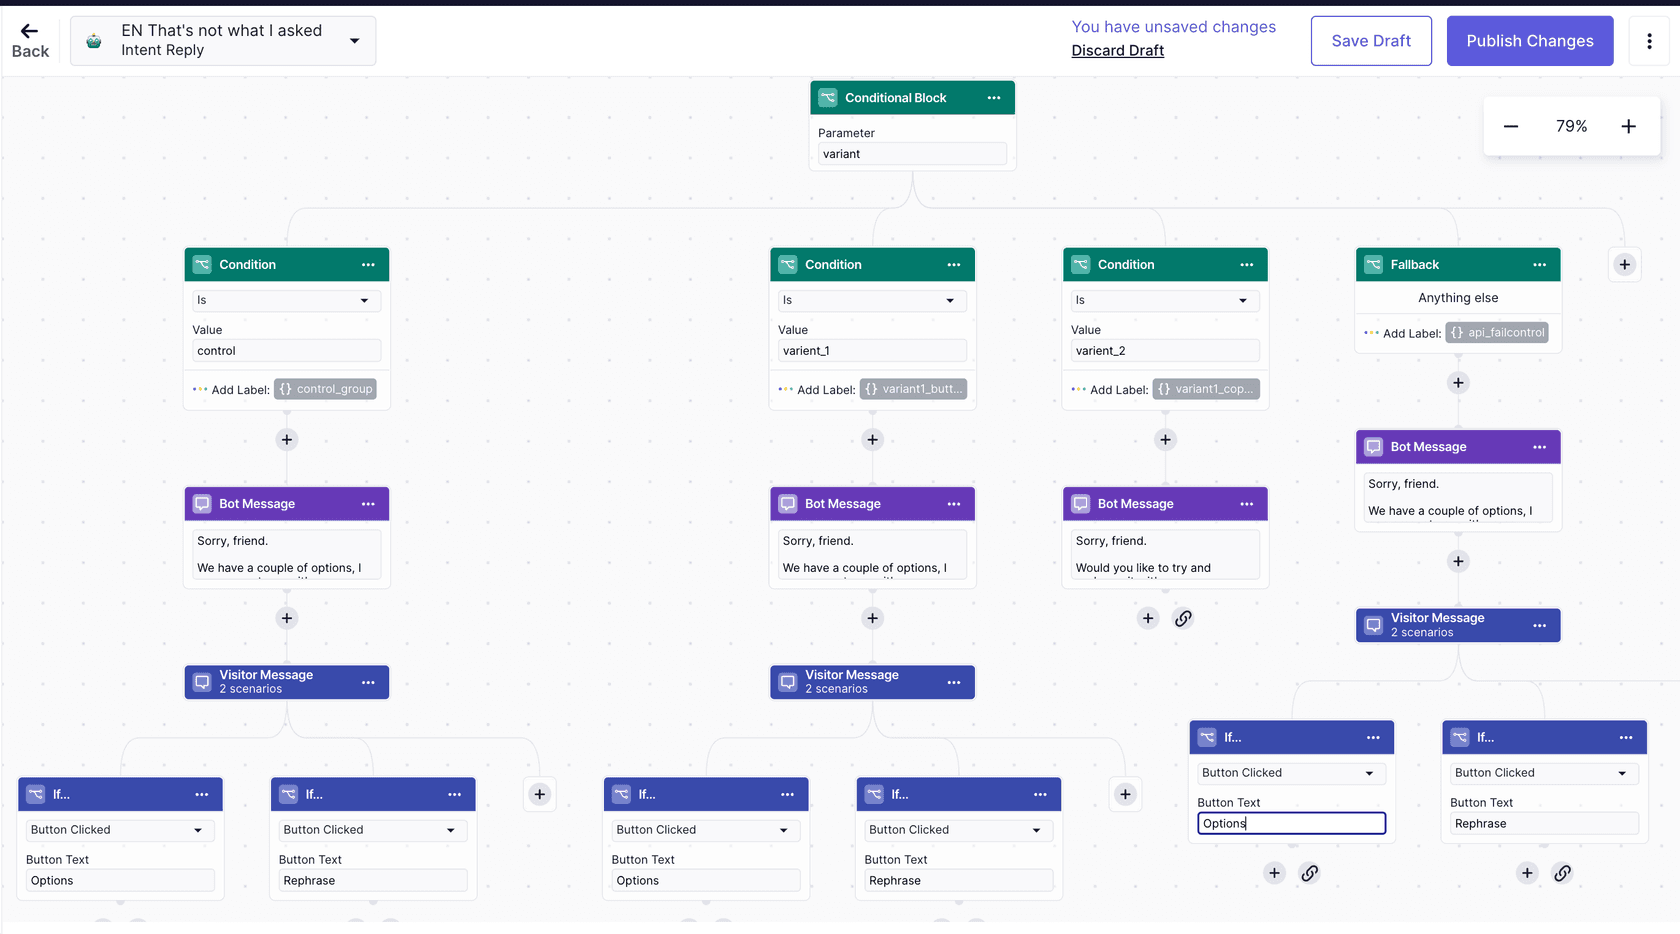
Nur einer der großen Helpdesks dokumentiert eine echte Kontrollgruppe. Der A/B-Testing-Leitfaden von Zendesk beschreibt eine trafficSplit-Methode, die Unterhaltungen zufällig Varianten zuweist („1,1“ ist eine 50/50-Aufteilung, und „the first group will always be the [control] group“). Sie läuft innerhalb von Messaging-Flows, und Sie müssen Ihren Zendesk-Account-Manager bitten, sie freizuschalten. Wenn eine Variante eine direkte Übergabe an einen Menschen ist, haben Sie Ihre Vergleichsgruppe.
Überall sonst bauen Sie die Vergleichsgruppe selbst. Der Abdeckungsprozentsatz von HubSpot ist am einfachsten: Bei 50% Abdeckung gehen die Hälfte der Unterhaltungen eines Kanals an Menschen. HubSpot versteht diese Einstellung als Hochlaufsteuerung, nicht als Kontrollgruppe, Sie vergleichen die beiden Hälften also in Ihrem eigenen Bericht, aber die Aufteilung selbst ist vorhanden.
Bei Freshdesk, Gorgias oder Help Scout funktionieren abwechselnde Tage (KI an Werktagen und Menschen am Wochenende ist zu schief) oder eine Regel auf Basis eines Kundenmerkmals, etwa gerade oder ungerade Kunden-ID. Sie brauchen keine Statistiksoftware. Sie brauchen dieselben Tickettypen, über dieselben Wochen auf zwei Arten bearbeitet.
Taggen Sie alles, was die KI anfasst
Sie werden die Tickets des Piloten später aus Ihrem Helpdesk ziehen wollen, ohne sich auf den Bericht des Anbieters zu verlassen. SE Ranking hat das gut gemacht: Sie haben einen ai_handled-Tag auf jedem Ticket verlangt, das eesel angefasst hat, dazu Tags für hilfreich und nicht hilfreich, sodass die Eindämmung in Zendesk gezählt statt geschätzt wird. Da sie nun direkte E-Mail-Antworten testen, werden die Testtickets über die Betreffzeile erkannt, und jeder Thread erhält einen Tag für offen, gelöst, eskaliert oder bei einer Person. Das ist ein Pilot, den Sie mit einer gespeicherten Ansicht und einer Tabelle prüfen können.
Starten Sie die erste Woche im Entwurfsmodus
Bevor die KI irgendjemandem antwortet, lassen Sie sie eine Woche lang Antworten oder interne Notizen zu echten eingehenden Tickets entwerfen und Ihr Team bewerten. Das kostet Sie kein Kundenrisiko, und hier zeigen sich die meisten behebbaren Probleme. Die vollständige Abfolge vor dem Start habe ich in KI-Support-Agenten testen behandelt, daher fasse ich mich kurz: Die Pilotuhr für die Scorecard startet, wenn die KI in ihrer Spur live geht, nicht wenn Sie sie verbinden.
Wie lange sollte ein KI-Support-Pilot laufen?
Drei bis vier Wochen mit Live-Traffic, plus eine weitere Woche, bevor Sie die endgültigen Zahlen auswerten. Darum ist das länger als bei den meisten kostenlosen Tests.
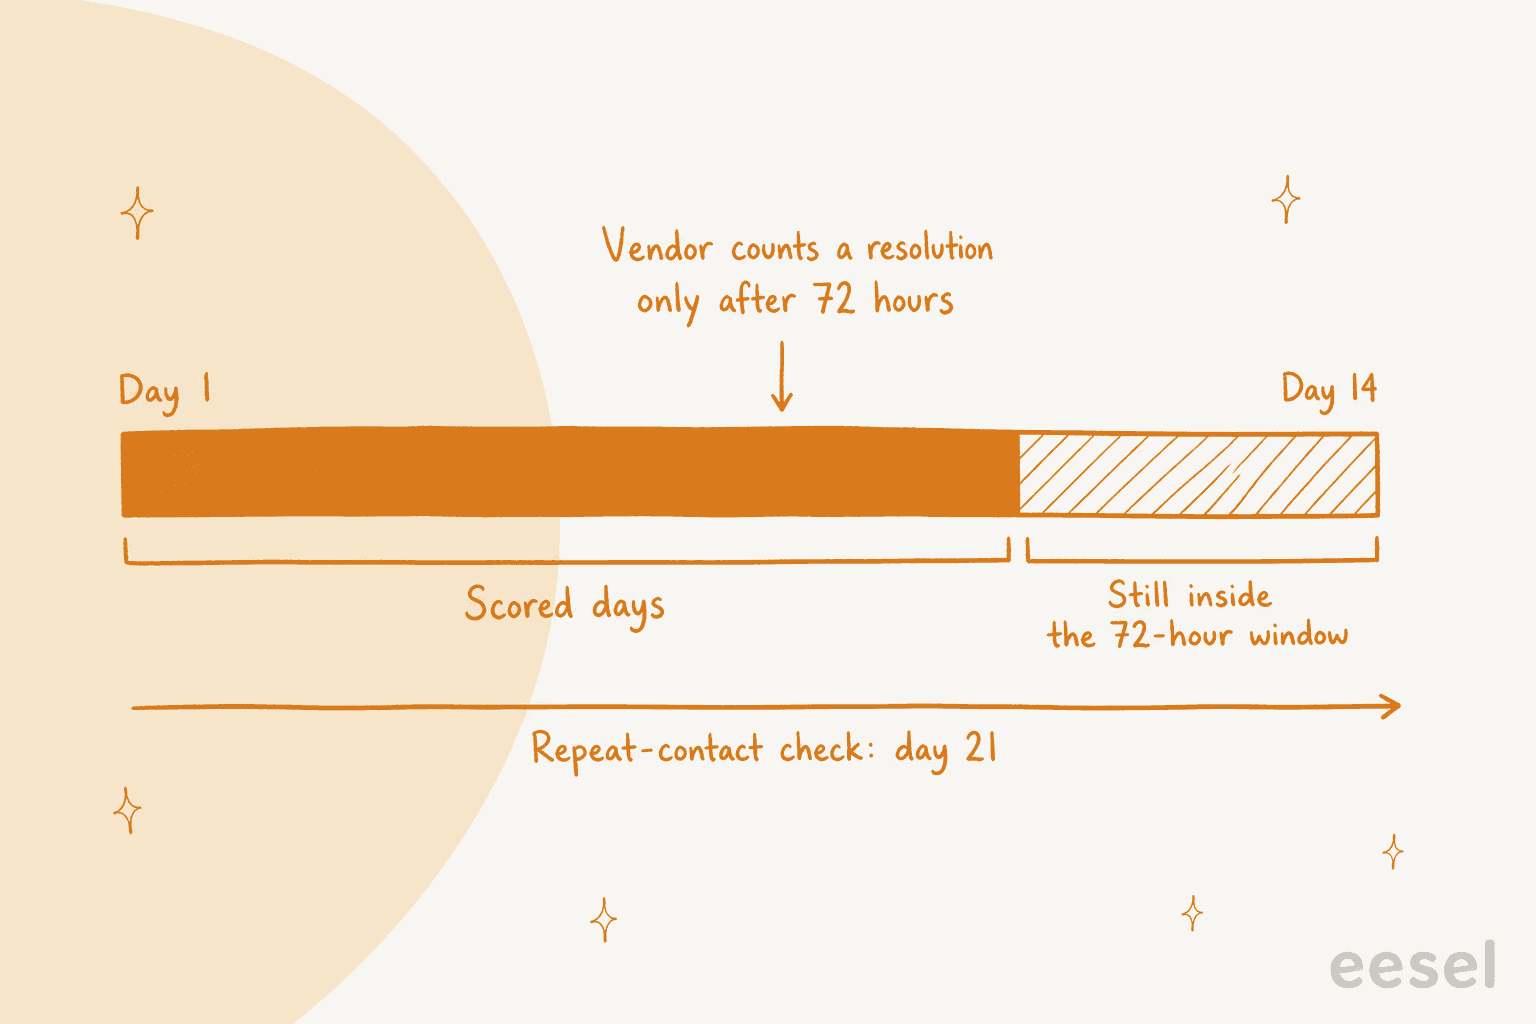
Die Lösungsfenster schieben Ihre Daten weiter nach hinten, als der Kalender vermuten lässt. Gorgias sagt es offen: Eine Interaktion wird erst nach 72 Stunden ohne menschliche Übergabe als automatisiert abgerechnet, „so the most recent 3 days aren't immediately reflected“ in der Kennzahl. HubSpot setzt den Lösungsstatus 72 Stunden nach der letzten Antwort des Besuchers. Das E-Mail-Fenster von Zendesk beträgt 72 Stunden ab der ersten E-Mail. Bei einem 14-Tage-Test lesen Sie bestenfalls 11 Tage abgeschlossener Daten.
Dazu kommt Ihre eigene 7-Tage-Prüfung auf Folgekontakte. Ein Ticket, das die KI an Tag 13 „gelöst“ hat, lässt sich erst an Tag 20 bestätigen. Wenn der Test des Anbieters an Tag 14 endet und das Verkaufsgespräch an Tag 15 stattfindet, unterschreiben Sie auf Zahlen, die noch nicht fertig gezählt sind.
Auch das Volumen zählt. Eine Woche mit 40 KI-Unterhaltungen schwankt wild. Das eigene Beispiel aus dem HubSpot-Hilfecenter zeigt eine Deflection-Rate, die bei einer Handvoll Unterhaltungen pro Woche von Monat zu Monat zwischen 0% und 81.82% springt:
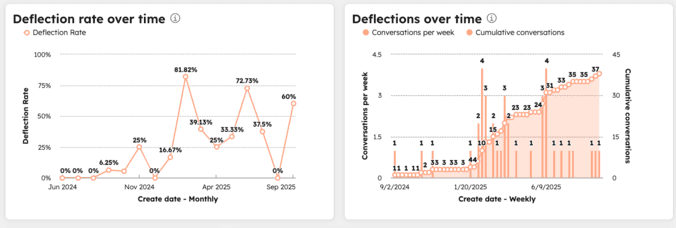
Als grobe Untergrenze wünsche ich mir einige hundert von der KI bearbeitete Unterhaltungen in der Spur, bevor ich der Quote auf ein paar Prozentpunkte genau vertraue. Wenn Ihr Volumen das in drei Wochen nicht erreicht, erweitern Sie die Spur, bevor Sie die Laufzeit verlängern.
Kostenlose Tests sind kürzer als der Pilot, den Sie brauchen. Prüfen Sie also, was jeder tatsächlich bietet, bevor Sie darauf planen:
| Helpdesk | Kostenloser Test oder Kontingent | Wird das Testen abgerechnet? | Haken für den Pilot |
|---|---|---|---|
| Zendesk | 14 days, ohne Karte, AI-Agenten inklusive | Test-Widget, Simulator und Sandbox verbrauchen keine automatisierten Lösungen. Ein im Livebetrieb getesteter E-Mail-Agent tut es | Das 72-Stunden-Fenster bei E-Mail frisst die letzten 3 Tage |
| HubSpot | 14 days kostenloser Zugang, Opt-in, Professional oder Enterprise | Vorschau, Test und Batch-Tests verbrauchen keine Credits | Der Agent „will automatically turn off“, wenn die 14 Tage enden |
| Freshdesk | 500 einmalige Sessions | Die Vorschau von Chat-Agenten verbraucht Sessions; die Vorschau des E-Mail-Agents nicht | Nicht zeitlich begrenzt, aber ungenutzte Sessions verfallen |
| Gorgias | Kostenloser Test, ohne Karte (Dauer nicht veröffentlicht) | Testunterhaltungen sind kostenlos und beeinflussen das Reporting nicht | Die letzten 3 Tage sind noch nicht in der Automatisierungsrate enthalten |
| Help Scout | 3-month kostenloser Test von AI Answers | Nicht angegeben | Lang genug für einen ordentlichen Pilot |
| Salesforce (Agentforce) | Kostenlose Developer Edition | Testing Center seit Summer '26 ohne Zählung | Das Routing für den Live-Pilot ist ein Flow, den Sie selbst bauen |
Wenn der Test 14 Tage dauert, bitten Sie den Anbieter vor Tag eins schriftlich um eine Verlängerung, mit angehängter Scorecard. Ein Anbieter, der von seinem Produkt überzeugt ist, sagt in der Regel Ja, und wie er antwortet, sagt Ihnen in beiden Fällen etwas.
So bewerten Sie jede Kennzahl
Legen Sie eine gemeinsame Tabelle an, mit einer Zeile pro Woche und einer Spalte pro Scorecard-Kennzahl. Füllen Sie sie aus Ihrem Helpdesk-Export, nicht aus dem Dashboard des Anbieters, und nutzen Sie das Dashboard nur zum Gegenprüfen.
Verifizierte Lösungsquote: Prüfen Sie den Stapel „gelöst“ von Hand
Ziehen Sie jede Woche 30 bis 50 Unterhaltungen, die die Plattform als gelöst markiert hat, und lesen Sie sie. Markieren Sie jede: tatsächlich beantwortet, Kunde hat aufgegeben oder falsch beantwortet. Wenn zwei Prüfer beim selben Ticket uneins sind, führen Sie eine kurze QA-Kalibrierung durch, bevor Sie der Auszählung trauen. So entdecken Sie die Lücke zwischen „die Unterhaltung ist zu Ende“ und „das Problem war gelöst“. Bei einem Gegencheck von 100 Tickets im Posteingang eines Schmuckhändlers während eines eesel-Tests lagen die Entwürfe zu 88 % der Fälle grundsätzlich richtig, aber nur 12% wurden ohne Änderungen gesendet und 7% enthielten einen Sachfehler. Eine einzige Genauigkeitszahl hätte alle drei Befunde verdeckt.
Die Checkliste eines Praktikers geht genau richtig über die Dashboard-Zahl hinaus:
"That's why I wouldn't measure this only by "tickets deflected." I'd also look at: Average human handling time after AI is involved Repeat contacts/reopens How often the customer has to repeat themselves after escalation Whether AI is actually removing repetitive work from the team And, obviously, whether customers are still getting the problem solved"
Folgekontakt: der 7-Tage-Rückblick
Prüfen Sie bei jedem von der KI gelösten Ticket, ob derselbe Kunde innerhalb von 7 Tagen ein weiteres Ticket geöffnet hat, in einem beliebigen Kanal. Machen Sie dasselbe für die Vergleichsgruppe. Die meisten Helpdesks können das mit einer Suche nach Anfragenden oder einem nach Kunde gefilterten Bericht, und es ist die eine Zahl, die Ihnen kein Anbieter-Dashboard direkt liefert. Gorgias öffnet bei E-Mail nur dann ein neues Ticket, wenn die Antwort mehr als 10 Tage nach der letzten Nachricht kommt (bei Chat, SMS und Sprache 3 Tage), und bei HubSpot öffnet eine E-Mail-Antwort nach 72 Stunden die Unterhaltung wieder und kann als zweite Lösung abgerechnet werden. Ein zurückkehrender Kunde landet also entweder im selben Ticket oder in einem neuen, und Sie müssen nach beidem suchen.
Kritische Fehler und falsche Aktionen: Lesen Sie das Protokoll, nicht die Antwort
Eine Antwort kann einwandfrei klingen und trotzdem auf einer falschen Aktion beruhen: Bestellung 4417 erstatten, obwohl der Kunde nach 4471 gefragt hat, ein Rückgabefenster nennen, das Sie letzten Monat geändert haben, einen Liefertermin versprechen, den niemand garantieren kann. Prüfen Sie jede Aktion der KI, die Geld oder ein Konto betrifft, und jede Antwort, die eine Richtlinie nennt. Wenn Sie einen Fall finden, führt eine kurze Fehleranalyse meist auf eine fehlende Regel oder einen veralteten Artikel zurück. Halten Sie Erstattungen, Kündigungen und Kontoänderungen für den gesamten Pilot hinter einer menschlichen Freigabe; Freigabe-Workflows kosten Sie täglich ein paar Minuten und nehmen den teuersten Fehler aus dem Test.
Qualität der Übergabe: Ziehen Sie Stichproben der Eskalationen
Ziehen Sie pro Woche 20 übergebene Unterhaltungen und stellen Sie Ihren Mitarbeitern eine Frage: Mussten Sie den Kunden etwas erneut fragen? Wenn die Antwort oft Ja lautet, spart die KI bei den Tickets, die sie schließt, Zeit und verbraucht sie bei denen, die sie übergibt. Der Beitrag Best Practices für die Übergabe enthält eine Checkliste dafür, was eine gute Übergabenotiz enthält.
Kosten pro gehaltener Lösung: Rechnen Sie mit den Lösungen, die Bestand hatten
Nehmen Sie Ihre KI-Ausgaben für den Pilotzeitraum und teilen Sie sie durch die verifizierten Lösungen nach der 7-Tage-Prüfung, nicht durch die Lösungszahl des Anbieters. Vergleichen Sie das dann mit Ihren voll belasteten Kosten pro von Menschen bearbeitetem Ticket. Der Leitfaden Chatbot-ROI listet auf, was in diese Zahl eingeht. Die Abrechnungseinheit verändert das Ergebnis stark, und deshalb lassen sich KI-Kennzahlen im Kundenservice bei verschiedenen Anbietern selten vergleichen:
| Helpdesk | Was Ihnen berechnet wird | Was das für die Scorecard bedeutet |
|---|---|---|
| Zendesk | $1.50 bei Abnahmeverpflichtung / $2.00 Pay-as-you-go pro verifizierter automatisierter Lösung | Das Fenster schließt nach 2 Stunden (Messaging) oder 72 Stunden (E-Mail), ein später zurückkehrender Kunde ändert die Zählung also nicht |
| Gorgias | $0.85 bis $1.00 pro automatisierter Interaktion, und ein vollständig von der KI gelöstes Ticket kann zusätzlich als Helpdesk-Ticket zählen | Bei aktueller Preisgestaltung können zwei Gebühren auf einem Ticket anfallen |
| Freshdesk | $49 pro 100 Sessions, unabhängig vom Ergebnis | Teilen Sie die Session-Ausgaben durch gehaltene Lösungen, nicht durch $0.49 |
| HubSpot | HubSpot Credits pro Lösung; ein wieder geöffneter E-Mail-Thread kann erneut abgerechnet werden | Credits sind im 14-tägigen Testzeitraum kostenlos, bewerten Sie den Pilot also zum vollen Preis |
| eesel | 1 Credit pro Ticket oder Chat, an dem es arbeitet, ab $299/month für 500 | Pauschal pro Ticket, die Kosten pro gehaltener Lösung sinken also, wenn die Lösung besser wird |
Details zu Zendesk finden Sie unter Zendesk-KI-Preise; Gorgias wird in Gorgias AI Agent Preise aufgeschlüsselt und Freddy in Freddy-KI-Preise.
Setzen Sie hier Ihre eigenen Zahlen ein. Die Standardwerte zeigen ein häufiges Ergebnis: eine Lösungsquote, die das Ziel erreicht, und ein Pilot, der trotzdem durchfällt, weil Kunden häufiger wiederkommen als nach einer menschlichen Antwort.
Wie sehen echte Pilotdaten aus?
Ehrliche Pilotdaten sind unebener als eine Fallstudie. Einiges, was ich in echten Tests mit eesel gesehen habe:
- Die meisten frühen Korrekturen betreffen Wissen, nicht das Modell. Eine Analyse der Wissenslücken zu den Fehlern der ersten Woche ist der schnellste Weg, die Zahl der zweiten Woche zu verbessern. Im Juwelier-Test betrafen etwa
65%der Änderungen, die Mitarbeiter an Entwürfen vornahmen, Länge und Tonfall, behebbar durch Training an den eigenen gesendeten Antworten des Teams. Etwa20%der Änderungen brauchten Daten, die die KI noch nicht hatte (Bestell- und Versandsysteme), und nur etwa5%der Änderungen korrigierten einen Sachfehler. (Die oben genannte Sachfehlerquote von7%zählt alle Entwürfe; diese Aufteilung zählt nur die Änderungen.) - Die Regeln wachsen Woche für Woche. Stil Classics lässt seinen Entwurfs-Agenten auf Gorgias die Shopify-Bestellung lesen, bevor er eine Zeile schreibt,
230Bestellabfragen bei320Tickets in einem Monat, und seine Anweisungen sind bei der neunten Überarbeitung, wobei jede Woche Tickets eine Regel hinzufügt. Ein Pilot ist der Ort, an dem diese ersten Überarbeitungen stattfinden, gewichten Sie daher die letzte Woche stärker als die erste. - Ein kurzer Test kann auf einer schmalen Spur trotzdem etwas beweisen. Gridwise hat eesel während eines 7-tägigen Tests auf Zendesk eingerichtet und danach geschrieben: „In the first month, eesel is resolving 73% of our tier 1 requests.“ Beachten Sie die Form dieser Aussage: Tier 1, erster Monat, nach dem Test. Das ist eine eingegrenzte Zahl, und das macht sie glaubwürdig.
Und die Warnung von der anderen Seite, von einem SaaS-Team, das ein Quartal lang das Falsche gemessen hat:
"We were excited about AI taking care of Level 1 support. The numbers looked great. Fifty percent of tickets were resolved without a human. Response times dropped to seconds, and support costs went down. Leadership loved the dashboard. Then Q3 renewal data came in. Net retention fell by 6 points."
Unterschreiben, verlängern oder abbrechen: die Entscheidungsregeln
Schreiben Sie diese drei Regeln in den Pilotplan und lassen Sie den Anbieter sie vor Tag eins sehen. Das verändert das Gespräch am Ende von „Wie fühlt es sich an?“ zu „In welche Kategorie ist es gefallen?“
- Abbrechen, wenn ein Kriterium verfehlt wurde: ein kritischer Fehler oder eine falsche Aktion, die einen Kunden erreicht hat, oder Folgekontakte, die schlechter sind als in der Vergleichsgruppe. Fragen Sie den Anbieter, was sich geändert hat, um das zu verhindern, und entscheiden Sie dann, ob ein zweiter Pilot sich lohnt.
- Verlängern, wenn die Kriterien eingehalten, aber ein Zielwert verfehlt wurde. Meist heißt das, die Spur war zu schmal, um das Volumen zu erreichen, oder die größten Wissenslücken wurden nicht geschlossen (ein Audit der Wissensdatenbank hilft hier). Zwei weitere Wochen, mit einer schriftlichen Liste dessen, was sich ändert.
- Unterschreiben, wenn beide Kriterien eingehalten und die Zielwerte bei Lösungen erreicht wurden, die die 7-Tage-Prüfung überstanden haben. Erweitern Sie dann einen Tickettyp nach dem anderen und lassen Sie dieselbe Scorecard nach dem Start jeden Monat weiterlaufen.
Der Test, der mir am besten gefällt, um zu prüfen, ob Ihr Ergebnis echt ist, stammt von einem Praktiker auf Reddit:
"On a returns-triage agent we ran, the only number leadership cared about was human hours the process no longer consumed, measured before and after on the same queue. Same intake, fewer human hours per week, error rate no worse than baseline. Eval scores and resolution rates never moved them. Those are agent metrics. Execs stop trusting agent metrics after about a month. My rule of thumb now: if the vendor dashboard vanished tomorrow, could you still prove the value from your own systems? If yes, you have ROI. If no, you have a dashboard."
Zwei Vertragspunkte sollten Sie vor der Unterschrift ansprechen, weil der Pilot Ihnen gezeigt haben wird, warum sie wichtig sind: ob Sie Rohdaten der Unterhaltungen exportieren können (nicht nur das Dashboard), falls Sie wechseln, und wie Lösungen angefochten werden, wenn sich eine „gelöste“ Unterhaltung als Kunde herausstellt, der aufgegeben hat.
"The hour later example is what I'd put in the contract, because the hard part is the clock, not the words. Most vendor logs call that ticket closed and billable, since their resolution means their ticket status. So put the metric on events you can pull yourself, like a refund id or an appointment that stayed booked. Anything with no clean system event bills at base price only. Otherwise the agent just gets good at closing tickets."
Häufige Fehler bei KI-Piloten
- Den Anbieter die Tickettypen wählen lassen. Er wählt die, in denen seine KI am besten ist. Wählen Sie die, die Ihr Team am meisten Zeit kosten, etwa Fragen zum Bestellstatus.
- Anbieter auf unterschiedlichen Spuren vergleichen. Wenn Sie zwei Piloten fahren, nutzen Sie für beide dieselben Tickettypen und dieselbe Scorecard, wie in einen KI-Support-Agenten auswählen.
- Auf allen Kanälen gleichzeitig testen. Sie können dann nicht erkennen, ob eine schlechte Woche am Chat, an der E-Mail oder an der Wissensdatenbank lag.
- Keine Ausgangslage. Wenn Sie Ihre aktuelle Folgekontaktquote oder Ihre Kosten pro Ticket nicht kennen, lässt sich nichts im Pilot mit irgendetwas vergleichen. Ziehen Sie die Zahlen des letzten Quartals vor Tag eins. Der Leitfaden Kundenservice-KPIs erklärt, wie.
- Probleme mitten im Pilot stillschweigend beheben, ohne es zu notieren. Beheben Sie sie, das ist der Sinn. Aber protokollieren Sie das Datum jeder Änderung, damit Sie wissen, welche Wochen zu welchem Setup gehören.
- Die Ergebnisse am letzten Testtag auswerten. Wegen der 72-Stunden-Fenster und des 7-Tage-Rückblicks ist die letzte Woche noch nicht bewertet. Legen Sie den Entscheidungstermin eine Woche nach Pilotende.
Die längere Liste von Einführungsfehlern finden Sie unter Fehler bei der Einführung von KI im Kundenservice.
Führen Sie Ihren KI-Support-Pilot mit eesel durch
eesel ist ein KI-Teammitglied, das in Ihren bestehenden Helpdesk einsteigt (Zendesk, Freshdesk, Gorgias, HubSpot und andere) und die Queue wie ein neuer Mitarbeiter abarbeitet. Für einen Pilot machen drei Dinge die Scorecard leichter auszufüllen:
- Ein Score vor dem ersten Live-Ticket. Der Simulations-Skill spielt Ihre echten vergangenen Tickets durch, vergleicht seine Antworten mit dem, was Ihr Team tatsächlich gesendet hat, und schlägt Anpassungen der Anweisungen vor. Er sendet nichts an Kunden.
- Entwurfsmodus und Freigaben als Standard. Es startet mit jeder Antwort als Entwurf oder interner Notiz, und Aktionen wie Erstattungen bleiben auf „Needs approval“, bis Sie sie ändern. Freigaben laufen nach einem Timeout nie von selbst durch.
- Ein Protokoll, das Sie prüfen können. Die Seite Aktivität listet jedes bearbeitete Ticket auf, was gesucht wurde, jede Aktion, wer sie freigegeben hat, und die Begründung. Übersprungene Tickets werden mit dem Grund aufgeführt, und genau das brauchen Sie für das Kriterium kritische Fehler.

Die Preise bestehen aus einem festen Monatstarif, bei dem ein Ticket oder ein Chat 1 Credit kostet: kostenlos für 100 Credits ohne Karte, dann ab $299/month für 500 Credits. Spam, den Sie überspringen lassen, zählt nicht. Das macht die Kostenzeile Ihrer Scorecard einfach zu berechnen, denn Sie zahlen nicht pro „Lösung“ nach der Definition des Anbieters. smava setzt eesel seit Dezember 2024 auf seinem Zendesk ein, und das aktuelle Setup mit drei Agenten, live seit Juni 2026, bearbeitet 27,000 Tickets pro Monat. Wenn Sie kurz vor einem Pilot stehen, lassen Sie zuerst den kostenlosen Tarif auf Ihrer eigenen Queue laufen und bringen Sie den Simulationsbericht in den Anbietervergleich mit. eesel testen.