

Warum „von KI gelöst" fünf verschiedene Dinge bedeutet
Ich beschäftige mich seit zwei Jahren mit Support-Inhalten aus Suchsicht, und das Muster in dem, was Käufer eintippen, ist klar: Sie fragen „Was ist eine gute KI-Lösungsrate?", lange bevor sie fragen „Was zählt mein Anbieter als gelöst?". Die zweite Frage ist die, auf die es ankommt, denn die Zahl in Ihrem Dashboard ist nur so ehrlich wie ihre Definition.
Hier ist die Narbe, die eesel das gelehrt hat. Bei einem Abgleich von 100 Tickets im Zendesk-Posteingang eines deutschen Online-Juweliers (etwa 1.000 Tickets pro Monat) waren die Entwürfe des Agenten zu 88 % in der Richtung korrekt, aber nur 12 % wurden unverändert gesendet, und 7 % enthielten einen sachlichen Fehler. Eine einzige „Genauigkeits"-Zahl hätte die beiden anderen Werte verdeckt. Derselbe Posteingang bestand zu 22 % aus Spam. Deshalb ist die erste Frage, die ich bei jeder genannten KI-Lösungsrate stelle, ob automatisch geschlossener Spam darin enthalten ist.
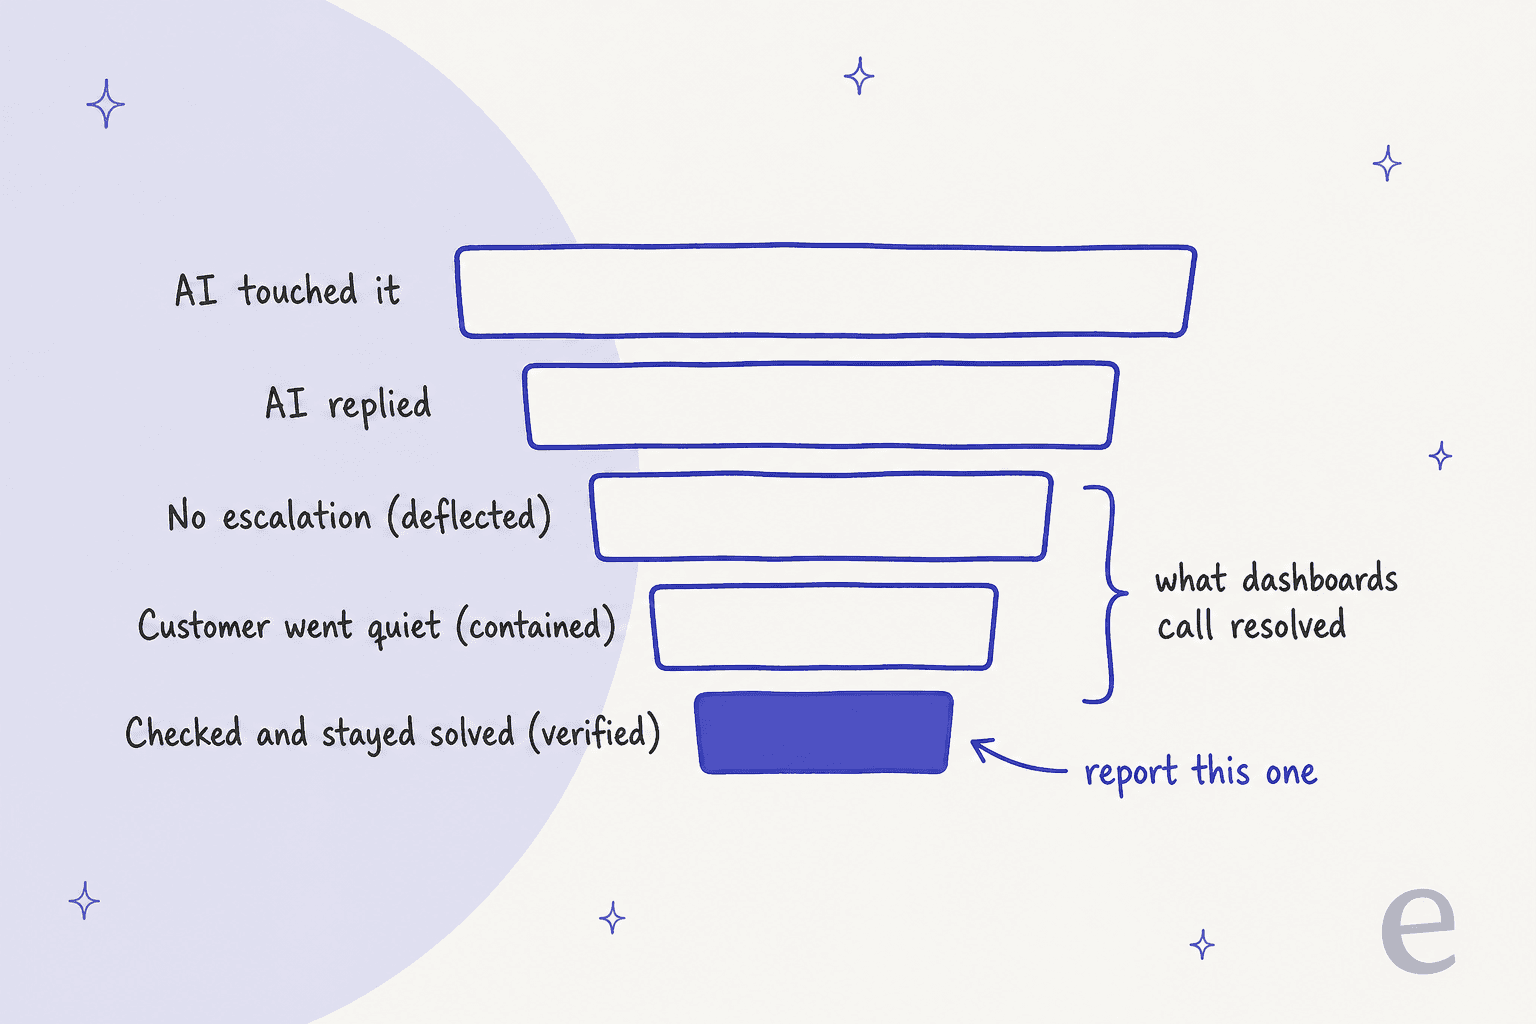
Jede Stufe in diesem Trichter ist eine strengere Definition, und jede liefert eine kleinere Zahl:
- Berührt: Die KI hat die Konversation gesehen. Gorgias nennt das Coverage, HubSpot nennt es Handle Rate.
- Geantwortet: Die KI hat etwas gesendet. Leicht zu zählen, sagt aber nichts über das Ergebnis.
- Deflektiert: Niemand hat eskaliert. Zendesks eigene Dokumentation sagt: „any conversation that doesn't end in escalation is considered deflected."
- Contained: Der Kunde wurde innerhalb eines Zeitfensters still. Still kann zufrieden heißen oder aufgegeben.
- Verifiziert: Etwas hat das Ergebnis geprüft. Ein Modell, das das Transkript liest, ein menschliches Audit oder (der stärkste Test) kein erneuter Kontakt zum selben Problem.
"execs loved our "automation success rate" - 40-something percent deflection, beautiful QBR slides. meanwhile i'm going through churn interviews and people are literally saying "i tried to get help and just gave up." that's not deflection, that's abandonment dressed up in a metric."

Wenn Sie sich nur eines merken: Die Haupt-KI-Kennzahl eines Anbieters liegt meist irgendwo zwischen deflektiert und contained, und in der Lücke zwischen ihr und verifiziert versickert still Ihr CSAT. Für die breitere Liste der Service-Zahlen pflege ich einen eigenen Leitfaden zu KI-Kundenservice-Kennzahlen und zu den klassischen Kundenservice-KPIs.
Wie jeder Helpdesk seine KI-Kennzahl definiert
Diesen Abschnitt überspringen die meisten Beiträge, und er entscheidet, ob Ihr Bericht etwas aussagt. Ich habe im Oktober 2026 das Hilfecenter und die Preisseite jedes Anbieters gelesen. Die Kurzfassung: Abrechnungseinheit und Hauptkennzahl sind meist dasselbe, und das sollten Sie wissen, bevor Sie diese Kennzahl als neutral behandeln.
| Helpdesk | Wie der KI-„Erfolg" heißt | Was zählt | Zeitfenster | Was Sie zahlen |
|---|---|---|---|---|
| Zendesk | Verified Resolution (eine von drei Stufen) | Keine Rückmeldung des Kunden, dann liest ein LLM das Transkript und bestätigt, dass es gelöst wurde | 2 Stunden bei Messaging (bis zu 72), 72 Stunden bei E-Mail, ab der ersten Nachricht | $1.50 Commitment, $2.00 Pay-as-you-go pro automatisierter Lösung (Preise) |
| Freshdesk (Freddy AI Agent) | Resolved / Deflection Rate | „Conversations closed without human intervention" | Abgebrochen nach etwa 24 Stunden ohne Antwort | $49 pro 100 Sessions, abgerechnet pro Session unabhängig vom Ergebnis (Preise) |
| Gorgias | Automated Interaction | Kunde braucht innerhalb von 72 Stunden keinen Menschen | 72 Stunden | $0.85 bis $1.00 pro automatisierter Interaktion (Preise) |
| HubSpot (Customer Agent) | Resolution | Agent hat eine Quelle geteilt oder eine Aktion ausgeführt, und es gab keine vom Besucher ausgelöste Übergabe | 72 Stunden nach der letzten Besucherantwort festgelegt | 50 HubSpot Credits pro gelöster Textkonversation |
| Salesforce (Agentforce) | Deflected Session / Billable Resolution | Session „ended by user", bzw. für die Abrechnung: 2+ Turns, finales Feedback nicht negativ, keine Eskalation | Bis zu 2 Stunden pro Chat-Lösung | $2 pro Konversation oder Flex Credits zu $500 pro 100.000 (Preise) |
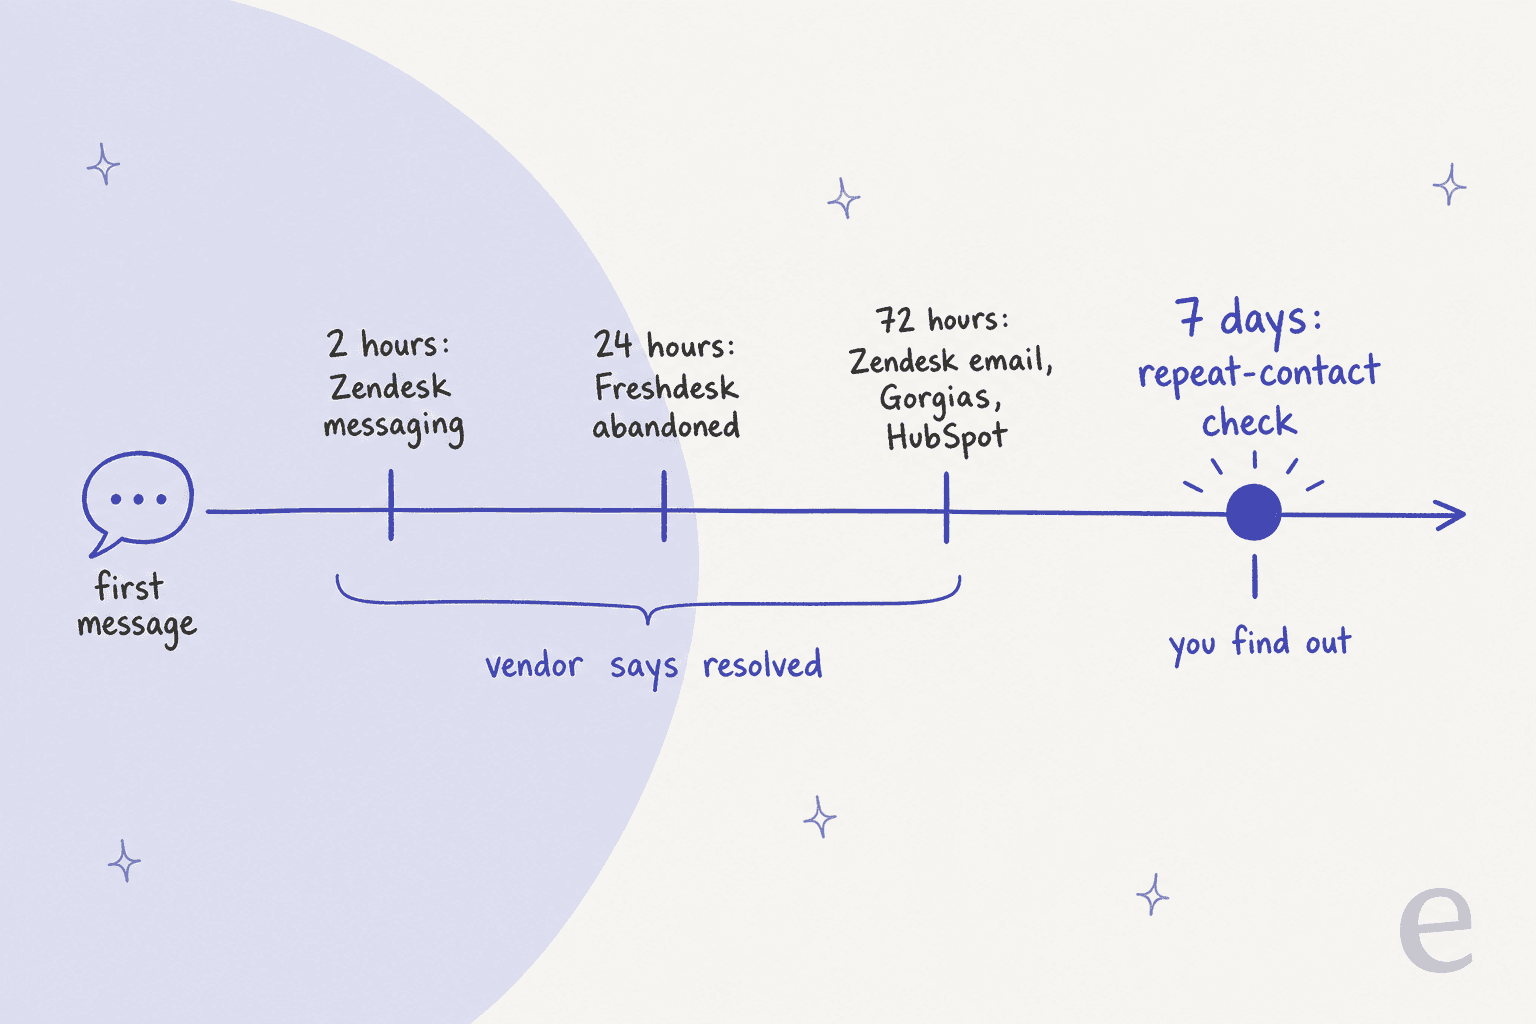
Die Zeitleiste hat mich am meisten überrascht. Jeder Anbieter entscheidet innerhalb von drei Tagen, ob etwas „gelöst" ist. Ein Kunde, der an Tag vier wegen derselben kaputten Bestellung zurückschreibt, erscheint als brandneue Konversation, und die erste bleibt ein Erfolg. Deshalb gehören wiederkehrende Support-Tickets auf jedes KI-Scorecard.
"The last one in the absence of feedback is only a very weak proxy for a resolved issue. If you consider customer support a cost center, you can guess how managers would optimize these numbers."

Zendesk: drei Stufen, und nur eine wird berechnet
Seit dem 18. Mai 2026 teilt Zendesk jede automatisierte Lösung in drei Stufen auf. Assisted Escalation heißt, die KI hat geholfen, aber ein Mensch hat abgeschlossen. Contained Resolution heißt, der Kunde hat weder um Klärung gebeten noch Feedback gegeben noch einen Menschen verlangt, aber die Konversation ist bei der LLM-Prüfung durchgefallen. Verified Resolution heißt, sie hat bestanden. Nur verifizierte Lösungen werden auf Ihr Kontingent angerechnet.
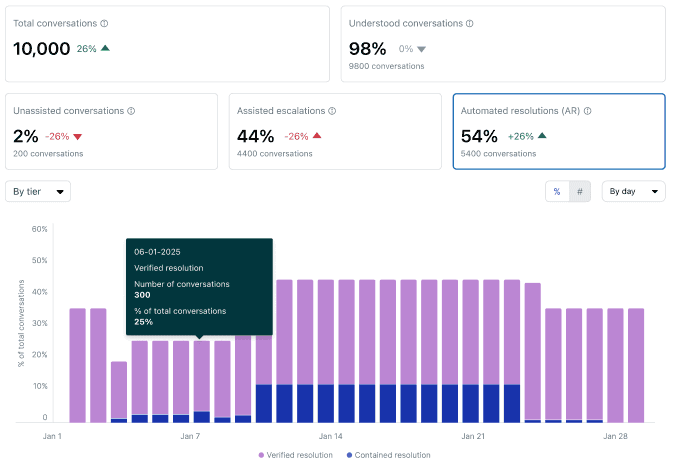
Das ist ein fairer Entwurf und kommt „verifiziert" näher als jeder andere Helpdesk. Drei Dinge sollten Sie wissen, bevor Sie die Zahl nach oben berichten:
- Die Verifizierung ist ein Modell, das das Transkript liest. Ein menschlicher Prüfschritt wird nicht beschrieben.
- Das Fenster beginnt mit der ersten Nachricht, daher läuft die Standardprüfung bei Messaging nach 2 Stunden.
- Lösungen werden „counted per conversation rather than per user", und die aktuellen KI-Agent-Berichte haben keine Kennzahl für Wiedereröffnung oder Folgekontakt. Die alte „non-reopened resolution rate" gibt es nur im Legacy-Datensatz.
Käufer drängen schon länger auf die Zählregeln. Bevor es die Stufen gab, schrieb ein Zendesk-Admin bei der Preisprüfung:
"We're also finding the "resolution" logic really unclear, especially when a user clicks something passively (like "Yes" on an article) and it still counts as a full resolution. It feels risky to commit when the billing metric isn't tightly tied to actual customer outcomes."
Die verifizierte Stufe ist ein echter Schritt, um das zu beheben. Zendesks Lösungsrate sind automatisierte Lösungen geteilt durch alle Konversationen, laut Kennzahlen-Referenz. Das KI-CSAT heißt BSAT: der Anteil der Bewertungen 4 und 5 auf einer Skala von 1 bis 5, nur bei Messaging. Ein Detail ist für Ihre Auswertung wichtig. Laut BSAT-Dokumentation werden per Trigger gesendete BSAT-Anfragen „aren't sent for conversations that were escalated to a human agent." BSAT bewertet also vor allem die Konversationen, die ohnehin gut liefen.
Die Dashboards selbst habe ich in Zendesk AI Agent Analytics behandelt, die Abrechnungsrechnung in Zendesk-KI-Preise.
Freshdesk: Achten Sie darauf, wo abgebrochene Konversationen landen
Freshdesks AI Agent Studio zeigt einen Trichter: Total, Unresolved, Escalated, Abandoned, Resolved, Closed. „Resolved" sind „conversations closed without human intervention", und eine Konversation ohne Antwort seit etwa 24 Stunden gilt als abandoned. Anerkennenswert: Freshdesk nennt eine Deflection Rate „below 60% for a high-volume topic" als Warnsignal und weist darauf hin, dass eine steigende Anzahl keine steigende Rate ist.
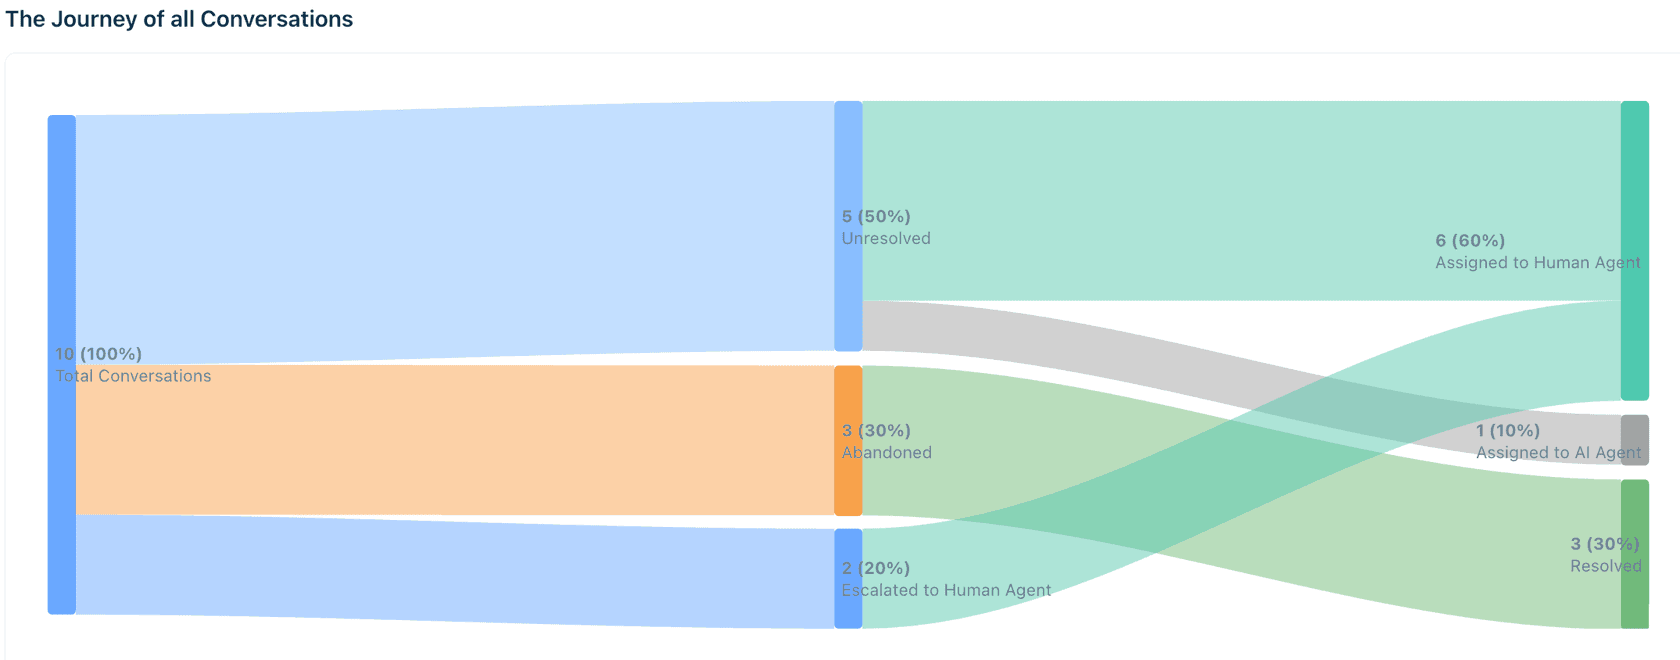
Schauen Sie sich das Beispieldiagramm in Freshdesks eigener Dokumentation genau an: Die 3 abgebrochenen Konversationen fließen rechts in die Spalte Resolved. Das ist das Containment-Problem in einem Bild. Der E-Mail-Agent ist noch lockerer, denn sein Deflection-Trend kann „a ticket being closed by a human agent after the customer read an answer without further interaction" enthalten.
Freddys KI-CSAT ist Daumen-Feedback, keine Umfrage, und eine Kennzahl für Folgekontakt beim KI-Agenten habe ich nicht gefunden. Abgerechnet wird pro Session („all interactions... within a 24-hour window", 72 Stunden bei E-Mail, laut Session-FAQ). Ihre Kosten pro Lösung sind also die gesamten Session-Ausgaben geteilt durch gelöste Konversationen, nicht $0.49. Mehr zum Produkt in meiner Aufschlüsselung zu Freddy AI Agents und im Leitfaden Freddy-AI-Preise.
Freshworks' Benchmark 2026, basierend auf 33.889 Konten und 1,2 Milliarden Tickets laut Benchmark-Bericht, berichtet: „AI agents are delivering an average deflection rate of 83%." Das ist eine echte Zahl aus einem großen Datensatz, aber die öffentlichen Seiten definieren Deflection nicht und veröffentlichen daneben weder Folgekontakt noch KI-CSAT. Behandeln Sie sie als Deflection-Benchmark, nicht als Lösungs-Benchmark.
Gorgias: Die Dashboard-Zahl ist die Rechnungszahl
Gorgias zählt eine automatisierte Interaktion, wenn „the customer does not require the involvement of a human agent within 72 hours." Das Kennzahlen-Glossar ist eines der klarsten, die ich gelesen habe:
- Automation Rate = automatisierte Interaktionen geteilt durch die gesamte abrechenbare Arbeitslast (automatisierte plus von Menschen bearbeitete Tickets), Spam ausgenommen.
- Coverage Rate = der Anteil der Tickets, die AI Agent „resolved, handled, or handed over" hat.
- Success Rate = abrechenbare KI-Interaktionen geteilt durch alle Tickets, die AI Agent bearbeitet hat, Übergaben eingeschlossen.
- KI-CSAT = der Umfragedurchschnitt von 1 bis 5 für jedes Ticket, bei dem AI Agent mindestens eine Antwort gesendet hat, auch übergebene. Das ist ein fairerer Blick als eine Umfrage nur nach sauberen Erfolgen.
Zwei Dinge sollten Sie im Blick behalten. Nach aktueller Preisgestaltung kann ein Ticket, das die KI vollständig löst, sowohl eine Ticketgebühr als auch eine Automatisierungsgebühr kosten. Und die Karte „Cost saved" setzt $3.10 menschliche Kosten pro Ticket zusätzlich zu Ihrer Ticketgebühr an, was zu Ihrem Team passen kann oder nicht. Wenn Sie Gorgias nutzen, gehen mein Leitfaden zu Gorgias Analytics und die Aufschlüsselung der Gorgias-AI-Agent-Preise tiefer.
HubSpot: der eine Anbieter, der es offen sagt
HubSpots Customer Agent zählt eine Lösung, wenn er eine Inhaltsquelle geteilt oder eine Aktion ausgeführt hat „and there is no qualifying handoff", wobei der Status 72 Stunden nach der letzten Besucherantwort gesetzt wird. Nur Übergaben, die der Besucher auslöst, zählen. Wenn ein Mitarbeiter das Ticket umweist oder ein Workflow es tut, zählt es trotzdem als gelöst.
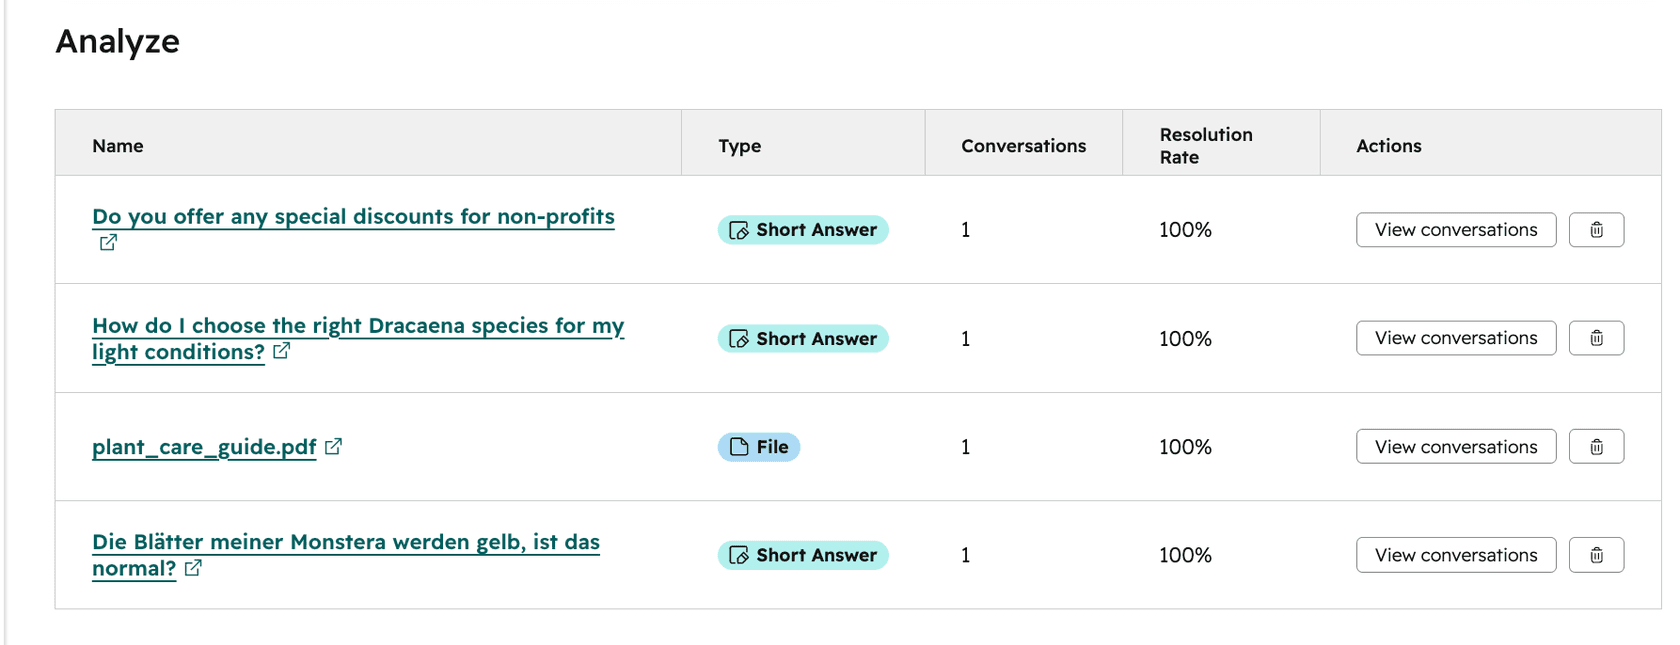
Der Screenshot oben erinnert daran, dass 100 % bei einer Konversation keine Erkenntnis sind. Erst das Volumen, dann die Rate.
Den Satz, den ich über jedes KI-Dashboard heften würde, stammt aus HubSpots eigener Performance-Dokumentation: „Deflections do not always indicate resolution. For example, if the customer agent was unable to answer a question, the customer may have left the chat without requesting a human agent." HubSpot rechnet außerdem pro Lösung in HubSpot Credits ab, und wenn ein Kunde nach 72 Stunden auf einen E-Mail-Thread antwortet, wird die Konversation wieder geöffnet und „additional credits are consumed", wenn sie erneut gelöst wird. Der Beitrag zum Breeze Customer Agent behandelt die Einrichtung.
Salesforce: Deflection und Lösung getrennt gehalten
Agentforces Agent Analytics definiert eine deflektierte Session als eine „ended by user (not by escalation or abandonment)" und führt separat eine modellbewertete Task Resolution Rate. Diese Trennung ist der richtige Instinkt. Die Abrechnung ist strenger als Deflection: Eine abrechenbare Lösung braucht mindestens zwei Turns, finales Feedback, das „not explicitly negative" ist, und keine Eskalation, wobei eine Chat-Lösung auf 2 Stunden begrenzt ist. Die vollständige Preisliste finden Sie unter Agentforce-Preise.
Salesforces Umfrage unter 3.075 Service-Fachleuten ergab, dass die Nutzung von KI-Agenten von 2025 auf 2026 von 39 % auf 66 % stieg, wobei Kundenzufriedenheit als „#1 improved KPI" genannt wurde. Das sind selbstberichtete Angaben von Service-Teams, kein gemessenes Kunden-CSAT, und genau deshalb zählt Ihre eigene Messung.
Die CX-KI-Kennzahlen, die zeigen, dass es funktioniert
Was also verfolgen? Hier ist das Set, das ich nutzen würde, mit Formel, denn eine Kennzahl ohne Formel ist nur ein Bauchgefühl. Die ausführliche Argumentation zu jeder steht in Beiträgen zu KI-CSAT, Containment und Eskalationsqualität und KI-Erstlösungsquote.
Verifizierte Lösungsrate (der Nordstern)
Formel: von der KI geschlossene Konversationen, minus jene, die innerhalb von 7 Tagen zum selben Problem zurückkamen, minus jene, die trotzdem einen Menschen erreichten, minus Spam und „Danke!"-Schließungen, geteilt durch alle Konversationen, die die KI berührt hat.
Nehmen Sie die strengste Stufe Ihres Anbieters als Ausgangspunkt (Zendesks Verified-Stufe, Salesforces Task Resolution) und ziehen Sie dann Folgekontakte selbst ab. Berichten Sie sie neben der Anbieterzahl, nie statt ihr, damit niemand denkt, Sie verbergen die schmeichelhaftere.
Folgekontakt innerhalb von 7 Tagen
Formel: von der KI gelöste Konversationen, bei denen derselbe Kunde innerhalb von 7 Tagen eine neue Konversation zum selben Thema eröffnet, geteilt durch von der KI gelöste Konversationen.
Das ist die Leitplanke, die kein Anbieter mitliefert. Gleichen Sie über Kunden-E-Mail oder ID plus Themen-Tag ab. Wenn sie steigt, während Ihre Lösungsrate steigt, schließt die KI Dinge, die sie nicht behoben hat.
"Don't track deflection without tracking subsequent contact. A bot might "successfully" complete a chat, but if the user submits an email ticket 20 mins later – that bot was trash. You have to analyze repeat contact rates to get true transparency."
Beachten Sie den Kanalwechsel in diesem Beispiel. Eine Prüfung auf Folgekontakt, die nur dasselbe Ticket betrachtet, übersieht den Kunden, der im Chat aufgibt und stattdessen eine E-Mail schreibt. Gleichen Sie also nach Kunde ab, nicht nach Ticket.
Übergabequalität
Formel: eskalierte Konversationen, bei denen der Mensch keine Informationen erneut erfragen musste, die der Kunde bereits gegeben hatte, geteilt durch alle Eskalationen. Verfolgen Sie auch die Antwortzeit des Menschen nach der Übergabe (Gorgias meldet sie nativ).
Eine niedrige Eskalationsrate ist nicht das Ziel. Eine saubere Eskalation ist es. Kunden verzeihen „ich hole jemanden" weit eher, als dass sie sich wiederholen müssen. Meine Notizen zur KI-Agent-Übergabe behandeln, was eine gute Zusammenfassungsnotiz enthält.
Manuell geprüfte Genauigkeit
Formel: aus einer Zufallsstichprobe von von der KI gelösten Konversationen (ich nehme 50 pro Woche) der Anteil, den eine Person als vollständig korrekt und ohne Richtlinienfehler markiert.
LLM-Verifizierung und Daumen-hoch-Buttons sind nützlich, aber eine Person, die eine Zufallsstichprobe liest, ist die einzige Prüfung, die eine selbstsichere falsche Antwort findet, der der Kunde geglaubt hat. Teilen Sie Fehler nach Schweregrad auf und legen Sie bei Erstattungen, Preisen und Kontoänderungen einen strengeren Maßstab an. Eine Support-QA-Kalibrierung hält die Prüfer konsistent, und KI-Support-Qualitätssicherung behandelt Tools.
"The AI will never be able to answer 100% of the questions, but if it tries and just answers 'sorry I don't know this,' I cannot go and check all my 7,000 tickets to see if the AI actually made a good answer..."
A CX lead handling about 7,000 tickets a month, on an eesel sales call
Das ist das Argument für Stichproben. Niemand liest 7.000 Tickets, aber jeder kann 50 lesen, und 50 zufällige fangen die Muster ein. Ein Entwickler auf Hacker News hat dasselbe auf die langsame Tour gelernt:
"our dashboard only tracked immediate task completion, and had no idea a cheaper model had quietly produced a worse answer that the customer reopened a week later."
KI-CSAT, mit Vorsicht gelesen
Drei verschiedene Dinge werden als KI-CSAT verkauft, und sie sind nicht austauschbar:
| Typ | Wer bewertet | Wo Sie es sehen | Worauf Sie achten sollten |
|---|---|---|---|
| Umfragewert | Der Kunde, 1 bis 5 | Zendesk BSAT, Gorgias Average CSAT | Wer befragt wird (Zendesk überspringt eskalierte Chats) und die Rücklaufquote |
| Daumen-Feedback | Der Kunde, ja oder nein | Freddy, HubSpot-Anteil „helpful", Salesforce-Feedback-Zahlen | Winzige Stichproben, verärgerte Kunden antworten nicht |
| Modellbewertete Qualität | Eine KI, die die KI bewertet | Salesforce Quality Score, eesels KI-CSAT | Gar kein Kundenfeedback |
Berichten Sie immer die Umfrage-Rücklaufquote neben dem Wert. Ein Wert von 90 % aus 4 % der Konversationen sagt sehr wenig.
Wissenslückenrate
Formel: Konversationen, in denen der KI das Wissen zur Antwort fehlte, geteilt durch alle von ihr berührten Konversationen, aufgeschlüsselt nach Thema.
Das ist die nützlichste Kennzahl, um den Agenten tatsächlich zu verbessern, weil sie auf den Artikel zeigt, den Sie schreiben müssen. Eine wachsende Lücke bei einem Thema ist eine To-do-Liste. Wie Sie das durchführen, steht in Support-Wissenslückenanalyse.
Kosten pro verifizierter Lösung
Formel: gesamte KI-Kosten des Monats (Lizenz plus Nutzung) geteilt durch verifizierte Lösungen, nicht durch gemeldete.
Preisgestaltung pro Lösung lässt die gemeldete Zahl wie Ihre Kosten pro Ergebnis aussehen, aber das stimmt nicht mehr, sobald Sie Folgekontakte und Scheinerfolge abziehen. Kosten pro Lösung vergleicht das mit der menschlichen Bearbeitung.
Berechnen Sie Ihre echte Lösungsrate
Tragen Sie die Zahlen des letzten Monats aus Ihrem Helpdesk in den Rechner unten ein. Er entfernt die „Lösungen", die keine waren, und bewertet den Rest neu.
Tragen Sie Ihren eigenen Monat ein: berührte Konversationen, gemeldete Lösungen und die drei Arten, die nicht halten. Verifizierte Rate und Kosten aktualisieren sich beim Tippen.
Mit den Standardwerten wird aus einer Dashboard-Rate von 50 % etwa 34 % verifiziert, und jedes echte Ergebnis kostet etwa das 1,5-Fache dessen, was das Dashboard nahelegt. Dieses Verhältnis würde ich in ein Verlängerungsgespräch mitbringen. Für den breiteren Business Case führt mein Leitfaden zur Messung des ROI von KI-Support durch den Rest.
Ein Scorecard mit Leitplanken
Eine einzelne Zahl wird manipuliert, auch ohne dass es jemand will. Trimmen Sie den Agenten darauf, mehr zu schließen, und er schließt mehr, auch Dinge, die er nicht schließen sollte. Kombinieren Sie den Nordstern daher mit Leitplanken, die in die falsche Richtung ausschlagen, wenn das passiert.
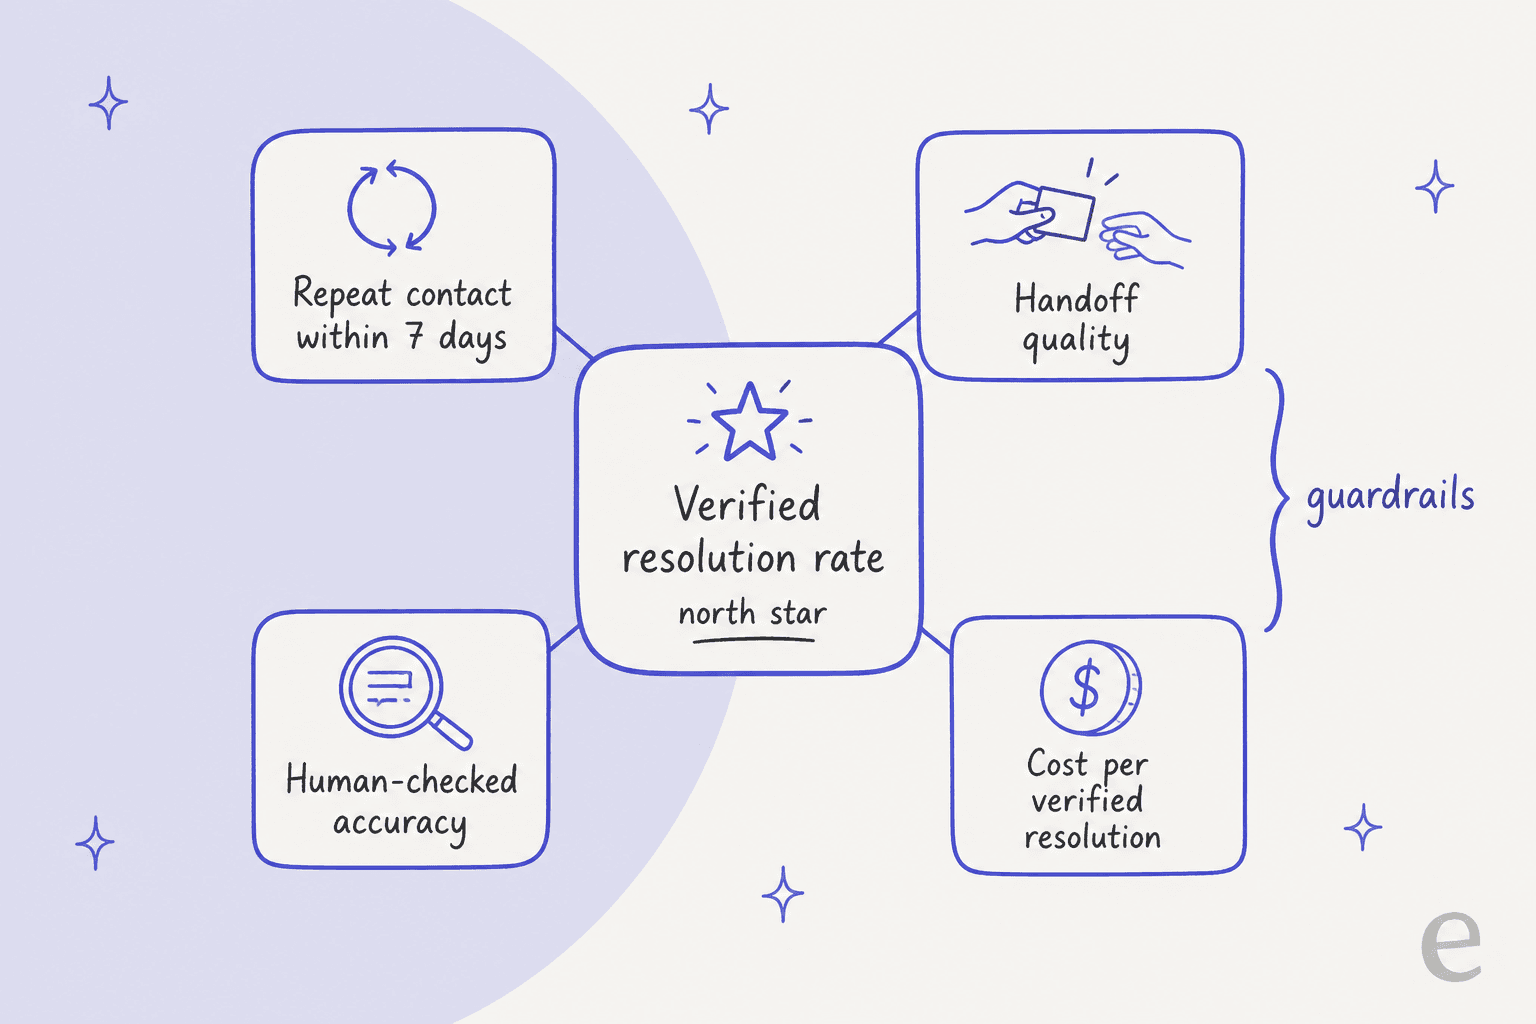
Hier ist das Scorecard, von dem ich ausgehen würde. Die Zielwerte sind meine Startpunkte, keine Branchen-Benchmarks. Legen Sie Ihre eigenen nach dem ersten Monat Daten fest.
| Kennzahl | Formel | Start-Leitplanke | Prüfen |
|---|---|---|---|
| Verifizierte Lösungsrate | Geschlossen, nicht wiederholt, nicht eskaliert, kein Spam / alle berührten | Monat für Monat steigend | Wöchentlich |
| Anbieter-Lösungsrate | Die eigene Definition Ihres Helpdesks | Neben verifizierter berichten, nie allein | Wöchentlich |
| Folgekontakt innerhalb von 7 Tagen | Gleicher Kunde, gleiches Thema, neue Konversation / von KI gelöst | Darf nicht steigen, wenn die Lösungsrate steigt | Wöchentlich |
| Übergabequalität | Eskalationen ohne Nachfragen / alle Eskalationen | Über 90 % | Monatliche Stichprobe |
| Manuell geprüfte Genauigkeit | Vollständig korrekt / Zufallsstichprobe von 50 KI-Lösungen | Null Fehler bei Erstattungen, Preisen, Kontoänderungen | Wöchentlich |
| KI-CSAT (Umfrage) | Bewertungen 4 bis 5 / alle Bewertungen, mit Rücklaufquote | Wenige Punkte Abstand zum menschlichen CSAT bei denselben Themen | Monatlich |
| Wissenslückenrate | Konversationen ohne Wissen / alle berührten, pro Thema | Sinkend bei Ihren Top-5-Themen | Wöchentlich |
| Kosten pro verifizierter Lösung | Gesamte KI-Kosten / verifizierte Lösungen | Unter Ihren menschlichen Kosten pro Ticket | Monatlich |
Schlüsseln Sie jede Zeile nach Thema und Kanal auf. Ein Durchschnitt über Themen verbirgt den einen Weg, der jedes Mal scheitert, und ein Erstattungsthema mit 40 % verifiziert neben einem Sendungsverfolgungsthema mit 90 % zeigt genau, wo Sie arbeiten müssen. Der Beitrag zur Analytics-Dashboard-Vorlage hat ein Layout, das Sie kopieren können.
"This is a management / measurement issue, not a tooling issue. Specifically, it's an offshoot of Goodhardt's Law: a metric that becomes a target ceases to become a good metric (because the business will solve for the target to its detriment). The solution is to pair Deflection Rate with a strong guardrail metric"
Wie das in einer echten Warteschlange aussieht
Kundengeschichten machen die Lücke zwischen „geantwortet" und „gelöst" greifbar, weil eesel beides getrennt meldet.
Question Beauty betreibt eesel auf Gorgias und Shopify. Zwischen dem 8. August und dem 8. September 2026 bearbeitete der Agent etwa 990 Tickets und sendete etwa 960 Antworten, doch nur etwa 280 Tickets wurden von eesel geschlossen und etwa 250 einer Person zugewiesen. Zählt man Antworten, sieht es nach 97 % Automatisierung aus. Zählt man Schließungen, sind es eher 28 %. Beides stimmt, und nur eines ist ein Ergebnis.
Swiftreg, das private Nummernschilder in Großbritannien verkauft, zeigt die Genauigkeitsseite. Im selben Monat bearbeitete eesel etwa 2.100 Zendesk-Tickets, sendete 1.494 öffentliche Antworten und hinterließ 1.055 interne Notizen, wo ein Schritt Sache der Mitarbeiter war. Bestellabfragen laufen über Skripte, die Swiftreg geschrieben hat, und ein Validator prüft jede Antwort gegen diese Ergebnisse, bevor etwas gesendet wird. Das ist manuell geprüfte Genauigkeit, die in den Workflow eingebaut ist, statt nachträglich angeflanscht zu werden.
ClutchLoop ist die Variante mit engem Umfang: Der Agent antwortet nur bei Retouren und Produktfragen selbstständig und sendete etwa 180 Antworten direkt zu etwa 230 Gorgias-Tickets, „about seven in ten conversations, no person needed." Der Umfang ist ebenfalls eine Kennzahlen-Entscheidung. Eine kleinere Menge an Themen, die die KI von Anfang bis Ende besitzt, lässt sich leichter verifizieren als eine große, die sie halb bearbeitet.
Wie eesel die KI-Leistung berichtet
Ich sage offen, wie eesel das macht, denn es ist das Produkt, an dem ich arbeite. Die Reports-Seite zeigt Volumen, KI-CSAT, Wissenslücken und Freigaben, und die Dokumentation sagt klar: „AI CSAT is not customer feedback. It is an AI's rating of your agent's answers." Das gefällt mir, weil es verhindert, dass ein Modellwert als Kundenwert durchgeht.
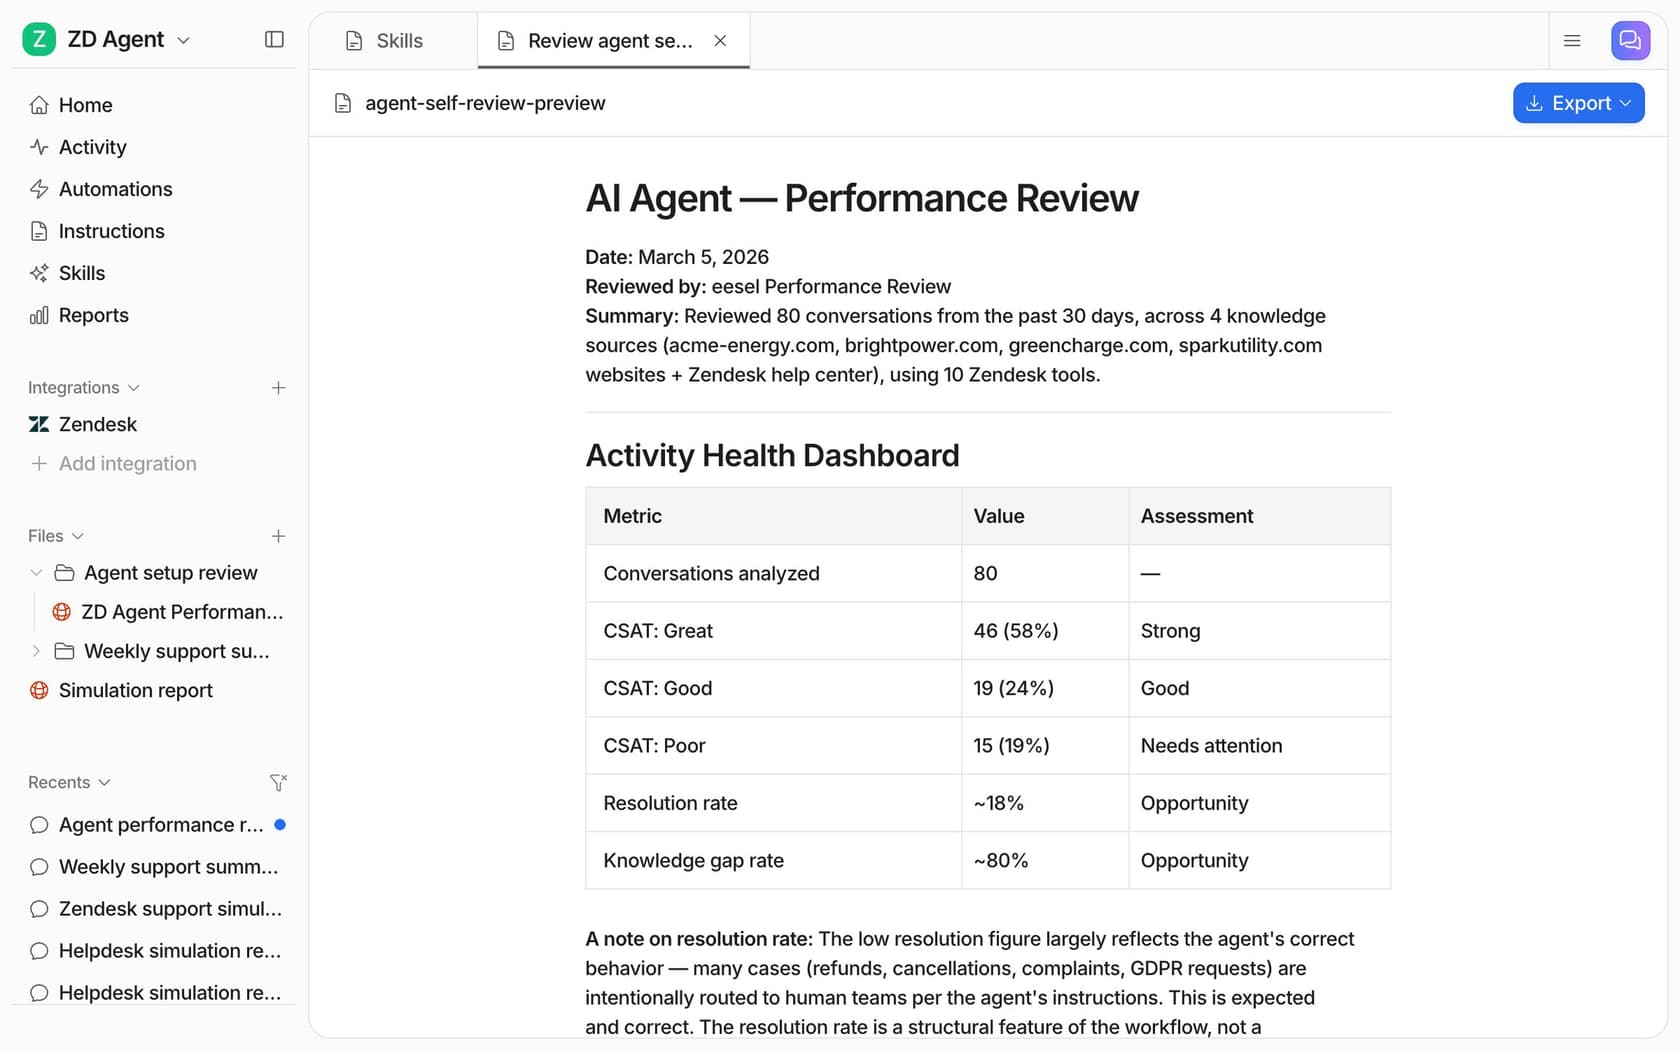
Sie können den Agenten auch im Chat um eine Leistungsauswertung bitten, und er schreibt eine mit den Zahlen zuerst und danach den nach Priorität geordneten Verbesserungen. Im Demo-Bericht oben liegt die Lösungsrate bei etwa 18 %, und der Bericht erklärt, dass Erstattungen, Kündigungen und Beschwerden absichtlich an Menschen geleitet wurden. Eine niedrige Rate mit den richtigen Übergaben schlägt eine hohe, die rät.
Zwei weitere Bausteine passen direkt auf das Scorecard:
- Simulation vor dem Livegang. Der Simulation Skill „runs your agent against real past tickets or generated test cases, scores each answer, and suggests instruction changes." Das ist manuell geprüfte Genauigkeit, auf Ihrer eigenen Historie, bevor ein Kunde etwas sieht.
- Freigaben als Graduierungskennzahl. Laut Reports-Dokumentation ist „an action approved every time without edits ready to run on its own." Starten Sie im Entwurfsmodus, beobachten Sie die Freigaberaten nach Thema und schalten Sie nur die Themen frei, die es sich verdienen.
Zu den Kosten: eesel-Preise sind ein fester Monatsplan, bei dem „a ticket or a chat is 1 credit" gilt, ab 299 $ im Monat für 500 Credits. Es berechnet bearbeitete Tickets, nicht Lösungen, daher hängt die Rechnung nicht davon ab, was als gelöst bezeichnet wird. Der Kompromiss ist klar: Sie zahlen auch dann für ein Ticket, wenn der Agent es an einen Menschen übergibt, daher bleiben die Kosten pro verifizierter Lösung die Zahl, die Sie im Auge behalten sollten.
eesel ausprobieren
Wenn Ihr KI-Dashboard Deflection meldet und Sie verifizierte Lösungen brauchen: eesel arbeitet in dem Helpdesk, den Sie bereits haben, auf Zendesk, Freshdesk, Gorgias oder HubSpot. Es spielt Ihre vergangenen Tickets vor dem Livegang in einer Simulation durch, beginnt mit Entwürfen für Ihr Team und meldet getrennt, was es gesendet, was es geschlossen und was es übergeben hat.

Der kostenlose Plan enthält 100 Credits, genug, um echte Entwürfe zu Ihren eigenen Tickets zu sehen, bevor Sie zahlen. eesel testen und die Zahlen an Ihrer eigenen Warteschlange prüfen.