

Es gibt keine einzelne Genauigkeitszahl für einen KI-Chatbot im Finanzwesen; eine Kennzahl mittelt sehr unterschiedliche Fragen. Zu erklären, was der effektive Jahreszins bedeutet, ist einfach. Bei Antworten, die von der aktuellen Gebührentabelle, einem Live-Zinssatz, der Kontostufe des Kunden oder einer Ausnahme abhängen, liegen Bots selbstbewusst falsch, meist wegen einer veralteten oder falschen Quelle, nicht wegen eines schwachen Modells. Genauigkeit entscheidet sich also über das Routing: geprüfte Dokumente für Konzepte, Live-Systeme für Kontofakten, ein Mensch für Erlasse und Streitfälle, und ein Durchlauf Ihrer bisherigen Tickets vor dem Start. Das Helpdesk-Teammitglied von eesel arbeitet genau so, zuerst an Ihren eigenen Tickets getestet.
Wie genau sind KI-Chatbots im Finanzwesen?
Die ehrliche Antwort lautet „es kommt auf die Frage an", und das ist keine Ausflucht. Ich baue die KI-Agenten bei eesel, und das Nützlichste, was ich beim Beobachten ihrer Antworten auf echte Tickets gelernt habe, ist: Genauigkeit ist keine einzelne Zahl, sondern vier, eine für jede Art von Frage, die ein Kunde stellt.
Banken setzen seit Jahren Chatbots ein. Der Bericht der CFPB zu Chatbots im Verbraucher-Finanzwesen stellte fest, dass alle zehn größten US-Geschäftsbanken sie nutzen und dass über 98 Millionen Menschen, etwa 37% der US-Bevölkerung, 2022 den Chatbot einer Bank genutzt haben. Die zentrale Erkenntnis ist hier die entscheidende: Chatbots seien „may be useful for resolving basic inquiries, but their effectiveness wanes as problems become more complex".
Das deckt sich mit meiner Beobachtung. So teilen sich die Fragen auf:
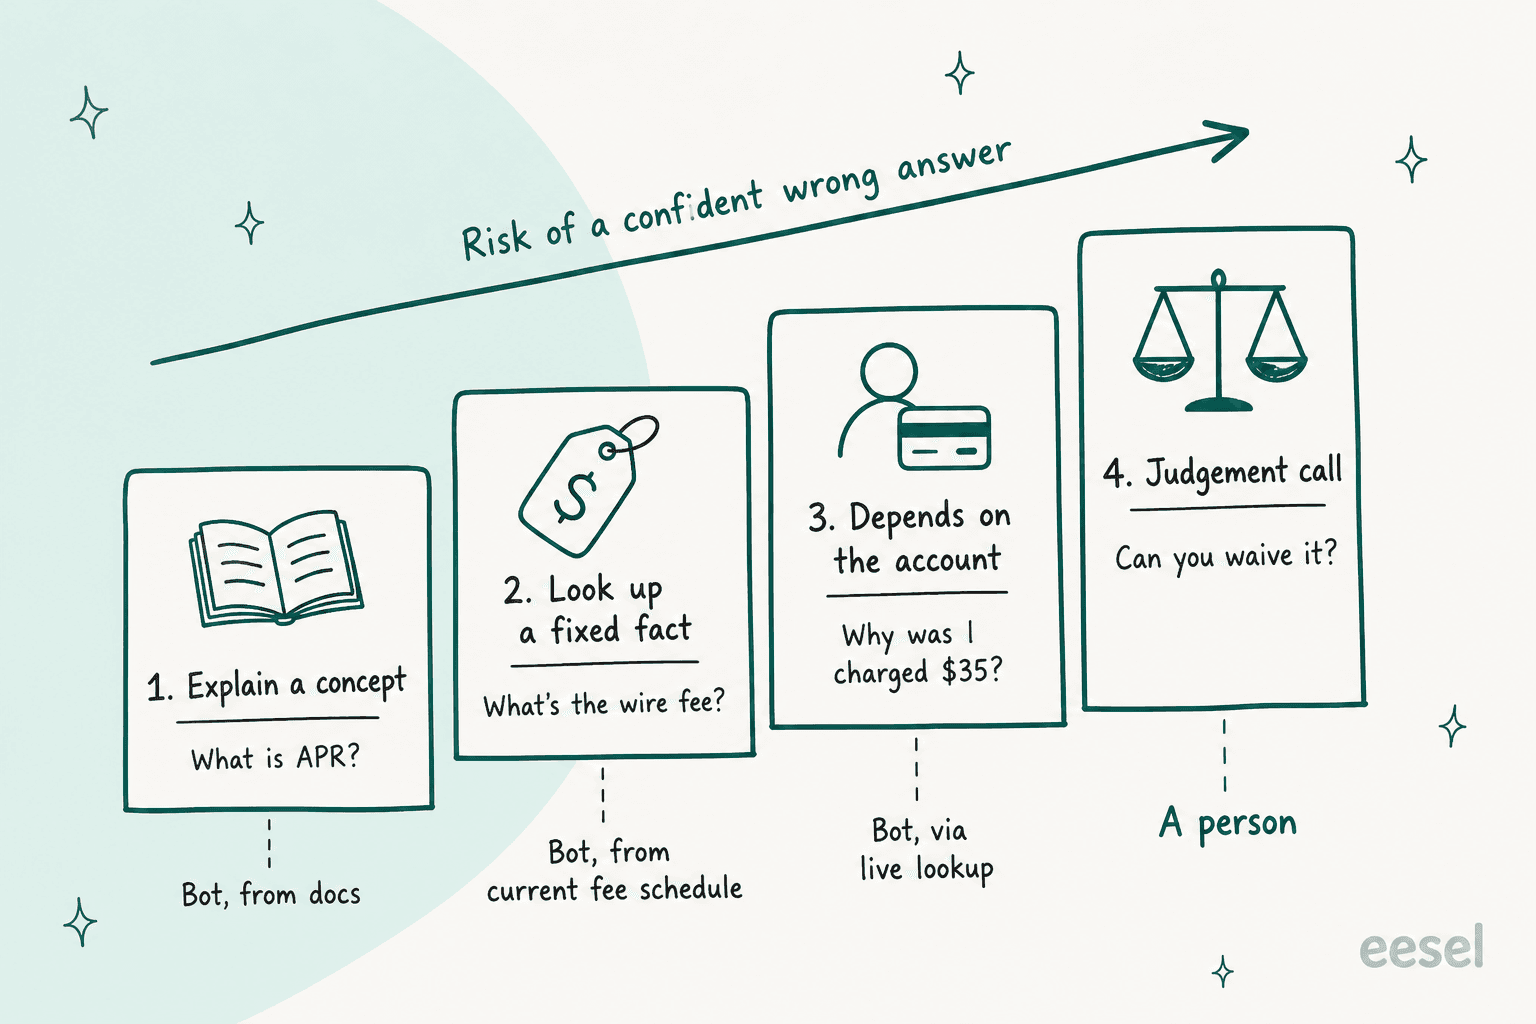
| Fragetyp | Beispiel | Risiko einer falschen Antwort | Richtige Quelle | Was der Bot tun sollte |
|---|---|---|---|---|
| Konzept erklären | „Was ist der effektive Jahreszins?" | Niedrig | Geprüfte Hilfeartikel | Antworten und den Artikel verlinken |
| Feste Tatsache nachschlagen | „Was kostet die internationale Überweisung?" | Mittel: veraltete oder doppelte Dokumente | Die aktuelle Gebührentabelle, ein Verantwortlicher, mit Datum | Nur aus der aktuellen Version antworten |
| Hängt vom Konto ab | „Warum wurden mir gestern 35 $ abgebucht?" | Hoch: die Gebührenseite kann es nicht wissen | Live-Transaktions- oder Kontoabfrage | Nachschlagen, den Datensatz zitieren oder weiterleiten |
| Ermessensentscheidung | „Können Sie das erlassen?" | Am höchsten: es ist eine Entscheidung, keine Tatsache | Ein Mensch mit Befugnis | Details sammeln und weiterleiten |
Ein Bot kann in der ersten Zeile fast perfekt abschneiden und in der dritten trotzdem gefährlich sein. Wenn ein Anbieter Ihnen einen einzigen gemischten Prozentsatz gibt, fragen Sie, welcher Anteil des Testsatzes „was ist der effektive Jahreszins"-Fragen waren.
eesel setzt seit Jahren KI-Agenten in echten Support-Queues ein, und das Muster gilt auch außerhalb des Finanzwesens. Bei einem Test mit echtem Traffic in einem E-Commerce-Postfach ging das eesel-Team jeden Entwurf durch, den die Support-Mitarbeitenden umgeschrieben hatten. Die meisten Überarbeitungen betrafen Länge und Ton. Etwa 20% brauchten Daten, die der Bot nicht sehen konnte, etwa Bestell- und Logistikdaten, und nur etwa 5% waren Fälle, in denen der Bot von sich aus faktisch falsch lag. Mit anderen Worten: die meisten „Genauigkeits"-Probleme waren fehlende Daten. Im Finanzwesen sind die fehlenden Daten die Gebührentabelle, das Konto und der Transaktionsverlauf.
Wenn Ihr Team Coding-Agenten nutzt, lässt die eesel CLI einen davon die Einrichtung übernehmen: Ihre geprüften Gebührentabellen und Richtliniendokumente hochladen, dem Agenten dann Testfragen zu jeder Gebühr stellen und die Antworten prüfen, bevor irgendetwas live geht. Das Verbinden Ihres Helpdesks braucht weiterhin jemanden mit Admin-Zugriff, der es freigibt.
Warum liegen Finanz-Chatbots bei Gebühren und Zinssätzen falsch?
Weil ein Sprachmodell flüssig beantwortet, was ihm vorliegt, egal ob die Quelle richtig war. Das Generative-AI-Profil des NIST nennt das Konfabulation: „confidently stated but erroneous or false content", besser bekannt als Halluzinationen. Bei einem Support-Bot sehe ich das aus fünf Quellen kommen.
- Ein veraltetes Dokument gewinnt die Suche. In einer typischen Retrieval-Pipeline steht die Gebührentabelle vom letzten Jahr noch im Hilfecenter und passt besser zu den Worten des Kunden als die neue. Der Bot zitiert sie mit voller Überzeugung.
- Zwei Stufen werden vermischt. Das Premium-Konto erlässt Geldautomatengebühren, das Basis-Konto nicht. Beide Seiten erwähnen Geldautomatengebühren, und der Bot verschmilzt sie zu einer Antwort, die für niemanden stimmt.
- Der Bot rechnet selbst. Ablösebeträge, anteilige Zinsen und Währungsumrechnungen sind Rechenaufgaben, und Sprachmodelle sind keine Taschenrechner.
- Die Frage braucht Kontodaten, die der Bot nicht hat. „Warum wurde ich belastet" lässt sich nicht von einer Gebührenseite beantworten. Ein Bot ohne Transaktionsabfrage rät die wahrscheinlichste Gebühr statt der tatsächlichen.
- Die Suche liefert nichts, und der Bot füllt die Lücke. eesel hat das bei echten Einführungen gesehen: Wenn die Wissensdatenbank nichts Passendes hatte, antwortete ein früher Agent aus allgemeinem Wissen, statt das zu sagen. Deshalb ist ein hartes „Das weiß ich nicht" als Rückfallebene heute Teil der Agenteneinrichtung.
Der Rechenpunkt wird unterschätzt. Hier der Versuch eines Hacker-News-Nutzers, eine Zahlungszahl aus ChatGPT herauszubekommen:
"I asked it to calculate my total mortgage payments over 10 years for $100,000 at 2% interest. The result ($102,945.60) looked a bit suspicious to me. But it gets really interesting with 4.5% interest."

Bei 4,5% produzierte das Modell anschließend eine negative Monatsrate und erklärte dann, warum das Sinn ergab. Niemand sollte einem Kunden einen Ablösebetrag aus der eigenen Rechnung eines Sprachmodells nennen. Die Zahl muss aus dem Kreditsystem kommen, und die Aufgabe des Bots ist, sie zu wiederholen.
Das größere Risiko ist, dass Kunden diesen Antworten glauben, egal ob sie vom Bot einer Bank oder von ChatGPT im Finanzwesen kommen. Ein anderer Kommentator in einem Privatfinanzforum drückte es so aus:
"Our robot overlords are terrible at anything financial. I'm on a financial forum where, lately, people are constantly posting stuff that they got from The Oracle and asking what they're doing wrong because they don't understand the result, and the answer is inevitably that ChatGPT or whatever fed them plausible-looking rubbish"
„Plausibel aussehend" ist das Problem in einem Wort. Eine falsche Gebühr in einer selbstbewussten, gut formatierten Antwort liest sich genau wie eine richtige. Der Leitfaden zur Vermeidung von Halluzinationen und der Beitrag zum Erden eines Agenten gehen tiefer auf die allgemeine Mechanik ein. Im Finanzwesen führen alle fünf Ursachen oben zu einer Frage: Woher kam diese Antwort?
Wer haftet, wenn ein Chatbot eine falsche Antwort gibt?
Das Unternehmen, das ihn eingesetzt hat. Der Fall, den alle zitieren, ist keine Bank, aber es ist das klarste Urteil, das es gibt.
In Moffatt v. Air Canada (2024 BCCRT 149, Entscheidung vom 14. Februar 2024) befasste sich das Civil Resolution Tribunal von British Columbia mit einem Chatbot, der einem trauernden Kunden sagte, er könne rückwirkend innerhalb von 90 Tagen nach dem Ticketkauf einen Trauertarif beantragen. Die eigene Trauertarif-Seite der Fluggesellschaft, auf die der Chatbot verlinkte, sagte das Gegenteil. Air Canada argumentierte, sie könne nicht für das haftbar gemacht werden, was ihr Chatbot sagte. Das Tribunal nannte das „a remarkable submission", stellte fest, dass die Fluggesellschaft keine angemessene Sorgfalt walten ließ, um die Genauigkeit des Chatbots sicherzustellen, und verurteilte sie zur Zahlung von 812,02 $, davon 650,88 $ Schadensersatz. Der Satz, den sich Finanzteams merken sollten: „It makes no difference whether the information comes from a static page or a chatbot."
Beachten Sie den Mechanismus. Dem Bot fehlte nicht die richtige Richtlinie. Er hatte die korrekte Seite direkt vor sich und produzierte trotzdem eine widersprüchliche Antwort. Das ist Fehler Nummer zwei aus der Liste oben, zwei widersprüchliche Quellen, und es ist die häufigste Art, wie eine Gebührenantwort schiefgeht.
Finanzaufsichtsbehörden sagen dasselbe in ihren eigenen Worten:
- CFPB (USA). Chatbots „must comply with all applicable federal consumer financial laws, and entities may be liable for violating those laws when they fail to do so." Der Bericht markiert auch Bots, die Streitfälle nicht erkennen, Menschen in „doom loops" gefangen halten und falsche Informationen geben, und stellt fest, dass automatisierte Systeme „may be less likely to waive fees".
- FCA (Großbritannien). Ihre Seite AI good and poor practice, aktualisiert am 20. Oktober 2026, listet als Good Practice, dass Firmen „limited chatbots and generative AI assistants to approved source material, with checks and escalation routes". Als Poor Practice listet sie Firmen, die „overstated the accuracy, reliability or role of AI systems".
- EU. Nach den Transparenzregeln des AI Act, die seit August 2026 gelten, sollen Nutzer eines Chatbots wissen, dass sie mit einer Maschine sprechen.
Nichts davon verbietet Chatbots. Es bedeutet, dass Sie für jede Antwort geradestehen, also müssen Sie wissen, welche Antworten Ihr Bot geben darf. Der Leitfaden zum EU AI Act, der Beitrag zu regulierter Unterstützung und die Checkliste zu SOC 2 und DSGVO behandeln die Compliance-Seite ausführlicher.
Woher sollte jede Antwort kommen?
Das ist der Teil, in den ich die meiste Zeit investieren würde, denn hier entscheidet sich die Genauigkeit. Jede Frage, die Ihr Bot beantworten könnte, sollte vor dem Start auf genau eine verlässliche Quelle abgebildet sein.
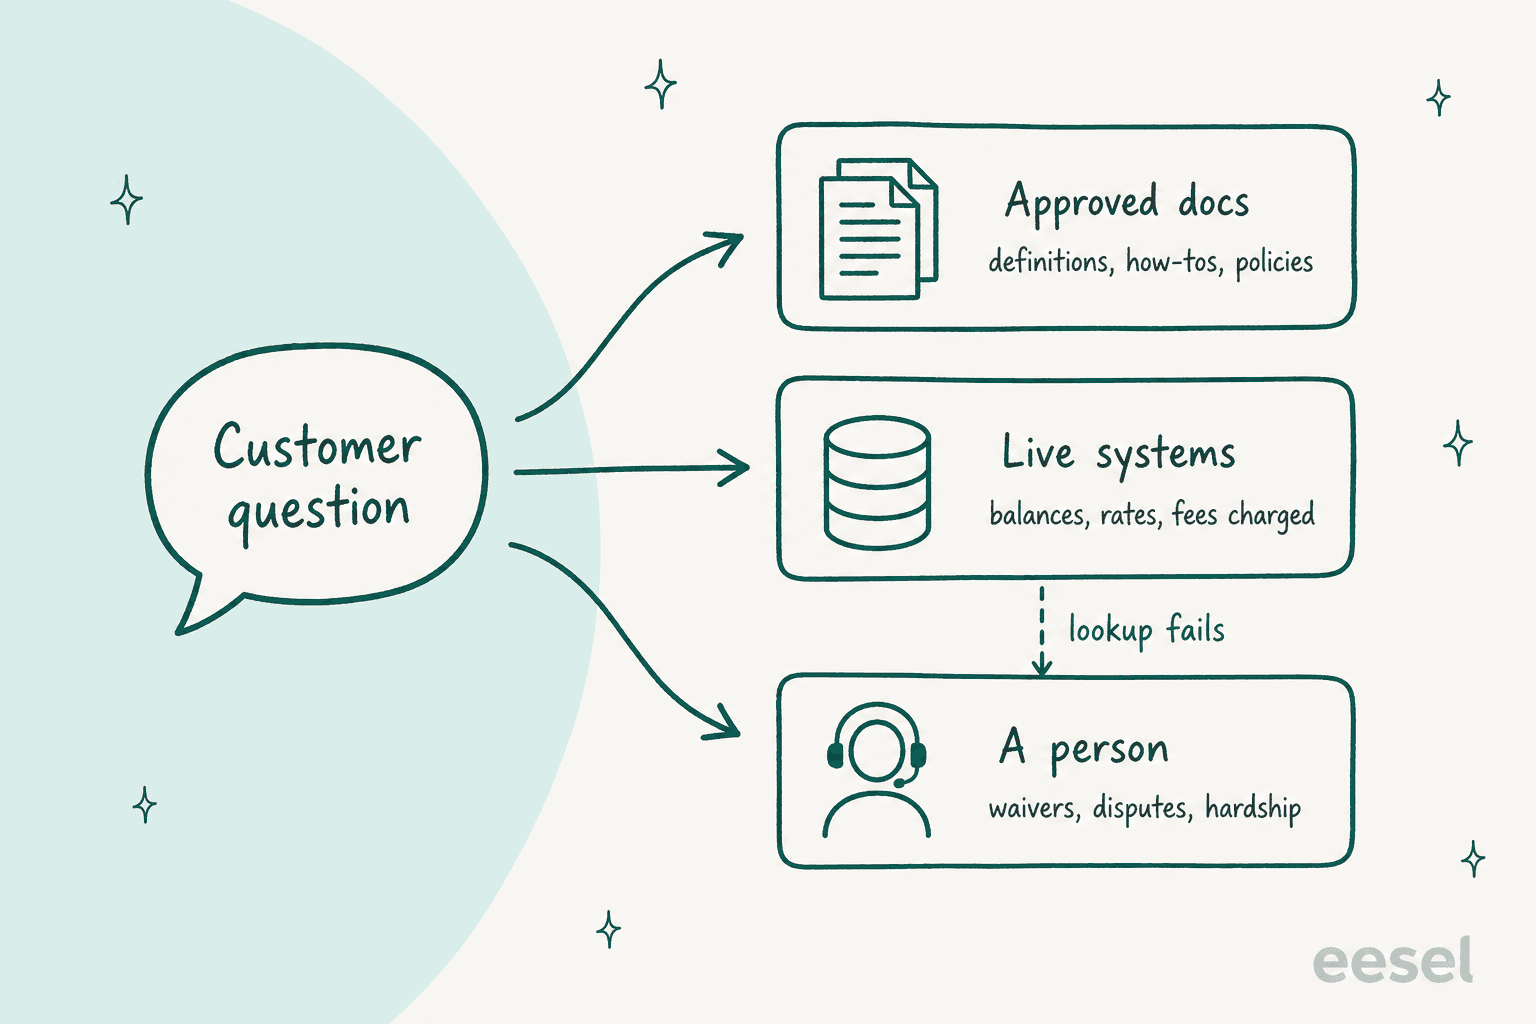
Geprüfte Dokumente tragen Konzepte, Anleitungen und veröffentlichte Richtlinien. Jedes Dokument braucht einen Verantwortlichen, eine Version und ein Gültigkeitsdatum, und die alte Version muss am Tag, an dem die neue startet, aus dem Wissen des Bots verschwinden. Wenn zwei Versionen einer Gebührenseite durchsuchbar sind, kann der Bot nicht wissen, welche aktuell ist. Ein regelmäßiges Wissensdatenbank-Audit und Werkzeuge zum Erkennen veralteter Inhalte bringen der Genauigkeit mehr als jedes Modell-Upgrade. Der Leitfaden zu einer KI-Wissensdatenbank für Fintech beschreibt, wie man sie strukturiert.
Live-Systeme tragen alles, was spezifisch für einen Kunden ist oder sich täglich ändert: Kontostände, die tatsächlich berechnete Gebühr, der aktuelle Zinssatz, ein Ablöseangebot, der Status einer Zahlung. Der Bot erreicht diese über Aktionen, also API-Abfragen, die er ausführen darf. Die Stripe-Integration von eesel zum Beispiel lässt den Agenten Rechnungen, Zahlungen und Abonnements lesen, um eine Abrechnungsfrage direkt aus dem Datensatz zu beantworten. Der Beitrag zu KI für Stripe-Abrechnungssupport zeigt, wie das aussieht. Schlägt die Abfrage fehl, sagt der Bot das und gibt ab. Er weicht nie auf die allgemeine Gebührenseite aus.
Ein Mensch trägt Entscheidungen: Erlasse, Erstattungen außerhalb der Richtlinie, Regelungen für finanzielle Notlagen, Streitfälle und Beschwerden. Mehr dazu im nächsten Abschnitt.
So läuft es bei smava, einer Berliner Plattform für Kreditvergleiche, die eesel auf Zendesk einsetzt. Rund 27.000 Tickets im Monat kommen über smava und Finanzcheck herein, fast alle auf Deutsch. smavas eigene Haltung ist unverblümt: Das ist reguliertes Finanzwesen, also zählt die Formulierung. eesel erstellt Entwürfe aus rund 820 Makros und Hilfecenter-Artikeln, getrennt nach Marke, und der Entwurfs-Agent übernimmt den passenden Makro-Text wortgleich. Kundenfertige Antworten gehen nur an Tickets, denen kein Kreditberater zugewiesen ist, etwa 1.100 der 27.000 im Monat. Die Anweisungen der Agenten verbieten das Versprechen, dass das Team etwas prüfen, weiterleiten oder arrangieren wird, und der Entwurfs-Agent darf nicht behaupten, gesucht zu haben, wenn er es nicht getan hat. Die Freiheit des Bots ist absichtlich eng, und diese Enge ist die Genauigkeitsstrategie.
Was sollte ein Finanz-Chatbot niemals selbst beantworten?
Alles, was eine Entscheidung statt einer Tatsache ist, und alles, wo der Bot nicht auf eine einzige aktuelle Quelle zeigen kann. Meine Standardliste für eine Finanz-Queue:
- Gebührenerlasse und Erstattungen außerhalb der schriftlichen Richtlinie. Der Bot kann die Richtlinie erklären. Er sollte nicht über die Ausnahme entscheiden.
- Streitfälle und nicht erkannte Transaktionen. Die CFPB markiert gezielt Bots, die einen Streitfall nicht erkennen oder nur die Angaben wiederholen, die der Kunde anfechtet. Einen Streitfall zu erkennen und den Fall ordentlich zu öffnen, ist die Aufgabe des Bots. Ihn zu lösen nicht.
- Finanzielle Notlagen, Inkasso und Schutzbedürftigkeit. Die Leitlinien der FCA warnen davor, anzunehmen, ein LLM könne Schutzbedürftigkeit ohne Tests verlässlich erkennen.
- Bonitäts- und Kreditentscheidungen. „Werde ich genehmigt?" ist nichts, das ein Support-Bot beantworten sollte.
- Jede Antwort, bei der sich zwei Quellen widersprechen. Findet der Bot zwei Gebührenangaben, sollte er weiterleiten, nicht eine auswählen.
- Berechnungen. Ablösebeträge, Zinsen und Umrechnungen kommen aus dem führenden System oder gar nicht.
Wählen Sie unten eine Frage, um zu sehen, wo sie einzuordnen ist und was der Bot damit tun sollte.
Kann mein Bot das selbst beantworten?
Quelle: ein geprüfter Hilfeartikel.
Bot tut: antwortet direkt und verlinkt den Artikel. Das ist die leichte Zeile, und hier kommt der Großteil der Headline-Genauigkeit eines Bots her.
Quelle: die aktuelle Gebührentabelle, mit Verantwortlichem und Gültigkeitsdatum.
Bot tut: antwortet nur aus der aktuellen Version. Findet er zwei unterschiedliche Angaben, gibt er ab, statt eine auszuwählen. Veraltete Gebührenseiten verursachen hier die meisten Fehler.
Quelle: eine Live-Transaktionsabfrage.
Bot tut: schlägt die tatsächliche Abbuchung nach und zitiert den Datensatz. Er rät nie anhand der Gebührenseite. Schlägt die Abfrage fehl, sagt er das und gibt ab.
Quelle: ein Mensch mit Entscheidungsbefugnis.
Bot tut: erklärt die schriftliche Richtlinie, sammelt Konto und Grund und gibt ab. Er verspricht nie einen Erlass.
Quelle: ein Ablöseangebot aus dem Kreditsystem.
Bot tut: fordert das Angebot an und gibt die Zahl wieder. Er rechnet die Zinsen nie selbst.
Quelle: Ihr Streitfallprozess und ein Mensch.
Bot tut: erkennt das als Streitfall, öffnet den Fall oder leitet ihn mit den Details weiter und sagt dem Kunden, was als Nächstes passiert. Einen Fall zu öffnen sollte zunächst eine Aktion mit Freigabepflicht sein.
Diese Grenzen aufzuschreiben ist der leichte Teil. Der Bot muss sie befolgen, und das bedeutet zwei Einstellungen: was er sagen darf und was er tun darf.
Was er sagen darf, steht in seinen Anweisungen. Bei eesel sind das Regeln in einfacher Sprache, und die wichtigste für das Finanzwesen ist die Ablehnungsregel: nur aus abgerufener Dokumentation antworten, und wenn nichts Passendes zurückkommt, sagen, dass man diese Information nicht hat.

Was er tun darf, steht in den Aktionsberechtigungen. Bei eesel ist jede Aktion auf An, Vorher fragen oder Aus gesetzt, pro Agent, laut den Dokumenten zu Aktionen und Freigaben. Für eine Finanz-Queue würde ich mit Abfragen auf An starten, allem, was Geld bewegt oder einen Fall öffnet, auf Vorher fragen, und Erstattungen auf Aus, bis Sie genug Durchläufe gesehen haben. Der Beitrag zu Erstattungs-Leitplanken erklärt, warum solche Grenzen in die Einstellungen gehören und nicht in den Prompt.
Auch die Übergabe selbst muss funktionieren. Enterprise-Support-Käufer, darunter einer aus der Medizinfinanzierung, haben eesels Vertriebsteam dasselbe gesagt: Sie akzeptieren keine KI, die auf alles antwortet, selbst mit „ich weiß es nicht", und wollen, dass sie nur automatisch antwortet, wenn sie das Ticket bearbeiten kann, und den Rest weiterleitet. Die Kundenseite einer kaputten Übergabe sieht so aus:
"I told it to go get me a human and it said it would find a human... then put me through a questionnaire before telling me to call the main support line. sigh"
Das ist der „doom loop" der CFPB im Kleinen. Eine Übergabe sollte die Konversation und die gesammelten Details im selben Kanal an einen Menschen weitergeben. Die Leitfäden zu Chatbot-Eskalation, menschlicher Übergabe und Konfidenzschwellen behandeln die Mechanik.
Für streitfall-intensive Queues siehe KI für Abrechnungsstreitfälle und Rückbuchungsanfragen. Zahlungsstreitfälle folgen demselben Muster: Der Bot sammelt die Fakten, ein Mensch entscheidet.
Wie testet man die Genauigkeit vor dem Start?
Spielen Sie Ihre eigenen bisherigen Tickets durch den Bot und vergleichen Sie seine Antworten mit dem, was Ihr Team tatsächlich gesendet hat. Ein generischer Benchmark zeigt Ihnen, wie ein Modell bei den Fragen eines anderen abschneidet. Ihre gelösten Tickets zeigen Ihnen, wie dieser Bot bei Ihren Gebühren, Ihren Kontostufen und der Wortwahl Ihrer Kunden abschneidet.
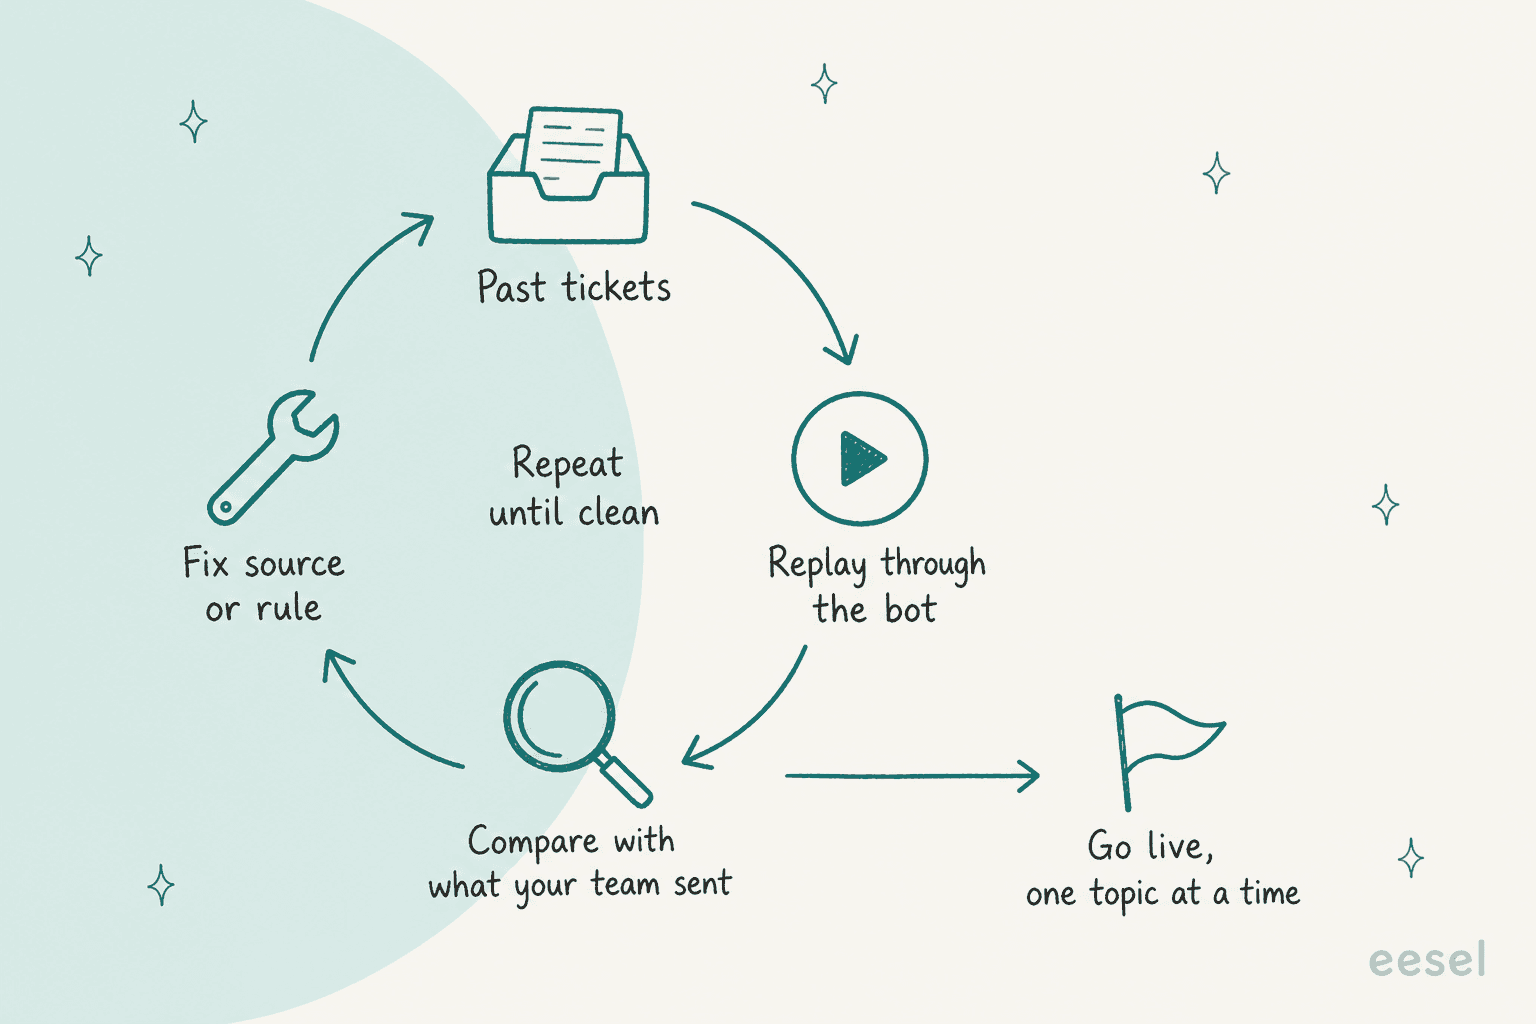
So würde ich vorgehen:
- Ziehen Sie ein paar Hundert gelöste Tickets, gewichtet zu den riskanten Zeilen: Gebührenfragen, Abbuchungen, Zinsfragen, Streitfälle. Lassen Sie Passwort-Resets die Stichprobe nicht dominieren.
- Spielen Sie sie durch, ohne etwas zu senden. Die Simulation von eesel führt den vollständigen Agenten in einer Sandbox auf echten oder generierten Tickets aus und bewertet jede Antwort gegen das, was Ihr Team gesendet hat.
- Bewerten Sie nach Thema, nicht als einen Durchschnitt. Eine Gesamtbewertung von
90%kann eine60%-Bewertung bei Gebührenfragen verdecken. Die Aufteilung nach Thema ist die Zahl, die zählt. - Kennzeichnen Sie jeden Fehlschlag nach Ursache. Veraltetes Dokument, vermischte Quellen, fehlende Abfrage, fehlende Ablehnungsregel. Jede Ursache braucht eine andere Lösung, und keine davon ist „ein anderes Modell ausprobieren".
- Beheben und dieselben Tickets erneut durchspielen. Testen Sie erneut an den Tickets, die durchgefallen sind, damit Sie wissen, dass die Lösung an genau der Formulierung funktioniert hat, die es kaputt gemacht hat.
- Gehen Sie themenweise live, beginnend mit der Zeile zum Konzepterklären, und behalten Sie die riskanteren Zeilen als Entwürfe für eine menschliche Freigabe.
Die FCA beschreibt dieselbe Idee von der Seite der Aufsicht. Ihre Good-Practice-Liste umfasst das Testen von Verbraucherergebnissen über verschiedene Kundengruppen und Szenarien, das Führen von Aufzeichnungen zu Prompts, Ausgaben und Eskalationsentscheidungen, und den Vergleich der Modellleistung mit dem menschengeführten Prozess. Kleinere Firmen, so die FCA, können Stichprobenausgaben und sorgfältig gefilterte Testdaten nutzen, statt in vollem Umfang zu testen.
Das Testen hört auch beim Start nicht auf. Qontro, ein Cloud-ERP-Unternehmen in Neuseeland, betreibt eesel als Co-Pilot auf Freshdesk: Jedes Ticket bekommt einen Entwurf, Abrechnungsfragen gehen direkt an einen Menschen, und wenn ein Ticket nicht genug enthält, um sicher zu antworten, sagt eesel das, statt zu raten. Das Team vergleicht jeden Entwurf mit der tatsächlich gesendeten Antwort, und wo ein Entwurf falsch lag, deutet das meist auf einen fehlenden Hilfeartikel oder eine Regel, die geschärft werden muss. Etwa einer von zehn Entwürfen geht inzwischen mit wenig oder keiner Bearbeitung hinaus. Das ist eine langsame, ehrliche Zahl, und die Lücke zeigt dem Team genau, wo es arbeiten muss.
Für den laufenden Teil behandeln die Leitfäden zum Überprüfen von KI-Konversationen, KI-Support-QA und adversariellem Testen, was man wöchentlich lesen sollte.
Betrachten Sie auch Ihre Lösungsrate mit etwas Misstrauen: Der Beitrag zu Deflection vs. Resolution erklärt, warum eine geschlossene Konversation kein Beweis für eine richtige Antwort ist.
eesel für den Finanzsupport testen
Wenn Sie KI vor Kunden stellen, die nach Gebühren, Zinssätzen und Abbuchungen fragen, ist eesel ein KI-Helpdesk-Teammitglied, das Ihrer bestehenden Queue in Zendesk, Freshdesk und anderen Helpdesks beitritt. Es lernt aus Ihrem Hilfecenter, Ihren Makros und bisherigen Tickets, antwortet nur aus dem, was es abgerufen hat, schlägt Live-Daten über Integrationen nach und gibt Erlasse und Streitfälle mit gesammelten Details an Ihr Team weiter.
Der Unterschied für ein Finanzteam ist das Testen. Bevor ein einziger Kunde ihn sieht, spielt eesel Ihre gelösten Tickets durch und zeigt, Thema für Thema, wo es eine falsche Gebühr zitiert oder eine Übergabe verpasst hätte. smava betreibt es über 27.000 Kredit-Tickets im Monat, mit jeder Regel in den Anweisungen der Agenten geschrieben, sodass eine Änderung dessen, was eesel sagen darf, eine Textbearbeitung ist und kein Projekt. Die Pläne starten bei 299 $ im Monat für 500 Credits nach einer 7-tägigen kostenlosen Testphase, laut eesel-Preisen.
Mehr zum Finanz-Anwendungsfall in den Leitfäden zu KI für Fintech-Support, Banking-Chatbots und Conversational AI für Banken.
eesel testen an Ihren eigenen bisherigen Tickets und sehen, welche Gebührenfragen es richtig beantwortet, bevor Ihre Kunden es herausfinden.