

Kurzfassung
Wer einen KI-Agenten in den Unternehmens-Stack integrieren will, denkt am besten in drei Aufgaben statt in einer großen Verbindung: was er liest (Help Center, frühere Tickets, Confluence, Notion, Google Drive), was ihn aufweckt (ein neues Ticket, eine Slack-Erwähnung, ein Webhook aus deinen eigenen Systemen) und was er tun darf (taggen, antworten, eine Bestellung nachschlagen, erstatten). Verbinde in dieser Reihenfolge, zuerst nur lesend, und stelle jede Aktion, die Geld bewegt, unter menschliche Freigabe.
An den Berechtigungen scheitern die meisten Rollouts. Ein Agent sieht immer nur, was der verbindende Nutzer sehen kann, was die Scopes erlauben und was du ausdrücklich freigegeben hast. Zendesk-API-Tokens können Admins imitieren, ein Freshdesk-API-Key erbt die Rolle einer einzelnen Person, Shopifys Scope read_orders deckt nur die letzten 60 Tage ab, und eine neue Notion-Verbindung sieht nichts, bis du sie einer Seite hinzufügst. Wähle OAuth statt persönlicher Tokens, gib dem Agenten eine eigene, schmale Identität und teste an vergangenen Tickets, bevor ein Kunde eine Antwort sieht.
Der KI-Helpdesk-Teamkollege von eesel ist genau auf diese Aufteilung ausgelegt. Er arbeitet in deinem bestehenden Helpdesk, liest deine Wissens-Tools, ruft deine eigenen APIs über eine Allowlist auf, und jede Aktion steht auf automatisch, erst fragen oder aus. Du kannst alles über das Dashboard, die eesel CLI oder einen MCP-Client einrichten, und ein Ticket kostet einen Credit, egal wie viele Systeme es berührt.
Was die Integration eines KI-Agenten in deinen Stack wirklich bedeutet
Ich arbeite am Produkt von eesel, das heißt vor allem: Konnektoren bauen, mit denen ein KI-Teammitglied in den Tools anderer Leute arbeiten kann. Das Nützlichste, was ich dabei gelernt habe: Die KI ist selten das schwache Glied. Die Verkabelung ist es. In einem Test mit echtem Traffic in einem E-Commerce-Posteingang mit Zendesk und Shopify (etwa 1.000 Tickets im Monat) betrafen rund 65 % der Änderungen, die Agenten an KI-Entwürfen vornahmen, Ton und Länge, und nur etwa 5 % gingen darauf zurück, dass die KI sachlich falsch lag. Etwa 20 % der Änderungen waren nötig, weil die Antwort Daten aus einem System brauchte, an das der Agent noch nicht angebunden war, etwa das ERP oder der Logistikdienstleister. Besseres Prompting behebt diese 20 % nicht. Mehr Integration schon.
Wenn mich also eine Support-Leiterin fragt, wie sie KI „in unseren Stack einbauen“ soll, teile ich die Frage in drei Teile. Die Doku von eesel beschreibt jede Integration auf dieselbe Weise, als Mischung aus Quellen, Triggern und Aktionen, und dieses Modell passt auf jeden Anbieter, den du bewertest:
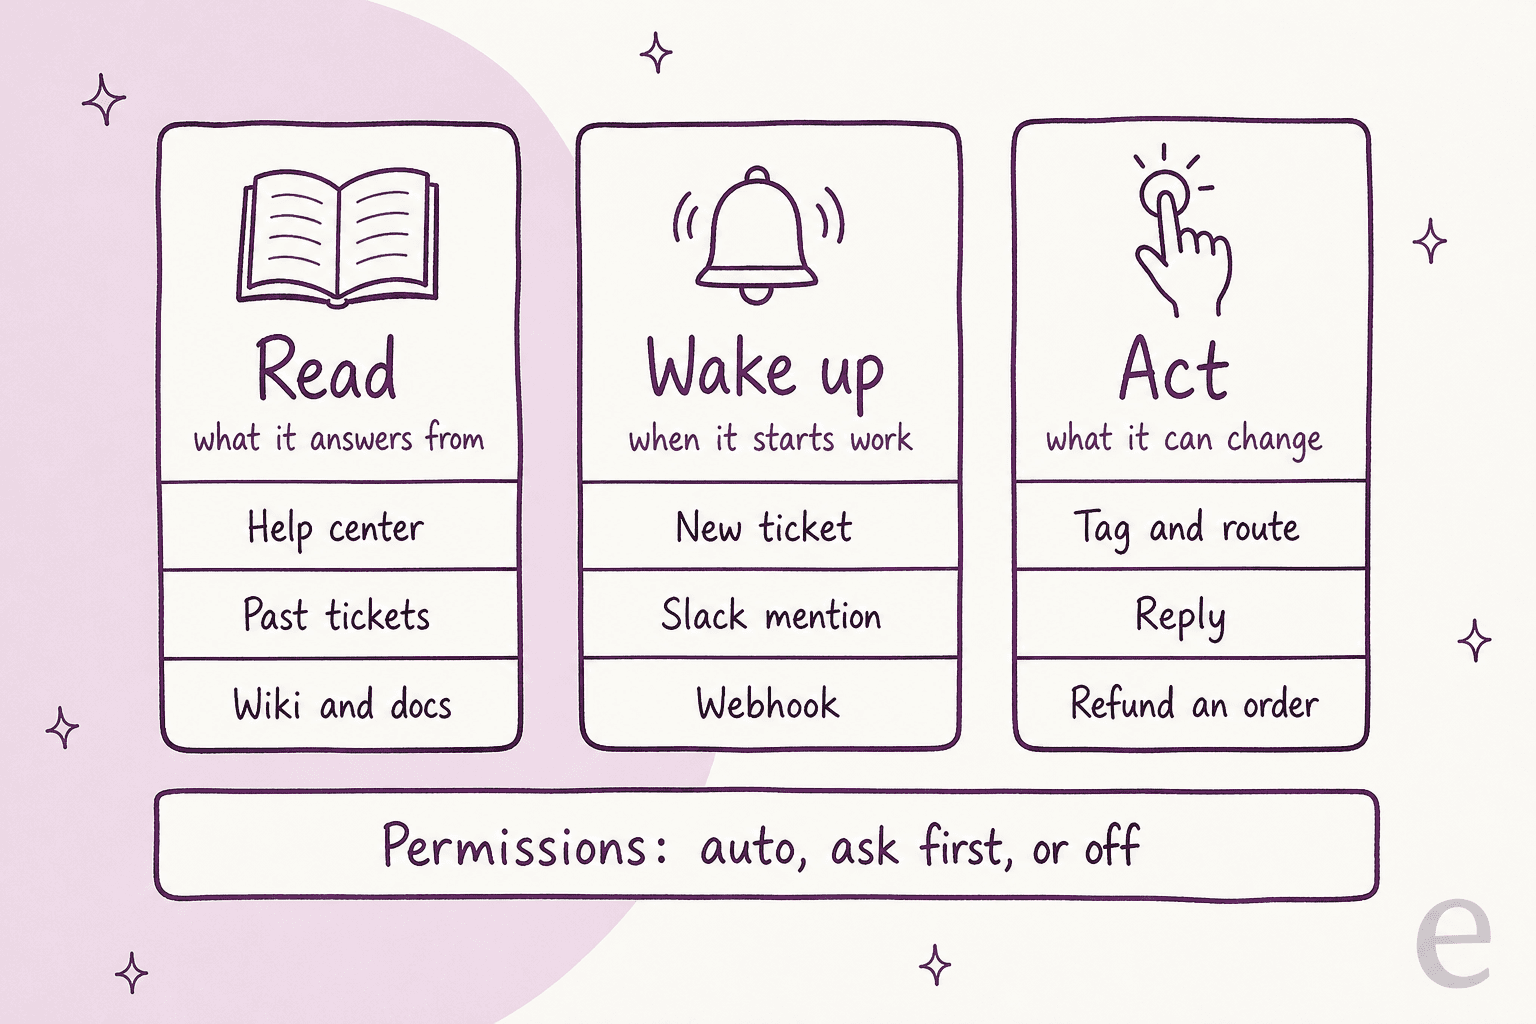
- Lesen. Das Wissen, aus dem er antwortet. Help-Center-Artikel, frühere Tickets und Makros, interne Wikis, Produktdokumentation, Richtlinien.
- Aufwecken. Die Ereignisse, die Arbeit auslösen. Ein neues Ticket, eine Kundennachricht, eine @Erwähnung in Slack, ein Webhook aus deinem Lagersystem, ein Zeitplan.
- Handeln. Was er verändern darf. Ein Ticket taggen und weiterleiten, eine interne Notiz hinterlassen, eine Antwort senden, eine Bestellung nachschlagen, eine Retoure starten, eine Erstattung auslösen.
Manche Tools erfüllen alle drei Aufgaben. Ein Helpdesk wie Zendesk ist Quelle (Tickets, Makros, Help Center), Trigger (neues Ticket) und Aktionsfläche (antworten, taggen, zuweisen). Andere sind reine Quellen: Confluence, Notion und Google Drive werden gelesen, nie beschrieben. Deine eigene Bestelldatenbank dient meist nur für Aktionen. Wenn du deinen Stack so sortierst, erkennst du, welche Verbindungen risikoarm sind (Lesen) und welche echte Leitplanken brauchen (Schreiben).
Wenn du zuerst das größere Bild von Agenten und Business-Tools möchtest, haben meine Kolleginnen und Kollegen einen Überblick zu KI-Agenten und Business-Tools geschrieben. Dieser Beitrag ist die praktische Version für Support- oder Ops-Verantwortliche.
Schritt 1: Stack erfassen, bevor du irgendetwas verbindest
Bevor du eine Einstellungsseite öffnest, schreibe pro System, das der Agent braucht, eine Zeile auf. Das dauert 20 Minuten und erspart dir den häufigsten Fehler, den ich sehe: Der Helpdesk wird verbunden, die Antworten sind ordentlich, und dann stellt sich heraus, dass die häufigsten Kundenfragen („Wo ist meine Bestellung?“, „Warum wurde ich doppelt belastet?“) Daten brauchen, die woanders liegen.
| System | Aufgabe des Agenten | Was er braucht | Wer die Verbindung freigeben muss |
|---|---|---|---|
| Helpdesk (Zendesk, Freshdesk, Gorgias) | Lesen, aufwecken, handeln | Frühere Tickets, Makros, Trigger, Antwort- und Tag-Aktionen | Ein Helpdesk-Admin, einmalig im Browser |
| Help Center | Lesen | Öffentliche Artikel | Niemand, wenn es öffentlich ist |
| Wiki (Confluence, Notion, Google Drive) | Lesen | Die konkreten Spaces, Seiten oder Ordner, denen du vertraust | Ein Space-Admin oder Seiteninhaber |
| Team-Chat (Slack, Teams) | Aufwecken, handeln | Kanäle, denen er beitreten darf, Erlaubnis zu posten | Ein Workspace-Admin |
| Shop (Shopify, BigCommerce) | Handeln | Bestellabfragen, dann Retouren, Adressänderungen, Erstattungen | Shopinhaber oder Mitarbeitende mit App-Rechten |
| Abrechnung (Stripe, dein Billing-System) | Handeln | Ein schmaler Schlüssel: Zahlungen lesen, vielleicht erstatten | Finanzen oder Entwicklung |
| CRM (Salesforce, HubSpot) | Lesen, handeln | Konto- und Tarifkontext, Case-Updates | Ein CRM-Admin |
| Deine eigenen APIs (Bestell-DB, Lager) | Handeln | Eine Domain auf der Allowlist und ein Auth-Header | Entwicklung |
Markiere dann in jeder Zeile, was schiefgeht, wenn der Agent es falsch macht. Eine falsche Antwort aus dem Wiki kostet dich eine Korrektur. Eine Erstattung auf die falsche Bestellung kostet Geld. In dieser Reihenfolge verbindest du die Systeme.
Ich habe unten den Planer gebaut: Hake an, was in deinem Stack steckt, und du erhältst die Reihenfolge, in der ich verbinden würde, samt Berechtigungsfalle je System, entnommen aus der Doku des jeweiligen Anbieters.
Integrationsplaner
Was steckt in deinem Stack?
Hake jedes System an, das dein Support-Team nutzt. Der Plan darunter listet sie in der Reihenfolge auf, in der ich sie verbinden würde, mit dem geringsten Risiko zuerst und der Berechtigungsfalle, die du je System prüfen solltest.
Wiki oder Doku (Confluence, Notion, Google Drive)
Nur lesend. Wähle die Spaces, Seiten oder Ordner, denen du vertraust, nicht den ganzen Workspace.
Falle: Eine neue Notion-Verbindung sieht keine Seiten, bis du sie jeder einzelnen hinzufügst, und eine Confluence-App sieht nie mehr als der Nutzer, der sie autorisiert hat.
Helpdesk (Zendesk, Freshdesk, Gorgias)
Per OAuth verbinden, frühere Tickets und Makros importieren und zunächst nur Antworten als interne Notizen schreiben.
Falle: Zendesk-API-Tokens gelten als veraltet und können Admins imitieren; ein Freshdesk-API-Key kann nur das, was die Rolle dieses einen Agenten erlaubt.
Slack
Freigaben und interne Fragen in Threads. Lass ihn nur den Kanälen beitreten, die du nennst.
Falle: Seit Mai 2025 bekommt eine neue Slack-App außerhalb des Marketplace 1 History-Aufruf pro Minute und 15 Nachrichten pro Aufruf.
CRM (Salesforce, HubSpot)
Zuerst nur lesende Konto- und Tarifabfragen. Case- oder Ticket-Updates später, hinter einer Freigabe.
Falle: Das tägliche API-Limit von HubSpot teilen sich alle privaten Apps im Konto; eine Salesforce-Integration läuft als der „Run As“-Nutzer, den du wählst.
Shopify-Shop
Bestell- und Sendungsabfragen automatisch. Retouren, Adressänderungen, Stornos und Erstattungen erst nach Rückfrage.
Falle: read_orders deckt nur die letzten 60 Tage ab, außer Shopify genehmigt read_all_orders, und eine Bestellstornierung lässt sich nicht rückgängig machen.
Stripe oder Billing
Ein eingeschränkter Schlüssel mit Lesezugriff auf das, was nachgeschlagen werden muss, und Schreibzugriff nur auf Erstattungen, wenn überhaupt.
Falle: Gib einem Agenten nie deinen Secret Key. Stripe empfiehlt eingeschränkte Schlüssel für KI-Agenten, und ein als Agent markierter Schlüssel bekommt standardmäßig Freigaberegeln für Erstattungen.
Deine eigene API (Bestell-DB, Lager, ERP)
Eine Domain auf die Allowlist setzen, den Auth-Header serverseitig speichern und mit GET-Anfragen beginnen.
Falle: Kann das Modell den Schlüssel sehen, kann es jeder sehen, der es dazu bringt, seine Anweisungen zu wiederholen. Halte Zugangsdaten komplett aus Prompts heraus.
Limits und Scopes stammen aus den Entwicklerdokus der jeweiligen Anbieter, Stand Oktober 2026. Tarife und Rate-Limits ändern sich, prüfe daher die in diesem Beitrag verlinkte Seite noch einmal, bevor du auf eine Zahl baust.
Schritt 2: Das Wissen anbinden, das er liest, und nur Wissen, dem du vertraust
Wissen ist die sicherste Ebene für den Start, weil jede Verbindung hier nur lesend ist. Hier entscheidet sich auch die Qualität. Die KI wiederholt, was du ihr gibst, schneller, als es ein Mensch könnte:
„Ich habe einen Bot gesehen, der selbstsicher falsche Antworten gab, weil die Wissensdatenbank seit 8 Monaten nicht aktualisiert worden war. Kunden bekamen nicht nur schlechte Antworten. Sie bekamen sie sofort.“

Drei Quellen sind wichtiger als der Rest:
- Frühere Tickets und Makros. So antwortet dein Team wirklich, einschließlich der Sonderfälle, für die niemand einen Artikel geschrieben hat. Wenn der Agent eines Anbieters nicht aus gelösten Tickets lernen kann, arbeitet er nur mit deiner Best-Case-Dokumentation. Mehr dazu im Leitfaden meiner Kollegen zum Training mit der Wissensdatenbank.
- Das Help Center. Öffentlich, strukturiert, meist am aktuellsten. Als Start in Ordnung, allein zu dünn.
- Interne Wikis und Dokumente. Confluence, Notion, Google Drive, SharePoint. Hier stehen Erstattungsausnahmen und Eskalationsregeln.
Jedes Wiki-Tool hat sein eigenes Berechtigungsmodell, und alle gewähren standardmäßig „weniger, als du denkst“:
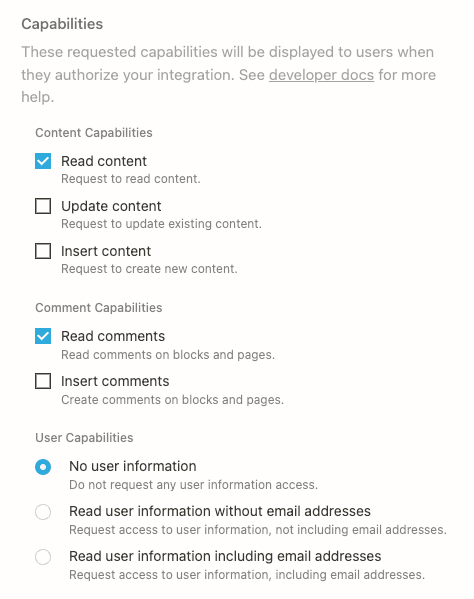
- Notion nennt Integrationen inzwischen „Verbindungen“. Eine Verbindung sieht nur Seiten, die mit ihr geteilt wurden: „Wenn die Seite nicht geteilt ist, antwortet jede API-Anfrage mit einem Fehler“ (Notion-Autorisierungsdoku). Lesen, Aktualisieren und Einfügen sind getrennte Fähigkeiten, du kannst also nur Lesen gewähren.
- Confluence Cloud-Apps handeln im Auftrag eines Nutzers, und „die Berechtigungen des Nutzers, für den eine App handelt, schränken die App immer ein, unabhängig von den Scopes der App“ (Atlassian-OAuth-Doku). Eingeschränkte Spaces erfordern, dass die App ausdrücklich hinzugefügt wird.
- Google Drive hat den breiten Scope
drive.readonly, den Google als eingeschränkt einstuft, und das Speichern dieser Daten auf einem Server löst eine Sicherheitsprüfung aus (Drive-Scope-Doku). Deshalb lassen die meisten Tools dich Dateien und Ordner auswählen.
Auf der eesel-Seite ist der Confluence-Konnektor von Haus aus nur lesend, und der Notion-Konnektor liest nur, es sei denn, du schaltest seine einzige allgemeine Schreibaktion ein, die standardmäßig aus ist.
Die zweite Lehre betrifft die Synchronisierung. Wissens-Konnektoren sind meist eine Kopie zu einem Zeitpunkt, kein Live-Feed, und sie fallen unbemerkt aus. Ich habe erlebt, wie ein Kunde deswegen gekündigt hat: Seine wichtigste Datenquelle war eine täglich geänderte Bestellstatus-Tabelle in Google Drive, die Synchronisierung schlug dreimal unbemerkt fehl, und er wechselte zu einem günstigeren Tool. Frage jeden Anbieter, wie neue Dateien ankommen und woran du merkst, dass eine Synchronisierung kaputt ist. Bei eesel unterscheiden sich die Antworten je Tool, und die Doku sagt das offen: Confluence-Seiten werden neu indexiert, wenn du sie bearbeitest, und die App gleicht etwa einmal pro Stunde ab (Confluence-Doku), während eine neue Google-Drive-Datei im Picker neu ausgewählt werden muss und ein Workspace bis zu 2.500 Dateien am Tag synchronisieren kann (Google-Drive-Doku).
Prüfe auch die Formate, die dein Team tatsächlich nutzt. Eine DTC-Supplement-Marke in einem eesel-Vertriebsgespräch (rund 7.000 Gorgias-Tickets im Monat) hielt ihre echten Abläufe in ClickUp-SOPs und Loom-Videos fest, dazu ein Haufen veralteter Makros. Nichts davon kann ein Text-Konnektor lesen, bis jemand es aufschreibt. Falls das auf dich zutrifft, kommt die Arbeit an der KI-Wissensdatenbank vor der Integrationsarbeit.
Schritt 3: In den Helpdesk einbinden, wo die Tickets schon liegen
Der Helpdesk ist die wichtigste Integration, weil er alle drei Aufgaben zugleich erfüllt. Meine klare Meinung: Setze den Agenten in den Helpdesk, den dein Team schon nutzt, statt Tickets in einen separaten KI-Posteingang auszulagern. Deine Agenten behalten ihre Ansichten, Makros und SLAs, und die Arbeit der KI erscheint als Notizen und Antworten im selben Ticket. So sollte eine KI-Helpdesk-Integration aussehen.
Pro Helpdesk ändert sich, wie sich eine externe App authentifiziert, als wessen Identität sie handelt und wie viel sie aufrufen darf. Das sagen die Entwicklerdokus der Anbieter:
| Helpdesk | Wie sich eine externe App verbindet | Als wessen Identität sie handelt | API-Rate-Limit | Öffentliche Antwort vs. Notiz |
|---|---|---|---|---|
| Zendesk | OAuth (API-Tokens sind als veraltet markiert) | API-Tokens „können genutzt werden, um jeden im Konto zu imitieren, auch Admins“ | 200/Min. bei Team bis 2.500/Min. bei Enterprise Plus | public: false erzeugt eine interne Notiz |
| Freshdesk | Persönlicher API-Key | Die Rolle dieses Agenten: Eine reine Leserolle kann per API nicht antworten | 100/Min. Growth, 400 Pro, 700 Enterprise | Getrennte Endpunkte für Antwort und Notiz; Notizen sind standardmäßig privat |
| Gorgias | API-Key (privat) oder OAuth2 (für öffentliche Apps erforderlich) | Das Konto, das den Schlüssel erstellt hat, mit „Vollzugriff“ auf Kontodaten | 40 Anfragen pro 20 s bei API-Keys, 80 bei OAuth | Kanal internal-note |
| HubSpot | Private-App-Token (nur Super-Admin) oder OAuth-App | Die App, begrenzt auf ihre Scopes | 100 bis 190 pro 10 s, plus ein Tageslimit, das alle Apps teilen | In HubSpots öffentlicher Doku nicht bestätigt |
| Salesforce | Connected App, OAuth Client Credentials | Der „Run As“-Nutzer, den du wählst; Salesforce empfiehlt einen Nutzer nur für die API | 100.000 Aufrufe/Tag plus 1.000 pro Lizenz (Enterprise) | CaseComment.IsPublished |
Drei Dinge in dieser Tabelle verändern, wie ich es einrichten würde:
- Nutze OAuth, nicht den API-Token einer Person. Zendesk sagt, dass Anbieter, die viele Kunden bedienen, „globale OAuth-Zugriffstokens verwenden müssen“ (Zendesk-Auth-Doku). Ein an eine Person gebundener Token funktioniert zudem nicht mehr, sobald diese Person das Unternehmen verlässt. Bietet dein Helpdesk nur persönliche Schlüssel, lege einen eigenen Agenten-Platz mit schmaler Rolle für die KI an und erzeuge den Schlüssel von dort.
- Rate-Limits werden geteilt. Im Team-Tarif von Zendesk decken 200 Anfragen pro Minute deine KI, deine CRM-Synchronisierung und jede andere App ab. Zendesk begrenzt außerdem Updates an einem einzelnen Ticket auf 30 pro 10 Minuten und Nutzer (Rate-Limits). Ein Agent, der in getrennten Aufrufen taggt, Notizen schreibt und antwortet, verbraucht das schneller, als du erwartest. Die Analyse meiner Kollegen zu Zendesk-API-Rate-Limits geht tiefer.
- Beginne mit internen Notizen. Jeder der genannten Helpdesks kann eine private Notiz posten. Das ist deine sicherste erste Woche: Die KI entwirft, ein Mensch liest und sendet, und nichts erreicht versehentlich einen Kunden.
Du musst außerdem entscheiden zwischen der eingebauten KI des Helpdesks und einer Ebene, die sich einklinkt. Eingebaute Agenten wie Zendesk AI, Freddy AI Agent oder Agentforce bedeuten am wenigsten Einrichtung, aber ihre Reichweite außerhalb des Helpdesks ist oft enger, als die Demo vermuten lässt. Ein Rezensent sagte es über Gorgias so:
„Der AI Agent folgt demselben Muster: volle Funktionalität nur für Shopify und ein umständliches Setup mit einer E-Mail pro Shop, das nicht zu jedem Unternehmen passt.“

Das ist ein berechtigter Punkt eines 5-Sterne-Rezensenten und genau die richtige Frage an jeden Anbieter: Funktionieren die Aktionen in meinem Stack oder nur im Stack der Demo? Auch ich stand schon auf der Verliererseite. Anfang des Jahres hat eesel Mid-Market-Deals verloren, weil es keinen nativen Salesforce- oder HubSpot-Helpdesk-Konnektor gab. Beide gibt es inzwischen (Salesforce, HubSpot), aber die Lehre bleibt. Die Konnektorliste ist ein hartes Filterkriterium, also prüfe sie zuerst.
So sieht eine vollständige Zendesk-Verbindung bei eesel aus: Help Center, Makros und frühere Tickets als drei getrennte Quellen mit je eigenem Schalter, sodass du eine weglassen kannst.
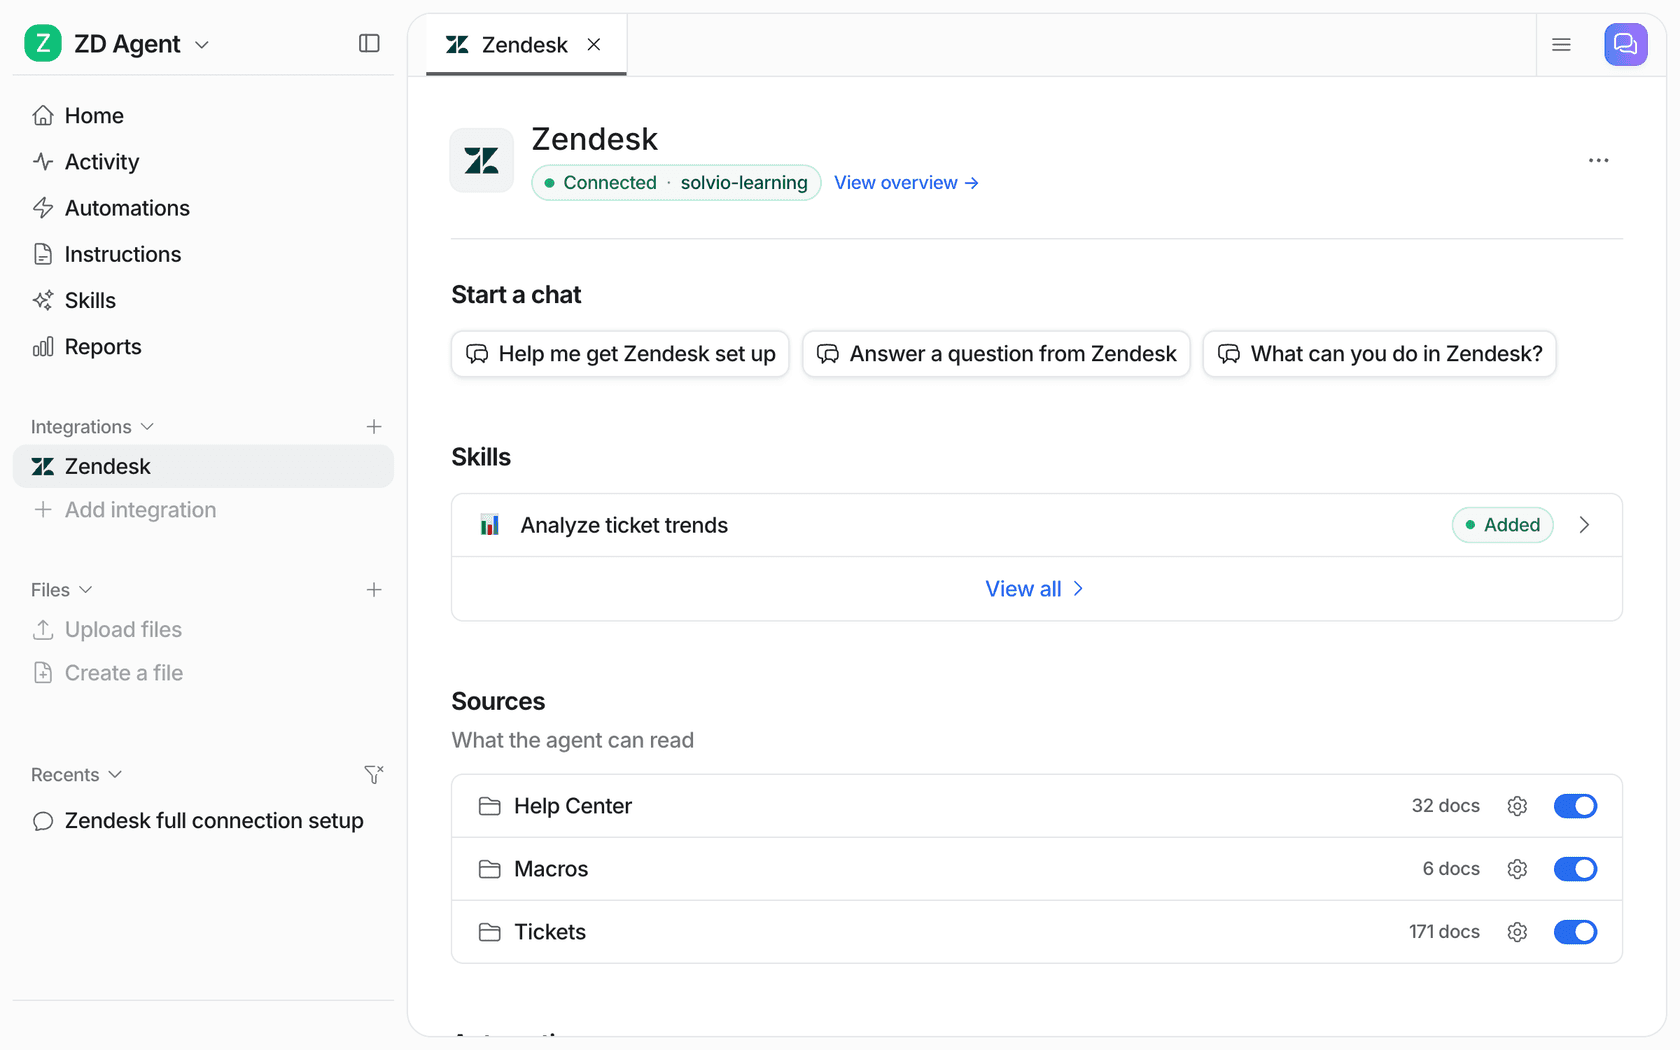
Die Helpdesk-Doku von eesel macht einen Punkt, den ich mir von jedem Anbieter wünsche: „Das Verbinden erlaubt deinem Agenten nur, deinen Helpdesk zu lesen. Er tut nichts an Tickets, bis du eine Automatisierung erstellst.“ (Helpdesk-Doku). Verbinden und Live-Gehen sind zwei getrennte Schritte, und du willst sie getrennt halten.
Schritt 4: Aktionen mit Shop, Abrechnung und internen Systemen verdrahten
Diese Ebene macht aus einem Antwort-Bot etwas, das Tickets schließt. Hier kostet ein Fehler auch Geld. Die meisten Tickets zu „Wo ist meine Bestellung“, „Adresse ändern“ und „Erstattet mir das“ brauchen eine Abfrage oder einen Schreibzugriff in einem System, das nicht dein Helpdesk ist.
Shopify und andere Shops
Shopify sehe ich am häufigsten, und seine Zugriffs-Scopes haben zwei Fallen, die du vor dem Verbinden kennen solltest:
read_ordersundwrite_orders„decken Bestellungen ab, die in den letzten 60 Tagen erstellt wurden. Für ältere Bestellungen fügeread_all_ordershinzu, wofür du Zugriff beantragen musst“ (Shopify-Zugriffs-Scopes). Ein Agent, der eine drei Monate alte Bestellung nicht findet, sagt dem Kunden, dass es sie nicht gibt.- Zum Stornieren braucht es
write_orders, und Shopifys eigene Doku sagt zuorderCancel: „Diese Aktion kann nicht rückgängig gemacht werden“ (orderCancel). Name, E-Mail, Telefonnummer und Adresse von Kunden sind außerdem geschützte Daten der Stufe 2, die für Apps eine zusätzliche Prüfung erfordern (geschützte Kundendaten).
Die Shopify-Integration von eesel teilt ihre Aktionen in eine Lesegruppe (Bestellung abrufen, Bestellhistorie, Versand und Tracking) und eine Schreibgruppe (Retoure anlegen, Lieferadresse ändern, erstatten, stornieren). Die Doku vermerkt auch, dass sie jetzt Shopifys Berechtigung zum Lesen aller Bestellungen anfordert, ein vor dieser Änderung verbundener Shop aber bei der 60-Tage-Grenze bleibt, bis jemand ihn neu verbindet (eesel-Shopify-Doku). Genau solche Details solltest du in deinem eigenen Setup prüfen. Eine ausführlichere Anleitung bietet Shopify-Bestelldaten anbinden für einen Support-Agenten.
Abrechnung und Zahlungen
Gib einem KI-Agenten nie deinen geheimen Zahlungsschlüssel. Stripes eigene Empfehlung ist eindeutig: „RAKs sind der empfohlene Schlüsseltyp für API-Schlüssel, die du KI-Agenten gibst“ (Stripe Restricted Keys). Ein eingeschränkter Schlüssel setzt pro Ressource Lesen, Schreiben oder Nichts, sodass ein Support-Agent Zahlungen und Rechnungen lesen kann, ohne Auszahlungen anzufassen. Stripe lässt dich einen Schlüssel außerdem als Agenten-Schlüssel markieren, und markierte Schlüssel erhalten standardmäßig Freigaberegeln für Auszahlungen, Erstattungen und Kontoänderungen (Stripe-API-Schlüssel).
Deine eigenen Systeme (Bestelldatenbank, Lager, ERP)
Für alles ohne fertigen Konnektor ist das Muster ein API-Aufruf über eine Allowlist. Du sagst dem Agenten, welche Domain er aufrufen darf und welchen Auth-Header er senden soll, und die Plattform hängt die Zugangsdaten serverseitig an, sodass das Modell sie nie sieht. Bei eesel heißt das Network Access: Anfragen an jede Domain, die du nicht hinzugefügt hast, werden abgelehnt, GET, POST, PATCH und DELETE werden unterstützt, und „die Zugangsdaten bleiben in deinen Einstellungen und werden von eesel an jede Anfrage angehängt, sodass die KI sie nie sieht.“
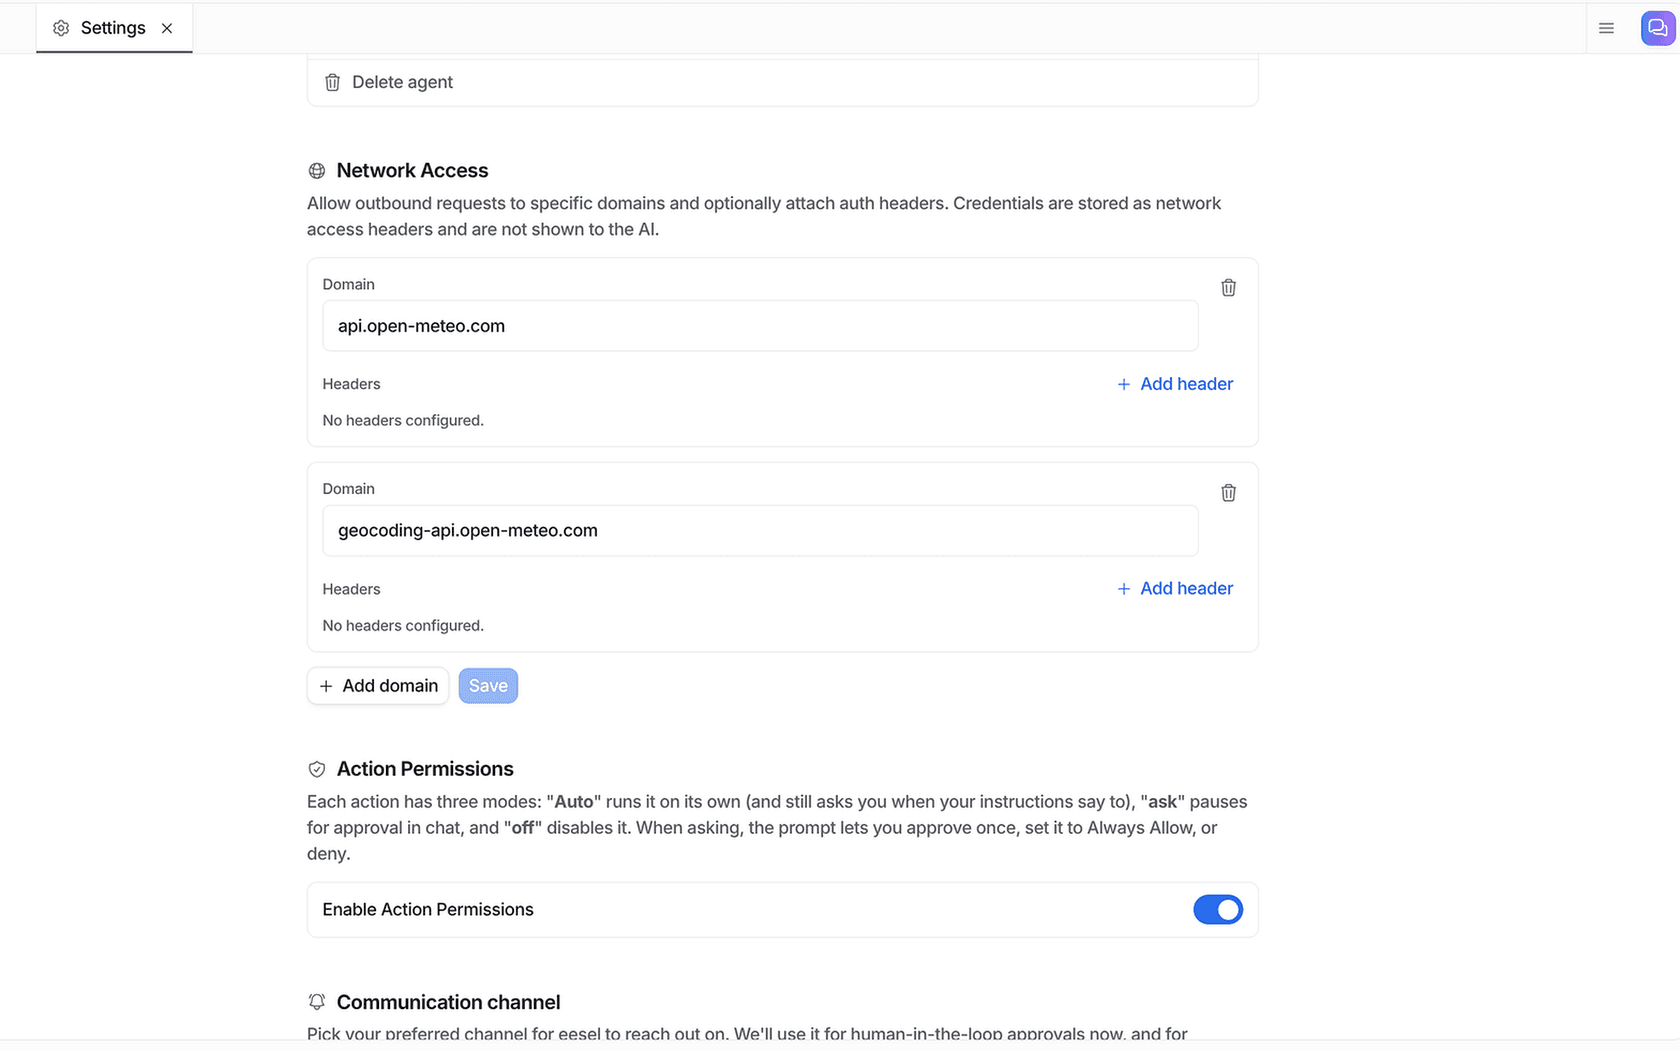
Welches Tool du auch nutzt: Teste, dass eine Aktion tatsächlich funktioniert, bevor der Agent darüber spricht. Ein Modell, das deine Erstattungsrichtlinie gelesen hat, bietet gern Erstattungen an, die es gar nicht ausführen kann. Ein Ada-Rezensent auf G2 erlebte genau das, als der Agent Stornierungen anbot, die er nicht durchführen konnte:
„Manchmal hat Ada Antworten oder Zusagen gegeben, die nicht Teil des ursprünglichen Trainings waren ... Zum Glück ließen sich diese Probleme leicht durch zusätzliches Coaching und Updates beheben, und die Genauigkeit hat sich mit der Zeit weiter verbessert.“

Die Lösung liegt ebenso in den Anweisungen wie in der Integration: Sag dem Agenten, welche Aktionen es gibt und was er antworten soll, wenn ein Kunde nach einer fragt, die es nicht gibt. Der Leitfaden meiner Kollegen zum Automatisieren von Erstattungen mit KI behandelt die Richtlinienseite.
Schritt 5: Berechtigungen setzen, bevor du Trigger setzt
Mein Denkmodell: Ein KI-Agent sieht nie „deinen Stack“. Er sieht die Schnittmenge aus vier Grenzen, und jede setzt eine andere Person:
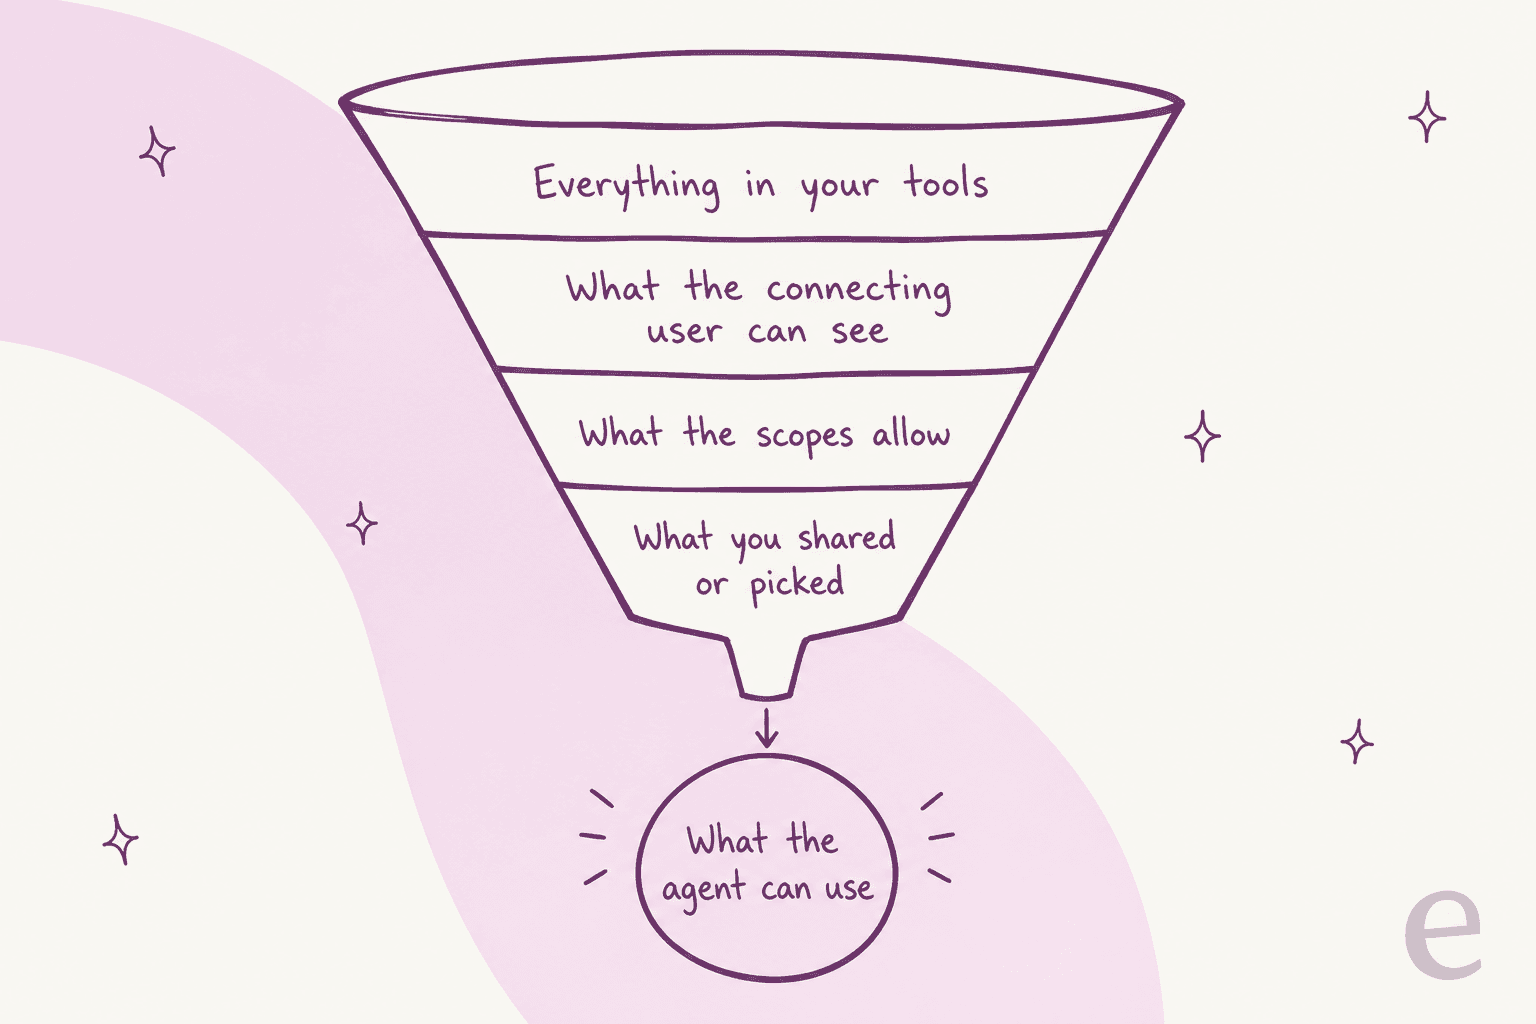
- Der verbindende Nutzer. Confluence-Apps werden durch den autorisierenden Nutzer begrenzt, ein Freshdesk-Key durch die Rolle dieses Agenten, eine Salesforce-Connected-App durch ihren Run-As-Nutzer. Wer auf „Zulassen“ klickt, legt die Obergrenze fest.
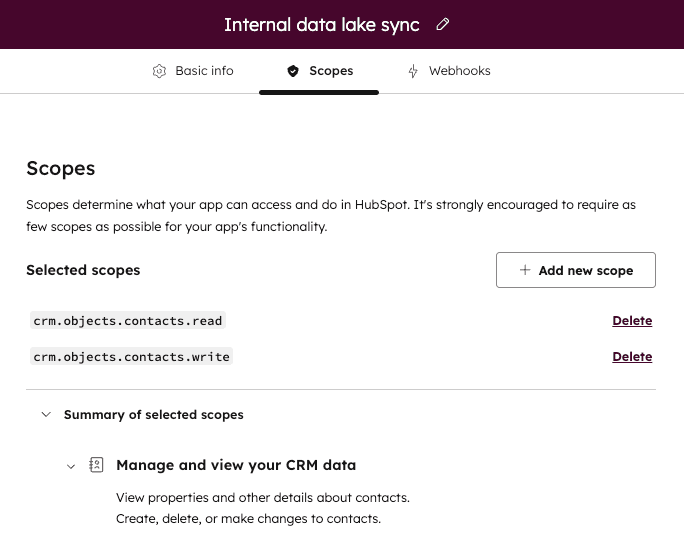
- Die Scopes. Was die App bei der Installation angefragt hat. HubSpots eigener Scope-Bildschirm sagt es klar: so wenige Scopes wie möglich verlangen.
- Was du geteilt oder ausgewählt hast. Notion-Seiten, die der Verbindung hinzugefügt wurden, Drive-Ordner im Picker, Slack-Kanäle, denen er beigetreten ist.
- Was der Agent damit tun darf. Die Einstellungen pro Aktion im KI-Tool selbst.
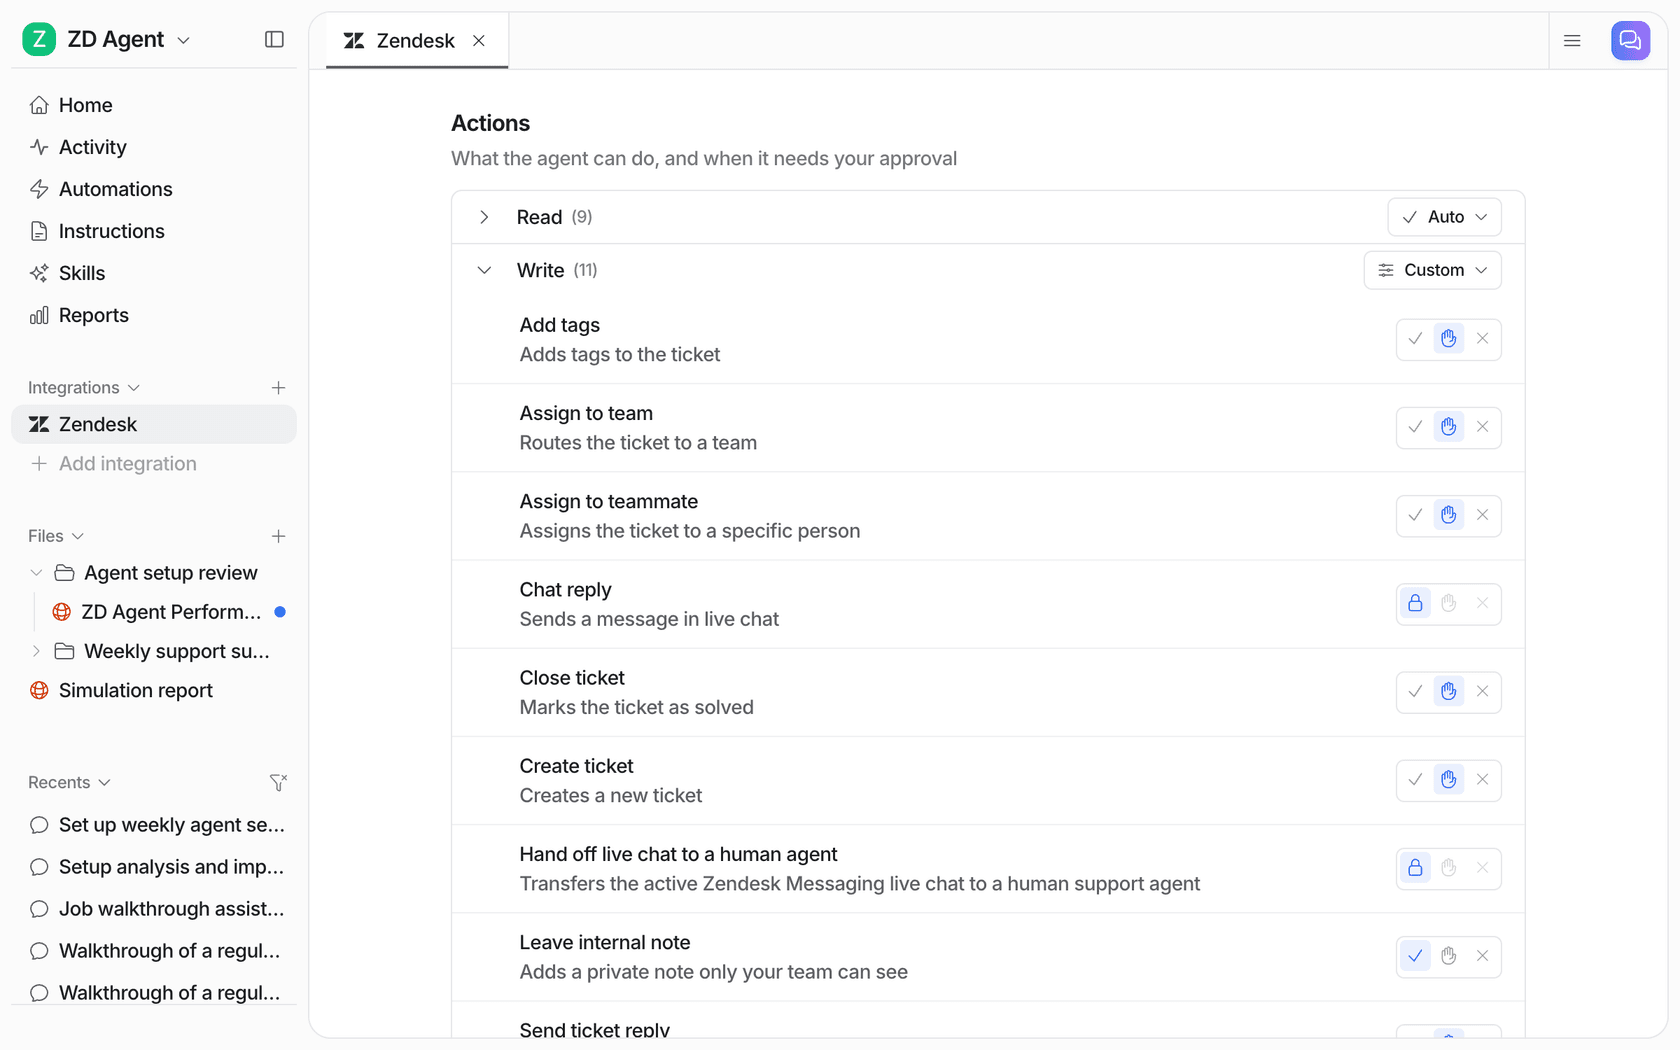
Die vierte Grenze steuerst du im Alltag, und hier würde ich die meiste Sorgfalt investieren. Bei eesel steht jede Aktion pro Agent auf Automatisch, Freigabe nötig oder Deaktiviert, und eine Aktion, die du nicht aktiviert hast, „steht dem Modell überhaupt nicht zur Verfügung, was auch immer es gefragt wird“ (eesel-Sicherheitsdoku). Die Empfehlung in der Doku zu Aktionen und Freigaben ist das Setup, das ich überall kopieren würde: Antworten und alles Unumkehrbare zunächst unter Freigabe halten und „Erstattungen, Stornierungen und alles, was Geld kostet, hinter einer Freigabe“ lassen.
Der schlimmste Integrationsfehler ist keine falsche Antwort. Es ist eine richtig aussehende Antwort auf Basis der Daten des falschen Kunden:
„der größte Fehler, den ich gesehen habe, war ein Agent, der ständig Daten vom Konto des falschen Nutzers zog, weil das Session-Token nicht korrekt an den API-Aufruf übergeben wurde. Die Textantworten sahen perfekt aus, also merkte es niemand, bis sich ein Kunde beschwerte, weil er den Kontostand eines anderen sah“
Salesforce weist im Sicherheitsleitfaden zu Agentforce auf dasselbe Risiko hin: Wenn ein Service-Agent eine Aktion aufruft, wird „die Identität des Agenten verwendet“, also muss dein eigener Code prüfen, zu welchem Kunden die Daten gehören (Salesforce-Doku). Auf welcher Plattform du auch bist: Schlage Bestell- und Kontodaten anhand der Identität im Ticket nach und teste mit zwei Kunden mit ähnlichen Namen. Wenn du regulierte Daten verarbeitest, informiere dich auch über SOC 2 und DSGVO bei Support-KI.
Schritt 6: Festlegen, was den Agenten aufweckt
Sobald er lesen und handeln kann, braucht der Agent einen Anlass zu starten. Es gibt drei Arten von Triggern, und die meisten Stacks nutzen alle.
Helpdesk-Ereignisse. Ein neues Ticket, eine Kundenantwort, eine @Erwähnung in einer internen Notiz. Sie kommen aus der Helpdesk-Integration. Beachte die Zustellregeln: HTTP-Integrationen von Gorgias laufen nach 5 Sekunden in ein Timeout, wiederholen kein 429 oder 500 und schalten sich nach 500 Fehlern in Folge ab (Gorgias-HTTP-Integrationen). Mehr dazu im Leitfaden zu Gorgias-Webhooks. Auch HubSpot-Webhooks laufen nach 5 Sekunden in ein Timeout, Zendesk-Custom-Actions nach 10. Ein langsames KI-Backend muss zuerst bestätigen und die Arbeit danach erledigen, sonst gehen Ereignisse verloren. Einen vollständigen Leitfaden zu Zendesk-Webhooks gibt es, falls du selbst baust.
Chat-Erwähnungen. In Slack landen Freigaben und interne Fragen meistens, und die Slack-Integration von eesel fragt, bevor sie einem Kanal beitritt. Ein Limit, das du kennen solltest, wenn du selbst einen Bot baust: Seit dem 29. Mai 2025 erhalten neue kommerziell vertriebene Apps, die nicht im Slack Marketplace sind, bei conversations.history und conversations.replies „1 Anfrage pro Minute“ und „maximal 15 Objekte pro Anfrage“ (Slack-Changelog). Interne Custom-Apps behalten 50+ Anfragen pro Minute. Slacks erklärter Grund war, massenhaften Datenabfluss zu verhindern, plane also keine Architektur, die deine gesamte Slack-Historie in eine KI kopiert.
Webhooks aus deinen eigenen Systemen. Diesen Trigger vergessen viele. Eine Lagerverzögerung, eine fehlgeschlagene Zahlung oder eine Neuanmeldung kann den Agenten samt Daten aufwecken. Bei eesel gibt dir eine Webhook-Automatisierung eine private URL, an die jedes System (Zapier, Make, dein Backend) JSON per POST senden kann. Sende einen X-Eesel-Event-Id-Header, und Wiederholungen werden genau einmal verarbeitet. Ein Workspace nimmt 60 Zustellungen pro Minute an, und eine Zustellung, die deine Anweisungen herausfiltern, wird nicht abgerechnet.
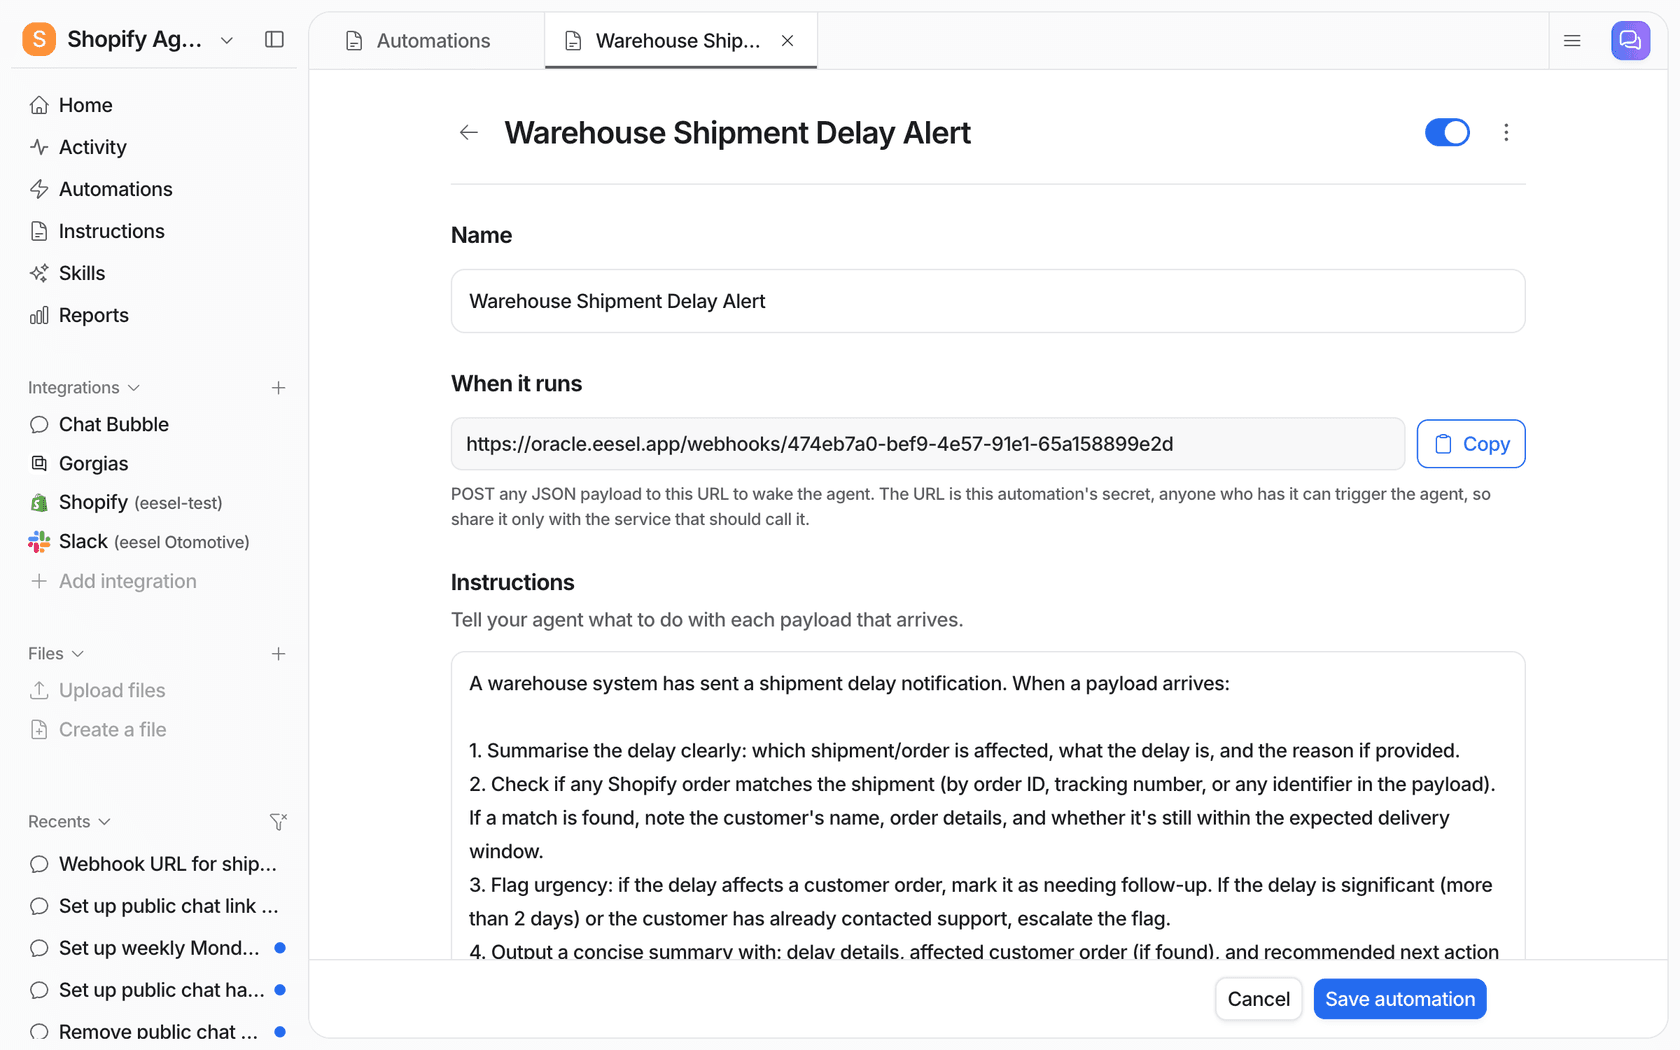
Im Beispiel der Doku trifft ein Payload zu einer Lieferverzögerung ein, der Agent sucht die passende Shopify-Bestellung, findet sie nicht und eröffnet ein getaggtes Gorgias-Ticket für das Team. Das sind drei Systeme in einem Durchlauf, ohne dass ein Mensch Daten zwischen Tabs kopiert.
Schritt 7: An eigenen vergangenen Tickets testen, bevor du live gehst
Integrationstests für einen KI-Agenten bedeuten nicht „liefert die API 200 zurück“. Sie bedeuten „gibt der Agent die Antwort, die mein Team gegeben hätte, mit den Daten, die er jetzt erreicht“. Die besten Testdaten sind die gelösten Tickets des letzten Monats. Die vollständige Methode wiederhole ich hier nicht, denn es gibt einen ganzen Beitrag zur Auswahl eines KI-Support-Agenten, der sie behandelt, aber drei Prüfungen sind integrationsspezifisch:
- Tickets auswählen, die jedes System brauchen. Wenn 30 % deiner Tickets Bestellstatus betreffen, sollten es auch 30 % deines Testsets sein. Sonst testest du nur das Help Center.
- Die Aktionen prüfen, nicht nur die Worte. Kontrolliere, welche Abfragen und Schreibvorgänge der Agent versucht hat und gegen welchen Datensatz. Eine perfekte Antwort auf Basis der falschen Bestellung ist ein Fehler.
- Die Lücke pro Thema bewerten. In eesel spielt der Simulations-Skill gelöste Tickets erneut ab und vergleicht jede Antwort mit dem, was dein Team tatsächlich gesendet hat. Der Beispiellauf der Doku nahm 20 Tickets als Stichprobe, 17 stimmten überein, dazu eine Rangliste von Korrekturen für den Rest (Helpdesk-Doku). Die Fehlschläge deuten meist direkt auf eine fehlende Integration.
Schritt 8: Eine Ebene nach der anderen ausrollen
Schalte Dinge in derselben Reihenfolge ein, in der du sie verbunden hast, und erweitere den Zugriff erst, wenn die vorherige Ebene eine Weile sauber gelaufen ist.
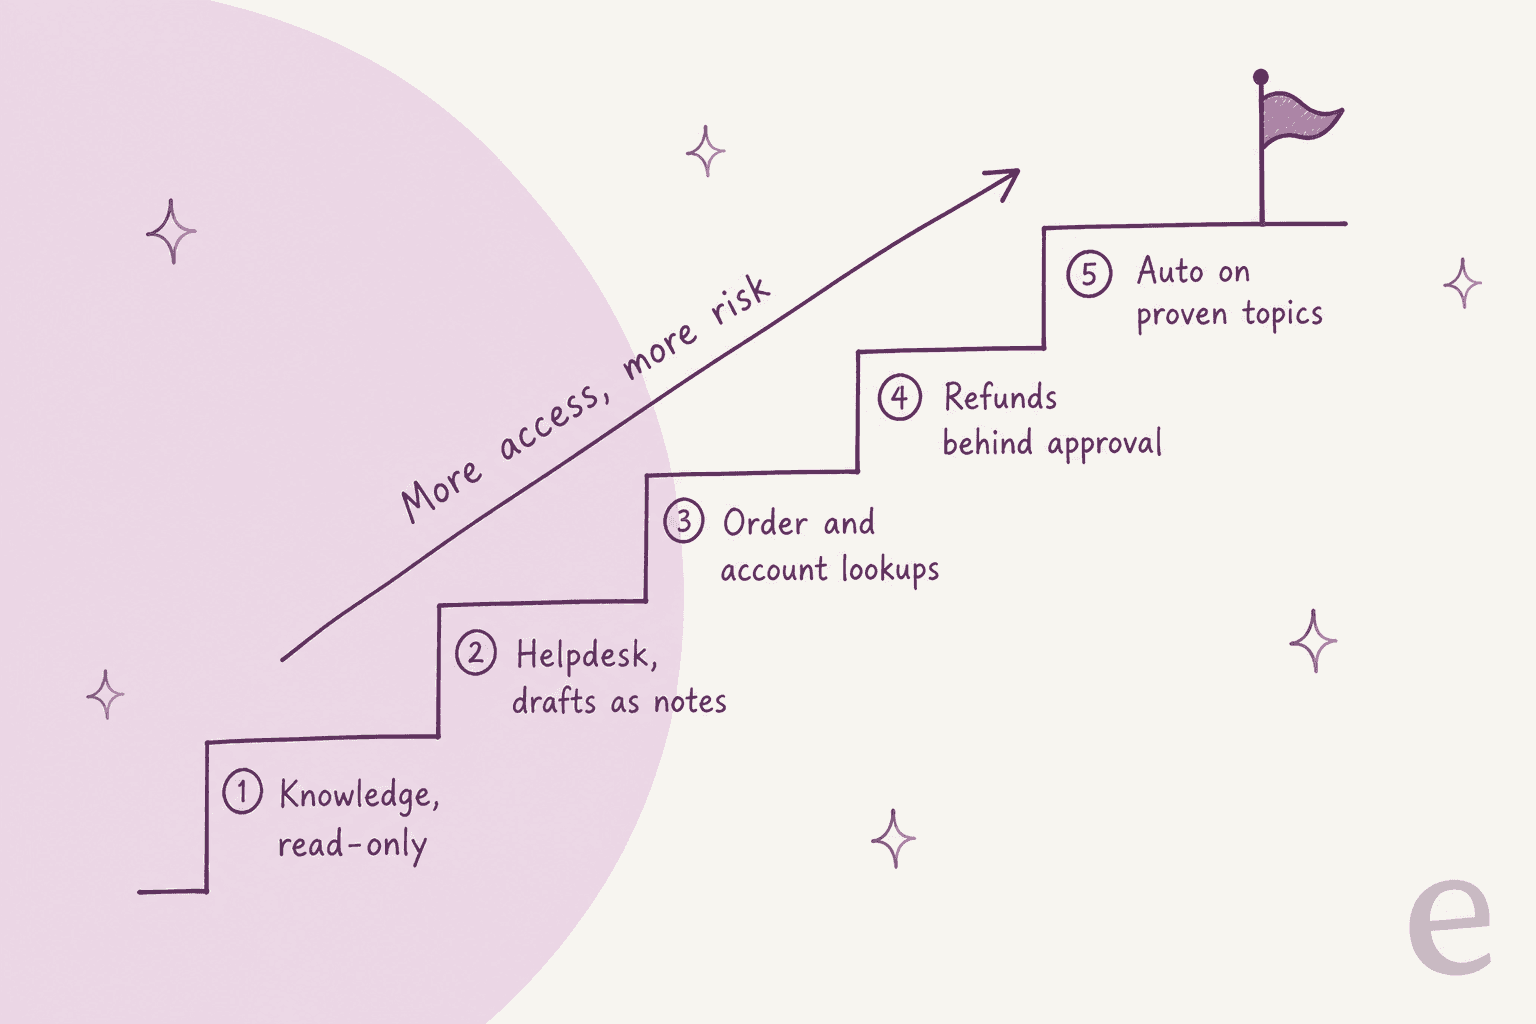
- Wissen, nur lesend. Stelle ihm intern Fragen. Kein Kunde sieht etwas.
- Helpdesk, Entwürfe als interne Notizen. Agenten lesen, bearbeiten und senden.
- Bestell- und Kontoabfragen. Entwürfe enthalten jetzt echten Bestellstatus und Tracking.
- Erstattungen und Änderungen hinter Freigabe. Der Agent bereitet die Aktion vor, ein Mensch klickt auf Freigeben. Bei eesel kann die Freigabe im Dashboard, in einem Slack-Thread oder im Terminal mit
eesel approvalserfolgen. - Automatisch bei bewährten Themen. Nur für Tickettypen, bei denen die Entwürfe seit Wochen unverändert gesendet werden.
Das deckt sich mit dem, was erfahrene Praktiker empfehlen:
„Der sicherste Rollout, den ich gesehen habe: den Agenten entwerfen lassen, Konfidenz plus Begründung taggen, für Erstattungen oder Kontoänderungen eine Freigabe verlangen und im ersten Monat jede wieder geöffnete Konversation prüfen. In diesem Prüfprotokoll zeigt sich meist die echte Automatisierungsgrenze.“
Plane die Übergabe gleich mit. Wenn der Agent ein Ticket an einen Menschen weitergibt, sollte dieser eine Zusammenfassung dessen erhalten, was der Agent schon nachgeschlagen hat, kein rohes Transkript. Der Leitfaden zur Agent-Übergabe enthält Muster dafür, und der Automatisierungsleitfaden zeigt, welche Tickettypen du zuerst automatisieren solltest.
Wo MCP, APIs und CLIs hineinpassen
Du hörst gerade oft „nimm einfach MCP“, hier also die schlichte Version. MCP, das Model Context Protocol, ist „ein Open-Source-Standard, um KI-Anwendungen mit externen Systemen zu verbinden“ (modelcontextprotocol.io). Ein MCP-Server stellt Tools (Aktionen, die eine KI aufrufen kann) und Ressourcen (Daten, die sie lesen kann) in einer einheitlichen Form bereit, sodass jeder MCP-fähige Client sie nutzen kann. Es ist ein saubererer Weg, die Ebenen „Lesen“ und „Handeln“ zu verdrahten, aber kein Ersatz für das Nachdenken über Berechtigungen von oben. Die aktuelle Spezifikation sagt sogar „Autorisierung ist für MCP-Implementierungen OPTIONAL“ (MCP-Autorisierungsspezifikation), also prüfe, wie jeder Server, den du verbindest, damit umgeht.
Die Anbieter sind hier schnell unterwegs. Atlassians Rovo-MCP-Server deckt Jira, Confluence und mehr ab, nutzt OAuth 2.1 und respektiert die bestehenden Berechtigungen der Nutzer (Atlassian-Doku). Shopify hat seine MCP-Tools für Warenkorb und Katalog im Storefront bereits auf einen neuen Universal-Commerce-Protocol-Endpunkt verlegt (Shopify Storefront MCP). Rechne damit, dass sich Endpunkte weiter verschieben, und bevorzuge eine Plattform, die sie für dich pflegt, statt jeden von Hand zu verdrahten. Einen längeren Erklärtext gibt es zu MCP für den Kundensupport.
MCP funktioniert auch in der Gegenrichtung: Dein Support-Agent kann selbst ein MCP-Server sein, mit dem andere KI-Tools sprechen. So funktioniert eesel, und deshalb gibt es die eesel CLI.
Die gesamte Integration vom Terminal aus einrichten
Die eesel CLI bringt dasselbe KI-Teammitglied in dein Terminal. Sie ist kein separates Produkt und keine Kopie: „Alles, was du in der CLI einrichtest, erscheint im Dashboard, und umgekehrt.“ Das zählt bei Integrationsarbeit, denn das Setup aus diesem Beitrag wird zu einem Skript, das du prüfen, erneut ausführen und einem Coding-Agenten übergeben kannst. Ein Setup aus Helpdesk und Shop sieht so aus:
npx @eesel/cli login                       # or: npm install -g @eesel/cli
eesel integrations connect zendesk         # prints an approval link for a Zendesk admin
eesel integrations connect shopify         # a store owner approves the app install
eesel integrations download start          # copy past tickets, macros and pages into knowledge
eesel integrations zendesk actions         # every action, with its auto / ask / off setting
eesel integrations api check               # custom API access for your own systems
eesel automations                          # what wakes the agent, and the instructions it follows
eesel approvals                            # held actions waiting on a human
eesel activity                             # what the agent actually did, newest first
Ein paar Details machen sie für Automatisierung gut geeignet. Jeder Befehl gibt JSON aus. Fehler kommen als eine JSON-Zeile mit einem hint zurück, der sagt, was stattdessen auszuführen ist, und genau so können Claude Code, Cursor oder Codex das Setup ausführen, ohne dass ein Mensch die Doku lesen muss. Schreibvorgänge aus der CLI folgen denselben Freigabe-Einstellungen wie das Dashboard, --dry-run gibt den genauen Aufruf aus, den ein Schreibvorgang senden würde, ohne ihn abzuschicken, und mit EESEL_API_TOKEN plus EESEL_AGENT_ID läuft sie in CI. Der eine Schritt, den sie nicht überspringen kann, ist die menschliche Freigabe in jedem Tool, und so soll es sein: Ein Zendesk-Admin muss weiterhin auf „Zulassen“ klicken.
Für MCP-Clients gibt eesel mcp token eine fertig einfügbare claude mcp add-Zeile aus. Der Token gilt 30 Tage und trägt deine Workspace-Rolle, sodass ein Viewer chatten und Aktivität lesen kann, während nur Editoren Anweisungen oder Automatisierungen ändern können (MCP-Client-Doku). Meine Kollegen haben mehr zum Steuern von Agenten per CLI und allgemein zu KI-Agent-MCP-Servern.
Fehler, die ich vermeiden würde
- Mit dem eigenen Admin-Login verbinden. Der Agent erbt alles, was du sehen kannst. Nutze OAuth mit einer eigenen, schmalen Identität.
- Das ganze Wiki verbinden. Wähle die Spaces und Ordner, hinter denen du vor einem Kunden stehen würdest. Alte Entwürfe werden zu selbstsicheren falschen Antworten.
- Schreibzugriffe schon am ersten Tag einschalten. Erst Abfragen, Schreibvorgänge hinter Freigabe, automatisch zuletzt.
- Annehmen, dass die Synchronisierung live ist. Finde heraus, wie jede Quelle aktualisiert wird und woran du einen Ausfall bemerkst.
- Geteilte Rate-Limits vergessen. Deine KI, deine CRM-Synchronisierung und dein Reporting-Tool ziehen alle aus demselben Helpdesk-API-Budget.
- Den Agenten Aktionen beschreiben lassen, die er nicht ausführen kann. Wenn er keine Bestellungen stornieren kann, sollten das seine Anweisungen sagen.
- Preise, die Integration bestrafen. Frage, ob eine Bestellabfrage, eine CRM-Prüfung oder ein Tool-Aufruf als zusätzliche Nutzung zählt. Manche Zähler rechnen jede Nachricht oder Aktion ab.
eesel in den Stack einbinden, den du schon hast
Wenn du diese Liste abarbeitest und nicht jeden Konnektor von Hand bauen willst, ist der KI-Helpdesk-Teamkollege von eesel genau dafür gemacht. Er arbeitet in deinem bestehenden Helpdesk (Zendesk, Freshdesk, Gorgias, HubSpot, Salesforce und mehr), lernt aus deinen früheren Tickets, liest Confluence, Notion und Google Drive, schlägt echte Bestellungen in Shopify nach und erreicht deine eigenen APIs über eine Allowlist. Jede Aktion steht auf automatisch, erst fragen oder aus, und Freigaben können aus Slack, dem Dashboard oder der CLI kommen. Wenn Zendesk dein Helpdesk ist, zeigt die Zendesk-Integrationsseite die vollständige Liste dessen, was er lesen und tun kann.
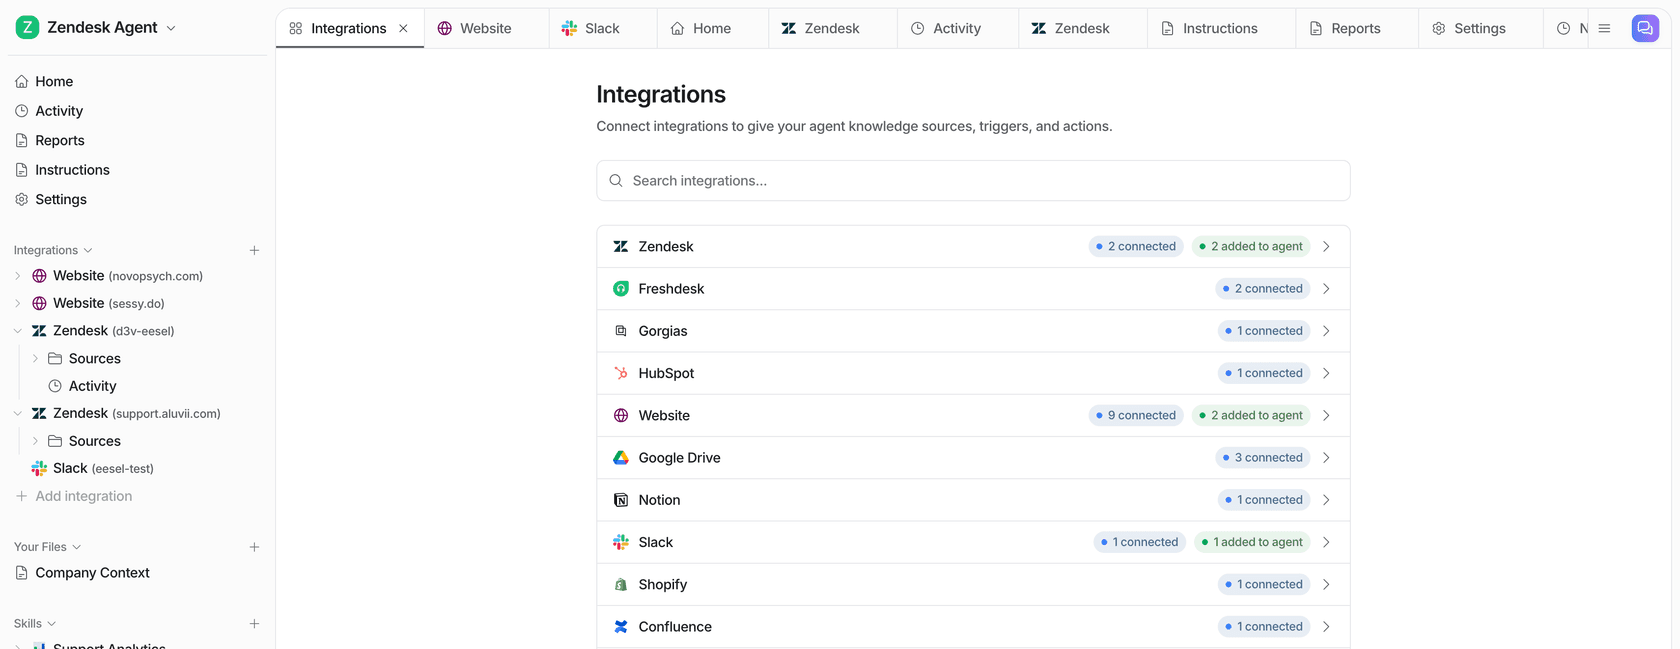
Auch die Preise passen zu integrationslastiger Arbeit. Auf der Preisseite von eesel ist ein Ticket ein Credit, „egal wie viele Antworten hin- und hergehen und was der Agent darin tut: eine Bestellung nachschlagen, eine Richtlinie prüfen, ein anderes Tool aktualisieren.“ Die Tarife beginnen bei 299 $ im Monat für 500 Credits, jede Integration ist enthalten, und der kostenlose Tarif gibt dir 100 Credits, um deinen Helpdesk zu verbinden und echte Entwürfe zu sehen, bevor du zahlst.
Probiere eesel an deinem eigenen Stack aus oder buche eine Demo, wenn ich oder ein Kollege dein Setup gemeinsam mit dir durchgehen soll.
Häufig gestellte Fragen
Wie integriere ich einen KI-Agenten in meinen Unternehmens-Stack?
Welche Systeme sollte ich zuerst an einen KI-Support-Agenten anbinden?
Wie integrieren sich KI-Agenten mit Zendesk, Shopify und Slack?
read_orders deckt nur 60 Tage an Bestellungen ab. Es gibt eigene Leitfäden zur Integration von KI mit Zendesk und zur Integration von KI mit Shopify.