

Não existe um único número de precisão para um chatbot de IA em serviços financeiros; um número só tira a média de perguntas muito diferentes. Explicar o que significa a CET é fácil. As respostas que dependem da tabela de taxas vigente, de uma taxa de juros em tempo real, do nível de conta do cliente ou de uma exceção são onde os bots erram com confiança, geralmente por causa de uma fonte desatualizada ou errada, não de um modelo fraco. Então a precisão se decide pelo roteamento: documentos aprovados para conceitos, sistemas em tempo real para fatos da conta, uma pessoa para isenções e disputas, e uma reprodução dos seus tickets antigos antes do lançamento. O colega de helpdesk da eesel trabalha assim, testado primeiro nos seus próprios tickets.
Quão precisos são os chatbots de IA em serviços financeiros?
A resposta honesta é "depende da pergunta", e isso não é uma fuga. Eu construo os agentes de IA na eesel, e a coisa mais útil que aprendi observando-os responder tickets reais é que precisão não é um número, são quatro, um para cada tipo de pergunta que um cliente faz.
Bancos operam chatbots há anos. O relatório da CFPB sobre chatbots em finanças do consumidor constatou que os 10 maiores bancos comerciais dos EUA os usam, e que mais de 98 milhões de pessoas, cerca de 37% da população americana, usaram o chatbot de um banco em 2022. Sua conclusão principal é a que importa aqui: os chatbots "may be useful for resolving basic inquiries, but their effectiveness wanes as problems become more complex".
Isso combina com o que eu vejo. Veja como as perguntas se dividem:
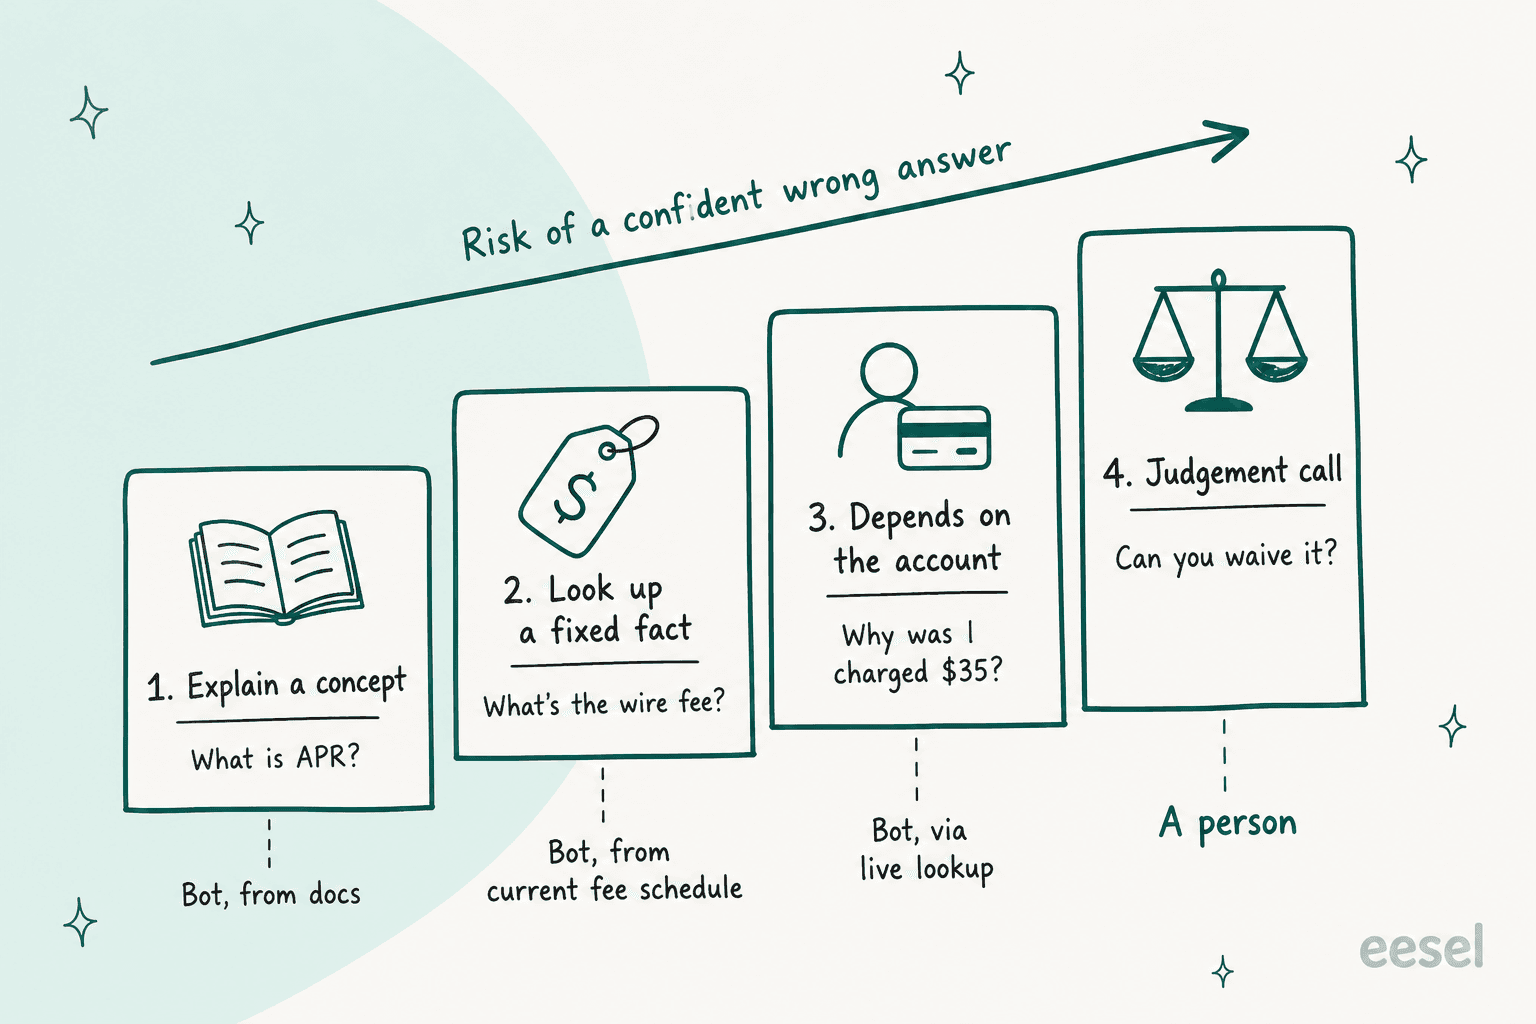
| Tipo de pergunta | Exemplo | Risco de resposta errada | Fonte correta | O que o bot deveria fazer |
|---|---|---|---|---|
| Explicar um conceito | "O que é a CET?" | Baixo | Artigos de ajuda aprovados | Responder e linkar o artigo |
| Consultar um fato fixo | "Qual é a taxa de transferência internacional?" | Médio: documentos desatualizados ou duplicados | A tabela de taxas vigente, com um responsável e data | Responder somente a partir da versão vigente |
| Depende da conta | "Por que fui cobrado 35 dólares ontem?" | Alto: a página de taxas não tem como saber | Consulta em tempo real de transação ou conta | Consultar, citar o registro, ou transferir |
| Decisão de julgamento | "Vocês podem isentar isso?" | O mais alto: é uma decisão, não um fato | Uma pessoa com autoridade | Coletar os detalhes e transferir |
Um bot pode ter uma pontuação quase perfeita na primeira linha e continuar perigoso na terceira. Se um fornecedor te der uma única porcentagem combinada, pergunte qual parte do conjunto de teste eram perguntas do tipo "o que é a CET".
A eesel vem colocando agentes de IA em filas de suporte reais há anos, e esse padrão se mantém fora do setor financeiro também. Em um teste com tráfego real em uma caixa de entrada de e-commerce, a equipe da eesel revisou cada rascunho que os agentes de suporte reescreveram. A maioria das reescritas era sobre tamanho e tom. Cerca de 20% precisava de dados que o bot não conseguia ver, como registros de pedidos e logística, e só cerca de 5% eram casos em que o bot errou o fato por conta própria. Em outras palavras, a maioria dos problemas de "precisão" eram problemas de dados faltantes. Em finanças, os dados faltantes são a tabela de taxas, a conta e o histórico de transações.
Se sua equipe usa agentes de código, a CLI da eesel permite que um deles faça o trabalho de configuração: suba suas tabelas de taxas e documentos de política aprovados, depois faça perguntas de teste ao agente sobre cada taxa e confira as respostas antes de qualquer coisa ir ao ar. Conectar seu helpdesk ainda precisa de alguém com acesso de admin para aprovar.
Por que chatbots financeiros erram taxas e juros?
Porque um modelo de linguagem responde com fluência o que lhe é dado, independentemente de a fonte estar certa. O perfil de IA generativa do NIST chama isso de confabulação: "confidently stated but erroneous or false content", mais conhecido como alucinações. Em um bot de suporte, eu vejo isso vir de cinco lugares.
- Um documento desatualizado vence a busca. Em um pipeline de recuperação típico, a tabela de taxas do ano passado ainda está na central de ajuda, e combina melhor com as palavras do cliente do que a nova. O bot a cita com total confiança.
- Dois níveis se misturam. A conta premium isenta taxas de caixa eletrônico, a básica não. As duas páginas mencionam taxas de caixa eletrônico, e o bot as mistura em uma resposta que não é verdadeira para ninguém.
- O bot faz a conta. Valores de liquidação, juros proporcionais e conversões de moeda são aritmética, e modelos de linguagem não são calculadoras.
- A pergunta precisa de dados de conta que o bot não tem. "Por que fui cobrado" não pode ser respondido a partir de uma página de taxas. Um bot sem consulta de transações vai chutar a taxa mais provável em vez da real.
- A recuperação não retorna nada e o bot preenche a lacuna. A eesel já viu isso em implantações reais: quando a base de conhecimento não tinha nada relevante, um agente inicial respondia a partir de conhecimento geral em vez de dizer isso. É por isso que uma resposta padrão rígida de "não tenho essa informação" hoje faz parte de como configuramos os agentes.
O ponto da matemática é subestimado. Aqui está a tentativa de um usuário do Hacker News de obter um valor de pagamento do ChatGPT:
"I asked it to calculate my total mortgage payments over 10 years for $100,000 at 2% interest. The result ($102,945.60) looked a bit suspicious to me. But it gets really interesting with 4.5% interest."

A 4,5%, o modelo passou a produzir um pagamento mensal negativo e depois explicou por que isso fazia sentido. Ninguém deveria citar a um cliente um valor de liquidação a partir da própria conta de um modelo de linguagem. O número tem que vir do sistema de empréstimos, e o trabalho do bot é repeti-lo.
O risco maior é que os clientes acreditem nessas respostas, venham elas do bot de um banco ou do ChatGPT em finanças. Outro comentarista em um fórum de finanças pessoais colocou assim:
"Our robot overlords are terrible at anything financial. I'm on a financial forum where, lately, people are constantly posting stuff that they got from The Oracle and asking what they're doing wrong because they don't understand the result, and the answer is inevitably that ChatGPT or whatever fed them plausible-looking rubbish"
"Com aparência plausível" é o problema em uma frase. Uma taxa errada em uma resposta confiante e bem formatada se lê exatamente como uma correta. O guia sobre prevenção de alucinações e o artigo sobre manter um agente com os pés no chão vão mais a fundo na mecânica geral. Em finanças, todas as cinco causas acima remontam a uma pergunta: de onde veio essa resposta?
Quem é responsável quando um chatbot dá uma resposta errada?
A empresa que o implantou. O caso que todos citam não é de um banco, mas é a decisão mais clara que existe.
Em Moffatt v. Air Canada (2024 BCCRT 149, decidido em 14 de fevereiro de 2024), o Tribunal de Resolução Civil da Colúmbia Britânica analisou um chatbot que disse a um cliente enlutado que ele poderia solicitar retroativamente uma tarifa de luto, dentro de 90 dias da compra da passagem. A própria página de tarifa de luto da companhia aérea, para a qual o chatbot linkava, dizia o contrário. A Air Canada argumentou que não poderia ser responsabilizada pelo que seu chatbot disse. O tribunal chamou isso de "a remarkable submission", concluiu que a companhia não tomou o cuidado razoável para garantir a precisão do chatbot, e a condenou a pagar US$ 812,02, incluindo US$ 650,88 em danos. A frase que as equipes financeiras deveriam lembrar: "It makes no difference whether the information comes from a static page or a chatbot."
Observe o mecanismo. Ao bot não faltava a política correta. Ele tinha a página correta ali mesmo e ainda assim produziu uma resposta contraditória. Essa é a falha número dois da lista acima, duas fontes discordando, e é a forma mais comum de uma resposta sobre taxas dar errado.
Os reguladores financeiros dizem o mesmo com suas próprias palavras:
- CFPB (EUA). Os chatbots "must comply with all applicable federal consumer financial laws, and entities may be liable for violating those laws when they fail to do so". O relatório também aponta bots que não reconhecem disputas, prendem pessoas em "doom loops" e dão informações imprecisas, e observa que sistemas automatizados "may be less likely to waive fees".
- FCA (Reino Unido). Sua página AI good and poor practice, atualizada em 20 de outubro de 2026, lista como boa prática empresas que "limited chatbots and generative AI assistants to approved source material, with checks and escalation routes". Como má prática, lista empresas que "overstated the accuracy, reliability or role of AI systems".
- UE. Segundo as regras de transparência da Lei de IA, em vigor desde agosto de 2026, as pessoas que usam um chatbot devem saber que estão falando com uma máquina.
Nada disso proíbe chatbots. Significa que você responde por cada resposta, então precisa saber quais respostas seu bot pode dar. O guia da Lei de IA da UE, o artigo sobre suporte regulado e a lista de verificação de SOC 2 e GDPR cobrem o lado da conformidade com mais detalhes.
De onde cada resposta deveria vir?
Essa é a parte em que eu gastaria mais tempo, porque é onde a precisão se decide. Toda pergunta que seu bot pode responder deveria mapear para exatamente uma fonte de verdade antes de ir ao ar.
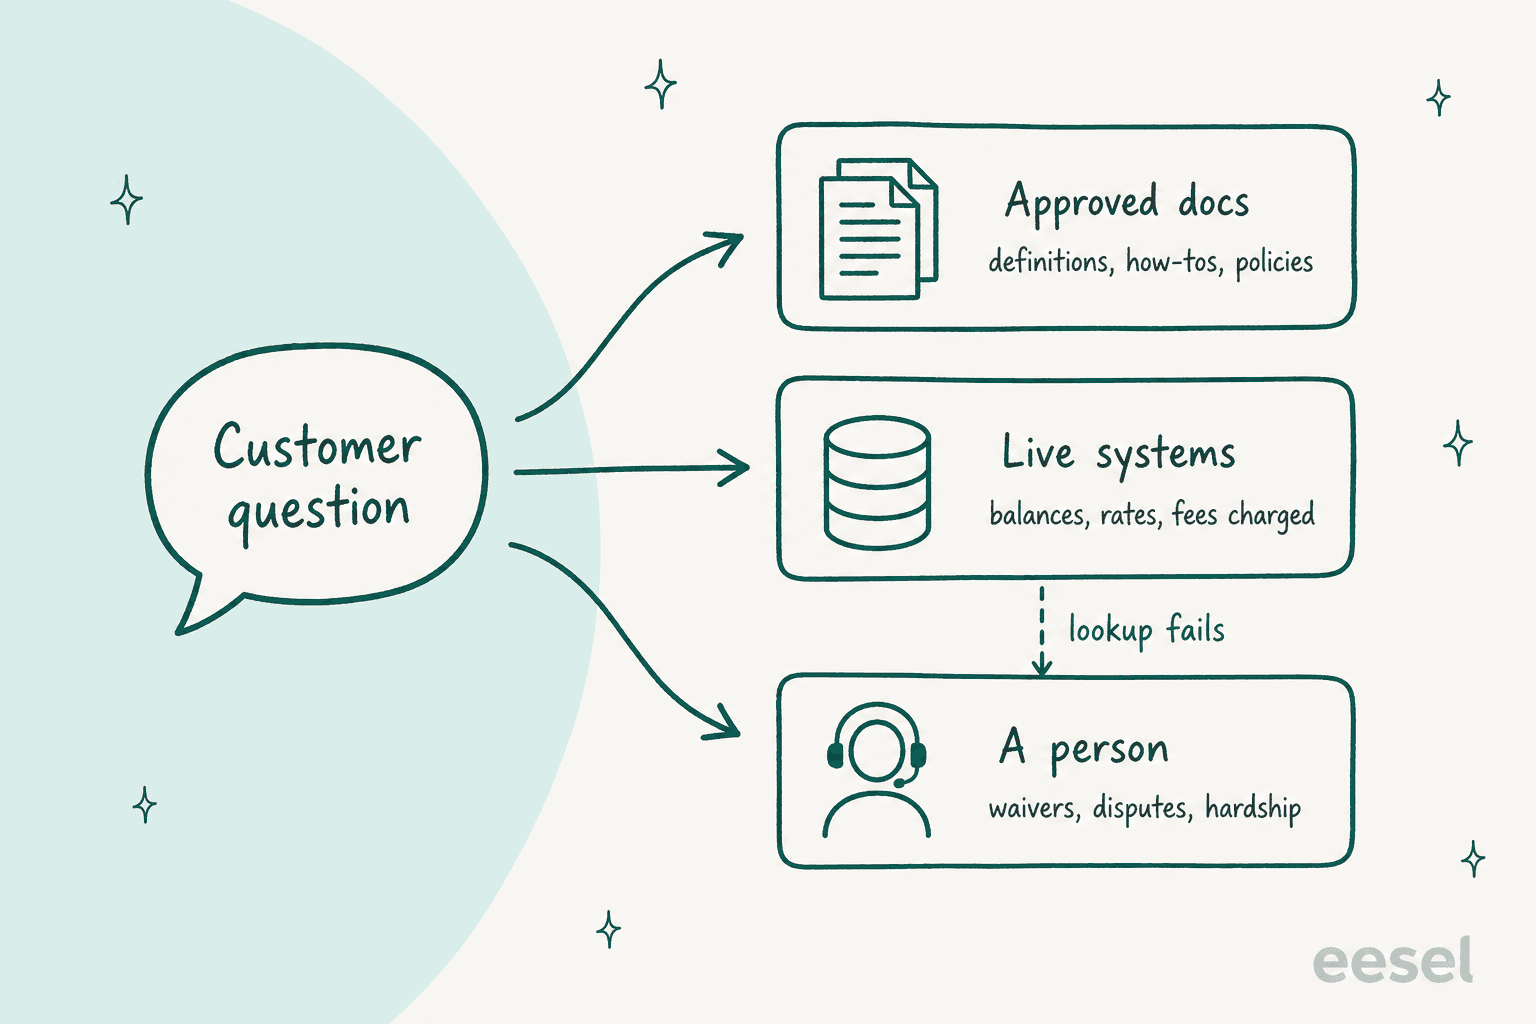
Documentos aprovados carregam conceitos, guias e políticas publicadas. Cada documento precisa de um responsável, uma versão e uma data de vigência, e a versão antiga tem que deixar o conhecimento do bot no dia em que a nova começa. Quando duas versões de uma página de taxas são pesquisáveis ao mesmo tempo, o bot não tem como saber qual é a vigente. Uma auditoria de base de conhecimento regular e ferramentas para detectar conteúdo desatualizado fazem mais pela precisão do que qualquer atualização de modelo. O guia de uma base de conhecimento de IA para fintech explica como estruturá-la.
Sistemas em tempo real carregam tudo que é específico de um cliente ou muda diariamente: saldos, a taxa realmente cobrada, a taxa de juros atual, uma cotação de liquidação, o status de um pagamento. O bot os alcança por meio de ações, ou seja, consultas de API que ele tem permissão de fazer. A integração da eesel com o Stripe, por exemplo, permite que o agente leia faturas, pagamentos e assinaturas para responder uma pergunta de cobrança diretamente a partir do registro. O artigo sobre IA para suporte de cobrança no Stripe mostra como isso funciona. Se a consulta falhar, o bot diz isso e transfere. Nunca recorre à página geral de taxas.
Uma pessoa carrega decisões: isenções, reembolsos fora da política, acordos por dificuldades financeiras, disputas e reclamações. Mais sobre isso na próxima seção.
É assim que a smava, uma plataforma de comparação de empréstimos de Berlim, opera a eesel no Zendesk. Cerca de 27.000 tickets por mês chegam entre a smava e a Finanzcheck, quase todos em alemão. O próprio posicionamento da smava é direto: isso é finança regulada, então a redação importa. A eesel elabora rascunhos a partir de cerca de 820 macros e artigos da central de ajuda, separados por marca, e o agente de rascunhos usa o texto exato da macro correspondente. Respostas prontas para o cliente só vão para tickets sem um consultor de crédito designado, cerca de 1.100 dos 27.000 por mês. As instruções dos agentes proíbem prometer que a equipe vai verificar, encaminhar ou providenciar algo, e o agente de rascunhos não pode afirmar ter pesquisado se não pesquisou. A liberdade do bot é estreita de propósito, e essa estreiteza é a estratégia de precisão.
O que um chatbot financeiro nunca deveria responder por conta própria?
Qualquer coisa que seja uma decisão em vez de um fato, e qualquer coisa em que o bot não consiga apontar para uma única fonte vigente. Minha lista padrão para uma fila financeira:
- Isenções de taxas e reembolsos fora da política escrita. O bot pode explicar a política. Não deveria decidir a exceção.
- Disputas e transações não reconhecidas. A CFPB marca especificamente bots que não reconhecem uma disputa ou apenas repetem a informação que o cliente está contestando. Reconhecer uma disputa e abrir o caso corretamente é trabalho do bot. Resolvê-la não é.
- Dificuldades financeiras, cobranças e vulnerabilidade. A orientação da FCA alerta contra supor que um LLM pode detectar vulnerabilidade de forma confiável sem testes.
- Decisões de elegibilidade e crédito. "Serei aprovado?" não é algo que um bot de suporte deveria responder.
- Qualquer resposta em que duas fontes discordem. Se o bot encontrar duas cifras de taxa, deveria transferir, não escolher uma.
- Cálculos. Liquidações, juros e conversões vêm do sistema de registro ou de lugar nenhum.
Escolha uma pergunta abaixo para ver onde ela se encaixa e o que o bot deveria fazer com ela.
Meu bot pode responder isso por conta própria?
Fonte: um artigo de ajuda aprovado.
O bot faz: responde diretamente e linka o artigo. Essa é a linha fácil, e de onde vem a maior parte da precisão em destaque de um bot.
Fonte: a tabela de taxas vigente, com responsável e data de vigência.
O bot faz: responde somente a partir da versão vigente. Se encontrar dois números diferentes, transfere em vez de escolher um. Páginas de taxas desatualizadas causam a maioria dos erros aqui.
Fonte: uma consulta de transação em tempo real.
O bot faz: consulta a cobrança real e cita o registro. Nunca chuta a partir da página de taxas. Se a consulta falhar, diz isso e transfere.
Fonte: uma pessoa com autoridade para decidir.
O bot faz: explica a política escrita, coleta a conta e o motivo, e transfere. Nunca promete uma isenção.
Fonte: uma cotação de liquidação do sistema de empréstimos.
O bot faz: solicita a cotação e repete o número. Nunca faz a conta de juros por conta própria.
Fonte: seu processo de disputa e uma pessoa.
O bot faz: reconhece isso como uma disputa, abre o caso ou o encaminha com os detalhes, e diz ao cliente o que vem a seguir. Abrir um caso deveria ser, no início, uma ação que exige aprovação.
Escrever esses limites é a parte fácil. O bot precisa segui-los, o que significa duas configurações: o que ele pode dizer e o que ele pode fazer.
O que ele pode dizer vive nas suas instruções. Na eesel, são regras em linguagem simples, e a mais importante para finanças é a regra de recusa: responder apenas a partir da documentação recuperada, e se nada relevante voltar, dizer que não tem essa informação.

O que ele pode fazer vive nas permissões de ação. Na eesel, cada ação é definida como Ativada, Perguntar antes ou Desativada, por agente, segundo a documentação de ações e aprovações. Para uma fila financeira, eu começaria com as consultas ativadas, qualquer coisa que mova dinheiro ou abra um caso em perguntar antes, e reembolsos desativados até você ter visto execuções suficientes. O artigo sobre limites de reembolso explica por que limites assim pertencem às configurações, não ao prompt.
A transferência em si também precisa funcionar. Compradores de suporte empresarial, incluindo um do setor de financiamento médico, disseram a mesma coisa à equipe de vendas da eesel: eles não aceitam uma IA que responda a tudo, mesmo com "não sei", e querem que ela só responda automaticamente quando puder resolver o ticket, encaminhando o resto. O lado do cliente de uma transferência quebrada se parece com isto:
"I told it to go get me a human and it said it would find a human... then put me through a questionnaire before telling me to call the main support line. sigh"
Esse é o "doom loop" da CFPB em pequena escala. Uma transferência deveria passar a conversa e os detalhes coletados para uma pessoa no mesmo canal. Os guias sobre escalonamento de chatbot, transferência para humano e limites de confiança cobrem a mecânica.
Para filas com muitas disputas, veja IA para disputas de cobrança e consultas de chargeback. Disputas de pagamento seguem o mesmo padrão: o bot reúne os fatos, uma pessoa decide.
Como testar a precisão antes do lançamento?
Reproduza seus próprios tickets antigos no bot e compare as respostas dele com o que sua equipe realmente enviou. Um benchmark genérico diz como um modelo se sai nas perguntas de outra pessoa. Seus tickets resolvidos dizem como esse bot se sai nas suas taxas, nos seus níveis de conta e na forma de falar dos seus clientes.
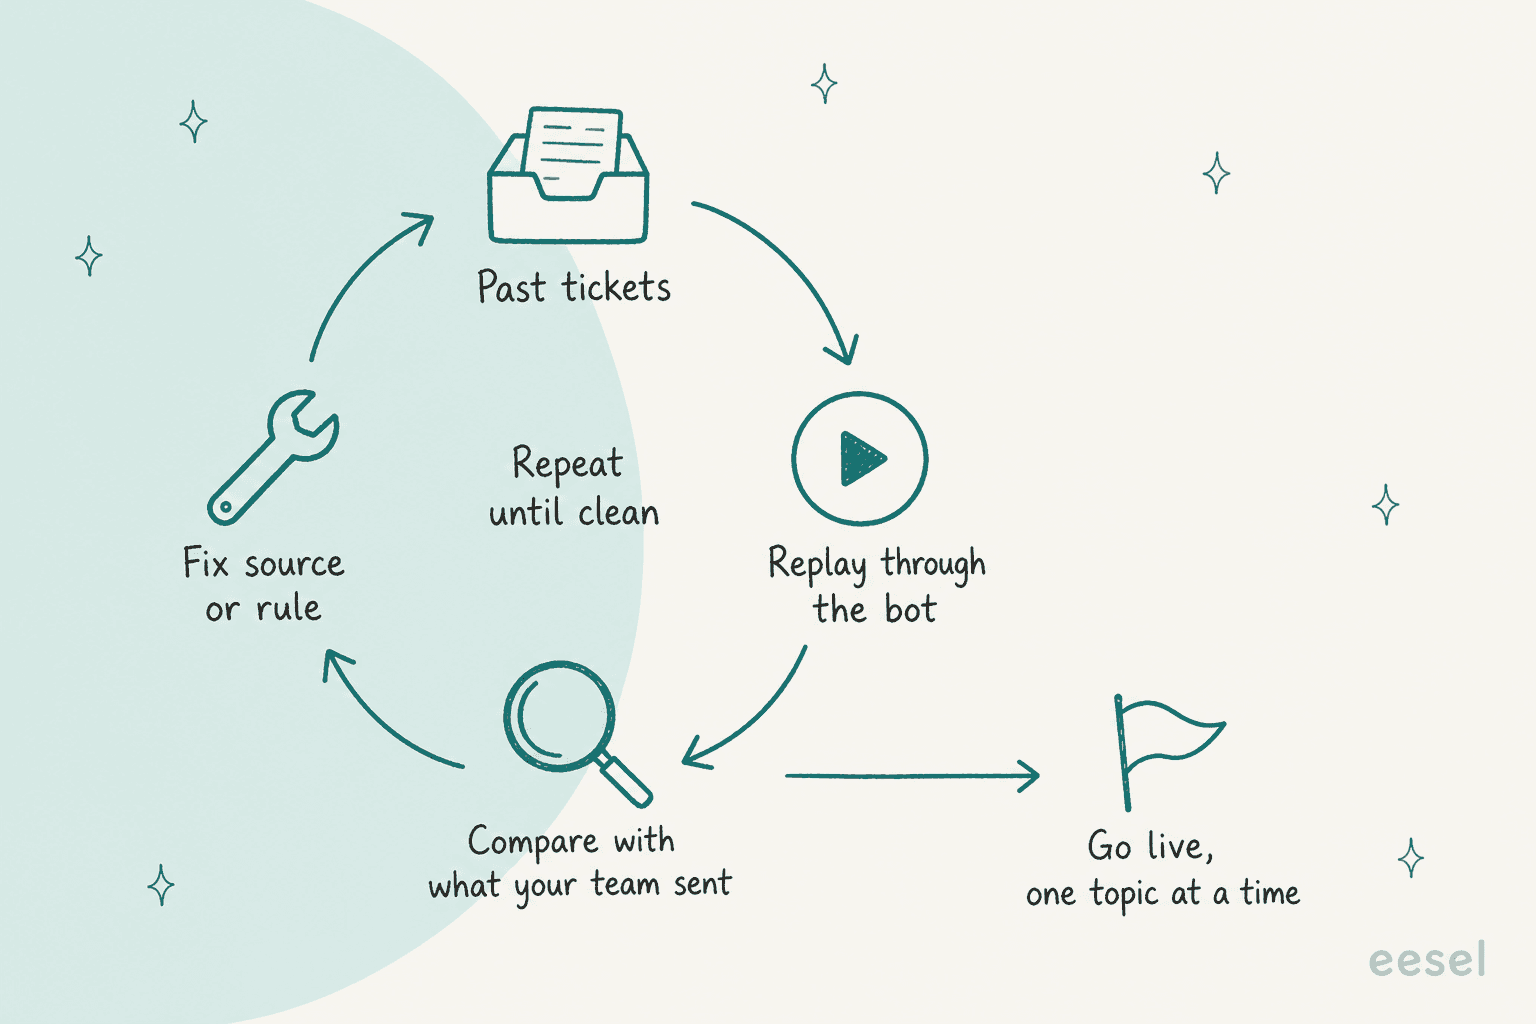
Aqui está a rotina que eu seguiria:
- Extraia algumas centenas de tickets resolvidos, com peso maior nas linhas de risco: perguntas de taxas, cobranças, perguntas de juros, disputas. Não deixe as redefinições de senha dominarem a amostra.
- Reproduza-os sem enviar nada. A simulação da eesel executa o agente completo sobre tickets reais ou gerados em um ambiente isolado e avalia cada resposta contra o que sua equipe enviou.
- Avalie por tema, não como uma única média. Uma pontuação geral de
90%pode esconder uma pontuação de60%em perguntas de taxas. A divisão por tema é o número que importa. - Rotule cada falha pela causa. Documento desatualizado, fontes misturadas, consulta faltante, regra de recusa faltante. Cada causa tem uma correção diferente, e nenhuma delas é "testar outro modelo".
- Corrija e reproduza os mesmos tickets. Teste novamente nos tickets que falharam, para saber que a correção funcionou na redação exata que a quebrou.
- Vá ao ar tema por tema, começando pela linha de explicar um conceito, e mantenha as linhas mais arriscadas como rascunhos para uma pessoa aprovar.
A FCA descreve a mesma ideia do lado do regulador. Sua lista de boas práticas inclui testar resultados para o consumidor em diferentes grupos de clientes e cenários, manter registros de prompts, saídas e decisões de escalonamento, e comparar o desempenho de um modelo com o processo conduzido por humanos. Empresas menores, ela observa, podem usar saídas de amostra e dados de teste cuidadosamente filtrados em vez de testar em escala total.
Os testes também não acabam no lançamento. A Qontro, uma empresa de ERP em nuvem na Nova Zelândia, usa a eesel como copiloto no Freshdesk: todo ticket recebe um rascunho, perguntas de cobrança vão direto para uma pessoa, e quando um ticket não tem informação suficiente para responder com confiança, a eesel diz isso em vez de chutar. A equipe compara cada rascunho com a resposta que uma pessoa realmente enviou, e onde um rascunho estava errado, geralmente aponta para um artigo de ajuda faltante ou uma regra a ser ajustada. Cerca de um em dez rascunhos agora sai com pouca ou nenhuma edição. Esse é um número lento e honesto, e a lacuna mostra à equipe exatamente onde trabalhar.
Para a parte contínua, os guias sobre revisar conversas de IA, QA de suporte com IA e testes adversariais cobrem o que ler a cada semana.
Observe também sua taxa de resolução com certa desconfiança: o artigo sobre deflexão vs. resolução explica por que uma conversa encerrada não é prova de uma resposta correta.
Teste a eesel para suporte financeiro
Se você vai colocar IA na frente de clientes que perguntam sobre taxas, juros e cobranças, a eesel é uma colega de helpdesk com IA que entra na sua fila existente no Zendesk, Freshdesk e outros helpdesks. Ela aprende com sua central de ajuda, macros e tickets antigos, responde apenas a partir do que recuperou, consulta dados em tempo real por integrações, e passa isenções e disputas para sua equipe com os detalhes já coletados.
A diferença para uma equipe financeira é o teste. Antes de um único cliente vê-la, a eesel reproduz seus tickets resolvidos e mostra, tema por tema, onde teria citado uma taxa errada ou perdido uma transferência. A smava a usa em 27.000 tickets de empréstimo por mês, com cada regra escrita nas instruções dos agentes, então mudar o que a eesel pode dizer é uma edição de texto, não um projeto. Os planos começam em US$ 299 por mês por 500 créditos após um teste gratuito de 7 dias, conforme os preços da eesel.
Para mais sobre o caso de uso financeiro, veja os guias sobre IA para suporte fintech, chatbots bancários e IA conversacional para bancos.
Teste a eesel nos seus próprios tickets antigos e veja quais perguntas de taxas ela acerta antes que seus clientes descubram.