
O que é o Level AI?
O Level AI é uma plataforma de contact center que pontua, treina e automatiza parcialmente as conversas com clientes. O discurso atual da página inicial é "full stack AI agents for the entire customer experience journey", mas quando você olha em torno de que o produto é realmente construído, ainda é controle de qualidade: verificar se os agentes seguiram o roteiro e a política, e mantiveram o tom que a sua equipe espera.
Primeiro alguns números, para você ter uma noção da empresa. O Level AI foi fundado por Ashish Nagar, ex-líder de produto na equipe Alexa da Amazon, e pelo CTO Sumeet Khullar. Levantou uma Série C de US$ 39,4 milhões em julho de 2024, liderada pela Adams Street Partners, elevando o total captado para US$ 73,1 milhões. Sua página About afirma mais de 1 bilhão de interações com clientes analisadas por ano em mais de 100 empresas. Os estudos de caso citam VistaPrint, Smartsheet e Extra Space Storage, e o post da Série C acrescenta Affirm, Penske e Carta.
Se você quer antes a visão mais ampla da empresa e do produto, comece pelo meu guia do Level AI. No G2, 162 das 220 avaliações estão na categoria Contact Center Quality Assurance, e a divisão por porte de empresa é bem clara: 123 avaliadores de médias empresas e 72 de grandes empresas, contra 23 de pequenas. Na prática, é uma ferramenta feita para equipes que têm um departamento de QA, e não para um suporte de duas pessoas.
Como avaliei o Level AI
Eu trabalho a fila de suporte da eesel todos os dias, então QA é a parte do suporte com a qual convivo: reler conversas, identificar a resposta que estava tecnicamente certa mas soou mal e descobrir se a correção é um problema de coaching ou de documentação. Escrever feedback de QA útil é metade do trabalho. Foi, mais ou menos, a lente que trouxe para esta avaliação.
O Level AI só é acessível por demo, não há teste gratuito nem central de ajuda pública, então não pude rodá-lo na minha própria fila. Em vez disso, li todas as páginas de produto e FAQs, as notas de versão do Q1 e Q2 de 2026, seis estudos de caso de clientes, a página de segurança e 220 avaliações do G2. Também percorri todos os marketplaces em que um preço poderia estar escondido. Onde as próprias páginas do Level AI se contradizem, eu aponto.
Mais um viés que devo declarar de antemão: a eesel passou anos colocando IA em filas de suporte ao vivo, e a lição que vi se firmar é que uma pontuação de IA só é tão boa quanto o teste por trás dela. Por isso toda implantação da eesel é simulada com tickets históricos antes de o agente responder a alguém, e por isso leio as alegações de precisão do Level AI com isso em mente.
O que o Level AI faz
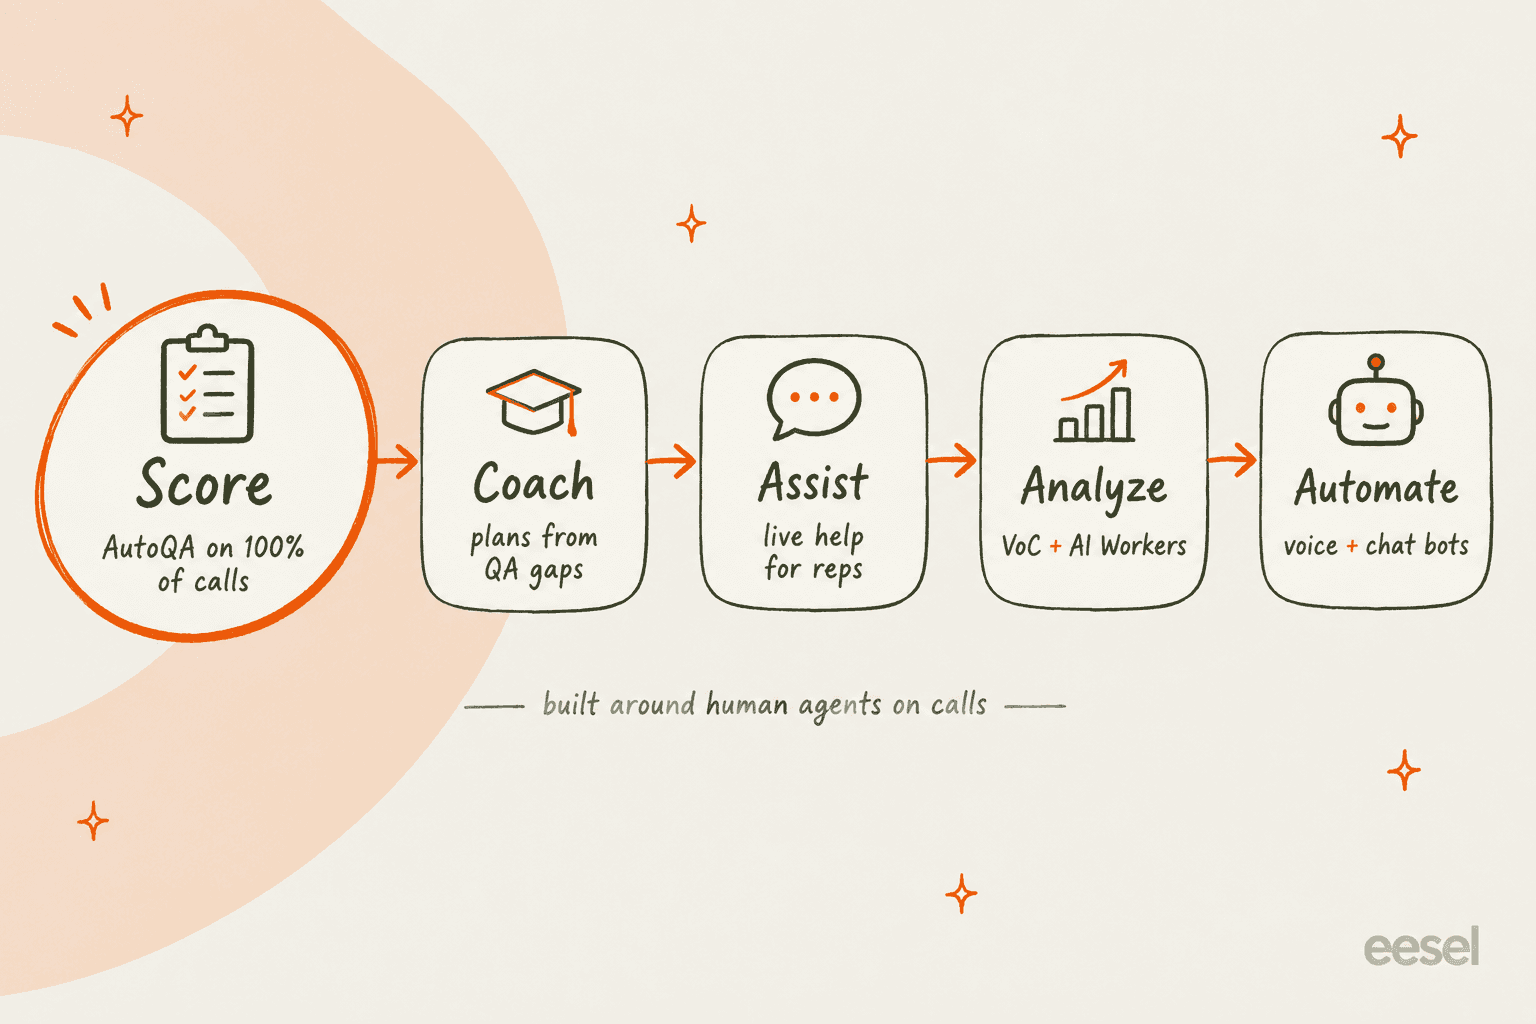
O Level AI vende uma plataforma com cinco funções coladas. A pontuação é a âncora aqui, e todo o resto ou a alimenta ou age sobre o que ela encontra.
AutoQA e QA-GPT: o produto central
O AutoQA é o principal motivo pelo qual a maioria das equipes acaba comprando o Level AI. A página do produto de QA promete pontuar "100 percent of calls, chats, emails, and bot conversations", contra uma base manual que o Level AI situa em "often around 1% to 3%" das interações. Essa diferença é, basicamente, todo o argumento a favor do QA assistido por IA.
O mecanismo de pontuação é o QA-GPT, que o Level AI descreve como um modelo proprietário treinado com os dados do seu contact center e capaz de "evaluate over 90% of the standards and metrics that scorecards cover". O que eu gosto é o quanto a mecânica do scorecard é prática no dia a dia:
- Mantenha o seu próprio scorecard. Você pode trazer uma rubrica existente (inclusive as que usa para relatórios externos) ou começar pela biblioteca de perguntas pré-treinadas do Level AI.
- Pontuação híbrida. Itens objetivos, como a saudação ou a verificação de identidade, são pontuados automaticamente. Itens subjetivos, como empatia, podem ir para uma pessoa, e depois ambos entram em uma única pontuação.
- N/A condicional. As perguntas podem ser desativadas por tipo de chamada ou departamento, para que uma disputa de cobrança não seja penalizada por não ter feito uma oferta de vendas.
- Evidência em cada resposta. Cada pontuação automática vem com a citação da transcrição e o carimbo de tempo em que se baseia.
- Correções que ensinam. Os avaliadores podem anular uma pontuação, e essas correções realimentam a forma como as conversas futuras são pontuadas.
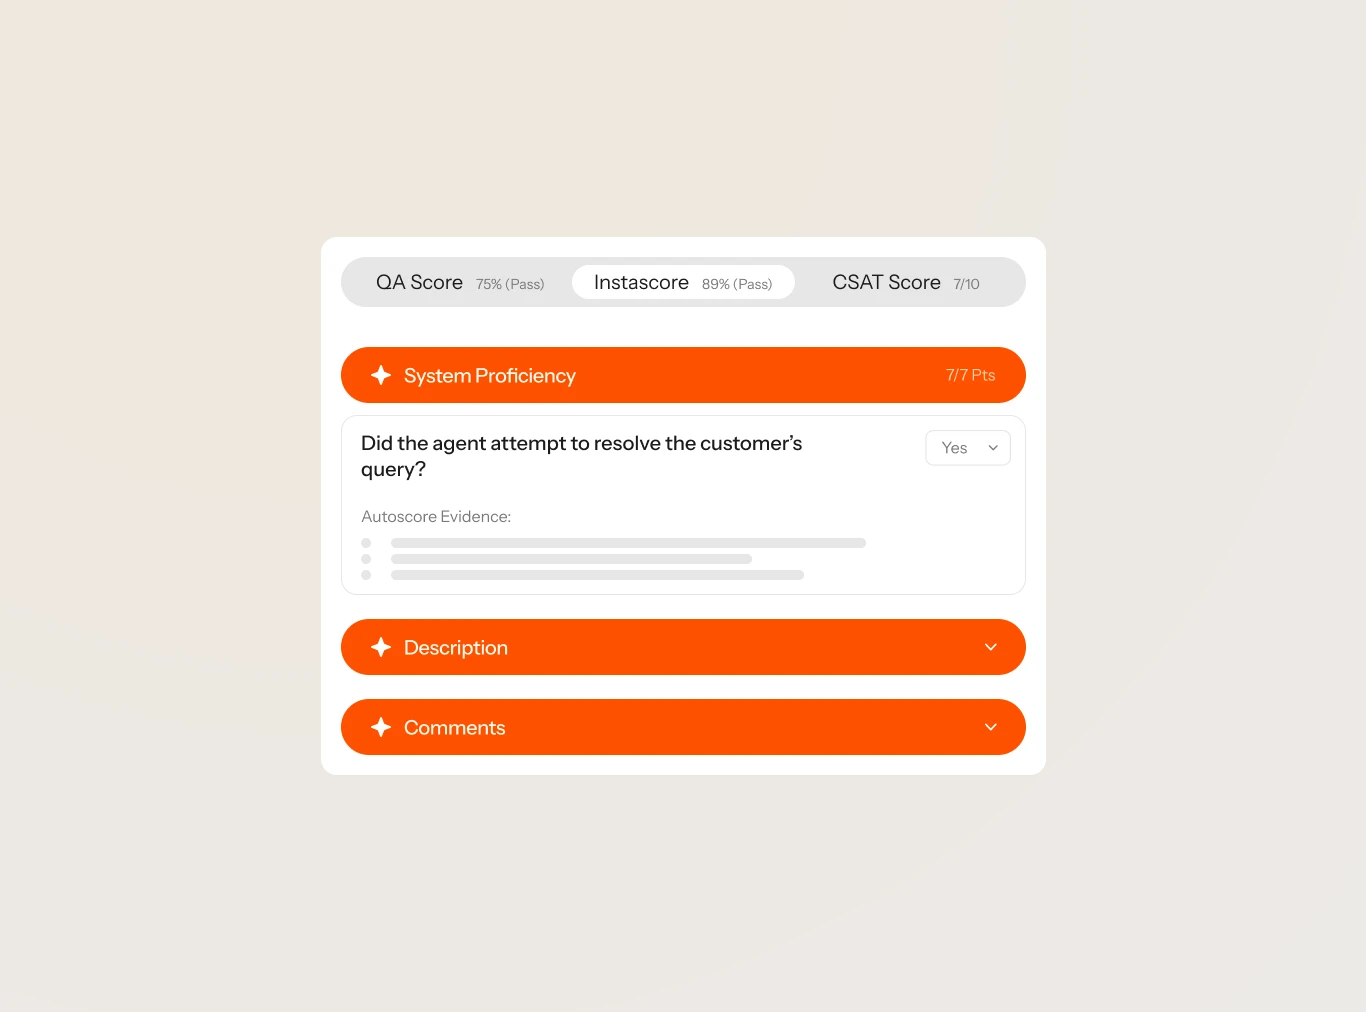
Para mim, esse rastro de evidências importa mais do que a manchete dos 100%. Se uma pontuação é algo em que dá para clicar e conferir, é uma pontuação que um líder de QA consegue defender diante de um agente. Se você está comparando abordagens, meu guia de QA para call center mostra como é uma rubrica defensável.
Duas coisas nas páginas do produto não batem entre si, e vale conhecê-las antes de sentar numa demo. A página de QA diz que o QA-GPT "even monitors agents' screens" para pontuar, enquanto a FAQ de gravação de tela diz que pontuar a partir de dados de tela ainda está no "product roadmap". E a página de QA afirma que as revisões são "10x faster", enquanto a landing de QA automatizado do Level AI diz "5x faster". Pergunte qual vale para a sua configuração.
Coaching e gravação de tela
O coaching vem depois da pontuação. O módulo de coaching filtra conversas por pontuação de QA, sentimento ou tópico, e os AI Workers redigem um plano de coaching personalizado que um gerente pode editar e enviar. É uma ferramenta para depois da chamada; a orientação ao vivo fica no Agent Assist.
A gravação de tela é a força mais discreta do produto e fácil de passar batido. Ela captura até quatro monitores com o que o Level AI chama de precisão de redação de "90%+", e é o recurso por trás de uma das melhores citações de clientes do site: o Global Director of Quality da Vista diz que ela "added 'eyes' to a process where we only had 'ears' before". Se o coaching de agentes é seu principal objetivo, note que um avaliador enterprise do G2 disse que o recurso de coaching "has not been used/adopted" na empresa dele.
Agent Assist para chamadas ao vivo
O Agent Assist é um copiloto para atendentes humanos durante uma chamada ou chat. Ele transcreve ao vivo, mostra a próxima melhor ação e o artigo de conhecimento certo, escreve resumos de chamadas e inclui o Phi, um bot de conhecimento que os agentes podem consultar no meio da conversa para obter uma resposta com citação. Os gerentes também recebem um painel ao vivo com o status e o sentimento de cada chamada, além de alertas de conformidade sempre que um atendente pula uma divulgação obrigatória.
O widget pode ser incorporado no Salesforce, Zendesk e Five9. Se você está avaliando essa categoria, meu panorama de ferramentas de agent assist o coloca ao lado das alternativas.
iCSAT, Voice of the Customer e AI Workers
O iCSAT é a pontuação de satisfação inferida do Level AI. Ele combina um modelo de sentimento, um modelo de esforço do cliente (repetições, transferências, tempo) e se o problema foi resolvido em uma única pontuação para cada conversa, sem precisar de pesquisa. É útil quando só uma fatia dos seus clientes responde a pesquisas, embora o Level AI não publique a ponderação nem qualquer número de validação. Meu texto sobre CSAT com IA explica a troca envolvida nas pontuações inferidas.
A camada mais nova são os AI Workers, lançados em maio de 2026. São agentes específicos por função que respondem a perguntas sobre os dados das suas conversas, como "What are the top reasons for customers asking for a refund?", e o Level AI diz que quase 100 equipes de CX enterprise tinham feito mais de 25.000 execuções de workers no lançamento. Um limite que vale registrar, segundo o lançamento dos custom workers: você ainda não pode enviar seus próprios documentos de política ou conhecimento para um custom worker.
Agentes virtuais para voz e chat
O Level AI também constrói bots que atendem o cliente diretamente. A página do agente virtual descreve "humanlike voice and chat agents in 50+ languages", e os lançamentos de 2026 foram muito voltados para voz: chamadas de saída em setembro e um recurso de Context Handoff que passa ao agente humano uma ficha de briefing em quatro partes e que, segundo o Level AI, corta de 60 a 90 segundos de cada chamada escalada. A transferência é o ponto em que a maioria dos bots perde a confiança do cliente, então vale ler sobre qualidade da escalação.
A parte inteligente é que o Level AI avalia os próprios bots com o VA Pulse, uma pontuação ponderada em 40% por tomada de decisão, 35% por velocidade e segurança e 25% por qualidade da conversa, com qualquer resposta mais lenta que 2,5 segundos marcada como falha. Poucos fornecedores auditam seus bots com a mesma rubrica que usam para os humanos, e este é um deles.
O que ele não é, porém, é um agente de tickets. E-mail não é um canal listado do agente virtual, nenhum helpdesk é citado na página, e uma busca no Zendesk Marketplace por Level AI retorna zero apps. Os números de latência também mudam conforme a página: "<2 s" na página do agente virtual e "<500 ms" na página de Voice AI. Se você procura especificamente bots de telefone, compare com minha lista de agentes de voz com IA.
Qual a precisão da pontuação por IA do Level AI?
Esta é a pergunta que decide se o Level AI economiza tempo da sua equipe de QA ou cria um segundo trabalho: conferir a IA. A resposta honesta é que as alegações ficam mais frouxas quanto mais de perto você olha.
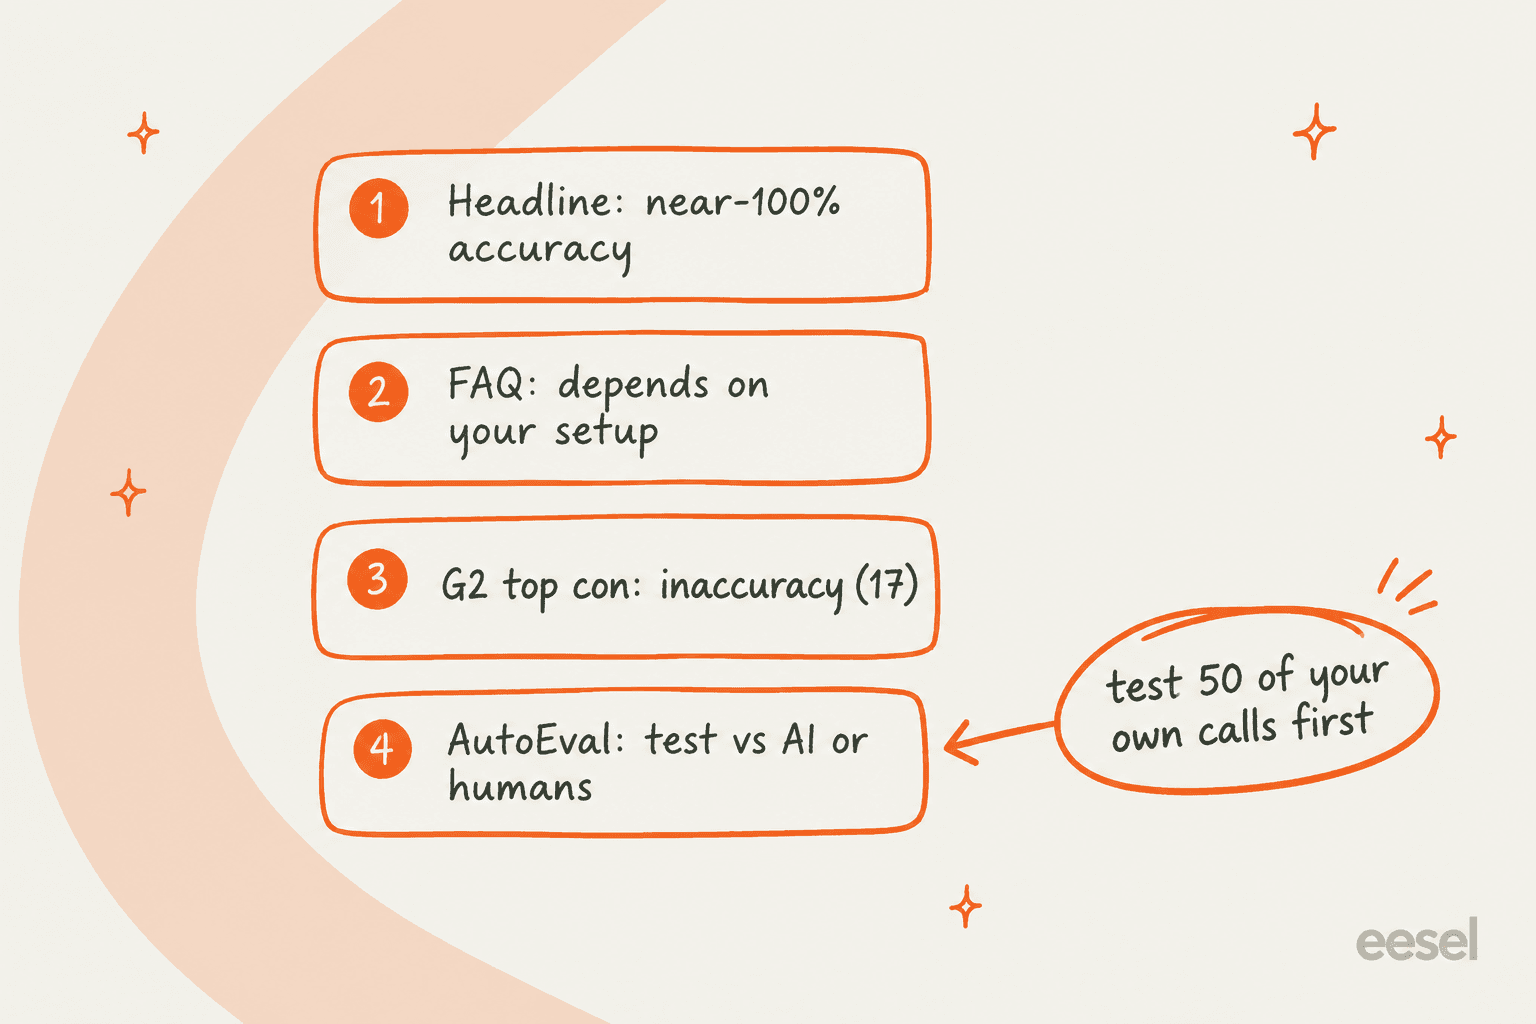
Aqui está o que cada fonte diz, uma por uma:
- A manchete. A página de QA afirma que o QA-GPT pontua "the most subjective scorecard questions with near-100% accuracy". Nenhum método ou tamanho de amostra é informado.
- A FAQ, na mesma página. "The accuracy of AI-based QA depends on how well the evaluation criteria and scoring logic are configured." Essa é a mais honesta das duas frases, e a que você deve usar para planejar.
- O benchmark original. O post de lançamento do QA-GPT de 2023 alegava precisão de "over 90%" "compared to a consensus of human QA managers". É um tipo real de teste, mas, de novo, sem tamanho de amostra.
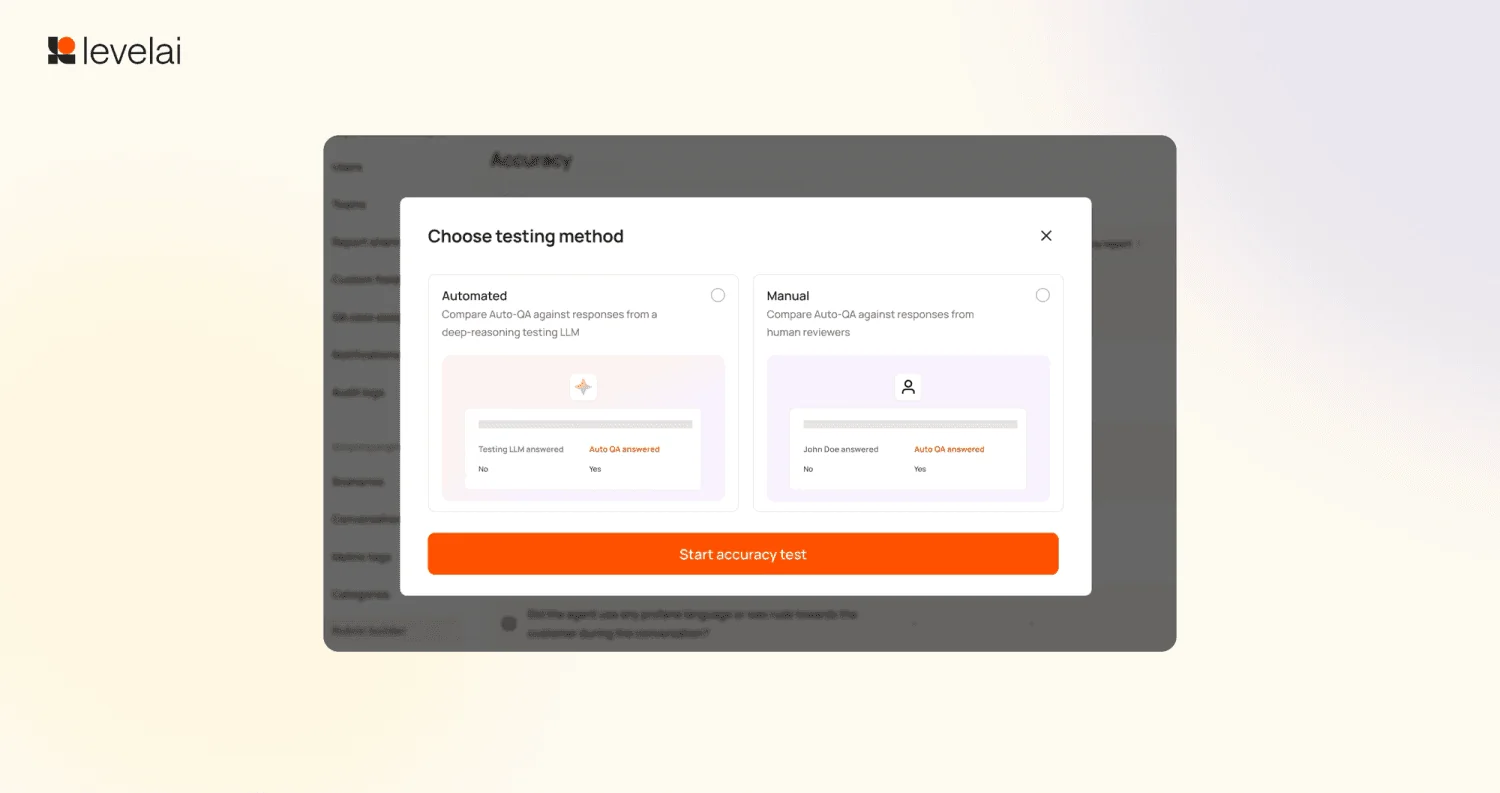
- As ferramentas de 2026. O AutoEval, das notas de versão do Q1 de 2026, faz um "deep-reasoning LLM" avaliar as mesmas perguntas do AutoQA e mostra onde divergem. A tela de teste também tem um modo Manual, que compara o AutoQA com os seus próprios revisores humanos. Escolha o modo manual, porque uma segunda IA concordando com a primeira prova menos do que o seu melhor auditor concordando.
- Os usuários. No resumo de prós e contras do G2, Inaccuracy é o principal ponto negativo com 17 menções, e o resumo do G2 o chama de "inaccuracy in AI QA scores".
Nada disso significa que a pontuação seja ruim. A precisão também aparece como ponto positivo em 27 menções no G2, e uma rubrica calibrada com critérios claros é onde os modelos vão bem. O que significa é que a precisão se conquista durante a configuração. A boa notícia é que o Level AI dá a ferramenta para isso: novas perguntas do AutoQA podem ser testadas em 50 conversas em um sandbox antes de entrar no ar. Use esse sandbox nas suas chamadas mais difíceis, não nas mais limpas, e depois do lançamento mantenha uma pessoa amostrando uma parte das pontuações toda semana.
Isso também espelha o que aparece nas chamadas de vendas da eesel. Um líder de CX de uma marca DTC de suplementos no Gorgias, com cerca de 7.000 tickets por mês, resumiu o que está em jogo em palavras simples:
"I cannot go and check all my 7,000 tickets to see if the AI actually made a good answer"
Troque "answer" por "score" e é a decisão de compra do AutoQA em uma linha. Se você não consegue confiar nas pontuações sem reconferi-las, então 100% de cobertura é apenas 100% mais dados que você precisa auditar.
O que os usuários dizem sobre o Level AI no G2
No geral, o quadro do G2 é forte. O Level AI tem nota 4,6/5 com 220 avaliações, com 78% de cinco estrelas. Um detalhe que notei: o selo do próprio site do Level AI diz "4.7 (200+ reviews)", um pouco atrás do número ao vivo do G2.
| Medida do G2 | Level AI |
|---|---|
| Nota geral | 4,6/5 (220 avaliações) |
| Ease of Use | 8,9 |
| Ease of Setup | 8,8 |
| Ease of Admin | 9,0 |
| Quality of Support | 9,0 |
| Tempo de implantação | 3 meses (19 respostas) |
| Retorno sobre o investimento | 4 meses (18 respostas) |
| Desconto médio | 8% |
As subnotas vêm da página Level AI vs Observe.AI do G2; o número do desconto é da página de avaliações do G2. Os elogios são bem consistentes e giram, em geral, em torno da passagem da amostragem para a cobertura quase total.
"Our QA has migrated from 2% manual volume to nearly 100% automated volume as a direct result of using Level AI. We also have iCSAT on 100% of contacts rather than traditional CSAT on just a fraction."

"Instead of sampling a handful of calls by hand, we can now review trends across thousands of interactions and immediately pull up the exact examples we need for training or root-cause analysis."
As reclamações se concentram em três pontos. O primeiro é a precisão, que cobri acima. O segundo são os dashboards e a configuração:
"At times, the analytics dashboard can be somewhat ambiguous. It is occasionally unclear how certain metrics are being calculated or visualized, which can make it difficult to fully trust the data without secondary validation."
O terceiro é a estabilidade. Slow Performance tem 14 menções, e um avaliador enterprise disse que muitas vezes "descobre" atualizações "because of bugs they cause". O preço, curiosamente, não aparece como tema nas avaliações que li.
Uma ressalva justa: 7 das 10 avaliações da primeira página do G2 têm data de 24 de junho de 2026, o que parece uma campanha de coleta de avaliações. Isso é comum e não é, por si só, sinal de alerta, mas vale dar peso também às avaliações mais antigas.
Resultados que clientes do Level AI relatam
Os estudos de caso são o lugar onde o Level AI mostra ganhos operacionais reais. São números do próprio fornecedor, citados exatamente de cada estudo de caso.
| Cliente | Tamanho da equipe | Resultado conforme informado |
|---|---|---|
| VistaPrint | 1.200 a 1.700 agentes | O over-crediting caiu de 20% para 8% em seis meses |
| Empyrean | ~400 agentes | QA de 3% para 100% das chamadas; mais de 13 mil horas de agente economizadas por ano |
| Ollie | 50 agentes | Cobertura de QA de menos de 1% para cerca de 90%, com a mesma equipe de QA |
| Purple | Não informado | 100% de cobertura de QA em chamadas de voz com mais de 2 minutos |
| Smartsheet | Não informado | O CSAT inferido subiu de 2,95 para 3,31, de fevereiro a julho |
| Extra Space Storage | 500 agentes | Preparação de coaching de cerca de duas horas para 30 minutos |
A queda do over-crediting da VistaPrint é o número mais convincente aqui, porque é uma métrica de dinheiro e está ligada a um comportamento que o QA consegue de fato capturar. Duas das páginas também têm inconsistências internas que vale notar: o título da Extra Space diz "120 Min saved" enquanto o corpo descreve 90 minutos, e o título da Ollie diz que 30% das pontuações de QA vêm do Auto QA enquanto o corpo diz "half".
O número da Smartsheet também merece uma segunda olhada, já que o iCSAT é a pontuação inferida do próprio Level AI e não uma pesquisa com clientes. É evidência de que a leitura de sentimento do modelo se moveu, o que é útil, mas não é o mesmo que os clientes dizendo que estão mais felizes. Combine-o com as métricas de suporte em que você já confia.
Integrações e segurança
A página de integrações do Level AI mostra 51 blocos, fortemente voltados a sistemas de telefonia. A própria página chama a lista de "non-exhaustive" e não diz o que cada integração realmente faz.
| Categoria | Exemplos da página de integrações |
|---|---|
| Telefonia e contact center (14) | Five9, Genesys, Amazon Connect, Nice, Talkdesk, Twilio, Dialpad |
| Helpdesk | Zendesk, Freshworks, Kustomer, Gladly, Gorgias, Front |
| CRM | Salesforce |
| Gestão de força de trabalho | Calabrio, Assembled |
As conexões com Five9 e Genesys têm suas próprias páginas de parceria, e também há uma listagem no Salesforce AppExchange, que exige Service Cloud e lista o inglês como idioma suportado. Se o planejamento de força de trabalho faz parte do seu stack, a parceria com a Assembled de fevereiro de 2026 diz que os recursos de integração "will roll out over the coming months".
A segurança é uma força real para compradores regulados. A página de segurança lista SOC 2 Type II, ISO 27001, HIPAA com BAA, PCI DSS, HITRUST CSF e GDPR, e diz que nomes, números de cartão e SSNs são ocultados antes de qualquer processamento por IA. A infraestrutura roda no Google Cloud, e os dados dos clientes não são usados para treinar modelos compartilhados. A única lacuna para compradores da UE é que nenhuma região de hospedagem ou opção de residência de dados é informada em lugar algum.
Preços do Level AI
O Level AI não publica preço. A página /pricing retorna um 404, e todas as rotas que verifiquei terminam em "talk to sales".
| O que verifiquei | O que mostra |
|---|---|
| Site do Level AI | Sem página de preços; apenas "Schedule a demo" |
| Listagem na Capterra | "Contact vendor"; "Free trial not available" |
| Página de preços do G2 | Não informado pelo fornecedor; 8% de desconto médio |
| Salesforce AppExchange, Five9 Marketplace | Listagens existem, sem preço |
| Marketplaces da AWS, Zendesk e Google Cloud | Sem listagem do Level AI |
| Calculadora de ROI | Pede interações mensais, número de agentes e mix de canais |
A unidade de cobrança também não é publicada. A calculadora de ROI pede volume de interações e número de agentes, o que indica em que base o time de vendas vai dimensionar o negócio, mas não diz como você será cobrado. Antes de assinar qualquer coisa, peça a unidade por escrito: por agente, por interação ou taxa de plataforma, além do que acontece quando o volume dispara. Meu detalhamento dos custos de atendimento ao cliente com IA cobre as perguntas que valem a pena fazer.
Quanto ao custo total, oriente o orçamento pelo tempo e não só pela licença. Três meses de implantação significam que a sua equipe de QA vai rodar o processo antigo e o novo lado a lado por um trimestre inteiro.
Prós e contras do Level AI
| Prós | Contras |
|---|---|
| Pontua 100% das chamadas, chats, e-mails e conversas de bots | As alegações de precisão superam as evidências; a imprecisão é o principal ponto negativo no G2 |
| Evidências e carimbos de tempo em cada pontuação de IA | Preço só sob consulta, sem teste, sem central de ajuda pública |
| Scorecards híbridos e lógica de N/A condicional | Cerca de 3 meses para implantar |
| Mesma rubrica de QA para agentes humanos e bots (VA Pulse) | Dashboards e rótulos exigem tentativa e erro para configurar |
| Integrações profundas com sistemas de telefonia (Five9, Genesys, Nice) | O agente virtual não trabalha tickets de helpdesk |
| Lista de segurança robusta, incluindo HITRUST e PCI DSS | Algumas páginas do produto se contradizem em alegações importantes |
Quem deve usar o Level AI?
A questão da adequação se resume, na verdade, a duas coisas: quantos agentes você tem e se o seu trabalho chega como chamadas ou como tickets.
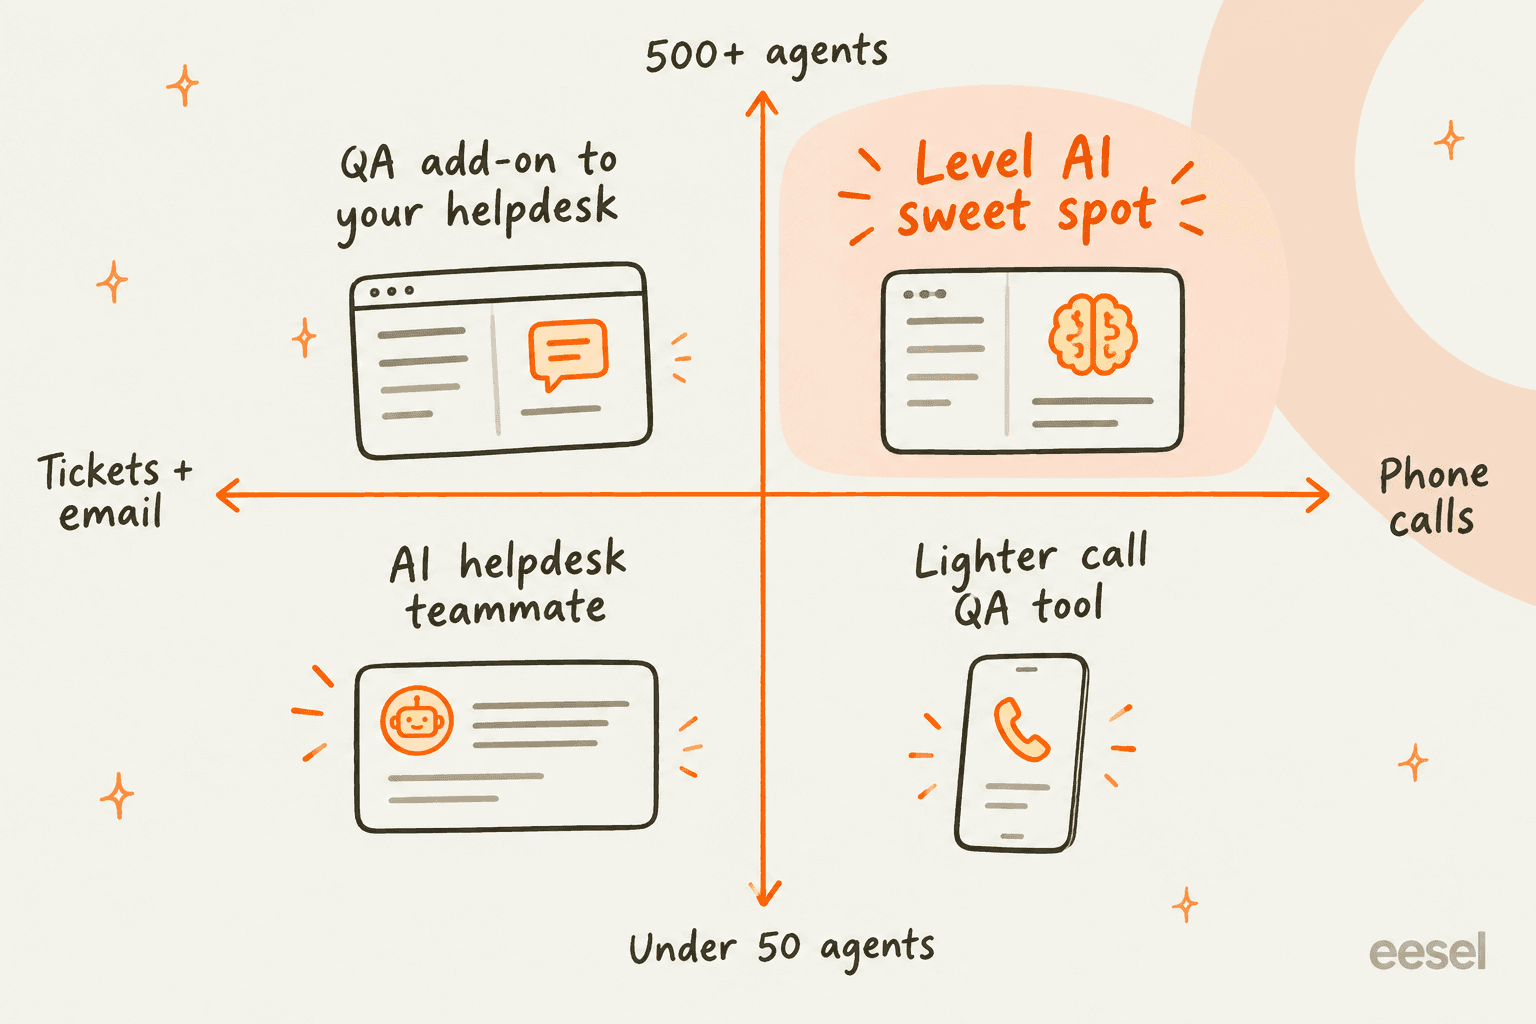
O Level AI serve para contact centers com centenas de agentes, uma função de QA de verdade e muito volume telefônico. Se você roda em Five9, Genesys ou Nice, precisa de controles HIPAA ou PCI e a sua equipe de QA está soterrada em amostragem manual de chamadas, é uma opção séria. Os estudos de caso estão exatamente nesse grupo.
O Level AI é um exagero para equipes com menos de cerca de 50 agentes, ou equipes cujo trabalho é principalmente e-mail e tickets de helpdesk. Você estaria comprando uma plataforma de QA enterprise com implantação de três meses e contrato conduzido por vendas, só para avaliar uma fila que uma ferramenta de QA mais leve ou o Zendesk QA poderiam cobrir. Se você quer a comparação mais direta, leia minha avaliação da Cresta; a Cresta atua no mesmo espaço de grandes contact centers.
Se o seu problema não é "não conseguimos avaliar conversas suficientes" mas sim "não conseguimos responder tickets suficientes", você precisa de algo que faça o trabalho, não de algo que o pontue.
eesel para equipes que trabalham uma fila de tickets
A eesel é uma plataforma de colegas de IA, e o colega que importa aqui é o colega de IA para helpdesk. Enquanto o Level AI avalia seus agentes humanos em suas chamadas, a eesel entra no seu helpdesk como um novo agente: lê sua central de ajuda, macros e tickets antigos, e então redige ou envia respostas, aplica tags e roteia dentro do Zendesk, Freshdesk, Gorgias, Front e outros helpdesks. É uma ferramenta de IA para helpdesk que se testa antes do lançamento.
O ângulo de QA vem embutido desde o início. Antes de a eesel responder a um cliente, sua skill de simulação reproduz centenas dos seus tickets antigos, pontua cada resposta em relação ao que a sua equipe realmente enviou e sugere mudanças nas instruções onde ficou aquém. É a mesma disciplina de "testar antes de confiar" que o Level AI pede de quem usa o AutoQA, só que aplicada ao próprio agente. Você pode começar no modo rascunho, para que uma pessoa aprove cada resposta, e depois passar as ações para automático uma a uma.

O preço é público. O plano gratuito dá 100 créditos sem cartão, e o plano Teammate começa em US$ 299/mês por 500 créditos, em que um ticket ou chat é um crédito, não importa quantas respostas leve, com agentes e usuários ilimitados. Um limite honesto a mencionar: a eesel não tem canal de telefone, então se o seu volume é de chamadas, o Level AI ou um agente de voz é a ferramenta certa. Se são tickets, experimente a eesel na sua própria fila e veja a simulação antes que ela toque em um cliente.
Perguntas frequentes
O Level AI vale a pena?
Para um contact center com muita voz, algumas centenas de agentes e uma equipe de QA presa amostrando de 1% a 3% das chamadas, sim. O AutoQA do Level AI pontua cada chamada, chat e e-mail, e sua nota no G2 é 4,6/5 com 220 avaliações. Para uma equipe pequena que trabalha com tickets e e-mail, uma ferramenta de QA para suporte mais leve ou um agente de IA para helpdesk é mais adequado.
Quanto custa o Level AI?
O Level AI não publica preços. A página /pricing retorna um 404, a Capterra lista o preço como "Contact vendor" e não há teste gratuito. Você recebe uma cotação depois de uma demo. Para comparar, veja como funcionam os preços da Cresta e os preços do Zendesk AI.
Qual a precisão do AutoQA do Level AI?
O Level AI afirma precisão próxima de 100%, mas a própria FAQ diz que a precisão depende de quão bem a sua lógica de pontuação está configurada. A imprecisão é o ponto negativo mais marcado no G2 (17 menções). Use o sandbox integrado para testar novas perguntas da rubrica em 50 das suas próprias conversas antes de confiar nas pontuações, a mesma disciplina por trás de um bom QA de suporte com IA.
O que diz uma avaliação do Level AI no G2?
Os avaliadores elogiam a facilidade de uso (60 menções) e a mudança da amostragem manual para uma cobertura de QA quase total. As reclamações mais comuns são a precisão da pontuação e da transcrição por IA, o desempenho lento em alto volume e dashboards difíceis de configurar. Ease of Use recebe 8,9 e Quality of Support 9,0.
O Level AI funciona com o Zendesk?
Em parte. O Zendesk está na lista de integrações do Level AI e o widget Agent Assist pode ser incorporado no Zendesk, mas não há um app do Level AI no Zendesk Marketplace e seu agente virtual é um bot de voz e chat, não um agente de tickets. Se você quer uma IA que responda tickets do Zendesk, olhe para uma opção nativa de helpdesk.
Quais são as melhores alternativas ao Level AI?
Para QA de call center e coaching em tempo real, a Cresta é a opção mais próxima. Para QA dentro de um helpdesk, o Zendesk QA serve para equipes que já usam Zendesk. Para filas de tickets em que você quer que a IA responda e se avalie, o colega de IA para helpdesk da eesel foi feito para isso.
Quanto tempo leva para implantar o Level AI?
Avaliadores do G2 relatam uma média de 3 meses para implantar e 4 meses para ver retorno sobre o investimento. O Level AI não tem central de ajuda pública, então a configuração passa pela equipe deles. Reserve tempo de calibração para os seus critérios de scorecard antes de confiar nas pontuações automáticas.

Article by
Riellvriany Indriawan
Riell is a designer and writer at eesel AI with about two years of experience researching CX platforms, AI chatbots, and helpdesk software. She combines her design background with a sharp eye for how these tools actually look and feel in practice — making her comparisons unusually visual and user-focused.