

A IA para comunicação de incidentes graves funciona quando você mantém um único registro de incidente verificado e deixa cada canal responder a partir dele: a página de status, as respostas a tickets, a macro dos seus agentes, os e-mails para contas grandes e o canal interno. A IA redige cada atualização, uma pessoa designada (seu líder de incidente ou responsável pela comunicação) aprova tudo o que é público, e uma atualização sai a cada 30 minutos, a meta que a incident.io define para incidentes graves.
A IA que responde tickets por conta própria só deve mexer em tickets associados a um incidente declarado, e só com palavras copiadas da última atualização aprovada. Nada de previsões de horário inventadas, nada de chutes sobre a causa raiz, nada de «seus dados estão seguros». Depois, planeje a segunda onda após a resolução: respostas de «está mesmo resolvido?», pedidos de relatório e pedidos de crédito por SLA.
Eu construo as integrações de helpdesk da eesel, e o colega de IA para helpdesk em que trabalho faz isso dentro do Zendesk, Freshdesk e Gorgias: ele etiqueta os tickets da queda, redige respostas a partir da atualização aprovada e passa quedas e perda de dados direto para uma pessoa, do jeito que a Qontro faz no Freshdesk. Os planos começam em US$ 299 por mês por 500 créditos.
Por que os clientes ouvem coisas diferentes durante uma queda?
Porque cada pessoa responde com o que sabe naquele momento, e todas sabem coisas diferentes. Um agente no ticket #4012 leu a página de status dez minutos atrás. Um gerente de contas ouviu algo em uma conversa do Slack. Um engenheiro disse a um cliente grande «deve estar resolvido em uma hora». A própria página de status não se mexeu desde a primeira publicação. Ninguém está mentindo. Estão apenas respondendo a partir de retratos diferentes.
A central de ajuda do Freshdesk descreve isso bem. No seu guia de tickets vinculados, ela observa que durante uma queda diferentes clientes recebem atualizações em intervalos diferentes, "based on the persistence of the customer and the workload of the agent." O cliente que escreve quatro vezes recebe quatro atualizações. O que escreve uma vez recebe silêncio.
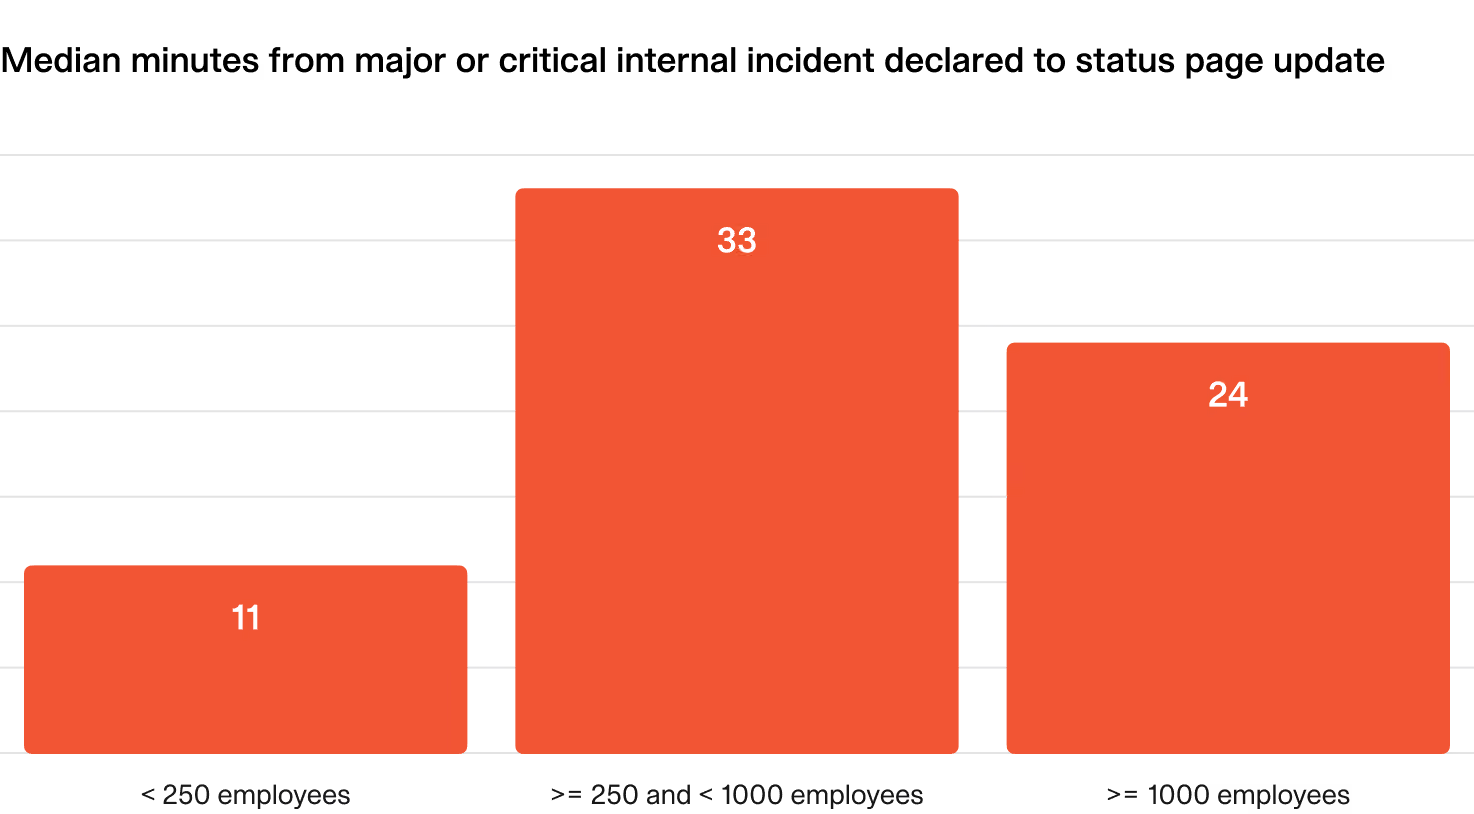
A lentidão da primeira atualização piora tudo. O relatório de boa gestão de incidentes da incident.io constatou que empresas com 250 a 1.000 funcionários levavam uma mediana de 33 minutos entre declarar um incidente grave e a primeira publicação na página de status, mais lento do que empresas menores e maiores. Essa meia hora é quando os tickets se acumulam e as histórias se dividem.
Quem conduz o incidente também sente isso por dentro. Um SRE pediu ajuda no Reddit justamente por isso:
"When stuff is finally resolved, I have to parse through slack to see what happened when, ignore the "what's the status" slacks sent by 15 different random people, build a timeline with my investigation steps, etc."

Então a solução não é «escrever mais rápido». É dar a todos um único lugar para ler e deixar a IA fazer a reescrita para cada público. Eu também leria meu guia sobre IA de suporte durante quedas de SaaS junto com este: aquele trata da enxurrada de tickets, meu guia de IA para atualizações da página de status trata da própria página de status, e este trata do que você diz em cada canal e de quem diz.
De onde cada canal deve responder?
De um único registro de incidente, escrito em palavras simples, de que uma pessoa é dona e que ela atualiza. Não do canal de Slack da engenharia, não da chamada da sala de crise, não da memória de alguém. Limite a quatro campos:
- O que está afetado: as áreas de produto, regiões ou grupos de clientes, nas palavras dos seus clientes («o checkout no aplicativo web»), não em nomes de serviços («payments-api-v2»).
- Fatos verificados: só o que os engenheiros confirmaram. «Alguns pagamentos com cartão falham» é um fato. «Um deploy ruim causou isso» é um palpite até alguém confirmar.
- O que estamos fazendo: uma linha. «Revertendo a versão das 14h10» basta.
- Próxima atualização às: um horário de relógio, sempre.
Esse registro pode ficar na sua ferramenta de incidentes (incident.io, PagerDuty, Jira Service Management) ou na própria página de status. Onde ele fica importa menos do que a regra de que toda mensagem para qualquer pessoa é reescrita a partir dele, nunca de uma conversa paralela.
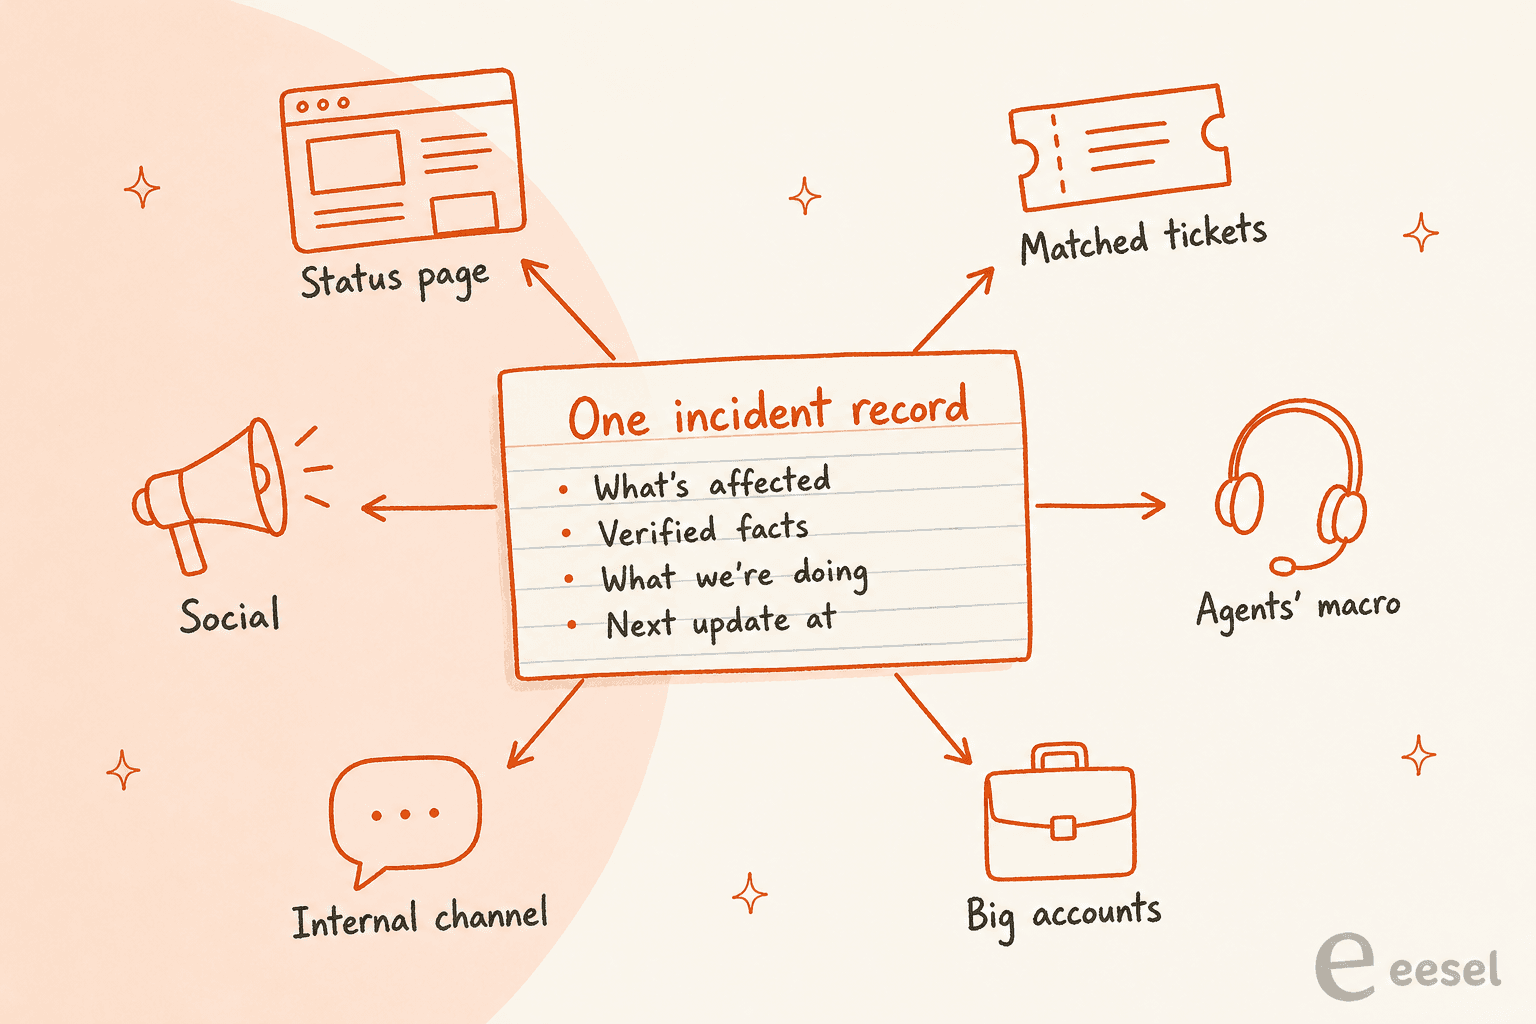
As setas apontam só para fora de propósito. Se um cliente em um ticket relata algo novo («também está quebrado no celular»), isso vai para o responsável pela comunicação, que confere e adiciona ao registro. Não salta direto para a resposta de outro cliente. Essa única regra é o que impede o canal número seis de se afastar do canal número um.
Quem é dono da comunicação do incidente, e onde a IA se encaixa?
Uma pessoa que não esteja consertando o problema. Engenheiros depurando produção não deveriam estar lapidando um pedido de desculpas. Isso apareceu várias vezes quando li como os operadores lidam com isso:
"Someone not directly working the incident owns comms. gets updates from the team, tracks timelines, and updates the dedicated status page/notification channels."
O relatório da incident.io dá o mesmo conselho em termos mais simples: "Assign communications roles", para ficar claro quem é dono das atualizações da página de status. A IA fica abaixo dessa pessoa, não ao lado dela. Ela transforma o registro em cinco versões para cinco públicos, e o responsável pela comunicação lê e aprova. Isso é human in the loop em sua forma mais simples, e o próprio guia de comunicação da incident.io traça a mesma linha: a IA deve ajudar a redigir, em vez de enviar mensagens externas sem que uma pessoa revise.
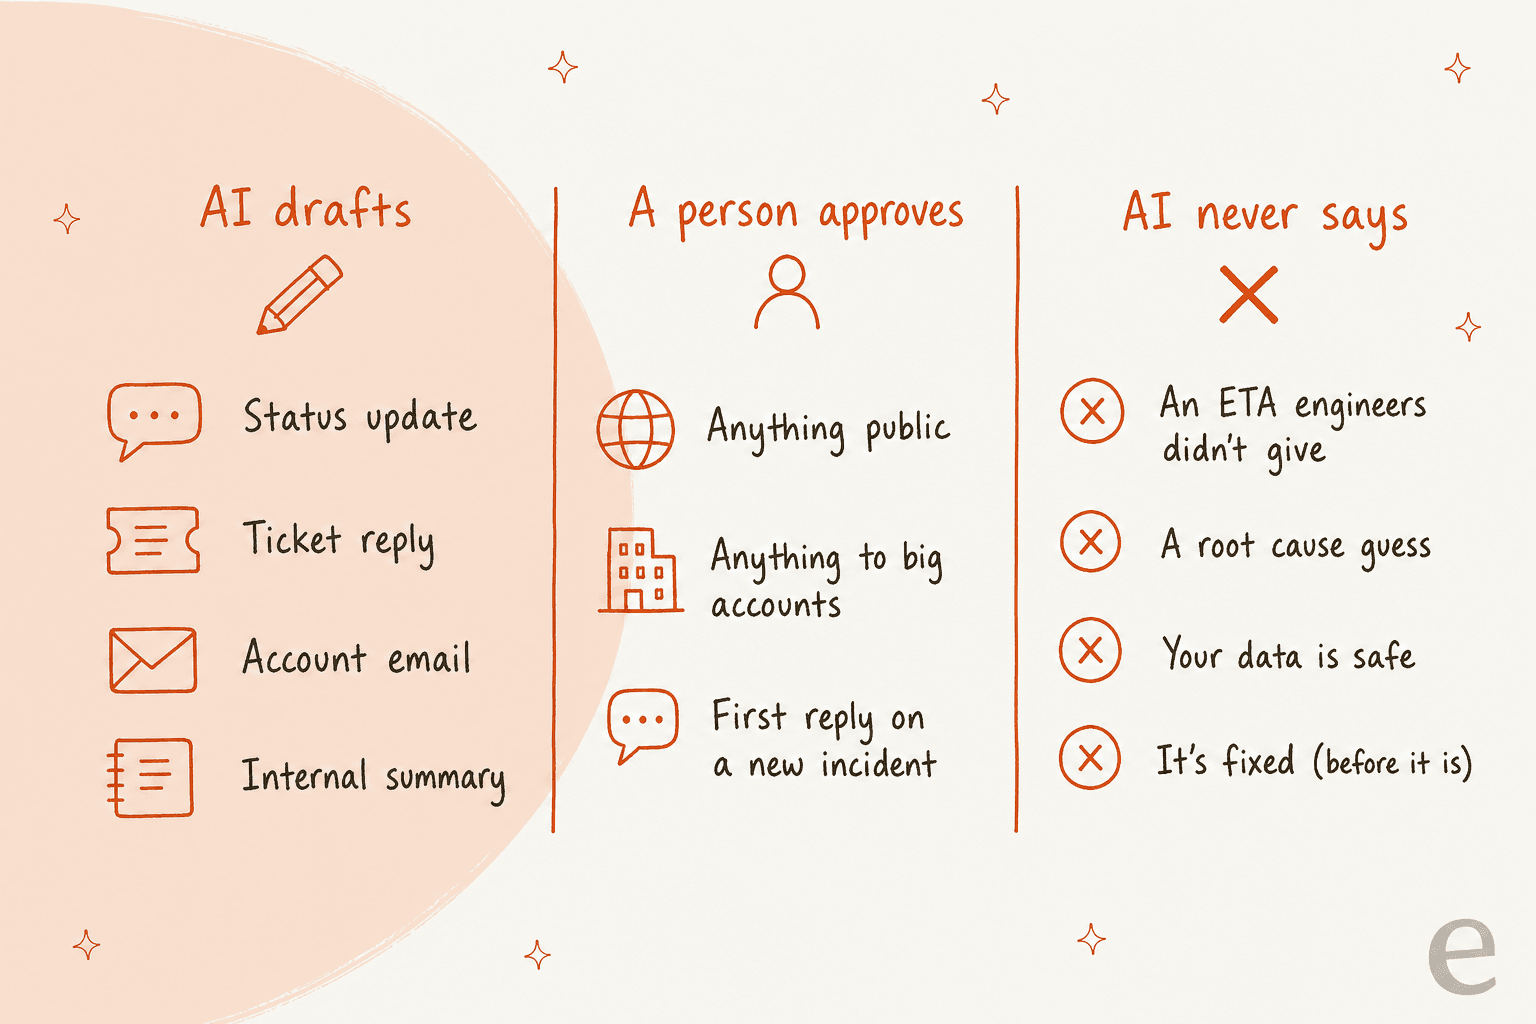
A coluna da direita é a parte que eu imprimiria. Cada uma dessas quatro linhas é uma frase que um modelo de linguagem escreve com prazer se o prompt der um empurrão, porque são exatamente o que um cliente ansioso quer ouvir. Uma alucinação de IA em um ticket normal custa um cliente. A mesma frase em uma resposta de incidente chega a centenas de pessoas ao mesmo tempo, e é a linha de que depois tiram print.
Com que frequência enviar atualizações do incidente?
A cada 30 minutos em um incidente grave, mesmo quando nada mudou. Essa é a meta do relatório da incident.io, que diz para "aim to share status page updates every 30 minutes during major and critical incidents." Os dados dela mostram que a maioria das equipes chega perto disso.
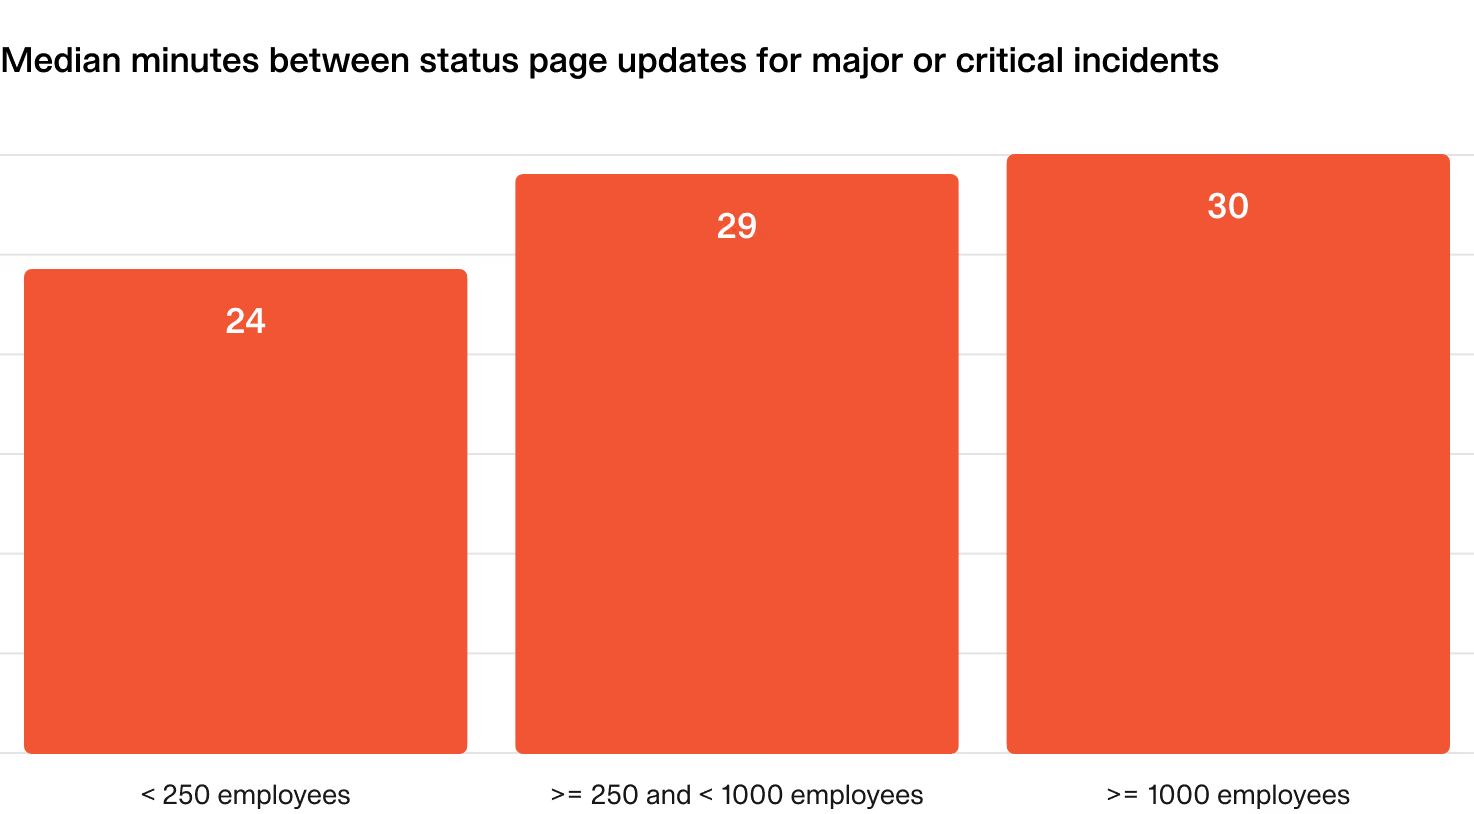
O guia da incident.io chama a atualização vazia de regra do «batimento cardíaco»: "We're still investigating. No new information. Next update in 30 minutes." Parece que não é nada, mas faz um trabalho real. Um cliente que sabe que a próxima atualização chega às 15h30 não abre um ticket às 15h20. O guia de comunicação dela sugere escalonar o ritmo por gravidade: a cada 20 a 30 minutos para um SEV1, a cada 4 horas para um SEV2 e atualizações em horário comercial para um SEV3.
Esse é o trabalho mais fácil de dar à IA. A atualização de batimento é chata, é a que as pessoas esquecem no minuto 45 de um incidente ruim, e quase não traz risco porque não diz nada de novo. Deixe a IA redigi-la a partir do registro e avisar o responsável pela comunicação quando estiver na hora. O plano abaixo mostra o que cada gravidade precisa, para que vocês combinem antes do próximo incidente em vez de durante ele.
Como manter os agentes e a IA no mesmo roteiro?
Dê ao suporte as mesmas palavras que a página de status usa e facilite encontrar todos os tickets sobre o incidente. Os dois grandes helpdesks já têm a infraestrutura para a segunda parte. O que cada um faz com ela vale conhecer em detalhe, porque já vi equipes assumirem mais do que o recurso realmente faz.
Tickets de problema e incidente do Zendesk. Na documentação do Zendesk, você cria um ticket de problema para a queda, define o tipo de cada ticket relacionado como incidente e os vincula. Quando você resolve o ticket de problema, todo ticket de incidente vinculado é resolvido, e o comentário que você escreve no ticket de problema é adicionado aos tickets de incidente que ainda estão abertos. Dois porém na mesma página: "Customers are not notified using the messaging channel" e "AI agent tickets can't be linked to problem and incident tickets." Então, se metade do seu tráfego da queda chega pelo próprio bot do Zendesk, o fechamento em massa não o alcança. Meu passo a passo de tickets de incidente e de problema cobre a configuração, e as atualizações de status em massa preenchem as lacunas.
Tickets vinculados do Freshdesk. O Freshdesk vincula tickets relacionados a um ticket mestre chamado tracker. Comentários no tracker vão para todos os tickets vinculados como transmissão, mas o guia de configuração diz que a "internal broadcast message will be visible only to agents of the helpdesk." Os clientes não a veem. Cada agente ainda envia a resposta de fato. E resolver o tracker não resolve os tickets vinculados por padrão. Tickets vinculados exigem o plano Pro ou Enterprise.
Essa é a lacuna que a IA preenche bem. O recurso do helpdesk dá uma lista de todos os tickets sobre a queda. A IA transforma a última atualização aprovada em uma resposta para cada um, no idioma do cliente, sem ninguém copiar e colar 300 vezes. Etiquetar também importa aqui: um operador no r/sre resumiu o movimento básico.
"support tools like zendesk allow you to add tags to tickets related to the same issue via a "master" ticket"
Uma etiqueta como incident-2026-10-30-checkout em cada ticket associado é o que permite fechar todos depois, contá-los para o relatório pós-incidente e identificar os clientes que escreveram três vezes. Se você ainda não configurou a etiquetagem de tickets com IA, uma queda é um lugar doloroso para descobrir que precisa dela. O mesmo vale para a deduplicação de tickets, já que os tickets de uma queda chegam em levas das mesmas pessoas.
Atualize a macro que seus agentes humanos usam ao mesmo tempo que a página de status. Uma macro de IA que ainda diz «estamos investigando» uma hora depois de a correção sair é como um cliente recebe duas respostas diferentes em uma mesma tarde.
Quando a IA deve responder sozinha durante um incidente?
Só quando três coisas forem verdadeiras: alguém declarou o incidente, o ticket claramente corresponde a ele e a resposta usa uma redação que uma pessoa já aprovou. Se faltar qualquer uma, a IA redige e uma pessoa envia. Essa é a regra inteira, e cobre quase todos os casos.
Assim eu classificaria os tickets recebidos durante um incidente grave:
| O ticket | O que a IA faz | Por quê |
|---|---|---|
| Corresponde a um incidente declarado | Responde com a última atualização aprovada e o horário da próxima, etiqueta e vincula | As palavras já foram verificadas uma vez |
| Parece uma queda, mas nada foi declarado | Deixa uma nota interna e avisa a equipe de plantão, não confirma nada | Pode ser o primeiro sinal de um incidente real, ou o wi-fi de um cliente |
| De uma conta grande ou cita um contrato | Passa ao responsável pela conta com um resumo | Esses clientes esperam uma pessoa e um caminho de escalonamento |
| Relata perda de dados, uma preocupação de segurança ou dinheiro cobrado duas vezes | Direto para uma pessoa, sem resposta | Uma linha errada aqui é um problema jurídico |
| Não é sobre a queda | Fila normal | Não deixe o incidente engolir todo o resto |
Duas dessas vêm direto de configurações reais. A Qontro, uma empresa de ERP no Freshdesk, redige uma resposta em cada ticket novo (190 em um mês), mas envia quedas, perda de dados e dúvidas de cobrança direto para uma pessoa, e quando um ticket não tem informação suficiente para responder com confiança, o agente diz isso em vez de chutar. A SE Ranking roda a eesel em 4.650 conversas do Zendesk por mês e etiqueta todo ticket que toca com ai_handled, para que a equipe possa contar exatamente o que a IA fez. A regra de transferência dela também combina bem com dias de incidente: o agente diz aos clientes para esperarem uma resposta em um ou dois dias úteis e nunca diz que alguém está entrando agora.
Esse último ponto é uma cicatriz para mim. Já vi um bot dizer aos clientes que os passava para uma pessoa quando a transferência nunca aconteceu, em uma empresa de hospedagem web no Zendesk. Durante uma queda, esse tipo de promessa vazia dobra a raiva. Então o que sua IA diz sobre os próximos passos precisa ser algo que seu sistema realmente faz. Meu artigo sobre boas práticas de transferência mostra como testar isso antes de precisar, e os testes de simulação permitem reproduzir os tickets da queda do trimestre passado com as novas regras antes de ativá-las.
Mais uma armadilha: as respostas de incidente da IA devem parar no momento em que uma pessoa assume a conversa. A ClutchLoop roda seu agente no Gorgias com exatamente essa regra: se um membro da equipe já está respondendo em uma conversa, o agente fica de fora. Para contas grandes com um gerente de contas no ticket, é o comportamento que você quer.
O que a IA das ferramentas de incidentes e de helpdesk realmente faz?
A maior parte da IA nas ferramentas de incidentes é voltada para os engenheiros: resumos, linhas do tempo, post-mortems. Menos recursos tocam nas mensagens aos clientes, e os que tocam são ferramentas de redação com uma pessoa revisando. Veja o que as páginas de cada fornecedor dizem, com seus preços.
| Ferramenta | IA para comunicação de incidentes | Página de status | Preço (página do fornecedor) |
|---|---|---|---|
| Atlassian Statuspage | Nenhuma listada na página de preços | Sim, é o produto principal | Free (100 assinantes), Hobby US$ 29, Startup US$ 99, Business US$ 399, Enterprise US$ 1.499 por mês |
| incident.io | Recursos de IA como Scribe e Suggestions, mais um editor de post-mortem nativo de IA no Pro e no Enterprise | 1 página pública no Basic, Team e Pro, páginas para clientes no Enterprise | Basic grátis, Team US$ 19 por usuário por mês, Pro US$ 25, mais plantão de US$ 10 a 20 por usuário |
| PagerDuty | O AI Status Updates redige atualizações internas e externas, quem responde revisa antes de enviar | Página externa a partir do Professional (250 assinantes) | Professional US$ 21 por usuário por mês no anual, IA como complemento; Starter US$ 2.800 por ano com 1.000 ações de IA |
| Jira Service Management | Agentes Rovo a partir do Standard; criação de incidentes com IA e rascunhos de revisão pós-incidente no Premium | Apenas plano Enterprise | Standard US$ 21,50, Premium US$ 55,28 por agente por mês |
| Zendesk | Copilot (resumos, sugestões de mesclagem, tickets semelhantes), agentes de IA cobrados por resolução automatizada | Não | Suite Team US$ 55, Professional US$ 115 por agente por mês no anual; Copilot US$ 50 por agente por mês |
| Freshdesk | Freddy AI Agent (500 sessões incluídas, depois US$ 49 por 100), Copilot US$ 29 por agente por mês | Não | Growth US$ 19, Pro US$ 55, Enterprise US$ 89 por agente por mês no anual |
| eesel | Redige ou envia respostas dentro do seu helpdesk, etiqueta e vincula tickets, aprovações por ação | Não, lê a sua | US$ 299 por mês por 500 créditos, um ticket é um crédito |
Alguns detalhes que importam mais do que a coluna de preço. A documentação da PagerDuty diz que o AI Status Updates só pode redigir atualizações externas a partir do Slack; no Microsoft Teams e no aplicativo web são apenas atualizações internas. No Jira Service Management, a "incident stakeholder communication" (convidar e enviar e-mails a partes interessadas internas e externas) é um recurso Premium, então o plano Standard não a inclui. Mais sobre isso no meu detalhamento dos preços do JSM e no artigo sobre revisões pós-incidente com IA.
No lado do helpdesk, nem o Zendesk Copilot nem o Freddy AI sabem do seu incidente a menos que alguém conte. Eles trabalham com tickets e artigos de ajuda, e seu registro de incidente fica em outra ferramenta. Conectar as duas coisas é o trabalho de verdade.
Os detalhes completos dos planos estão nos meus guias de preços do Zendesk e preços do Freshdesk.
Como conectar o registro de incidente ao helpdesk?
Envie cada atualização de status da sua ferramenta de incidentes para a IA que responde tickets, como dados. Esta é a parte em que passo meus dias, então aqui vai a versão simples de como funciona.
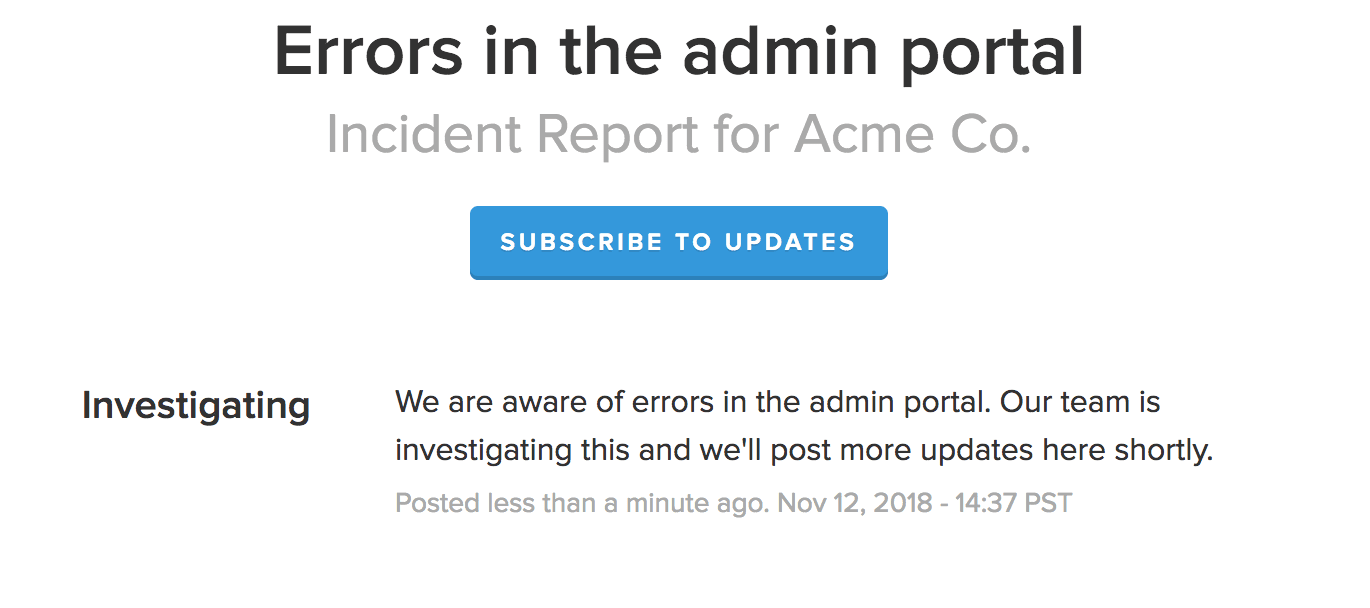
O Statuspage pode enviar cada atualização de incidente para uma URL. Suas notificações por webhook são requisições HTTP POST com a atualização do incidente ou do componente, e estão disponíveis a partir do plano Startup (US$ 99 por mês). Este é o tipo de atualização que esses payloads carregam:
Do lado da eesel, uma automação por webhook dá a você uma URL privada para a qual qualquer serviço pode enviar JSON por POST, e o agente acorda com esses dados e segue as instruções que você escreveu para ele. Então você aponta o webhook do Statuspage para essa URL e diz ao agente: "When an incident update arrives, save the latest approved text as the current incident status. On new tickets that match it, reply with that text and the next update time, add the incident tag, and leave everything else for a person." O mesmo funciona a partir da incident.io ou da PagerDuty por meio de seus próprios webhooks ou do Zapier. A eesel não tem integração nativa com o Statuspage, então o webhook é o caminho.
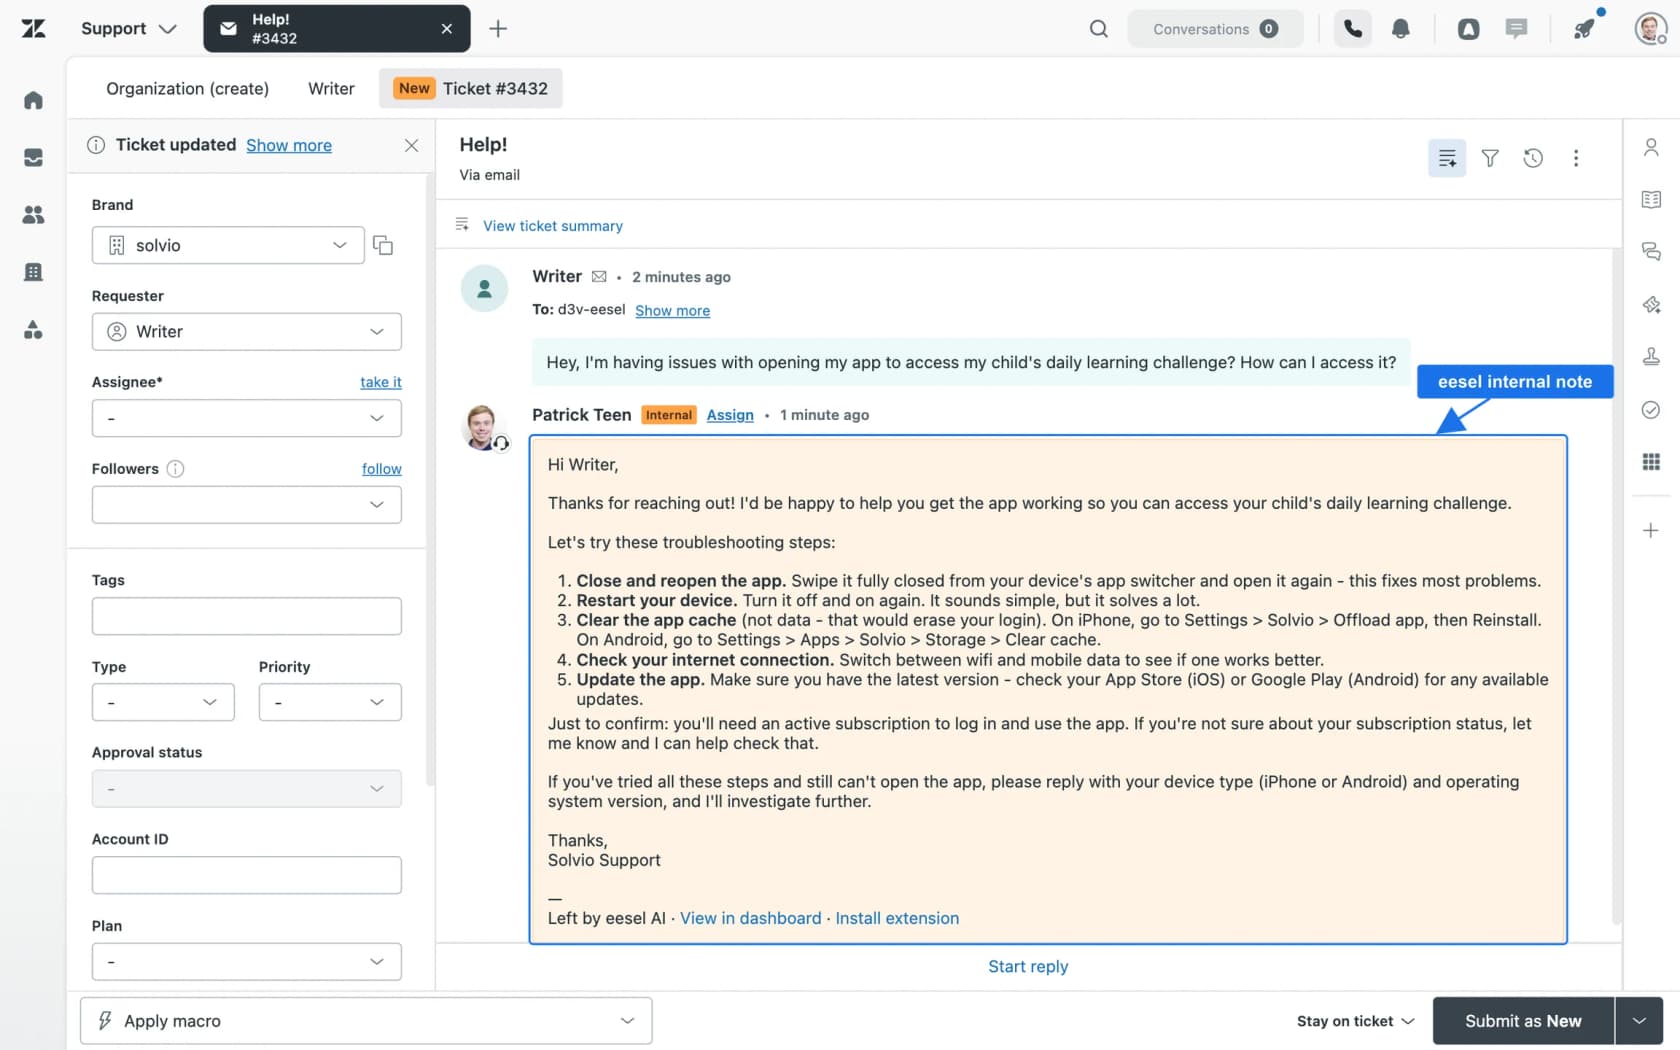
Dentro do Zendesk, as ações da eesel que importam em um dia de incidente são: redigir resposta de ticket (retida até uma pessoa aprovar), deixar nota interna, adicionar etiquetas, buscar tickets e atualizar campos como status ou prioridade. Cada ação pode ser configurada para rodar sozinha, exigir aprovação ou ficar desativada. No primeiro dia eu colocaria "Send ticket reply" em aprovação e "Add tags" e "Leave internal note" em automático.
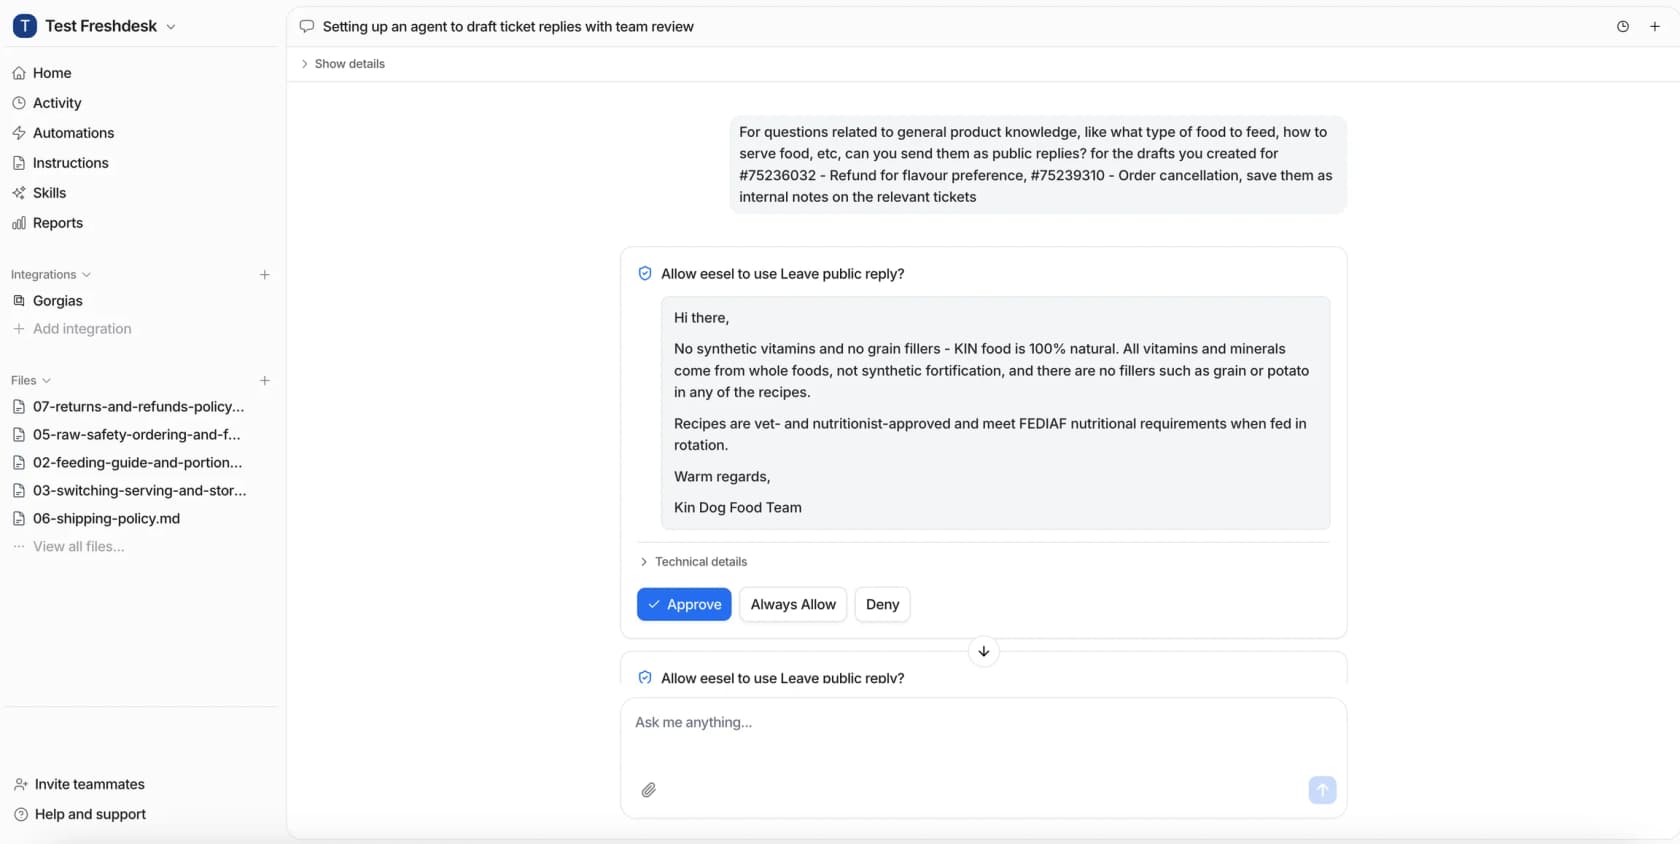
As aprovações não precisam acontecer no painel. Se a execução começou pelo Slack, o cartão de aprovação cai nessa conversa, então seu responsável pela comunicação pode aprovar respostas no mesmo canal que já está acompanhando. Se seu líder de incidente vive em um terminal, a CLI da eesel faz o mesmo trabalho: eesel approvals lista o que está esperando e eesel approvals approve <id> envia. Isso também significa que um agente de programação como o Claude Code ou um script no seu runbook de incidentes pode conferir a fila por você. Nada no agente muda entre o painel, o Slack e o terminal. É o mesmo colega com as mesmas permissões.
O que acontece depois que o incidente é resolvido?
Uma segunda onda de tickets, e a maioria das equipes não a planeja. A página de status muda para resolvido, todo mundo respira, e então a caixa de entrada se enche de um outro tipo de mensagem.
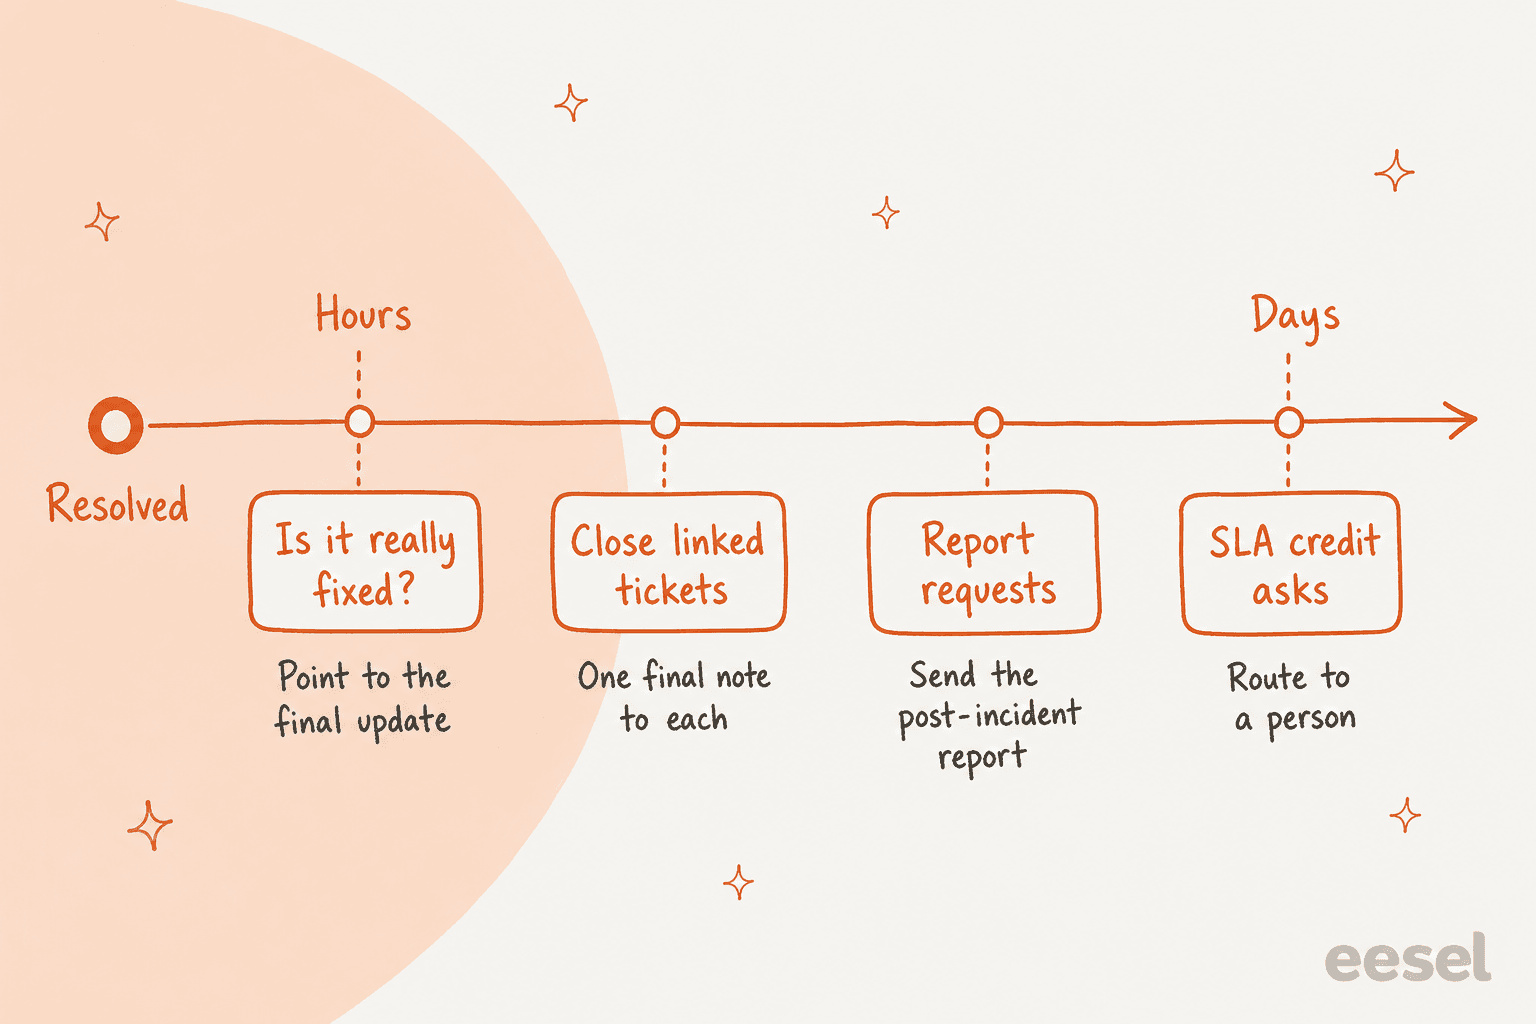
Eis o que chega, mais ou menos em ordem:
- «Está mesmo resolvido?» Chegam em poucas horas, muitas vezes de clientes que nunca viram a publicação de resolvido. A IA pode responder com o texto da atualização final e uma linha convidando a responder caso ainda vejam o problema. Um «continua quebrado para mim» de verdade vai para uma pessoa, pois pode significar que a correção não chegou a todos.
- Fechar todos os tickets vinculados. Envie uma nota final a todo ticket etiquetado com o incidente, não só aos que ainda estão abertos. No Zendesk, resolver o ticket de problema faz a maior parte. No Freshdesk, você resolve os tickets vinculados por conta própria ou faz a IA publicar a nota final em cada um. Acompanhe sua taxa de reabertura nos próximos dias, pois ela mostra se a mensagem de «resolvido» chegou.
- Pedidos do relatório pós-incidente. Clientes maiores pedem a análise, muitas vezes para o próprio compliance. Mantenha uma lista de quem pediu durante o incidente (a etiqueta facilita) e envie o relatório a todos quando for publicado. Não deixe a IA resumir a causa raiz antes de seus engenheiros publicarem.
- Pedidos de crédito por SLA. São questões contratuais com dinheiro envolvido. Encaminhe-as a uma pessoa com o plano do cliente e os horários de início e fim do incidente anexados, do mesmo jeito que eu trataria disputas de cobrança.
A onda também é onde você mais aprende. Conte os tickets etiquetados, quantos chegaram antes da primeira publicação de status e quantos perguntaram «alguma atualização?». Esses três números dizem se sua primeira publicação foi lenta, se seu ritmo se manteve e por onde começar da próxima vez. Os relatórios de suporte com IA podem levantá-los para você.
Acertar isso importa além do próprio dia. Como um fundador no r/SaaS colocou:
"if you wait until an outage to figure this out it’s already chaos, so even a simple status page plus a prewritten we’re investigating template and one owner for updates goes a long way because trying to debug while replying to tickets in real time is how small issues turn into trust problems fast"
Confiança também é o motivo pelo qual eu ligaria isso ao seu trabalho contra o cancelamento. Os clientes que escreveram durante uma queda são os mais propensos a avaliar uma troca depois, e um acompanhamento pessoal do gerente de contas uma semana mais tarde custa muito pouco.
Como configurar antes da próxima queda?
Faça isso em uma terça-feira tranquila, não às 2 da manhã. Esta é a ordem que eu seguiria:
- Nomeie o revezamento de responsáveis pela comunicação. Uma pessoa por turno que não esteja de plantão na engenharia. Escreva ao lado da sua escala de plantão.
- Escreva o modelo de registro de incidente. Os quatro campos: o que está afetado, fatos verificados, o que estamos fazendo, próxima atualização às.
- Pré-aprove a redação. Publicações de «Investigando», «Identificado», «Monitorando», «Resolvido», mais uma resposta a ticket e um e-mail para contas para cada uma. O relatório da incident.io recomenda modelos pré-aprovados para incidentes comuns exatamente por isso.
- Ative a vinculação de tickets. Tickets de problema e incidente no Zendesk, ou tickets vinculados no Freshdesk, mais um formato de etiqueta para cada incidente.
- Conecte a IA com as aprovações ativadas. Configure as respostas públicas para exigir aprovação, etiquetas e notas internas para automático, e conecte o webhook da página de status. Revise uma semana de rascunhos em tickets reais antes de passar qualquer resposta para automático.
- Faça um simulado. Simule um SEV2 em uma marca de teste. Confira se a primeira publicação sai dentro da sua meta, se o batimento dispara, se a macro é atualizada e se todo ticket etiquetado recebe a nota final.
Se sua equipe trabalha com trocas de turno ou cobre pouco os fins de semana, o passo 1 é o mais importante. Uma queda às 3 da manhã sem ninguém no revezamento de comunicação é como a página de status fica em «investigando» por quatro horas.
Experimente a eesel nos seus dias de incidente
Se sua fila de suporte roda no Zendesk, Freshdesk ou Gorgias, o colega de IA para helpdesk da eesel entra como um novo agente que já leu sua central de ajuda e tickets passados. Em um dia de incidente, ele etiqueta todo ticket da queda, responde em tickets associados com a atualização que seu responsável pela comunicação aprovou e passa contas grandes, perda de dados e cobrança direto para uma pessoa, a configuração que a Qontro roda no Freshdesk. Conecte sua página de status por um webhook e cada resposta fica na mesma história da página de status.
Começar é grátis com 100 créditos, depois US$ 299 por mês por 500, com um ticket contando como um crédito não importa quantas atualizações receba. Configure no Zendesk ou no Freshdesk antes da sua próxima queda, não durante ela.