


A IA para rastrear pedidos de recursos faz quatro trabalhos: percebe o pedido dentro de um ticket de suporte, separa-o de bugs e dúvidas de uso, vincula-o a um pedido compartilhado para que a demanda seja contada e responde a todos que pediram quando o recurso é lançado. Os três primeiros são bem cobertos por ferramentas como Canny, Linear e Productboard. O quarto, a resposta, é o que quase nenhuma faz dentro do ticket, e é o que seus clientes notam.
Por isso, configure pelo lado do suporte, não pelo lado do produto. Deixe a IA marcar cada ticket a partir de uma lista fixa, criar ou encontrar o pedido correspondente e manter o ticket vinculado. Quando o pedido é lançado, esses tickets vinculados são sua lista de aviso. O Autopilot do Canny está incluído em todos os planos e lê tickets fechados por conta própria. A integração com o Zendesk do Linear reabre o ticket quando o issue é concluído, mas uma pessoa ainda escreve a resposta.
Se sua fila roda no Zendesk, Freshdesk ou Gorgias e sua equipe de produto roda no Jira, a eesel faz a metade do suporte em uma única passada: marca o pedido, procura no Jira um issue existente antes de criar um novo e redige a resposta de "já foi lançado" quando o issue é fechado. A smava já a usa para categorizar 14.600 tickets do Zendesk por mês em campos, que é a mesma habilidade em que a marcação de pedidos de recursos se baseia.
O que a IA para rastrear pedidos de recursos realmente faz?
A IA para rastrear pedidos de recursos lê cada conversa de suporte, decide se o cliente está pedindo algo que o produto ainda não faz e transforma isso em um registro contado e vinculado com o qual sua equipe de produto pode trabalhar. Ela não decide o que será construído.
Eu cuido da fila de suporte da eesel e vejo a versão bruta disso todos os dias. Alguém envia quatro parágrafos sobre uma dúvida de cobrança, e a última linha diz "além disso, seria ótimo se isso exportasse para o Sheets". Essa linha é o pedido. Para um gerente de produto, o resto é ruído, e um comentarista do Hacker News disse isso anos antes de os LLMs poderem ajudar:
"The Customer Support teams of your customers are going to be one of the main channels for capturing feature requests. We use Zendesk and have custom fields for categorizing and sub-categorizing requests along with a brief description. We do this so that the PMs don't have to read the entire Support ticket if one sentence is about the feature request out of 10 pages of text."

Esse é basicamente o trabalho. Você extrai a frase e a arquiva em um lugar onde ela seja contada, mantendo o link de volta ao ticket. Para a IA, isso se divide em quatro etapas:
- Perceber. Encontrar o pedido, mesmo quando está enterrado em um ticket sobre outra coisa.
- Classificar. É um pedido real, um bug, uma dúvida de uso ou algo que o produto já faz?
- Vincular e contar. Anexar o ticket a um pedido compartilhado, em vez de abrir um novo a cada vez.
- Responder quando for lançado. Usar os tickets vinculados para avisar a cada cliente que pediu.
As etapas de um a três são a parte de "rastreamento" e se sobrepõem bastante à marcação de tickets com IA e à desduplicação de tickets. A maioria das configurações para antes da etapa quatro. Se você já tem um programa de voz do cliente, pense nisto como a fatia de tickets de suporte dele.
Por que os pedidos de recursos se perdem no suporte?
Os pedidos de recursos se perdem porque o suporte os anota no que estiver mais à mão, enquanto o produto procura em outro lugar. O ticket diz "repassei isso para a equipe". Depois disso, o pedido acaba em uma conversa do Slack ou em uma planilha, ou talvez em um marcador de ticket sobre o qual ninguém faz relatórios.
Aqui está a versão com planilha, de um Head of Product no Reddit:
"So, what ends up happening is each of these customers has a google sheet of their asks/needs/requests. As the Head of Product, I am always checking these spreadsheets and trying to prioritize burning asks into our dev cycles. Its a nightmare to see it all in one place, and understand "what is the biggest need from our clients right now". I find myself prioritizing one feature only impacting a $400K client vs. a feature that would benefit 10 $20K clients."

E aqui está o lado do cliente da mesma bagunça, de alguém cujo ticket ficou parado por um mês:
"I'm not asking for instantaneous results. I'm asking for communication. My ticket sat untouched for something like a month before I sent a support ticket in and it was then tagged as a feature request."
Veja o que realmente irritou esse cliente. Não foi o recurso não ter sido lançado. Foi o ticket ter sido marcado como pedido de recurso e depois nada ter voltado. Um marcador é arquivamento, não uma resposta.
Já vi isso dar certo no próprio produto da eesel. Os pedidos que mais apareciam nas anotações de vendas da eesel eram integrações de helpdesk que faltavam: Front, HubSpot Service Hub, Jira Service Management e Zoho Desk surgiam o tempo todo, e negócios foram perdidos por isso. Esses pedidos foram contados em vez de dispersos, então viraram trabalho, e os quatro estão agora na lista de integrações. Quando o pedido de um cliente é lançado, a atualização no canal da equipe da eesel se parece com esta que meu colega Amogh publicou em maio: "CUS-605 prompt compressor shipped, unblocked." Um ID de issue e um cliente, mais uma pessoa que agora sabe que precisa avisá-lo.
Como a IA separa um pedido de recurso de um bug ou de uma dúvida de uso?
A IA separa por intenção, mas só faz isso bem depois que você escreve as categorias com exemplos. A divisão usual tem três faixas: "o botão de exportar está quebrado" é um bug, "vocês podem adicionar exportações semanais?" é um pedido de recurso, "não encontro o botão de exportar" é uma dúvida de uso. Eu acrescentaria uma quarta, porque é a faixa que mais economiza tempo.
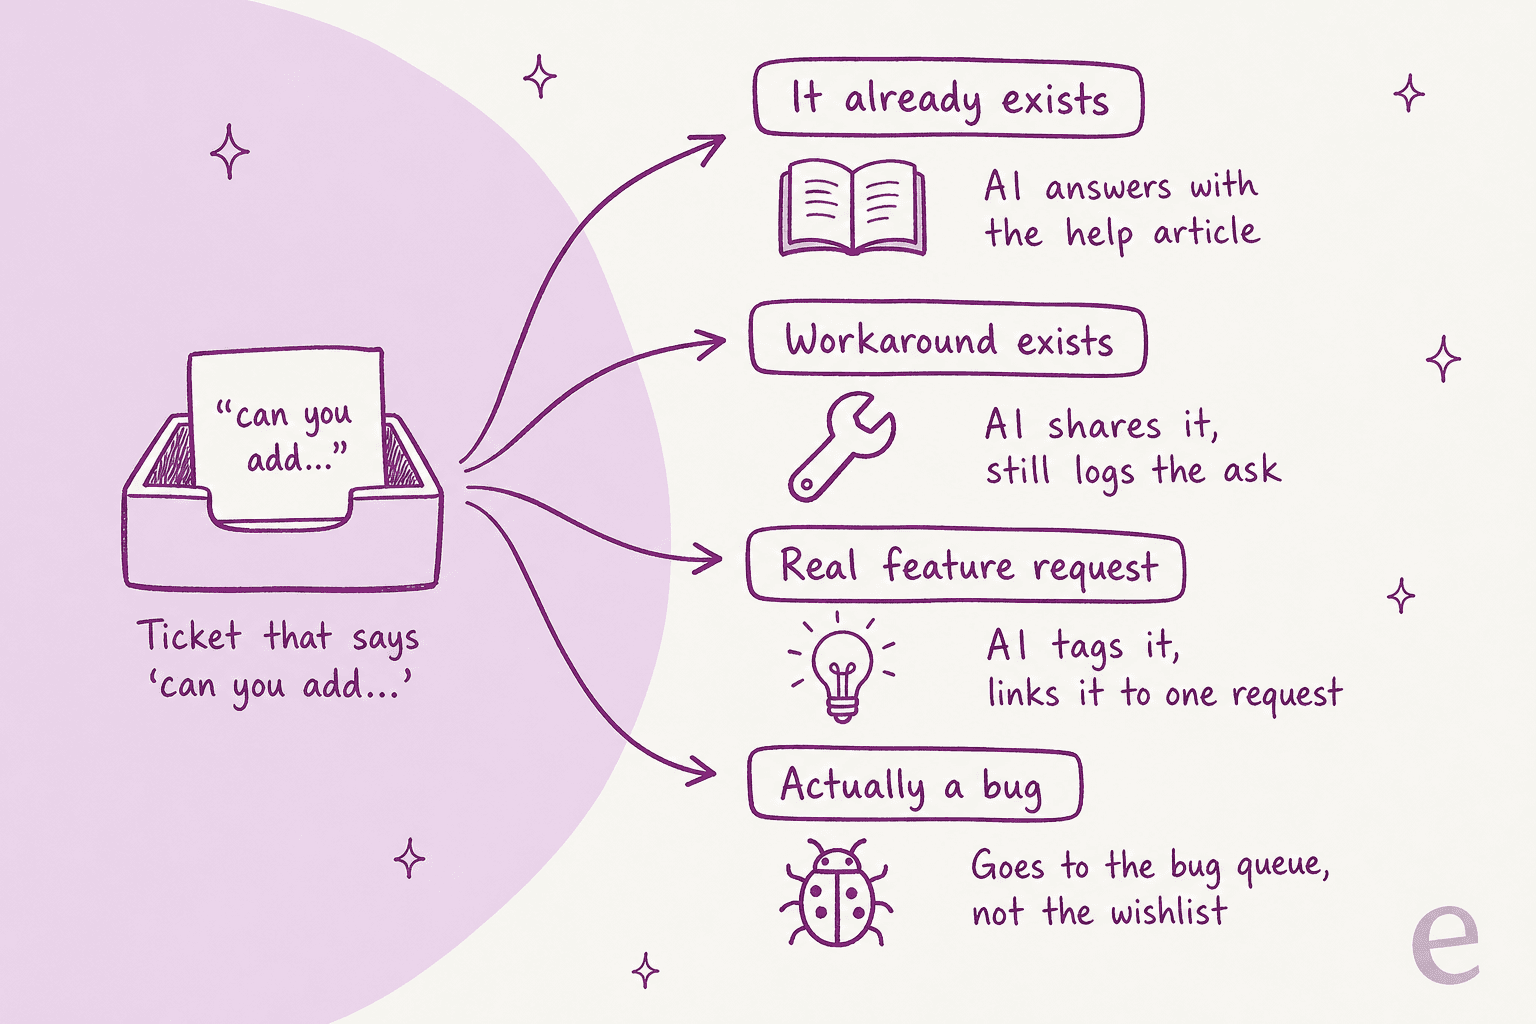
Já existe. Um bom número de tickets de "vocês podem adicionar X?" acaba sendo sobre algo que o produto já faz. Uma boa IA de suporte deve responder a esses a partir da sua central de ajuda em vez de registrá-los, já que um pedido de um recurso existente é na verdade um problema de descoberta. Uma customer success manager no Reddit criticou repasses vagos exatamente por esse motivo:
"So you don't have any detail on the request? No validation? What if its actually something they could already do or approximately do 80% of with existing features? You don't have conversations around why they want it or how it will benefit them? "Hey PM. Mr customer said they want to send emails! Figure it out!""
Existe uma alternativa. Compartilhe-a, mas registre o pedido mesmo assim. Quem vive com uma alternativa ainda conta como um voto.
É um pedido real. Marque-o e escreva o pedido com as próprias palavras do cliente, depois vincule-o ao pedido correspondente.
Na verdade é um bug. Envie-o para o fluxo de triagem de bugs. Um bug arquivado como desejo pode ficar meses em um quadro de roadmap, e enquanto isso o cliente acha que você está ignorando algo quebrado.
O que torna isso confiável é uma lista fixa. A Rúngne, uma marca de roupas de escalada no Gorgias, roda seu agente de triagem da eesel com uma lista definida de marcadores. A contagem da própria história é 880 tickets marcados em um mês, todos dessa lista, "nothing invented". Um marcador de pedido de recurso funciona do mesmo jeito. A IA escolhe da sua lista em vez de inventar uma categoria nova toda terça-feira. Se você está começando do zero, meu guia sobre como automatizar a marcação de tickets mostra como montar essa lista.
O que cada pedido rastreado deve registrar?
Cada pedido rastreado deve conter o pedido com as próprias palavras do cliente, um link de volta para cada ticket, quem pediu, qualquer alternativa que você deu e um status. São cinco campos, e você acabará precisando de todos depois.
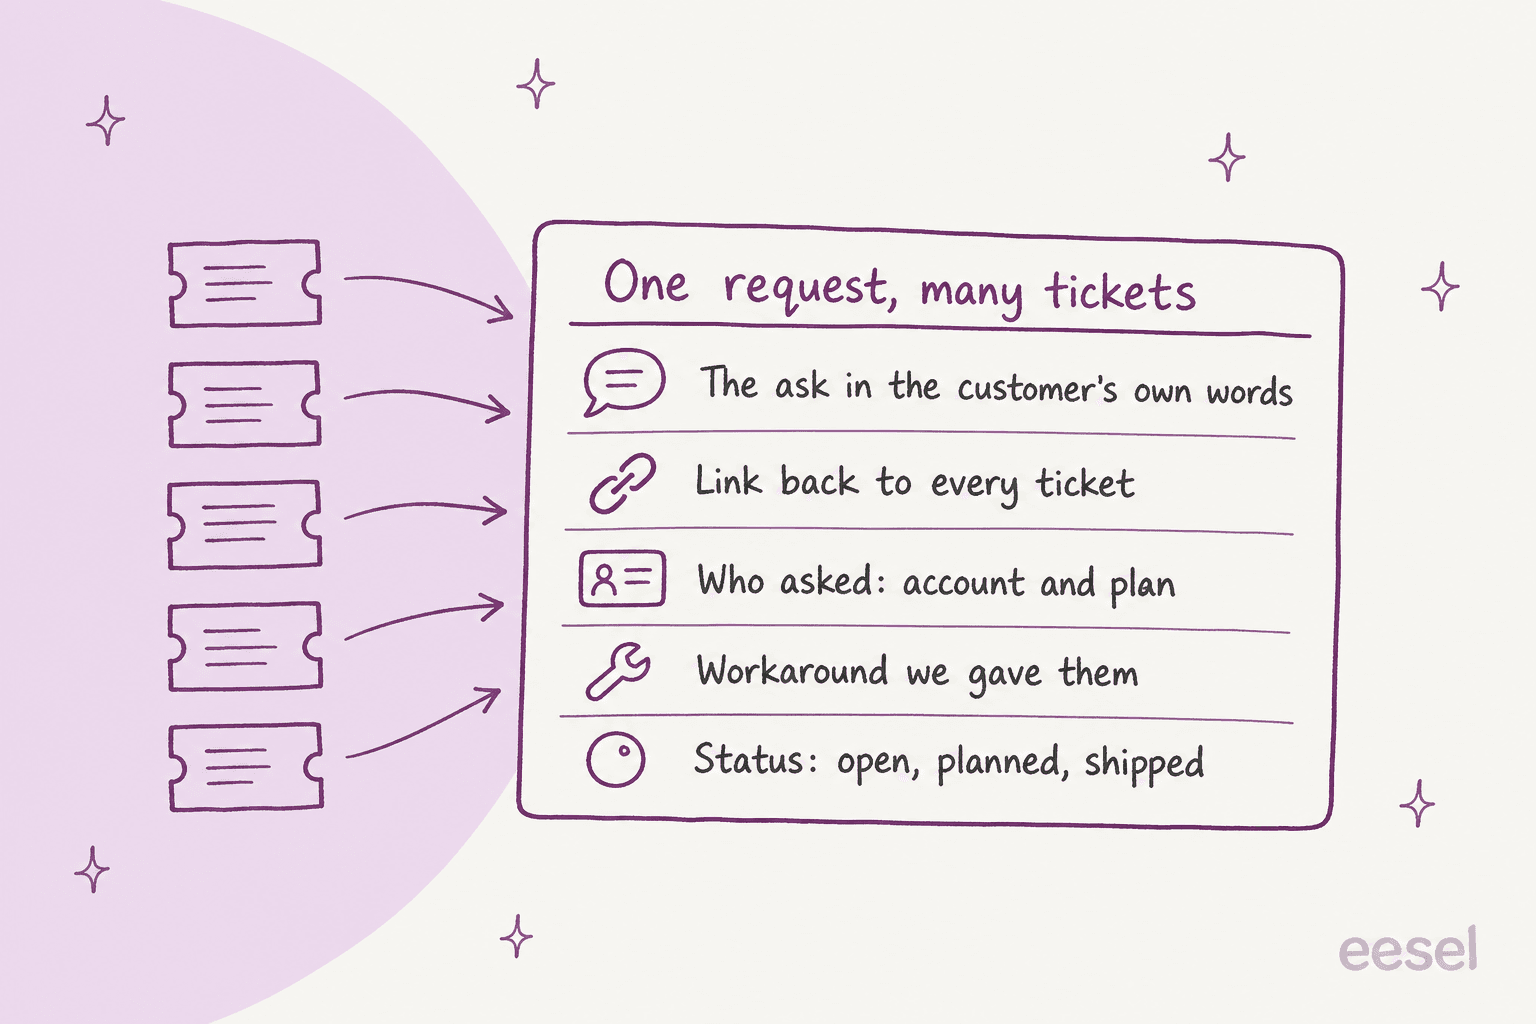
A maioria das configurações perde o link de volta para cada ticket. Cole um resumo em uma planilha e o link do ticket simplesmente some, então seis meses depois, quando o recurso é lançado, ninguém sabe dizer quem pediu. O Linear lida bem com isso: quando um issue é criado ou vinculado a partir do Zendesk, "will automatically add a request pointing back to the source", e o pedido cita a mensagem original do cliente com nome e carimbo de data e hora.
"Quem pediu" importa porque uma contagem bruta sozinha mente. O Head of Product do Reddit acima estava pesando um cliente de US$ 400 mil contra dez clientes de US$ 20 mil. O Linear permite marcar um pedido como importante por cliente, e a lista de votantes do Canny mostra o MRR de cada cliente ao lado do ticket do Zendesk vinculado. Quando seu helpdesk já conhece o plano ou o tamanho da conta, faça a IA escrevê-los no pedido, para que a contagem possa ser ponderada e não apenas somada.
Paul Graham fez a outra metade do argumento em 2009, escrevendo sobre a própria página de pedidos de recursos do Hacker News:
"One of the main points of the feature request page is to separate feature requests from submmissions. You want to do this because most are either duplicates or bad ideas, and yet (like all meta discussion, including this post) tend to get a lot of upvotes. The feature request page serves that purpose even if no one reads it."
Duplicatas são normais, não a exceção. Então "vincular a um pedido existente" tem que ser o primeiro movimento da IA, com "criar um novo" como alternativa.
Quais ferramentas rastreiam pedidos de recursos a partir de tickets de suporte?
As ferramentas que rastreiam pedidos de recursos a partir de tickets de suporte se dividem em quadros do lado do produto (Canny, Productboard, Featurebase, Jira Product Discovery), um rastreador de issues que aceita pedidos (Linear) e IA dentro do próprio helpdesk (a triagem inteligente do Zendesk ou um agente como a eesel). Veja como se comparam nos quatro trabalhos. Os preços vêm da página de preços de cada fornecedor, conferidos em 30/10/2026.
| Ferramenta | Como os tickets entram | O que a IA faz | Como quem pediu fica sabendo | Preço inicial |
|---|---|---|---|---|
| Canny | O Autopilot lê tickets fechados do Zendesk, Freshdesk, Help Scout; app na barra lateral do Zendesk | Encontra pedidos, mescla duplicatas, modo manual ou automático | E-mails de status, inclusive para "users tracked internally" | Grátis para 25 usuários rastreados; Pro US$ 99/mês para 100 (US$ 79 anual) |
| Linear | Criar ou vincular um issue a partir da barra lateral do Zendesk ou Front | "Create with Linear Agent" escreve o issue a partir de toda a conversa; Triage Intelligence sinaliza duplicatas | Nota interna + ticket reaberto; uma pessoa escreve a resposta | Business US$ 16/usuário/mês, cobrado anualmente (necessário para o Zendesk) |
| Productboard | Tickets do Zendesk importados por marcador ou gatilho; Freshdesk um de cada vez | O Spark classifica o feedback em oportunidades; vincular automaticamente a recursos é "Not yet" no Spark | Um gerente de produto escreve uma atualização no portal | Não divulgado; mínimo de 5 makers |
| Featurebase | Caixa de entrada própria (IA), apps do Zendesk e HubSpot (manual) | Vincula feedback a pedidos, mescla duplicatas claras, divide mensagens com vários pedidos | E-mail de status; uma atualização personalizada pode responder em conversas vinculadas | Growth US$ 29/assento/mês anual (US$ 37 mensal) |
| Jira Product Discovery | Colar um link do Zendesk ou JSM em uma ideia como insight | O Rovo resume e faz brainstorm, só Premium | Nada embutido hoje | Grátis para 3 criadores; Standard US$ 10,50/criador/mês |
| Triagem inteligente do Zendesk | Classifica todo ticket com comentário público | Marca a intenção; precisa de um tópico personalizado de "pedido de recurso" | Nada embutido | Suite Professional; Copilot US$ 50/agente/mês para usar em fluxos de trabalho |
| eesel | Entra no Zendesk, Freshdesk, Gorgias e outros helpdesks como agente | Marca a partir da sua lista, escreve campos, procura duplicatas no Jira antes de criar | Redige a resposta em cada ticket vinculado, acordado por um webhook | 100 créditos grátis; US$ 299/mês para 500 créditos |
Algumas linhas dessa tabela merecem um olhar mais atento.
O Canny é o mais automático na captura. O Autopilot está "Included in all plans" e lê os tickets só "after they are closed out" no helpdesk, começando pelos 30 dias anteriores na primeira conexão. Ele também ignora campos de dados pessoais. O que vigiar é a contagem: as pessoas cujo feedback o Autopilot encontra contam como usuários rastreados, e o preço do Pro sobe com os usuários rastreados (100 por US$ 99 ao mês, 500 por US$ 349, 1.000 por US$ 661 no pagamento mensal).
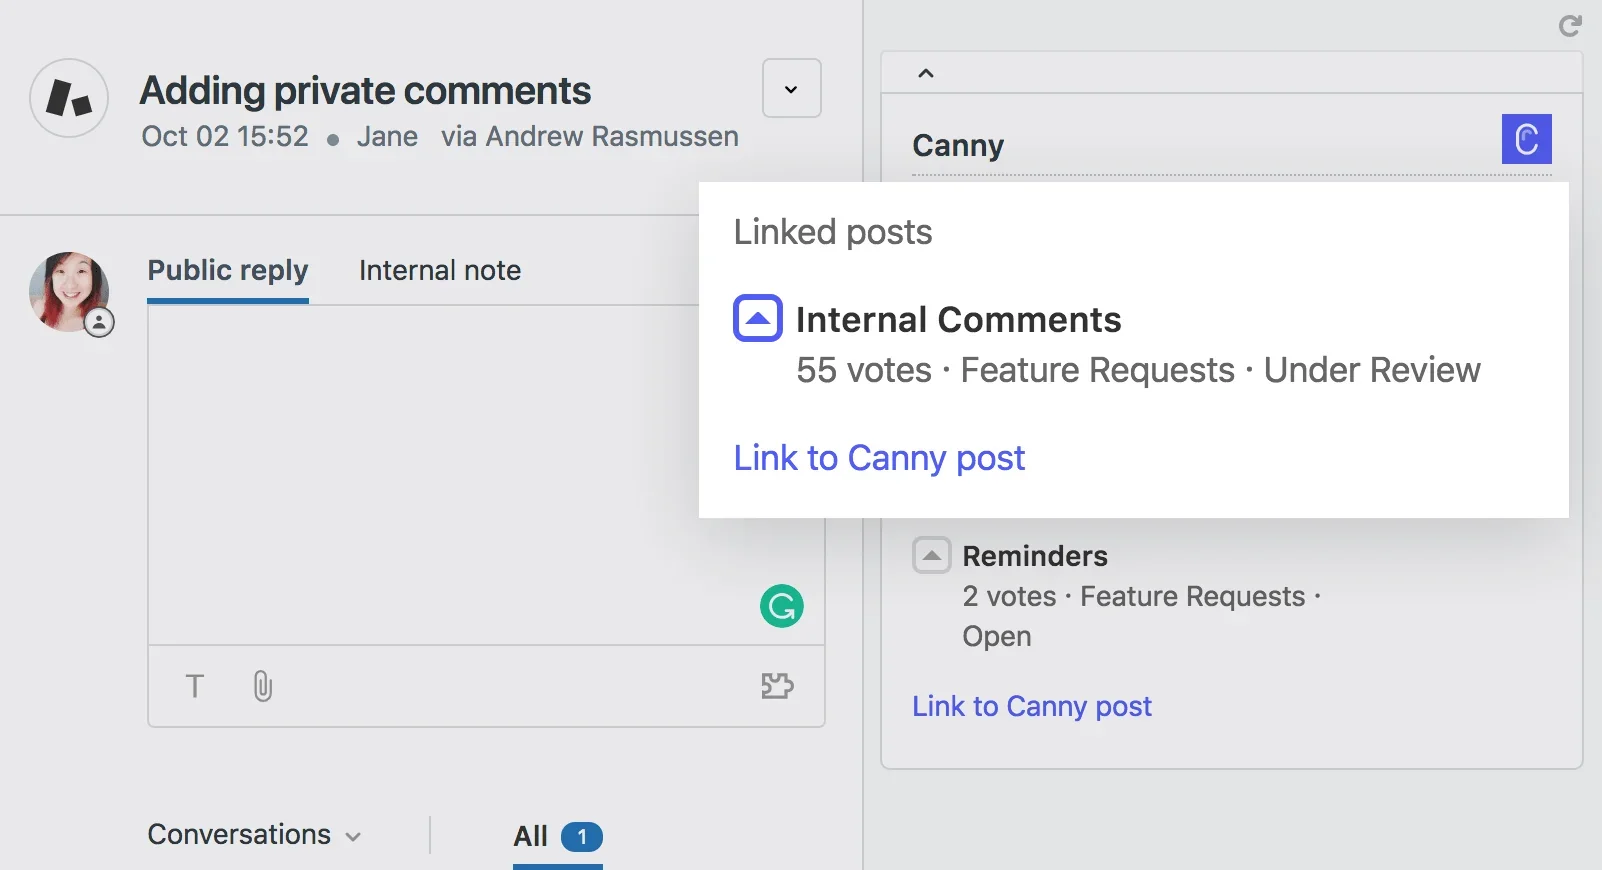
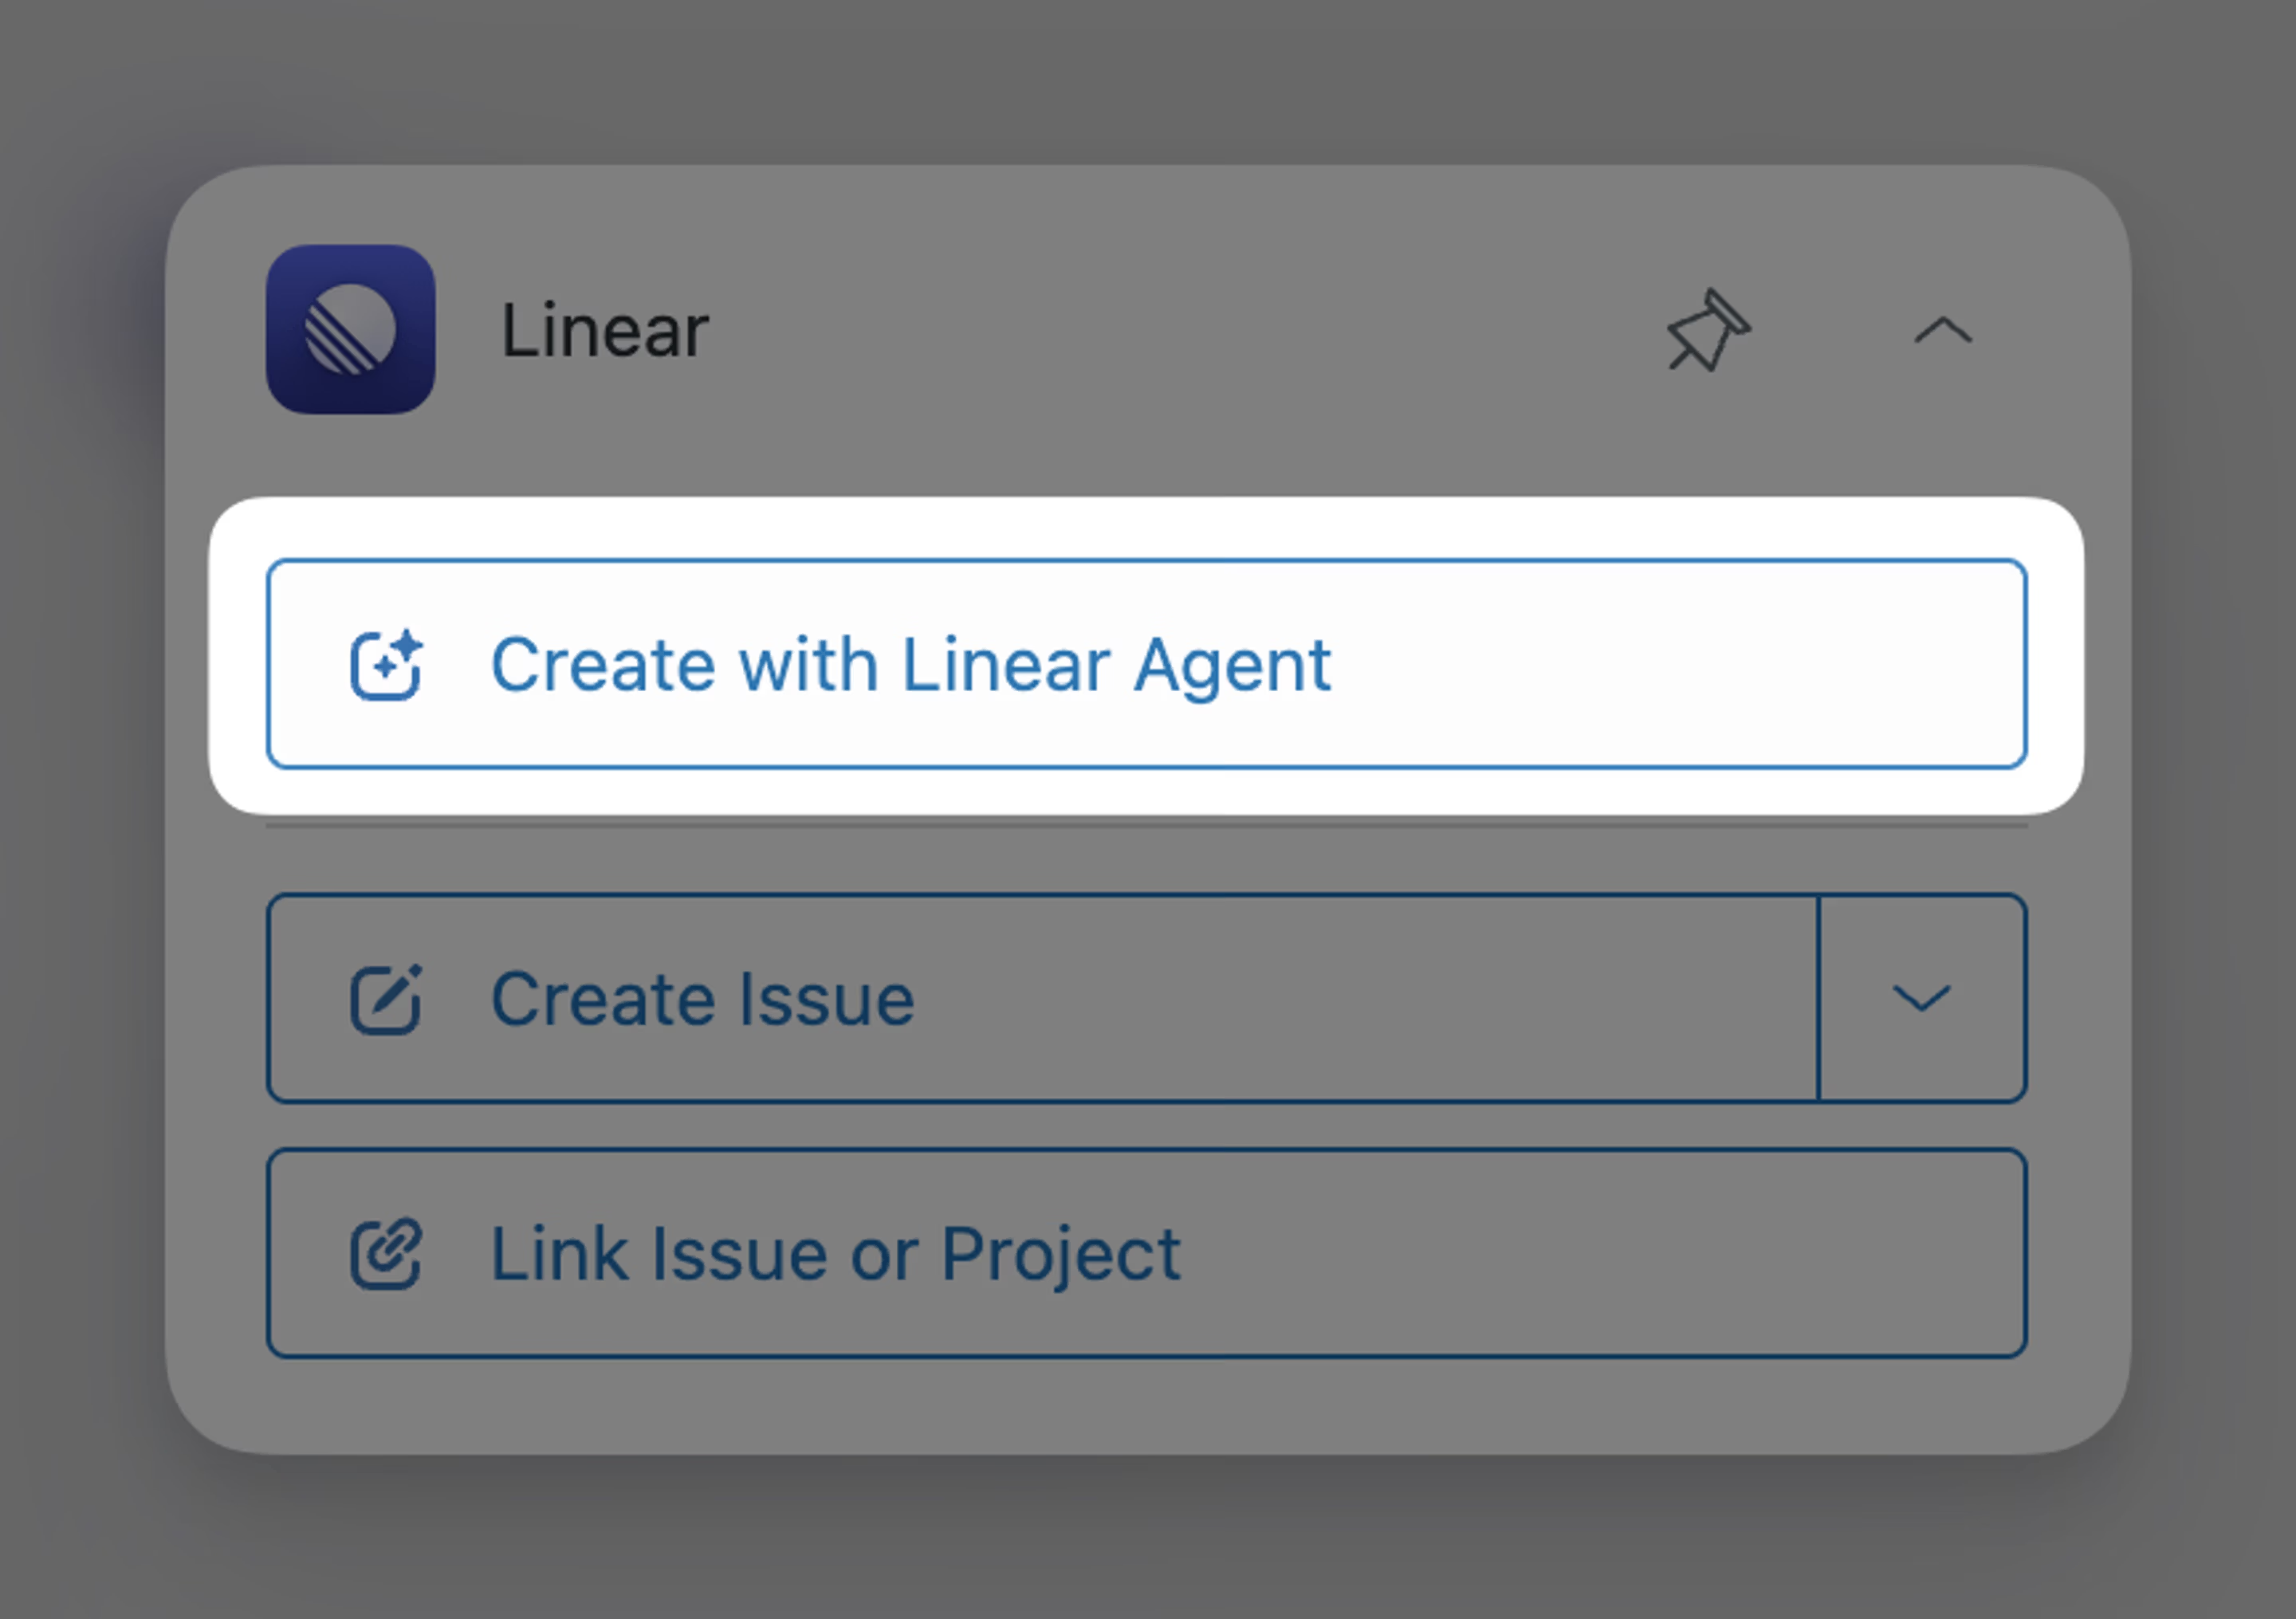
O Linear é o mais forte em manter o link. Você pode vincular "as many Zendesk tickets to a Linear issue as you like", e quando issues duplicados são mesclados, os links do Zendesk passam para o issue que sobrevive, de modo que as automações continuam funcionando. Sua IA é acionada por um agente. Quem trabalha o ticket clica em "Create with Linear Agent", e então o Linear lê a conversa inteira, anexos incluídos, para escrever o issue. Ele não vai varrer todos os tickets por conta própria.
A IA do próprio Zendesk marca, mas não rastreia. A triagem inteligente classifica tickets por intenção, mas não encontrei na documentação um tópico embutido de "pedido de recurso". Você teria que criar um tópico personalizado por conta própria. Ela também não conta a demanda por recurso, então você ainda precisaria de um quadro ou de um rastreador na outra ponta. Minha análise da triagem inteligente aprofunda os planos.
A IA do Productboard lê, mas ainda não vincula. O Spark está incluído em todo workspace e lê o feedback do Zendesk para montar uma lista ranqueada de oportunidades com citações. Mas na própria tabela comparativa do Productboard, a vinculação automática de insights para o Spark está marcada como "Not yet", e a Productboard AI mais antiga que fazia isso não está mais à venda.
Se você está avaliando as ferramentas do lado do produto isoladamente, meus artigos sobre alternativas ao Featurebase, Jira Product Discovery AI e Linear vs Jira vão além do que posso aqui.
O que acontece quando o recurso pedido é lançado?
Quando o recurso é lançado, a maioria das ferramentas envia um e-mail de status da ferramenta de produto ou deixa uma nota interna no ticket. Alguém no suporte ainda precisa escrever a resposta de verdade. O "rastreamento" é automatizado quase em todo lugar. O "avisar o cliente" quase nunca.
Veja o que cada ferramenta faz nessa última etapa, segundo a própria documentação:
- Linear publica uma nota interna e reabre o ticket do Zendesk ou Front "so that your agents will be able to notify the customers". Uma pessoa escreve a resposta.
- Featurebase adiciona uma nota interna às conversas vinculadas numa mudança de status. "Sending a customer reply is a separate action", segundo sua documentação de atualizações de status, embora uma atualização personalizada possa responder em conversas vinculadas.
- Canny envia e-mail aos usuários cujo pedido chegou por um ticket se você marcar "Notify users tracked internally". O e-mail vem do Canny, e "if a user replies directly to the email, the reply is not recorded", segundo sua documentação de e-mails de mudança de status.
- Productboard permite que um gerente de produto escreva uma atualização no portal e a envie aos votantes e a todos com um insight vinculado. "It is not yet possible to reply to email updates", segundo seu guia para fechar o ciclo.
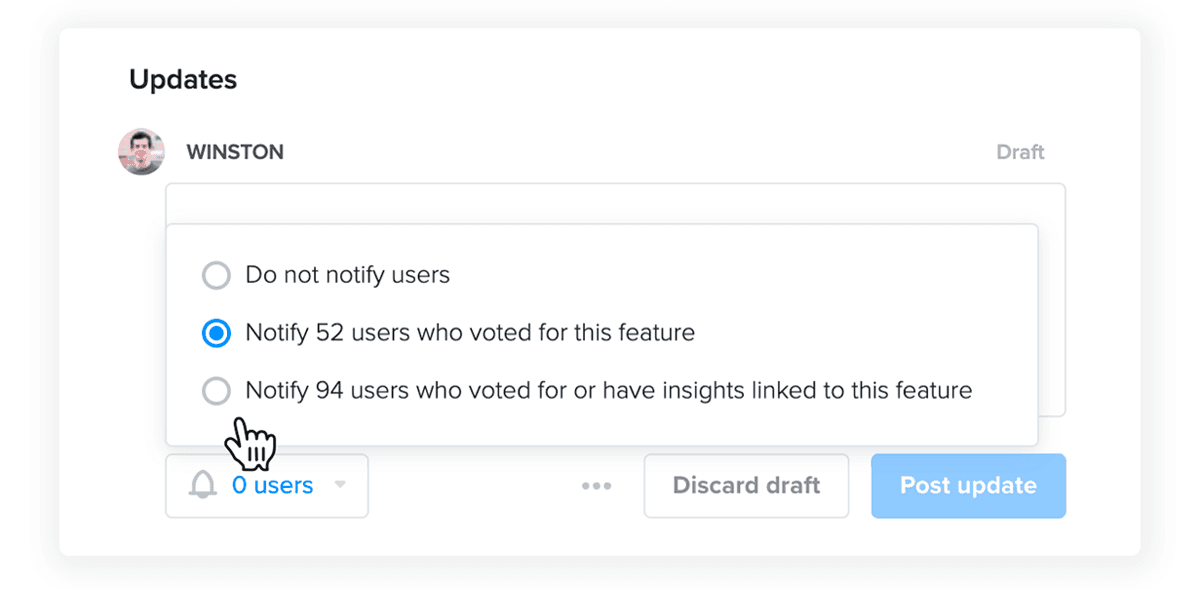
Nesse exemplo do Productboard, 52 pessoas votaram, mas 94 tinham votado ou tinham feedback vinculado. Então quem pediu pelo suporte é uma fatia grande do público, e nunca tocou no quadro. Pediu em um ticket. Um avaliador do G2 sobre o Canny resumiu a lacuna com clareza:
"It is very basic. Unless the PM makes comments, it is difficult to understand if there has been any progress. There is no way to close the loop when a feature has been released."

Essa avaliação vem de uma equipe em que o Canny "was a way for our support team to submit feature ideas to the Product team", que é exatamente a configuração de que este artigo trata.
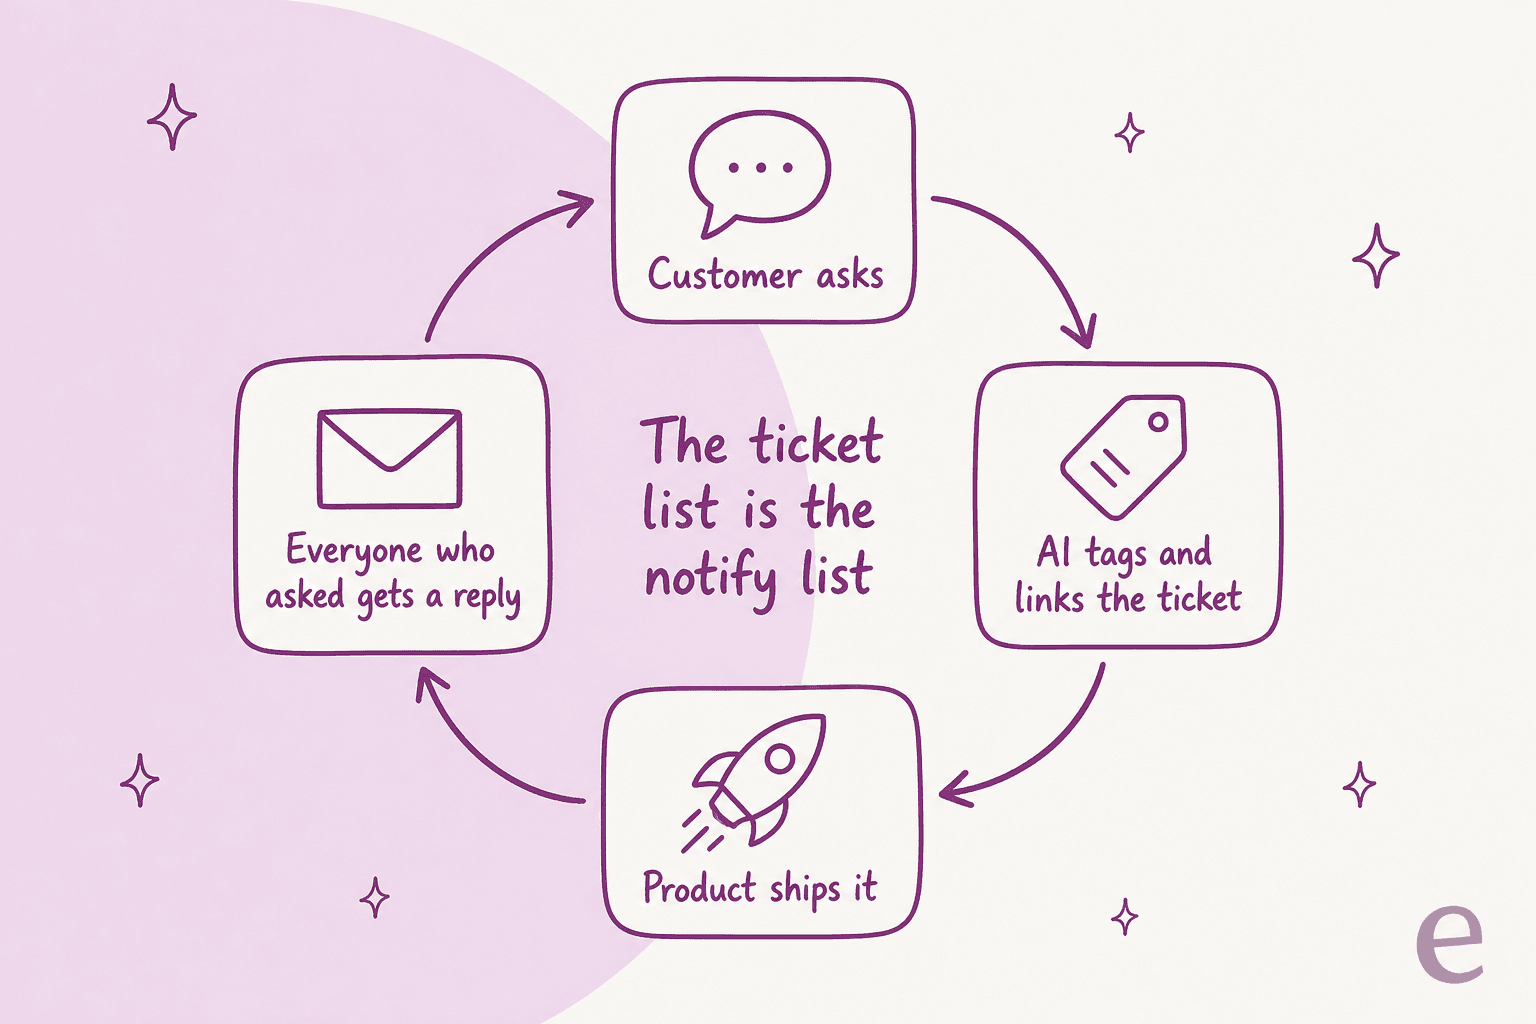
Esta é a mudança que eu faria se estivesse configurando isso hoje. Trate a lista de tickets como a lista de aviso. Se cada pedido mantém um link para cada ticket que o fez, então "foi lançado" é uma lista conhecida de conversas, cada uma com seu próprio contexto. Uma IA pode redigir uma resposta em cada uma, mencionando o que aquele cliente queria e o que usou nesse meio-tempo, e uma pessoa as aprova. O cliente recebe a resposta na mesma conversa em que pediu, da mesma equipe. É a mesma ideia de escalar tickets do Zendesk para o Jira, executada ao contrário.
Como configurar o rastreamento de pedidos de recursos com IA no seu helpdesk?
Você configura em seis etapas: definir o que conta como pedido, dar à IA uma lista fixa de marcadores, escolher onde os pedidos ficam, fazê-la pesquisar antes de criar, começar com aprovações e ligar a resposta de "já foi lançado". Abaixo está como eu trataria cada uma. Uso a eesel como exemplo porque é o que conheço, mas as etapas valem para qualquer agente.
1. Escreva o que é um pedido de recurso
Coloque as quatro faixas de antes nas instruções do agente com dois ou três exemplos reais de cada, tirados dos seus próprios tickets. Inclua a faixa "já existe", com os artigos de ajuda a partir dos quais ele deve responder. As instruções na eesel são texto simples, o que significa que mudar o que conta é uma edição rápida e não um projeto. A configuração da smava funciona do mesmo jeito: seu agente de categorização "picks one category from smava's mapping document, judging by intent", e cada regra vive nas instruções.
2. Dê a ele uma lista fixa de marcadores e um campo
Escolha um marcador para pedidos de recursos e, se seu helpdesk tiver campos personalizados, um campo para a área do produto. As ações do Zendesk da eesel incluem Add tags, Update ticket e Get ticket field options, esta última para que leia os valores reais dos seus campos em vez de adivinhar. A SE Ranking usa isso para medição. Ela pediu um marcador ai_handled em todo ticket que a eesel toca, para que os números vivam no Zendesk e não na cabeça de alguém. Se você faz relatórios no Zendesk Explore, meu guia sobre relatórios de marcadores de tickets mostra como montar gráficos das contagens.
3. Decida onde os pedidos ficam
Se sua equipe de produto roda no Jira, o agente pode criar lá diretamente (meu guia de Zendesk e Jira cobre também o caminho nativo). A integração com o Jira Service Management da eesel tem Create Issue (projeto, resumo, descrição, responsável, etiquetas) e Label Issue. Se sua equipe usa Asana, há uma integração nativa com o Asana que cria tarefas. Para Linear, Canny ou Productboard não há integração nativa da eesel na documentação, então você conectaria a API deles por meio do Network Access, que permite ao agente fazer chamadas GET, POST, PATCH e DELETE para qualquer API REST que você autorize. A outra opção é manter o app do Zendesk do próprio rastreador para vincular e usar o agente só para marcar e responder.
4. Faça-o pesquisar antes de criar
Esta etapa é o que evita duplicatas. A integração do Jira da eesel tem uma ação Search Issues que "finds issues with a JQL query, so your agent can find related or duplicate issues". A documentação do Asana diz sem rodeios: "Tell it to search before it creates. Otherwise you get a second copy of a task that already exists." Escreva isso nas instruções. Pesquise primeiro e vincule se houver correspondência, crie só quando não houver, e em ambos os casos adicione o link do ticket e o cliente ao issue.
5. Comece com mesclagens e novos issues sob aprovação
Cada ação da eesel pode rodar em Auto, Needs approval ou Disabled, por agente, como descreve a documentação de ações e aprovações. Minha escolha seria a marcação em Auto desde o primeiro dia, com Create Issue em Needs approval nas primeiras semanas. Mesclagens de IA sem supervisão podem enterrar o pedido de um cliente, e foi isso que aconteceu com este usuário do Canny:
"Their AI assistant that auto-creates features for you merges tickets in a way that's not helpful. What the AI tool was doing was: 1. Creating a feature request based on feedback 2. Merging an old ticket into the newly created feature request That was driving me mad! The trouble was being able to find my old ticket that I KNEW I created."
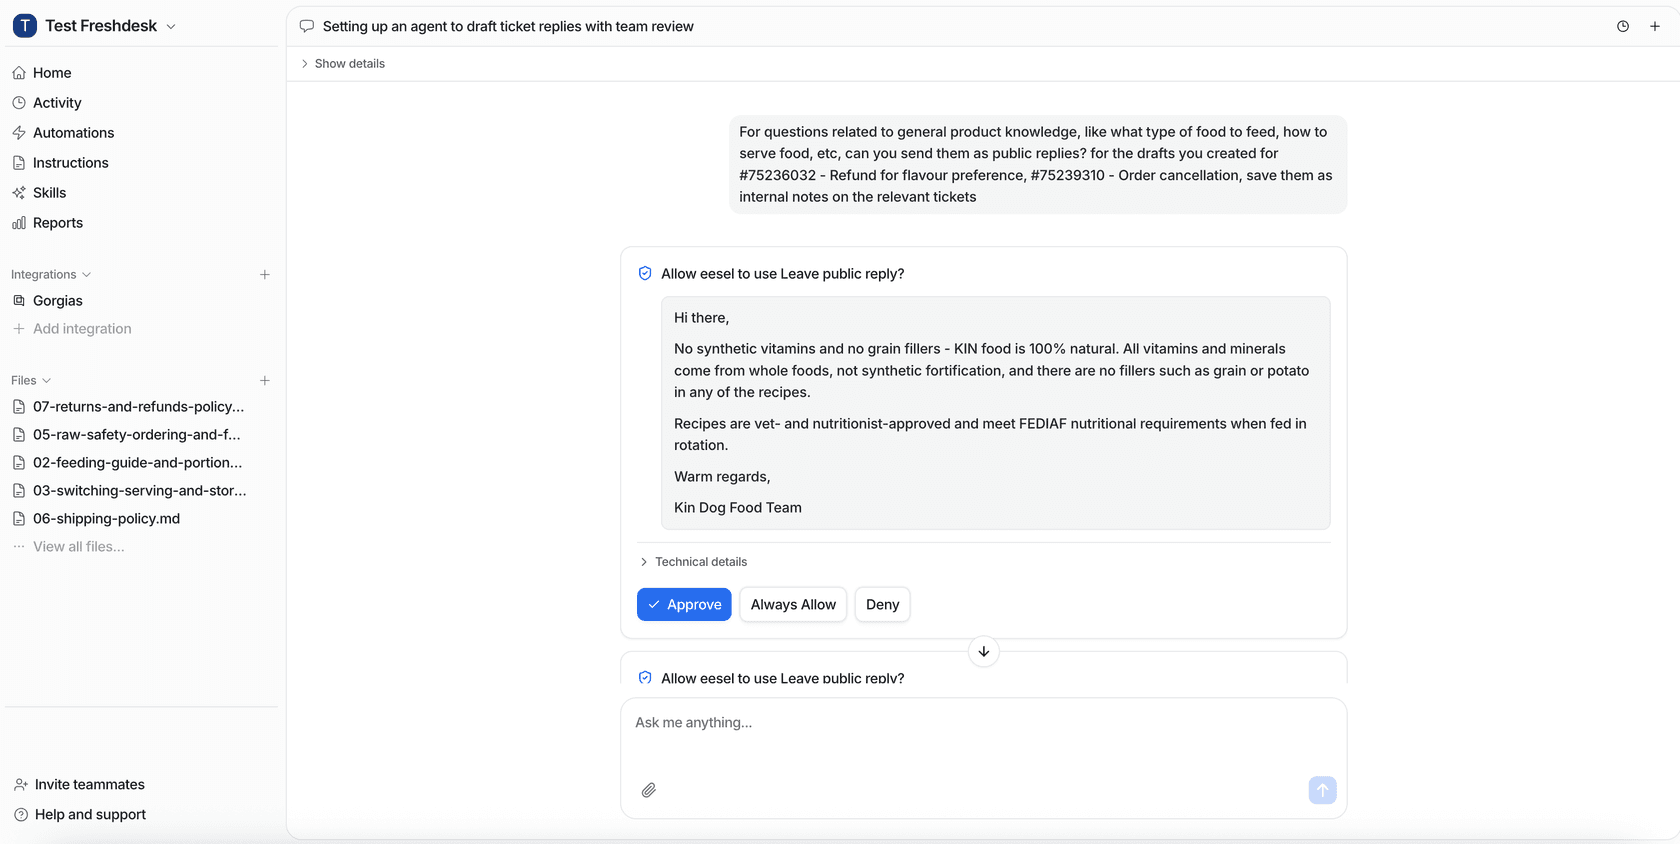
Depois de algumas semanas, se as aprovações parecerem certas, clique em "Always allow" nas que você confia, e essa ação passa para Auto a partir daí.
6. Ligue a resposta de "já foi lançado"
Há um limite real aqui. Os gatilhos do Jira da eesel disparam quando um issue é criado ou comentado, não quando seu status muda, então ela não vai saber de "Done" por conta própria. A alternativa é uma regra do Jira Automation que envia uma requisição web para um webhook da eesel quando um issue passa para Done. "Send any JSON you like, and your agent reads all of it." O agente acorda com a chave do issue, procura no helpdesk os tickets marcados e vinculados a ele e redige uma resposta em cada um. Eu manteria as respostas em Needs approval, pelo menos até você ter lido um lote.
Para a visão semanal, uma programação pode rodar toda segunda-feira e publicar os principais pedidos em um canal do Slack com a integração com o Slack da eesel, desde que ela tenha sido convidada para esse canal. A habilidade de Reports "Analyze ticket trends" cobre o mesmo terreno pelo outro lado: os temas que não param de aparecer, com volume e sentimento. Se você preferir comandar por um terminal, a CLI da eesel lista automações com eesel automations, conecta o Jira com eesel integrations connect jira e trata aprovações pelo terminal, então um agente de código como o Claude Code pode comandar o mesmo agente que você configurou no painel.
Você deve contar os pedidos de recursos ou ponderá-los?
Pondere-os, mas mantenha a contagem bruta visível também. Sozinha, uma contagem bruta premia quem escreve mais. Um gerente de produto no Reddit que usa o Canny descreveu exatamente esse viés:
"I just feel like they just make it easier for users to throw feature requests at my team and in my experience often the vast majority of feature request don't help a ton unless a common request and they could be biased by power users."
Uma pontuação de IA mais esperta não vai resolver isso. Entradas melhores resolvem. Se cada ticket vinculado carrega a conta e o plano, um gerente de produto pode ordenar por "pedidos de clientes no plano mais alto" ou "pedidos de contas que mencionaram cancelar". A documentação do Linear dá o exemplo de uma visão de issues do nível Enterprise "where each issue has at least 20 requests", ordenada por número de clientes. A parte do suporte é garantir que esses dados estejam no pedido, e decidir o que construir continua com o produto.
Há também uma razão do lado do suporte para registrar com cuidado, e uma customer success manager no Reddit disse bem:
"It's pretty big, especially in a CYA way. For example, if an Enterprise customer threatens to cancel for years due to a missing feature, you need to make that well known in case they churn so people know that you sounded the alarms."
Um marcador com a conta nele é esse alarme, registrado por escrito. E, uma vez que os pedidos estão marcados de forma consistente, eles se encaixam direto em relatórios de motivo de contato junto com tudo o mais que sua fila conta.
Rastreie pedidos de recursos com a eesel
A eesel é uma colega de helpdesk com IA que entra na sua fila existente no Zendesk, Freshdesk ou Gorgias, de modo que o rastreamento de pedidos de recursos acontece onde o pedido chega, não em uma ferramenta separada que o suporte tenha que lembrar de abrir. Ela responde os tickets de "já existe" a partir da sua central de ajuda, marca os pedidos reais a partir da sua própria lista, pesquisa no Jira antes de criar para que duplicatas sejam vinculadas em vez de se multiplicarem e redige a resposta de "já foi lançado" em cada ticket vinculado quando o trabalho é entregue.
A parte de marcação já roda em volume: a smava categoriza 14.600 tickets do Zendesk por mês em campos, a Dokument 24 marca 430 tickets por mês por produto, e os agentes da SE Ranking criaram cerca de 400 tickets para sua equipe de segunda linha em um mês com as evidências anexadas.
O preço é por ticket, não por assento: US$ 299 por mês para 500 créditos, e um ticket é 1 crédito, não importa quanto o agente faça dentro dele, então marcar, pesquisar no Jira e criar um issue em um ticket continua custando um crédito. Há um plano gratuito com 100 créditos para testar na sua própria fila. Experimente a eesel.