

クライアント別ナレッジベースとは何か、誰に必要か
クライアント別ナレッジベースとは、1つのクライアント企業または1つの対象グループに限定したヘルプコンテンツです。クライアントは自分の記事と共有記事を見られます。それ以外の人は共有記事だけを見ます。
最終的にこれが必要になるチームは4種類あります。
- 代理店やアウトソーシングのサポートチーム:1つのヘルプデスクから複数ブランドのサポートを運営します。クライアントAの返金ポリシーがクライアントBのチャットに表示されてはいけません。
- MSP:各クライアントのネットワーク、ベンダー、運用手順書を文書化します。これだけでソフトウェアの一大カテゴリーになっています(HuduとIT Glueについては後述)。
- B2B SaaSチーム:エンタープライズ顧客が、カスタム構成、SSO設定、契約固有のSLAを持っています。
- 複数ブランドを持つ企業:マルチブランドのカスタマーサポートのガイドで取り上げました。
あるZendesk管理者がこの問題の形を説明したもので、私が見つけた中で最も的確な表現です。
"Can anyone advise on configuration for guide where I have 100 unique sites that need a help center? 2/3 of the content needs to be available for all end users but 1/3 of content is site-specific and needs to be invisible to users outside of that specific site. Multi brand? Orgs/tags? Labels?"

この比率に注目してください。3分の2が共有、3分の1がクライアント固有です。この比率が、ナレッジベース管理の構成からAIの設定まで、この記事の残りのほとんどを左右します。
私はAliciaで、eeselでAIエージェントを作っています。そのため、クライアントAの顧客が質問したときにAIが何を読んでよいか、という検索側に多くの時間を割いています。記事の後半はそこに充てます。クライアント固有のコンテンツが、気づかないうちにクライアント固有でなくなるのがそこだからです。
3つの分離レベル
どのヘルプデスクも、ブランド、ポータル、ワークスペース、Docsサイトなど呼び方は違っても、同じ3つのレベルの組み合わせを提供しています。目的を果たす最も低いレベルを選んでください。1段上がるごとに運用の手間が増えるからです。
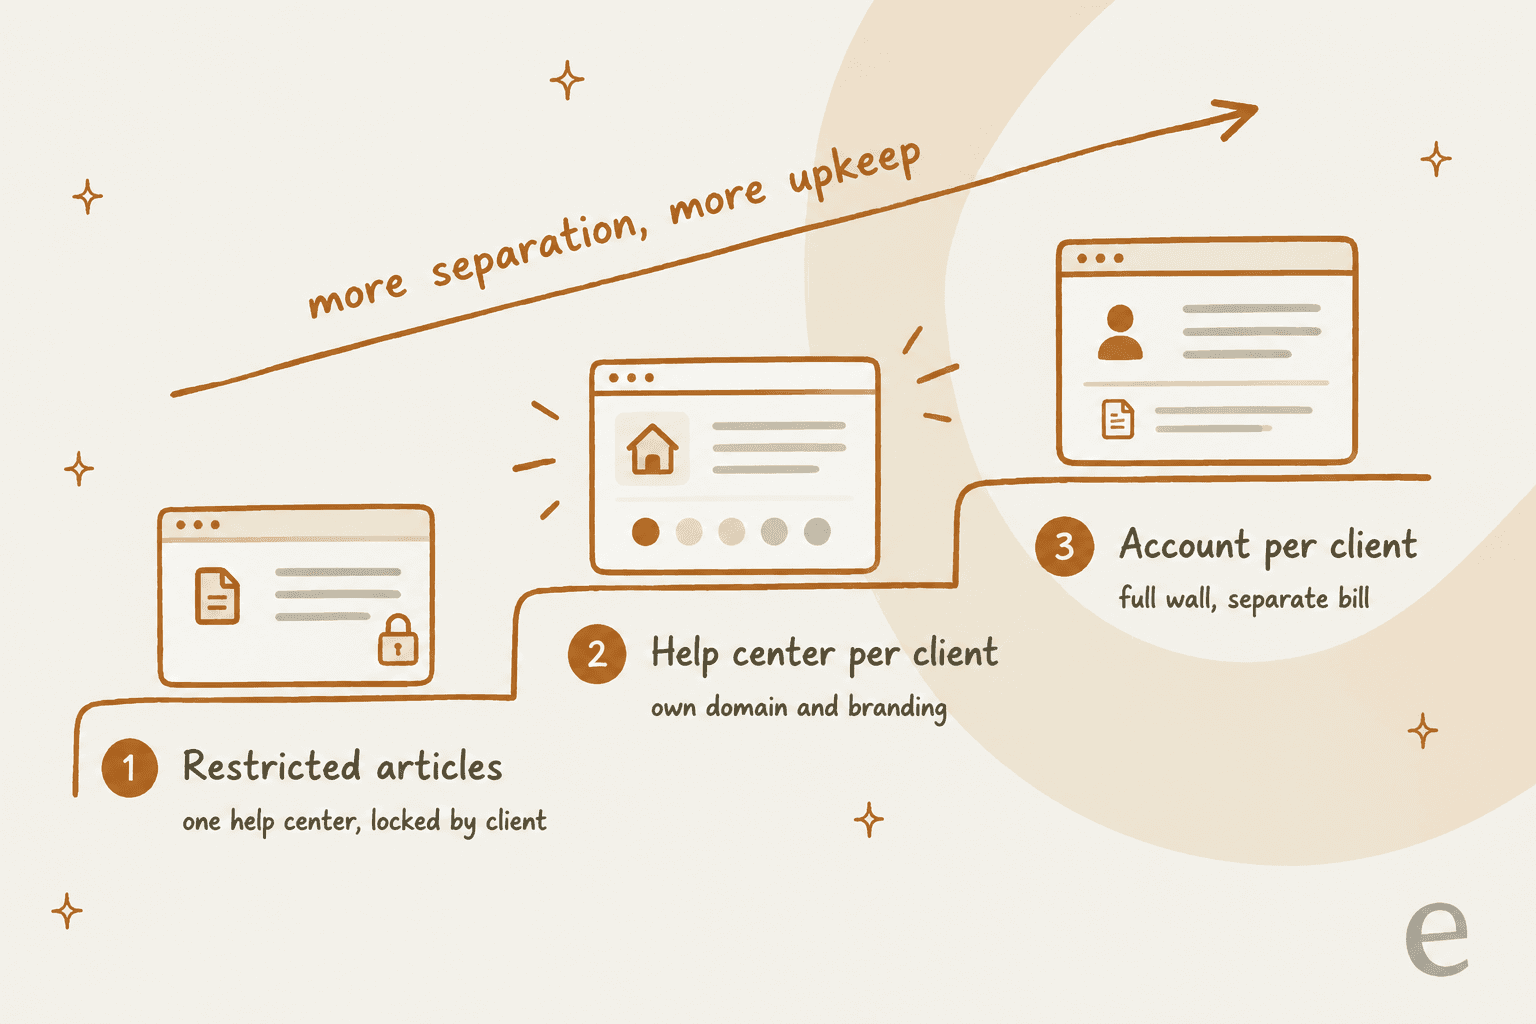
**レベル1:1つのヘルプセンター内の制限付き記事。**クライアントがサインインし、各クライアントのユーザーは自分の記事と共有記事を見ます。記事ライブラリは1つ、URLも1つです。ほとんどのチームにとって適切な初期設定で、r/Zendeskの返信も同じ方向を指していました。
"User Segments all the way. Cool part though if you have User data coming from say Azure. You can premap info. Or domains as well. Then user segments check that data and allow access to articles pertaining to their content. Little bit of maintenance but it's the best way"
落とし穴はサインインです。制限は、ヘルプデスクが誰が読んでいるかを把握している場合にしか機能しないため、匿名の訪問者には公開コンテンツしか表示されません。
**レベル2:クライアントごとのヘルプセンター。**各クライアントが独自のドメイン、ロゴ、記事セットを持ちます。サービスを再販したり、自社ブランドで提供したりするクライアントが望むことが多く、Zendeskのマルチブランド設定のガイドで手順を説明している構成です。ただし、自動的に非公開になるわけではありません。Zendesk自身のブランド別ヘルプセンターのドキュメントにはこうあります。"you cannot restrict users to a specific help center. All of your help centers are accessible to all of your end users." 別のヘルプセンターはブランディングの判断であり、プライバシーの判断ではありません。内容が機密なら、サインインと制限の両方が引き続き必要です。
**レベル3:クライアントごとのアカウント。**ヘルプデスク、請求、管理者がすべて別になります。FreshdeskのWorkspacesのドキュメントには、請求や法的な所有を分ける場合は別アカウントが必要になることがあると書かれています。完全な壁ですが、最も手間もかかります。共有記事のすべてをN回メンテナンスすることになるからです。
記事をクライアントごとにコピーしない
最もよく見かける間違いは、「クライアント別」を「ライブラリ全体をクライアントごとにコピーすること」と捉えてしまうことです。先ほどの共有が3分の2という比率で考えると、編集の大半は同じ修正を12回貼り付ける作業になり、1つでも忘れた時点でコピー同士がずれ始めます。
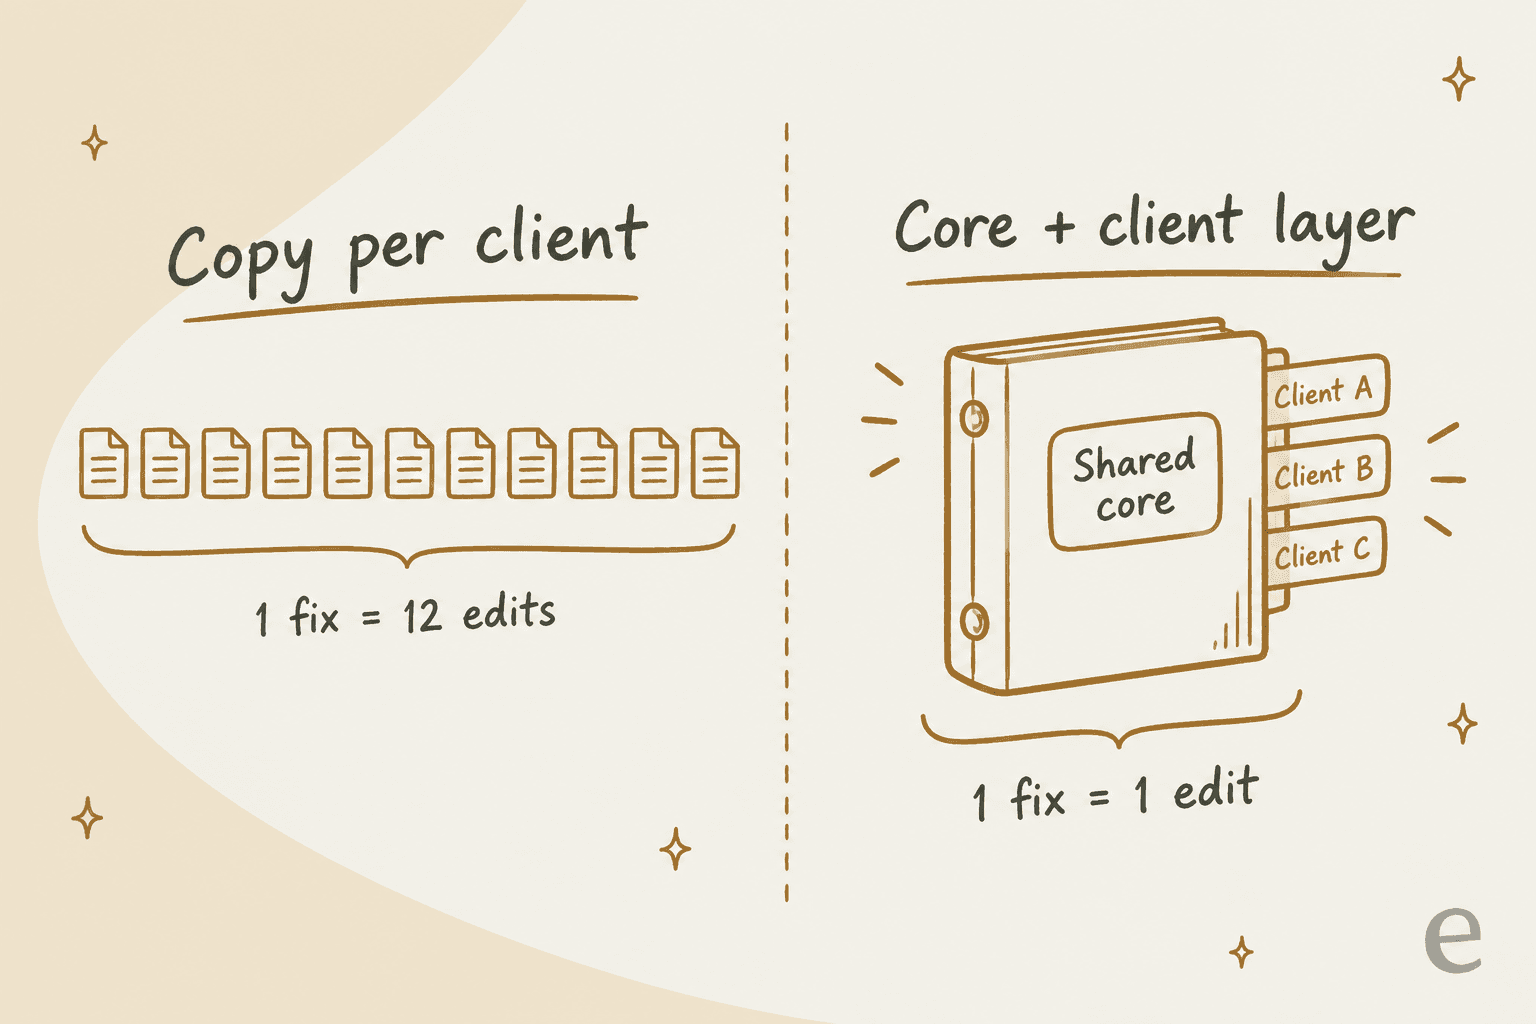
長続きするパターンは、共有コアと薄いクライアント層です。
- **共有コア:**製品の仕組み、標準ポリシー、トラブルシューティング。1度だけ書きます。
- **クライアント層:**異なる部分だけ。カスタム設定、契約条件、担当者名、クライアント固有のエスカレーション経路、標準ポリシーの例外。
同じ分け方は社内ナレッジベースにも使えます。その場合のクライアント層は、顧客には見えないエージェント専用のメモになります。
MSP向けドキュメントツールはまさにこの設計です。Huduはこれを二重のナレッジベースライブラリと呼び、"for information that pertains to multiple clients"の中央記事と、"pertain only to that space."のクライアント記事に分けています。Zendeskには、1つのアカウント内で同じ役割を果たす機能が2つあります。記事の複数配置は、1つの記事をブランドをまたいで最大10のセクションに配置でき、各配置が独自の閲覧権限を保ちます。
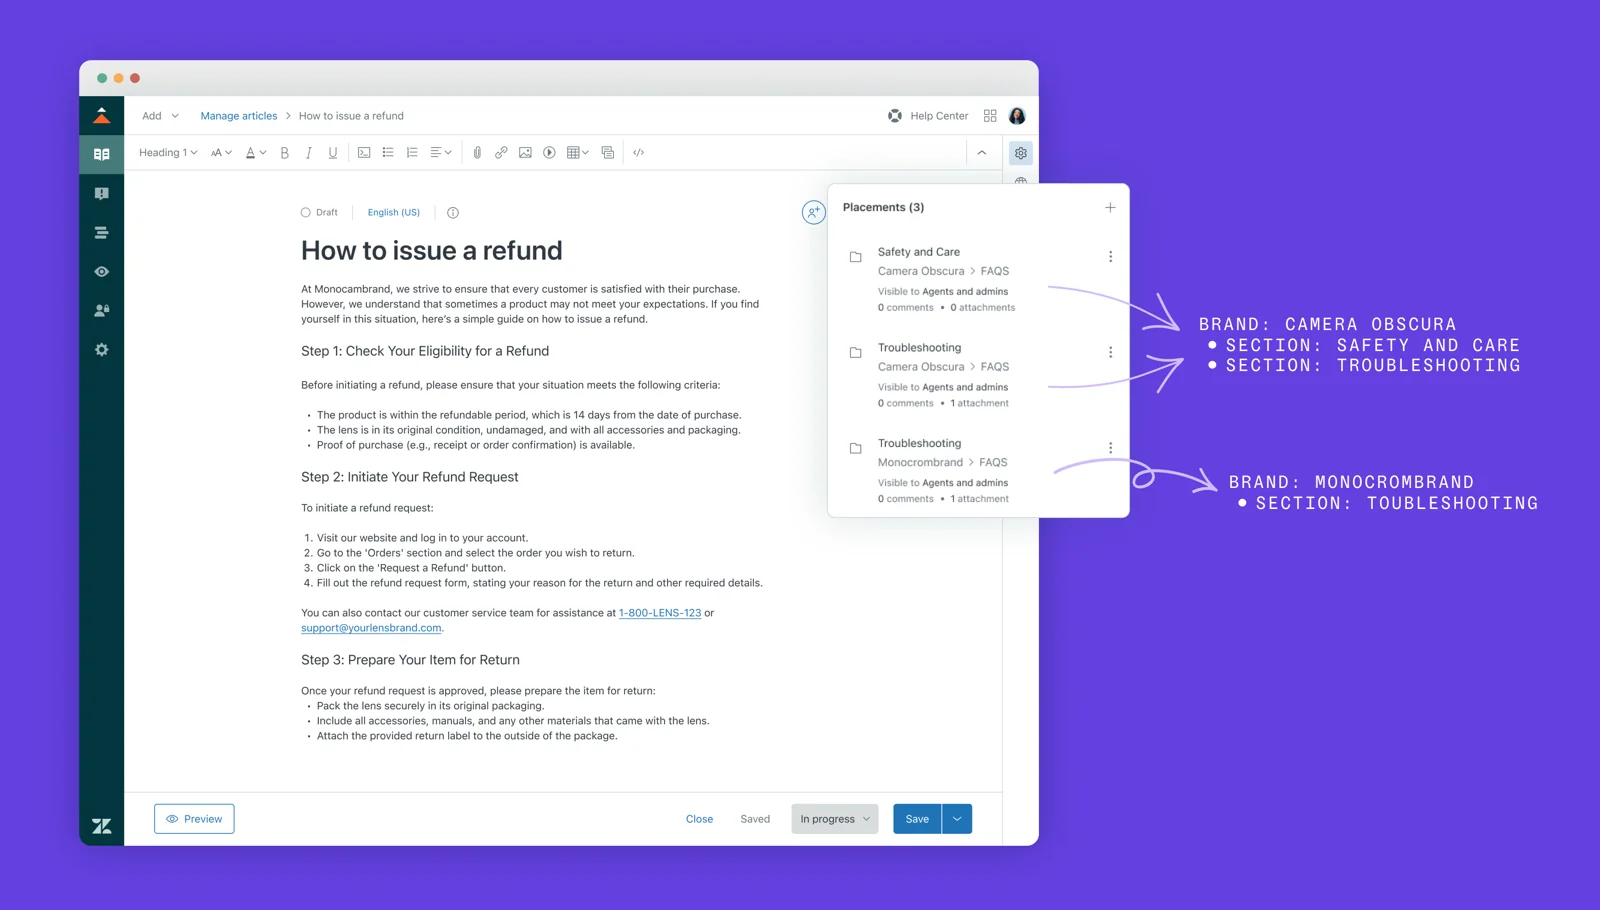
コンテンツブロックはさらに小さい単位で、挿入したすべての場所で更新される再利用可能な段落や表です。ただしEnterprise限定なので、多くのチームは代わりに複数配置と明確な命名規則に頼ることになります。
IT Glueについて正直に言うと、ネイティブの共有ライブラリはありません。自社の権限ドキュメントは、共有コンテンツ用に"named something like 'Common Documents'"という組織を作ることを提案しています。機能はしますが、ツールが用意する構造ではなく、自分たちで徹底しなければならない運用ルールです。
各ヘルプデスクのクライアント別記事の扱い
どのツールが、どのレベルで、どのプランで何を制限できるかを示します。価格は、各ベンダーの料金ページに基づく2026年10月時点の、年払いでの1エージェントまたは1ユーザーあたりの月額です。
| ヘルプデスク | 制限できる最小単位 | クライアントごとの仕組み | クライアント別制限に必要なプラン | クライアントごとの別ヘルプセンター |
|---|---|---|---|---|
| Zendesk | 記事 | 組織、タグ、指名ユーザーによるユーザーセグメント | Suite Professional $115(カスタムセグメント)。1記事に複数セグメントはEnterpriseが必要 | Professionalは5、Enterpriseは300 |
| Freshdesk | フォルダー | 選択した会社、連絡先セグメント、会社セグメントにフォルダーを公開 | Freshdeskのフォルダーのドキュメントでは全プランに記載 | Pro $55(最大5ポータル)、Enterprise $89(無制限) |
| HubSpot Service Hub | 記事またはナレッジベース全体 | アクセスグループ(静的またはフィルターベース) | Professional:アクセスグループ2つ、Enterprise:100 | Enterpriseのみ(最大100のナレッジベース) |
| Help Scout | Docsサイト全体 | クライアントごとに制限付きDocsサイトを1つ | Plus $45またはPro $75、さらにカスタムコード | サイト数:Plus 3、Pro 5、追加は月$20 |
| Zoho Desk | カテゴリー、セクション、記事 | ヘルプセンターのユーザーグループ(1ヘルプセンターあたり最大200) | Freeでは不可。ナレッジベースはStandard $14から | Enterprise $40(マルチブランドのヘルプセンター) |
| Front | ヘルプセンター全体 | クライアントごとにログイン制御のヘルプセンターを1つ | Professional $65 | Professional以上 |
この表のいくつかの点は、1つのセルだけでは足りません。
Zendesk:実際に役立つのはユーザーセグメント
Zendeskのユーザーセグメントは、ここで最も柔軟な選択肢です。1つのセグメントで最大50の組織、各タググループ内の50のタグ、50の指名ユーザーを絞り込め、アカウントあたり最大200のセグメントをブランド間で共有できます。各クライアントのユーザーを1つの組織に入れれば、クライアントと1対1のセグメントになります。
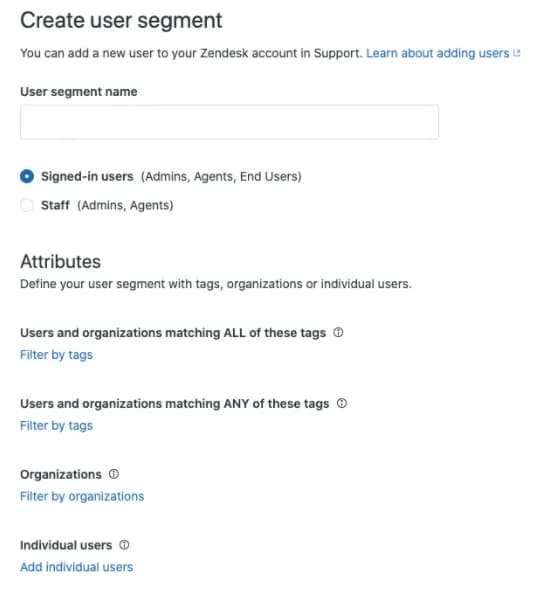
プランに関する重要な点が2つあります。Suite Teamでは「全員」か「サインイン済みユーザー」しか選べないため、クライアントセグメントもエージェント専用記事も使えません。また制限は記事単位で、セクション単位ではないので、クライアントのセクション全体を一括更新でロックします。セグメントによる記事の制限のガイドで手順を説明しており、マルチブランドのヘルプセンターの記事ではレベル2を扱っています。
Freshdesk:フォルダー単位、そして会社単位が標準
Freshdeskは公開設定を記事ではなくフォルダーに設定します。選択肢には、全ユーザー、ログイン済みユーザー、全エージェント、ボット、特定の会社のほか、連絡先セグメントと会社セグメントがあります。Freshdeskのウィジェットのドキュメントは、クライアントのケースを直接挙げています。記事を"about a company to just contacts from that company"表示する、というものです。
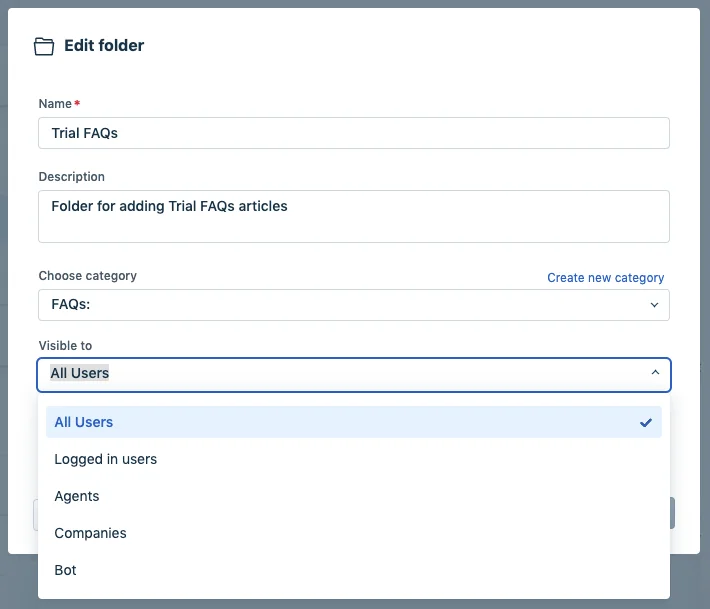
そのため、Freshdeskはレベル1を最も安く実現できる方法の1つです(プランの一覧はFreshdeskの料金の内訳にあります)。計画すべき形は、クライアントごとに1フォルダーです。フォルダー内では記事ごとに公開設定を変えられないためです。
HubSpot:Enterpriseなら十分、Professionalでは窮屈
HubSpotは、アクセスグループで個別の記事やナレッジベース全体を制限します。Professionalではアクセスグループが2つ、ナレッジベースが1つです。「公開、パートナー、VIP層」には十分ですが、10社のクライアントには足りません。Enterpriseではグループが100、ナレッジベースが最大100で、HubSpotの非公開コンテンツは接続済みのカスタムドメインでのみ機能します。HubSpotのAIについては、そこが面白いところなので後述します。残りはHubSpotのナレッジベースのまとめに、AI側はService HubのナレッジベースAIの記事にあります。
Help Scout、Zoho Desk、Front
Help Scoutは、コレクションではなくDocsサイト全体を制限します。制限付きDocsにはPlusまたはProと、訪問者トークンを発行するための"custom code development by your own team"が必要です。非公開コレクションはありますが、「非公開」とはクライアントではなく自社のHelp Scoutユーザーを指します。またHelp Scoutは、DocsがGDPRやHIPAAの対応範囲外であることも明記しているため、クライアントのアカウントデータは入れないでください。
Zoho Deskは、この3つの中で最も細かく設定できます。カテゴリーは、なし、グループ、公開、エージェント、カスタムIPに設定でき、ヘルプセンターのユーザーグループは"a specific account"に結び付けられると説明されています。上限は、1ヘルプセンターあたり200グループ、1グループあたり2,000ユーザーです。Ziaに学習させる予定なら、先に下のAIのセクションを読んでください。
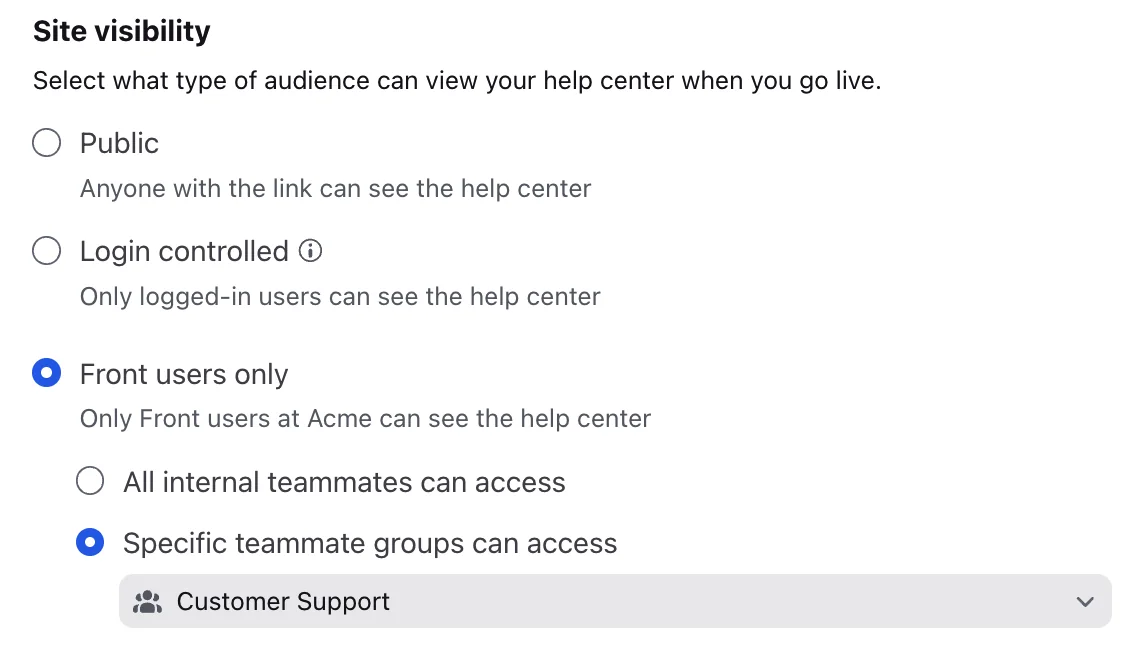
Frontは、ヘルプセンター単位で制限します。公開、ログイン制御(自社のIDプロバイダー経由)、Frontユーザーのみのいずれかです。非公開カテゴリーはナビゲーションから隠すだけで、直接リンクを知っていれば誰でも開けるため、クライアントを分ける壁にはなりません。そのAIが何を読むかはFront AIのレビューで扱っています。
クライアント別コンテンツが漏れる場所:AI
ここが私が強調したい転換点です。チームはヘルプセンターの権限を整えるのに何週間もかけ、その後、別のルールでナレッジベースを読むAIエージェントをオンにします。顧客に見える権限モデルが、AIの従うモデルと同じとは限りません。
| AI機能 | クライアント制限付き記事を使うか | あなたにとっての意味 |
|---|---|---|
| ZendeskのAIエージェント(現在の設定) | はい。サインイン済みユーザーについて閲覧権限を尊重 | メッセージングには、外部IDが一致するJWTサインインが必要。制限付きの回答はテストウィジェットではテストできない |
| 2026年3月10日より前に購入したZendeskのAIエージェント | 記事は"public or private to everyone"だった | 移行は7月1日から2026年末まで |
| Freshdesk Freddy AI Agent | いいえ。"Private or restricted articles are excluded" | クライアントのフォルダーはソースにならない。公開にする必要がある |
| Freshdesk Freddy Copilot(エージェント側) | はい。エージェント自身のアクセス範囲に限定 | エージェント向けには良いが、顧客向けの回答には不向き |
| HubSpotのカスタマーエージェント | はい。引用なし | HubSpotは非公開コンテンツが"may still appear in responses"と警告 |
| Help Scout AI Answers | Beaconの設定で非公開コレクションを選択可能 | Beaconごとに1つのAIエージェントで、クライアント別に範囲を絞ることをおすすめ |
| Zoho Desk Answer Bot | Zohoは"published and public resources"のみと説明 | 同じページのユーザーコメントに、エージェント専用記事が表示されるとの報告あり。テストしてください |
2つの行は、もう少し詳しく見る価値があります。
Freshdeskは、安全な方向に厳格です。AI Agentのナレッジのドキュメントには"only articles visible to All users are used for AI learning."とあります。つまり、ボットがクライアントAのフォルダーをクライアントBに漏らすことはありませんが、クライアントAのフォルダーからクライアントAに回答することもできません。Freshdeskの回避策であるフィルター検索は、連絡先や会話のプロパティで検索対象を絞りますが、もともとAIが学習を許可されたコンテンツしか絞り込めません。
HubSpotは逆方向です。カスタマーエージェントのソースのドキュメントは、非公開ソースは"will not be cited, but their content may still appear in responses"と述べ、機密情報や顧客の非公開データを含めないよう案内しています。回答時に非公開ソースをそのアクセスグループに限定する、文書化された方法は見つかりませんでした。
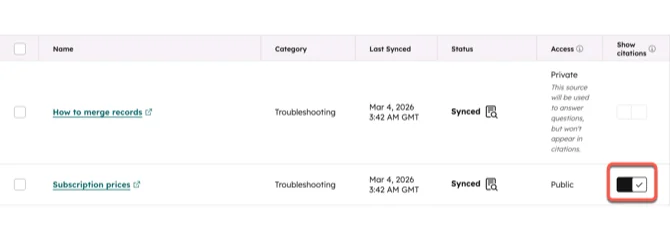
同じ問題は、クライアントだけでなく地域をまたいでも起こります。あるZendesk管理者はこう述べています。
"The problem: Zendesk AI pulls knowledge from the Help Centers linked to the same brand, regardless of language or region. So if a Brazilian customer asks something, the AI might base its answer on all related contents, even in articles just created for US."
まず範囲を絞り、それから検索する
自前で構築する人たちがたどり着く解決策も同じです。検索を実行した後ではなく、実行する前に、誰のコンテンツが対象かを決めます。10社のクライアント向けに1つのAIワークフローを動かしているn8nの開発者は、こう説明しました。
"Once I've filtered the clientid the model won't make a mistake because if it gets the clientid gonna search for everything related to the client id, even the chat history is connected trough clientid so it seems pretty solid."
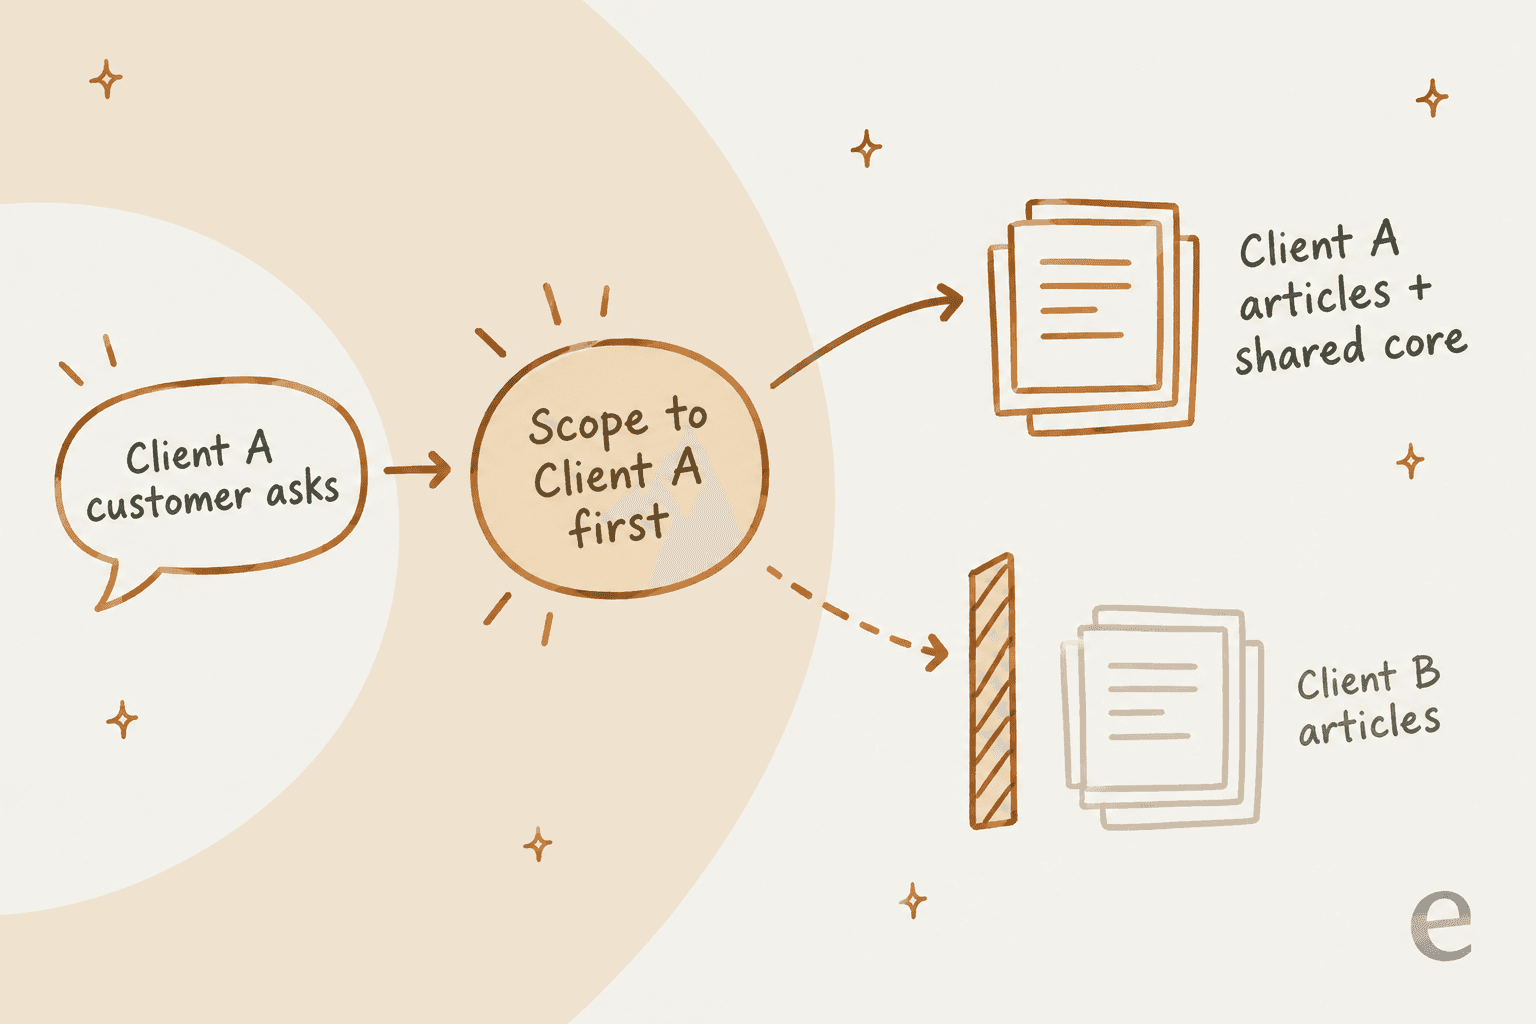
ヘルプデスクで最初に範囲を絞る最も簡単な方法は、クライアントごとに1つのAIエージェントを置き、そのクライアントのソースだけに接続することです。「クライアントAの記事だけを使う」といった指示は壁ではありません。コンテンツがエージェントのインデックスにあるなら、外に出る可能性があると考えてください。これは、RAGとファインチューニングで説明しているとおり、AIが検索を使うか、調整済みモデルを使うかにかかわらず同じです。
ここでは過去のチケットも重要になります。チケット履歴は、記事がカバーしなかったあらゆるエッジケースを含むため、手元にある最も豊富なクライアント固有の知識です。同時に、1つのヘルプデスクに全クライアントのチケットが入っていることが多いため、最も混ざりやすいソースでもあります。エージェント側のヘルプデスクコパイロットは、送信前に人間がすべての下書きを読むので、リスクの低い出発点です。
eeselで構築して学んだこと
今年の初め、ベルギーの配送テックのチーム(オランダ語と英語、1,625件のドキュメント、同期の中で最も活発なトライアル)が、1つのZendeskから2つのAIエージェントを動かしたいと考えました。1つは匿名ユーザーに公開記事から回答し、もう1つはサインイン済みユーザーに公開記事と制限付き記事の一部から回答します。eeselのインポートはカテゴリーでは絞り込めましたが、制限付き記事の一部を記事単位で選ぶことはできず、行き詰まりました。ほぼ同じ時期に、ブランドごとの設定が自力では面倒すぎるという理由で解約した他のマルチブランドチームも見ました。
そこから2つの教訓を得ました。第一に、クライアント固有のコンテンツは初日から専用のカテゴリーやセクションに入れること。AIを含むほぼすべてのツールは、個別の記事よりもコンテナ単位のほうが確実に範囲を絞れるからです。第二に、ブランドごとの接続は詳細設定ではなく、デフォルトであるべきだということです。現在のeeselでは、Zendeskの各ブランドを個別に接続し、そのブランドのチケットとヘルプセンター記事だけをインポートし、各ブランドを別のエージェントに割り当てられます。あるマルチブランドのウェルネス企業は、この方法で5つのブランド専用AIエージェントを運用し、それぞれが自ブランドのチケットで学習しています。
クライアント別ナレッジベースを6ステップで設定する
これは上記のどのツールでも使えます。ツールより順序が重要です。
- **記事を共有とクライアント固有に分類する。**簡単なナレッジベース監査を行い、各記事にタグを付けます。共有が3分の2に近い比率になるはずです。その際、ナレッジギャップがあれば記録しておきます。あるクライアントの層が共有コアより大きいなら、そのクライアントにはレベル2か3が必要かもしれません。
- **各クライアントに、ヘルプデスクが理解できるコンテナを用意する。**Zendeskの組織、Freshdeskの会社、HubSpotのアクセスグループ、Zohoのユーザーグループなどです。可能ならメールドメインやSSOのデータでユーザーを自動的に割り当て、新しいクライアントユーザーが誤ったグループに入らないようにします。
- **クライアントの記事を、クライアント専用のカテゴリーまたはフォルダーに入れる。**共有セクションに混ぜないでください。後からAIや権限の一括変更を管理しやすくするのが、このステップです。
- **何をコピーではなく参照で共有するか決める。**複数配置、コンテンツブロック、複数のポータルに紐付けられるポータルカテゴリーを使います。クライアント版が本当に異なる場合にだけコピーします。
- **サインインを有効にし、各クライアントとしてテストする。**クライアントAとクライアントBの実際のユーザーとしてログインし、互いのコンテンツを検索します。Zendeskのサインイン制限とセグメントのドキュメントによると、サインイン済みのエージェントには組織フィルターが無視され、ナレッジ管理者はすべての制限を回避します。つまり、自分自身としてテストしても何も証明されません。
- **AIをクライアントごとに絞り、そのクライアントの履歴でテストする。**クライアントまたはブランドごとに1つのエージェントを置き、そのクライアントのソースだけに接続します。本番で誰かに回答する前に、そのクライアントの過去のチケットで実行してください。
公開後は、クライアント層を定期レビューの対象にします。クライアント固有の記事は、契約や担当者に依存していて変わっている可能性があるため、共有記事より早く古くなります。レビューはポリシー変更のプロセスと結び付け、契約の更新が記事の更新のきっかけになるようにします。見つけ方は古くなったヘルプセンターのコンテンツの記事で扱っています。
MSP:HuduとIT Glueはすでにこの方式
MSPの場合、クライアント別ナレッジベースはおそらくヘルプデスクの中ではなく、ドキュメントツールの中にあります。そこではクライアントごとの分離が設計の中心です。
| Hudu | IT Glue | |
|---|---|---|
| クライアントごとのコンテナ | 会社スペース | 組織 |
| 共有ライブラリ | ネイティブの中央ナレッジベース | 共有の「Common Documents」組織 |
| 価格 | 1ユーザー月額$27(年払い)、最低利用なし | 1ユーザー月額$29 / $38 / $44、最低5ユーザー、36か月契約 |
| クライアントポータル | ポータルユーザーは無料 | MyGlueアドオン、月額$407 |
| AI | HudiniアシスタントとMCP、標準搭載 | Cooper Copilot、全ティアに掲載 |
出典:Huduの料金とIT Glueの料金。
注意すべき日付が1つあります。Huduのバージョン2.47は2026年10月12日からロールアウトが始まり、クライアントポータルがポータルユーザーのロールに置き換わります。Hudu自身の警告は、ポータルユーザーが"everything their groups can see"を引き継ぐ点です。以前のポータルは、そのポータル向けに設定したレコードだけを表示していました。Huduのポータルでクライアントのドキュメントを共有しているなら、その日までにグループの権限を確認してください。
専用ツールを使っても、情報が見つけにくいという問題は消えません。
"It can be really difficult to find client specific information unless you know exactly how to search for it. There is sometimes lost time spent there."

同じスタックのチケット管理の面は、MSP向けチケットシステムのガイドで扱っています。
クライアント別ナレッジベースにeeselを試す
Zendesk、Freshdesk、Gorgias、Zoho Deskで複数のクライアントやブランドのサポートを運営しているなら、eeselは各クライアントに専用のAIヘルプデスクチームメイトを用意します。代理店向けAIサポートで説明しているのと同じ構成です。既存のキューに参加し、Zendeskのブランドごとまたはヘルプデスクのアカウントごとに接続し、そのクライアントのヘルプセンター、マクロ、過去のチケットからのみ学習します。すべてのソースはトグルで切り替えられるため、エージェントが学習すべきでないチケット履歴はオフにでき、"uninstall from agent"を使えば、他のクライアントに影響せずに1つのクライアントのエージェントから接続を外せます。

エージェントをクライアント向けに稼働させる前に、シミュレーションスキルがそのクライアントの実際の過去のチケットを再生し、エージェントの回答をあなたのチームが送った内容と比較します。アクションもエージェントごとなので、クライアントAに返金を許可しても、クライアントBのエージェントができることは変わりません。
料金は、どのプランでもエージェントとシートが無制限で、100クレジットの無料プランから始まり、その後は500クレジットで月額$299からです。1チケットが1クレジットです。請求はワークスペース単位なので、6社の小規模クライアントを抱える代理店は、6つのサブスクリプションではなく、全チケット分の1つのクレジットプランを購入します。クライアントごとに1つのエージェントをスクリプトで作りたい場合は、eesel CLIでeesel agents createを使って新しいエージェントを作成し、--agentで任意のエージェントを指定できます。ターミナルからでも、Claude Codeのようなコーディングエージェントからでも使えます。

eeselが提供しないもの:ホワイトラベルAIプラットフォームやリセラープログラムではなく、ユーザーロールもクライアントごとではなくワークスペース全体で適用されます。クライアントが自分のエージェントを管理するために専用のログインを必要とする場合、現時点では対応できていません。各クライアントのAIを範囲内に収めたいなら、eeselを無料で試してみてください。