

La IA para la comunicación de incidentes graves funciona cuando mantienes un único registro de incidente verificado y dejas que cada canal responda a partir de él: la página de estado, las respuestas a tickets, la macro de tus agentes, los correos a cuentas grandes y el canal interno. La IA redacta cada actualización, una persona designada (tu responsable del incidente o de comunicación) aprueba todo lo público, y sale una actualización cada 30 minutos, el objetivo que fija incident.io para incidentes graves.
La IA que responde tickets por su cuenta solo debería tocar tickets asociados a un incidente declarado, y solo con palabras copiadas de la última actualización aprobada. Nada de horas estimadas inventadas, nada de conjeturas sobre la causa raíz, nada de «tus datos están a salvo». Después, planifica la segunda oleada tras la resolución: respuestas de «¿de verdad está arreglado?», solicitudes de informe y peticiones de créditos por SLA.
Yo construyo las integraciones de helpdesk de eesel, y el compañero de IA para helpdesk en el que trabajo hace esto dentro de Zendesk, Freshdesk y Gorgias: etiqueta los tickets de la caída, redacta respuestas a partir de la actualización aprobada y pasa las caídas y la pérdida de datos directamente a una persona, tal como lo hace Qontro en Freshdesk. Los planes empiezan en 299 $ al mes por 500 créditos.
¿Por qué los clientes oyen cosas distintas durante una caída?
Porque cada persona responde con lo que sabe en ese momento, y todas saben cosas distintas. Un agente en el ticket #4012 leyó la página de estado hace diez minutos. Un gestor de cuentas oyó algo en un hilo de Slack. Un ingeniero le dijo a un cliente grande «debería estar arreglado en una hora». La propia página de estado no se ha movido desde la primera publicación. Nadie miente. Solo responden desde instantáneas distintas.
El centro de ayuda de Freshdesk lo describe bien. En su guía de tickets vinculados, señala que durante una caída distintos clientes reciben actualizaciones a intervalos diferentes, "based on the persistence of the customer and the workload of the agent." El cliente que escribe cuatro veces recibe cuatro actualizaciones. El que escribe una vez recibe silencio.
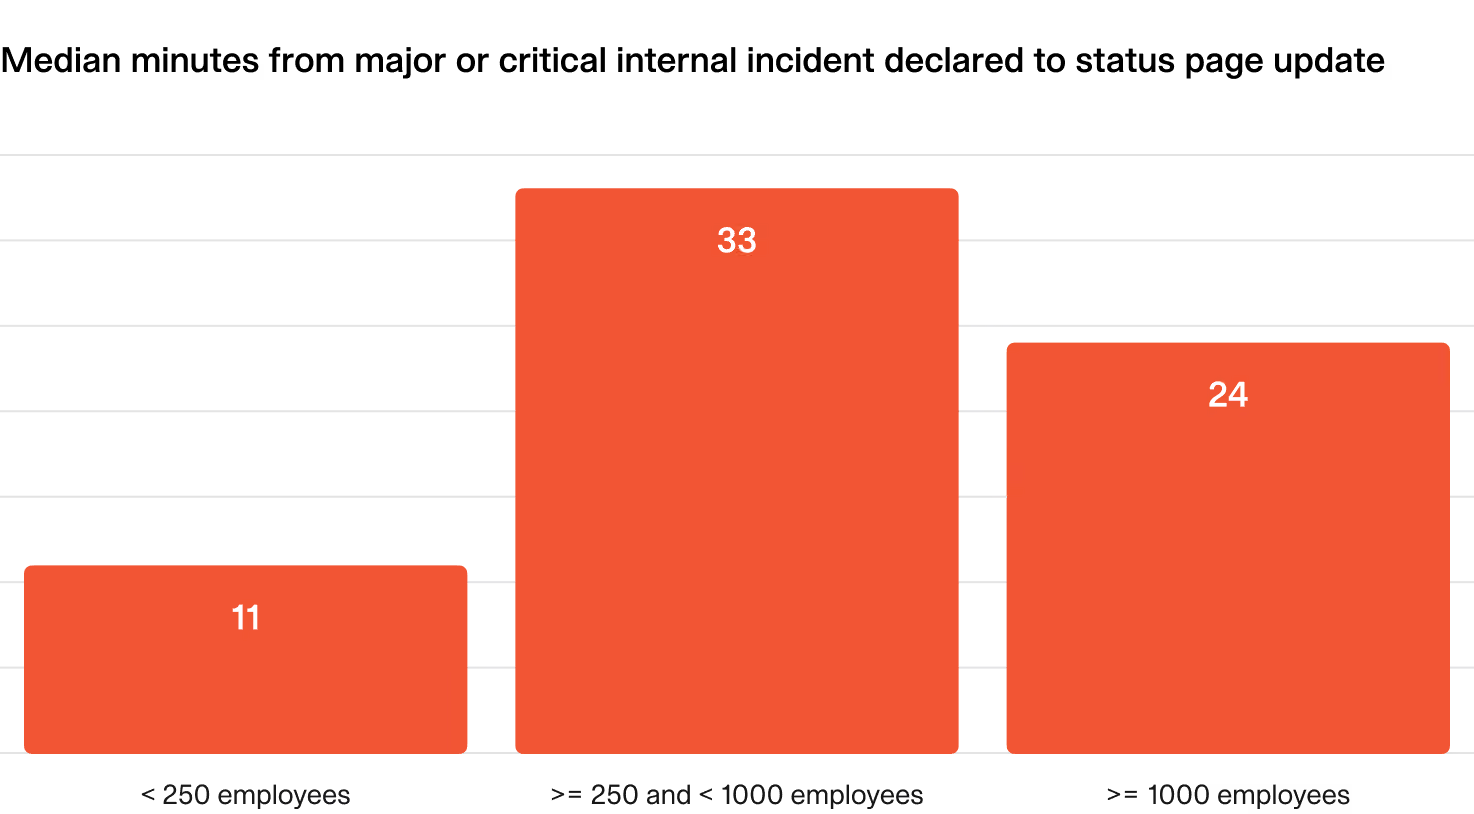
La lentitud de la primera actualización lo empeora. El informe de buena gestión de incidentes de incident.io encontró que las empresas de 250 a 1.000 empleados tardaban una mediana de 33 minutos desde declarar un incidente grave hasta su primera publicación en la página de estado, más lento que las empresas más pequeñas y más grandes. Esa media hora es cuando los tickets se acumulan y las historias se bifurcan.
Quienes gestionan el incidente también lo sienten desde dentro. Un SRE pidió ayuda en Reddit justo por esto:
"When stuff is finally resolved, I have to parse through slack to see what happened when, ignore the "what's the status" slacks sent by 15 different random people, build a timeline with my investigation steps, etc."

Así que la solución no es «escribir más rápido». Es darle a todos un único lugar del que leer y dejar que la IA haga la reescritura para cada audiencia. También leería mi guía sobre IA de soporte durante caídas de SaaS junto a esta: aquella cubre la avalancha de tickets, mi guía de IA para actualizaciones de la página de estado cubre la página de estado en sí, y esta cubre qué dices en cada canal y quién lo dice.
¿De qué debería responder cada canal?
De un único registro de incidente, escrito en palabras sencillas, del que una persona sea responsable y que actualice. No del canal de Slack de ingeniería, no de la llamada de la sala de crisis, no de la memoria de alguien. Redúcelo a cuatro campos:
- Qué está afectado: las áreas de producto, regiones o grupos de clientes, con las palabras de tus clientes («el pago en la aplicación web»), no con nombres de servicios («payments-api-v2»).
- Hechos verificados: solo lo que los ingenieros han confirmado. «Algunos pagos con tarjeta fallan» es un hecho. «Un despliegue defectuoso lo causó» es una conjetura hasta que alguien lo confirma.
- Qué estamos haciendo: una línea. «Revirtiendo la versión de las 14:10» basta.
- Próxima actualización a las: una hora del reloj, siempre.
Ese registro puede vivir en tu herramienta de incidentes (incident.io, PagerDuty, Jira Service Management) o en la propia página de estado. Dónde viva importa menos que la regla de que cada mensaje a cualquiera se reescribe a partir de él, nunca de una conversación paralela.
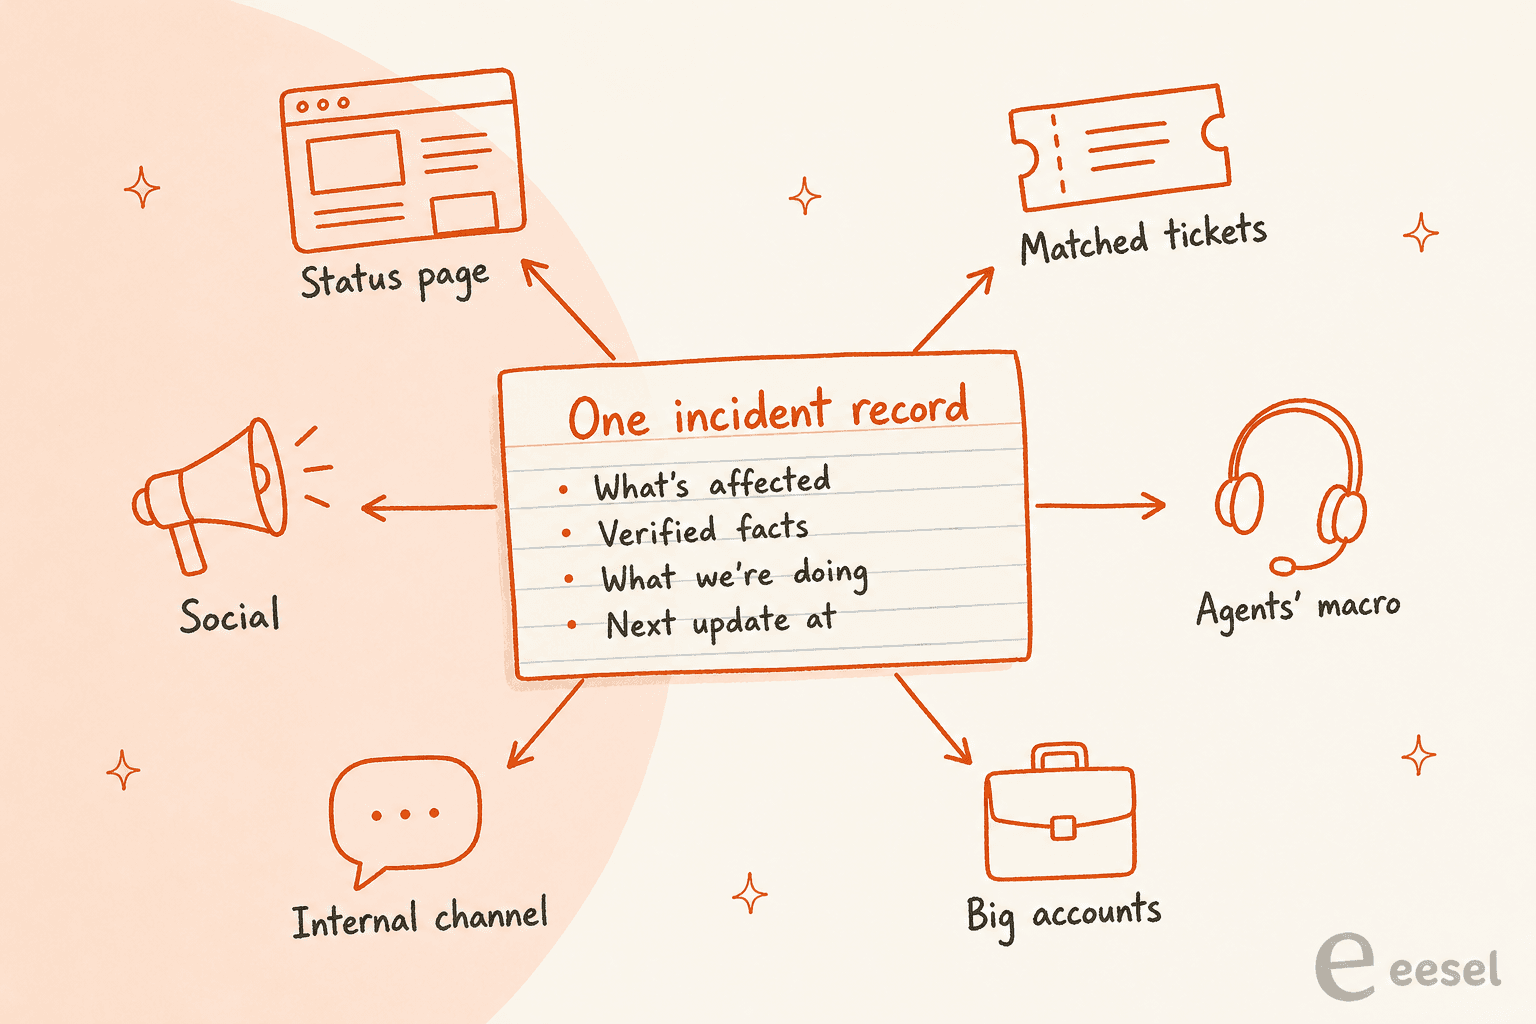
Las flechas apuntan solo hacia fuera a propósito. Si un cliente en un ticket informa de algo nuevo («también falla en el móvil»), eso va al responsable de comunicación, que lo comprueba y lo añade al registro. No salta directamente a la respuesta de otro cliente. Esa única regla es lo que evita que el canal número seis se desvíe del canal número uno.
¿Quién es responsable de la comunicación del incidente y dónde encaja la IA?
Una persona que no está arreglando el problema. Los ingenieros que depuran producción no deberían estar puliendo una disculpa. Esto salió una y otra vez al leer cómo lo gestionan los operadores:
"Someone not directly working the incident owns comms. gets updates from the team, tracks timelines, and updates the dedicated status page/notification channels."
El informe de incident.io da el mismo consejo en términos más llanos: "Assign communications roles", para que quede claro quién es responsable de las actualizaciones de la página de estado. La IA encaja debajo de esa persona, no a su lado. Convierte el registro en cinco versiones para cinco audiencias, y el responsable de comunicación lee y aprueba. Eso es human in the loop en su forma más simple, y la guía de comunicación de la propia incident.io traza la misma línea: la IA debe ayudar a redactar en lugar de enviar mensajes externos sin que una persona los revise.
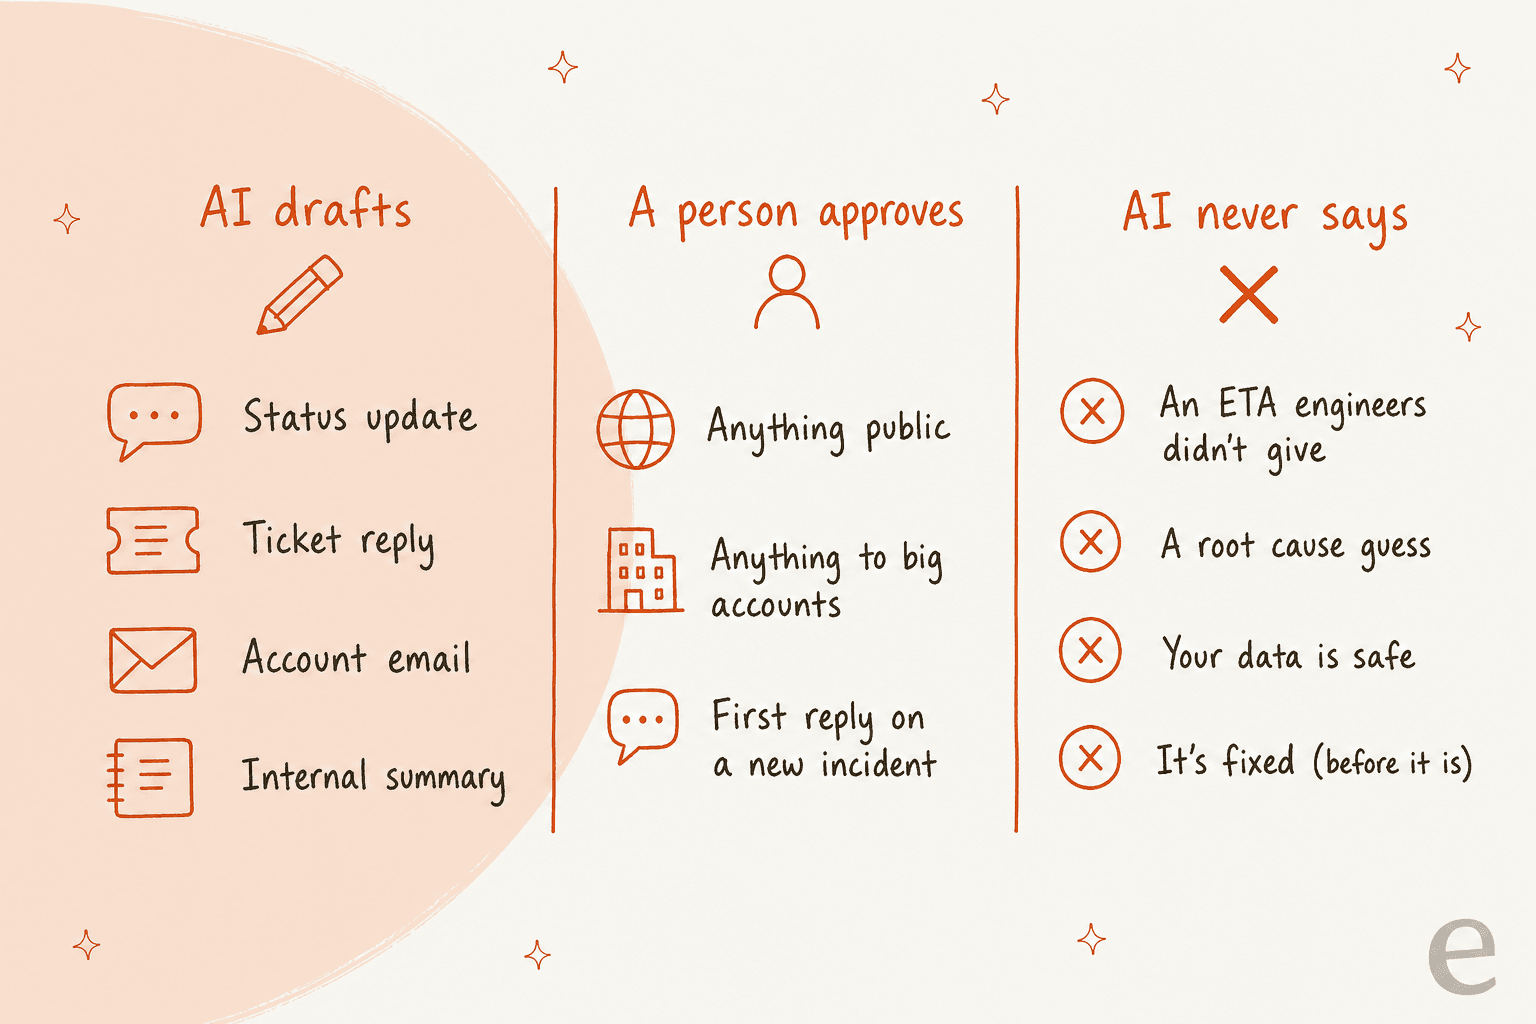
La columna derecha es la parte que imprimiría. Cada una de esas cuatro líneas es una frase que un modelo de lenguaje escribirá encantado si el prompt lo empuja, porque son exactamente lo que un cliente ansioso quiere oír. Una alucinación de la IA en un ticket normal le cuesta a un cliente. La misma frase en una respuesta de incidente llega a cientos de personas a la vez, y es la línea de la que luego hacen captura de pantalla.
¿Con qué frecuencia deberías enviar actualizaciones del incidente?
Cada 30 minutos en un incidente grave, aunque nada haya cambiado. Ese es el objetivo del informe de incident.io, que dice que hay que "aim to share status page updates every 30 minutes during major and critical incidents." Sus datos muestran que la mayoría de los equipos se acerca bastante.
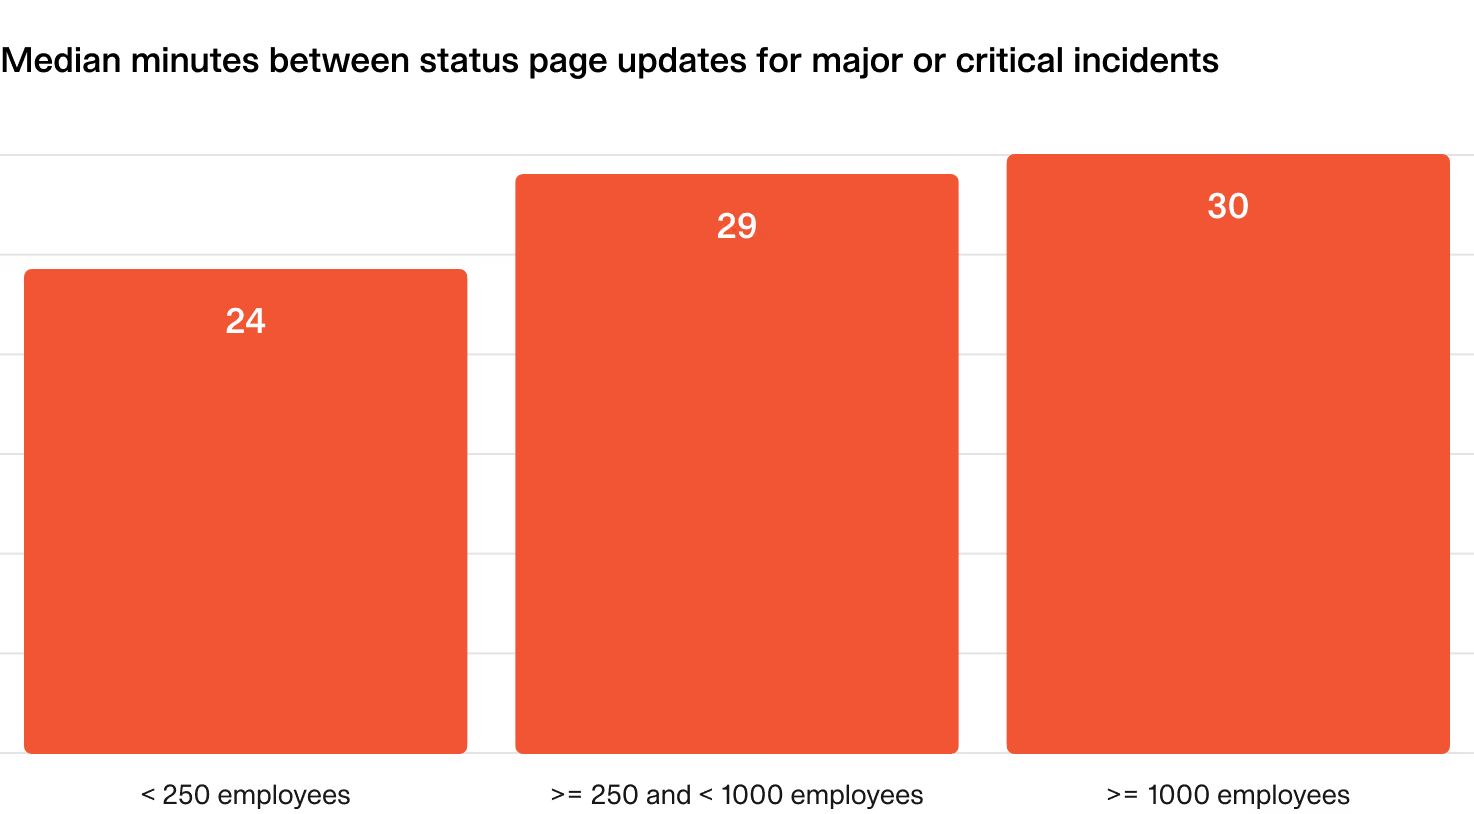
La guía de incident.io llama a la actualización vacía la regla del «latido»: "We're still investigating. No new information. Next update in 30 minutes." Parece que no es nada, pero hace un trabajo real. Un cliente que sabe que la próxima actualización llega a las 15:30 no abre un ticket a las 15:20. Su guía de comunicación sugiere escalar el ritmo según la gravedad: cada 20 a 30 minutos para un SEV1, cada 4 horas para un SEV2 y actualizaciones en horario laboral para un SEV3.
Es el trabajo más fácil de dar a la IA. La actualización de latido es aburrida, es la que la gente olvida en el minuto 45 de un mal incidente y casi no conlleva riesgo porque no dice nada nuevo. Deja que la IA la redacte a partir del registro y avise al responsable de comunicación cuando toque. El plan de abajo muestra qué necesita cada gravedad, para que lo acordéis antes del próximo incidente en vez de durante él.
¿Cómo mantienes a los agentes y a la IA con el mismo guion?
Dale al servicio de soporte las mismas palabras que usa la página de estado y facilita encontrar todos los tickets del incidente. Los dos grandes helpdesks ya tienen la infraestructura para lo segundo. Lo que cada uno hace con ella merece conocerse al detalle, porque he visto equipos suponer más de lo que la función hace en realidad.
Tickets de problema e incidente de Zendesk. En la documentación de Zendesk, creas un ticket de problema para la caída, pones el tipo de cada ticket relacionado en incidente y los vinculas. Cuando resuelves el ticket de problema, se resuelve cada ticket de incidente vinculado, y el comentario que escribes en el ticket de problema se añade a los tickets de incidente que siguen abiertos. Dos pegas de la misma página: "Customers are not notified using the messaging channel" y "AI agent tickets can't be linked to problem and incident tickets." Así que si la mitad de tu tráfico de la caída llega por el propio bot de Zendesk, el cierre masivo no lo alcanzará. Mi guía sobre tickets de incidente y de problema cubre la configuración, y las actualizaciones masivas de estado llenan los huecos.
Tickets vinculados de Freshdesk. Freshdesk vincula tickets relacionados a un ticket maestro llamado tracker. Los comentarios en el tracker llegan a cada ticket vinculado como difusión, pero la guía de configuración dice que el "internal broadcast message will be visible only to agents of the helpdesk." Los clientes no lo ven. Cada agente sigue enviando la respuesta real. Y resolver el tracker no resuelve por defecto los tickets vinculados. Los tickets vinculados requieren el plan Pro o Enterprise.
Ese es el hueco que la IA llena bien. La función del helpdesk te da una lista de cada ticket sobre la caída. La IA convierte la última actualización aprobada en una respuesta para cada uno, en el idioma del cliente, sin que nadie copie y pegue 300 veces. El etiquetado también importa aquí: un operador de r/sre resumió la jugada básica.
"support tools like zendesk allow you to add tags to tickets related to the same issue via a "master" ticket"
Una etiqueta como incident-2026-10-30-checkout en cada ticket asociado es lo que te permite cerrarlos todos después, contarlos para el informe posincidente y detectar a los clientes que escribieron tres veces. Si todavía no has configurado el etiquetado de tickets con IA, una caída es un lugar doloroso para descubrir que lo necesitas. Lo mismo vale para la deduplicación de tickets, ya que los tickets de una caída llegan en tandas de las mismas personas.
Actualiza la macro que usan tus agentes humanos al mismo tiempo que la página de estado. Una macro de IA que sigue diciendo «estamos investigando» una hora después de que salió el arreglo es la forma en que un cliente recibe dos respuestas distintas en una misma tarde.
¿Cuándo debería responder la IA por su cuenta durante un incidente?
Solo cuando se dan tres cosas: alguien ha declarado el incidente, el ticket coincide claramente con él y la respuesta usa una redacción que una persona ya aprobó. Si falta una, la IA redacta y una persona envía. Esa es toda la regla, y cubre casi todos los casos.
Así clasificaría yo los tickets entrantes durante un incidente grave:
| El ticket | Qué hace la IA | Por qué |
|---|---|---|
| Coincide con un incidente declarado | Responde con la última actualización aprobada y la hora de la próxima, lo etiqueta y lo vincula | Las palabras ya se revisaron una vez |
| Parece una caída, pero no hay nada declarado | Deja una nota interna y avisa al equipo de guardia, no confirma nada | Podría ser la primera señal de un incidente real, o el wifi de un cliente |
| De una cuenta grande o menciona un contrato | Lo pasa al responsable de la cuenta con un resumen | Estos clientes esperan a una persona y una vía de escalado |
| Informa de pérdida de datos, un problema de seguridad o un cobro doble | Directo a una persona, sin respuesta | Una línea equivocada aquí es un problema legal |
| No trata de la caída | Cola normal | No dejes que el incidente se trague todo lo demás |
Dos de estos salen directamente de configuraciones reales. Qontro, una empresa de ERP en Freshdesk, redacta una respuesta en cada ticket nuevo (190 en un mes), pero envía caídas, pérdida de datos y preguntas de facturación directamente a una persona, y cuando un ticket no tiene suficiente información para responder con confianza, el agente lo dice en vez de adivinar. SE Ranking ejecuta eesel en 4.650 conversaciones de Zendesk al mes y etiqueta cada ticket que toca con ai_handled, para que el equipo pueda contar exactamente qué hizo la IA. Su regla de traspaso también encaja bien con los días de incidente: el agente dice a los clientes que esperen respuesta en uno o dos días laborables y nunca dice que alguien se une ahora mismo.
Ese último punto es una cicatriz para mí. He visto a un bot decirles a los clientes que los pasaba a una persona cuando el traspaso nunca ocurrió, en una empresa de alojamiento web con Zendesk. Durante una caída, ese tipo de promesa vacía duplica el enfado. Así que lo que tu IA diga sobre los próximos pasos tiene que ser algo que tu sistema haga de verdad. Mi artículo de buenas prácticas de traspaso explica cómo probarlo antes de necesitarlo, y las pruebas de simulación te permiten reproducir los tickets de la caída del trimestre pasado con las reglas nuevas antes de activarlas.
Una trampa más: las respuestas de incidente de la IA deben detenerse en cuanto una persona toma el hilo. ClutchLoop ejecuta su agente en Gorgias con exactamente esa regla: si un miembro del equipo ya está respondiendo en un hilo, el agente se mantiene al margen. Para cuentas grandes con un gestor de cuentas en el ticket, es el comportamiento que quieres.
¿Qué hace realmente la IA de las herramientas de incidentes y de helpdesk?
La mayor parte de la IA en las herramientas de incidentes está dirigida a los ingenieros: resúmenes, líneas de tiempo, análisis posincidente. Menos funciones tocan los mensajes a clientes, y las que lo hacen son herramientas de redacción con una persona que revisa. Esto es lo que dicen las páginas de cada proveedor, con sus precios.
| Herramienta | IA para comunicación de incidentes | Página de estado | Precio (página del proveedor) |
|---|---|---|---|
| Atlassian Statuspage | Ninguna en la página de precios | Sí, es el producto principal | Free (100 suscriptores), Hobby 29 $, Startup 99 $, Business 399 $, Enterprise 1.499 $ al mes |
| incident.io | Funciones de IA como Scribe y Suggestions, más un editor de análisis posincidente nativo de IA en Pro y Enterprise | 1 página pública en Basic, Team y Pro, páginas para clientes en Enterprise | Basic gratis, Team 19 $ por usuario al mes, Pro 25 $, más guardia de 10 a 20 $ por usuario |
| PagerDuty | AI Status Updates redacta actualizaciones internas y externas, quienes responden revisan antes de enviar | Página externa desde Professional (250 suscriptores) | Professional 21 $ por usuario al mes anual, IA como complemento; Starter 2.800 $ al año con 1.000 acciones de IA |
| Jira Service Management | Agentes Rovo desde Standard; creación de incidentes con IA y borradores de revisión posincidente en Premium | Solo plan Enterprise | Standard 21,50 $, Premium 55,28 $ por agente al mes |
| Zendesk | Copilot (resúmenes, sugerencias de fusión, tickets similares), agentes de IA facturados por resolución automatizada | No | Suite Team 55 $, Professional 115 $ por agente al mes anual; Copilot 50 $ por agente al mes |
| Freshdesk | Freddy AI Agent (500 sesiones incluidas, luego 49 $ por 100), Copilot 29 $ por agente al mes | No | Growth 19 $, Pro 55 $, Enterprise 89 $ por agente al mes anual |
| eesel | Redacta o envía respuestas dentro de tu helpdesk, etiqueta y vincula tickets, aprobaciones por acción | No, lee la tuya | 299 $ al mes por 500 créditos, un ticket es un crédito |
Algunos detalles que importan más que la columna de precios. La documentación de PagerDuty dice que AI Status Updates solo puede redactar actualizaciones externas desde Slack; en Microsoft Teams y en la aplicación web son solo actualizaciones internas. En Jira Service Management, la "incident stakeholder communication" (invitar y enviar correos a partes interesadas internas y externas) es una función Premium, así que el plan Standard no la incluye. Más sobre esto en mi desglose de los precios de JSM y en el artículo sobre revisiones posincidente con IA.
Del lado del helpdesk, ni Zendesk Copilot ni Freddy AI saben de tu incidente a menos que alguien se lo diga. Trabajan con tickets y artículos de ayuda, y tu registro de incidente vive en otra herramienta. Conectar ambos es el verdadero trabajo.
Los detalles completos de los planes están en mis guías de precios de Zendesk y precios de Freshdesk.
¿Cómo conectas el registro de incidente con el helpdesk?
Envía cada actualización de estado de tu herramienta de incidentes a la IA que responde tickets, como datos. Esta es la parte a la que dedico mis días, así que aquí va la versión sencilla de cómo funciona.
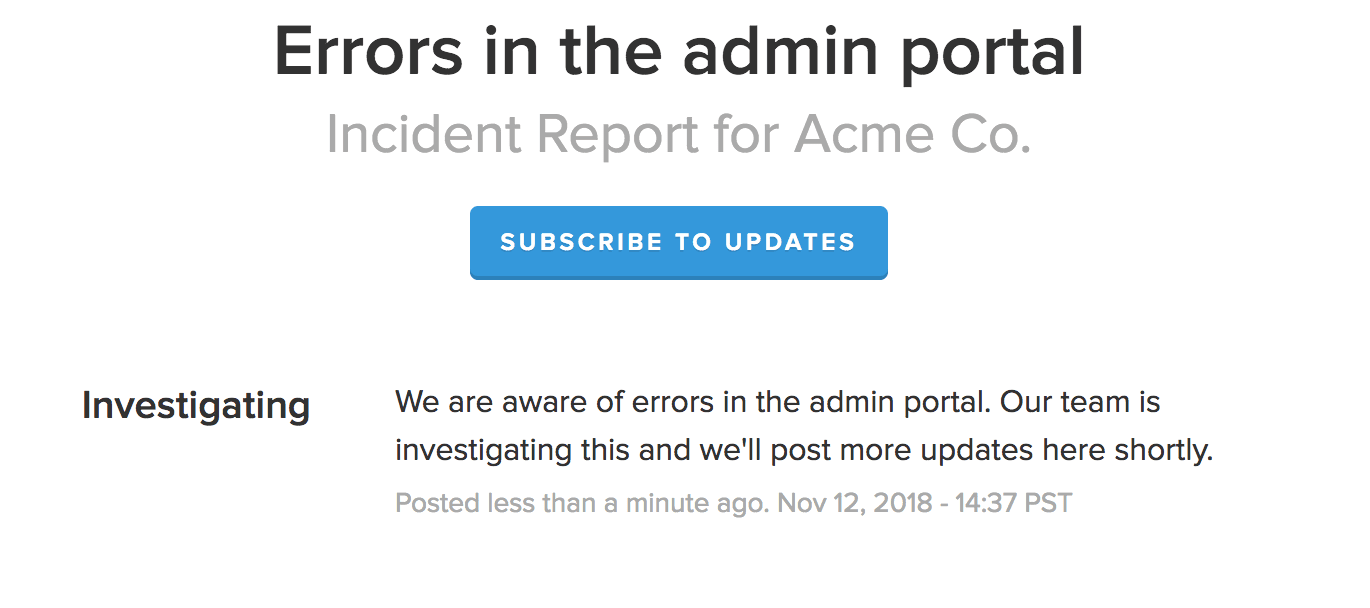
Statuspage puede enviar cada actualización de incidente a una URL. Sus notificaciones por webhook son solicitudes HTTP POST con la actualización del incidente o del componente, y están disponibles desde el plan Startup (99 $ al mes). Este es el tipo de actualización que llevan esos payloads:
Del lado de eesel, una automatización por webhook te da una URL privada a la que cualquier servicio puede enviar JSON por POST, y el agente se despierta con esos datos y sigue las instrucciones que escribiste para él. Así que apuntas el webhook de Statuspage a esa URL y le dices al agente: "When an incident update arrives, save the latest approved text as the current incident status. On new tickets that match it, reply with that text and the next update time, add the incident tag, and leave everything else for a person." Lo mismo funciona desde incident.io o PagerDuty mediante sus propios webhooks o Zapier. eesel no tiene una integración nativa con Statuspage, así que el webhook es el camino.
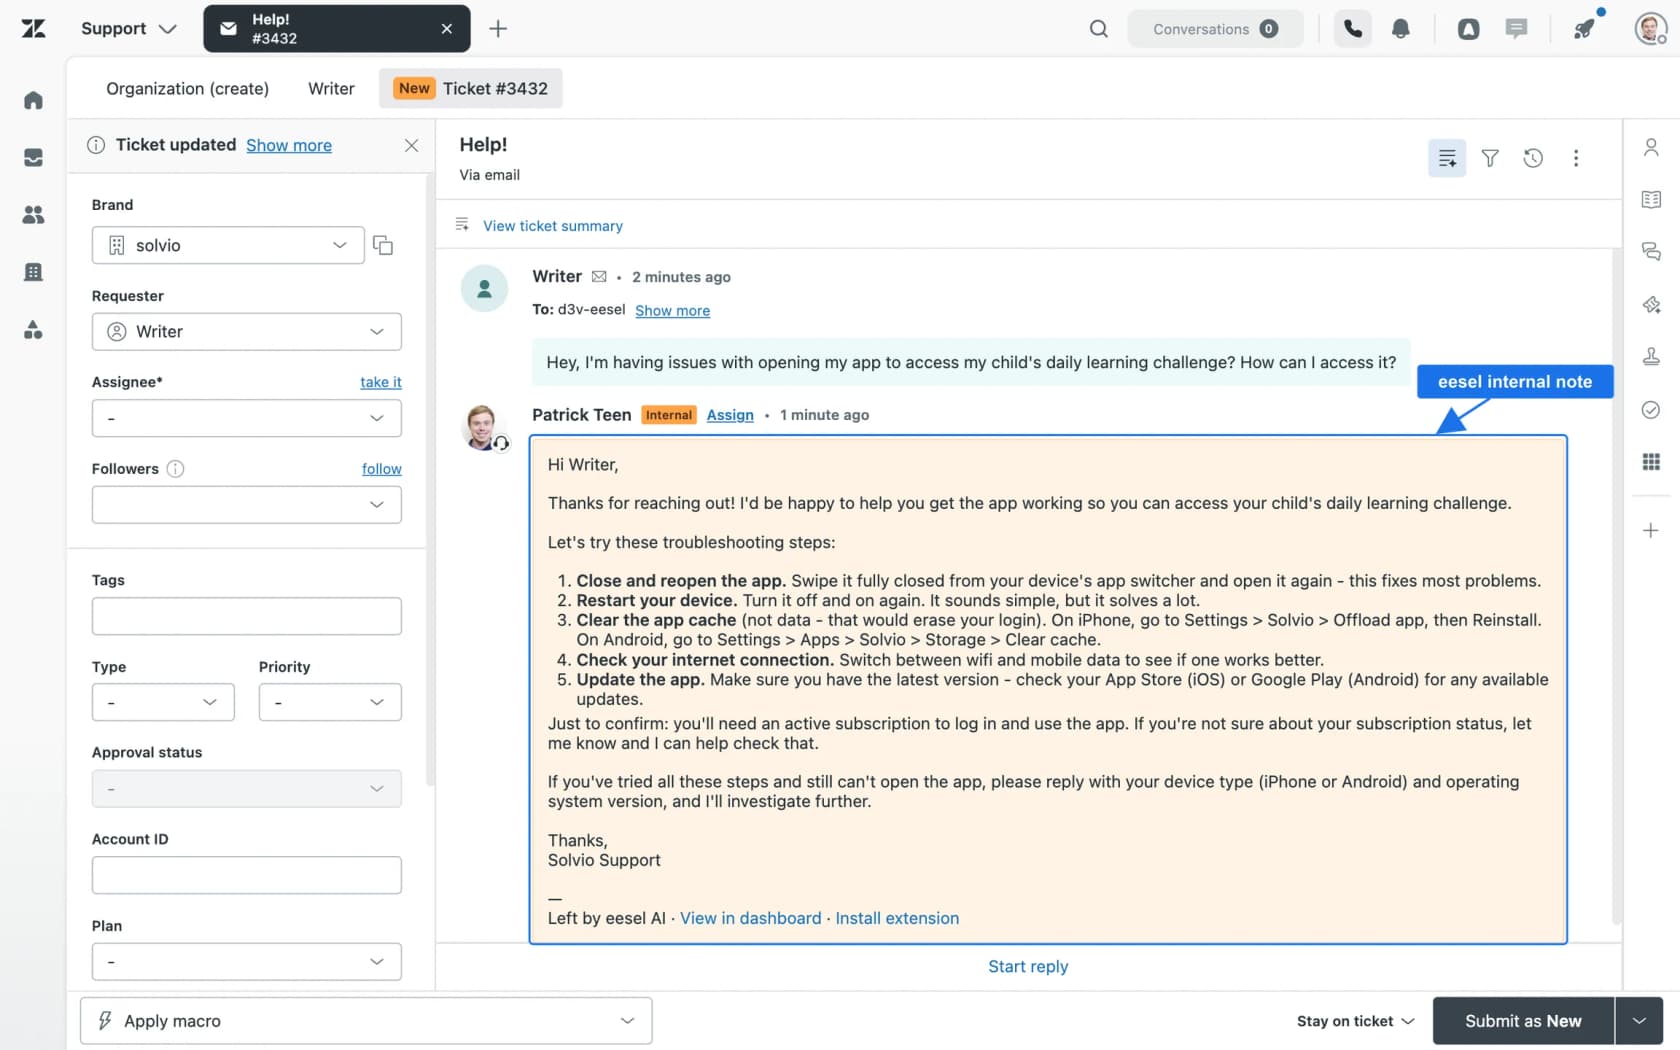
Dentro de Zendesk, las acciones de eesel que importan en un día de incidente son: redactar respuesta de ticket (retenida hasta que una persona apruebe), dejar nota interna, añadir etiquetas, buscar tickets y actualizar campos como el estado o la prioridad. Cada acción puede configurarse para ejecutarse sola, requerir aprobación o estar desactivada. El primer día pondría "Send ticket reply" en aprobación y "Add tags" y "Leave internal note" en automático.
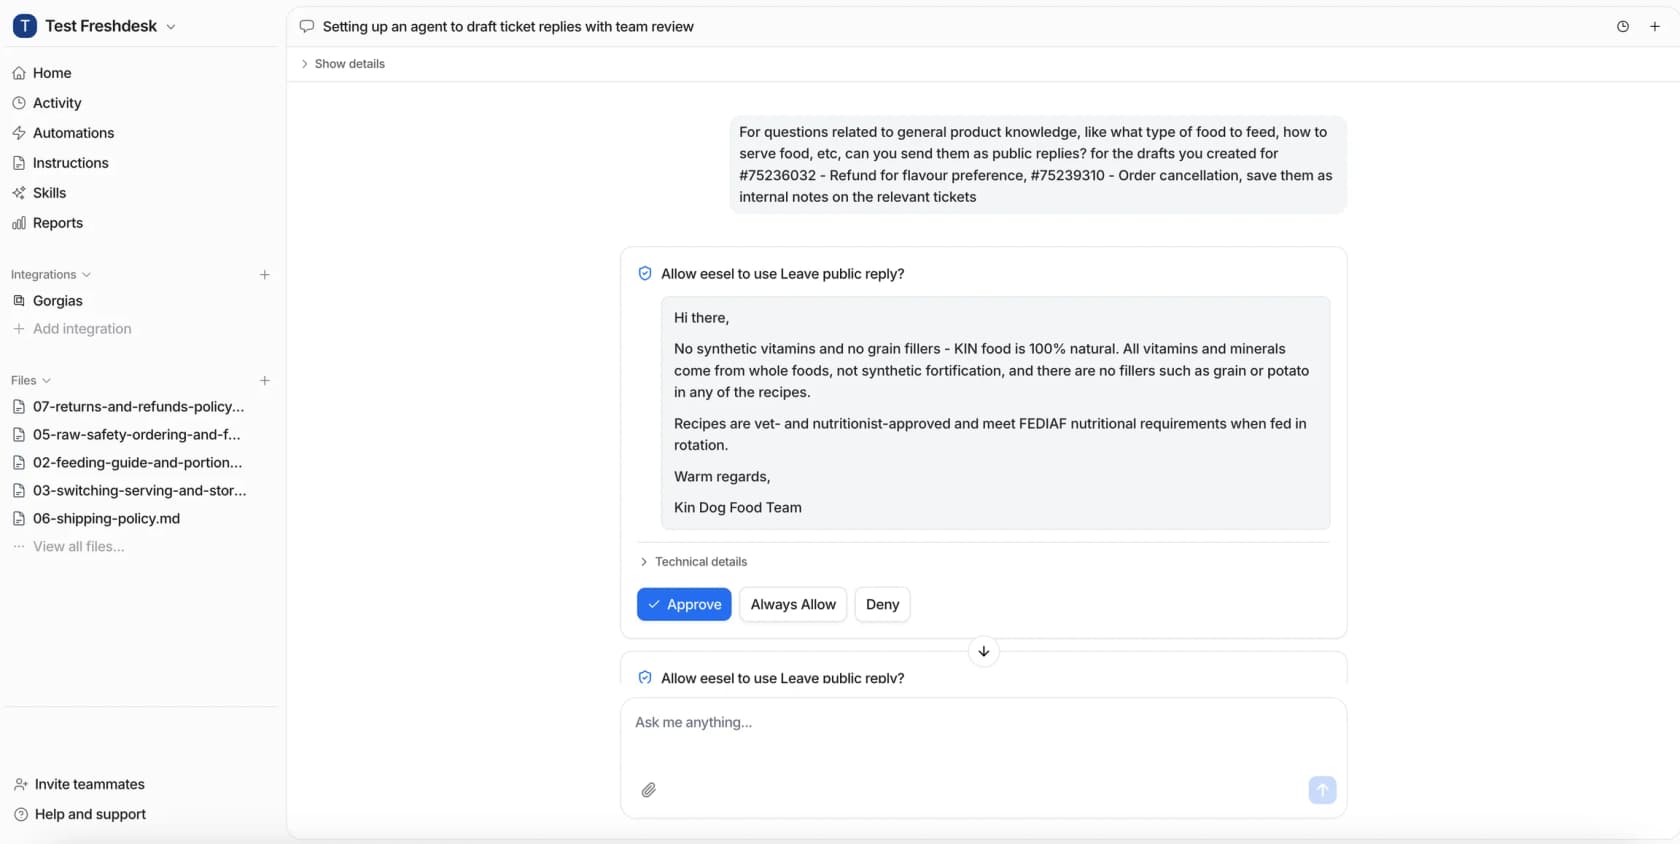
Las aprobaciones no tienen por qué hacerse en el panel. Si la ejecución empezó desde Slack, la tarjeta de aprobación llega a ese hilo, así que tu responsable de comunicación puede aprobar respuestas desde el mismo canal que ya está vigilando. Si tu responsable del incidente vive en una terminal, la CLI de eesel hace el mismo trabajo: eesel approvals lista lo que espera y eesel approvals approve <id> lo envía. Eso también significa que un agente de programación como Claude Code o un script de tu runbook de incidentes puede revisar la cola por ti. Nada del agente cambia entre el panel, Slack y la terminal. Es el mismo compañero con los mismos permisos.
¿Qué pasa después de resolver el incidente?
Una segunda oleada de tickets, y la mayoría de los equipos no la planifica. La página de estado pasa a resuelto, todos respiran, y luego la bandeja se llena con otro tipo de mensaje.
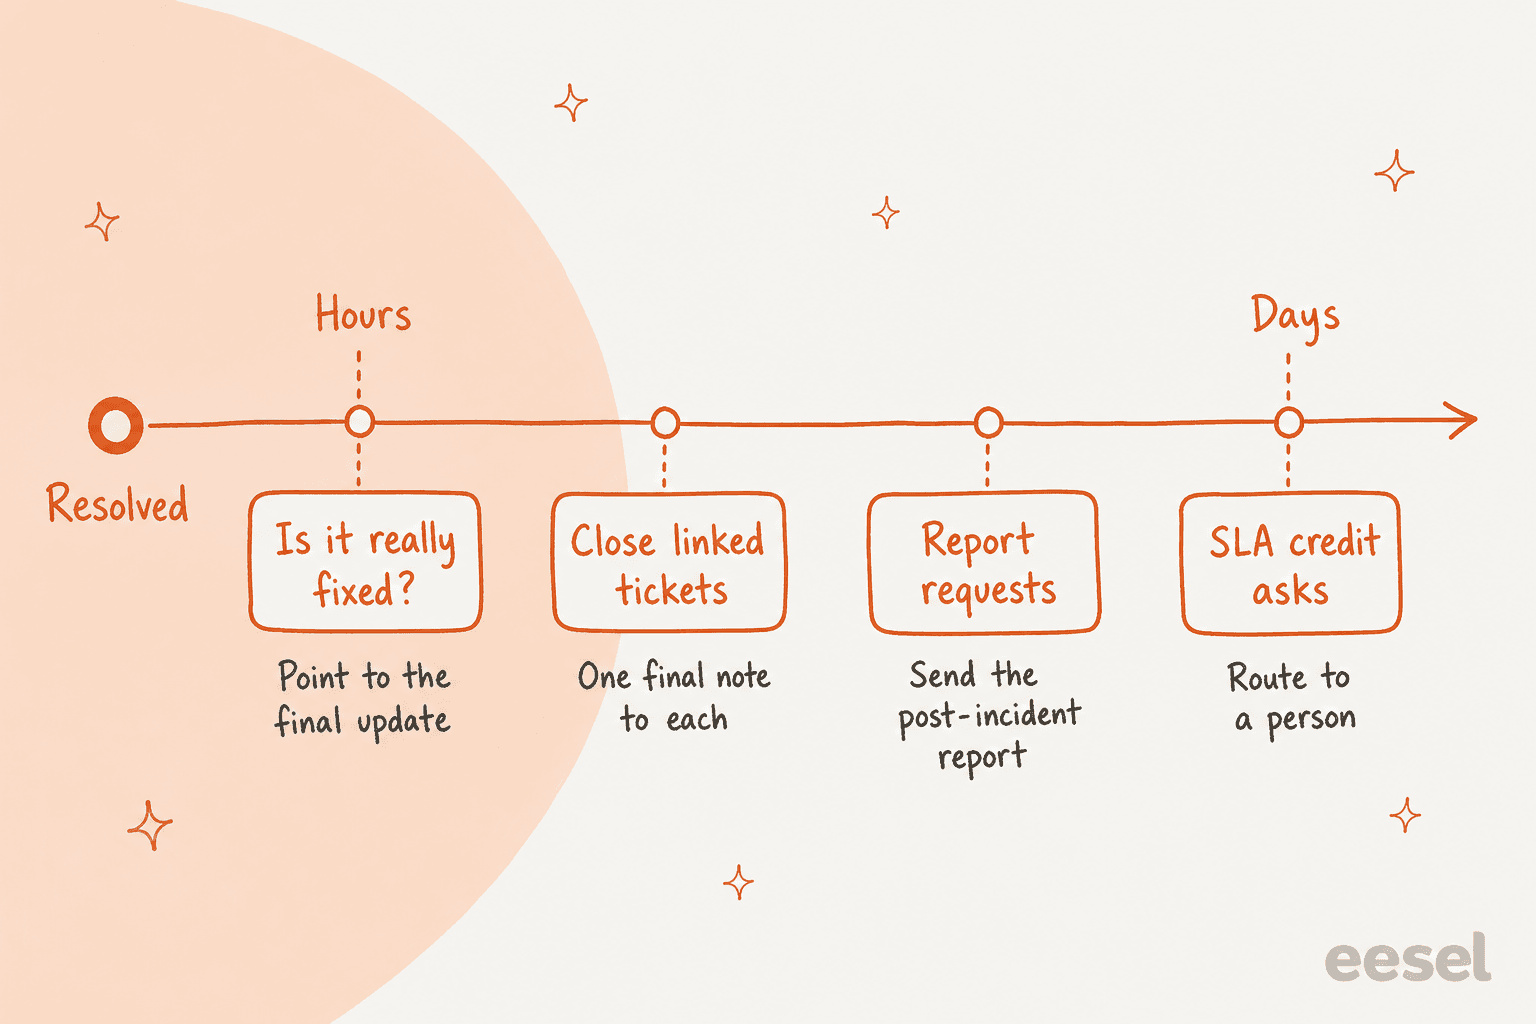
Esto es lo que llega, más o menos en orden:
- «¿De verdad está arreglado?» Llegan en cuestión de horas, a menudo de clientes que nunca vieron la publicación de resuelto. La IA puede responderlas con el texto de la actualización final y una línea que los invite a responder si todavía ven el problema. Un «a mí sigue sin funcionar» real va a una persona, ya que podría significar que el arreglo no llegó a todos.
- Cerrar todos los tickets vinculados. Envía una nota final a cada ticket etiquetado con el incidente, no solo a los que siguen abiertos. En Zendesk, resolver el ticket de problema hace la mayor parte. En Freshdesk, resuelves tú los tickets vinculados o haces que la IA publique la nota final en cada uno. Vigila tu tasa de reapertura durante los próximos días, porque te dice si el mensaje de «arreglado» llegó.
- Solicitudes del informe posincidente. Los clientes más grandes piden el análisis, a menudo para su propio cumplimiento normativo. Mantén una lista de quién lo pidió durante el incidente (la etiqueta lo facilita) y envía el informe a todos cuando se publique. No dejes que la IA resuma la causa raíz antes de que tus ingenieros la publiquen.
- Peticiones de crédito por SLA. Son cuestiones contractuales con dinero de por medio. Derívalas a una persona con el plan del cliente y las horas de inicio y fin del incidente adjuntas, igual que gestionaría las disputas de facturación.
La oleada es también donde más aprendes. Cuenta los tickets etiquetados, cuántos llegaron antes de la primera publicación de estado y cuántos preguntaron «¿alguna actualización?». Esos tres números te dicen si tu primera publicación fue lenta, si tu ritmo se mantuvo y por dónde empezar la próxima vez. Los informes de soporte con IA pueden sacártelos.
Hacerlo bien importa más allá del propio día. Como lo expresó un fundador en r/SaaS:
"if you wait until an outage to figure this out it’s already chaos, so even a simple status page plus a prewritten we’re investigating template and one owner for updates goes a long way because trying to debug while replying to tickets in real time is how small issues turn into trust problems fast"
La confianza es también la razón por la que conectaría esto con tu trabajo contra la baja de clientes. Los clientes que escribieron durante una caída son los más propensos a plantearse cambiar después, y un seguimiento personal de su gestor de cuentas una semana más tarde cuesta muy poco.
¿Cómo lo configuras antes de la próxima caída?
Hazlo un martes tranquilo, no a las 2 de la madrugada. Este es el orden que seguiría:
- Nombra la rotación de responsables de comunicación. Una persona por turno que no esté de guardia en ingeniería. Escríbela junto a tu calendario de guardias.
- Escribe la plantilla del registro de incidente. Los cuatro campos: qué está afectado, hechos verificados, qué estamos haciendo, próxima actualización a las.
- Aprueba la redacción de antemano. Publicaciones de «Investigando», «Identificado», «Monitorizando», «Resuelto», más una respuesta a ticket y un correo a cuentas para cada una. El informe de incident.io recomienda plantillas preaprobadas para incidentes comunes precisamente por esto.
- Activa la vinculación de tickets. Tickets de problema e incidente en Zendesk, o tickets vinculados en Freshdesk, más un formato de etiqueta para cada incidente.
- Conecta la IA con las aprobaciones activadas. Configura las respuestas públicas para que requieran aprobación, las etiquetas y notas internas en automático, y conecta el webhook de la página de estado. Revisa una semana de borradores en tickets reales antes de pasar cualquier respuesta a automático.
- Haz un simulacro. Simula un SEV2 en una marca de pruebas. Comprueba que la primera publicación sale dentro de tu objetivo, que el latido se dispara, que la macro se actualiza y que cada ticket etiquetado recibe la nota final.
Si tu equipo trabaja con cambios de turno o cubre poco los fines de semana, el paso 1 es el más importante. Una caída a las 3 de la madrugada sin nadie en la rotación de comunicación es la forma en que la página de estado se queda en «investigando» cuatro horas.
Prueba eesel en tus días de incidente
Si tu cola de soporte corre en Zendesk, Freshdesk o Gorgias, el compañero de IA para helpdesk de eesel se une como un agente nuevo que ya leyó tu centro de ayuda y tus tickets pasados. En un día de incidente etiqueta cada ticket de la caída, responde en tickets asociados con la actualización que aprobó tu responsable de comunicación y pasa cuentas grandes, pérdida de datos y facturación directamente a una persona, la configuración que Qontro ejecuta en Freshdesk. Conecta tu página de estado mediante un webhook y cada respuesta se mantiene en la misma historia que la página de estado.
Empezar es gratis con 100 créditos, luego 299 $ al mes por 500, y un ticket cuenta como un crédito sin importar cuántas actualizaciones reciba. Configúralo en Zendesk o Freshdesk antes de tu próxima caída, no durante ella.