

La IA para el soporte a desarrolladores funciona cuando divides la cola en cuatro tipos de tickets: preguntas de documentación que la IA responde con un enlace, problemas de configuración que diagnostica a partir del código del desarrollador, preguntas de cuenta que responde consultando su ID de solicitud, y posibles bugs que redacta para un ingeniero. El bot de documentación es la parte fácil. Las dos que de verdad ahorran tiempo a los ingenieros son la consulta de solo lectura y el informe de bug.
Lo que la mayoría de los equipos pasa por alto: una parte creciente de los tickets de desarrolladores viene ya de sus propias herramientas de programación con IA, que se inventan partes de tu API. Cada respuesta equivocada, suya o tuya, apunta a una laguna en tu documentación, así que arregla la página, no solo la respuesta.
Si tu cola vive en Freshdesk, Zendesk o Jira Service Management, eesel lo hace dentro de ella. Timengo lo usa para redactar respuestas en danés a administradores de TI sobre certificados, complementos de Outlook y flujo de correo, a partir de unos 5.300 tickets y artículos anteriores, y un ingeniero envía cada una.
¿Cómo es el soporte a desarrolladores en 2026?
Construyo las integraciones de eesel, lo que significa que paso buena parte de la semana al otro lado de tu cola: leyendo la referencia de API de otra persona, topándome con un 401 que no entiendo y preguntándome si el fallo es mío o suyo. Los tickets de desarrolladores se leen distinto del soporte al consumidor. Llegan con trazas de pila, medio comando curl y una versión de SDK, y quien escribe suele saber más de su propio código que tu equipo de soporte.
Suelen caer en unos pocos grupos:
- Preguntas de cómo hacer algo y de referencia. Cuál es el límite de tasa de este endpoint, qué scope necesito, hay un SDK de Go.
- Problemas de configuración y autenticación. Clave de prueba en producción, token OAuth caducado, URL base equivocada, una firma de webhook que no se verifica.
- "¿Qué pasó con mi solicitud?" Una entrega de webhook fallida, un pago que nunca se registró, un 500 en un ID de solicitud concreto.
- Posibles bugs. Un comportamiento que no coincide con la documentación, una regresión tras una versión del SDK, un error que solo lanza una región.
El cuarto grupo es donde se mete a los ingenieros, y también donde el soporte es más débil, porque un ticket vago de "vuestro webhook está roto" obliga al ingeniero a empezar la investigación desde cero. Es el mismo problema sobre el que escribí en IA para soporte de nivel 2: en ese nivel el trabajo no es responder, es investigar.
¿Está ya la IA del propio desarrollador escribiendo tus tickets?
Hay un tipo nuevo de ticket que no existía hace unos años. Un desarrollador le pide a su asistente de programación que escriba un cliente para tu API, el asistente adivina campos que nunca ha visto y tu equipo de soporte recibe el resultado. Un desarrollador en Hacker News describió exactamente esa cola en un cliente suyo:
"What I'm seeing is a little eternal September of support tickets about programs that fail to interface the JSON API of a customer of mine. The API is always allucinated. In the best case there are out of place attributes. Often they don't exist at all."

Su solución fue responder con comentarios línea por línea sobre el JSON inventado. Es un trabajo perfecto para la IA de tu lado, siempre que compare la carga útil con tu especificación real y no con su propia suposición. También dice algo sobre dónde conviene poner esfuerzo: si la IA de otras personas se equivoca una y otra vez con tu API, la documentación que leen esas herramientas ya forma parte de tu superficie de soporte. Las plataformas de documentación se han dado cuenta. Mintlify incluye un servidor MCP en su plan gratuito Starter, y kapa.ai ofrece un servidor MCP alojado para que los agentes de programación consulten tu documentación directamente.
¿Qué preguntas de desarrolladores puede responder la IA por sí sola?
ChatGPT, al recibir esta pregunta de un equipo que vende una API y SDKs, dividió la cola por tipo de pregunta y puso los posibles bugs bajo "supervisión humana". Estoy de acuerdo con esa división, y añadiría otra línea entre los carriles: qué necesita tener conectado la IA para hacer cada uno.
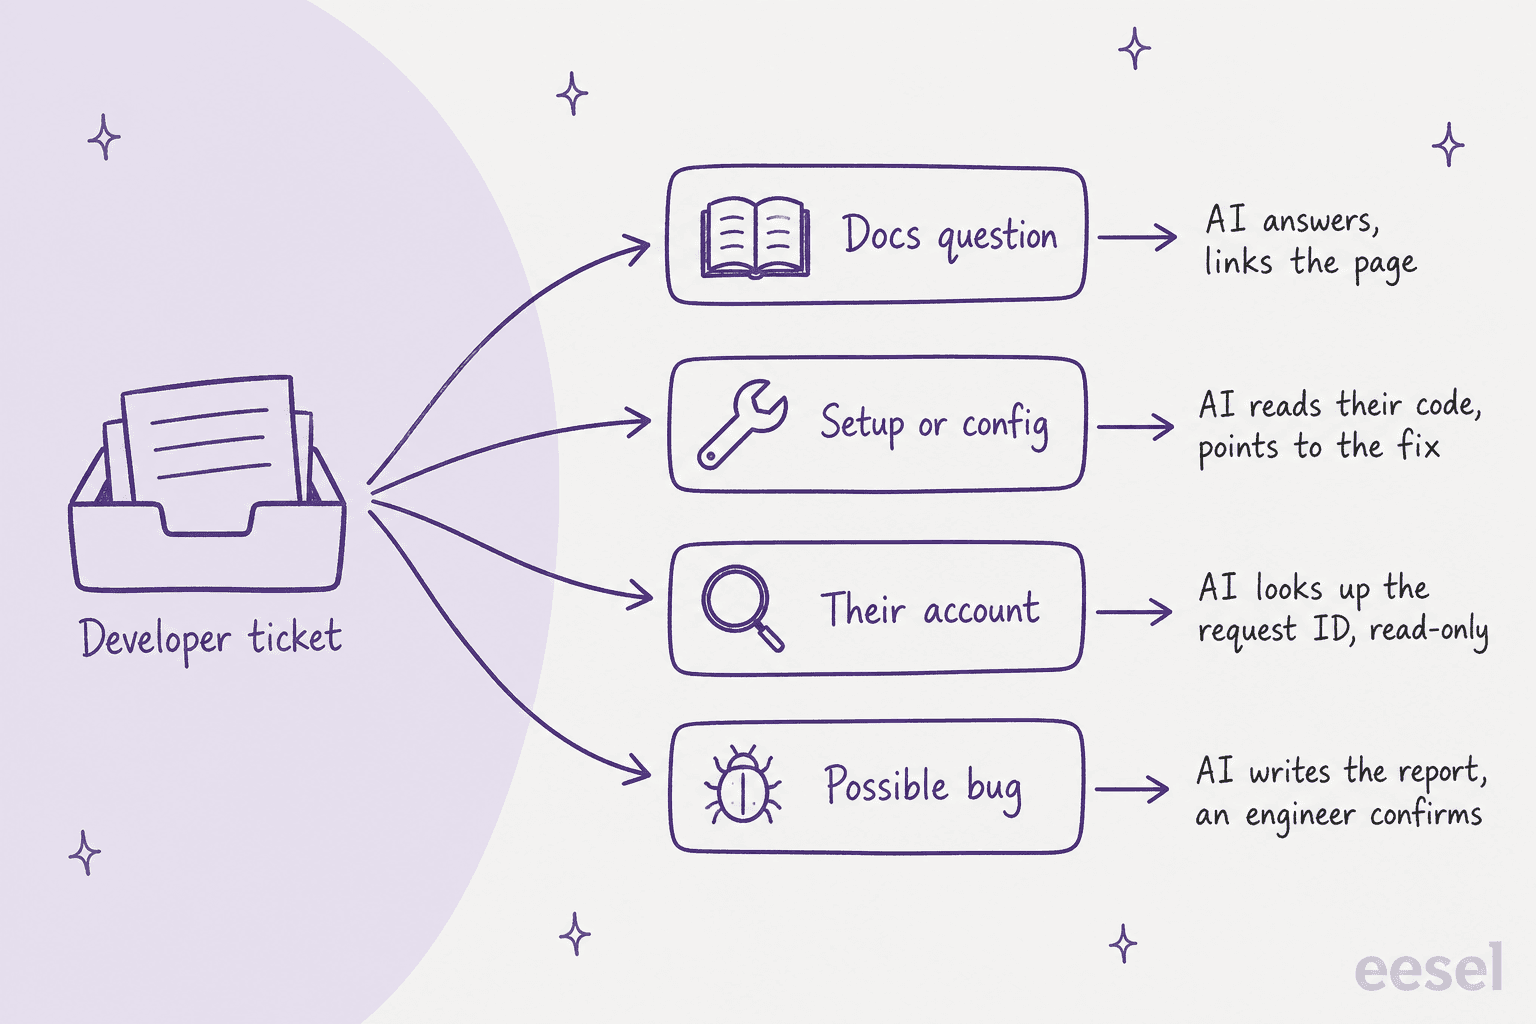
| Tipo de ticket | Ejemplo | Qué debería hacer la IA | Qué necesita conectado |
|---|---|---|---|
| Pregunta de documentación | "¿Cuál es el límite de tasa de /search?" | Responder y enlazar la página | Referencia de API, documentación del SDK, changelog |
| Configuración | "401 tras rotar claves en Node SDK 2.4" | Pedir versión del SDK e ID de solicitud, nunca la clave, y señalar la solución probable | Documentación, changelog, tickets anteriores |
| Su cuenta | "El webhook invoice.paid nunca llegó" | Consultar el registro de entregas, solo lectura, y explicar qué pasó | Una consulta a tu propia API o herramientas de administración |
| Posible bug | "/search devuelve 500 solo en la región UE desde las 9" | Revisar problemas conocidos y estado, redactar el informe, pasarlo a un ingeniero | Problemas conocidos, página de estado, gestor de incidencias |
| Cambio de cuenta | "¿Podéis subir nuestro límite de tasa?" | Recoger los detalles y esperar a que una persona apruebe | Un paso de aprobación |
Los dos primeros carriles son donde los bots de documentación ya funcionan bien. El tercero es donde se detienen la mayoría de las configuraciones, porque necesita una conexión en vivo con tus propios sistemas. El cuarto es donde están las horas.
Prueba a clasificar tú mismo algunos tickets de aspecto real:
¿A dónde va este ticket de desarrollador?
Elige un ticket para ver a qué carril pertenece y qué necesita la IA para gestionarlo.
Aún no has elegido nada. Empieza con cualquier ticket de arriba.
La respuesta está en tu referencia de API. La IA responde con el nombre del scope y enlaza la página que usó, para que el desarrollador pueda comprobarlo.
Necesita: referencia de API y documentación del SDK, rastreadas de forma programada.
Pide la versión del SDK y un ID de solicitud, nunca la clave en sí, y luego revisa el changelog de esa versión y los tickets anteriores con el mismo error. Una clave de prueba en producción es el culpable habitual.
Necesita: documentación, changelog, tickets anteriores.
Probablemente un asistente de programación se inventó esos campos. La IA compara la carga útil con tu esquema real campo por campo y enlaza el correcto. Regístralo también como señal para la documentación: si su herramienta adivinó mal, quizá tu documentación sea difícil de leer para las herramientas.
Necesita: especificación OpenAPI o referencia de API.
Llama a tu registro interno de entregas para esa solicitud, de solo lectura y limitada a este cliente, y explica lo que encontró: reintentos, el código de respuesta que devolvió su endpoint, cuándo se rindió.
Necesita: una consulta a tu propia API, con credenciales que la IA nunca ve.
Revisa problemas conocidos y la página de estado, reúne región, endpoint, IDs de solicitud y marcas de tiempo, y presenta un informe a ingeniería. Le dice al desarrollador que se está revisando y nunca lo llama un bug confirmado.
Necesita: problemas conocidos, página de estado, tu gestor de incidencias.
La IA recoge el plan, el uso actual y el motivo, y retiene el cambio para una persona. Todo lo que cambie una cuenta o dinero espera aprobación.
Necesita: un paso de aprobación en cada acción de escritura.
¿Por qué un bot de documentación solo te lleva a medio camino?
Un bot de documentación es el primer paso obvio, y es bueno. kapa.ai, por ejemplo, conecta documentación, repositorios de GitHub, una especificación OpenAPI, hilos de Slack y tickets de Zendesk, y entre sus clientes están OpenAI, Grafana y Netlify. Un desarrollador cuyo equipo lo compró resumió el valor con claridad:
"It's not right all the time, but it is most of the time and, crucially, it shares not just an answer but a link to the docs that led it to that answer. That makes it easier to fact check the LLM."
Ese enlace es la clave. Un desarrollador confiará en una respuesta que puede comprobar, y no en una que no puede. Pero tres cosas impiden que un bot de documentación cubra toda la cola.
La recuperación es más difícil de lo que parece. El propio fundador de kapa.ai, Emil Sorensen, escribió que los bots de documentación son "deceptively hard to get right in production", que la recuperación depende mucho de cómo se trocea y estructura tu documentación, y que la única forma de afinarla son las evaluaciones, "lots of them", según su comentario en Hacker News. Si un proveedor cuyo producto entero es esto lo dice, créele antes de montar el tuyo un fin de semana.
Las versiones se desvían. Un desarrollador con el SDK 2.4 necesita la respuesta de la 2.4, no la de la 3.0. Tu IA necesita el changelog como fuente, y tu documentación necesita etiquetas de versión que pueda leer. Sin ambas, da la respuesta más reciente a todo el mundo.
La documentación no sabe nada de su cuenta. "¿Por qué falló mi webhook?" no tiene respuesta en ninguna página de documentación. La tiene en tus registros de entregas, a los que un bot de documentación no llega. Esos son los carriles tres y cuatro, y por eso las herramientas de soporte para equipos de desarrolladores (Plain, Pylon, eesel) ponen la IA dentro de la cola de tickets con acceso a tus sistemas, no solo en el sitio de documentación.
¿Qué debería leer la IA antes de responder?
Las fuentes importan más que el modelo. Esto es lo que conectaría, más o menos por orden de utilidad:
- Referencia de API y especificación OpenAPI. La fuente de verdad sobre endpoints, parámetros y códigos de error. La especificación es lo que permite a la IA detectar un campo inventado.
- Documentación del SDK por lenguaje. Pasos de instalación, configuración y las particularidades de cada biblioteca cliente.
- Changelog y notas de versión. Así sabe la IA que un parámetro se renombró en la 2.4 o que un valor por defecto cambió en la 3.0.
- Tickets resueltos. Los casos límite que nadie documentó. Esta es la fuente que hace que las respuestas suenen a tu ingeniero sénior. Orosoft apunta su agente a unos 6.100 tickets resueltos de Freshdesk y le indica que prefiera los resueltos, dé más peso a los recientes e indique en qué ticket o artículo se basa cada borrador.
- Problemas conocidos y estado. Para que la IA diga "estamos al tanto" en lugar de guiar a un desarrollador por una solución para una caída.
- Manuales internos. Para el personal de soporte, no para respuestas públicas.
Dos reglas que fijaría desde el primer día. Primera: los tickets anteriores están llenos de datos de clientes, así que elimínalos antes de indexarlos. La redacción de PII de eesel pasa cada ticket sincronizado por un detector de quince categorías, entre ellas números de tarjeta y nombres, antes de almacenar nada, de modo que el agente nunca ve los originales. Segunda: mantén las fuentes al día de forma programada. Timengo vuelve a rastrear su sitio de documentación cada lunes, resincroniza su centro de ayuda cada domingo por la tarde y trae el historial completo de tickets cada mes, algo que importa en un producto donde los certificados caducan en ciclos de tres años y las renovaciones llegan todas a la vez.
Si partes de un centro de ayuda escaso, mi auditoría de base de conocimiento con IA es el lugar para empezar, y base de conocimiento con IA para SaaS cubre la estructura.
¿Cómo consulta la IA un ID de solicitud sin ver tus claves de API?
Este es el carril que convierte a una IA de un buscador de documentación en algo que ahorra tiempo a los ingenieros. El desarrollador da un ID de solicitud, la IA lo busca en tu sistema y explica qué pasó. Bien hecho, tampoco pide ni ve nunca un secreto.
Las reglas que mantendría:
- Nunca pidas al desarrollador su clave de API. Pide el ID de solicitud, la versión del SDK y el endpoint. Con eso basta para buscar.
- Primero solo lectura. La IA puede ver registros de entregas y de solicitudes. No puede cambiar nada hasta que tú decidas que puede.
- Limita a su cuenta. Una consulta para un cliente solo debe devolver los registros de ese cliente.
- Las credenciales quedan fuera del alcance de la IA. La clave que autoriza la consulta está en la configuración, no en el prompt.
En eesel esto es Network Access. Permites un dominio, añades el encabezado de autenticación que espera y le dices al agente con palabras sencillas para qué sirve la conexión, como "cuando un desarrollador dé un ID de solicitud, búscalo y explica el estado". Según la documentación, las credenciales "stay in your settings and are attached to each request by eesel, so the AI never sees them". Admite GET, POST, PATCH y DELETE, de modo que el mismo mecanismo puede llegar a una API interna de administración o a una pública como la de tu gestor de incidencias, si lo permites.
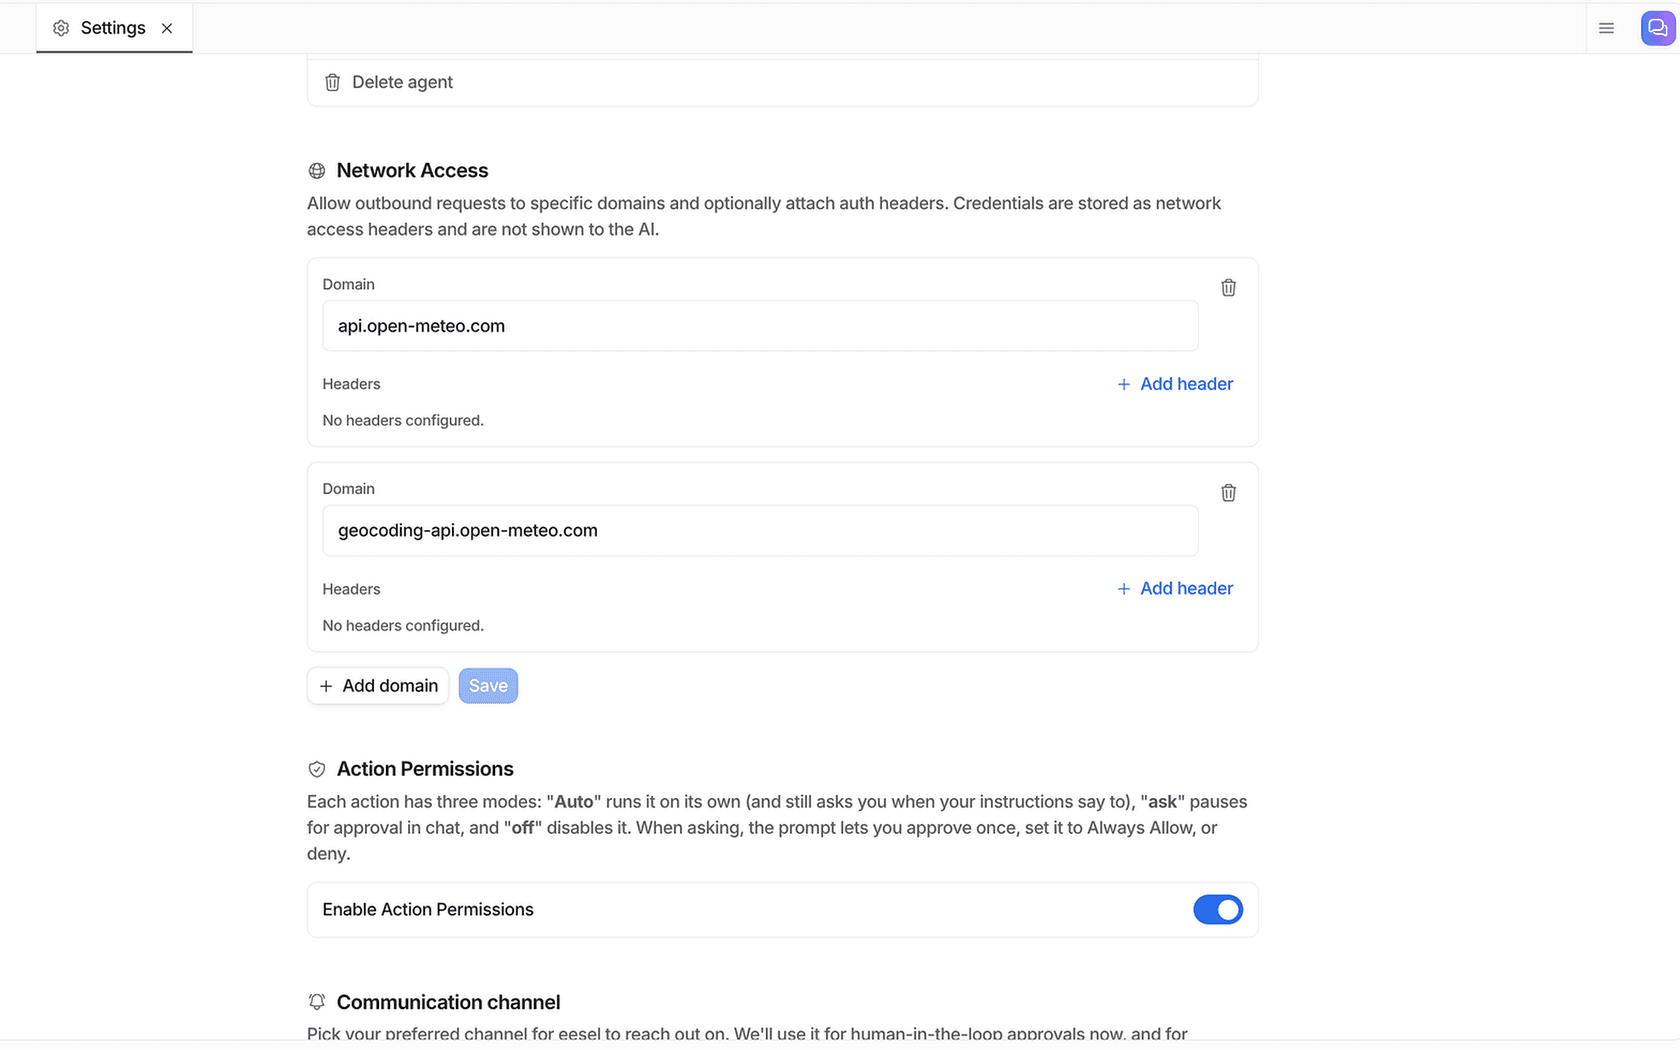
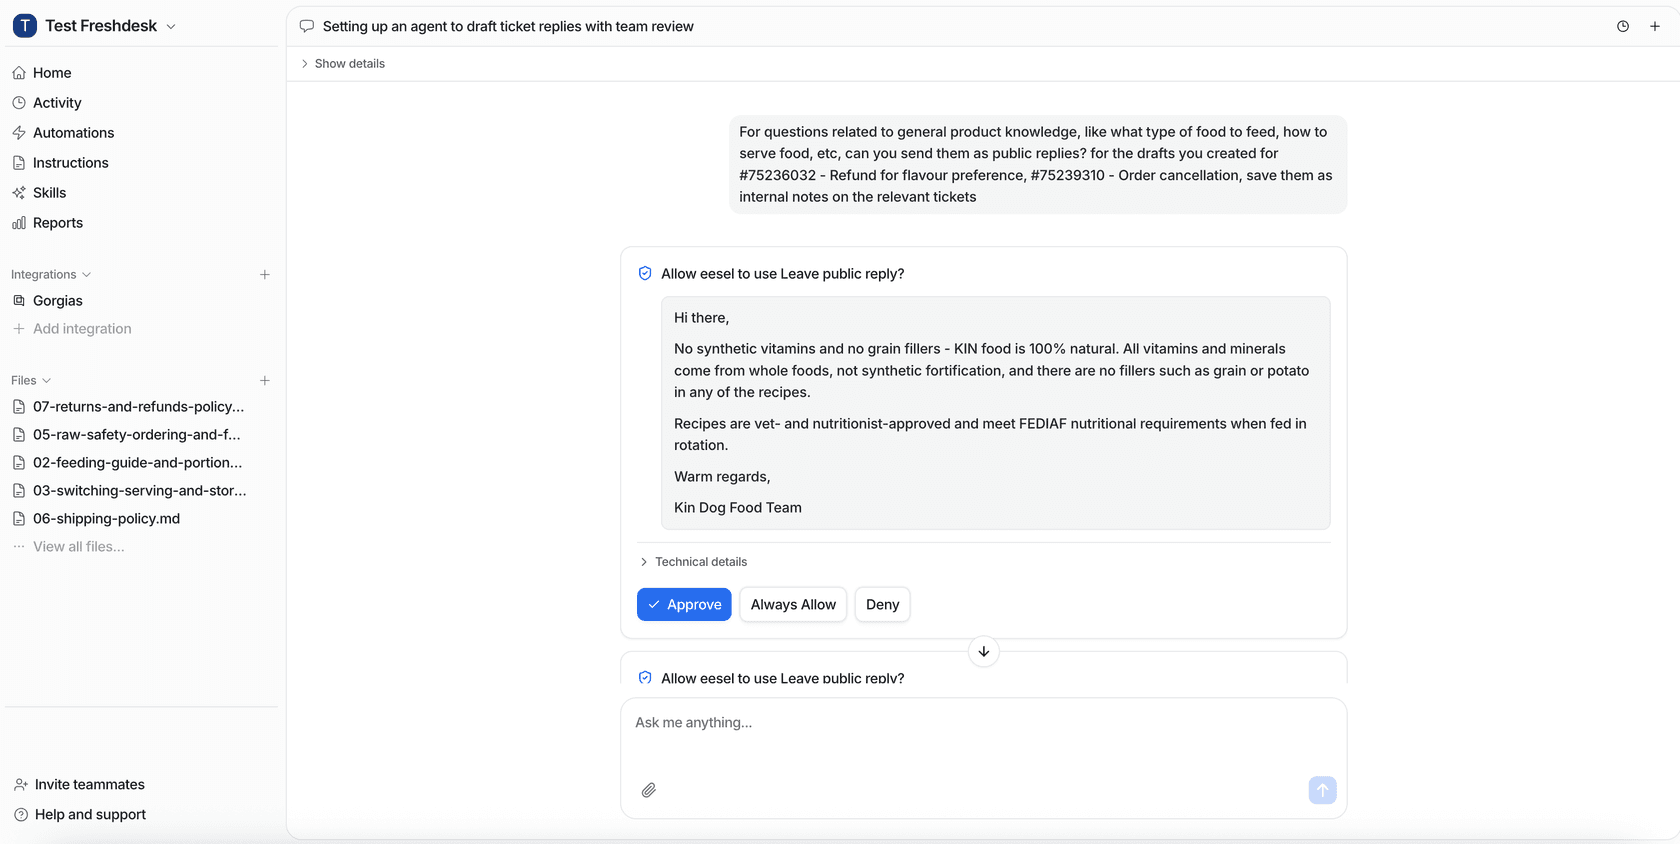
Todo lo que cambie un estado va tras una aprobación. Las acciones y aprobaciones de eesel te permiten fijar cada acción en Auto, Needs approval o Disabled. El consejo de la propia documentación es empezar con los agentes nuevos supervisados y mantener tras una aprobación todo lo que cueste dinero, que para una empresa de API son los cambios de límite de tasa, los créditos y las mejoras de plan. Las aprobaciones aparecen en el panel, en Slack o en la terminal.
¿Cómo debe llegar un posible bug a ingeniería?
El peor ticket de desarrollador que puede recibir un ingeniero es uno reenviado con "el cliente dice que los webhooks están rotos" arriba. El mejor es un informe sobre el que pueda actuar en cinco minutos. La IA es buena escribiendo el segundo, porque puede reunirlo todo mientras el desarrollador sigue en la conversación.
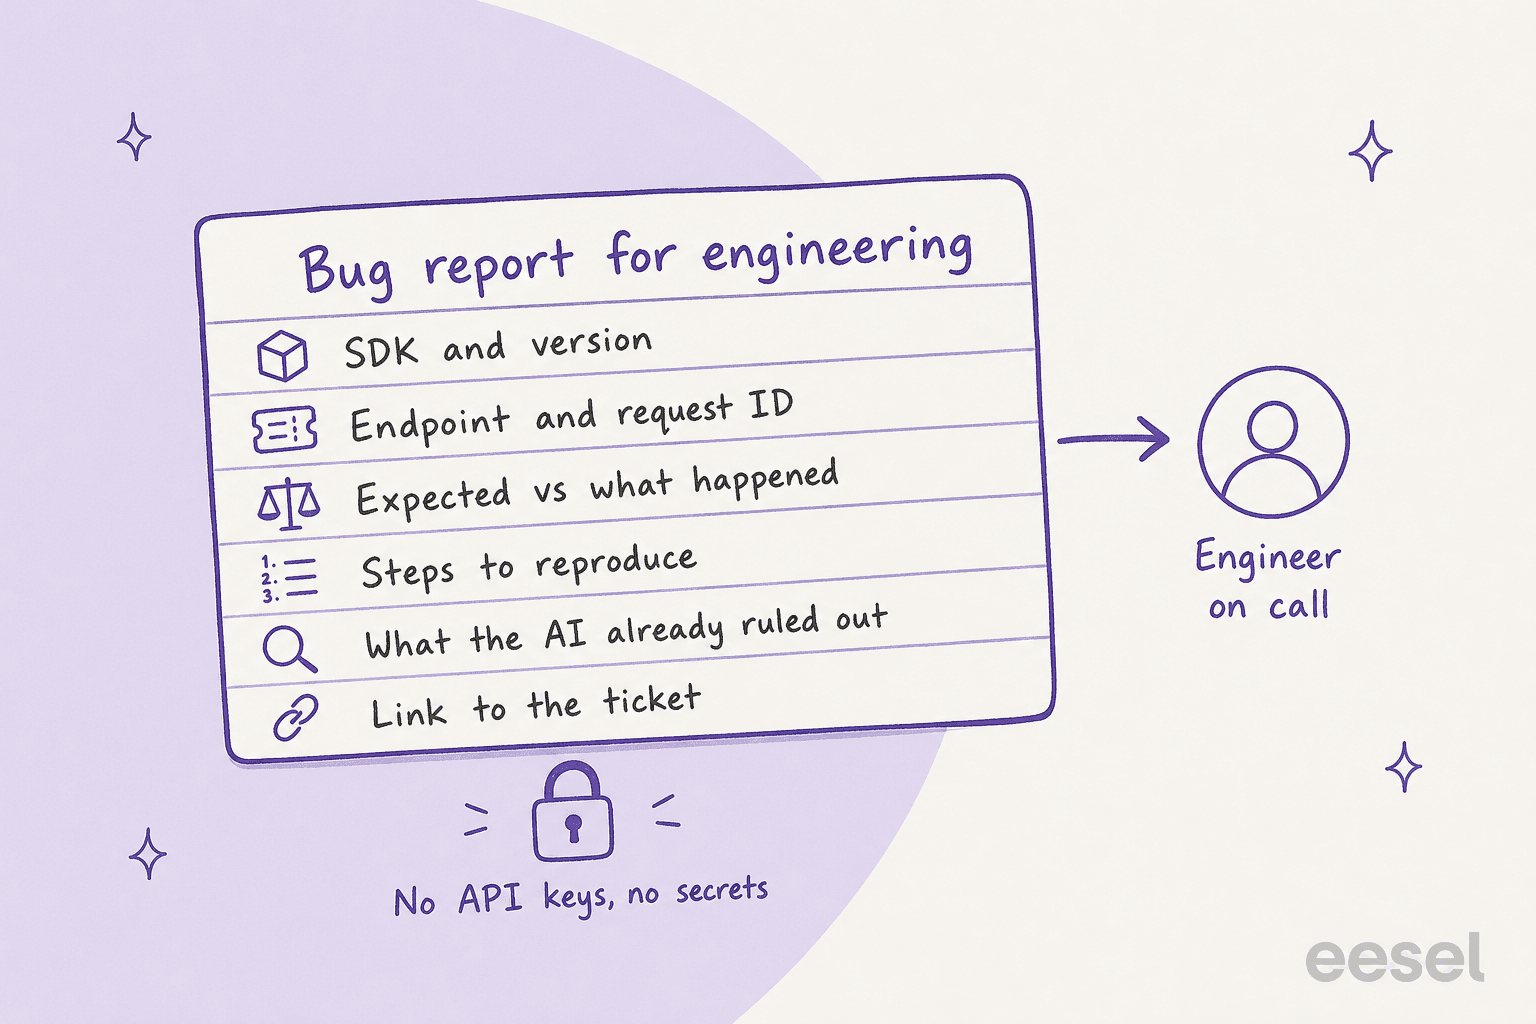
Un buen informe lleva:
- SDK, lenguaje y versión, más la versión de la API si la versionas.
- Endpoint, IDs de solicitud y marcas de tiempo.
- Lo que el desarrollador esperaba y lo que obtuvo, con el cuerpo del error.
- Pasos para reproducirlo, hasta donde el desarrollador pueda darlos.
- Lo que la IA ya descartó: problemas conocidos revisados, página de estado revisada, la configuración parecía correcta.
- Un enlace de vuelta al ticket.
Y una regla por encima de todas: la IA puede decir "esto podría ser un bug, lo he pasado a ingeniería", pero nunca debería decirle a un desarrollador que algo es un bug confirmado. Esa decisión corresponde a quien puede leer el código.
Dónde aterriza el informe depende de tu stack. La integración de Jira Service Management de eesel puede responder, dejar notas internas y mover, asignar, etiquetar y crear incidencias, y puedes indicarle cómo estructurar sus notas. eesel no tiene una integración nativa con GitHub ni con Linear. Plain enumera integraciones con Linear, Jira y GitHub en su página de precios, y Pylon enumera conectores de agentes de programación y acciones de API personalizadas.
Si ingeniería ya vive en Jira, mi artículo sobre la escalada de Zendesk a Jira profundiza más. La deduplicación de tickets ayuda cuando una sola caída llega como cuarenta tickets.
¿Por qué las respuestas equivocadas son la señal más útil?
Todo equipo que monta esto se preocupa por que la IA dé una respuesta equivocada, y a veces lo hará. Lo que me sorprendió en la investigación fue la frecuencia con que una respuesta equivocada resultaba ser un problema de documentación. Un desarrollador en Hacker News describió cómo su propio chatbot de documentación a veces se inventaba una opción de línea de comandos que no existía:
"So it was considered as product feedback. Maybe that exact flag wasn't needed, but something was missing and so the LLM hallucinated what it saw as an intuitive option."
Ese es el reflejo correcto. Un parámetro inventado es la IA diciéndote dónde tu documentación deja un hueco en el que también caería un desarrollador.
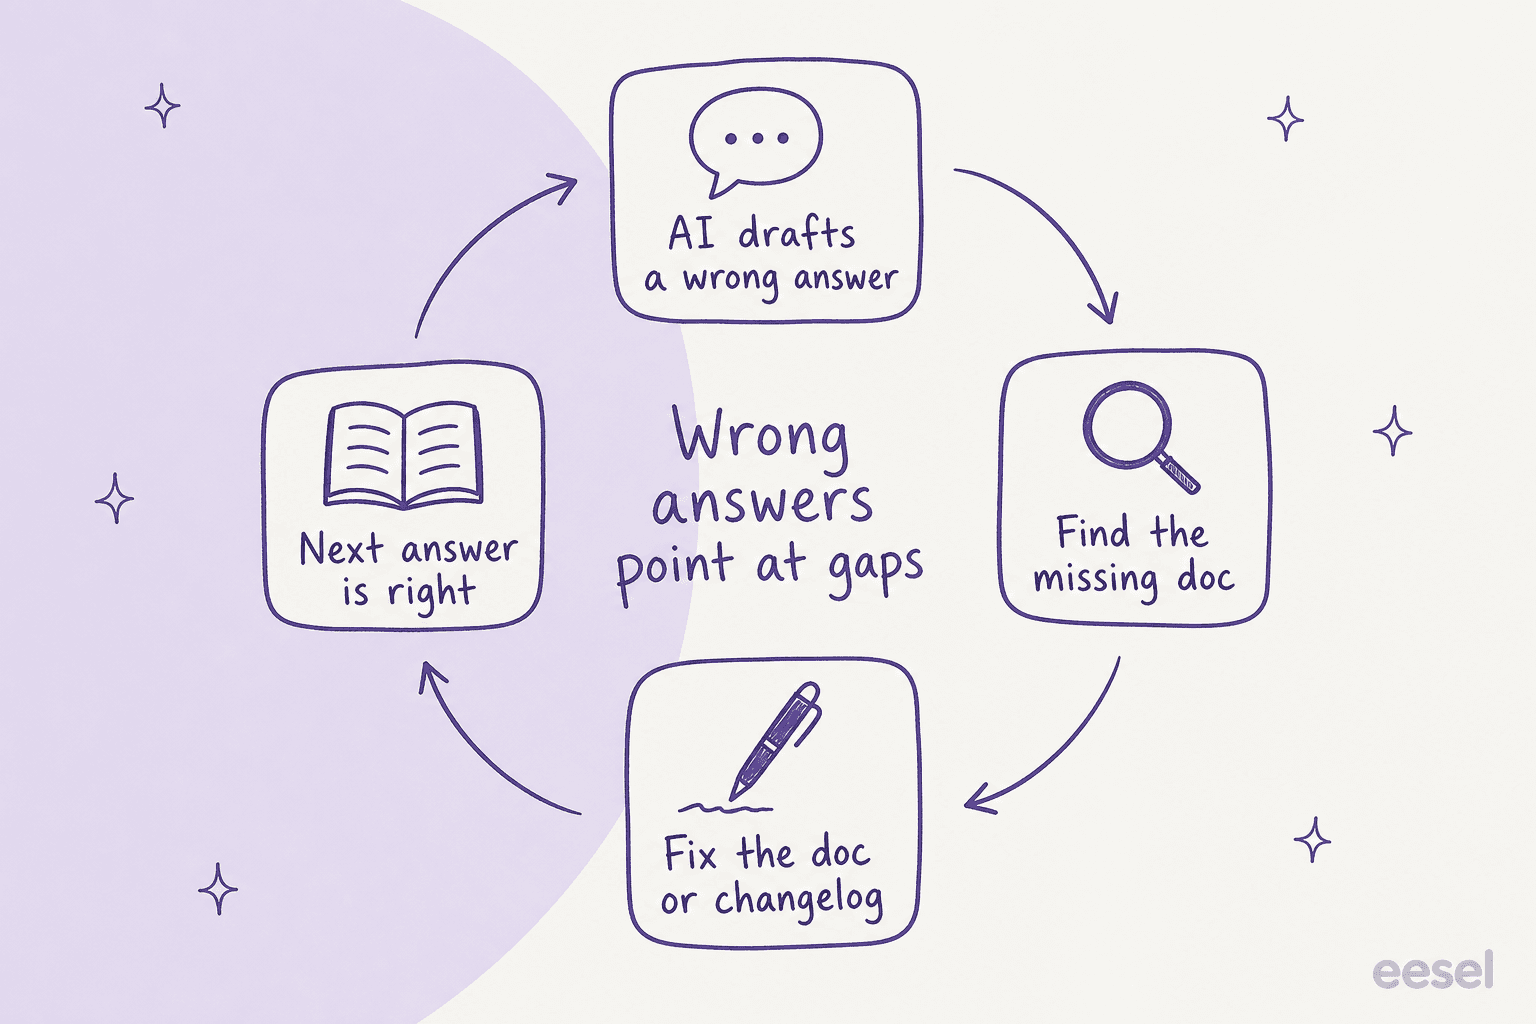
Qontro, que vende software ERP en la nube, montó su despliegue justo sobre esto. Cada ticket de Freshdesk recibe un borrador como nota interna, basado en el centro de ayuda y en unos 9.800 tickets y artículos anteriores. El equipo compara cada borrador con la respuesta que una persona envió realmente, y cuando el borrador estaba mal, suele señalar un artículo de ayuda que falta o una regla que hay que afinar. Según su historia, alrededor de uno de cada diez borradores sale ya con poca o ninguna edición, y la proporción sube. Los errores del sistema, la pérdida de datos y las integraciones a medida van directamente a una persona.
Para la mecánica de mantener las respuestas fundamentadas, mira mi artículo sobre prevenir las alucinaciones de la IA en soporte, la entrada del glosario sobre fundamentación de la IA y el análisis de lagunas de conocimiento en soporte para convertir las respuestas equivocadas en una lista de tareas.
¿Construirlo tú o comprar una herramienta?
La respuesta de ChatGPT a esta pregunta apuntaba directamente a la documentación de agentes de OpenAI y a una configuración casera: una capa de recuperación, llamadas a herramientas para consultar solicitudes, barreras de protección y un paso de escalada. Es una opción real si tienes ingenieros que se encarguen. Lo que omite es lo que señaló el fundador de kapa.ai: la calidad de la recuperación y las evaluaciones son trabajo continuo, no una tarea de lanzamiento. Y aun así tienes que conectarlo con tu helpdesk.
Así se comparan las opciones que revisé. Los precios proceden de la página de precios de cada proveedor, consultada el 30 de octubre de 2026.
| Opción | Qué es | Dónde responde la IA | Modelo de precios | Precio público |
|---|---|---|---|---|
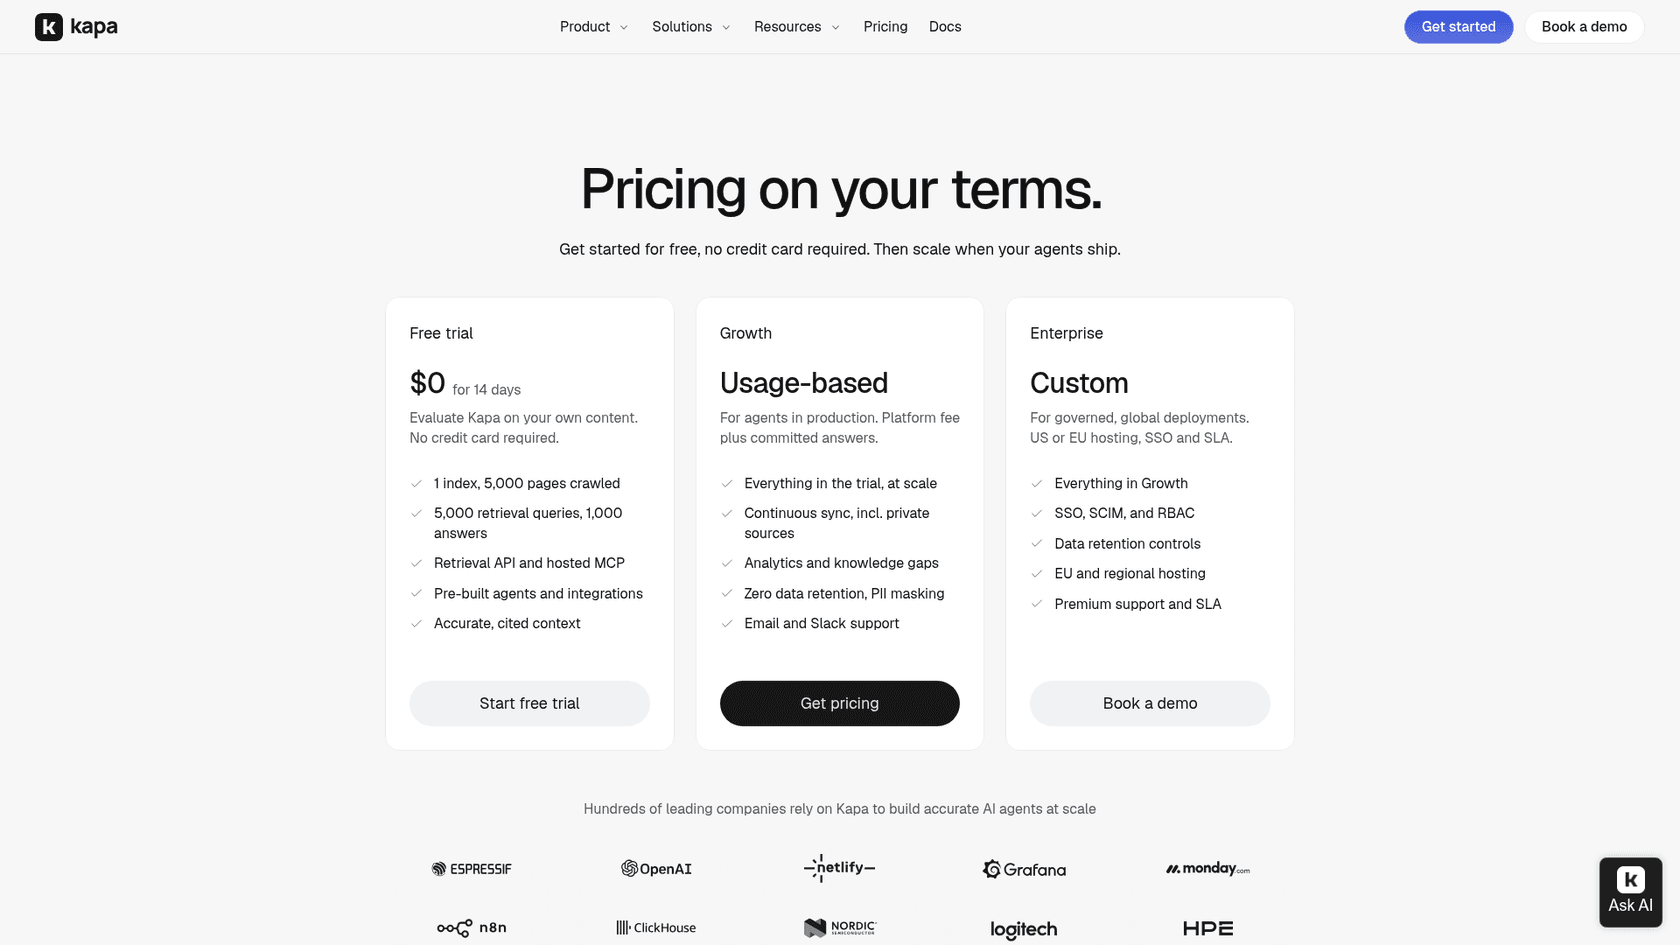
| kapa.ai | IA de documentación y API de recuperación | Sitio de documentación, dentro del producto, formulario de soporte, Slack, Discord, Zendesk | Tarifa de plataforma más respuestas comprometidas | Prueba gratuita de 14 días, luego Growth solo con presupuesto |
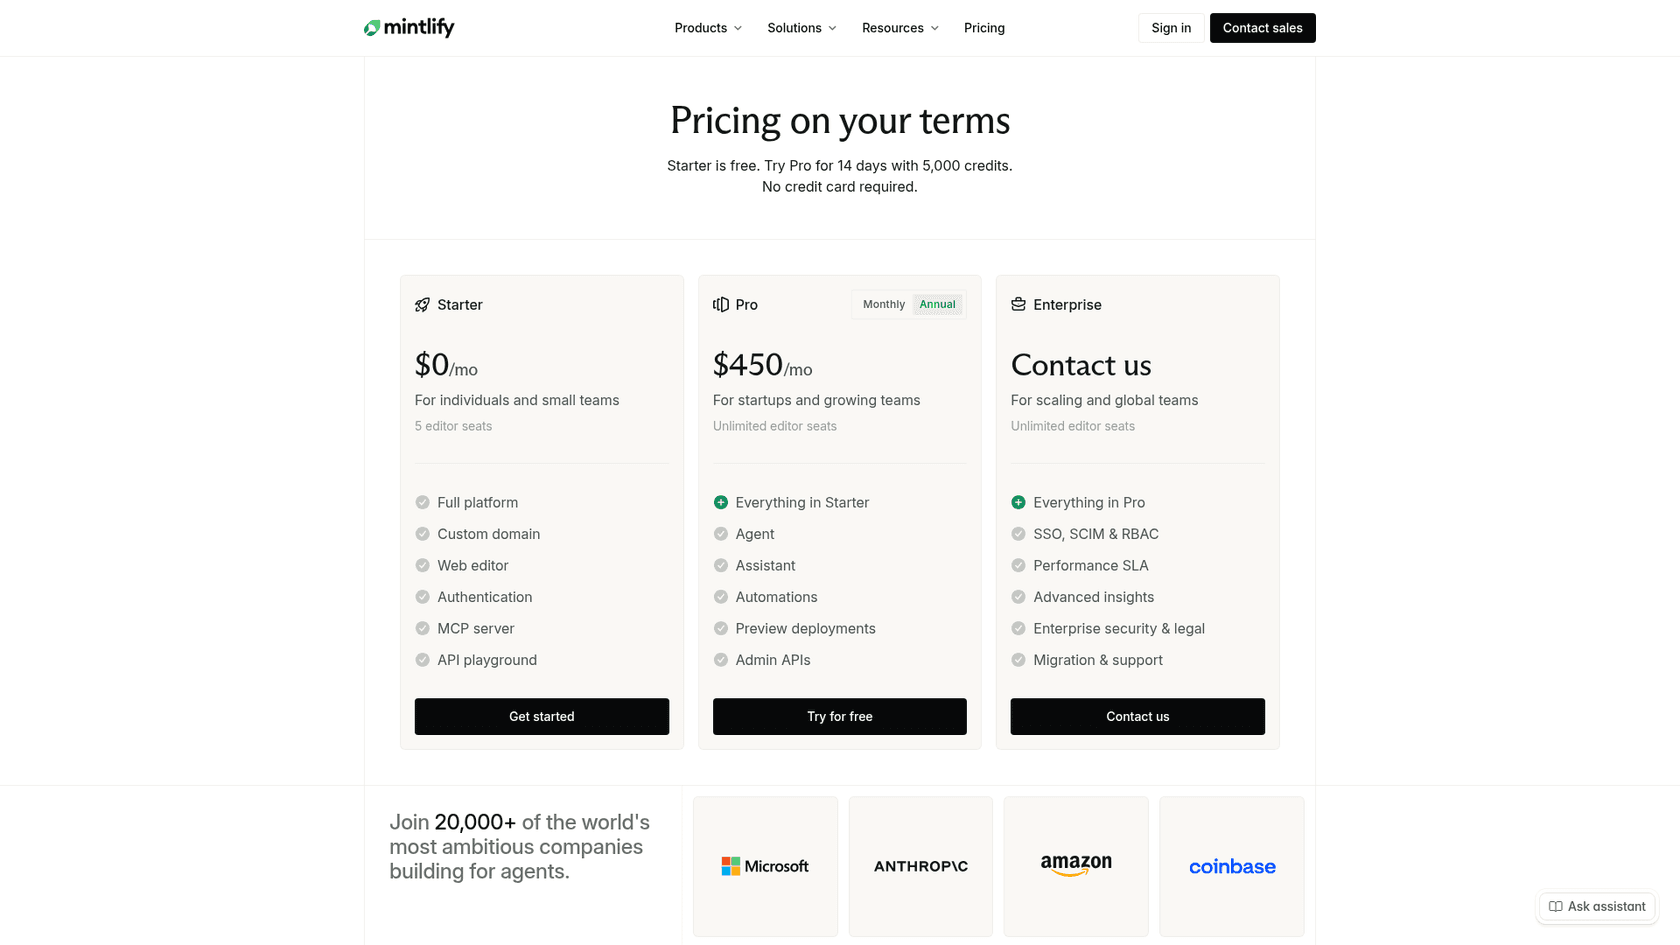
| Mintlify | Plataforma de documentación con asistente de IA | Tu sitio de documentación | Plan más créditos | Pro 450 $/mes con facturación anual (540 $ mensual), 10.000 créditos, 25 créditos por respuesta |
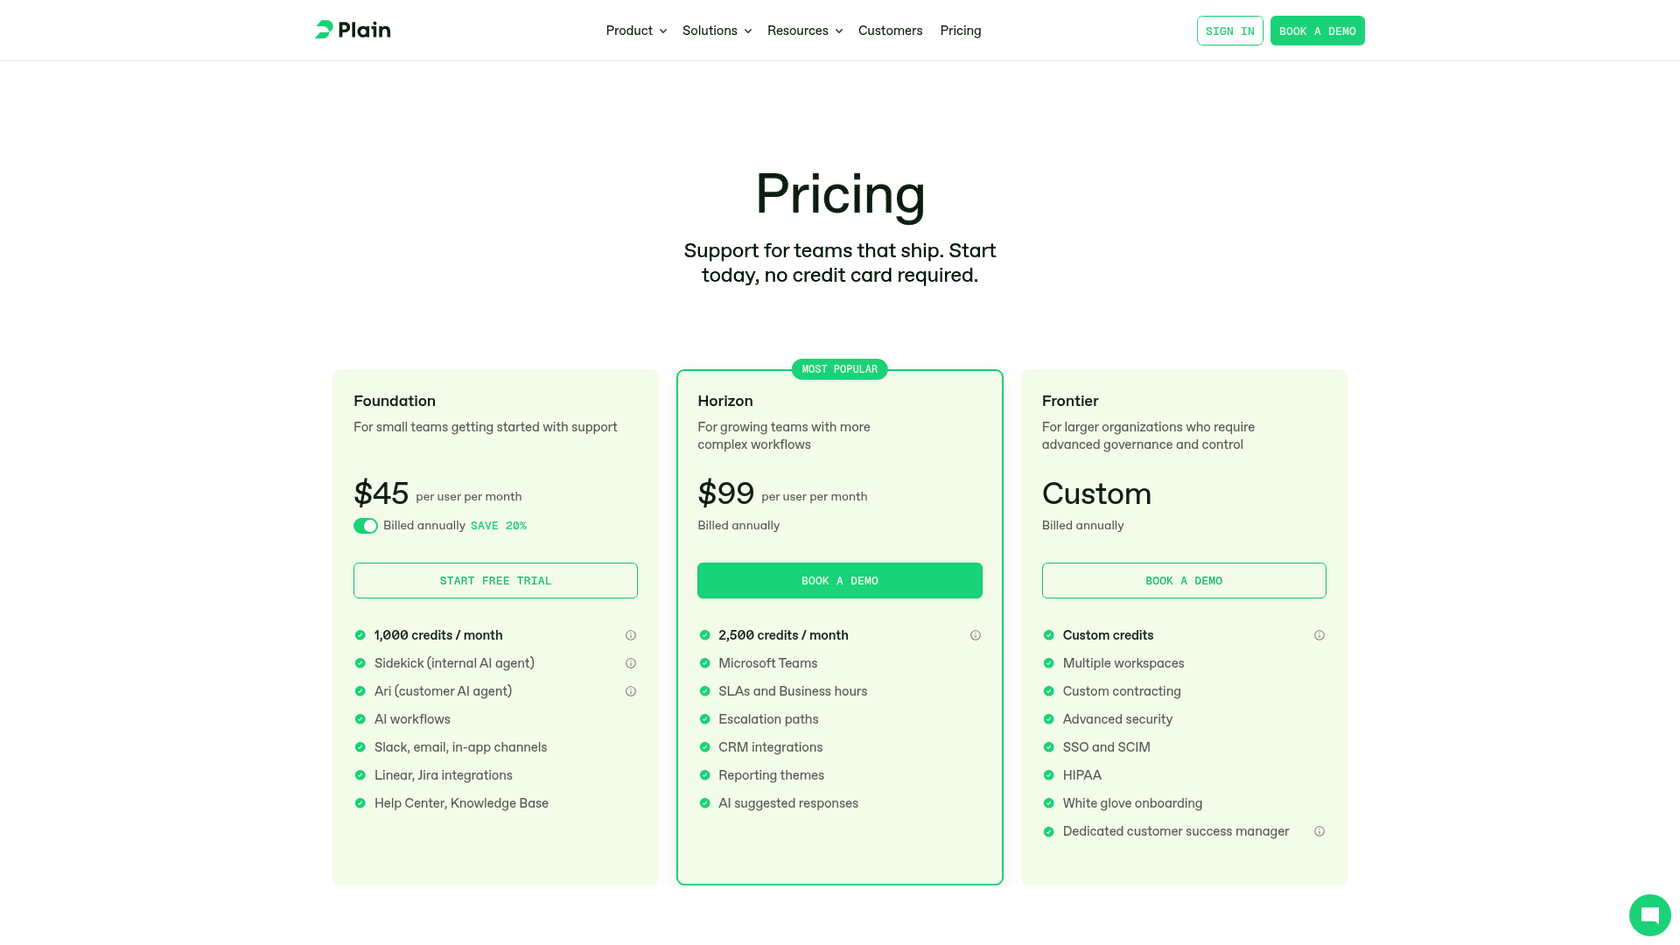
| Plain | Plataforma de soporte para equipos B2B técnicos | Slack, correo, en la app, chat | Por puesto más créditos | Foundation 45 $/usuario/mes anual (55 $ mensual), 100 créditos por resolución de IA, +1.000 créditos por 10 $ |
| Pylon | Plataforma de soporte B2B | Slack, Teams, correo, WhatsApp | Por puesto más créditos | Professional 89 $/puesto/mes anual, créditos a 0,30 $ cada uno de pago por uso |
| eesel | Compañero de IA dentro de tu helpdesk actual | Freshdesk, Zendesk, Jira Service Management, chat, Slack, correo | Créditos mensuales fijos | 299 $/mes por 500 créditos, 1 crédito por ticket o chat, puestos ilimitados |
| Construir sobre una API de modelo | Tu propio agente | Donde lo conectes | Tokens más tiempo de ingeniería | Depende de tu desarrollo |
¿Cuánto cuesta para un equipo?
Los precios por puesto, por respuesta y por resolución no se pueden comparar hasta calcularlos para un mismo comprador. Así que tomemos una empresa de API con 2.000 tickets de desarrolladores al mes, tres personas de soporte y la IA resolviendo por completo el 30 % de los tickets (600), el mismo 30 % que usa Pylon en su propio ejemplo.
| Opción | La cuenta | Coste mensual |
|---|---|---|
| eesel | Plan de 2.000 créditos, puestos ilimitados, cada ticket que trabaja cuenta | 849 $ |
| Plain (Foundation, anual) | 3 puestos x 45 $ = 135 $, más 600 resoluciones x 100 créditos = 60.000 créditos, menos 1.000 incluidos = 59.000 x 0,01 $ = 590 $ | Unos 725 $, antes de créditos de redacción de Sidekick para los otros 1.400 |
| Pylon (Professional, anual) | 3 puestos x 89 $ = 267 $, más la estimación media propia de Pylon para 2.000 tickets de 26.395 $ al año en créditos comprometidos | Unos 2.467 $ |
| Mintlify (Pro, anual) | 450 $ más 2.000 respuestas de documentación x 25 créditos = 50.000 créditos, menos 10.000 incluidos = 40.000 x 0,01 $ = 400 $ | Unos 850 $, solo para respuestas de documentación, no tickets |
| kapa.ai | No es público | Presupuesto |
Dos salvedades sobre esa tabla. Las unidades no son lo mismo: eesel cuenta cada ticket que trabaja, redactado o respondido, mientras que los 100 créditos de Plain son solo para resoluciones completas de la IA. Y el asistente de Mintlify vive en tu sitio de documentación, así que reduce los tickets antes de que se creen en lugar de trabajar los que llegan. Bien puedes querer ambos.
Mi opinión: si estás al principio y la mayoría de los tickets son preguntas de documentación, empieza con el asistente de documentación que ya ofrece tu plataforma. Si ya usas Freshdesk, Zendesk o Jira Service Management y el dolor está en la cola de tickets, pon la IA ahí en lugar de cambiar de helpdesk. Plain y Pylon tienen más sentido si de todos modos vas a elegir un helpdesk nuevo, sobre todo si tus desarrolladores viven en Slack. Hay resúmenes del campo más amplio en mejor IA para soporte SaaS y mejor chatbot para desarrolladores.
¿Cómo lo despliegas sin quemar la confianza de los desarrolladores?
Los desarrolladores perdonan un "no lo sé, se lo paso a un ingeniero". No perdonan una respuesta equivocada y segura de sí misma sobre su integración en producción. Así que despliega en este orden:
- Solo borradores, en cada ticket. La IA escribe un borrador o una nota interna, una persona envía. Así funciona Timengo: en un mes eesel preparó unos 300 tickets de Freshdesk, escribió unos 180 borradores de respuesta y unas 260 notas internas, y nunca envió una respuesta por su cuenta.
- Fundamentada o nada. Dile que nombre el documento o ticket que usó y que deje una nota pidiendo a una persona cuando nada respalde una respuesta. El agente de Orosoft hace exactamente eso.
- Compara los borradores con lo enviado. Arregla la documentación donde el borrador estaba mal, como hace Qontro.
- Añade las consultas. Conecta acceso de solo lectura a los registros de solicitudes y webhooks cuando las respuestas de documentación sean fiables.
- Deja que temas acotados vayan en automático. Límites de tasa, scopes, pasos de instalación del SDK. Mantén con una persona los bugs, los cambios de cuenta y todo lo que implique dinero.
Para los plazos, mi cronograma de implementación de soporte con IA tiene cifras realistas, y las pruebas de simulación de soporte con IA cubren cómo probar con tickets pasados antes de salir en vivo.
Vale la pena hacer una revisión de seguridad antes de dar a cualquier IA acceso a sistemas de producción. Cuándo pasar a una persona está en las buenas prácticas de traspaso a humanos.
¿Pueden los ingenieros configurarlo desde la terminal?
Para una empresa de API, esto importa. La CLI de eesel ejecuta desde una terminal el mismo agente que ves en el panel, y cada comando imprime JSON, así que un agente de programación como Claude Code, Cursor o Codex también puede manejarla. npx @eesel/cli init chat-bubble --site https://your-site.com configura una burbuja de chat sin cuenta, eesel files upload añade un documento, eesel chat "how do I verify a webhook signature?" prueba una respuesta y eesel approvals approve <id> libera una acción retenida. Para CI o un servidor, lee EESEL_API_URL y EESEL_API_TOKEN en lugar de un inicio de sesión en el navegador. eesel también funciona como servidor MCP para Claude Code y otros clientes MCP, lo que viene bien cuando tus ingenieros prefieren actualizar el conocimiento del agente desde la misma herramienta en la que escriben la documentación. El trasfondo de la idea está en mi artículo sobre servidores MCP para agentes de IA.
Prueba eesel para el soporte a desarrolladores
Si tus tickets de desarrolladores llegan a Freshdesk, Zendesk o Jira Service Management, eesel se une a esa cola como un nuevo ingeniero de soporte que ya leyó tu documentación, tu changelog y todos los tickets que has resuelto. Redacta las respuestas de documentación y configuración con la fuente enlazada, consulta registros de solicitudes y webhooks a través de tu propia API sin tener nunca la clave, y deja a ingeniería un informe de bug en lugar de una queja reenviada.
Timengo gestiona así su soporte técnico en danés, con un ingeniero enviando cada respuesta.
Los planes empiezan en 299 $ al mes por 500 tickets o chats, con puestos ilimitados, y hay una prueba gratuita con 100 créditos. Prueba eesel con los tickets del mes pasado y mira qué borradores habría enviado tu equipo.