

Por qué "resuelto" no significa "correcto"
Llevo dos años trabajando en búsqueda en eesel, y pocos temas de soporte tienen tanta intención de compra como este. Nadie busca "how to train AI on past tickets" por curiosidad. Lo busca porque tiene años de historial del helpdesk y acaba de darse cuenta de que es el registro más detallado de cómo trabaja su equipo. Entrenar con tickets anteriores es también la petición que aparece con más constancia en las propias llamadas comerciales de eesel.
Pero hay un problema. El estado de un ticket te dice que la conversación terminó. No te dice que el cliente recibiera la respuesta correcta, que la política citada siga vigente o que la respuesta sonara como el agente que querrías clonar. Muchos tickets "resueltos" los cerró una regla de cierre automático, se reabrieron una semana después o los respondió alguien en su primer mes.
La buena noticia es que el historial enseña justo aquello en lo que la IA suele ser peor de serie: sonar como tu equipo. En una prueba de eesel, una marca de joyería ecommerce con unos 1.000 tickets al mes en Zendesk y Shopify, los agentes enviaron tal cual solo el 12% de los borradores de la IA. Cuando el equipo miró el motivo, aproximadamente dos tercios de las reescrituras eran por longitud y tono, convirtiendo borradores largos en respuestas de una a tres frases, mientras que solo alrededor del 5% corregía un dato erróneo. Esa es exactamente la brecha que cierra un conjunto depurado de las respuestas enviadas por tu propio equipo.
Así que el trabajo no es "entrenar una IA con tickets anteriores". Es "enseñar a la IA con tus mejores tickets anteriores y dejar fuera el resto". Eso es lo que recorre esta guía, en seis pasos. Si todavía estás decidiendo qué datos necesitas en general, empieza por qué datos necesitas para entrenar una IA y vuelve.
Qué puede enseñar a una IA un solo ticket anterior
Antes de exportar nada, conviene ver que un ticket enseña varias cosas distintas y que cada lección pertenece a un lugar diferente.
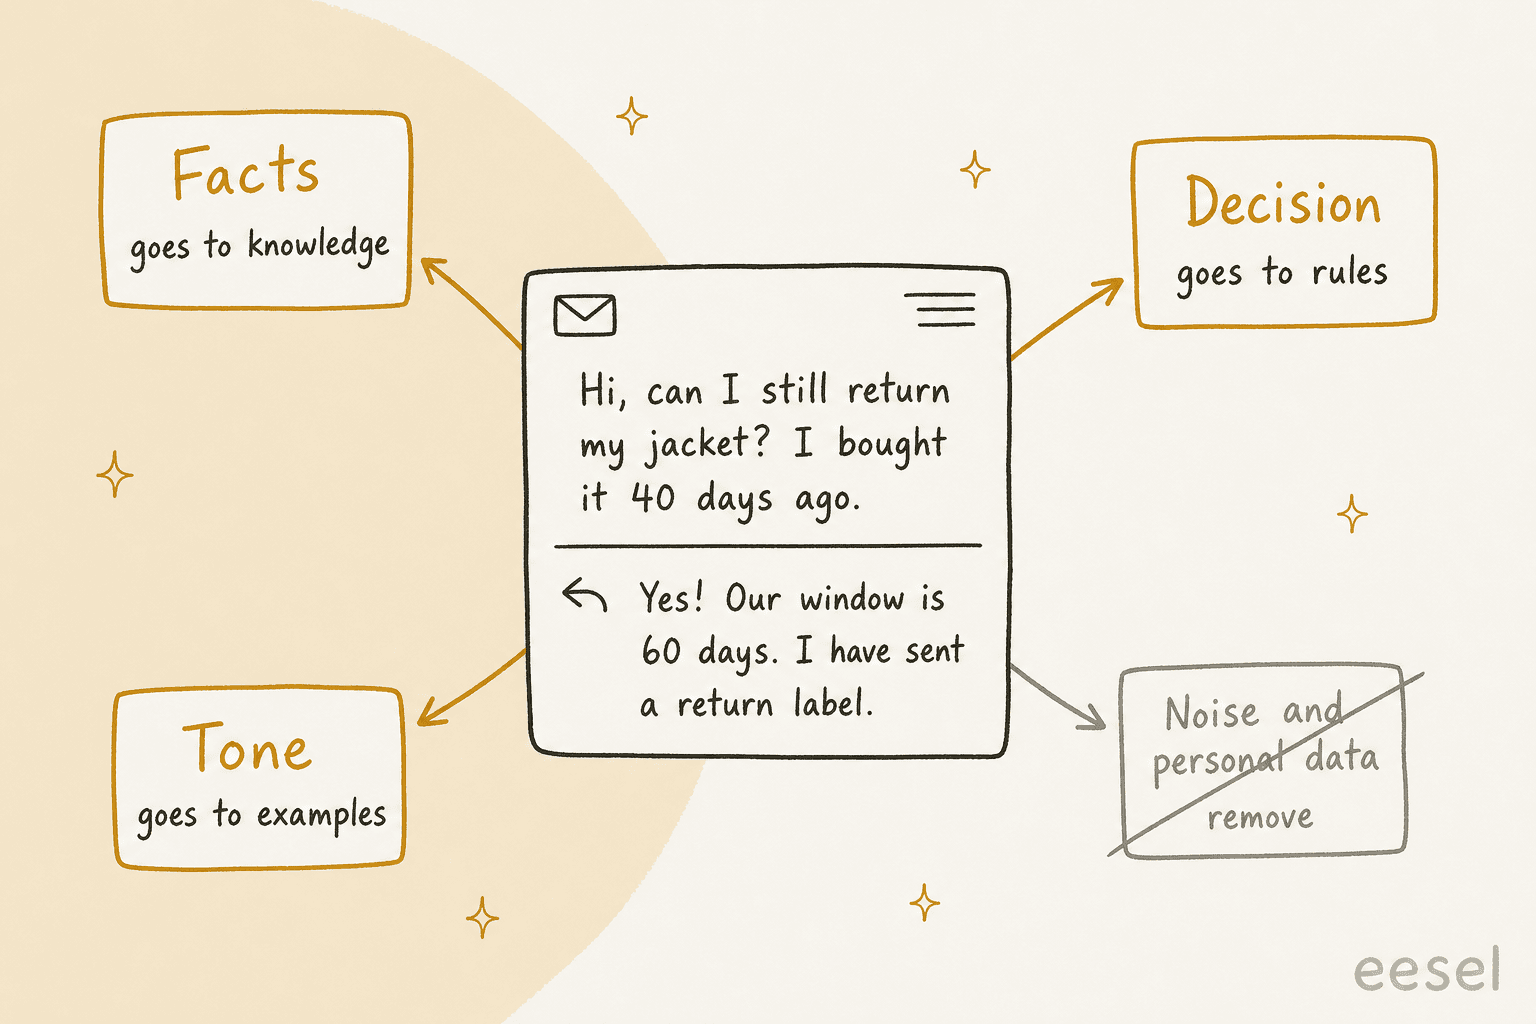
Toma una simple solicitud de devolución. La respuesta del agente contiene:
- Un hecho: el plazo de devolución es de 60 días. Eso va en tu base de conocimiento, donde se puede actualizar en un solo lugar cuando cambia la política.
- Una decisión: este cliente cumple los requisitos, así que se envía una etiqueta. Eso es una regla ("dentro de 60 días, sin usar, enviar etiqueta; fuera de ese plazo, derivar"), y las reglas son más seguras escritas que deducidas de cientos de ejemplos.
- Tono: breve, cálido, un signo de exclamación, sin disculpa. Eso lo enseñan las respuestas de ejemplo.
- Ruido: el nombre del cliente, la dirección, el número de pedido, la firma del agente y una nota interna. Nada de eso debería llegar a la IA.
Si vuelcas el ticket entero en una IA, aprende las cuatro cosas a la vez y no las distingue. Así acabas con un bot que cita un plazo de 30 días de 2023 con una voz perfectamente amable. Gorgias expone el riesgo con claridad: "if a help center article says your return window is 30 days but a guidance says 14, AI Agent might not respond the same way every time" (documentación de conocimiento de Gorgias). Los tickets antiguos son la mayor fuente de ese tipo de conflictos.
Las tres formas de usar tickets anteriores
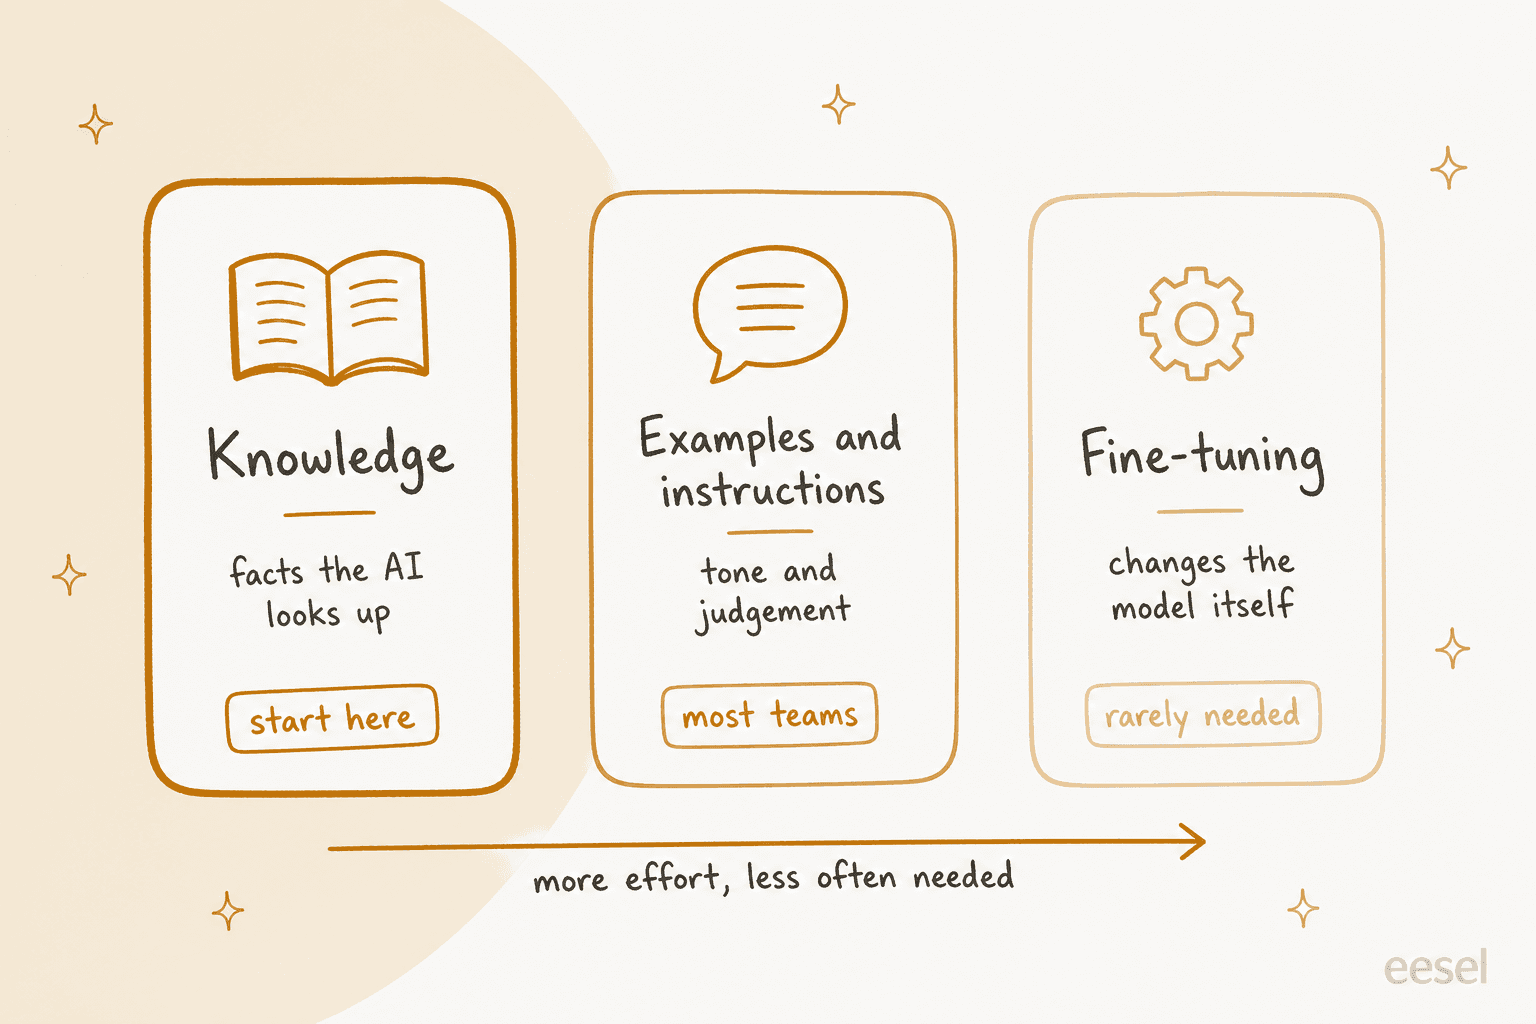
Hay tres formas de convertir el historial de tickets en comportamiento de IA, y no son igual de útiles.
| Método | Qué enseña | Cómo funciona | Esfuerzo | Cuándo es la opción correcta |
|---|---|---|---|---|
| Extracción de conocimiento y recuperación | Hechos, pasos, políticas | Extraer respuestas de los tickets, convertirlas en artículos o preguntas y respuestas, y dejar que la IA las consulte al responder (RAG) | Bajo a medio | Siempre. De aquí sale la precisión |
| Ejemplos e instrucciones | Tono, longitud, criterio | Elegir unas pocas decenas de tus mejores respuestas como ejemplos, escribir las decisiones como reglas | Bajo | Casi siempre. De aquí sale el "suena como nosotros" |
| Fine-tuning | Formato y estilo a gran escala | Entrenar los pesos de un modelo con miles de conversaciones de ejemplo | Alto | Rara vez: volumen muy alto, una tarea acotada y evaluaciones que demuestren que el prompting no basta |
La recuperación es donde vive la precisión. La IA busca en tu centro de ayuda, tus macros y las respuestas depuradas de los tickets cuando llega una pregunta, y responde con lo que encuentra. Cuando cambia una política, editas un artículo y la siguiente respuesta es correcta. Si quieres la versión extensa de este argumento, mira RAG frente a fine-tuning.
Los ejemplos y las instrucciones son donde vive el tono. El propio consejo de Freshdesk para su agente de correo es "Include examples of ideal responses in your instructions. The agent learns from concrete examples faster than it does from abstract rules" (configuración del agente de IA de correo de Freshdesk). No necesitas 10.000 tickets para esto. Necesitas de 20 a 50 respuestas de las que tus mejores agentes se sentirían orgullosos.
El fine-tuning es lo que todos preguntan y casi nadie necesita. La documentación de OpenAI recomienda el fine-tuning supervisado sobre todo para clasificación, traducción, formatos de salida fijos y "correcting instruction-following failures" (fine-tuning supervisado de OpenAI). Aprender tu política de reembolsos actual no figura en esa lista, porque los hechos grabados en los pesos del modelo quedan obsoletos el día que cambia la política. La documentación también dice "The prompt engineering process may be all you need" (optimización de modelos de OpenAI).
Un desarrollador en Reddit lo probó de todos modos, y el resultado es la imagen más clara que he encontrado de lo que hace en realidad el fine-tuning con tickets en bruto:
"So I pulled about 8k past tickets which were mostly about shipping, returns, account issues and product information and anonymized the sensitive data then set up a training run. The good news was that it picked up the brand tone and mirrored our macros, but it also prioritized weird quirks too often. Our old agent would write 'hey there' for nearly every tricket so this model started spraying it everywhere."

Acabaron volviendo a un prompt de sistema estricto y una capa ligera de recuperación. El modelo aprendió el tono y también la manía de un agente, porque un fine-tune no distingue una rareza de una política.
Y ahora hay una razón práctica para saltárselo. OpenAI está retirando el fine-tuning de autoservicio: las organizaciones que no habían hecho fine-tuning antes perdieron el acceso el 7 de mayo de 2026, y los clientes activos no pueden crear nuevos trabajos después del 6 de enero de 2027 (obsolescencias de OpenAI). Si ya eres usuario, entrenar un modelo gpt-4.1-mini cuesta $5.00 por millón de tokens de entrenamiento, y el modelo ajustado funciona luego a $0.80 de entrada y $3.20 de salida por millón de tokens, el doble de la tarifa del modelo base (precios de OpenAI). Para más sobre ese camino, consulta la guía de la API de fine-tuning de OpenAI.
¿No sabes cuál necesita tu problema? Elige el síntoma que ves.
Elige el síntoma que ves para saber qué parte de tu historial de tickets lo arregla.
Qué hace ya tu helpdesk con los tickets anteriores
Antes de construir nada, comprueba qué hace tu helpdesk por su cuenta, porque la respuesta varía más de lo que sugiere el marketing. Repasé el centro de ayuda de cada proveedor para que no tengas que hacerlo tú.
| Helpdesk | ¿Aprende de tickets anteriores? | Cómo | Ventana de consulta | Precio de la IA (página del proveedor) |
|---|---|---|---|---|
| Zendesk | En parte | Auto assist usa tickets resueltos similares solo cuando no encaja ningún procedimiento ni artículo; los procedimientos y borradores del centro de ayuda se generan a partir de tickets resueltos para que los publiques | 90 días para los borradores generados | Copilot $50/agente/mes anual; agente de IA $1.50 por resolución automatizada comprometida, $2.00 pago por uso |
| Freshdesk | Para probar, no para responder | Los tickets anteriores no figuran como fuente de conocimiento; los tickets resueltos se pueden importar como conjunto de prueba | 30 días por API por defecto | Freddy AI Agent: primeras 500 sesiones incluidas, luego $49 por cada 100 sesiones |
| Gorgias | De forma indirecta | "Opportunities" (beta) sugiere lagunas de conocimiento y conflictos a partir de conversaciones que la IA no pudo resolver; apruebas cada una | Los informes usan 28 días | $0.85 a $1.00 por interacción automatizada |
| HubSpot | Sí | Genera pares de preguntas y respuestas a partir de tickets resueltos o conversaciones de la bandeja; aceptas, omites o rechazas cada uno | 90 días o un segmento de tickets | 50 créditos por resolución, $0.50 a tarifas de pago por uso |
Algunos detalles destacaron.
Zendesk trata los tickets como último recurso. Auto assist sugiere respuestas "based on procedures, help center articles, similar solved tickets", y el orden importa: "If there are no relevant procedures or help center articles available, then similar solved tickets are used" (Acerca de auto assist). Solo cuentan los tickets de la misma marca. Zendesk también redactará hasta tres procedimientos por marca cada semana a partir de "Relevant solved tickets from the last 90 days", pero cada uno espera a que un administrador lo publique (procedimientos generados por IA). Los precios están en la página de precios de Zendesk.
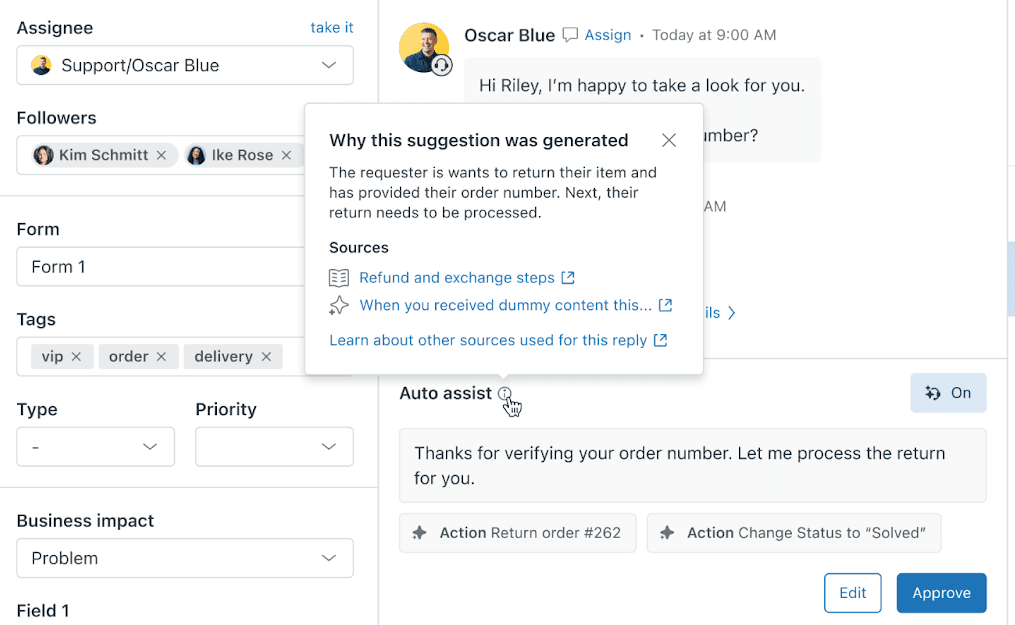
El Knowledge builder de Zendesk también merece conocerse si aún no tienes centro de ayuda. Lee los últimos 90 días de tickets y propone hasta 40 artículos. Sus reglas sobre tickets son un buen modelo para tu propio filtro: solo Resueltos o Cerrados, solo comentarios públicos no vacíos, y sin notas internas, spam ni problemas puntuales. El propio Zendesk dice que "will likely not be helpful" para un centro de ayuda bien mantenido.
Freshdesk mantiene los tickets fuera del camino de la respuesta. Enumera las fuentes del agente de IA como "URLs, files, solution articles, custom Q&As, and external apps" (documentación de conocimiento de Freshdesk). El historial aparece en las pruebas: puedes importar tickets históricos resueltos a una ejecución de evaluación. Más sobre eso en el paso 5. Los precios están en la página de precios de Freshdesk.
HubSpot es el más directo. Va a "generate knowledge sources from your resolved tickets, inbox conversations, or uploaded files", agrupados por temas como pares de estilo FAQ para que los revises (generador de conocimiento de HubSpot). Está en los planes Professional y Enterprise.
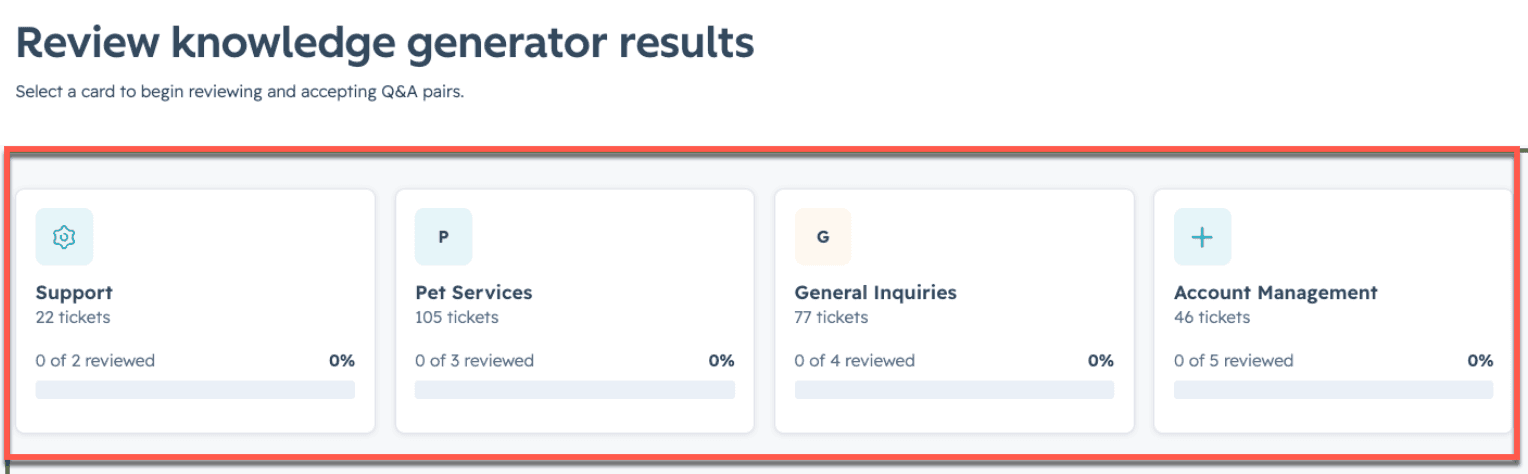
Fíjate en el patrón: todo proveedor que aprende de tickets pone un paso de aprobación humana en medio. Es el proveedor diciéndote, con educación, que el historial de tickets en bruto no es seguro para aprender sin revisión.
Paso 1: exporta los tickets, con la conversación adjunta
La primera sorpresa para la mayoría de los equipos: la exportación estándar de tickets normalmente no incluye la conversación. Obtienes el asunto, el estado y los campos, pero no el intercambio de mensajes del que realmente quieres aprender.
- Zendesk: la exportación incremental recomendada es el endpoint
GET /api/v2/incremental/tickets/cursor.json, hasta 1.000 tickets por página y 10 solicitudes por minuto (30 con el complemento High Volume), solo para administradores. Los comentarios no vienen incluidos. Extráelos del flujo de eventos de tickets coninclude=comment_events, o por ticket desde el endpoint de comentarios, dondepublic: falsemarca una nota interna. La guía de exportación incremental de Zendesk tiene el recorrido completo. - Freshdesk: la exportación desde la interfaz "will NOT give you the entire conversation from the ticket or historical data" (documentación de exportación de Freshdesk). Usa una exportación de la cuenta o la API, que solo devuelve los últimos 30 días a menos que pases
updated_since, y como máximo 30.000 tickets por llamada de lista (API de Freshdesk). - Gorgias: la exportación de vistas admite hasta 1 millón de tickets, pero no incluye el texto de los mensajes. "Export with message content" desde un detalle de analítica cubre solo los 30 días más recientes, hasta 100.000 tickets, solo mensajes públicos (documentación de exportación de Gorgias).
Exporta solo mensajes públicos. Las notas internas son donde los agentes escriben "el cliente miente, reembolsa igualmente para quitárnoslo de encima", y no quieres que la IA aprenda de eso. Las propias herramientas de Zendesk descartan las notas internas por la misma razón.
Paso 2: filtra los tickets que enseñarían lo equivocado
Este es el paso que decide el proyecto. No intentas conservar tantos tickets como puedas. Intentas conservar los que le enseñarías con gusto a un nuevo empleado como "así lo hacemos".
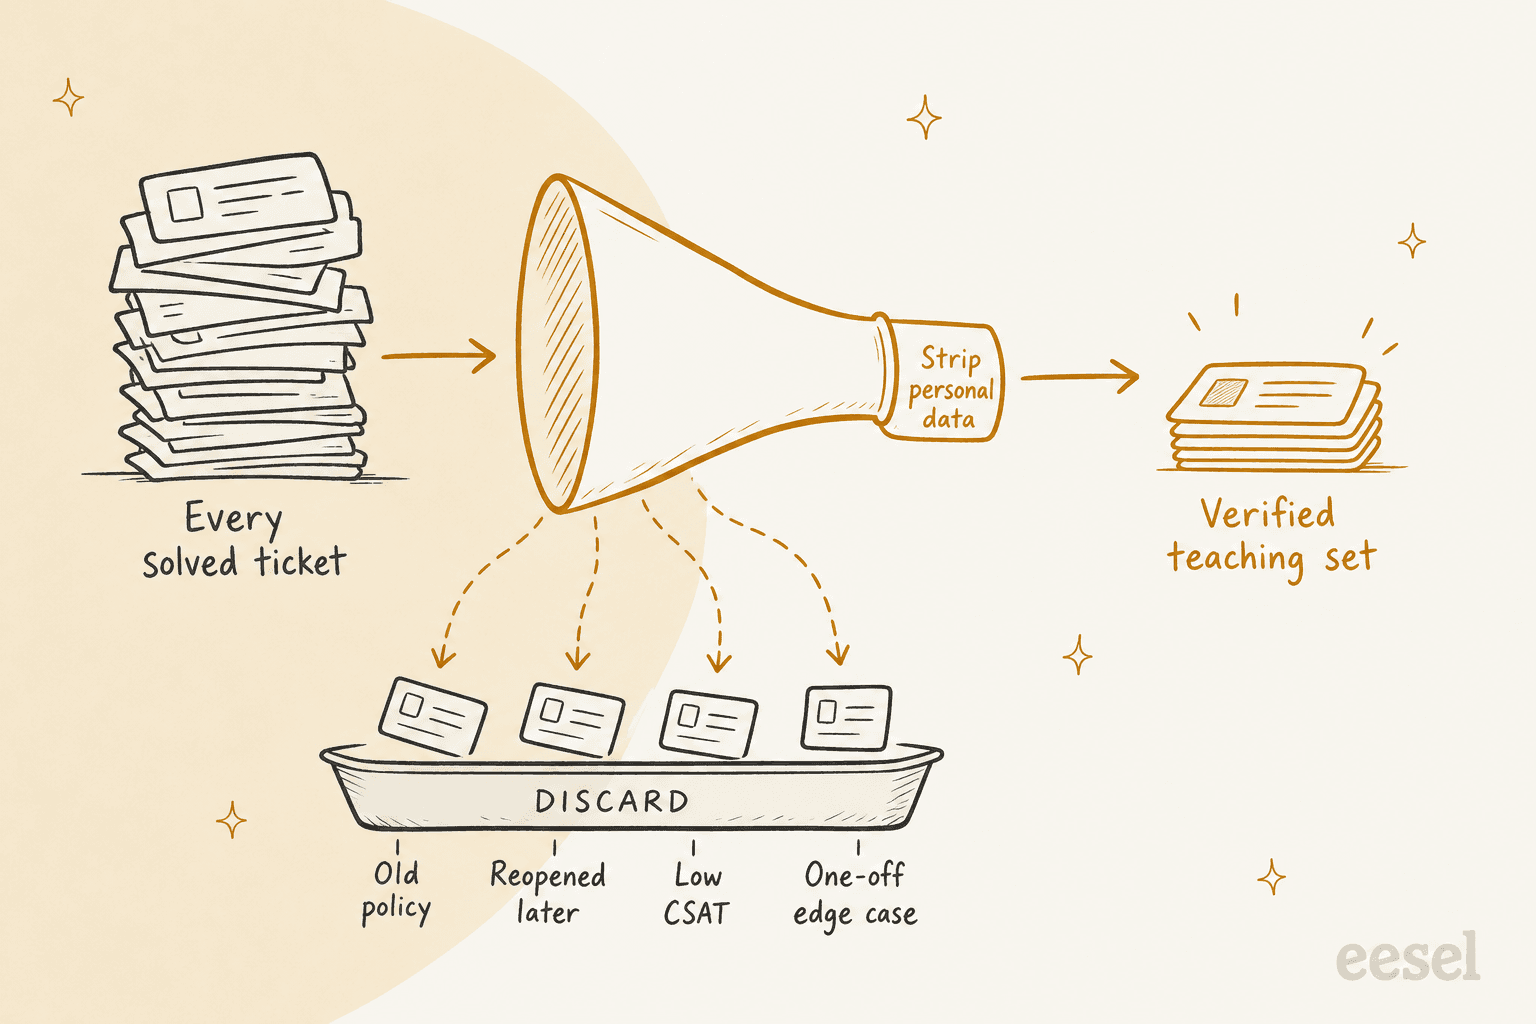
Descarta estos:
- Tickets anteriores a tu último cambio de política. Si tu política de devoluciones cambió en marzo, todo lo anterior a marzo enseña la regla antigua. En caso de duda, empieza por los últimos tres a seis meses. Zendesk y HubSpot usan ambos 90 días por defecto en sus propias funciones de aprendizaje con tickets.
- Tickets que se reabrieron, se escalaron tras el "resuelto" o a los que siguió un segundo ticket sobre el mismo problema. La primera respuesta no funcionó.
- Tickets con mala puntuación de CSAT o una revisión de QA fallida. Si haces QA de soporte, los tickets aprobados por QA son tu conjunto de oro.
- Tickets cerrados automáticamente sin respuesta de un agente, spam y seguimientos de "¡gracias!".
- Casos aislados. El trato a medida que tu responsable de soporte hizo una vez a un VIP no debería convertirse en la respuesta por defecto.
- Picos estacionales, si distorsionaran la mezcla. Una marca de entrega de flores en una llamada comercial de eesel pidió 300 tickets aleatorios al mes durante 10 meses, sin los picos de San Valentín y del Día de la Madre, para que un pico de febrero no ahogara a los otros 10 meses.
La guía de OpenAI sobre datos de entrenamiento dice lo mismo desde el otro lado: "a smaller amount of high-quality data is generally more effective than a larger amount of low-quality data" (buenas prácticas de fine-tuning de OpenAI). También advierte de que el desequilibrio enseña hábitos. Si el 60% de las respuestas de ejemplo dicen "I cannot answer this" pero solo el 5% debería, "you will likely get an overabundance of refusals." Tu historial de tickets tiene su propia versión de ese sesgo, normalmente hacia el mes de más trabajo.
Un administrador de Zendesk en Reddit expuso bien el problema del historial en bruto, y es la razón de que exista este paso:
"I am not entirely sure this approach would be bullet-proof (especially for businesses that have struggled to offer consistent customer support across agents - yes, I've worked for one!). Also, training on tickets is only half the battle, it's integrating all the other "knowledge" sources that makes a difference."
Paso 3: elimina los datos personales antes de indexar nada
Los tickets de soporte están llenos de nombres, correos, direcciones, números de pedido y, a veces, números de tarjeta y contraseñas que los clientes pegan cuando están frustrados. Si eso entra en el conocimiento de una IA, el riesgo no es solo de cumplimiento. Es que la IA repita los datos de un cliente en la respuesta a otro.
Los proveedores son explícitos en esto. La documentación de HubSpot advierte de que las fuentes de conocimiento privadas "will not be cited, but their content may still appear in responses", así que "do not include personal, confidential, sensitive information, or private customer data" (fuentes de conocimiento de HubSpot). El complemento Advanced Data Privacy and Protection de Zendesk marca nombres, correos, direcciones, números de tarjeta, números de la seguridad social, direcciones IP y teléfonos en los comentarios, con una advertencia que merece leerse dos veces: "Ticket redaction cannot be reversed" (redacción de Zendesk).
La parte legal es fácil de enunciar, como hizo un comentarista de Hacker News:
"A support ticket or live chat with a customer is customer data. With things like GDPR you need to know exactly where customer data is stored and for how long."

Así que no redactes los tickets de tu helpdesk para preparar un conjunto de entrenamiento. Redacta la copia con la que entrenas. Algunas reglas que yo seguiría:
- Enmascara, no borres. Sustituye un correo por
[EMAIL]en lugar de quitarlo, para que el ejemplo se lea con naturalidad y la IA aprenda a "pedir el correo del pedido" sin aprender el correo real de nadie. - Deja los ID de pedido fuera de los ejemplos salvo que enseñes el formato. La IA debería consultar los pedidos en vivo, no recordarlos.
- Falla en cerrado. Si un ticket no se puede limpiar, omítelo. Un conjunto más pequeño es mejor que una fuga.
- Revisa el interruptor. Los ajustes de redacción suelen estar desactivados por defecto. En eesel, por ejemplo, la redacción de tickets anteriores está desactivada en los espacios de trabajo creados hace poco, y la documentación dice "Check the toggle rather than assuming it's on" (redacción de PII de eesel).
Para más sobre la mecánica, consulta redactar PII en transcripciones de soporte y el análisis de la privacidad de datos de la IA de Zendesk.
Paso 4: divide cada ticket en hechos, decisiones y tono
Ahora toma tu conjunto limpio y lleva cada lección a su lugar.
Los hechos se convierten en conocimiento. Cuando la misma pregunta recibe la misma respuesta correcta en 15 tickets y no hay artículo de ayuda para ella, eso es un artículo que falta, no un ejemplo de entrenamiento. Escríbelo una vez, en tu centro de ayuda o en un documento interno, y deja que la IA lo recupere. Esta parte también hace más rápido a tu equipo humano, porque las respuestas que vivían en la cabeza de una persona acaban escritas. Un análisis de lagunas de conocimiento es la versión sistemática de este paso.
Las decisiones se convierten en reglas. Un reembolso por encima de un límite, una reclamación de garantía, una amenaza legal, un VIP enfadado: son decisiones de criterio, y una IA que las aprendió de ejemplos será incoherente, porque tus agentes también lo fueron. La documentación de OpenAI le pone cifra al motivo: si las personas solo coinciden en el 70% de los casos, "the model would likely not be able to do better than this" (buenas prácticas de fine-tuning de OpenAI). Escribe la regla, incluida la ruta de escalado, y pruébala. El diseño de Zendesk también lo refleja: auto assist sugiere acciones solo "if they're defined in your procedures", nunca a partir de tickets similares.
El tono se convierte en ejemplos. Elige de 20 a 50 respuestas de tus mejores agentes sobre tus temas principales: una respuesta breve de "dónde está mi pedido", una respuesta de facturación cuidadosa, un no amable. Etiqueta cada una con lo que la hace buena ("dos frases, sin disculpa, enlace al seguimiento"). Eso basta para cambiar longitud y voz, que es donde se va la mayor parte del tiempo de edición. Las guías sobre la voz de marca de la IA y el tono de soporte explican cómo escribir las reglas que acompañan a los ejemplos.
OroSoft, que fabrica software para la industria de metales preciosos, muestra cómo se ve esto en la práctica. Su agente de eesel en Freshdesk aprende de unos 6,100 tickets anteriores, resincronizados cada noche, pero tiene la instrucción de preferir los tickets resueltos y cerrados, dar más peso a los recientes y tratar el centro de ayuda como fuente de verdad para las políticas, siguiendo la fuente más reciente cuando las dos discrepan. Cuando encaja un ticket anterior, el borrador copia su estructura, tono y longitud, de modo que una respuesta corta que funcionó antes sigue siendo corta. Y nunca copia nombres ni datos de clientes de tickets antiguos.
Extraer conocimiento de los tickets tampoco tiene que ser sofisticado. Un comentarista de Hacker News describió así cómo apuntó un modelo a su historial:
"read this historical dump of 15k support tickets and break them into categories that make sense, then propose help docs that i could write to handle the most frequent queries in each category"
Ese es el instinto correcto: el resultado son documentos de ayuda que una persona escribe y aprueba, no un modelo que memorizó 15.000 tickets.
Paso 5: reserva tickets recientes y reprodúcelos
Este es el error de pruebas que veo con más frecuencia: los equipos prueban la IA con los mismos tickets de los que aprendió, sacan una gran puntuación y lanzan. Claro que le fue bien. Había visto las respuestas.
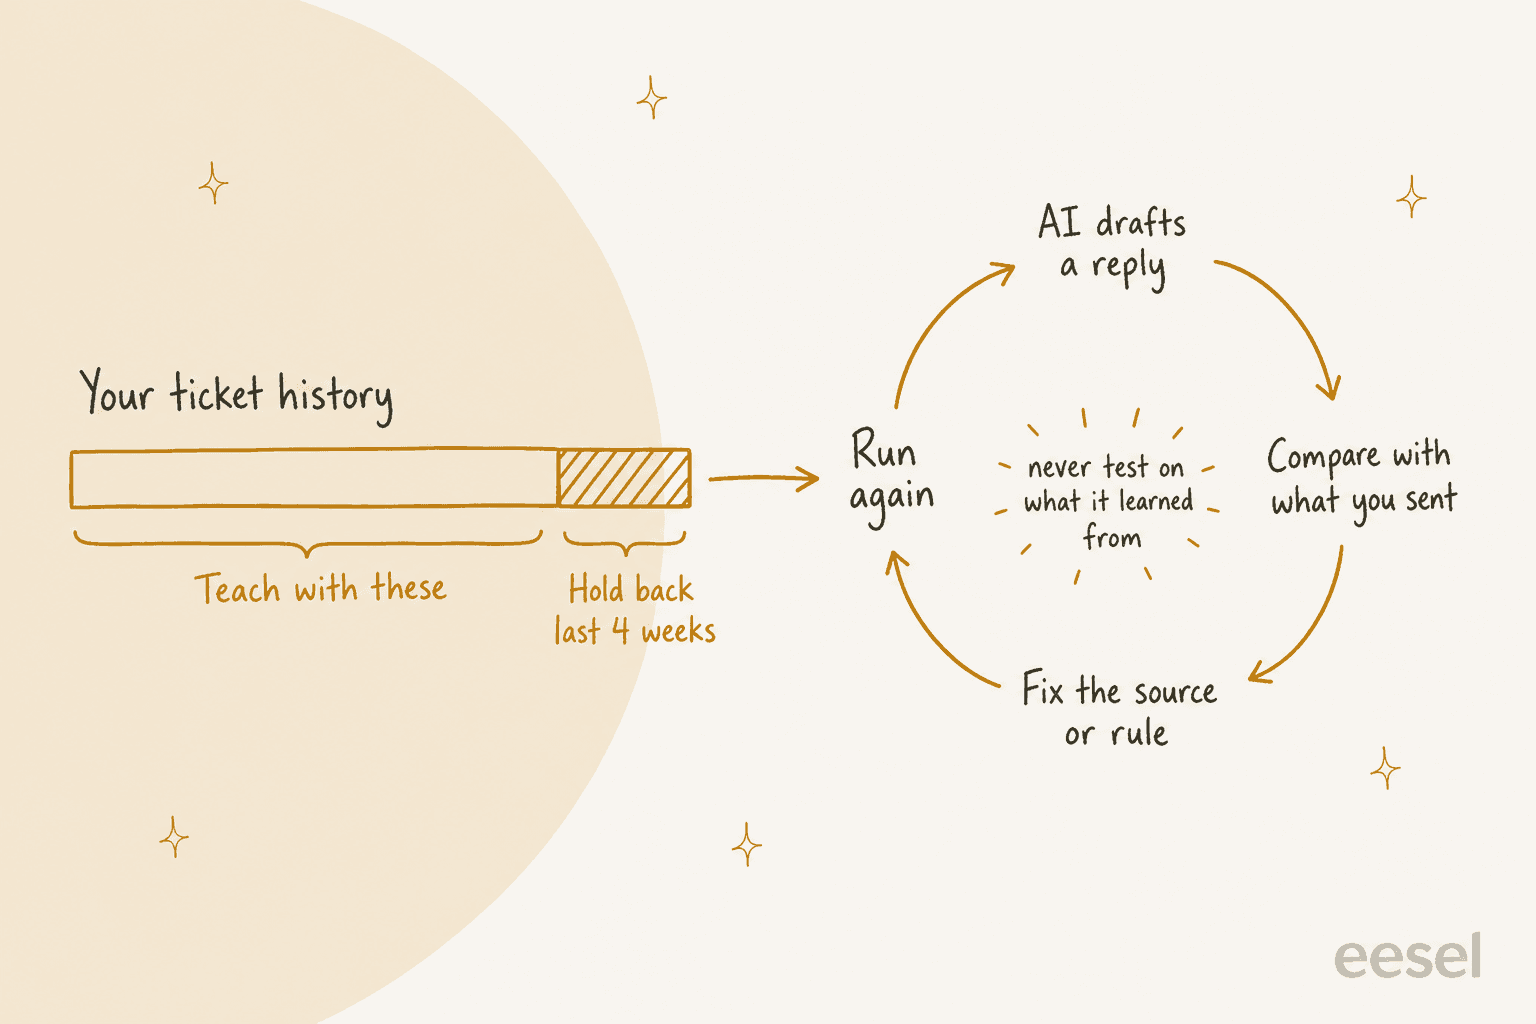
La documentación de OpenAI lo dice sin rodeos: "Good evals first!", y recomienda un conjunto reservado que "acts as a control group" (fine-tuning supervisado de OpenAI). Lo mismo vale cuando ni siquiera haces fine-tuning. Una versión sencilla:
- Reserva tus tres o cuatro semanas más recientes de tickets resueltos fuera de la importación. Son los más representativos de las preguntas de hoy y la IA no los ha visto.
- Reproduce de 50 a 100 de ellos. Haz que la IA redacte una respuesta a cada mensaje de cliente sin enviar nada.
- Compara cada borrador con lo que tu equipo envió realmente, y puntúa por separado la precisión y el tono. Un borrador puede ser correcto en los hechos y aun así necesitar una reescritura completa.
- Rastrea cada fallo hasta una causa: un artículo que falta (arregla el conocimiento), una decisión equivocada (arregla la regla) o la voz equivocada (arregla los ejemplos). Luego ejecútalo de nuevo.
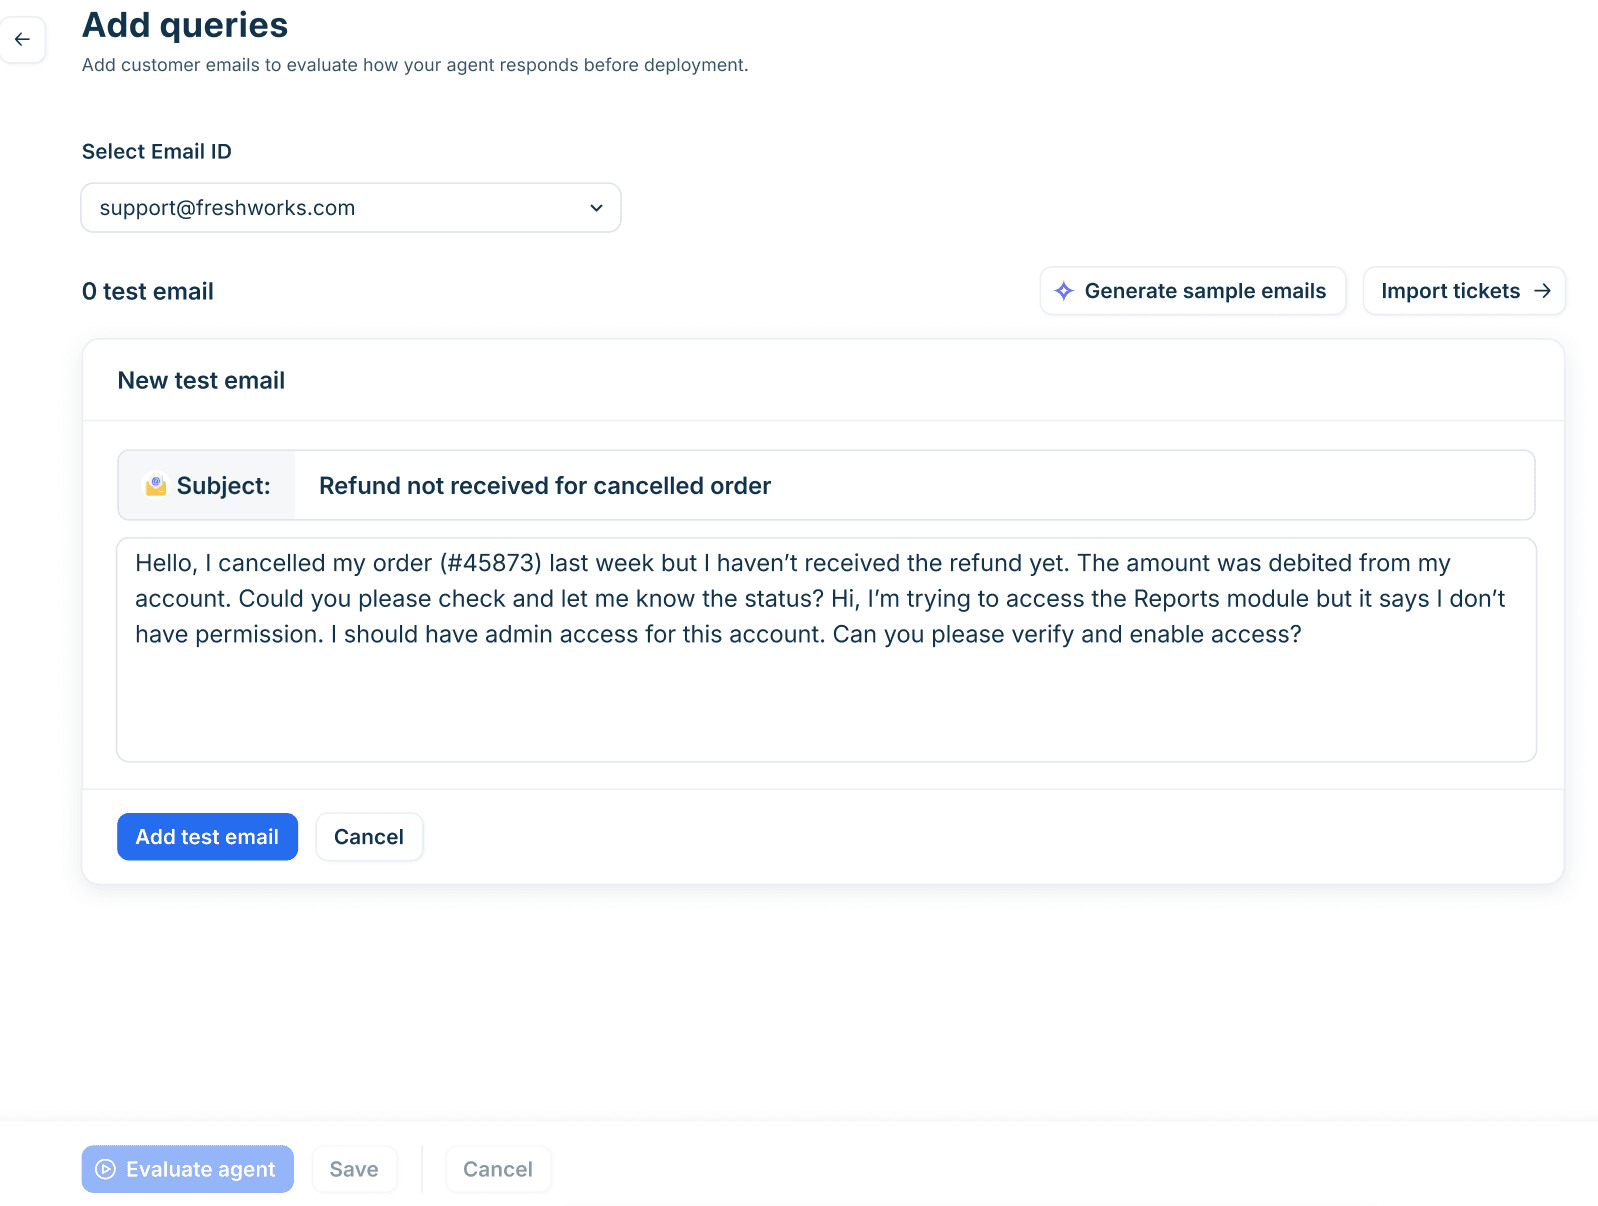
La mayoría de los helpdesks te da una herramienta para la reproducción. El agente de correo de Freshdesk te permite "Import tickets to use solved historical tickets" como conjunto de prueba, hasta 50 consultas por ejecución, y recomienda al menos 20 consultas representativas antes de desplegar (configuración del agente de IA de correo de Freshdesk). Las pruebas por lotes de HubSpot no consumen créditos. La habilidad Simulation de eesel redacta una respuesta a 20 tickets que tu equipo resolvió hace poco, compara cada una con lo que envió tu equipo y agrupa los resultados por tema con correcciones, sin enviar nada a los clientes.
La empresa de ERP en la nube Qontro convirtió esta comparación en un hábito en lugar de una puerta de lanzamiento. Su agente de eesel redacta en cada ticket nuevo de Freshdesk, y el equipo compara cada borrador con la respuesta que una persona envió realmente. Cuando el borrador estaba mal, eso normalmente señala un artículo de ayuda que falta o una regla que hay que afinar, y lo arreglan. Ahora alrededor de uno de cada diez borradores sale con poca o ninguna edición, y la proporción sube despacio. Para un plan de pruebas completo, consulta pruebas de agentes de soporte con IA y las comprobaciones de probar antes del lanzamiento.
Paso 6: mantén el entrenamiento al día
El entrenamiento con tickets no es una importación única. Tus productos, políticas y clientes cambian, y una IA que aprendió de los tickets del año pasado se va quedando obsoleta poco a poco.
- Resincroniza con un calendario. La empresa danesa de software Timengo resincroniza su centro de ayuda de Freshdesk cada domingo, vuelve a rastrear su documentación cada lunes, trae los tickets abiertos cada semana y el historial completo de tickets cada mes. Los bots de Norden-Frisia se resincronizan desde Zendesk, así que un cambio en un artículo sobre baca de techo o descuentos por discapacidad llega al bot sin reentrenar.
- Retira tickets cuando cambie una política. Cuando actualices el plazo de devolución, los tickets antiguos que lo citan deberían salir del conjunto de entrenamiento ese mismo día.
- Busca lagunas en los tickets nuevos. Las preguntas que la IA no pudo responder este mes son los artículos de ayuda del mes que viene. HubSpot marca lagunas de conocimiento en tickets que el agente no pudo responder, y Opportunities de Gorgias muestra temas que su IA "has repeatedly handed over to your team" (Gorgias Opportunities). Una base de conocimiento que se actualiza sola es el objetivo, con una persona aprobando cada cambio.
- Haz una auditoría trimestral del conocimiento en el que se apoya la IA. Una auditoría de la base de conocimiento de IA detectará más respuestas obsoletas que cualquier ajuste de prompt.
Errores comunes al entrenar una IA con tickets anteriores
- Importarlo todo "por si acaso". Más tickets significan más políticas antiguas y más decisiones incoherentes. Depura primero.
- Decirle a la IA que ignore algunos tickets en lugar de eliminarlos. Las instrucciones no filtran el conocimiento de forma fiable. Si de una cola no se debe aprender (datos de prueba, un producto antiguo, tickets de otro equipo), exclúyela de la importación.
- Aprender decisiones de los ejemplos. Los límites de reembolso y las reglas de escalado pertenecen por escrito, donde puedes probarlos.
- Olvidar los datos personales hasta que lo pregunte legal. Redacta la copia de entrenamiento antes de indexar nada.
- Probar con los datos de entrenamiento. Reserva tickets recientes, o tu puntuación te está halagando.
- Recurrir primero al fine-tuning. Es la opción más lenta y cara y arregla el problema menos común.
- Tratar el lanzamiento como el final. La fase piloto es donde encuentras las lagunas que tu historial no cubría.
Cómo aprende eesel de tus tickets anteriores
Seré sincero en que aquí tengo un sesgo, pero eesel se creó en torno a este flujo exacto, así que vale la pena mostrar cómo encaja con los seis pasos.
- Importación con control. Con una conexión completa a Zendesk, Freshdesk o Gorgias, eesel lee tu centro de ayuda, tus macros y tus tickets anteriores. La primera importación es una muestra de hasta 1.000 tickets resueltos recientes, y puedes filtrar por estado y fecha para importar más (documentación de configuración de Zendesk). Si de una fuente no se debe aprender, la desactivas en la página de la integración porque, como dice la documentación, decirle que ignore tickets anteriores "does not stop it finding them; the switch does."
- Datos personales enmascarados antes de indexar. Los tickets anteriores pasan por un detector que cubre 15 tipos de datos personales, sustituidos por máscaras tipadas como
[REDACTED:EMAIL], y los tickets que no se pueden limpiar se omiten en lugar de almacenarse en bruto (documentación de redacción de PII). - Reproducción antes de salir en vivo. La habilidad Simulation reproduce tickets resueltos recientes, puntúa cada respuesta frente a lo que envió tu equipo y sugiere cambios de instrucciones. Nada se ejecuta sobre tickets reales hasta que creas una automatización, y la mayoría de los equipos empieza con borradores.
- Correcciones que se quedan. Cuando corriges una respuesta en el chat, eesel escribe la corrección en sus propias instrucciones, así que el arreglo se mantiene la semana siguiente.
- Una CLI para la fontanería de exportar e importar. Si prefieres automatizarlo con scripts, o que lo haga un agente de código como Claude Code o Cursor, la CLI de eesel maneja el mismo agente desde una terminal, con salida JSON.
eesel integrations sources zendeskmuestra qué contienen las fuentes de centro de ayuda, macros y tickets,eesel integrations download start zendesklas copia al conocimiento de eesel, yeesel chatte permite pedirle que importe un rango de fechas concreto o ejecute una simulación. Es el mismo agente que el panel, así que todo lo que configures allí aparece en ambos.
El minorista sueco de vehículos eléctricos Nordbutiker es un buen ejemplo de la idea de "depurar, no volcar". Gestiona cuatro tiendas en Suecia, Noruega, Dinamarca y Finlandia, y el bot de cada tienda aprende de los tickets resueltos de su propia marca de Zendesk, de modo que las respuestas reflejan lo que dijeron en realidad los agentes de esa tienda. Todo lo que el sitio y los tickets anteriores no cubren, como repuestos y reclamaciones de garantía, va a una persona.
Entrena una IA con tus tickets anteriores con eesel
Si tienes años de historial del helpdesk y quieres una IA que responda como tus mejores agentes, eesel es el camino más corto que conozco. Se incorpora a Zendesk, Freshdesk o Gorgias como un empleado nuevo que ya ha leído tu centro de ayuda, tus macros y tus mejores tickets anteriores, con los datos personales enmascarados. Luego reproduce tus tickets recientes para mostrarte dónde se habría equivocado antes de redactar una sola respuesta real.
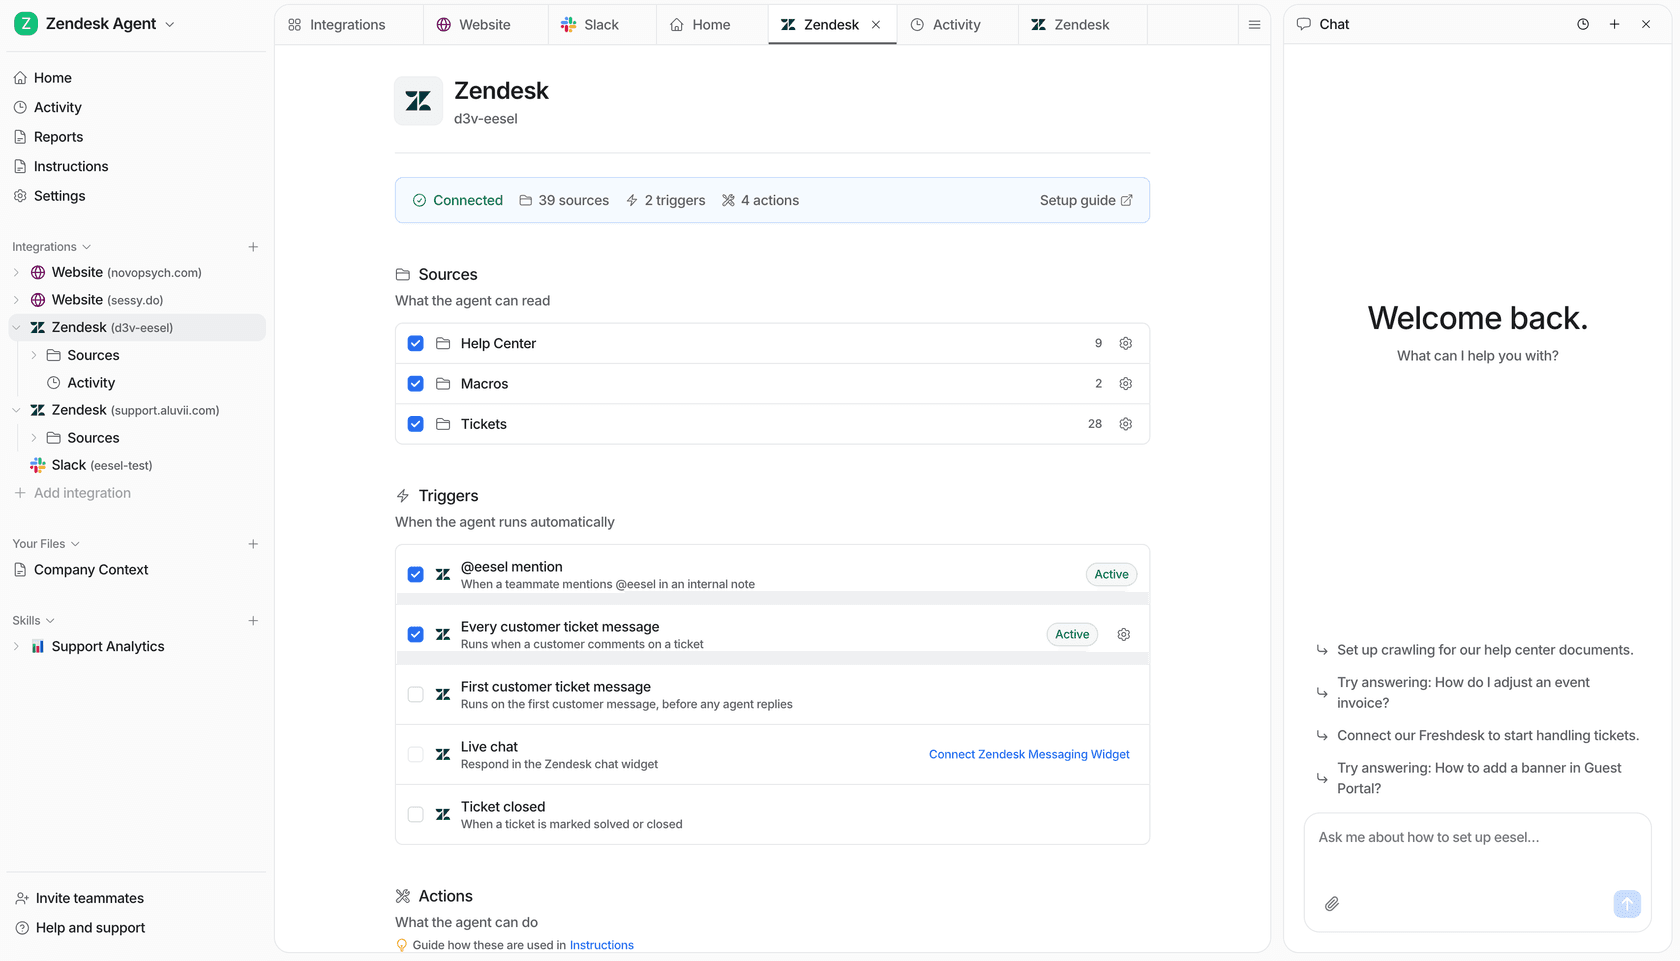
Eso fue lo que convenció a Norden-Frisia: en la semana de prueba el equipo conectó Zendesk, trajo las macros y los últimos tres meses de tickets, y se registró en cuestión de días. El plan gratuito incluye 100 créditos sin tarjeta, y los planes de pago empiezan en $299/month por 500 créditos, donde un ticket cuesta un crédito sin importar cuántas respuestas vayan y vengan (precios de eesel). Prueba eesel con tu propio historial de tickets y mira los borradores antes de pagar nada.