

El mejor modelo de IA para tickets de soporte en 2026 es Qwen 3.8 Max según los números, pero el modelo no es la variable que decide si tu cola funciona. En τ-bench, el único benchmark público que obliga a un agente de IA a recuperar respuestas de una base de conocimiento real de 698 documentos y luego actuar sobre ellas, Qwen 3.8 Max logra un 55,2 % en el primer intento, Claude Opus 5 un 48,7 %, y Claude Fable 5, el modelo más caro del mercado, queda sexto con un 39,7 %.
Esta es la parte que debería cambiar lo que hagas a continuación. Toma un modelo y mantenlo constante. Claude Opus 4.5 logra un 92,3 % en el dominio de telecomunicaciones, donde la respuesta está detrás de una llamada a una herramienta, y un 24,7 % en el dominio bancario, donde la respuesta está en un montón de documentos. Mismo modelo, misma semana, 68 puntos de diferencia, decididos por completo por cómo estaba almacenado el conocimiento. La diferencia entre el mejor y el peor modelo del campo actual es de 30 puntos. La diferencia que crea dónde pones tu documentación es de 68.
Y el argumento del coste también está al revés. Claude Opus 5 cuesta unos 0,11 $ por ticket con volúmenes de tokens realistas. Zendesk cobra 1,50 $ por resolución automatizada además de eso. Estás regateando por el 7 % de la factura.
Así que: elige un modelo competente de gama media, dedica el esfuerzo ahorrado a tu base de conocimiento y a tus reglas de escalación, y prueba todo contra tu propio historial de tickets antes de que lo vea un cliente. Ese último paso es lo que hace eesel, reproduciendo tus tickets pasados y puntuando las respuestas de la IA frente a lo que tu equipo envió realmente.
La pregunta que me hacen y la que realmente decide
Construyo agentes de IA en eesel, y la pregunta más habitual de los responsables técnicos de soporte que evalúan software de atención al cliente con IA es alguna versión de "¿qué modelo deberíamos usar?". Es una pregunta razonable. También es, la mayoría de las veces, la primera pregunta equivocada.
Lo sé porque he visto lo que pasa cuando los equipos la responden y se quedan ahí. Algunos de nuestros propios clientes se han ido a construir algo por su cuenta directamente sobre las API de frontera. Mirando esa lista con honestidad, incluye una empresa de realidad aumentada y tecnología de la construcción y una marca de belleza DTC, esta última yéndose directamente a la API de Claude. No es una crítica. Son equipos de ingeniería competentes y la API es realmente buena. Pero todos estaban resolviendo para el modelo, y el modelo nunca fue la parte difícil.
El responsable de ingeniería de una empresa de cajeros de Bitcoin en nuestro plan Team, con una base de Confluence de 300 artículos, expresó el otro lado con claridad:
"We could try to write our own LLM application but we didn't want to invest our time into that. We wanted something that we would not have to maintain."
Dos equipos, la misma pregunta de partida, conclusiones opuestas. La diferencia entre ellos no es qué modelo eligieron. Es si tenían una forma de saber si la cosa funcionaba.
Este artículo es mi intento de responder bien a la pregunta del modelo, con números reales, y luego mostrarte por qué la respuesta importa menos que lo que hay debajo.
Hay un benchmark hecho justo para esto y casi nadie lo cita
Cada lanzamiento de un modelo cita MMLU, SWE-bench, GPQA o alguno de los índices agregados de inteligencia. Ninguno te dice nada útil sobre si un modelo puede cerrar un ticket de soporte, porque cerrar un ticket de soporte no es un examen de conocimientos. Es una secuencia: entender una petición confusa, encontrar la política relevante, llamar a las herramientas correctas en el orden correcto, negarse a lo que no está permitido y dejar la base de datos en el estado correcto. Esa es la diferencia entre un modelo de lenguaje y un sistema de tickets con IA que funciona.
Sierra creó un benchmark precisamente para eso, y se llama τ-bench. El artículo original de τ-bench apareció en 2024 con los dominios de retail y aerolíneas. τ²-bench añadió un dominio de telecomunicaciones en 2025, y su aportación clave fue hacer que también el usuario actúe, de modo que el agente tiene que guiar al cliente por pasos que solo el cliente puede realizar. Así es el soporte técnico en la realidad. La conclusión del propio artículo es contundente: el rendimiento cae de forma significativa en cuanto el agente tiene que guiar a un usuario en lugar de simplemente actuar por él.
Luego, en 2026, llegó la versión que más importa a los equipos de soporte. τ³-bench añadió τ-Knowledge, un dominio bancario en el que el agente tiene que trabajar con una base de conocimiento en lugar de una lista ordenada de herramientas.
Así es esa base de conocimiento, según el propio texto de Sierra: 698 documentos en 21 categorías de producto, unos 195.000 tokens. Cada tarea necesita de media 18,6 documentos y 9,5 llamadas a herramientas, y algunas hasta 33. Las tareas se puntúan según si el agente produjo el estado final correcto de la base de datos, no según si la respuesta sonaba bien.
Si alguna vez te has preguntado por qué tu centro de ayuda parece pelearse con la IA, esta es la versión benchmark de tu centro de ayuda. También es la razón por la que las guías de desviación dedican más tiempo al contenido que a los ajustes del modelo.
El precipicio de la recuperación
Este es el gráfico que pondría en la pared de cualquiera que evalúe IA para sistemas de tickets.
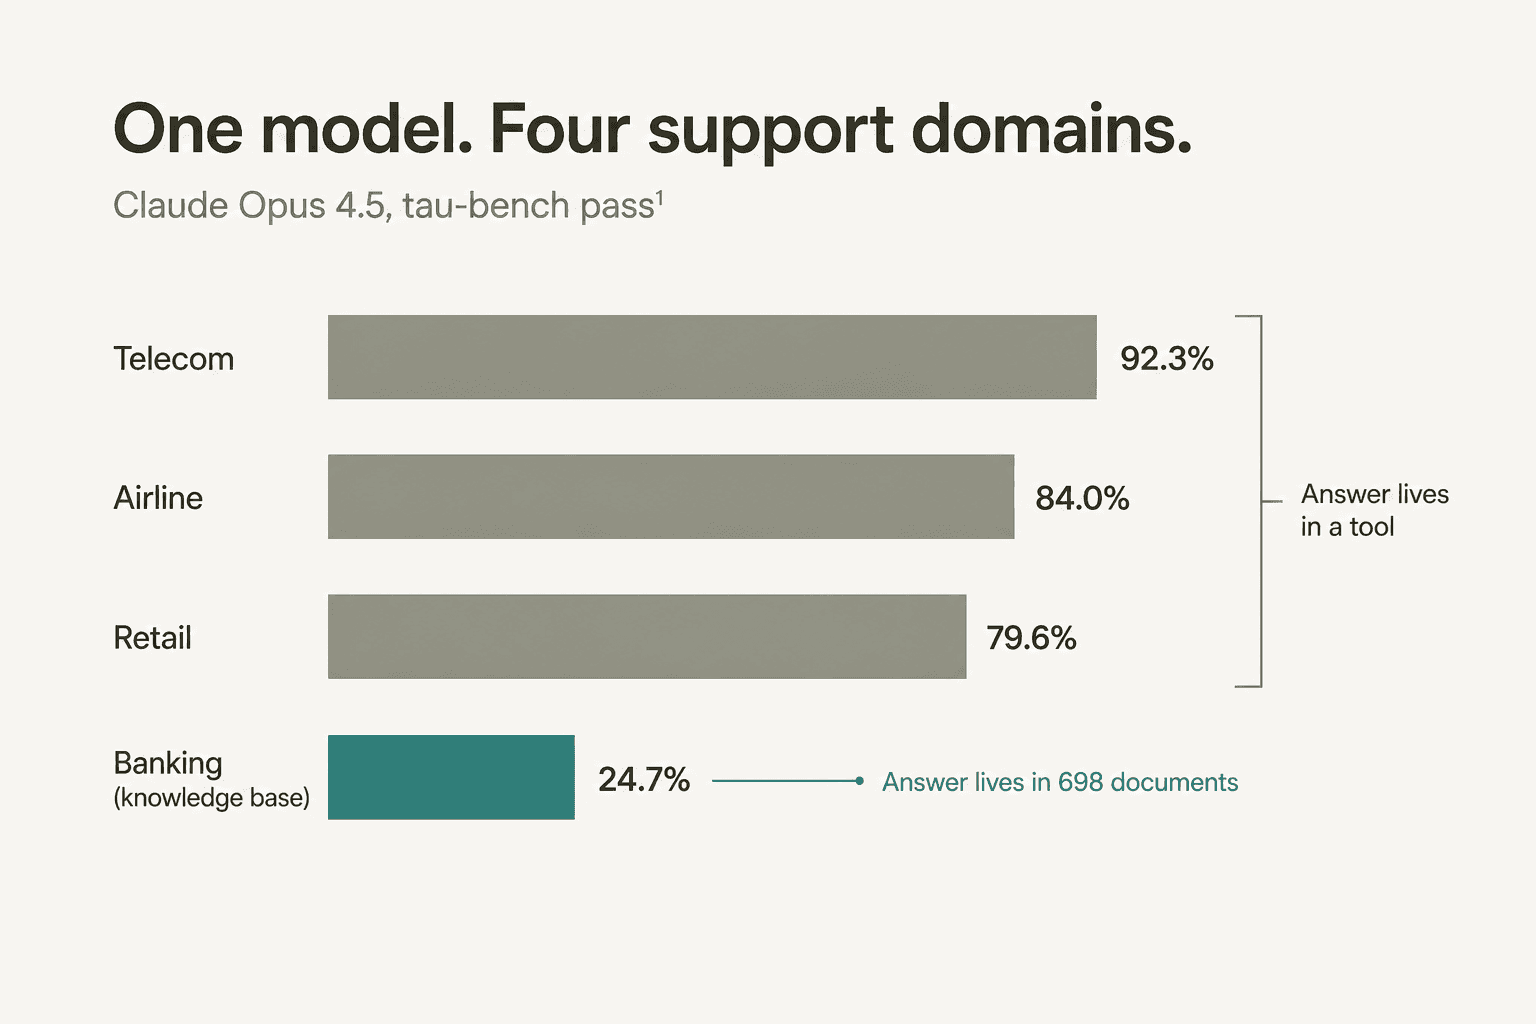
Un modelo. Una ejecución de evaluación. Cuatro dominios. Telecomunicaciones 92,3 %, aerolíneas 84,0 %, retail 79,6 %, banca 24,7 %.
Los tres primeros dominios dan al agente un conjunto limpio de herramientas y la respuesta se alcanza llamándolas. El cuarto obliga al agente a ir primero a buscar la respuesta en documentos. Ese único cambio cuesta 68 puntos, más que toda la diferencia entre el mejor y el peor modelo de frontera en la misma prueba.
Qwen3.5-397B muestra la misma forma de manera aún más cruda: 97,81 % en telecomunicaciones frente a 9,79 % en banca. Un derrumbe de 88 puntos con los mismos pesos.
Quiero ser cuidadoso con lo que esto demuestra y lo que no. Es un único benchmark, y sintético. Pero el mecanismo que expone es exactamente el que veo en producción. Cuando un cliente me dice que su chatbot de base de conocimiento con IA "no es lo bastante inteligente", más o menos nueve de cada diez veces el modelo está bien y la recuperación trae los tres párrafos equivocados.
El ranking de 2026 para tickets de soporte
Sierra ejecutó un lote nuevo el 04-08-2026 que cubre la mayor parte de la frontera actual. Todas estas entradas usaron la misma configuración de recuperación, el mismo simulador de usuario GPT-5.2, la misma versión del benchmark y cuatro intentos, así que se comparan limpiamente entre sí.
| Modelo | Proveedor | Correcto al 1.er intento | Correcto 4 de 4 | Ajuste de esfuerzo |
|---|---|---|---|---|
| Qwen 3.8 Max | Qwen | 55,2 % | 35,1 % | xhigh |
| Claude Opus 5 | Anthropic | 48,7 % | 32,0 % | max |
| Grok 4.5 | xAI | 47,9 % | 32,0 % | high |
| GPT-5.6 Sol | OpenAI | 46,9 % | 27,8 % | xhigh |
| Meta Muse Spark 1.1 | Meta | 40,5 % | 20,6 % | xhigh |
| Claude Fable 5 | Anthropic | 39,7 % | 28,9 % | max |
| Claude Opus 4.8 | Anthropic | 39,7 % | 22,7 % | max |
| GLM-5.2 | Z.ai | 37,1 % | 13,4 % | xhigh |
| Kimi K3 | Moonshot AI | 37,1 % | 17,5 % | max |
| Inkling | Thinking Machines Lab | 25,0 % | 11,3 % | max |
Varias cosas saltan a la vista en esa tabla.
El modelo más caro no es el mejor. Claude Fable 5 cuesta 10 $ por millón de tokens de entrada y 50 $ por millón de salida. Qwen 3.8 Max cuesta 2 $ y 6 $. El modelo más barato puntúa 15,5 puntos más en la tarea de soporte. Si has asumido que el precio de frontera compra rendimiento de frontera en soporte, no es así.
Las diferencias entre los cuatro primeros son pequeñas. De Qwen 3.8 Max a GPT-5.6 Sol hay 8,3 puntos, y de Opus 5 a Grok 4.5 menos de un punto. No son clases distintas de herramienta. Son vecinos.
El progreso es real pero lento. Claude Opus 4.5 logró un 24,7 % en este dominio en febrero. Opus 5 lo duplicó hasta el 48,7 % en agosto. Progreso genuino a lo largo de dos generaciones. Aun así significa que el modelo se equivoca más a menudo de lo que acierta, un punto de partida muy distinto del que suele implicar una comparativa de proveedores de chatbots.
Faltan dos modelos obvios. Ni Gemini 3.7 Flash ni DeepSeek V4 Flash tienen un envío en este dominio, así que no puedo clasificarlos aquí con honestidad. Las entradas antiguas de Gemini usaron una configuración de recuperación distinta, lo que las hace no comparables en lugar de simplemente más bajas.
Una nota metodológica que conviene llevarse: las entradas más antiguas del ranking usaron configuraciones de recuperación distintas, por lo que las comparaciones entre lotes son más frágiles de lo que parecen. Sierra también volvió a calificar el dominio bancario en julio de 2026 y dice que los resultados anteriores a esa corrección no son comparables. Quien cite una puntuación bancaria de principios de año probablemente cita una desfasada.
Acertar una vez no es acertar siempre
La columna que la mayoría se salta es la que yo miraría primero.
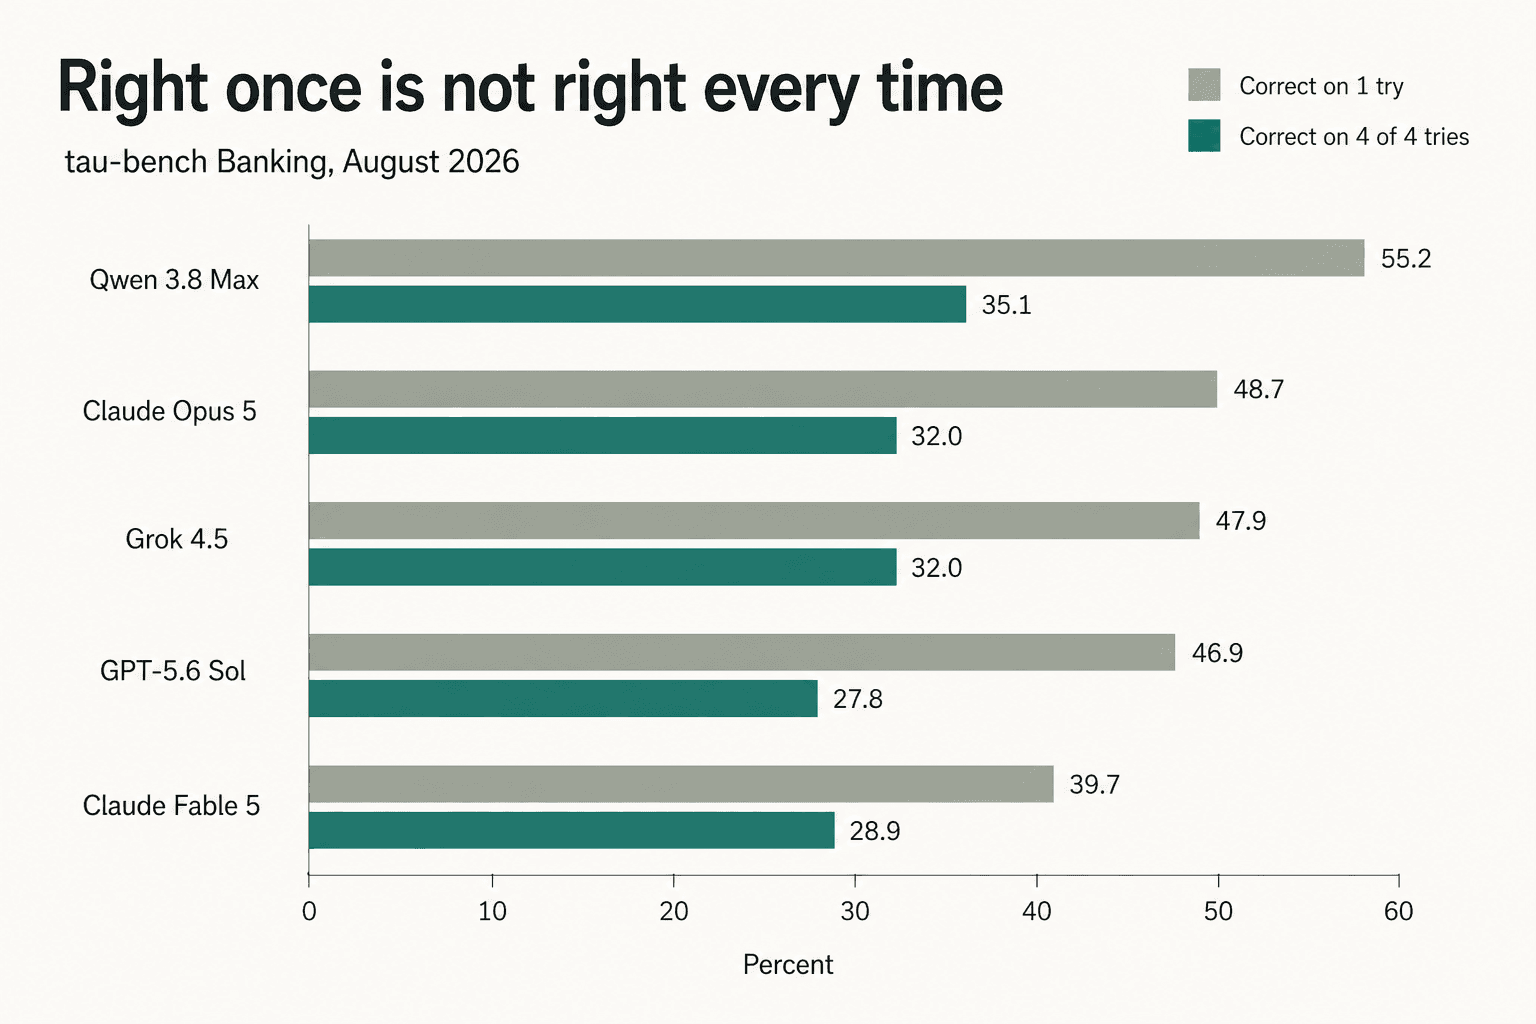
τ-bench reporta pass^k, que pregunta si un modelo resolvió bien la misma tarea en todos los k intentos independientes. Pass^1 es "puede hacerlo". Pass^4 es "lo hace de forma fiable".
El mejor modelo del campo es fiablemente correcto en el 35,1 % de estas tareas. Opus 5 cae del 48,7 % al 32,0 %. GPT-5.6 Sol cae del 46,9 % al 27,8 %. GLM-5.2 se desploma, del 37,1 % al 13,4 %, lo que indica que adivina bien en lugar de razonar con consistencia.
Esa diferencia entre pass^1 y pass^4 es el número que decide si puedes dejar a una IA sola con una cola. Un modelo con 48,7 % de pass^1 y 32,0 % de pass^4 no es un modelo que resuelve la mitad de tus tickets. Es un modelo que tratará el mismo tipo de ticket de forma distinta según el día.
Una responsable de CX de una marca DTC de suplementos que gestiona unos 7.000 tickets de Gorgias al mes me dijo la versión operativa de esto mejor que cualquier benchmark:
"The AI will never be able to answer 100% of the questions, but if it tries and just answers 'sorry I don't know this,' I cannot go and check all my 7,000 tickets to see if the AI actually made a good answer, then the point is a little bit gone. I need an AI who is only handling the tickets that it's confident to handle and all the other ones, leave them alone."
Eso es pass^k expresado como requisito de negocio. La varianza no es un problema de calidad que se arregle con un modelo mejor, es un problema de enrutamiento que se arregla con escalación basada en confianza. Todo despliegue de soporte serio en el que he trabajado acaba aquí, y es la razón por la que una configuración de copiloto suele ser una primera fase más segura que la autonomía total.
Las tres formas en que los modelos fallan realmente en un ticket real
Sierra publicó la taxonomía de fallos junto con el benchmark, y leerla resultó incómodamente familiar. No son fallos exóticos de la IA. Son exactamente las tres cosas de las que se quejan los responsables de soporte.
Pasa por alto la política que depende de otra política. En el ejemplo del benchmark, un cliente quiere disputar una transacción y pedir un aumento de su límite de crédito. El agente busca la política de disputas, la encuentra y presenta la disputa primero porque es el orden en que lo pidió el cliente. Nunca busca la política del límite de crédito, que dice que los aumentos de límite se rechazan automáticamente cuando hay una disputa pendiente. El cliente recibe una denegación que un agente humano habría evitado haciendo los dos pasos en el orden contrario.
Informa de éxito en algo que falló. Muchas de las herramientas del benchmark hay que desbloquearlas antes de usarlas. Cuando el agente se salta ese paso y recibe un error, el texto de Sierra señala que algunos agentes entonces alucinan una respuesta de éxito para el usuario. Es el modo de fallo que te cuesta un cliente y no solo un ticket. Un equipo danés de telemática de vehículos B2B en Zendesk, con unos 200 tickets al mes y camino de los 2.000, sufrió la versión de consumo cuando su bot confirmó soporte para marcas de coche que no estaban en la base de datos, porque la base de conocimiento decía "damos soporte a todos los modelos".
Se cree al cliente. Cuando el usuario simulado afirma que su disputa fue aprobada, los agentes con frecuencia aplican el abono sin comprobar el estado real. Todo equipo de soporte tiene una versión de esto. Un responsable de soporte de eCommerce fue tajante en nuestro propio chat del panel:
"stop promising customer things we cant do. we cannot guarantee this customer's order to them by friday"
Ninguno de estos tres se resuelve con un modelo más grande. Se resuelven acotando lo que el agente puede tocar. Hay un comentario en Hacker News que lo plantea mejor que la mayoría de la documentación de proveedores:
"Give your LLM the same level of permissions that you would give a human you just hired in the same role. The examples given, tricking the customer support LLM into sending text messages to all users, or into transferring money, are not things that you would ever give a human customer support agent the tools to do."

Esa es toda la postura de seguridad y fiabilidad en dos frases, y adoptarla no cuesta nada. También es cómo se construye la mayor parte de la automatización de atención al cliente duradera, un permiso estrecho tras otro.
Lo que cuesta realmente cada modelo por ticket
Pongamos números reales, porque "depende de tu uso" no es una respuesta.
Un ticket de soporte respondido con recuperación tiene una forma bastante predecible. Pongamos 15.000 tokens de entrada (prompt del sistema, política, los fragmentos recuperados de la base de conocimiento, historial de la conversación) y 1.500 tokens de salida (la respuesta más los tokens de razonamiento, que se facturan a la tarifa de salida en todos los grandes proveedores). Tus números serán distintos, pero las proporciones entre modelos no.
| Modelo | Entrada / salida por 1 M | Coste por 1.000 tickets | Por ticket |
|---|---|---|---|
| Claude Fable 5 | $10.00 / $50.00 | $225.00 | $0.225 |
| GPT-5.6 Sol | $5.00 / $30.00 | $120.00 | $0.120 |
| Claude Opus 5 | $5.00 / $25.00 | $112.50 | $0.113 |
| Kimi K3 | $3.00 / $15.00 | $67.50 | $0.068 |
| GPT-5.6 Terra | $2.00 / $12.00 | $48.00 | $0.048 |
| Claude Sonnet 5 | $2.00 / $10.00 | $45.00 | $0.045 |
| Qwen 3.8 Max | $2.00 / $6.00 | $39.00 | $0.039 |
| Claude Haiku 4.5 | $1.00 / $5.00 | $22.50 | $0.023 |
| Gemini 3.7 Flash | $0.75 / $3.75 | $16.88 | $0.017 |
| GPT-5.6 Luna | $0.20 / $1.20 | $4.80 | $0.005 |
| DeepSeek V4 Flash | $0.22 / $0.66 | $4.29 | $0.004 |
Las tarifas proceden de la página de precios de cada proveedor. Las cifras de Anthropic y Qwen están enlazadas en la sección anterior; el resto están en la tarifa de OpenAI y la de Google, con la de DeepSeek enlazada más abajo.
En esa tabla hay cuatro trampas.
El precio de Gemini es promocional. Los 0,75 $ y 3,75 $ de Google rigen hasta el 31 de diciembre de 2026 y luego se duplican a 1,50 $ y 7,50 $ el 1 de enero. Si hoy construyes un modelo de costes sobre Gemini 3.7 Flash, constrúyelo con la tarifa del año que viene.
DeepSeek ahora cobra según la hora del día. La tarifa de DeepSeek indica horas punta de 01:00 a 04:00 y de 06:00 a 10:00 UTC al doble exacto de la tarifa valle, así que los 0,22 $ y 0,66 $ de arriba pasan a 0,44 $ y 1,32 $ en esas franjas. Esas horas siguen el horario laboral chino, que para una cola de soporte de EE. UU. o Europa cae sobre todo fuera de tu periodo de más carga. Es una peculiaridad que juega a tu favor, y también es frágil.
Los 2 $ y 10 $ de Sonnet 5 son introductorios. La tarifa publicada de Anthropic vuelve a 3 $ y 15 $ el 31 de agosto de 2026. Son dos semanas desde que escribo esto.
La residencia de datos conlleva un recargo. Anthropic aplica un multiplicador de 1,1 cuando fijas la inferencia solo en EE. UU., y OpenAI cobra un 10 % de recargo en los puntos de acceso de procesamiento regional para los modelos lanzados después del 5 de marzo de 2026. Si manejas datos personales de clientes bajo un requisito de residencia, súmalo.
Prueba los números con tu propio volumen
El modelo es alrededor del 7 % de tu factura
Ejecuta esa calculadora con cualquier medidor de plataforma realista y la forma de la respuesta deja de cambiar.
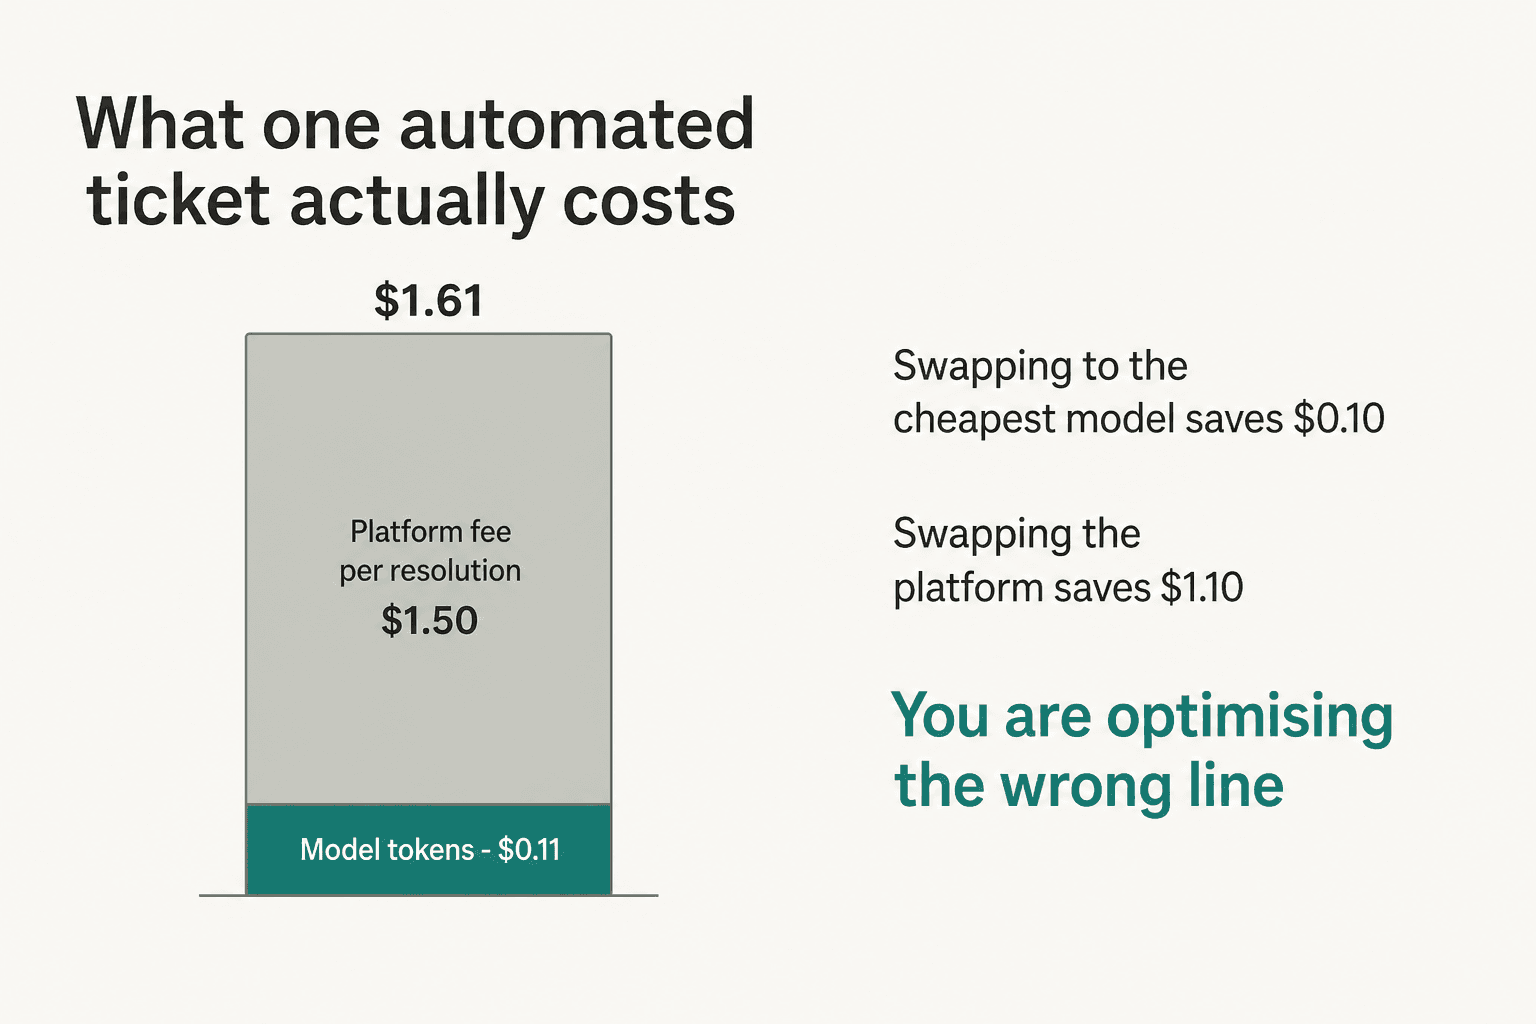
Zendesk publica 1,50 $ por resolución automatizada con compromiso y 2,00 $ con pago por uso, dentro de la tabla comparativa de planes y no en las tarjetas de los planes. Gorgias cobra entre 0,85 $ y 1,00 $ por interacción automatizada según el plan. Freshdesk cobra 0,49 $ por sesión por encima de las 500 incluidas. Help Scout cobra 0,75 $ por resolución, con la regla más justa de la categoría: una resolución por conversación sin importar cuántas preguntas responda la IA dentro de ella.
Pon Claude Opus 5 detrás de la tarifa comprometida de Zendesk y tu coste por ticket es de 1,61 $, de los cuales la inteligencia en sí son 0,11 $. Bajar al modelo más barato del mercado te ahorra seis céntimos y te cuesta nueve puntos de benchmark. Es el peor trato de todo este artículo.
La unidad facturable también importa más que la tarifa. Un medidor por sesión vuelve a cobrar cuando un ticket resuelto se reabre al día siguiente. Un medidor por interacción cobra incluso cuando la IA traspasa a una persona. Si tu tasa de reapertura es alta, esos dos detalles te cuestan más que cualquier decisión de modelo. Nuestro desglose de la tasa de resolución de la IA explica cómo difieren las definiciones entre proveedores. Para la comparación con una base de personal, consulta coste de la IA frente al de un agente humano.
Entonces, qué modelo deberías elegir
Esta es mi lectura honesta, con el razonamiento adjunto en lugar de un encogimiento de hombros sobre tus necesidades concretas.
Si quieres las mejores puntuaciones de soporte y la residencia de datos no es un bloqueo: Qwen 3.8 Max. Encabeza el dominio de conocimiento con un 55,2 % y cuesta 2 $ y 6 $, menos de la mitad de la tarifa de salida de Opus 5. El inconveniente es real y conviene sopesarlo bien: se sirve desde Alibaba Cloud, lo que para la mayoría de los equipos de soporte occidentales que manejan datos personales de clientes es una conversación de cumplimiento antes que técnica. Revisa tus obligaciones de acuerdo de tratamiento de datos antes de revisar el benchmark.
Si necesitas una opción por defecto alojada en Occidente: Claude Opus 5 o GPT-5.6 Sol. Están a menos de dos puntos entre sí en el benchmark y a menos de ocho céntimos por cada mil tickets. Opus 5 tiene una fiabilidad en cuatro de cuatro algo mejor, 32,0 % frente a 27,8 %, lo que importa si automatizas sin supervisión. Ambos están bien documentados y tienen detrás acuerdos empresariales reales.
Si tienes un volumen alto con una base de conocimiento limpia y pequeña: Gemini 3.7 Flash o Claude Haiku 4.5. No existe un envío de banca de τ-bench para ninguno de los dos, así que no puedo clasificarlos con honestidad frente al resto. Lo que sí puedo decir es que el precipicio de la recuperación funciona en ambos sentidos: cuando tu base de conocimiento son 40 artículos bien escritos y no 698 documentos desordenados, la tarea se parece mucho más al dominio de telecomunicaciones, donde casi todo puntúa por encima del 80 %. Valora con cuidado la tarifa promocional en el caso de Gemini.
Si tienes un presupuesto ajustado y puedes aceptar varianza: DeepSeek V4 Flash. Es con diferencia la opción creíble más barata, y las franjas valle favorecen de verdad el horario laboral occidental. Dos salvedades. Los términos de su API de pago guardan silencio sobre el uso para entrenamiento en lugar de proteger explícitamente, y no hay una opción publicada de retención cero, así que no sirve sin más para datos de clientes. Y Artificial Analysis midió una tasa alta de alucinación, justo el modo de fallo equivocado para una respuesta de cara al cliente.
Descarta Claude Fable 5 para este trabajo. Es un modelo magnífico y el más caro de aquí, a 10 $ y 50 $. En el benchmark de soporte queda sexto, por debajo de Opus 5 y GPT-5.6 Sol, que cuestan la mitad o menos. No hay lectura de los datos en la que sea la elección correcta para una cola de tickets. Lo mismo vale para Kimi K3: a 3 $ y 15 $ cuesta más que Qwen 3.8 Max y puntúa 18 puntos menos.
Una cosa más que conviene decir claramente: las tasas de alucinación fueron en la dirección equivocada a lo largo de esta generación. Artificial Analysis midió que la tasa de Claude Opus 5 sube 14 puntos hasta el 50 %, y que Gemini 3.7 Flash retrocede al 64,5 % desde el 55,6 % de Gemini 3.6 Flash, incluso cuando la precisión mejoró. Los modelos se volvieron más listos y más seguros de sí mismos al equivocarse a la vez. Para la IA en atención al cliente, ese intercambio es malo de una forma en que no lo es para un asistente de programación, porque una respuesta equivocada llega directamente a un cliente.
Qué arreglar antes de tocar el desplegable de modelos
Si el precipicio de la recuperación es real, y creo que la evidencia es fuerte, aquí está donde de verdad se encuentra la palanca.
Arregla primero la base de conocimiento. Es el cambio de mayor retorno disponible. La discusión sobre τ-bench en Hacker News tiene una demostración del principio que se me quedó grabada: alguien reescribió los documentos de políticas del benchmark como árboles de decisión claros y pasos numerados, sin tocar el modelo ni las tareas, y mejoró GPT-5-mini un 22 %. La propia explicación del autor de por qué es la línea más afilada del hilo:
"If a model only performs well once the rules are clarified, that's still revealing something important about its agency: it's brittle when policies are ambiguous, but much stronger when they're structured."
Veintidós puntos por reescribir documentación. Ninguna mejora de modelo se acerca a eso. Nuestras guías sobre IA para la gestión del conocimiento y las mejores herramientas de base de conocimiento cubren la parte práctica.
Acota las herramientas como harías con un empleado nuevo. Volvamos al tema de los permisos. Si la IA no puede emitir reembolsos por encima de un umbral, no se la puede convencer de emitir uno. Es más barato y más fiable que pedirle en el prompt que no lo haga, y es lo que separa a un verdadero compañero de equipo con IA de un chatbot con claves de API. Los ejemplos de agentes que funcionan suelen tener listas de herramientas estrechas, no prompts ingeniosos.
Enruta por confianza, no por tipo de ticket. Pass^k dice que el mismo modelo trata el mismo ticket de forma distinta entre ejecuciones. La respuesta no es un modelo mejor, es dejar que la IA decline. Configura reglas de traspaso que traten "no estoy seguro" como un resultado válido y frecuente en lugar de un fallo. Aquí también es donde el coaching de agentes se amortiza, porque los tickets rechazados te dicen qué escribir a continuación.
Mide las cosas correctas en producción. Un comentarista de Hacker News describió cómo un proveedor seguía τ-bench aerolíneas con una media móvil de 32 días, junto con la tasa de errores de llamadas a herramientas y la tasa de errores de salida estructurada. Es un panel mejor que la tasa de resolución sola, porque separa "el modelo se equivocó" de "el modelo llamó a la herramienta equivocada". Nuestro artículo sobre métricas de atención al cliente cubre con qué combinarlas.
Prueba con tu propio historial antes de salir en vivo. Todos los benchmarks de este artículo son la cola de otra persona. La tuya tiene productos distintos, casos límite distintos y un tono distinto. La única prueba que te dice si un modelo funcionará para ti es una reproducción de tus propios tickets resueltos.
Esa última no es opcional, y es el paso que los equipos que construyen sobre la API en bruto se saltan con más frecuencia. También es la razón por la que un ranking de benchmark debe informar tu lista corta y nunca decidirla.
Prueba eesel en tu cola de tickets
Todo lo anterior apunta a la misma conclusión: el modelo es un componente, y lo que decide si tu automatización de soporte funciona es el andamiaje que lo rodea. Ese andamiaje es eesel.
La pieza que señalaría en concreto, dado el argumento de este artículo, es la simulación. Puedes pedirle a eesel que ejecute una simulación sobre tus tickets recientes, y reproduce cientos de tus tickets pasados y puntúa las respuestas de la IA frente a lo que tu equipo envió realmente, y luego te devuelve las lagunas y cambios de instrucciones sugeridos. Es el problema de pass^k abordado con tus propios datos en lugar de los de un benchmark. No te pronostica una tasa de resolución, y desconfiaría de cualquier proveedor que lo afirme.

Se conecta con Zendesk, Gorgias, Freshdesk, Front, Help Scout, HubSpot, Salesforce y Jira Service Management. El precio es una cuota mensual fija desde 299 $/mes por 500 créditos (1 crédito por ticket o chat), sin tarifa por asiento. Hay un plan gratuito con 100 créditos y sin tarjeta, que para la mayoría de los equipos son tickets reales de sobra para probar.
Si llevas la última semana comparando nombres de modelos en una hoja de cálculo, este es el atajo: elige cualquiera de los cuatro primeros, conecta tu helpdesk, reproduce tus propios tickets y deja que los resultados te digan si el modelo fue alguna vez el problema.