

Um KI-Supportgespräche zu überprüfen, lies jede Eskalation, jedes Gespräch mit niedrigem CSAT, jedes wiedereröffnete und jedes Erstattungs- oder Richtliniengespräch, plus eine zufällige Stichprobe von 20 bis 30 der als gelöst markierten Fälle, denn "gelöst" bedeutet oft nur, dass der Kunde verstummt ist. Prüfe jedes auf eine korrekte, belegte Antwort, Richtlinientreue, Aktionen, den richtigen Übergabezeitpunkt und den Ton. Benenne dann die Fehlerursache (fehlendes Wissen, Anweisungslücke, falsche Aktion, späte Übergabe), behebe sie an der Quelle und spiele dieselben vergangenen Tickets erneut durch, bevor die Änderung live geht. Überprüfe in der ersten Woche täglich, danach wöchentlich. eesel zeigt die Quellen und die Begründung hinter jeder Antwort und spielt gelöste Tickets erneut durch, ohne etwas zu versenden.
Warum bedeutet "gelöst" nicht, dass die KI es richtig gemacht hat?
Ich arbeite in der Support-Queue von eesel, und dem Ersten, dem ich am wenigsten vertraue, ist ein grünes "gelöst"-Abzeichen. Ein KI-Agent kann ein Gespräch mit einer flüssigen, höflichen, falschen Antwort schließen, und nichts im Dashboard zuckt. Der Kunde gibt entweder auf oder kommt zwei Tage später verärgert auf einem anderen Kanal zurück.
Das sagen die Anbieter selbst. HubSpot setzt den Lösungsstatus bei einem Customer-Agent-Gespräch 72 Stunden nach der letzten Besucherantwort, und späteres negatives Feedback "ändert den Lösungsstatus nicht". Dieselbe Seite ist unverblümt: "Deflections bedeuten nicht immer eine Lösung." Zendesks neues Qualitätsbewertungs-Dashboard, veröffentlicht am 10. November 2026, bewertet Verständnis und Empathie und warnt dann: "Verständnis bedeutet nicht, dass das Problem gelöst wurde." Die Lücke zwischen Deflection und Lösung hat ihren eigenen Artikel.
So sieht das von der Betreiberseite aus, von einem Team, das einen selbst gehosteten Support-Bot betreibt:
"just ast week a customer sent a screenshot where the bot told him accidental damage was covered under warranty and we'd repair it for free. It isn't and we don't. The doc it pulled was about the extended plan, which he doesn't have, and the bot blended the two we had to honor it ... haunting part is nothing in our logs looked obviously wrong. The answer was fluent and on topic, it was just built on the wrong chunk"

eesel hat dasselbe Muster in eigenen Rollouts gesehen. In einem Testlauf beobachtete ein B2B-Technik-Support-Team, wie der Agent Kunden erzählte, ein Produkt werde unterstützt, obwohl das nicht stimmte, weil ein Hilfeartikel wortwörtlich sagte: "wir unterstützen alle Modelle." Der Agent hat sich das nicht ausgedacht. Er hat einen zu allgemeinen Satz gelesen und ihn selbstbewusst wiederholt. Ein solcher Fehler zeigt sich erst, wenn eine Person das Gespräch neben der Quelle liest.
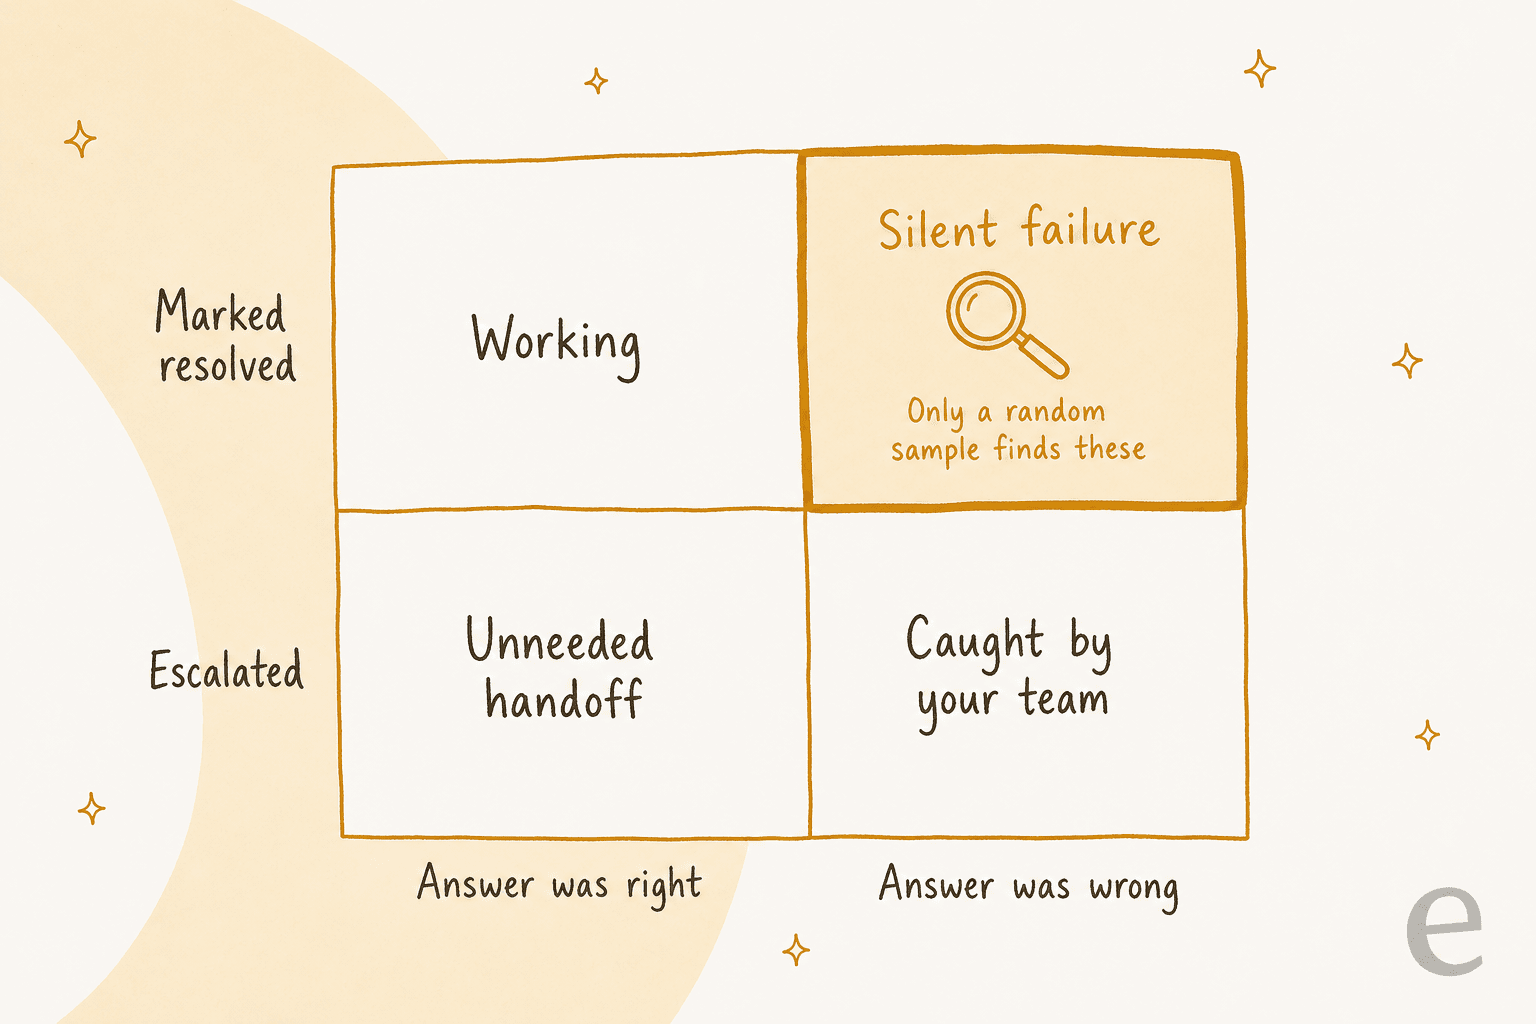
Eskalationen landen ohnehin vor deinem Team. Die stillen Fehler im oberen rechten Feld nicht, weshalb die Routine unten einen Teil ihrer Zeit auf Gespräche verwendet, die unauffällig wirken. Das ist eine andere Aufgabe als Support-QA für menschliche Mitarbeiter: Du coachst keine Person, du findest heraus, welche Eingabe an den Agenten falsch war.
Wenn dein Team Coding-Agenten einsetzt, lässt die eesel-CLI einen davon an diesem Kreislauf teilnehmen. Nachdem du eine Regel korrigiert hast, kann der Agent die Korrektur mit eesel chat senden, die gespeicherte Regel mit eesel instructions zurücklesen und dann die Fragen aus den fehlgeschlagenen Tickets erneut stellen und die Antworten prüfen, bevor sich etwas für Kunden ändert. Den Helpdesk überhaupt erst zu verbinden, braucht weiterhin jemanden mit Admin-Zugriff, der das genehmigt.
Welche KI-Supportgespräche solltest du dir vornehmen?
Du kannst nicht alles lesen, und du solltest es auch nicht versuchen. Eine CX-Leitung bei einer Nahrungsergänzungsmittelmarke mit rund 7.000 Tickets im Monat hat es in einem Gespräch mit dem Vertriebsteam von eesel klar gesagt:
"The AI will never be able to answer 100% of the questions, but if it tries and just answers 'sorry I don't know this,' I cannot go and check all my 7,000 tickets to see if the AI actually made a good answer"
Mit der Mathematik hat sie recht. Die Antwort ist ein Stichprobenplan mit zwei Teilen: Lies jedes Gespräch in den riskanten Eimern, und nimm eine kleine Zufallsstichprobe aus dem großen "gelöst"-Eimer.
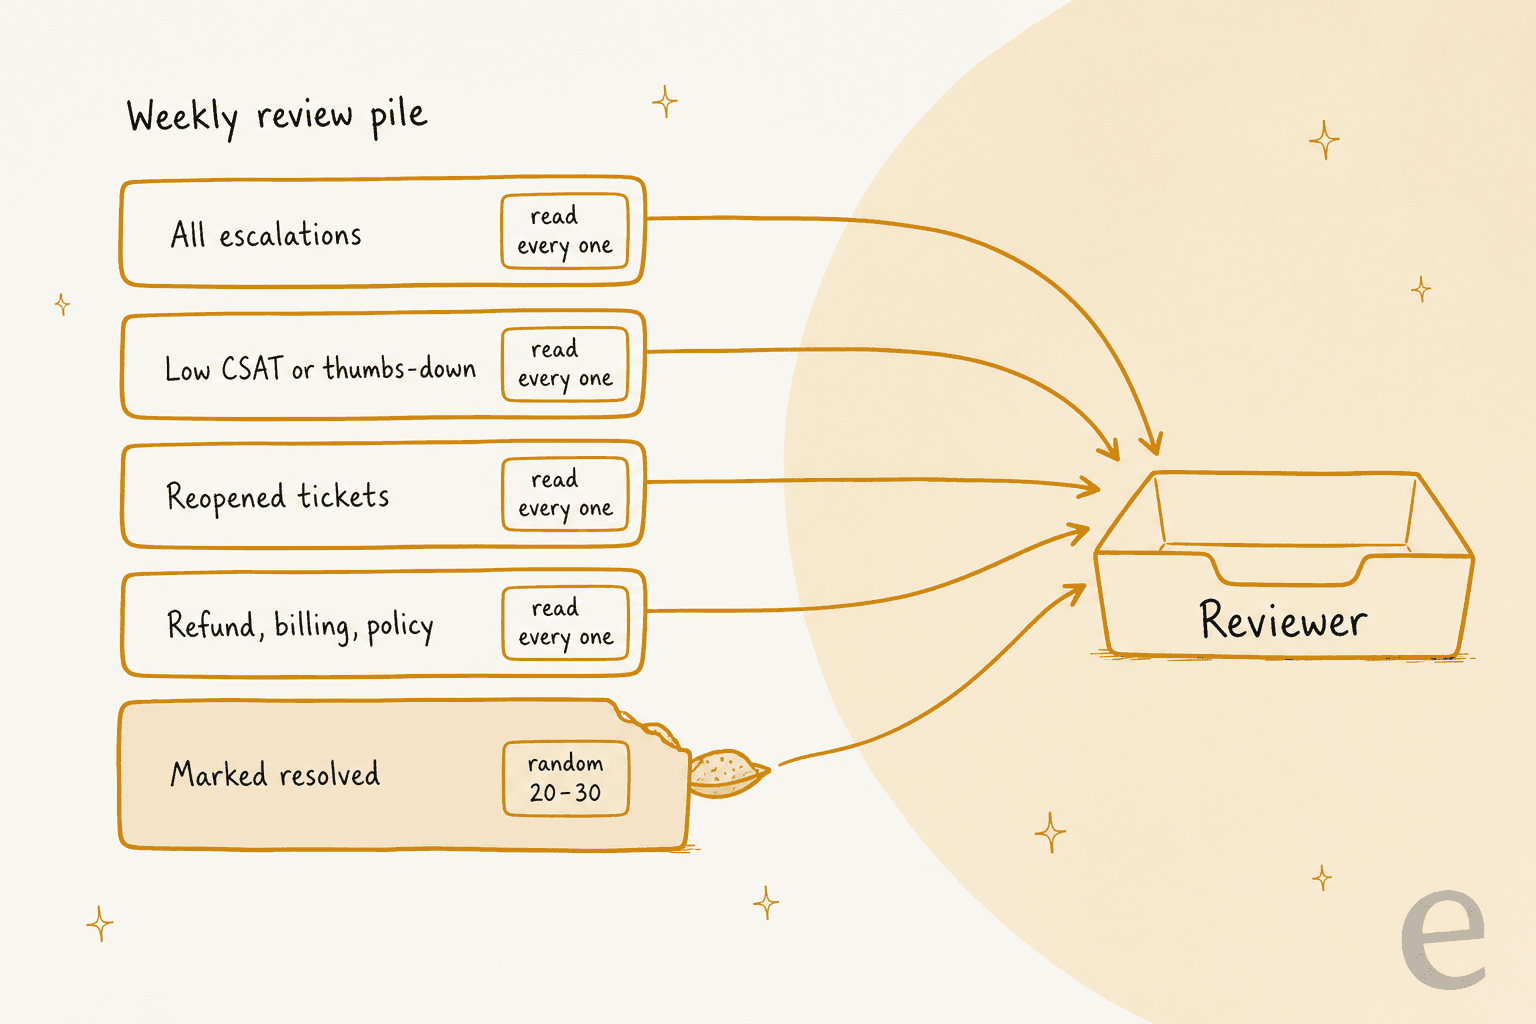
| Eimer | Wie viele lesen | Warum er im Stapel landet |
|---|---|---|
| Alle Eskalationen und Übergaben | Jede | Zeigt, was der Agent nicht konnte, und ob er zu früh oder zu spät aufgegeben hat |
| Niedriger CSAT oder Daumen runter | Jede | Kunden sagen dir, dass etwas schiefgelaufen ist, selbst wenn das Ticket geschlossen wurde |
| Wiedereröffnete Tickets | Jede | Die Antwort hat nicht gehalten. Oft eine falsche oder unvollständige Antwort, die als gelöst markiert wurde |
| Erstattungs-, Abrechnungs- und Richtlinienthemen | Zunächst jede | Eine falsche Antwort kostet hier Geld oder ein Versprechen, das du einhalten musst |
| Zufällige Stichprobe aus "gelöst" | 20 bis 30 pro Woche | Der einzige Weg, stille Fehler zu finden |
Ein Hinweis zu CSAT: Ein KI-generierter Zufriedenheitswert ist nicht dasselbe wie den Kunden zu fragen. eesels eigene Dokumentation sagt "KI-CSAT ist kein Kundenfeedback" auf der Reports-Seite, und behandelt es nur als internes Signal. Nutze echtes CSAT für KI-Feedback, wo du es hast.
Wo du diese herbekommst, hängt von deinem Helpdesk ab, und jeder große Anbieter hat inzwischen einen Platz dafür:
- Zendesk. Konversationsprotokolle liegen unter Optimize > Monitoring > Conversation logs und zeigen standardmäßig die letzten 7 Tage. Die Filter passen gut auf die Eimer oben: nicht verstandene Nachrichten, Abbrüche, fehlgeschlagene Eskalation, BSAT, und ob eine Wissensantwort genutzt wurde. Der Leitfaden zu Zendesk-Konversationsprotokollen geht sie durch.
- Freshdesk. Im AI Agent Studio filtert Analyze > Ticket logs nach Status, einschließlich Übergabe an einen Agenten, und trennt echte Gespräche von Vorschau-Tests. Freshdesks eigener Rat lautet, dass "das Lesen von zwei oder drei echten Gesprächen der schnellste Weg ist", um zu bestätigen, dass ein Thema scheitert (Freshdesk-Dokumentation). Mehr zur Analyse hier.
- Gorgias. Die Ticketansicht des AI Agent hat einen Bereich To review, der jedes Ticket sammelt, bei dem AI Agent eine Antwort gesendet hat, sowie einen Tag
ai_failed_actionfür fehlgeschlagene Aktionen (Gorgias-Dokumentation). Ein Ticket, das sowohl mitai_answeredals auch mitai_handovergetaggt ist, lohnt sich zuerst zu lesen: Es hat geantwortet und trotzdem eskaliert. - HubSpot. Der Customer Agent gruppiert Fehler unter Analyze > Coaching opportunities, mit der genauen Nachricht, die er nicht beantworten konnte, rot markiert.
Ein praktisches Detail: Die letzten 72 Stunden sind noch in Bewegung. Gorgias rechnet eine Interaktion erst als automatisiert ab, sobald 72 Stunden vergangen sind ohne menschliche Übergabe, und HubSpot wartet dieselben 72 Stunden. Nimm für alles, was du zählen willst, die Gespräche der letzten Woche, nicht von gestern.
Was solltest du in jedem Gespräch prüfen?
Sechs Checks pro Gespräch. Die meisten dauern Sekunden, sobald du dich daran gewöhnt hast. Der langsame ist die Quellenprüfung, und er ist derjenige, der die Garantie-artigen Fehler fängt.
| Check | Worauf du achtest | Warnsignal |
|---|---|---|
| Richtige Antwort | Hätte dein bester Mitarbeiter dasselbe gesagt? | Richtiges Thema, falsches Detail (Tarif, Region, Datum, Betrag) |
| In einer Quelle verankert | Welchen Artikel, welches Makro oder welches alte Ticket hat sie genutzt? | Keine Quelle, die falsche Quelle oder zwei vermischte Quellen |
| Richtlinie befolgt | Erstattungsfristen, Berechtigung, was genehmigt werden muss | Etwas versprochen, das deine Richtlinie nicht erlaubt |
| Aktionen korrekt ausgeführt | Erstattungen, Kündigungen, Tags, Bestellabfragen | Eine Aktion auf die falsche Bestellung ausgeführt oder lautlos fehlgeschlagen |
| Übergabezeitpunkt | Wann eskaliert wurde und was die Übergabenotiz sagte | Weitergeschleift, nachdem der Kunde nach einer Person gefragt hat, oder die Notiz passt nicht zum Transkript |
| Ton | Klingt es wie dein Team? | Übertriebenes Entschuldigen, robotisch oder fröhlich bei einem verärgerten Kunden |
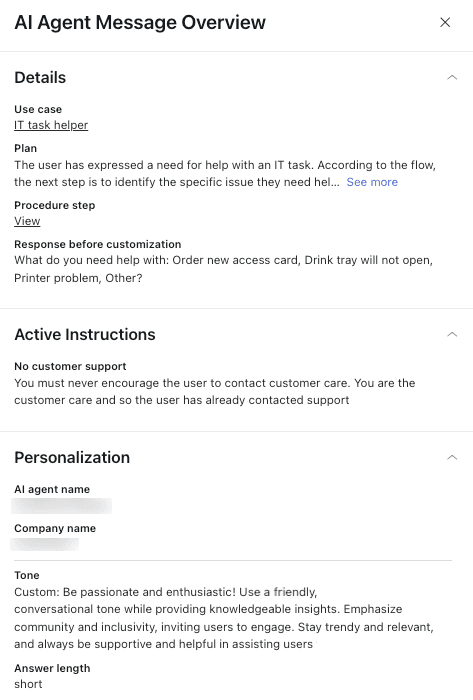
Die Quellenprüfung braucht den Arbeitsweg des Agenten, nicht nur seine Antwort. Zendesks View details pro Nachricht zeigt den Plan des Agenten, die Antwort vor der Anpassung und die Active instructions, denen er gefolgt ist, womit du ein Wissensproblem von einem Anweisungsproblem unterscheidest.
Bei der Richtlinienprüfung achte besonders auf Geld. Wenn dein Agent Erstattungen auslösen kann, lies im ersten Monat jedes Erstattungsgespräch, ob markiert oder nicht. Der Beitrag zu Erstattungs-Leitplanken behandelt, welche Grenzen in die Einstellungen gehören statt in den Prompt.
Behandle die Übergabenotiz als eigenen Check. Es ist leicht, die Antwort der KI zu lesen, zu sehen, dass eskaliert wurde, und weiterzugehen. Aber auch die Notiz, die dein menschlicher Mitarbeiter bekommt, kann falsch sein:
"My place added an AI bot that handles the chat first and gives the summary of what the client said to the agent, but the thing is, its summaries are often just lies that it hallucinated lol. It just makes up stuff that the customer never said, and you still have to check the whole history."
Vergleiche die Zusammenfassung mit dem Transkript. Wenn sie nicht übereinstimmen, ist das ein Fehler, selbst wenn die Eskalation an sich richtig war. Der Beitrag zu den Best Practices für Übergaben behandelt, was eine gute Notiz enthält.
Der Ton ist der letzte Check und der am leichtesten überbewertete. Eine leicht steife, aber korrekte Antwort schlägt eine warme, falsche. Behebe den Ton gesammelt, sobald du mehrere Beispiele hast, mit einer Markenstimme-Regel statt mit Einzelkorrekturen.
Wie benennst du, was schiefgelaufen ist?
Sobald ein Gespräch einen Check nicht besteht, gib ihm eine Fehlerursache. Das Label entscheidet, wohin der Fix geht, und der übliche Fehler ist, alles im Prompt zu reparieren. Ich nutze vier Labels:
- Fehlendes oder veraltetes Wissen. Die Tatsache stand in keiner Quelle, oder die Quelle war falsch.
- Anweisungslücke. Die Fakten waren richtig, aber der Agent hat damit das Falsche gemacht.
- Falsche Aktion oder Berechtigung. Er hat eine Aktion ausgeführt, übersprungen oder verpfuscht, oder durfte etwas, das er nicht sollte.
- Hätte übergeben werden müssen. Er hat weitergemacht, obwohl eine Person hätte übernehmen sollen, oder etwas übergeben, das er hätte beantworten können.
Dein Helpdesk hat davon vielleicht schon eine Version. HubSpots Coaching Opportunities sortieren Fehler nach Reason: Knowledge, Handoff, Experience, Action und Other (HubSpot-Dokumentation). Zendesk lässt dich Labels zu Gesprächen hinzufügen und warnt vor einem eigenen Label pro Gespräch, da Labels "dazu gedacht sind, Gespräche zur Analyse zu gruppieren". Halte deine Labels auf eine kurze, feste Liste, damit die Zählungen etwas bedeuten.
Eine Falle, die du kennen solltest: In manchen Tools ändert eine Bewertung den Agenten überhaupt nicht. Gorgias sagt, seine Bad-, Okay- und Good-Bewertungen "ändern nicht sofort, wie sich AI Agent in Gesprächen mit deinen Kunden verhält"; um das Verhalten zu ändern, bewertest du stattdessen oder fügst Quellen hinzu (Gorgias-Dokumentation). Zendesks eingebaute Feedback-Optionen für generative Antworten (Incomplete answer, Made-up facts, Missing article und so weiter) gehen an Zendesks KI-Forscher. Beides ist nützlich, aber keines ist ein Fix auf deiner Seite.
Wähle unten einen Fehlertyp, um zu sehen, wie er in einem Transkript aussieht, wohin der Fix in jedem Helpdesk geht, und wie du ihn erneut testest.
Wähle einen Fehlertyp, um zu sehen, wohin sein Fix in Zendesk, Freshdesk, Gorgias, HubSpot und eesel geht.
Der beste Beweis für diesen Ansatz, den ich kenne, ist Qontro, das ERP-Software herstellt und eesel auf Freshdesk als Co-Pilot betreibt. Das Team vergleicht jeden eesel-Entwurf mit der Antwort, die eine Person tatsächlich gesendet hat. Wenn der Entwurf falsch war, deutet das meist auf einen fehlenden oder unvollständigen Hilfeartikel hin oder auf eine Regel, die gestrafft werden muss, und das beheben sie, statt das einzelne Ticket. Etwa jeder zehnte Entwurf geht inzwischen mit wenig bis keiner Bearbeitung hinaus, und der Anteil steigt langsam. Das sind die vier Labels in der Praxis, bei rund 190 Freshdesk-Tickets, die pro Monat entworfen werden.
Wenn ein Label immer wieder auftaucht, geh einen Schritt von einzelnen Tickets zurück. Viel "fehlendes oder veraltetes Wissen" bedeutet, dass es Zeit für ein Knowledge-Base-Audit ist, und KI kann helfen, veralteten Inhalt zu erkennen, bevor der Agent ihn wiederholt.
Wie behebst du es und testest es erneut, bevor es live geht?
Behebe es an der Quelle, auf die das Label zeigt, und spiele dann dieselben vergangenen Tickets, die fehlgeschlagen sind, erneut durch. Nicht neu erfundene Fragen, die echten Tickets. Ein Fix, der deine eigene Testfrage besteht, kann trotzdem an der Formulierung des Kunden scheitern, und die fehlgeschlagenen Tickets sind genau die Formulierung, von der du schon weißt, dass sie Dinge kaputt macht.
Ein Kommentator beschrieb die Angewohnheit, die das zusammenwachsen lässt:
"Keep the transcript reads too, but let them compound instead of evaporate: every escalation like this becomes a case in a small regression set, re-run on every prompt, chunking, or model change, so the failure classes you've already paid for stay fixed."
Jeder Helpdesk testet ein bisschen anders erneut, und der Unterschied ist wichtig:
| Tool | Wo du erneut testest | Was die Testfragen sind |
|---|---|---|
| Zendesk | Test-Widget und der Conversation Simulator | Szenarien aus einer Bibliothek oder selbst geschriebene |
| Freshdesk | Test-Tab, bis zu 100 Anfragen pro Lauf | Eingefügte Anfragen oder 50, die aus deinem Wissen generiert wurden |
| Gorgias | Playground, einschließlich Draft Skills und Artikel | Nachrichten, die du eingibst, als neuer oder bestehender Kunde |
| HubSpot | Batch Testing, bis zu 8 Testsets | Generiert aus echten Gesprächen (5+ ähnliche pro Thema) oder von dir geschrieben |
| eesel | Helpdesk-Simulation | Deine gelösten, vergangenen Tickets, bewertet gegen das, was dein Team gesendet hat |
Gorgias fügt eine Warnung hinzu, die sich lohnt, in dein eigenes Runbook zu kopieren: Wenn du Aktionen in einem Test einschaltest, "können sie echte Kunden- und Bestelldaten beeinflussen" (Gorgias-Dokumentation). Nutze ein Fake-Kundenprofil.
Der Grund, warum eesel mit vergangenen Tickets arbeitet, ist, dass das dem Nächsten kommt, was einem Probelauf auf deiner echten Queue am ähnlichsten ist. Die Simulation spielt gelöste Tickets erneut durch, entwirft zu jedem eine Antwort, stellt sie neben das, was dein Team gesendet hat, und gruppiert die Ergebnisse nach Thema. "Es sendet nichts an Kunden", laut eesels Dokumentation. Der Beispiellauf in der Helpdesk-Dokumentation hat 20 gelöste Tickets gestichprobt, 17 davon getroffen und fünf eingestufte Fixes zurückgegeben. Diese 3-von-20-Trefferliste ist genau der Prüfstapel, den du willst, bevor Kunden irgendetwas sehen.
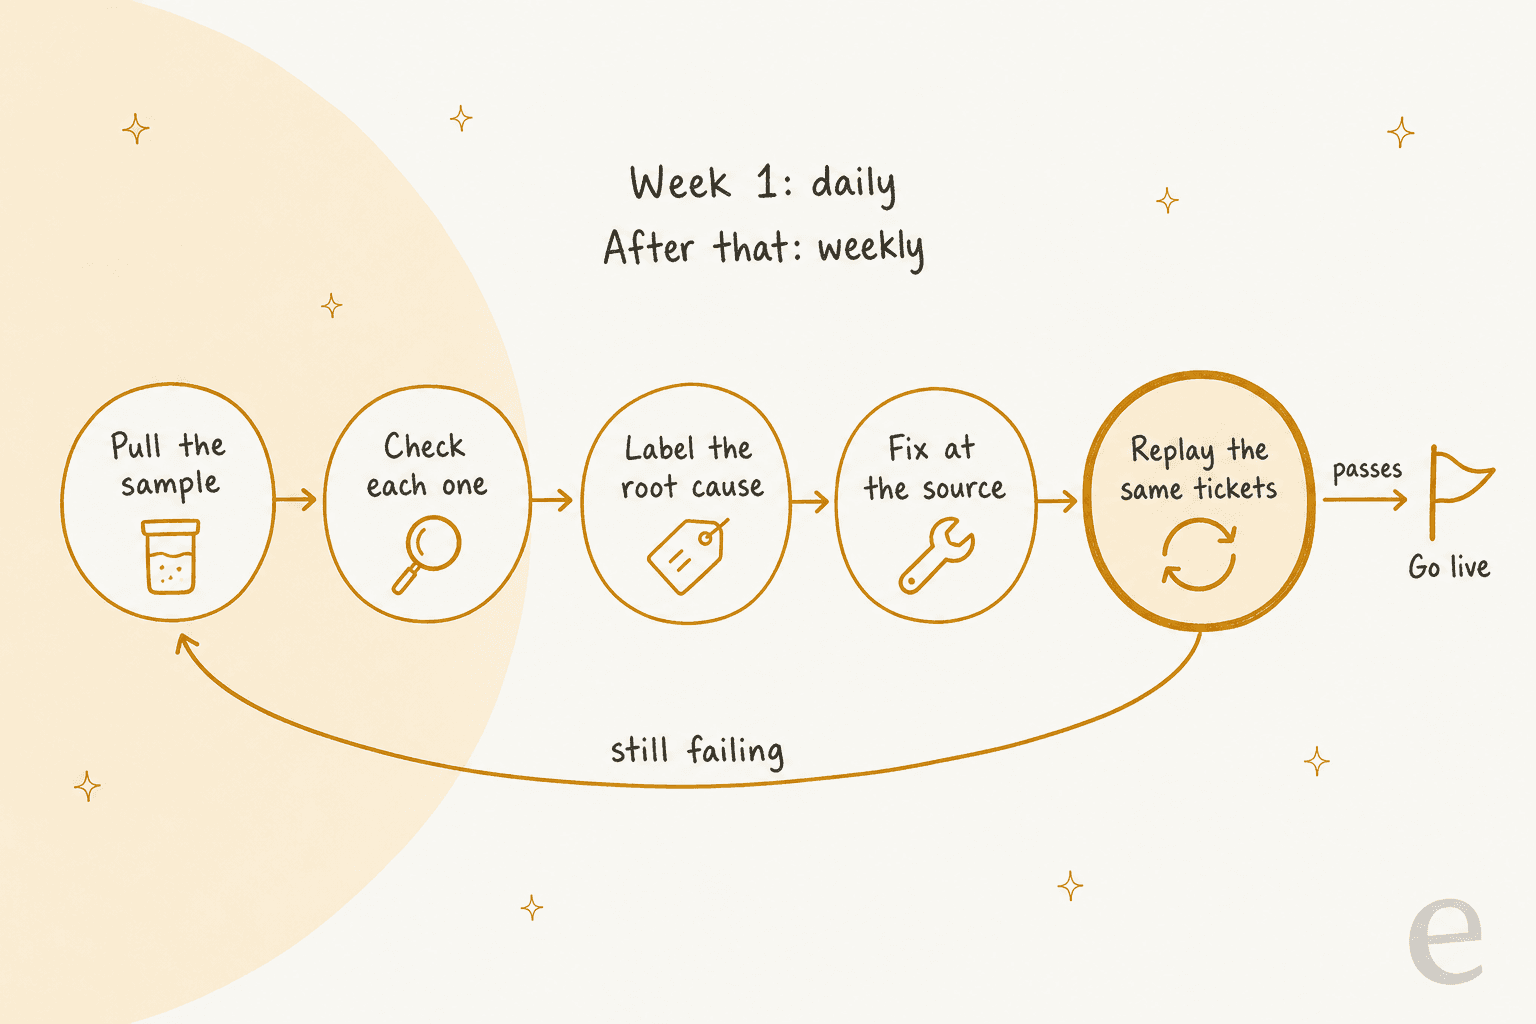
Geh erst live, wenn der Replay besteht. Wenn es immer noch scheitert, war das Label wahrscheinlich falsch, das passiert. Ein "fehlendes Wissen"-Fehler, der auch nach dem Hinzufügen des Artikels bleibt, kann eine Anweisung sein, die dem Agenten sagt, eine andere Quelle zu bevorzugen. Mehr zum Testdesign im Leitfaden zum Testen von KI-Support-Agenten.
Wie oft solltest du KI-Supportgespräche überprüfen?
Täglich in der ersten Woche, dann wöchentlich. Das ist der Takt, mit dem ich bei jedem neuen Agenten anfangen würde, oder bei jedem Agenten, dem du gerade einen neuen Kanal oder eine neue Aktion gegeben hast.
Woche eins, täglich. Lies jedes markierte Gespräch und etwa 10 zufällige gelöste pro Tag. Fehler ballen sich früh, weil die ersten echten Kunden die Lücken finden, die deine Testfragen übersehen haben.
Danach wöchentlich. Jedes markierte Gespräch plus 20 bis 30 zufällige gelöste, und ein Blick auf die Label-Zählungen. Wenn die Zählung eines Labels nach einem Fix sinkt, hat er funktioniert. Wenn die Zufallsstichprobe drei oder vier Wochen lang keine Fehler mehr findet, verkleinere sie, aber nie auf null.
Geh nach jeder großen Änderung zurück auf täglich. Ein neuer Kanal, eine neue Aktion, ein Modellwechsel oder ein großer Wissensimport setzt die Uhr zurück.
Wie viel du überprüfst, hängt auch davon ab, wie viel der Agent unbeaufsichtigt macht. Bei eesel ist jede Aktion auf On, Ask first oder Off gestellt, und die Aktionen-Dokumentation schlägt vor, beaufsichtigt zu starten und Routineaktionen auf On zu stellen, "sobald die Entwürfe durchgängig richtig sind". Eine Ausnahme: Live-Chat-Antworten sind immer On, weil niemand einen Live-Chat zur Genehmigung anhalten kann. Das macht Chat zu dem Kanal, bei dem die Zufallsstichprobe am meisten zählt.
Die Reports-Seite von eesel hat einen Approvals-Bereich, der dasselbe von der anderen Seite zeigt. Die Dokumentation sagt, eine Aktion, die "jedes Mal ohne Bearbeitung genehmigt wird, ist bereit, allein zu laufen", während eine, die "immer wieder abgelehnt wird, eine Anweisungskorrektur braucht".

Damit der wöchentliche Durchgang nicht ins Rutschen kommt, setze ihn auf einen Zeitplan. eesel hat einen Weekly digest-Skill, der behandelte Gespräche nach Thema und Kanal zusammenfasst, wartende Genehmigungen, und was übersprungen wurde und warum, und die Karte richtet ihn so ein, dass er jeden Montag gesendet wird (eesel-Dokumentation). Welches Tool du auch nutzt, der Digest sollte mit einer kurzen Liste von Gesprächen enden, die eine Person lesen soll, nicht nur mit Zahlen.
Welche Fehler lassen eine Review-Routine zusammenbrechen?
Die üblichen:
- Nur Eskalationen lesen. Du lernst, was der Agent nicht kann, und übersiehst, was er selbstbewusst falsch macht. Behalte die zufällige gelöste Stichprobe.
- Alles im Prompt reparieren. Eine fehlende Tatsache, die in die Anweisungen geschrieben wird, funktioniert für ein Ticket und wird am Tag veraltet, an dem sich die Richtlinie ändert. Fakten gehören in deine Wissensdatenbank oder Makros.
- Der Lösungsrate als Score vertrauen. Nutze sie, um zu entscheiden, wo du nachsiehst, nicht als Beweis, dass die Antworten richtig waren.
- Nur mit neuen Fragen erneut testen. Spiele die fehlgeschlagenen Tickets erneut durch. Sonst beweist du nie, dass der Fix bei der Formulierung funktioniert hat, die ihn kaputt gemacht hat.
- Kein Verantwortlicher. Reviews, die erledigt werden, "wenn jemand Zeit hat", hören leise auf. Benenne eine Person pro Woche, und nutze QA-Kalibrierung, wenn sich mehrere Leute die Arbeit teilen, damit die Labels konsistent bleiben.
- Ein menschliches QA-Scorecard unverändert übernehmen. Scorecards, die für Menschen gebaut wurden, wie die in Zendesk QA, bewerten Empathie und Prozess. Füge die Quellen- und Aktionschecks hinzu, sonst bewertest du eine höfliche, falsche Antwort als bestanden.
Die Kosten, die Labels zu überspringen, zeigen sich schnell. Wenn ein Team nicht sagen kann, welche KI-Entscheidungen falsch sind, endet es damit, alle zu prüfen, wie dieser Hacker-News-Kommentar beschreibt:
"The AI would confidently misroute 15-20% of tickets, requiring human review of ALL AI decisions"

Überprüfe die Arbeit deines KI-Support-Agenten mit eesel
eesel ist ein KI-Helpdesk-Teammate, das sich deiner bestehenden Queue in Zendesk, Freshdesk, Gorgias oder HubSpot anschließt. Es wurde dafür gebaut, überprüft zu werden. Jeder Lauf landet in Activity mit einem Link zum Ticket, was ihn ausgelöst hat, welche Quellen er durchsucht hat, jede Aktion, die er ausgeführt hat, seine Begründung Schritt für Schritt, und ob er auf eine Wissenslücke gestoßen ist. Wenn eine Antwort falsch ist, öffnest du den Lauf und sagst ihm im Chat daneben, was zu ändern ist, und der Fix wandert in seine Anweisungen oder ein Memory.

Du kannst auch wählen, wie viel es allein macht, während du Vertrauen aufbaust. STIL Classics betreibt eesel auf Gorgias als Entwürfe: In einem Monat hinterließ es rund 430 interne Notizen, die meisten davon Antwortentwürfe, die das Team prüft und sendet, und wenn eine Tatsache fehlt, lässt der Entwurf eine Lücke in Klammern, statt zu raten. Das macht die Überprüfung schnell, weil die Lücken direkt auf das fehlende Wissen zeigen.
SamCart betreibt getrennte Agenten auf Freshdesk-Tickets und seinem Website-Chat, und wenn ein Verkäufer nach einer Person fragt oder die Frage über das Hilfe-Center hinausgeht, wird das Ticket für die Übergabe markiert und der Agent hört auf zu antworten. Dieser Tag gibt der wöchentlichen Überprüfung einen klaren Stapel zum Lesen.
Bevor etwas live geht, spielt die Simulation deine gelösten Tickets erneut durch und zeigt, wo Agent und Team nicht übereinstimmen, ohne dass etwas gesendet wird. Tarife starten bei 299 $ pro Monat für 500 Credits nach einer 7-tägigen kostenlosen Testphase, laut eesel-Preisen.
Probiere eesel an deinen eigenen vergangenen Tickets aus und sieh, wie dein Prüfstapel aussieht, bevor es deine Kunden tun.