

O GPT-6.2 Sol custa US$ 2 por milhão de tokens de entrada, US$ 0,10 em cache e US$ 10 de saída, exatamente o que custava o GPT-6.1 Sol. Por tarefa difícil, é cerca de 20% mais barato, porque usa menos tokens. Mas uma simples troca de modelo pode custar mais em dois pontos. No meu teste, o GPT-6.2 Sol não colocou nada em cache a partir do campo instructions de nível superior, enquanto o 6.1 Sol fazia isso, o que transforma US$ 5,45 por 1.000 tickets de suporte em US$ 29,20. E não há mais nível Flex, então os trabalhos que rodavam no 6.1 Sol Flex agora custam de 20% a 100% mais, a menos que migrem para a API Batch.
Quanto custa o GPT-6.2 Sol?
O GPT-6.2 Sol custa US$ 2 por milhão de tokens de entrada e US$ 10 por milhão de tokens de saída no nível Standard, com a entrada em cache a US$ 0,10. A OpenAI o lançou em 17 de novembro de 2026 junto com o GPT-6.2 Astra, e o post de lançamento diz que ele "mantém as taxas do GPT-6.1 Sol". Se você se interessa pelo modelo em si, o resumo do GPT-6.2 Sol cobre o que mudou e como ele se sai nos benchmarks.
Se você está avaliando preços para uma fila de suporte, um colega de IA do helpdesk como a eesel pula o medidor de tokens, e com a CLI da eesel um agente de código pode subir artigos de ajuda aprovados e testar perguntas contra eles antes de qualquer coisa ir ao ar. Conectar o helpdesk em si ainda precisa que um admin aprove.
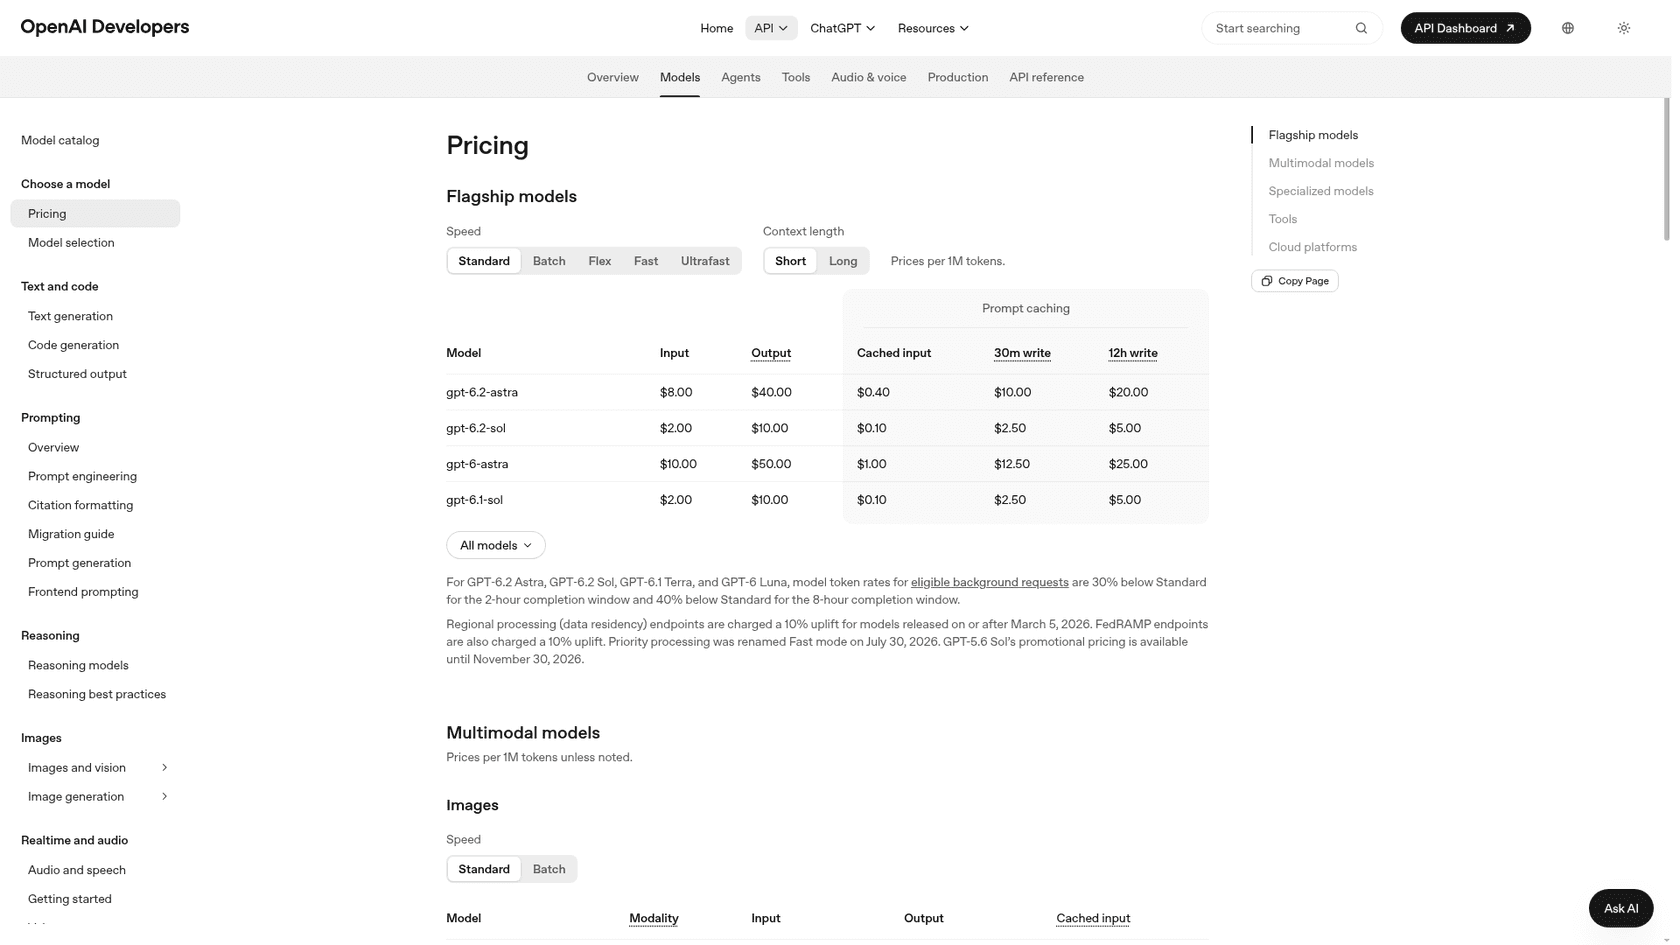
Eu passo boa parte da semana olhando como as pessoas buscam preços de modelos, e a pergunta por trás de "preços do GPT-6.2 Sol" é quase sempre a mesma: essa atualização vai mudar minha conta? Então eu precifiquei do jeito que a eesel precifica um agente de suporte, por ticket, e fiz meu próprio teste de cache nas duas versões do Sol. Aqui está cada medidor da página de preços da OpenAI e da página do modelo GPT-6.2 Sol, por milhão de tokens:
| Nível | Entrada | Entrada em cache | Escrita de cache 30 min | Escrita de cache 12 h | Saída |
|---|---|---|---|---|---|
| Standard | US$ 2,00 | US$ 0,10 | US$ 2,50 | US$ 5,00 | US$ 10,00 |
| Standard, mais de 272.000 na entrada | US$ 4,00 | US$ 0,20 | n/a | n/a | US$ 15,00 |
| Batch | US$ 1,00 | US$ 0,05 | US$ 1,25 | US$ 2,50 | US$ 5,00 |
| Background, janela de 8 horas | US$ 1,20 | US$ 0,06 | US$ 1,50 | US$ 3,00 | US$ 6,00 |
| Background, janela de 2 horas | US$ 1,40 | US$ 0,07 | US$ 1,75 | US$ 3,50 | US$ 7,00 |
| Fast | US$ 4,00 | US$ 0,20 | US$ 5,00 | US$ 10,00 | US$ 20,00 |
| Ultrafast (até 28 fev 2027) | US$ 6,00 | US$ 0,30 | US$ 7,50 | US$ 15,00 | US$ 30,00 |
| Ultrafast (a partir de 1º mar 2027) | US$ 12,00 | US$ 0,60 | US$ 15,00 | US$ 30,00 | US$ 60,00 |
| Flex | Não oferecido |
As linhas de background são meu cálculo a partir da regra da OpenAI de que solicitações em segundo plano elegíveis rodam "30% abaixo do Standard na janela de 2 horas e 40% abaixo do Standard na janela de 8 horas". A linha de contexto longo vem da página do modelo: além de 272.000 tokens de entrada, as taxas de entrada e cache dobram e a saída custa 1,5 vez a taxa de contexto curto para a solicitação inteira. Ela não lista preços de escrita de cache em contexto longo, então deixei esses campos em branco.
O modelo tem uma janela de contexto de 1.050.000 tokens, 922.000 tokens de entrada no máximo, 128.000 tokens de saída no máximo e um corte de conhecimento em 1º de junho de 2026. A API também "rejeita solicitações que definem o esforço de raciocínio como none", então low é a configuração mais barata que você pode escolher. Endpoints regionais de residência de dados custam 10% extra, como em qualquer modelo lançado depois de 5 de março de 2026.
Pelo que você é cobrado exatamente?
Cada solicitação do GPT-6.2 Sol cai em até quatro medidores, com preços muito diferentes:
- Entrada nova a US$ 2 por milhão: a mensagem do cliente e qualquer outra coisa que tenha mudado.
- Entrada em cache a US$ 0,10 por milhão: a parte no início do prompt que coincide exatamente com uma solicitação recente.
- Escritas de cache a US$ 2,50 (30 minutos) ou US$ 5 (12 horas) por milhão: a primeira vez que um prefixo reutilizável é salvo.
- Saída a US$ 10 por milhão: a resposta mais qualquer token de raciocínio oculto, que o guia de raciocínio da OpenAI cobra como saída.
O guia de cache de prompts da OpenAI diz que escritas de cache "não são uma taxa adicional": cada token de entrada é cobrado uma única vez, em uma das três taxas de entrada. As leituras no GPT-6.2 Sol custam "0,05 vez a taxa de entrada normal", um desconto de 95%, enquanto a maioria dos outros modelos recentes da OpenAI tem 90%. O prefixo mínimo que pode ir para cache é de 1.024 tokens.
Isso faz um token em cache custar um vigésimo do preço de um token novo. Em qualquer app que envia as mesmas instruções ou o mesmo conhecimento a cada chamada, a taxa de acerto de cache importa mais que o preço de tabela. Por isso o próximo resultado me surpreendeu.
O GPT-6.2 Sol realmente coloca seu prompt em cache?
Só se o prompt estiver no lugar certo. Testei isso em 18 de novembro de 2026 pela API Responses: um centro de ajuda de 8.300 tokens para uma empresa SaaS fictícia, três perguntas diferentes de clientes em sequência, esforço baixo, cada caso executado duas vezes nos dois modelos Sol. A única variável foi onde o centro de ajuda ficava.
| Modelo | Posição do prompt | Chamada 1 | Chamadas 2 e 3 |
|---|---|---|---|
| GPT-6.1 Sol | instructions de nível superior | 8.295 tokens escritos no cache | 8.283 tokens lidos do cache |
| GPT-6.1 Sol | Mensagem developer | 8.295 escritos | 8.283 lidos |
| GPT-6.2 Sol | instructions de nível superior | 0 escritos | 0 lidos |
| GPT-6.2 Sol | Mensagem developer | 8.295 escritos | 8.283 lidos |
As duas rodadas deram números idênticos. Então o mesmo código que colocava tudo em cache perfeitamente no GPT-6.1 Sol para de fazer isso no instante em que você muda o ID do modelo para gpt-6.2-sol, sem erro nenhum. Você passa a pagar US$ 2 por milhão em cada token de prompt em vez de US$ 0,10. O teste da eesel no dia do lançamento do GPT-6.2 Astra mostrou o mesmo comportamento, então parece ser uma mudança de toda a geração 6.2, não uma peculiaridade do Sol.
A documentação da OpenAI aponta na mesma direção sem dizer isso diretamente. O guia de cache observa que "as instructions de nível superior não podem conter um ponto de interrupção explícito", e que instruções developer reutilizáveis vão "em um bloco input_text dentro de uma mensagem developer". O post de lançamento também recomenda "manter os prefixos de prompt inalterados e anexar novas instruções".
Aqui está o que isso faz com um agente de suporte que reaproveita um prompt de 12.500 tokens (instruções mais conteúdo do centro de ajuda) com 600 tokens de entrada nova e 300 tokens de saída por ticket:
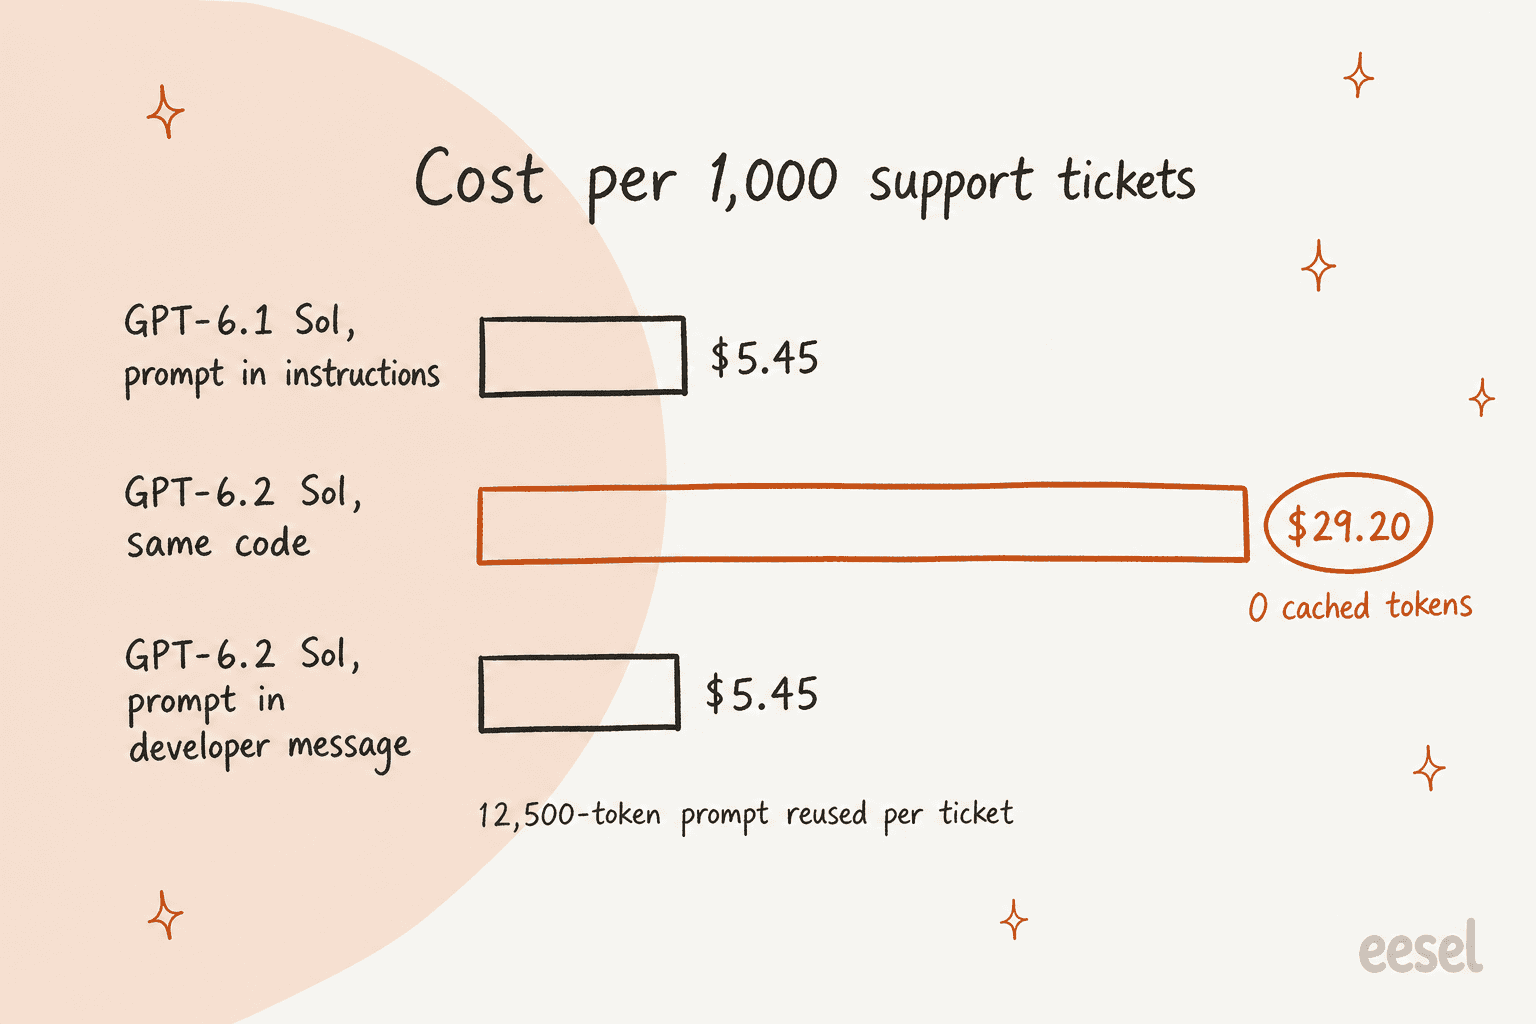
Isso é um salto de 5,4 vezes por ticket causado por uma atualização de modelo que deveria ser neutra em preço. A correção são poucas linhas: mova o prompt para uma mensagem developer e depois confira cached_tokens no bloco usage das suas primeiras chamadas. Se você migrou direto do GPT-5.6 Sol ou de versões anteriores, o guia de migração da OpenAI também recomenda substituir prompt_cache_retention por prompt_cache_options.ttl.
O que aconteceu com o preço Flex?
O GPT-6.2 Sol não tem. A tabela Flex da OpenAI lista o GPT-6.1 Sol a US$ 1/US$ 5, junto com GPT-6 Astra, GPT-6.1 Terra e GPT-6 Luna, mas sem linha para o 6.2 Sol:
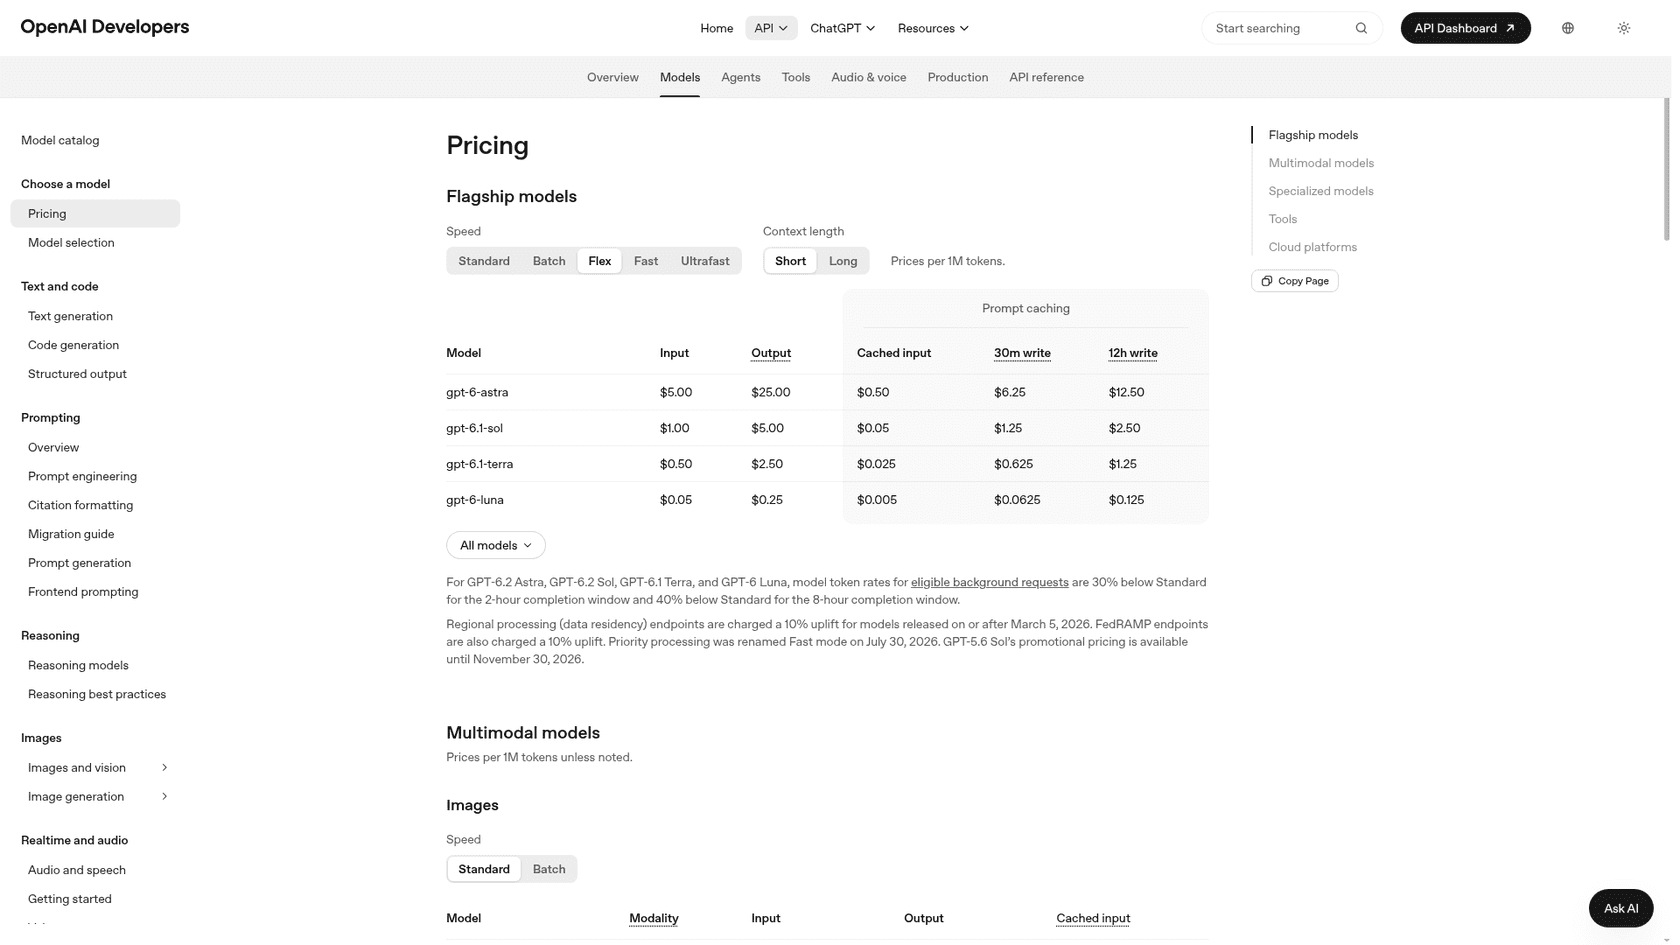
Desenvolvedores notaram isso poucas horas depois do lançamento:
"Did they remove the flex pricing? I see it here:- https://developers.openai.com/api/docs/models/gpt-6.1-sol but not here:- https://developers.openai.com/api/docs/models/gpt-6.2-sol"

O Flex importava porque precificava tokens "nas taxas da API Batch", segundo o guia Flex da OpenAI, enquanto ainda respondia a uma chamada normal de API, só que mais lenta e com "disponibilidade de recursos ocasional". Servia para evals, enriquecimento de dados e trabalhos noturnos. No GPT-6.2 Sol, esses trabalhos têm três rotas de desconto, cada uma com uma pegadinha:
- API Batch (50% de desconto). Mesmo preço do antigo Flex, mas você envia um arquivo e recolhe os resultados depois, então o código muda.
- Background, janela de 8 horas (40% de desconto). Uma flag em uma chamada normal da Responses, mas 20% mais caro que o Flex.
- Background, janela de 2 horas (30% de desconto). Mais rápido, mas 40% mais caro que o Flex.
Segundo o guia de background da OpenAI, as janelas com desconto estão em beta público, exigem processamento Standard e compartilham o limite de taxa do Batch. Também há uma pegadinha de cache: "solicitações Standard fora das janelas de conclusão com desconto não podem reaproveitar entradas de cache de prompt criadas por solicitações em segundo plano de 2h ou 8h, mesmo quando o prompt é idêntico". Então você não pode esquentar um cache durante a noite e lê-lo barato a partir do seu app em produção.
Aqui está um trabalho noturno, marcando 50.000 tickets antigos com cerca de 2.000 tokens de entrada e 200 de saída cada:
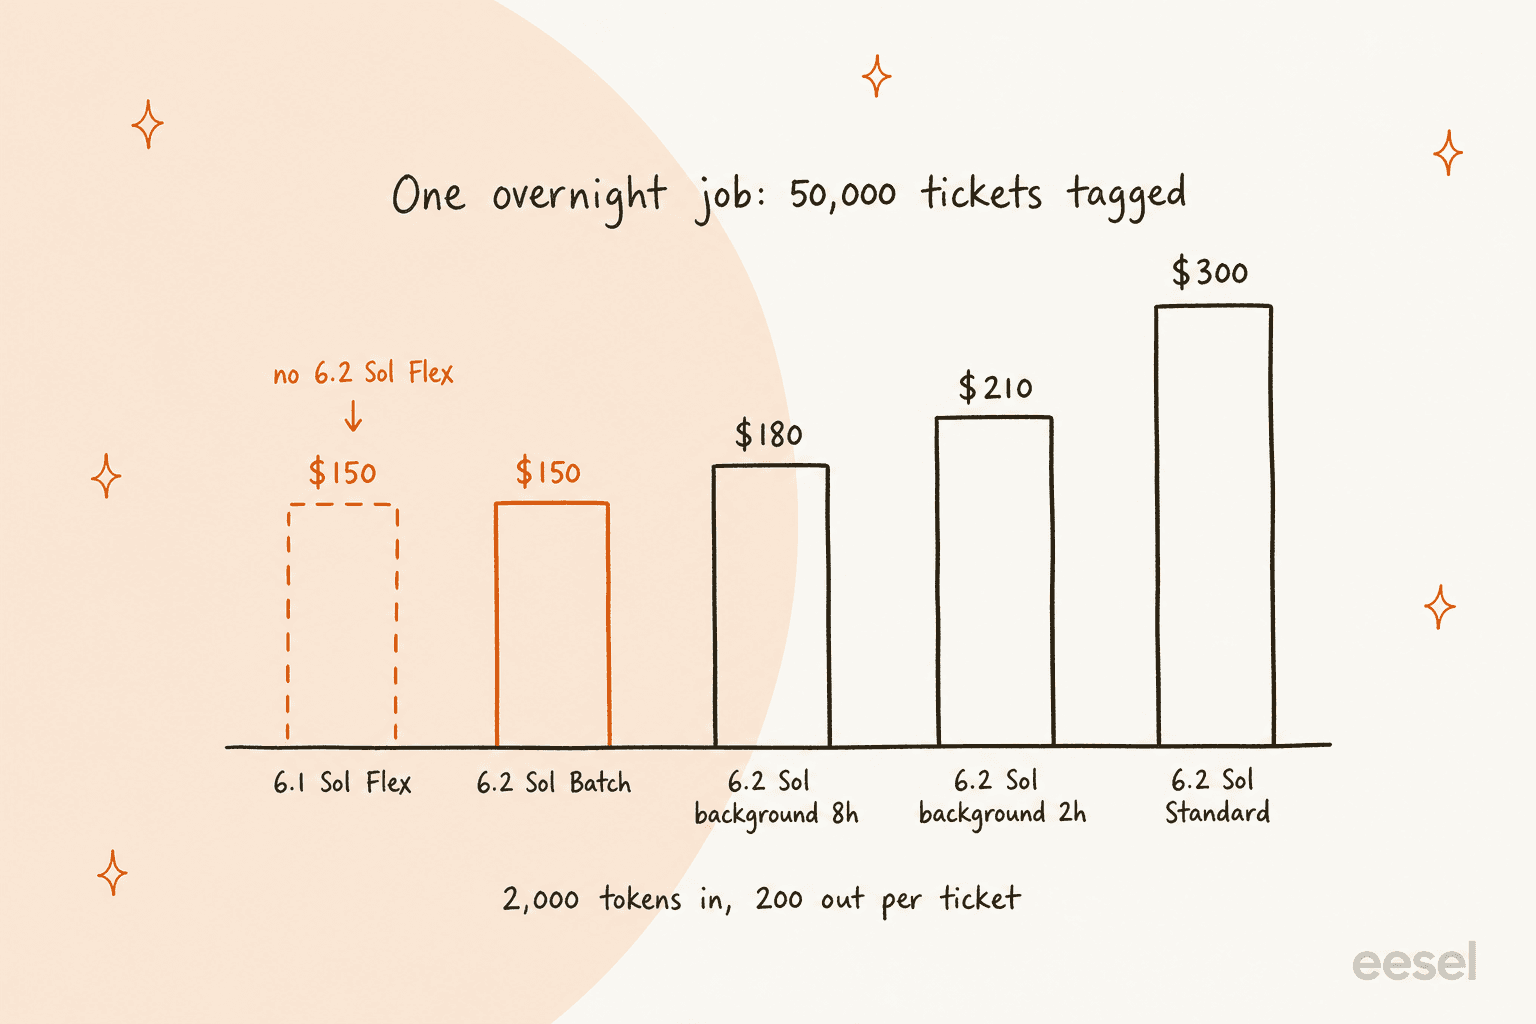
Se um trabalho assim rodar toda noite, a diferença entre Batch e Standard é de US$ 4.500 por mês. Para marcação pura ou triagem, um modelo menor pode ser a melhor economia: o GPT-6.1 Terra ainda tem Flex a US$ 0,50/US$ 2,50, e o GPT-6 Luna fica ainda mais barato.
O GPT-6.2 Sol é mais barato por tarefa que o GPT-6.1 Sol?
Em trabalho longo e difícil, sim, em cerca de 20%. Em respostas curtas, é um pouco mais caro. As duas coisas são verdadeiras, e o que você sente depende de quanto o modelo precisa pensar.
A Artificial Analysis coloca o custo de rodar seu Intelligence Index em US$ 1,01 por tarefa para o GPT-6.2 Sol contra US$ 1,27 para o GPT-6.1 Sol no esforço máximo, com uma pontuação de 57 contra 55. Mesmas taxas, menos tokens: a Artificial Analysis contou 60,9 milhões de tokens de saída para o 6.2 Sol em max contra 63,7 milhões para o 6.1 Sol. Ela também coloca o 6.2 Sol "no mesmo nível do GPT-6 Astra por cerca de 15% do custo por tarefa".
Respostas curtas de suporte contam outra história. No teste de 60 rodadas de tickets da eesel para a análise do GPT-6.2 Sol, com 15 tickets em esforço baixo e médio nos dois modelos, toda configuração passou nos 15:
| Configuração | Custo por 1.000 tickets | Tokens de saída médios |
|---|---|---|
| GPT-6.2 Sol, médio | US$ 1,42 | 60 |
| GPT-6.2 Sol, baixo | US$ 1,41 | 58 |
| GPT-6.1 Sol, médio | US$ 1,35 | 55 |
| GPT-6.1 Sol, baixo | US$ 1,32 | 52 |
O GPT-6.2 Sol escreveu respostas um pouco mais longas, e com o mesmo preço por token, isso explica a maior parte da diferença de 5% a 7%. Esses tickets usavam um prompt curto sem centro de ajuda, por isso são tão baratos ao lado do exemplo de 12.500 tokens acima.
No Hacker News, um desenvolvedor lendo os gráficos da OpenAI chegou à mesma conclusão sobre o trade-off de esforço:
"Looks like 6.1-sol high+ is equivalent to 6.2-sol medium at the same price. So a bit smarter at a cheaper cost."
Qual esforço de raciocínio você deveria pagar?
Para a maioria dos apps, médio. Tokens de raciocínio são cobrados como saída a US$ 10 por milhão, então o esforço é tanto um ajuste de preço quanto de qualidade. A Artificial Analysis contou esses tokens de saída em todo o seu Intelligence Index para o GPT-6.2 Sol:
| Esforço | Índice de Inteligência AA | Tokens de saída para rodar o índice | Saída vs max |
|---|---|---|---|
| Baixo | 41 | 7,2 M | 12% |
| Médio | 53 | 14,6 M | 24% |
| Alto | 55 | 22,7 M | 37% |
| Xhigh | 56 | 33,3 M | 55% |
| Max | 57 | 60,9 M | 100% |
O médio mantém 53 dos 57 pontos do max com um quarto dos tokens de saída. Ir de xhigh para max quase dobra a saída por apenas um ponto. O guia de migração da OpenAI também recomenda começar novas integrações em medium.
Em tarefas curtas como respostas de suporte, a configuração quase não se nota. As rodadas de esforço baixo e médio nesse teste de tickets custaram US$ 1,41 e US$ 1,42 por 1.000 tickets porque o modelo raciocina muito pouco antes de uma resposta de três frases de qualquer forma. Gaste seu tempo de ajuste no cache, não no esforço, a menos que seu agente rode trabalhos longos de vários passos.
Quanto custaria o GPT-6.2 Sol para o seu volume?
Insira seus próprios números na calculadora. Ela compara o GPT-6.2 Sol com o GPT-6.1 Sol e o GPT-6.2 Astra na mesma carga de trabalho, usando as taxas publicadas pela OpenAI. Falhas de cache são cobradas como escritas de cache de 30 minutos. O seletor de posição do prompt aplica o que vi no meu teste: nos modelos 6.2, um prompt no campo instructions de nível superior é cobrado como entrada nova em toda chamada.
Com os valores padrão, 8.000 solicitações por mês com uma taxa de acerto de cache de 95% custam US$ 55,60 no GPT-6.2 Sol. Mude a posição do prompt para o campo instructions e o mesmo mês custa US$ 233,60, enquanto o GPT-6.1 Sol fica em US$ 55,60. Mude o nível para uma janela de background e você verá a diferença do Flex da seção anterior.
Quanto custa o GPT-6.2 Sol em diferentes tamanhos de equipe?
Aqui está a carga de trabalho de suporte de 12.500 tokens em três volumes mensais, a taxas Standard. A coluna do meio assume que o prompt está em uma mensagem developer com 95% de taxa de acerto; a terceira mostra o que acontece quando ele está no campo instructions.
| Tickets por mês | GPT-6.2 Sol, em cache | GPT-6.2 Sol, campo instructions | GPT-6.2 Sol, Batch | GPT-6.2 Astra, em cache |
|---|---|---|---|---|
| 1.000 | US$ 6,95 | US$ 29,20 | US$ 3,48 | US$ 27,80 |
| 8.000 | US$ 55,60 | US$ 233,60 | US$ 27,80 | US$ 222,40 |
| 50.000 | US$ 347,50 | US$ 1.460,00 | US$ 173,75 | US$ 1.390,00 |
O Batch só se encaixa em trabalho que ninguém está esperando, como rascunhar resumos dos tickets da semana passada. Respostas em tempo real ficam no Standard. O detalhamento de preços do GPT-6.2 Astra mostra por que o Astra custa quatro vezes mais na mesma carga de trabalho.
Para dar uma ideia de escala, a MentorShow, uma plataforma francesa de aprendizado online, disse à eesel que recebe entre 5.000 e 13.000 tickets por mês. O agente eesel dela lê cada nova conversa do HubSpot, verifica o cadastro do membro e uma base de conhecimento de 123 artigos, e deixa uma nota interna com um rascunho de resposta no idioma do membro. Nesse volume, os tokens do GPT-6.2 Sol com um cache funcionando saem por cerca de US$ 35 a US$ 90 por mês. Com o bug do campo instructions, US$ 146 a US$ 380.
De qualquer forma, os tokens são a linha pequena no custo de atendimento com IA. As linhas maiores são o retrieval, o function calling para buscas de pedidos, as regras de escalonamento e a observabilidade para ver o que o agente disse.
É por isso que o custo de um agente de suporte de IA depende muito mais de construir ou comprar do que do modelo.
O GPT-6.2 Sol é mais barato que o Claude Sonnet 5.5?
No preço de tabela, são idênticos. A página de preços da Anthropic lista o Claude Sonnet 5.5 a US$ 2 de entrada, US$ 10 de saída e US$ 0,10 em leituras de cache por milhão de tokens. As diferenças estão nos detalhes:
| Por milhão de tokens | GPT-6.2 Sol | Claude Sonnet 5.5 | GPT-6.2 Astra | Claude Opus 5.5 |
|---|---|---|---|---|
| Entrada | US$ 2,00 | US$ 2,00 | US$ 8,00 | US$ 4,00 |
| Saída | US$ 10,00 | US$ 10,00 | US$ 40,00 | US$ 20,00 |
| Leitura de cache | US$ 0,10 | US$ 0,10 | US$ 0,40 | US$ 0,20 |
| Escrita de cache mais barata | US$ 2,50 (30 min) | US$ 2,50 (5 min) | US$ 10,00 (30 min) | US$ 5,00 (5 min) |
| Escrita de cache mais longa | US$ 5,00 (12 h) | US$ 4,00 (1 h) | US$ 20,00 (12 h) | US$ 8,00 (1 h) |
| Prompts acima de 272.000 | 2x entrada, 1,5x saída | Mesma taxa até 1M | 2x entrada, 1,5x saída | Mesma taxa até 1M |
| Batch | 50% de desconto | 50% de desconto | 50% de desconto | 50% de desconto |
Três coisas decidem qual é mais barato para você:
- Filas tranquilas favorecem o Sol. A mesma escrita de US$ 2,50 compra 30 minutos no Sol e 5 minutos no Sonnet. Se as solicitações chegam com 10 minutos de intervalo, o Sol mantém o cache quente enquanto o Sonnet fica reescrevendo.
- Prompts enormes favorecem o Sonnet. A Anthropic cobra "a mesma taxa por token" em toda a janela de 1M. Uma solicitação de 400.000 tokens com uma resposta de 4.000 tokens custa US$ 1,66 no GPT-6.2 Sol e US$ 0,84 no Sonnet 5.5. Dividir documentos em partes abaixo de 272.000 fecha a maior parte dessa diferença.
- A quantidade de tokens por tarefa decide o resto. Com taxas iguais, ganha o modelo que responde em menos tokens. Isso depende da carga de trabalho, então teste os dois com seus próprios prompts.
Se você quiser comparar mais amplamente, o Claude Opus 5.5 custa o dobro por token, e o melhor modelo IA para suporte compara todo o campo em trabalho de tickets.
Quanto custa o GPT-6.2 Sol no ChatGPT?
No ChatGPT você paga uma assinatura fixa, não por token. A OpenAI diz que o GPT-6.2 Sol está "disponível para todos os usuários Plus, Pro, Enterprise e Edu no ChatGPT Work e Codex", com acesso para Enterprise e Edu quando um admin do workspace ativa.
| Plano | Preço | Acesso ao GPT-6.2 Sol |
|---|---|---|
| Free | US$ 0 | Não listado no post de lançamento |
| Go | US$ 8/mês | Não listado no post de lançamento |
| Plus | US$ 20/mês | Sim, no ChatGPT Work e no app Codex |
| Pro (Pro 100, Pro 200, Pro 500) | A partir de US$ 100/mês | Sim; o Pro 200 ganha Ultrafast com Sol por primeira vez, e o Pro 500 ganha Ultrafast com Sol ou Astra |
| Enterprise e Edu | Contatar vendas | Sim, quando um admin ativa |
Os preços vêm da página de preços do ChatGPT. Os planos Pro também incluem créditos mensais de API: US$ 100, US$ 200 ou US$ 500 dependendo do nível, sujeito aos termos de elegibilidade da OpenAI. Na taxa em cache de US$ 6,95 por 1.000 tickets, US$ 200 de créditos cobrem cerca de 28.800 tickets do GPT-6.2 Sol por mês. O guia preços do ChatGPT tem o detalhamento completo dos planos.
O GPT-6.2 Sol vale a pena para o suporte ao cliente?
No preço, sim. É um quarto do custo em tokens do GPT-6.2 Astra e passou nos 15 tickets do teste da eesel. Os riscos reais estão em outro lugar. A Artificial Analysis mediu uma taxa de alucinação de 55% para o Sol no esforço máximo, o que significa que ele chuta em vez de admitir que não sabe. Nesse teste, transformou um número de rastreio em um link para ups.com que a ferramenta de pedidos nunca forneceu. Um modelo barato que chuta ainda precisa de embasamento, prevenção de alucinações e testes com tickets reais antes de responder aos clientes.
Também existe a pergunta se você quer uma conta de tokens para começo de conversa. Ela pode mudar sem que seu código mude: o cache para de acertar depois de uma atualização, um nível de desconto desaparece, ou o Ultrafast dobra em 1º de março de 2027. Em uma call de vendas da eesel, um comprador consciente do orçamento disse à equipe que o preço de um fornecedor anterior tinha mais que dobrado, e pediu um bloqueio contratual de preço antes de assinar qualquer coisa. Preços por token não conseguem oferecer isso.
Essa é a troca entre construir ou comprar. Se você constrói sobre o GPT-6.2 Sol, ganha tokens baratos, mais o trabalho de vigiar cached_tokens, níveis e páginas de preços. Se compra, a escolha do modelo e suas peculiaridades de cobrança se tornam problema de outra pessoa.
Experimente a eesel
Se você está avaliando preços do GPT-6.2 Sol porque quer IA na sua fila de suporte, o colega de IA do helpdesk da eesel te dá isso sem medidor de tokens. Ele se conecta ao helpdesk que você já usa, aprende com seus tickets passados e seu centro de ajuda, e deixa você rodá-lo contra tickets históricos para ler cada resposta antes que ela chegue a um cliente real. Os planos são pacotes fixos de créditos, a partir de US$ 299 por 500 créditos, então uma mudança de cache ou um novo nível na OpenAI não aparece na sua conta.
A Lesson Pro, um grupo de marcas de aulas particulares, usa isso em duas contas do Zendesk: em um mês, trabalhou 1.900 tickets, deixou 1.700 notas internas para a equipe e rascunhou 560 respostas para uma pessoa aprovar, respondendo a partir de cerca de 4.000 tickets, artigos e páginas da web.

Você pode experimentar a eesel de graça em uma parte da sua fila, ou comparar com usar o ChatGPT direto se ainda estiver decidindo se constrói por conta própria.
Perguntas frequentes
Quanto custa o GPT-6.2 Sol?
O GPT-6.2 Sol é mais caro que o GPT-6.1 Sol?
O GPT-6.2 Sol tem preço Flex?
Como consigo o desconto de entrada em cache do GPT-6.2 Sol?
cached_tokens no bloco usage da API Responses para confirmar.