

Resumo
O Fish Audio Drama 3 é o melhor modelo de texto para fala de pesos abertos que você pode baixar hoje, e o primeiro que vi em que você dirige uma linha como orientaria um ator: [barely holding it together] I'm fine. Ele é o nº 1 no teste de pronúncia da Artificial Analysis com 93,2%, à frente do Eleven v4.
As três ressalvas: ele fica em 10º, não em 1º, quando os ouvintes escolhem a voz de que mais gostam; a licença comercial gratuita termina em US$ 500.000 de receita anual; e os US$ 10 por milhão de caracteres da API são um desconto de lançamento de 80% que volta para US$ 50 depois de 12 de novembro.
Escolha-o para audiolivros, radioteatro, jogos e vídeo curto, onde você renderiza uma linha, fica com a melhor tomada e segue em frente. Evite-o para voz ao vivo e em alto volume, onde a variação entre tomadas atrapalha. E se o trabalho por trás do seu áudio é a própria escrita, é aí que o redator de blog com IA da eesel se encaixa: ele produz o roteiro pesquisado que um modelo como o Drama 3 depois lê em voz alta.
O que é o Fish Audio Drama 3?
O Drama 3 é o novo modelo de texto para fala da Fish Audio, lançado em 13 de outubro de 2026 no aplicativo web fish.audio, nos apps para iOS e Android e na API. Uma prévia foi enviada aos usuários da API em 23 de setembro com o nome drama-3-preview, e a página inicial ainda traz hoje um selo "Preview".
Trabalho na fila de suporte da eesel todos os dias, e boa parte desse trabalho é separar as ferramentas que brilham na demo das que aguentam a centésima execução. A eesel passou anos colocando IA em filas de clientes ao vivo, e a maior lição é que uma saída confiante ainda pode estar errada, por isso cada implantação da eesel é simulada primeiro com tickets passados. Li o Drama 3 pela mesma lente: além do vídeo de lançamento, na documentação, no relatório técnico, nas páginas de preços e nas primeiras reações da comunidade.
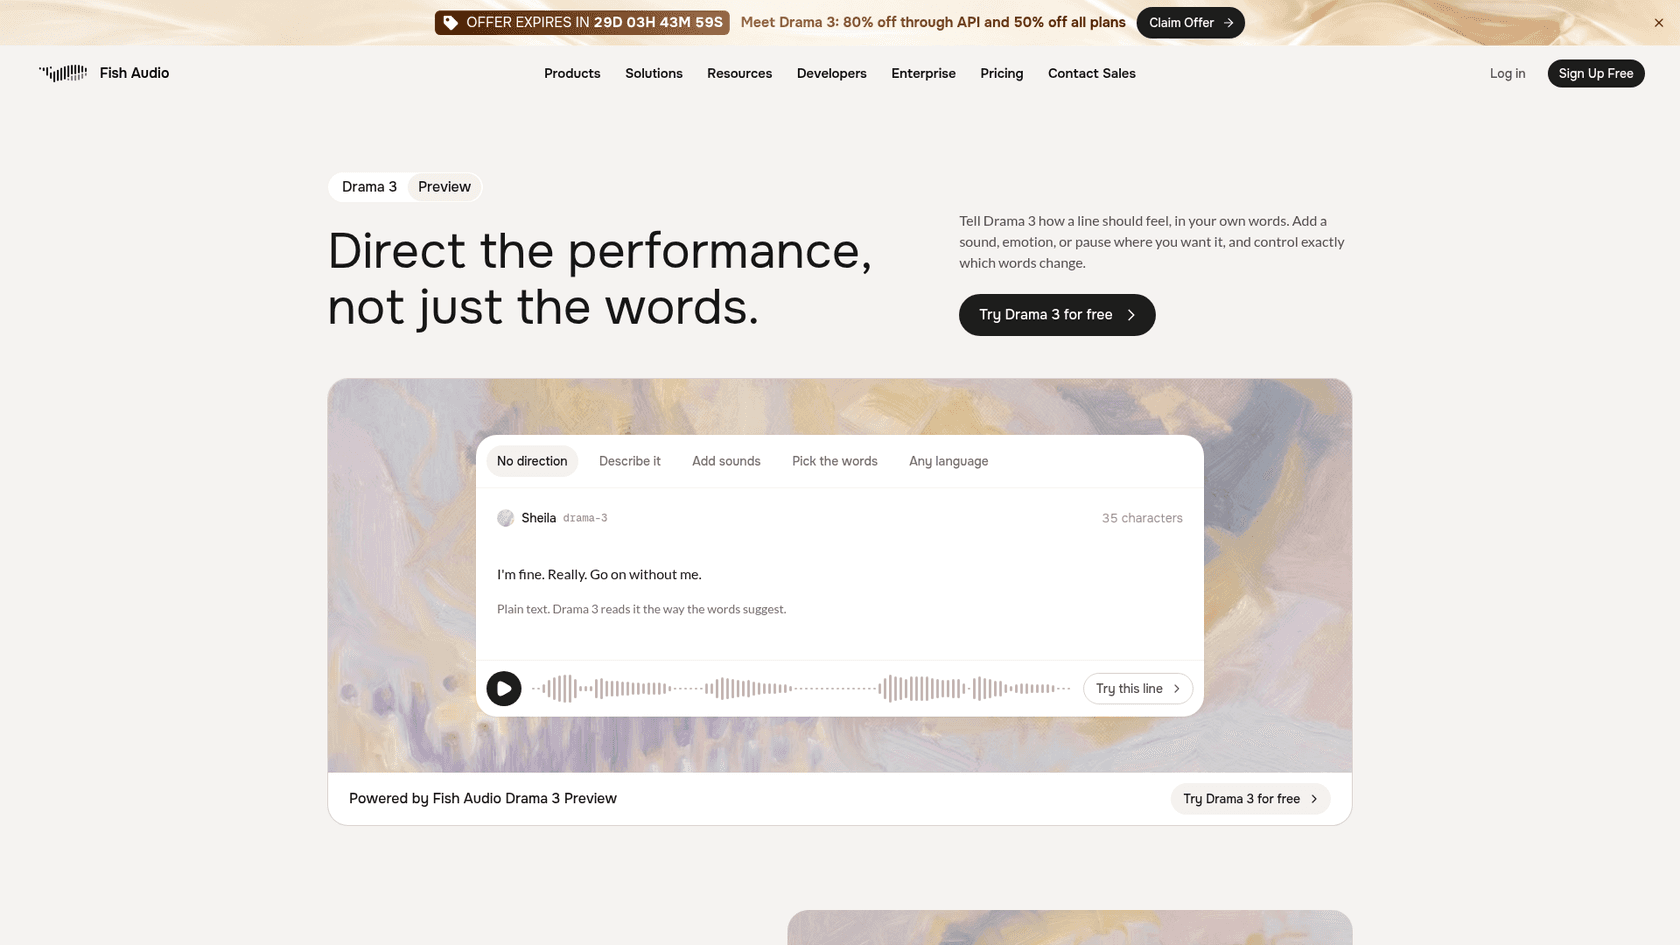
Os fatos principais, todos das próprias páginas da Fish Audio:
- 83 idiomas, e a indicação pode ser escrita em um idioma diferente do da linha (post de lançamento).
- Pesos abertos no Hugging Face sob a nova Fish Audio Community License v1.0. Novo no hub? Meu guia do Hugging Face cobre o básico.
- Mistura de especialistas de 35B parâmetros, cerca de 3B ativos por token, inicializada a partir do modelo de linguagem do Qwen3.5-35B-A3B, segundo o relatório técnico.
- O mesmo endpoint de API do S2.1 Pro, então a troca é um cabeçalho:
model: drama-3.
A própria Fish Audio é uma empresa jovem com tração real: fundada em 2025, ela informa US$ 21 milhões em receita recorrente anual e mais de 15 milhões de usuários no seu comunicado de lançamento, com HeyGen, Runway e Vercel citados como clientes.
Como funciona dirigir uma linha
Esta é a parte que diferencia o Drama 3 do fluxo do ElevenLabs e da API de fala da OpenAI que a maioria conhece. Em vez de escolher em uma lista fixa de predefinições de emoção, você escreve indicações de cena direto no roteiro.
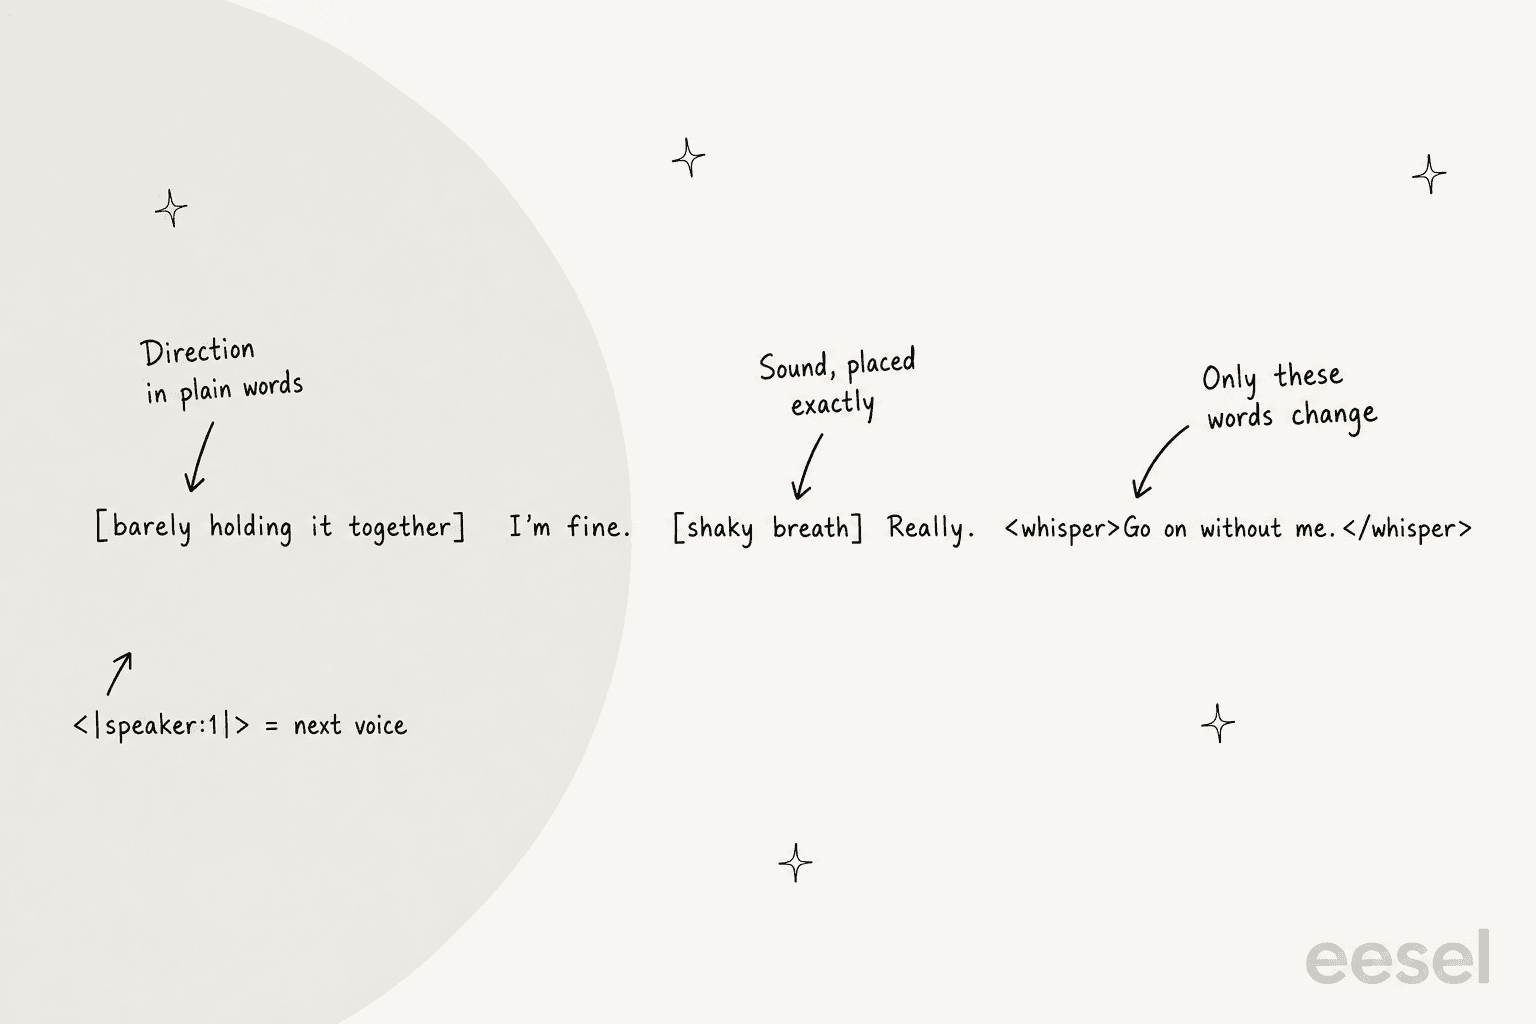
A documentação do Drama 3 descreve cinco ferramentas, e você pode misturar todas em uma linha:
| O que você quer | Como escrever | Exemplo |
|---|---|---|
| Definir a entrega | Palavras simples entre colchetes | [slow, dangerously quiet] Just one. |
| Posicionar um som ou pausa | Um colchete onde acontece | I'm fine. [shaky breath] Really. |
| Mudar só algumas palavras | Tags em par: <whisper>, <emphasis>, <soft>, <fast>, <slow>, <stress>, <forceful> | <whisper>Go on without me.</whisper> |
| Trocar de idioma no meio da linha (experimental) | Tags de idioma | <french>Je voudrais une table pour deux</french> |
| Fixar uma pronúncia | Tags de fonema (CMU Arpabet, pinyin, romaji) | <|phoneme_start|>EH1 N JH AH0 N IH0 R<|phoneme_end|> |
Uma cena inteira vai em uma única requisição: você passa um ID de voz por falante em reference_id e começa cada fala com <|speaker:0|>, <|speaker:1|> e assim por diante. O card do modelo diz que um texto pode ter até 16 personagens. No aplicativo web, um botão Auto Tag escreve indicações de primeiro rascunho para um roteiro simples, uma boa porta de entrada se você nunca escreveu indicações de cena.
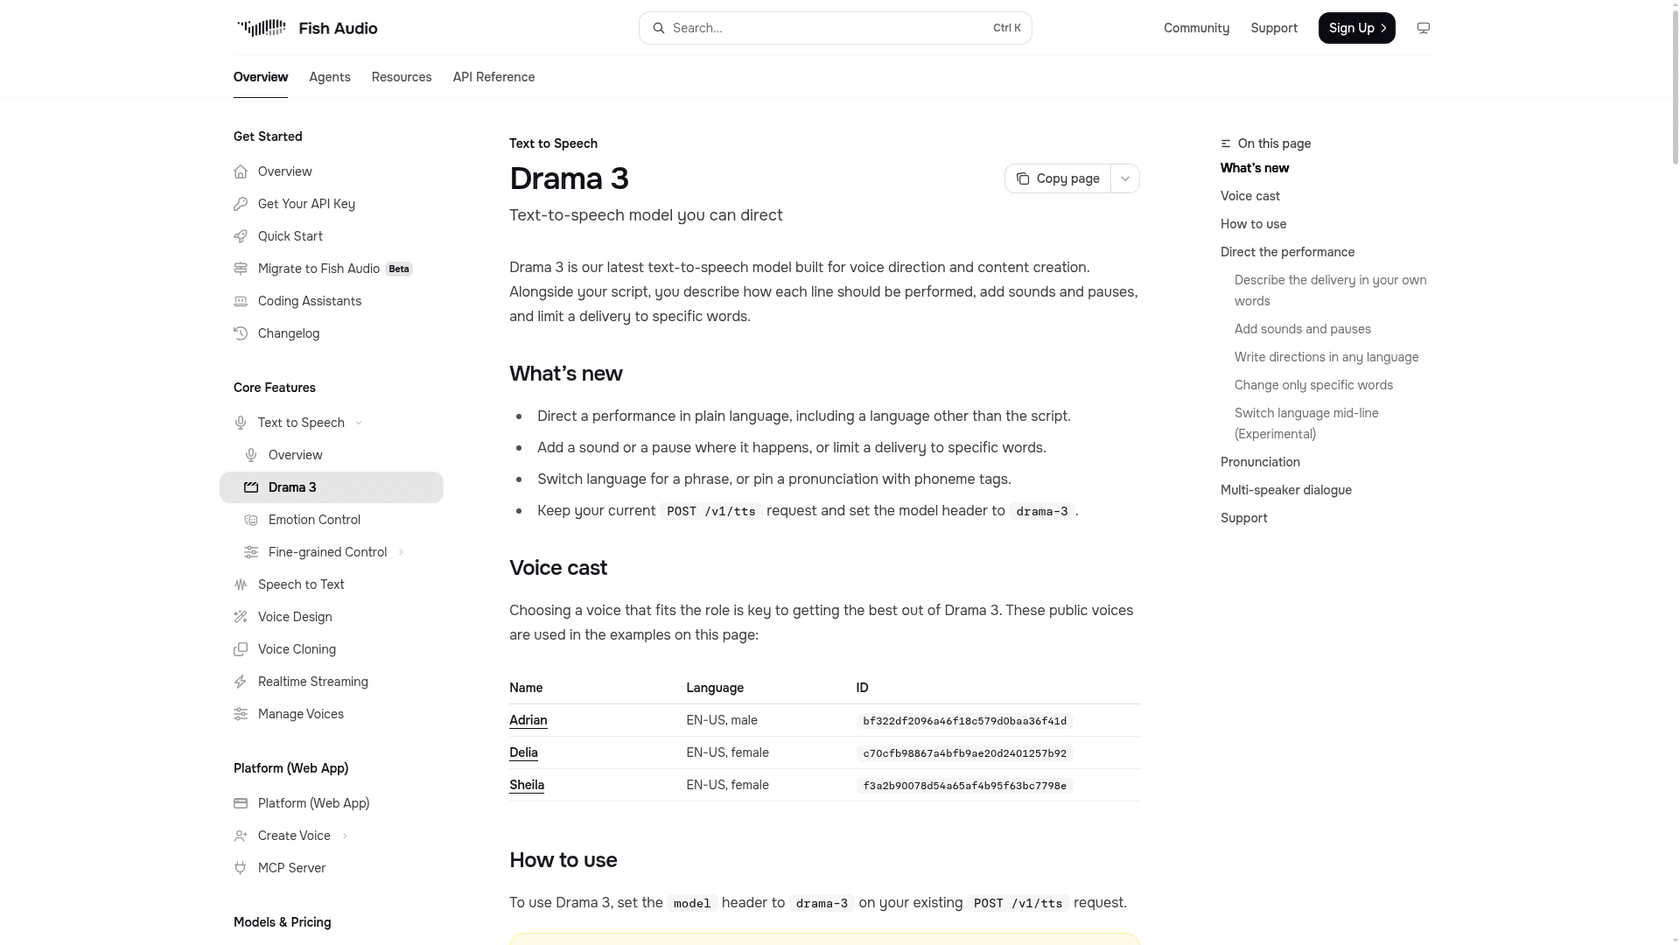
Uma pegadinha na documentação merece ser tatuada em algum lugar: se o cabeçalho model estiver ausente ou escrito errado, a requisição não falha; ela volta silenciosamente para s2.1-pro. Você recebe áudio, é cobrado e nunca obtém o Drama 3. Se suas linhas dirigidas soarem chatas, confira o cabeçalho antes de culpar o modelo.
O que o Drama 3 faz bem
Três coisas se destacam, e são mensuráveis, não impressões.
Ele lê palavras difíceis corretamente
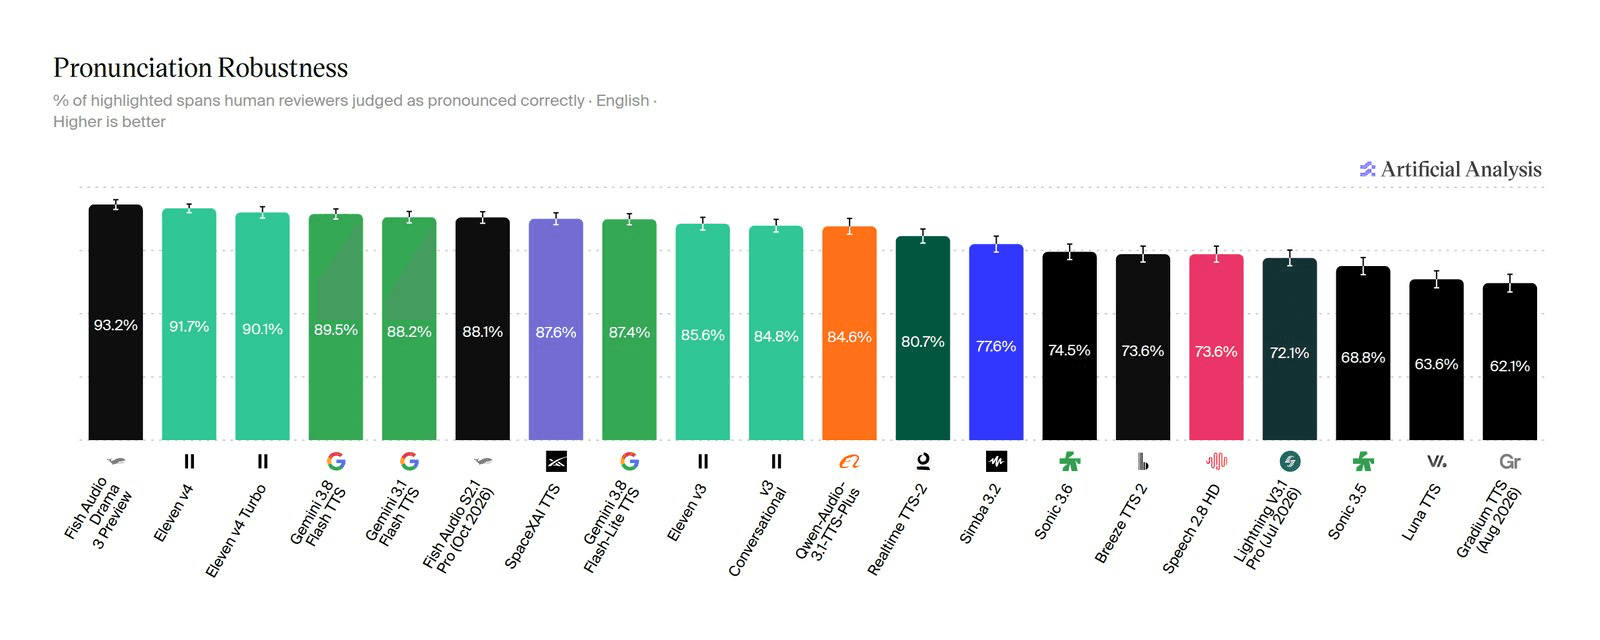
Mais emoção só ajuda se as palavras sobrevivem a ela. No teste Pronunciation Robustness da Artificial Analysis, em que revisores humanos checam nomes de marcas, números, códigos e palavras que dependem do contexto, o Drama 3 marcou 93,2%, primeiro lugar da tabela, à frente do Eleven v4 com 91,7% e do Eleven v4 Turbo com 90,1%.
A divisão por categoria do post de lançamento da Fish Audio mostra de onde veio o salto em relação ao próprio antecessor:
| O que está sendo lido | Drama 3 | S2.1 Pro |
|---|---|---|
| Marcas, lugares, termos técnicos | 95,9% | 87,3% |
| Palavras cuja leitura depende do contexto | 95,3% | 86,1% |
| Números, datas, unidades | 93,6% | 92,7% |
| Códigos, caminhos de arquivo, e-mails | 86,3% | 79,4% |
| Geral | 93,2% | 88,1% |
Para um audiolivro que diz "Chapter XVII" ou uma explicação de produto cheia de SKUs, esse ganho de 8,6 pontos em marcas e termos técnicos é a diferença entre uma renderização e três.
Ele aceita direção no meio da linha
A Fish Audio treinou o Drama 3 de forma diferente dos modelos anteriores. Modelos de fala costumam ser recompensados por serem fáceis de transcrever e próximos do clipe de referência, o que pune silenciosamente uma risada ou um sussurro. O Drama 3 foi ajustado com um único modelo de recompensa aprendido sobre qual tomada as pessoas preferiram, segundo o post de lançamento. Na prática, isso significa que uma linha pode começar ofegante, cair para um sussurro e terminar mortalmente séria, e a leitura vira onde você coloca o colchete.
Ele também gera uma cena com vários personagens de uma só vez, e o ComfyUI o lançou como nó parceiro no primeiro dia justamente por isso. Se você escreve roteiros para vídeo com IA ou podcasts, poder escrever a emoção no próprio arquivo do roteiro é um fluxo mais limpo do que mexer em controles clipe a clipe.
Você pode mesmo baixá-lo
Os pesos abertos são o motivo de o pessoal de TTS no Reddit ter se animado. A Fish Audio publica os pesos, o código no GitHub e a receita de serviço para o SGLang-Omni, e o card do modelo informa primeiro áudio em 88,9 ms para um único stream em uma H200. A Artificial Analysis o lista como o modelo de pesos abertos nº 1 nos três rankings de TTS, 15 pontos à frente do Voxtral TTS da Mistral em pronúncia.
"After getting banned on Eleven Labs three times, I'm so happy something like this is finally open weight. It's fast and sounds great."

Esse mesmo usuário o colocou para rodar em duas RTX 3090 com cerca de 39 GB de VRAM com ajuda do Claude Opus 5.5, o que mostra que é possível em hardware de consumidor e que não é uma instalação de um clique.
Onde o Drama 3 fica devendo
Nenhum desses pontos é decisivo. São coisas que o vídeo de lançamento não menciona e que eu gostaria de saber antes de apostar um pipeline de produção.
É o melhor modelo aberto, não o de melhor som
A manchete do nº 1 é sobre precisão de pronúncia. Quando a Artificial Analysis pergunta aos ouvintes qual voz preferem, o quadro muda.
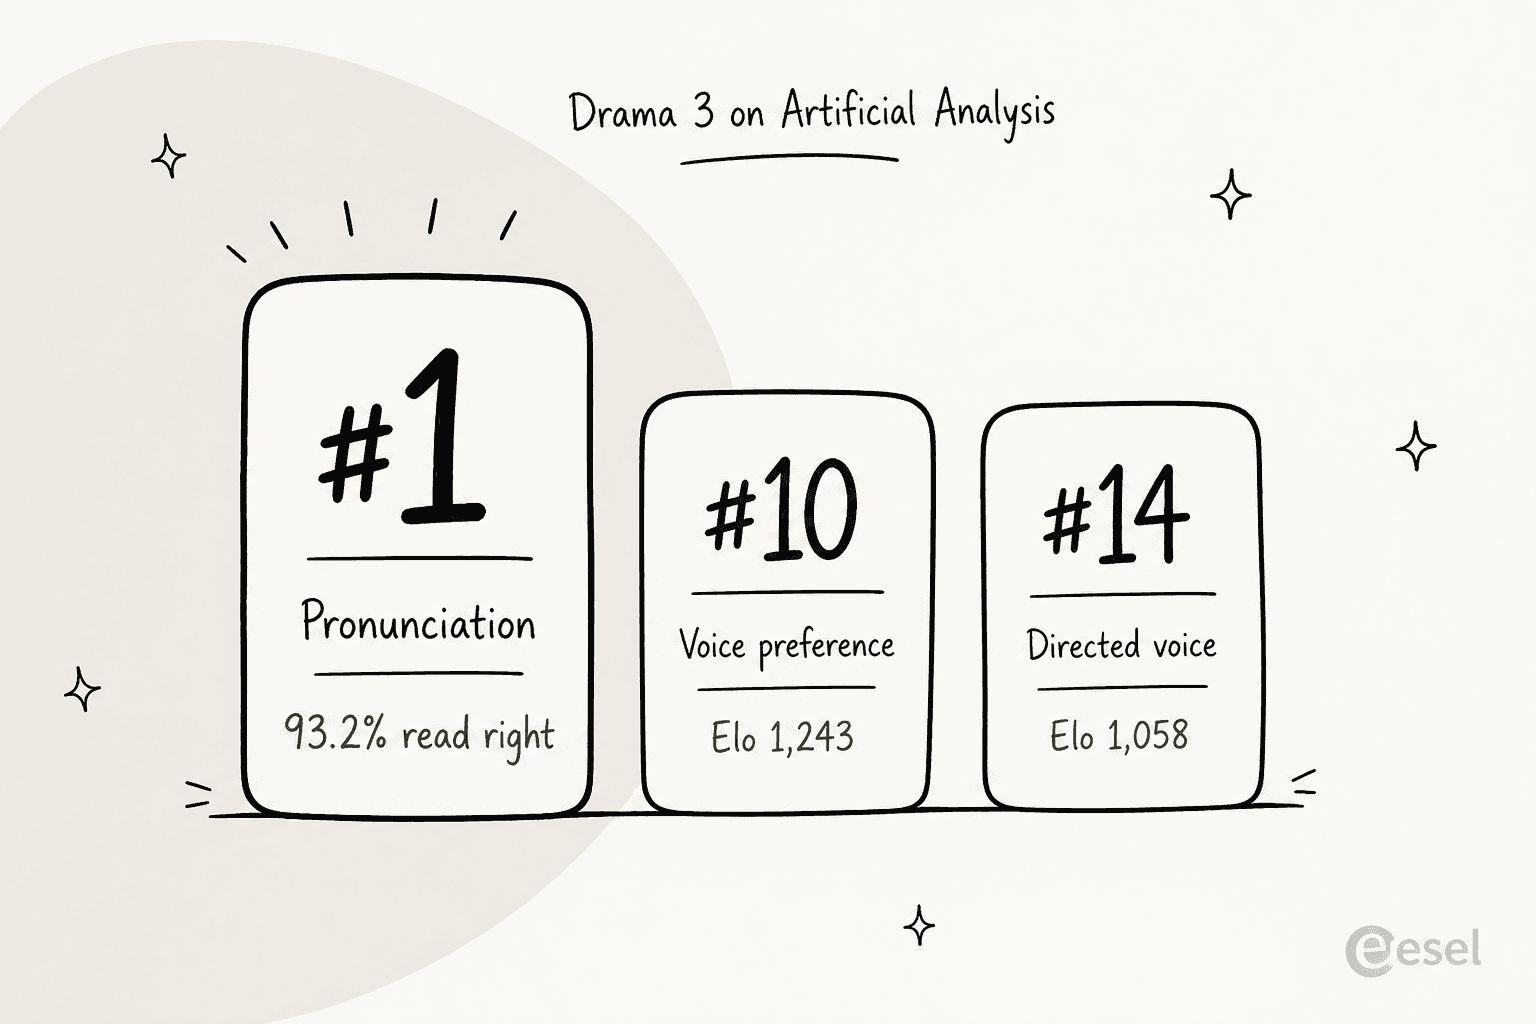
Na arena Provider Voice, o Drama 3 tem um Elo de 1.243 em 1.857 confrontos, nº 10, logo atrás do Simba 3.2 da Speechify, segundo o thread da Artificial Analysis. É um salto de 101 pontos sobre o S2.1 Pro, um passo grande. Mas nove modelos ainda vencem mais comparações às cegas em qualidade geral de voz, e na arena Controlled Voice ele está em 14º. Nem todo mundo no Reddit ficou convencido:
"barely better than breeze with nearly 10x the size"
As tomadas variam e as ferramentas de edição ainda não chegaram
A Fish Audio é franca sobre isso: "Takes vary, so render a few and keep the one that plays", diz o post de lançamento, e o FAQ da página inicial explica o rótulo Preview da mesma forma. Isso é tranquilo para um narrador que renderiza um capítulo uma vez. É um custo real para quem gera milhares de linhas automaticamente, onde ninguém escolhe a melhor tomada.
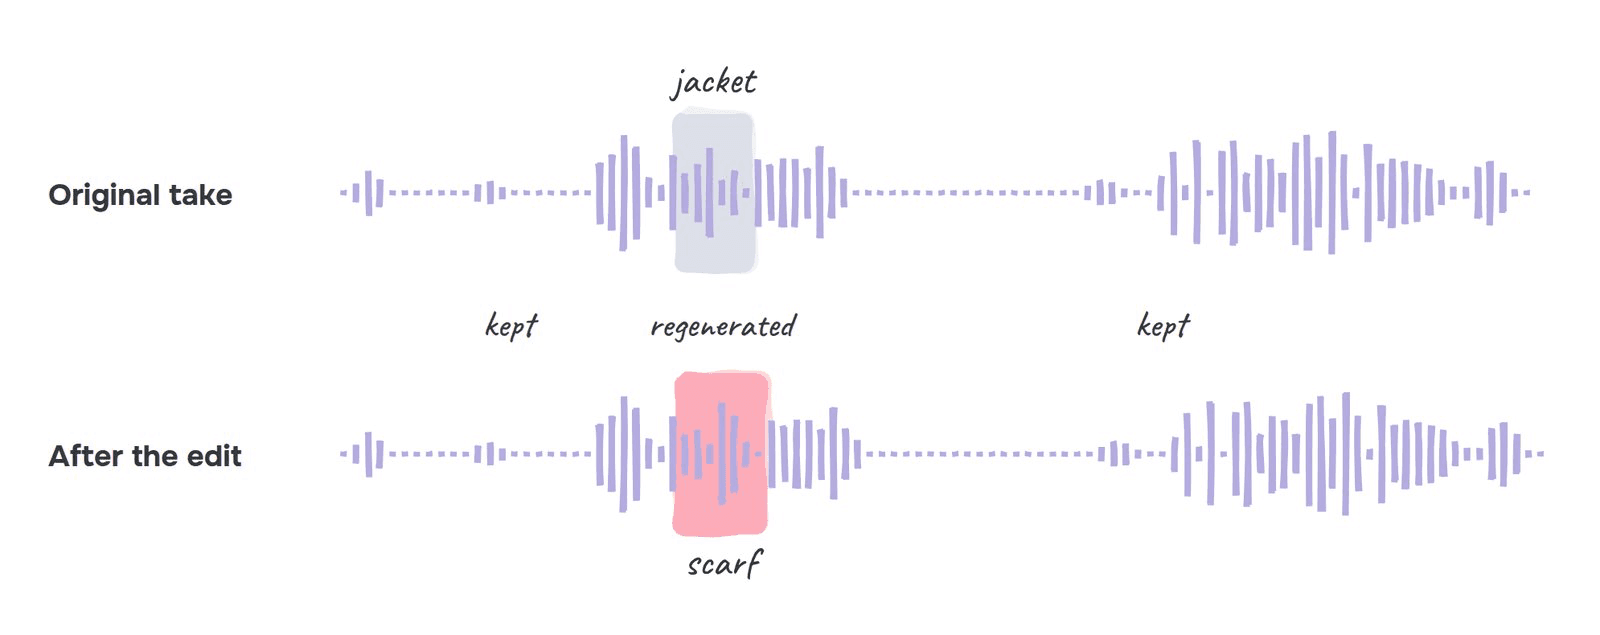
Os dois recursos que resolveriam a maior parte disso, edição interativa ("softer than that one") e inpainting de áudio (regenerar uma única palavra dentro de uma tomada aprovada), estão em testes apenas por convite, com uma API de edição "coming soon".
A licença tem um teto, e o hardware tem um piso
A Fish Audio Community License é gratuita para uso comercial apenas enquanto você e suas afiliadas faturarem menos de US$ 500.000 por ano. Acima disso, ou se você quiser oferecer o Drama 3 a terceiros como API de voz, precisa de uma licença paga. O próprio FAQ da Fish Audio o chama de "open-weight rather than open source", e a comunidade percebeu:
"Lame license."
A licença também proíbe clonar a voz de uma pessoa real sem consentimento, o que considero um ponto positivo. Em hardware, o autor original do thread colocou o patamar em uma placa CUDA de 48 GB; uma quantização de 4 bits da comunidade reduz para 32 GB. De qualquer modo, não é um modelo de notebook.
Preços do Fish Audio Drama 3
Há duas formas de pagar: a API para desenvolvedores, cobrada por texto, ou um plano para criadores no aplicativo web, cobrado em créditos. O preço da API é o que tem um precipício.
| Modelo de API | Preço | Unidade | Fonte |
|---|---|---|---|
| Drama 3, oferta de lançamento (13 out. a 12 nov. 2026) | US$ 10 | por 1 M de caracteres | Post de lançamento |
| Drama 3, preço de tabela | US$ 50 | por 1 M de caracteres | Post de lançamento |
| S2.1 Pro | US$ 15 | por 1 M de bytes UTF-8 | Documentação de preços da API |
| S2.1 Pro Free | US$ 0 | por 1 M de bytes UTF-8 | Documentação de preços da API |
Duas coisas a observar. Primeiro, em 14 de outubro a tabela oficial de preços da documentação não lista drama-3 de forma alguma, então o post de lançamento é o único lugar onde a Fish Audio informa o número. Segundo, no preço de tabela o Drama 3 custa 3,3x o que o S2.1 Pro custa, então depois de 12 de novembro você paga um prêmio pela atuação, não pela voz. A documentação da Fish Audio coloca 1 M de bytes UTF-8 em cerca de 180.000 palavras em inglês, ou cerca de 12 horas de fala; para texto em inglês um caractere é um byte, então as unidades batem.
Insira seu próprio volume mensal para ver onde a mudança de 12 de novembro vai parar:
Um exemplo prático: um romance de 90.000 palavras tem cerca de meio milhão de caracteres. Narrá-lo uma vez custa cerca de US$ 5 no Drama 3 com o preço de lançamento, US$ 25 no preço de tabela e US$ 7,50 no S2.1 Pro. Renderize cada capítulo três vezes para escolher a melhor tomada e esses números triplicam. Para um criador solo ainda é barato; para uma plataforma que narra milhões de palavras por mês, o preço de tabela é o que se deve orçar.
Do lado dos criadores, a Fish Audio diz que o Drama 3 usa os mesmos créditos do S2.1 Pro, a cerca de 600 a 625 créditos por minuto de áudio segundo a página de planos.
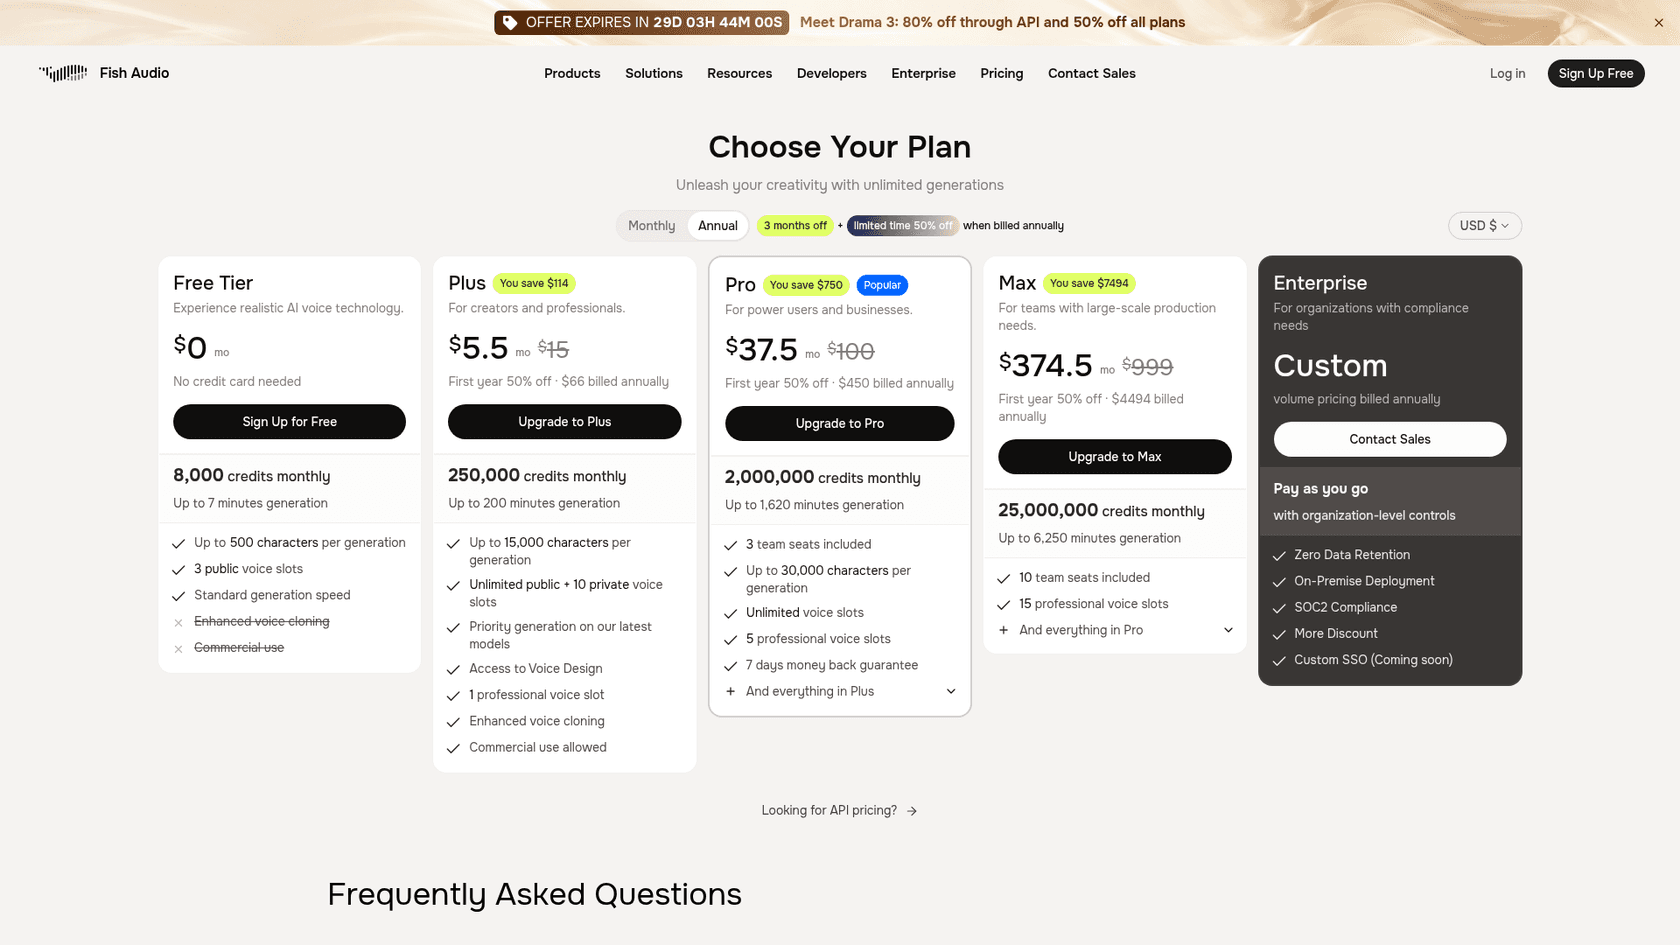
| Plano | Preço de tabela mensal | Primeiro ano, anual (oferta de lançamento) | Créditos por mês | Áudio por mês | Caracteres por geração | Vale saber |
|---|---|---|---|---|---|---|
| Free | US$ 0 | US$ 0 | 8.000 | Até 7 min | 500 | Sem clonagem de voz, sem uso comercial |
| Plus | US$ 15 | US$ 66 | 250.000 | Até 200 min | 15.000 | Uso comercial, Voice Design, 1 vaga de voz profissional |
| Pro | US$ 100 | US$ 450 | 2.000.000 | Até 1.620 min | 30.000 | 3 assentos de equipe, 5 vagas de voz profissional |
| Max | US$ 999 | US$ 4.494 | 25.000.000 | Até 6.250 min | 30.000 (como o Pro) | 10 assentos de equipe, 15 vagas de voz profissional |
| Enterprise | Personalizado | Personalizado | Personalizado | Personalizado | Personalizado | Zero retenção de dados, on-premise, SOC 2 |
Até 12 de novembro, as novas assinaturas Plus, Pro e Max têm 50% de desconto no primeiro mês na cobrança mensal, ou no primeiro ano na cobrança anual. Créditos não usados não acumulam. Empresas que migram de outro provedor de voz ganham os três primeiros meses grátis, segundo o comunicado de imprensa.
Como o Drama 3 se compara
Veja como ele se posiciona frente aos modelos de voz com os quais mais provavelmente será comparado. As pontuações de pronúncia vêm do mesmo ranking da Artificial Analysis; para o preço de cada concorrente, siga o link para o meu detalhamento.
| Modelo | Pronúncia (AA) | Pesos abertos | Análise | Preços |
|---|---|---|---|---|
| Fish Audio Drama 3 | 93,2% (nº 1) | Sim, licença com limite de receita | Você está lendo | US$ 10 lançamento / US$ 50 tabela por 1 M de caracteres |
| Eleven v4 | 91,7% | Não | Avaliações do ElevenLabs | Preços do Eleven v4 |
| Gemini 3.8 Flash TTS | 89,5% | Não | Análise do Gemini TTS | Preços do Gemini TTS |
| Fish Audio S2.1 Pro | 88,1% | Família S2, licença de pesquisa | Coberto acima | US$ 15 por 1 M de bytes, plano gratuito |
Duas notas que a tabela não comporta. O Gemini 3.8 Flash TTS supera o Drama 3 em palavras que dependem do contexto (97,9% vs 95,3%), então teste os dois se seus roteiros estão cheios de palavras como "read" e "lead" (thread da AA). E se o ElevenLabs é sua ferramenta atual, meu detalhamento de preços do ElevenLabs é a referência justa para comparar.
Se o seu uso é um agente de voz em tempo real em vez de um roteiro renderizado, o conjunto de comparação muda por completo. Comece pela minha análise do Cartesia Sonic 3, construída em torno da latência. O texto sobre o Grok Voice Think Fast 2 cobre o lado de fala para fala.
Para voz guiada por emoção em particular, a Hume AI é o outro nome que vale uma olhada, e meu post de preços da Hume AI traz os números. Se você ainda está escolhendo entre modelos de fala e de transcrição, Whisper vs API de TTS desembaraça os dois.
Quem deve usar o Drama 3 e quem deve evitar
A Fish Audio é incomumente honesta sobre o próprio ponto forte: "Drama 3 does its best work on scripted lines you render once and keep." Eu levaria isso ao pé da letra.
Use se você é:
- Produtor de audiolivros ou radioteatro. Direção no roteiro, pronúncia de primeira linha e cenas com vários personagens de uma só vez são exatamente o seu fluxo.
- Um estúdio de jogos ou animação. Direção por linha e tags no nível da palavra vencem regravar, e os pesos abertos permitem rodá-lo internamente se você estiver abaixo do limite de receita.
- Criador de vídeo curto. O Auto Tag do aplicativo web e o desconto de lançamento de 50% tornam barato experimentar. Para o visual, uma ferramenta de avatar como o HeyGen combina bem. Meu guia de criação de conteúdo com IA cobre o resto da stack.
- Um desenvolvedor que quer uma voz auto-hospedável. É a opção aberta mais forte na Artificial Analysis hoje, com uma receita de serviço publicada.
Evite, ou espere, se você é:
- Quem roda voz ao vivo em volume. A variação entre tomadas e o prêmio de 3,3x no preço de tabela sobre o S2.1 Pro apontam para o S2.1 Pro ou um modelo em tempo real. Minha lista de melhores agentes de voz com IA os cobre.
- Uma empresa acima de US$ 500.000 de receita planejando auto-hospedar. Reserve antes a conversa sobre a licença comercial.
- Alguém que só precisa de narração simples. O S2.1 Pro lê texto simples bem e custa menos; você pagaria por uma atuação que não usa.
Se você está aqui porque pensa em voz para atendimento ao cliente, um aviso do lado de suporte do meu trabalho: a voz raramente é a parte difícil. Uma voz expressiva lendo uma resposta errada continua sendo uma resposta errada, por isso eu leria sobre alucinações de IA no suporte e olharia agentes de voz com IA para suporte feitos para isso, como o Decagon Voice 3, antes de recorrer a um modelo de performance.
eesel para equipes que transformam texto em áudio
O Drama 3 é um modelo de voz. Ele lê o que você entregar, de forma bonita, mas não decide o que vale a pena dizer. Se você transforma posts de blog em áudio narrado, podcasts ou roteiros de vídeo, o gargalo costuma estar um passo antes: conseguir um roteiro pesquisado e preciso logo de início.
Esse é o trabalho do redator de blog com IA da eesel. É um colega de IA que pesquisa um tema em fontes primárias, escreve o post longo na voz da sua marca, gera as imagens e entrega um rascunho pronto para publicar, ou para alimentar direto o Drama 3. Pense na divisão assim: o Drama 3 é o intérprete, a eesel é o escritor que você contratou. Você pode ver como ele se sai na minha análise do redator de blog com IA e como ele se encaixa no reaproveitamento de conteúdo.
Quer um roteiro que valha a pena dirigir? Escreva seu próximo post com a eesel e confira os preços quando estiver pronto. Experimente a eesel.