

O que é o Fish Audio Drama 3?
Eu construo agentes de IA na eesel, então leio todo lançamento de modelo de voz com uma pergunta: isso muda o que uma equipe consegue entregar, ou só como uma demo soa? O Drama 3 é do tipo mais interessante, porque a mudança está na interface. Em vez de escolher uma emoção predefinida em um menu, você escreve uma direção de cena.
A Fish Audio o descreve como um modelo feito para direção: junto com o roteiro, você descreve como uma fala deve ser interpretada, adiciona sons e pausas e limita um efeito a palavras específicas. O relatório técnico acrescenta a engrenagem. A base é um modelo de mistura de especialistas com 35B de parâmetros que ativa cerca de 3B por token, inicializado a partir do Qwen3.5-35B-A3B (veja minha visão geral do Qwen se essa família for nova para você), mais um novo decodificador de áudio que prevê dez codebooks por quadro.
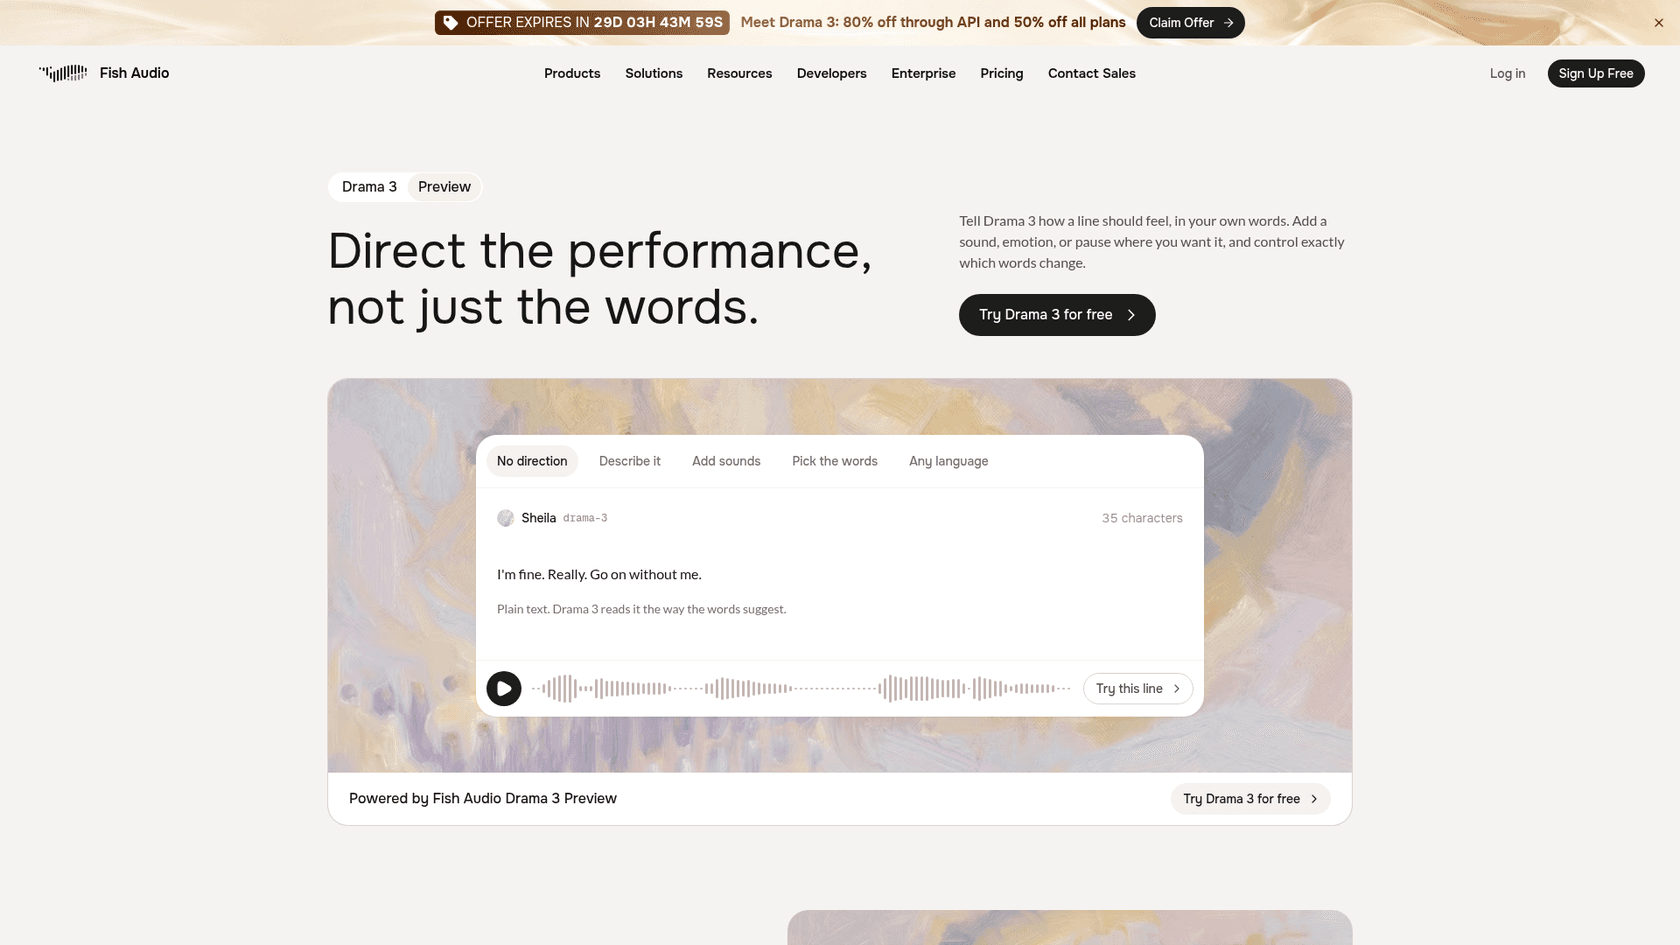
Há também uma breve história. A Fish Audio anunciou uma prévia em 23 de setembro, acessada pela string de modelo drama-3-preview, e lançou o modelo final em 13 de outubro. A página de destino ainda traz um selo "Preview", então espere algum refinamento depois do lançamento. A Fish Audio não é um laboratório pequeno: o comunicado de imprensa de lançamento cita 15 milhões de usuários e US$ 21 milhões em receita anual recorrente.
O que há de novo em relação ao S2.1 Pro?
O resumo honesto é que a interface ficou e a interpretação mudou. Os dois modelos aceitam direção entre colchetes, os dois falam 83 idiomas e os dois ficam atrás do mesmo endpoint POST /v1/tts. O que o Drama 3 acrescenta é uma aderência mais próxima à direção, tags delimitadas para palavras individuais e um objetivo de treinamento diferente.
| S2.1 Pro | Drama 3 | |
|---|---|---|
Direção em [colchetes] | Sim | Sim, com mais sentimento segundo a Fish Audio |
Tags delimitadas (<whisper>, <emphasis>, <slow>...) | Não listadas na visão geral de modelos | Sim, sete tags |
| Idiomas | 83 | 83 |
| Pronunciation Robustness (Artificial Analysis) | 88,1% | 93,2% |
| Preço de API por milhão | US$ 15 | US$ 50 de tabela, US$ 10 até 12 nov. |
| Pesos | API hospedada | Pesos abertos, Community License |
Fontes: visão geral de modelos da Fish Audio para o S2.1 Pro, publicação de lançamento do Drama 3 para o restante.
A mudança no treinamento é a parte que acho mais crível. A Fish Audio diz que a maioria dos modelos de fala, inclusive o próprio S2, é ajustada com recompensas por serem fáceis de transcrever e por soarem como o clipe de referência, e essas pontuações penalizam uma risada ou um sussurro. O Drama 3 é ajustado com um único modelo aprendido de quais takes as pessoas preferiram, então uma risada que você pediu não é punida. É uma explicação plausível de por que um modelo pode ser mais expressivo sem ficar mais descuidado com as palavras.
Como dirigir uma fala?
A direção é texto simples dentro do seu roteiro, em três camadas que você pode misturar livremente. Colchetes antes de uma fala definem como ela é interpretada, escritos como você instruiria um dublador. Os colchetes também podem conter um som ou uma pausa no ponto em que deve ocorrer, como [shaky breath]. Tags em par limitam um efeito a poucas palavras: <whisper>, <emphasis>, <soft>, <fast>, <slow>, <stress> e <forceful>.
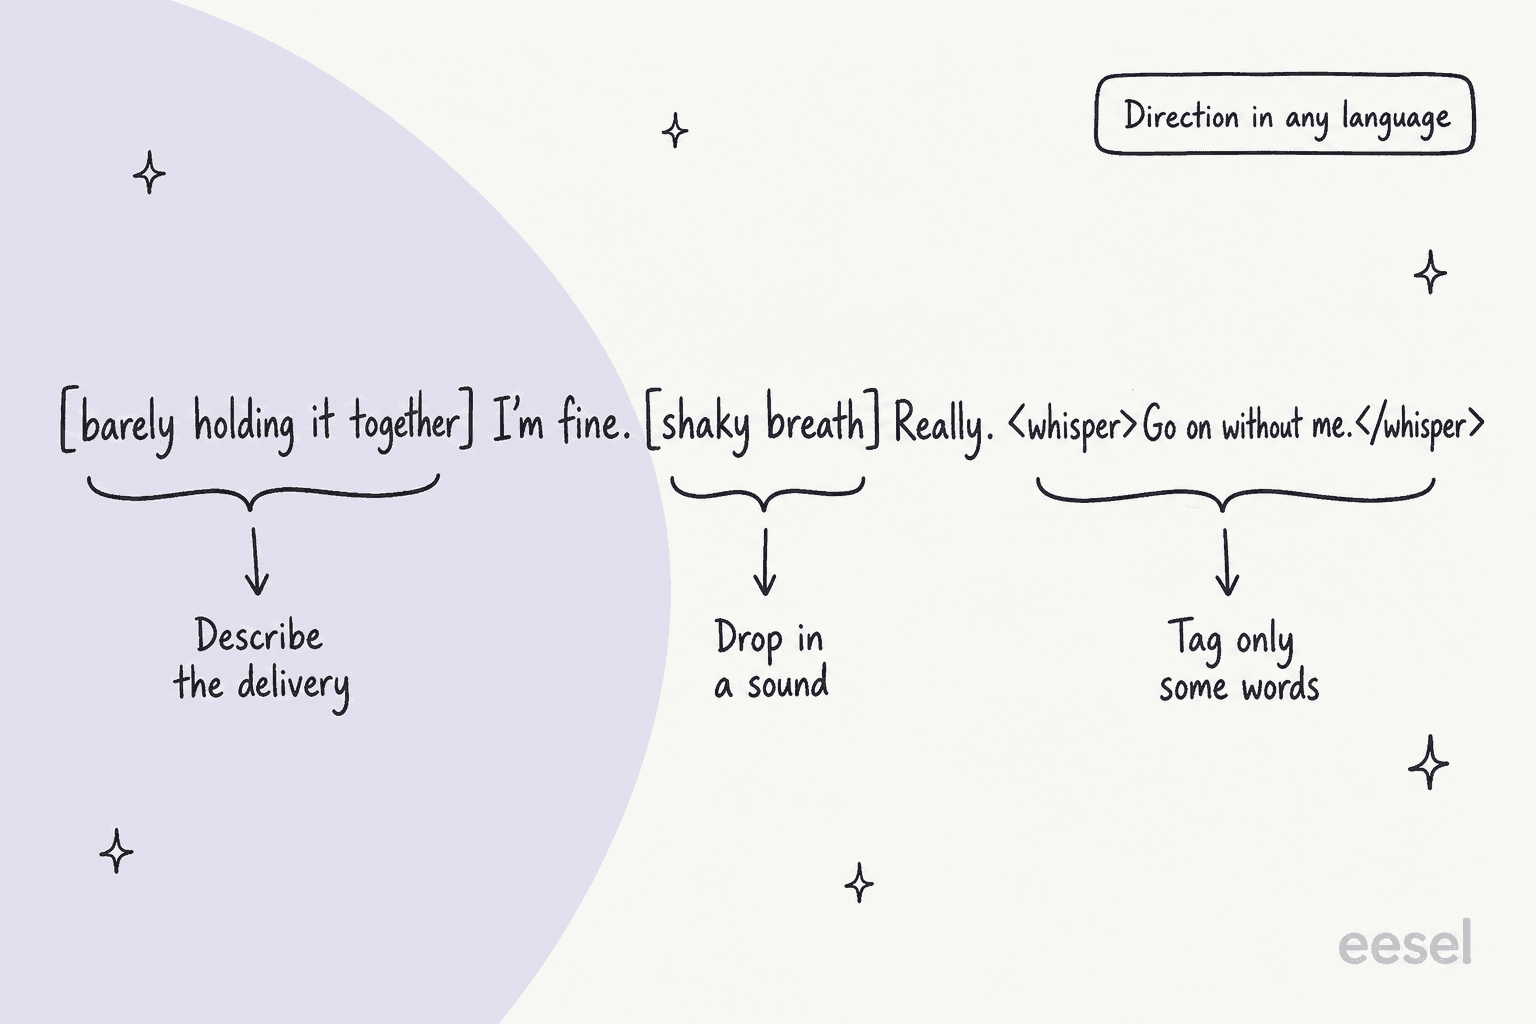
A direção não precisa estar em inglês. A documentação do Drama 3 mostra um colchete em chinês, um em espanhol e um em japonês sobre a mesma fala em inglês, e a Fish Audio diz que a interpretação segue a direção em qualquer idioma em que ela seja escrita. Existe uma tag de idioma para trocar no meio da fala, como <french>...</french>, mas ela é rotulada como experimental, com precisão que varia conforme o idioma e a voz.
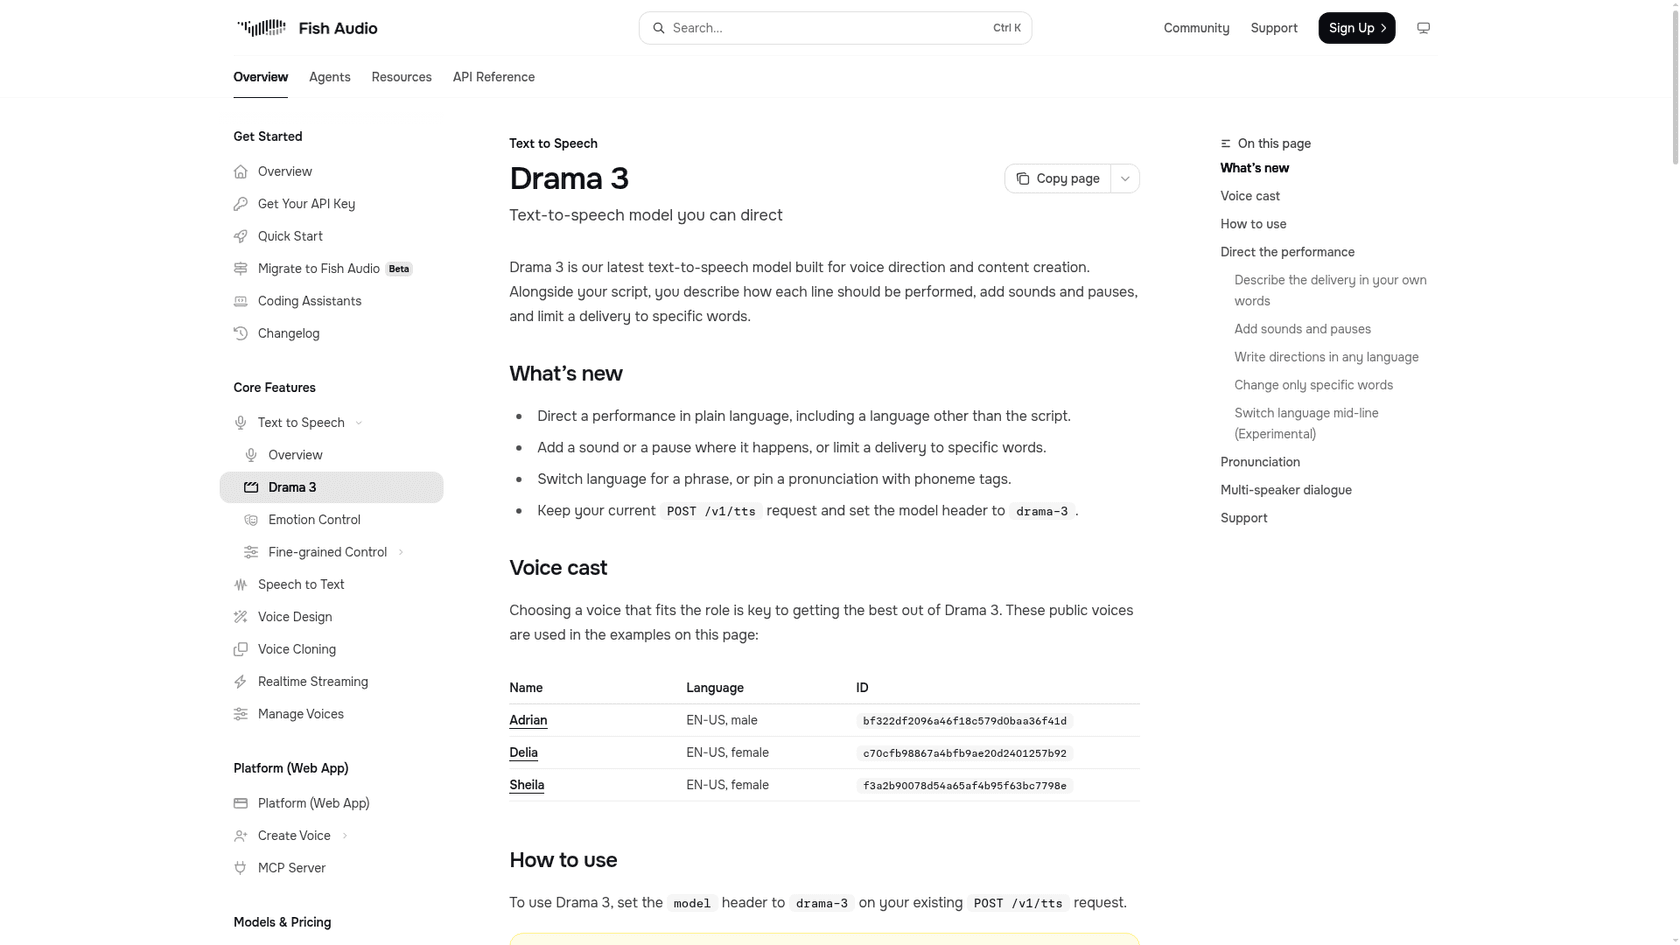
Dois detalhes importam se você automatiza isso com scripts. Primeiro, cenas com vários falantes usam tags no estilo <|speaker:0|> com um ID de voz por falante passado como array em reference_id, e o model card no Hugging Face diz que um texto pode ter até 16 personagens. Segundo, um cabeçalho model ausente ou com erro de digitação não falha: a requisição volta silenciosamente para s2.1-pro. Se o seu áudio de repente soar mais sem graça que as demos, confira o cabeçalho antes de culpar o modelo.
Um exemplo que vale copiar da documentação é [barely holding it together, forcing a smile] I'm fine. [shaky breath] Really. [small laugh] Go on without me. É uma fala com três funções diferentes e a forma mais rápida de descobrir se o modelo segue a direção com a sua voz.
Quão bom é o Drama 3 em testes independentes?
O próprio blog da Fish Audio diz que o Drama 3 é o primeiro na Artificial Analysis em Pronunciation Robustness. A Artificial Analysis confirma, e seus números também traçam os limites dessa afirmação.
"Drama 3 Preview is the #1 open weights model on all three of our Text to Speech leaderboards."
| Medida da Artificial Analysis | Drama 3 Preview | Ponto de referência |
|---|---|---|
| Pronunciation Robustness | 93,2%, posição 1 | Eleven v4 91,7%, Eleven v4 Turbo 90,1%, S2.1 Pro 88,1% |
| Arena Provider Voice (Elo) | 1.243, posição 10 | S2.1 Pro 1.142 (ganho de 101 pontos) |
| Arena Controlled Voice (Elo) | 1.058, posição 14 | n/d |
| Melhor rival de pesos abertos em pronúncia | n/d | Voxtral TTS da Mistral com 78,1% |
Fonte: thread da Artificial Analysis, 13 de outubro de 2026.
Leia essa tabela como um comprador deveria. A liderança em pronúncia é real, e a diferença para qualquer modelo de pesos abertos é de 15 pontos, o que importa se o seu roteiro está cheio de nomes de marca, códigos e números. Contra o Eleven v4, a margem é de 1,5 ponto. Na audição às cegas, porém, o Drama 3 é o 10º na arena Provider Voice, então "most emotive in the world" é a descrição da Fish Audio, não um ranking que mais alguém tenha produzido até agora. O salto em relação ao S2.1 Pro é o número mais útil: 101 pontos Elo entre dois modelos do mesmo laboratório.
A reação da comunidade no primeiro dia combina com essa divisão. Um usuário que colocou os pesos para rodar na própria máquina escreveu:
"It's fast and sounds great."

Outro foi mais direto sobre a troca com o tamanho:
"barely better than breeze with nearly 10x the size"
Esse comentário compara o Drama 3 com o Breeze TTS 2, um modelo aberto que a Artificial Analysis coloca logo atrás na arena Provider Voice (1.221 contra 1.243). As duas coisas são verdade: a liderança é pequena, e o espaço entre modelos abertos também.
Como acessar o Drama 3?
Há quatro caminhos, e eles servem a pessoas diferentes.
- App web e apps móveis. Abra Text to Speech em fish.audio com
?version=drama-3, ou use os apps de iOS e Android. A página de destino oferece o Drama 3 para testar grátis, e a voz licenciada do Uncle Roger está disponível para zoações. - API. Mantenha sua requisição
POST /v1/ttse adicione o cabeçalhomodel: drama-3. A thread de lançamento da Fish Audio lista parceiros do dia do lançamento, incluindo ComfyUI, Runway, Pika, OpenRouter e Vercel, embora eu só tenha conferido o anúncio do ComfyUI, que diz que ele roda como um Partner Node. Se você já usa o Runway, verifique se o nó dele expõe a mesma sintaxe de direção. - Pesos abertos. O modelo está no Hugging Face, com serviço SGLang-Omni desde o dia zero.
- Empresarial. O comunicado de imprensa da Fish Audio diz que empresas que trocam de outro provedor de voz ganham os três primeiros meses grátis; é uma conversa comercial.
Para equipes de suporte e operações que já lidam com vários fornecedores de voz, o resumo de agentes de voz e minha lista de empresas de voz com IA mostram onde um modelo como este se situa ao lado de plataformas completas de agentes.
Quanto custa o Drama 3?
Comece pela API, porque o preço é o número mais confuso deste lançamento. A publicação de lançamento da Fish Audio diz que o Drama 3 tem tabela de US$ 50 por milhão de caracteres e, de 13 de outubro a 12 de novembro, tem 80% de desconto, ou seja, US$ 10. A documentação de preços e a página de desenvolvedores da própria Fish Audio ainda listam apenas o S2.1 Pro a US$ 15 e não têm linha do Drama 3 em 14 de outubro, e a documentação cobra em bytes UTF-8 em vez de caracteres. Para texto simples em inglês os dois são próximos, mas confira seu painel antes de orçar.
"Drama 3 Preview is available via the Fish Audio API at $15/1M characters, the same as S2.1 Pro, compared to Eleven v4 at $80/1M characters and Eleven v4 Turbo at $40/1M characters."
Essa é uma listagem do dia do lançamento para o modelo de prévia, então eu a trataria como história. Oriente-se pelo preço de tabela de US$ 50 e trate os US$ 10 como um desconto de um mês. A página de preços de API da ElevenLabs lista o v4 a US$ 0,08 por 1.000 caracteres e o v4 Turbo a US$ 0,04, ou seja, US$ 80 e US$ 40 por milhão.
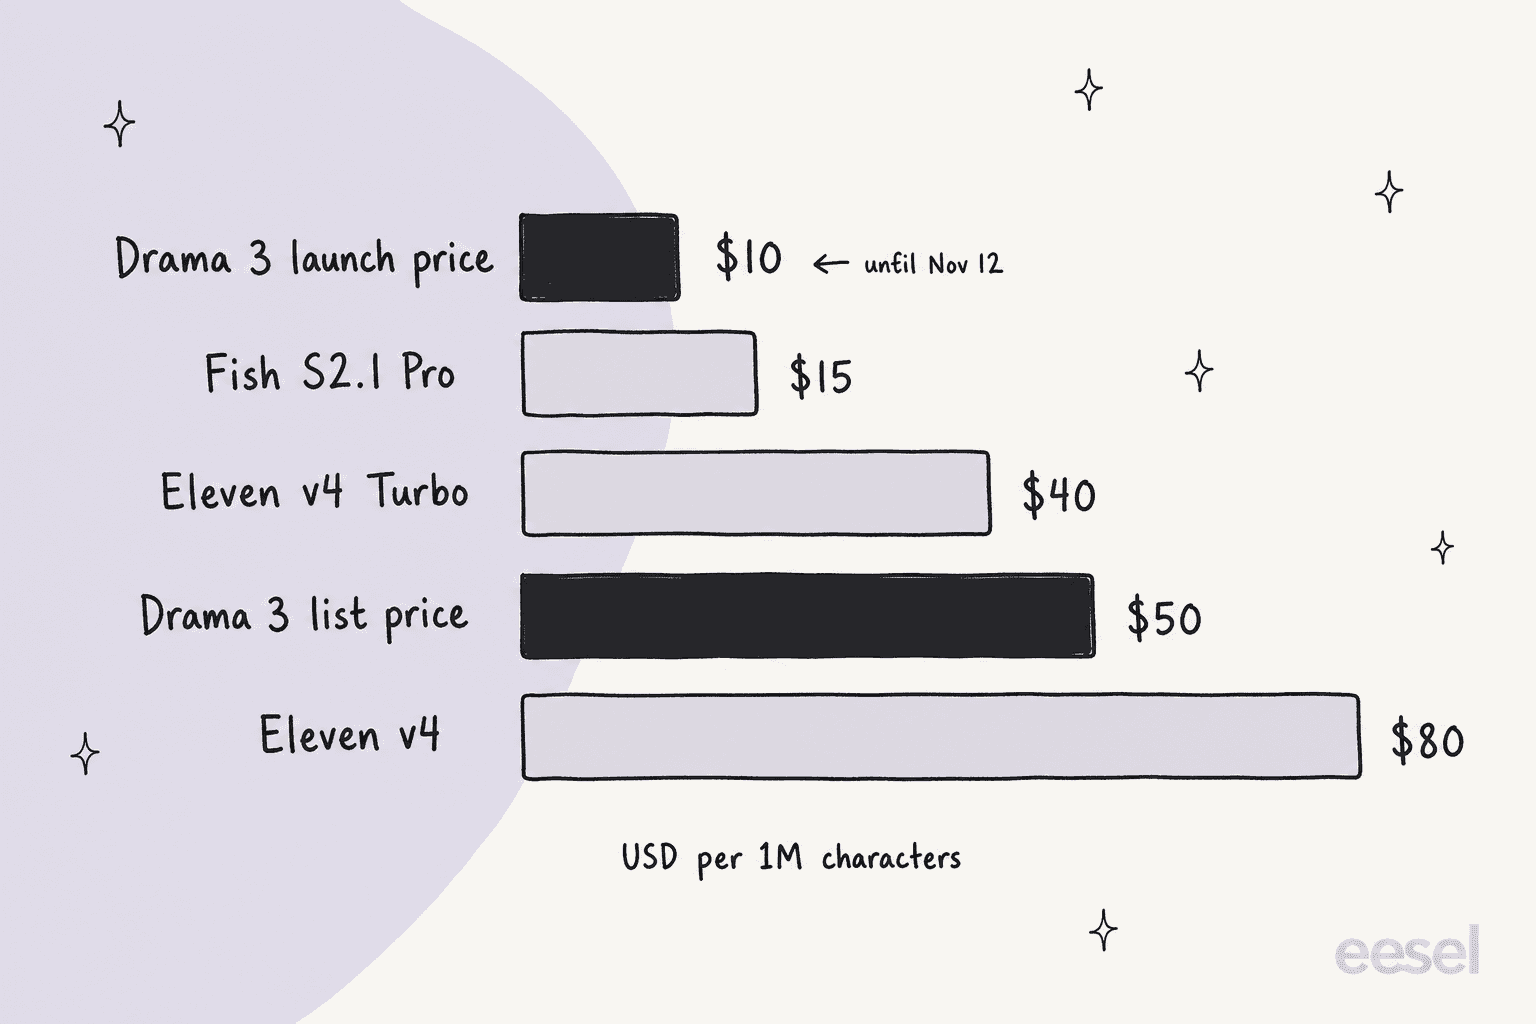
Veja quanto custa um trabalho de 450.000 caracteres, aproximadamente um romance de 80.000 palavras, usando a mesma contagem de caracteres em todas as linhas:
| Caminho | Preço por milhão de caracteres | Custo para 450.000 caracteres |
|---|---|---|
| Drama 3, preço de lançamento (até 12 nov.) | US$ 10 | US$ 4,50 |
| Drama 3, preço de tabela | US$ 50 | US$ 22,50 |
| Eleven v4 Turbo | US$ 40 | US$ 18,00 |
| Eleven v4 | US$ 80 | US$ 36,00 |
| Drama 3 hospedado por você | Só tempo de GPU | Grátis abaixo de US$ 500.000 de receita |
No preço de tabela, o Drama 3 é mais barato que o Eleven v4, mas mais caro que o Turbo, então a escolha é sobre a voz e não sobre a conta. Para análises mais detalhadas, veja meus guias de preços do Eleven v4 e preços da ElevenLabs, e os preços do Gemini 3.8 Flash TTS se você estiver avaliando o Google.
Os apps funcionam de outra forma. O Drama 3 custa os mesmos créditos que o S2.1 Pro e, até 12 de novembro, um novo plano Plus, Pro ou Max tem 50% de desconto no primeiro mês na cobrança mensal ou no primeiro ano na cobrança anual.
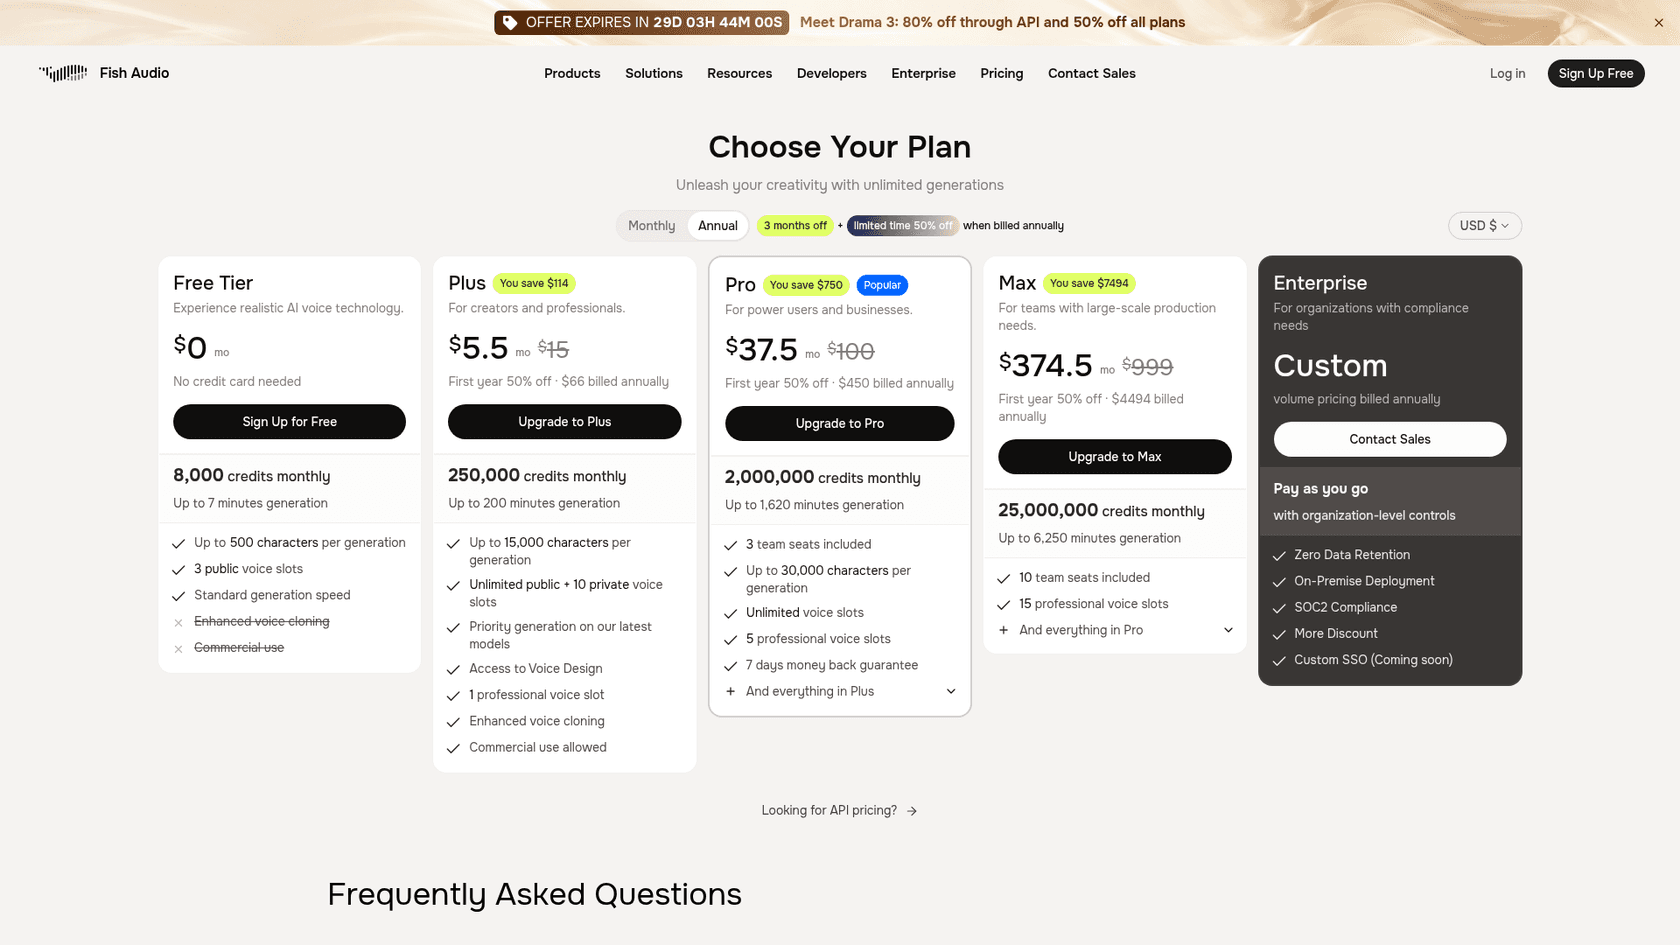
| Plano | Preço exibido (anual, primeiro ano) | Créditos por mês |
|---|---|---|
| Free | US$ 0 | 8.000, até 500 caracteres por geração, sem uso comercial |
| Plus | US$ 5,50 por mês, US$ 15 riscado | 250.000 |
| Pro | US$ 37,50 por mês, US$ 100 riscado | 2.000.000, 3 assentos de equipe |
| Max | US$ 374,50 por mês, US$ 999 riscado | 25.000.000, 10 assentos de equipe |
| Enterprise | Personalizado | Pague conforme o uso, SOC 2, retenção zero de dados |
Fonte: página de planos da Fish Audio, capturada em 14 de outubro de 2026. Os preços riscados são as taxas posteriores à oferta.
Dá para rodar o Drama 3 por conta própria?
Sim, com condições. Os pesos estão no Hugging Face sob a Fish Audio Community License v1.0. É gratuita para pesquisa e uso não comercial, e gratuita para uso comercial se você e suas afiliadas tiverem menos de US$ 500.000 de receita anual. Acima disso, ou para oferecer o Drama 3 a terceiros como serviço de TTS, clonagem de voz ou inferência, você precisa de uma licença da Fish Audio. Ela também proíbe clonar a voz de uma pessoa real sem o consentimento dela. A Fish Audio chama o lançamento de open-weight e não de open source, e essa é a palavra correta.
O hardware é o outro limite. O model card lista 36B de parâmetros em FP8 e bf16, e os relatos da comunidade no dia do lançamento iam de "needs a 48gb Cuda card" até uma execução em duas GPUs de consumo:
"Opus 5.5 was able to get it running on my two RTX 3090s at ~39gb of VRAM."
Os números da própria Fish Audio vêm de NVIDIA H200. Em uma H200 com um único fluxo, o card do Hugging Face informa uma mediana de tempo até o primeiro áudio de 88,9 ms e, com 16 fluxos simultâneos, a mediana é de 210,1 ms. A licença gerou alguma reclamação, e um comentarista respondeu com justiça:
"License is a bit lame but I understand they need to make money too lol"
Se você está comparando hospedagem própria com um caminho gerenciado, meu resumo de agentes de IA de código aberto cobre a mesma troca para software de agentes.
Quais são os limites do Drama 3?
Seis coisas a saber antes de comprometer um projeto com ele:
- Ele é voltado a falas renderizadas. A própria publicação de lançamento da Fish Audio diz que o Drama 3 rende melhor em falas roteirizadas que você renderiza uma vez e guarda, como audiolivros, drama em áudio, jogos e vídeos curtos. Conversa ao vivo é outro trabalho; compare o Eleven v4 Turbo ou o Cartesia Sonic 3 para isso.
- Os takes variam. A Fish Audio diz para renderizar alguns e ficar com o que funciona.
- A edição ainda não está aberta. Edição interativa e inpainting de áudio estão em testes pequenos só por convite, com uma API de edição "coming soon".
- A troca de idioma é experimental. As tags no estilo
<french>não são garantidas para todos os idiomas ou vozes. - A licença tem condições. O teto de receita e a regra de não vender como serviço importam para quem constrói um produto de voz em cima dele.
- A linha de preço ainda não está na documentação. Veja acima.
Eu também não leria a contagem de 83 idiomas como 83 idiomas igualmente bons. As pontuações de pronúncia da Fish Audio são apenas de inglês, então teste o idioma de que você realmente precisa, como um usuário do Reddit perguntou no dia do lançamento sobre alemão, ainda sem resposta. Para trabalho multilíngue voltado ao cliente, meu guia de controle de qualidade de suporte multilíngue mostra como verificar cada idioma separadamente.
Quem deve usar o Drama 3 e quem deve deixar de lado?
Use-o para audiolivros, podcasts de ficção, diálogos de jogos e vídeos curtos em que cada fala é renderizada, revisada e guardada. As tags delimitadas são o recurso que justifica a atualização: corrigir uma palavra de uma fala é mais barato do que regenerar um capítulo, o que a CEO da Fish Audio, Rissa Cao, apresenta como o objetivo do trabalho de longa duração. Se você faz roteiros de vídeos ou podcasts, os geradores de roteiro de podcast com IA e as ferramentas de roteiro de vídeo com IA combinam naturalmente com ele.
Olhe as alternativas se você quer a voz mais comprovada em audição às cegas; nesse caso, ElevenLabs e Cartesia são as comparações óbvias, ou uma camada de emoção no estilo da Hume AI. Meu post de alternativas à ElevenLabs as coloca lado a lado.
Deixe de lado por enquanto se você precisa de um agente telefônico ao vivo pronto para uso. O Drama 3 é uma voz, não um agente, então você ainda precisa de algo que decida o que dizer e quando passar para uma pessoa. Para isso, veja Retell AI, Vapi, Decagon Voice 3 e Grok Voice Think Fast 2. Se você só está comparando APIs de fala por custo e simplicidade, a API de fala da OpenAI e Whisper vs a API de TTS são as referências mais simples.
O que um modelo de voz significa para uma equipe de suporte?
Um modelo de voz muda como uma resposta soa, não se a resposta está certa. Um cliente que ouve uma política de reembolso calorosa e bem ritmada ainda recebe o prazo de reembolso errado se o agente por trás tiver chutado. Vozes expressivas tornam os erros mais convincentes, e é por isso que me importo com a camada de baixo.
O padrão que continuo vendo em filas reais é que as equipes querem voz, mas começam pelos tickets. Uma equipe de suporte que usa a eesel escreveu que a falta de suporte a gravações de voz obrigava os agentes a resumir as ligações manualmente para a IA, e que adicioná-lo "would significantly increase our usage". É um pedido de recurso, e não vou exagerar: a eesel hoje é focada em texto, trabalhando com tickets e chats em vez de áudio telefônico. A configuração útil é acertar as respostas primeiro em texto e depois passá-las ao modelo de voz que couber.
Se você está pensando em voz para suporte, as ferramentas de atendimento ao cliente por voz e os agentes de voz com IA do Zendesk são bons pontos de partida, e a IA conversacional para atendimento ao cliente cobre a camada anterior à voz. Mantenha também a voz coerente com a sua marca; um modelo que segue direção só é útil se alguém escreve a direção.
Experimente a eesel
Se sua equipe está avaliando voz porque tickets e chats estão se acumulando, comece onde as respostas são feitas. O colega de IA para helpdesk da eesel entra no helpdesk que você já usa, aprende com seus tickets anteriores e sua central de ajuda e responde no seu tom. Antes de tocar em um cliente real, você pode executá-lo contra tickets históricos para ver o que ele teria dito, que é como eu testaria também o roteiro de qualquer camada de voz.

Se você prefere um terminal, a CLI da eesel permite que você, um script ou um agente de programação como o Claude Code leiam e alterem as instruções do mesmo colega e revisem sua atividade, como você faria com qualquer outro serviço. O plano gratuito inclui 100 créditos sem cartão, e a página de preços mostra os níveis pagos. Experimente a eesel nos tickets do mês passado antes de decidir qualquer coisa sobre voz.
Perguntas frequentes
O que é o Fish Audio Drama 3?
Quanto custa o Fish Audio Drama 3?
O Drama 3 é open source e gratuito para uso comercial?
Como uso o Drama 3 pela API?
POST /v1/tts atual e defina o cabeçalho model: drama-3. Um cabeçalho ausente ou com erro de digitação volta para s2.1-pro sem erro, então confira-o primeiro se o áudio soar sem graça. A mesma chamada funciona em scripts e agentes de programação, como a CLI da eesel faz com um colega de suporte.