

Meu veredito num relance
Se você ler só uma seção, leia esta tabela. É a análise comprimida nas seis dimensões que realmente me importam quando um modelo assim chega à minha mesa.
| Dimensão | Nota | O que encontrei |
|---|---|---|
| Velocidade | A | 32,8 ms p50 por pergunta roteada, cerca de 7,8 vezes mais rápido que os 236-276 ms da Jev |
| Calibração | A | ECE 0.081 após reajuste de temperatura contra 0.246 da Jev, um 3x real |
| Precisão zero-shot | D | ~0.362 base, mal acima da linha de base aleatória de 0.318 |
| Precisão com fine-tuning | A- | 0.766 no conjunto tipado, acima do teto do professor de 0.735 |
| Tarefas de alta cardinalidade | C | Piora acima de ~20 opções; 0.425 no Banking77 de 77 classes |
| Custo e licença | A+ | Apache 2.0, $0 hospedado por conta própria, roda isolado da rede |
O formato desse boletim é a análise inteira: brilhante em ser rápido, honesto e barato; mediano até você investir em fine-tuning; fraco em classificação ampla. Se você quer o passo a passo completo da arquitetura em vez do veredito, escrevi isso à parte no aprofundamento sobre o Laya AI.
O que é o Laya AI, em um parágrafo
A maior parte da IA que você já usou é autorregressiva: ela prevê o próximo token, depois o próximo, construindo uma frase. Isso é ótimo para escrever uma resposta e um desperdício para uma decisão de sim ou não, o tipo de lacuna que separa uma verdadeira plataforma de IA conversacional de um modelo bruto. O Laya é do outro tipo: um codificador bidirecional que lê a entrada inteira de uma vez e responde a uma pergunta fixa pontuando as suas opções em vez de escrevê-las. A Convai o chama de modelo de Sistema 1, o julgamento reflexo instantâneo, em oposição ao raciocínio lento de Sistema 2 de um LLM generativo. O criador, Nandakishor Mukkunnoth, resume a motivação em uma linha:
"Not every AI problem requires an autoregressive chatbot."
Ele tem razão, e se você já acoplou um modelo de 8B a um prompt que termina em "respond only with JSON" só para rotear um ticket, você sentiu exatamente a dor que ele resolve. Esta análise presume que você já aceita essa premissa e foca em saber se a execução se sustenta.
Você deveria usar o Laya AI? Uma checagem rápida de adequação
A decisão de compra aqui é incomumente clara, então em vez de enterrá-la em prosa, esta é a decisão que eu explicaria a um colega. Escolha o ramo que combina com você.
O que os benchmarks realmente dizem
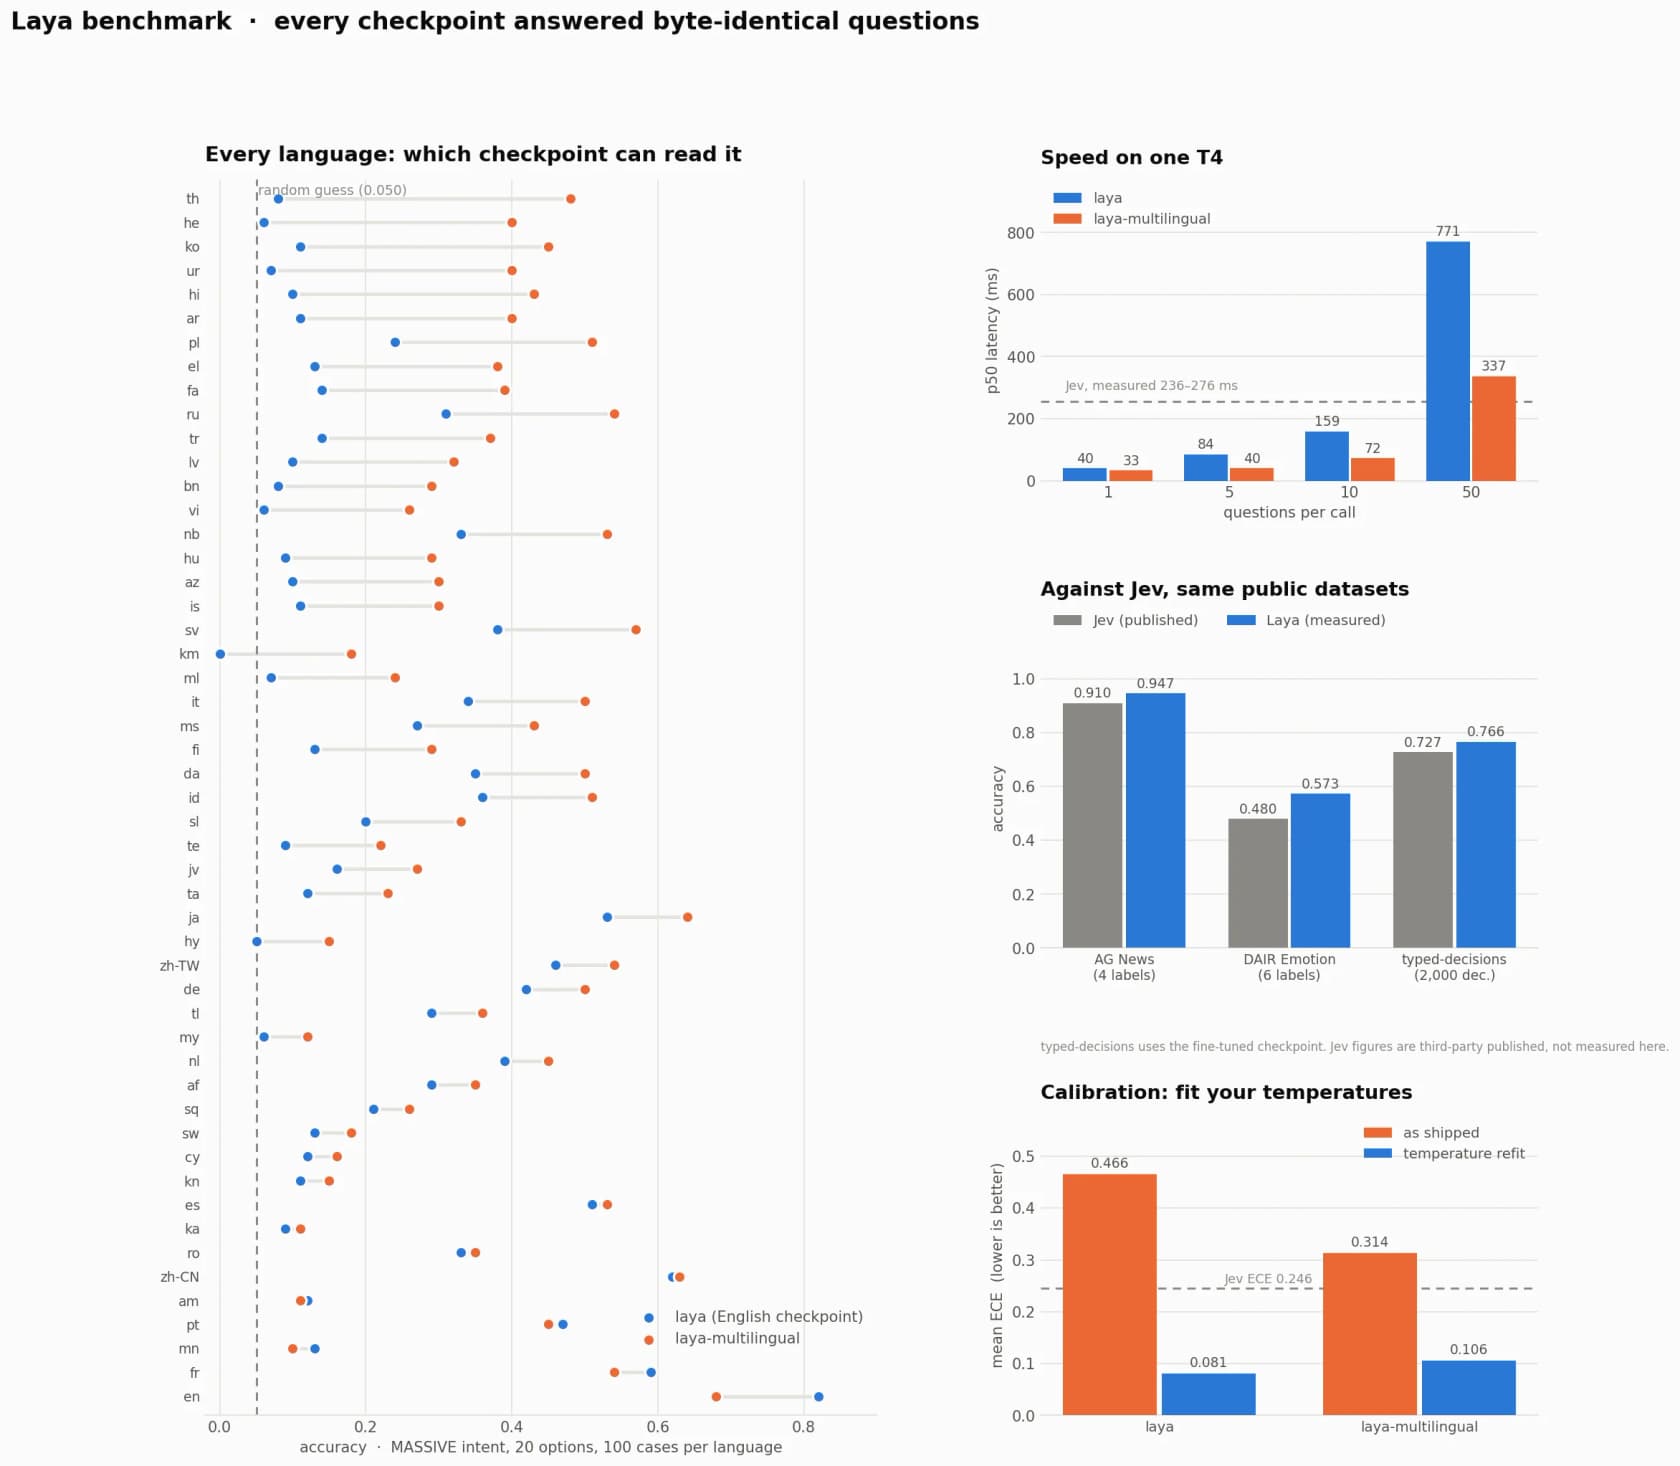
Aqui está a comparação completa que o projeto publicou contra a Jev. É densa, mas o destaque é que o Laya (roteado) supera a Jev nos conjuntos de dados públicos compartilhados, sendo muito mais rápido e melhor calibrado.
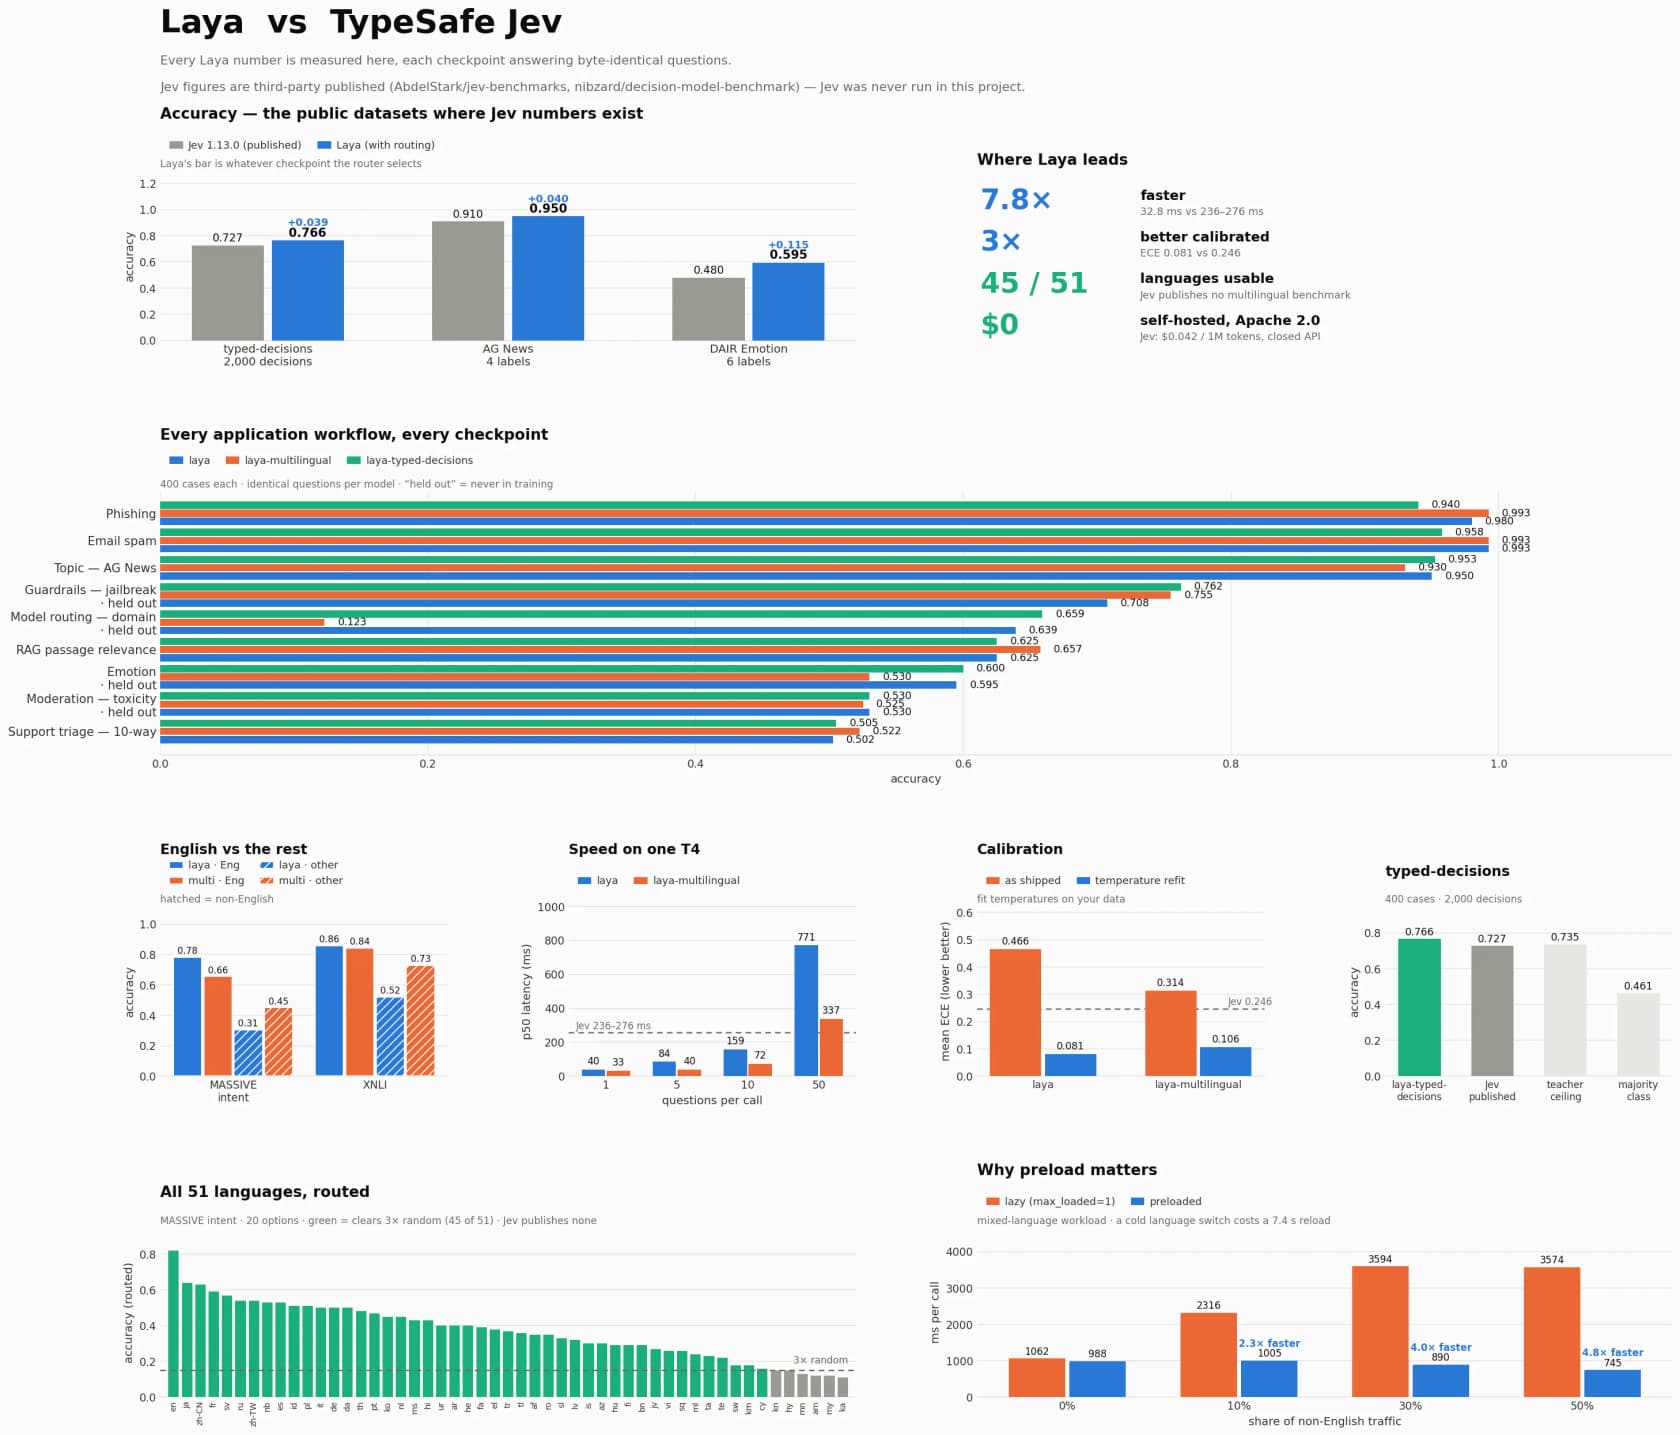
Os três números que vale levar, todos medidos em uma única Tesla T4 com os dados da Jev publicados por terceiros (a Convai não teve acesso à API):
- Latência: 32,8 ms p50 para uma pergunta roteada, contra 236 a 276 ms da Jev. Esse é o 7,8x.
- Calibração: ECE de 0.081 após reajuste de temperatura, contra 0.246 da Jev, uma pontuação de calibração 3x melhor.
- Precisão: 0.766 no conjunto tipado de 2.000 decisões, contra 0.727 da Jev, e supera o teto do professor de 0.735.
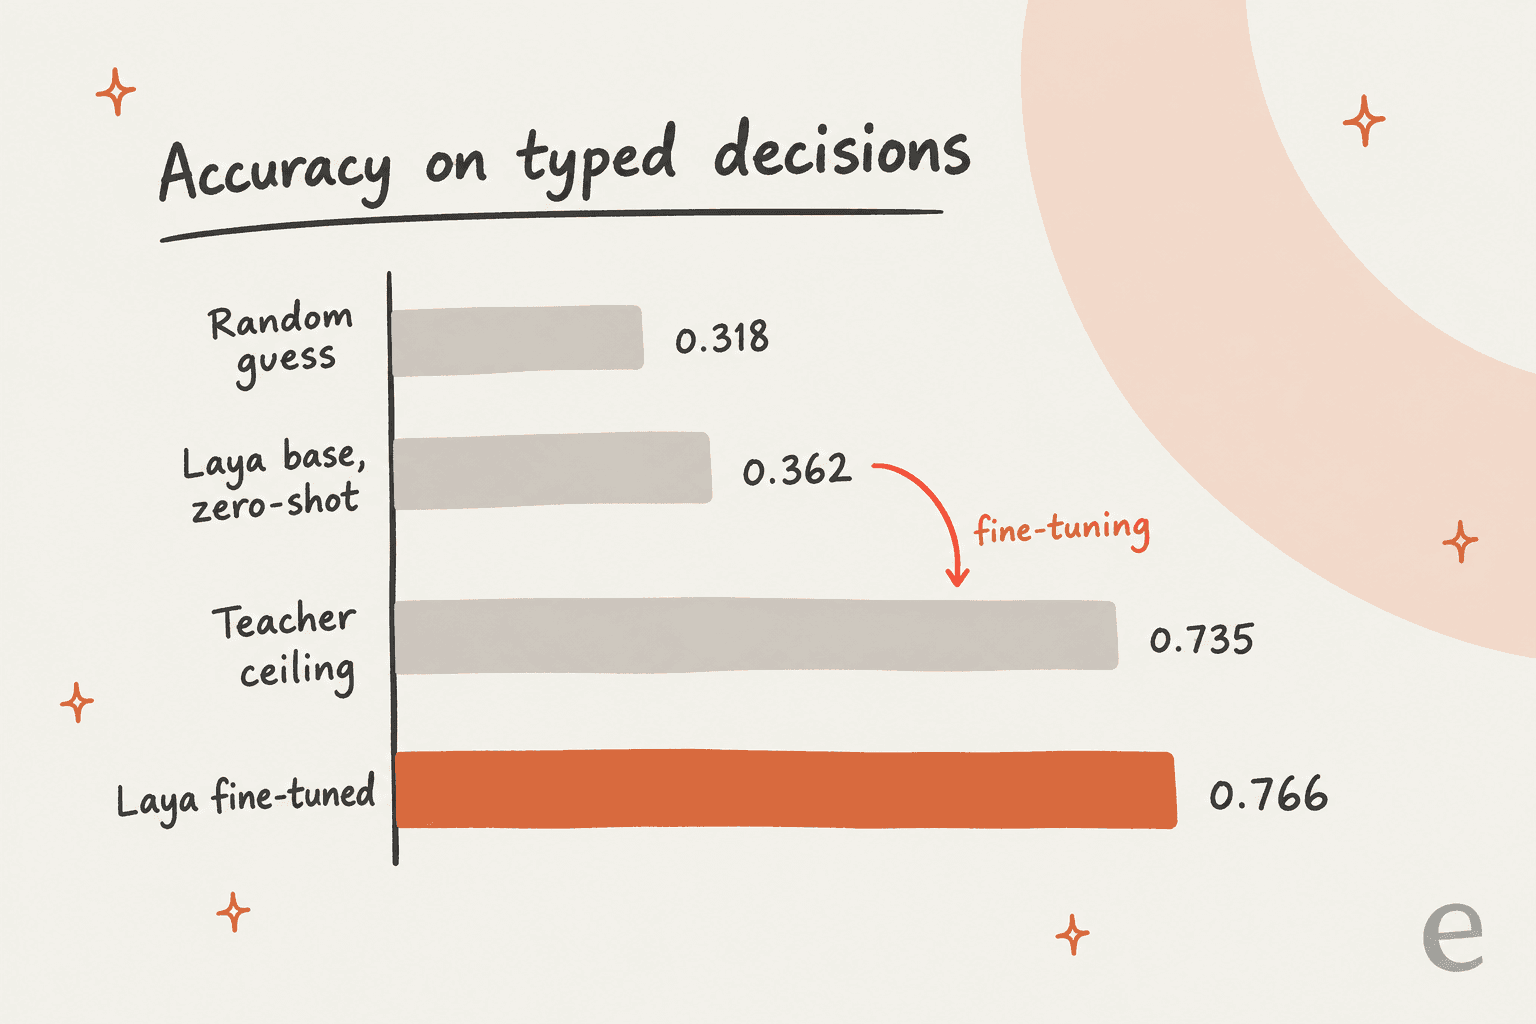
E então o asterisco que dominou toda discussão séria do lançamento. Esse 0.766 é o checkpoint com fine-tuning. Os modelos base, intocados, pontuam cerca de 0.362 no mesmo benchmark, um fio acima da linha de base aleatória de 0.318. A própria seção de limitações da Convai diz isso com clareza, o que respeito. No Hacker News, onde o lançamento passou de 1.300 pontos, o principal comentário crítico foi exatamente este:
"This should be way up in the article. Fine tuning is a pain, requiring it for good results put Laya in a whole different category vs Jev"

É um golpe justo e a linha mais importante de toda esta análise. A Jev é vendida como utilizável zero-shot; o Laya, lido com honestidade, é uma base que você especializa.
Onde o Laya realmente brilha
Tirado o drama com a Jev, o Laya é um classificador rápido com confiança honesta, o que vale muito. A calibração é o que eu mais buscaria nele, e combina com algo que aprendi da pior maneira operando automação de suporte: a falha perigosa não é um bot que diz "não sei", é um que está confiantemente errado. Um modelo que informa probabilidades honestas permite filtrar por confiança e escalar as decisões duvidosas, e isso vale mais para mim do que um ponto de precisão bruta. A Convai o treina com um esquema que chama de RLCD, aprendizado por reforço contra regras de pontuação estritamente próprias, e a frase de Nandakishor sobre por que o treinamento ingênuo falha é a mais afiada do texto:
"Naive RL maximizes accuracy by destroying calibration. It turns your model into a confidently wrong machine."
Os resultados por fluxo de trabalho confirmam onde ele é forte. O Laya informa:
- Filtragem de spam de e-mail: 0.993
- Detecção de phishing: 0.980
- Guardrails de LLM e detecção de jailbreak: 0.755 a 0.762 (0.931 com 50% de cobertura seletiva)
- Relevância de trechos em RAG: 0.657
- Roteamento de tickets de suporte, 10 classes: 0.522
As decisões binárias de segurança são excelentes, e a pontuação de roteamento é uma base sólida para o tipo de exemplos de agentes de IA que as equipes realmente lançam. A história operacional é igualmente boa: 45 de 51 idiomas ficam acima de 3 vezes o acaso quando roteados, contra zero números multilíngues publicados pela Jev.
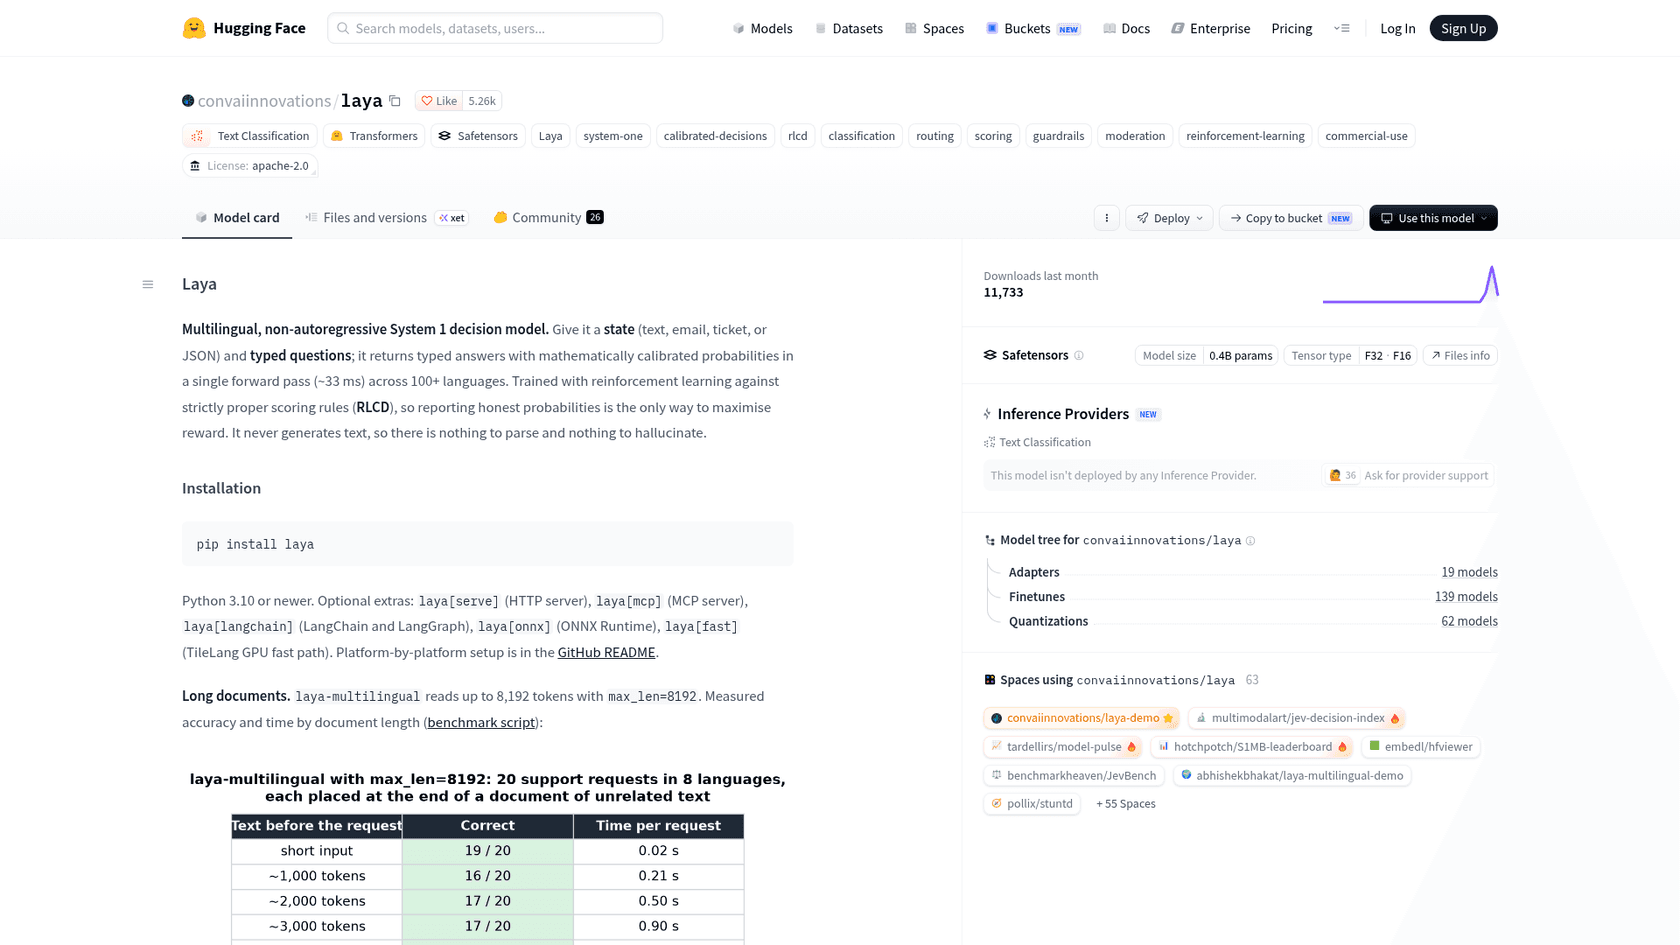
Em custo, é Apache 2.0 e hospedado por conta própria, então são $0.00 por milhão de tokens contra $0.042 da Jev, uma diferença que cresce rápido quando você a compara ao custo de um agente humano, e roda isolado da rede no seu próprio hardware, o que importa para quem tem restrições de HIPAA ou LGPD/GDPR. A instalação é uma linha, pip install laya, e Router(preload=True) mantém todos os checkpoints residentes para evitar um recarregamento a frio de 7 a 10 segundos ao trocar de idioma.
O model card agora lista extras opcionais para um servidor HTTP, um servidor MCP, LangChain e ONNX. O repositório do GitHub também documenta um endpoint /v1/systemone compatível com a Jev, então você pode servir o Laya como API em vez de chamá-lo no mesmo processo.
Onde ele fica a desejar
Quero ser justo, porque as lacunas são reais, mas mais estreitas do que a internet fez parecer. Três coisas se destacaram nos testes.
Primeiro, o fine-tuning não é opcional para trabalho de precisão, o que exclui o Laya como chatbot sem código para quem não é engenheiro. O 0.362 zero-shot é o número honesto, e um profissional no HN descreveu o custo disso melhor do que eu poderia:
"Idk, your limitations section sure makes it seem less drop in and less general than Jev... I don't want to manage GPUs / CPUs now. I don't want to maintain my corpus and retrain as my product's data distribution shifts... I do just want a reasonably good general classifier served to me with a great devex and calibrated confidence scores to help me figure out when to fallback."
Segundo, a classificação de alta cardinalidade sofre, o que importa se você esperava substituir uma frota de modelos de IA personalizados por um único roteador. No Banking77 (77 rótulos) o Laya marcou 0.425 contra 0.870 da Jev, porque cada opção só tem 3 a 4 tokens para se distinguir no orçamento padrão. A solução é aumentar o orçamento de tokens ou dividir em uma hierarquia do grosso ao fino, mas de fábrica um roteador de 10 classes é confortável e um de 77 não.
Terceiro, o modo de falha multilíngue é feio se você ignorar o roteador. O modelo raiz em inglês colapsa fora dos alfabetos latinos: na varredura de 51 idiomas ele marcou 0.000 de precisão em khmer enquanto informava 0.952 de confiança, exatamente a armadilha do "confiantemente errado" que o modelo pretende evitar. O Laya traz um Router embutido que detecta o alfabeto em menos de meio milissegundo e escolhe o checkpoint multilíngue, então tem solução, mas é preciso usá-lo.
Nada disso é impeditivo. São os limites de um componente, e todos estão documentados, o que é mais do que a maioria dos lançamentos consegue.
O que a comunidade realmente pensa
A reação foi barulhenta e, depois de filtrar o drama da prioridade, útil. A crítica mais repetida foi a ressalva do zero-shot quase aleatório, colada literalmente por várias pessoas que achavam que deveria estar no topo do anúncio. A resposta do lado entusiasta foi igualmente consistente:
"In the limitations you say that 'Out-of-the-box base models score ~0.35 on the typed-decisions benchmark (near random)...' - but that's the whole point, you can obviously fine-tune specialized models but having a model follow you instructions and be promotable and fast makes it massively easier to use."
E o valor prático, quando alguém cortou o ruído, ficou claro:
"The ability to knock out any arbitrary classification problem in minutes instead of in a week is a big deal... I don't want to spend a week to create a dataset, finetune a model, and set up infrastructure to run the model, every time I have a small routing or classification problem."
Houve também um alívio geral por a versão aberta existir, até entre céticos que leram a linguagem de "can't hallucinate" do lançamento irmão da Jev como isca para capital de risco. É mais ou menos onde eu também chego, e lembra como a comunidade reagiu às atualizações do Claude da Anthropic para suporte: confiança conquistada vale mais que afirmações barulhentas.
A controvérsia, em resumo
Não dá para analisar o Laya sem a história de origem, porque ela é metade do motivo de ele ter viralizado. O argumento de Nandakishor é uma reivindicação de prioridade: ele diz que publicou essa abordagem não autorregressiva treinada com RL em um artigo do arXiv de março de 2025, um ano inteiro antes de a TypeSafe lançar a Jev.
A comunidade se dividiu de forma justa, alguns notando que uma marca limpa e uma API utilizável são em si o produto. Minha opinião é que a briga por crédito distrai de um lançamento sólido. Tenha o Laya sido o primeiro ou não, ele é aberto, rápido, honestamente documentado e funciona bem para os trabalhos sobre os quais é honesto. Detalho a cronologia completa na visão geral do Laya AI se você quiser.
Onde um modelo de decisão se encaixa versus um colega de IA
Esta é a parte que mais me importa, porque construo isso para viver. Um modelo de decisão e um colega de IA não são concorrentes, vivem em camadas diferentes.
O Laya é infraestrutura. Ele responde "a que fila este ticket pertence" ou "isto é urgente?" em 33 ms, e faz essa única coisa maravilhosamente. Mas não lê a sua central de ajuda, não redige a resposta, não consulta o status do pedido e não fecha a conversa. Esses são os trabalhos reais que uma equipe de suporte precisa ver feitos, e eles exigem um modelo que age, não um que apenas classifica. Essa é a diferença entre um componente e um funcionário.
A eesel é uma plataforma de colegas de IA, e o colega de IA de helpdesk é o contratado para suporte. Ele entra na sua fila existente no Zendesk, Freshdesk ou onde você já trabalha, lê seus tickets e documentos anteriores e resolve o ticket inteiro de ponta a ponta. Por baixo, ele toma as mesmas decisões rápidas e calibradas de roteamento e confiança em que o Laya é bom, mas as envolve na leitura, na redação e na ação que transformam uma classificação em uma conversa resolvida. Se você é desenvolvedor e prefere programar esse colega a clicar nele, a CLI da eesel e o servidor MCP deixam uma pessoa, um script ou um agente de código como o Claude Code operar o mesmo workspace que o painel usa, que é o lar natural para exatamente o tipo de classificação programática que os fãs do Laya querem.
Experimente a eesel
Se você está olhando o Laya porque quer decisões de suporte mais inteligentes e rápidas, vale deixar claro o que está comprando. Um modelo de decisão lhe dá um componente para construir. Um colega de IA de suporte lhe dá o trabalhador pronto.

Confio no argumento de calibração que o Laya defende porque vivi a alternativa. Vi bots de tom confiante darem respostas erradas em silêncio em filas reais, e por isso toda implantação da eesel roda primeiro uma simulação sobre os seus próprios tickets históricos, para você ver a taxa de resolução exata e as respostas exatas antes de tocar em um único cliente. O preço é um preço mensal fixo, a partir de $299/mês por 500 créditos (1 crédito por ticket ou chat), sem taxas por usuário, e há um plano gratuito com 100 créditos. Se você quer a decisão executada e não apenas rotulada, essa é a camada para olhar.
O que eu diria a um amigo
O Laya é uma contribuição real, e fico feliz que seja aberto. Se você é desenvolvedor com problemas de classificação ou roteamento e disposição para fazer fine-tuning, é uma das ferramentas novas mais interessantes do ano: rápida, calibrada, multilíngue e gratuita. Leia primeiro o model card, ele é refrescantemente honesto sobre os próprios limites, e essa honestidade é boa parte do motivo de esta análise ser positiva.
Mas leia essa seção de limites antes de construir em cima dele. Os números zero-shot são quase aleatórios, a confiança precisa ser reajustada com seus dados e a classificação ampla pede fine-tuning. Trate-o como a excelente base que ele diz ser. E se o que você realmente precisa é o trabalho de suporte inteiro feito, em vez de uma única decisão devolvida, recorra a um colega, não a um componente.
Perguntas frequentes
Vale a pena usar o Laya AI em 2026?
Para o trabalho certo, sim. Minha análise do Laya AI chega a isto: se você é desenvolvedor, tem problemas de roteamento ou classificação e disposição para fazer fine-tuning, o Laya é um dos lançamentos abertos mais interessantes do ano: rápido, calibrado, multilíngue e gratuito. Se você quer algo que resolva um ticket de suporte inteiro em vez de apenas rotulá-lo, precisa de um colega de IA de helpdesk.
Quanto custa o Laya AI?
O Laya é gratuito. Os pesos são Apache 2.0 no Hugging Face, então hospedar por conta própria custa $0.00 por milhão de tokens, contra os $0.042 por milhão de tokens cobrados pela API fechada da Jev. Seu único custo real é a GPU ou CPU em que você o executa. Se preferir não rodar nenhum modelo, a eesel tem um preço mensal fixo a partir de $299/mês por 500 créditos (1 crédito por ticket ou chat), sem taxas por usuário.
O Laya AI é bom para rotear tickets de suporte?
É uma base forte para isso, não um roteador pronto. Em um conjunto de triagem de suporte com 10 classes, o modelo base pontua 0.522, e cada resposta vem com uma pontuação de confiança calibrada na qual você pode definir limites. Para um panorama maior, veja nosso resumo da melhor IA para triagem de tickets de suporte e a mecânica da própria triagem de tickets.
Preciso fazer fine-tuning do Laya AI?
Para precisão séria, normalmente sim. De fábrica, os checkpoints base pontuam quase ao acaso (~0.362) no benchmark de decisões tipadas; o 0.766 dos destaques vem de fazer fine-tuning nessa tarefa. Trate o Laya como uma base rápida para especializar e reajuste a temperatura dele com seus próprios dados antes de confiar nos números de confiança. Ferramentas como a eesel evitam esse passo aprendendo diretamente da sua base de conhecimento.
O Laya AI realmente não alucina?
Dentro do seu espaço de saída, sim. O Laya nunca emite tokens de texto, apenas probabilidades sobre um conjunto fixo de opções que você define, então uma categoria inventada ou um JSON malformado é impossível por construção. Ele ainda pode estar errado, e por isso a pontuação de confiança calibrada importa muito mais que o slogan de marketing, e por isso uma taxa de resolução honesta vale mais que um palpite confiante.
Laya AI vs Jev: qual é melhor?
Eles otimizam para compradores diferentes. A Jev é vendida como uma API zero-shot utilizável; o Laya é uma base aberta que você especializa e, nos próprios benchmarks, é cerca de 7,8 vezes mais rápido e 3 vezes mais bem calibrado. O veredito da minha análise do Laya AI: escolha o Laya se for hospedar por conta própria e fazer fine-tuning, e a Jev se quiser uma API que funcione sem ajuste. Para uma visão mais ampla, veja nossa análise completa do Laya AI.
O que dá para construir de fato com o Laya AI?
Decisões estruturadas rápidas: filtros de spam e phishing, guardrails para LLMs, relevância de trechos em RAG, pontuação de sentimento e roteamento. Ele se encaixa onde você hoje paga demais a um modelo generativo por uma decisão pequena. Em uma stack de suporte, combina naturalmente com a análise de sentimento com IA e a marcação automática de tickets.