

O que o Laya AI realmente é
O slogan na página inicial do Laya é "decisions, not text" (decisões, não texto), e esse é o produto inteiro em três palavras. A maior parte da IA que você já usou é autorregressiva: ela prevê o próximo token, depois o próximo, construindo uma frase. Isso é ótimo para escrever uma resposta e péssimo para uma decisão de sim ou não, porque você roda um modelo de linguagem para obter um único bit de informação e depois interpreta texto livre para recuperá-lo.
O Laya é o outro tipo de modelo. É um codificador bidirecional que lê toda a entrada de uma vez e responde a uma pergunta fixa pontuando suas opções, em vez de escrevê-las. A Convai o chama de modelo System 1: o julgamento instantâneo e reflexo, em oposição ao raciocínio System 2, lento e deliberativo, de um LLM generativo. O criador, Nandakishor Mukkunnoth, da Convai Innovations, resume a motivação sem rodeios:
"Not every AI problem requires an autoregressive chatbot."
Ele tem razão, e se você já ligou um modelo de 8B a um prompt que termina em "respond only with JSON", sentiu a dor que ele descreve.
A ideia: System 1, não System 2
A proposta se apoia em uma ineficiência real. Quando você chama um modelo generativo para rotear um ticket ou marcar um e-mail de phishing, paga três vezes: 500 a 2.000 ms de latência, custo real de inferência e um parsing de strings frágil na saída. Pior ainda, o número de confiança que um LLM lhe dá é teatro. Como diz Nandakishor:
"When an LLM outputs 'confidence: 0.95', it is just predicting tokens that sound confident. There is zero mathematical calibration behind it."
A resposta do Laya é transformar a decisão reflexa em seu próprio modelo, um que devolve uma distribuição de probabilidade de verdade em vez de uma frase que soa confiante. Esse contraste é toda a razão de o modelo existir.
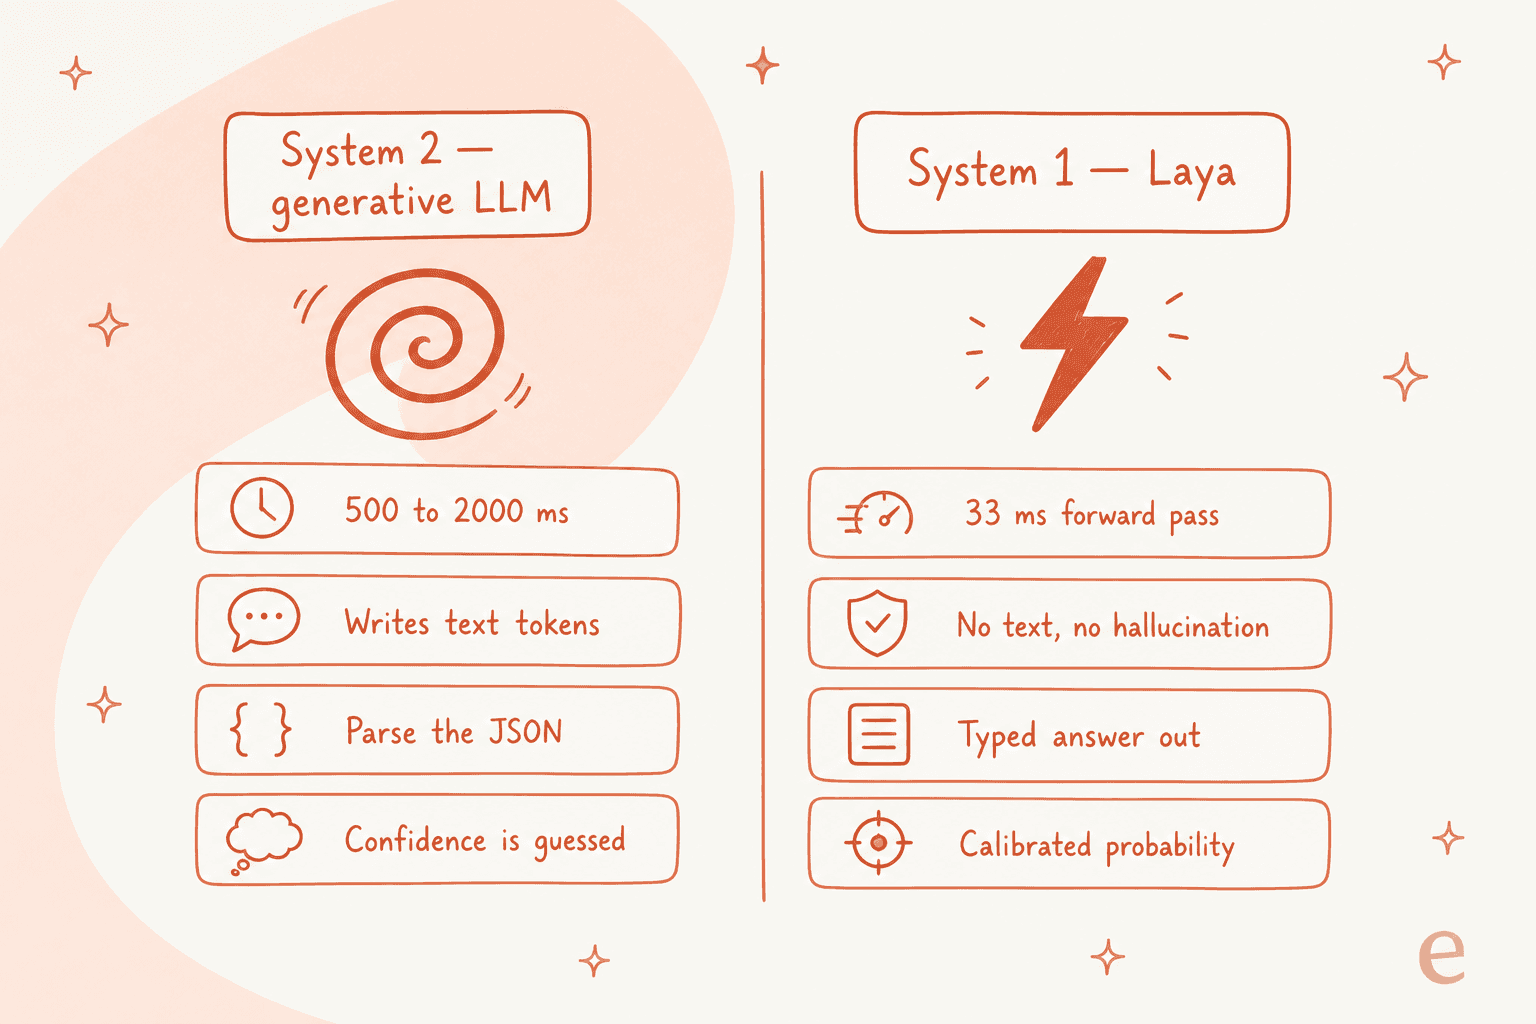
Esta é a parte que acho mais interessante, porque combina com algo que aprendi do jeito difícil. A falha perigosa na automação de suporte não é um bot que diz "não sei". É um bot que está confiante e errado. Um modelo que informa probabilidades honestas vale mais do que um ponto acima em precisão bruta, porque você consegue de fato definir um limite pela confiança e escalar os casos duvidosos. O Laya foi construído em torno dessa ideia desde o início.
Como o Laya funciona por dentro
Mecanicamente, o Laya recebe um estado mais uma ou mais perguntas tipadas e responde a todas em uma única passagem paralela. Há três primitivas de pergunta e, quando você as conhece, percebe que cobrem a maioria das "decisões" de um fluxo de suporte:
- choice escolhe uma opção de um conjunto que você define (roteamento, intenção, tópico).
- score posiciona o estado em uma escala ordinal, como de 0 a 3 (urgência, frustração, gravidade).
- noul é um booleano que devolve um P(true) calibrado de 0.0 a 1.0 (phishing, spam, jailbreak, risco de cancelamento).
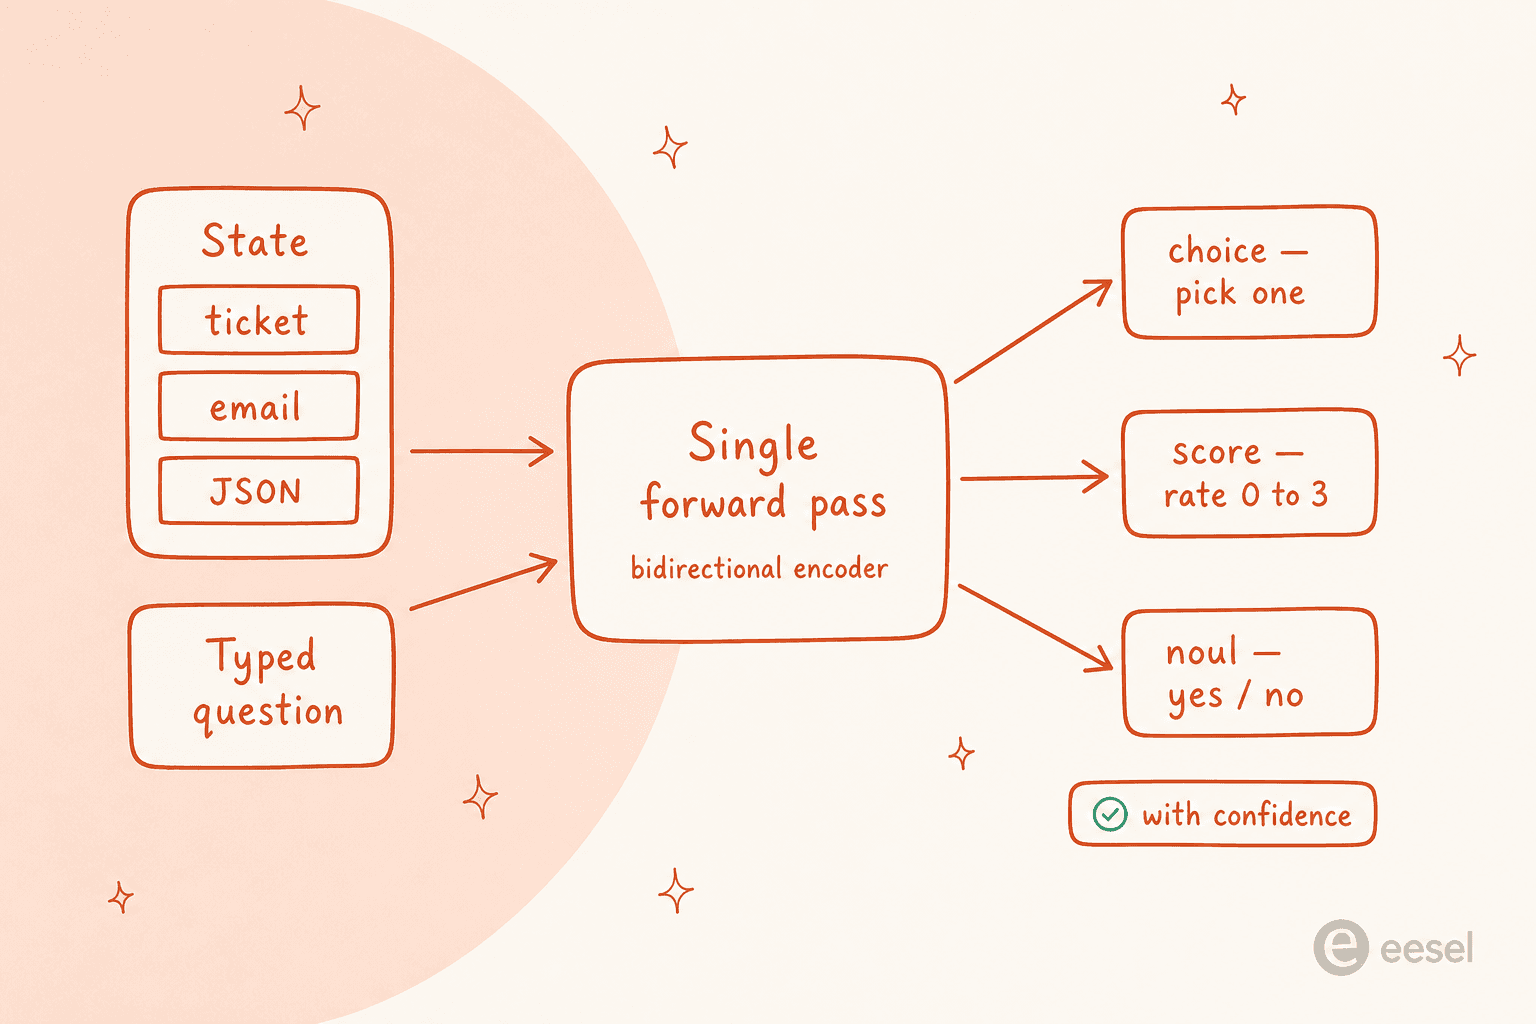
O truque inteligente é como ele pontua as opções. Cada opção é empacotada com seu próprio token [MASK], e o modelo lê o estado oculto nesse marcador para produzir um logit, depois aplica softmax sobre as opções da pergunta. Como o espaço de respostas é definido no momento da requisição, novos esquemas não exigem retreinamento, basta passar opções diferentes. O checkpoint em inglês é o ModernBERT-large com 421M de parâmetros, com uma pequena cabeça de decisão treinada por cima.
Depois vem o treinamento, que é de onde sai a calibração. O Laya é treinado com o que a Convai chama de RLCD, aprendizado por reforço contra regras de pontuação estritamente próprias. A versão curta: o treinamento ingênuo ensina o modelo a ser excessivamente confiante, porque empurrar a probabilidade vencedora para 1.0 maximiza uma recompensa de precisão simples. A frase de Nandakishor sobre isso é a mais afiada de todo o texto:
"Naive RL maximizes accuracy by destroying calibration. It turns your model into a confidently wrong machine."
O RLCD, em vez disso, recompensa o modelo apenas quando a probabilidade informada corresponde à realidade, então a confiança honesta é o caminho para vencer. É uma escolha de projeto real e verificável, não um slogan, e é isso que eu realmente buscaria no Laya.
Os três checkpoints
"Laya" é na verdade uma família de três checkpoints reunidos em um único repositório do Hugging Face, e escolher o certo importa mais do que o marketing sugere.
| Checkpoint | Backbone | Parâmetros | Melhor em |
|---|---|---|---|
convaiinnovations/laya | ModernBERT-large | 421M | Guardrails em inglês, triagem de e-mail |
laya-multilingual | mmBERT-base | 322M | Mais de 100 idiomas, ~2,2 vezes mais rápido |
laya-typed-decisions | ModernBERT-large | 421M | Os quatro fluxos de decisões tipadas (0.766 de precisão) |
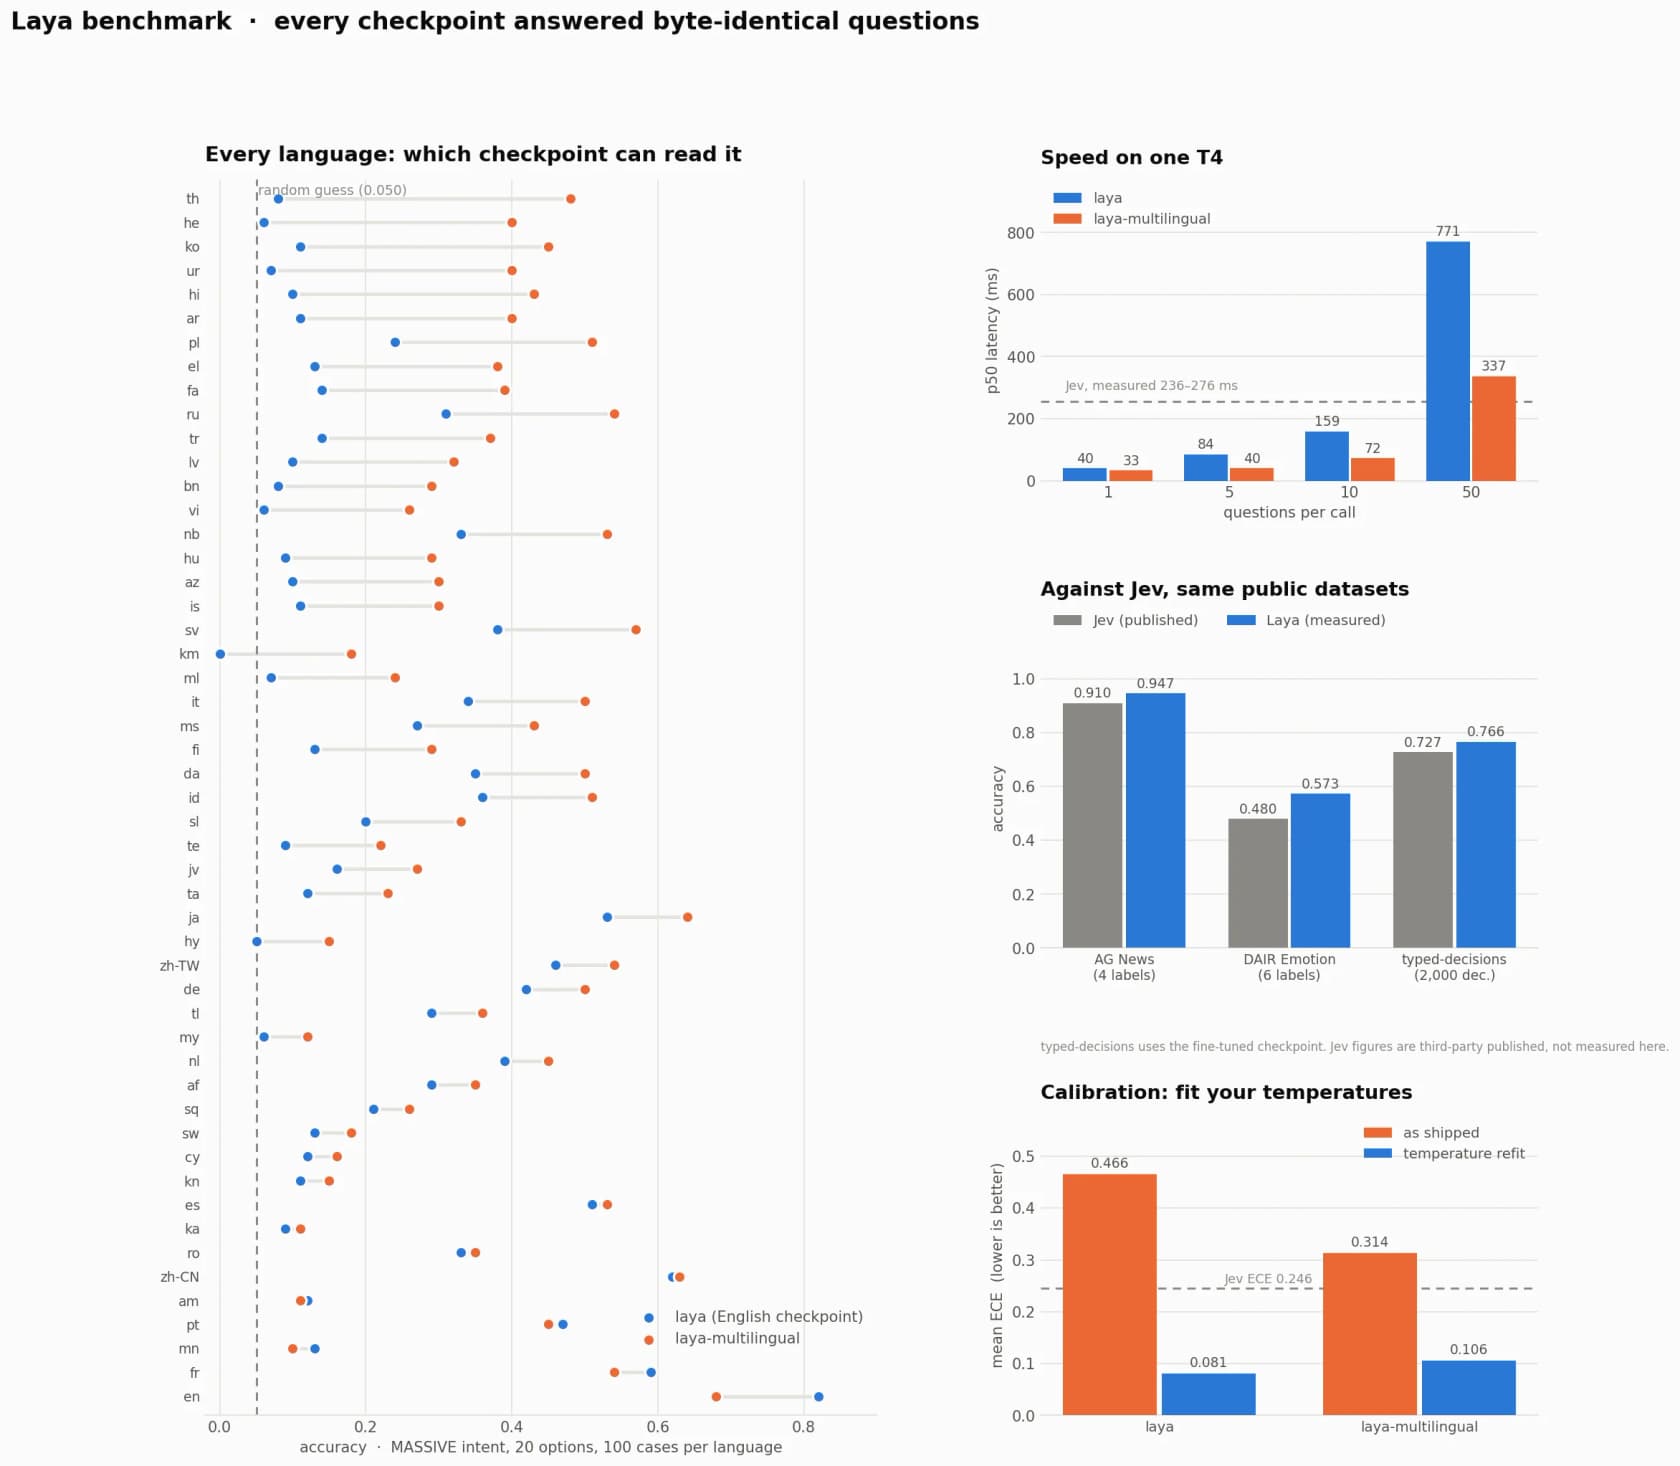
O modelo raiz em inglês colapsa fora dos alfabetos latinos, e não de forma elegante. No teste com 51 idiomas, ele marcou 0.000 de precisão em khmer enquanto informava 0.952 de confiança, exatamente a armadilha do "confiante e errado" que o modelo deveria evitar. O filtro por confiança não consegue salvá-lo aí, então o Laya inclui um Router embutido que detecta o alfabeto em menos de meio milissegundo e escolhe o checkpoint multilíngue antes mesmo de a passagem direta rodar.
Os benchmarks e a ressalva que todos ignoraram
Aqui está a comparação completa que o projeto publicou contra o Jev. É muita coisa, mas a manchete é que o Laya (com roteamento) supera levemente o Jev nos conjuntos de dados públicos compartilhados, sendo muito mais rápido e melhor calibrado.
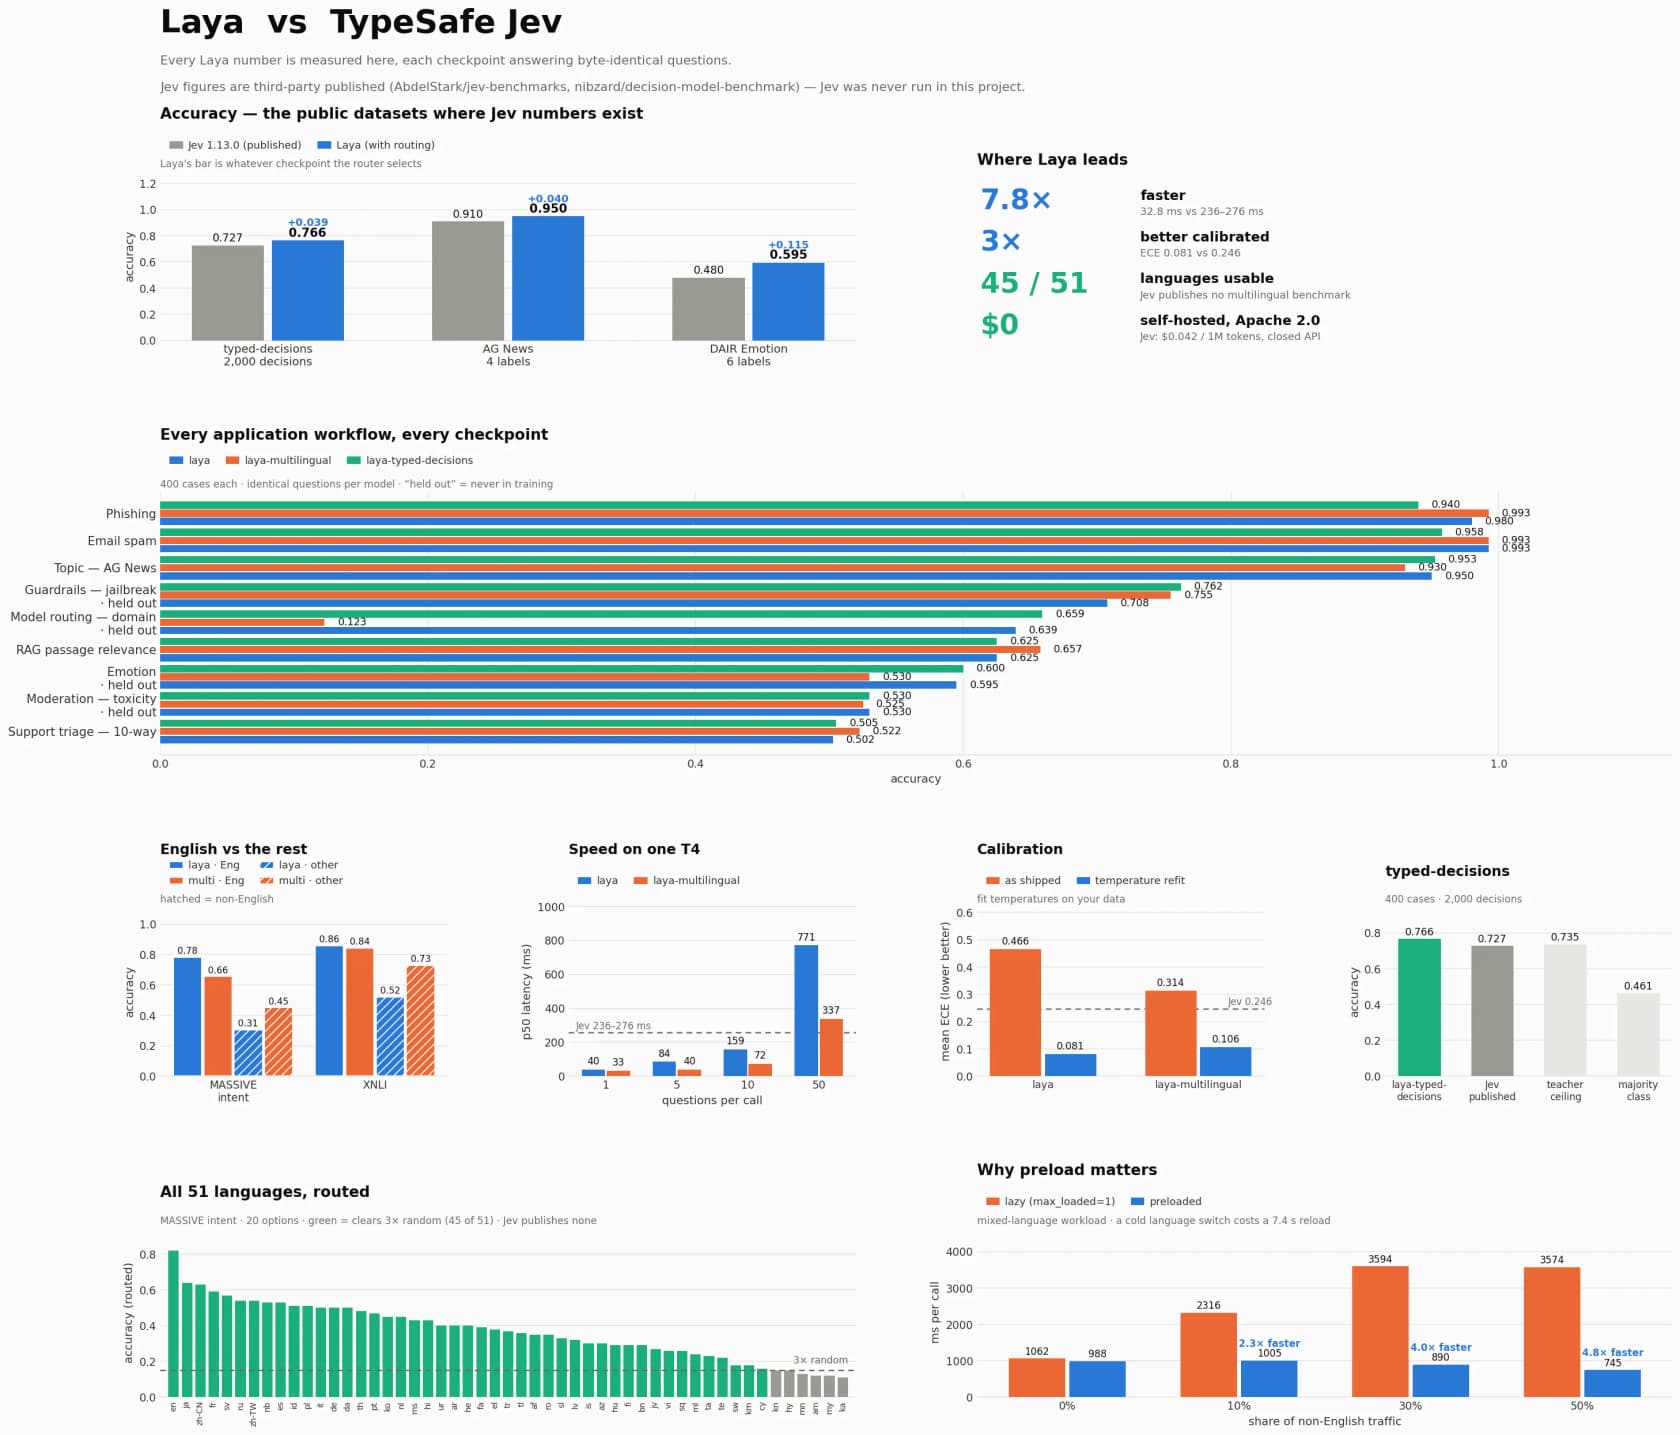
Os números que vale a pena guardar, todos medidos em uma única Tesla T4 (com as cifras do Jev publicadas por terceiros, já que a Convai não tinha acesso à API):
- Latência: 32,8 ms p50 para uma pergunta roteada, contra 236 a 276 ms do Jev. Esse é o 7,8x.
- Calibração: ECE de 0.081 após reajuste de temperatura, contra 0.246 do Jev, uma pontuação de calibração 3 vezes melhor.
- Precisão: 0.766 no conjunto tipado de 2.000 decisões, contra 0.727 do Jev, e supera o teto do professor de 0.735.
E então o asterisco que dominou a discussão. Esse 0.766 é do checkpoint com fine-tuning. Os modelos base, de fábrica, pontuam cerca de 0.362 no mesmo benchmark, mal acima da linha de base aleatória de 0.318. A própria seção de limitações do projeto diz isso claramente: trate o Laya como uma base rápida para especializar, não como um oráculo zero-shot. No Hacker News, onde o lançamento passou de 1.300 pontos, o principal comentário crítico foi exatamente este:
"This should be way up in the article. Fine tuning is a pain, requiring it for good results put Laya in a whole different category vs Jev"

É um golpe justo. O Jev é vendido como utilizável em zero-shot; o Laya, lido com honestidade, é uma base que você especializa. Os defensores também tinham uma réplica razoável: um modelo rápido, controlável por prompt e calibrado, que você consegue ajustar em uma tarde, ainda é um grande avanço em relação a gerenciar uma frota de classificadores sob medida.
Para que você realmente o usaria
Tirando o drama com o Jev, o Laya é um classificador rápido com confiança honesta, então serve em qualquer lugar onde você hoje paga demais a um modelo generativo para tomar uma pequena decisão estruturada. O projeto informa a precisão real por fluxo de trabalho, e a variação mostra onde ele é forte:
- Filtro de spam de e-mail: 0.993
- Detecção de phishing: 0.980
- Guardrails de LLM e detecção de jailbreak: 0.755 a 0.762 (0.931 com 50% de cobertura seletiva)
- Relevância de trechos em RAG: 0.657
- Roteamento de tickets de suporte, 10 classes: 0.522
As decisões de segurança binárias são excelentes; a classificação ampla e difusa é onde ele precisa do fine-tuning. O argumento de quem pratica a favor de um modelo assim foi bem colocado no HN e combina com o que ouço de equipes afogadas em regras de roteamento avulsas:
"The ability to knock out any arbitrary classification problem in minutes instead of in a week is a big deal... I don't want to spend a week to create a dataset, finetune a model, and set up infrastructure to run the model, every time I have a small routing or classification problem."
Há uma tensão real nesse tópico que vale nomear, porque é a verdadeira decisão de compra. Alguns desenvolvedores querem algo pronto que nunca precisem treinar:
"I don't want to manage GPUs / CPUs now. I don't want to maintain my corpus and retrain as my product's data distribution shifts... I just want a reasonably good general classifier served to me with a great devex and calibrated confidence scores to help me figure out when to fallback."
Esse é o limite honesto do Laya para muitas equipes: é um excelente componente se você estiver disposto a executá-lo e especializá-lo, e menos adequado se queria algo que simplesmente funcione de fábrica.
Velocidade, idiomas e custo
Onde o Laya é inequivocamente forte é na parte operacional e entediante. Ele funciona em 45 de 51 idiomas acima de 3 vezes o acaso quando roteado, contra zero números multilíngues publicados pelo Jev.
Em custo, é Apache 2.0 e hospedado por conta própria, então são $0.00 por milhão de tokens contra os $0.042 do Jev, e roda isolado da rede no seu próprio hardware, o que importa para quem tem restrições de HIPAA ou LGPD/GDPR. A instalação é uma linha, pip install laya, e Router(preload=True) mantém todos os checkpoints residentes para evitar um recarregamento a frio de 7 a 10 segundos ao trocar de idioma. O repositório no GitHub passou de 9.000 estrelas, e há um Space de demonstração ao vivo se você quiser testar antes de escrever código.
A única ressalva para problemas de alta cardinalidade: as perguntas choice se degradam acima de cerca de 20 opções com o orçamento de tokens padrão. No Banking77 (77 rótulos), o Laya marcou 0.425 contra 0.870 do Jev, porque cada opção só tem 3 a 4 tokens para se distinguir. A solução é aumentar o orçamento ou dividir em uma hierarquia do grosso ao fino, mas de fábrica, um roteador de 10 classes é confortável e um de 77 não.
A polêmica: quem construiu primeiro
Não dá para escrever sobre o Laya sem a história de origem, porque ela é metade do motivo de o texto ter viralizado. O enquadramento de Nandakishor é uma reivindicação de prioridade: ele diz que publicou essa abordagem de decisão não autorregressiva, treinada com RL, em um artigo do arXiv de março de 2025 e em um acompanhamento de setembro de 2025, um ano inteiro antes de a TypeSafe lançar o Jev com estardalhaço.
"It is incredibly frustrating when something you poured your heart into for months as an open-source researcher gets overlooked because it was built for a vertical use case, while a funded lab packages the same core idea horizontally and gets all the glory."
A comunidade se dividiu, com razão. Alguns apontaram que uma marca limpa e uma API utilizável são, em si, o produto, e que o trabalho anterior dele foi vendido como uma ferramenta de nicho de "conversão de vendas" que ninguém leu. Outros foram solidários, e vários ficaram contentes por a versão aberta existir, mesmo revirando os olhos para o alarde do lançamento dos dois modelos:
"I had used versions of bert to achieve the same functionality years ago. But to me it seems like they were able to trick the VCs with 'can't hallucinate' etc. To the above author, kudos for sharing your work and making it open."
Minha opinião: o argumento da prioridade é uma distração de um lançamento forte. Tenha o Laya sido o primeiro ou não, ele é aberto, rápido, honestamente documentado e funciona bem nas tarefas sobre as quais é honesto. Isso vale mais do que a disputa por crédito.
Onde um modelo de decisão se encaixa e onde entra um colega de IA
Aqui está a parte que mais me importa, porque construo isso para viver. Um modelo de decisão e um colega de IA não são concorrentes. Eles vivem em camadas diferentes.
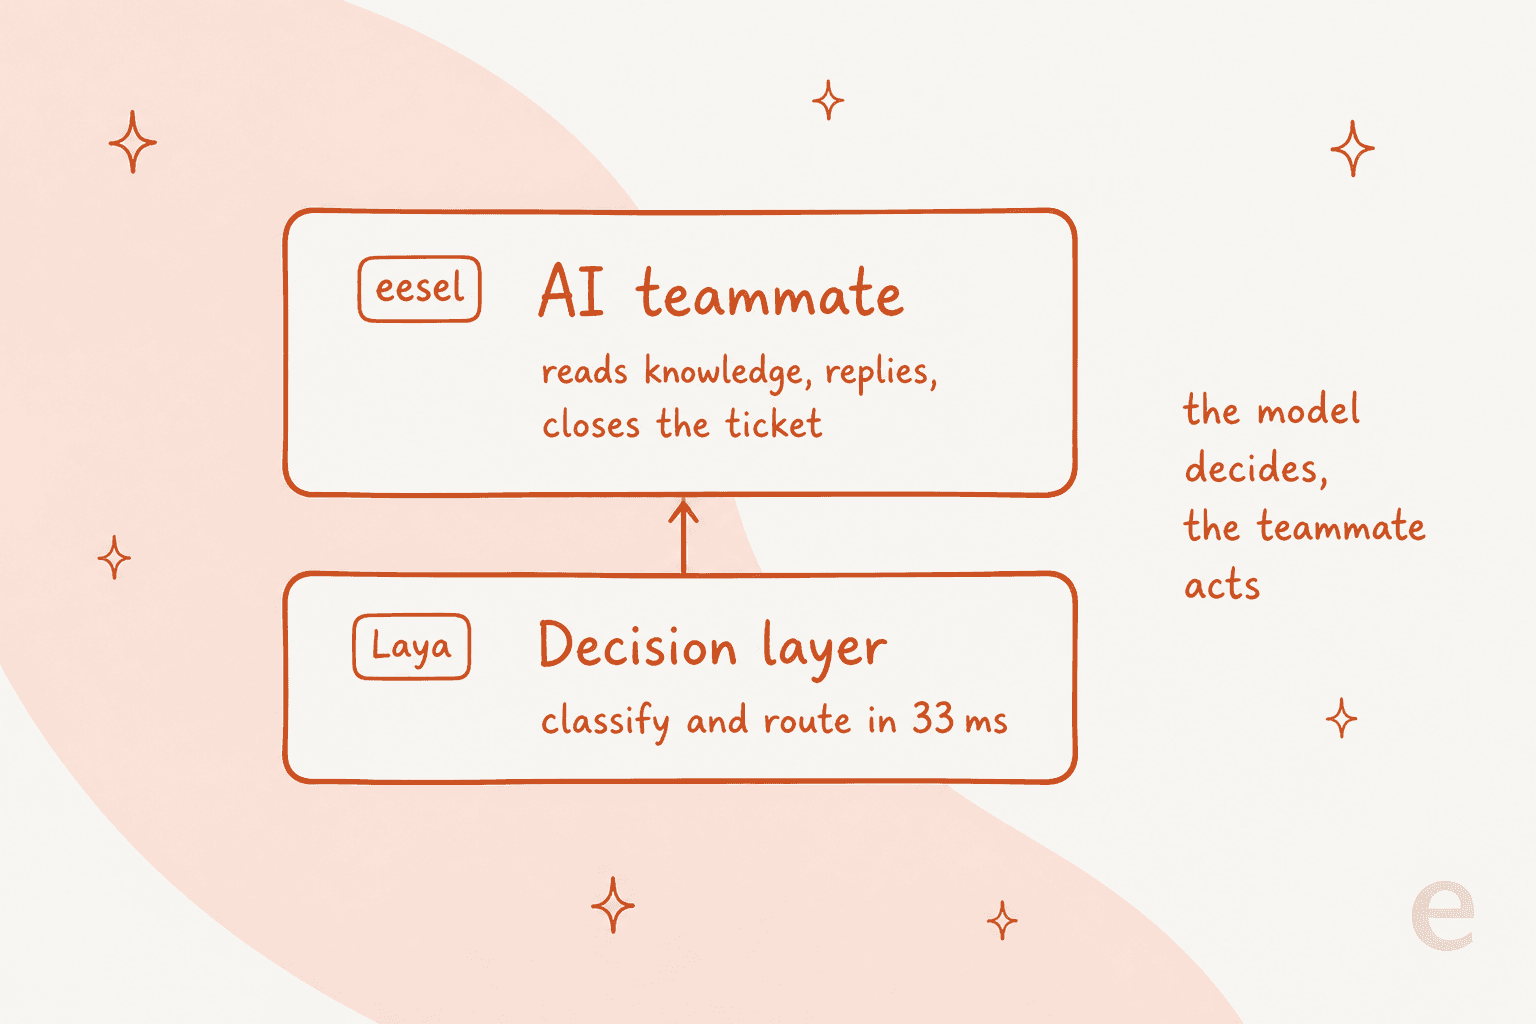
O Laya é infraestrutura. Ele responde "em qual fila este ticket deve ficar?" ou "isso é urgente?" em 33 ms, e faz essa única coisa muito bem. Mas ele não lê sua central de ajuda, não redige a resposta, não consulta o status do pedido e não encerra a conversa. Esses são os trabalhos reais que uma equipe de suporte precisa ver feitos, e eles exigem um modelo que age, não apenas classifica.
Essa é a diferença entre um componente e um funcionário. A eesel é uma plataforma de colegas de IA, e o colega de IA para o helpdesk é o contratado para suporte: ele entra na sua fila atual no Zendesk, Freshdesk ou onde você já trabalha, lê seus tickets e documentos anteriores e resolve o ticket inteiro de ponta a ponta. Por baixo, ele toma o mesmo tipo de decisões rápidas e calibradas de roteamento e confiança em que o Laya é bom, mas as envolve na leitura, na redação e na ação que transformam uma classificação em uma conversa resolvida. Se você é desenvolvedor e quer programar ou automatizar esse colega diretamente, a CLI da eesel e o servidor MCP permitem que uma pessoa, um script ou um agente de código como o Claude Code controle o mesmo workspace que o painel usa.
Experimente a eesel
Se você está olhando o Laya porque quer decisões de suporte mais inteligentes e rápidas, vale deixar claro o que está comprando. Um modelo de decisão lhe dá um componente para construir. Um colega de IA para suporte lhe dá o trabalhador pronto.

Confio no argumento de calibração do Laya porque já vivi a alternativa. Vimos bots que soam confiantes darem respostas erradas em silêncio em filas reais, e por isso toda implantação da eesel começa com uma simulação sobre seus próprios tickets históricos, para que você veja a taxa de resolução exata e as respostas exatas antes de tocar em um único cliente. O preço é uma tarifa mensal fixa, a partir de $299/mês por 500 créditos (1 crédito por ticket ou chat), sem cobrança por usuário, e há um plano gratuito com 100 créditos. Se você quer a decisão executada e não apenas rotulada, essa é a camada que deve olhar.
O que eu diria a um amigo
O Laya é uma contribuição real e fico feliz por ele ser aberto. Se você é desenvolvedor com problemas de classificação ou roteamento e disposição para fazer fine-tuning, é uma das ferramentas novas mais interessantes do ano: rápida, calibrada, multilíngue e gratuita. Leia o cartão do modelo, é refrescantemente honesto sobre os próprios limites.
Mas leia essa seção de limitações antes de construir em cima dele. Os resultados zero-shot ficam perto do acaso, a confiança precisa ser reajustada com seus dados e a classificação ampla pede fine-tuning. Trate-o como a excelente base que ele diz ser, e se o que você realmente precisa é o trabalho de suporte inteiro feito, em vez de uma única decisão devolvida, recorra a um colega, não a um componente.
Perguntas frequentes
O que é Laya AI?
Laya AI é um modelo de decisão de código aberto, com 421M de parâmetros, da Convai Innovations. Em vez de gerar texto como um chatbot, ele recebe um estado (um ticket, um e-mail ou JSON) mais perguntas tipadas e devolve respostas tipadas com probabilidades calibradas em uma única passagem direta de cerca de 33 ms. É lançado sob Apache 2.0 e posicionado como a resposta aberta ao Jev, o modelo fechado da TypeSafe AI.
Quanto custa o Laya AI?
O Laya é gratuito. Os pesos estão sob Apache 2.0 no Hugging Face, então hospedar por conta própria custa $0.00 por milhão de tokens, contra os $0.042 por milhão de tokens cobrados pela API fechada do Jev. Seu único custo é a GPU ou CPU em que você o executa. Se você prefere não executar modelo nenhum, um colega de IA para o helpdesk cuida da classificação e da resposta por você.
O Laya AI é bom para roteamento de tickets?
É uma base sólida para isso. Em um benchmark de triagem de suporte com 10 classes, o modelo base marca 0.522 e o checkpoint com fine-tuning supera o teto do modelo professor no conjunto de decisões tipadas, e cada resposta traz uma pontuação de confiança calibrada para acionar o plano alternativo. Veja nossa comparação de ferramentas de IA para triagem de tickets para entender como isso se encaixa em uma stack de suporte real.
O Laya AI realmente não consegue alucinar?
Dentro do seu espaço de saída, sim. O Laya nunca emite tokens de texto; ele só devolve probabilidades sobre um conjunto fixo de opções que você define, então uma resposta malformada ou uma categoria inventada é impossível por construção. Ele ainda pode errar, e é por isso que a pontuação de confiança calibrada importa mais que o slogan de marketing.
Preciso fazer fine-tuning do Laya AI?
Para uma precisão séria, geralmente sim. De fábrica, os checkpoints base pontuam quase ao acaso (~0.362) no benchmark de decisões tipadas; o 0.766 das manchetes vem do fine-tuning nessa tarefa. Trate o Laya como uma base rápida para especializar, não como um oráculo zero-shot, e reajuste a temperatura dele com seus próprios dados antes de confiar nos números de confiança.