Um modelo que chegou antes do próprio comunicado
A maioria dos lançamentos de modelo é um post de blog, um gráfico de benchmarks e um model card, tudo de uma vez. O M3.1 Flash fez o contrário. Apareceu no seletor de modelos do MiniMax Code, ao lado do M3 e do M2.7, e a comunidade o encontrou ali antes de a MiniMax dizer qualquer coisa. O desenvolvedor que revelou a novidade notou na hora o novo menu de raciocínio:
"🚨重磅!MiniMax M3.1-Flash 预览版疑似已上线 MiniMax Code!推理等级单独成菜单:low / medium / high / xhigh / max。目前还没有官方公告,属于先露在产品里的灰度上线。" (Tradução: "Grande novidade! A preview do MiniMax M3.1-Flash parece estar no ar no MiniMax Code. Os níveis de raciocínio têm menu próprio: low / medium / high / xhigh / max. Ainda sem anúncio oficial, é um rollout cinza/gradual mostrado primeiro no produto.")
O lançamento também veio com um certo suspiro. A MiniMax vem lançando modelos de vídeo e música em ritmo acelerado, a série M (texto) tinha ficado quieta, e a resposta mais curtida sob o post de lançamento soou como impaciência afetuosa:
"You finally remembered the M series"
Há também uma história por trás do hype. Por dias antes, desenvolvedores testaram à exaustão um modelo stealth gratuito chamado "Space Bunny" e tentaram adivinhar o que era; a resposta veio poucos dias antes do lançamento:
"Confirmed, Space Bunny Alpha is Minimax M3.1"
Então a empolgação é real, mas o "lançamento" é uma preview escalonada, que aparece primeiro no produto. Se você está decidindo se vai construir em cima dele, essa distinção importa mais que o hype: uma preview de rollout cinza sem preço e sem pesos não é o mesmo compromisso que um modelo GA.
O que o MiniMax M3.1 Flash realmente é
Tirando o teatro do lançamento, a documentação da plataforma é clara sobre a substância. Na tabela de modelos suportados, o M3.1 Flash é descrito como um "frontier multimodal coding model with 1M context window and tunable thinking depth", feito para raciocínio agêntico, uso de ferramentas, programação e execução de tarefas estruturadas. Ele aceita texto, imagens e vídeo como entrada.
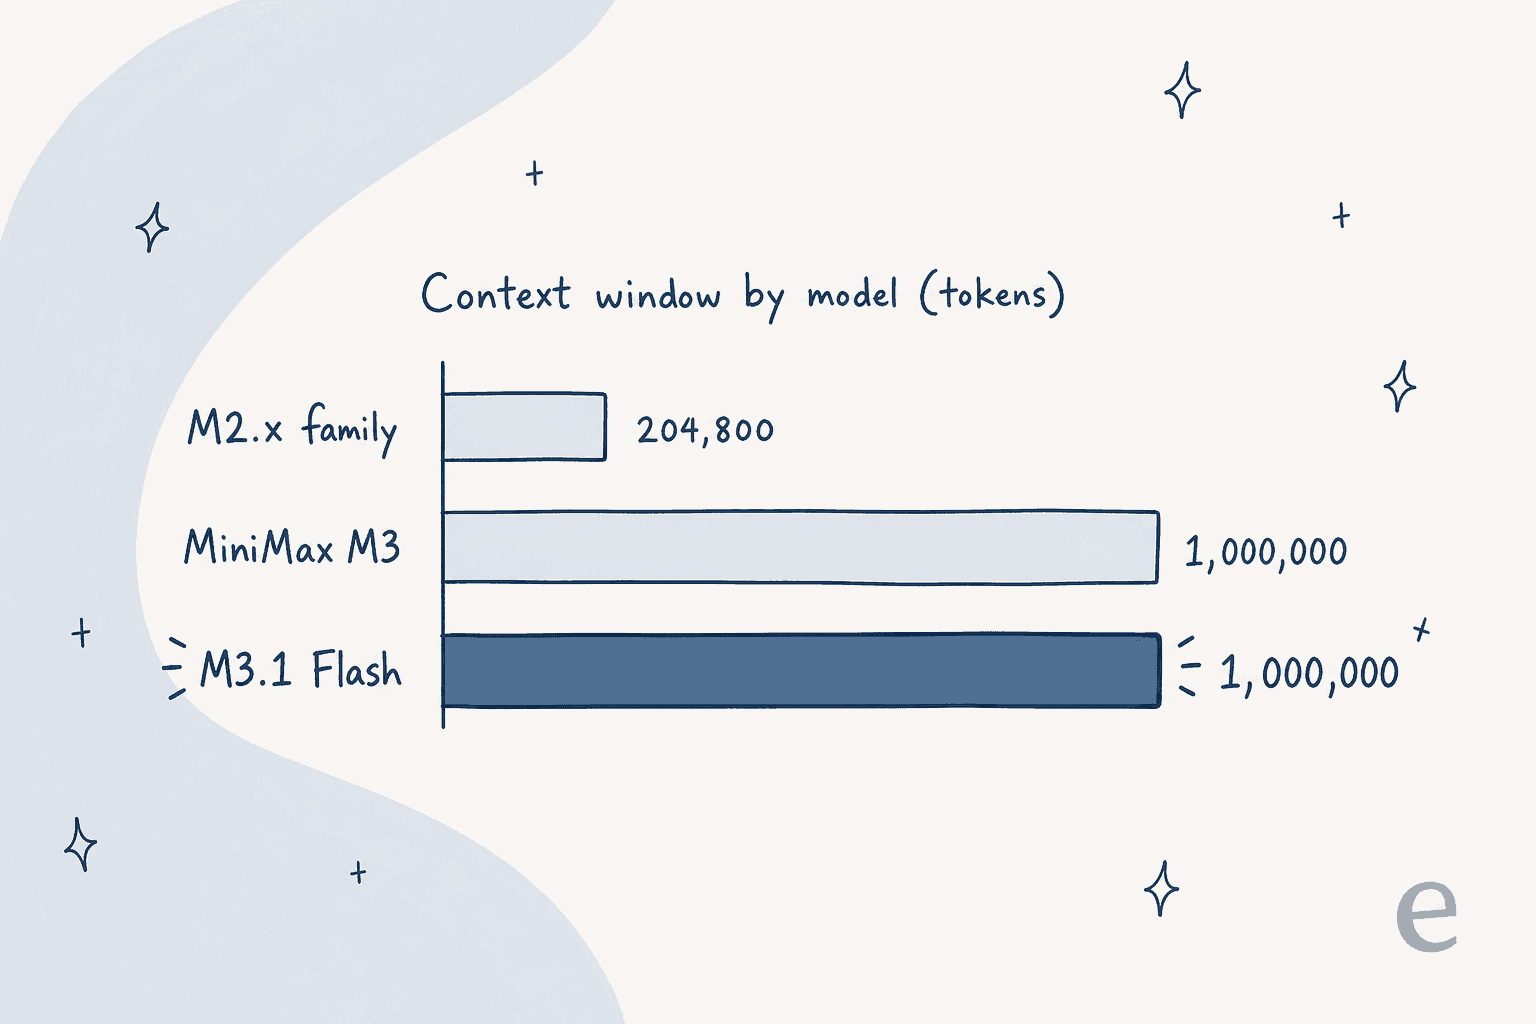
O contexto de 1M é a especificação principal e é um salto real dentro da série M, não um arredondamento de marketing. Toda a família M2 chegava a 204.800 tokens; a geração M3, incluindo o M3.1 Flash, é um salto limpo de cinco vezes.
Isto é o que a documentação afirma e o que não afirma:
| Atributo | MiniMax M3.1 Flash |
|---|---|
| Id do modelo | MiniMax-M3.1-Flash-Preview |
| Janela de contexto | 1.000.000 de tokens |
| Modalidades de entrada | Texto, imagem, vídeo |
| Raciocínio | Ligado por padrão, ajustável via effort, não pode ser desativado |
| Disponibilidade | Somente Token Plan + MiniMax Code |
| Pesos abertos | Nenhum (sem card no Hugging Face) |
| Número de parâmetros | Não informado |
| Throughput (tps) | Não informado |
| Preço por token | Não publicado |
Essa tabela é deliberadamente honesta sobre as lacunas. Não há número de parâmetros informado, número oficial de tokens por segundo nem suíte de benchmarks específica para o M3.1 Flash. Se uma página diz que o modelo tem "428B parâmetros" ou cita uma pontuação de benchmark, está pegando emprestado do M3 original, não citando o M3.1 Flash. Prefiro apontar a lacuna a disfarçá-la.
O único controle que o define: effort
O único recurso que a documentação destaca para o M3.1 Flash e não para o M3 é a profundidade de raciocínio ajustável. O modelo sempre raciocina antes de responder, e você controla o quanto ele pensa com uma configuração effort que aceita low, medium, high, xhigh e max. Se você omitir, o padrão é max.
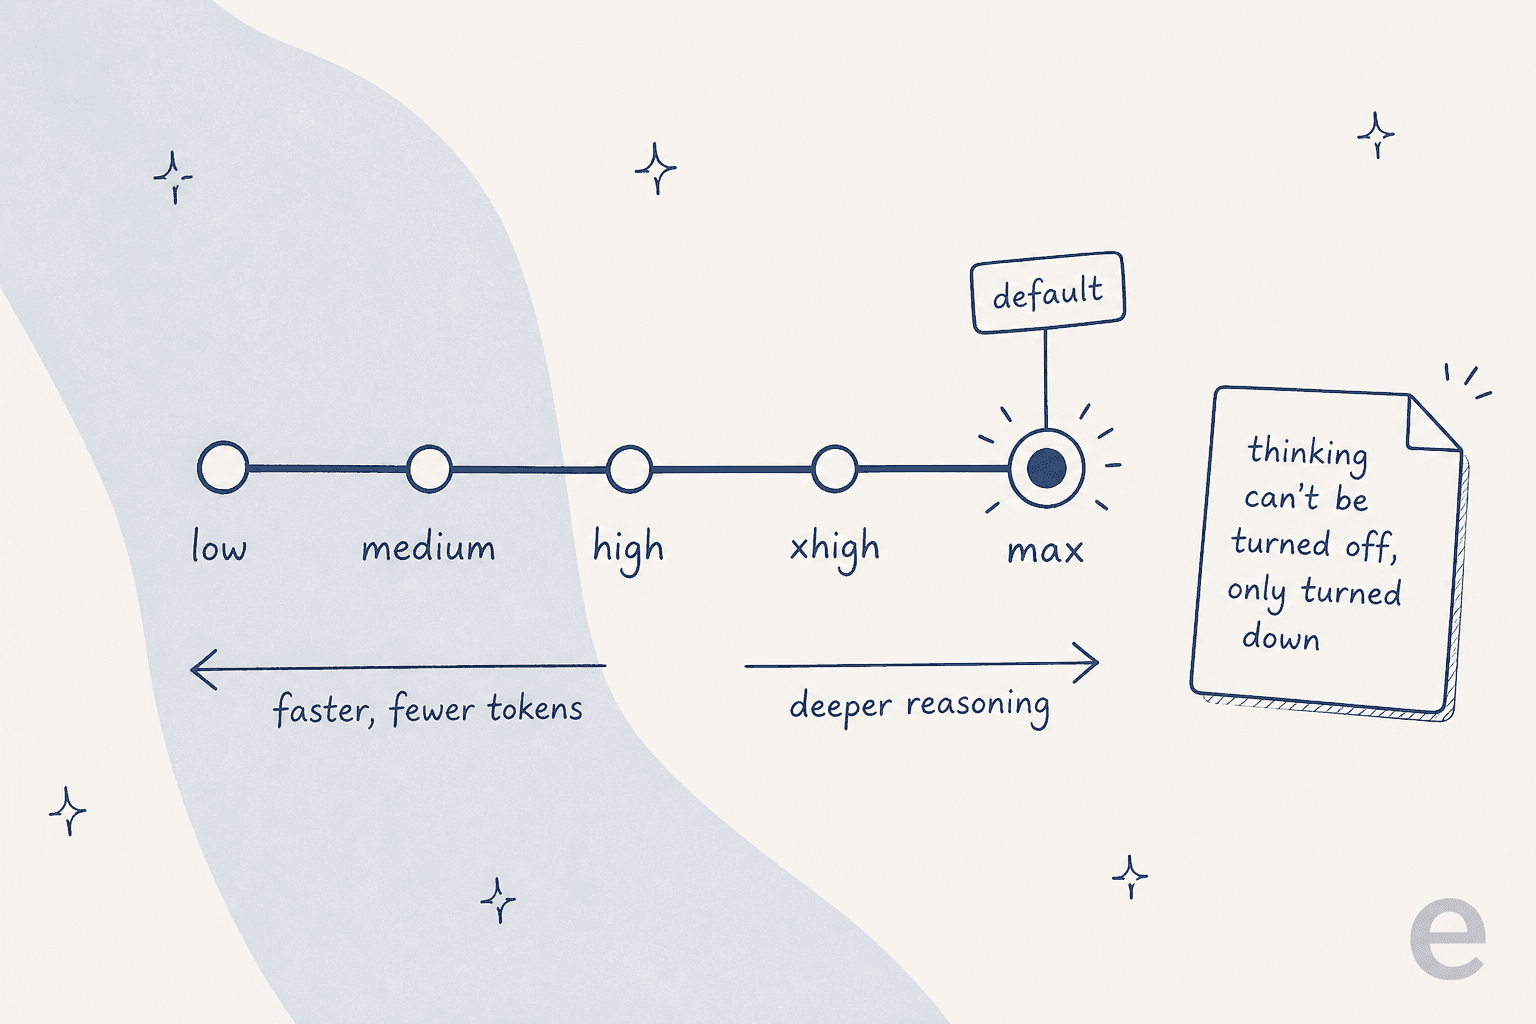
O detalhe que pega as pessoas: você não pode desligar o raciocínio. Se enviar thinking: {"type": "disabled"} ou effort: "none", a API retorna um 400 com a mensagem requires adaptive thinking (docs). Se precisar de menor latência ou menos tokens de saída, você reduz o effort para low; não existe modo sem raciocínio. É uma opinião de design de verdade, e vale saber antes de plugá-lo em um caminho sensível à latência. Para um modelo "Flash", usar max como padrão é uma escolha um pouco surpreendente, e significa que o comportamento barato e rápido que o nome sugere é algo que você precisa ativar.
Ele é mesmo rápido?
A MiniMax não publicou um número de throughput, então os únicos dados reais de velocidade até agora vêm de desenvolvedores que testaram no primeiro dia. A medição mais citada colocou a velocidade de decodificação numa faixa sólida, mas não líder da categoria:
"MiniMax-M3.1-flash-preview is hanging around 90 - 110 t/s range for decode. It's fast, love seeing it, def faster than MiMo-v2.6-flash but not as fast as deepseek-v4.1-flash"
Esse é o posicionamento honesto: rápido, à frente de alguns concorrentes da categoria flash, atrás de outros. E nem todo mundo acha que a velocidade bruta de decodificação é o que se deve comemorar:
"Decode speed is not equivalent to fast. The model is slow for the quality in my opinion, numbers dropping soon!"
Acho que esse cético tem um ponto que vale guardar. Um modelo que usa max de effort por padrão e não consegue parar de pensar vai parecer mais lento em tarefas reais do que um número de tokens por segundo sugere, porque gera muitos tokens de raciocínio antes da resposta. A pergunta útil não é "quantos tokens por segundo", e sim "quanto tempo até eu receber uma resposta correta que posso entregar", e esse é um benchmark que ninguém rodou ainda no M3.1 Flash.
A arquitetura por baixo
A documentação não repete os detalhes internos do M3.1 Flash, então o justo é tratar a arquitetura como herdada da geração M3 e não como uma especificação confirmada do M3.1 Flash. A linha M3 introduziu a MiniMax Sparse Attention (MSA), um design de atenção esparsa que torna um contexto de um milhão de tokens prático em vez de ruinosamente lento.
A própria comparação da MiniMax com a atenção padrão de consulta agrupada (GQA) é a ilustração mais clara de por que a atenção esparsa importa nesse tamanho de contexto:
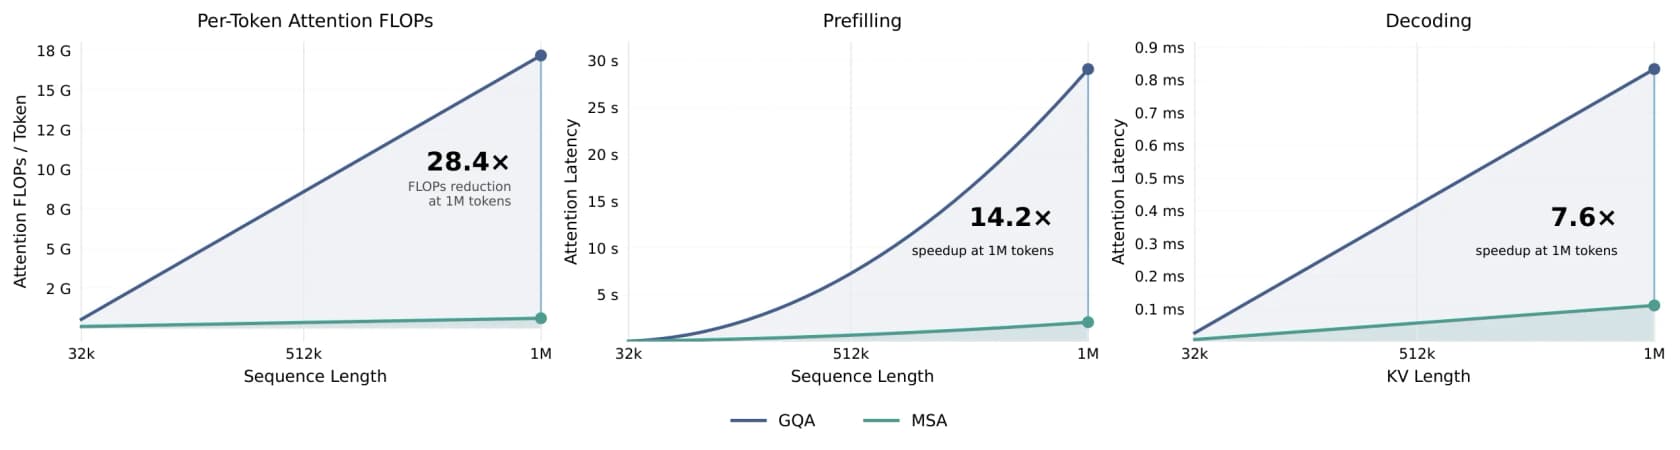
Com um milhão de tokens, o gráfico da MiniMax mostra a MSA reduzindo o cálculo de atenção por token em cerca de 28 vezes e acelerando a decodificação em ~7,6 vezes em relação à atenção padrão. São números da geração M3; como o M3.1 Flash tem a mesma janela de 1M, quase certamente usa a mesma arquitetura, mas eu não os citaria como especificação medida do M3.1 Flash até a MiniMax publicar uma.
Quanto custa
É aqui que o M3.1 Flash fica realmente incomum: não há preço por token em lugar nenhum. Ele não está na tabela pay-as-you-go, e a própria documentação da MiniMax diz que ele está disponível por ora apenas pelo Token Plan e pelo MiniMax Code. Então o custo real é a sua assinatura dividida pelo quanto você usa.
Este é o Token Plan, uma cota compartilhada entre texto, imagem e voz:
| Plano | Mensal | Anual (2 meses grátis) | ~Tokens M3 / mês | Geração de vídeo |
|---|---|---|---|---|
| Plus | US$ 20 | US$ 220 | ~1,7B | Nenhuma |
| Max | US$ 50 | US$ 550 | ~5,1B | 3 clipes/dia |
| Ultra | US$ 120 | US$ 1.320 | ~12,5B | 5 clipes/dia |
Há também uma opção de Credits pré-pagos (US$ 5 por 5.000, US$ 25 por 25.000, US$ 100 por 100.000, válidos por um ano) e nenhuma camada gratuita de LLM. A cota é renovada em janelas móveis de 5 horas e semanais, e a cota mensal não usada não acumula.
Se você quer ter noção do que uma API pública pode eventualmente cobrar, o irmão de 1M de contexto, o MiniMax M3, está no pay-as-you-go. Essas são as tarifas do M3, não do M3.1 Flash, mas a estrutura provavelmente antecipa o que vem por aí:
| MiniMax M3 (camada padrão) | Entrada | Saída | Leitura de cache |
|---|---|---|---|
| ≤ 512K de entrada | US$ 0,30 /M | US$ 1,20 /M | US$ 0,06 /M |
| > 512K de entrada | US$ 0,60 /M | US$ 2,40 /M | US$ 0,12 /M |
Duas coisas estruturais a notar para o futuro: um corte de 512K de entrada que dobra a tarifa acima dele, e uma camada de serviço Priority que custa 1,5x a tarifa padrão. Barato para a categoria, em outras palavras, mas com um adicional de contexto longo embutido.
Como rodá-lo na prática
Para uma preview, o acesso é surpreendentemente amigável para desenvolvedores. O M3.1 Flash fala dois protocolos: um endpoint compatível com a Anthropic em https://api.minimax.io/anthropic (o caminho recomendado pela MiniMax, com blocos de thinking) e um compatível com a OpenAI em https://api.minimax.io/v1. O campo effort fica em lugares diferentes conforme o que você usa: output_config.effort na API da Anthropic, reasoning_effort na da OpenAI.
Por ser compatível com Anthropic e OpenAI, você pode apontar ferramentas agênticas de programação existentes direto para ele. A MiniMax lista Claude Code, Cursor, Codex CLI e outras como suportadas pelo Token Plan, sem precisar de outra API key. Esse é o caso de uso real que a combinação "Flash + preview" persegue: um modelo padrão barato e rápido para programação cotidiana e loops de agentes, rodando dentro das ferramentas em que os desenvolvedores já vivem.
Onde um modelo assim se encaixa
O que me traz de volta ao enquadramento do início. O M3.1 Flash é um motor rápido com uma janela de contexto grande e um seletor de raciocínio. Isso é infraestrutura. É a capacidade bruta, exposta como endpoint, e é genuinamente boa no que faz. Mas um endpoint não conhece a sua empresa, não fica dentro do seu helpdesk e não é dono de um trabalho de ponta a ponta. Você ainda precisa construir tudo isso em volta dele.
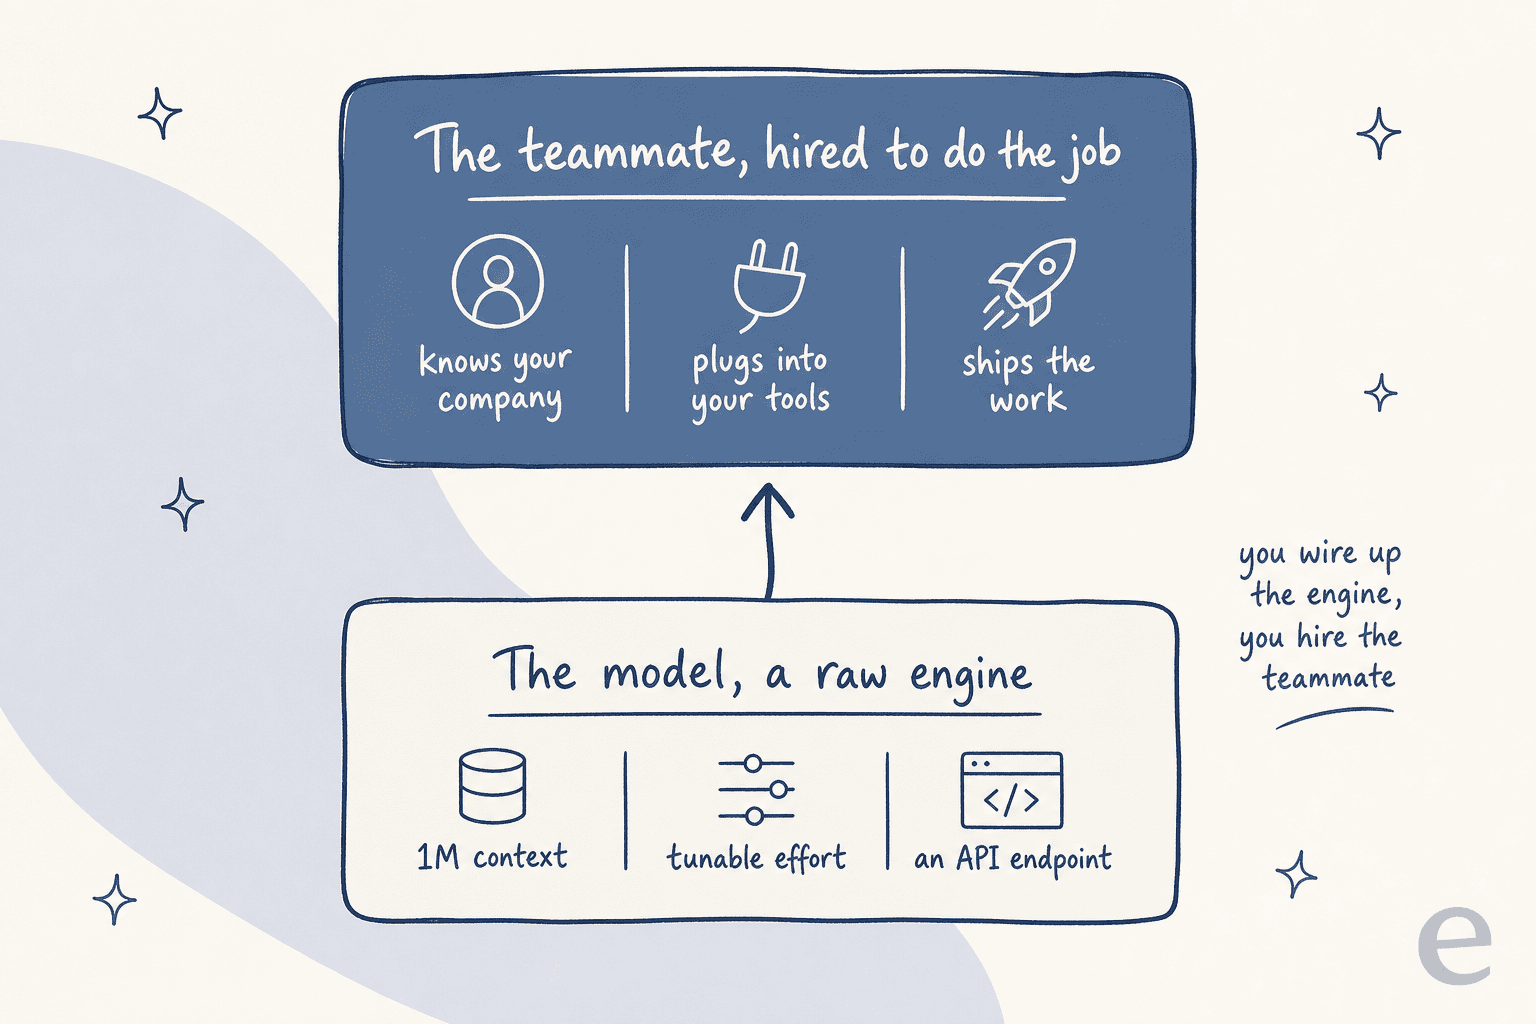
Essa distância entre "um modelo capaz" e "trabalho realmente feito" é toda a razão de existir da eesel. A eesel é uma plataforma de colegas de IA: em vez de te entregar um modelo e um editor em branco, você contrata um colega pronto para trabalhar em uma função específica. O time atual inclui um colega de IA para helpdesk que entra na sua fila de suporte existente e um redator de blog com IA que pesquisa e redige posts com a sua voz. Cada um chega já sabendo desempenhar o seu papel e se conecta às ferramentas que você já usa.
Se você vive no terminal, a eesel CLI é a parte que vai parecer mais familiar depois de ler uma página de docs como a da MiniMax. É o mesmo colega do painel, controlado pela linha de comando: você pode conectar um helpdesk, enviar conhecimento, configurar automações e aprovar ações retidas sem nunca abrir a interface. Todo comando imprime JSON, e os erros voltam como objetos estruturados {error, hint, retryable}, de modo que um agente de programação como Claude Code, Cursor ou Codex pode conduzir toda a configuração lendo o campo hint e decidindo o que executar em seguida. Todo workspace também funciona como servidor MCP, então o mesmo agente que chama o M3.1 Flash pode chamar a eesel. O modelo mental é simples: o modelo é o motor que você conecta; o colega é quem você contrata.
Experimente a eesel
Se você está empolgado com o M3.1 Flash porque quer a IA fazendo trabalho de verdade, e não só respondendo chamadas de API, essa última milha é o que a eesel resolve. Aponte-a para os seus tickets antigos e a sua central de ajuda, e o colega de IA para helpdesk começa a redigir respostas reais em minutos; ou dê um tema ao redator de blog com IA e ele pesquisa, redige e ilustra um post completo com a sua voz, do mesmo jeito que este foi feito.
O melhor é que você pode vê-lo trabalhar antes de se comprometer, já que a eesel roda primeiro contra o seu próprio histórico, e você vê a qualidade nos seus tickets reais, não em uma demo. É grátis para começar, sem cartão de crédito, para você ver por conta própria a diferença entre alugar um modelo e contratar um colega.
Perguntas frequentes
O que é o MiniMax M3.1 Flash?
MiniMax-M3.1-Flash-Preview) é o modelo mais recente da série M da MiniMax: um modelo multimodal de programação com janela de contexto de 1.000.000 de tokens e profundidade de raciocínio ajustável. Chegou como preview dentro do MiniMax Code e do Token Plan em 27 de setembro de 2026 e é voltado para trabalho rápido e cotidiano de programação e agentes. Se você quer um modelo assim fazendo um trabalho de verdade em vez de ficar atrás de uma API, um colega de IA como a eesel é a camada que transforma isso em trabalho.Quanto custa o MiniMax M3.1 Flash?
O MiniMax M3.1 Flash é open source ou está no Hugging Face?
Como o M3.1 Flash difere do MiniMax M3?
É possível desligar o raciocínio no MiniMax M3.1 Flash?
effort: "none" ou thinking: disabled retorna um erro 400. Para reduzir latência e uso de tokens, você diminui o nível de effort em vez de desligar o raciocínio.

Article by
Rama Adi
Rama is a software engineer at eesel AI with two years of experience writing about B2B SaaS, AI tools, and customer support technology. Based in Bali, Indonesia, he brings a developer's perspective to product comparisons — cutting through marketing copy to what the integrations and APIs actually do.